

မြန်ဆန်ပြီး အရည်အသွေးမြင့် ဗီဒီယိုအကြောင်းအရာအတွက် ၀ယ်လိုအားသည် ယခင်ကထက် ပိုမိုများပြားလာပါသည်။ ယနေ့ခေတ် မီဒီယာလောကတွင် သတင်းအဖွဲ့ငယ်များ၊ လွတ်လပ်သော အကြောင်းအရာဖန်တီးသူများနှင့် ပွဲကျင်းပရေးအဖွဲ့များသည် post-production အဖွဲ့ သို့မဟုတ် ဗဟိုချုပ်ကိုင်မှုရှိသော အခြေခံအဆောက်အအုံ၏ ပံ့ပိုးမှုမပါဘဲ ပရော်ဖက်ရှင်နယ်အဆင့် ဗီဒီယိုများကို အချိန်နှင့်တပြေးညီ ရိုက်ကူး၊ တည်းဖြတ်ပြီး ထုတ်ဝေရန် မျှော်လင့်ထားကြသည်။
ထို့ကြောင့် edge-based production systems များမှတစ်ဆင့် ပေးပို့သော on-premise AI search သည် footage ပမာဏ ပေါက်ကွဲပြီး ပြန်လည်အသုံးပြုရန် လိုအပ်ချက် မြင့်တက်လာသည်နှင့်အမျှ မရှိမဖြစ်လိုအပ်သော အရာတစ်ခု ဖြစ်လာပါသည်။ အဖွဲ့များအား ရိုက်ကူးသည့်အချိန်တွင် footage ဖြင့် တိုက်ရိုက်အလုပ်လုပ်နိုင်စေခြင်းဖြင့် edge workflows များသည် အတားအဆီးများကို ဖယ်ရှားပေးပြီး ဖန်တီးသူများအား footage များကို ရှာဖွေခြင်းနှင့် စီမံခန့်ခွဲခြင်းအတွက် အချိန်နည်းပါးစေပြီး အကောင်းဆုံးအကြောင်းအရာများကို ထုတ်လုပ်ရန် အချိန်ပိုမိုရရှိစေပါသည်။
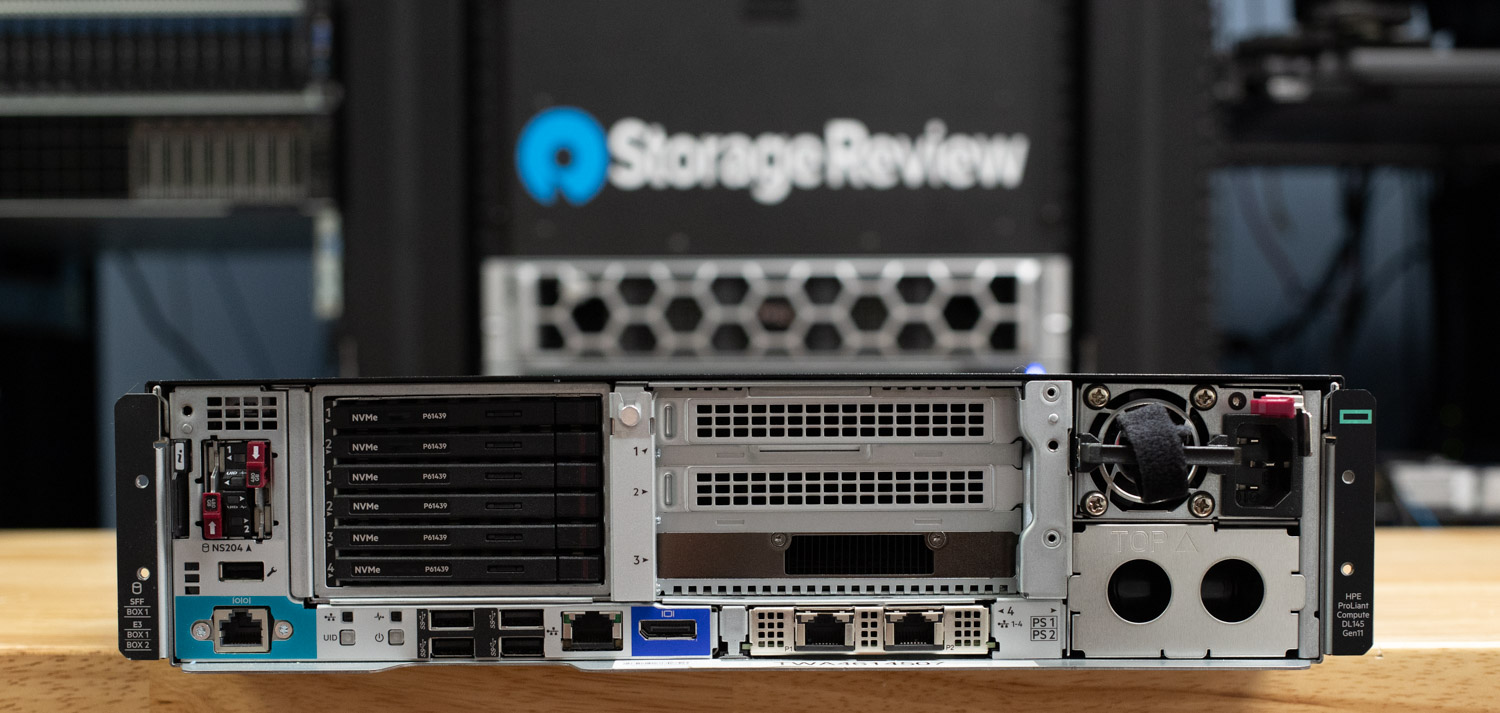
Axle AI သည် AI ဖြင့် လည်ပတ်သော မီဒီယာပိုင်ဆိုင်မှုစီမံခန့်ခွဲမှုနှင့် အလိုအလျောက်လုပ်ဆောင်သည့် ပလက်ဖောင်းတစ်ခုဖြစ်ပြီး ဤဗဟိုချုပ်ကိုင်မှုမရှိသော၊ မြန်ဆန်သော workflow အတွက် အထူးဒီဇိုင်းထုတ်ထားသည်။ HPE ProLiant DL145 Gen11 server၊ NVIDIA L4 GPU နှင့် Solidigm PCIe Gen5 SSD များကဲ့သို့သော လုပ်ငန်းနယ်ပယ်တွင် ဦးဆောင်နေသော hardware များနှင့် ပေါင်းစပ်လိုက်သောအခါ ရလဒ်အနေဖြင့် အစွမ်းထက်ပြီး သယ်ဆောင်ရလွယ်ကူသော ထုတ်လုပ်မှုပတ်ဝန်းကျင်တစ်ခု ဖြစ်လာသည်။ ၎င်းသည် ပရော်ဖက်ရှင်နယ် AI ဖြင့် အထောက်အကူပြုသော မီဒီယာစွမ်းရည်များကို အပါးလွှာဆုံးအဖွဲ့များထံပင် ယူဆောင်လာပေးသည်။
စနစ်ဗိသုကာ ခြုံငုံသုံးသပ်ချက်
HPE ProLiant DL145 Gen11 edge server သည် နေရာ၊ ပါဝါနှင့် အအေးပေးစနစ် အကန့်အသတ်ရှိသော လယ်ကွင်းနှင့် ပွဲလမ်းသဘင်ပတ်ဝန်းကျင်များတွင် Axle AI ဖြန့်ကျက်မှုများအတွက် ကောင်းမွန်သော ရွေးချယ်မှုတစ်ခုဖြစ်သည်။ ၎င်း၏ 2U အတိုအနက်ဒီဇိုင်းသည် အနက် ၁၆ လက်မသာရှိသော ဤ server ကို mobile racks နှင့် flight cases ကဲ့သို့သော ကျဉ်းကျပ်သောနေရာများတွင် သယ်ဆောင်ရလွယ်ကူမှုနှင့် တပ်ဆင်မှုအတွက် ရည်ရွယ်ချက်ရှိရှိ တည်ဆောက်ထားသည်။ ရိုးရာ enterprise gear များနှင့်မတူဘဲ၊ ၎င်းသည် -5°C မှ 55°C အထိ တိုးချဲ့ထားသော operating temperature range ကို ပံ့ပိုးပေးသောကြောင့် ထိန်းချုပ်မှုနည်းသောပတ်ဝန်းကျင်များအတွက် သင့်လျော်သည်။ ၎င်း၏ အရွယ်အစားသေးငယ်သော်လည်း၊ ၎င်းသည် redundant power နှင့် boot drive options များကဲ့သို့သော enterprise-class features များကို ပေးဆောင်သောကြောင့် full-sized hardware ၏ overhead မပါဘဲ ခိုင်မာပြီး edge-capable infrastructure လိုအပ်သော အဖွဲ့များအတွက် အသင့်တော်ဆုံးဖြစ်သည်။
CPU ဘက်တွင် DL145 သည် AMD EPYC 8004 (Siena) series processors များကို ပံ့ပိုးပေးပြီး cores ရှစ်ခုမှ ၆၄ ခုအထိ ပံ့ပိုးပေးပါသည်။ ကျွန်ုပ်တို့၏ စမ်းသပ်စနစ်တွင် EPYC 8434P တပ်ဆင်ထားပြီး cores ၄၈ ခုနှင့် thread ၉၆ ခု ပေးဆောင်ပါသည်။ 200W TDP ဖြင့် ၎င်းသည် ထိရောက်မှုနှင့် တွက်ချက်မှုစွမ်းအားအကြား ခိုင်မာသောဟန်ချက်ညီမှုကို ဖြစ်ပေါ်စေပြီး အလွန်အမင်း workloads များအတွက် အသင့်တော်ဆုံးဖြစ်စေပါသည်။ processor သည် PCIe 5.0 ၏ 96 lanes ကို ပံ့ပိုးပေးပြီး DDR5 memory channel ခြောက်ခုကို ပေးဆောင်သောကြောင့် memory bandwidth အလွန်ကောင်းမွန်သော 4800 MT/s အထိ မြန်နှုန်းကို ပေးစွမ်းနိုင်ပါသည်။ Axle AI အတွက် အနည်းဆုံးလိုအပ်ချက်များ တွင် အနည်းဆုံး CPU cores ၁၆ ခုနှင့် RAM 32GB လိုအပ်သော်လည်း ကျွန်ုပ်တို့၏ configuration သည် cores ၄၈ ခုနှင့် DDR5 memory 256GB ဖြင့် ဤလိုအပ်ချက်များကို အဆင်ပြေစွာ ကျော်လွန်ပါသည်။
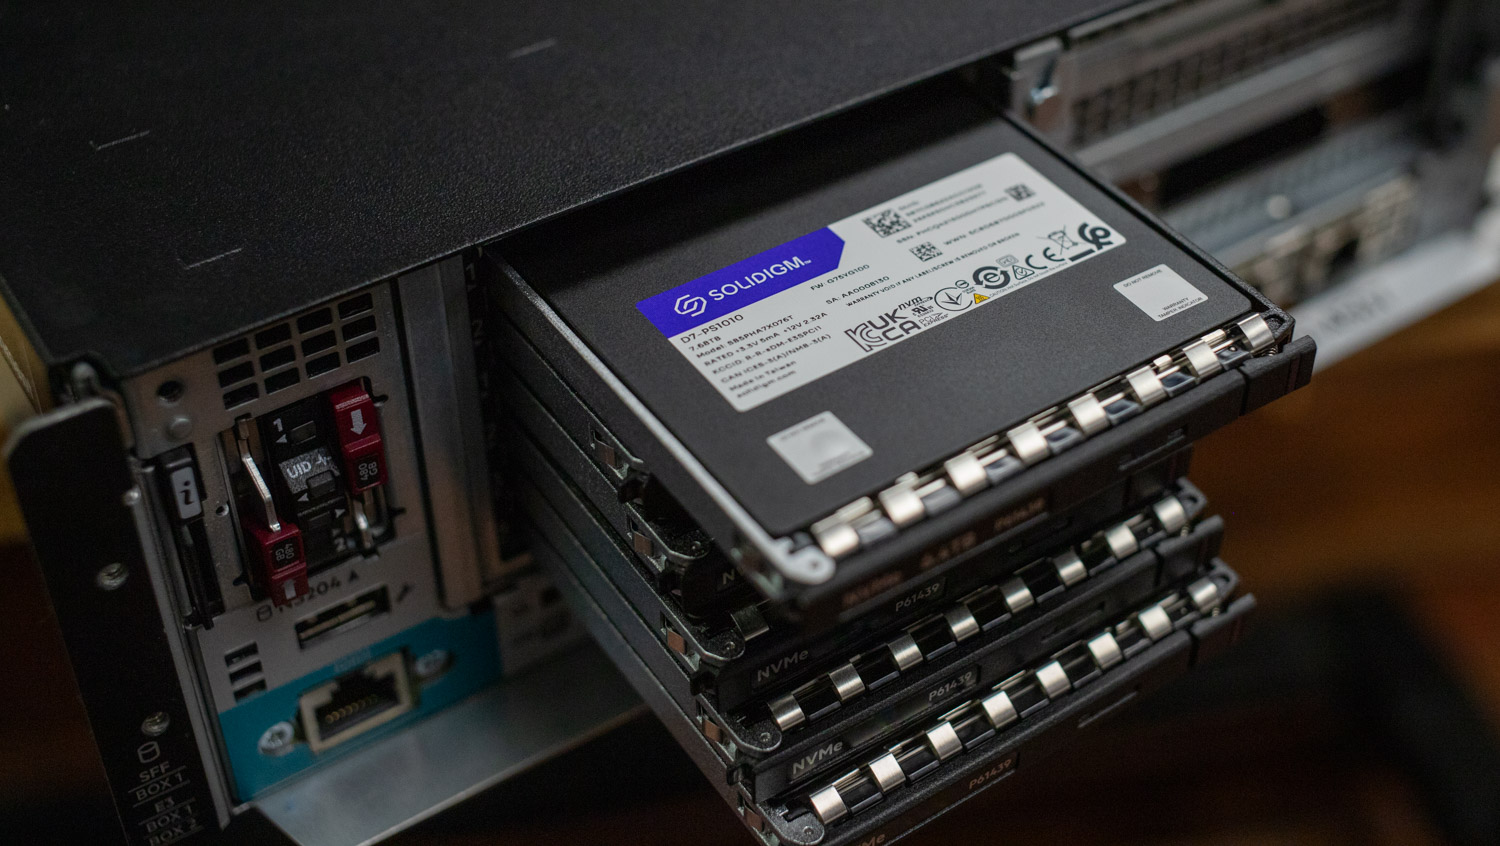
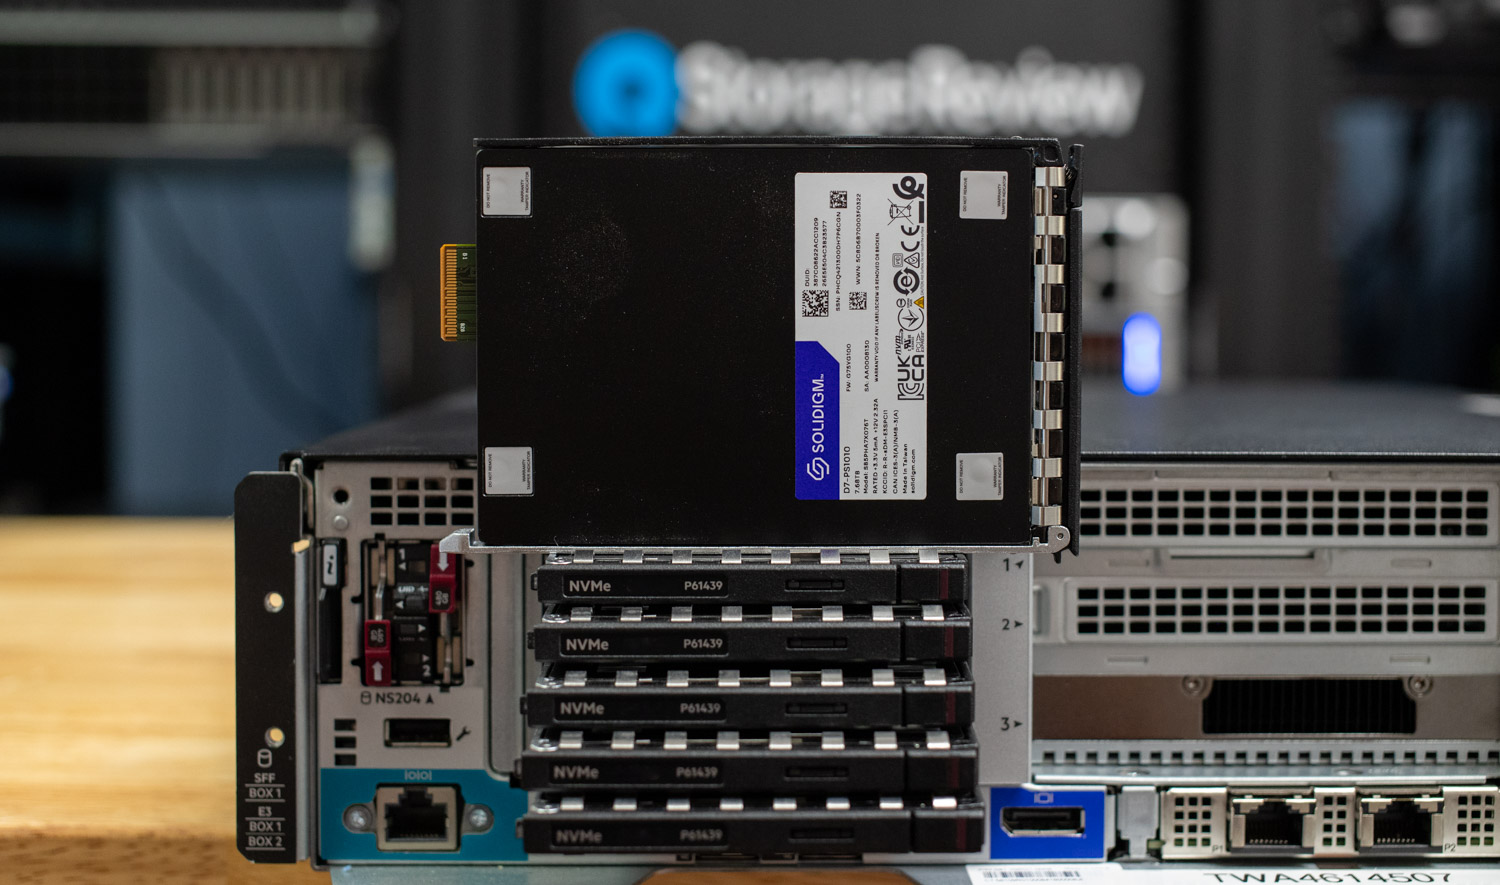
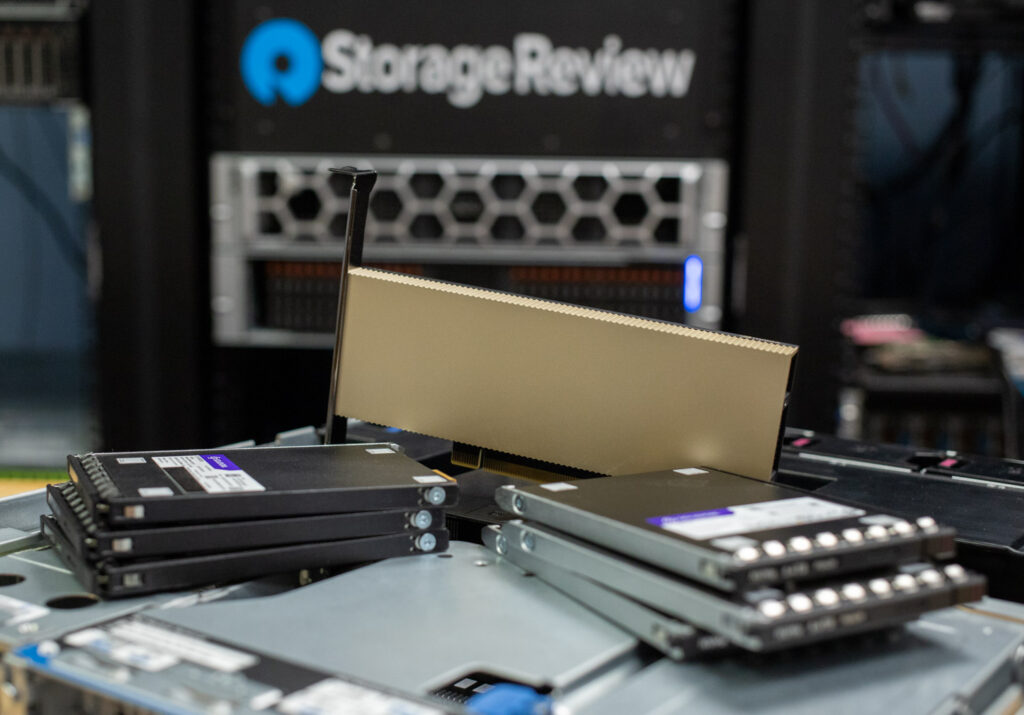
မီဒီယာပိုက်လိုင်းတိုင်းတွင် သိုလှောင်မှုစွမ်းဆောင်ရည်သည် အလွန်အရေးကြီးပြီး DL145 သည် ဤလိုအပ်ချက်များကို ဖြည့်ဆည်းရန်အတွက် EDSFF E3.S NVMe ဒရိုက်ခြောက်ခုအထိ ပံ့ပိုးပေးပါသည်။ ကျွန်ုပ်တို့၏ ဖွဲ့စည်းပုံတွင်၊ ကျွန်ုပ်တို့သည် Solidigm D7-PS1010 E3.S SSD ခြောက်ခုကို အသုံးပြုခဲ့ပြီး တစ်ခုစီတွင် 7.68 TB စွမ်းရည်ရှိသည်။ ဤ PCIe 5.0 x4 ဒရိုက်များသည် 14,500 MB/s read နှင့် 10,000 MB/s write speeds အထိ ပေးစွမ်းနိုင်ပြီး မြန်နှုန်းမြင့်သိုလှောင်မှု 46 TB နီးပါးအတွက် ပေါင်းစပ်ထားသည်။ AI နှင့် မီဒီယာလုပ်ငန်းစဉ်များအတွက် ဒီဇိုင်းထုတ်ထားသော ဤ SSD များသည် အထင်ကြီးလောက်သော စွမ်းအင်ထိရောက်မှုကို ပေးစွမ်းပြီး ရိုးရာ NVMe ဒရိုက်များနှင့် နှိုင်းယှဉ်ပါက သတ်မှတ်ထားသော ပိုက်လိုင်းအဆင့်များတွင် 50% ပိုမိုမြင့်မားသော throughput ကို ပေးစွမ်းနိုင်သည်။ အပိုစွမ်းရည် လိုအပ်သော အဖွဲ့များအတွက်၊ ဤ setup သည် ဒရိုက်တစ်ခုလျှင် 15.36 TB အထိ တိုးချဲ့နိုင်ပြီး ကျစ်လစ်သောပုံစံဖြင့် မြန်ဆန်ပြီး သိပ်သည်းသောသိုလှောင်မှု 92 TB ကို ပေးစွမ်းနိုင်သည်။
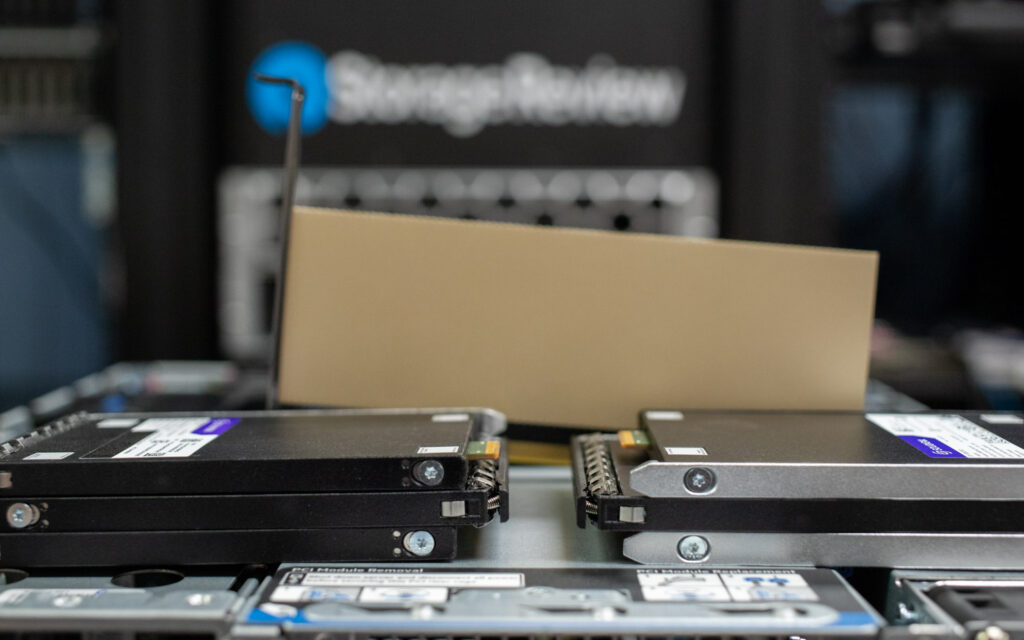
DL145 သည် single-slot GPU သုံးခုအထိ ပံ့ပိုးပေးပြီး ကျွန်ုပ်တို့၏ configuration တွင် Ada Lovelace architecture ပေါ်တွင်တည်ဆောက်ထားသော power-efficient accelerator တစ်ခုဖြစ်သည့် NVIDIA L4 တစ်ခုတည်းကို အသုံးပြုထားပါသည်။ video processing၊ AI inference၊ visual computing နှင့် virtualization workloads များအတွက် ဒီဇိုင်းထုတ်ထားသော L4 သည် 72 watts သာသုံးစွဲသော်လည်း ကောင်းမွန်သောစွမ်းဆောင်ရည်ကို ပေးစွမ်းသည်။ ၎င်းတွင် 24 GB GDDR6 VRAM ပါဝင်ပြီး power နှင့် data နှစ်မျိုးလုံးအတွက် PCIe 4.0 x16 interface မှတစ်ဆင့် ချိတ်ဆက်ထားသည်။ Axle AI သည် အနည်းဆုံး 16 GB VRAM ကို အကြံပြုထားပြီး L4 သည် 8 GB ထပ်မံပါဝင်သောကြောင့် resolution မြင့်မားသော media tasks များနှင့် AI-driven operations များအတွက် နေရာလွတ်ရရှိစေပါသည်။
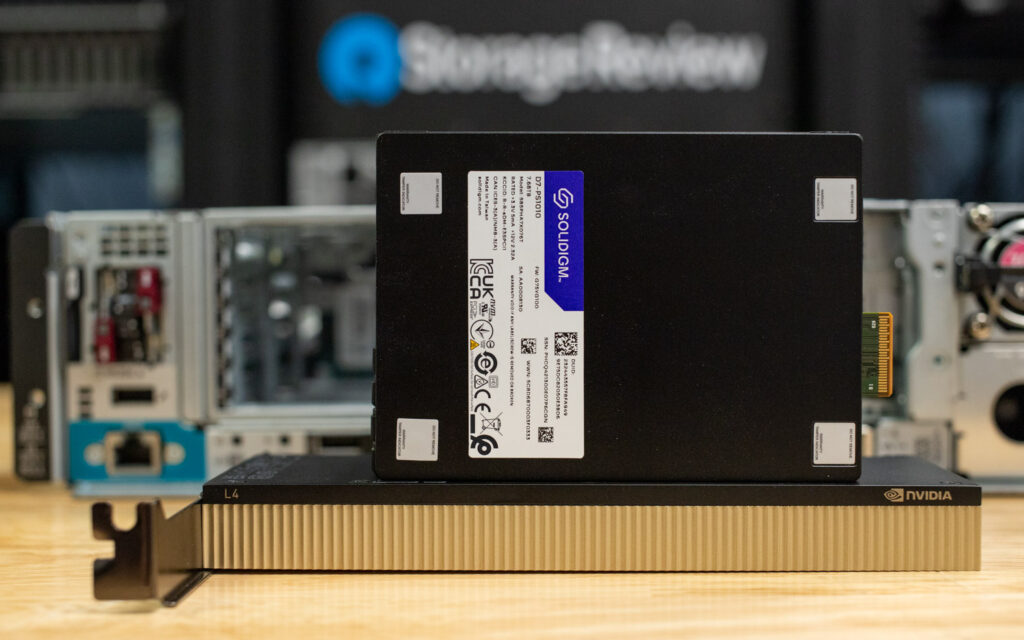
Nvidia L4 single-slot GPU
application layer အတွက်၊ Proxmox Virtual Environment (8.3.5) ကို အသုံးပြု၍ Axle AI MAM နှင့် Axle AI Tags များကို ဖြန့်ကျက်ခဲ့ပါသည်။ စနစ်ကို dedicated virtual machine နှစ်ခုဖြင့် configure လုပ်ထားသည်- တစ်ခုမှာ Axle AI MAM ကို run ပြီး နောက်တစ်ခုမှာ Axle AI Tags ကို run ထားသည်။ ဤဖွဲ့စည်းပုံသည် media management နှင့် AI-powered metadata processing အကြား ရှင်းလင်းသော ခွဲခြားမှုကို ပေးစွမ်းပြီး components များအကြား ချောမွေ့စွာ ဆက်သွယ်နိုင်စေပါသည်။
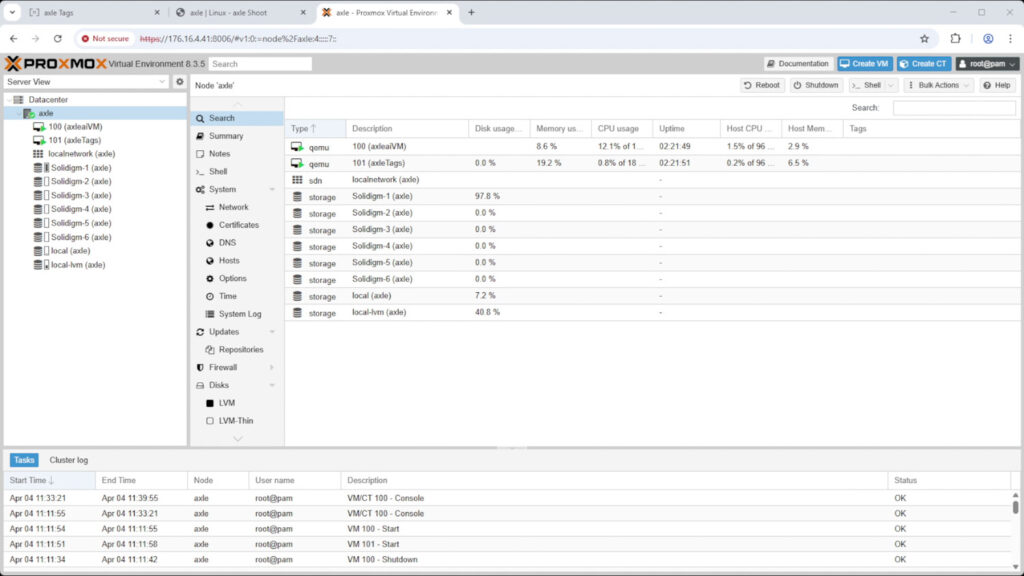
Proxmox ပတ်ဝန်းကျင်နှင့် ဟာ့ဒ်ဝဲ အကျဉ်းချုပ်
MAM နှင့်အတူ လည်ပတ်နေသော Axle AI Tags သည် semantic vector search၊ object နှင့် logo recognition နှင့် လေ့ကျင့်နိုင်သော face detection အပါအဝင် on-premise AI စွမ်းရည်များကို ယူဆောင်လာပါသည်။ ၎င်းကို Docker container တွင် ဖြန့်ကျက်ထားပြီး PCIe pass-through မှတစ်ဆင့် NVIDIA L4 GPU ကို ထိရောက်စွာ အချိန်နှင့်တပြေးညီ တွက်ချက်မှုအတွက် အသုံးချသည်။ browser-based training နှင့် admin interface သည် ပြောင်းလွယ်ပြင်လွယ် tuning ကို ခွင့်ပြုပြီး ၎င်း၏ modular design သည် Intel/NVIDIA သို့မဟုတ် AMD/NVIDIA hardware configuration များကို ပံ့ပိုးပေးသည်။ ကျွန်ုပ်တို့၏ setup တွင် MAM နှင့် အပြည့်အဝပေါင်းစပ်ထားသော်လည်း Axle AI Tags သည် အခြား platform များနှင့် အသုံးပြုရန် REST API compatibility ကိုလည်း ပေးဆောင်ပါသည်။
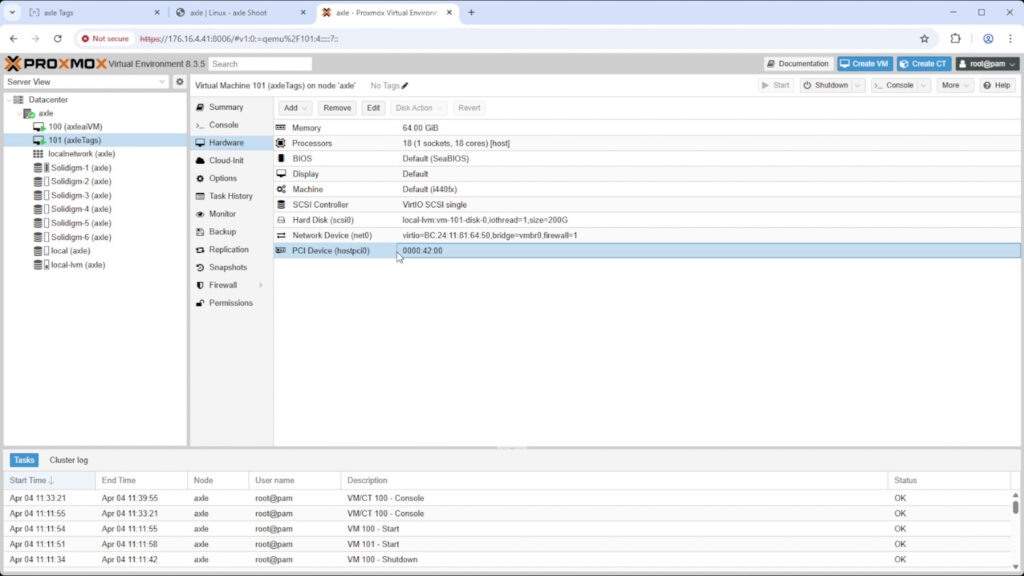
Axle AI Tags ၏ hardware configure သည် virtual machine ဖြစ်သည်။
Solidigm PS1010 drives များကို Axle AI MAM virtual machine တွင် တပ်ဆင်ထားပြီး မြန်နှုန်းမြင့်ပြီး latency နည်းပါးသော footage များကို ဝင်ရောက်ကြည့်ရှုနိုင်စေပါသည်။ stack တစ်ခုလုံးကို virtualize လုပ်ခြင်းနှင့် compute resources တစ်ခုချင်းစီကို dedicated ပြုလုပ်ခြင်းဖြင့် ဤ setup သည် workstation တစ်ခုတည်းက ပေးစွမ်းနိုင်သည်ထက် များစွာသာလွန်သော uptime၊ ပိုမိုကောင်းမွန်သော resource management နှင့် multi-user support တို့ကို ပေးဆောင်ပါသည်။ ၎င်းသည် ပူးပေါင်းဆောင်ရွက်မှု၊ ပမာဏများများ ထုတ်လုပ်သည့်ပတ်ဝန်းကျင်အတွက် အသင့်တော်ဆုံးဖြစ်စေပါသည်။
ဤအစိတ်အပိုင်းများ ပေါင်းစပ်လိုက်သောအခါ၊ မြန်ဆန်သော၊ ဒေသတွင်း၊ AI စွမ်းအင်သုံး မီဒီယာလုပ်ငန်းစဉ်များကို လုပ်ဆောင်နိုင်စေမည့် တင်းကျပ်စွာပေါင်းစပ်ထားသော ဟာ့ဒ်ဝဲဖြေရှင်းချက်တစ်ခုကို ဖွဲ့စည်းပေးသည်။ ၎င်းသည် နေရာနှင့် ပါဝါအကန့်အသတ်ရှိသော်လည်း AI လုပ်ဆောင်မှုမှာ မရှိမဖြစ်လိုအပ်သည့် ယုံကြည်စိတ်ချရသော စွမ်းဆောင်ရည်ကို လိုအပ်သည့် ဝေးလံခေါင်သီသောအဖွဲ့များအတွက် ထိရောက်ပြီး လက်တွေ့အသုံးပြုရန် အသင့်ဖြစ်သော ပလက်ဖောင်းတစ်ခုဖြစ်သည်။
HPE ProLiant DL145 Gen11 စွမ်းဆောင်ရည်
benchmarking အကြောင်းမပြောခင်၊ အောက်ဖော်ပြပါဇယားတွင် HPE ProLiant DL145 Gen11 ၏ system configuration ကိုဖော်ပြထားပါသည်။ Proxmox ကို run သည့် virtualized installation တွင် Axle AI ဖြင့်စမ်းသပ်နေစဉ်၊ ကျွန်ုပ်တို့၏ GDSIO နှင့် FIO စမ်းသပ်မှုများတွင် storage performance ကိုတိုင်းတာရန် system ကို Ubuntu Server 22.04.5 သို့ပြောင်းရွှေ့ခဲ့သည်။
| HPE ProLiant DL145 Gen 11 | ဟာ့ဒ်ဝဲခြုံငုံသုံးသပ်ချက် |
|---|---|
| စီပီယူ | AMD EPYC 8434P တစ်ခုတည်း |
| ရမ် | 256GB ECC DDR5 |
| သိုလှောင်ခြင်း | ၆x Solidigm D7-PS1010 E3s SSD 7.68tb |
| ဘွတ်တင်သိုလှောင်မှု | NS204 port 2x ကို ထည့်သွင်းထားသည် (480GB Samsung PM9A3 M.2) |
| GPU ကို | NVIDIA L4 တစ်ခုတည်း |
| ကွန်ပျူတာစက်လည်ပတ်ရေးစနစ်ပရိုဂရမ် | Ubuntu ဆာဗာ ၂၂.၀၄.၅ |
အမြင့်ဆုံး ဓာတုဗေဒဆိုင်ရာ စွမ်းဆောင်ရည်
FIO စမ်းသပ်မှုသည် SSD နှင့် HDD များအပါအဝင် သိုလှောင်မှုကိရိယာများ၏ စွမ်းဆောင်ရည်ကို တိုင်းတာရန်အသုံးပြုသည့် ပြောင်းလွယ်ပြင်လွယ်ရှိပြီး အစွမ်းထက်သော benchmarking tool တစ်ခုဖြစ်သည်။ ၎င်းသည် bandwidth၊ IOPS (Input/Output Operations Per Second) နှင့် sequential နှင့် random read/write operations ကဲ့သို့သော workloads အမျိုးမျိုးအောက်တွင် latency ကဲ့သို့သော metrics များကို အကဲဖြတ်သည်။ ဤစမ်းသပ်မှုကို အမြင့်ဆုံးစွမ်းဆောင်ရည်ကိုဖမ်းယူရန်နှင့် workloads အများအပြားတွင် storage system ကို stress ပေးရန် ဒီဇိုင်းထုတ်ထားပြီး မတူညီသော devices များ သို့မဟုတ် configurations များကို နှိုင်းယှဉ်ရန်အတွက် အထူးအသုံးဝင်စေသည်။ ဤကိစ္စတွင်၊ drives များ၏ စွမ်းရည်တစ်ခုလုံးကို ၎င်းတို့၏ ရေရှည်စွမ်းဆောင်ရည်လက္ခဏာများ၏ ပြည့်စုံသောအမြင်ကို ပေးစွမ်းနိုင်ရန် full-surface test ကို လုပ်ဆောင်ခဲ့သည်။
128K blocks များကို အသုံးပြု၍ sequential read test တွင် စနစ်သည် 56.4 GB/s bandwidth ကို ပေးပို့ခဲ့ပြီး ပျမ်းမျှ latency 1.78 milliseconds ဖြင့် 430,000 IOPS ကို ထိန်းသိမ်းထားနိုင်ခဲ့သည်။ block အရွယ်အစားတူတွင် sequential write performance သည် 45.4 GB/s အထိ ရောက်ရှိခဲ့ပြီး 346,000 IOPS နှင့် ပျမ်းမျှ latency 2.22 milliseconds ကို ထုတ်လုပ်ခဲ့သည်။ 4K blocks များကို အသုံးပြု၍ random read operations များအတွက် စနစ်သည် 11.4 million IOPS နှင့် ပျမ်းမျှ latency 0.269 milliseconds ဖြင့် 46.6 GB/s အထိ ရောက်ရှိခဲ့ပြီး intensive access patterns များအောက်တွင် NVMe storage array ၏ high-throughput potential ကို မီးမောင်းထိုးပြခဲ့သည်။ 4K တွင် random write operations များသည် 29.1 GB/s အထိ ရောက်ရှိခဲ့ပြီး 7.1 million IOPS နှင့် ပျမ်းမျှ latency 0.432 milliseconds အထိ ရောက်ရှိခဲ့ပြီး fragmented access အောက်တွင်ပင် ခိုင်မာသော sustained write capability ကို အတည်ပြုခဲ့သည်။
| HPE DL145 Gen 11 FIO Benchmark အကျဉ်းချုပ် | bandwidth – GB/s | IOPS | Avg Latency |
|---|---|---|---|
| အစဉ်လိုက်ဖတ်ရှုခြင်း (128K) | 56.4 GB ကို / s နဲ့ | 430k | 1.78 ms |
| အစဉ်လိုက်ရေးသားခြင်း (128K) | 45.4 GB ကို / s နဲ့ | 346k | 2.22 ms |
| ကျပန်းဖတ်ရှုခြင်း (4KB) | 46.6 GB ကို / s နဲ့ | 11.4M | 0.269 ms |
| ကျပန်းရေးသားခြင်း (4K) | 29.1 GB ကို / s နဲ့ | 7.1M | 0.432 ms |
GPU တိုက်ရိုက်သိုလှောင်မှု
ဤ testbench တွင် ကျွန်ုပ်တို့ပြုလုပ်ခဲ့သော စမ်းသပ်မှုများထဲမှတစ်ခုမှာ Magnum IO GPU Direct Storage (GDS) စမ်းသပ်မှုဖြစ်သည်။ GDS သည် NVIDIA မှ တီထွင်ထားသော အင်္ဂါရပ်တစ်ခုဖြစ်ပြီး NVMe drives များ သို့မဟုတ် အခြားမြန်နှုန်းမြင့် storage devices များတွင် သိမ်းဆည်းထားသော အချက်အလက်များကို ဝင်ရောက်ကြည့်ရှုသည့်အခါ GPU များသည် CPU ကိုကျော်ဖြတ်နိုင်စေပါသည်။ CPU နှင့် system memory မှတစ်ဆင့် data များကို routing လုပ်မည့်အစား GDS သည် GPU နှင့် storage device အကြား တိုက်ရိုက်ဆက်သွယ်မှုကို ဖွင့်ပေးပြီး latency ကို သိသိသာသာလျှော့ချပေးပြီး data throughput ကို တိုးတက်ကောင်းမွန်စေပါသည်။
GPU Direct Storage ဘယ်လိုအလုပ်လုပ်လဲ
ရိုးရာအစဉ်အလာအရ GPU တစ်ခုက NVMe drive မှာသိမ်းဆည်းထားတဲ့ဒေတာတွေကို စီမံဆောင်ရွက်တဲ့အခါ ဒေတာဟာ GPU ဆီကိုမရောက်ခင် CPU နဲ့ system memory ကနေတစ်ဆင့် ဦးစွာဖြတ်သန်းသွားရပါမယ်။ ဒီလုပ်ငန်းစဉ်က CPU ဟာ ကြားခံတစ်ခုဖြစ်လာတာကြောင့် နှောင့်နှေးမှုကို တိုးစေပြီး အဖိုးတန် system resource တွေကို သုံးစွဲတာကြောင့် ပိတ်ဆို့မှုတွေကို ဖြစ်ပေါ်စေပါလိမ့်မယ်။ GPU Direct Storage က GPU ကို PCIe bus မှတစ်ဆင့် storage device ကနေ တိုက်ရိုက်ဒေတာတွေကို ရယူနိုင်အောင် လုပ်ပေးခြင်းအားဖြင့် ဒီထိရောက်မှုမရှိခြင်းကို ဖယ်ရှားပေးပါတယ်။ ဒီတိုက်ရိုက်လမ်းကြောင်းက ဒေတာရွှေ့ပြောင်းမှုနဲ့ဆက်စပ်တဲ့ overhead ကို လျော့ကျစေပြီး ဒေတာလွှဲပြောင်းမှုတွေကို ပိုမိုမြန်ဆန်ထိရောက်စေပါတယ်။
AI workloads များ၊ အထူးသဖြင့် deep learning ပါဝင်သည့် workloads များသည် data များစွာအသုံးပြုရပါသည်။ ကြီးမားသော neural network များကို လေ့ကျင့်ပေးရန်အတွက် data terabytes များကို processing လုပ်ရန် လိုအပ်ပြီး data transfer နှောင့်နှေးမှုတစ်စုံတစ်ရာသည် GPU များကို အသုံးမချနိုင်ခြင်းနှင့် လေ့ကျင့်ချိန်ပိုကြာခြင်းတို့ ဖြစ်စေနိုင်ပါသည်။ GPU Direct Storage သည် data ကို GPU သို့ အမြန်ဆုံးပေးပို့ခြင်း၊ အားလပ်ချိန်ကို အနည်းဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းနှင့် တွက်ချက်မှုစွမ်းဆောင်ရည်ကို အမြင့်ဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းဖြင့် ဤစိန်ခေါ်မှုကို ဖြေရှင်းပေးပါသည်။
ထို့အပြင်၊ GDS သည် ဗီဒီယိုလုပ်ဆောင်ခြင်း၊ သဘာဝဘာသာစကားလုပ်ဆောင်ခြင်း သို့မဟုတ် အချိန်နှင့်တပြေးညီ ကောက်ချက်ချခြင်းကဲ့သို့သော ဒေတာအစုအဝေးကြီးများကို streaming လုပ်ခြင်းပါဝင်သည့် workloads များအတွက် အထူးအကျိုးရှိပါသည်။ CPU အပေါ် မှီခိုမှုကို လျှော့ချခြင်းဖြင့် GDS သည် ဒေတာရွှေ့ပြောင်းမှုကို အရှိန်မြှင့်ပေးပြီး အခြားအလုပ်များအတွက် CPU အရင်းအမြစ်များကို လွတ်လပ်စေပြီး စနစ်စွမ်းဆောင်ရည်ကို ပိုမိုမြှင့်တင်ပေးပါသည်။
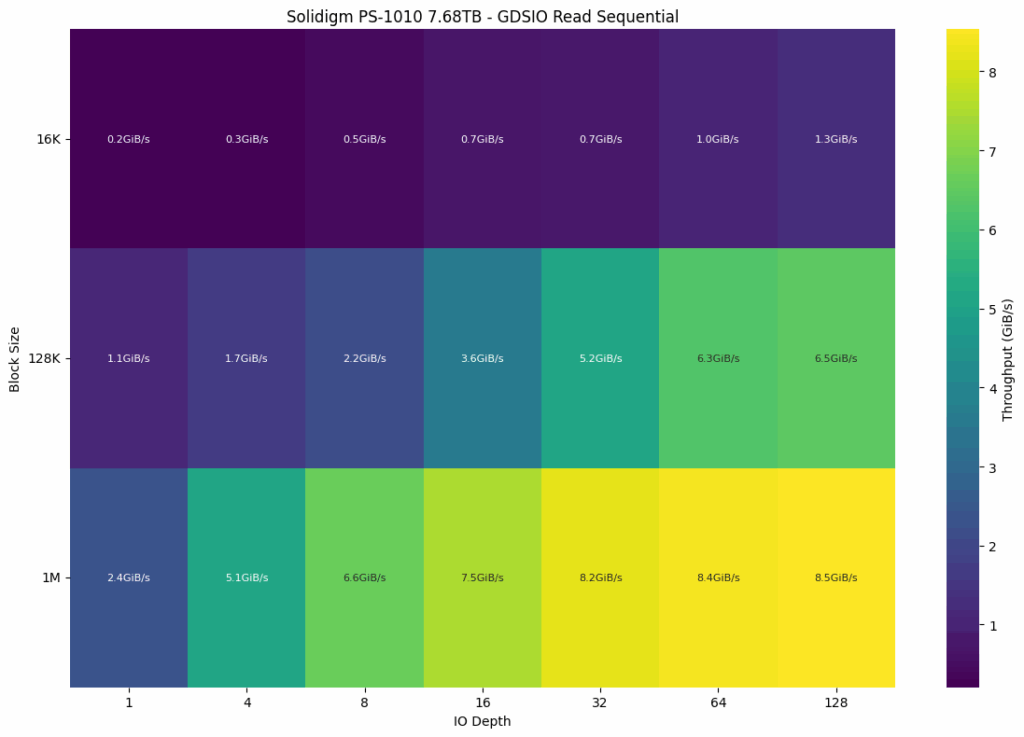
GDSIO ဖတ်ရှုခြင်း အစီအစဉ်
Solidigm PS1010 7.68TB drive ၏ GDSIO sequential read စမ်းသပ်မှုတွင် block အရွယ်အစားနှင့် I/O depth နှစ်မျိုးလုံးနှင့်အတူ စွမ်းဆောင်ရည်သည် သိသိသာသာ မြင့်တက်လာခဲ့သည်။ အသေးငယ်ဆုံး 16K block အရွယ်အစားတွင် throughput သည် 1 queue depth တွင် 0.2 GiB/s မှစတင်ခဲ့ပြီး 128 အနက်တွင် တဖြည်းဖြည်း 1.3 GiB/s အထိ မြင့်တက်လာခဲ့ပြီး ထို granularity တွင် scalability အကန့်အသတ်ရှိကြောင်း ပြသခဲ့သည်။ 128K blocks အထိ ရွေ့လျားသွားသောအခါ စွမ်းဆောင်ရည်သည် ပိုမိုသိသိသာသာ တိုးတက်လာခဲ့ပြီး 1.1 GiB/s မှစတင်ကာ အမြင့်ဆုံးအနက်တွင် 6.5 GiB/s အထိ မြင့်တက်လာခဲ့သည်။ အကောင်းဆုံးရလဒ်များကို 1M block အရွယ်အစားဖြင့် ရရှိခဲ့ပြီး throughput သည် ကနဦးတွင် 2.4 GiB/s အထိရောက်ရှိခဲ့ပြီး 128 queue depth တွင် 8.5 GiB/s တွင် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး drive ၏ အကောင်းဆုံးစွမ်းဆောင်ရည်ပရိုဖိုင်ကို sequential read ကြီးများနှင့် deep queues များဖြင့် ရရှိကြောင်း ညွှန်ပြသည်။
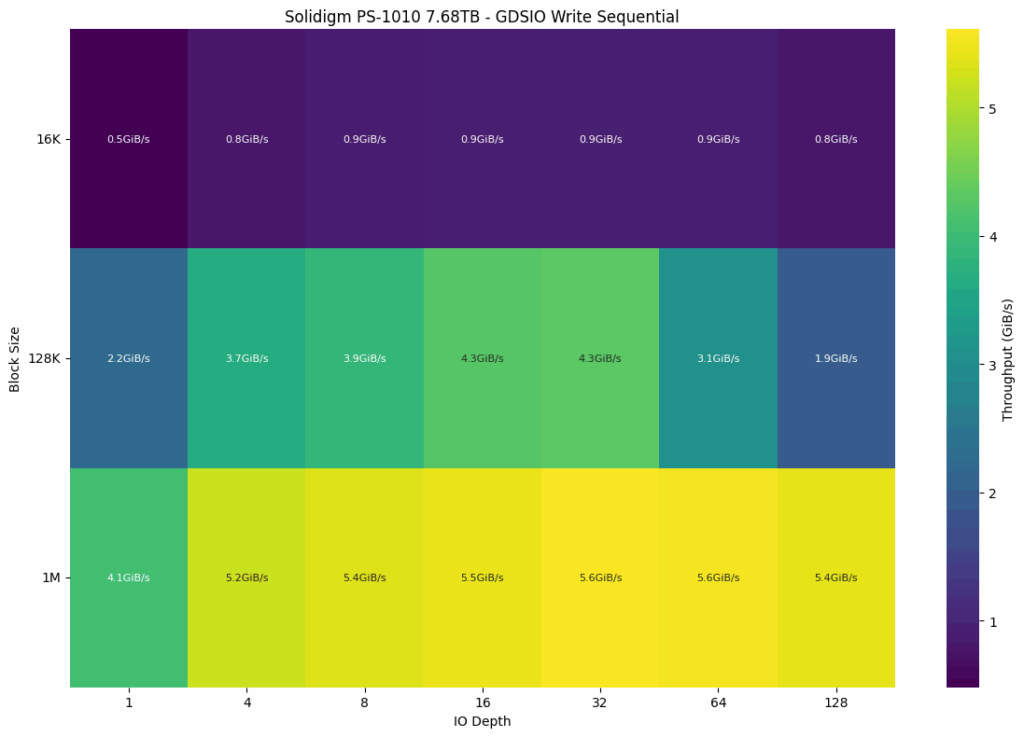
GDSIO ရေးရန် အစီအစဉ်တကျ
Solidigm PS1010 ရှိ အစဉ်လိုက်ရေးသားမှုစွမ်းဆောင်ရည်သည် block အရွယ်အစားကြီးများတွင် ခိုင်မာသော scalability ကိုပြသသော်လည်း အလတ်စား workloads များတွင် queue depths မြင့်မားသောအခါတွင် regression အချို့ပြသသည်။ အသေးဆုံး 16K block အရွယ်အစားတွင် write speeds သည် 0.5 GiB/s မှစတင်ခဲ့ပြီး queue depths 8 မှ 64 အထိ 0.9 GiB/s တွင် အတန်ငယ်အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး depth 128 တွင် 0.8 GiB/s အထိ အနည်းငယ်ကျဆင်းသွားခဲ့သည်။ 128K blocks များဖြင့် စွမ်းဆောင်ရည်သည် 2.2 GiB/s မှစတင်ခဲ့ပြီး depth 32 တွင် အမြင့်ဆုံး 4.3 GiB/s အထိ တိုးတက်ကောင်းမွန်လာပြီးနောက် အနက်ရှိုင်းဆုံး queue တွင် 1.9 GiB/s အထိ ကျဆင်းသွားခဲ့ပြီး write saturation သို့မဟုတ် throttling ဖြစ်နိုင်ခြေကို ညွှန်ပြနေသည်။ အကောင်းဆုံးတည်တံ့သောစွမ်းဆောင်ရည်ကို 1M block အရွယ်အစားများဖြင့် ရရှိခဲ့ပြီး depth 1 တွင် 4.1 GiB/s မှ depth 32 နှင့် 64 တွင် 5.6 GiB/s အထိ ရှင်းလင်းစွာ ချိန်ညှိခဲ့ပြီး 128 အထိ တည်ငြိမ်နေခဲ့သည်။
GDSIO အကျဉ်းချုပ်
ဤဇယားသည် Solidigm D7-PS1010 SSD တွင် စုဆောင်းထားသော latency နှင့် IOPS အတွက် GDSIO စွမ်းဆောင်ရည် မက်ထရစ်များကို IO အနက် 128 ဖြင့် 16K၊ 128K နှင့် 1M တို့တွင် တိုင်းတာထားသည်။ 128 queue အနက်တွင် latency နှင့် IOPS တို့သည် block အရွယ်အစားနှင့်အတူ ခန့်မှန်းခြေအားဖြင့် ချိန်ညှိသည်။ 16K block read သည် 82.3K IOPS ဖြင့် ပျမ်းမျှ 1.549ms ရှိပြီး write latency မှာ 52.6K IOPS ဖြင့် 2.429ms ဖြစ်သည်။ 128K blocks ဖြင့် read latency သည် 2.414ms (52.9K IOPS) အထိ မြင့်တက်လာပြီး write latency မှာ 8.050ms (15.9K IOPS) အထိ မြင့်တက်လာသည်။ 1M တွင် read latency သည် 8.7K IOPS ဖြင့် 14.643ms အထိ ရောက်ရှိခဲ့ပြီး write latency သည် 5.6K IOPS ဖြင့် 23.030ms အထိ မြင့်တက်လာခဲ့သည်။
| GDSIO ဇယား (၁၆K၊ ၁၂၈K၊ ၁M ဘလောက်အရွယ်အစား ပျမ်းမျှ) | HPE DL145 Gen 11 (6 x Solidigm D7-PS1010 E3s SSD 7.68TB) |
|---|---|
| (16K Block Size 128 IO Depth) ပျမ်းမျှဖတ်ရှုမှု | ၄.၁ GiB/s (၃၀.၇၈၂ms) IOPS: ၄.၂K |
| (16K Block Size 128 IO Depth) ပျမ်းမျှရေးသားမှု | ၀.၈GiB/s (၂.၄၂၉ms) IOPS: ၅၂.၆K |
| (128K Block Size 128 IO Depth) ပျမ်းမျှဖတ်ရှုမှု | ၄.၁ GiB/s (၃၀.၇၈၂ms) IOPS: ၄.၂K |
| (128K Block Size 128 IO Depth) ပျမ်းမျှရေးသားမှု | ၄.၁ GiB/s (၃၀.၇၈၂ms) IOPS: ၄.၂K |
| (၁M ဘလောက်အရွယ်အစား ၁၂၈ IO အနက်) ပျမ်းမျှဖတ်ရှုမှု | ၄.၁ GiB/s (၃၀.၇၈၂ms) IOPS: ၄.၂K |
| (၁M ဘလောက်အရွယ်အစား ၁၂၈ IO အနက်) ပျမ်းမျှရေးသားမှု | ၄.၁ GiB/s (၃၀.၇၈၂ms) IOPS: ၄.၂K |
အနားသတ်တွင် မီဒီယာထုတ်လုပ်မှု
Axle AI ဆိုတာ ဘာလဲ။
Axle AI သည် အသေးစားနှင့် အလတ်စား မီဒီယာအဖွဲ့များအတွက် ဗီဒီယိုလုပ်ငန်းစဉ်များကို ရိုးရှင်းစေသည့် on-prem AI ဖြင့် လုပ်ဆောင်သော မီဒီယာပိုင်ဆိုင်မှုစီမံခန့်ခွဲမှု (MAM) ပလပ်ဖောင်းတစ်ခုဖြစ်သည်။ ၎င်းသည် ရိုးရာ MAM စနစ်များ၏ ကုန်ကျစရိတ် သို့မဟုတ် ရှုပ်ထွေးမှုမရှိဘဲ ingest လုပ်ခြင်း၊ tagging လုပ်ခြင်းနှင့် မီဒီယာရှာဖွေခြင်းကဲ့သို့သော အဓိကအလုပ်များကို အလိုအလျောက်လုပ်ဆောင်ပေးသည်။ မြန်နှုန်းနှင့် အသုံးပြုရလွယ်ကူစေရန် ဒီဇိုင်းထုတ်ထားသော Axle AI သည် အဖွဲ့များအား ရုံးတွင်ရှိနေသည်ဖြစ်စေ၊ အဝေးမှအလုပ်လုပ်သည်ဖြစ်စေ အကြောင်းအရာများကို ပိုမိုထိရောက်စွာ စီမံခန့်ခွဲပြီး ပေးပို့နိုင်စေပါသည်။
ဒီပလက်ဖောင်းက ထုတ်လုပ်မှုလုပ်ငန်းစဉ်တစ်ခုလုံးကို ပံ့ပိုးပေးပါတယ်။ ဗီဒီယိုဖိုင်တွေကို အလိုအလျောက် စုပ်ယူပြီး proxy တွေ ဖန်တီးပေးကာ object recognition၊ face detection နဲ့ semantic search လိုမျိုး feature တွေကို အသုံးပြုပြီး AI-driven metadata တွေကို အသုံးပြုပြီး Adobe Premiere Pro နဲ့ DaVinci Resolve အပါအဝင် industry-standard editing tool တွေနဲ့ ပေါင်းစပ်ပေးပါတယ်။ ဒါကြောင့် အဖွဲ့တွေအနေနဲ့ အတားအဆီးတွေ ဒါမှမဟုတ် နှောင့်နှေးမှုတွေမရှိဘဲ အကြောင်းအရာတွေကို မြန်မြန်ဆန်ဆန် ရှာဖွေ၊ တည်းဖြတ်ပြီး ထုတ်ဝေနိုင်ပါတယ်။
အစစ်အမှန်ကမ္ဘာအသုံးပြုမှုကိစ္စများ
Axle AI ကို ထုတ်လွှင့်သူများ၊ မှတ်တမ်းရုပ်ရှင်ရိုက်ကူးသူများ၊ ကော်ပိုရိတ်ဗီဒီယိုဌာနများ၊ စျေးကွက်ရှာဖွေရေးအေဂျင်စီများနှင့် တိုက်ရိုက်ပွဲထုတ်လုပ်သူများ အပါအဝင် မီဒီယာအဖွဲ့အမျိုးမျိုးက ယုံကြည်ကြသည်။ ဤအဖွဲ့များသည် မကြာခဏ နေရာအများအပြားတွင် အလုပ်လုပ်လေ့ရှိပြီး လေးလံသောအခြေခံအဆောက်အအုံများ မလိုအပ်ဘဲ ၎င်းတို့၏ မီဒီယာစာကြည့်တိုက်များသို့ ယုံကြည်စိတ်ချရသော ဝင်ရောက်ခွင့် လိုအပ်ပါသည်။
Axle AI ဖြင့် အသုံးပြုသူများသည် proxy မီဒီယာကို ချက်ချင်းဝင်ရောက်ခွင့်ပေးသည့် browser-based interface မှတစ်ဆင့် အဝေးမှ ပူးပေါင်းဆောင်ရွက်နိုင်ပါသည်။ တည်းဖြတ်သူများသည် ၎င်းတို့နှစ်သက်ရာ non-linear editing systems (NLEs) တွင် ဗီဒီယိုများကို ချက်ချင်းဖြတ်တောက်နိုင်ပြီး ထုတ်လုပ်သူများနှင့် stakeholders များသည် clip များကို အချိန်နှင့်တပြေးညီ ပြန်လည်သုံးသပ်ခြင်း၊ tag လုပ်ခြင်း သို့မဟုတ် အတည်ပြုခြင်းတို့ကို ပြုလုပ်နိုင်ပါသည် (ဖိုင်များစွာလွှဲပြောင်းခြင်း သို့မဟုတ် အထူးပြုနည်းပညာကျွမ်းကျင်မှုများ မလိုအပ်ပါ)။
သင်ဟာ ငါးယောက်အဖွဲ့ဖြစ်စေ၊ ငါးဆယ်အဖွဲ့ဖြစ်စေ Axle AI ဟာ ပိုမိုမြန်ဆန်ပြီး ပိုမိုထိရောက်တဲ့ workflow တွေကို လုပ်ဆောင်ပေးနိုင်ပါတယ်။ ၎င်းရဲ့ ရိုးရှင်းတဲ့ interface၊ မြန်ဆန်တဲ့ deployment နဲ့ ရှိပြီးသား storage system တွေနဲ့ တွဲဖက်အသုံးပြုနိုင်မှုတို့က ပမာဏများများ ဖြန့်ဝေထားတဲ့ မီဒီယာထုတ်လုပ်မှုအတွက် စမတ်ကျတဲ့ ဖြေရှင်းချက်တစ်ခု ဖြစ်စေပါတယ်။
ချက်ချင်းလူမှုမီဒီယာအတွက် အလွန်အမင်းဝယ်လိုအားက မီဒီယာထုတ်လုပ်မှုအရှိန်အဟုန်ကို သိသိသာသာတိုးမြှင့်ပေးခဲ့ပါတယ်။ အထူးသဖြင့် တိုက်ရိုက်ပွဲများနှင့် ၎င်းတို့ပတ်လည်ရှိ အကြောင်းအရာဖန်တီးမှုနှင့်သက်ဆိုင်သည့်အခါတွင် ၎င်းသည် အလွန် "ပထမဆုံးမဟုတ်လျှင် နောက်ဆုံးဖြစ်သည်" ဟူသော အတွေးအခေါ်ဖြစ်သည်။ မီဒီယာကုမ္ပဏီများသည် များပြားလှသော ရုပ်သံမှတ်တမ်းများကို စီစဉ်ပြီး လျင်မြန်စွာ ပြန်လည်သုံးသပ်ရန် ထိရောက်သောနည်းလမ်းတစ်ခု လိုအပ်ပါသည်။ Axle AI ကဲ့သို့သောကိရိယာများသည် လုပ်ငန်းငယ်များအထိ လျှော့ချနိုင်စွမ်းရှိသောကြောင့် ဤလုပ်ငန်းစဉ်ကို လက်တွေ့အသုံးချနိုင်စေပါသည်။ proxy များနှင့် raw မှတ်တမ်းများကို တစ်ပြိုင်နက်မှတ်တမ်းတင်နိုင်သော ကင်မရာများကဲ့သို့သော သင့်လျော်သောလုပ်ငန်းစဉ်နှင့် တွဲဖက်လိုက်သောအခါ ထိရောက်မှုအတွက် အခွင့်အလမ်းများ တိုးလာပါသည်။
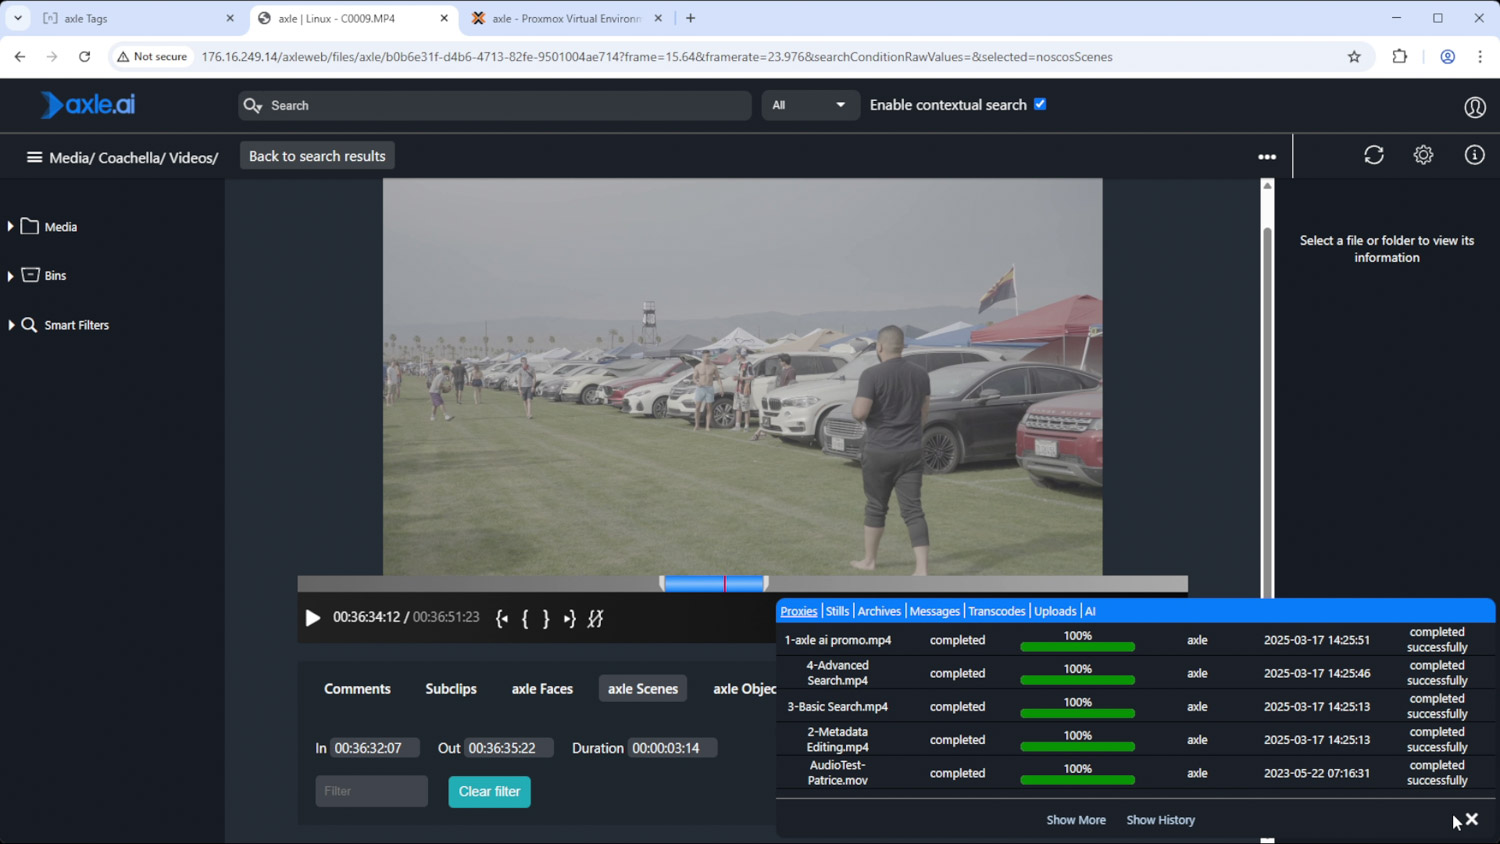
Axle AI Tags တွင် သေးငယ်သော proxy ဖိုင်များကို ချက်ချင်းဖမ်းယူပြီး လုပ်ဆောင်ခြင်းဖြင့် resolution မြင့်မားသောနှင့် resolution နိမ့်သော proxy media နှစ်မျိုးလုံးကို သိမ်းဆည်းခြင်းဖြင့် footage အားလုံးကို ချက်ချင်းရှာဖွေနိုင်ပါသည်။ Adobe Premiere Pro၊ DaVinci Resolve နှင့် Avid Media Composer ကဲ့သို့သော အဓိက NLE အများစုနှင့် Axle AI ၏ ပေါင်းစပ်မှုဖြင့် အယ်ဒီတာများသည် ချက်ချင်းအလုပ်လုပ်နိုင်ပါသည်။ ၎င်းသည် ထုတ်လုပ်ရေးအဖွဲ့၏ ပခုံးမှ ဝန်ထုပ်ဝန်ပိုးများစွာကို လျှော့ချပေးပြီး အခြားအလုပ်များကို အာရုံစိုက်နိုင်စေသည် သို့မဟုတ် ပင်ပန်းနွမ်းနယ်မှုကို ရှောင်ရှားနိုင်စေပါသည်။
ရိုးရာအစဉ်အလာအရ၊ မှတ်တမ်းတင်ခြင်းသည် မီဒီယာဖမ်းယူမှုလုပ်ငန်းစဉ်၏ အပင်ပန်းဆုံးနှင့် မကြာခဏကျော်သွားလေ့ရှိသော ရှုထောင့်များထဲမှ တစ်ခုဖြစ်သည်။ Axle AI သည် ရိုးရာ metadata field များအစား AI-generated scene descriptions များဖြင့် မီဒီယာကို အလိုအလျောက် မှတ်တမ်းတင်ပေးသောကြောင့် editor တစ်ဦးအနေဖြင့် clip တွင်ပါဝင်သည့်အရာများကို ဖတ်ရှုနိုင်မည်ဖြစ်သည်။ ၎င်းသည် semantic search tools များကိုလည်း ပံ့ပိုးပေးသောကြောင့် editor များနှင့် producers များအနေဖြင့် သတ်မှတ်ထားသော tag များကို အားကိုးမည့်အစား concept များနှင့် themes များကို အသုံးပြု၍ သက်ဆိုင်ရာ content များကို လျင်မြန်စွာ ရှာဖွေနိုင်မည်ဖြစ်သည်။
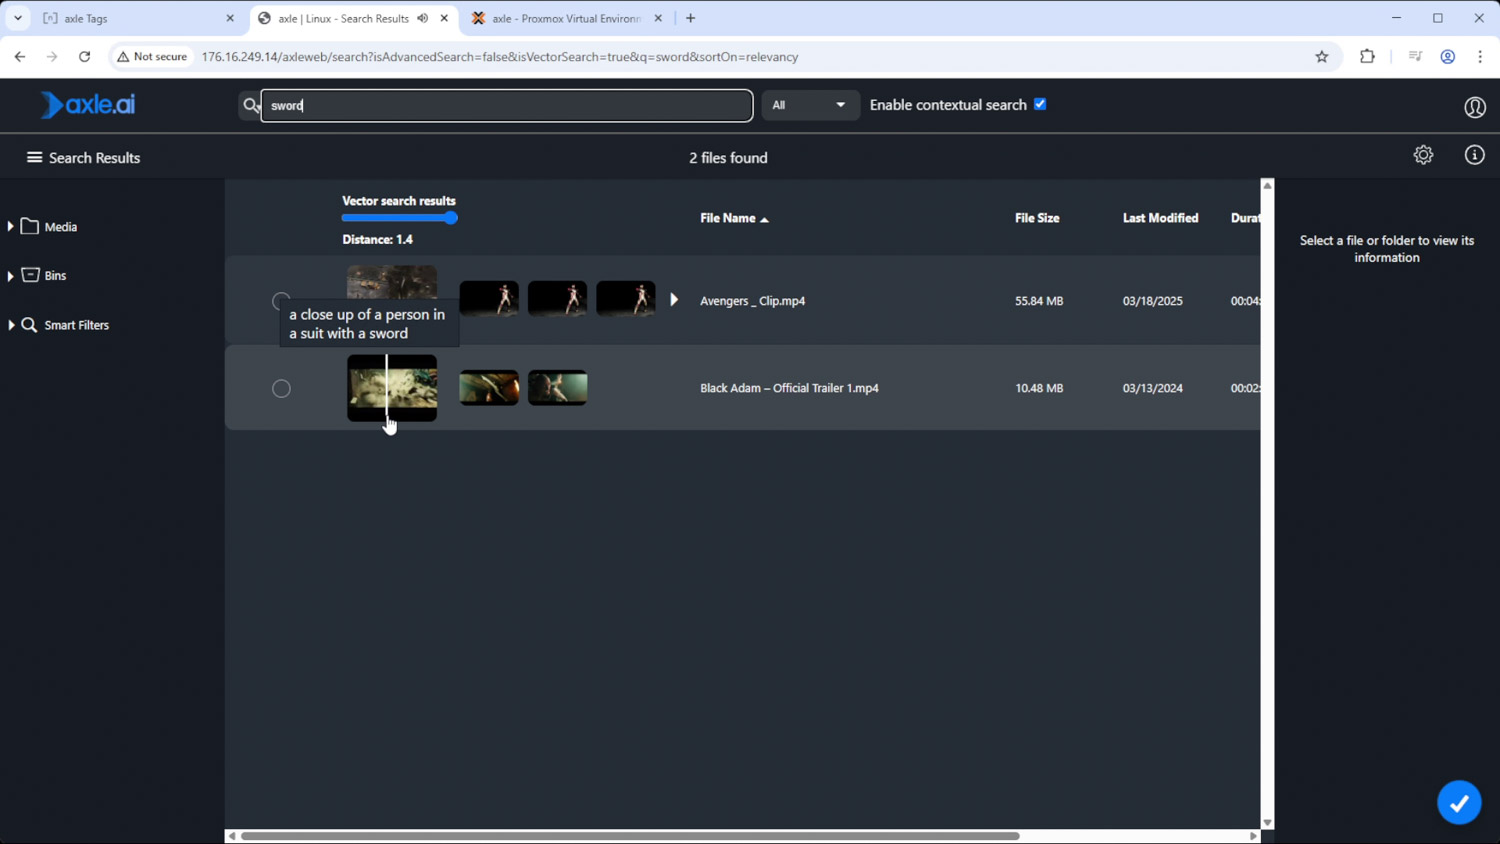
အလုပ်အားလုံးသည် မြန်ဆန်သော၊ လုပ်ငန်းခွင်တွင် မီဒီယာထုတ်လုပ်မှု မလိုအပ်သောကြောင့် တိုးချဲ့နိုင်မှုသည်လည်း အဓိကကျပါသည်။ Axle AI ကို မီဒီယာကုမ္ပဏီတစ်ခု၏ ကွန်ရက်မျှဝေမှုမှတစ်ဆင့် လက်ကျန်ဗီဒီယိုများကို ဝင်ရောက်ကြည့်ရှုနိုင်သည့် ပိုမိုအားကောင်းပြီး တည်ငြိမ်သောစနစ်တစ်ခုတွင် တည်ဆောက်နိုင်သည်။ ၎င်းသည် အယ်ဒီတာများနှင့် ထုတ်လုပ်သူများအား သက်ဆိုင်ရာမီဒီယာကို ပိုမိုမြန်ဆန်စွာ ရှာဖွေနိုင်စေသည် သို့မဟုတ် ယခင်က မစဉ်းစားဖူးသော မော်ကွန်းတိုက်များတွင် "ပျောက်ဆုံး" နေသော မီဒီယာကိုပင် ရှာဖွေတွေ့ရှိနိုင်စေပါသည်။ အကြောင်းအရာဖန်တီးသူများနှင့် ထုတ်လွှင့်သူများသည် ဤကဲ့သို့သော လက်ကျန်အညွှန်းကိန်းမှ သိသိသာသာ အကျိုးကျေးဇူးရရှိနိုင်ပြီး ဆာဗာတွင် အလုပ်မလုပ်သော မီဒီယာမှ တန်ဖိုးပိုမိုဖန်တီးပေးနိုင်ပါသည်။ မှားယွင်းခြင်းမရှိသော်လည်း မီဒီယာဖန်တီးမှုလုပ်ငန်းစဉ်၏ အချိန်ကုန်ဆုံးသော ရှုထောင့်အချို့တွင် မီဒီယာကုမ္ပဏီများအား ဦးဆောင်မှုပေးနိုင်ပါသည်။
HPE ProLiant DL145 Gen11 သည် ဤ edge AI ဖြန့်ကျက်မှုအတွက် hardware အခြေခံအုတ်မြစ်အဖြစ် ဆောင်ရွက်ပေးပြီး compute density၊ storage throughput နှင့် GPU acceleration တို့ကို ကျစ်လျစ်သော footprint တွင် အထင်ကြီးလောက်စရာ ဟန်ချက်ညီအောင် ပေးစွမ်းပါသည်။ စွမ်းအင်ချွေတာသော 8004 Series မှ 48-core AMD EPYC 8434P processor ဖြင့် စွမ်းအားပေးထားသော ဤစနစ်ကို multithreaded workloads များအတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားပြီး ပါဝါနည်းပါးသော envelope ကို ထိန်းသိမ်းထားသည်။ configuration တွင် 256GB RAM နှင့် NVIDIA L4 GPU တစ်ခုပါဝင်ပြီး edge တွင် AI inference အတွက် သင့်လျော်သော မြင့်မားသော ထိရောက်မှုရှိသော accelerator တစ်ခုဖြစ်သည်။ သိုလှောင်မှုကို Solidigm D7-PS1010 E3.S SSD ခြောက်လုံးဖြင့် ပံ့ပိုးပေးထားပြီး တစ်ခုစီတွင် 7.68TB စွမ်းရည်ရှိပြီး မီဒီယာပိုင်ဆိုင်မှုများနှင့် metadata-intensive workloads များအတွက် လုံလောက်သော မြင့်မားသောစွမ်းဆောင်ရည် flash storage ကို ပေးစွမ်းသည်။ single-wide GPU သုံးခုအထိနှင့် E3.S drives စုစုပေါင်းခြောက်ခုအတွက် ပံ့ပိုးမှုဖြင့် DL145 Gen11 သည် တောင်းဆိုမှုများသော ဗီဒီယိုနှင့် AI အသုံးပြုမှုကိစ္စရပ်များကို တိုးချဲ့ရန် ကောင်းစွာနေရာယူထားသည်။ Axle AI မှ စွမ်းအားပေးသည့် edge-focused AI workflows များအတွက် ထူးကဲသောစွမ်းဆောင်ရည်ကို ရရှိစေရန်အတွက် CPU၊ GPU နှင့် SSD များအပါအဝင် ခေတ်မီ hardware အစိတ်အပိုင်းများကို ဂရုတစိုက်တပ်ဆင်ခြင်း၏ အရေးပါမှုကို ဤ setup က အလေးပေးဖော်ပြသည်။
ကောက်ချက်
Axle AI သည် ဗီဒီယိုအကြောင်းအရာ ထုတ်လုပ်ပုံကို ပြောင်းလဲစေနေပြီး အထူးသဖြင့် အရင်းအမြစ်အကန့်အသတ်ဖြင့် အချိန်နှင့်တပြေးညီ လုပ်ဆောင်နေသော အဖွဲ့များအတွက်ဖြစ်သည်။ ဉာဏ်ရည်ထက်မြက်သော မီဒီယာပိုင်ဆိုင်မှုစီမံခန့်ခွဲမှုကို အစွမ်းထက်သော ကောက်ချက်ချကိရိယာများနှင့် ပေါင်းစပ်ခြင်းဖြင့် Axle AI သည် ရိုးရာ MAM စနစ်များ မယှဉ်နိုင်သော အလိုအလျောက်လုပ်ဆောင်မှုနှင့် တုံ့ပြန်မှုအဆင့်ကို ဖြစ်စေသည်။ HPE ProLiant DL145 Gen11 edge server၊ NVIDIA L4 GPU နှင့် Solidigm Gen5 SSD များနှင့် တွဲဖက်လိုက်သောအခါ၊ ကျွန်ုပ်တို့တည်ဆောက်ထားသော rig သည် ခေတ်မီမီဒီယာလုပ်ငန်းစဉ်များအတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသော ကျစ်လစ်ပြီး မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော ပတ်ဝန်းကျင်ကို ပေးစွမ်းသည်။ လယ်ကွင်းတွင်ဖြစ်စေ၊ hybrid editing pipeline ၏ တစ်စိတ်တစ်ပိုင်းအဖြစ်ဖြစ်စေ ဤ configuration သည် အရည်အသွေး သို့မဟုတ် ထိန်းချုပ်မှုတို့ကို မထိခိုက်စေဘဲ ဗီဒီယိုအကြောင်းအရာကို ယခင်ကထက် ပိုမိုမြန်ဆန်စွာ ingest လုပ်ရန်၊ tag လုပ်ရန်၊ ရှာဖွေရန်နှင့် ပေးပို့ရန် တိုးချဲ့နိုင်ပြီး ထိရောက်သောနည်းလမ်းကို ပေးစွမ်းသည်။ မြန်ဆန်သော အကြောင်းအရာရှုခင်းတွင် ဦးဆောင်နေရန် တာဝန်ပေးအပ်ထားသော အဖွဲ့များအတွက်၊ edge infrastructure နှင့် AI-assisted workflows ပေါင်းစပ်မှုသည် သိသာထင်ရှားသော ယှဉ်ပြိုင်နိုင်စွမ်းအားသာချက်ကို ပေးစွမ်းသည်။



 အမေဇုံ