

Supermicro ရဲ့ JumpStart ပရိုဂရမ်ဟာ AI အခြေခံအဆောက်အအုံအတွက် ဝယ်ယူမှုမတိုင်မီ အကဲဖြတ်ကိရိယာတန်ဆာပလာတွေမှာ အသုံးဝင်ဆုံးကိရိယာတွေထဲက တစ်ခုအဖြစ် ထင်ရှားလာခဲ့ပါတယ်။ မျှဝေအသုံးပြုတဲ့ပတ်ဝန်းကျင်မှာ scripted demo အစား JumpStart ဟာ အရည်အချင်းပြည့်မီတဲ့အသုံးပြုသူတွေကို SSH၊ IPMI နဲ့ VNC မှတစ်ဆင့် စစ်မှန်တဲ့ထုတ်လုပ်မှုဆာဗာတွေကို အခမဲ့၊ အချိန်အကန့်အသတ်နဲ့ bare-metal access ပေးစွမ်းပြီး တကယ့် hardware ပေါ်မှာ workloads တွေကို လုပ်ဆောင်နိုင်စေပါတယ်။ ပြီးခဲ့တဲ့ နိုဝင်ဘာလက NVIDIA HGX B200 ပါတဲ့ X14 စနစ်ကို အသုံးပြုပြီး ပရိုဂရမ်ကို ကျွန်ုပ်တို့ အသေးစိတ်လေ့လာ ခဲ့ပြီး တစ်ပတ်ကြာ အာရုံစိုက်ထားတဲ့ access က ဘာတွေပြောပြနိုင်လဲ၊ ဘာတွေမပြောနိုင်လဲဆိုတာကို ရှင်းရှင်းလင်းလင်း သိရှိခဲ့ရပါတယ်။ ဒီတစ်ခါမှာတော့ Supermicro ဟာ အလွန်ကွဲပြားတဲ့ accelerator ဇာတ်လမ်းနဲ့ H14 8U စနစ်ကို access ပေးခဲ့ပါတယ်။
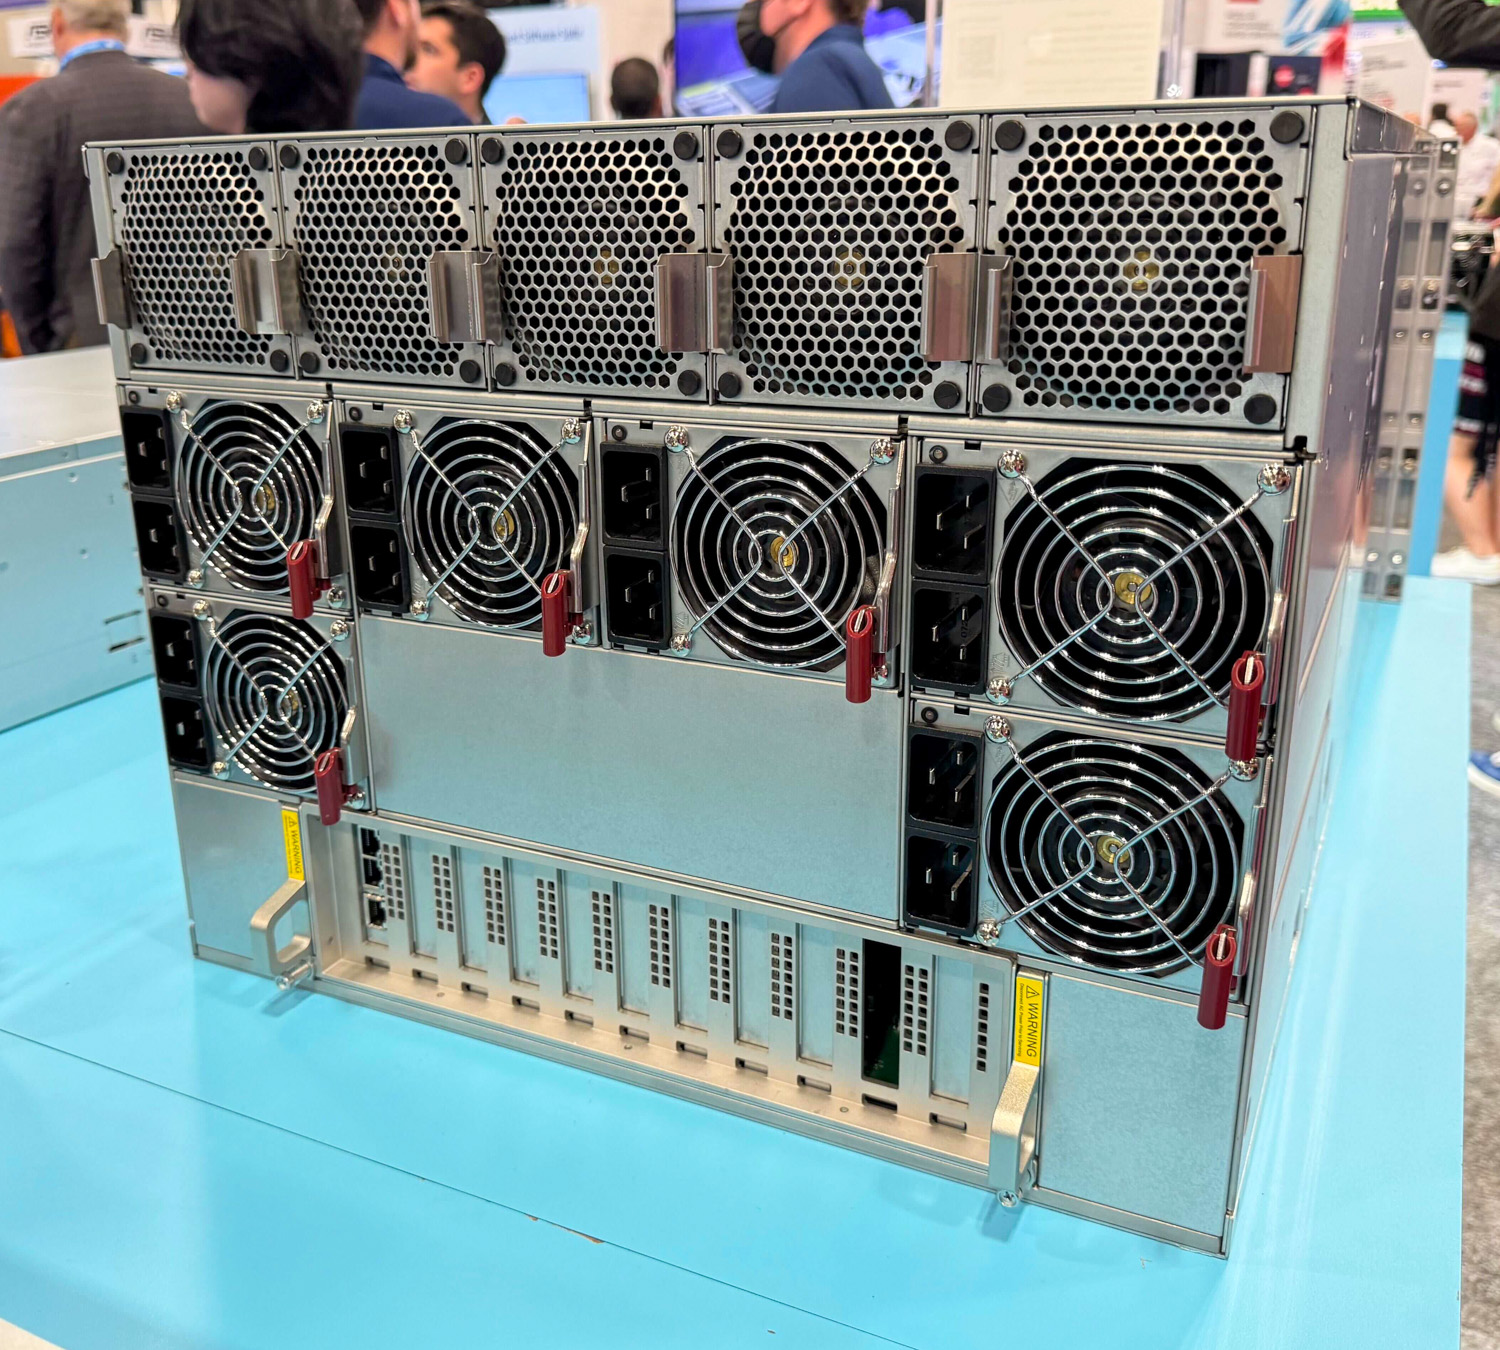
ကျွန်ုပ်တို့သည် AS-8126GS-TNMR စနစ်ကို စမ်းသပ်ခဲ့ပြီး ၊ ၎င်းသည် dual AMD EPYC 9575F processors နှင့် AMD Instinct MI350X GPU ရှစ်လုံးဖြင့် တည်ဆောက်ထားသော 8U လေအေးပေးစနစ်တစ်ခုဖြစ်သည်။ MI350X သည် AMD ၏ လက်ရှိ flagship data center accelerator ဖြစ်ပြီး TSMC ၏ 3nm node တွင် 4th Gen CDNA architecture ပေါ်တွင် တည်ဆောက်ထားပြီး GPU တစ်ခုလျှင် HBM3e 288GB ပါရှိသည်။ AMD Infinity Fabric မှတစ်ဆင့် ချိတ်ဆက်ထားသော GPU ရှစ်ခုတွင် server သည် single node တွင် စုစုပေါင်း GPU မှတ်ဉာဏ် 2.3 TB ကို ပေးဆောင်ပြီး စုစုပေါင်း bandwidth 1,024 GB/s ရှိသည်။ full system သည် 3+3 redundant configuration တွင် 5,250W Titanium-level power supplies ခြောက်ခုကို အသုံးပြုထားပြီး Supermicro သည် scale-out deployments များအတွက် GPU တစ်ခုလျှင် 400 Gbps networking ကို ပံ့ပိုးပေးထားသည်။
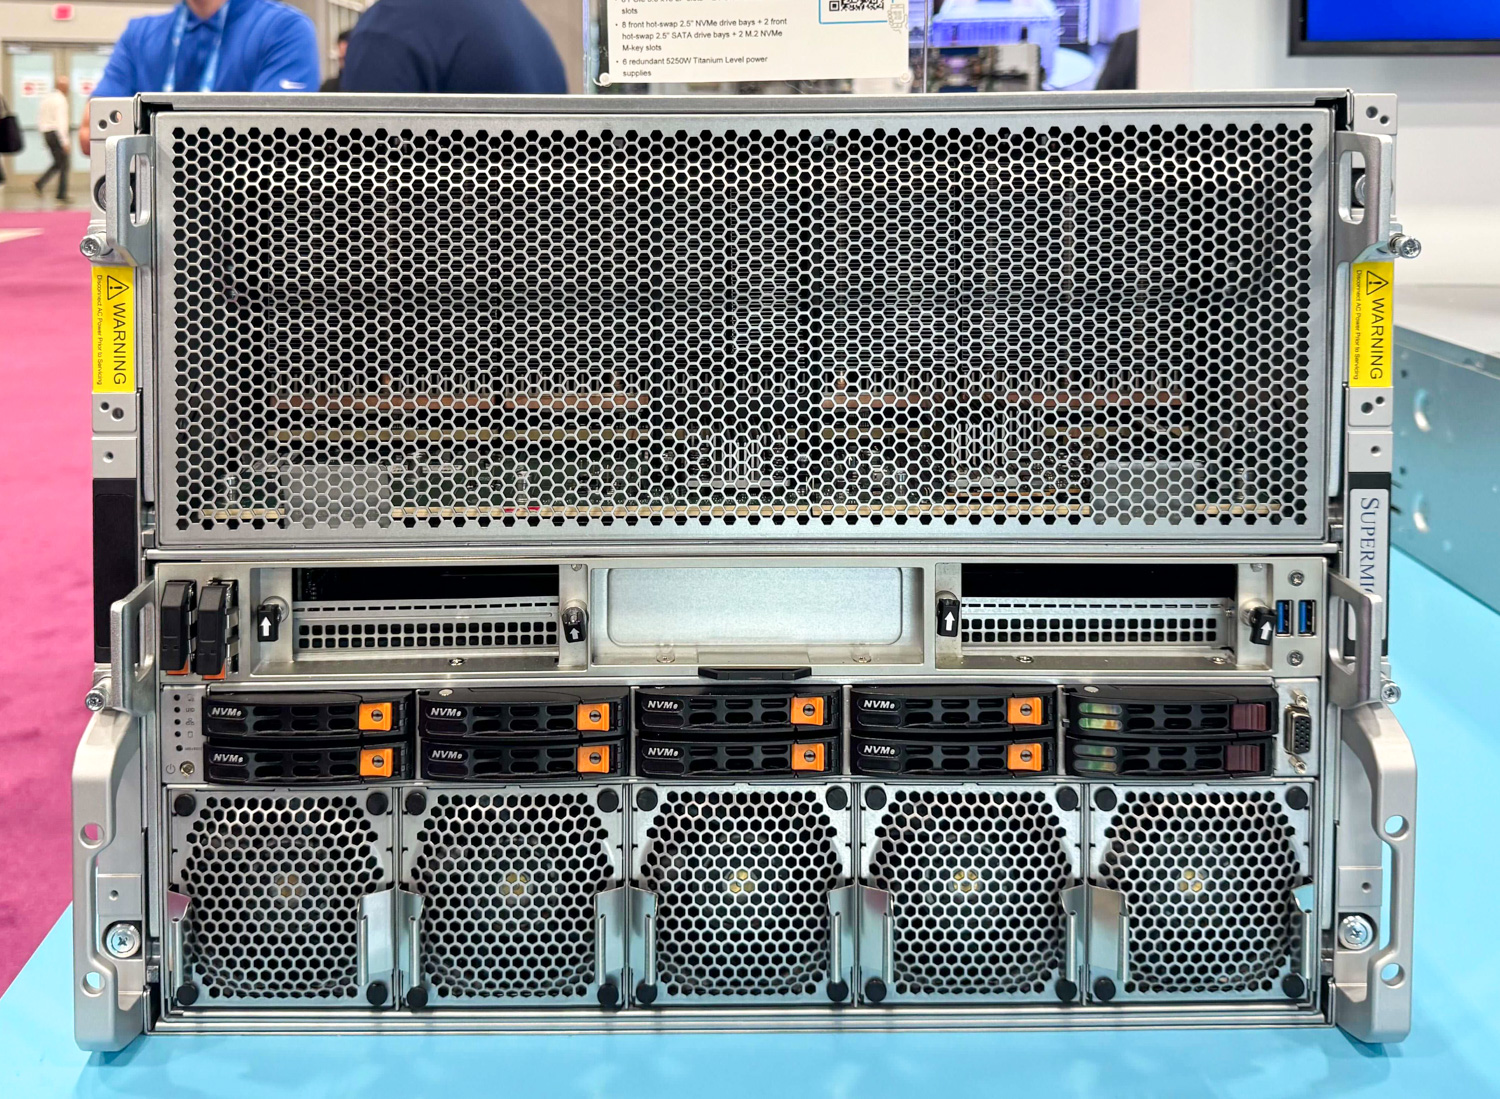
ဒေတာစင်တာ GPU ဈေးကွက်တွင် AMD ၏ ရပ်တည်မှုသည် ပြီးခဲ့သည့် နှစ်နှစ်အတွင်း သိသိသာသာ ပြောင်းလဲလာခဲ့ပြီး MI350X မျိုးဆက်သည် ယခင် Instinct ထုတ်ကုန်များထက် NVIDIA အတွက် ပိုမိုပြင်းထန်သော ယှဉ်ပြိုင်မှုဆိုင်ရာ စိန်ခေါ်မှုတစ်ရပ်ကို ကိုယ်စားပြုသည်။ ၂၀၂၅ ခုနှစ် စက်တင်ဘာလတွင် ထွက်ရှိခဲ့ပြီး ယခု ဗားရှင်း 7.2 တွင် native MI350X ပံ့ပိုးမှုနှင့်အတူ သိသိသာသာ တိုးတက်ကောင်းမွန်သော inference စွမ်းဆောင်ရည်၊ CUDA လိုက်ဖက်ညီမှုကွာဟချက်ကို ပိတ်ပေးသည့် HIP API အပ်ဒိတ်များနှင့် PyTorch၊ JAX၊ TensorFlow၊ ONNX Runtime၊ vLLM နှင့် SGLang အပါအဝင် framework ပံ့ပိုးမှုကို တိုးချဲ့ခဲ့သည်။
vLLM ပရောဂျက်သည် ၂၀၂၅ ခုနှစ် ဒီဇင်ဘာလနှောင်းပိုင်းတွင် AMD ROCm CI pipeline ကို ထပ်မံထည့်သွင်းခဲ့ပြီး AMD hardware ကို downstream port အစား ထို inference stack တွင် ပထမတန်းစား platform တစ်ခုဖြစ်လာစေခဲ့သည်။ ဂေဟစနစ်၏ လက်ခံအသုံးပြုမှုကိုလည်း လျစ်လျူရှုရန် ခက်ခဲသည်- AMD နှင့် Meta တို့သည် ၂၀၂၆ ခုနှစ် ဖေဖော်ဝါရီလတွင် Meta ၏ MI300 နှင့် MI350 series hardware များ၏ လက်ရှိထုတ်လုပ်မှု ဖြန့်ကျက်မှုများအပေါ် အခြေခံ၍ နှစ်ပေါင်းများစွာ၊ မျိုးဆက်များစွာ 6-gigawatt GPU ဖြန့်ကျက်မှု သဘောတူညီချက်ကို ကြေညာခဲ့သည်။ ကမ္ဘာ့အကြီးဆုံး AI အခြေခံအဆောက်အအုံ အော်ပရေတာများထဲမှ တစ်ခုထံမှ ထိုကတိကဝတ်အဆင့်သည် စျေးကွက်ရှာဖွေရေး မှတ်ချက်မဟုတ်ပါ။
လက်ရှိတွင် AI accelerator infrastructure ကို အကဲဖြတ်နေသော အဖွဲ့အစည်းများအတွက် NVIDIA hardware အတွက် ဦးဆောင်ချိန်သည် စိုးရိမ်စရာတစ်ခုအဖြစ် ရှိနေဆဲဖြစ်သည်။ မေးခွန်းမှာ AMD သည် fallback ထက် ယုံကြည်စိတ်ချရသော အစားထိုးတစ်ခု ဖြစ်မဖြစ်ဖြစ်သည်။ ROCm 7.2.0 နှင့် လက်ရှိ vLLM ဖြင့် တစ်ပတ်ကြာ စမ်းသပ်မှုအပေါ် အခြေခံ၍ အဖြေသည် လွန်ခဲ့သော ၁၈ လကနှင့် အဓိပ္ပာယ်ရှိရှိ ကွာခြားပါသည်။
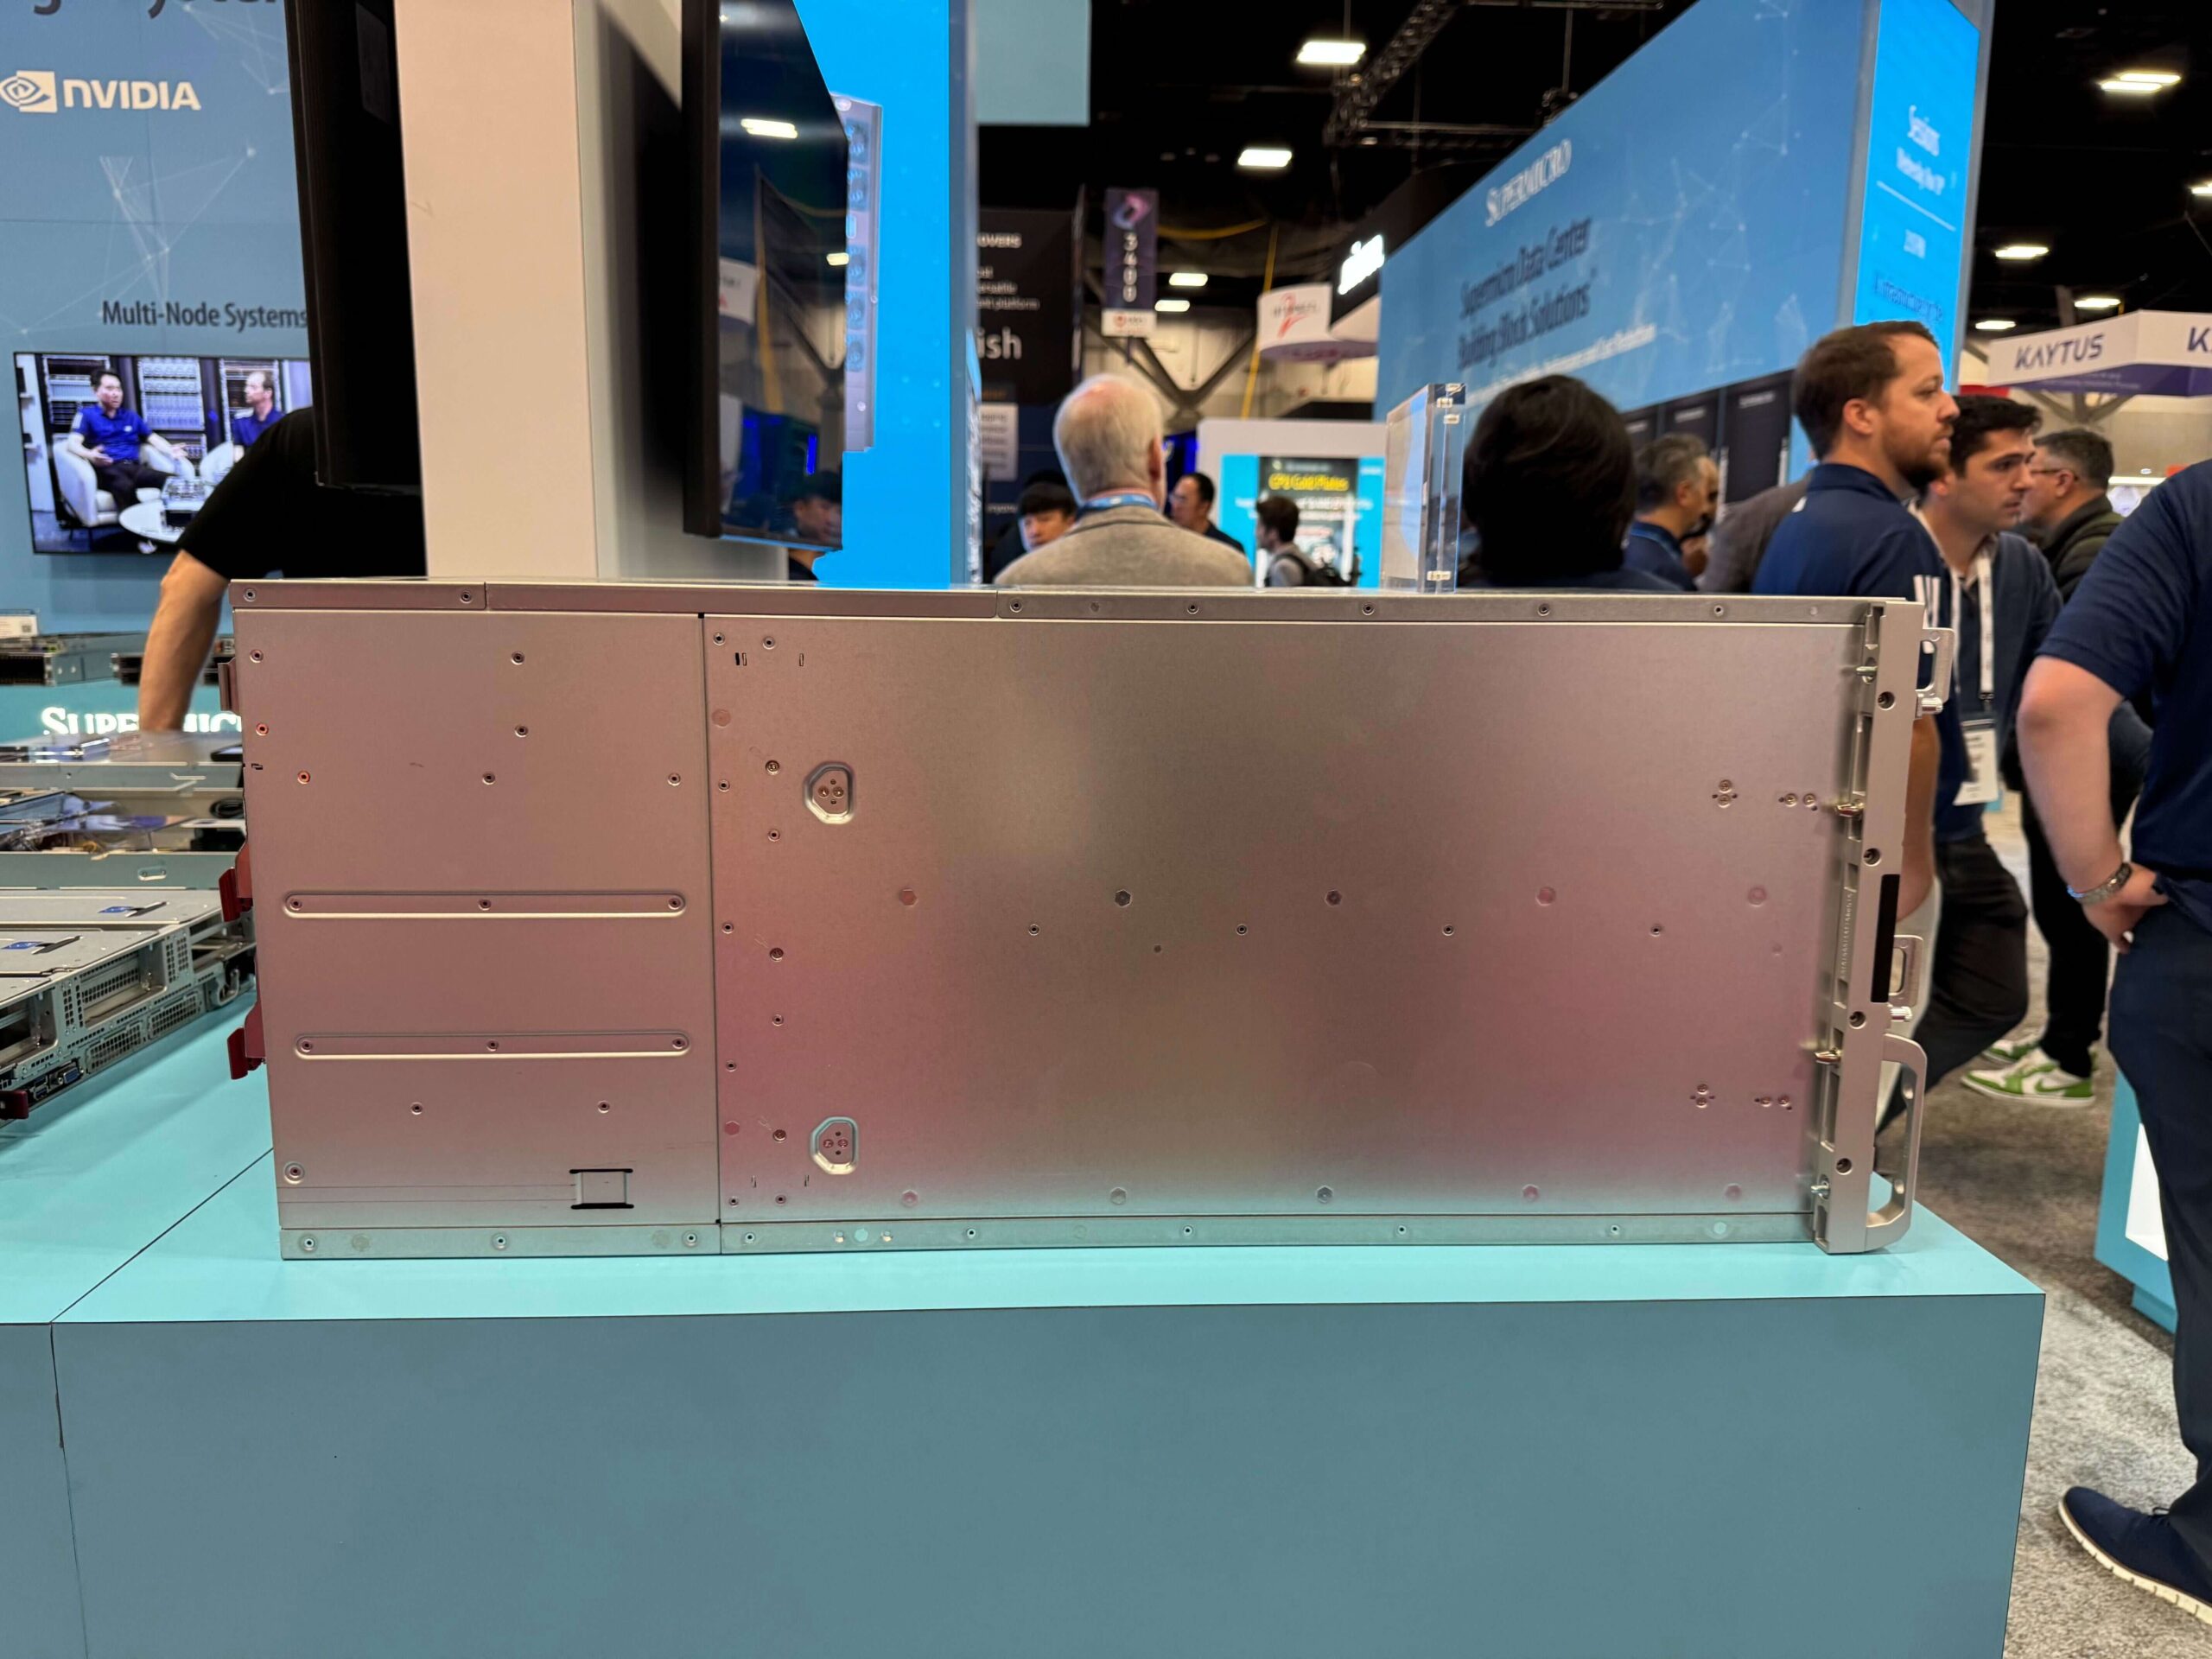
ကျွန်ုပ်တို့၏ စမ်းသပ်မှုတွင် လူကြိုက်များသော မော်ဒယ်များကို ရွေးချယ်ခဲ့သည်။ single node တွင် 2.3TB HBM3e သည် Moonshot ၏ Kimi K2.5 နှင့် MiniMax M2.5 အပါအဝင် large-parameter မော်ဒယ်များတွင် single-server မှ ကောက်ချက်ချနိုင်စေခဲ့သည်။
AMD Instinct MI350X: ဗိသုကာနှင့် မျိုးဆက်တိုးတက်မှုများ
MI350X သည် Instinct ထုတ်ကုန်လိုင်းတွင် AMD ၏ ယနေ့အထိ ဗိသုကာပိုင်းဆိုင်ရာ ရည်မှန်းချက်ကြီးမားသော မျိုးဆက်တစ်ခု၏ ခုန်ပျံကျော်လွှားမှုကို ကိုယ်စားပြုသည်။ ၎င်းနောက်ကွယ်ရှိ အင်ဂျင်နီယာဆိုင်ရာ ဆုံးဖြတ်ချက်များကို နားလည်ခြင်းသည် နောက်ဆက်တွဲ စွမ်းဆောင်ရည်ရလဒ်များကို အဓိပ္ပာယ်ဖွင့်ဆိုရန်အတွက် အရေးကြီးသော နောက်ခံအခြေအနေကို ပေးပါသည်။
CDNA 4 ဗိသုကာနှင့် လုပ်ငန်းစဉ် Node အကူးအပြောင်း
MI300 စီးရီးမှ MI350 စီးရီးသို့ အခြေခံပြောင်းလဲမှုသည် ယခင်မျိုးဆက်တွင် အသုံးပြုခဲ့သော 5nm ထုတ်လုပ်မှုမှ ရွှေ့ပြောင်းလာသော Accelerator Compute Chiplets (XCDs) အတွက် TSMC ၏ N3P လုပ်ငန်းစဉ် node ကို လက်ခံကျင့်သုံးခြင်းအပေါ် အခြေခံသည်။ စုစုပေါင်း transistor အရေအတွက်သည် MI300 မျိုးဆက်ထက် ၂၁% ခန့် တိုးလာပြီး ပါဝါသုံးစွဲမှု တိုးလာခြင်းမရှိဘဲ ၁၈၅ ဘီလီယံခန့် ရှိသည်။
MI350X သည် AMD ၏ သက်သေပြထားသော multi-chiplet packaging ဗျူဟာကို ဆက်လက်ထိန်းသိမ်းထားသည်။ ၎င်း၏ အဓိကအချက်အနေဖြင့် GPU package တွင် အဓိက တွက်ချက်မှုအင်ဂျင်များအဖြစ် Accelerator Compute Chiplets (XCDs) ရှစ်ခု ပါဝင်သည်။ XCD တစ်ခုစီတွင် shader အင်ဂျင်လေးခုပါဝင်ပြီး တစ်ခုချင်းစီတွင် active CDNA 4 compute unit ရှစ်ခုပါရှိပြီး XCD တစ်ခုလျှင် CU ၃၂ ခုနှင့် full accelerator အတွက် CU ၂၅၆ ခု ထုတ်ပေးပါသည်။
CDNA 4 package ဒီဇိုင်းတွင် I/O Die အလွှာကိုလည်း tile လေးခုမှ နှစ်ခုအထိ ပေါင်းစည်းခဲ့သည်။ ဤပြန်လည်ဖွဲ့စည်းမှုသည် AMD အား Infinity Fabric bus width ကို နှစ်ဆတိုးနိုင်စေခဲ့ပြီး၊ bi-sectional bandwidth ကို တိုးတက်ကောင်းမွန်စေကာ bus frequency နှင့် operating voltage ကို လျှော့ချကာ ပါဝါသုံးစွဲမှုကို လျှော့ချနိုင်စေခဲ့သည်။
ပြန်လည်ဒီဇိုင်းထုတ်ထားသော Compute Units များနှင့် ချဲ့ထွင်ထားသော Precision Support
CDNA 4 compute unit matrix math စွမ်းရည်များဖြင့် သိသိသာသာ မြှင့်တင်မှုရှိသည်- MI350 CU များသည် ၎င်းတို့၏ MI300 counterparts များနှင့် နှိုင်းယှဉ်ပါက 16-bit (BF16, FP16) နှင့် 8-bit (FP8, INT8) လုပ်ဆောင်ချက်များအတွက် CU တစ်ခုလျှင် throughput ၂ ဆ တိုးလာစေပါသည်။
raw throughput gains များအပြင်၊ CDNA 4 သည် MI300 စီးရီးတွင် မပါဝင်သော တိကျမှုနည်းသောဒေတာအမျိုးအစားများ၊ အထူးသဖြင့် FP6 နှင့် FP4 အတွက် ဟာ့ဒ်ဝဲပံ့ပိုးမှုကို မိတ်ဆက်ပေးပြီး ယခင်မျိုးဆက်မှ ဆက်လက်သယ်ဆောင်လာသော လက်ရှိ FP8 ပံ့ပိုးမှုနှင့်အတူ ဖြစ်သည်။
ဤစံပုံစံများအပြင်၊ MI350X သည် OCP microscaling မျိုးကွဲများဖြစ်သည့် MXFP4၊ MXFP6 နှင့် MXFP8 အတွက် native hardware support ကို ထည့်သွင်းထားသည်။ Microscaling ပုံစံများကို စံ quantization ပုံမှန်ခွင့်ပြုသည်ထက် ပိုမိုမြင့်မားသော တိကျမှုအခြေခံများနှင့် ပိုမိုနီးကပ်စွာ output အရည်အသွေးကို ထိန်းသိမ်းထားစဉ်တွင် တိကျမှုနည်းသော compute ၏ throughput အားသာချက်များကို ပေးဆောင်ရန် ဒီဇိုင်းထုတ်ထားသည်။ ၎င်းသည် AMD-specific ဖွံ့ဖြိုးတိုးတက်မှုမဟုတ်ပါ။ NVIDIA ၏ NVFP4 ပုံစံသည် တူညီသော microscaling နိယာမများတွင် လုပ်ဆောင်ပြီး နယ်စပ်မော်ဒယ်ဖြန့်ကျက်မှုများတွင် ကျယ်ကျယ်ပြန့်ပြန့် လက်ခံကျင့်သုံးမှုကို မြင်တွေ့ခဲ့ရပြီး OpenAI မှ GPT-OSS မိသားစုသည် ဤပုံစံများပတ်လည်တွင် တည်ဆောက်ထားသော အထင်ရှားဆုံး ဥပမာများထဲမှ တစ်ခုဖြစ်သည်။ MI350X ၏ native MXFP4 support သည် software emulation သို့မဟုတ် precision promotion များသို့ ပြန်မသွားဘဲ ဤနှင့် အလားတူ quantized မော်ဒယ်မိသားစုများကို ဝန်ဆောင်မှုပေးနိုင်သည်။
MI350X သည် MXFP4 နှင့် MXFP6 တွင် 9.2 PFLOPs များကို ပေးစွမ်းနိုင်ပြီး OCP-FP8 တွင် 4.6 PFLOPs ရှိပြီး FP16 တွင် 2.3 PFLOPs နှင့် 2,200 MHz ၏ peak engine clock ရှိသည်။ microscaling quantization ဖြစ်နိုင်သည့် inference-optimized deployments များအတွက်၊ compute headroom သည် FP8 workloads နှင့် နှိုင်းယှဉ်ပါက နှစ်ဆတိုးလာသည်။ CDNA 4 compute unit တွင် vector ALU အသစ်တစ်ခုကိုလည်း ထည့်သွင်းထားပြီး၊ 2-bit operations များကို ပံ့ပိုးပေးပြီး BF16 ရလဒ်များကို FP32 သို့ စုဆောင်းနိုင်ပြီး primary matrix compute path ပြင်ပရှိ low-precision vector workloads များအတွက် အပိုပြောင်းလွယ်ပြင်လွယ်ရှိစေပါသည်။
မှတ်ဉာဏ် ဆပ်စနစ်- HBM3e၊ Infinity Cache နှင့် Bandwidth Efficiency
MI350 စီးရီးတွင် HBM3e မှတ်ဉာဏ် stack ရှစ်ခုပါရှိသော သိသိသာသာ အဆင့်မြှင့်တင်ထားသော မှတ်ဉာဏ် subsystem ပါရှိပြီး GPU တစ်ခုလျှင် စုစုပေါင်းစွမ်းရည် 288GB ပေးစွမ်းနိုင်သည်။ 12-high 24Gbit devices များဖြင့် ဖွဲ့စည်းထားသော 36GB stack တစ်ခုစီသည် pin တစ်ခုလျှင် 8Gbps ၏ HBM3e pin speed အပြည့်ဖြင့် လည်ပတ်သည်။ ဗိသုကာလက်ရာတွင် HBM နှင့် Infinity Fabric/L2 caches များအကြားတွင် တည်ရှိသော မှတ်ဉာဏ်ဘက်ခြမ်း cache ဖြစ်သည့် AMD ၏ Infinity Cache ကို ထိန်းသိမ်းထားသည်။ ၎င်းတွင် GPU တစ်ခုလျှင် စုစုပေါင်း 256 MB ရှိသော 2 MB cache ဖြင့် ကျောထောက်နောက်ခံပြုထားသော channel 128 ခု ပါဝင်သည်။ AMD သည် IOD များအတွင်းရှိ on-die network bus များကို ချဲ့ထွင်ပြီး ဗို့အားလျှော့ချခြင်းဖြင့် လည်ပတ်သောကြောင့် MI300 စီးရီးထက် watt တစ်ခုလျှင် 1.3 ဆခန့် မြင့်မားသော မှတ်ဉာဏ် bandwidth ကို ဖြစ်စေသည်။
MI300X ရဲ့ 192GB ကနေ 288GB အထိ မန်မိုရီစွမ်းရည် တိုးလာတာက AMD ရဲ့ per-GPU မန်မိုရီ စွမ်းရည်မှာ ဦးဆောင်မှုကို တိုးချဲ့ပေးပြီး မော်ဒယ်ကြီးတွေရဲ့ ကောက်ချက်ချမှုအတွက် တိုက်ရိုက်သက်ရောက်မှုတွေ ရှိပါတယ်။ MI350X GPU တစ်ခုစီဟာ 500 billion ကျော်တဲ့ မော်ဒယ်တွေကို သီးခြားစီ host လုပ်နိုင်ပါတယ်။ ရှစ်ခုပါ GPU server တစ်လျှောက်မှာ HBM3e ရဲ့ စုစုပေါင်း 2.3TB ဟာ Kimi K2.5 နဲ့ MiniMax M2.5 ရလဒ်တွေက ပြသထားတဲ့အတိုင်း trillion-parameter ဖြန့်ကျက်မှုတွေကို ရှုပ်ထွေးစေတဲ့ multi-node ဖြန့်ကျက်မှု လိုအပ်ချက်တွေကို ဖယ်ရှားပေးပါတယ်။
ပြောင်းလွယ်ပြင်လွယ်ရှိသော ပိုင်းခြားခြင်းနှင့် ဖြန့်ကျက်ခြင်း ဗိသုကာ
MI350 စီးရီးသည် socket တစ်ခုလျှင် ပြောင်းလွယ်ပြင်လွယ် GPU partitioning ကို ပံ့ပိုးပေးပြီး memory ကို cluster နှစ်ခုအဖြစ် ပိုင်းခြားထားသည်။ ဤပြောင်းလွယ်ပြင်လွယ်ရှိမှုသည် XCD များအတွက်လည်း အကျုံးဝင်ပြီး quad XCD cluster ကို dual သို့မဟုတ် single blocks အဖြစ် ပိုင်းခြားနိုင်သောကြောင့် chip သည် CPX+NPS2 ရှိ 70B မော်ဒယ်များ၏ instance ၈ ခုကဲ့သို့သော configuration များကို ပံ့ပိုးပေးနိုင်သည်။ shared infrastructure တစ်လျှောက်တွင် heterogeneous inference workloads များကို လုပ်ဆောင်နေသော အဖွဲ့အစည်းများအတွက်၊ ဤ partitioning စွမ်းရည်သည် မော်ဒယ်အဆင့်တစ်ခုလျှင် dedicated hardware အတွက် လိုအပ်ချက်ကို လျှော့ချပေးပြီး ရောနှောဖြန့်ကျက်မှုပတ်ဝန်းကျင်များတွင် အသုံးချမှုစီးပွားရေးကို တိုးတက်စေသည်။
MI350 စီးရီးသည် MI300 စီးရီးစနစ်များတွင်အသုံးပြုသော UBB (Universal Base Board) အခြေခံအဆောက်အအုံနှင့် drop-in တွဲဖက်အသုံးပြုနိုင်မှုကိုလည်း ထိန်းသိမ်းထားသည်။ ရှိပြီးသား server chassis၊ power delivery နှင့် cooling အခြေခံအဆောက်အအုံများကို ပြုပြင်မွမ်းမံခြင်းမရှိဘဲ ဆက်လက်တည်ရှိနေပြီး active MI300 ဖြန့်ကျက်မှုများရှိသော အဖွဲ့အစည်းများအတွက် အဆင့်မြှင့်တင်မှုပွတ်တိုက်မှုကို လျှော့ချပေးသည်။
MI355X: အရည်ဖြင့်အအေးပေးထားသော ညီအစ်ကို
MI350 စီးရီးကို တူညီသော အောက်ခံဆီလီကွန်ပေါ်တွင် တည်ဆောက်ထားပြီး မတူညီသော အပူချိန်လည်ပတ်မှုအဖုံးများအတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသော မျိုးကွဲနှစ်မျိုးဖြင့် တင်ပို့ရောင်းချပါသည်။ ဤနေရာတွင် စမ်းသပ်ထားသော MI350X သည် လေဖြင့်အအေးပေးသော မျိုးကွဲဖြစ်ပြီး MI355X သည် ၎င်း၏ အရည်ဖြင့်အအေးပေးသော ဗားရှင်းဖြစ်ပြီး တိုက်ရိုက်အရည်အအေးပေးသည့် အခြေခံအဆောက်အအုံများ ရရှိနိုင်သည့် မြင့်မားသောသိပ်သည်းဆရှိသော ဖြန့်ကျက်မှုများအတွက် ဒီဇိုင်းထုတ်ထားသည်။
ဗားရှင်းနှစ်မျိုးလုံးကို အခြေခံဟာ့ဒ်ဝဲတစ်ခုတည်းပေါ်တွင် တည်ဆောက်ထားသော်လည်း MI355X ၏ မြင့်မားသောလည်ပတ်မှုပါဝါအဖုံးသည် ပိုမိုမြင့်မားသော clock frequencies များကို ဖြစ်ပေါ်စေပြီး MI350X နှင့်နှိုင်းယှဉ်ပါက လက်တွေ့ကမ္ဘာ၊ end-to-end workloads များတွင် စွမ်းဆောင်ရည် ၂၀% ခန့် အားသာချက်ရှိသည်။ MI355X တွင် MI350X ၏ 1,000W ထက် အမြင့်ဆုံး TBP 1,400W ရှိပြီး clock speed သည် အမြင့်ဆုံး 2.4 GHz ရှိပြီး လေအေးပေးထားသော ဗားရှင်းတွင် 2.2 GHz ရှိသည်။
မျိုးဆက်အလိုက် ပြောရရင် MI355X ပလက်ဖောင်းဟာ MI300X ထက် အမြင့်ဆုံးသီအိုရီစွမ်းဆောင်ရည် ၄ ဆအထိ တိုးတက်မှုကို ပေးစွမ်းနိုင်ပြီး၊ agentic နဲ့ chatbot workloads တွေမှာ လက်တွေ့ကမ္ဘာက inference gains ၄.၂ ဆခန့်နဲ့ content generation scenarios တွေမှာ ၃ ဆခန့် တိုးတက်လာခဲ့ပါတယ်။ MI350X ဖြန့်ကျက်မှုတွေကို အကဲဖြတ်တဲ့ အဖွဲ့အစည်းတွေအတွက်၊ variants နှစ်ခုကြားက ၂၀% စွမ်းဆောင်ရည်ကွာခြားချက်က ရှင်းလင်းတဲ့ အမြင့်ဆုံးအဆင့်ကို ကိုယ်စားပြုပါတယ်။ DLC အခြေခံအဆောက်အအုံရှိတဲ့ အဆောက်အဦတွေဟာ thermal investment က သူတို့ရဲ့ workload profile အတွက် လုံလောက်တဲ့ throughput uplift ကို ဖြစ်ပေါ်စေသလားဆိုတာ ဆုံးဖြတ်ဖို့ MI355X ကို အကဲဖြတ်သင့်ပါတယ်။
Supermicro JumpStart Program မှတစ်ဆင့် AMD Instinct MI350X ကို ဝင်ရောက်ခြင်း
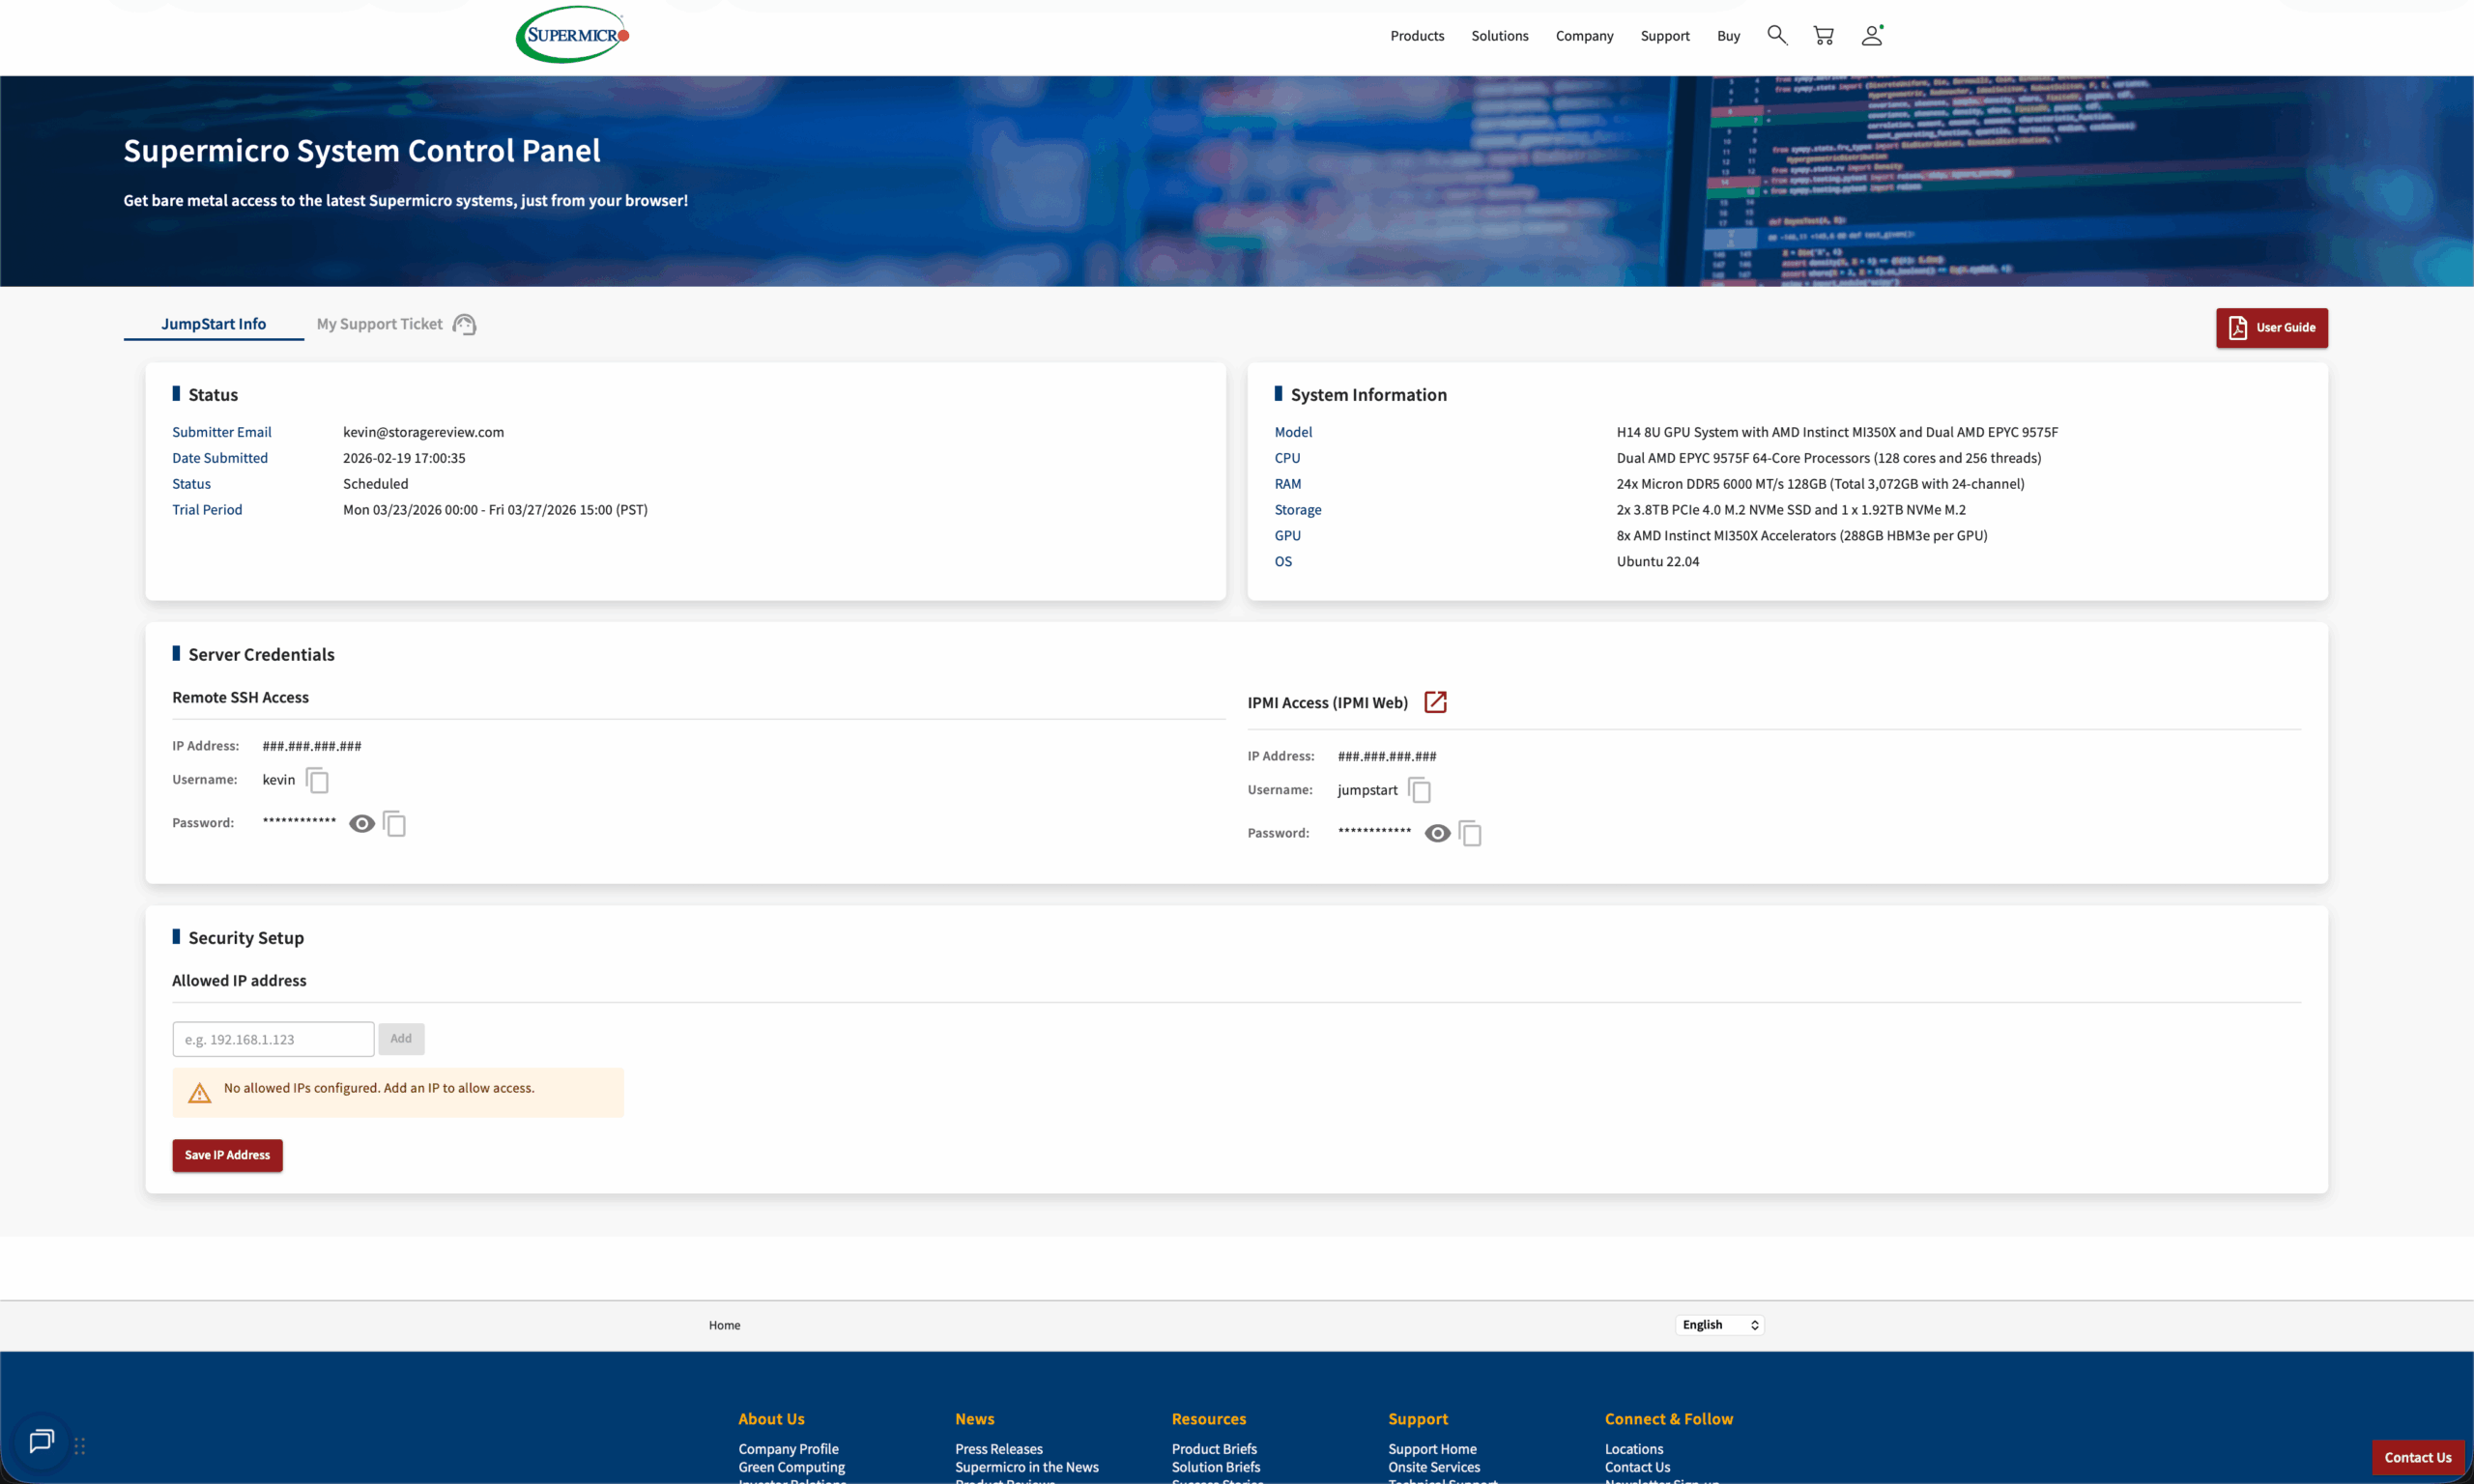
JumpStart ဖြင့်စတင်ရန် Supermicro ၏ portal တွင် မှတ်ပုံတင်ရန် လိုအပ်ပြီး၊ အရည်အချင်းပြည့်မီသော အသုံးပြုသူများသည် ရရှိနိုင်သော စနစ်များကို ကြည့်ရှုနိုင်ပြီး ကြိုတင်မှာယူမှုဝင်းဒိုးကို အချိန်ဇယားဆွဲနိုင်သည်။ အတည်ပြုပြီးသည်နှင့် portal သည် ကြိုတင်မှာယူမှုကာလအတွင်း SSH အထောက်အထားများ၊ IPMI ဝင်ရောက်ခွင့်နှင့် ဝဘ်အခြေပြု အဝေးထိန်း console ကို ပေးပါသည်။ စနစ်သည် Ubuntu နှင့်အတူ ကြိုတင်ထည့်သွင်းထားပြီး အသုံးပြုရန် အဆင်သင့်ဖြစ်ပါသည်။ စတင်ရန် ပံ့ပိုးပေးမှု နှောင့်နှေးခြင်း နှင့် ပံ့ပိုးမှု အပြန်အလှန်ဆက်သွယ်မှု မလိုအပ်ပါ။ ကျွန်ုပ်တို့၏ ကြိုတင်မှာယူမှုသည် ၂၀၂၆ ခုနှစ် မတ်လ ၂၃ ရက်မှ မတ်လ ၂၇ ရက်အထိ ကြာမြင့်ခဲ့ပြီး HGX B200 တွင် ကျွန်ုပ်တို့၏ ယခင် JumpStart ပါဝင်ဆောင်ရွက်မှုနှင့် ကိုက်ညီသော ပလက်ဖောင်းတွင် တစ်ပတ်ပြည့် အချိန်ရစေပါသည်။
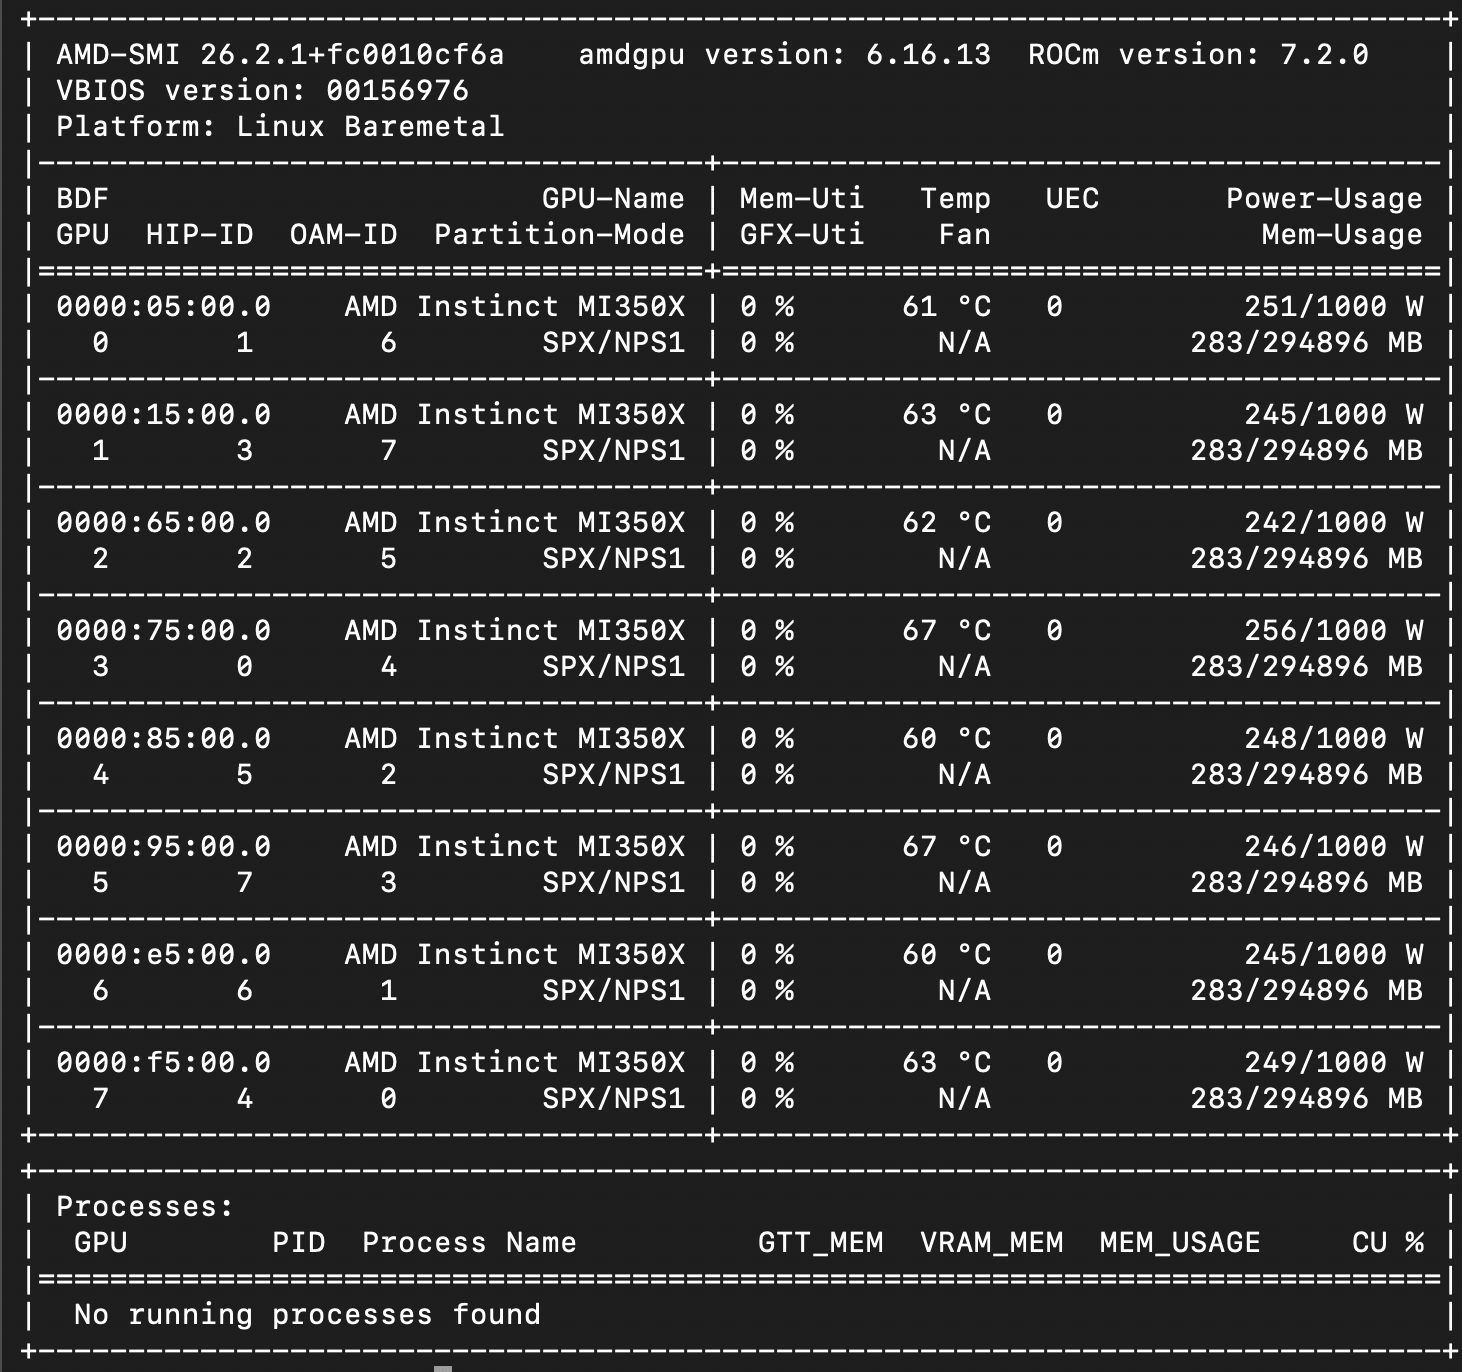
အောက်ဖော်ပြပါ ဖန်သားပြင်ဓာတ်ပုံတွင် H14 စနစ်အတွက် jumpstart မှ ကျွန်ုပ်တို့၏ terminal output ကိုပြသထားပြီး AMD-SMI tool သည် AMD Instinct MI350X GPU ရှစ်ခုနှင့် ၎င်းတို့၏လည်ပတ်နေသော software ဗားရှင်းများကိုပြသထားသည်။
AMD Instinct MI350X စွမ်းဆောင်ရည်စမ်းသပ်မှုရလဒ်များ
System Configuration
- ကိုယ်ထည်: စူပါမိုက်ခရို H14
- CPU ကို: AMD EPYC 9575F နှစ်ထပ်
- မှတ်ဉာဏ်: 3TB DDR5
- GPU ကို: AMD Instinct MI350X ရှစ်လုံး
- သိုလှောင်မှု: ၂ x 3.8TB PCIe 4.0 M.2 NVMe SSD နှင့် ၁ x 1.92TB NVMe M.2
ရလဒ်များအကျဉ်းချုပ်
| ပုံစံ | စေ့စပ်သေချာခြင်း | ညီမျှသော (၂၅၆/၂၅၆) | ကြိုတင်ဖြည့်သွင်း-လေးလံသော (၈ ကီလိုမီတာ/၁ ကီလိုမီတာ) | ဒီကုဒ်-အကြီးစား (၁ ကီလိုမီတာ/၈ ကီလိုမီတာ) |
|---|---|---|---|---|
| GPT-OSS 20B | NVFP4 | 62,247 | 123,714 | 32,468 |
| GPT-OSS 120B | NVFP4 | 33,538 | 84,018 | 20,602 |
| Llama 3.1 8B ညွှန်ကြားချက် | BF16 | 51,467 | 77,658 * | 19,326 |
| မစ်စထရယ် အသေးစား ၃.၁ ၂၄ဘီ | FP8 | 40,742 | 56,093 | 14,557 |
| မစ်စထရယ် အသေးစား ၃.၁ ၂၄ဘီ | BF16 | 30,530 | 53,740 | 13,559 |
| Qwen3 ကုဒ်ဒါ 30B A3B | BF16 | 34,980 | 51,550 | 11,782 |
| Qwen3 ကုဒ်ဒါ 30B A3B | FP8 | 25,928 | 47,179 | 11,014 |
| MiniMax M2.5 | ဘလောက်-စကေးသတ်မှတ်ထားသော FP8 | 14,391 | 23,689 | 6,068 |
| ပါဝင်နေတဲ့ K2.5 | INT4 QAT + BF16 | 6,527 | 11,256 | 2,513 |
| tok/s ဖြင့် တန်ဖိုးအားလုံး၊ BS=256 တွင် အမြင့်ဆုံး throughput ဖြစ်သည်။ *Llama 3.1 8B prefill-heavy သည် BS=128 (77,658 tok/s) တွင် အမြင့်ဆုံးသို့ ရောက်ရှိခဲ့သည်။ BS=256 သည် 76,893 tok/s ဖြစ်သည်။ | ||||
Claude ကုဒ်ဝန်ဆောင်မှု – MiniMax M2.5
ရိုးရာ raw LLM inference benchmarks များအပြင်၊ ဤ hardware သည် agent coding workflow တွင် မည်မျှကောင်းမွန်စွာ လုပ်ဆောင်နိုင်သည်ကို ကျွန်ုပ်တို့ အကဲဖြတ်လိုခဲ့ပြီး၊ အထူးသဖြင့် locally hosted model ဖြင့် တစ်ပြိုင်နက်တည်း Claude Code sessions များစွာကို ဝန်ဆောင်မှုပေးပါသည်။ ဤအသုံးပြုမှုကိစ္စသည် development team productivity နှင့် တိုက်ရိုက်ဆက်စပ်နေသည်- အတွေ့အကြုံ ယိုယွင်းပျက်စီးသွားခြင်းမပြုမီ node တစ်ခုတည်းမှ ဝန်ဆောင်မှုပေးသော AI coding assistant ကို အင်ဂျင်နီယာမည်မျှ တစ်ပြိုင်နက်အသုံးပြုနိုင်သနည်း။
ဒါကိုစမ်းသပ်ဖို့အတွက်၊ ကျွန်တော်တို့ဟာ အသင့်အတင့်ခက်ခဲတဲ့ coding ပြဿနာတွေရဲ့ dataset တစ်ခုကို ထုတ်လုပ်ပေးတဲ့ benchmark harness တစ်ခုကို တည်ဆောက်ခဲ့ပါတယ် (LRU cache ကို အကောင်အထည်ဖော်တာ၊ CLI todo application တစ်ခုတည်ဆောက်တာ၊ markdown converter ရေးသားတာနဲ့ REST API တစ်ခုတည်ဆောက်တာလိုမျိုး အလုပ်တွေ)။ ပြီးတော့ Claude Code session တစ်ခုစီကို သူ့ရဲ့ကိုယ်ပိုင် Docker container ထဲမှာ local vLLM server နဲ့ ယှဉ်ပြီး လုပ်ဆောင်ပါတယ်။ transparent proxy တစ်ခုဟာ session တွေနဲ့ inference endpoint ကြားမှာ ရှိနေပြီး Claude code instance တစ်ခုစီအတွက် per-request metrics တွေကို ဖမ်းယူပါတယ်။ အသုံးပြုခဲ့တဲ့ model က MiniMax M2.5 ဖြစ်ပြီး MI350X GPU ရှစ်ခုမှာ vLLM မှတစ်ဆင့် ဝန်ဆောင်မှုပေးပါတယ်။ public leaderboards တွေမှာ ထိပ်တန်း coding model မဟုတ်ပေမယ့် M2.5 ဟာ user အများအပြား local မှာ အသုံးပြုတဲ့ capable model တစ်ခုဖြစ်ပြီး ကျွန်တော်တို့ရဲ့ developer သူငယ်ချင်းတွေ အများအပြားလည်း ပါဝင်ပါတယ်။
အခြေခံကိုးကားချက်အတွက်၊ ကျွန်ုပ်တို့သည် production API ဝင်ရောက်ခွင့်အတွက် အလွန်ရေပန်းစားသော routing service များထဲမှ တစ်ခုဖြစ်သည့် OpenRouter.ai မှတစ်ဆင့် Anthropic ၏ Claude Opus 4.6 ပျမ်းမျှ output throughput ကို အသုံးပြုပါသည်။ ထိုအခြေခံသည် API request တစ်ခုလျှင် တစ်စက္ကန့်လျှင် တိုကင် ၃၇ ခုခန့် ရှိပါသည်။
ကျွန်ုပ်တို့သည် အဓိက မက်ထရစ်နှစ်ခုကို တိုင်းတာခဲ့သည်- Claude Code session တစ်ခုလျှင် တစ်စက္ကန့်လျှင် ပျမ်းမျှ output tokens (developer တစ်ဦးချင်းစီ ကြုံတွေ့ရသည်များ) နှင့် session အားလုံးတွင် တစ်စက္ကန့်လျှင် စုစုပေါင်း output tokens (server မှ ထုတ်လုပ်နေသော စုစုပေါင်းအလုပ်)။
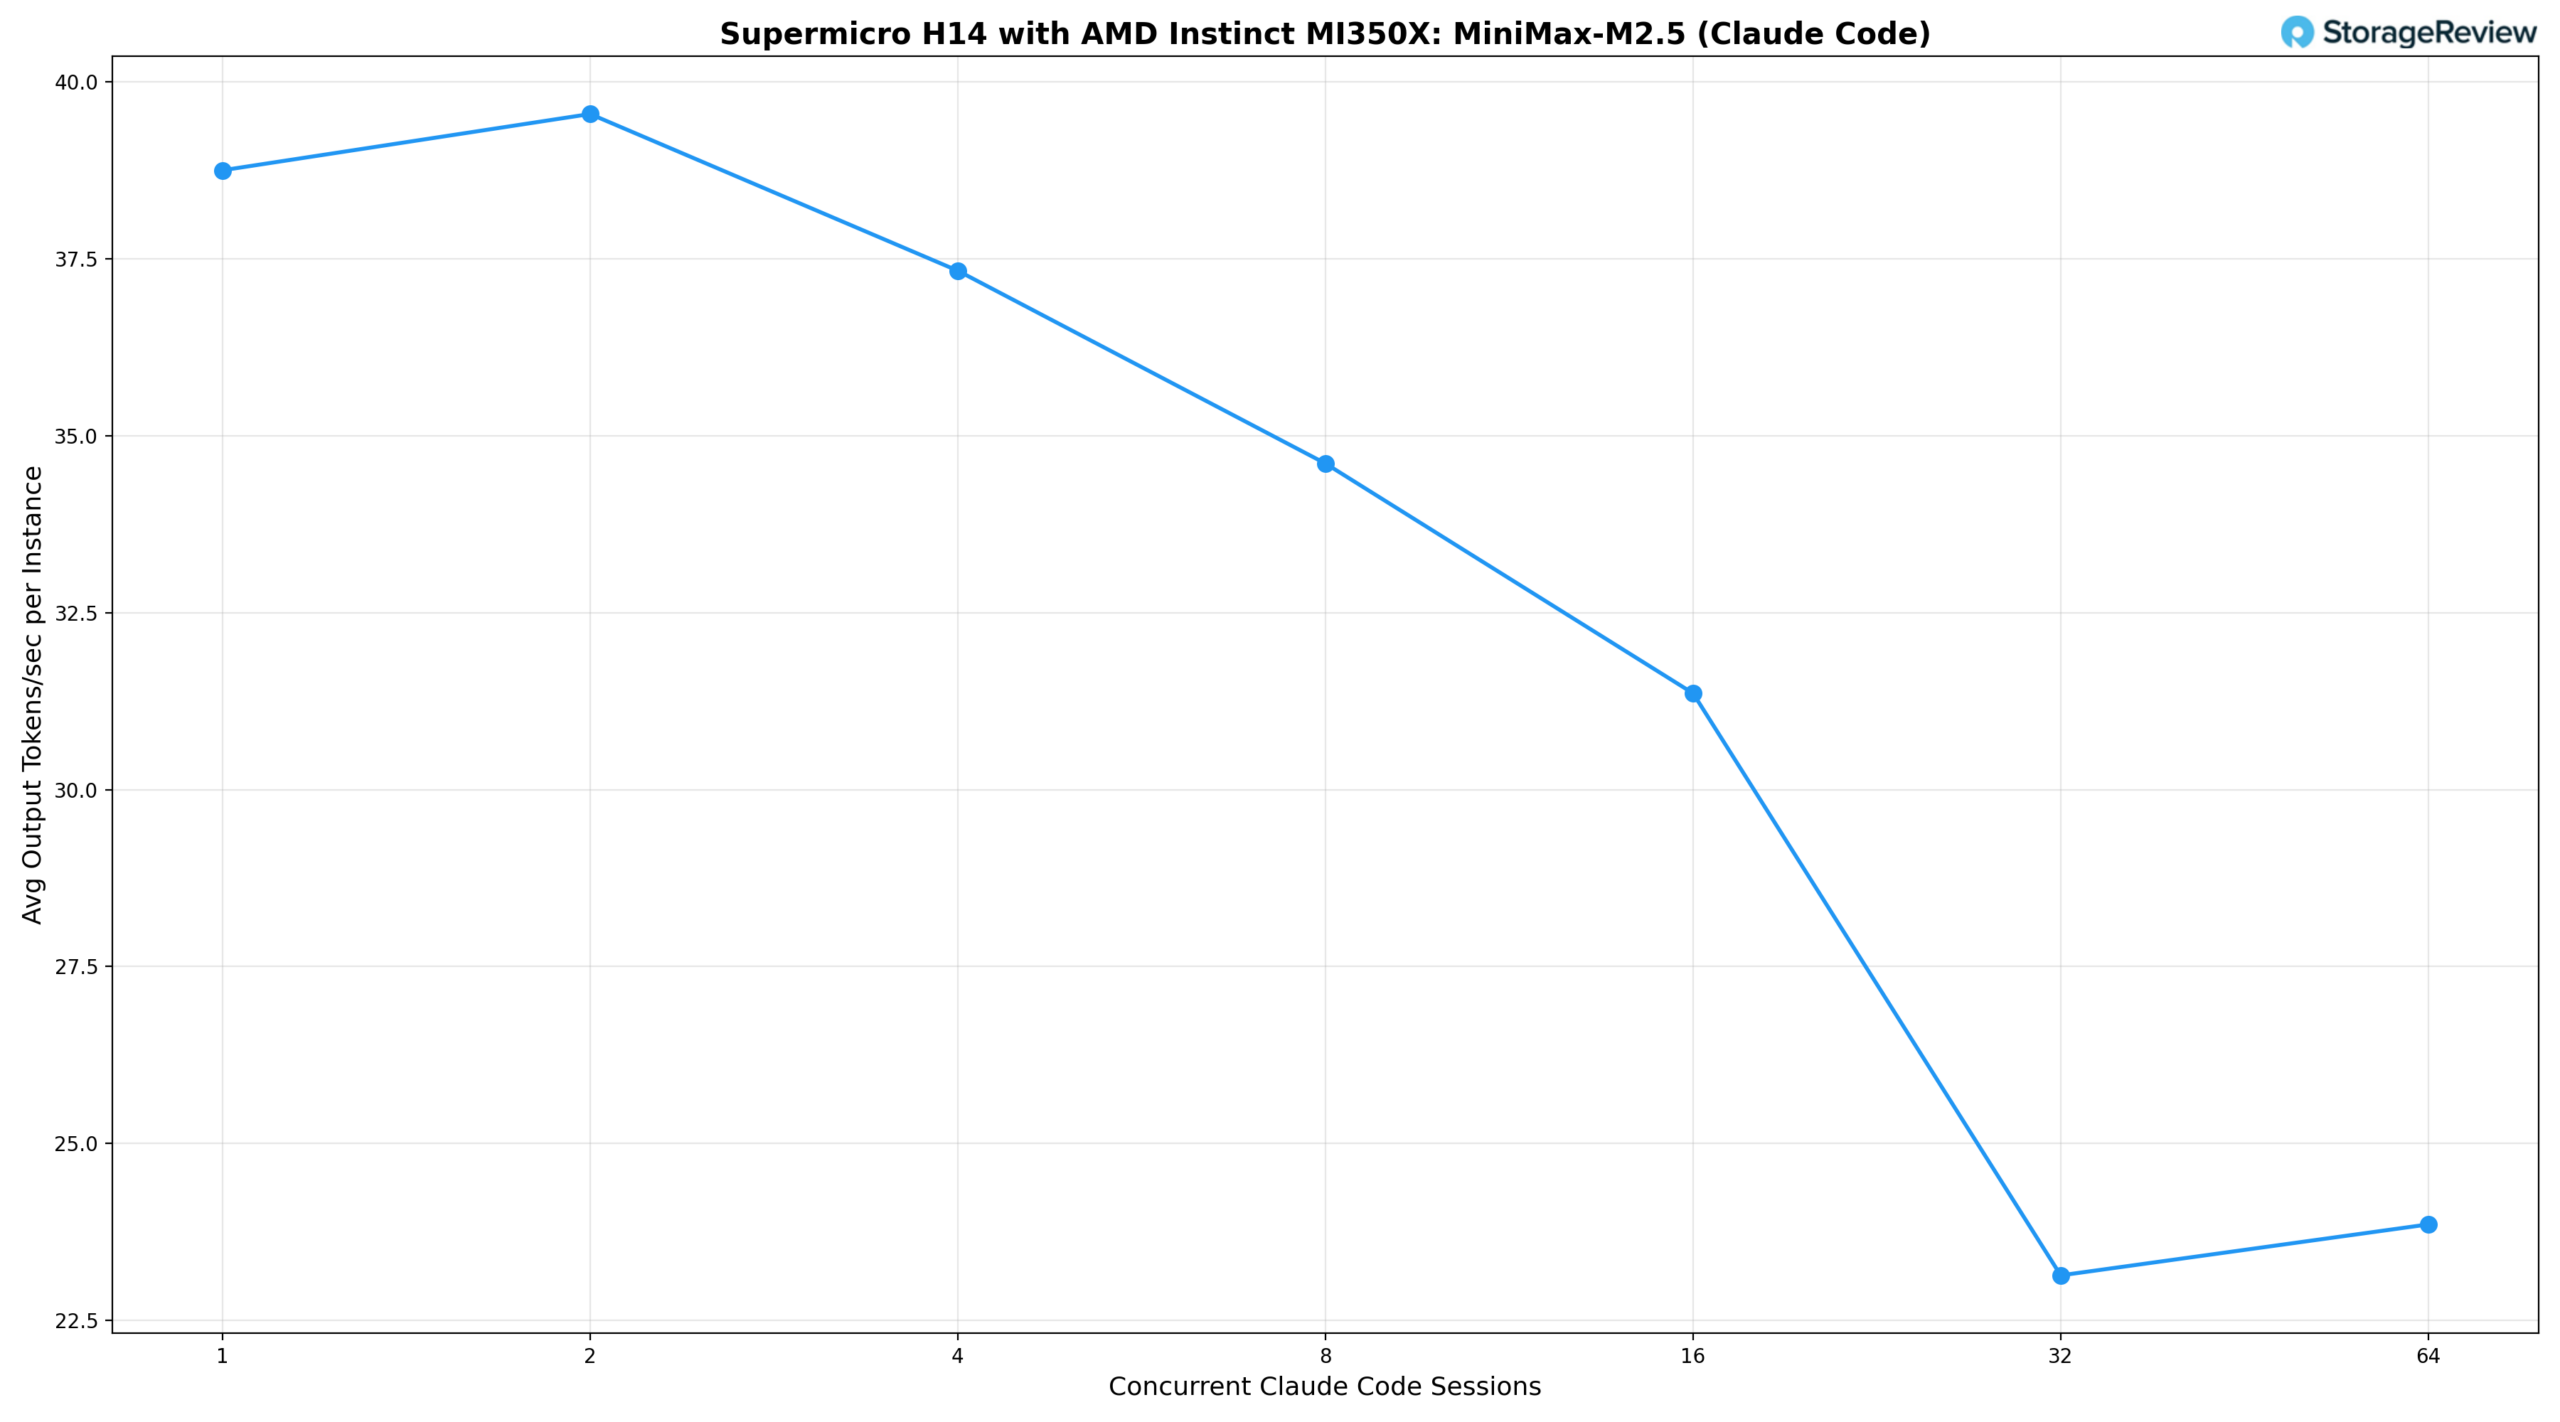
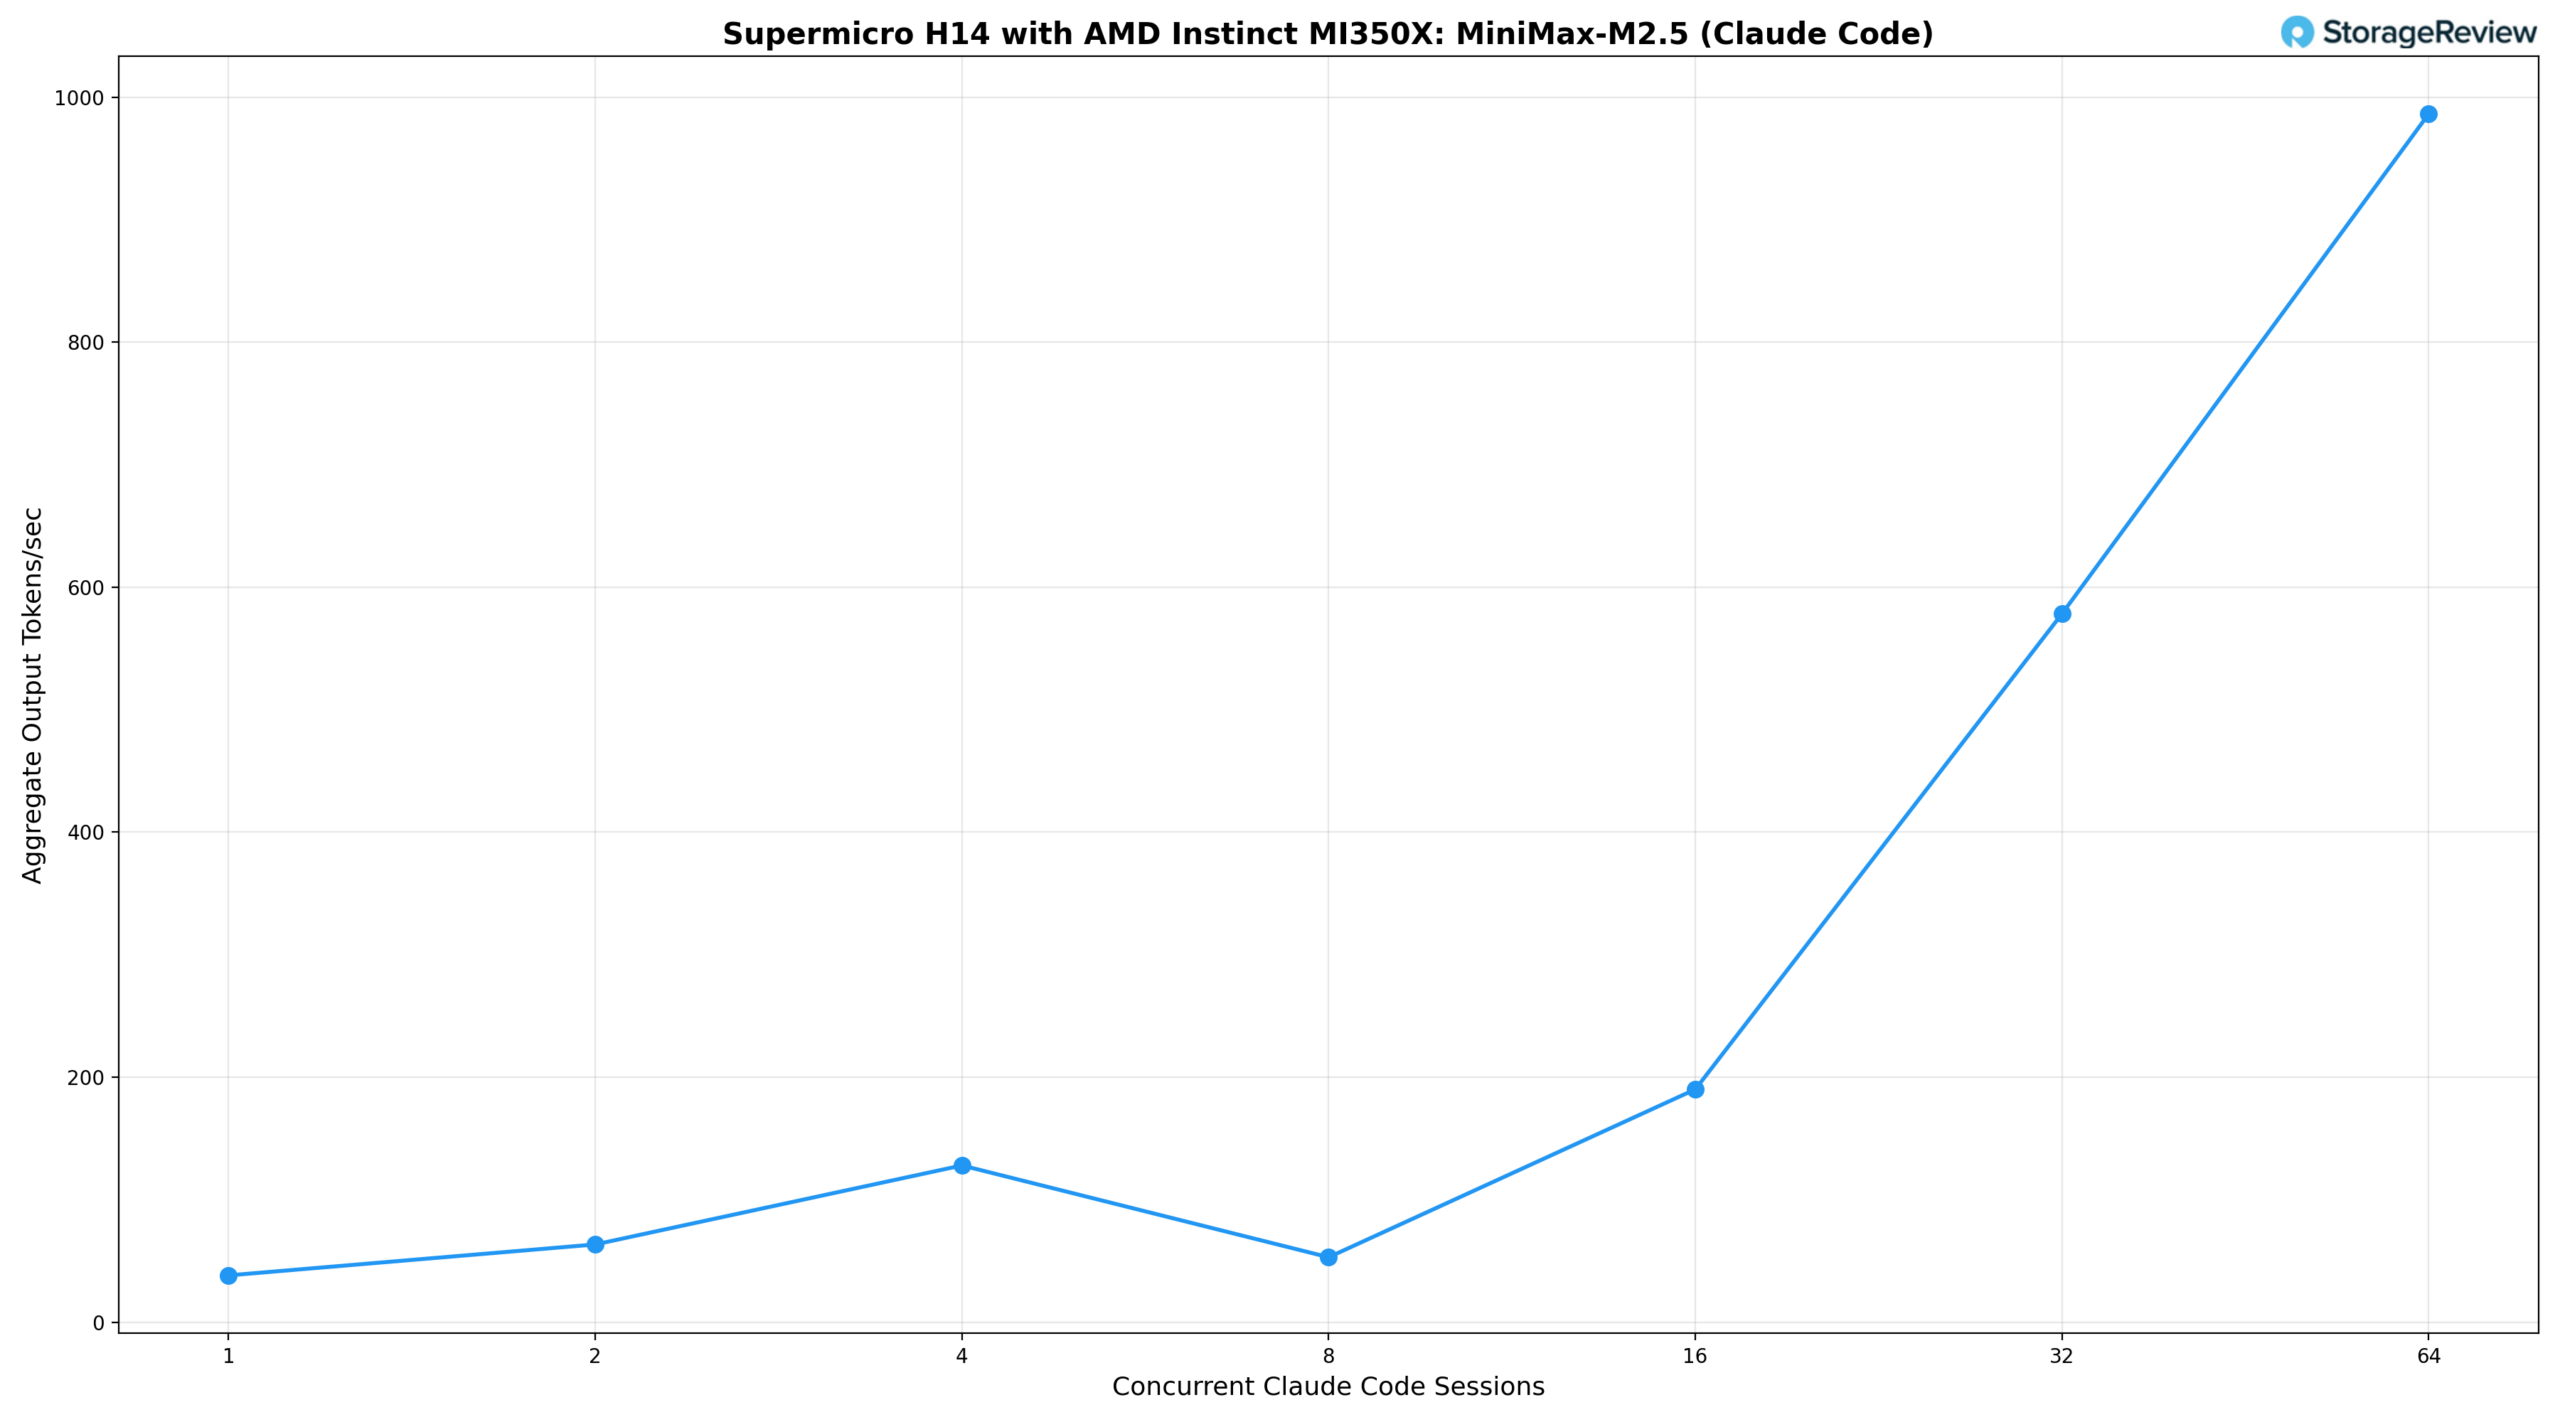
ရလဒ်များကိုကြည့်လျှင် တစ်ပြိုင်နက်တည်း session တစ်ခုသည် အသုံးပြုသူတစ်ဦးလျှင် tok/s ၃၈.၈ နှင့် စုစုပေါင်း ၃၈ tok/s ပေးစွမ်းနိုင်ပြီး OpenRouter cloud baseline ထက် အနည်းငယ်ပိုများသည်။ session နှစ်ခုတွင် vLLM ၏ batching သည် overhead ကို amortize လုပ်သောအခါ စနစ်သည် အသုံးပြုသူတစ်ဦးလျှင် tok/s ၃၉.၅ အထိ မြင့်တက်လာပြီး စုစုပေါင်း throughput သည် ၆၃ tok/s အထိ မြင့်တက်လာသည်။ တစ်ပြိုင်နက်တည်း session လေးခုကို အသုံးပြုသူတစ်ဦးလျှင် tok/s ၃၇.၃ ကျင်းပပြီး cloud baseline နှင့် ကိုက်ညီကာ developer လေးဦးကို တစ်ပြိုင်နက်တည်း ဝန်ဆောင်မှုပေးနေပြီး စုစုပေါင်း throughput သည် ၁၂၈ tok/s အထိ ရောက်ရှိသည်။ session ရှစ်ခုမှစ၍ instance တစ်ခုလျှင် throughput ကျဆင်းလာသည်- session ရှစ်ခုတွင် အသုံးပြုသူတစ်ဦးလျှင် tok/s ၃၄.၆၊ ၁၆ ခုတွင် tok/s ၃၁.၄ နှင့် စုစုပေါင်း tok/s ၁၉၀ ရှိပြီး session ၃၂ ခုနှင့် ၆၄ ခုတွင် အသုံးပြုသူတစ်ဦးလျှင် tok/s ၂၃ ခန့် တည်ငြိမ်သွားပြီး စုစုပေါင်း throughput သည် အသီးသီး ၅၇၈ tok/s နှင့် ၉၈၆ tok/s အထိ မြင့်တက်သွားသည်။ ဒါက batching-throughput-versus-interactivity trade-off ရိုးရာနည်းလမ်းပါ။ စနစ်ဟာ request တွေကို batching လုပ်ခြင်းအားဖြင့် total throughput ကို သိသိသာသာ မြင့်မားစွာ ရရှိနိုင်ပေမယ့် user တစ်ဦးချင်းစီဟာ response time နှေးကွေးတာကို ကြုံတွေ့ရပါတယ်။ တစ်ပြိုင်နက်တည်း user ၆၄ ယောက်မှာတောင် developer တစ်ဦးချင်းစီဟာ cloud baseline ထက် သိသိသာသာ နှေးကွေးပေမယ့် အသုံးပြုနိုင်တဲ့ interactive experience ကို မြင်တွေ့ရဆဲပါ။
တစ်ပြိုင်နက်တည်း စီးပွားဖြစ် API စာရင်းသွင်းမှု ဒါဇင်ပေါင်းများစွာ၏ ကုန်ကျစရိတ်ကို self-hosted infrastructure နှင့် နှိုင်းယှဉ်စဉ်းစားနေသော အဖွဲ့အစည်းများအတွက်၊ အပေးအယူလုပ်ရန် လိုအပ်ချက်မှာ ရှင်းပါသည်- MI350X node တစ်ခုတည်းသည် အင်ဂျင်နီယာ ၁၆ ဦးမှ ၃၂ ဦးအထိ ပါဝင်သော ဖွံ့ဖြိုးတိုးတက်ရေးအဖွဲ့ကို ဝန်ဆောင်မှုပေးနိုင်ပြီး cloud baseline ၏ 60-85% အတွင်း အသုံးပြုသူတစ်ဦးချင်းစီ၏ တုံ့ပြန်မှုအမြန်နှုန်းကို ထိန်းသိမ်းထားနိုင်သည့်အပြင် စုစုပေါင်း output ကို 600 မှ 1,000 tok/s အထိ ပေးစွမ်းနိုင်ပြီး data locality၊ per-token API အခကြေးငွေများ မရှိခြင်းနှင့် မော်ဒယ်ရွေးချယ်မှုကို အပြည့်အဝထိန်းချုပ်နိုင်ခြင်းတို့၏ အကျိုးကျေးဇူးများ ထပ်လောင်းရရှိထားသည်။
vLLM အွန်လိုင်းဝန်ဆောင်မှု – LLM ကောက်ချက်ချမှုစွမ်းဆောင်ရည်
vLLM သည် LLM များအတွက် အလွန်ရေပန်းစားသော high-throughput inference နှင့် serving engine များထဲမှ တစ်ခုဖြစ်သည်။ vLLM အွန်လိုင်း serving benchmark သည် concurrent request များအောက်တွင် ဤ inference engine ၏ လက်တွေ့ကမ္ဘာ serving စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည်။ ၎င်းသည် request rate၊ input/output အရှည်များနှင့် concurrent client အရေအတွက်ကဲ့သို့သော configure လုပ်နိုင်သော parameter များဖြင့် လည်ပတ်နေသော vLLM server သို့ request များပေးပို့ခြင်းဖြင့် production workloads များကို simulate လုပ်သည်။ benchmark သည် throughput (တစ်စက္ကန့်လျှင် token များ)၊ ပထမဆုံး token မှအချိန်နှင့် output token တစ်ခုလျှင်အချိန် (TPOT) အပါအဝင် အဓိက metric များကို တိုင်းတာပြီး အသုံးပြုသူများ vLLM သည် မတူညီသော load condition များအောက်တွင် မည်သို့လုပ်ဆောင်သည်ကို နားလည်ရန် ကူညီပေးသည်။
ကျွန်ုပ်တို့သည် မတူညီသော concurrency profiles များအောက်တွင် throughput ကို အကဲဖြတ်ရန်အတွက် မတူညီသော architectures၊ parameter scales နှင့် quantization strategies များကို လွှမ်းခြုံထားသော မော်ဒယ်အစုံတစ်လျှောက် inference performance ကို စမ်းသပ်ခဲ့ပါသည်။
GPT-OSS 120B နှင့် 20B
GPT-OSS မော်ဒယ်မိသားစုကို Supermicro H14 တွင် 120B နှင့် 20B ပုံစံနှစ်မျိုးလုံးဖြင့် စမ်းသပ်ခဲ့သည်။
GPT-OSS 120B
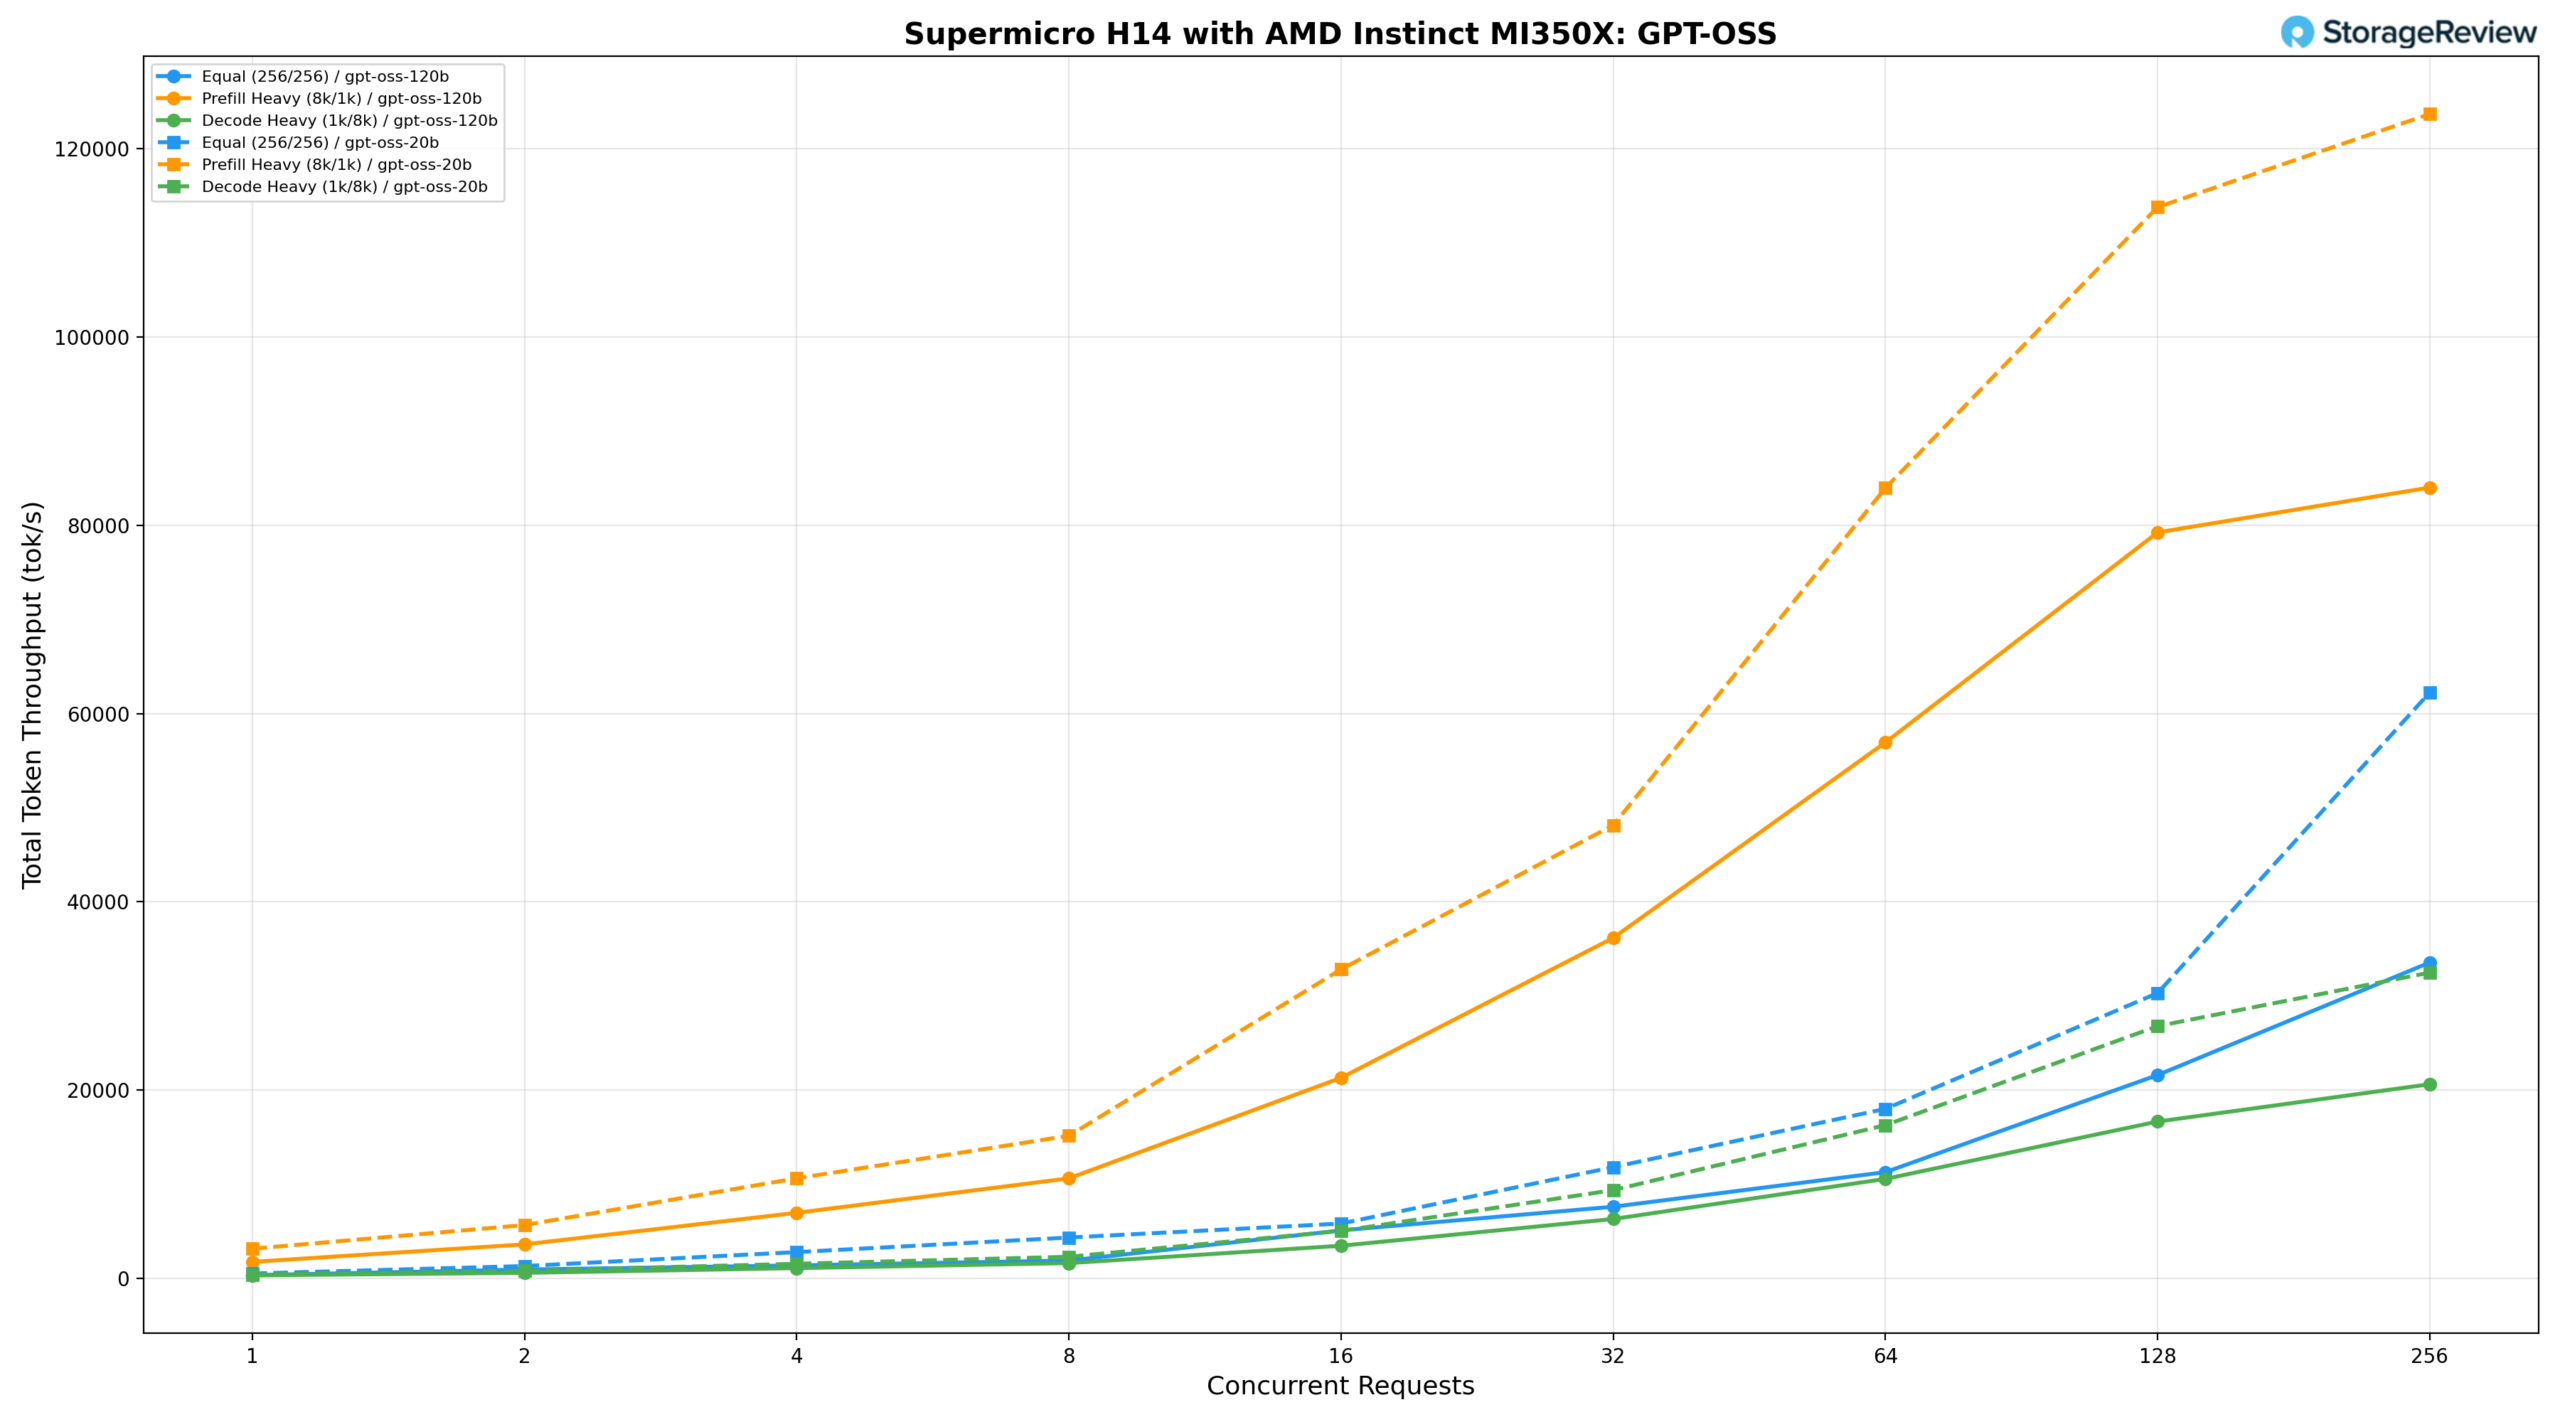
တူညီသော workload (၂၅၆/၂၅၆) အောက်ရှိ 120B မော်ဒယ်သည် BS=1 တွင် 313.42 tok/s ပေးစွမ်းပြီး BS=64 တွင် 11,261.72 tok/s ရောက်ရှိကာ BS=256 တွင် 33,538.23 tok/s တွင် အမြင့်ဆုံးရောက်ရှိပါသည်။ Prefill-heavy (8k/1k) သည် 1,724.84 tok/s မှစတင်၍ BS=32 တွင် 36,156.80 tok/s နှင့် BS=128 တွင် 79,247.76 tok/s အထိ မြင့်တက်ပြီး BS=256 တွင် 84,018.79 tok/s တွင် အမြင့်ဆုံးရောက်ရှိပါသည်။ Decode-heavy (1k/8k) သည် BS=1 တွင် 288.90 tok/s မှ BS=256 တွင် 20,602.52 tok/s အထိ မြင့်တက်လာပြီး concurrency အဆင့်နိမ့်များတွင် latency ကို ကောင်းစွာထိန်းချုပ်ထားဆဲဖြစ်သည်။
GPT-OSS 20B
20B မော်ဒယ်သည် တူညီသော workload အောက်တွင် BS=1 တွင် 485.17 tok/s ရရှိပြီး BS=64 တွင် 17,986.36 tok/s ရောက်ရှိကာ BS=256 တွင် 62,247.52 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိသည်။ Prefill-heavy သည် 3,120.72 tok/s မှစတင်၍ BS=32 တွင် 48,132.52 tok/s နှင့် BS=64 တွင် 83,968.71 tok/s အထိ မြင့်တက်ပြီး BS=256 တွင် 123,714.50 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိသည်—မော်ဒယ်အရွယ်အစားနှစ်ခုလုံးတွင် မှတ်တမ်းတင်ထားသော အမြင့်ဆုံး absolute prefill throughput ဖြစ်သည်။ BS=1 တွင် Decode-heavy သည် 378.20 tok/s မှ BS=256 တွင် 32,468.67 tok/s အထိ တိုးလာပြီး အမြင့်ဆုံး တစ်ပြိုင်နက်တည်းတွင် 120B ၏ decode throughput ၏ 1.6x ခန့်ကို ပေးစွမ်းနိုင်သော်လည်း latency လက္ခဏာများကို တစ်လျှောက်လုံး ပိုမိုတင်းကျပ်စွာ ထိန်းသိမ်းထားနိုင်သည်။
Qwen3 Coder 30B A3B ညွှန်ကြားချက်နှင့် FP8 ညွှန်ကြားချက်
Supermicro H14 ရှိ Qwen3-Coder-30B-A3B-Instruct ကို စံ (BF16) နှင့် FP8 တိကျမှုနှစ်ခုလုံးတွင် စမ်းသပ်ခဲ့သည်။
Qwen3-Coder-30B-A3B-ညွှန်ကြားချက် (BF16)
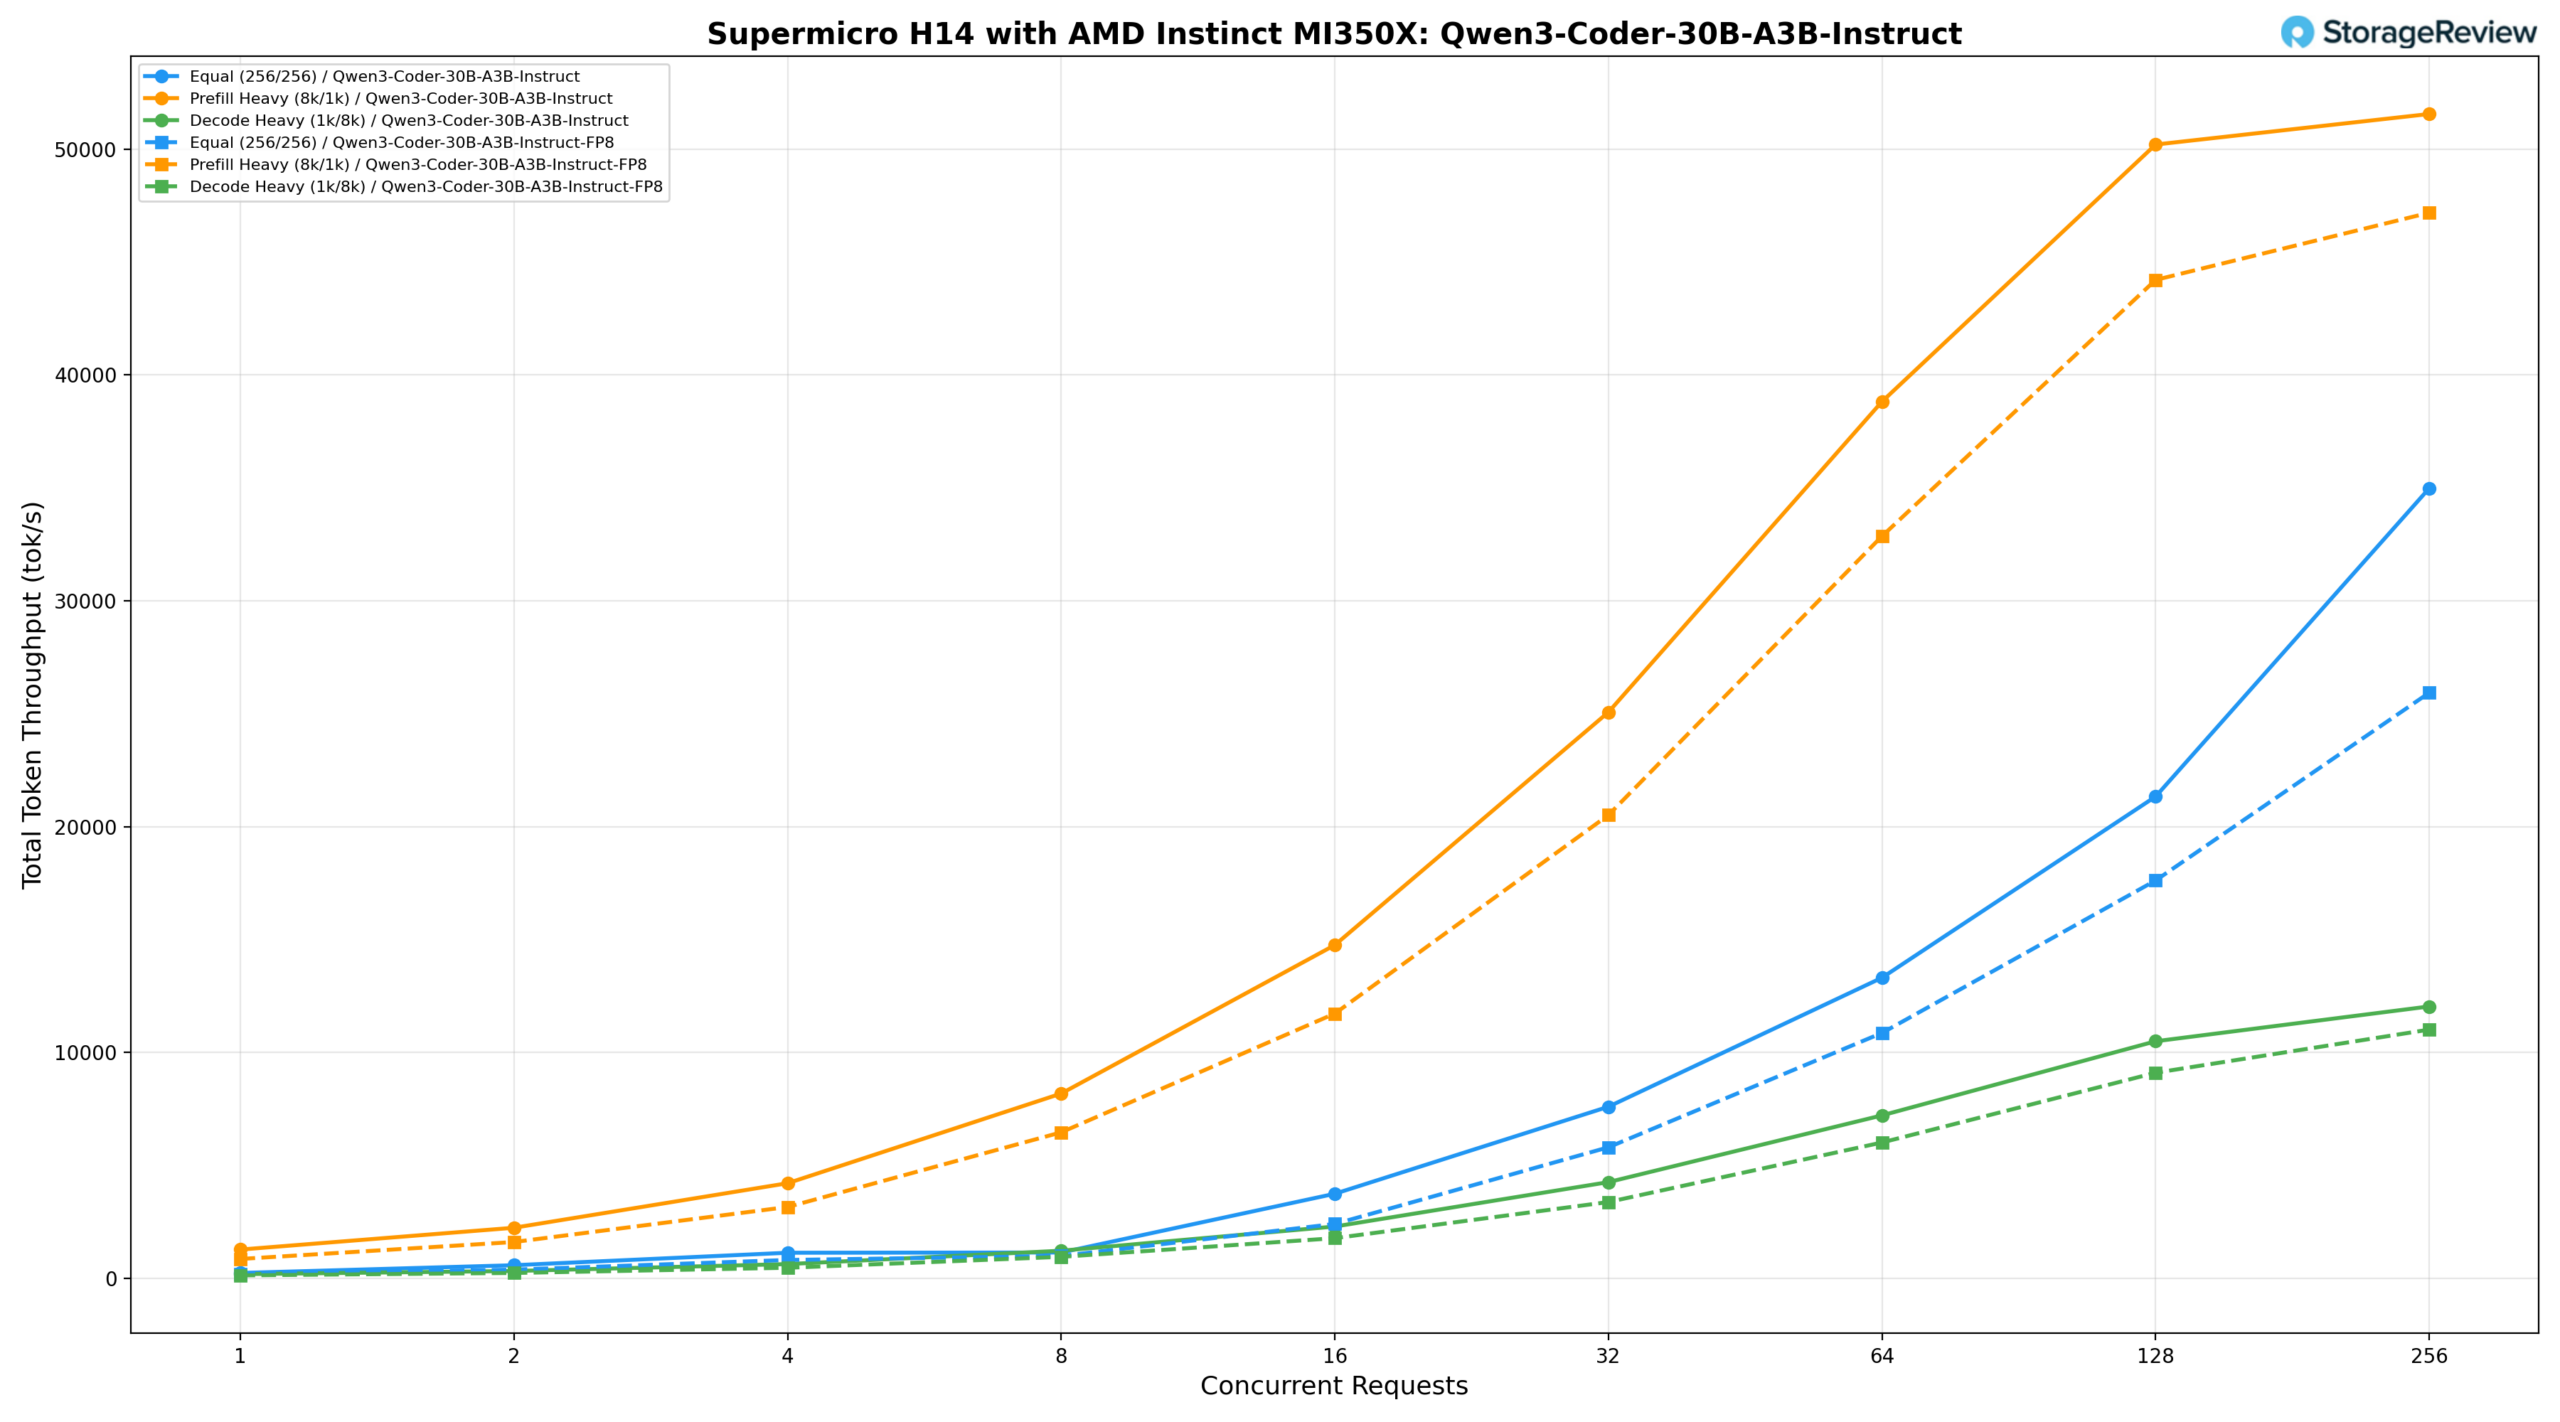
BF16 တွင်၊ ညီမျှသော workload (256/256) သည် BS=1 တွင် 240.53 tok/s ကို ပေးစွမ်းပြီး BS=64 တွင် 13,312.70 tok/s နှင့် BS=128 တွင် 21,333.79 tok/s အထိ ရောက်ရှိကာ BS=256 တွင် အမြင့်ဆုံး throughput 34,980.97 tok/s ရှိခဲ့သည်။ Prefill-heavy (8k/1k) သည် 1,276.76 tok/s မှစတင်၍ BS=32 တွင် 25,069.32 tok/s နှင့် BS=128 တွင် 50,198.94 tok/s အထိ မြင့်တက်ပြီး BS=256 တွင် 51,550.66 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့သည်။ Decode-heavy (1k/8k) သည် BS=1 တွင် ခန့်မှန်းခြေအားဖြင့် 188 tok/s မှ BS=256 တွင် 11,782 tok/s အထိ တဖြည်းဖြည်း တိုးလာပြီး အခြေအနေသုံးခုတွင် အတင်းကျပ်ဆုံး latency profile ကို ထိန်းသိမ်းထားပါသည်။
Qwen3-Coder-30B-A3B-ညွှန်ကြားချက် (FP8)
FP8 မျိုးကွဲသည် တူညီသော workload အောက်တွင် BS=1 တွင် 188.92 tok/s ကို ပေးစွမ်းနိုင်ပြီး BS=64 တွင် 10,866.27 tok/s နှင့် BS=128 တွင် 17,617.60 tok/s အထိ ရောက်ရှိကာ BS=256 တွင် 25,928.77 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိပြီး BF16 ရလဒ်များထက် အနည်းငယ်နောက်ကျနေပါသည်။ Prefill-heavy သည် 860.07 tok/s မှစတင်၍ BS=32 တွင် 20,513.77 tok/s နှင့် BS=128 တွင် 44,205.46 tok/s အထိ မြင့်တက်ကာ BS=256 တွင် 47,179.15 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိပါသည်။ Decode-heavy သည် BS=1 တွင် 133.79 tok/s မှ BS=256 တွင် 11,014.95 tok/s အထိ တိုးလာပြီး အဆက်မပြတ် တိုးချဲ့နေပြီး တစ်လျှောက်လုံး BF16 အနီးတွင် ရှိနေပါသည်။
Mistral Small 3.1 24B ညွှန်ကြားချက် ၂၅၀၃
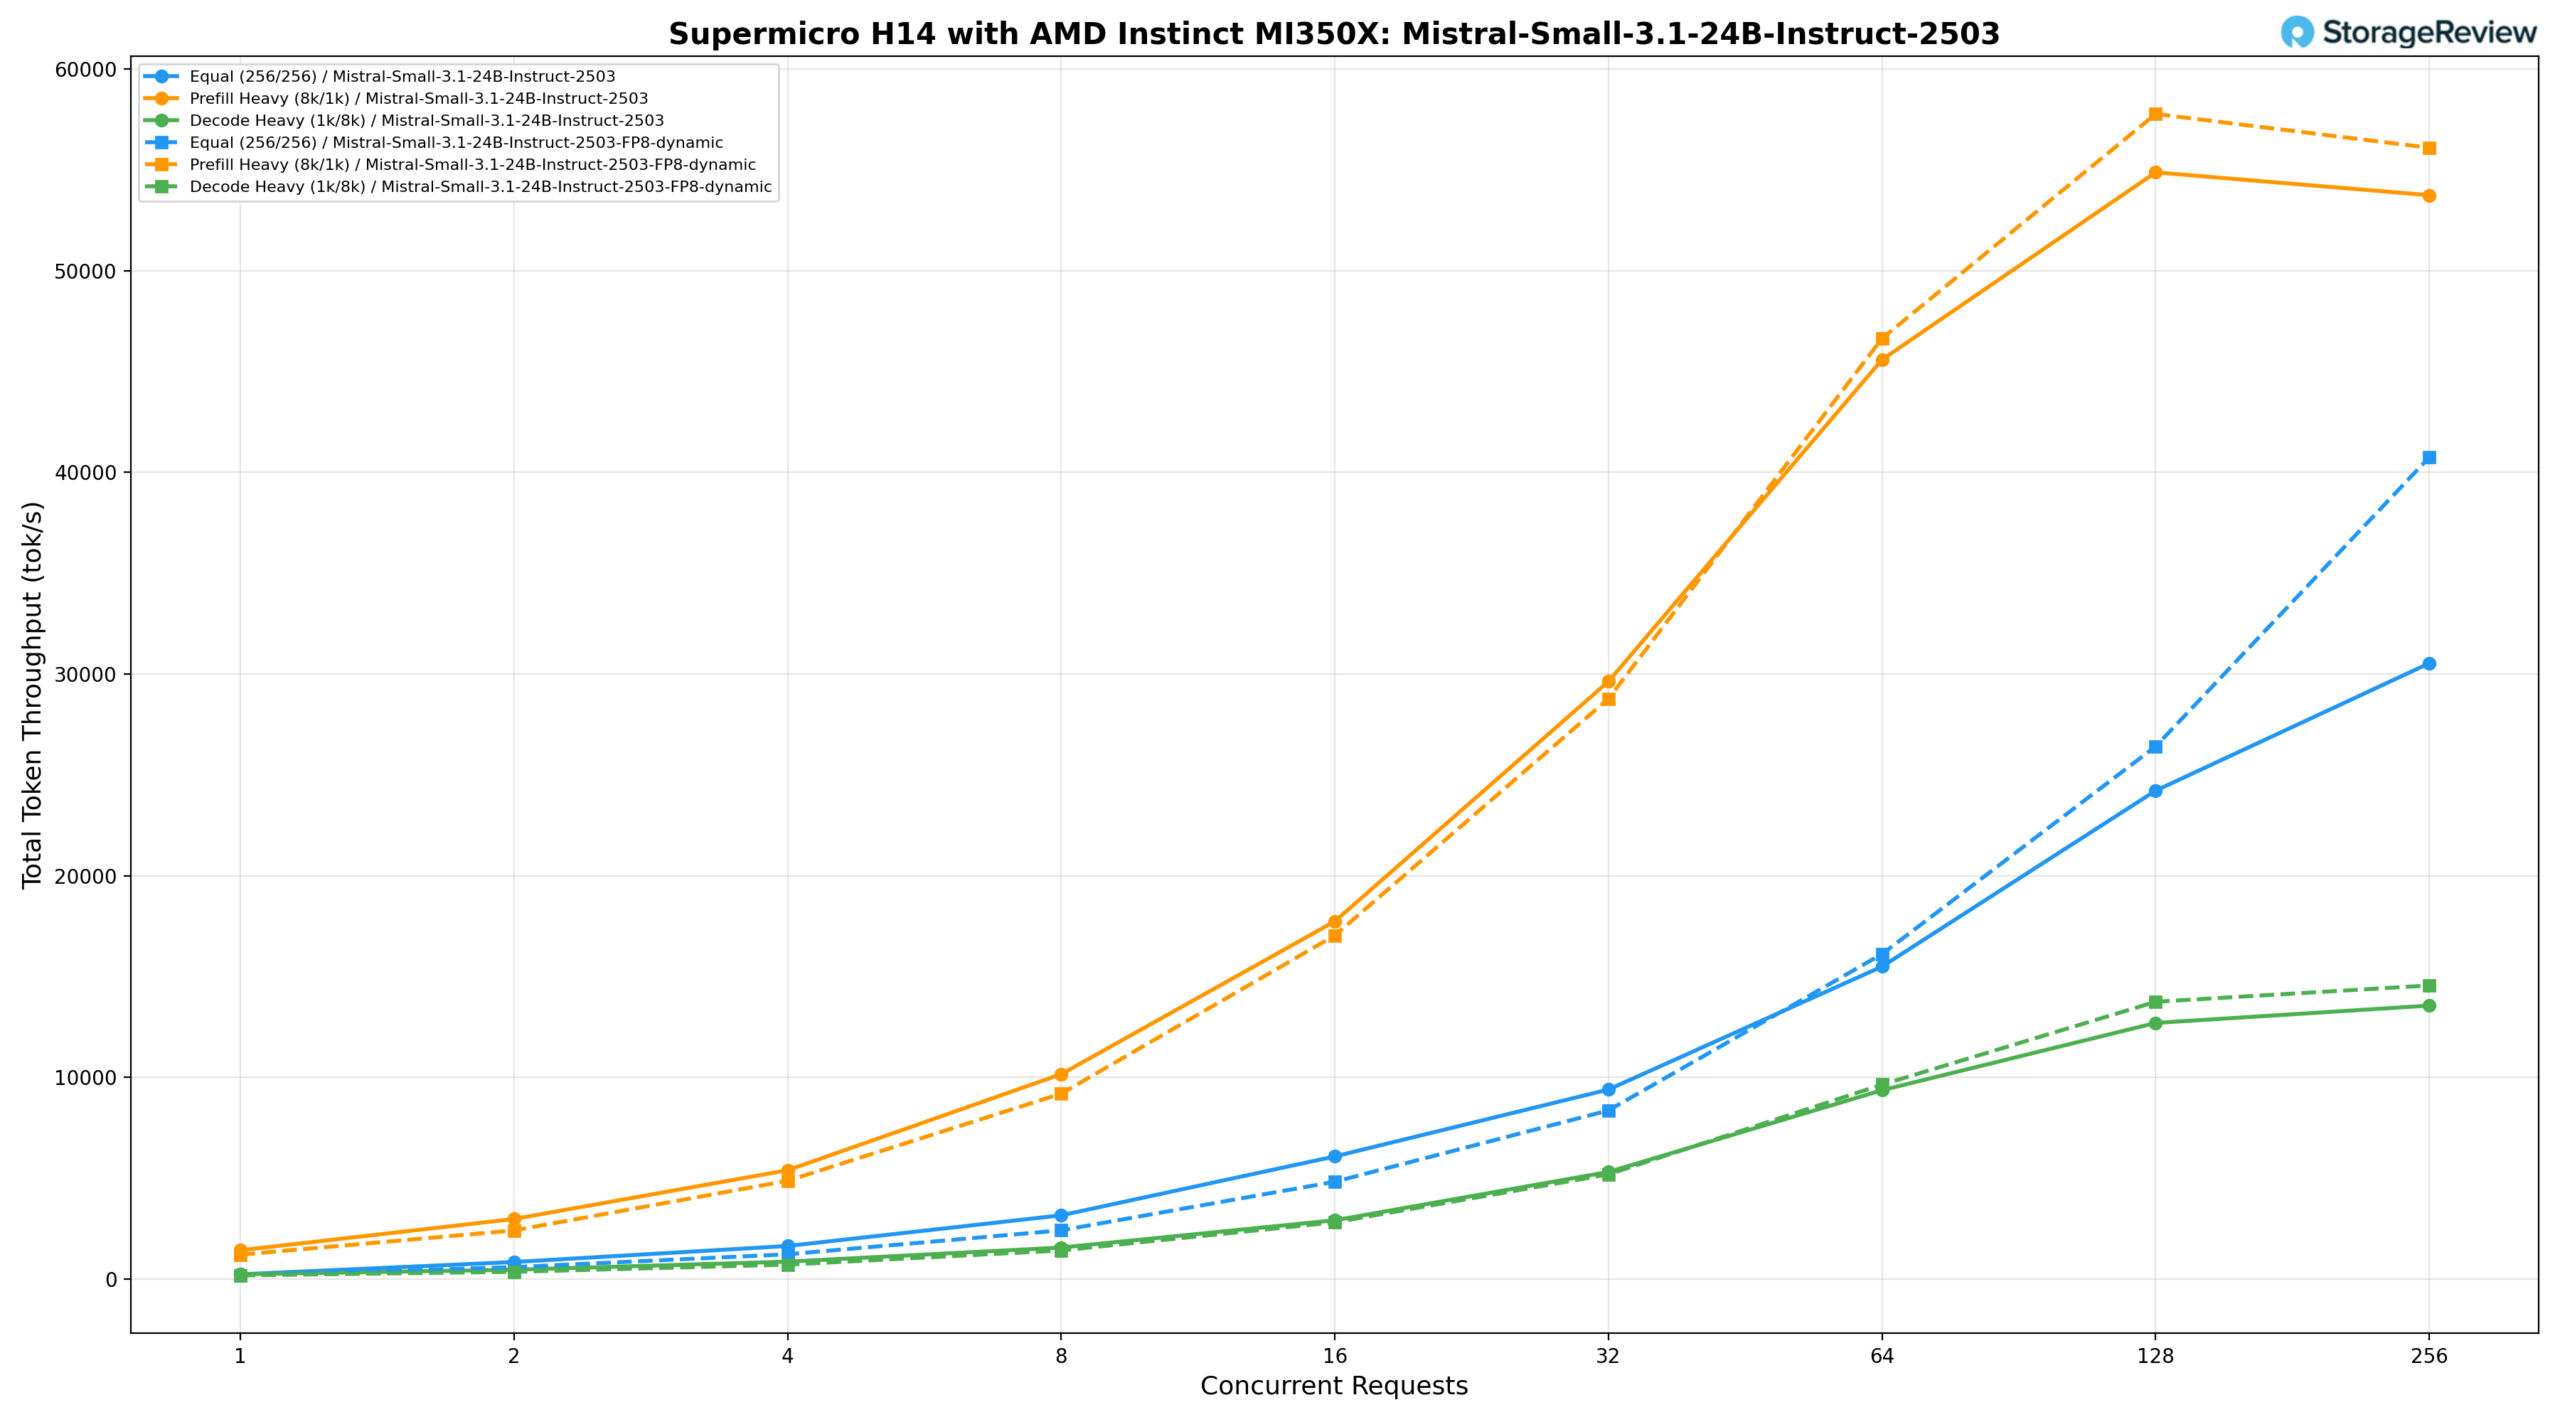
H14 ရှိ Mistral-Small-3.1-24B-Instruct-2503 ကို စံနှင့် FP8-dynamic တိကျမှု နှစ်မျိုးလုံးဖြင့် စမ်းသပ်ခဲ့ပြီး workload profile သုံးခုလုံးတွင် တသမတ်တည်း scaling ကို ပြသခဲ့သည်။
Mistral-Small-3.1-24B-Instruct-2503 (BF16)
BF16 တိကျမှုဖြင့်၊ ညီမျှသော workload (၂၅၆/၂၅၆) သည် BS=၁ တွင် ၂၃၆.၁၅ tok/s ထုတ်ပေးပြီး BS=၆၄ တွင် ၁၅,၄၉၄.၅၆ tok/s၊ BS=၁၂၈ တွင် ၂၄,၂၁၆.၅၂ tok/s ရောက်ရှိကာ BS=၂၅၆ တွင် ၃၀,၅၃၀.၅၄ tok/s တွင် အမြင့်ဆုံးရောက်ရှိသည်။ Prefill-heavy (၈k/၁k) သည် ၁,၄၂၉.၄၁ tok/s မှစတင်၍ BS=၃၂ တွင် ၂၉,၆၃၁.၆၈ tok/s နှင့် BS=၁၂၈ တွင် ၅၄,၈၇၁.၇၄ tok/s အထိ မြင့်တက်ပြီး BS=၂၅၆ တွင် ၅၃,၇၄၀.၀၄ tok/s တွင် အမြင့်ဆုံးရောက်ရှိသည်။ ဒီကုဒ်များစွာသုံး (1k/8k) သည် BS=1 တွင် 242.66 tok/s မှ BS=256 တွင် 13,559.19 tok/s အထိ မြင့်တက်လာပြီး အပြည့်အဝအကွာအဝေးတွင် တဖြည်းဖြည်း မြင့်တက်လာပါသည်။
Mistral-Small-3.1-24B-Instruct-2503 (FP8-dynamic)
FP8-dynamic variant သည် တူညီသော workload အောက်တွင် BS=1 တွင် 184.25 tok/s ကို ပေးစွမ်းပြီး BS=64 တွင် 16,113.95 tok/s နှင့် BS=128 တွင် 26,409.01 tok/s အထိ ရောက်ရှိကာ BS=256 တွင် 40,742.04 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့သည်။ Prefill-heavy သည် 1,210.06 tok/s မှစတင်၍ BS=32 တွင် 28,773.52 tok/s နှင့် BS=128 တွင် 57,765.02 tok/s အထိ မြင့်တက်ကာ BS=256 တွင် 56,093.09 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိကာ BS=64 မှစ၍ စံတိကျမှုရလဒ်ကို ဦးဆောင်နေသည်။ Decode-heavy သည် BS=1 တွင် 183.94 tok/s မှ BS=256 တွင် 14,557.94 tok/s အထိ တိုးလာပြီး BS=128 နှင့် BS=256 တွင် အနည်းငယ် ရှေ့သို့ ဆွဲယူခြင်းမပြုမီ အလယ်အလတ်အကွာအဝေးတစ်လျှောက် အနီးကပ် ခြေရာခံနေပါသည်။
Llama 3.1 8B ညွှန်ကြားချက်
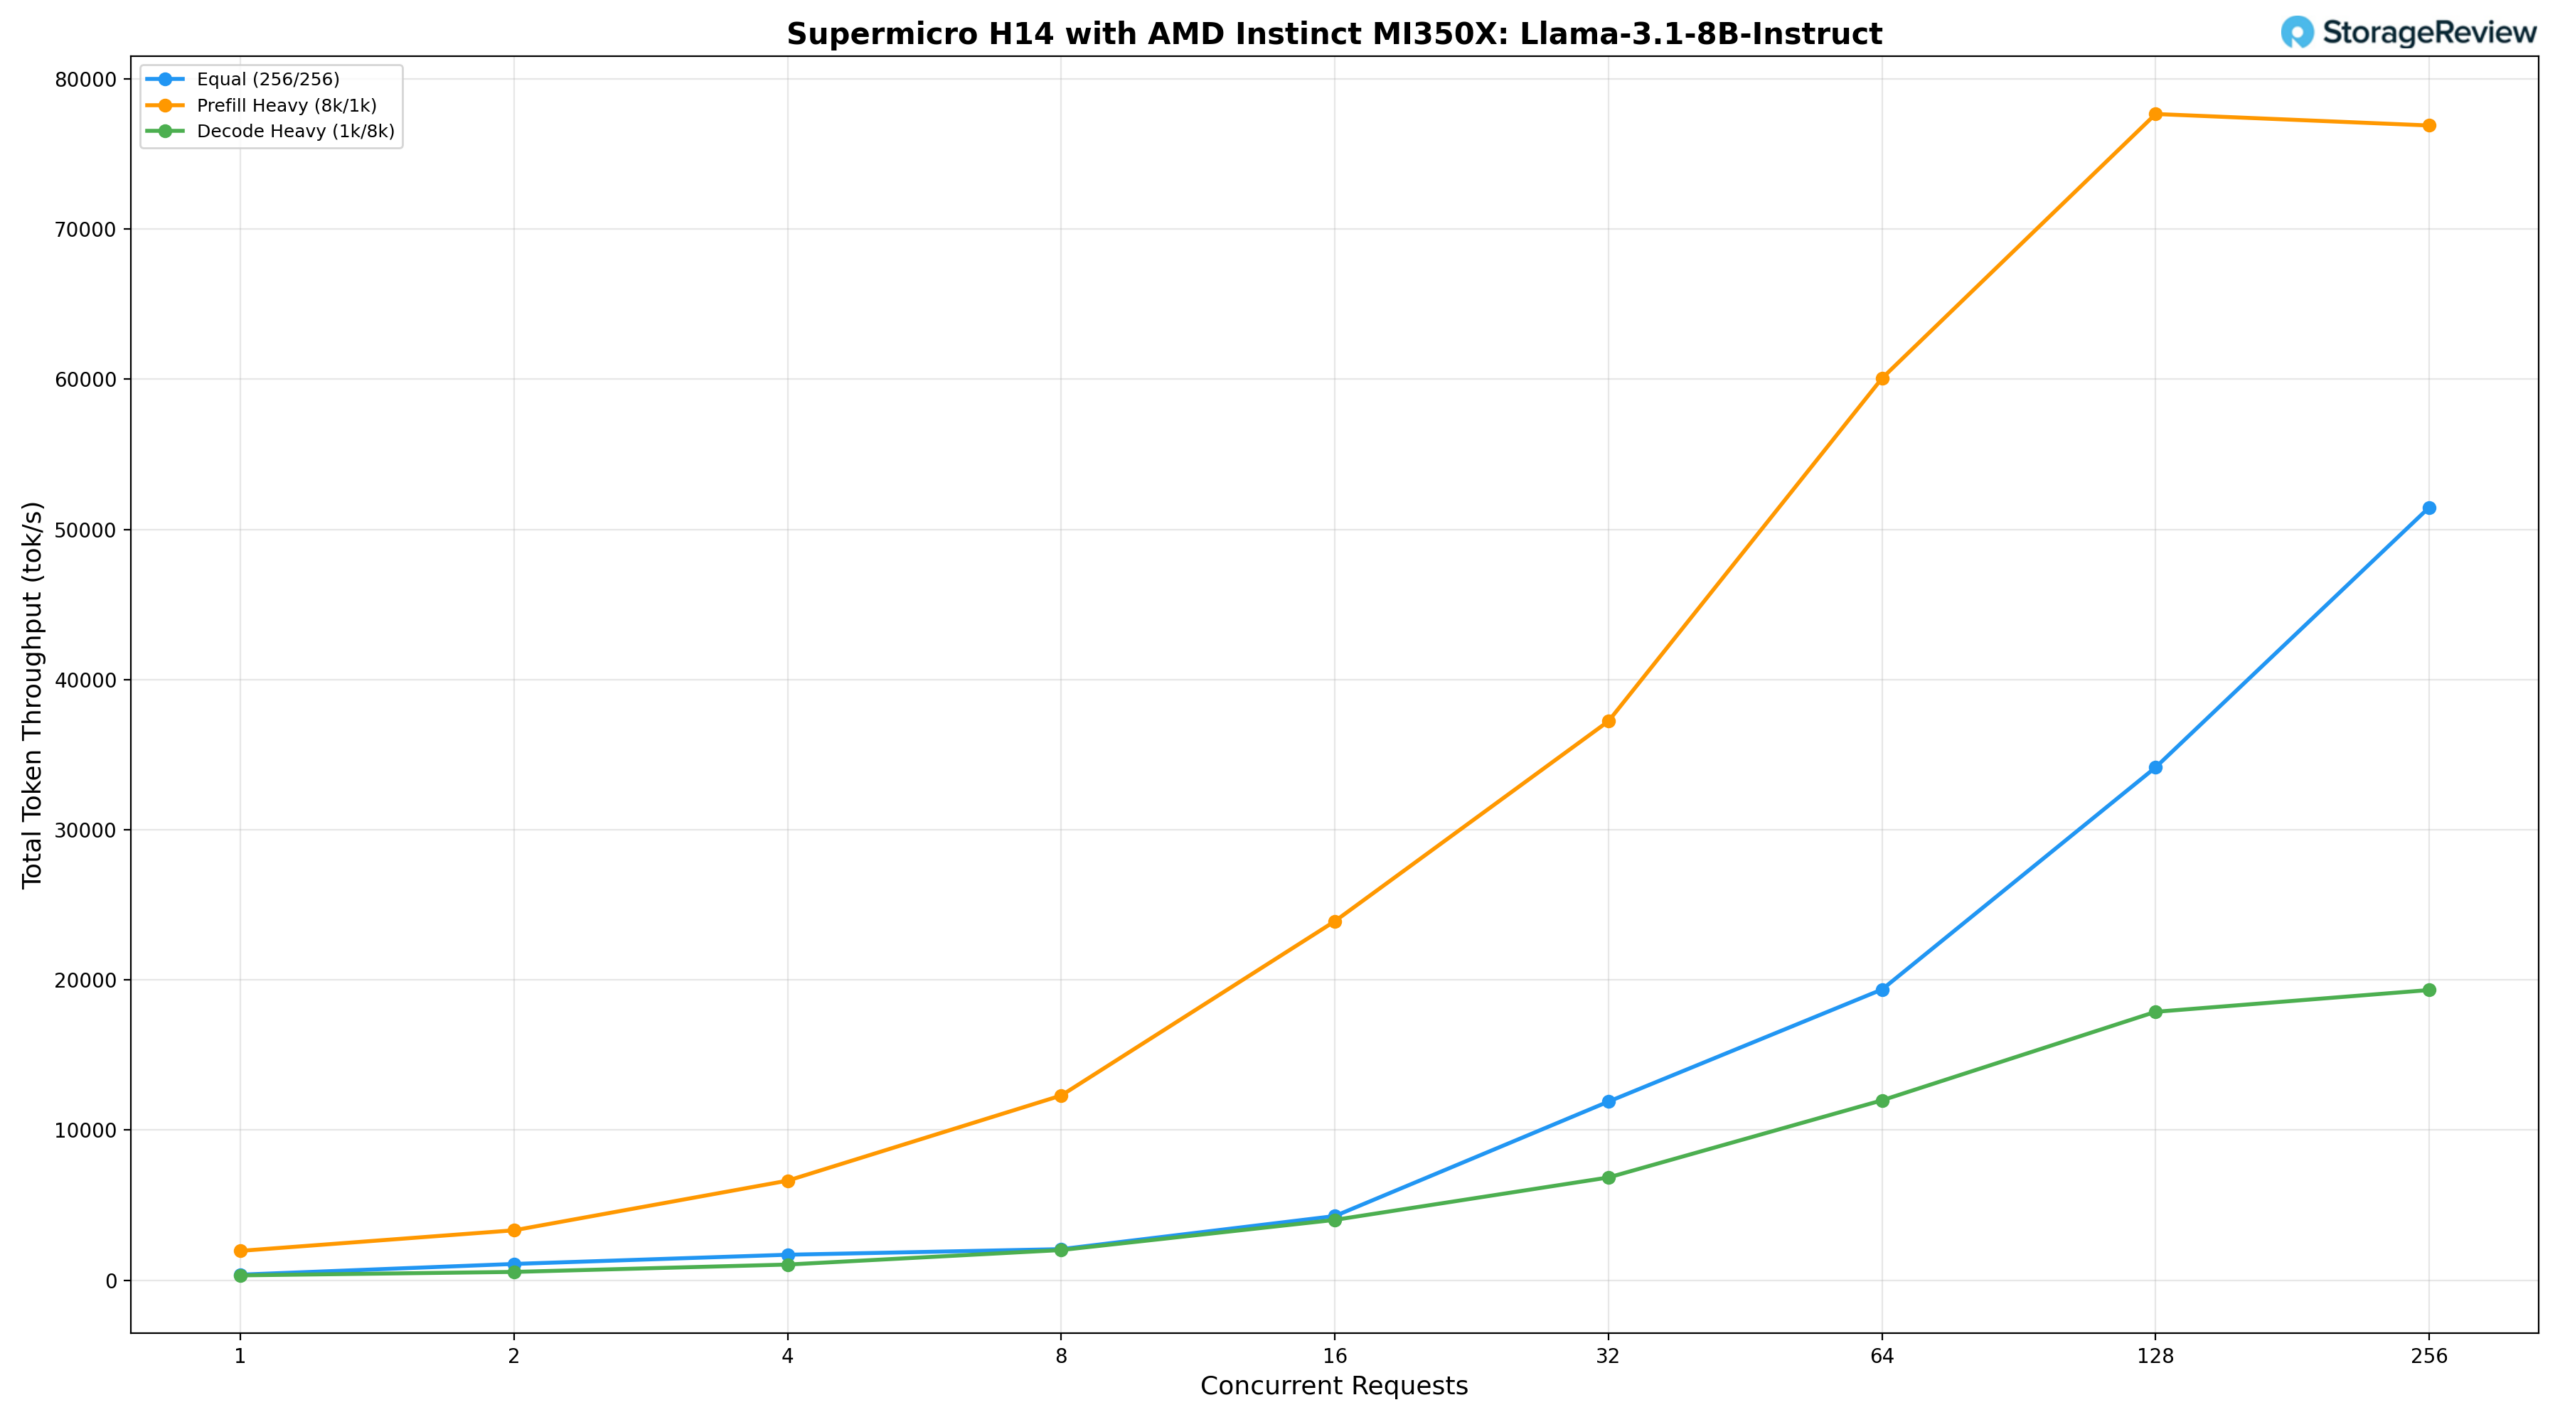
Llama-3.1-8B-Instruct အတွက်၊ ညီမျှသော workload (256/256) သည် BS=1 တွင် 373.26 tok/s ပေးစွမ်းပြီး BS=64 တွင် 19,363.33 tok/s၊ BS=128 တွင် 34,155.70 tok/s ရောက်ရှိကာ BS=256 တွင် 51,467.30 tok/s တွင် အမြင့်ဆုံးရောက်ရှိနေသည်ကို ကျွန်ုပ်တို့တွေ့မြင်ခဲ့ရသည်။ Prefill-heavy (8k/1k) သည် 1,959.04 tok/s မှစတင်၍ BS=32 တွင် 37,227.63 tok/s နှင့် BS=64 တွင် 60,062.40 tok/s အထိ မြင့်တက်ကာ BS=128 တွင် 77,658.50 tok/s တွင် အမြင့်ဆုံးရောက်ရှိပြီးနောက် BS=256 တွင် 76,893.77 tok/s အထိ အနည်းငယ်ကျဆင်းသွားခဲ့သည်။ Decode-heavy (1k/8k) သည် 326.48 tok/s မှစတင်၍ BS=128 တွင် 17,877.52 tok/s နှင့် BS=256 တွင် 19,326.35 tok/s အထိ ရောက်ရှိခဲ့ပြီး စမ်းသပ်ထားသော ပိုကြီးသော မော်ဒယ်များထက် concurrency range အတွင်းတွင်ပင် တိုကင်တစ်ခုလျှင် latency ကို နိမ့်ကျစေခဲ့သည်။
MiniMax M2.5
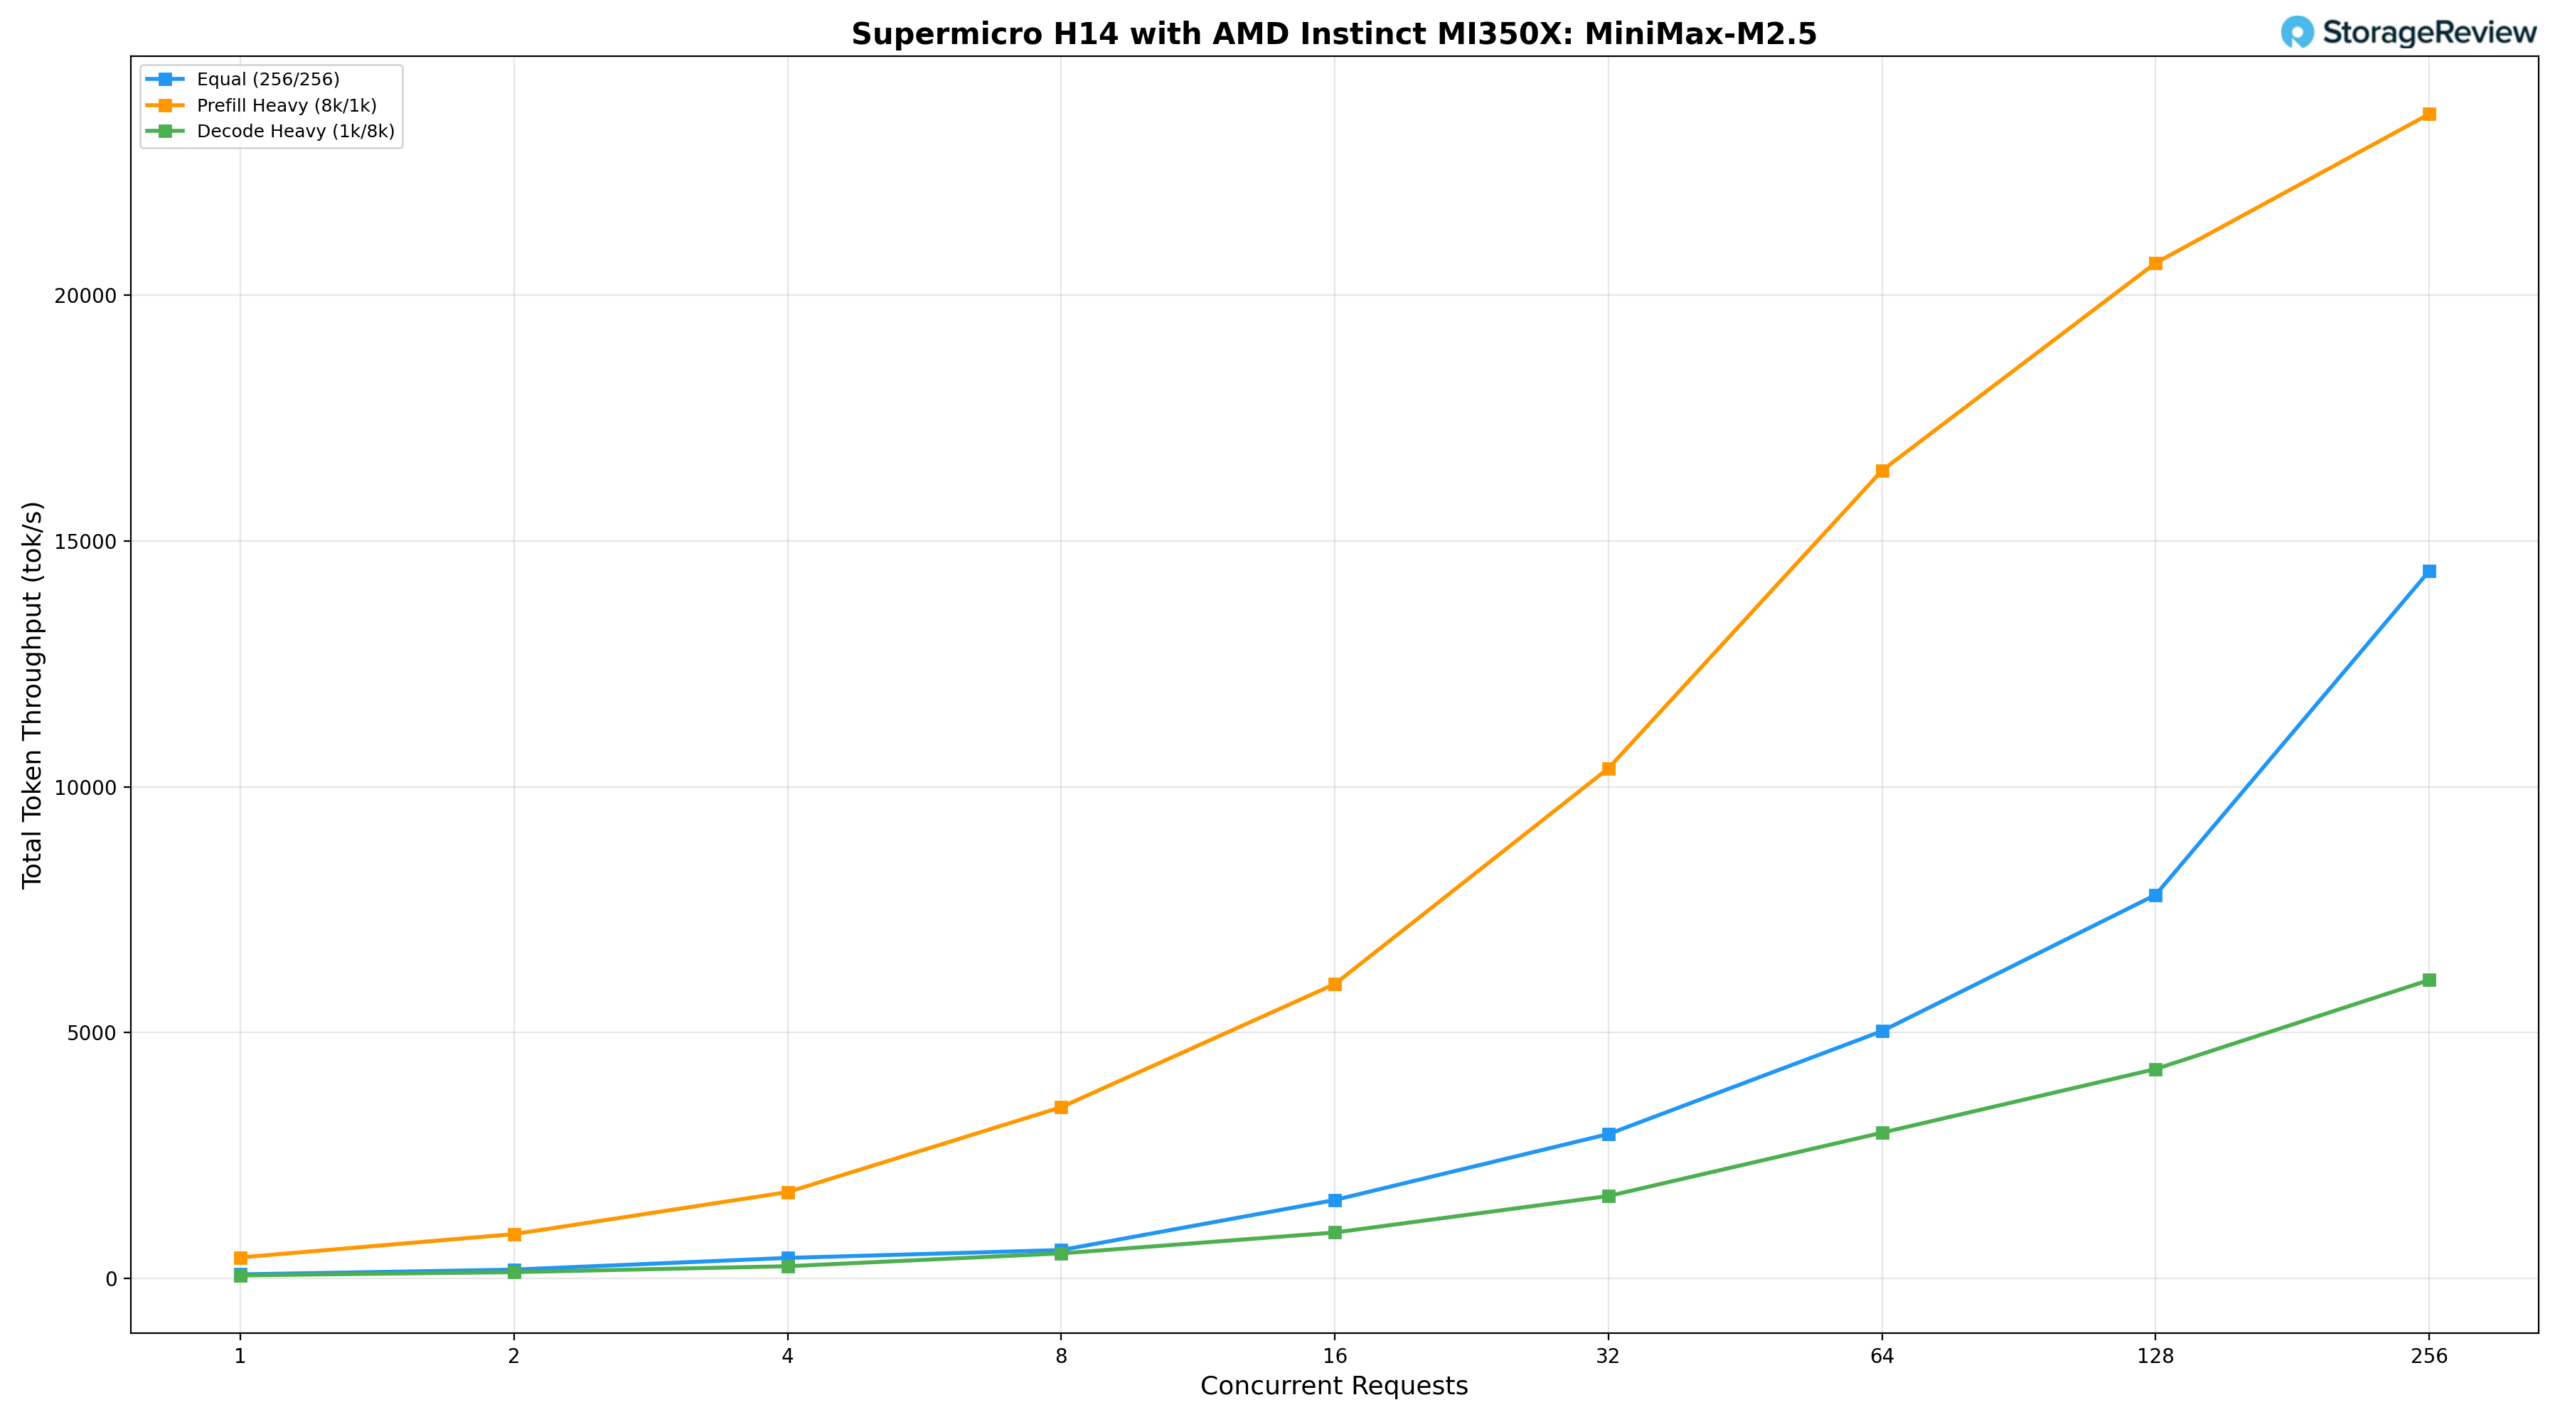
H14 ရှိ MiniMax-M2.5 သည် throughput profile အရ Kimi K2.5 နှင့် အလတ်စားမော်ဒယ်များကြားတွင် ရှိနေပြီး ၎င်း၏ ရောနှောထားသော ကျွမ်းကျင်သူဗိသုကာလက်ရာကို ထင်ဟပ်စေသော ဝိသေသလက္ခဏာများဖြင့် မော်ဒယ်လိုင်းကို ပြီးပြည့်စုံစေသည်။ ညီမျှသော workload (256/256) သည် BS=1 တွင် 79.31 tok/s ထုတ်ပေးပြီး BS=64 တွင် 5,029.76 tok/s၊ BS=128 တွင် 7,801.10 tok/s နှင့် BS=256 တွင် 14,391.98 tok/s အထိ ရောက်ရှိသည်။ Prefill-heavy (8k/1k) သည် အခြေအနေသုံးရပ်တွင် အားအကောင်းဆုံး scaling ကိုပြသပြီး BS=32 တွင် tok/s 424.41 မှစတင်၍ BS=128 တွင် 10,376.75 tok/s နှင့် BS=128 တွင် 20,658.57 tok/s အထိ မြင့်တက်လာကာ BS=256 တွင် 23,689.18 tok/s ဖြင့် အမြင့်ဆုံးရောက်ရှိခဲ့သည်။ Decode-heavy (1k/8k) သည် BS=128 တွင် 4,257.68 tok/s နှင့် BS=256 တွင် 6,068.70 tok/s အထိ တဖြည်းဖြည်း မြင့်တက်လာပြီး full concurrency range တစ်လျှောက်တွင် အတည်ငြိမ်ဆုံး latency growth ကို ပေးစွမ်းသည်။
ပါဝင်နေတဲ့ K2.5
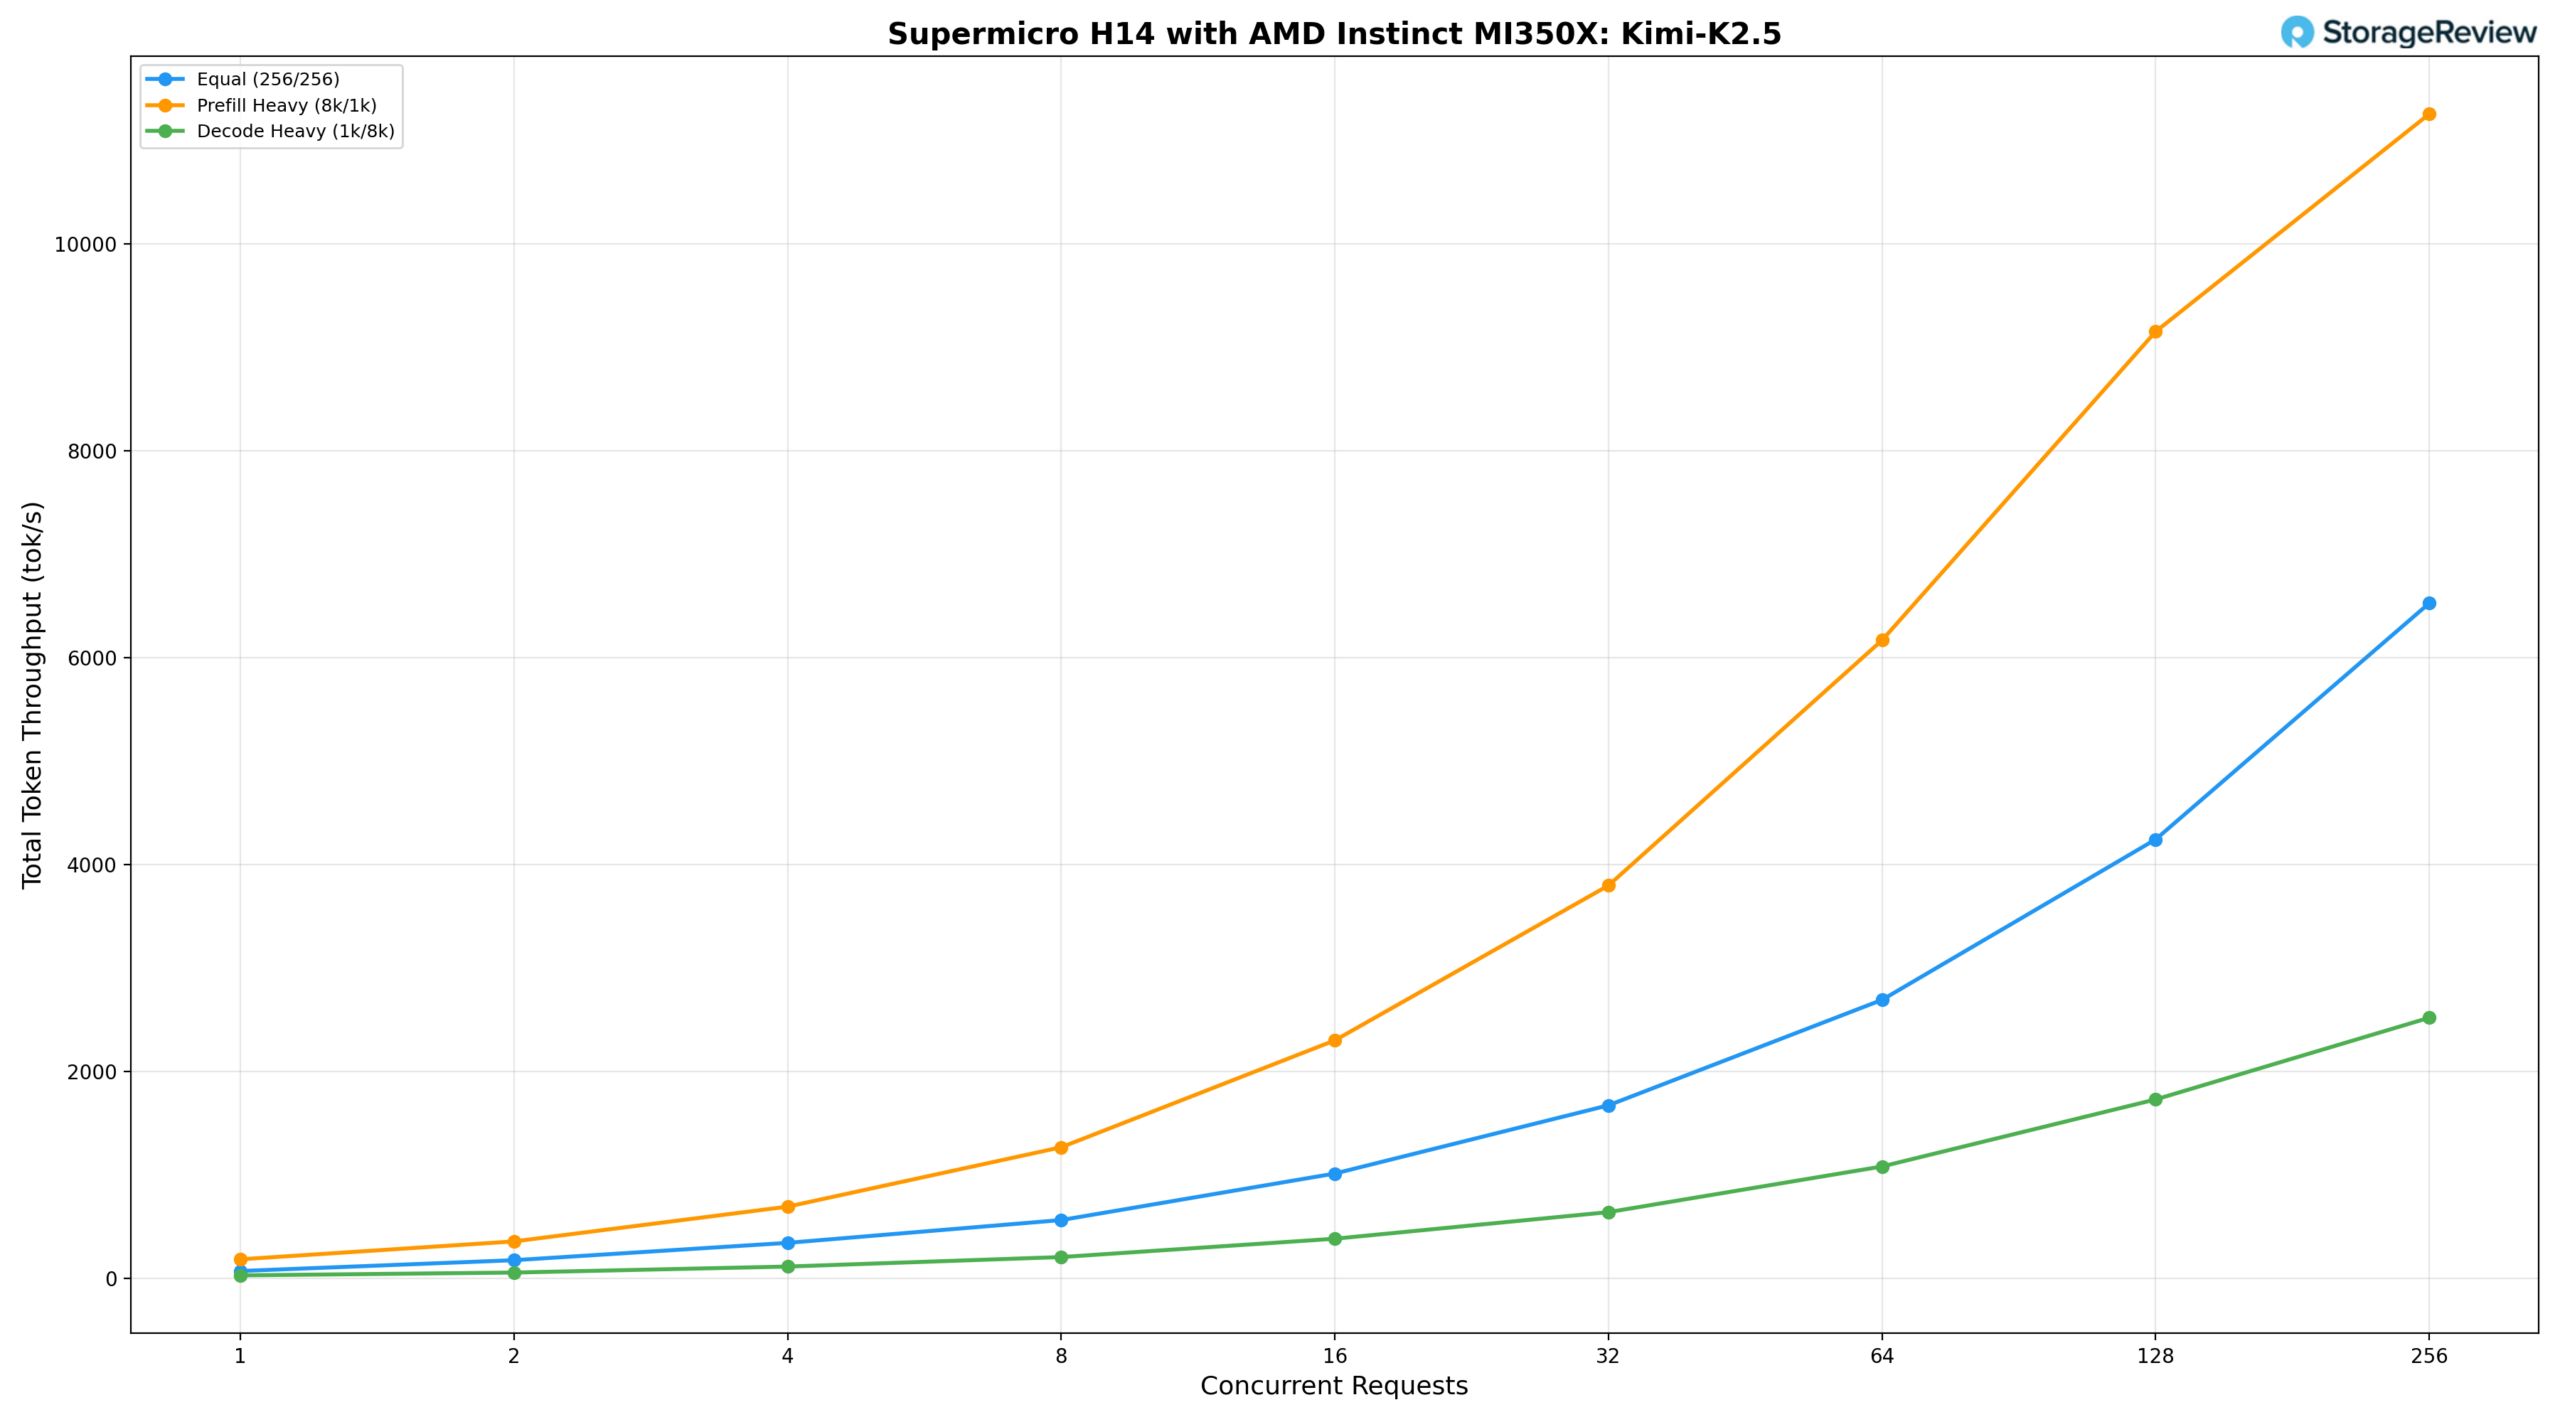
H14 ပေါ်ရှိ Kimi K2.5 1-trillion-parameter မော်ဒယ်သည် ဤသုံးသပ်ချက်တွင် စမ်းသပ်ထားသော အကြီးဆုံးနှင့် အစမတ်ဆုံး မော်ဒယ်ဖြစ်ပြီး ၎င်း၏ throughput သည် ထိုအလေးချိန်ကို ထင်ဟပ်စေသည်။
ညီမျှသော workload (၂၅၆/၂၅၆) သည် BS=၁ တွင် ၇၂.၀၆ tok/s ပေးစွမ်းပြီး BS=၆၄ တွင် ၂,၆၉၃.၀၇ tok/s၊ BS=၁၂၈ တွင် ၄,၂၄၄.၂၇ tok/s ရောက်ရှိကာ BS=၂၅၆ တွင် ၆,၅၂၇.၆၂ tok/s တွင် အမြင့်ဆုံးရောက်ရှိသည်။ Prefill-heavy (၈k/၁k) သည် ပိုမိုတက်ကြွစွာ တိုးချဲ့လာပြီး ၁၈၅.၂၉ tok/s မှစတင်၍ BS=၃၂ တွင် ၃,၇၉၈.၈၅ tok/s နှင့် BS=၁၂၈ တွင် ၉,၁၅၃.၁၂ tok/s ရောက်ရှိကာ BS=၂၅၆ တွင် အမြင့်ဆုံး throughput ၁၁,၂၅၆.၆၉ tok/s ရှိသည်။ BS=၁၂၈ မှ BS=၂၅၆ အထိ အဆင့်ဆင့်တိုးလာခြင်းသည် သိသာထင်ရှားသော latency cost ရှိပြီး ဤမော်ဒယ်အရွယ်အစားအတွက် စနစ်သည် batch depth အပြည့်တွင် ၎င်း၏ memory နှင့် compute limit များဆီသို့ နီးကပ်လာနေကြောင်း ညွှန်ပြသည်။ Decode-heavy (1k/8k) သည် BS=1 တွင် 29.88 tok/s မှ BS=256 တွင် 2,513.85 tok/s အထိ တိုးလာပြီး အခြေအနေသုံးခုတွင် အတင်းကျပ်ဆုံး scaling curve ကို ပေးစွမ်းနေစဉ်တွင် အကွာအဝေးတစ်ခုလုံးတွင် တသမတ်တည်း throughput တိုးတက်မှုများကို ပြသနေပါသည်။
ကောက်ချက်
AMD Instinct MI350X သည် ဤနေရာတွင် စမ်းသပ်ထားသော workload profile များတွင် အလွန်ယှဉ်ပြိုင်နိုင်သော inference စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ပြီး Supermicro AS-8126GS-TNMR သည် ၎င်းကို အခွင့်ကောင်းယူရန်အတွက် ကောင်းမွန်စွာ အင်ဂျင်နီယာထားသော platform တစ်ခုကို ပေးစွမ်းသည်။ accelerator တစ်ခုလျှင် HBM3e 288GB နှင့် Infinity Fabric မှတစ်ဆင့် ချိတ်ဆက်ထားသော GPU ရှစ်ခုဖြင့် node တစ်ခုတည်းတွင် ရရှိနိုင်သော aggregate GPU memory 2.3TB သည် Kimi K2.5 နှင့် MiniMax M2.5 ကဲ့သို့သော trillion-parameter မော်ဒယ်များကို multi-node ဖြန့်ဖြူးမှု သို့မဟုတ် model-partitioning workarounds များ မလိုအပ်ဘဲ ဝန်ဆောင်မှုပေးရန် လုံလောက်ပါသည်။ ဤစွမ်းရည်သည် ကြီးမားသော inference အတွက် deployment architecture ကို သိသိသာသာ ရိုးရှင်းစေသည်။
မော်ဒယ်ငယ်များသည်လည်း ခိုင်မာသောရလဒ်များကို ပေးဆောင်ခဲ့သည်။ Llama 3.1 8B သည် prefill-heavy workloads များအောက်တွင် 77,000 tok/s ကျော်လွန်ခဲ့ပြီး Mistral Small 3.1 24B နှင့် Qwen3 Coder 30B ကဲ့သို့သော အလယ်အလတ်တန်းစား ဗိသုကာများသည် တစ်ပြိုင်နက်တည်းအတိုင်းအတာတစ်လျှောက်တွင် ကောင်းစွာထိန်းချုပ်ထားသော latency ဖြင့် မြင့်မားသော throughput ကို ထိန်းသိမ်းခဲ့သည်။ အလုံးစုံသောရလဒ်များအရ၊ မြင့်မားသော batch depths တွင် ချောက်ကမ်းပါးမှ ပြုတ်ကျခြင်းထက် ဝန်အောက်တွင် ကြိုတင်ခန့်မှန်းနိုင်သော scale လုပ်နိုင်သော hardware platform တစ်ခုကို ညွှန်ပြနေသည်။
ROCm 7.2 သည် AMD inference software stack တွင် အထူးသဖြင့် vLLM 0.18 နှင့် တွဲဖက်အသုံးပြုသည့်အခါ သိသာထင်ရှားသော တိုးတက်မှုများကို ယူဆောင်လာပါသည်။ ဤတွဲဖက်အသုံးပြုခြင်းသည် ယခင် ROCm မျိုးဆက်များထက် ပိုမိုတည်ငြိမ်ပြီး စွမ်းဆောင်ရည်မြင့်မားသော ဝန်ဆောင်မှုအတွေ့အကြုံကို ပေးစွမ်းပြီး ပိုမိုကျယ်ပြန့်သော framework ပံ့ပိုးမှုနှင့် အစောပိုင်း Instinct ဖြန့်ကျက်မှုများကို သွင်ပြင်လက္ခဏာပြသော ကြမ်းတမ်းသောအနားသတ်များ နည်းပါးစေပါသည်။ AMD hardware နှင့်ပတ်သက်သည့် ဂေဟစနစ်၏ အရှိန်အဟုန်ကိုလည်း သတိပြုသင့်သည်- upstream vLLM သည် ယခုအခါ သီးသန့် AMD ROCm CI pipeline ကို ထိန်းသိမ်းထားပြီး Meta ၏ 6-gigawatt scale တွင် multi-generation ဖြန့်ကျက်မှုကတိကဝတ်သည် ထုတ်လုပ်မှုအတည်ပြုချက်သည် ထိန်းချုပ်ထားသော benchmarking ပတ်ဝန်းကျင်များထက် များစွာကျော်လွန်ကြောင်း အားဖြည့်ပေးပါသည်။
Claude Code ၏ အကဲဖြတ်မှုသည် raw throughput နံပါတ်များသို့ လက်တွေ့ကျသော မှန်ဘီလူးတစ်ခုကို ထည့်သွင်းပေးပါသည်။ MI350X node တစ်ခုတည်းသည် cloud-baseline နီးပါးတုံ့ပြန်မှုအမြန်နှုန်းကို တစ်ပြိုင်နက်တည်း coding session ၁၆ ခုအထိ ထိန်းသိမ်းထားနိုင်ပြီး တစ်ပြိုင်နက်တည်းအသုံးပြုသူ ၆၄ ဦးအထိနှင့် အပြန်အလှန်ဆက်သွယ်နိုင်ခဲ့ပြီး စုစုပေါင်း output ၁၀၀၀ tok/s နီးပါး ထုတ်လုပ်ပေးပါသည်။ self-hosted infrastructure နှင့် စီးပွားဖြစ် API subscriptions ၏ ကုန်ကျစရိတ်ကို ချိန်ဆနေသော အဖွဲ့အစည်းများအတွက်၊ data locality၊ per-token ကုန်ကျစရိတ်များကို ဖယ်ရှားခြင်းနှင့် ကန့်သတ်ချက်မရှိသော မော်ဒယ်ရွေးချယ်မှုတို့တွင် အပိုအားသာချက်များနှင့်အတူ စီးပွားရေးသည် ထိုသိပ်သည်းဆတွင် ရိုးရှင်းလာပါသည်။
Supermicro ရဲ့ JumpStart ပရိုဂရမ်ဟာ အခြေခံအဆောက်အအုံ အကဲဖြတ်လုပ်ငန်းစဉ်မှာ နေရာတစ်နေရာ ရရှိနေဆဲပါ။ ပံ့ပိုးပေးမှု အပိုကုန်ကျစရိတ်မရှိဘဲ ထုတ်လုပ်မှုဟာ့ဒ်ဝဲကို သတ္တုဖြင့် အလွယ်တကူ ဝင်ရောက်အသုံးပြုနိုင်ခြင်းက စမ်းသပ်မှုကာလတစ်လျှောက်လုံးမှာ လက်တွေ့အခြေအနေတွေအောက်မှာ တကယ့်အလုပ်ဝန်တွေကို လုပ်ဆောင်နိုင်စေခဲ့ပါတယ်။ Accelerator ဝယ်ယူမှု အကဲဖြတ်မှုတွေကို လုပ်ဆောင်နေတဲ့ အဖွဲ့တွေအတွက် ဒီလက်တွေ့ဝင်ရောက်ခွင့်အဆင့်ဟာ spec sheet နှိုင်းယှဉ်မှုတွေ ဒါမှမဟုတ် curated vendor demonstration တွေထက် အများကြီး ပိုအသိပေးစရာရှိပါတယ်။



 အမေဇုံ