

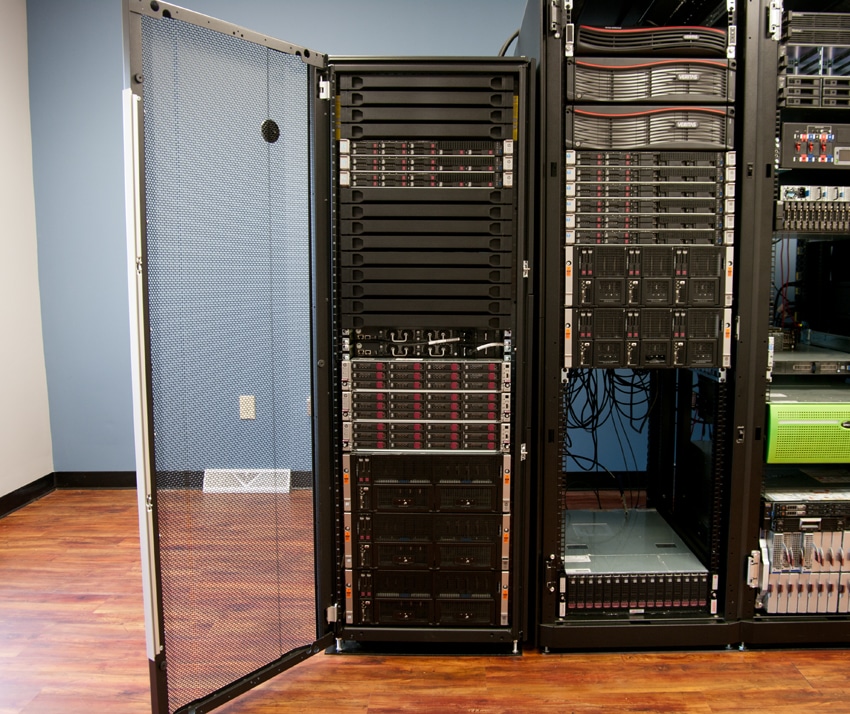
SUSE Enterprise Storage သည် Ceph မှ စွမ်းအားပေးသော software-defined storage solution တစ်ခုဖြစ်ပြီး၊ စဉ်ဆက်မပြတ် တိုးပွားလာနေသော data set များကို စီမံခန့်ခွဲရန် လုပ်ငန်းများကို ကူညီပေးရန် ဒီဇိုင်းထုတ်ထားသည်။ ထို့အပြင်၊ hard drive များ ပိုမိုကြီးမားလာပြီး flash ဈေးနှုန်းများ ဆက်လက်ကျဆင်းနေချိန်တွင် SUSE သည် ကောင်းမွန်သော storage စီးပွားရေးကို အခွင့်ကောင်းယူခြင်းဖြင့် ကူညီရန် ရည်ရွယ်ပါသည်။ ပုံမှန်အားဖြင့် hybrid အဖြစ် configure လုပ်လေ့ရှိသော်လည်း၊ Ceph သည် ဖောက်သည်၏ တောင်းဆိုမှုအတိုင်း ပြောင်းလွယ်ပြင်လွယ်ရှိသည်။ ယနေ့ခေတ်တွင် software-defined gusto အများစုသည် primary storage နှင့် hyperconverged offerings များကို အာရုံစိုက်နေသော်လည်း၊ Ceph သည် သိသာထင်ရှားသော hardware ဖွံ့ဖြိုးတိုးတက်မှုကိုလည်း မြှင့်တင်ရန် ကူညီပေးနေပါသည်။ HP၊ Dell၊ Supermicro နှင့် အခြားသူများသည် Ceph လိုအပ်သော အခြေခံ hardware platform များကို ပံ့ပိုးပေးရန်အတွက် compute node များစွာပါရှိသော 3.5" chassis တွင် များစွာ ရင်းနှီးမြှုပ်နှံခဲ့ကြသည်။ ဤအထူးသုံးသပ်ချက်တွင်၊ ကျွန်ုပ်တို့သည် ProLiant server များနှင့် Apollo chassis အပါအဝင် HPE gear များကို အသုံးချခဲ့သော်လည်း SUSE Enterprise Storage ကို မည်သည့်အရာတွင်မဆို တပ်ဆင်နိုင်သည်။
Ceph အကြောင်း နက်နက်နဲနဲ လေ့လာဖို့ ဒီသုံးသပ်ချက်ရဲ့ အတိုင်းအတာထက် ကျော်လွန်နေပေမယ့် Ceph ဆိုတာ ဘာလဲဆိုတာကို အခြေခံအားဖြင့် နားလည်ထားဖို့ အရေးကြီးပါတယ်။ Ceph ဟာ object, block နဲ့ file storage တွေကို တစ်ခုတည်းသော unified system မှာ ပေးပို့နိုင်တဲ့ ထူးခြားတဲ့ software storage platform တစ်ခုဖြစ်ပါတယ်။ Ceph ရဲ့ နောက်ထပ်ဆွဲဆောင်မှုတစ်ခုကတော့ scalable မြင့်မားပြီး exabytes data အထိ မြင့်မားစွာ သိမ်းဆည်းနိုင်ပါတယ်။ commodity hardware တွေမှာ run နိုင်ပါတယ် (ဆိုလိုတာက အထူးအထွေ ဘာမှ မလိုအပ်ပါဘူး)။ Ceph ကို single points of failure တွေကို ရှောင်ရှားဖို့ ဒီဇိုင်းထုတ်ထားပါတယ်။ လူတိုင်းအတွက် စိတ်ဝင်စားစရာကောင်းတဲ့အရာတစ်ခုကတော့ Ceph ကို အခမဲ့ရယူနိုင်ပါတယ်။
အသုံးပြုသူများသည် commodity hardware ပေါ်တွင် Ceph node တစ်ခုကို တည်ဆောက်နိုင်ပြီး ၎င်းတွင် intelligent daemons အများအပြားကို အသုံးပြုသည်၊ အထူးသဖြင့် လေးခုမှာ Cluster monitors (ceph-mon), Metadata servers (ceph-mds), Object storage devices (ceph-osd), နှင့် Representational state transfer (RESTful) gateways (ceph-rgw) တို့ဖြစ်သည်။ user data ကို ပိုမိုကောင်းမွန်စွာ ကာကွယ်ရန်နှင့် fault-tolerant ဖြစ်စေရန်အတွက် Ceph သည် data ကို ပုံတူကူးယူပြီး throughput မြင့်မားစေရန်အတွက် node များစွာတွင် stripes လုပ်သည်။
SUSE Enterprise Storage သည် Ceph ကို ဒေတာအမျိုးအစားများစွာအတွက် အလွန်ကြီးမားသော၊ ကုန်ကျစရိတ်သက်သာသော အစုလိုက်သိုလှောင်မှုအဖြစ် အသုံးပြုနေပါသည်။ ဒေတာသည် ကြီးထွားလာမည်ဖြစ်ပြီး Big Data သည် အလွန်တန်ဖိုးရှိသော်လည်း စွမ်းရည်များစွာကို ယူဆောင်သွားပါသည်။ Big Data သည် ကုမ္ပဏီများအား ၎င်းတို့၏ အောက်ခြေလိုင်းအတွက် အလွန်တန်ဖိုးရှိသော အသိအမြင်များကို ပေးစွမ်းနိုင်သော်လည်း ဤဒေတာကို ခွဲခြမ်းစိတ်ဖြာရန်အတွက် ၎င်းတို့သည် ထိုအတောအတွင်း သိမ်းဆည်းရန် နေရာတစ်ခု လိုအပ်ပါသည်။ ကုန်ကျစရိတ်သက်သာသော နည်းလမ်းဖြင့် ဒေတာအမြောက်အမြားကို သိမ်းဆည်းနိုင်ရုံသာမက SUSE Enterprise Storage သည် အလွန်လိုက်လျောညီထွေဖြစ်အောင် ပြုလုပ်နိုင်သည်။ ကိုယ်တိုင်စီမံခန့်ခွဲခြင်းနှင့် ကိုယ်တိုင်ကုသခြင်းကဲ့သို့သော ဆော့ဖ်ဝဲသည် လိုအပ်ချက်များ ပြောင်းလဲမှုကို လျင်မြန်စွာ လိုက်လျောညီထွေဖြစ်အောင် ပြုလုပ်ရန် အကောင်းဆုံးဖြစ်သည်။ ဆိုလိုသည်မှာ အက်ဒမင်များသည် စွမ်းဆောင်ရည်ကို လျင်မြန်စွာ ချိန်ညှိနိုင်ပြီး အနှောင့်အယှက်မရှိဘဲ အပိုသိုလှောင်မှုကို ပံ့ပိုးပေးနိုင်သည်။ လိုက်လျောညီထွေဖြစ်အောင် ပြုလုပ်နိုင်ခြင်းသည် SUSE Enterprise Storage နှင့်အတူ အသုံးပြုသော ကုန်စည်ဟာ့ဒ်ဝဲများကို ပြောင်းလွယ်ပြင်လွယ်ရှိစေရန် ကူညီပေးသည်။
SUSE Enterprise သိုလှောင်မှု အင်္ဂါရပ်များ
- ကက်ရှ် အဆင့်သတ်မှတ်ခြင်း
- ပါးပါးလေး စီမံဆောင်ရွက်ပေးခြင်း။
- ကူးယူရေးသားသည့် ကလုန်းများ
- ဖျက်ခြင်းကုဒ်ရေးခြင်း
- မတူညီသော OS ပိတ်ဆို့ဝင်ရောက်ခွင့် (iSCSI)
- ပေါင်းစည်းထားသော အရာဝတ္ထု၊ ဘလော့ခ်နှင့် ဖိုင်စနစ် ဝင်ရောက်ခွင့် (နည်းပညာဆိုင်ရာ အစမ်းကြည့်ရှုခြင်း)
- ပရိုဂရမ်မာအသုံးပြုခွင့်အတွက် API များ
- OpenStack ပေါင်းစပ်မှု
- node များ သို့မဟုတ် စွမ်းရည်၏ အွန်လိုင်းတိုးချဲ့နိုင်မှု
- အွန်လိုင်းဆော့ဖ်ဝဲလ် အပ်ဒိတ်များ
- Data-at-rest ကုဒ်ဝှက်ခြင်း
SUSE Enterprise Storage Hardware Configuration
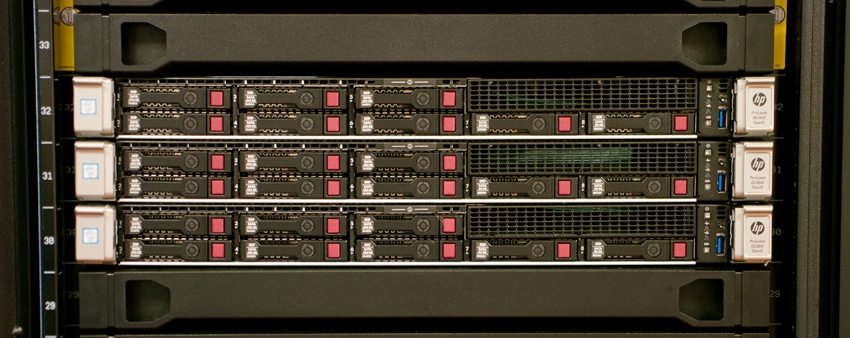
မော်နီတာ node များသည် cluster အခြေအနေကို ခြေရာခံသော်လည်း data path တွင် မတည်ရှိပါ။ ကျွန်ုပ်တို့၏ကိစ္စတွင် မော်နီတာ node သုံးခုသည် 1U HPE ProLiant DL360 server များဖြစ်သည်။ SUSE Enterprise Storage cluster အများစုအတွက် monitoring node သုံးခုသည် လုံလောက်သော်လည်း storage node အရေအတွက် အလွန်များပြားပါက enterprise တစ်ခုသည် ငါးခု သို့မဟုတ် ထို့ထက်ပို၍ deploy လုပ်နိုင်သည်။
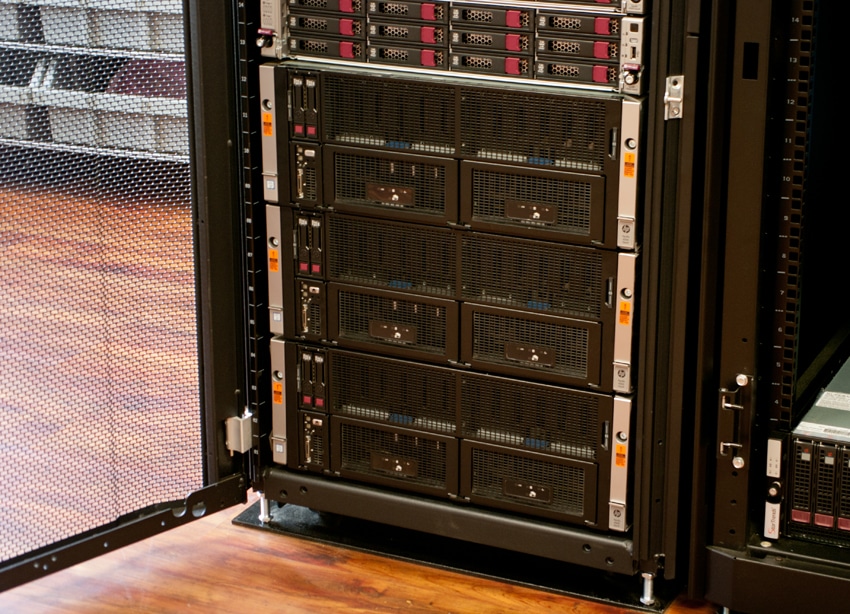
SUSE သိုလှောင်မှု node များသည် အလျားလိုက် ချိန်ညှိနိုင်ပြီး HPE Apollo 4200 node သုံးခုနှင့် HPE Apollo 4510 node သုံးခုဖြင့် ဖွဲ့စည်းထားသည်။ ကျွန်ုပ်တို့၏ configuration တွင် storage node များတစ်လျှောက်တွင် data ကို triplicate ဖြင့် ရေးသားနေပြီး၊ လိုအပ်ချက်ပေါ်မူတည်၍ ပြောင်းလဲနိုင်ပါသည်။ အကာအကွယ်အဆင့်များကို pool level တွင် သတ်မှတ်နိုင်သည်။
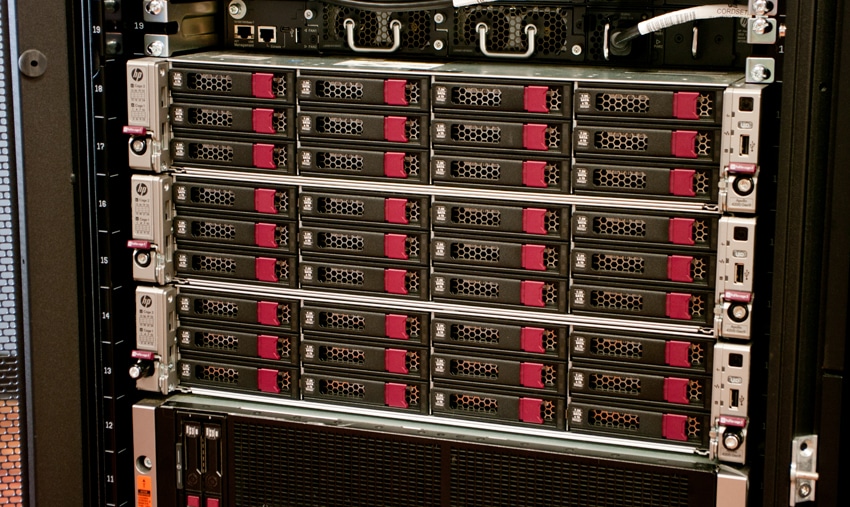
- HPE Apollo 4200 node ၃ ခု
- Intel E5-2680 v3 ပရိုဆက်ဆာ ၂ ခု
- 320GB RAM ကို
- M.2 ဘွတ်ဖိနပ်ကိရိယာ
- 4x 480GB SSD
- 24x 6TB SATA 7.2k ဒရိုက်များ
- ၁ x 40Gb နှစ်ပေါက် အဒက်တာ
- HPE Apollo 4510 node ၃ ခု
- e5-2690 v3 ပရိုဆက်ဆာ ၂ ခု
- 320GB RAM ကို
- M.2 ဘွတ်ဖိနပ်ကိရိယာ
- 4x 480GB SSD
- 24x 6TB SATA 7.2k ဒရိုက်များ
- ၁ x 40Gb နှစ်ပေါက် အဒက်တာ
- HPE ProLiant DL360 node ၃ ခု
- ၁ E5-2660v3
- 64GB RAM ကို
- 2x 80GB SSD
- 6x 480GB SSD
- ၁ x 40Gb နှစ်ပေါက် အဒက်တာ
- ၂x HP FlexFabric 5930-32QSFP+ ခလုတ်
- ဆာဗာဖွဲ့စည်းပုံ
- SUSE Linux Enterprise Server 12 SP1 ပါဝင်သော SUSE Enterprise Storage
- ဂျာနယ်စက်ပစ္စည်းများအတွက် HDD နှင့် SSD အချိုး 6:1 ဖြင့် OSD များကို ဖြန့်ကျက်ထားသည်
- HPE Apollo 4200s နှင့် 4510s များသည် စုစုပေါင်း သိုလှောင်မှုကိရိယာ ၁၄၄ ခုအတွက် တစ်ခုတည်းသော သိုလှောင်မှု cluster တွင် အတူတကွ ပါဝင်ပါသည်။
- DL360 များသည် admin၊ monitor နှင့် Romana GUI အခန်းကဏ္ဍများတွင် လုပ်ဆောင်သည်။
- iSCSI gateway ဝန်ဆောင်မှုများကို storage node ၆ ခုလုံးတွင် ဖြန့်ကျက်ထားသည်။
SUSE Enterprise Storage Management
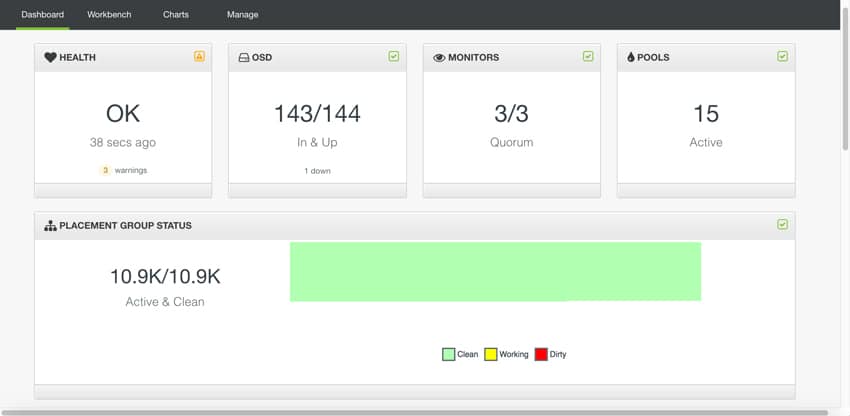
SUSE enterprise storage အများစုကို CLI မှတစ်ဆင့် စီမံခန့်ခွဲသော်လည်း web-based GUI လည်းရှိပါသည်။ လက်ရှိတွင် SUSE သည် ၎င်း၏ GUI အတွက် Calamari ကို အသုံးပြုနေသော်လည်း နောင်တွင် ပြောင်းလဲသွားနိုင်ပါသည်။ အသုံးပြုသူများသည် Calamari ကို setup လုပ်ပြီး ဖွင့်လိုက်သည်နှင့် GUI မှ ပုံမှန်အားဖြင့် မျှော်လင့်ထားသည့်အရာများကို ကြည့်ရှုနိုင်မည်ဖြစ်သည်။ အဓိကစာမျက်နှာတွင် Dashboard၊ Workbench၊ Charts နှင့် Manage အပါအဝင် အပေါ်ဘက်တွင် လည်ပတ်နေသော အဓိက tab လေးခုရှိသည်။ Dashboard tab (default ပွင့်သည့် tab) သည် စနစ်၏ ကျန်းမာရေးကို ပြသထားပြီး လက်ရှိတက်ကြွနေသော သတိပေးချက်များကို ပြသထားသည်။ cluster ရှိ OSD အရေအတွက် စုစုပေါင်းကို ပြသထားပြီး အပေါ်အောက် စုစုပေါင်းပမာဏကိုလည်း ပြသထားသည်။ monitor အရေအတွက် (စုစုပေါင်း/နှင့် လုပ်ဆောင်နေသည့်အရာ) ကို ပြသထားသည်။ ထို့အပြင် pool အရေအတွက် စုစုပေါင်းကိုလည်း ပြသထားသည်။ ၎င်းတို့အောက်တွင် active နှင့် clean နံပါတ်များအပါအဝင် placement group status နှင့် clean (အစိမ်းရောင်)၊ working (အဝါရောင်) နှင့် dirty (အနီရောင်) user များကို ပြသသည့် color code system တို့ ပါဝင်သည်။
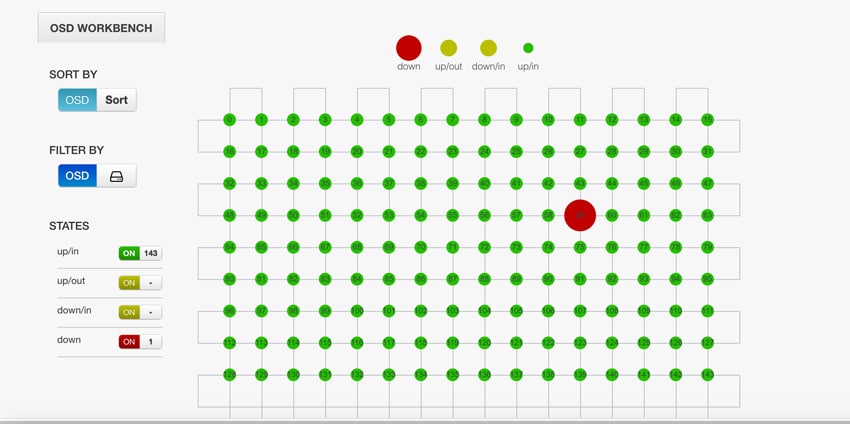
Workbench tab သည် အသုံးပြုသူများအား OSD ပမာဏနှင့် မည်သည့်အရာများ ကောင်းမွန်စွာလည်ပတ်နေသည်နှင့် မည်သည့်အရာများ အောက်ခြေတွင်ရှိသည်ကို ဂရပ်ဖစ်ကိုယ်စားပြုမှုပေးသည်။ ဂရပ်ဖစ်မှ အများစုသည် အစိမ်းရောင်ဖြင့် မှန်ကန်စွာလည်ပတ်နေသော်လည်း အနီရောင်ဖြင့် မီးမောင်းထိုးပြထားပြီး အနည်းငယ်ပိုကြီးသော အောက်ခြေတစ်ခုရှိကြောင်း မြင်တွေ့နိုင်သည်။ ဘယ်ဘက်ခြမ်းတွင် အသုံးပြုသူများသည် OSD အလိုက် စီစစ်နိုင်ပြီး စစ်ထုတ်နိုင်သည်။
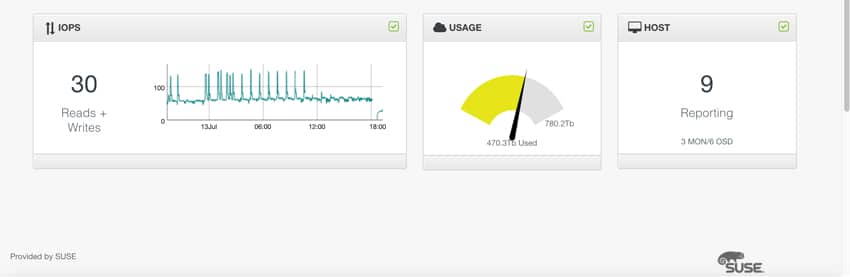
Workbench tab မှတစ်ဆင့် အသုံးပြုသူများသည် ၎င်းတို့၏ storage စွမ်းဆောင်ရည်၏ ဂရပ်ဖစ်ကိုယ်စားပြုမှုကိုလည်း ရရှိနိုင်ပါသည်။ အောက်ပါ ဥပမာတွင် အသုံးပြုသူများသည် ၎င်းတို့၏ read + write IOPS၊ ၎င်းတို့၏ storage အသုံးပြုမှု နှင့် host အရေအတွက် အစီရင်ခံခြင်းကို မြင်တွေ့နိုင်ပါသည်။
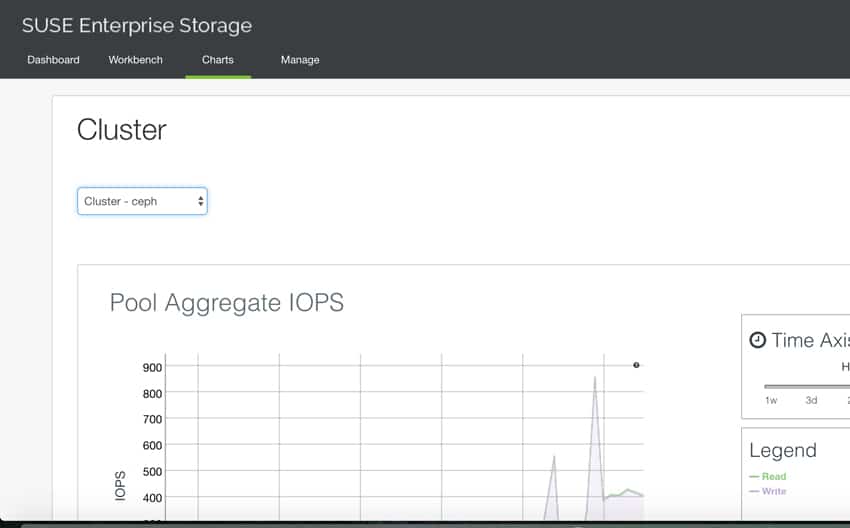
Charts tab ဖြင့် အသုံးပြုသူများသည် cluster တစ်ခုကို ရွေးချယ်နိုင်ပြီး ၎င်း cluster များ၏ စွမ်းဆောင်ရည်ကို ပြသသည့် မျဉ်းကွေးဇယားတစ်ခုကို ရယူနိုင်ပြီး ၎င်းတွင် read နှင့် write နှစ်မျိုးလုံးကို ပြသထားသည်။
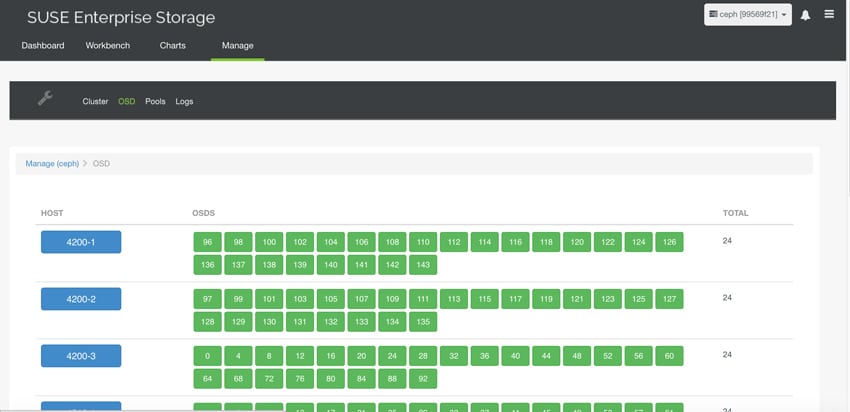
Manage tab သည် အသုံးပြုသူများအား Clusters၊ OSD၊ Pools များကို တည်းဖြတ်နိုင်ပြီး Logs များကို ကြည့်ရှုနိုင်စေပါသည်။ OSD sub tab အောက်တွင် အသုံးပြုသူများသည် ဘယ်ဘက်ခြမ်းတွင် ဖော်ပြထားသော host များနှင့် host တစ်ခုချင်းစီတွင် မည်သည့် OSD များရှိသည်ကို မြင်တွေ့နိုင်သည်။ အသုံးပြုသူများသည် ဝန်ကို ဟန်ချက်ညီစေရန် OSD ကို ရွှေ့နိုင်သည်။
Enterprise Synthetic Workload ခွဲခြမ်းစိတ်ဖြာခြင်း
array သည် ၎င်း၏ workload အတွက် condition လုပ်လာသည်နှင့်အမျှ storage စွမ်းဆောင်ရည် ကွဲပြားသည်၊ ဆိုလိုသည်မှာ benchmark များ တိကျမှန်ကန်ကြောင်း သေချာစေရန်အတွက် fio synthetic benchmark တစ်ခုချင်းစီမတိုင်မီ storage device များကို ကြိုတင် condition လုပ်ရမည်ဖြစ်သည် ။ စမ်းသပ်မှုတစ်ခုစီတွင် primary test တွင် အသုံးပြုသော workload တူညီသော group ကို ကြိုတင် condition လုပ်ထားသည်။ စမ်းသပ်မှုအတွက်၊ ကျွန်ုပ်တို့သည် stock, un-tuned configuration ဖြင့် SUSE Enterprise ကို လုပ်ဆောင်ခဲ့သည်။ အနာဂတ်တွင် SUSE စမ်းသပ်မှုကို သီးခြား OS နှင့် Ceph tuning ဖြင့် လုပ်ဆောင်နိုင်သည်။
ကြိုတင်အခြေအနေပြင်ဆင်ခြင်းနှင့် မူလတည်ငြိမ်အခြေအနေစမ်းသပ်မှုများ-
- ပမာဏ (ဖတ်+ရေး IOPS စုစည်းမှု)
- ပျမ်းမျှ နှောင့်နှေးမှု (ဖတ်+ရေး နှောင့်နှေးမှု အတူတကွ ပျမ်းမျှ)
- အများဆုံး နှောင့်နှေးမှု (အမြင့်ဆုံး ဖတ်ရန် သို့မဟုတ် ရေးရန် နှောင့်နှေးမှု)
- နှောင့်နှေးမှု စံသွေဖည်မှု (ဖတ်+ရေး စံသွေဖည်မှုကို ပျမ်းမျှပေါင်းစပ်ထားသည်)
Dell PowerEdge LoadGen သတ်မှတ်ချက်များ
- Dell PowerEdge R730 ဆာဗာများ (၂-၄)
- CPU များ- Dual Intel Xeon E5-2690 v3 2.6GHz (12C/28T)
- မှတ်ဉာဏ်: 128GB DDR4 RDIMM တစ်ခုစီ
- ကွန်ရက်ချိတ်ဆက်မှု- Mellanox ConnectX-3 40GbE
SUSE Enterprise Storage cluster ကို ကြီးမားသော sequential transfer များအတွက် ရည်ရွယ်ထားသောကြောင့်၊ ကျွန်ုပ်တို့သည် random workload test တစ်ခုကို ထည့်သွင်းခဲ့ပြီး၊ transfer size များ တိုးပွားလာနေသော cluster တွင် sequential transfer test သုံးခုကို အာရုံစိုက်ခဲ့သည်။ workload တစ်ခုစီကို thread ၁၀ ခုနှင့် queue depth ၁၆ ခုဖြင့် အသုံးချခဲ့သည်။ Random workloads များကို client ၂ ခုဖြင့် အသုံးချခဲ့ပြီး ရလဒ်များကို စုစုပေါင်းရမှတ်အဖြစ် ပေါင်းစပ်ခဲ့ပြီး၊ sequential ရလဒ်များကို client ၂ ခုနှင့် ၄ ခုဖြင့် တိုင်းတာခဲ့သည်။ client တစ်ခုစီကို RBD ( RADOS Block Devices) protocol မှတစ်ဆင့် CEPH cluster ရှိ block devices များနှင့် ချိတ်ဆက်ထားသည်။
အလုပ်ဝန်ပရိုဖိုင်များ
- 4k ကျပန်း
- ၁၀၀% ဖတ်ပြီး ၁၀၀% ရေး
- ၁၀၂၄k အစီအစဉ်အတိုင်း
- ၁၀၀% ဖတ်ပြီး ၁၀၀% ရေး
- ၁၀၂၄k အစီအစဉ်အတိုင်း
- ၁၀၀% ဖတ်ပြီး ၁၀၀% ရေး
- ၁၀၂၄k အစီအစဉ်အတိုင်း
- ၁၀၀% ဖတ်ပြီး ၁၀၀% ရေး
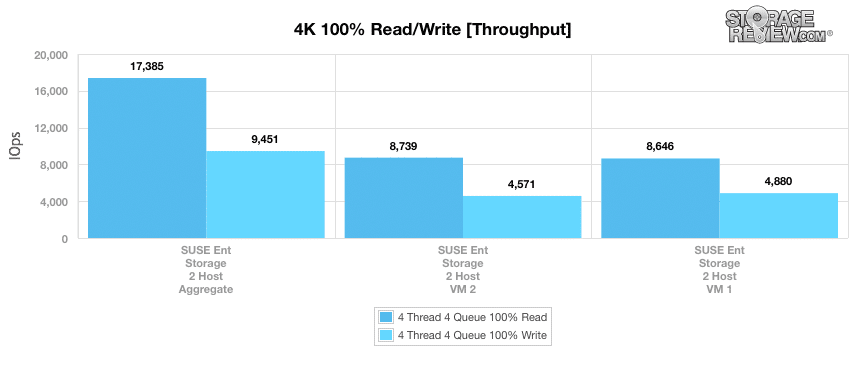
ကျွန်ုပ်တို့ရဲ့ ကျပန်း 4k synthetic benchmark မှာ SUSE Enterprise Storage (ဒီကနေစပြီး တိုတိုပြောရရင် SUSE လို့ ရည်ညွှန်းပါတယ်) ဟာ individual host တွေနဲ့ read throughput 8,739 နဲ့ 8,646 IOPS ရရှိခဲ့ပြီး စုစုပေါင်း read score 17,385 IOPS ရရှိခဲ့ပါတယ်။ write throughput မှာတော့ individual host တွေက 4,571 နဲ့ 4,880 IOPS ရရှိခဲ့ပြီး စုစုပေါင်း score 9,451 IOPS ရရှိခဲ့ပါတယ်။
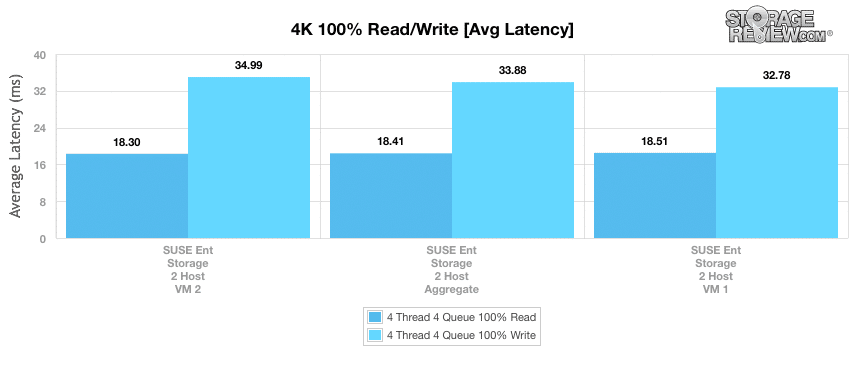
ပျမ်းမျှ latency ကိုကြည့်လျှင် host နှစ်ခုလုံးနှင့် ထို့ကြောင့် ၎င်းတို့အကြားပျမ်းမျှသည် read နှင့် write နှစ်မျိုးလုံးတွင် အလွန်နီးကပ်စွာရှိနေသည်။ read ဘက်တွင် တစ်ဦးချင်း host များတွင် latency 18.3ms နှင့် 18.51ms ရှိပြီး စုစုပေါင်း 18.41ms ရှိသည်။ write ဖြင့် တစ်ဦးချင်း host များတွင် 34.99ms နှင့် 32.78ms ရှိပြီး စုစုပေါင်း 33.88ms ရှိသည်။
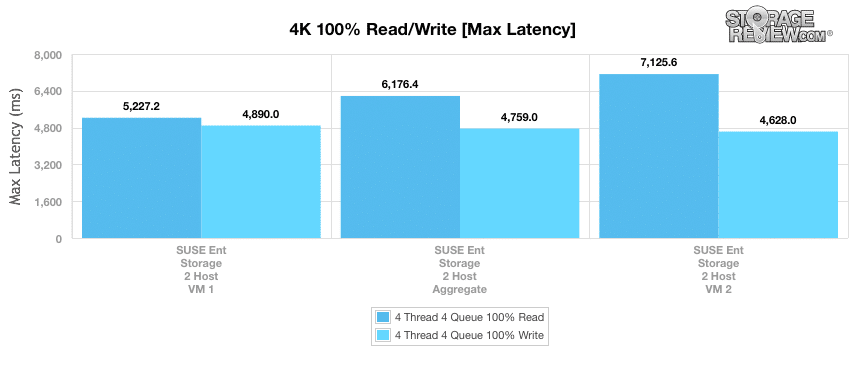
အမြင့်ဆုံး latency သည် တစ်ဦးချင်း host များအတွက် 4,890ms နှင့် 4,628ms ဖြင့် ရေးသားရမှတ်တွင် အတော်လေး တသမတ်တည်း ပြသခဲ့ပြီး စုစုပေါင်း 4,759ms ရှိသည်။ read latency တွင် တစ်ဦးချင်း host များအကြား 5,227.2ms မှ 7,125.6ms အထိ latency များရှိသည့် ကွာခြားချက် ပိုမိုကြီးမားပြီး စုစုပေါင်း 6,176.4ms ရရှိစေပါသည်။
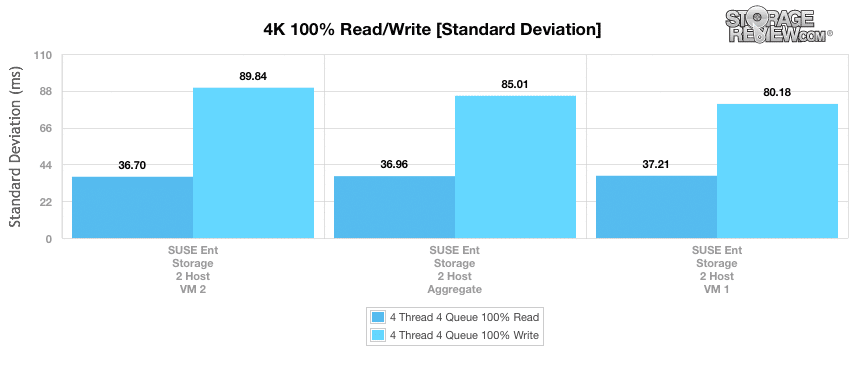
စံသွေဖည်မှုကြောင့် latency သည် တစ်ဖန်ပြန်လည်နီးကပ်လာသည်ကို တွေ့မြင်ခဲ့ရသည်။ တစ်ဦးချင်း host များသည် စုစုပေါင်း 36.96ms ဖြင့် read latency 36.7ms နှင့် 37.21ms ပေးခဲ့သည်။ ရေးသား latency များသည် စုစုပေါင်းရမှတ် 85.01ms ဖြင့် 80.18ms မှ 89.84ms အထိ ရရှိခဲ့သည်။
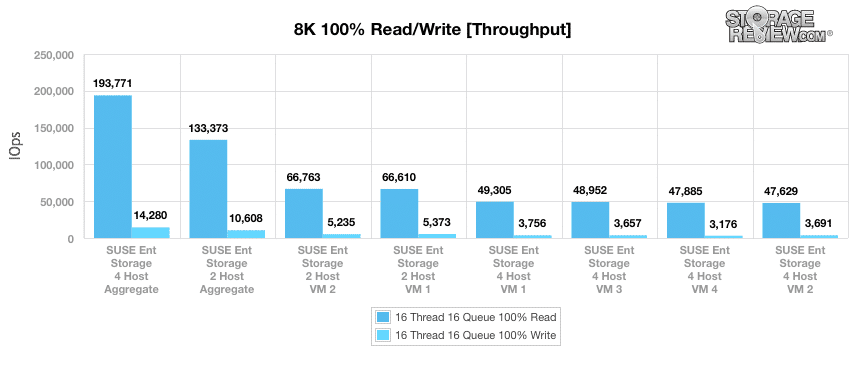
ဒီကနေစပြီး sequential test တွေဆီ ပြန်သွားပါမယ်။ ပထမတစ်ခုက ကျွန်တော်တို့ရဲ့ 8k ပါ။ ဒီမှာ SUSE 2 မှာ host နှစ်ခုနဲ့ SUSE 4 မှာ host လေးခုပါဝင်တဲ့ test set နှစ်ခု (SUSE 2 နဲ့ SUSE 4) ကို set တစ်ခုစီအတွက် စုစုပေါင်းရမှတ်တွေနဲ့ ကြည့်ပါမယ်။ SUSE 2 က read throughput 66,610 နဲ့ 66,763 IOPS နဲ့ write throughput 5,235 နဲ့ 5,375 IOPS ရရှိပါတယ်။ host နှစ်ခုပါတဲ့ SUSE အတွက် စုစုပေါင်းရမှတ် 133,373 IOPS read နဲ့ write 10,608 IOPS ရရှိပါတယ်။ host လေးခုပါတဲ့ SUSE က read throughput 47,629 မှ 49,305 IOPS အထိ ရရှိပြီး write throughput 3,176 မှ 3,756 IOPS အထိ ရရှိပြီး စုစုပေါင်းရမှတ် 193,771 IOPS read နဲ့ write 14,280 IOPS ရရှိပါတယ်။
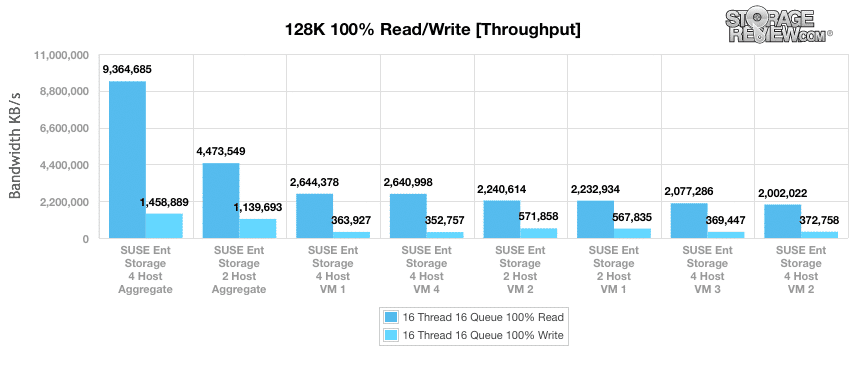
large block 128k sequential test ကိုပြောင်းလိုက်တဲ့အခါ host နှစ်ခုပါတဲ့ SUSE က read throughput 2.32GB/s နဲ့ 2.34GB/s ရှိပြီး read aggregate score 4.47GB/s ရရှိခဲ့ပါတယ်။ host နှစ်ခုပါတဲ့ system က write throughput 568MB/s နဲ့ 572MB/s ရှိပြီး write aggregate score 1.459GB/s ရရှိခဲ့ပါတယ်။ host လေးခုပါတဲ့ SUSE က read throughput 2GB/s ကနေ 2.644GB/s အထိ ရရှိခဲ့ပြီး read aggregate score 9.365GB/s ရရှိခဲ့ပါတယ်။ write throughput တွေကိုကြည့်ရင် host လေးခုပါတဲ့ SUSE က 353MB/s ကနေ 373MB/s အထိ ရရှိခဲ့ပြီး write aggregate score 1.46GB/s ရရှိခဲ့ပါတယ်။
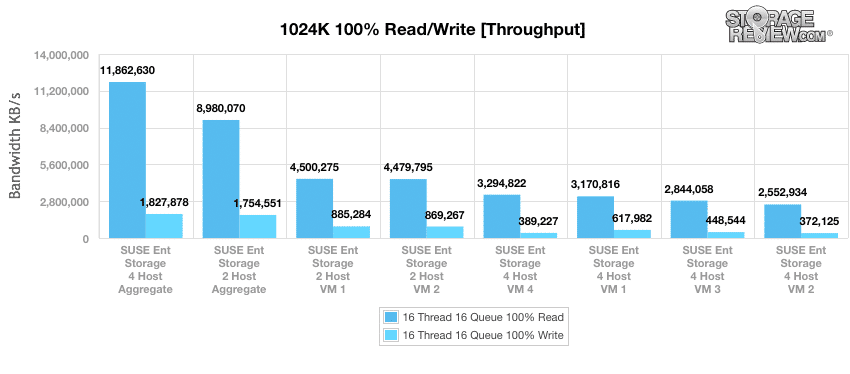
ပိုကြီးတဲ့ block 1,024k sequential test ကိုပြောင်းလိုက်တဲ့အခါ host နှစ်ခုပါတဲ့ SUSE က read throughput 4.48GB/s နဲ့ 4.5GB/s ရှိပြီး စုစုပေါင်း 8.98GB/s ရရှိခဲ့ပါတယ်။ write throughput တွေနဲ့ဆိုရင် host နှစ်ခုပါတဲ့ SUSE က 869MB/s နဲ့ 885MB/s ရှိပြီး write throughput 1.755GB/s ရရှိခဲ့ပါတယ်။ host လေးခုစနစ်က read throughput 2.553GB/s မှ 3.295GB/s အထိ ရရှိခဲ့ပြီး read throughput 11.863GB/s ရရှိခဲ့ပါတယ်။ write throughput တွေနဲ့ဆိုရင် host လေးခုပါတဲ့ SUSE က 372MB/s မှ 618MB/s အထိ ရရှိခဲ့ပြီး write aggregate score 1.828GB/s ရရှိခဲ့ပါတယ်။
ကောက်ချက်
SUSE Enterprise Storage သည် တိုးပွားလာနေသော ဒေတာအစုများနှင့် ရုန်းကန်နေရသော ကုမ္ပဏီများကို ကူညီရန် ဒီဇိုင်းထုတ်ထားသော Ceph စွမ်းအင်သုံး SDS Solution တစ်ခုဖြစ်သည်။ SUSE သည် Ceph ကို ဒေတာအမျိုးအစားအားလုံးအတွက် bulk storage အဖြစ် အသုံးပြုပြီး Big Data ကို ပုံစံအမျိုးမျိုးဖြင့် ထုတ်ပေးသောကြောင့် အကျိုးရှိပါသည်။ Ceph ၏ ပြောင်းလွယ်ပြင်လွယ်ရှိမှုသည်လည်း အပေါင်းလက္ခဏာတစ်ခုဖြစ်ပြီး မည်သည့်အရာတွင်မဆို ဖြန့်ကျက်နိုင်သောကြောင့် ကုမ္ပဏီများသည် Ceph ဖြင့် SUSE Enterprise Storage ကို လက်ရှိရင်းနှီးမြှုပ်နှံမှုများတွင် အသုံးချနိုင်သည် (ကျွန်ုပ်တို့၏ သုံးသပ်ချက်အတွက် HPE ProLiant server များနှင့် Apollo chassis ကို အသုံးပြုခဲ့သည်)။ ပြောင်းလွယ်ပြင်လွယ်ရှိမှုသည် အရောင်းရဆုံးအချက်တစ်ခုဖြစ်သော်လည်း SUSE Enterprise Storage သည် အလွန်လိုက်လျောညီထွေဖြစ်အောင် ပြုလုပ်နိုင်ပြီး ကိုယ်တိုင်စီမံခန့်ခွဲနိုင်ပြီး ကိုယ်တိုင်ကုသနိုင်သည်။ တစ်နည်းအားဖြင့် SUSE Enterprise Storage ကိုအသုံးပြုသော admin များသည် စွမ်းဆောင်ရည်ကို လျင်မြန်စွာ ပြောင်းလဲနိုင်ပြီး အနှောင့်အယှက်မရှိဘဲ သိုလှောင်မှုပိုမိုပံ့ပိုးပေးနိုင်မည်ဖြစ်သည်။
စွမ်းဆောင်ရည်ပိုင်းမှာတော့ ကျွန်တော်တို့ stock ဒါမှမဟုတ် un-tune configuration ကို လုပ်ဆောင်ခဲ့ပါတယ်။ Ceph မှာ configure လုပ်လို့ရတဲ့ variations အများကြီးရှိပါတယ်။ OS ဒါမှမဟုတ် Ceph ကို ချိန်ညှိမယ့်အစား ကျွန်တော်တို့တွေ့ရတဲ့ ရလဒ်တွေက stock ရဲ့ performance baseline ကို သတ်မှတ်ဖို့ အထောက်အကူပြုနေပါတယ်။ SUSE Enterprise Storage ဟာ sequential transfer ကြီးကြီးမားမားတွေအတွက် ပိုပြီး အာရုံစိုက်ထားတာကြောင့် ကျွန်တော်တို့ရဲ့ စမ်းသပ်မှုအများစုက ဒီလိုပဲ ဦးတည်နေပါတယ်။ user မှာ SUSE Enterprise Storage cluster ရှိရင် sequential ကြီးကြီးမားမားအတွက် အသုံးပြုဖို့ များပြီး အဲဒီရလဒ်တွေကို ပိုပြီး စိတ်ဝင်စားလာမှာပါ။ ဒါပေမယ့် system က မလိုအပ်တဲ့ တစ်ခုခုနဲ့ တင်ပြထားရင်တောင် system ဘယ်လိုအလုပ်လုပ်လဲဆိုတာကို အလုံးစုံသိရှိနိုင်ဖို့ 4k random tests တွေကို လုပ်ဆောင်ခဲ့ပါတယ်။
ကျွန်ုပ်တို့ရဲ့ 4k random test တွေမှာ Host 1 နဲ့ Host 2 လို့ခေါ်တဲ့ client နှစ်ခုကို run ခဲ့ပါတယ်။ chart တွေမှာ Host 1 နဲ့ Host 2 လို့ခေါ်တဲ့ client နှစ်ခုကို run ခဲ့ပါတယ်။ တစ်ခုချင်းစီရဲ့ ရမှတ်တွေအပြင် combined score ကိုပါ ကြည့်ခဲ့ပါတယ်။ throughput အတွက် SUSE Enterprise Storage က aggregate read score 17,385 IOPS နဲ့ aggregate write score 9,451 IOPS ရရှိခဲ့ပါတယ်။ 4k latencies တွေနဲ့ SUSE Enterprise Storage က aggregate average latency 18.41ms read နဲ့ 33.88ms write၊ aggregate max latencies 6,176.4ms read နဲ့ 4,759ms write နဲ့ aggregate standard deviation 36.96ms read နဲ့ 85.01ms write ရရှိခဲ့ပါတယ်။
ပိုမိုကြီးမားသော sequential စမ်းသပ်မှုများကို client ၂ ခု သို့မဟုတ် ၄ ခုပါသော host ၄ ခုဖြင့် ပြုလုပ်ခဲ့ပြီး client ၂ ခုနှင့် ၄ ခုစီအတွက် စုစုပေါင်းရမှတ်များကိုလည်း ထည့်သွင်းတွက်ချက်ခဲ့ပါသည်။ ကျွန်ုပ်တို့သည် 8k၊ 128k နှင့် 1024k တို့ကို အသုံးပြု၍ sequential စွမ်းဆောင်ရည်ကို စမ်းသပ်ခဲ့ပါသည်။ စမ်းသပ်မှုတစ်ခုစီတွင် အကောင်းဆုံးစွမ်းဆောင်ရည်ရှိသော client ၄ ခု၏ စုစုပေါင်း host သည် အံ့သြစရာမဟုတ်ပါ။ 8k တွင် SUSE Enterprise Storage သည် 193,771 IOPS read နှင့် 14,280 IOPS write ဖြင့် မြင့်မားသောစုစုပေါင်းရမှတ်များကို ပေးစွမ်းခဲ့သည်။ ကျွန်ုပ်တို့၏ 128k benchmark တွင် အမြင့်ဆုံးစုစုပေါင်းရမှတ်မှာ 9.365GB/s read နှင့် 1.459BG/s write ဖြစ်သည်။ ထို့အပြင် ကျွန်ုပ်တို့၏ နောက်ဆုံး large block sequential benchmark 1024k တွင် SUSE Enterprise Storage သည် 11.863GB/s read နှင့် 1.828GB/s write ဖြင့် မြင့်မားသောစုစုပေါင်းရမှတ်ကို ပေးစွမ်းခဲ့သည်။
Pros
- ဒေတာအစုံများ တိုးချဲ့ရန်အတွက် မြင့်မားစွာ တိုးချဲ့နိုင်သော ဖြေရှင်းချက်
- Software-Defined ဆိုသည်မှာ ဖြန့်ကျက်မှုတွင် ပြောင်းလွယ်ပြင်လွယ်ရှိခြင်း
- iSCSI ကဲ့သို့သော ရိုးရာချိတ်ဆက်မှုပံ့ပိုးမှုကို ပေးဆောင်သည်
- သီးခြား အလုပ်ပမာဏများနှင့် တိကျသော လိုအပ်ချက်များအတွက် ချိန်ညှိနိုင်သည်
အားနည်းချက်များ
- Radom IO ပံ့ပိုးမှုကို အသုံးပြုမှုနယ်ပယ်များ တိုးချဲ့နိုင်ရန် ပိုမိုကောင်းမွန်အောင် ပြုလုပ်နိုင်ပါသည်။
- ဖြန့်ကျက်မှုနှင့် စီမံခန့်ခွဲမှုအတွက် ခိုင်မာသော Linux-based ကျွမ်းကျင်မှု လိုအပ်သည်
အောက်ဆုံးလိုင်း
SUSE Enterprise Storage သည် Big Data ကို သိမ်းဆည်းပြီး အသုံးချလိုသော ကုမ္ပဏီများအတွက် လုံလောက်သော စကေး၊ ပြောင်းလွယ်ပြင်လွယ်ရှိမှုနှင့် မြင့်မားသော လိုက်လျောညီထွေဖြစ်အောင် လုပ်ဆောင်နိုင်စွမ်းကို ပေးစွမ်းပါသည်။


 အမေဇုံ