

De belangrijkste beslissing die veel bedrijven het komende jaar nemen op het gebied van AI-infrastructuur zal geen investering in GPU's zijn, maar een upgrade van hun database. Oracle AI Database 26ai is de release met langetermijnondersteuning waar Oracle zijn bestaande 19c-systemen naartoe stuurt. 26ai integreert vectorzoekopdrachten in dezelfde engine als de transacties. Doordat de vectorindex zich in de database bevindt, vormen de block array en het SAN-netwerk erachter AI-infrastructuur, die naast de transacties ook ophaalverkeer verwerkt.
Key Takeaways
- OLTP en vector zoeken delen één array: Met een beperking van 45,000 IOPS per vectorvolume, behield FlashSystem 870,000 IOPS bij 377 microseconden en 6.9 GB/s met een CPU-gebruik van 25 procent, terwijl Swingbench gedurende de hele test een constante snelheid van ongeveer 19,500 TPS handhaafde; zonder deze beperking nam de vectorbelasting 37 procent van de OLTP-belasting af.
- 64G Fibre Channel verdubbelt bijna de doorvoer van vectorzoekopdrachten: Dezelfde host, array en Emulex LPe38102 SecureHBA's leverden 85.0 query's per seconde bij 64G tegenover 43.7 bij 32G, een toename van 95 procent, waarbij de p99-latentie bij 80 threads daalde van 4.08 seconden naar 1.14 seconden en de IVF_FLAT-indexopbouw 28.8 procent sneller werd voltooid.
- De ransomware-aanval gericht op het RMAN-back-upsysteem werd binnen 60 seconden onderschept: FlashSystem heeft alle 31 volumes in de groep gemarkeerd, zelf een onveranderlijke Safeguarded Copy-snapshot gemaakt en de bewaartermijn van de laatst bekende goede kopie verlengd, zonder dat er een hostagent in het pad aanwezig was.
- Vectorcapaciteit is een budgetpost die vanaf dag één moet worden opgenomen: Een miljoen 1,024-dimensionale embeddings zetten 0.90 GB aan brontekst om in 16.24 GB op de SAN, 18 keer zoveel als de brontekst, met 15 tot 23 GB aan TEMP-geheugen nodig tijdens het opbouwen van de index en een vermenigvuldigingsfactor die varieert van 4.8x tot 32.5x, afhankelijk van het embeddingmodel.
- De werkzaamheden van dag twee blijven op de array: AutoZoning met Brocade target-driven zoning voegt een host toe zonder zoning ticket, opslagpartities geven de DBA- en AI-teams aparte tenants op één systeem, en Emulex SecureHBAs versleutelen host-naar-array-verkeer tijdens de overdracht over een Brocade Gen 8-fabric met post-quantum cryptografie.
De database is veranderd onder invloed van AI.
Oracle bouwde 26ai rond dat idee: een native VECTOR-datatype, SQL-vectorzoekfuncties, in-database modeluitvoering via ONNX en SELECT AI voor zoekopdrachten in natuurlijke taal, allemaal in een LTS-release die volgens het bedrijf meer dan 300 nieuwe functies bevat. In de praktijk kan een DBA embeddings genereren, deze opslaan naast de rijen die ze beschrijven en een gelijkeniszoekopdracht uitvoeren binnen dezelfde transactiescope als een orderopzoeking. Er is geen aparte vectoropslag nodig, geen synchronisatiepipeline om te onderhouden en geen tweede kopie van gereguleerde gegevens die buiten het auditspoor valt.
IBM citeert IDC over deze trend: "Geïntegreerde vectordatabases zijn duidelijk het platform bij uitstek voor het opslaan en opvragen van vector-embeddings, omdat organisaties de voorkeur geven aan uniforme, beheerde omgevingen voor agentische AI." De klanten van IBM en Broadcom willen de database die ze al vertrouwen uitbreiden voordat ze er een nieuwe naast implementeren.
Oracle is niet de enige in deze richting. De populariteitsranglijst van DB-Engines uit oktober 2026 vermeldt de vier beste relationele en multi-model database-engines: Oracle, MySQL, Microsoft SQL Server en PostgreSQL. Alle vier hebben vectortypen of vectorzoekopdrachten toegevoegd, native of via extensies zoals pgvector. IBM koos ervoor om zijn validatiewerk met Oracle te beginnen, voornamelijk vanwege diens marktleiderschap, hoewel het argument over opslag in dit artikel ook van toepassing is op de andere engines.

De argumenten voor het lokaal opslaan van blokgegevens zijn niet veranderd met de komst van AI: de data die een AI-implementatie bruikbaar maken, zoals patiëntendossiers, declaraties, bestellingen en transacties, mogen niet worden overgezet. Het kopiëren ervan naar een speciaal AI-platform betekent dat er twee keer voor opslag betaald moet worden, dat de kopie kan afwijken van het productiecluster en dat de beheermogelijkheden verloren gaan die de originele gegevens juridisch verdedigbaar maakten. Door het ophalen van gegevens binnen de database te houden, worden al deze problemen voorkomen. De array die een rijopzoeking in minder dan een milliseconde mogelijk maakt, dient nu tegelijkertijd ook voor een vectorgelijkenisscan voor een arts en als back-upstream.
IBM Storage en de Fibre Channel (FC)-groep van Broadcom wilden de situatie met gemengde workloads valideren en bouwden een omgeving rond Oracle AI Database 26ai op IBM FlashSystem met Broadcoms Brocade Gen 8 SAN-fabric en Emulex 64G SecureHBAs . Vervolgens beantwoordden ze de vragen die een infrastructuurteam had gesteld: wat is de impact op de transactionele latentie wanneer een vectorworkload ernaast start, wat is het effect van de fabricsnelheid op de doorvoer van vectorzoekopdrachten, hoeveel capaciteit wordt verbruikt door embeddings, hoe effectief is ransomwaredetectie bij een RMAN-back-upvolume en wat zijn de vereisten voor het toevoegen van een host aan de SAN zonder zoningticket?
De data staat al opgeslagen in blokken, en nu komt de AI erbij.
Dit alles wil niet zeggen dat AI-workloads in het algemeen thuishoren op blokopslag. Bedrijven zullen bestands- en objectarrays blijven gebruiken voor de ongestructureerde gegevens: documenten, afbeeldingen, video's, trainingssets en modelcontrolepunten die nooit in een database zijn opgeslagen en waarschijnlijk ook nooit zullen worden opgeslagen. In de volgende demonstratie in de gezondheidszorg bewaart IBM de ruwe röntgenfoto's in objectopslag, terwijl alleen de embeddings en casusmetadata in Oracle worden opgeslagen. Wat verandert, is de belasting van de array, die nu meerdere workloads met zeer verschillende I/O-profielen tegelijkertijd verwerkt.
De relationele laag is de meest bekende: miljoenen willekeurige I/O-bewerkingen van 4 KB tot 16 KB per seconde, rijopzoekingen en commits die binnen microseconden moeten worden uitgevoerd, hoge schrijfsnelheid door redo-, undo- en checkpointverkeer, en een staartlatentie die voorspelbaar blijft omdat een applicatie die door de gebruiker wordt gebruikt erop wacht. RMAN, het back-upprogramma van Oracle, is het tegenovergestelde: een sequentiële stream die voldoende ruimte nodig heeft om binnen het venster te worden voltooid zonder de eerste workload te verstoren. Beide lagen zijn goed bekend en de arrays van IBM zijn erop afgestemd.
De vectorlaag is lastiger te karakteriseren omdat grote tabellen met vector-embeddings ervoor kunnen zorgen dat vector zoeken lijkt op een bandbreedte-intensieve workload: een grote sequentiële scan. IBM's karakterisering van het Oracle 26ai vectorpad ligt dichter bij OLTP. Elke stap door de index is een willekeurige leesbewerking van ongeveer 4 KB; het querypad is IOPS-gebonden en latency-gevoelig, en leesbewerkingen domineren omdat schrijfbewerkingen in een aparte fase voor data-invoer en indexopbouw plaatsvinden.
Bandbreedte is van belang in bursts, wanneer een index wordt opgebouwd of een corpus opnieuw wordt ingebed, en die bursts zijn doorgaans vrij groot. Die verdeling vormt de kern van het gemengde I/O-probleem: op het querypad concurreert de vectorbelasting met transacties om dezelfde wachtrijen, waardoor isolatie een kwaliteitsaspect van de dienstverlening wordt. En juist in die burstfasen bereikt de bandbreedte van het netwerk zijn limiet, zoals de resultaten van 32G versus 64G verderop in dit artikel laten zien.
De gevalideerde architectuur
IBM en Broadcom hebben voor deze validatie een omgeving gecreëerd in het AI-lab van Broadcom in Colorado. De opslag bestaat uit een IBM FlashSystem 9000-serie array met IBM Storage Virtualize 9.1.3 en 24 FlashCore-modules, die 64G Fibre Channel-poorten beschikbaar stellen aan een paar Brocade Gen 8 G820 SAN-switches. De databasehost is een dual-socket Intel Xeon 6767P-server met twee 2-poorts Emulex LPe38102 64G SecureHBA's, waarop Oracle AI Database 26ai op ASM draait zonder GPU in het opslagpad; IBM Storage Insights bewaakt de array.

We hebben de resultaten voor fabric en capaciteit, de vergelijking van 32G versus 64G vector search en de footprint-metingen met VectorDBBench uitgevoerd op de BioASQ 1M-dataset, uitsluitend op die host. Dezelfde configuratie ondersteunt ook de applicatieworkload. Een Supermicro 821GE-TNHR met twee Xeon Platinum 8470-processors en acht NVIDIA H100 80GB GPU's host de zorgapplicatie en het bijbehorende taalmodel. De softwarestack omvat Oracle's in-database ONNX-integratie, Ollama serving Llama 3 en NVIDIA cuVS. Een Broadcom Tomahawk 5-switch en Thor 2 400GbE NIC's verbinden de twee servers. De I/O QoS, multi-tenancy, ransomware-detectie en demonstraties voor de zorgomgeving zijn in deze omgeving uitgevoerd.

Volgens IBM draait de FlashSystem-familie (de 5300 en 5600, 7300 en 7600, en 9500 en 9600) dezelfde Storage Virtualize-software. De hier gedemonstreerde functies, waaronder I/O-throttling, AutoZoning, ransomware-detectie, beleidsgebaseerde HA en migratie van opslagpartities, werken op dezelfde manier met Oracle AI Database 26ai op al deze arrays, met dezelfde code. Prestaties en dichtheid variëren per model en FlashCore Module-generatie, dus elk cijfer in dit artikel is gebaseerd op het systeem waarop het is gemeten.
Optimale prestaties voor OLTP- en vectorworkloads garanderen met I/O QoS.
De eerste vraag die IBM en Broadcom wilden beantwoorden, is de vraag die elke DBA zich stelt wanneer een vectorworkload wordt voorgesteld voor de productieomgeving: wat gebeurt er met de kerntransacties? IBM voerde twee demonstraties uit op de FlashSystem 9000-serie met behulp van I/O-throttling op volumeniveau, het mechanisme achter wat IBM I/O QoS noemt. De database was verdeeld over 30 volumes: 15 voor de OLTP-tablespaces (ORCL16 tot en met ORCL30) onder Swingbench Order Entry met 192 gebruikers, en 15 voor de vectortabellen (ORCL31 tot en met ORCL45) onder een synthetische generator met 200 threads die top-k 500-gelijkenisquery's uitvoerde, waarbij Storage Insights elke volumegroep in kaart bracht.
Toen OLTP alleen draaide, had elk OLTP-volume een constante capaciteit van 20,500 bewerkingen per seconde. Toen de vectorgenerator startte, stegen de vectorvolumes binnen een minuut naar ongeveer 73,000 bewerkingen per seconde, terwijl de OLTP-volumes daalden naar ongeveer 13,000, een daling van 37 procent zonder dat er aan de transactiekant iets veranderde. Het zoekpad van de vector bestaat uit willekeurige leesbewerkingen van 4 KB met dezelfde blokgrootte als de transacties, waardoor dezelfde wachtrijen worden geraadpleegd en de gegevens uit de array worden gebruikt.

Een limiet van 45,000 IOPS per vectorvolume, één regel van mkthrottle Via de CLI werden de vectorvolumes tot de limiet opgetrokken, waardoor OLTP teruggebracht werd naar ongeveer 17,000 bewerkingen per seconde. Het verwijderen van de limiet maakte dit ongedaan, en toen de vectorrun eindigde, keerde OLTP terug naar 20,500. Het dashboard registreerde in totaal hetzelfde: 1.28 miljoen IOPS zonder beperking en ongeveer 950,000 onder de limiet, wat, op een paar procent na, overeenkomt met de snelheid per volume vermenigvuldigd met 30 volumes.

De tweede demo toont de configuratie die IBM verwacht in een productieomgeving te implementeren: eerst worden de limieten ingesteld, 45,000 IOPS per vectorvolume en 20,000 per OLTP-volume, waarna beide workloads tegelijkertijd worden gestart. De vectorvolumes bereikten hun maximale capaciteit, de OLTP-volumes stabiliseerden zich op ongeveer 12,200 bewerkingen per seconde en bleven gedurende de hele test stabiel. De array haalde 870,000 IOPS (800,000 leesbewerkingen, 70,000 schrijfbewerkingen) met een verwerkingstijd van 377 microseconden en een doorvoer van 6.9 GB/s bij een CPU-gebruik van 25%. De OLTP-limiet bleef boven de vraag van de workload en werd nooit geactiveerd; deze is ingesteld om te voorkomen dat een overbelasting aan de ene kant de andere kant overbelast.
Swingbench hield zijn 192 gebruikers gedurende de hele testperiode op ongeveer 1.19 miljoen transacties per minuut, oftewel circa 19,500 TPS. De generator was afgestemd op maximale volumes, waardoor de latentie per query geen representatieve benchmark voor de applicatieprestaties is. Gedurende de 30 minuten durende test werden 35,672 queries voltooid met een snelheid van 19.8 per seconde, met een mediane latentie van ongeveer 10 seconden en een p99 van 14.3 seconden, terwijl de applicatie een time-out van 15 seconden had. 99 queries (0.28 procent) bereikten deze time-out, maar de transacties merkten hier niets van.


Een FlashSystem-throttle is een volumelimiet die wordt afgedwongen op de array, ongeacht de host of het pad, met een optionele bandbreedtelimiet naast de IOPS-limiet; het beperkt de naburige volumes en reserveert niets. De limiet is een kwestie van dimensionering: 15 vectorvolumes van 45,000 IOPS betekent 675,000 IOPS aan vectorcapaciteit, wat de OLTP-volumes van deze array voldoende capaciteit gaf. Een andere array of combinatie kan dit getal enigszins beïnvloeden. Stel de vectorlimiet zo in dat de transacties hun latentie behouden, en de vectorworkload krijgt alles daarboven.
Ransomware-detectie op actieve Oracle-volumes
Uit een onderzoek van Sophos uit 2024 onder 2,974 organisaties die getroffen waren door ransomware, bleek dat 94 procent van de aanvallers hun back-ups aanviel, dat de poging in 57 procent van de gevallen slaagde en dat de gemiddelde herstelkosten acht keer hoger lagen wanneer dit wel lukte. IBM voerde de test op dezelfde basis uit, waarbij back-ups als eerste doelwit werden gekozen en de productieomgeving als tweede, en richtte de aanval op het RMAN-back-updoelwit, terwijl de databasevolumes ongemoeid werden gelaten. RMAN schreef zijn back-upsets naar FlashSystem-volumes, waarop een ransomware-simulator werd uitgevoerd, en de array werd aan zijn lot overgelaten, zonder tussenkomst van een hostagent.
Detectie vindt plaats binnen de schijven: FCM4- en FCM5-FlashCore-modules berekenen de entropie en comprimeerbaarheid van elke schrijfbewerking, samen met de blokgrootte, het adres en de herschrijfpatronen. Elke twee seconden sturen ze een samenvatting per volume naar een inferentie-engine in Storage Virtualize (versie 8.6.3 of later met FCM-firmware 4.1 of later). Het model genereert waarschuwingen in de FlashSystem GUI en IBM Storage Insights Pro, stuurt deze door naar Storage Defender of een SIEM-systeem en kan zelfstandig worden gepatcht. Een opnieuw getraind model wordt daarom als een kleine beveiligingsupdate uitgebracht zonder dat een firmware-upgrade nodig is.
Omdat de analyse op de module draait, blijft deze werken, zelfs als de host is gecompromitteerd. Versleutelde uitvoer heeft een hoge entropie en stopt met comprimeren. Dit is zichtbaar in de statistieken, ongeacht of de aanvaller bestandsextensies wijzigt, slechts elk tweede blok versleutelt of de snelheid verlaagt om zich te verbergen voor een endpointagent.
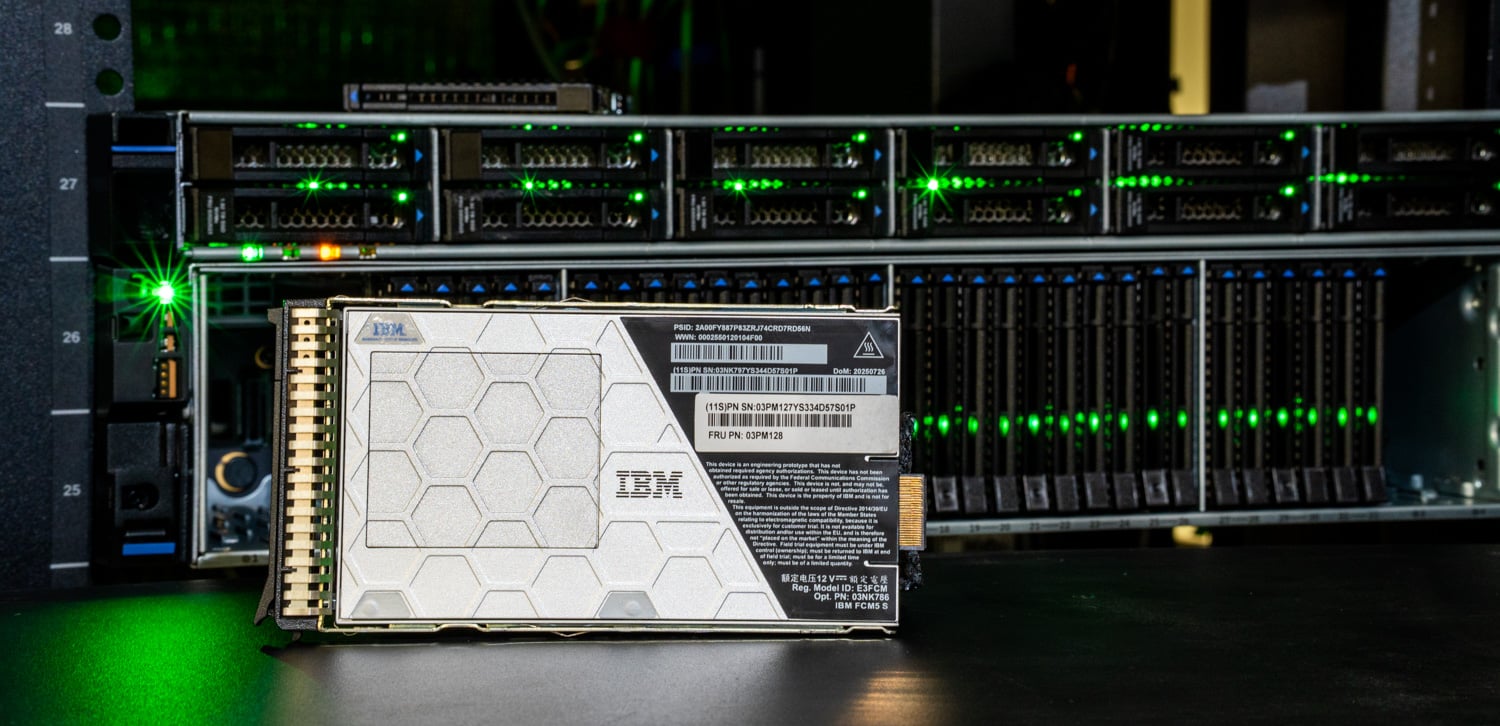
Tijdens de validatie schreef RMAN de back-up over 16 parallelle kanalen, waarbij elke back-upset een maximum van 150 GB had. De database stond op 15 schijven van 200 GB per ASM-schijfgroep voor OLTP- en vectorgegevens. IBM voerde de aanval uit op dit back-updoel en de waarschuwing bereikte Storage Insights binnen 60 seconden, wat binnen het detectievenster valt dat IBM voor deze functie publiceert. Storage Insights markeerde alle 31 volumes in de volumegroep als een bedreiging, aangezien een waarschuwing voor één volume de hele groep als een bedreiging markeert.
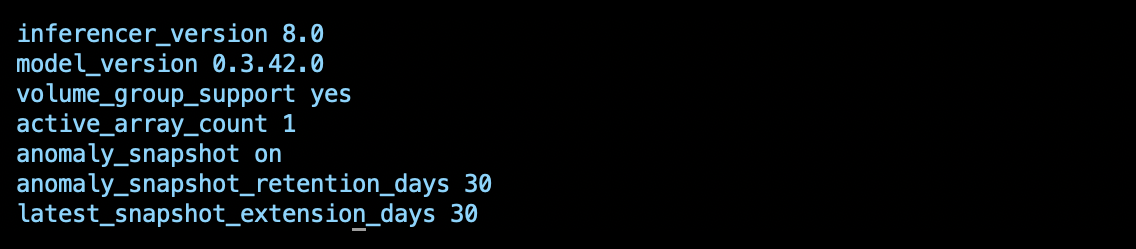
Het antwoord is 'Safeguarded Copy', en de array heeft dit zonder tussenkomst van een operator afgehandeld: het FlashSystem heeft een onveranderlijke momentopname gemaakt van de betreffende volumegroep op het moment dat de dreiging zich voordeed en tegelijkertijd de bewaartermijn van de laatst bekende goede momentopname verlengd. lsanomalydetection De uitvoer van de array toont de achterliggende configuratie: inferentie-engine 8.0 met model 0.3.42.0, anomaly_snapshot ingeschakeld, 30 dagen bewaartijd voor de nieuwe snapshot en 30 dagen toegevoegd aan de laatst geldige snapshot. Storage Virtualize markeert de verdachte snapshot ook, zodat niemand er een herstelbewerking van uitvoert. Hierdoor blijft er een schoon herstelpunt over van vóór de encryptie begon.
Het netwerk bevat ook een beveiligingslaag. Broadcom integreert post-kwantumcryptografie in Brocade Gen 8-platforms, de Emulex SecureHBAs versleutelen data tijdens de overdracht van host naar opslagarray via dat netwerk, en de nieuwe FC-SP-3-standaard van FCIA stelt de kwantumveilige beveiligingsbasislijn vast voor Fibre Channel als geheel.
SAN-groei zonder zonebeheerproblemen: IBM FlashSystem AutoZoning met behulp van door Broadcom gestuurde zonebeheer
Het toevoegen van een host aan een Fibre Channel SAN vereist normaal gesproken een ticket en twee teams: de serverbeheerder verzamelt de HBA WWPN's, de SAN-beheerder bouwt handmatig zones op beide fabrics en de storagebeheerder koppelt de host aan de juiste doelpoorten. Eén verkeerd ingevoerde WWPN zorgt ervoor dat een nieuwe Oracle RAC-node geen paden heeft. AutoZoning verplaatst dit werk naar de array: FlashSystem communiceert rechtstreeks met de fabric, identificeert de initiator WWPN's, selecteert doelpoorten en creëert zelf de zones, zonder dat iemand hoeft in te loggen op een switch.

Deze functie is gebaseerd op Brocade Target Driven Zoning (TDZ) en is geïntroduceerd in FlashSystem-softwareversie 9.1.2. Hiervoor zijn Brocade-switches met Fabric OS 9.1.1 of hoger vereist, waarbij TDZ door de fabric-beheerder is ingeschakeld op de switchpoorten die zijn gekoppeld aan de FlashSystem-doelpoorten. Deze inschakeling is de enige stap die door het SAN-team moet worden uitgevoerd, en AutoZoning onderneemt pas actie op een poort nadat dit is gebeurd. Vervolgens bouwt FlashSystem peerzones, waardoor host-initiators de doelpoort kunnen bereiken, maar niet elkaar, onder een voorspelbare IBM_SV_-naam die aangeeft dat ze door de array worden beheerd.
De configuratie begint in de Fibre Channel-poortweergave, die nu laat zien met welke switch elke poort is verbonden, of de poort AutoZone-compatibel is en of de connectiviteit symmetrisch is, wat betekent dat dezelfde poort-ID op elk knooppunt op hetzelfde fabric-netwerk is aangesloten. Een topologieweergave brengt dit in kleur in kaart, waarbij alleen groene poorten die actief, AutoZone-compatibel en symmetrisch zijn, AutoZone ondersteunen. Asymmetrische poorten worden niet weergegeven, zelfs als ze verder wel AutoZone-compatibel zijn, omdat de GUI waarschuwt dat dit de redundantie en failover in gevaar kan brengen.

Het aanmaken van een host begint met een lijst van niet-geconfigureerde hosts, gevuld via FDMI, die de hostnaam, het besturingssysteem en de poorten van elke HBA aan het fabric rapporteert. In de handleiding van IBM werd het dialoogvenster 'Host toevoegen' geopend met de servernaam, het besturingssysteem en beide HBA-poorten van een host die nog geen zones had. De beheerder selecteerde een poortset met AutoZone-functionaliteit, die de doelpoorten definieert die de host kan bereiken, en klikte op 'Toevoegen'. FlashSystem koppelde de doelpoorten aan de host-initiators, pushte de zones naar beide switches en de host kwam online met vier paden over twee fabrics.

Voor Oracle positioneert IBM AutoZoning voor het toevoegen van RAC-nodes en het vervangen van HBA's, omdat de functie wijzigingen in host- of opslagconnectiviteit bijhoudt en zonedefinities hierop aanpast. Hierdoor hoeft een vervangen HBA niet handmatig opnieuw te worden gezoneerd. Dezelfde automatisering is van toepassing wanneer hosts paden naar een tweede array nodig hebben voor de migratie van opslagpartities of Policy-Based HA (PBHA). Het SAN-team behoudt de controle over welke doelpoorten deelnemen, aangezien er niets op een poort gebeurt totdat TDZ is ingeschakeld. Het toevoegen van een host is daardoor niet langer afhankelijk van een zoneringswijziging.
Operationeel kader: PBHA, netwerkmigratie, meerdere huurders en plaatsing
Policy-Based HA (PBHA) repliceert synchroon een opslagpartitie tussen twee FlashSystem-arrays op metro-afstand, met actieve-actieve hosttoegang op beide locaties. IBM stelt dat de functie is ontworpen voor een RPO van nul en voor een failover van de opslag die een correct geclusterde Oracle-implementatie kan doorstaan zonder gegevensverlies. Wanneer de uitgevallen locatie weer operationeel is, worden de gegevens gesynchroniseerd en kan de workload zonder onderbreking worden hervat.
De FlashSystem Grid-functie federeert tot 32 FlashSystem-arrays onder één beheersoverzicht, en met de migratie van opslagpartities wordt een partitie, inclusief volumes, volumegroepen en hosts, van de ene array naar de andere verplaatst zonder applicatie-uitval. Voor Oracle wijst IBM op hardwarevernieuwing, het leegmaken van een systeem vóór een firmware-update en het verplaatsen van een vectorpartitie naar een systeem met meer capaciteit naarmate de ingebedde set groeit. Een systeem migreert één partitie tegelijk via Fibre Channel of high-speed Ethernet; hosts kunnen verbinding maken via Fibre Channel, iSCSI of NVMe/TCP, en een partitie die al is geconfigureerd voor PBHA komt niet in aanmerking voor migratie.
De Storage Insights plaatsingsadviseur verzorgt de planning voor hetzelfde grid. Op basis van de capaciteit, groeisnelheid, I/O-profiel en latentiedoelstelling van een workload, beoordeelt de adviseur elk systeem in het grid, rangschikt het de meest geschikte optie voordat er iets wordt geprovisioneerd en kan het ook een migratie aanbevelen wanneer er een onevenwicht in CPU- of IOPS-gebruik wordt geconstateerd. Zowel migratie als plaatsing maken gebruik van Storage Insights Pro, waarbij elk systeem in het grid is geregistreerd bij dezelfde Storage Insights-tenant.

Multitenancy stelt een DBA-team en een AI-team in staat om hetzelfde grid te delen zonder de administratie te hoeven delen. In de handleiding van IBM creëerde een beheerder twee tenants op dezelfde array (Tenant_Scale en Tenant_oracle_ai) en gaf elk een systeem, een gebruikersgroep met een tenantrol en een eerste gebruiker. Vervolgens bouwde hij voor elke tenant een opslagpartitie met een aparte volumegroep, volumes en hosttoewijzingen. De GUI biedt de mogelijkheid om replicatie te configureren zodra een nieuwe partitie bestaat. Ingelogd als de gebruiker Tenant_Scale toonde de GUI alleen de partitie en resources van die tenant, zonder informatie van Tenant_oracle_ai, en dezelfde controle vanaf de kant van Tenant_oracle_ai gaf hetzelfde resultaat.
Het verschil tussen 32G en 64G Fibre Channel onder Vector Search.
De enige variabele die IBM en Broadcom tijdens deze tests bewust hebben gewijzigd, was de fabric. Dezelfde array, host en Emulex LPe38102 SecureHBA's hebben VectorDBBench tweemaal uitgevoerd op de BioASQ 1M-dataset (één miljoen vectoren met 1,024 dimensies uit het biomedische vraag-antwoordcorpus): eenmaal met de twee HBA-poorten op 32 Gbps en eenmaal op 64 Gbps, via dezelfde Brocade G820-switches. Al het andere, van de 16 ASM-volumes tot de 4 GB SGA, bleef ongewijzigd, dus het verschil tussen de twee runs zit hem in de Fibre Channel-generatie en niets anders.

De zoekfase van deze benchmark is een alleen-lezen scan: Oracle's IVF_FLAT-index routeert elke query naar een cluster van partities en leest deze volledig uit. Met FLOAT32-vectoren van 1,024 dimensies is dat een bandbreedte-intensieve workload. Op twee 32G-poorten stabiliseerden de leessnelheden aan de hostzijde zich op 6.3 GB/s, de lijnsnelheid van het paar, en de zoekcurve vlakte af op 43.7 queries per seconde met 20 threads. Op twee 64G-poorten las dezelfde host met 12.5 GB/s en bleef schalen tot 85.0 QPS met 80 threads, 95% meer doorvoer met dezelfde opslag.

De latentie vertelt het andere deel van het 64G-verhaal: bij één thread liggen de twee fabrics binnen 8% van elkaar, 0.107 seconden tegen 0.099, omdat een enkele query geen van beide pijplijnen volledig vult. Vanaf vijf threads begint de 32G echter met wachtrijen: de gemiddelde latentie verdubbelt bij elke stap ten opzichte van de 64G, en bij 80 threads bereikt p99 4.08 seconden tegen 1.14. Een verzadigde FC-fabric faalt niet; elke query wordt in de wachtrij geplaatst, en die wachttijd is zichtbaar als staartlatentie.

Ook de laadfase veranderde; het verwerken van de miljoen vectoren duurde 94.1 seconden op 32G en 84.5 seconden op 64G, en het opbouwen van de IVF_FLAT-index duurde 139.6 seconden in plaats van 108.4 seconden, 28.8% langer op de tragere verbinding, voor een totale laadtijd van 233.7 seconden in plaats van 193.0 seconden. Recall en NDCG lagen binnen 0.1% van elkaar bij beide runs (83.81% en 84.42% op 32G, 83.95% en 84.56% op 64G), dus de verbinding had invloed op de snelheid waarmee antwoorden binnenkwamen. Voor een database die sinds de implementatie op 32G draait, is de upgrade van de HBA en de switch een duidelijke kans om betere prestaties te leveren.
Planning voor de groei van de vectorcapaciteit
Vectorzoekopdrachten veranderen de capaciteitsberekeningen voordat ze de prestaties beïnvloeden. Een embedding is een numerieke kopie met een vaste breedte van een stuk brondata, en voor tekst is die kopie meestal groter dan het stuk dat het beschrijft: een passage van 1,000 bytes wordt een FLOAT32-vector met 1,024 dimensies van 4,096 bytes voordat de database een rij toevoegt om deze op te slaan. Het team noemt dit vectoropslagamplificatie en heeft dit gemeten op dezelfde BioASQ 1M-dataset die werd gebruikt in de fabric-vergelijking.
De brontekst achter de miljoen vectoren is 0.90 GB. In Oracle 26ai werd dit een vectortabel van 7.67 GB, inclusief ongeveer 0.3 GB aan overhead voor rijen. De IVF_FLAT-index voegde daar nog eens 8.57 GB aan toe, omdat deze een tweede, geclusterde kopie van elke vector bewaart, plus ongeveer 4 MB aan centroids. De permanente footprint op de SAN is 16.24 GB, 18 keer de brontekst, nog voordat de operationele ruimte die Oracle eromheen nodig heeft, wordt meegerekend: 15 tot 23 GB TEMP tijdens het opbouwen van de index, en 4 tot 8 GB UNDO en ongeveer 15 GB REDO tijdens het importeren.

De vermenigvuldigingsfactor schaalt mee met het inbeddingsmodel: Broadcom extrapoleert vanuit dezelfde methode en schat de vermenigvuldigingsfactor voor een 768-dimensionaal Cohere v3-model (ook gemeten) op 4.8x de bron, voor een 384-dimensionaal MiniLM-model op 9.6x en voor een 4,096-dimensionaal Mistral-model op 32.5x. De chunkgrootte is net zo belangrijk als de breedte, aangezien een brede vector over een lange passage minder versterkt wordt dan dezelfde vector over een korte passage, en gekwantiseerde indexen verkleinen het indexaandeel.
Dit alles is niet specifiek voor FlashSystem of Oracle. De amplificatie vindt plaats binnen de database voordat de array een byte ziet, en elke vectorindex op elk platform bevat een kopie van de vectoren. Daarom hoort het thuis in het capaciteitsbudget op de dag dat een vectorproject wordt goedgekeurd, samen met de GPU's. Wat de array bepaalt, is hoeveel van die groei het aankan: IBM's vijfde generatie FlashCore Module heeft een capaciteit van 105.6 TB per module, wat neerkomt op 3.3 PB ruwe ruimte in een 2U-behuizing op de grootste FlashSystem-modellen, 11.8 PB effectieve ruimte volgens IBM. Een vectorlaag kan dus jarenlang op dezelfde plek groeien voordat een partitie verplaatst moet worden.
IBM's dimensioneringsmodel voor de zorgtoepassing die hierna volgt, werkt andersom voor afbeeldingen: 100 GB aan röntgenfoto's levert ongeveer 2 GB aan databaseruimte op, omdat alleen de embeddings en casusmetadata daarin worden opgeslagen. Tekst is de duurste: 100 GB aan gechunkte klinische tekst komt neer op 860 GB tot 1.2 TB, waarvan het grootste deel HNSW-index is. De input voor de dimensionering is het aantal chunks en de breedte van het model; de broncorpus is geen goede leidraad. Embeddings comprimeren ook minder dan rijen, 1.2 tot 2 keer, vergeleken met 2 tot 4 keer voor relationele data, volgens IBM's ervaring. Daardoor kan de datareductie van de FlashCore Module minder van de groei terugwinnen, en elke her-embed vereist opnieuw de TEMP-ruimte.
De praktische regel van IBM is: meet voordat je een definitieve beslissing neemt. Laad 1 tot 5 procent van het daadwerkelijke corpus met het productiemodel en de chunking-instellingen, meet het werkelijke aantal bytes per vector, schaal vervolgens lineair en herhaal de oefening telkens wanneer het model, het aantal dimensies of het chunking-beleid verandert.
End-to-end AI-inferentie: de toepassing in de gezondheidszorg
IBM ontwikkelde de applicatie voor deze validatie als een assistent voor radiologie en gastro-enterologie, genaamd RAD-AI. Het is een voorbeeldapplicatie met eisen die vergelijkbaar zijn met die van een productieomgeving. In dit artikel wordt een complete inferentiepipeline gedemonstreerd op dezelfde array en hetzelfde netwerk als de eerder gemeten secties. Een arts voert de leeftijd, het geslacht en de klachten van een patiënt in, uploadt een röntgenfoto van de borstkas of een endoscopiebeeld en ontvangt een gestructureerd rapport dat is samengesteld uit de meest vergelijkbare eerdere gevallen in het archief.
Het archief bevat 112,120 röntgenfoto's van de borstkas uit de NIH ChestX-ray14-dataset en meer dan 10,000 endoscopiebeelden van het maag-darmkanaal uit HyperKvasir, inclusief per-frame vectoren van 367 volledige endoscopievideo's, voor meer dan 172,000 vooraf ingebedde casussen. Elke afbeelding wordt een 768-dimensionale vector door een CLIP ViT-L/14-model dat draait in Oracle AI Database 26ai via de ONNX-runtime, waardoor de inbedding in dezelfde transactie terechtkomt als de rij waarin deze zich bevindt. De onbewerkte afbeeldingen blijven in objectopslag; de vectoren en casusmetadata worden opgeslagen in Oracle.

Tijdens het opvragen van gegevens voert Oracle een benaderende zoekopdracht uit naar de dichtstbijzijnde buur op basis van de cosinusafstand in het archief en retourneert de meest relevante gevallen, samen met hun oorspronkelijke bevindingen, diagnoses en uitkomsten. Deze opgehaalde gegevens vormen de context voor Llama 3, dat door Ollama wordt uitgevoerd op een van de H100 GPU's in de Supermicro-server. Llama 3 genereert vervolgens het rapport: een klinische prioriteit, een samenvatting van de bevindingen, een gerangschikte differentiële diagnose en aanbevolen acties, met daaronder een lijst van de overeenkomende gevallen. Endoscopie volgt hetzelfde pad en voegt een klinische notitie toe; voor video integreert de pipeline frame voor frame, zodat een laesie langs het maag-darmkanaal kan worden gevolgd.
De applicatie voert twee workloads uit op dezelfde FlashSystem-volumes. De transactionele workload omvat aanmeldingen, rapportopslag, auditregistratie en sessies; de vectorworkload voert willekeurige leesbewerkingen met een hoge fan-out uit over de embeddingtabellen en casusmetadata, overeenkomend met het generatorprofiel in de I/O QoS-demonstratie. De implementatie van IBM stelt de eerder beschreven volumebeperkingen zo in dat een batch-re-embeddingtaak een arts niet vertraagt bij het openen van een casus, en de hierboven getoonde ransomwaredetectie en partitiemigratie zijn ongewijzigd van toepassing op deze volumes.

De meest resource-intensieve stap is het bouwen van het archief. IBM heeft dit gemeten door de volledige set van 112,120 röntgenfoto's van de borstkas tweemaal in te bedden met hetzelfde model en dezelfde VECTOR(768, FLOAT32)-target. Met het ONNX-model dat in de database op de host-CPU's draaide, haalde de pipeline een doorvoer van 3.41 afbeeldingen per seconde met een verwerkingstijd van 0.272 seconden per inbedding, en de volledige set duurde 9.1 uur. Door het model naar de Private AI Services-container van Oracle op de tweede server te verplaatsen, steeg de doorvoer naar 8.55 afbeeldingen per seconde (0.097 seconden per afbeelding), en was dezelfde verwerking in 3.6 uur voltooid.

De voorbewerking (ongeveer 0.019 seconden per afbeelding) en de Oracle-insert (minder dan een milliseconde) waren identiek bij beide runs, dus de winst van 2.5x komt volledig voort uit de locatie waar het model wordt uitgevoerd. De embedding-service van Private AI Services draait op een CPU ONNX-runtime, dus de H100's op die server werden niet gebruikt in deze test; de winst kwam voort uit het feit dat het model niet langer op de databasehost draait, en het aandeel van de GPU in de pipeline is de indexopbouw, die hierna wordt besproken.
IBM heeft deze cijfers gemeten in het laboratorium in Colorado; wij hebben de test niet uitgevoerd of gecontroleerd. De praktische conclusie is dat het eerste inbedden van een archief, en elke herinbedding na een modelwijziging, een batchtaak is die uren duurt, terwijl het ophalen dat daarop volgt een CPU- en opslagtaak is die milliseconden duurt.
Dezelfde container verzorgt ook de indexconstructie. Oracle 26ai kan een HNSW-build naar de Vector Index Service van de container sturen, die NVIDIA cuVS op de GPU gebruikt om de nabuurgrafiek op te bouwen voordat de voltooide index naar de database wordt teruggestuurd. Zoekopdrachten worden vervolgens zonder GPU-ondersteuning uitgevoerd. In de meting van IBM duurde de basis HNSW-build (32 buren, efConstruction 200) 8.47 seconden in de database en 2.26 seconden met de offload, een reductie van 3.7x. Deze test gebruikte een kleine demonstratietabel, dus het bevestigt dat de methode werkt in deze configuratie; we moeten de resultaten op klinische schaal nog meten.
De applicatie demonstreert de taakverdeling die centraal staat in dit artikel. De GPU-server host het taalmodel en, tijdens het bouwen of herbouwen van archieven, de inbeddings- en indexeringsservices. De database slaat vectoren op samen met de records die ze beschrijven, terwijl de array en fabric de leesbewerkingen en transacties voor het ophalen van gegevens afhandelen. Geen enkele stap in het ophaalproces maakt gebruik van een externe API en patiëntgegevens verlaten nooit het datacenter.
IBM koos de gezondheidszorg als sector om het concept te bewijzen, en niets in het patroon is specifiek voor die sector. Vervang het röntgenarchief door declaratiegeschiedenissen, onderhoudsgegevens of een productcatalogus en dezelfde drie onderdelen blijven behouden: vectoren die naast de records die ze beschrijven worden opgeslagen, generatie op de GPU-server en ophalen en transacties op één array. Elke branche die inferentie uitvoert op data die ze al bezit, komt uit op dezelfde architectuur.
Wat volgt
De validatie wordt voortgezet op dezelfde hardware: Fase 2 verplaatst de KV-cache van de inferentie-engine van GPU-geheugen naar FlashSystem via hetzelfde Fibre Channel-netwerk, zodat een model met een lange context een groter deel van zijn werkset binnen bereik houdt; het volgende artikel in deze reeks beschrijft dat werk. IBM bouwt ook een contentbewuste vernieuwingspipeline, waarbij IBM Storage Scale AFM en Kafka nieuwe documenten aan de in-database ONNX-vectorisatie leveren zodra ze binnenkomen, zodat de vectorindex zijn bronnen bijhoudt zonder een batch-re-embed. IBM is ook van plan dezelfde opslagvalidatie uit te breiden naar de andere multi-modeldatabases die vectorzoekfunctionaliteit hebben toegevoegd.
Fase 2 zet de beveiligingslaag ook in voor nieuwe data. Wanneer de KV-cache naar FlashSystem wordt verplaatst, wordt de werkcontext van een zorgmodel (inclusief patiëntgeschiedenis) via dezelfde Fibre Channel-verbindingen verzonden als de vectorindex en de transactiegegevens. Emulex SecureHBAs versleutelen deze gegevens tijdens de overdracht van begin tot eind, van de hostadapter tot de opslagarray. De Brocade Gen 8-fabric transporteert het versleutelde verkeer transparant en biedt tevens post-quantumcryptografie voor inter-switch link (ISL) en langeafstandsverkeer. Elke fase voegt een workload toe aan de fabric zonder een extra pad te creëren waarlangs data onversleuteld wordt verzonden.
Leaderboard: IBM's profiel op onze pagina met de beste opslagarrays omvat nu naast Storage Scale ook FlashSystem-blokopslag.
Dit rapport wordt gesponsord door Broadcom. Alle standpunten en meningen die in dit rapport worden geuit, zijn gebaseerd op onze onpartijdige visie op het/de product(en) in kwestie.


 Amazon