

Ollama 0.40.11 biedt Windows-gebruikers een desktopchattoepassing en een lokale modelruntime voor andere software. Ollama is ook verder gegaan dan de oorspronkelijke commandoregelinterface en heeft een doorzoekbare modelkiezer, de mogelijkheid om afbeeldingen bij te voegen en links naar programmeertools toegevoegd. Sommige besturingselementen die we nodig hadden voor het testen, zijn nog steeds beschikbaar in PowerShell en modelconfiguratiebestanden.
We hebben Ollama geïnstalleerd op onze HP Z4 Rack G5 met Windows 11 Pro voor werkstations, 128 GB RAM en een NVIDIA RTX 5000 Ada Generation GPU. Met onze bestaande Jan V3.5 4B en Jan V2 VL High GGUF's hebben we de generatiesnelheid, chat, afbeeldingen, online zoeken en de lokale API getest. Ollama verwerkte onze lokale modellen goed, hoewel het importeren van de GGUF's en het verzamelen van prestatiegegevens ons uit de desktopchat haalde. Het is de derde applicatie in onze reeks lokale LLM-tools, na Jan en Open WebUI , en de resultaten worden gebruikt voor onze pagina met de beste lokale LLM-tools .
Testsysteem
| Bestanddeel | Configuratie |
|---|---|
| Besturingssysteem | Windows 11 Pro voor werkstations |
| CPU | Intel Xeon w5-2465X, 16 kernen |
| Geheugen | 128GB |
| GPU | NVIDIA RTX 5000 Ada-generatie |
| VRAM | 32 GB (32,760 MiB gerapporteerd) |
| NVIDIA Driver | 597.06 |
| CUDA-compatibiliteit | 13.2 (gerapporteerd door nvidia-smi) |
| Ollama | 0.40.11 |
| Inferentie-runtime | Ollama llama.cpp runner (buildnummer niet geregistreerd) |
Ollama installeren en aan de slag gaan
Het installeren van Ollama op ons Windows-werkstation was een welkome verandering ten opzichte van de installatieproblemen die we bij andere applicaties in deze reeks tegenkwamen. We downloadden het standaard Windows-installatieprogramma, startten de applicatie en hoefden geen aparte inferentie-runtime te installeren of CUDA-pakketten op te sporen. Een snelle controle via PowerShell bevestigde dat Ollama 0.40.11 draaide en dat de lokale service al reageerde op http://127.0.0.1:11434.
Het welkomstscherm van Ollama introduceert de lokale AI-functies en de koppelingen met programmeertools voordat de hoofdinterface wordt geopend.
Nadat we het welkomstscherm hadden doorlopen, opende Ollama met een vertrouwde chatinterface met recente gesprekken, apps en instellingen in de linkerzijbalk. Het berichtveld bevatte de knop voor bijlagen, de webzoekfunctie en de modelkiezer. We konden direct chatten met onze geïmporteerde lokale modellen zonder een account aan te maken, hoewel Ollama ons later tijdens het testen wel vroeg om in te loggen toen we de webzoekfunctie wilden inschakelen.
Modellen bekijken en toevoegen
Ollama houdt de modelselectie vrij eenvoudig, met een dropdownmenu dat zowel geïnstalleerde modellen als modellen die te downloaden zijn, toont. We zagen onze geïmporteerde Jan-modellen en Qwen3-VL naast verschillende cloudgebaseerde opties, die werden aangeduid met een klein wolkje. Er is ook een zoekveld om andere modellen te vinden, hoewel we hier graag meer informatie hadden gezien, zoals modelgroottes, kwantisering en hardwarevereisten. Jan biedt deze details via hun modelhub, terwijl Ollama de meeste van deze informatie buiten de hoofdchatinterface houdt.
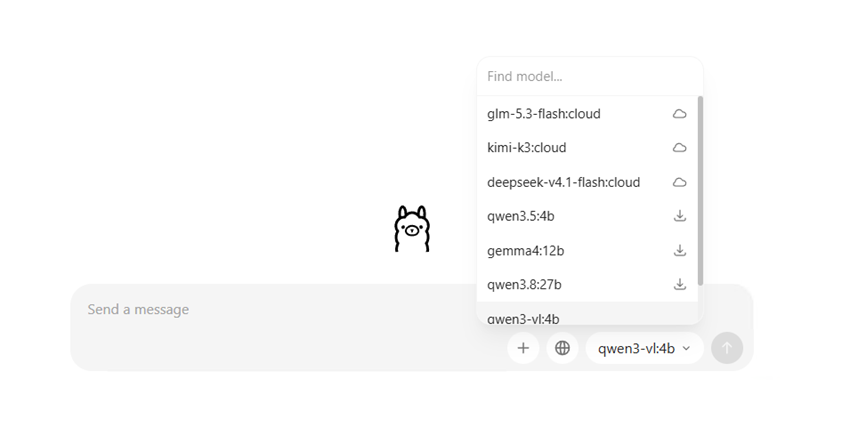
De modelkiezer combineert downloadbare en cloudmodellen met de lokaal geïnstalleerde modellen.
Het importeren van onze twee benchmarkmodellen in Ollama kostte meer moeite, omdat we exact dezelfde GGUF-bestanden wilden gebruiken als in onze eerdere reviews. Zo wilden we de prestatietests zo vergelijkbaar mogelijk houden. Hoewel je in Ollama modellen rechtstreeks via de desktopinterface kunt downloaden, konden we geen optie vinden om GGUF-bestanden te importeren die al op het werkstation waren opgeslagen. We moesten daarom PowerShell gebruiken en voor elk model een Modelfile aanmaken die verwees naar het bestaande GGUF-bestand en de samplingparameters bevatte die we in onze eerdere tests hadden gebruikt. Vervolgens gebruikten we de ollama create commando om ze toe te voegen aan de modelbibliotheek van Ollama.
Beide importen verliepen zonder problemen, waarbij Jan V3.5 als volgt werd weergegeven: jan-v35-sr en Jan V2 VL Hoog als jan-v2-srWe hebben Qwen3-VL 4B ook rechtstreeks via Ollama gedownload voor een aparte beeldanalysetest.
Na het importeren van de modellen hebben we gecontroleerd hoe Ollama ze identificeerde en of hun instellingen correct waren overgenomen. Jan V2 VL High werd herkend als een Qwen3-VL-model met 8.2 miljard parameters dat gebruikmaakt van Q4_K_M-kwantisatie, wat overeenkwam met ons oorspronkelijke bestand. Jan V3.5 was de uitzondering, omdat het GGUF-bestand dat we importeerden een andere naam had. Jan-v3.5-4B-Q4_K_XL.ggufMaar Ollama gaf aan dat de kwantisering Q4_K_M was. We hebben het originele bestand ongewijzigd gelaten; de waarschijnlijke reden hiervoor is dat Q4_K_XL de dynamische kwantisering van Unsloth is, die grotendeels is opgebouwd uit Q4_K_M-lagen, en dat de metadata van het bestand dat basistype registreert.
Modelinstellingen en GPU-gebruik
De instellingenpagina van Ollama bevat opties voor cloudtoegang, automatische updates, netwerktoegang, een pad voor modelopslag en een schuifregelaar voor de contextlengte, die bij onze eerste inspectie 32K aangaf. Onze prestatietests vroegen expliciet 8,192 tokens aan via de API, dus de onderstaande benchmarkresultaten gebruikten die context, niet de standaard desktopcontext.
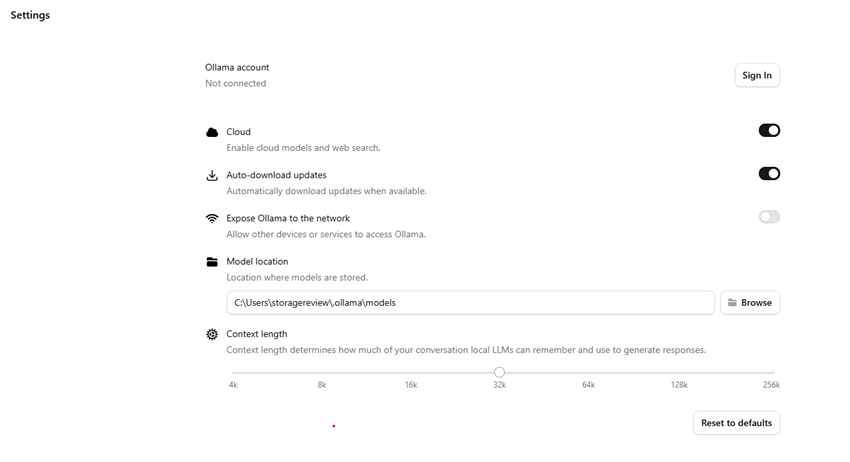
De pagina Instellingen biedt opties voor cloud, updates, netwerk, modelopslag en contextlengte. De initiële contextinstelling die hier wordt weergegeven, was 32K.
Omdat Ollama via de desktopinterface niet dezelfde mate van modelconfiguratie biedt als Jan, hebben we de meeste aanpassingen gedaan via modelbestanden en API-verzoeken. Om onze benchmarks vergelijkbaar te houden, hebben we dezelfde instellingen gebruikt als in onze vorige tests: temperatuur 0.8, Top K 40, Top P 0.95, Min P 0.05 en een herhalingsstraf van 1.0. We hebben ook een batchgrootte van 2,048 aangevraagd, hoewel we niet onafhankelijk konden verifiëren of Ollama deze tijdens de generatie heeft toegepast.
De GPU-configuratie was ook anders, aangezien er geen desktopinstelling was die overeenkwam met de 100 GPU-lagen die we in januari gebruikten. Ollama verzorgde de GPU-offloading automatisch, en een snelle controle met ollama ps bevestigde dat beide geïmporteerde modellen volledig op de RTX 5000 Ada draaiden.
We hebben dat rapport vergeleken met de eigen metingen van NVIDIA. Jan V3.5 verhoogde de VRAM-toewijzing met enkele gigabytes na het laden, en een live meting bereikte 93 procent GPU-gebruik tijdens het genereren. Jan V2 rapporteerde ook een volledige GPU-residentie en toonde 96 procent gebruik in onze diagnostische test. Tenminste op dit werkstation hoefden we geen aparte CUDA-variant of GPU-laagconfiguratie te gebruiken om versnelde generatie te verkrijgen.
Prestaties van lokale energieopwekking
Voor de generatietests gebruikten we dezelfde prompt als in onze gepubliceerde praktijktest van januari : "Leg RAID 5 en RAID 6 uit aan iemand die zijn eerste NAS bouwt. Beschrijf de belangrijkste voor- en nadelen van beide, in ongeveer 400 woorden." We schakelden webzoekopdrachten uit, stelden de context in op 8,192 tokens en namen alleen dat ene gebruikersbericht op in elk API-verzoek. We verwierpen één opwarmreactie per model en verzamelden vervolgens drie meetruns.
Beide modellen voltooiden alle drie de meetruns zonder generatiefouten, en het GPU-gebruik bleef gedurende de hele test hoog. Ollama vereiste geen extra CUDA-configuratie of handmatige aanpassingen aan de GPU-laag om beide modellen met volledige GPU-acceleratie te laten draaien, wat niet het geval was bij Open WebUI, waar we handmatig CUDA-runtime-DLL's hebben toegevoegd.
| Model | quantisatie | Uitvoertokens | Decodeersnelheid | GPU-geheugen |
|---|---|---|---|---|
| Jan V3.5 4B | Q4_K_XL-bestand* | 529 | 145.48 tok/s | 5,082 MiB |
| Jan V2 VL High | Q4_K_M | 1,696 | 92.87 tok/s | 7,124 MiB |
Opmerking: Het aantal uitvoertokens, de decodeersnelheden en de GPU-geheugencijfers zijn de medianen van drie gemeten runs na één weggegooide opwarmrun. Het GPU-geheugen is de mediaan van het piekgebruik van het GPU-brede geheugen dat tijdens elke gemeten run is geregistreerd.
*De bestandsnaam Jan V3.5 GGUF identificeert Q4_K_XL, terwijl de modelinformatie van Ollama Q4_K_M vermeldt; zie de importnotities hierboven.
Jan V3.5 registreerde 145.48, 145.73 en 145.44 tokens/sec tijdens de gemeten runs, terwijl Jan V2 92.87, 92.22 en 92.97 tokens/sec registreerde. Beide sets bleven qua resultaten dicht bij elkaar van run tot run, en de gemeten pieken in het GPU-geheugengebruik bleven binnen elke set ongewijzigd. Jan V2 produceerde aanzienlijk meer gerapporteerde uitvoertokens, blijkbaar inclusief redeneeractiviteit, dus deze totalen zijn geen directe vergelijking van de zichtbare antwoordlengte.
Op hetzelfde werkstation en met dezelfde modelbestanden zijn dit de snelste resultaten in deze reeks tot nu toe. Jan V3.5 decodeerde 18 procent sneller dan Jan zelf (123 tokens/sec) en 26 procent sneller dan Open WebUI Desktop (115.32), en Jan V2 was 13 procent sneller dan Jan (82) en 24 procent sneller dan Open WebUI (75.06). Elke applicatie draait zijn eigen llama.cpp-build en beheert GPU-offload op zijn eigen manier, dus de vergelijking weerspiegelt het complete pakket dat elke applicatie levert, niet alleen het model.
We hebben de medianen van de promptverwerking niet gepubliceerd omdat herhaalde verzoeken zeer korte tijden opleverden die mogelijk door caching werden beïnvloed. Ook kunnen de runtime-instellingen niet in alle opzichten identiek zijn: Jan stelde GPU-lagen direct beschikbaar, terwijl Ollama de offload automatisch afhandelde.
Ollama gebruiken voor lokale chat
Nadat de modellen waren geïnstalleerd, selecteerden we Jan V3.5 of Jan V2 in het keuzemenu en voerden we de RAID-prompt in. De antwoorden verschenen met kopjes en lijsten, terwijl recente gesprekken in de zijbalk bleven staan. Ollama gaf de generatiesnelheid of het aantal tokens niet weer onder de antwoorden, dus verzamelden we die gegevens via de API.
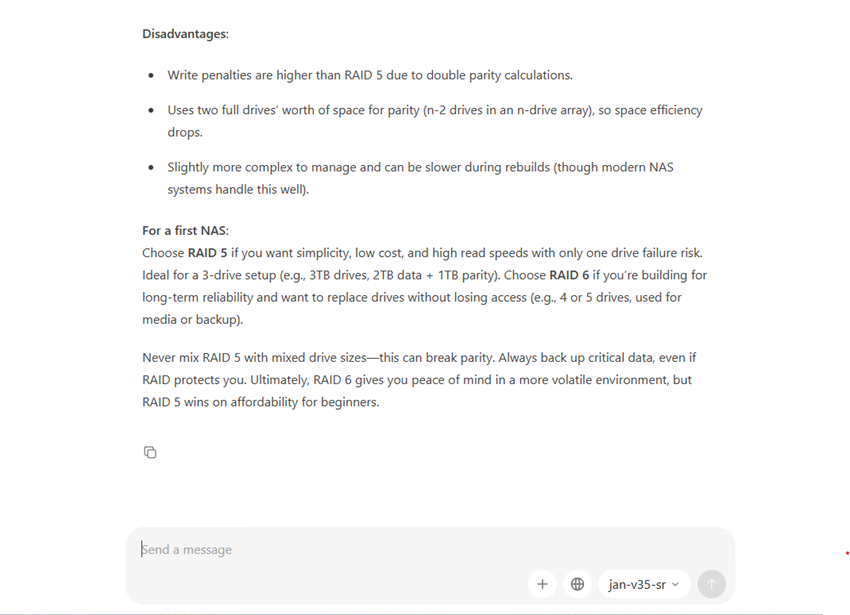
Jan V3.5 beantwoordt de vraag over RAID 5 versus RAID 6 in de desktopchat van Ollama, zonder dat de token-rate onder het antwoord wordt weergegeven.
Het beheren van gesprekken in Ollama was vrij eenvoudig. Door met de rechtermuisknop op een eerder gesprek te klikken, verschenen opties om het te hernoemen of te verwijderen, met een optie 'Delen' onder 'Meer tools'. We konden ook teruggaan en prompts bewerken die we al hadden verzonden, hoewel er minder opties waren voor de reacties van het model. De enige knop die we vonden was 'Kopiëren', die onder elk antwoord zichtbaar blijft, zelfs als je er niet met de muis overheen beweegt. We konden geen manier vinden om een reactie opnieuw te genereren of de statistieken van de gegenereerde reactie vanuit het chatvenster te bekijken, althans niet in de versie die we hebben getest.
Ollama heeft ook een sectie 'Apps' met programmeerhulpmiddelen, waaronder Codex CLI, Claude Code, OpenCode en Cline. We wilden zien hoe deze integraties werkten, dus klikten we op Codex CLI om te zien wat de installatie inhield. Ollama opende geen configuratiescherm; het kopieerde een opstartopdracht naar het klembord en vroeg ons deze in een terminal te plakken. We hebben de volledige installatie niet voltooid en Codex niet uitgevoerd, maar het gaf ons wel een beter beeld van hoe Ollama lokale modellen verbindt met externe applicaties.
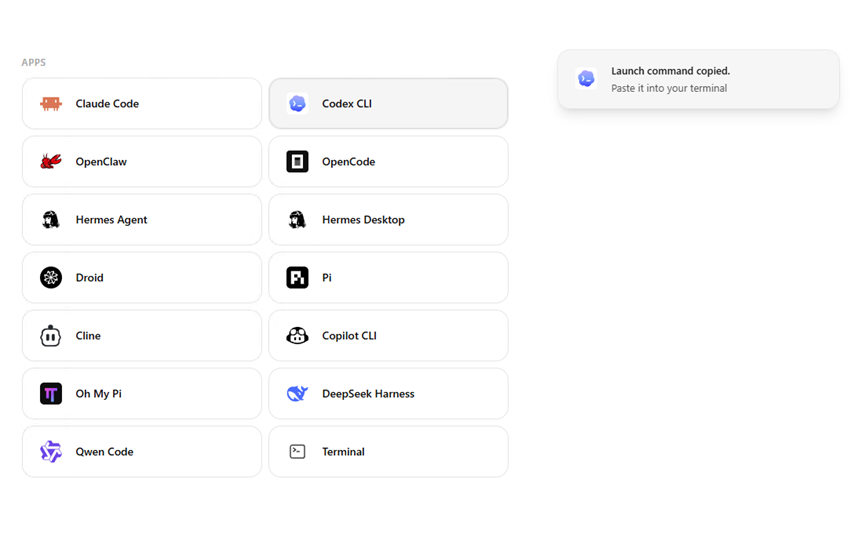
Door Codex CLI te selecteren op de pagina 'Apps' werd een opstartopdracht voor de terminal gekopieerd; we hebben de integratie zelf niet uitgevoerd.
Zoeken op het web
Ollama plaatst een wereldbolknop naast de bijlageknop in de chat, maar bij het selecteren ervan verscheen de melding dat web zoeken een Ollama-account vereist. Nadat we een gratis account hadden aangemaakt en de functie hadden ingeschakeld, gebruikten we onze bestaande testvraag waarin we vroegen naar de meest recente stabiele versie van Open WebUI van 15 oktober 2026, met een bronvermelding.
We stuitten op een ander probleem tijdens het testen van de webzoekfunctie van Ollama: de applicatie probeerde resultaten op te halen, maar gaf in plaats daarvan een "search API error (status 402)"-melding terug. HTTP 402 is de code die aangeeft dat een betaling vereist is, wat suggereert dat de zoekservice een betaald abonnement nodig heeft, hoewel Ollama dit niet expliciet vermeldde. Het model suggereerde dat het probleem mogelijk verband hield met accountkosten of gebruikslimieten, maar we konden de exacte oorzaak niet vaststellen. Aangezien onze lokale modellen normaal functioneerden, besloten we geen verdere tijd te besteden aan het oplossen van het probleem met de zoekservice. Het was echter wel teleurstellend dat we de webzoektest die we met de andere applicaties in deze reeks hadden uitgevoerd, niet konden voltooien.
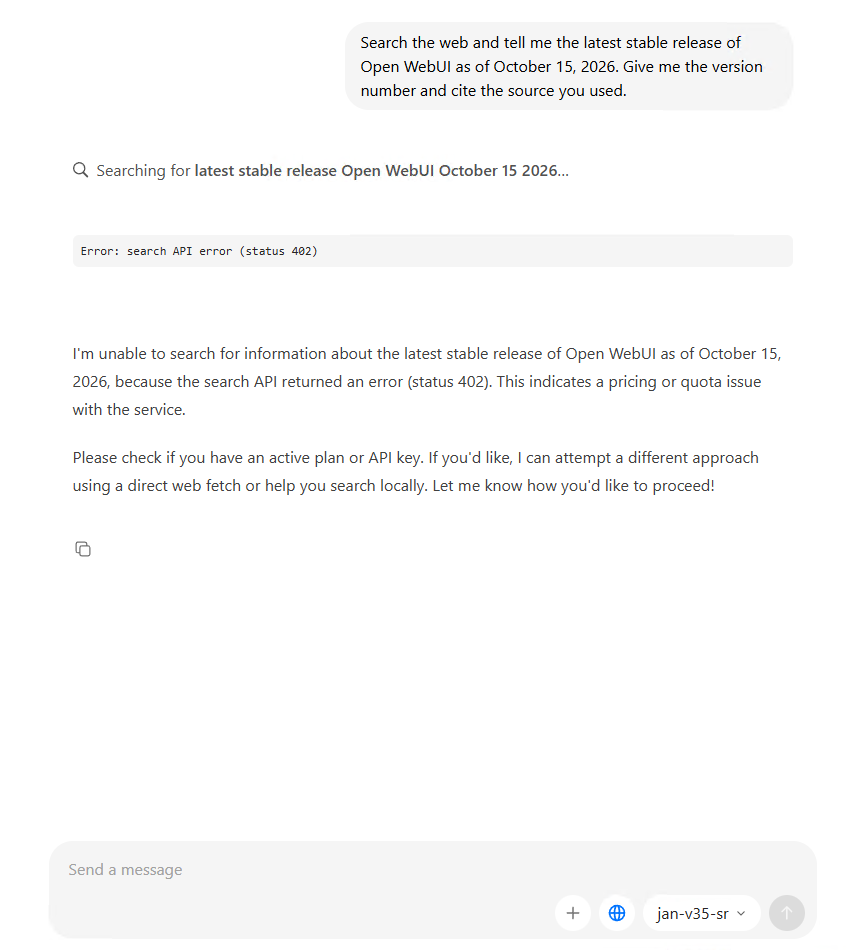
Ollama probeerde onze online versie van de zoekopdracht uit te voeren, maar gaf een HTTP 402-foutmelding van de zoek-API.
Multimodale invoer
Onze eerste beeldtest maakte gebruik van hetzelfde Jan V2 VL High GGUF-bestand dat werkte met een aparte vision-projector in Jan. Ollama accepteerde het taalmodelbestand, maar onze importprocedure koppelde het bijbehorende mmproj-bestand niet. Toen we probeerden de NVIDIA-screenshot aan een Jan V2-gesprek toe te voegen, gaf de desktopapplicatie de melding "Dit model ondersteunt geen afbeeldingen" weer voordat we de prompt konden verzenden.
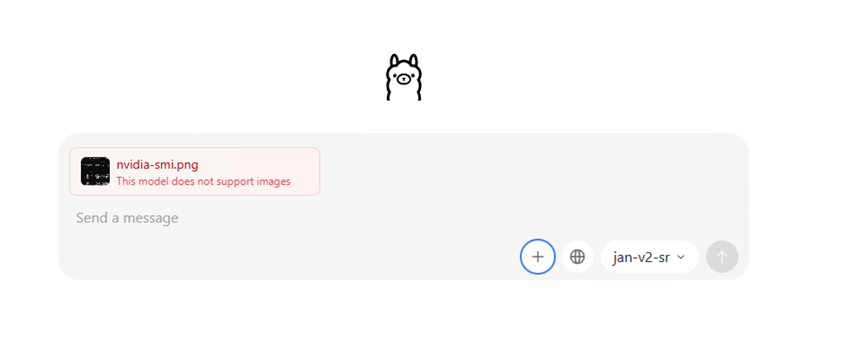
Ons geïmporteerde Jan V2 VL High-model weigerde de NVIDIA-screenshot, met de melding dat het geen afbeeldingen in deze configuratie ondersteunde.
Vervolgens probeerden we Qwen3-VL 4B, gedownload via Ollama, met dezelfde prompt waarin gevraagd werd naar het GPU-model, de driverversie, het VRAM-geheugen, het gebruik, de temperatuur en het stroomverbruik. Dat model accepteerde de schermafbeelding en gaf de juiste zes waarden weer: RTX 5000 Ada-generatie, driver 597.06, 32,760 MiB, 0 procent gebruik, 39°C en 40W. De respons was niet overal perfect, want het gaf kortstondig een onjuiste waarde van 8 procent gebruik weer, voordat die waarde in de eindsamenvatting werd gecorrigeerd.
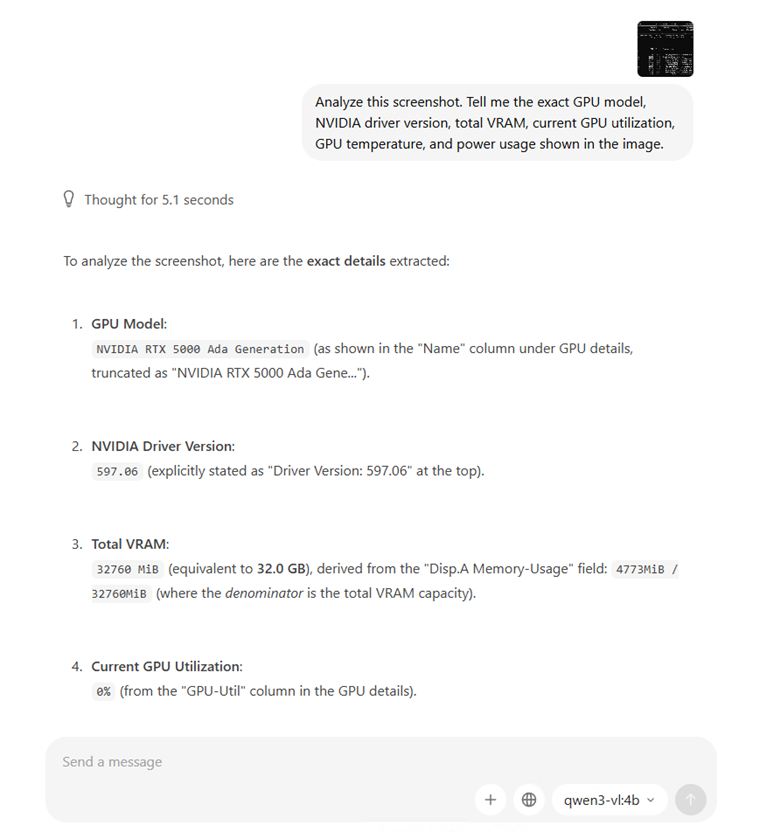
De Ollama Qwen3-VL 4B verwerkte de bijgevoegde NVIDIA-screenshot en identificeerde de hardwaregegevens; de uiteindelijke samenvatting gaf alle zes metingen correct weer.
In Ollama konden we geen afbeelding rechtstreeks vanuit Windows Knipprogramma in het chatvenster plakken, zoals bij andere applicaties wel mogelijk was. We moesten de schermafbeelding eerst opslaan en vervolgens uploaden met de + knop naast het berichtveld. Dat werkte zonder problemen en Ollama's Qwen3-VL-model analyseerde de afbeelding succesvol. Ons geïmporteerde Jan V2-model kon dezelfde bijlage niet accepteren, waardoor we de oorspronkelijke multimodale test niet konden herhalen.
Lokale API-server
De lokale API van Ollama was beschikbaar zodra de Windows-service startte, zonder dat er een aparte server vanuit de desktopinterface hoefde te worden opgestart. Een verzoek aan http://127.0.0.1:11434/v1/models We hebben onze geïnstalleerde Jan V3.5- en Qwen3-VL-modellen geretourneerd, en een verzoek ingediend om /v1/chat/completions Met behulp van Jan V3.5 werd een uitleg van RAID 6 in één zin gegenereerd.
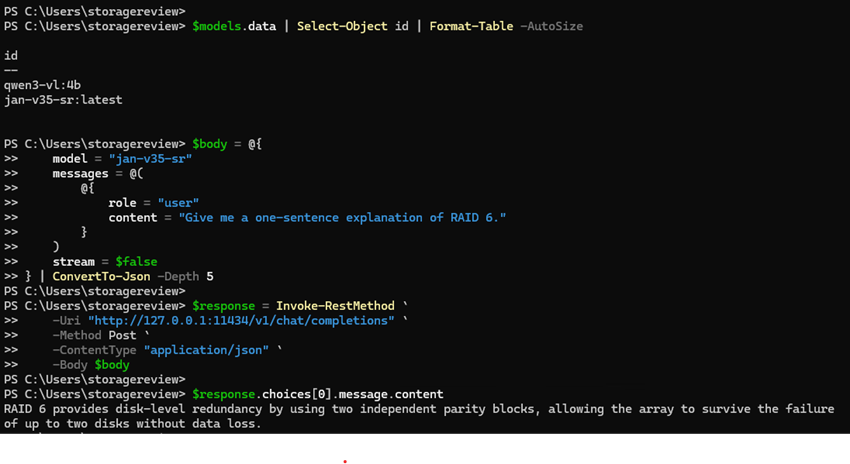
De OpenAI-compatibele lokale API gaf de lijst met geïnstalleerde modellen van Ollama en een RAID 6-chatreactie via PowerShell terug.
Het antwoord gebruikte een enigszins onnauwkeurige formulering met betrekking tot RAID 6-pariteit, wat een probleem was met de modeloutput en niet met een API-fout. Het werkende eindpunt stelde ons in staat om lokale modellen rechtstreeks vanuit PowerShell op te vragen zonder gebruik te maken van de desktopchat.
Wat ging er mis
Het meest frustrerende probleem dat we tegenkwamen, was het werkend krijgen van ons geïmporteerde Jan V2 VL High-model met afbeeldingen. We hadden geen problemen met het importeren van het GGUF-bestand of het uitvoeren van tekstprompts met volledige GPU-acceleratie, maar dat veranderde toen we onze NVIDIA-screenshot probeerden toe te voegen. Ollama vertelde ons dat het model geen afbeeldingen ondersteunde omdat onze import de aparte vision projector die Jan V2 vereist, niet bevatte. We konden de beeldanalysetest nog steeds voltooien met Ollama's Qwen3-VL-download, die zonder problemen werkte. Dit toonde aan dat Ollama afbeeldingen kon verwerken, maar het was niet zo eenvoudig om ons bestaande Jan V2-model hetzelfde te laten doen door simpelweg het GGUF-bestand te importeren.
Om de webzoekfunctie te kunnen gebruiken, moesten we eerst een Ollama-account aanmaken. Nadat we waren ingelogd en onze testvraag hadden ingediend, gaf de service een HTTP 402-foutmelding en geen zoekresultaten. We konden niet achterhalen wat de fout veroorzaakte en er was weinig reden om accountinstellingen te blijven wijzigen of verschillende abonnementen uit te proberen zonder te weten of dat zou helpen.
We merkten ook hoe vaak we terug moesten naar PowerShell voor taken zoals het importeren van onze bestaande modellen, het aanpassen van hun instellingen en het verzamelen van prestatiegegevens. De desktopapplicatie was gemakkelijk te gebruiken voor dagelijkse communicatie, maar bood niet dezelfde mate van controle als de interface van Jan. Afgezien van deze problemen gaf Ollama ons tijdens het testen weinig problemen: beide modellen werden succesvol geïmporteerd, alle zes benchmarktests werden voltooid en de lokale API werkte zoals verwacht.
Conclusie
Onze tests met Ollama 0.40.11 verliepen over het algemeen goed, vooral het draaien van lokale modellen op de RTX 5000 Ada. Beide geïmporteerde GGUF's werkten met volledige GPU-acceleratie zonder dat extra CUDA-configuratie nodig was, en de prestaties waren toonaangevend in de reeks. Jan V3.5 behaalde een mediaan van 145.48 tokens/sec en Jan V2 VL High 92.87 tokens/sec, de snelste resultaten in deze reeks en 13 tot 18 procent sneller dan Jan op hetzelfde werkstation. Nadat alles was geconfigureerd, ondervonden we geen problemen bij het schakelen tussen de desktopchatinterface en de lokale API, en alle gemeten benchmarkruns werden zonder problemen voltooid.
Hoewel we Ollama erg eenvoudig vonden voor alledaagse chats, hadden we liever meer controle gehad over individuele modellen in de desktopapplicatie. Het gebruik van PowerShell en het aanmaken van modelbestanden om onze bestaande GGUF's te importeren, voegde een paar extra stappen toe, vooral in vergelijking met Jan, waar de meeste instellingen direct in de interface beschikbaar zijn. Dit zal iemand die al bekend is met het werken met lokale modellen niet per se storen, maar nieuwkomers die alles via een grafische interface willen beheren, zullen Ollama wellicht beperkend vinden. We ondervonden ook een paar problemen met de webzoekfunctie en ons geïmporteerde visiemodel, hoewel geen van beide de normale tekstgeneratie beïnvloedde.
Wat we het meest waardeerden aan Ollama was hoe gemakkelijk het lokale modellen beschikbaar kon stellen aan andere applicaties zonder dat we een aparte server hoefden te configureren. De chatfunctie op de desktop is gebruiksvriendelijk, terwijl de lokale API en ondersteuning voor externe programmeertools gebruikers veel meer mogelijkheden bieden dan alleen chatten met lokale modellen. We zouden graag betere beheermogelijkheden voor modellen in de desktopinterface zien, maar Ollama presteerde goed op ons werkstation en bood ons een betrouwbare manier om beide testmodellen met GPU-acceleratie uit te voeren.
Klassement: Ollama heeft de beste algehele lokale LLM-runtime op onze pagina met de beste lokale LLM-tools , waar deze resultaten nu naast onze cijfers van Jan en Open WebUI staan.


 Amazon