

Podczas konferencji AWS Global Summit firma Alluxio ogłosiła dziś najnowszą wersję swojej technologii orkiestracji danych – Alluxio 2.0. Najnowsza wersja oferuje innowacje dla inżynierów danych i jest skierowana do analityki wielochmurowej oraz sztucznej inteligencji.
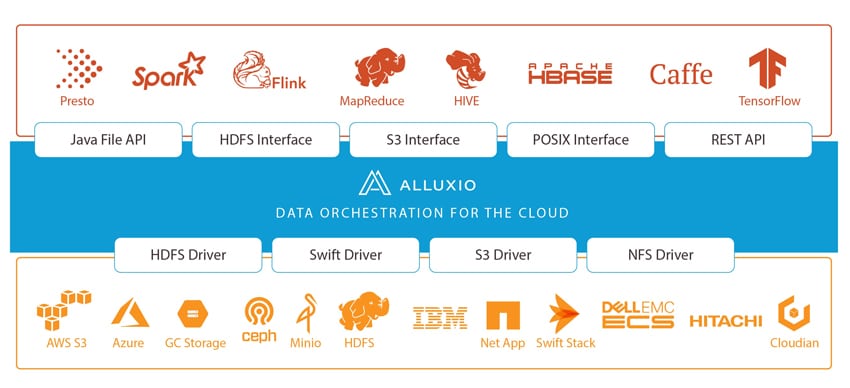
Jak wspomnieliśmy na początku, Alluxio twierdzi, że jest pierwszym na świecie systemem, który ujednolica dane z prędkością pamięci. Ta „prędkość pamięci” umożliwi firmom szybki dostęp do danych w różnych systemach pamięci masowej, co z kolei oznacza, że mogą one wydajniej zarządzać danymi, szybciej uzyskiwać cenne informacje i łatwiej wdrażać chmurę hybrydową. Obecnie Alluxio obsługuje krytyczne obciążenia dla takich firm jak Alibaba, Baidu, Barclay's Bank, CERN, ESRI, Huawei, Intel i Juniper.
Świat przechodzi na obciążenia obliczeniowe o dużej intensywności w chmurze. To nowe podejście oznacza, że zasoby obliczeniowe muszą skalować się elastycznie, niezależnie od zasobów pamięci masowej. Choć takie podejście przynosi szereg korzyści pod względem wydajności, stwarza potencjalne problemy dla inżynierów danych. Alluxio dąży do rozwiązania tego problemu poprzez dodanie warstwy abstrakcji, która zapewnia lokalność, dostępność i elastyczność danych, umożliwiając obliczenia w silosach danych, strefach, regionach, a nawet chmurach.
Funkcje i możliwości obejmują:
- Innowacja w orkiestracji danych dla środowisk wielochmurowych:
- Zarządzanie danymi oparte na zasadach
- Alluxio 2.0 zawiera nową funkcję, która pozwala inżynierom danych automatyzować przenoszenie danych między systemami pamięci masowej w oparciu o predefiniowane zasady, automatycznie i na bieżąco. Oznacza to, że w miarę tworzenia danych i zarządzania nimi (gorącymi, ciepłymi i zimnymi), Alluxio może zautomatyzować warstwowanie danych w dowolnej liczbie systemów pamięci masowej, zarówno lokalnie, jak i we wszystkich chmurach.
- Zespoły zarządzające platformami danych mogą teraz obniżyć koszty przechowywania danych, automatycznie zarządzając wyłącznie najważniejszymi danymi w drogich systemach przechowywania danych i przenosząc pozostałe dane do tańszych alternatywnych rozwiązań.
- Ulepszone zarządzanie politykami dostępu do danych: Oprócz szczegółowych polityk na poziomie plików, użytkownicy mogą teraz konfigurować polityki na poziomie dowolnego katalogu i folderu, aby usprawnić dostęp do danych, a także wydajność obciążeń. Obejmuje to definiowanie zachowań dla poszczególnych zestawów danych w zakresie różnych podstawowych funkcji, takich jak zapisywanie danych lub synchronizowanie danych z systemami pamięci masowej w ramach Alluxio.
- Wydajne przesyłanie danych między chmurami za pośrednictwem usługi danych: Nowa usługa danych umożliwia niezwykle wydajne przesyłanie danych, w tym między magazynami w chmurze, takimi jak AWS S3 i Google GCS, dzięki czemu kosztowne operacje w pamięci masowej obiektów stają się bezproblemowe w kontekście infrastruktury obliczeniowej.
- Zarządzanie danymi oparte na zasadach
- Zoptymalizowany pod kątem obliczeń dostęp do danych na potrzeby analityki w chmurze:
- Partycjonowanie klastra zorientowane na obliczenia: Użytkownicy mogą teraz partycjonować pojedyncze Alluxio w oparciu o dowolny wymiar, dzięki czemu zbiory danych dla każdej platformy lub obciążenia nie są zanieczyszczane przez inne. Najczęstszym zastosowaniem jest partycjonowanie klastra według platformy Spark, Presto itp. Dodatkowo pozwala to obniżyć koszty transferu danych, ograniczając dane do określonej strefy lub regionu.
- Integracja z zewnętrznymi źródłami danych przez REST: Użytkownicy mogą teraz pobierać dane nawet z internetowych źródeł danych, agregować je w Alluxio i przeprowadzać analizy. Dowolną lokalizację internetową z plikami można łatwo wskazać w Alluxio, aby pobierać je w razie potrzeby na podstawie zapytania lub uruchomienia modelu.
- Inne funkcje obejmują:
- Highly Distributed Data Services – 2.0 wprowadza usługę danych Alluxio, rozproszoną usługę klastrową, która umożliwia wykonywanie operacji na danych, takich jak replikacja i trwałość, w celu zapewnienia wysokiej wydajności i masowej skalowalności.
- Adaptacyjna replikacja zapewniająca większą lokalność danych – nowa funkcja umożliwiająca skonfigurowanie zakresu liczby kopii danych przechowywanych w Alluxio, które są zarządzane automatycznie.
- Wysoka dostępność z wbudowanym dziennikiem – nowy tryb odporności na błędy i wysokiej dostępności dla metadanych plików i obiektów, zwany wbudowanym dziennikiem, który wykorzystuje algorytm konsensusu RAFT i jest niezależny od innych zewnętrznych systemów pamięci masowej. Jest to szczególnie przydatne w przypadku abstrakcji pamięci masowej obiektów.
- API POSIX Alluxio – funkcja FUSE w Alluxio umożliwia korzystanie z API zgodnego z POSIX, dzięki czemu frameworki takie jak Tensorflow, Caffe i inne modele oparte na Pythonie mogą uzyskiwać bezpośredni dostęp do danych z dowolnego systemu pamięci masowej za pośrednictwem Alluxio, korzystając z tradycyjnego dostępu do systemu plików.
- Wsparcie Amazon AWS:
- Integracja z usługą AWS Elastic Map Reduce (EMR): Wraz z migracją użytkowników do usług w chmurze w celu wdrażania obciążeń analitycznych i sztucznej inteligencji, coraz częściej wykorzystywane są usługi takie jak AWS EMR. Alluxio można teraz bezproblemowo zintegrować z klastrem AWS EMR, udostępniając je jako warstwę danych w EMR dla platform Spark, Presto i Hive. Użytkownicy mają teraz wysokowydajną alternatywę dla buforowania danych z S3 lub danych zdalnych, jednocześnie redukując liczbę kopii danych przechowywanych w EMR.
Dostępność:
Obie wersje Alluxio 2.0 Community i Enterprise są już dostępne.
Omów tę historię


 Amazon