

Firma AMD ogłosiła wprowadzenie na rynek Instinct MI350P, akceleratora PCIe przeznaczonego dla przedsiębiorstw, które chcą korzystać z inferencji AI na miejscu bez konieczności przebudowy centrum danych. Karta ma dwa gniazda, pełną wysokość i długość, a jej konstrukcja została zaprojektowana z myślą o standardowych serwerach chłodzonych powietrzem. To również pierwszy raz od prawie czterech lat, kiedy AMD umieściło układ Instinct obecnej generacji w obudowie, która pasuje do standardowego serwera.
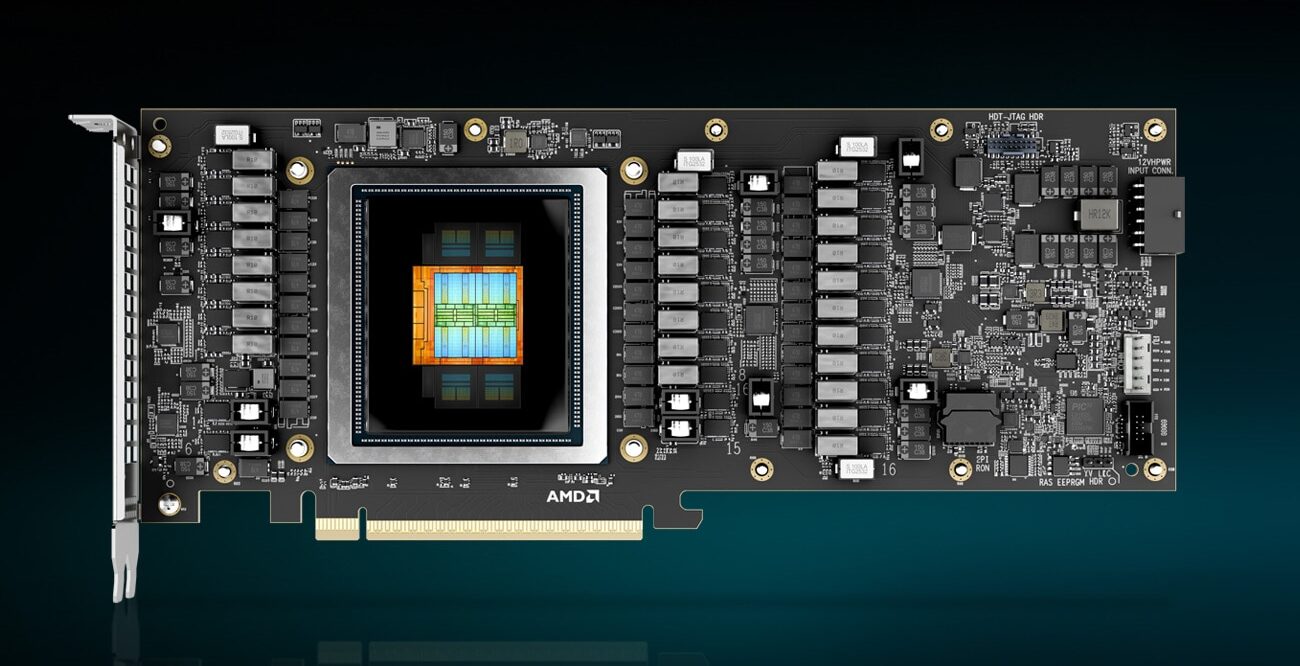
Seria PCIe Instinct praktycznie zniknęła po premierze MI210 na początku 2022 roku. Każda kolejna generacja (MI300X, MI325X i OAM MI350X) była modułem z gniazdem OAM na płycie bazowej Universal Baseboard, wymagającym specjalnie zaprojektowanej obudowy z zasilaniem i przepływem powietrza dla ośmiu akceleratorów klasy 1,000 W w jednej obudowie. To rozwiązanie sprawdza się w przypadku hiperskalerów kupujących procesory graficzne w szafach rack. Nie sprawdza się w przypadku przedsiębiorstw, które chcą korzystać z inferencji lokalnej, ale nie mogą lub nie chcą inwestować w niestandardową szafę AI. MI350P wypełnia tę lukę, a obecnie NVIDIA nie oferuje flagowej karty serwerowej PCIe w tej samej klasie, więc AMD ma na razie cały segment dla siebie.
Sprzęt: MI350P vs. MI350X OAM
MI350P nie jest odłączoną wersją MI350X. AMD zaprojektowało dla niego mniejszy układ. MI350X posiada dwie matryce I/O, każda z czterema złożonymi matrycami akceleratora (XCD), co daje łącznie osiem matryc XCD i 256 jednostek obliczeniowych. MI350P ma pojedynczą matrycę I/O z czterema matrycami XCD i 128 jednostkami obliczeniowymi, czyli o połowę mniej krzemu, działającą z tym samym szczytowym taktowaniem 2.2 GHz, co jego większy odpowiednik. Pamięć ma ten sam schemat. Cztery stosy HBM3E zamiast ośmiu. Magistrala 4,096-bitowa zamiast 8,192-bitowej. 144 GB z prędkością 4 TB/s zamiast 288 GB z prędkością 8 TB/s.
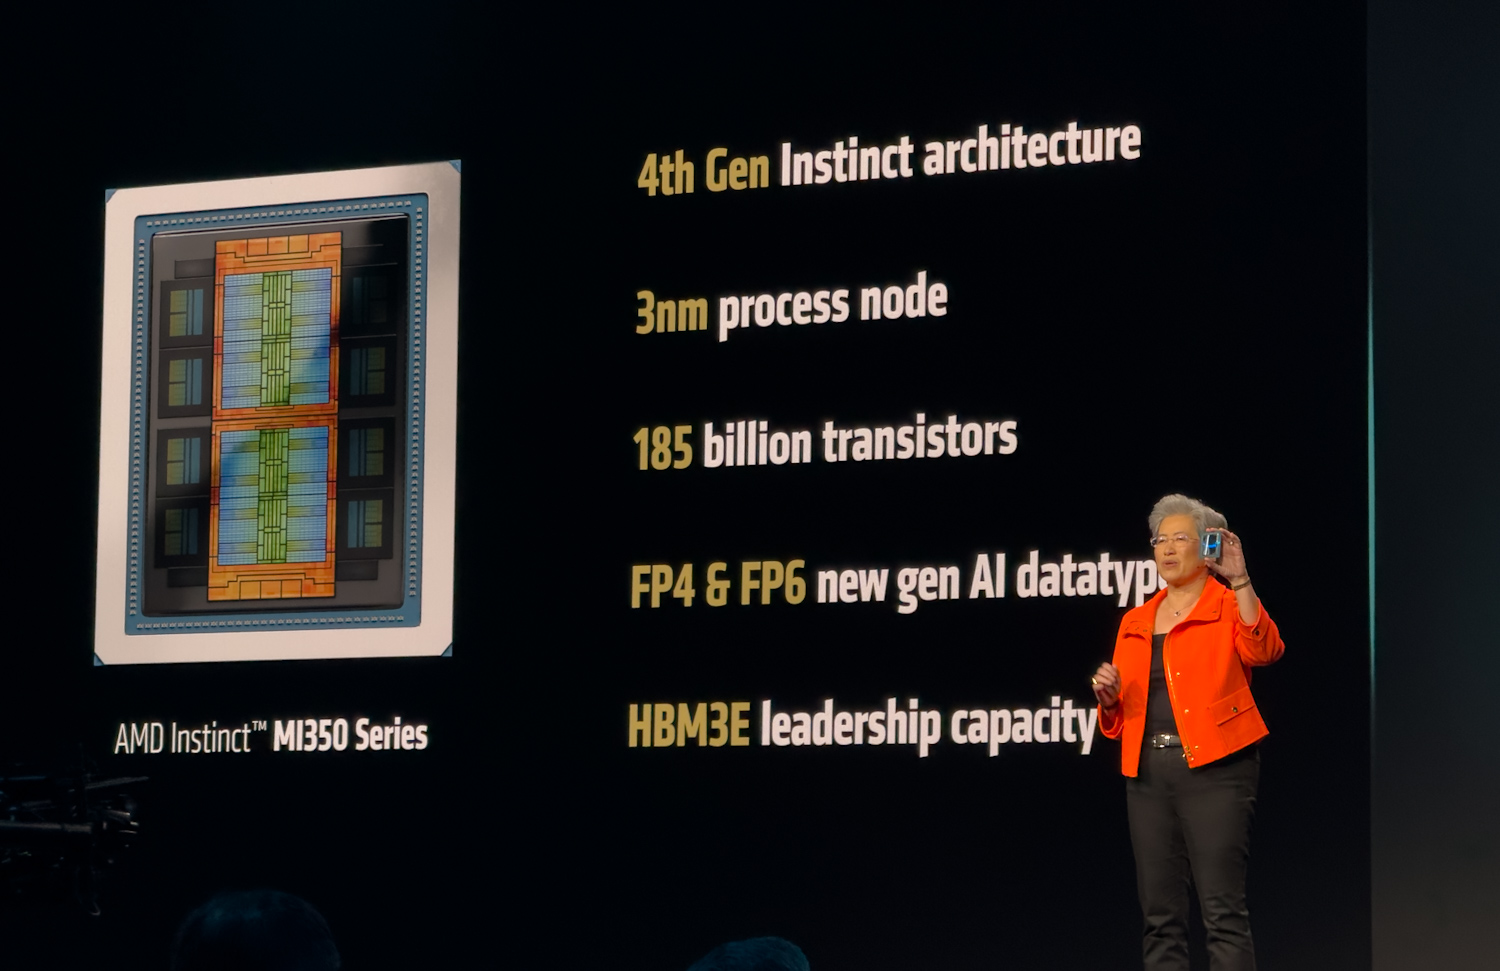
Moc obliczeniowa w trybie szczytowym również spada o połowę. MI350P osiąga 4,600 TFLOPS w MXFP4, podczas gdy MI350X osiąga 9.2 PFLOPS, a 2,300 TFLOPS w FP8, podczas gdy 4.6 PFLOPS. BF16, FP16 i reszta stosu precyzyjnego skalują się w ten sam sposób. Miło jest widzieć, że AMD publikuje dane wraz z wartościami szczytowymi. Dostarczone dane to 2,299 TFLOPS w MXFP4, 1,529 TFLOPS w FP8 i 713 TFLOPS w BF16. Liczby te odzwierciedlają faktyczne możliwości karty w obudowie 600 W, gdzie ograniczenia elektryczne i przepustowości pamięci ograniczają teoretyczne wartości szczytowe.
Przyjrzeliśmy się platformie MI350X w ramach programu Jumpstart firmy Supermicro i byliśmy pod wrażeniem jej wydajności w przypadku obciążeń inferencyjnych. Nie możemy się doczekać testów MI350P i sprawdzenia, jak wariant PCIe sprawdzi się w bardziej konwencjonalnych obudowach serwerowych, do których został zaprojektowany.
| Karta PCIe AMD Instinct MI350P | ||
|---|---|---|
| Specyfikacja | Dostarczono (FLOPS) | Szczyt (TFLOPS) |
| Wydajność | ||
| BF16 | 713 | 1150 |
| FP16 | 672 | 1150 |
| FP8 | 1529 | 2300 |
| MXFP8 | 1327 | 2300 |
| MXFP6 | 1804 | 4600 |
| MXFP4 | 2299 | 4600 |
| Pamięć i partycjonowanie | ||
| Pojemność pamięci | 144 GB HBM3E | 144 GB HBM3E |
| Pamięć BW | 3.6 TB / s | 4.0 TB / s |
| Instancje GPU | Do 4 x 36 GB każdy | Do 4 x 36 GB każdy |
| Platforma | ||
| Dekodowanie wideo i JPEG | ||
| Połączenie między urządzeniami GPU Scale-up | Nie jest obsługiwany | Nie jest obsługiwany |
| Produkt FF | FHFL dwugniazdowy chłodzony powietrzem | FHFL dwugniazdowy chłodzony powietrzem |
| Maksymalna całkowita moc płyty (TBP) | 600W (450W konfigurowalne) |
600W (450W konfigurowalne) |
| Host PCIe | x16 PCIe Gen 5 o przepustowości 128 GB/s | x16 PCIe Gen 5 o przepustowości 128 GB/s |
Moc nie spada aż o połowę. MI350P ma moc znamionową 600 W TBP, czyli około 60% mocy MI350X wynoszącej 1,000 W. 600 W to górna granica mocy określona przez specyfikację PCIe CEM, więc karta grzeje się tak mocno, jak pozwala na to gniazdo. Tryb 450 W jest dostępny dla obudów, które nie są w stanie zapewnić pełnej mocy ani pełnego zakresu chłodzenia, co powoduje pewne obniżenie wydajności. Moc znamionowa 600 W plasuje również MI350P w tej samej kategorii co karty NVIDIA H200 NVL i serwer RTX Pro 6000, z którymi będzie porównywany w tym segmencie.
W przeciwieństwie do oferty NVL4 firmy NVIDIA w modelu H200, AMD nie udostępnia łączy Infinity Fabric procesora graficznego w modelu MI350P; cała komunikacja zbiorowa odbywa się za pomocą łącza PCIe Gen5 x16 (128 GB/s).
Historia chłodzenia powietrzem ośmiu procesorów graficznych
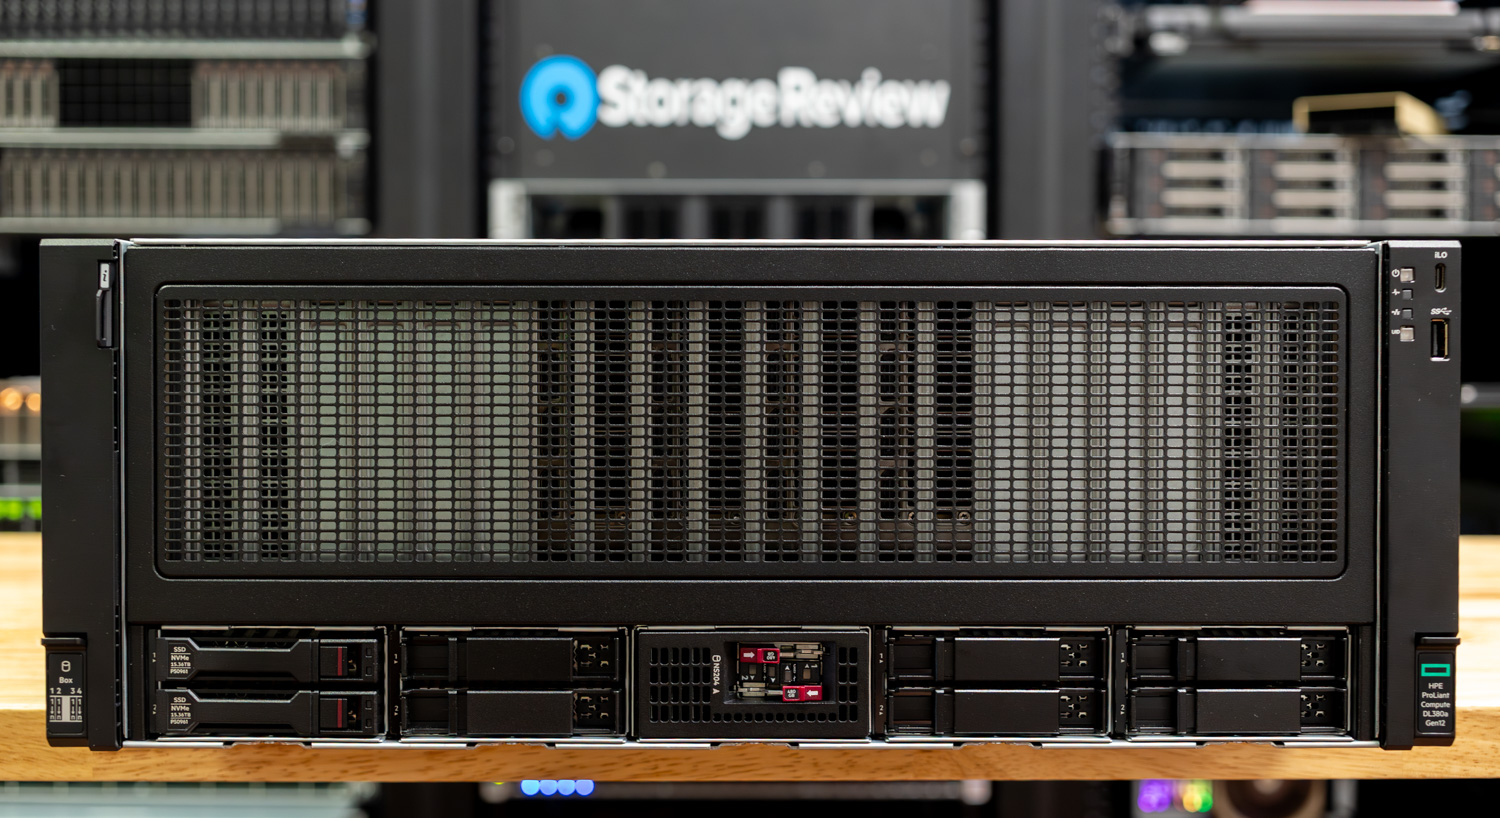
Ponieważ MI350P to standardowa dwugniazdowa karta PCIe o pełnej wysokości i długości, pasuje do serwerów, które przedsiębiorstwa już wdrażają i obsługują, w tym do platform z ośmioma procesorami graficznymi chłodzonymi powietrzem, dostarczanych obecnie przez głównych producentów OEM. Dell PowerEdge XE7740 i HPE ProLiant DL380a Gen12, które recenzowaliśmy wcześniej, są oczywistymi celami. Każdy z nich został zaprojektowany specjalnie do obsługi ośmiu dwugniazdowych akceleratorów FHFL w obudowie chłodzonej powietrzem, a system zasilania i przepływ powietrza są już zaprojektowane dla kart klasy 600 W. Brak niestandardowej szafy rack, pętli chłodzenia cieczą i płyty bazowej OAM.
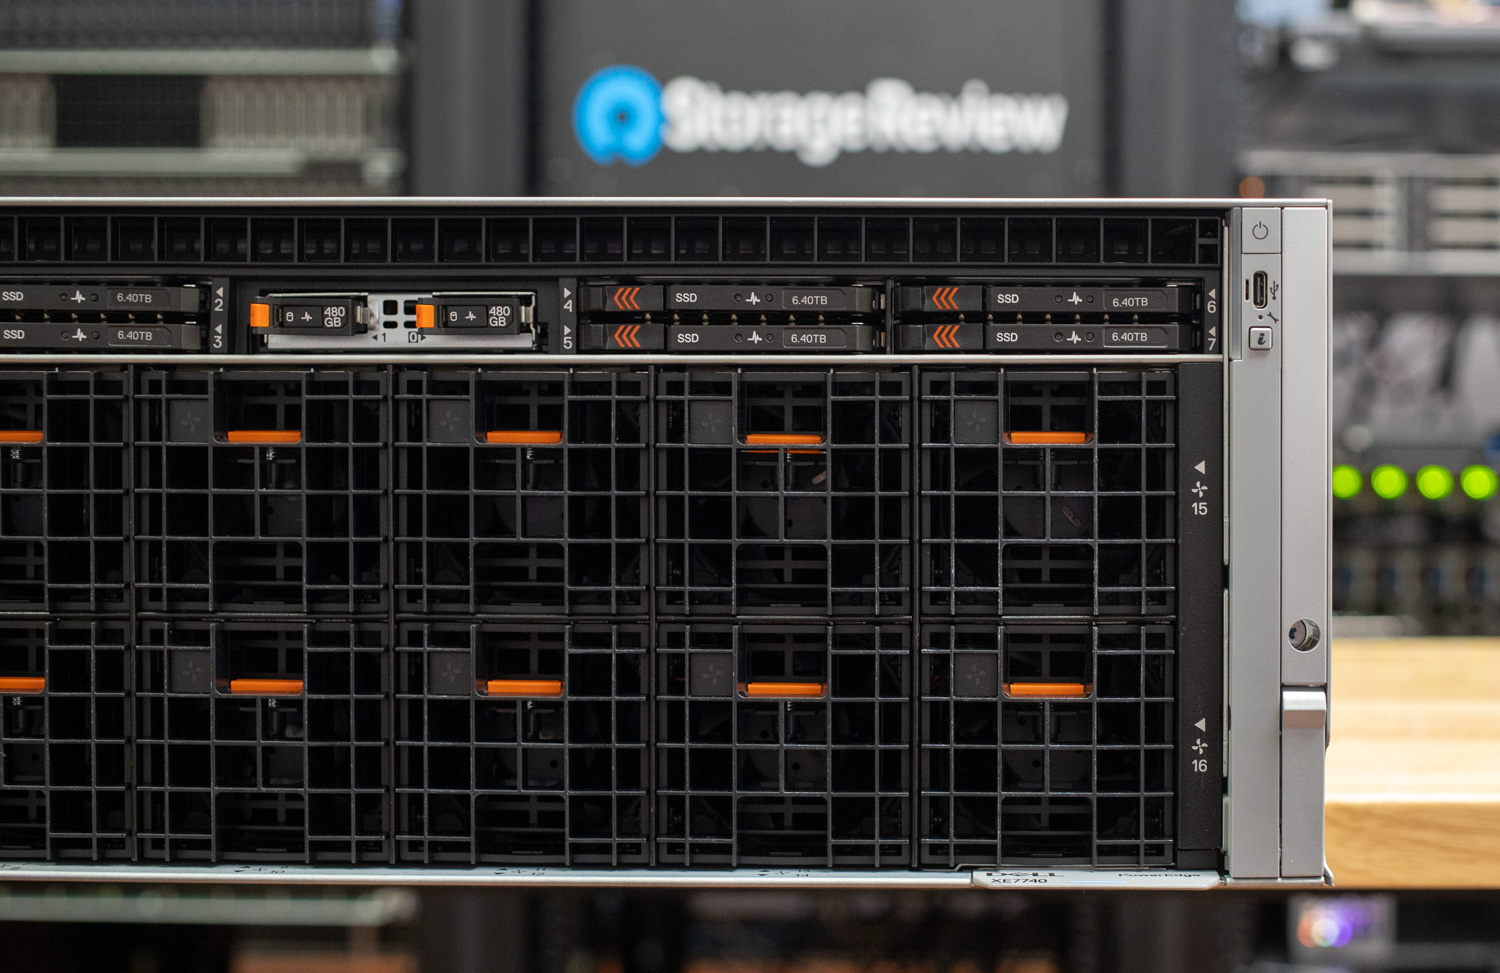
Konfiguracja MI350P z ośmioma kartami w jednym z tych systemów mieści 1,152 GB pamięci HBM3E i łączną przepustowość pamięci 32 TB/s w jednej, chłodzonej powietrzem obudowie. W przypadku wnioskowania na dużych modelach o otwartej wadze wystarcza to do obsługi modelu o bilionie parametrów na MXFP4 w jednej obudowie. Jak jednak wspomnieliśmy wcześniej, kompromisem jest brak infrastruktury skalowalnej. W systemie OAM MI350X procesory graficzne (GPU) komunikują się przez Infinity Fabric poprzez uniwersalną płytę bazową (Universal Baseboard). W systemie MI350P każdy zbiorczy interfejs GPU-GPU korzysta z magistrali PCIe Gen5 x16 z przepustowością 128 GB/s, czyli tą samą ścieżką, która dociera do hosta. W przypadku obciążeń wnioskowania, szczególnie z równoległym shardingiem tensorowym wewnątrz węzła oraz równoległością danych w potoku lub między węzłami, jest to wykonalne. W przypadku ściśle sprzężonego treningu, w którym redukcja przepustowości ma decydujący wpływ na czas kroku, platforma OAM pozostaje właściwym rozwiązaniem.
Formaty precyzyjne
Warto omówić kwestię precyzji, choć żaden z formatów obsługiwanych przez MI350P nie jest nowy. MI350X ma ten sam zestaw. Powodem, dla którego wciąż ma to znaczenie, jest to, że typy danych skalowania bloków OCP (MXFP8, MXFP6, MXFP4) stały się standardem dla laboratoriów modeli granicznych w zakresie trenowania i dostarczania modeli. Formaty te pozwalają laboratoriom trenować z niższą precyzją przy niewielkiej lub żadnej utracie jakości, a korzyści z wnioskowania są widoczne natychmiast.
Niższa precyzja oznacza szybszą pracę. MXFP4 działa ponad dwukrotnie szybciej niż FP8 i około czterokrotnie szybciej niż BF16 w szczytowym momencie. To przyspieszenie jest widoczne w rzeczywistych obciążeniach. Wydanie gpt-oss OpenAI wyraźnie pokazało wzrost przepustowości, a modele frontier, takie jak Kimi K2.6, są natywnie trenowane z uwzględnieniem kwantyzacji w INT4 od samego początku, a nie kwantyzowane po fakcie. Drugą połową historii jest pamięć. Wagi INT4 i MXFP4 zajmują jedną czwartą miejsca BF16. To oznacza, że modele o bilionach parametrów mogą zmieścić się w jednej obudowie z ośmioma procesorami GPU. Dla przedsiębiorstwa, które chce hostować duży model open-weight lokalnie, różnica polega na tym, że jeden rack jest lepszy od klastra wielowęzłowego ze wszystkimi związanymi z tym funkcjami sieciowymi i orkiestracją.
Podsumowanie
Większość przedsiębiorstw rozważających wdrożenie sztucznej inteligencji w siedzibie klienta, zanim wyczerpią się zasoby mocy, chłodzenia, gęstości szaf lub budżetu, traci dostęp do zasobów obliczeniowych. PCIe Instinct, który trafia do infrastruktury serwerowej, z której już korzystają, omija najgorsze z tych ograniczeń. NVIDIA nie ma obecnie flagowej karty PCIe do serwerów, która mogłaby z nią konkurować, co daje AMD czystą pozycję w tym segmencie, dopóki to się nie zmieni.
Dodatkowe informacje są dostępne na stronie AMD Instinct.


 Amazon