

Konteneryzacja przepływów pracy w obszarze rozwoju, testowania i produkcji rewolucjonizuje zarządzanie IT na wszystkich poziomach, zarówno w przypadku aplikacji i usług skierowanych do klienta, jak i wewnętrznych. Organizacje zyskują na efektywności rozwoju i skracają czas wdrażania, wykorzystując architektury oparte na mikrousługach , zbudowane na kontenerach i wykorzystując platformy do orkiestracji kontenerów, takie jak Kubernetes.
Przejście od klasycznego IT do podejścia opartego na kontenerach często wynika z oddolnych wysiłków zespołów lub działów DevOps , które tworzą prototypowe środowisko, a następnie replikują je inne zespoły. Chociaż zespoły te robią to w celu zwiększenia wydajności i elastyczności, rezultatem często są silosy klastrów DevOps, a co za tym idzie, albo niska wydajność (niewystarczająca ilość zasobów), albo słabe wykorzystanie (niedostateczne wykorzystanie zasobów poza godzinami szczytowego zapotrzebowania). Zazwyczaj występuje jedno i drugie: podczas gdy jeden zespół jest „pod wodą” pod względem zapotrzebowania i podaży zasobów, inne zespoły mogą mieć wiele dostępnych cykli bezczynności. Co gorsza, zespoły często nadmiernie alokują zasoby, co generuje ogromne koszty. Branżowe standardy wykorzystania klastrów często oscylują w okolicach 20%.
Konsolidacja klastrów (lub kont w chmurze, jeśli o to chodzi) z wielu do mniejszej liczby, a najlepiej do jednego, oraz współdzielenie zasobów między zespołami i przypadkami użycia to recepta na zwiększenie wydajności i wydajności przy jednoczesnej redukcji kosztów. Konsolidacja i współdzielenie pozwalają naprawdę zrobić więcej mniejszym kosztem – o ile potrafisz współdzielić zasoby efektywnie, automatycznie i sprawiedliwie.
Obecne frameworki orkiestracji kontenerów, takie jak Kubernetes , Docker Swarm lub Mesos, nie pozwalają jednak na osiągnięcie tego od razu. Kubernetes i Swarm zapewniają uproszczone schematy dystrybucji obciążeń, takie jak „rozproszenie” (round-robin), „pakowanie” lub „losowe”, a w przeciwnym razie wymagają ręcznego segmentowania zasobów klastra za pomocą koncepcji takich jak przestrzenie nazw lub etykiety. W Mesos różne typy obciążeń (np. Spark, Hadoop lub usługi w ramach Marathon) mają własny harmonogram, który może lub nie oferować pewnych zasad współdzielenia zasobów (z własną logiką i konfiguracją), ale obciążenia będą ze sobą konkurować o dostęp do zasobów i nie ma nadrzędnego systemu zasad, który rozumie, które obciążenia są najważniejsze dla firmy i jak zaspokoić jej potrzeby, nie przydzielając jej jednocześnie nadmiernych zasobów.
W przypadku nietypowych przypadków współdzielenia zasobów każdy z tych systemów będzie wymagał wielu ręcznych interwencji i nadal będzie wymagał nadmiernego alokowania zasobów lub będzie odczuwał skutki spadku wydajności spowodowanego konfliktami zasobów.
Aby móc udostępniać pulę zasobów między organizacjami i dowolnymi typami obciążeń (zarówno skonteneryzowanych, jak i nieskonteneryzowanych), naprawdę potrzebny jest zaawansowany system zasad, który rozumie charakterystykę obciążenia i priorytety biznesowe, dzięki czemu może zautomatyzować podejmowanie decyzji o alokacji zasobów i realokować zasoby na żądanie w przypadku zmiany warunków brzegowych lub zapotrzebowania.
Navops Command to obecnie unikatowy przykład takiej funkcjonalności. Rozszerza on platformę Kubernetes i dodaje zaawansowane, dynamiczne i oparte na zapotrzebowaniu polityki, które automatyzują podejmowanie decyzji dotyczących priorytetyzacji obciążeń i zużycia zasobów w dowolnym momencie. W porównaniu z innymi platformami do orkiestracji kontenerów, Kubernetes oferuje najbogatszy zestaw funkcji o dużej mocy obliczeniowej, umożliwiających niezawodne zarządzanie obciążeniami (takich jak automatyczne kontrolery replik, zadania, wdrożenia, akceptacja obciążeń itp.). Dzięki Navops Command na platformie Kubernetes można uruchamiać kompilacje oprogramowania, zautomatyzowane testy i wdrożenia produkcyjne wielu aplikacji i środowisk usług w tym samym klastrze lub puli chmurowej. Zadania DevOps i usługi produkcyjne mogą pochodzić od wielu zespołów i mieć różną wagę, która może się zmieniać w ciągu dnia. Navops Command gwarantuje, że żadne z powiązanych obciążeń nie będzie sobie przeszkadzać, a jednocześnie będą działać zgodnie z wymaganiami w tym samym czasie.
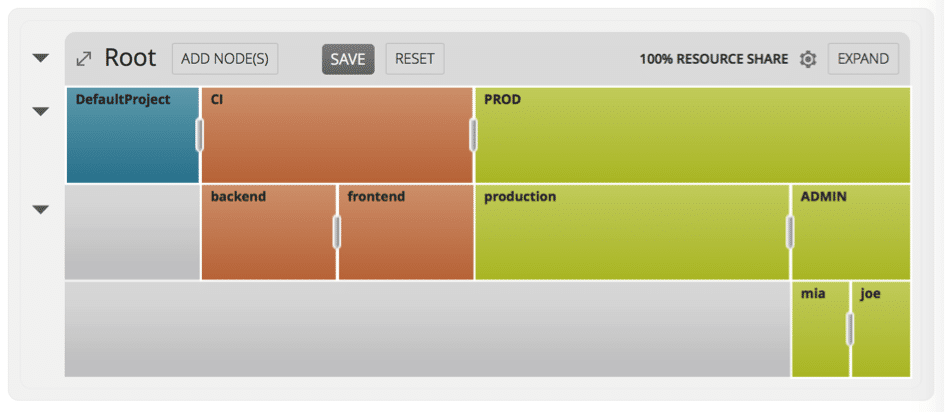
Rysunek 1: Polityka dowództwa Navops „Udziały proporcjonalne” automatyzująca współdzielenie zasobów między grupami, projektami i osobami
Dzięki Navops Command możliwe jest osiągnięcie wskaźnika wykorzystania klastra na poziomie 80%, a nawet wyższym. Rozwiązanie to zapewnia korzyści nawet w ramach jednego zespołu, gdy wykonujesz różne zadania, takie jak kompilacja, testowanie i operacje, a jeszcze więcej korzyści przynosi udostępnianie między zespołami.
Navops Command demonstruje, co jest niezbędne do efektywnego uruchamiania aplikacji opartych na mikrousługach, a także innych obciążeń kontenerowych w środowisku współdzielonym (lokalnym lub w chmurze). Jest on obecnie dostępny dla każdego typu dystrybucji Kubernetes i można go łatwo przetestować, jak opisano tutaj.
O autorze
Fritz Ferstl jest obecnie dyrektorem ds. technicznych i rozwoju biznesu EMEA w Univa Corporation.
Fritz Ferstl wnosi do Univy 20 lat doświadczenia w dziedzinie przetwarzania sieciowego i chmurowego, a jako dyrektor ds. technologii będzie pomagał w kształtowaniu wizji technicznej, a jednocześnie przewodził sojuszom strategicznym. Fritz, od dawna uważany za ojca oprogramowania Grid Engine i jego prekursorów, Codine i GRD, przez ostatnie 10 lat zarządzał działem oprogramowania Grid Engine w Sun Microsystems i Oracle, przekształcając je z nowatorskiej technologii w najszerzej wdrażane rozwiązanie do zarządzania obciążeniami w jednych z najbardziej wymagających środowisk centrów danych na świecie. Pod kierownictwem Fritza oprogramowanie Grid Engine stało się oprogramowaniem open source i zyskało prężnie działającą społeczność.


 Amazon