

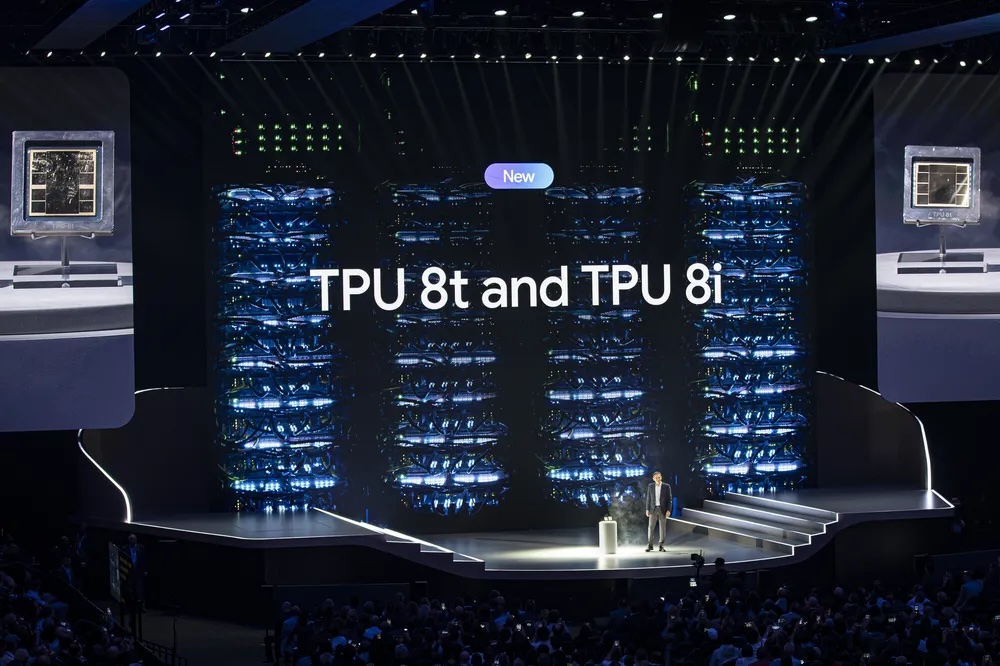
Podczas konferencji Google Cloud Next firma Google ogłosiła akceleratory AI nowej generacji: TPU 8t „Sunfish” do trenowania i TPU 8i „Zebrafish” do wnioskowania, a także nową infrastrukturę centrów danych Virgo. Z wpisów na blogu Google jasno wynika, że te układy są zoptymalizowane pod kątem „ery agentowej”: trenowania pionierskich modeli mieszanych ekspertów w skali setek tysięcy układów, a następnie obsługiwania tych samych modeli przy niskich opóźnieniach i agresywnych celach ceny za token. 8t i 8i to dwa odrębne architektonicznie układy, które współdzielą platformę hosta i infrastrukturę, ale różnią się pojemnością pamięci, pamięcią SRAM na chipie, topologią połączeń i specjalizacją na chipie. 8t został zbudowany z myślą o gęstym mnożeniu macierzy (matmul) na dużą skalę, podczas gdy 8i opiera się na pamięci podręcznej KV na krzemie i zbiorczym opóźnieniu na token.
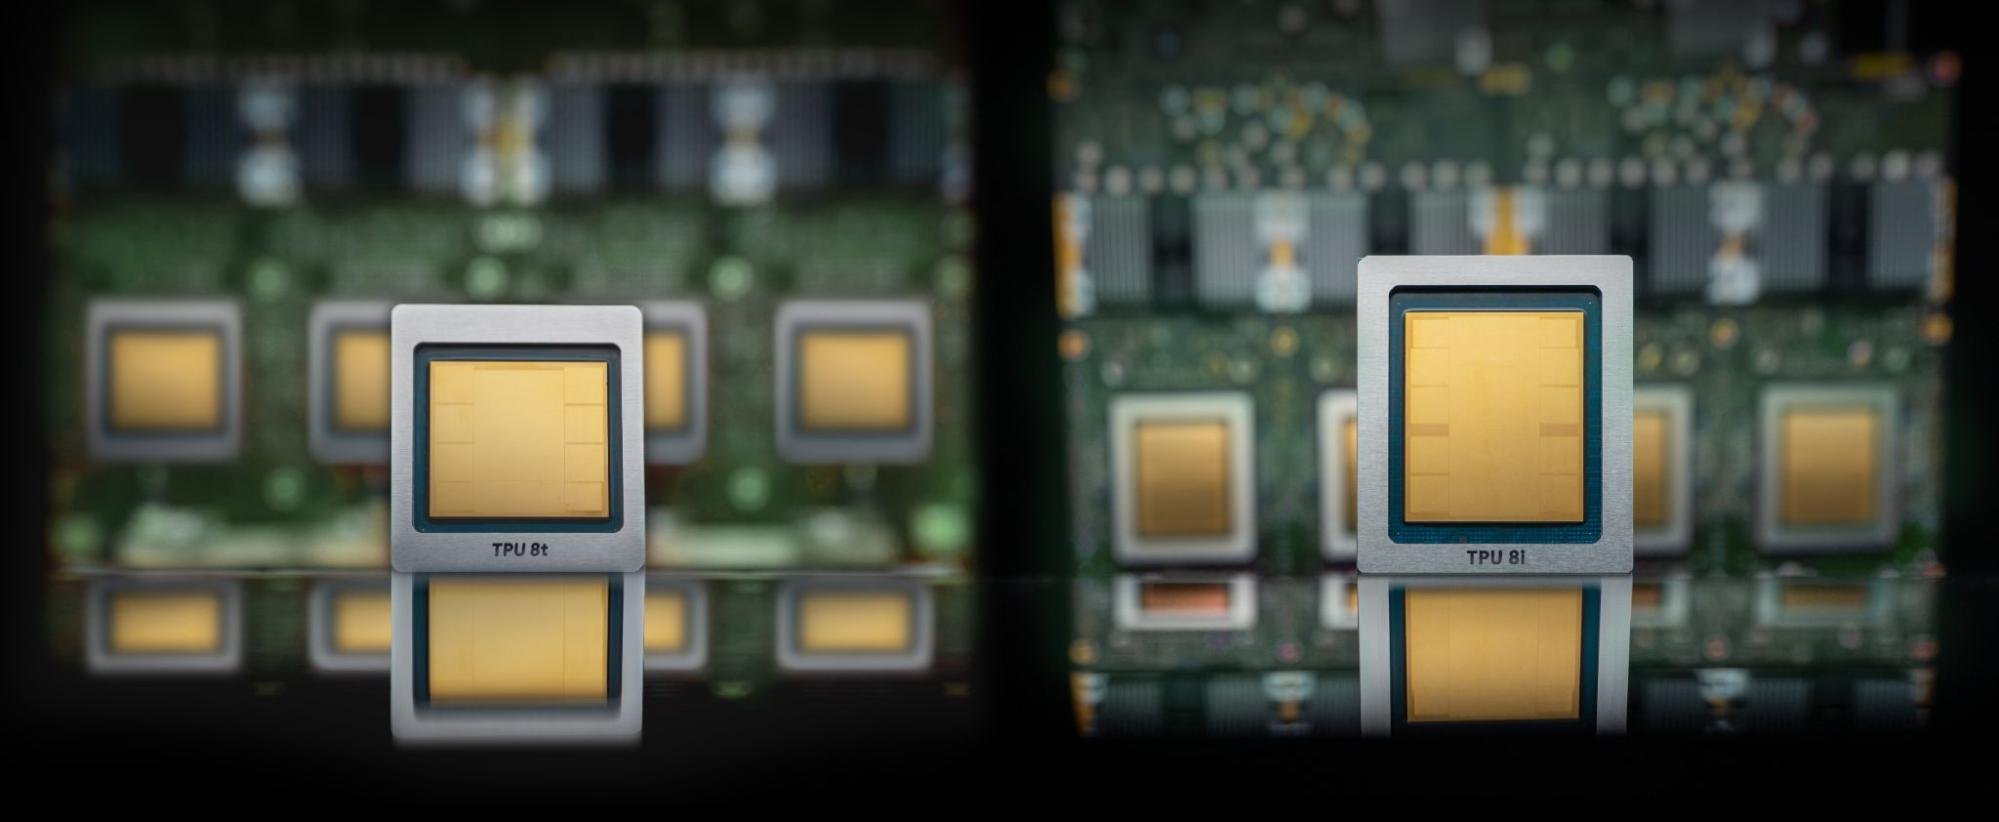
Pojedynczy superpod 8t skaluje się do 9,600 chipów, mieści 2 PB pamięci HBM i zapewnia 121 EFLOPS mocy obliczeniowej FP4, czyli prawie 3 razy więcej niż moc obliczeniowa na pod w porównaniu z superpodem Ironwood. 8i łączy 288 GB pamięci HBM z 384 MB wbudowanej pamięci SRAM (3x Ironwood) w domenie skalowalnej 1,152 chipów i zapewnia o 80% lepszą wydajność w przeliczeniu na dolara niż Ironwood w przypadku wnioskowania LLM. Virgo łączy obie rodziny chipów w jedną sieć centrów danych, która łączy ponad 134 000 chipów 8t z przepustowością 47 Pb/s bez blokowania, z nawet 4-krotnie większą przepustowością na akcelerator i o 40% niższym opóźnieniem bez obciążenia niż poprzednia generacja.
Czym właściwie jest TPU
Zanim przejdziemy do omówienia 8 układów scalonych, kilka słów o tym, czym jest TPU i czym różni się od GPU, ponieważ te 8 decyzji projektowych ma sens tylko w tym kontekście.
Tensor Processing Unit to niestandardowy układ ASIC, który Google rozwija od 2015 roku. Każda generacja opiera się na tej samej idei: zamiast dynamicznie planować tysiące małych rdzeni, jak GPU, TPU koncentruje się na niewielkiej liczbie bardzo dużych jednostek MXU (macierzowych jednostek mnożenia), zasilanych przez wbudowany w układ, zarządzany programowo blok pamięci SRAM i sterowanych przez kompilator z wyprzedzeniem. Każdy układ zawiera kilka rdzeni TensorCore, z których każdy zbudowany jest wokół jednego dużego bloku MXU z matrycą systolicową, oraz mniejszy zestaw rdzeni SparseCore dedykowanych do nieregularnych wyszukiwań typu „zbierz-rozrzuć”, które dominują we wbudowaniach rekomendacji. Dane przepływają z HBM przez blok pamięci, przez MXU, z powrotem do bloku pamięci i z powrotem, a jednostka Vector Processing Unit obsługuje aktywacje, normalizacje i redukcje. Nie ma sprzętowego planisty warp, hierarchii pamięci podręcznej L1 lub L2 w rozumieniu GPU ani dynamicznego rozsyłania.
Zaletą tego projektu jest wydajność w gęstej algebrze liniowej. Dzięki kompilatorowi z wyprzedzeniem decydującemu o miejscu występowania każdego tensora i momencie odpalenia każdego kolektywu, nie występuje jitter związany z chybieniem pamięci podręcznej ani obciążenie harmonogramu warp, co ma większe znaczenie niż się wydaje, gdy dziesiątki tysięcy chipów muszą być zsynchronizowane za pomocą kolektywu. Wykorzystanie FLOP-ów w rzeczywistych modelach na układach TPU dla dobrze dostrojonych obciążeń treningowych jest zazwyczaj wyższe niż na tradycyjnych procesorach GPU. Wadą jest to, że wszystko, co nie mapuje się czysto na duże, gęste matmula, w szczególności dynamiczne kształty, nieregularne wzorce rzadkości, routing MoE z nierównomiernym rozkładem tokenów lub grafowe sieci neuronowe, jest trudniejsze do efektywnego wyrażenia. Układy TPU historycznie obsługiwały również mniej HBM na chip niż ich odpowiedniki na GPU i miały znacznie węższe wsparcie frameworka. XLA i JAX są pierwszorzędne; PyTorch do niedawna wymagał warstwy translacji; ponadto kompilator, środowisko uruchomieniowe, biblioteki sieciowe i stos oprogramowania dla wielu podów pozostają zamknięte w Google.
Rozrzedzenie jest najczystszym przykładem filozoficznej przepaści między procesorami GPU a TPU, a powodem jest struktura, a nie marketing. NVIDIA wspiera rozrzedzenie strukturalne 2:4 w rdzeniach Tensor od czasów Ampere, a teoretycznie wydajność w przypadku obciążeń rzadkich jest dwukrotnie wyższa niż w przypadku obciążeń gęstych. Rdzeń Tensor jest zasadniczo jednostką dyspozytorską: pobiera jawne obciążenie operandów dla każdej instrukcji MMA, więc dodanie wariantu rzadkiego MMA, który akceptuje skompresowany blok 2 z 4 plus metadane indeksowe, jest prostym rozszerzeniem istniejącego zestawu instrukcji. W każdym cyklu sprzęt pobiera do tablicy mnożników tylko wartości niezerowe i ich indeksy, niejawnie pomijając zera.
Tablica systoliczna działa w odwrotny sposób. Każdy element przetwarzający (PE) oblicza każdy cykl, a operandy przesyłane są strumieniowo przez tablicę w synchronizacji, poprzez bezpośrednie ścieżki rejestr-rejestr od jednego elementu przetwarzającego (PE) do następnego. Ten deterministyczny przepływ danych to właśnie źródło przewagi nad SIMT w zakresie energooszczędności: brak powtarzających się odczytów z pamięci SRAM, brak narzutu na rozsyłanie instrukcji, maksymalne ponowne wykorzystanie operandów. Oznacza to jednak również, że sprzęt nie może pominąć elementu o wartości zerowej w każdym cyklu bez przerwania potoku.

Źródło: Google
TPU mogą nadal wykorzystywać rzadkość na poziomie kafelka; jeśli cały kafelek rozmiaru MXU składa się z samych zer, kompilator nie planuje na nim pracy. Jednak decyzja Google'a o nie dodawaniu sprzętowego przyspieszenia dla rzadkości strukturalnej jest celowa. Dodanie rzadkości strukturalnej M:N do tablicy systolicznej można osiągnąć za pomocą wielu technik, z których każda wiąże się z innymi kompromisami. Jedna z takich technik wymaga jednostki kompresji umieszczonej między pamięcią SRAM a portami wejściowymi tablicy. Ale tablica systoliczna to potok, a nie dyspozytor. Gwarancja wydajności wynika z operandów przychodzących w deterministycznym rytmie, przy czym każdy element przetwarzania jest zajęty w każdym cyklu. Zezwolenie na pomijanie operandów wymusza jeden z dwóch kosztów. Zatrzymanie potoku na zerach, co zniweczy przewagę wydajnościową, która pierwotnie motywowała tę architekturę. Lub dodanie dedykowanego sprzętu dekompresora w celu rekonstrukcji strumienia o pełnej szerokości ze skompresowanego wejścia przed jego wejściem do tablicy, co zajęłoby obszar matrycy i zwiększyłoby opóźnienie.
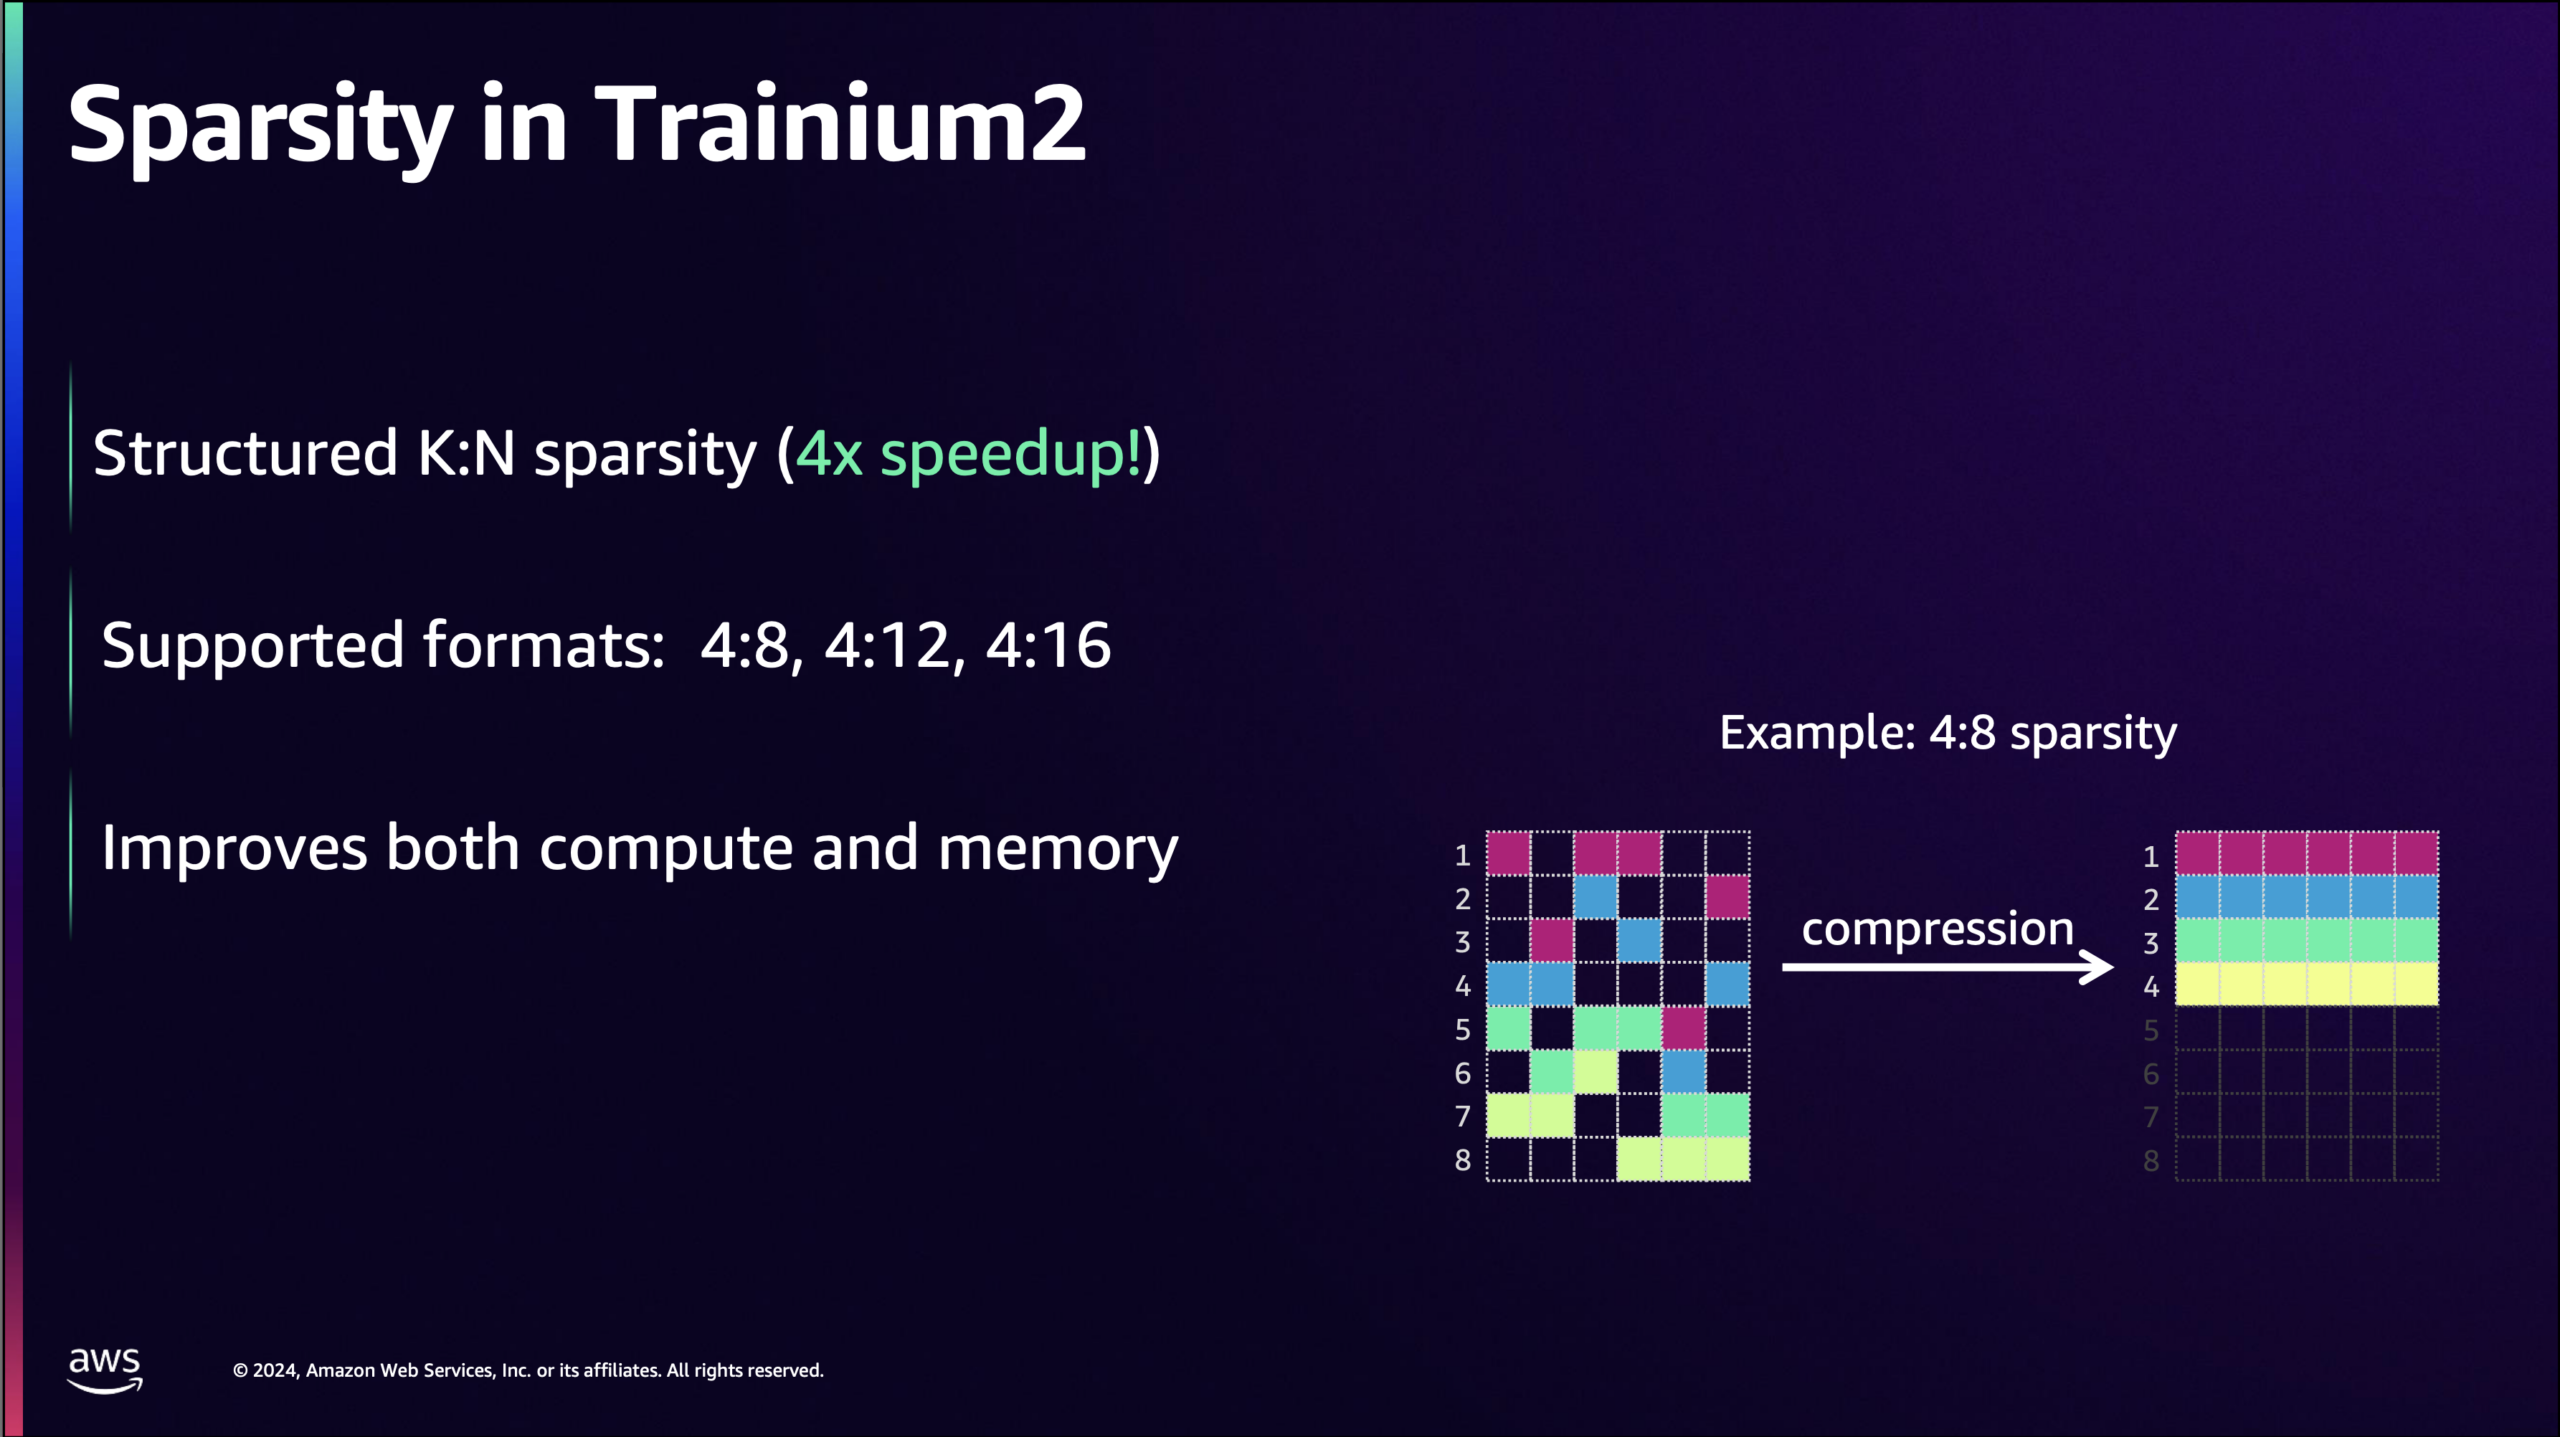
Źródło: AWS
Niektóre akceleratory łączą tablice systoliczne ze sprzętowym wsparciem dla rzadkości. AWS zbudował jeden, zaczynając od NeuronCore-v3, silnika wewnątrz Trainium2 i Trainium3. Implementacja pokazuje, jak wygląda sprzętowo rzadka tablica systoliczna. Silnik tensorowy NeuronCore-v3 to 128×128 systoliczna tablica, która działa na stacjonarnej macierzy wag i strumieniowej macierzy aktywacji, z wymiarem kontrakcji wyrównanym do wymiaru partycji tablicy. W trybie rzadkim ścieżka danych wejściowych rozszerza się z 2×128 elementów na cykl w gęstym BF16 i FP16 do 5×128 elementów na cykl, a strona stacjonarna pobiera dane ze skompresowanej reprezentacji macierzy wag, a nie z oryginalnych gęstych wag. W momencie kompilacji tensor wag jest przetwarzany do formatu M:N. Z każdych N ciągłych elementów wzdłuż wymiaru kontrakcji, zachowywanych jest tylko M, z kompaktowym kodowaniem maski bitowej, którego pozycje są niezerowe. Skompresowany bufor przechowuje tylko wartości M, zmniejszając się o współczynnik N/M. Podczas wykonywania instrukcji matmul, sprzęt odczytuje skompresowane wagi i używa maski bitowej do kierowania odpowiednich aktywacji z kafelka stacjonarnego do odpowiednich elementów przetwarzających. Elementy PE, które zostałyby pomnożone przez zero, nie otrzymują pracy dla tego slotu. Ponieważ wyszukiwanie i kierowanie maską bitową odbywa się w dekompresorze, który zasila tablicę, a nie w samej tablicy, potok utrzymuje taktowanie z pełną przepustowością dla wartości niezerowych, zamiast zatrzymywać się na zerach.
Gęste mnożenie macierzy to nie jedyna funkcja TPU. Od kilku generacji TPU zawierają rdzenie SparseCore obok rdzeni TensorCore. SparseCore to silnik domenowy zaprojektowany dla nieregularnych wzorców dostępu typu „zbieraj-rozpraszaj”, które definiują modele rekomendacji. Model rankingowy YouTube lub model trafności reklam w wyszukiwarkach nie przypomina gęstego transformatora. Większość jego parametrów znajduje się w tabelach osadzania, których rozmiary mogą wahać się od setek gigabajtów do petabajtów, a większość czasu obliczeniowego jest poświęcana na wykonywanie małych wyszukiwań w tych tabelach, lekkie przekształcanie pobranych wartości i łączenie wyników. Ten wzorzec dostępu jest najgorszym przypadkiem dla MXU i tylko nieznacznie lepszym dla hierarchii pamięci podręcznej GPU. Rdzenie SparseCore są dostrojone właśnie do tego: wysokoprzepustowych operacji „zbieraj-rozpraszaj” w odniesieniu do tabel osadzania rezydentnych w HBM, ze sprzętowym wsparciem dla operacji deduplikacji i łączenia, od których zależy reszta potoku osadzania. Ten sam sprzęt wspomaga również trasowanie eksperckie MoE, ponieważ po wybraniu top-k wygenerowaniu indeksów eksperckich reszta procesu trasowania (permutacja tokenów według eksperta, przesyłanie ich pomiędzy układami, zbieranie wyników eksperckich i wykonywanie ważonej redukcji) odbywa się zgodnie z tym samym wzorcem zbierania/rozpraszania/redukcji, co potok osadzania, przy czym obsługa sortowania SparseCore obejmuje sam krok top-k.
Mając to na uwadze, oto ogłoszenia.
TPU 8t „Sunfish”
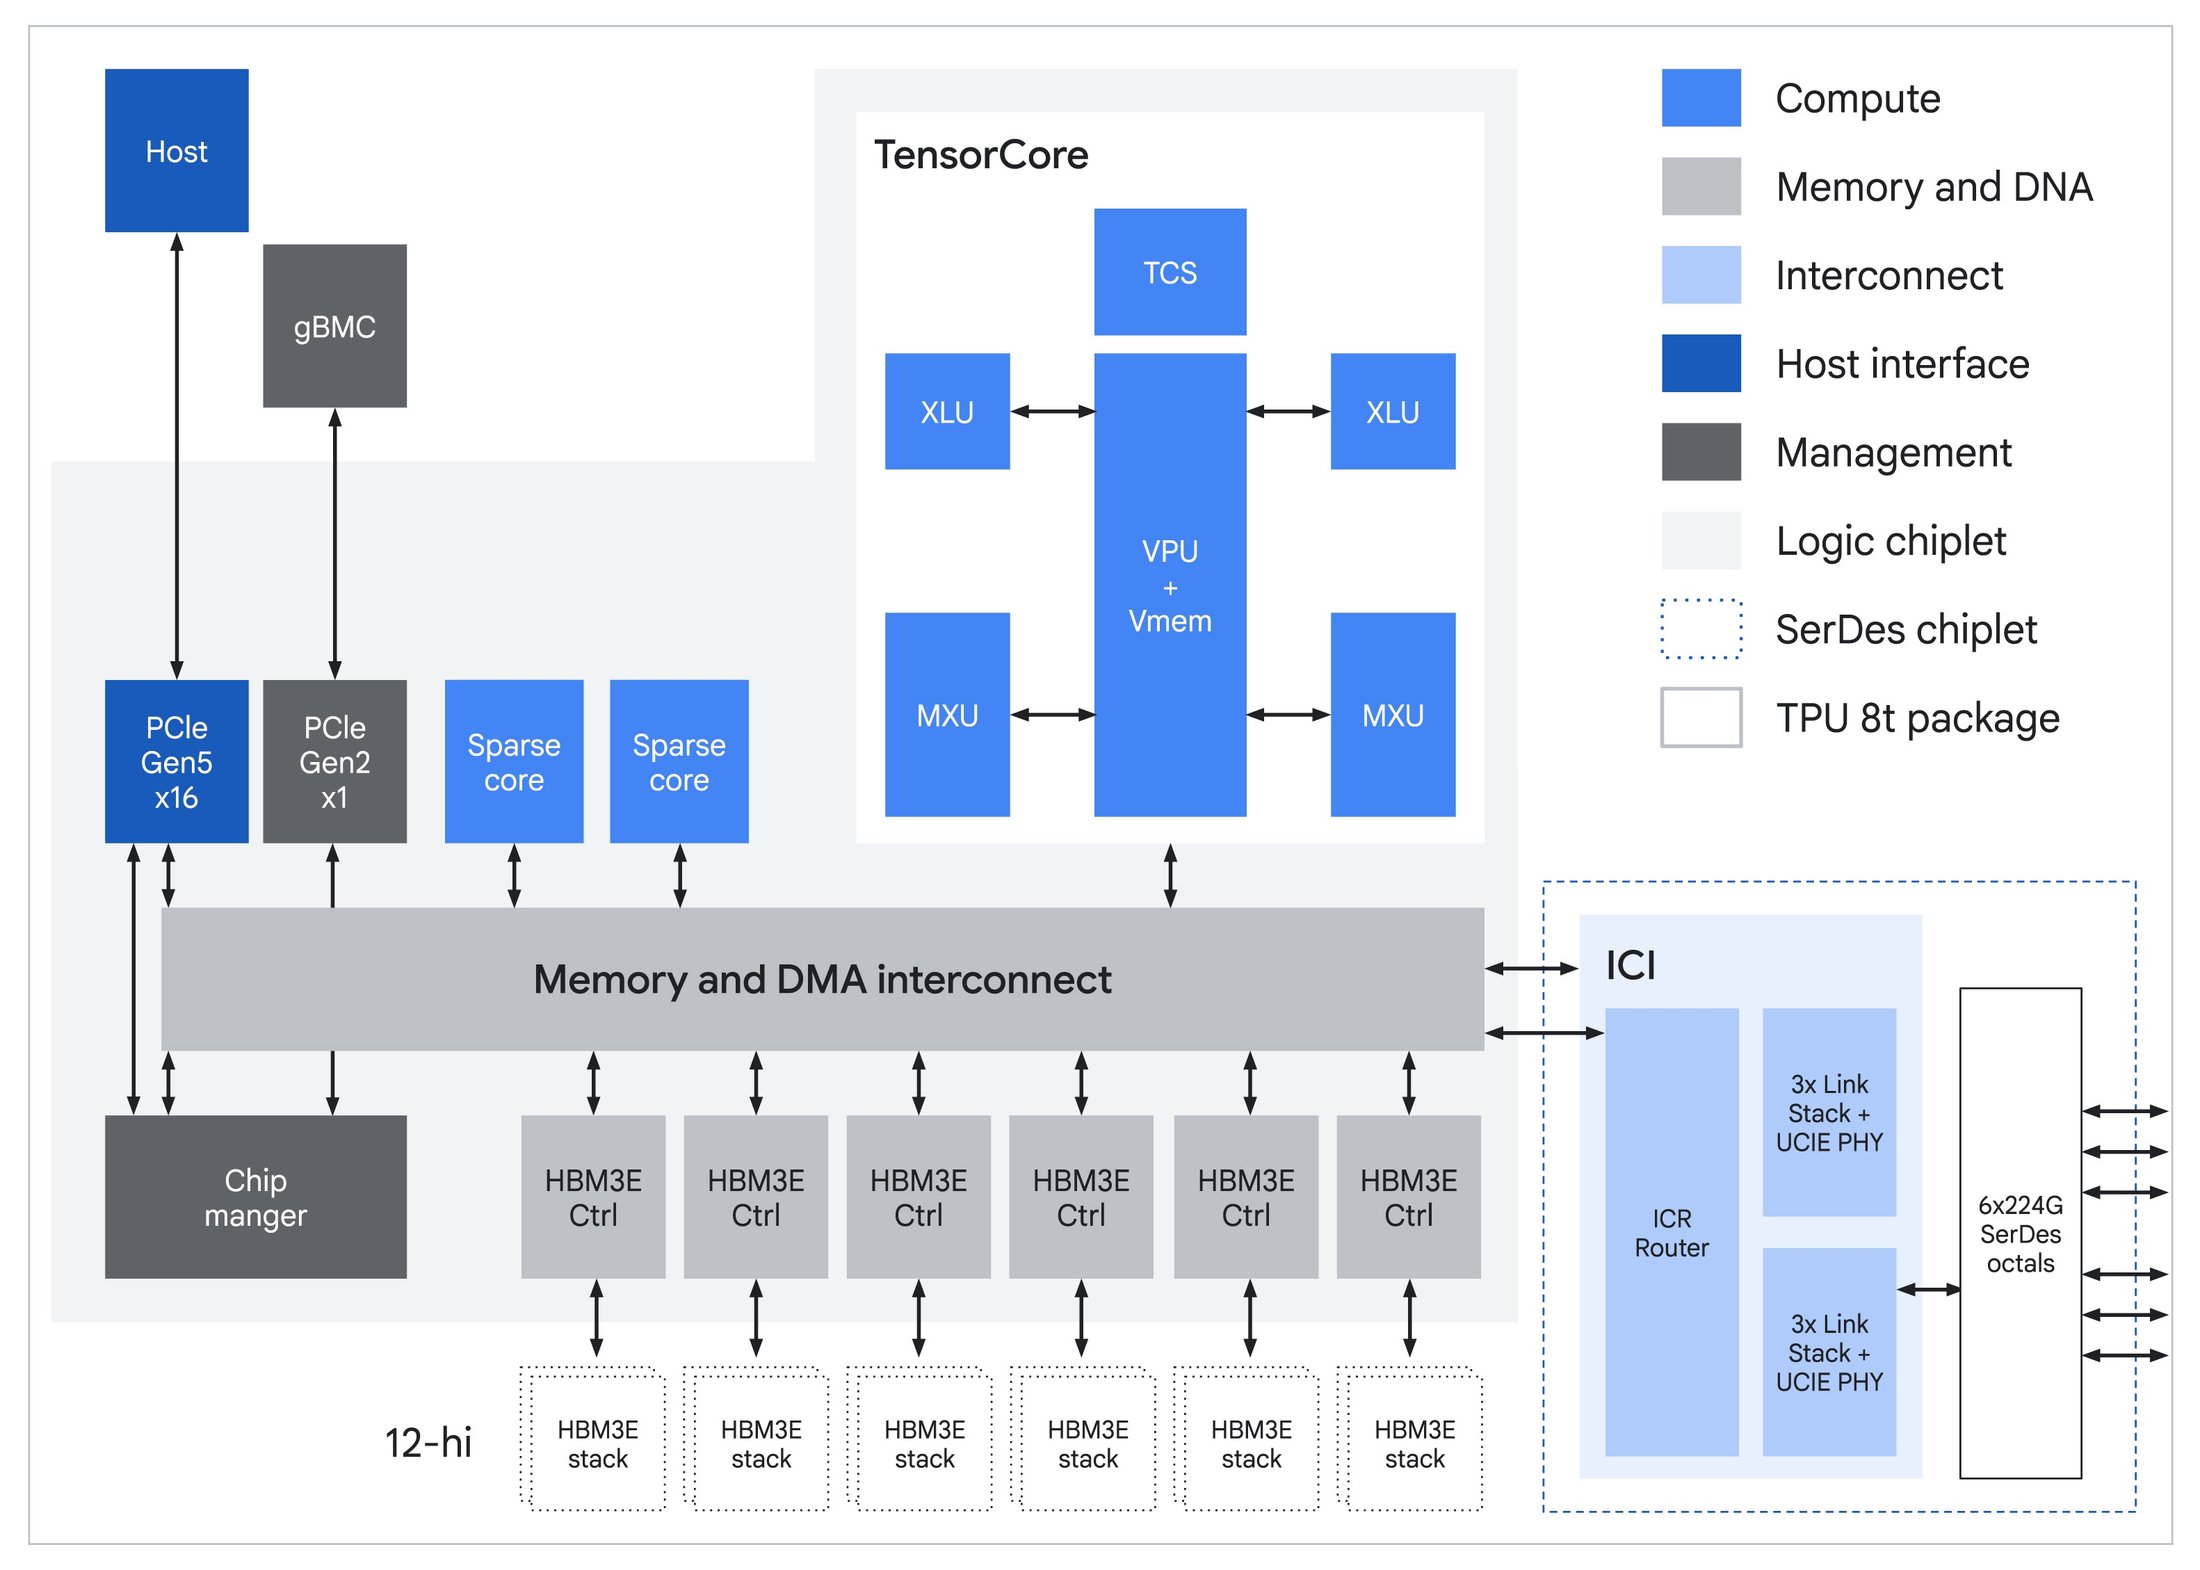
Pierwszym zapowiedzianym układem jest TPU 8t o nazwie kodowej Sunfish, który jest układem szkoleniowym. Przejście Ironwooda na nową generację pod wieloma względami podąża za oczekiwanymi założeniami: więcej pamięci, większa przepustowość, natywna obsługa węższych typów danych. Każdy układ zawiera pojedynczy rdzeń TensorCore zasilany przez sześć stosów 12-Hi HBM3e o łącznej pojemności 216 GB i przepustowości 6.5 TB/s, w porównaniu do 192 GB w Ironwood, rozmieszczonych na ośmiu stosach. Wbudowana pamięć SRAM Vmem wynosi 128 MB.
Natywny FP4 w MXU to źródło większości skoku obliczeniowego. Uruchamianie matmulsów w 4-bitach zamiast 8-bitowych podwaja przepustowość na cykl dla tej samej macierzy fizycznej, dzięki czemu Google przechodzi z 4.6 PFLOPS w FP8 w Ironwood do 12.6 PFLOPS w FP4 w 8t. Trening o mieszanej precyzji nadal zachowuje główną kopię wag FP32 dla kroku optymalizatora; FP4 zmniejsza liczbę tensorów roboczych, które pochłaniają większość czasu obliczeniowego.
Źródło: Google
Historia połączeń międzyprocesowych jest prosta. Przepustowość ICI podwaja się do 19.2 Tb/s na układ, superpod z 9,600 układami agreguje 2 PB HBM i 121 EFLOPS, a topologia torusa 3D zostaje zachowana. Torus ma sens w przypadku uczenia, ponieważ zadania graniczne są zdominowane przez kolektywy przyjazne dla pierścienia: all-reduce dla paralelizmu danych i tensorów, all-gathers i reduce-scatter dla FSDP oraz równoległe przesyłanie danych punkt-punkt w potoku. Wszystkie te operacje są czytelnie odwzorowane na osiach torusa.
Google zachowuje również rdzenie SparseCore, które były dostarczane w każdym procesorze TPU od wersji 4. Ich pierwotnym przeznaczeniem były modele rekomendacji w stylu DLRM, w których większość czasu obliczeniowego pochłania nieregularne gromadzenie i rozpraszanie danych w odniesieniu do masywnych tabel osadzania. Ten sam sprzęt obsługuje również routing MoE. JAX udostępnia nieregularne operacje „wszyscy do wszystkich” i odpowiadający im element ragged_dot jako operacje pierwszej klasy, w których każdy układ może wysłać fragment o innej wielkości do każdego węzła. Odpowiada to rzeczywistemu sposobowi rozsyłania MoE, ponieważ routing typu top-k jest zależny od danych, a liczba tokenów przesyłanych do każdego eksperta zmienia się na każdym kroku. Kompilator łączy nieregularną komunikację i nieregularny matmul eksperta w jedną zaplanowaną operację, podczas gdy SparseCore obsługuje otaczające sortowanie i permutację. Ponieważ architektura mix-of-expert jest obecnie dominującą architekturą w modelach granicznych, ten sprzęt udowadnia swoją wartość w każdym nowoczesnym zadaniu szkoleniowym, a nie tylko w przypadku obciążeń reklamowych i rankingowych, do których został pierwotnie zaprojektowany.
To kroki ewolucyjne. Większe zmiany to TPUDirect i przejście na hosty oparte na Axionie, które rozwiązują wąskie gardła widoczne dopiero w skali pionierskiej.
TPUDirect RDMA i pamięć masowa TPUDirect
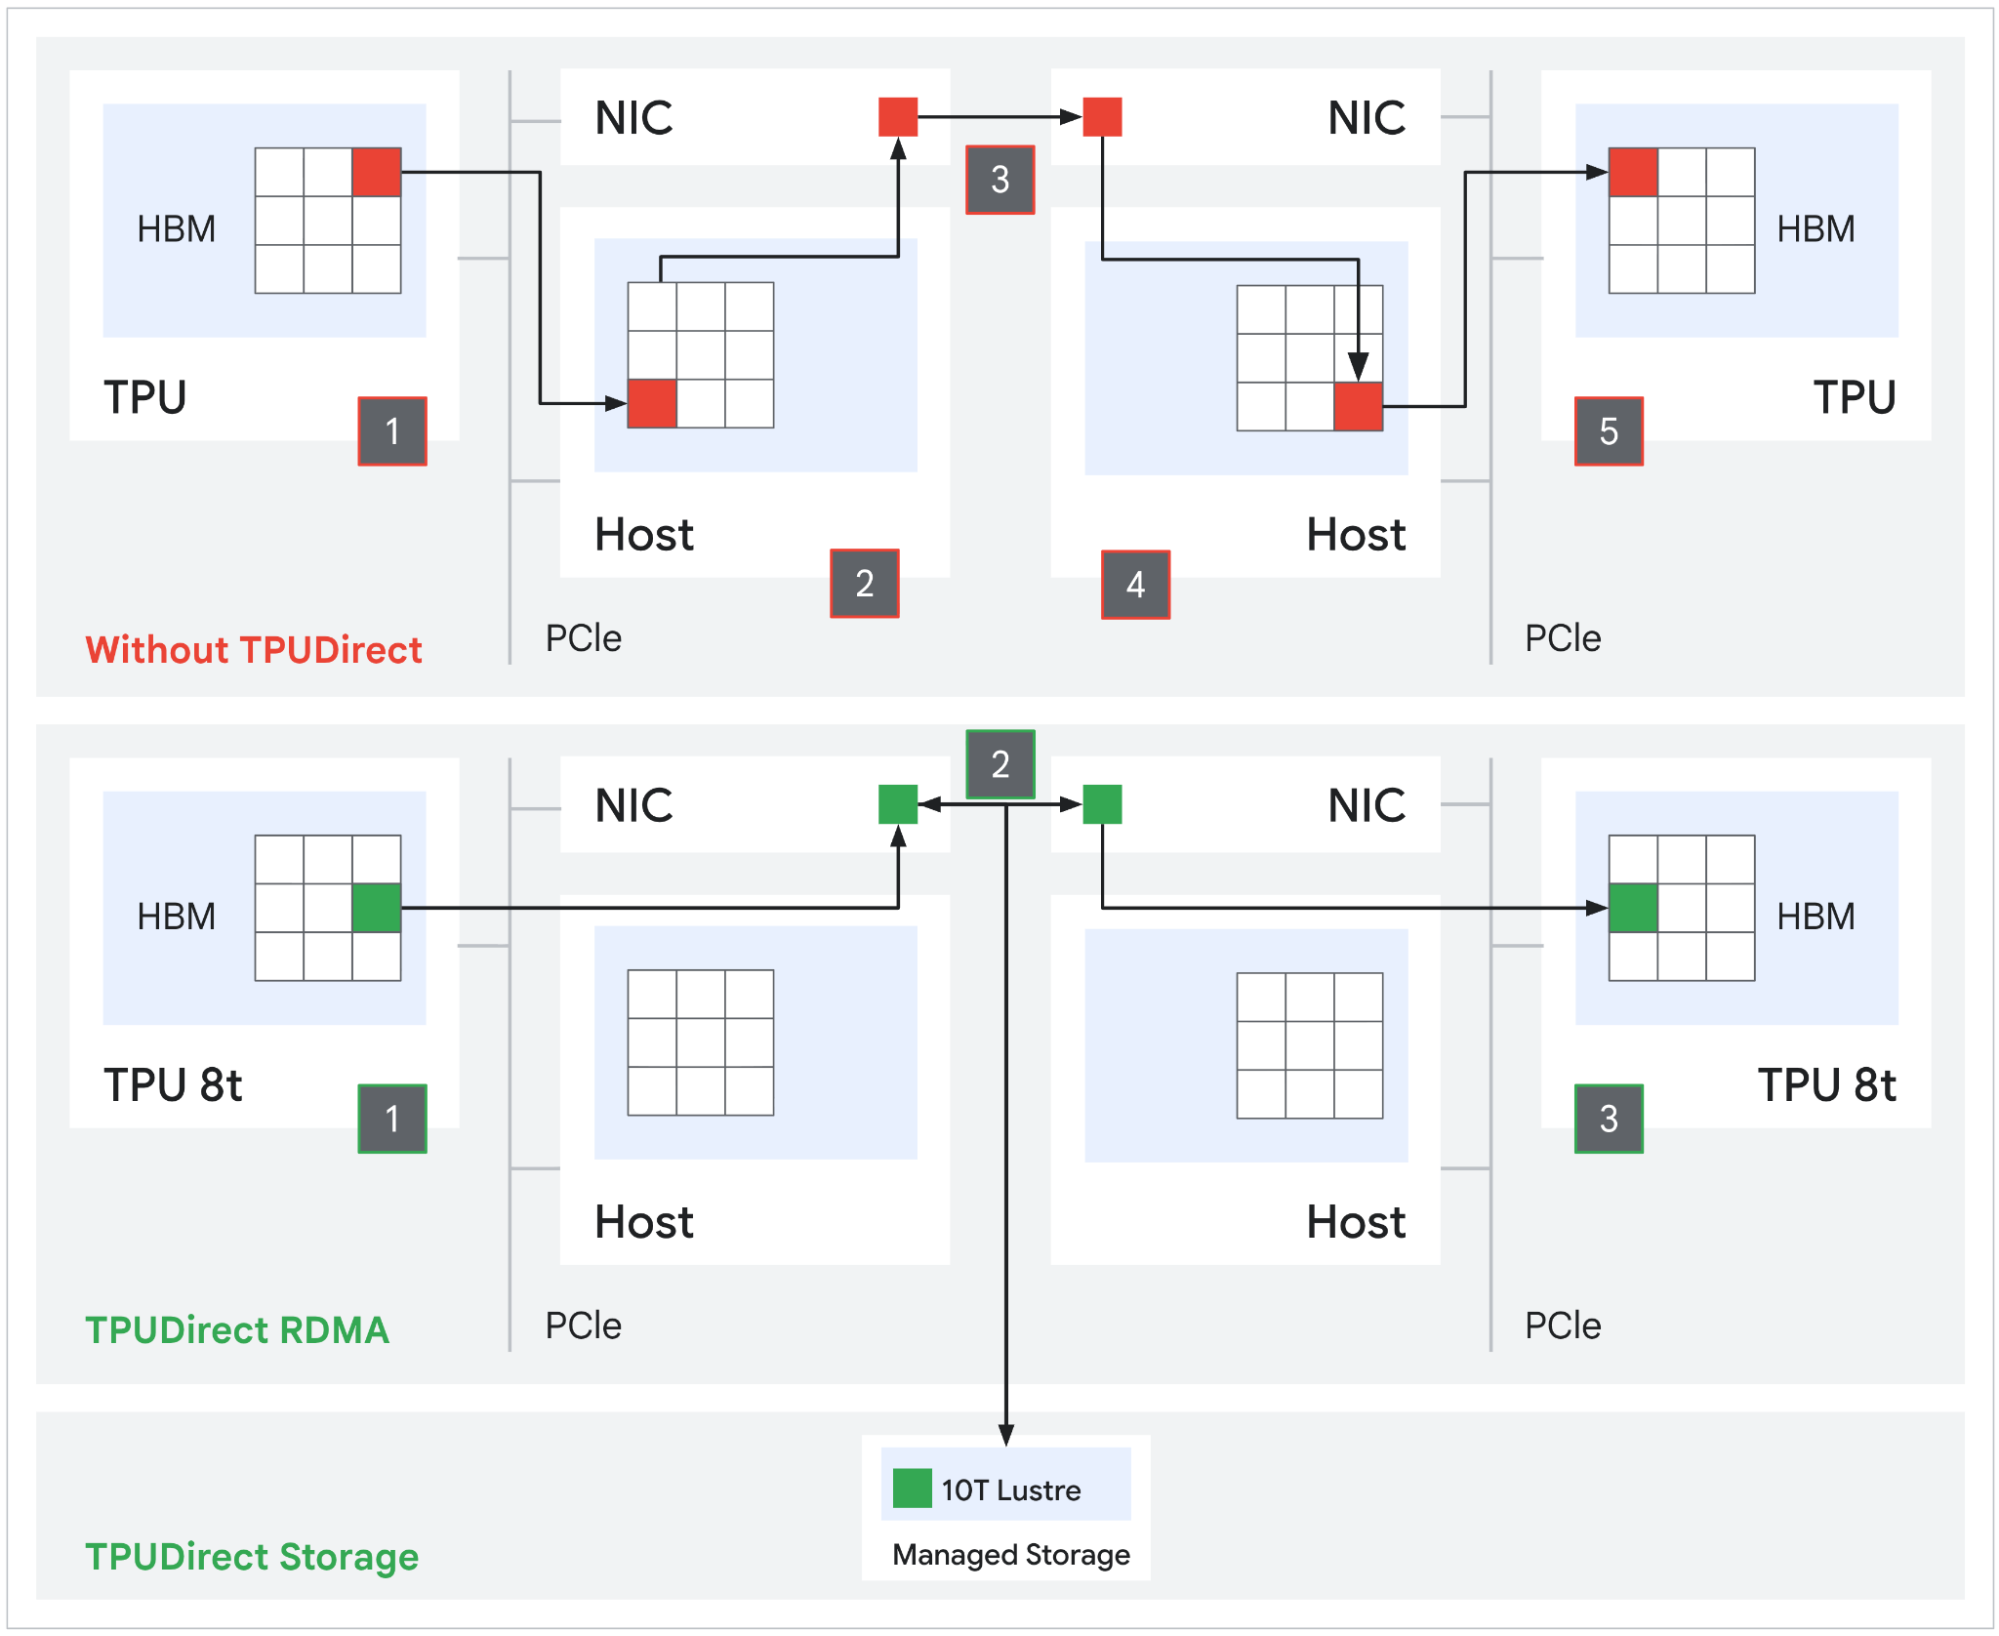
Poprzednie generacje TPU wykorzystywały ścieżkę pośredniczoną przez hosta do obsługi wejścia/wyjścia sieciowego i pamięci masowej: pakiety trafiały najpierw do pamięci DRAM hosta, a następnie oddzielny DMA kopiował je do pamięci HBM TPU. Oznacza to dwie transakcje pamięci z procesorem hosta w pętli. Technologia TPUDirect RDMA eliminuje bufor odbić. Karta sieciowa odczytuje i zapisuje dane HBM TPU bezpośrednio przez interfejs PCIe peer-to-peer, usuwając hosta ze ścieżki danych. NVIDIA od lat oferuje podobne możliwości w technologii GPUDirect RDMA i deklaruje około dziesięciokrotną poprawę w porównaniu ze ścieżką pośredniczoną przez hosta. Google obecnie dorównuje temu rozwiązaniu w przypadku TPU.
Źródło: Google
Technologia TPUDirect Storage rozszerza tę samą zasadę na pamięć trwałą. Tensory przemieszczają się bezpośrednio między TPU HBM a Managed Lustre z łączną prędkością 10 TB/s, co według Google zapewnia 10-krotnie szybszy dostęp do pamięci masowej niż równoważna ścieżka w Ironwood. W skali granicznej, gdzie punkty kontrolne mogą osiągać setki terabajtów, różnica polega na tym, czy wielotygodniowy przebieg treningowy przesyła punkty kontrolne i zestawy danych z prędkością łącza, czy też zatrzymuje potok MXU oczekujący na wejście/wyjście hosta.
Gospodarze Arm Axion
Wszystkie poprzednie generacje TPU działały na hostach x86 innych firm. 8t jest pierwszym, który wykorzystuje autorski procesor Google Axion, oparty na architekturze Arm Neoverse V2, jako nagłówek systemowy. Zadanie procesora hosta w podzie TPU jest realne i staje się trudniejsze w przypadku skalowalności: steruje on potokiem wejściowym, dekoduje i tasuje wielopetabajtowe zestawy danych, zarządza płaszczyzną sterowania JAX/XLA, obsługuje serializację punktów kontrolnych i koordynuje wysyłanie sygnałów SPMD do tysięcy układów. Jeśli host się zatrzyma, MXU pozostaje bezczynny.
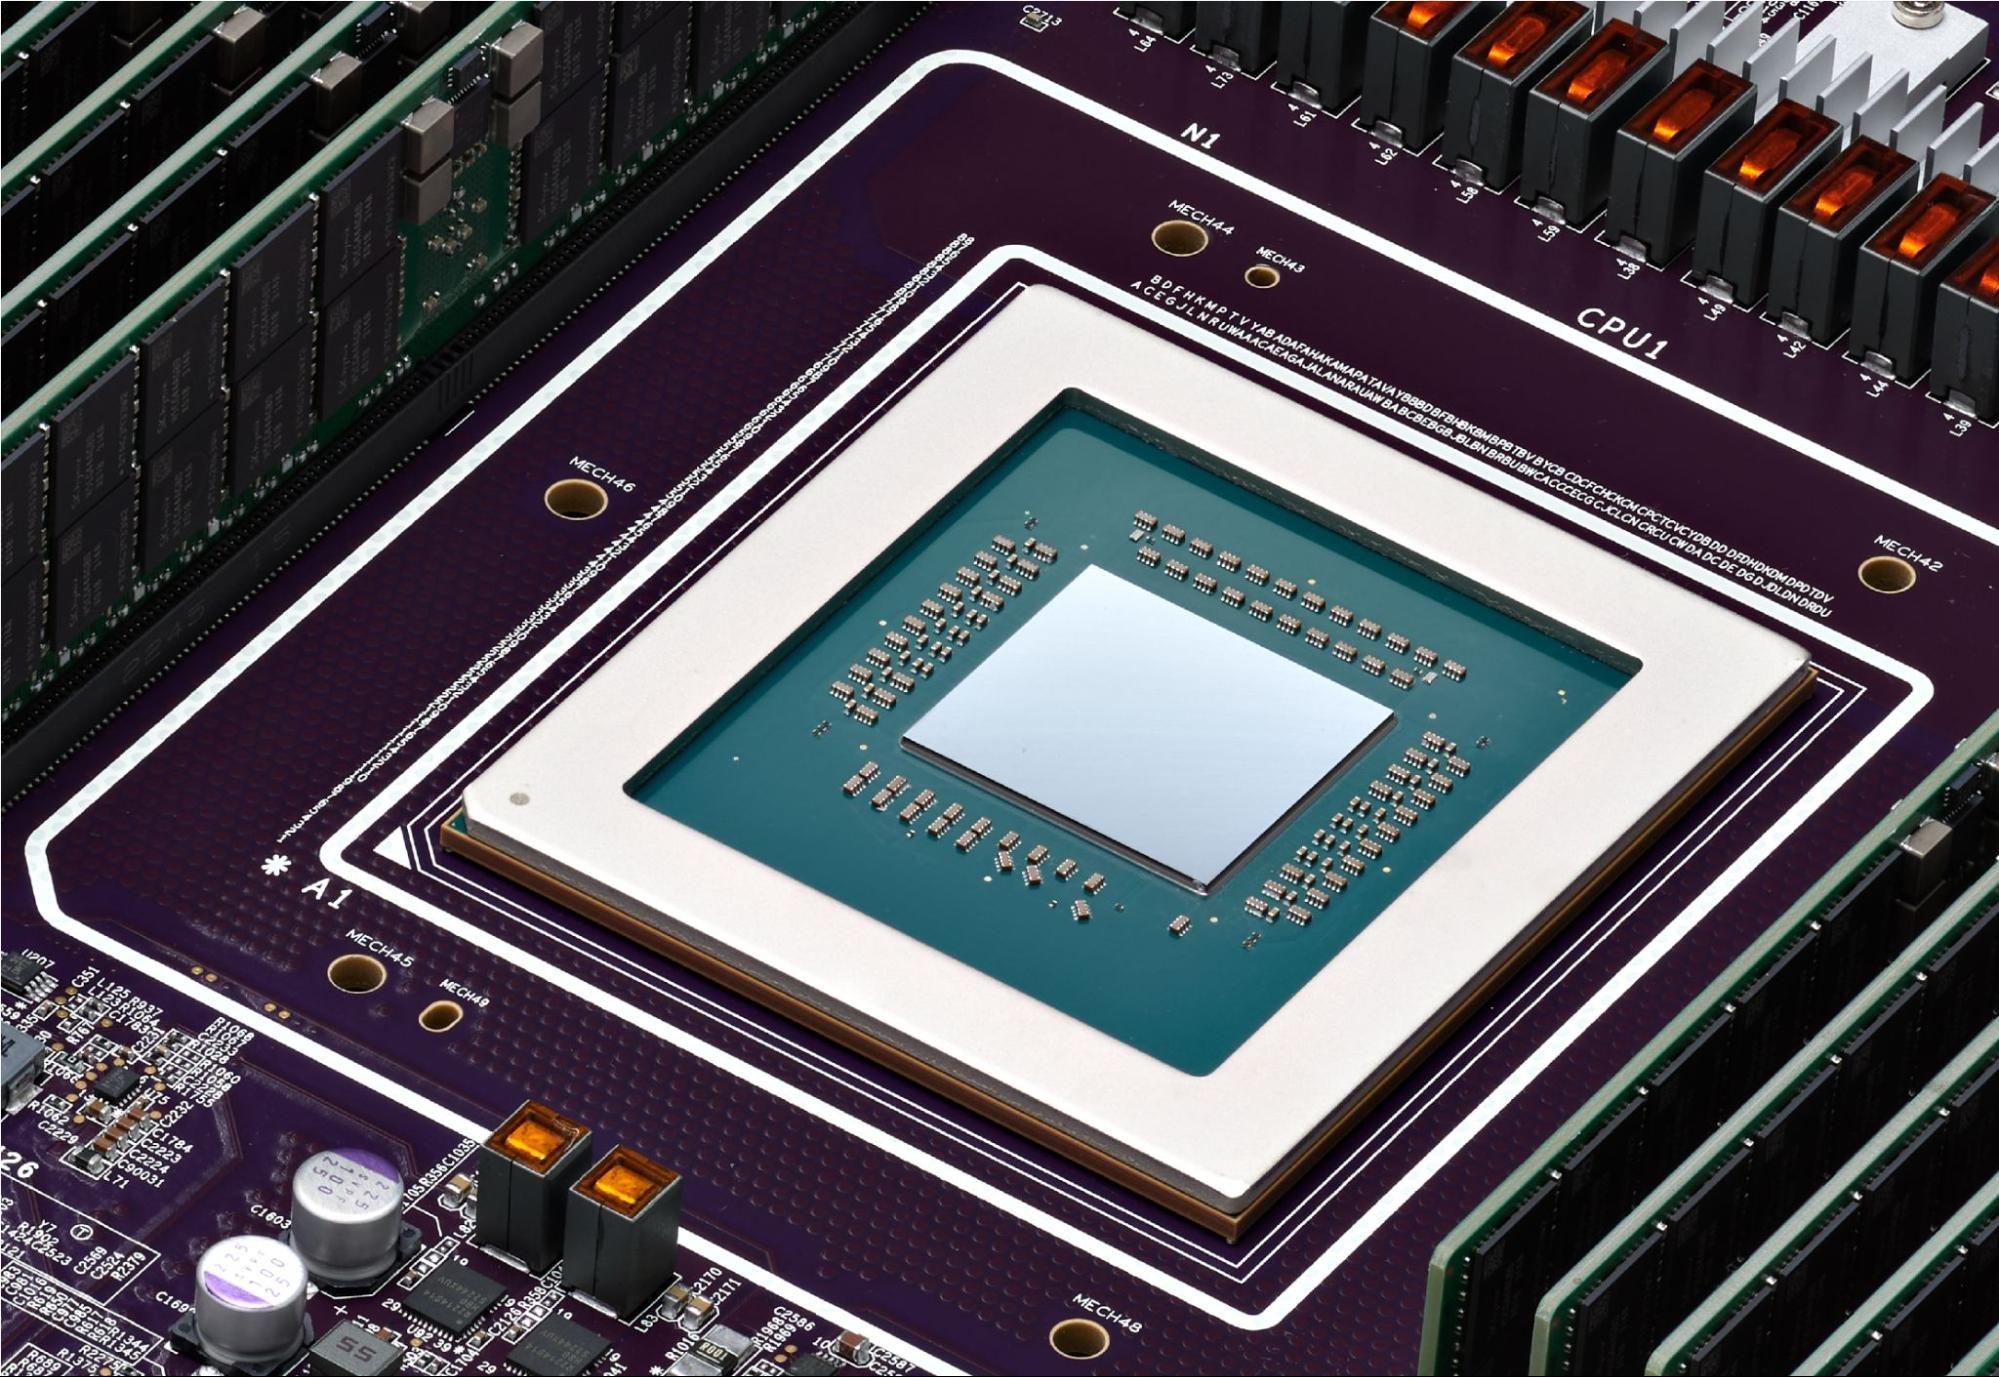
Google wyraźnie wskazuje na izolację NUMA opartą na Axionie w 8t jako mechanizm zapobiegający przedostawaniu się jittera po stronie hosta do zsynchronizowanych, zbiorczych faz treningu. Przy 9,600 chipach na pod, nawet niewielkie problemy z hostem przekładają się na mierzalną utratę przepustowości. TPUDirect obsługuje ścieżkę danych, eliminując hosta z transferów zbiorczych. Axion obsługuje ścieżkę sterowania, zapewniając każdemu procesorowi TPU wystarczającą dedykowaną przepustowość procesora, dzięki czemu przetwarzanie wstępne nigdy nie staje się wąskim gardłem. Google zwiększył również liczbę fizycznych hostów Axion na serwer na platformie ósmej generacji, zapewniając narzut orkiestracji, który skaluje się wraz z liczbą chipów, większy margines niż zapewniała konfiguracja hosta Ironwood.
TPU 8i „Dziewczynka”
Układ wnioskowania współdzieli platformę hosta Axion firmy 8t, natywny układ FP4 i generację pamięci HBM3e, ale krzem znajdujący się pod nim jest przeznaczony do obsługi innego wąskiego gardła. Uczenie jest ograniczone obliczeniowo; dekodowanie wnioskowania jest ograniczone przepustowością pamięci. Większość różnic architektonicznych w 8i wynika właśnie z tego.
Największą zmianą jest pamięć SRAM na chipie. 8i ma 384 MB pamięci Vmem, trzy razy więcej niż Ironwood. Ma to znaczenie ze względu na pamięć podręczną KV. Podczas dekodowania długiego kontekstu każdy wygenerowany token wymaga odczytania zgromadzonych stanów klucz-wartość z poprzednich tokenów. W większości akceleratorów odczyt ten pochodzi z pamięci HBM, co oznacza, że przepustowość dekodowania jest bramkowana przez przepustowość pamięci, a nie przez moc obliczeniową. 8i ma rozmiar umożliwiający przechowywanie znaczących śladów pamięci podręcznej KV w całości na krzemie. Przepustowość pamięci SRAM na chipie jest mniej więcej o rząd wielkości wyższa niż w pamięci HBM, więc każdy odczyt KV z pamięci SRAM, a nie z pamięci HBM, oznacza krótsze opóźnienie na token i większą liczbę tokenów na sekundę przy tym samym poborze mocy.
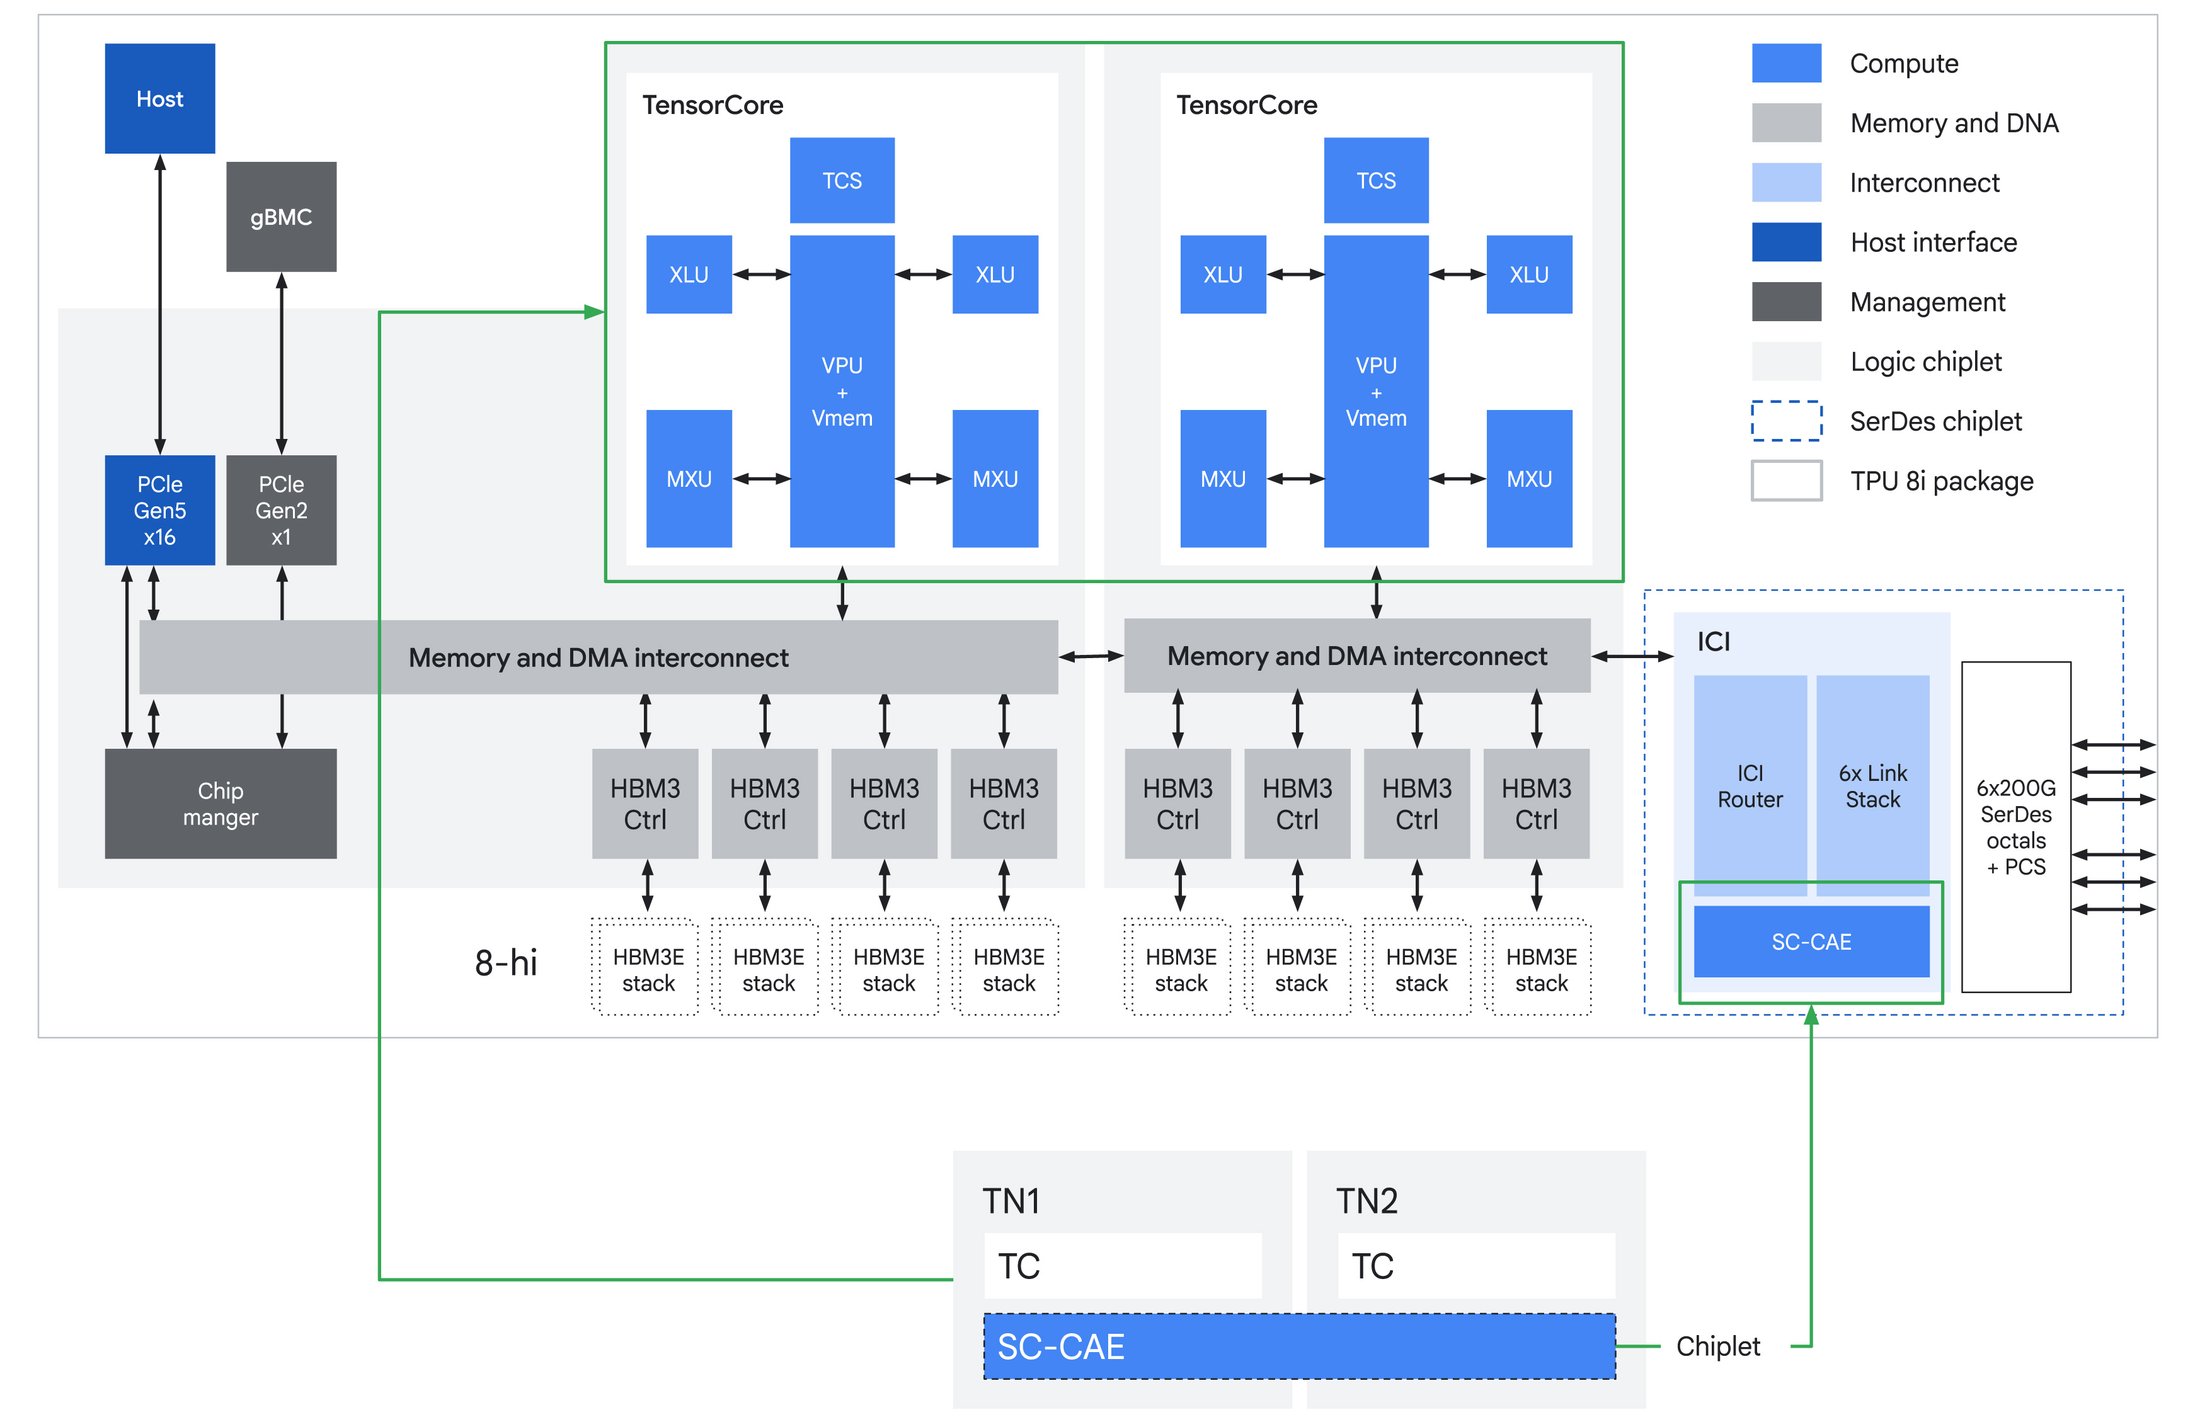
Źródło: Google
Konfiguracja TensorCore to kolejna istotna zmiana. Podczas gdy 8t wykorzystuje pojedynczy rdzeń TensorCore z łączną mocą obliczeniową 12.6 PFLOPS, 8i dzieli obliczenia na dwa rdzenie TensorCore z łączną mocą obliczeniową 10.1 PFLOPS. Niższa szczytowa przepustowość brzmi jak obniżenie, dopóki nie weźmie się pod uwagę, jak faktycznie wygląda wnioskowanie na poziomie układu scalonego. Obciążenia treningowe są zdominowane przez zadania wsadowe: duże macierze (matmuls) amortyzują stały narzut, a pojedyncza duża jednostka MXU może utrzymać wykorzystanie bliskie szczytowemu. Dekodowanie wnioskowania jest odwrotne. Rozmiary zadań wsadowych są małe, okna obliczeniowe per token są krótkie, a układ poświęca znaczną część swojego czasu na kolektywy, próbkowanie i routing zamiast na czyste macierze (matmul). Pojedynczy duży silnik zatrzymuje się podczas tych nieregularnych przerw. Podział na dwa rdzenie TensorCore pozwala 8i na efektywniejsze nakładanie się faz obliczeniowych, przy czym każdy rdzeń TensorCore jest zasilany przez cztery własne, bezpośrednio podłączone stosy HBM, co daje łącznie 288 GB przy 8.6 TB/s w całym pakiecie. W rezultacie uzyskuje się wyższe, stałe wykorzystanie w przypadku partii, które są faktycznie obsługiwane w trybie interaktywnym.
Na poziomie domeny skalowania, 1,024 aktywne układy scalone w module Boardfly zapewniają łącznie około 295 TB pamięci HBM, 384 GB pamięci SRAM na chipie i 10.3 EFLOPS mocy obliczeniowej FP4. Liczba pamięci SRAM ma największe znaczenie dla wnioskowania: 384 GB pamięci podręcznej na chipie w całej domenie wystarcza do przechowywania znacznej ilości stanu KV bez ingerencji w HBM, co umożliwia obsługę długiego kontekstu z niskim opóźnieniem.
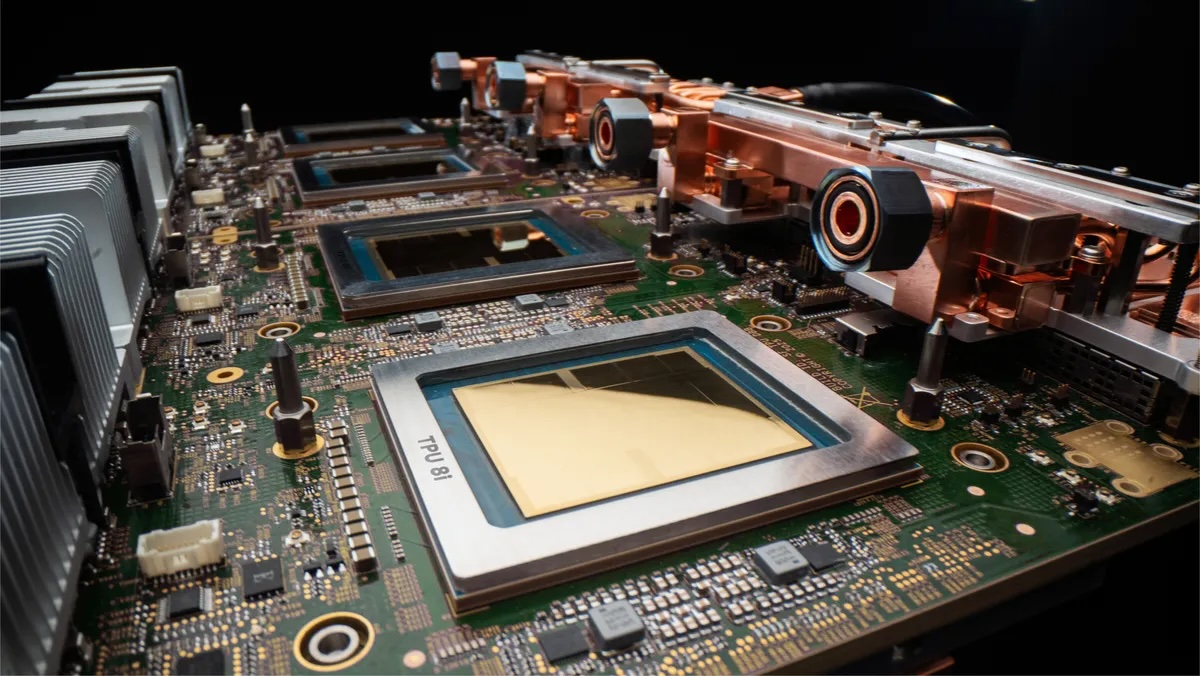
Po stronie hosta obowiązuje ta sama logika. Google twierdzi, że zwiększyło liczbę fizycznych hostów Axion na serwer w 8i w porównaniu z Ironwood. Serwery inferencyjne poświęcają nietrywialny ułamek czasu na token na tokenizację, logikę próbkowania, routing, przetwarzanie wsadowe i orkiestrację środowiska wykonawczego agenta. Te obciążenia skalują się wraz ze współbieżnością, a nie rozmiarem modelu, a przy częstotliwościach żądań generowanych przez obciążenia agenta, host może stać się wąskim gardłem. Większa moc obliczeniowa hosta na akcelerator to proste rozwiązanie.
Silnik akceleracji kolektywów
Inną istotną zmianą w układzie scalonym jest silnik akceleracji Collectives Acceleration Engine, który zastępuje cztery rdzenie SparseCore, które były stosowane w Ironwood. Rdzenie SparseCore obsługują routing i wyszukiwanie w MoE za pomocą dedykowanego sprzętu typu „garget-scatter”, dzięki czemu usunięcie ich z sygnałów układu wnioskowania pozwala 8i zoptymalizować je pod kątem innego wąskiego gardła.
Wąskim gardłem CAE jest opóźnienie zbiorcze. Każdy zdekodowany token wymaga synchronizacji uczestniczących układów: wszystkie sygnały wyjściowe uwagi muszą być zredukowane, metadane trasowania eksperckiego muszą być rozgłaszane, a próbkowane tokeny muszą być propagowane do następnego kroku. Na procesorach GPU koordynacja ta odbywa się programowo za pośrednictwem NCCL, który planuje kolektywne operacje jako sekwencję uruchomień jądra i operacji sieciowych. W systemie 8i CAE to dedykowany układ scalony umieszczony na osobnej strukturze chipletu obok rdzeni TensorCore, obsługujący te prymitywy synchronizacji sprzętowo.
Google twierdzi, że zbiorcze opóźnienie na chipie jest nawet 5-krotnie niższe niż w Ironwood. W przypadku pakietów obliczeniowych o rozmiarach na skalę szkoleniową, ta poprawa zostałaby zniwelowana przez czas obliczeniowy; kolektywne opóźnienie stanowi jedynie niewielki ułamek kroku. W przypadku małych pakietów i krótkich okienek per token w interaktywnym wnioskowaniu, zbiorcze opóźnienie może zdominować czas per token, więc 5-krotna redukcja jest widoczna w liczbie tokenów na sekundę i cenie za token.
8i przechodzi również z topologii torusa 3D do tego, co Google nazywa Boardfly, hierarchicznej topologii inspirowanej Dragonfly, która zamienia kolektywną przepustowość pierścienia na opóźnienie między wszystkimi. Przyjrzymy się Boardfly szczegółowo poniżej.
Topologia Boardfly
8i wykorzystuje inną topologię niż 8t, ponieważ proces uczenia i wnioskowania przebiega w innych wzorcach komunikacji.
Torus 3D idealnie nadaje się do kolektywów pierścieniowych: każdy chip ma sześciu sąsiadów, dane obracają się wokół pierścienia, a żaden chip nie kieruje dowolnego ruchu. Uczenie jest zdominowane przez te przyjazne dla pierścienia wzorce, dlatego 8t zachowuje torus. Pierścieniowy model all-reduce idealnie odwzorowuje pojedynczą oś torusa. Zadania Frontier zazwyczaj umieszczają paralelizm danych na jednej osi, paralelizm tensorów na drugiej, a paralelizm potoków na trzeciej. Topologia i obciążenie są dopasowane.
Wnioskowanie obsługujące duży model MoE ma inny profil komunikacji. Eksperci są przypięci do wielu chipów, a każdy zdekodowany token uruchamia komunikację typu „wszyscy do wszystkich”: tokeny muszą dotrzeć do przypisanych ekspertów rozproszonych po strukturze, a dane wyjściowe ekspertów muszą zostać zwrócone. To nie jest pierścień. To dowolny ruch punkt-punkt, a w przypadku 1,024-chipowego torusa trójwymiarowego, w najgorszym przypadku ścieżka między dowolnymi dwoma chipami wynosi 16 przeskoków. Google rozkłada to równanie na czynniki pierwsze: „W torusie trójwymiarowym węzły są ułożone w siatce, w której każdy wymiar zawija się jak pierścień. Aby dotrzeć do najdalszego możliwego chipa w konfiguracji 8 x 8 x 16 (1024 chipy), pakiet musi pokonać połowę odległości każdego pierścienia:
Torus 3D = 8/2(X) + 8/2(Y) + 16/2(Z) = 16 przeskoków
Chociaż torus jest wysoce wydajny w komunikacji między sąsiadami, typowej dla gęstego uczenia, generuje on obciążenie opóźnienia dla wzorców komunikacji typu „wszyscy z wszystkimi”. W erze modeli wnioskowania i mechanizmu doskonałości (MoE), gdzie każdy układ scalony może potrzebować komunikacji z dowolnym innym układem scalonym, aby skierować token, ta liczba przeskoków ma znaczenie.
W przypadku interaktywnego serwowania wrażliwego na opóźnienia, te dodatkowe przeskoki powodują, że opóźnienie na token przekracza jego docelowy poziom usług (SLO).
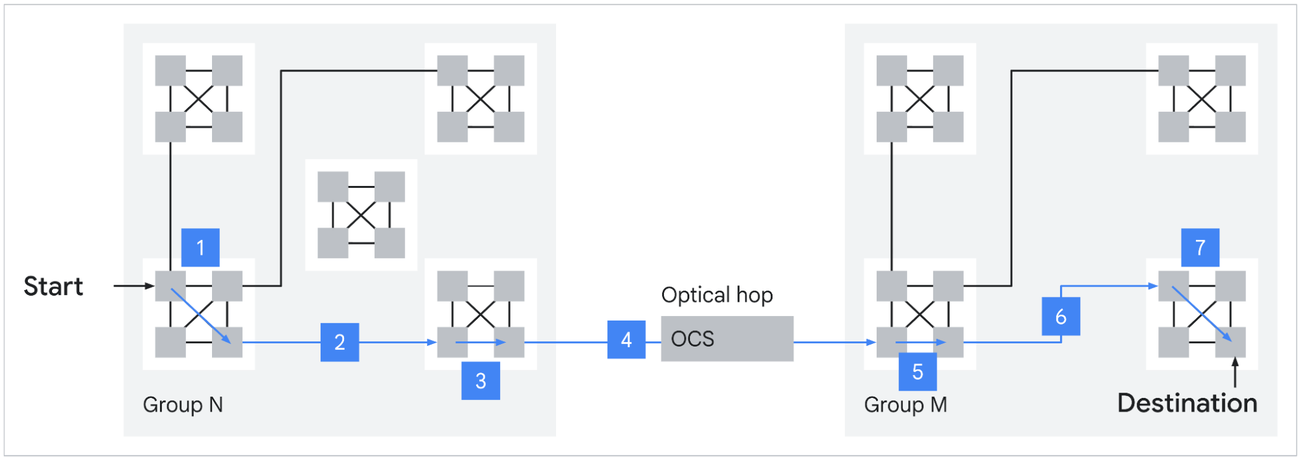
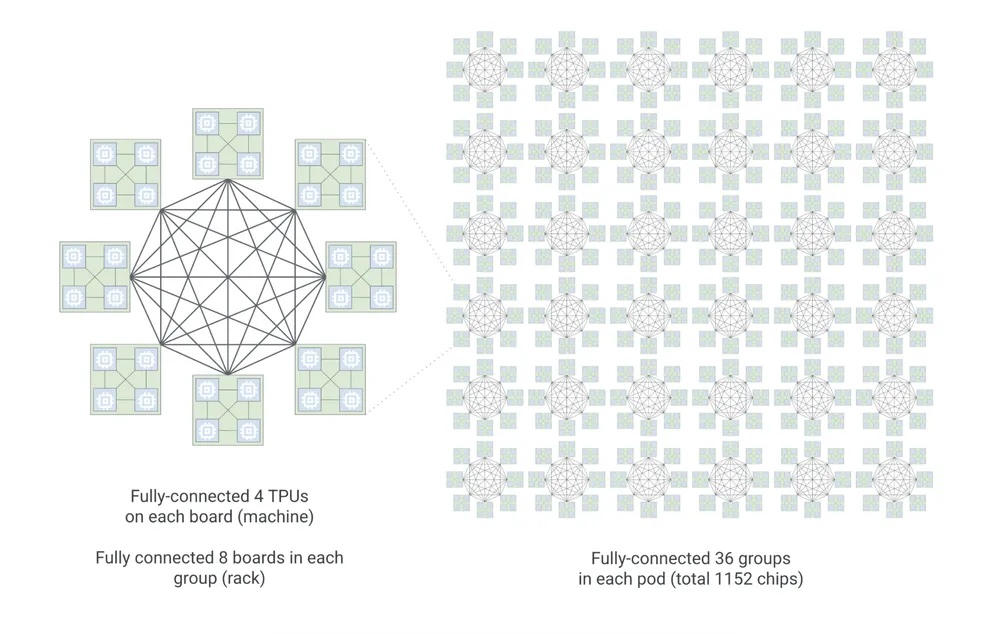
Źródło: Google
Boardfly to hierarchia inspirowana Dragonfly, zaprojektowana w celu skompresowania tej średnicy. Struktura ma trzy poziomy. Podstawowym elementem jest pierścień z czterema chipami i 16 połączeniami zewnętrznymi. Osiem z tych bloków tworzy grupę, w pełni połączoną miedzianym okablowaniem z 11 łączami na grupę. Trzydzieści sześć grup łączy się za pomocą przełączników obwodów optycznych (OPC), tworząc pod. Rezultatem jest domena skalowalna z 1,152 chipami (1,024 aktywnymi) i maksymalnie 7 przeskokami między dowolnymi dwoma chipami, co stanowi redukcję o 56% w porównaniu z torusem. Google twierdzi, że zapewnia to nawet 50% redukcję opóźnień w przypadku obciążeń intensywnie wykorzystujących komunikację, takich jak MoE all-to-all.
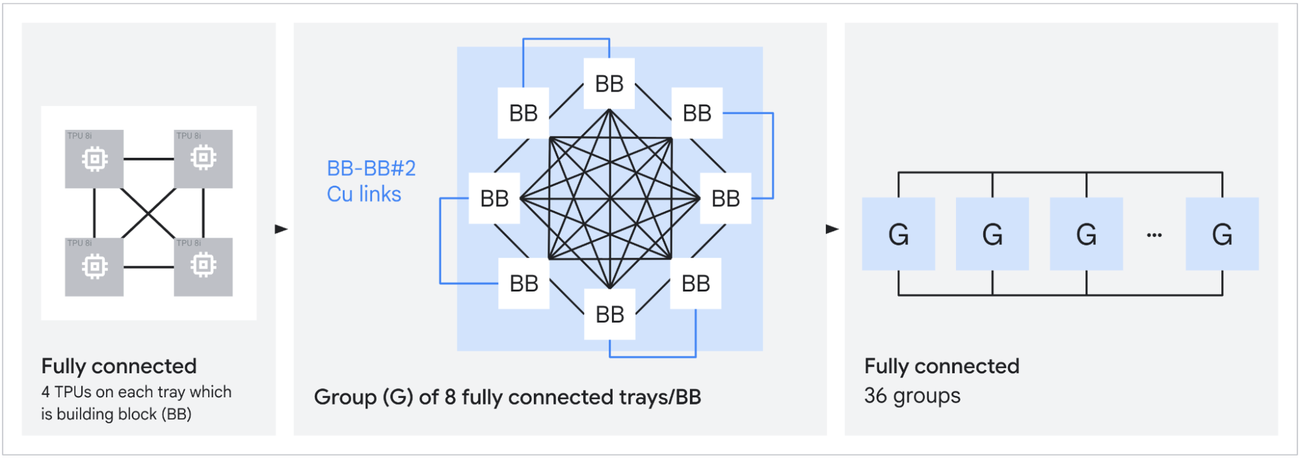
Większa domena skalowania ma również znaczenie dla replikacji eksperckiej. Więcej chipów na strukturę ICI oznacza, że każdy ekspert w dużym MoE może być replikowany więcej razy, co niweluje nierównowagę routingu i utrzymuje płaskie opóźnienie dekodowania w przypadku nierównomiernego rozkładu tokenów. Routing typu top-k jest zależny od danych; niektórzy eksperci zobaczą więcej tokenów niż inni na danym etapie. Replikacja kompensuje tę rozbieżność. Przepustowość ICI została podwojona do 19.2 Tb/s na chip, częściowo w celu obsługi generowanego ruchu.
Sieć Panny
Superpod z 9,600 chipami jest duży, ale szkolenia Frontier wymagają coraz więcej. Virgo to infrastruktura skalowalna, która łączy superpody w centrum danych, obsługując ruch RDMA wschód-zachód między podami, gdy zadanie przekracza pojedynczą domenę skalowalną.
Pojedyncza struktura Virgo łączy ponad 134 000 chipów 8t z nieblokującą, dwusekcyjną przepustowością 47 Pb/s, co zapewnia do 4 razy większą przepustowość na akcelerator i o 40% niższe opóźnienie bez obciążenia w porównaniu z poprzednią generacją. Architektura to płaska, dwuwarstwowa, nieblokująca topologia oparta na przełącznikach o wysokiej częstotliwości, o wielopłaszczyznowej konstrukcji i niezależnych domenach sterujących.
Tradycyjne struktury Clos przesubskrybują na wyższych poziomach, aby utrzymać liczbę portów i koszty na rozsądnym poziomie. Działa to dobrze, gdy większość ruchu odbywa się w kierunku północ-południe, co jest typowe dla chmury ogólnego przeznaczenia: klienci trafiają do systemów równoważenia obciążenia, systemy równoważenia obciążenia trafiają do serwerów aplikacji, a serwery aplikacji trafiają do pamięci masowej. Obciążenia treningowe sztucznej inteligencji są niemal w całości realizowane w układzie wschód-zachód, od układu do układu, a kolektywy są zdominowane przez podział na dwie części. Każda nadsubskrypcja na dowolnym poziomie bezpośrednio wpływa na czas trwania kroku treningowego. Płaska, dwuwarstwowa konstrukcja Virgo z przełącznikami o wysokiej częstotliwości eliminuje wąskie gardło w warstwie szkieletowej, budując przełączniki z wystarczającą liczbą portów na układ ASIC, aby zakończyć znaczną część struktury w dwóch przeskokach.
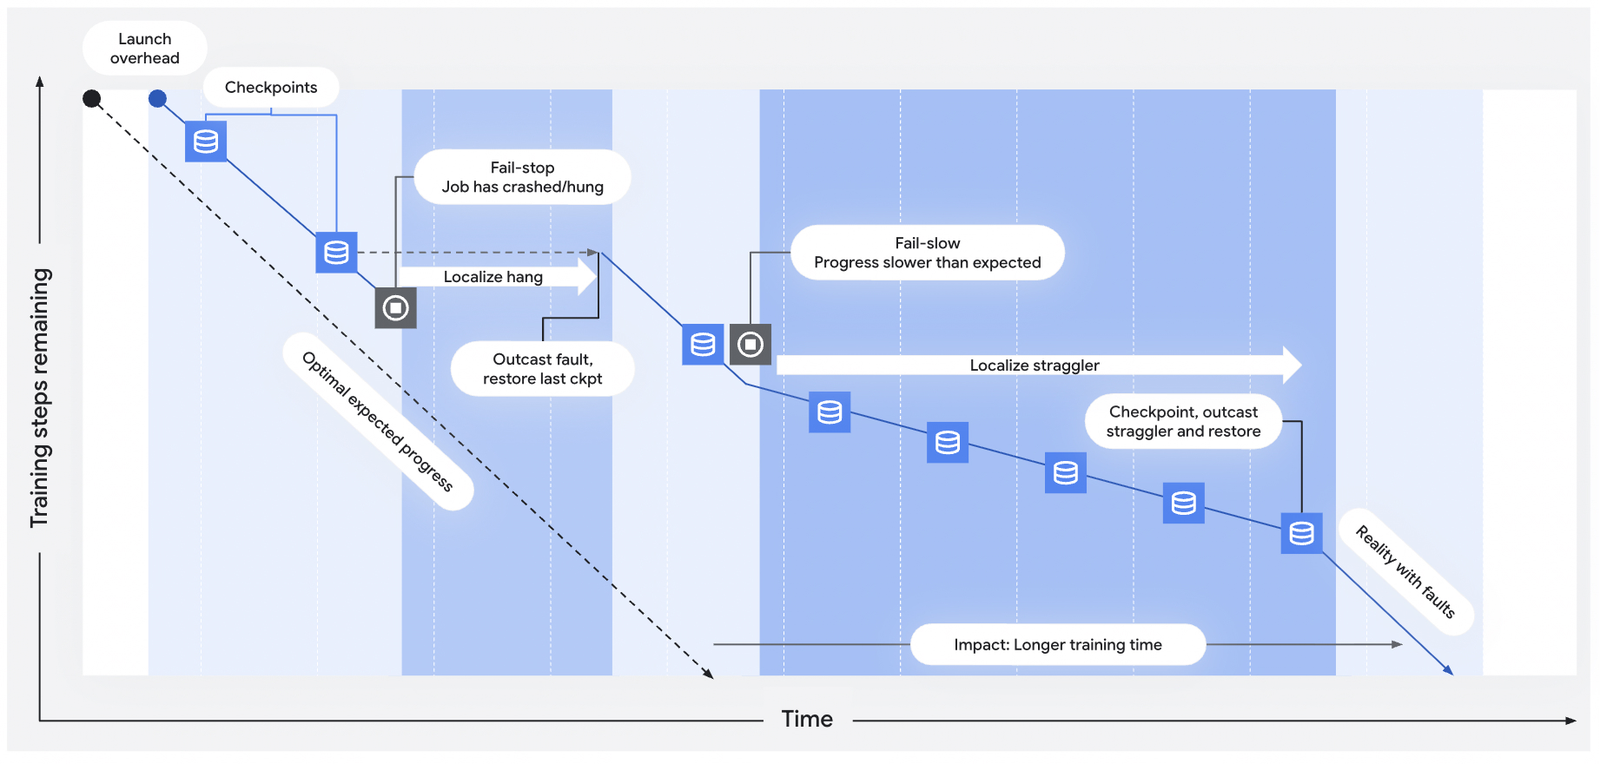
Inżynieria niezawodności ma znaczenie w tej skali i w dużej mierze zależy od przełączników obwodów optycznych Google opartych na technologii MEMS. OCS pozwala Google rekonfigurować topologię fizyczną między zadaniami bez konieczności ponownego okablowania, a co ważniejsze, omijać uszkodzone układy scalone lub łącza w trakcie pracy. W przypadku wykrycia awarii OCS może przemapować uszkodzoną część struktury w ciągu milisekund, eliminując potrzebę ręcznej interwencji. Telemetria submilisekundowa zapewnia automatyczne wykrywanie opóźnień i zawieszeń. Połączenie szybkiego wykrywania i reroutingu opartego na OCS optymalizuje średni czas między przerwaniami i średni czas odzyskiwania w skali ponad 100 000 układów scalonych, gdzie statystyczna pewność wystąpienia awarii podczas wielotygodniowego cyklu pracy zbliża się do 100%. Cel dobrej przepustowości na poziomie 97%, który Google podaje dla podów 8t, zależy od tej infrastruktury. Ta sama technologia OCS pojawia się w całym stosie TPU: łączy kostki w superpody na warstwie ICI, łączy grupy Boardfly na warstwie skalowania 8i i obsługuje ruch między podami na warstwie Virgo.
Przy 134 000 chipów, łączna moc obliczeniowa sięga około 1,690 EFLOPS FP4, czyli około 1.7 ZFLOPS. Google twierdzi, że architektura obsługuje niemal liniowe skalowanie do miliona chipów w jednym logicznym klastrze szkoleniowym, choć obecne wdrożenia nie osiągnęły jeszcze tego pułapu.
Jupiter i skala wielu centrów danych
Virgo obsługuje ruch akceleratora wschód-zachód w centrum danych, ale nie jest najnowocześniejszym rozwiązaniem. Jupiter to istniejąca struktura Google'a o kierunku północ-południe, obecnie w piątej generacji, która obsługuje ruch front-end oraz dostęp do rozproszonych zasobów pamięci masowej i obliczeniowych. Jupiter nie został zaprezentowany na konferencji Cloud Next; to istniejąca infrastruktura, na której opiera się ósma generacja.
Najnowsza wersja Jupitera zapewnia przepustowość bisekcyjną 13 Pb/s na budynek centrum danych, przy dostępności na poziomie 99.999%, wykorzystując przełączniki Apollo MEMS OCS o mocy około 108 W na OCS w porównaniu z około 3,000 W dla równoważnego elektrycznego przełącznika pakietowego. To właśnie ta struktura łączy centra danych Google ze światem zewnętrznym i między sobą.
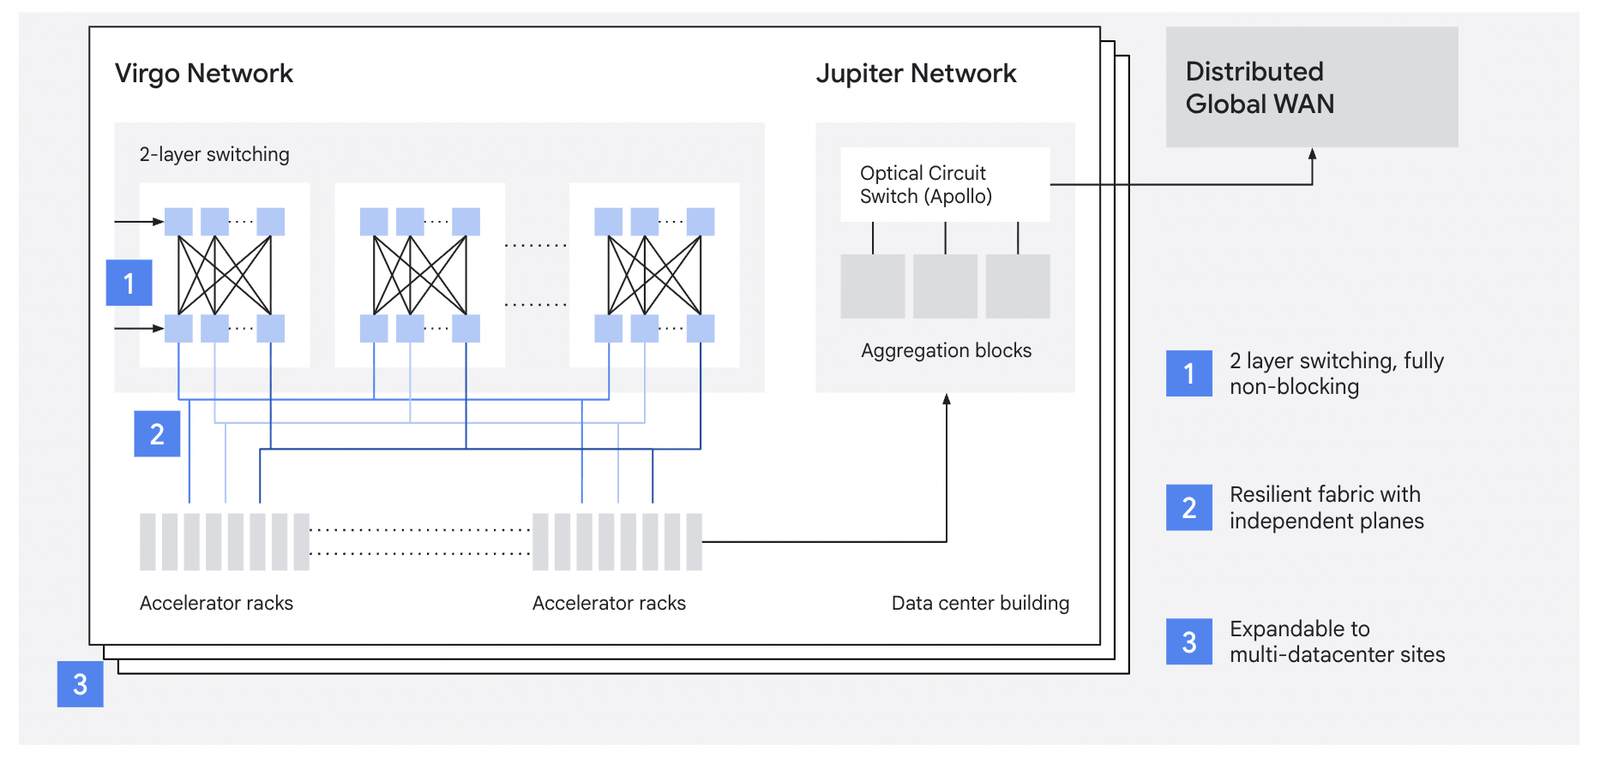
W przypadku przebiegów szkoleniowych, które przekraczają moc i przestrzeń pojedynczego centrum danych, Jupiter umożliwia skalowanie w wielu lokalizacjach. Połączenie jest warstwowe: ICI w obrębie poda, Virgo między podami w obrębie lokalizacji, Jupiter między lokalizacjami. Pakiet oprogramowania Pathways firmy Google może obsługiwać obciążenia w tych domenach obejmujących wiele centrów danych jako pojedynczy klaster logiczny.
Z wydajnością ~1.7 ZFLOPS, pojedyncza struktura Virgo jest największym ogłoszonym klastrem szkoleniowym AI. Wiele struktur Virgo połączonych przez Jupiter może obsłużyć ponad milion układów TPU, co jest skalą docelową Google, nawet jeśli obecne wdrożenia jeszcze jej nie osiągnęły.
Dobra wydajność i wykorzystanie
Surowe FLOP-y mają mniejsze znaczenie niż ułamek tych FLOP-ów, które generują użyteczną pracę. Google podaje cel 97% dobrej przepustowości dla superpodów 8t, co oznacza, że 97% czasu zegara ściennego jest przeznaczane na wydajne obliczenia, a nie na odzyskiwanie danych, przestoje czy narzut koordynacyjny. Ta wartość zależy od odporności na błędy opartej na OCS i telemetrii submilisekundowej, o których mowa powyżej.
Wykorzystanie FLOP-ów (MFU) to druga zmienna. MFU mierzy, jaki ułamek szczytowych teoretycznych FLOP-ów układ faktycznie obsługuje przy rzeczywistym obciążeniu. SemiAnalysis szacuje, że przy 40% MFU TPU, koszt efektywnego treningu FLOP spada o około 62% w porównaniu z GB300 NVL72, z progiem rentowności na poziomie około 15% MFU TPU. Publicznie ujawnione przez Anthropic dane ekonomiczne dotyczące TPU sugerują, że układy te działają znacznie powyżej tego progu rentowności. Połączenie wysokiej wydajności (utrzymującej sprawność układów) i konkurencyjnego MFU (zajmującej pracę układów podczas pracy) sprawia, że TCO TPU jest efektywne w dużej skali.
Gdzie siedzi 8
Porównywanie TPU 8 z obecnymi i przyszłymi platformami firmy NVIDIA wymaga szczególnej uwagi. NVIDIA podaje przepustowość NVLink jako sumę dwukierunkową; B200 z prędkością 1.8 TB/s, NVLink 5 ma 900 GB/s w każdym kierunku. Podane przez NVIDIĘ wartości FLOP-ów (FLOPS) zazwyczaj wynoszą 2:4 dla architektury rozproszonej; gęstość (DIP) to połowa tej wartości. Dane Google dotyczące TPU są gęste i dwukierunkowe. Czytając jakiekolwiek porównanie, sprawdź, czy przepustowość jest jednokierunkowa, czy dwukierunkowa, oraz czy wartości FLOP-ów (FLOPS) są gęste, czy rozproszone.
Procesor FP4 na chipie, 8 t o gęstości 12.6 PFLOPS, plasuje się pomiędzy GB200 o gęstości 10 PFLOPS (gęstość 5 PFLOPS) a GB300 o gęstości 20 PFLOPS (gęstość 15 PFLOPS). Porównanie na chipie jest bliskie. Porównanie w skali nie jest bliskie. Szafa GB300 NVL72 mieści 72 procesory graficzne w jednej domenie NVLink. Superpod 8 t składa się z 9,600 chipów w jednym torusie 3D. To 133 razy więcej chipów w jednej domenie zbiorczej, co stanowi lukę oddzielającą platformy do szkolenia pionierów.
NVIDIA nie stoi w miejscu. Vera Rubin trafi na rynek w drugiej połowie 2026 roku z 50 PFLOPS-ami inferencji NVFP4 na pakiet (choć SemiAnalysis kwestionuje, czy ta wartość zakłada kompresję adaptacyjną), 288 GB pamięci HBM4 przy 22 TB/s oraz NVLink 6 o dwukierunkowej przepustowości 3.6 TB/s. Rubin Ultra w drugiej połowie 2027 roku będzie oferował cztery matryce siatki, co daje do 100 PFLOPS-ów FP4 i 1 TB pamięci HBM4e na pakiet. Kyber NVL576 połączy 576 procesorów graficznych Rubin Ultra w jednym racku z 15 EFLOPS-ami inferencji FP4. To zaczyna zmniejszać przewagę Google w zakresie skalowalności, choć 576 procesorów graficznych to wciąż o rząd wielkości mniej niż 8-tonowy superpod.
Gdzie 8 prowadzi: skalowalny rozmiar domeny (9,600 układów scalonych w porównaniu do 72 procesorów GPU, czyli 576 po wprowadzeniu Kyber), skalowalność pojedynczej struktury (ponad 134 000 układów scalonych przy 47 Pb/s), deterministyczne opóźnienie wynikające ze statycznego harmonogramowania XLA oraz całkowity koszt posiadania (TCO) dla obciążeń pasujących do modelu TPU.
Gdzie 8 jest na przegranej pozycji: pojemność pamięci HBM na chip (216 GB w porównaniu z 288 GB w pamięci HBM4 w Rubinie), rzadkość (NVIDIA ma ścieżkę sprzętową 2:4, Google nie) i szerokość ekosystemu (CUDA, cuDNN, TensorRT-LLM i stos obsługujący PyTorch jako pierwszy trafiają na platformę NVIDIA; natywny PyTorch na TPU jest wciąż w fazie przedpremierowej).
Obie platformy cieszą się dużym popytem. Meta podobno prowadzi rozmowy o wielomiliardowej umowie na wdrożenie procesorów TPU Google w swoich centrach danych począwszy od 2027 roku, z potencjalnym wynajmem procesorów TPU w chmurze już w 2026 roku. Jednocześnie Google Cloud ogłosiło instancje A5X zbudowane na platformie NVIDIA Vera Rubin NVL72, skalowalne do 80 000 procesorów GPU Rubin w jednej lokalizacji i 960 000 procesorów GPU w przypadku wdrożeń w wielu lokalizacjach. Google rozwija obie platformy na dużą skalę.
Zamotać
Ósma generacja TPU składa się z dwóch chipów, a nie jednego, i została zaprojektowana z myślą o obecnych potrzebach związanych z trenowaniem na dużą skalę i wnioskowaniem agentowym, a nie z myślą o obciążeniach AI ogólnego przeznaczenia. 8t zwiększa skalowalność do 9,600 chipów na superpod i skalowalność do ponad 134 000 chipów na strukturę Virgo. 8i zamienia rdzenie SparseCores na krzem z funkcją kolektywnej akceleracji i zamienia torus 3D na Boardfly, aby spełnić cele dotyczące opóźnień wymagane przez MoE obsługujące skalowalność. Plan rozwoju firmy NVIDIA, z Vera Rubin, Rubin Ultra i Kyber, zniweluje niektóre z tych luk w latach 2026-2027, ale przewaga w dziedzinie skalowalności utrzymuje się na razie. Dla laboratoriów pionierskich, które wykorzystują modele oparte na mieszanym doświadczeniu ekspertów na setkach tysięcy chipów, 8 jest wiarygodną alternatywą dla Grace Blackwell, a dyskusje w Meta sugerują, że rynek zaczyna to uwzględniać w swoich wycenach.


 Amazon