

Firma IBM wprowadziła IBM Spyre Accelerator, silnik wnioskowania o niskim opóźnieniu, przeznaczony do generatywnej i agentowej sztucznej inteligencji, gdzie responsywność, bezpieczeństwo i dostępność są priorytetem. Spyre został zaprojektowany dla przedsiębiorstw, które chcą zintegrować sztuczną inteligencję z istniejącymi systemami danych, umożliwiając tym samym zachowanie wrażliwych danych na platformie bez obniżania wydajności.
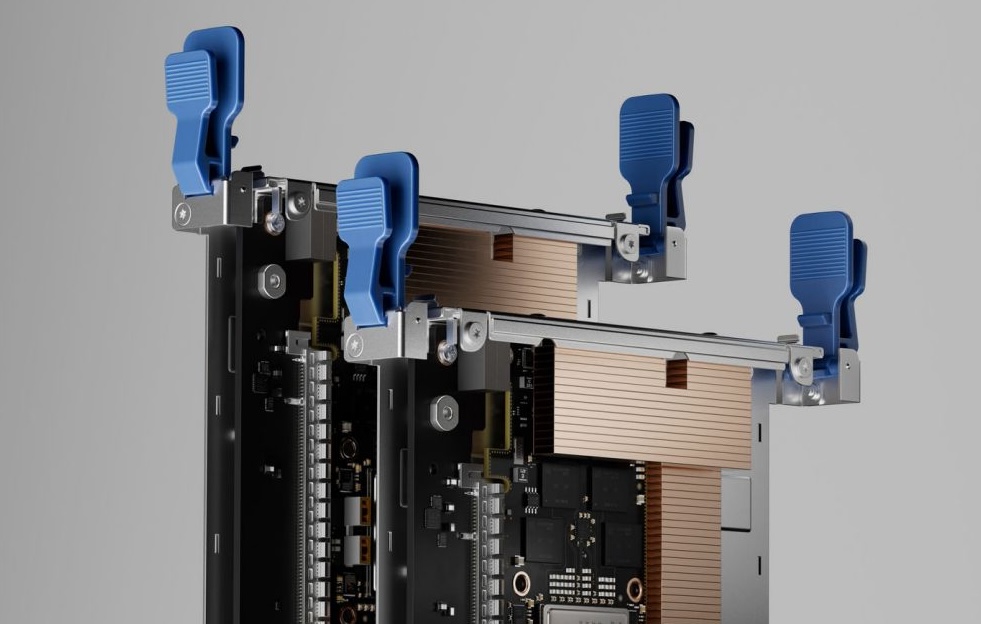
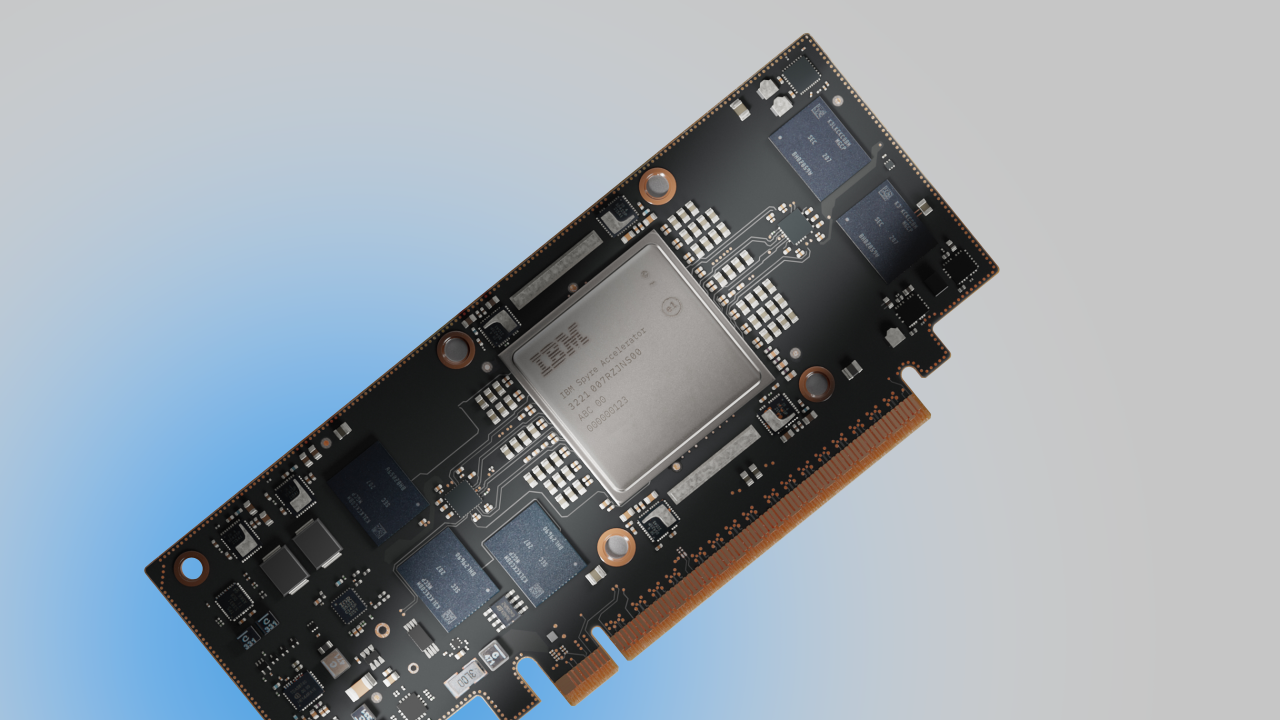
Ogólna dostępność rozpocznie się 28 października dla systemów IBM z17 i LinuxONE 5, a Power11 na początku grudnia. Akcelerator to 5-nm, 32-rdzeniowy układ SoC umieszczony na karcie PCIe o mocy 75 W. IBM obsługuje klastry do 48 kart na system IBM Z lub LinuxONE oraz do 16 kart na system IBM Power, co umożliwia skalowanie w poziomie w celu wnioskowania wielomodelowego w połączeniu z obciążeniami transakcyjnymi, takimi jak wykrywanie oszustw, automatyzacja sprzedaży detalicznej i ocena ryzyka. Spyre to produktyzacja badań IBM AI Hardware Center, dostosowana do wdrożeń lokalnych, gdzie lokalizacja danych, bezpieczeństwo i energooszczędność są podstawowymi wymaganiami.
Od potoków logicznych do sztucznej inteligencji agentowej
Przepływy pracy w przedsiębiorstwach odchodzą od deterministycznych łańcuchów logicznych w kierunku sztucznej inteligencji (AI), która postrzega kontekst, planuje i działa w czasie rzeczywistym. Te systemy agentowe wymagają wnioskowania o niskich opóźnieniach i przewidywalnej jakości usług, nawet gdy systemy centralne obsługują dużą liczbę transakcji. Podejście IBM polega na umieszczaniu dedykowanego sprzętu do wnioskowania bezpośrednio na platformach, na których znajdują się już krytyczne dane. Przechowywanie danych na platformach IBM Z, LinuxONE i Power zmniejsza ryzyko i obciążenie związane z przestrzeganiem przepisów, unikając zbędnego transferu danych i przetwarzania zewnętrznego. Uruchamianie wnioskowania generatywnego i agentowego blisko danych minimalizuje również zmienność wywołaną przez sieć i sieć, co często jest przyczyną pojawiania się opóźnień końcowych. Nadrzędnym celem jest dodanie podejmowania decyzji przez AI do istniejących przepływów OLTP, wsadowych i komunikatów bez obniżania przepustowości, okien zmian ani poziomu usług.
Architektura Spyre
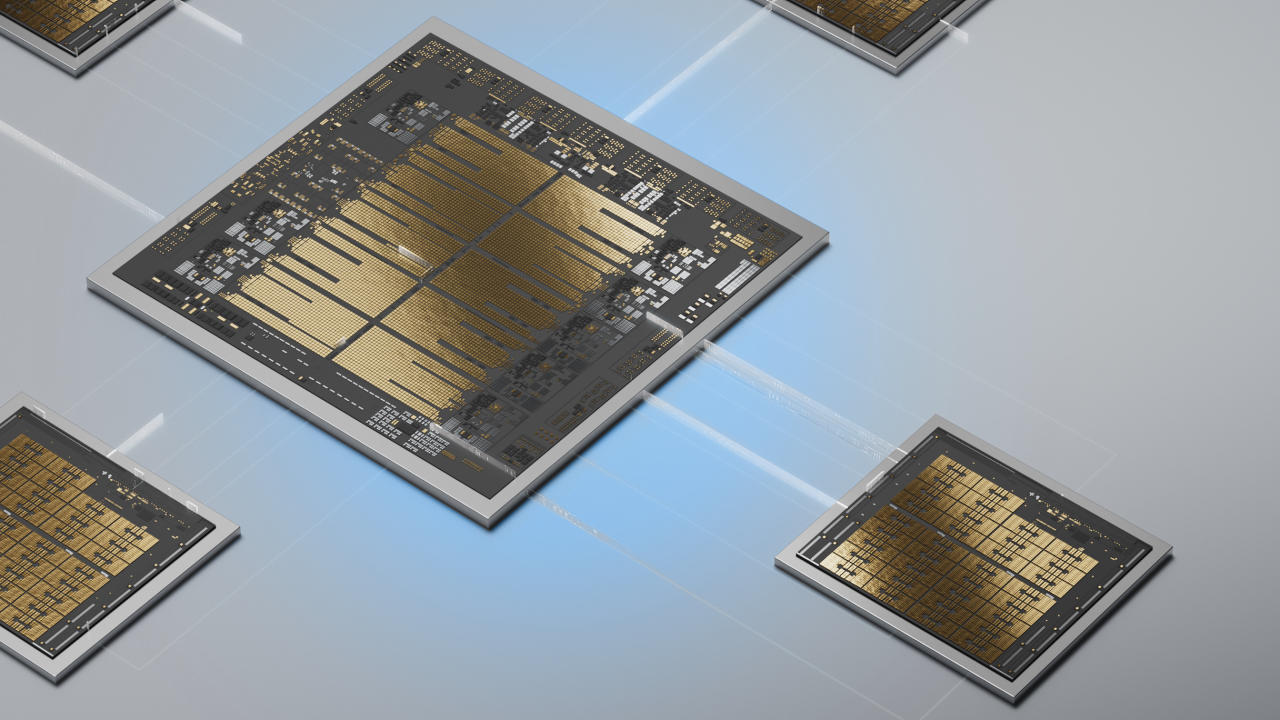
Spyre to komercyjny system typu system-on-a-chip (SoC) opracowany na podstawie prototypów stworzonych przez IBM Research. Zbudowany w procesie technologicznym 5 nm z 25.6 miliarda tranzystorów i 32 rdzeniami akceleratora, jest zoptymalizowany pod kątem współbieżnego wnioskowania z niskim opóźnieniem, a nie trenowania modelu. Urządzenie jest dostarczane jako karta rozszerzeń PCIe o mocy 75 W, co zapewnia zespołom ds. infrastruktury znany model wdrażania i obsługi.
IBM zaprojektowało konfiguracje skalowalne, które umożliwiają obsługę do 48 kart w systemie IBM Z lub LinuxONE 5 oraz do 16 kart w systemie IBM Power11, umożliwiając obsługę wielu modeli i izolację najemców w ramach jednej platformy. Od strony oprogramowania, Spyre integruje się ze stosem IBM Enterprise w zakresie obsługi modeli, bezpieczeństwa i obserwowalności, a Power dodaje katalog obsługiwany jednym kliknięciem, co przyspiesza wdrażanie usług. To połączenie ma na celu przyspieszenie czasu potrzebnego na uzyskanie wartości przy jednoczesnym utrzymaniu usług AI w ramach istniejących granic operacyjnych i zgodności.
Integracja platformy
IBM Z i LinuxONE: kolokacja z Telum II
Na platformach z17 i LinuxONE 5, Spyre działa równolegle z kompleksem procesorów Telum II, aby zapewnić współistnienie wnioskowania z danymi transakcyjnymi i strumieniami zdarzeń. Takie rozwiązanie zachowuje istniejące domeny bezpieczeństwa i ścieżki audytu, które są niezbędne w środowiskach regulowanych. Dzięki lokalnemu uruchamianiu wnioskowania organizacje minimalizują konieczność korzystania z zewnętrznych akceleratorów i zapobiegają dodatkowym opóźnieniom wpływającym na umowy SLA dotyczące transakcji. System może skalować się do 48 kart, obsługując jednocześnie wiele modeli i obciążeń. Zapewnia logiczną izolację, dostosowaną do potrzeb różnych jednostek biznesowych lub wymogów regulacyjnych. Jest to szczególnie istotne w przypadku przepływów płatności, zapobiegania oszustwom, obsługi roszczeń i zdarzeń w łańcuchu dostaw, gdzie liczy się każda milisekunda, a rozszerzanie zakresu zgodności nie jest pożądane.
IBM Power11: Usługi AI oparte na katalogu i synergia MMA
Na serwerach Power11, Spyre integruje się z katalogiem usług AI, zaprojektowanym z myślą o szybkiej adopcji w ugruntowanych środowiskach Power. Administratorzy mogą wdrażać usługi jednym kliknięciem, dostosowując się do tradycyjnego sposobu, w jaki klienci Power wdrażają oprogramowanie pośredniczące, analitykę i aplikacje biznesowe. Połączenie Spyre z wbudowanym akceleratorem MMA Power poprawia przepustowość konwersji danych i wstępnego przetwarzania, które są kluczowymi etapami dla generatywnych potoków AI i integracji złożonych procesów.
IBM podaje przykład przepustowości, gdzie przy rozmiarze zgłoszenia 128, system może przetworzyć ponad osiem milionów dokumentów w celu integracji z bazą wiedzy w ciągu około godziny. W przypadku przedsiębiorstw opracowujących systemy RAG lub prowadzących wyszukiwanie na dużą skalę, nacisk kładziony jest na przyspieszenie przygotowywania i pobierania danych, a nie tylko na etap wnioskowania. Ogólne dopasowanie jest ukierunkowane na zróżnicowane sektory, takie jak produkcja, handel detaliczny, opieka zdrowotna i wdrożenia intensywnie wykorzystujące systemy ERP, gdzie przewidywalna przepustowość i łatwość serwisowania są kluczowe.
Od IBM AI Hardware Center do wdrożeń terenowych
Spyre pokazuje, jak IBM przekształca badania w praktyczne produkty. Technologia ta powstała jako prototyp opracowany przez IBM Research, a następnie rozwijała się poprzez iteracyjne wdrożenia klastrowe w kampusie Yorktown Heights oraz współpracę z Centrum Nowych Systemów Sztucznej Inteligencji Uniwersytetu w Albany. Następnie IBM Infrastructure wprowadziło projekt na rynek dla platform IBM Z, LinuxONE i Power, dostosowując krzem do wymagań przedsiębiorstw, takich jak bezpieczeństwo, niezawodność, zarządzanie cyklem życia i łatwość serwisowania. Kierownictwo IBM charakteryzuje Spyre jako infrastrukturę dla wielomodelowej sztucznej inteligencji, kładąc nacisk na bezpieczne i odporne skalowanie obciążeń generatywnych i agentowych na platformach, którym już zaufano w zakresie podstawowych danych i transakcji.
Wartość Spyre jest nierozerwalnie związana z postawą operacyjną IBM. Dzięki wnioskowaniu w miejscu tworzenia i zarządzania danymi, organizacje ograniczają ich wypływ i zmniejszają złożoność procedur zgodności. IBM Z i LinuxONE oferują funkcje kryptografii, izolacji, rejestrowania i audytu, które są już integralną częścią ram regulacyjnych wielu klientów. Power oferuje solidny pakiet zabezpieczeń i zarządzania, dostosowany do mieszanych środowisk analitycznych i transakcyjnych. Obsługa klastrowania, partycjonowanie logiczne i narzędzia do obserwowania własnych systemów (first party observation tools) są zgodne z normami operacyjnymi komputerów mainframe i Power, umożliwiając wdrażanie, monitorowanie i obsługę usług AI na równi z każdym innym obciążeniem pierwszego poziomu. Dla wielu klientów z branży finansowej, opieki zdrowotnej i sektora publicznego te gwarancje operacyjne mają pierwszeństwo przed surowymi testami TOPS lub syntetycznymi benchmarkami.
Zagadnienia dotyczące wydajności i skalowalności
Chociaż IBM nie opublikował szczegółowych informacji o wydajności dla każdego modelu, wskaźniki architektoniczne są oczywiste. Spyre koncentruje się na ścieżkach wnioskowania o niskim opóźnieniu, zoptymalizowanych pod kątem pętli agentowych i potoków sterowanych zdarzeniami, gdzie współbieżność i kontrola opóźnień końcowych są ważniejsze niż sama przepustowość szczytowa. Skalowalność pozioma za pomocą klastrów kart PCIe umożliwia zespołom skalowanie wdrożeń pod kątem obsługi wielu modeli, izolacji dzierżawców i przyszłego rozwoju bez konieczności przeprojektowywania platformy.
W systemie Power połączenie MMA-Spyre przyspiesza przygotowywanie i konwersję danych, co często decyduje o czasie realizacji całego procesu w przypadku RAG i wyszukiwania korporacyjnego. Przedsiębiorstwa powinny tworzyć dowody słuszności koncepcji, aby odzwierciedlały warunki produkcyjne: rozmiary modeli i okna tokenów, współbieżność żądań, interakcję z obciążeniami transakcyjnymi oraz telemetrię pod kątem opóźnień w przypadku rywalizacji.
Barry Baker, dyrektor operacyjny IBM Infrastructure i dyrektor generalny IBM Systems, podkreślił nacisk firmy na rozwój infrastruktury dla nowych obciążeń AI. Podkreślił rolę Spyre Accelerator w ulepszaniu systemów pod kątem obsługi wielomodelowej AI, w tym AI generatywnej i agentowej. Dodał, że ta innowacja ma na celu umożliwienie klientom bezpiecznego, odpornego i wydajnego skalowania krytycznych obciążeń AI, przy jednoczesnej maksymalizacji wartości danych korporacyjnych.
Mukesh Khare, dyrektor generalny IBM Semiconductors, zauważa, że IBM uruchomiło swoje Centrum Sprzętu AI w 2019 roku, aby sprostać rosnącym wymaganiom obliczeniowym sztucznej inteligencji, jeszcze przed niedawnym boomem na tę dziedzinę. Świętuje komercjalizację pierwszego układu scalonego w centrum, zaprojektowanego w celu zwiększenia wydajności komputerów mainframe i serwerów IBM.
Przypadków użycia
Zespoły usług finansowych mogą wykorzystywać Spyre do wykrywania oszustw w czasie rzeczywistym, który działa bezpośrednio na zestawach danych na platformie, umożliwiając odświeżanie modeli i aktualizację zasad bez rozszerzania zakresu audytu. W handlu detalicznym i logistyce asystenci agentów mogą koordynować decyzje dotyczące zapasów i realizacji zamówień, zapewniając spójny czas reakcji, dzięki wnioskowaniu lokalnemu dla systemów operacyjnych. Organizacje z sektora opieki zdrowotnej i administracji publicznej mogą wdrażać podsumowania generatywne i wspomaganie decyzji w ramach ścisłych ograniczeń dotyczących prywatności i miejsca zamieszkania, unikając przenoszenia danych, które w przeciwnym razie wiązałoby się z dodatkowymi pracami związanymi z zapewnieniem zgodności. W środowiskach przemysłowych i intensywnie korzystających z systemów ERP, Spyre może wspierać automatyzację procesów i wykrywanie anomalii w pobliżu systemów SAP, Oracle i telemetrii zakładowej działających na platformie Power, zapewniając deterministyczne działanie i łatwość konserwacji.
Kierownictwo IBM Infrastructure przedstawia Spyre jako fundamentalną infrastrukturę dla transformacji w dziedzinie sztucznej inteligencji (AI), zaprojektowaną do obsługi wielomodelowych obciążeń generatywnych i agentowych w skali korporacyjnej, z silnymi gwarancjami bezpieczeństwa i odporności. Kierownictwo IBM Semiconductors opisuje Spyre jako pierwszy kamień milowy komercjalizacji AI Hardware Center, przewidując dalszy rozwój innowacji sprzętowych dla klientów IBM w segmencie komputerów mainframe i serwerów.
Podsumowanie
Spyre to lokalne rozwiązanie IBM do wnioskowania z niskim opóźnieniem w środowiskach, które nie mogą narażać bezpieczeństwa, niezawodności ani lokalizacji danych na szwank. Skala sprzętowa, natywna integracja platformy i model operacyjny są zgodne z systemami IBM Z, LinuxONE i Power, które poszukują agentowej sztucznej inteligencji w tym samym promieniu zasięgu, co transakcje bazowe. Kolejnym krokiem dla nabywców są dowody: dowody słuszności koncepcji, które potwierdzają zalety w zakresie opóźnień, współbieżności i zarządzania w rzeczywistych obciążeniach. Jeśli wydajność w terenie odpowiada wymaganiom, Spyre oferuje pragmatyczną ścieżkę do osadzenia generatywnej i agentowej sztucznej inteligencji bezpośrednio w systemach o znaczeniu krytycznym.
Dostępność:
Spyre będzie ogólnie dostępny dla systemów IBM z17 i LinuxONE 5 od 28 października. Systemy IBM Power11 otrzymają Spyre na początku grudnia. Ta stopniowa aktualizacja zapewnia klientom komputerów mainframe i LinuxONE najwcześniejszą ścieżkę dostępu do inferencji na platformie, a systemy Power pojawią się wkrótce potem.


 Amazon