

Microsoft wprowadził Maia 200, nowy, niestandardowy akcelerator inferencji zaprojektowany w celu poprawy ekonomiki generowania tokenów AI na dużą skalę. Jest to pierwsza platforma krzemowa i systemowa firmy zoptymalizowana specjalnie pod kątem inferencji AI.
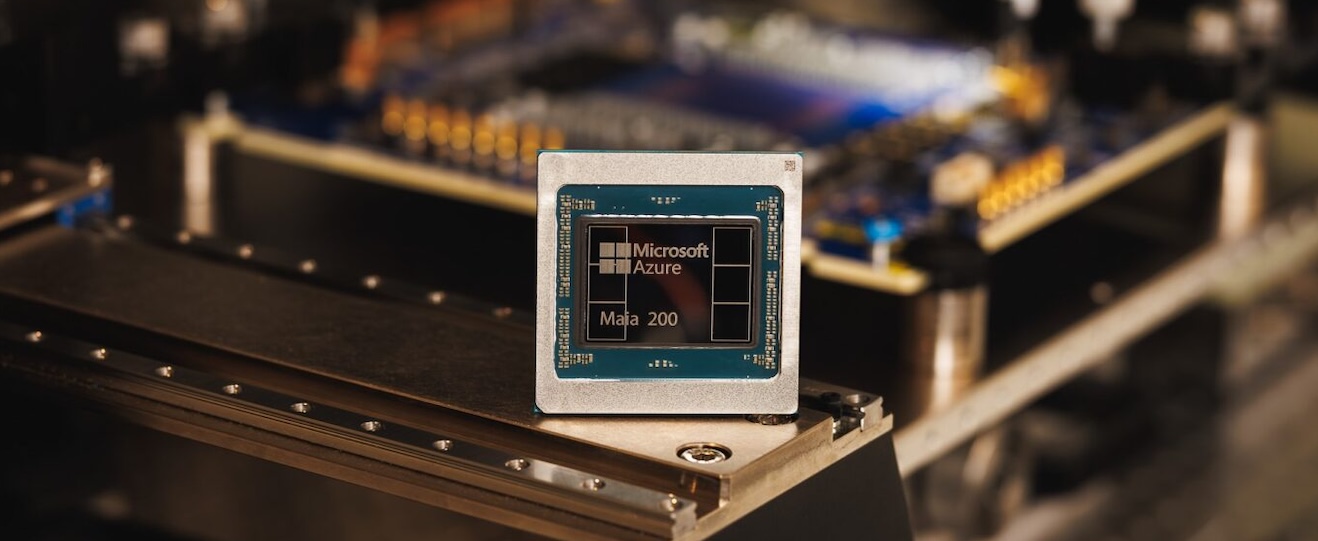
Microsoft wyznacza ramy wnioskowania AI wokół „granicy efektywności”, która równoważy możliwości i dokładność z kosztami, opóźnieniami i zużyciem energii. W praktyce ta granica wygląda inaczej w zależności od obciążenia: interaktywni piloci priorytetowo traktują niskie opóźnienia, podsumowania wsadowe i wyszukiwanie kładą nacisk na przepustowość w przeliczeniu na dolara, a zaawansowane wnioskowanie zapewnia stałą wydajność w przypadku długich okien kontekstowych i wykonywania zadań w wielu krokach. Przesłanie Microsoftu jest takie, że infrastruktura nie może być już uniwersalna i że Azure potrzebuje portfolio opcji obsługi dostosowanych do różnych profili wnioskowania.
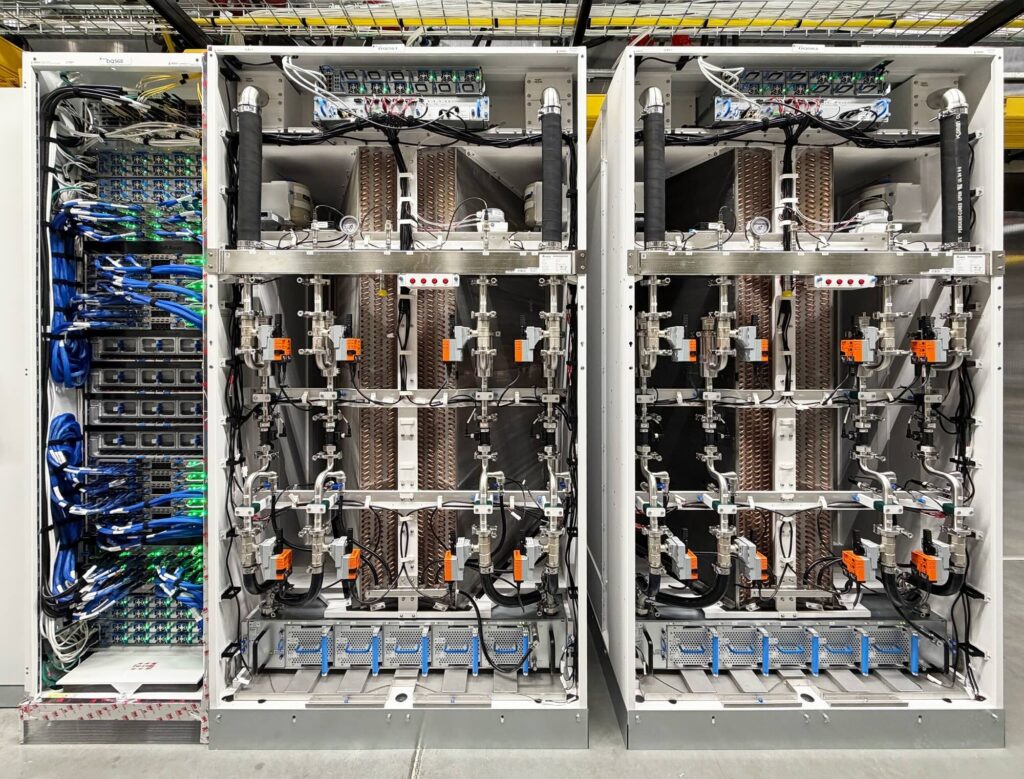
Microsoft Maia Rack
Microsoft twierdzi, że Maia odzwierciedla kompleksowe podejście obejmujące oprogramowanie, układy scalone, systemy i centra danych, i zapewnia 30% poprawę wydajności w przeliczeniu na dolara w porównaniu ze sprzętem najnowszej generacji, który jest obecnie wdrażany w jego flocie. Firma pozycjonuje tę zintegrowaną konstrukcję jako fundamentalną zaletę w miarę jak aplikacje agentowe stają się coraz bardziej złożone i coraz szerzej stosowane.
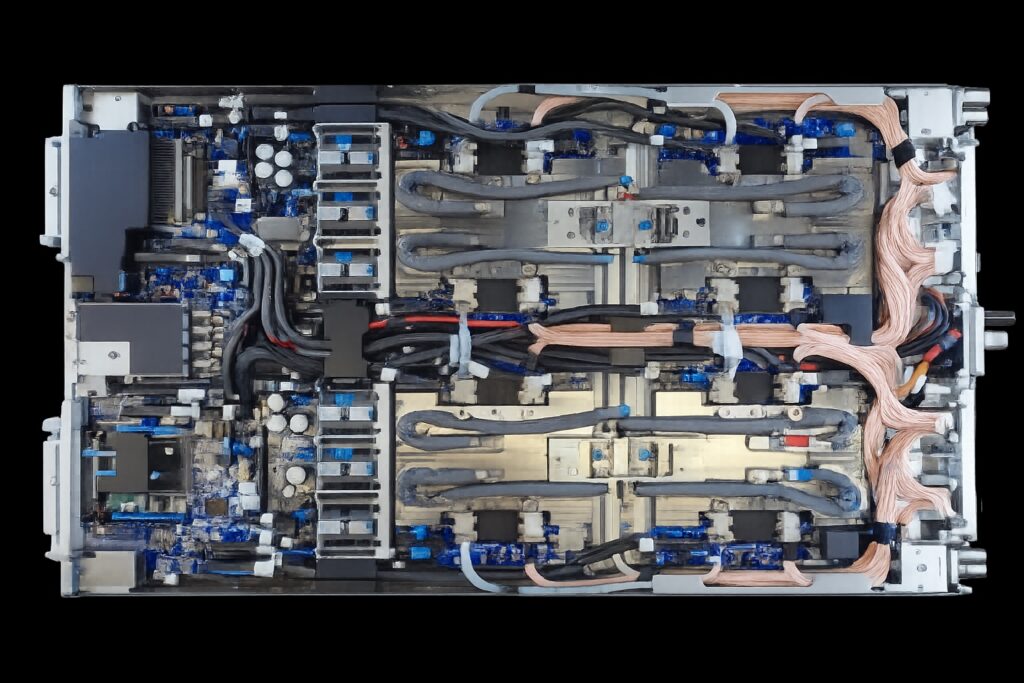
Serwer typu blade Microsoft Maia 200
Maia 200: Najważniejsze założenia architektoniczne i szczytowe specyfikacje
Maia została zbudowana na bazie precyzyjnego wykonywania operacji, hierarchii pamięci zaprojektowanej w celu ograniczenia ruchu poza układem oraz konstrukcji opartej na skalowalności Ethernetu, która ma na celu zachowanie efektywności wnioskowania wieloakceleratorowego.
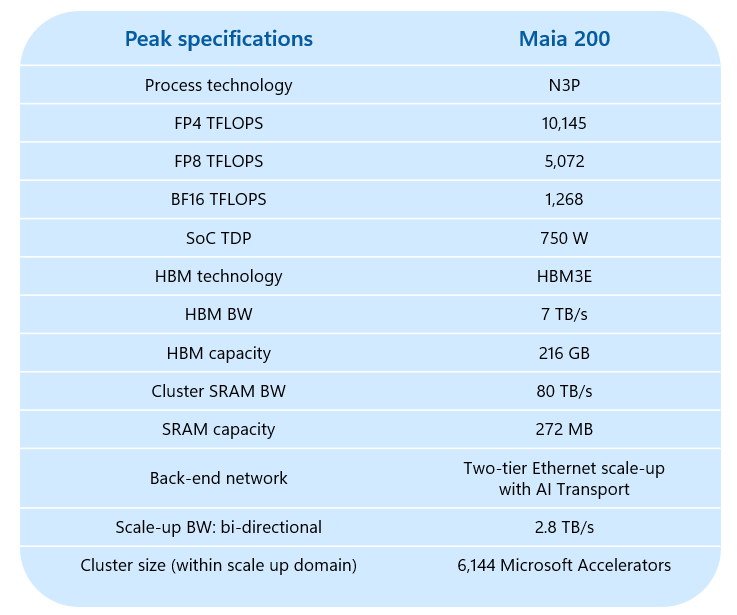
Microsoft podkreśla kilka specyfikacji szczytowych i punktów projektowych. Maia wykorzystuje zoptymalizowane ścieżki danych o wąskiej precyzji w procesie N3 firmy TSMC i ma szczytową wydajność 10.1 PetaOPS w FP4. Microsoft skłania się ku FP4 jako ekonomicznemu formatowi wnioskowania, dążąc do wyższych tokenów w przeliczeniu na dolara i wat.
Pamięć jest ważnym tematem. Maia łączy 272 MB wbudowanej pamięci SRAM z 216 GB pamięci HBM3e, a Microsoft deklaruje przepustowość pamięci HBM na poziomie 7 TB/s. Celem jest utrzymanie lokalnych, krytycznych zestawów roboczych, zmniejszenie zapotrzebowania na przepustowość pamięci HBM poprzez lepszą lokalizację oraz poprawa efektywności energetycznej poprzez minimalizację ruchu poza układem.
W zakresie przesyłania danych, Maia łączy wielopoziomowy podsystem DMA z hierarchiczną siecią na chipie, aby zapewnić przewidywalną wydajność dla heterogenicznych obciążeń o ograniczonej pamięci. Microsoft kładzie nacisk na wzajemne powiązanie przesyłania danych i obliczeń, a także na strukturalne wsparcie dla układów przyjaznych tensorom.
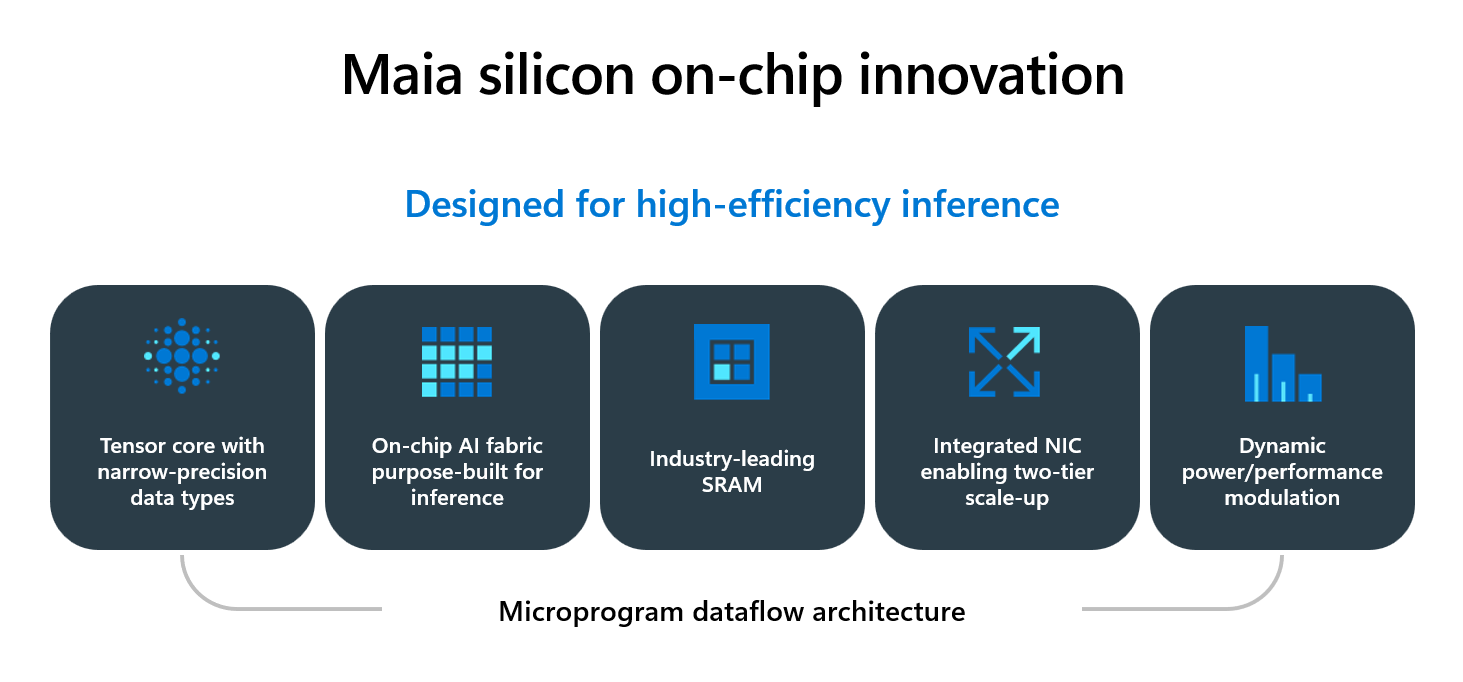
W celu zwiększenia skalowalności, Maia integruje wbudowaną kartę sieciową i połączenie Ethernet o przepustowości dwukierunkowej 2.8 TB/s. Microsoft twierdzi, że projekt obsługuje dwupoziomową domenę skalowania z maksymalnie 6,144 akceleratorami, ukierunkowaną na komunikację o dużej przepustowości i niskim opóźnieniu dla dużych klastrów wnioskowania.
Mikroarchitektura oparta na kafelkach i klastrach
Projekt obliczeniowy Maia jest zorganizowany hierarchicznie. Najmniejszą jednostką jest kafelek, który łączy jednostkę tensorową kafelków (TTU) do operacji macierzowych i splotów z procesorem wektorowym kafelków (TVP), pozycjonowanym jako programowalny silnik SIMD. Każdy kafelek jest zasilany przez wielobankową pamięć SRAM kafelków (TSRAM) i wykorzystuje silnik DMA na poziomie kafelka do przesyłania danych bez zatrzymywania potoku obliczeniowego. Lekki procesor sterujący koordynuje wydawanie zadań, a semafory sprzętowe zapewniają ścisłą synchronizację między ruchem a obliczeniami.
Kafelki grupują się w klastry, które dodają współdzieloną lokalizację poprzez pamięć SRAM klastra (CSRAM) i wprowadzają drugą warstwę DMA do przesyłania danych między CSRAM a współpakietowaną pamięcią HBM. Microsoft zauważa również redundancję kafelków i pamięci SRAM, co poprawia wydajność i możliwości produkcyjne, zachowując jednocześnie spójność modelu programowania.
Wąskie skupienie na precyzji: FP4 i precyzja mieszana
Microsoft stawia przede wszystkim na wąską precyzję jako dźwignię wydajności wnioskowania, powołując się na wyniki branżowe, zgodnie z którymi FP4 może zachować dokładność wnioskowania, jednocześnie obniżając koszty obliczeniowe i pamięci. Procesor TTU firmy Maia jest zoptymalizowany pod kątem FP8, FP6 i FP4 i obsługuje tryby mieszanej precyzji, takie jak aktywacje FP8 pomnożone przez wagi FP4. TVP obsługuje FP8 wraz z BF16, FP16 i FP32 dla operatorów, którym zależy na wyższej precyzji. Zintegrowany reshaper konwertuje formaty o niskiej precyzji z prędkością łącza, aby uniknąć wąskich gardeł podczas obliczeń.
Microsoft twierdzi, że przepustowość FP4 w systemie Maia jest dwukrotnie większa niż w systemie FP8 i ośmiokrotnie większa niż w systemie BF16, co pozycjonuje architekturę pod kątem większej liczby tokenów na sekundę i lepszej wydajności na wat w przypadku wdrożeń intensywnie wykorzystujących wnioskowanie.
Podsystem pamięci dostrojony do lokalności i determinizmu
Pamięć SRAM w Maia jest podzielona na pule na poziomie klastra i kafelków, a obie warstwy są w pełni zarządzane programowo. Microsoft pozycjonuje to jako deterministyczną kontrolę nad rozmieszczeniem i lokalizacją, bezpośrednio przez programistów lub poprzez decyzje kompilatora i środowiska wykonawczego.
Firma opisuje kilka zamierzonych wzorców: jądra GEMM mogą zachowywać pośrednie fragmenty w pamięci TSRAM, aby uniknąć przesyłania danych do HBM; jądra uwagi mogą lokalnie przypinać tensory kluczowe i produkty cząstkowe, aby zmniejszyć obciążenie związane z ruchem; a komunikacja zbiorowa może buforować ładunki w pamięci CSRAM, podczas gdy akumulacja przebiega w pamięci TSRAM, aby uniknąć obciążenia pamięci HBM podczas operacji wielowęzłowych. Microsoft podkreśla również, że pamięć CSRAM jest buforem przejściowym dla potoków międzyjądrowych, mającym na celu redukcję przestojów w gęstych łańcuchach operatorów i połączonych obciążeniach.
Przenoszenie danych: niestandardowa infrastruktura NoC i wielowarstwowy DMA
Microsoft uważa, że wydajność wnioskowania jest często ograniczona przez ruch danych, a nie przez szczytową przepustowość matematyczną, dlatego Maia inwestuje w przewidywalne transfery i sygnalizację sterującą o niskim opóźnieniu. Połączenie na chipie jest opisywane jako siatka obejmująca klastry, kafelki, kontrolery pamięci i jednostki wejścia/wyjścia, z oddzielnymi płaszczyznami logicznymi dla ruchu tensorowego o dużej przepustowości i ruchu sterującego wrażliwego na opóźnienia. Ten podział ma na celu zapobieganie blokowaniu synchronizacji, przerwań i małych komunikatów podczas transferów zbiorczych.
Microsoft wymienia również hierarchiczną transmisję rozgłoszeniową, która redukuje redundantne odczyty HBM, lokalny ruch klastra, aby utrzymać ruch w klastrze, bezpośredni dostęp do pamięci SRAM w celu współdzielenia wewnątrz klastra bez konieczności korzystania z HBM, oraz mechanizmy QoS, które priorytetyzują pilny ruch sterujący i wyjściowy. Silniki DMA są warstwowe w obrębie ról kafelków, klastrów i sieci, umożliwiając jednoczesne przesyłanie danych między warstwami pamięci i łączami poza układem scalonym, bez przerywania obliczeń.
Sieci skalowalne: wbudowane karty sieciowe, Ethernet i ATL
Do wnioskowania z wykorzystaniem wielu akceleratorów Maia wykorzystuje zintegrowaną kartę sieciową i infrastrukturę skalowalną opartą na sieci Ethernet, zbudowaną w oparciu o warstwę transportową AI (ATL) firmy Microsoft. Microsoft twierdzi, że ATL działa kompleksowo w standardowej sieci Ethernet i jest przeznaczony do współpracy z popularnymi przełącznikami różnych dostawców, oferując jednocześnie funkcje transportowe, takie jak rozpylanie pakietów, routing wielościeżkowy i kontrola przepływu odporna na przeciążenia.
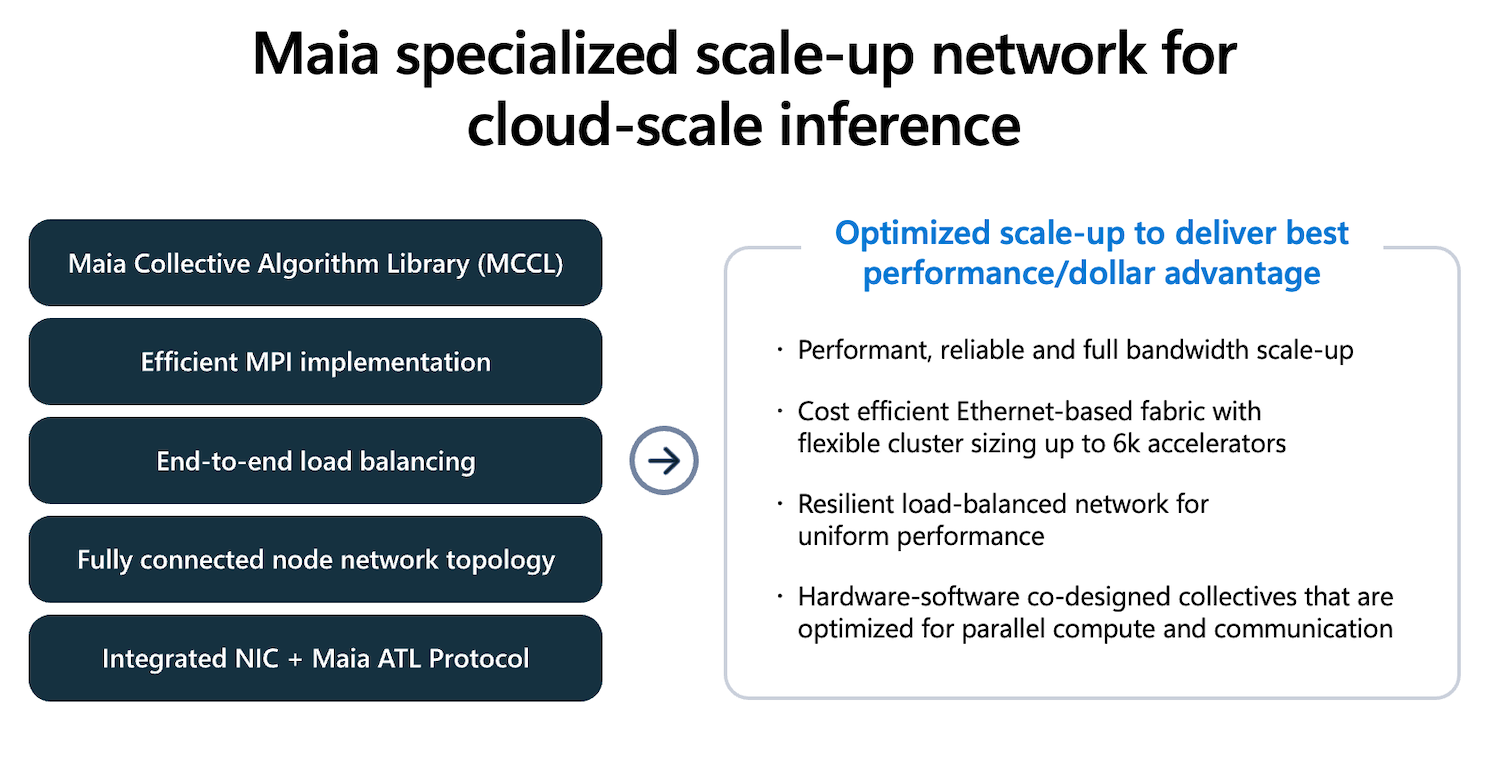
Microsoft opisuje również wybór topologii mający na celu zmniejszenie zależności od zewnętrznych przełączników w lokalnym ruchu tensorowo-równoległym. Oferowany przez firmę Fully Connected Quad (FCQ) grupuje cztery akceleratory z bezpośrednimi połączeniami, utrzymując lokalne kolektywy o wysokiej intensywności poza przełączaną strukturą. Druga warstwa skaluje się następnie poza domenę FCQ do większych klastrów, które Microsoft pozycjonuje jako „odpowiedniej wielkości” dla wzorców synchronizacji wnioskowania w porównaniu z zachowaniem typu „wszyscy ze wszystkimi” w stylu uczenia.
W obszarze oprogramowania operacji zbiorczych, Microsoft podkreśla bibliotekę Microsoft Collective Communication Library (MCCL), zaprojektowaną wspólnie ze sprzętem w celu zwiększenia efektywności skalowania. Firma wskazuje na nakładanie się obliczeń i operacji wejścia/wyjścia, hierarchiczne kolektywy, dynamiczny wybór algorytmów oraz harmonogramowanie potokowe, które pozwalają ukryć opóźnienia i zmniejszyć obciążenie sieci.
Model integracji i wdrażania platformy Azure
Microsoft reklamuje Maię jako natywny akcelerator dla platformy Azure, a nie jako samodzielny akcelerator. Został on zaprojektowany tak, aby był zgodny ze standardami Azure w zakresie szaf, zasilania i mechaniki, stosowanymi w systemach GPU innych firm, upraszczając wdrażanie i serwisowanie oraz umożliwiając korzystanie z heterogenicznych flot akceleratorów w tym samym centrum danych.
Platforma Maia została zaprojektowana zarówno do środowisk chłodzonych powietrzem, jak i cieczą, w tym z opcją sidecara drugiej generacji z chłodzeniem cieczą, przeznaczoną do szaf rack o wysokiej gęstości. Pod względem operacyjnym platforma integruje się z płaszczyzną sterowania platformy Azure, umożliwiając zarządzanie cyklem życia, monitorowanie stanu, wdrażanie oprogramowania sprzętowego i obsługę przepływów pracy floty, co ma na celu ograniczenie wpływu na usługi podczas modernizacji i konserwacji.
Microsoft twierdzi, że Maia będzie częścią heterogenicznej infrastruktury AI, obsługującej wiele modeli, w tym najnowsze modele GPT-5.2 firmy OpenAI, i będzie wykorzystywana do zasilania obciążeń AI w Microsoft Foundry i Microsoft 365 Copilot. Firma podkreśla, że obciążenia można planować, partycjonować i monitorować za pomocą tych samych narzędzi, co floty GPU platformy Azure, dążąc do przenośności i możliwości optymalizacji pod kątem wydajności w przeliczeniu na dolara, opóźnień lub pojemności bez konieczności przebudowy orkiestracji.
Łańcuch narzędzi programistycznych: Maia 200 SDK, ścieżka Triton i kontrola niskiego poziomu
Microsoft opisuje pakiet SDK Maia 200, który obsługuje znane punkty wejścia, takie jak PyTorch, oferując jednocześnie wiele poziomów kontroli. Opcje obejmują ścieżkę kompilatora Maia Triton do generowania jądra, dostrojone biblioteki jądra dla architektury kafelkowej i klastrowej oraz język NPL (Nested Parallel Language) firmy Microsoft do jawnego zarządzania przenoszeniem danych, rozmieszczeniem pamięci SRAM i wykonywaniem równoległym.
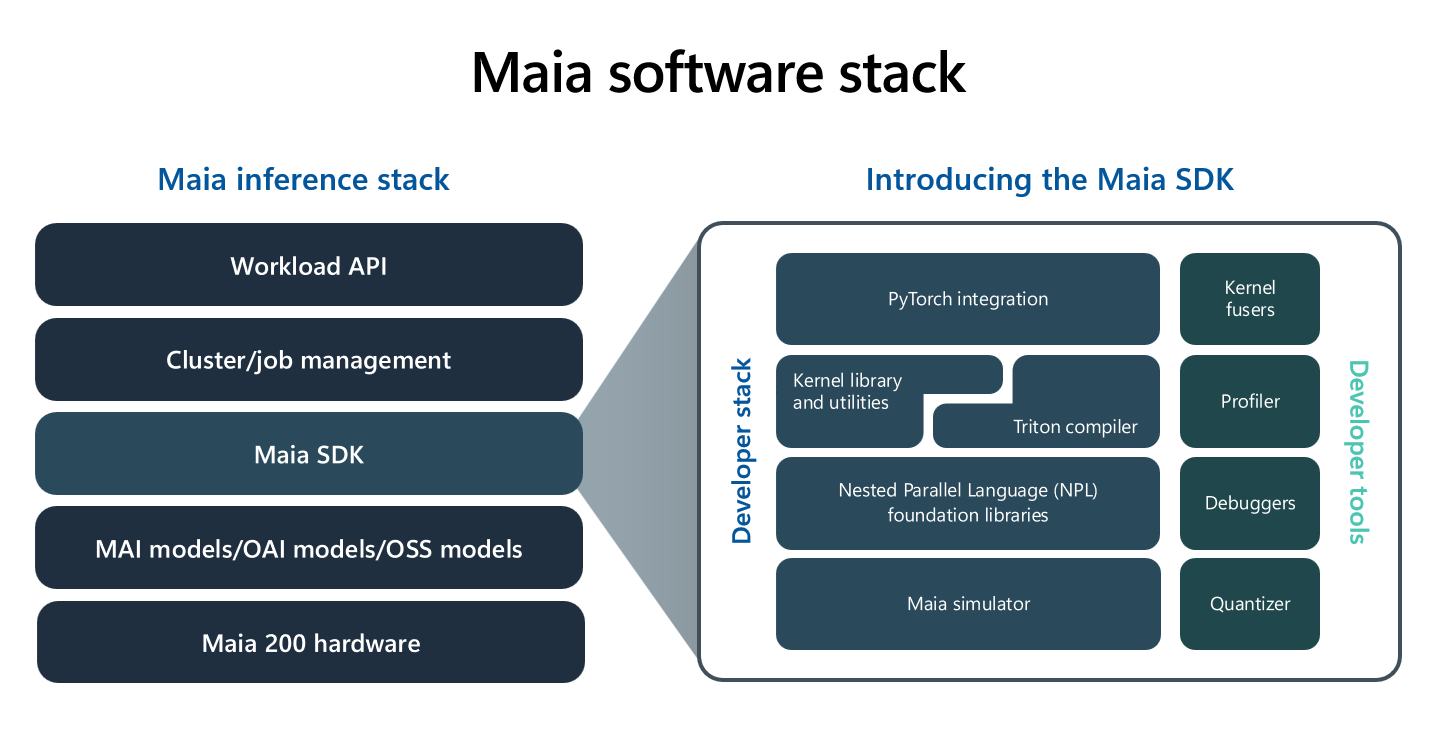
Zestaw SDK zawiera również symulator, potok kompilatora, profiler, debugger oraz narzędzia do kwantyzacji i walidacji. Microsoft pozycjonuje to jako sposób na wczesne prototypowanie i dostrajanie wydajności, diagnozowanie wąskich gardeł i zwiększanie wykorzystania całego stosu.
Dolna linia
Microsoft pozycjonuje Maia 200 jako platformę wnioskowania projektowanego specjalnie z myślą o tokenach w przeliczeniu na dolara i wat, z architekturą kładącą nacisk na obliczenia o wąskiej precyzji, programowo zarządzaną lokalizację pamięci SRAM oraz zintegrowaną bezpośrednio z rdzeniem strukturę skalowania Ethernet. Głównym twierdzeniem firmy jest 30% poprawa wydajności w przeliczeniu na dolara w porównaniu z obecnym sprzętem, uzyskana dzięki skoordynowanej optymalizacji obejmującej krzem, sieć, systemy i operacje Azure.


 Amazon