

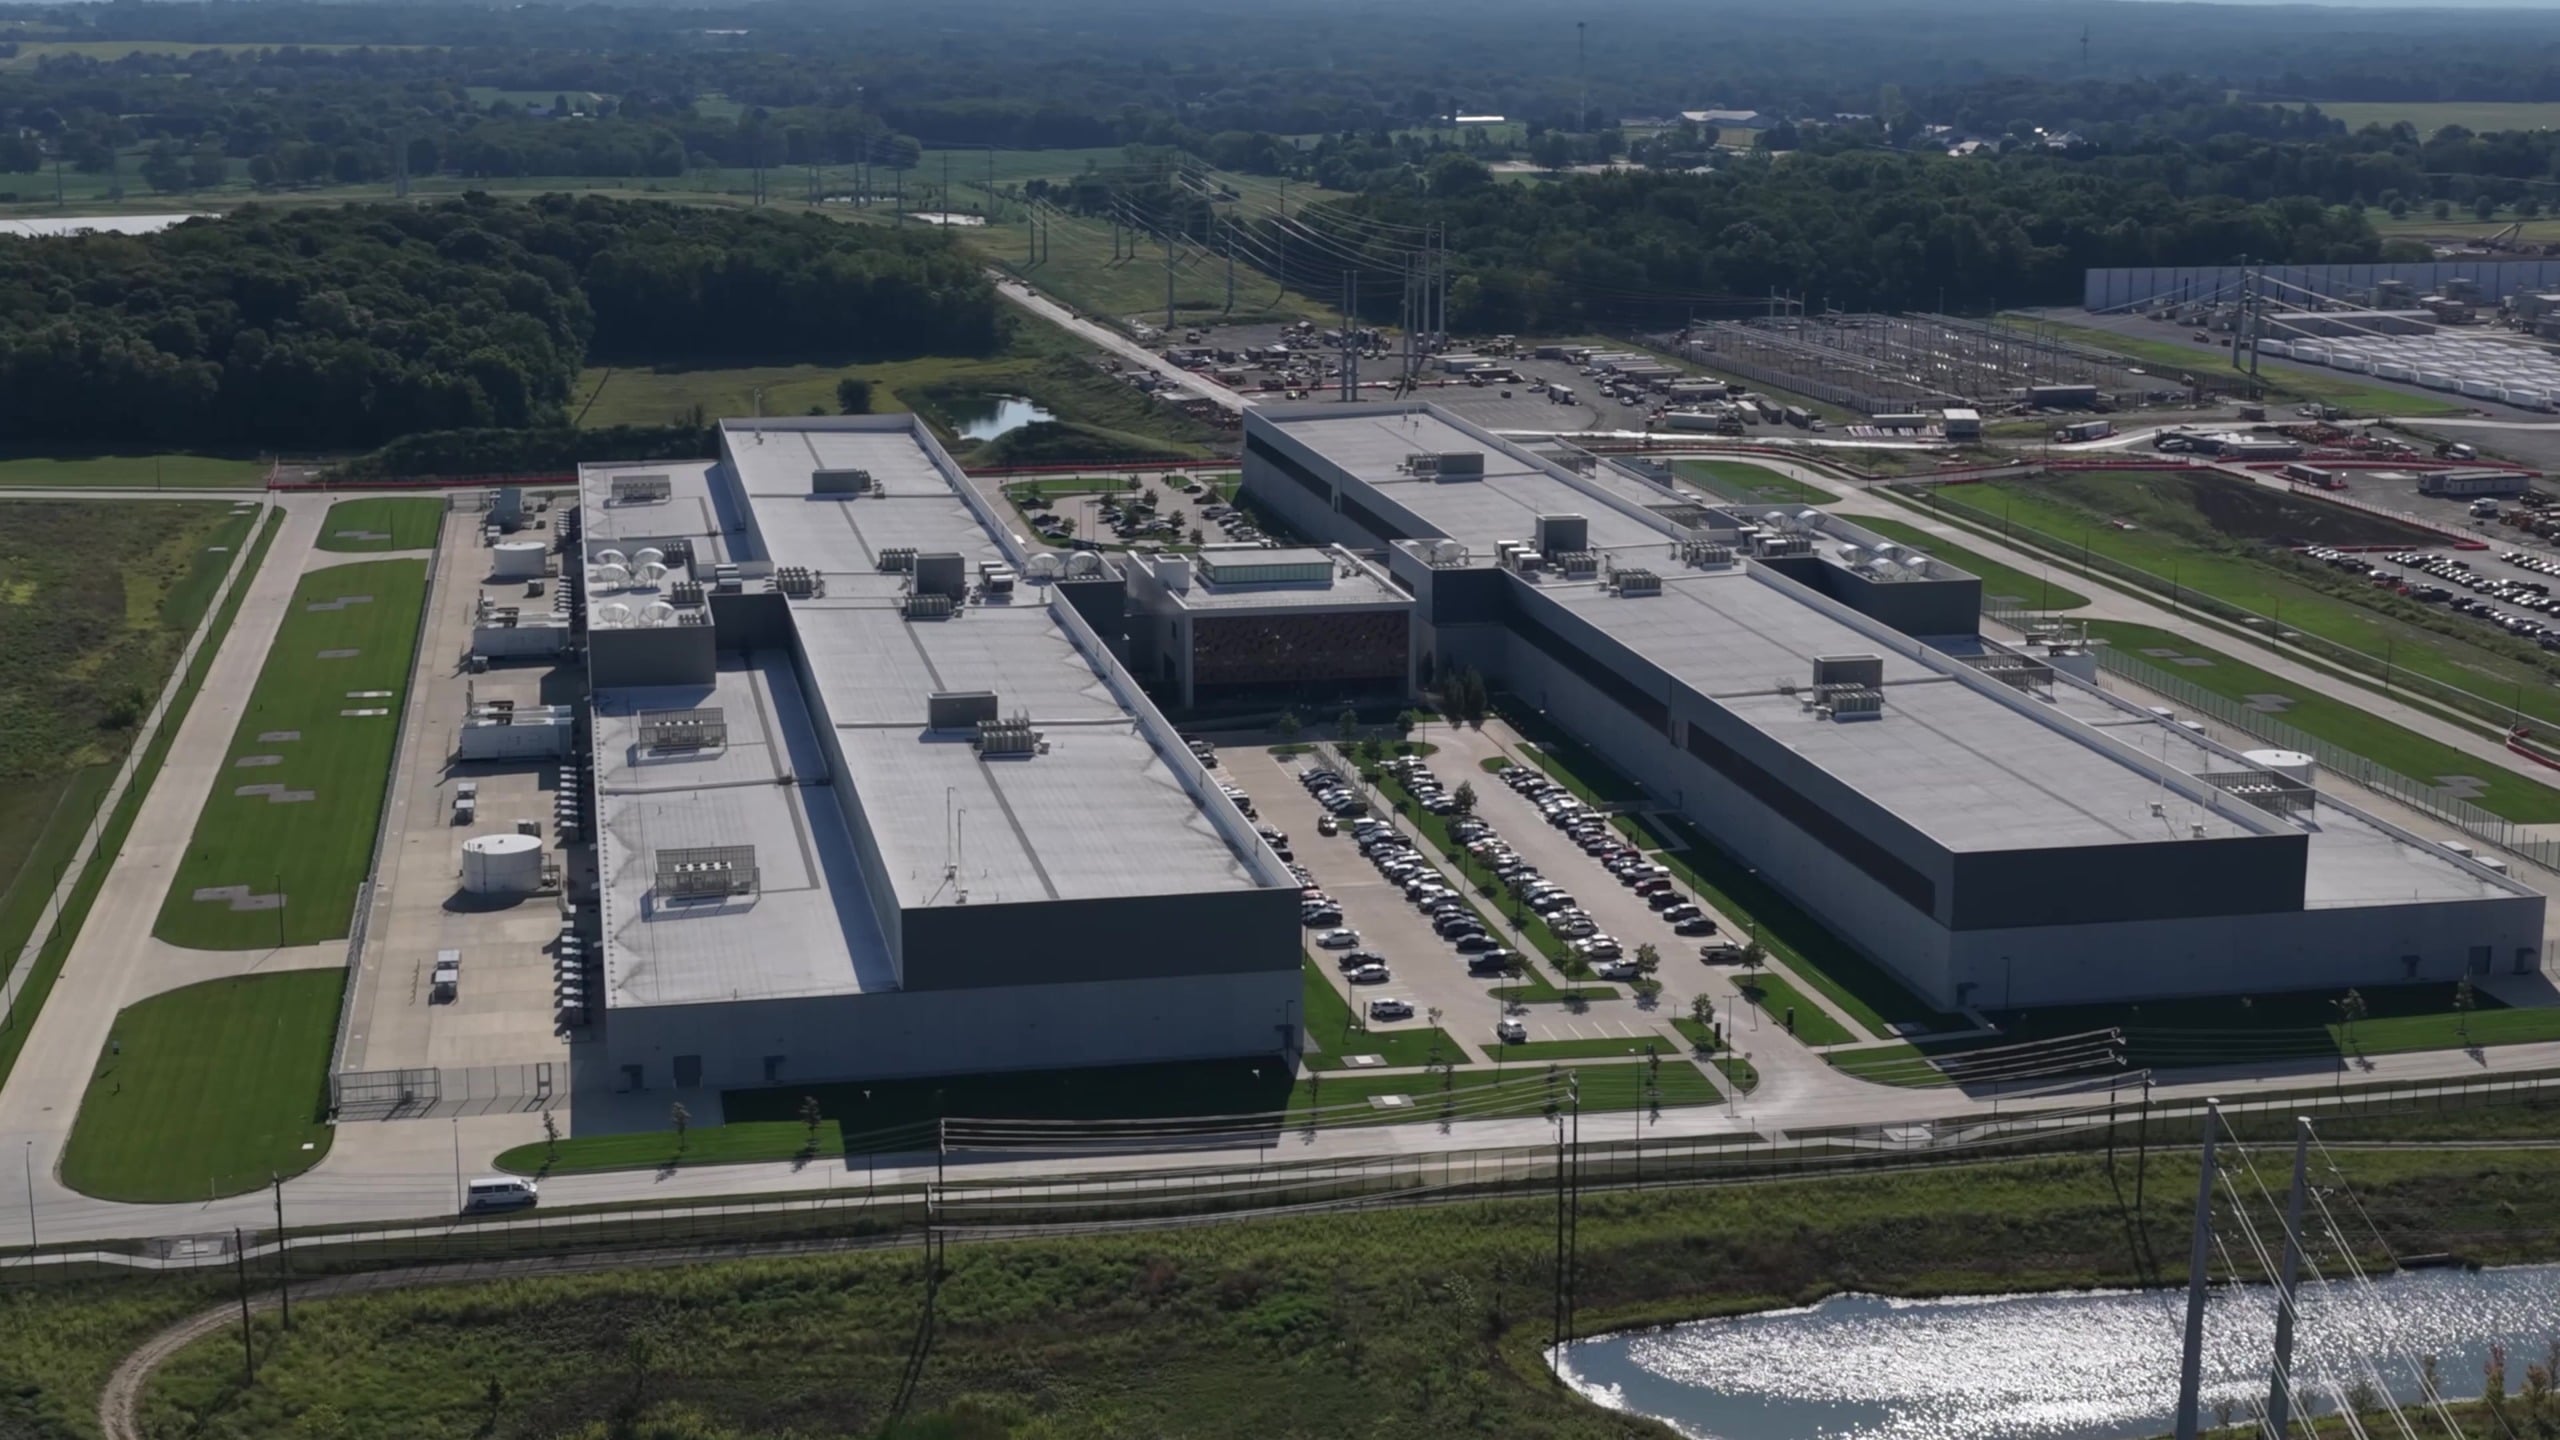
Meta opublikowała dziś szczegółowy opis Prometheusa, gigawatowego superklastra sztucznej inteligencji, który buduje w New Albany w stanie Ohio. Pierwsza faza została ukończona i wytrenowała rodzinę modeli fundamentowych Muse, w tym modele Muse Wonder. Meta twierdzi, że platforma jest skalowana do około miliona procesorów GPU. Dwa lata temu ten sam kampus był konwencjonalnym centrum danych obsługującym ruch internetowy. Wpis, autorstwa inżynierów Meta: Kevina Lee, Yashara Bayaniego, Ahmeda Sharifa i Yee Jiun Song, omawia kwestie sprzętu, sieci oraz prac nad niezawodnością, które zapewniają ciągłość zadań szkoleniowych.
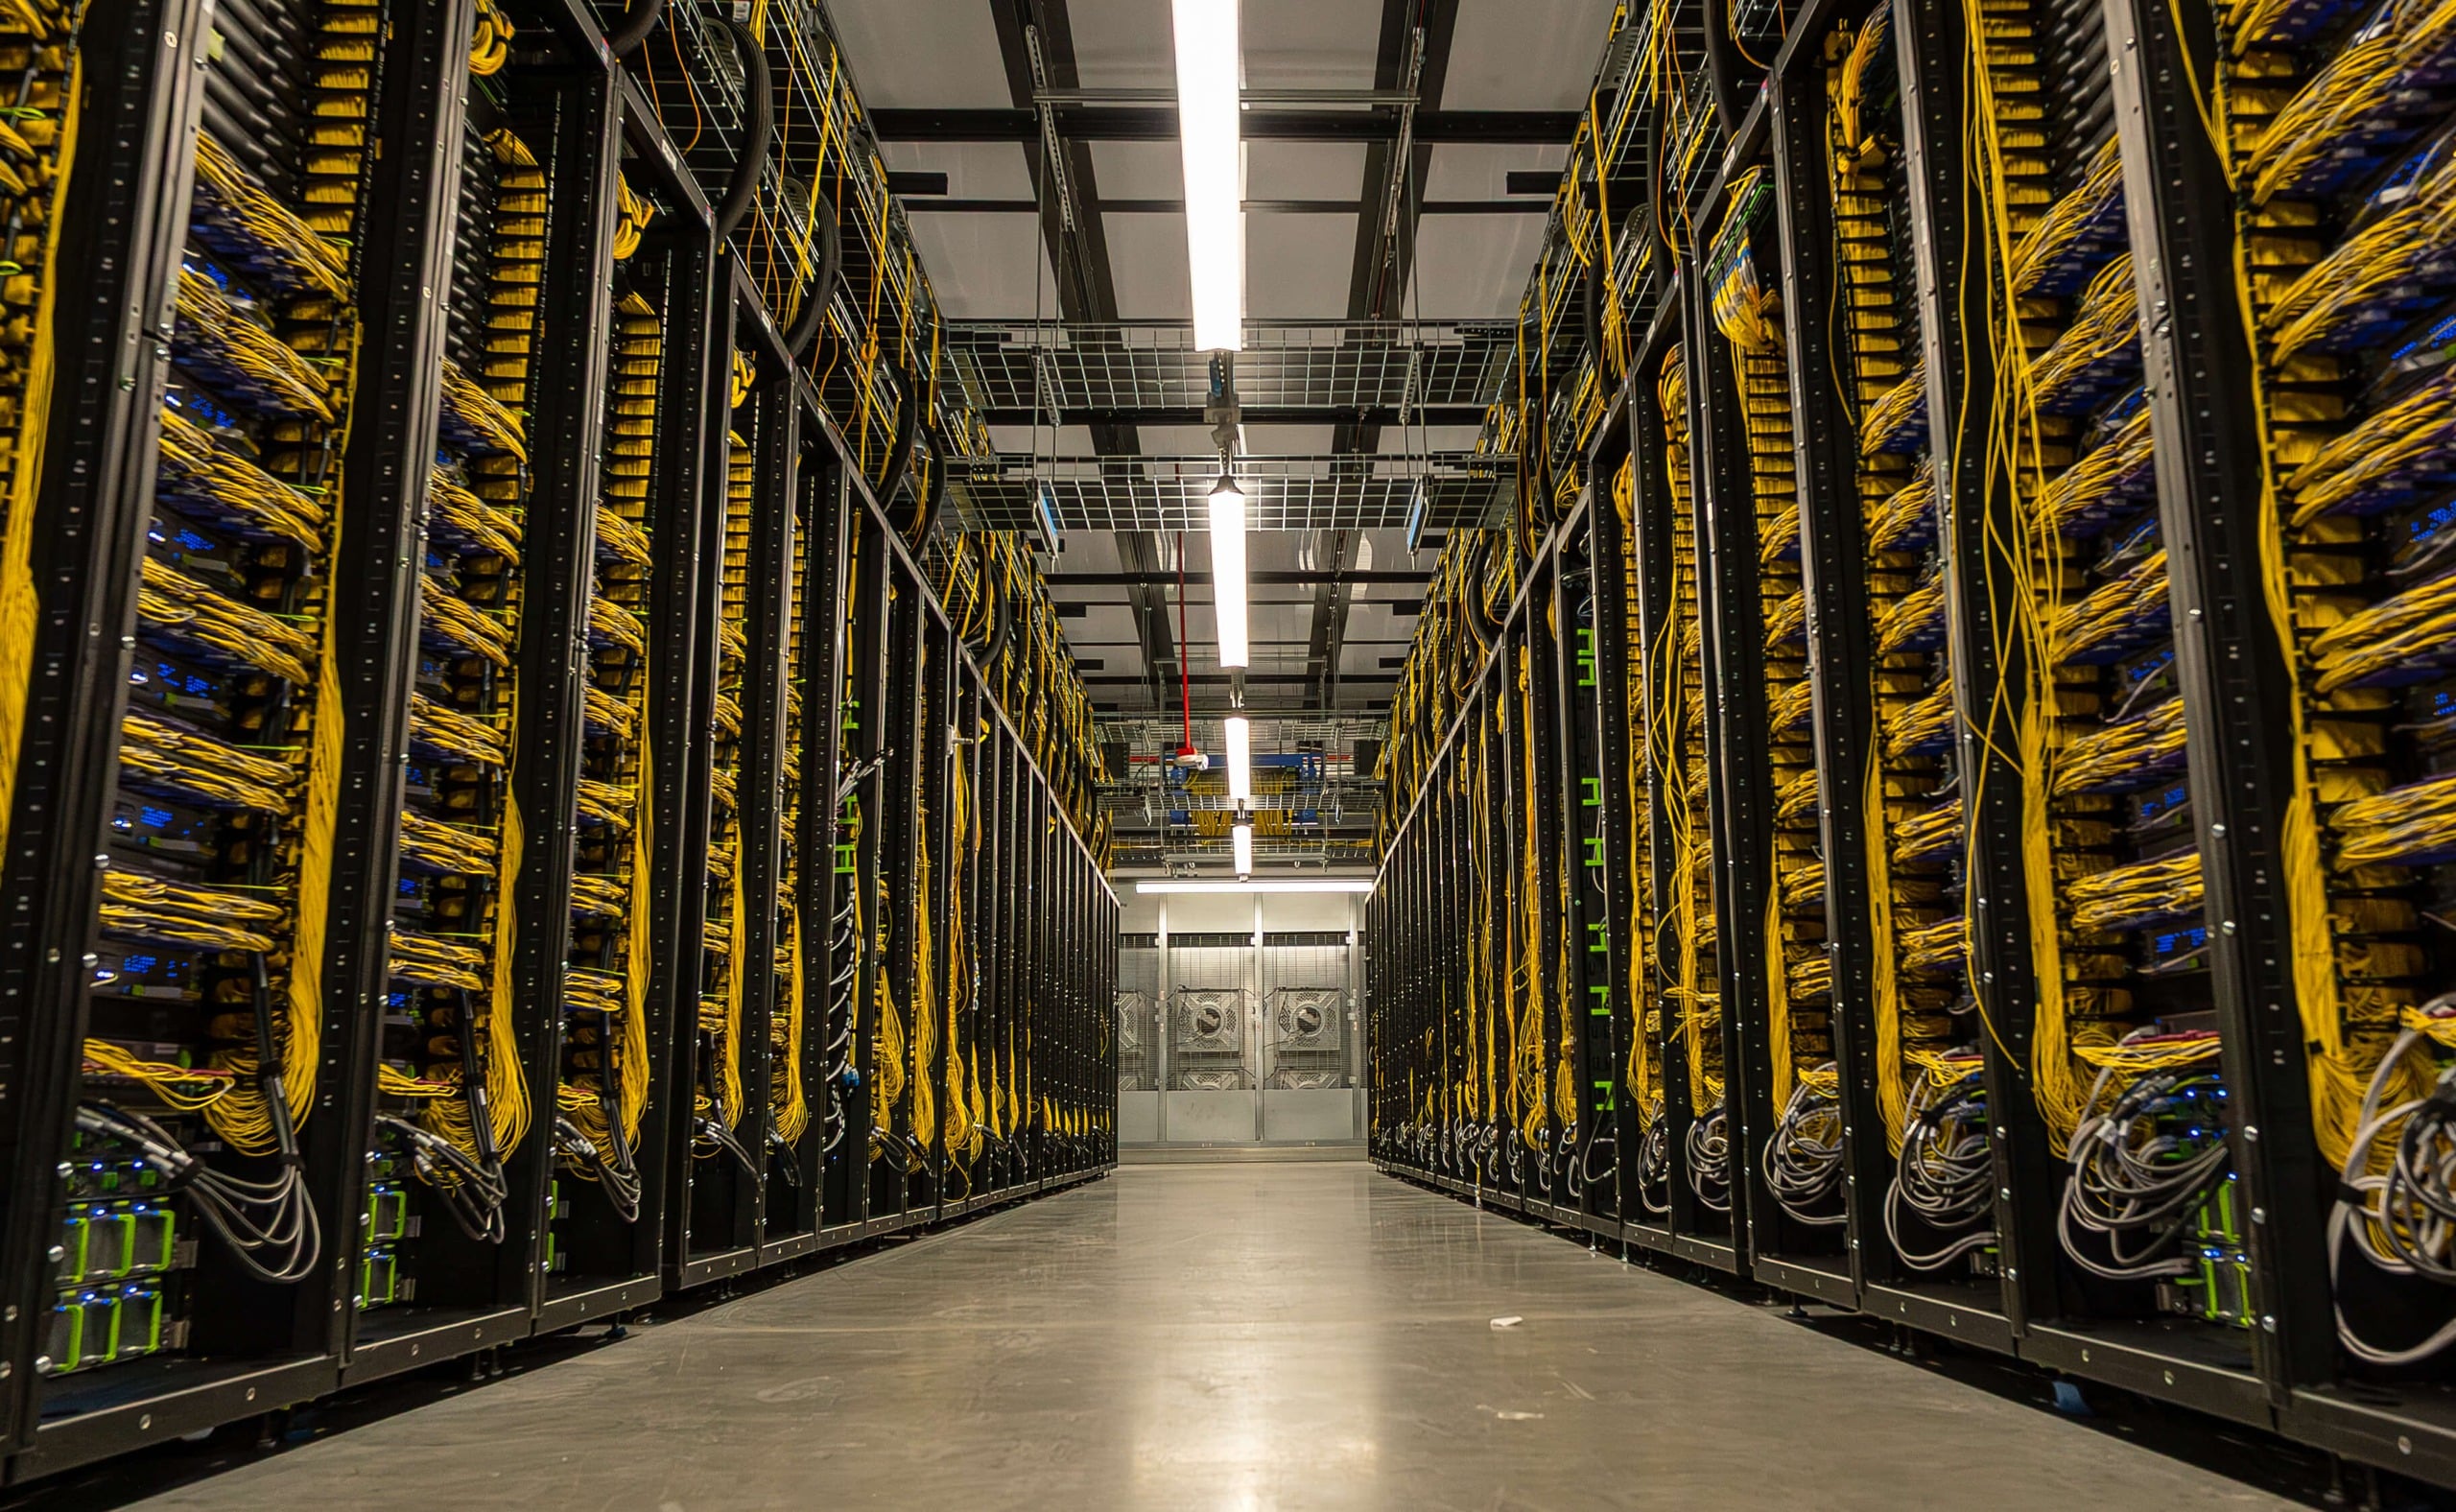
Meta ujawniła również jedne z najciekawszych danych dotyczących uruchamiania dużych zadań szkoleniowych: wskaźniki niezawodności. Meta raportuje ponad 85% dobrego przepustowości (goodput) w przebiegach przedtreningowych Muse Wonder i ponad 90% w przebiegach uczenia wzmacniającego, przy czym średni czas między przerwami wynosi około 47 000 godzin pracy GPU podczas tych przebiegów. Poprawki oprogramowania układowego wprowadzone od tego czasu zwiększyły MTBI do ponad 54 000 godzin pracy GPU. Deklarowanym celem Meta są dwie przerwy na 8,000 GPU dziennie, co daje około 100 000 godzin pracy GPU między przerwami.
Dwie generacje NVL72 w produkcji, Vera Rubin Next
Prometheus obsługuje obecnie dwie platformy GPU NVIDIA, obie zbudowane w architekturze rack NVL72, w której 72 GPU współdzielą jedną domenę NVLink, a trzecia, oparta na Vera Rubin NVL72, pojawi się wkrótce. Pierwsza, którą Meta nazywa Catalina, wykorzystuje GB200 NVL72 w wariancie Ariel: konfigurację dwuskrzynkową z 36 GPU na szafę, zbudowaną w oparciu o wysokowydajną konstrukcję rackową Open Rack V3 firmy Meta, opracowaną w ramach projektu Open Compute Project. Każdy GPU Blackwell współpracuje z procesorem Grace i dwiema kartami sieciowymi ConnectX-7 400G, co zapewnia stosunek CPU do GPU 1:1, co daje każdemu GPU 800 GB skalowalnej przepustowości.
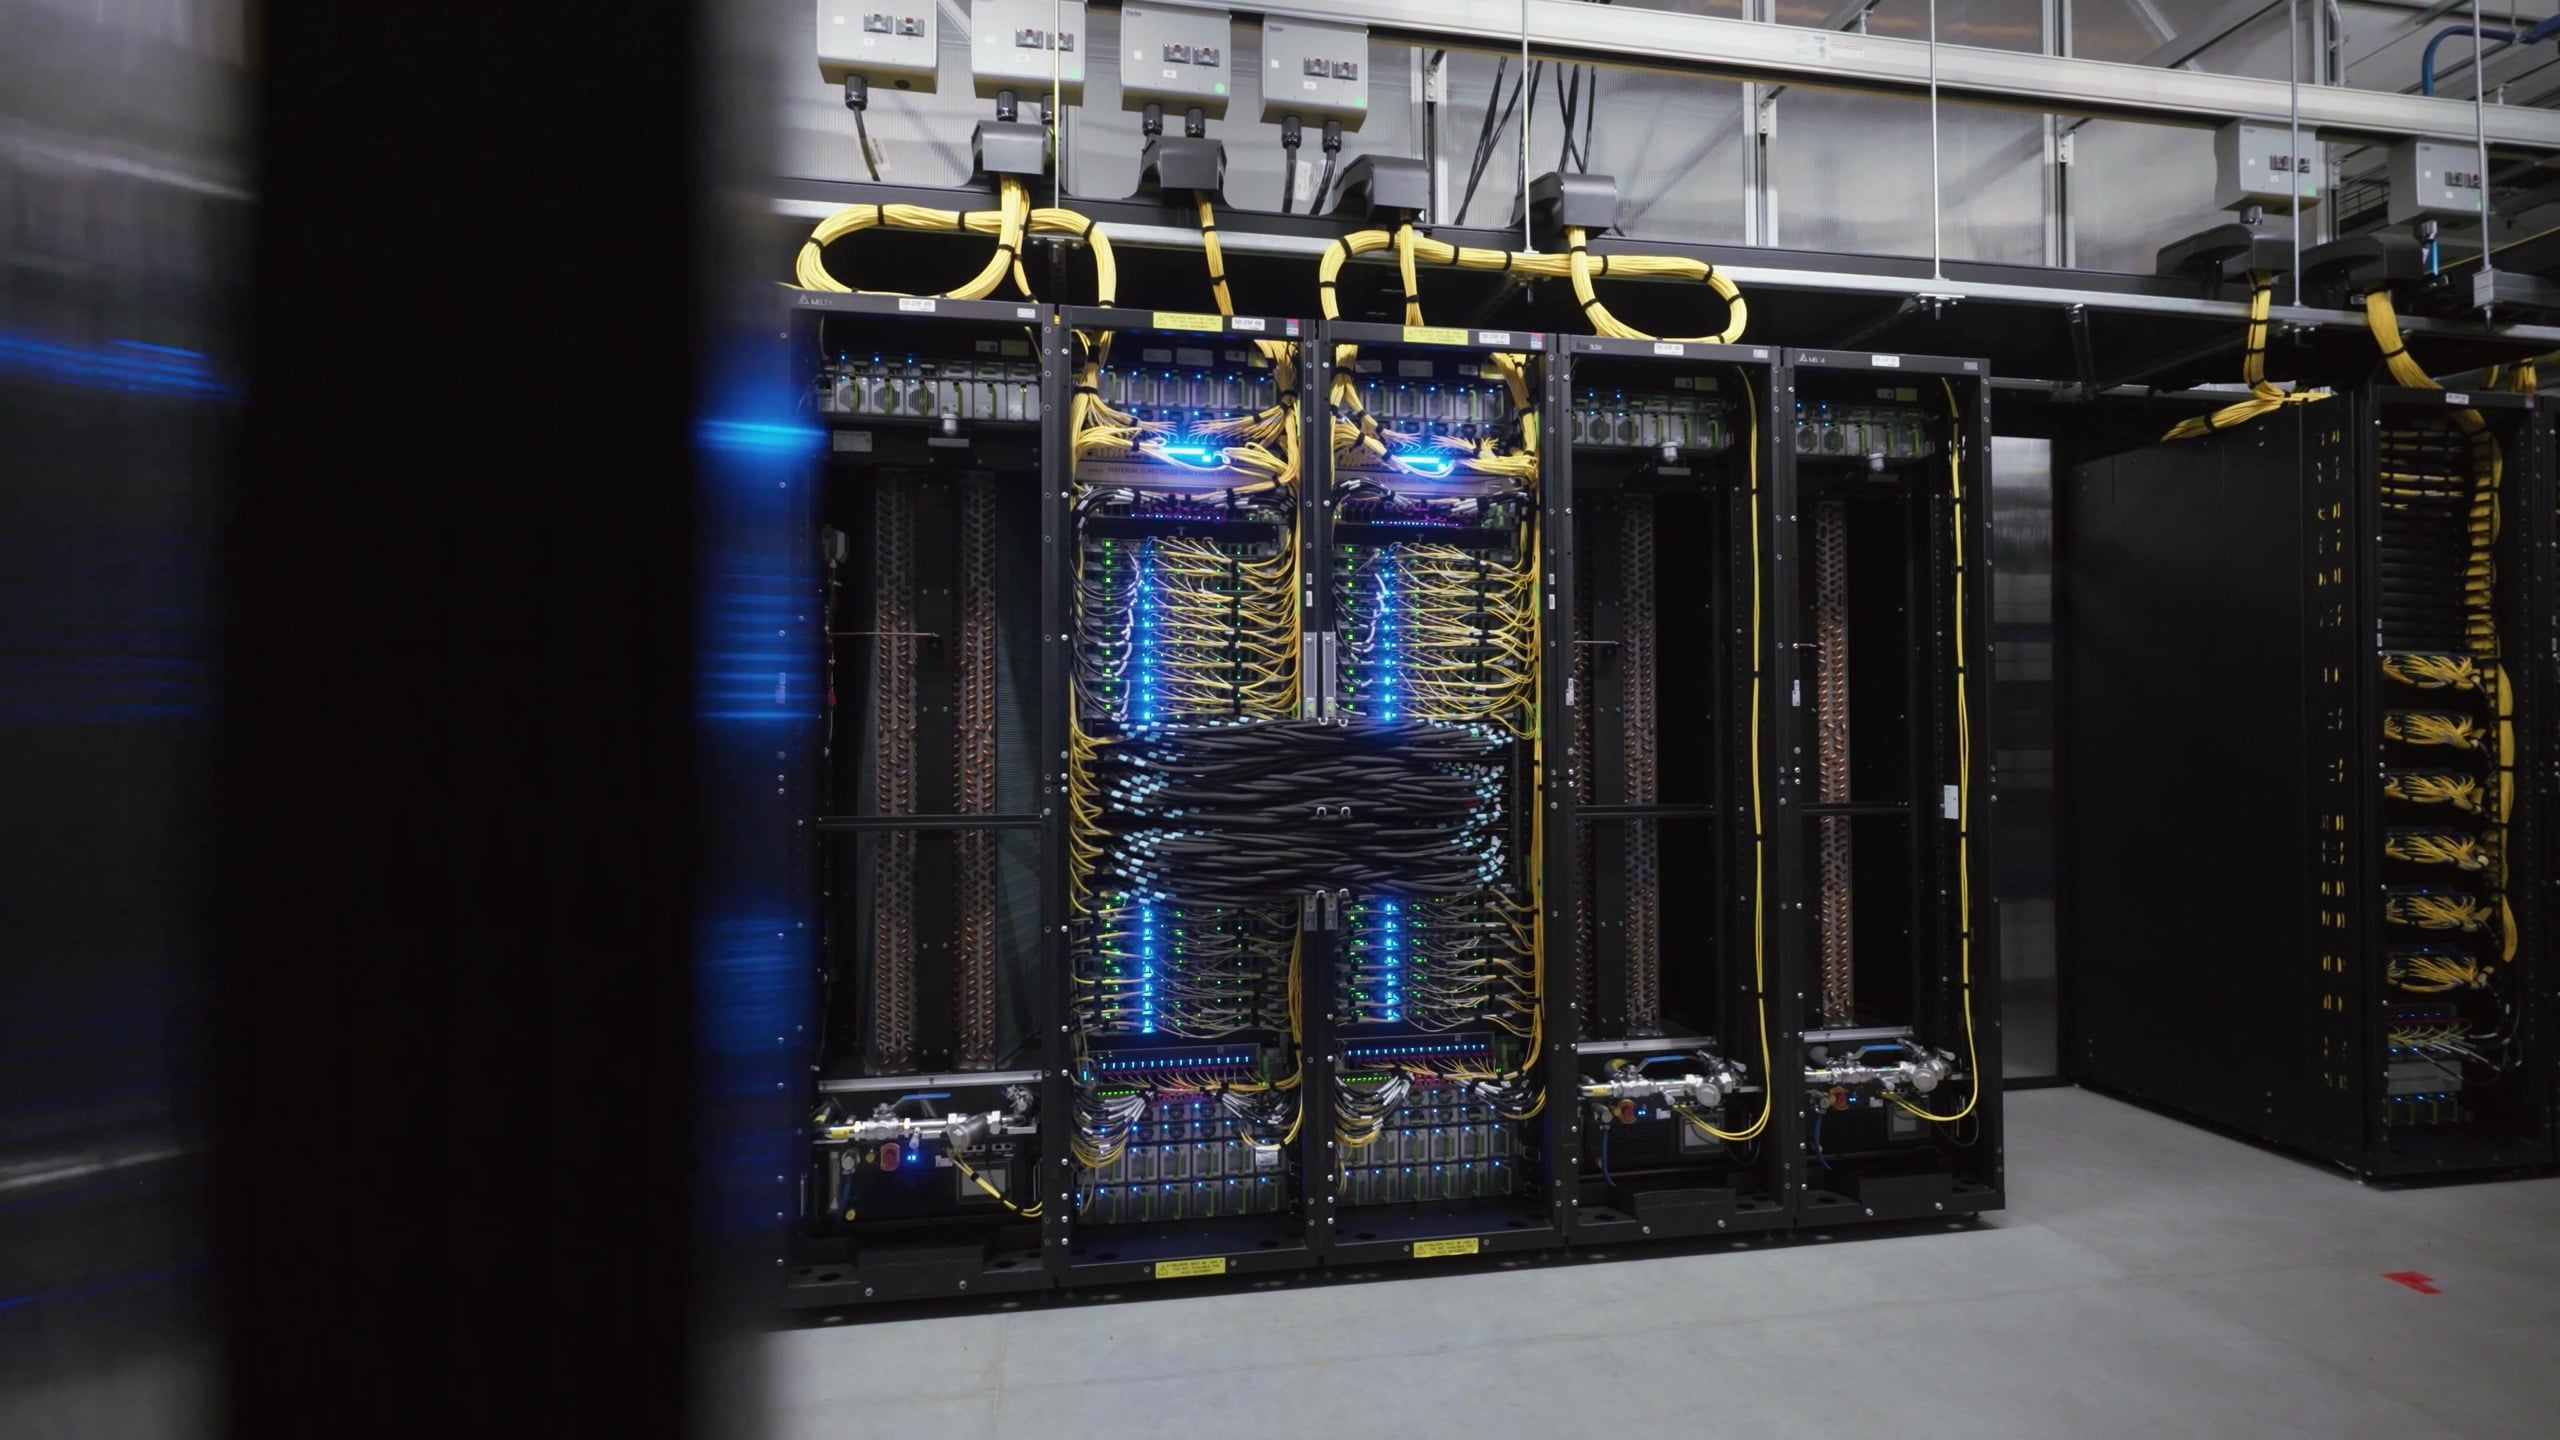
Firma Meta twierdzi, że wybrała Ariel, ponieważ GB200 NVL72 skalował liczbę FLOPS-ów, przepustowość HBM, przepustowość skalowania w górę i rozmiar domeny znacznie przewyższał H100, podczas gdy standardowe skalowanie w poziomie utrzymywałoby się na poziomie 400 GB na GPU, a firma spodziewała się, że ta dysproporcja wpłynie negatywnie na wydajność. Według Meta, para procesorów Catalina zawiera 72 procesory graficzne Blackwell z 13.4 TB pamięci HBM3e (192 GB na GPU), 720 PFLOPS szczytowych mocy obliczeniowych do treningu FP8 (1,440 PFLOPS w FP4), 130 TB/s przepustowości NVLink w domenie, 576 TB/s łącznej przepustowości pamięci i pobiera około 120 kW mocy w obu szafach.
Druga platforma, Clemente, przechodzi na GB300 NVL72. Pamięć HBM na GPU wzrasta 1.5-krotnie do 288 GB, przepustowość gęstego FP4 wzrasta o podobny współczynnik, a przyspieszenie uwagi jest mniej więcej dwukrotnie większe. Karty ConnectX-8 SuperNIC oferują natywnie 800 Gb/s na GPU, więc skalowalność wbudowana w Ariel w Meta staje się punktem odniesienia, a stosunek GPU do CPU 2:1 pozwala na umieszczenie całej domeny 72 GPU w jednej szafie rack. Meta podaje 20.7 TB pamięci HBM3e, ponad eksaflopa mocy obliczeniowej szczytowej FP4, 130 TB/s przepustowości NVLink (1.8 TB/s w obu kierunkach na GPU), około 135 kW mocy na szafę rack i wzrost wydajności o 5 do 10 procent w porównaniu z GB200 NVL72.
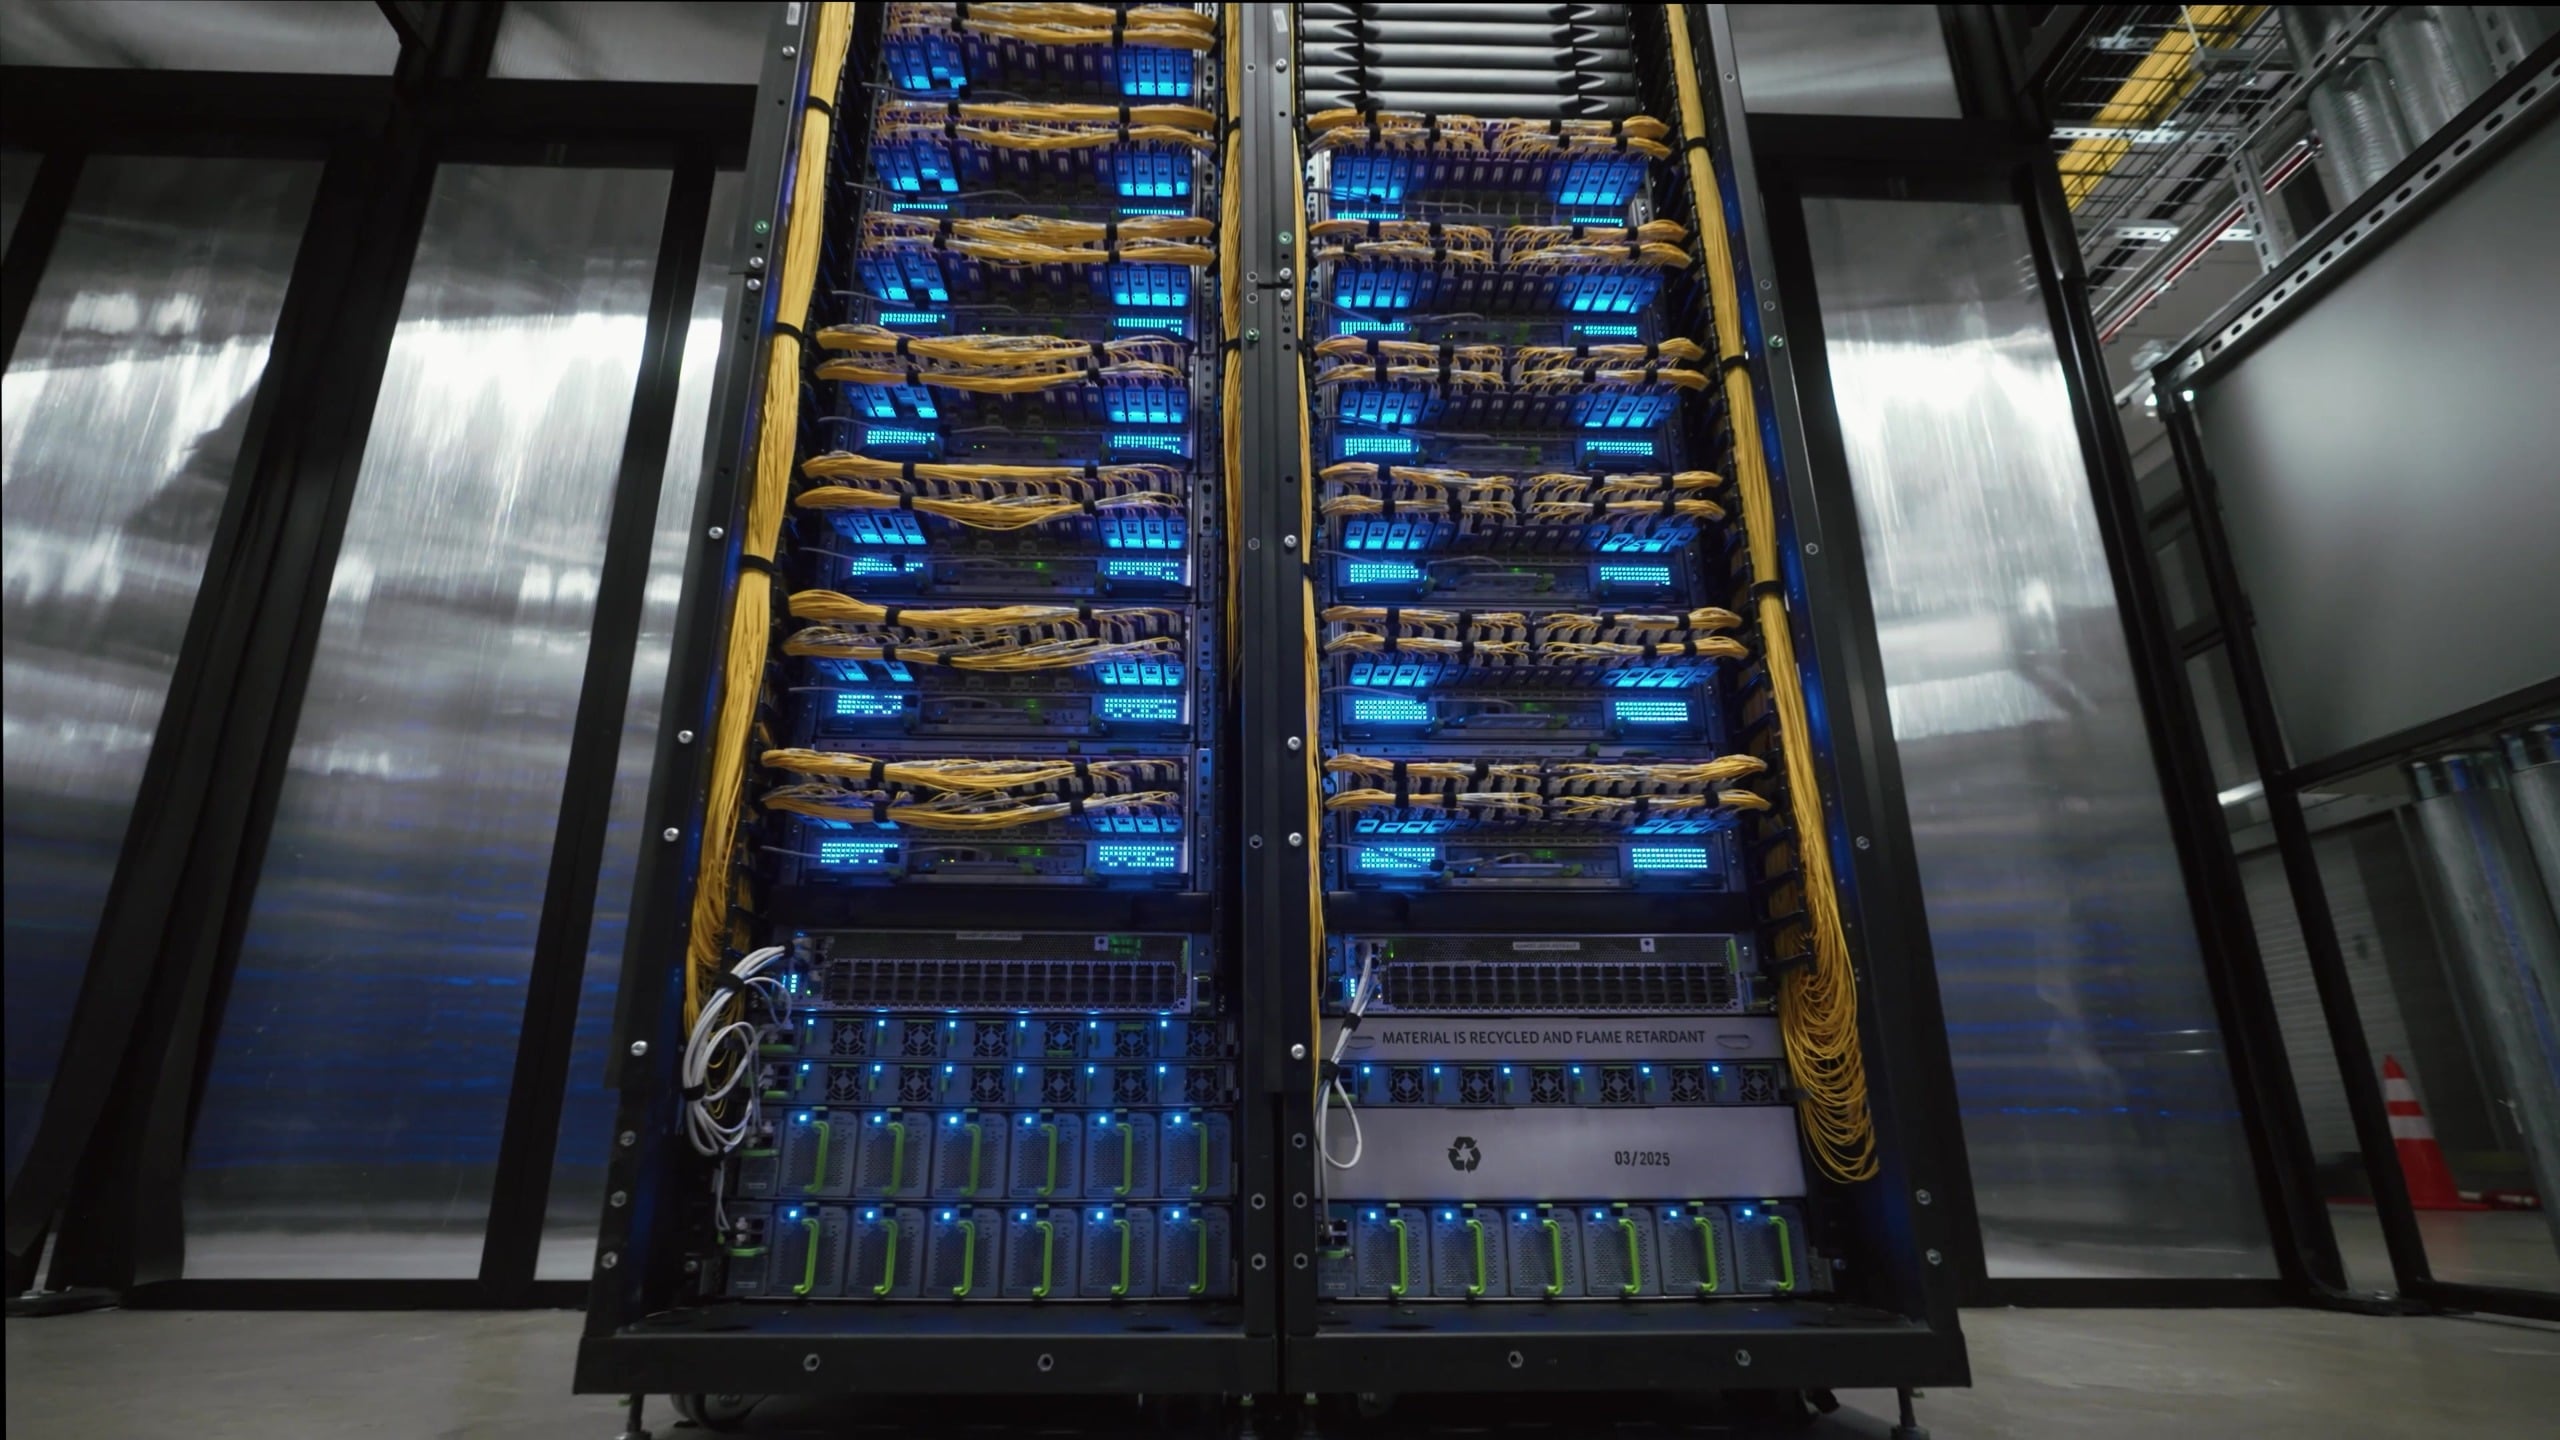
Clemente korzysta z modułowego systemu chłodzenia cieczą wspomaganego powietrzem firmy Meta lub z zakładowego chłodzenia cieczą w nowszych budynkach zoptymalizowanych pod kątem sztucznej inteligencji, a Meta twierdzi, że łatwość serwisowania jest większa dzięki mniejszej liczbie kabli.
Kolejna platforma Meta, San Miguel, wprowadzi Vera Rubin NVL72 do tej samej struktury sieciowej. Dane Meta dla tej szafy to: 288 GB pamięci HBM4 na GPU przy 19.2 TB/s, 2.52 eksaFLOPS szczytowej mocy obliczeniowej dla treningu FP4 i 1.26 eksaFLOPS dla FP8, 216 TB/s przepustowości NVLink (3 TB/s na GPU), około 1,500 TB/s łącznej przepustowości pamięci, w pełni chłodzone cieczą tacki obliczeniowe o mocy ponad 170 kW na szafę oraz 10-20% wzrost wydajności na wat w porównaniu z GB300 NVL72. CoreWeave uruchomiło Vera Rubin NVL72 w produkcji na początku tego miesiąca.
Dedykowany back-end Ethernet obejmujący budynki
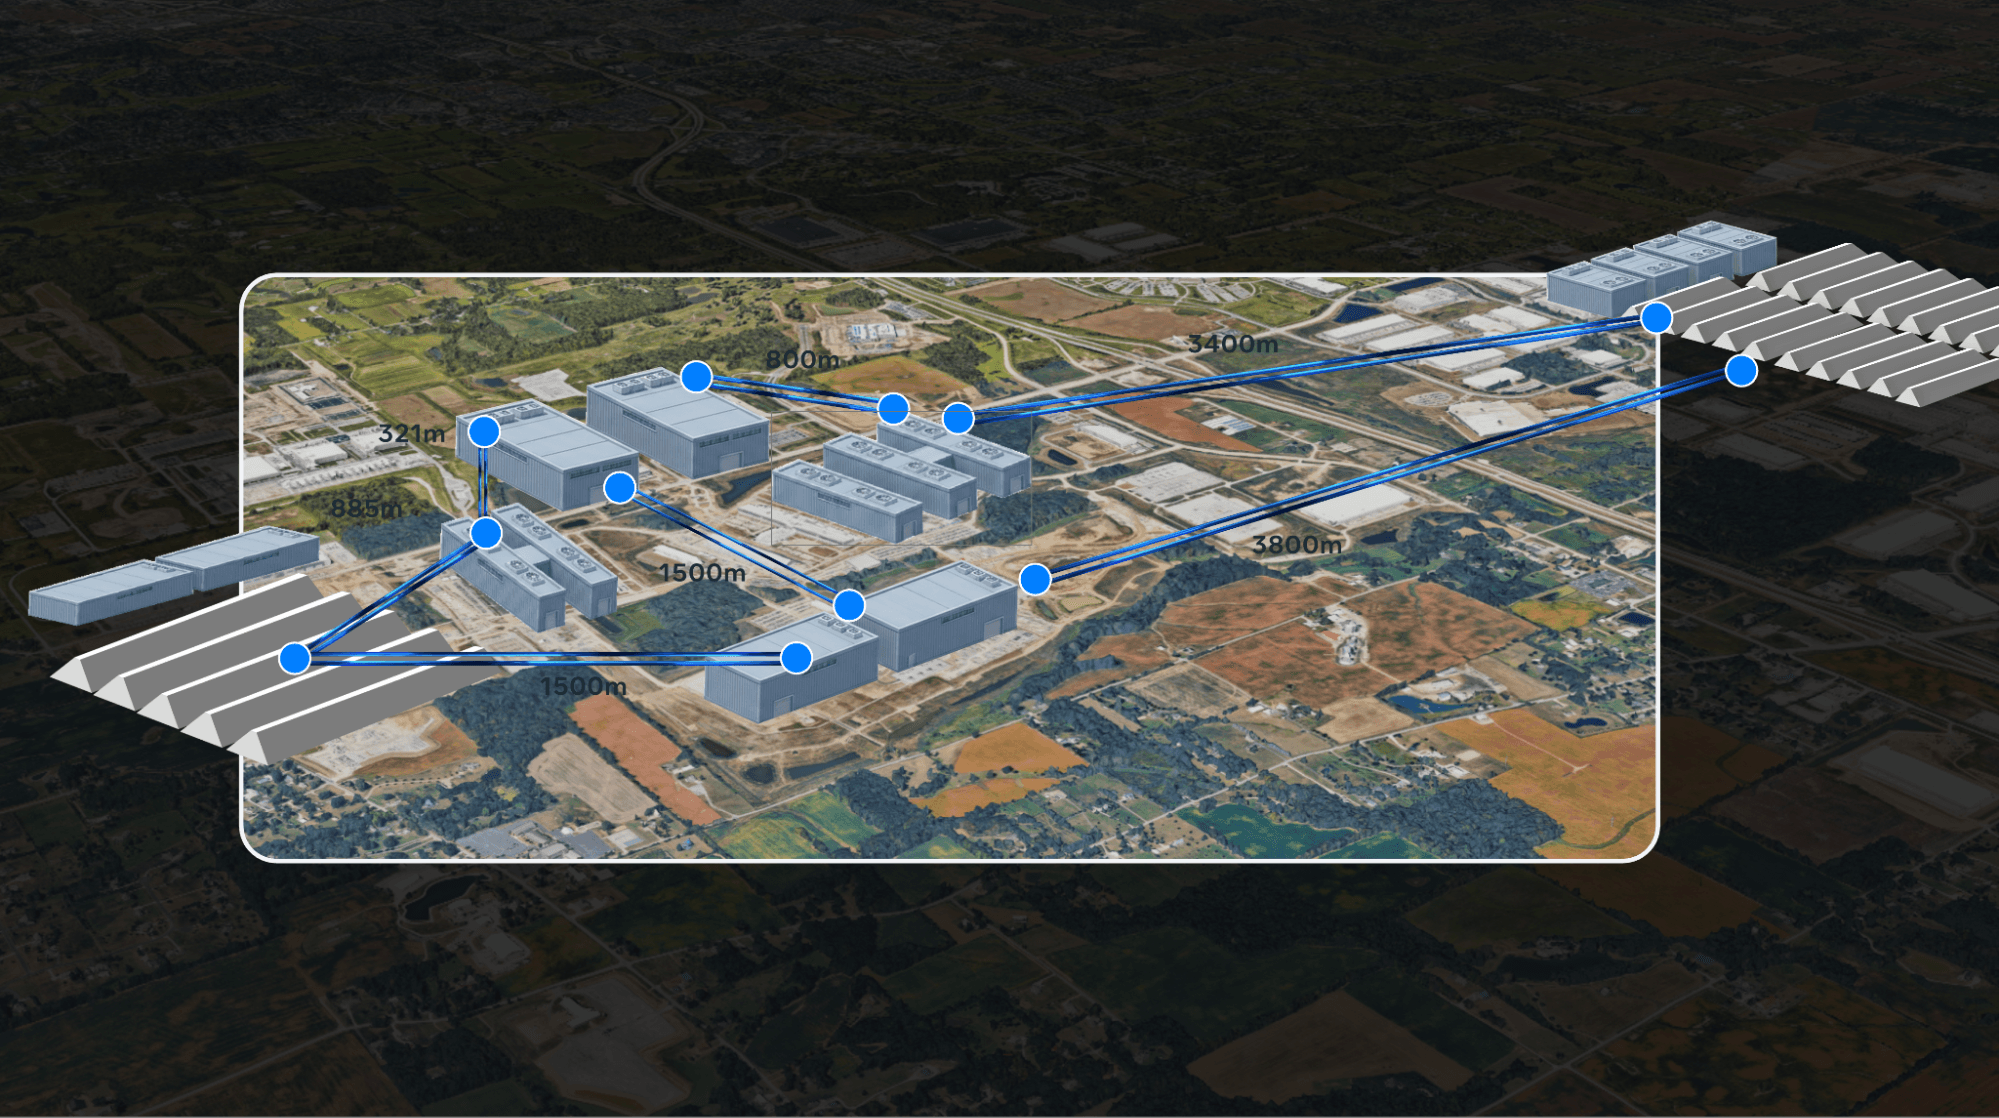
Ruch treningowy odbywa się w drugiej sieci centrum danych przez Ethernet, oddzielonej od sieci front-end, która obsługuje standardowy ruch usługowy. Projekt odzwierciedla kształt zadania treningowego: repliki równoległe przechowują swoje wrażliwe na opóźnienia i wymagające dużej przepustowości kolektywne struktury wewnątrz struktury budynku, podczas gdy bardziej tolerancyjny ruch między replikami przechodzi przez warstwę agregacji, która łączy budynki. Meta wbudowała tę samą hierarchię we wcześniejsze klastry o skali budynku z 24 000 GPU oraz w regionalny klaster z ponad 100 000 GPU, zanim rozszerzyła ją do Prometheusa.
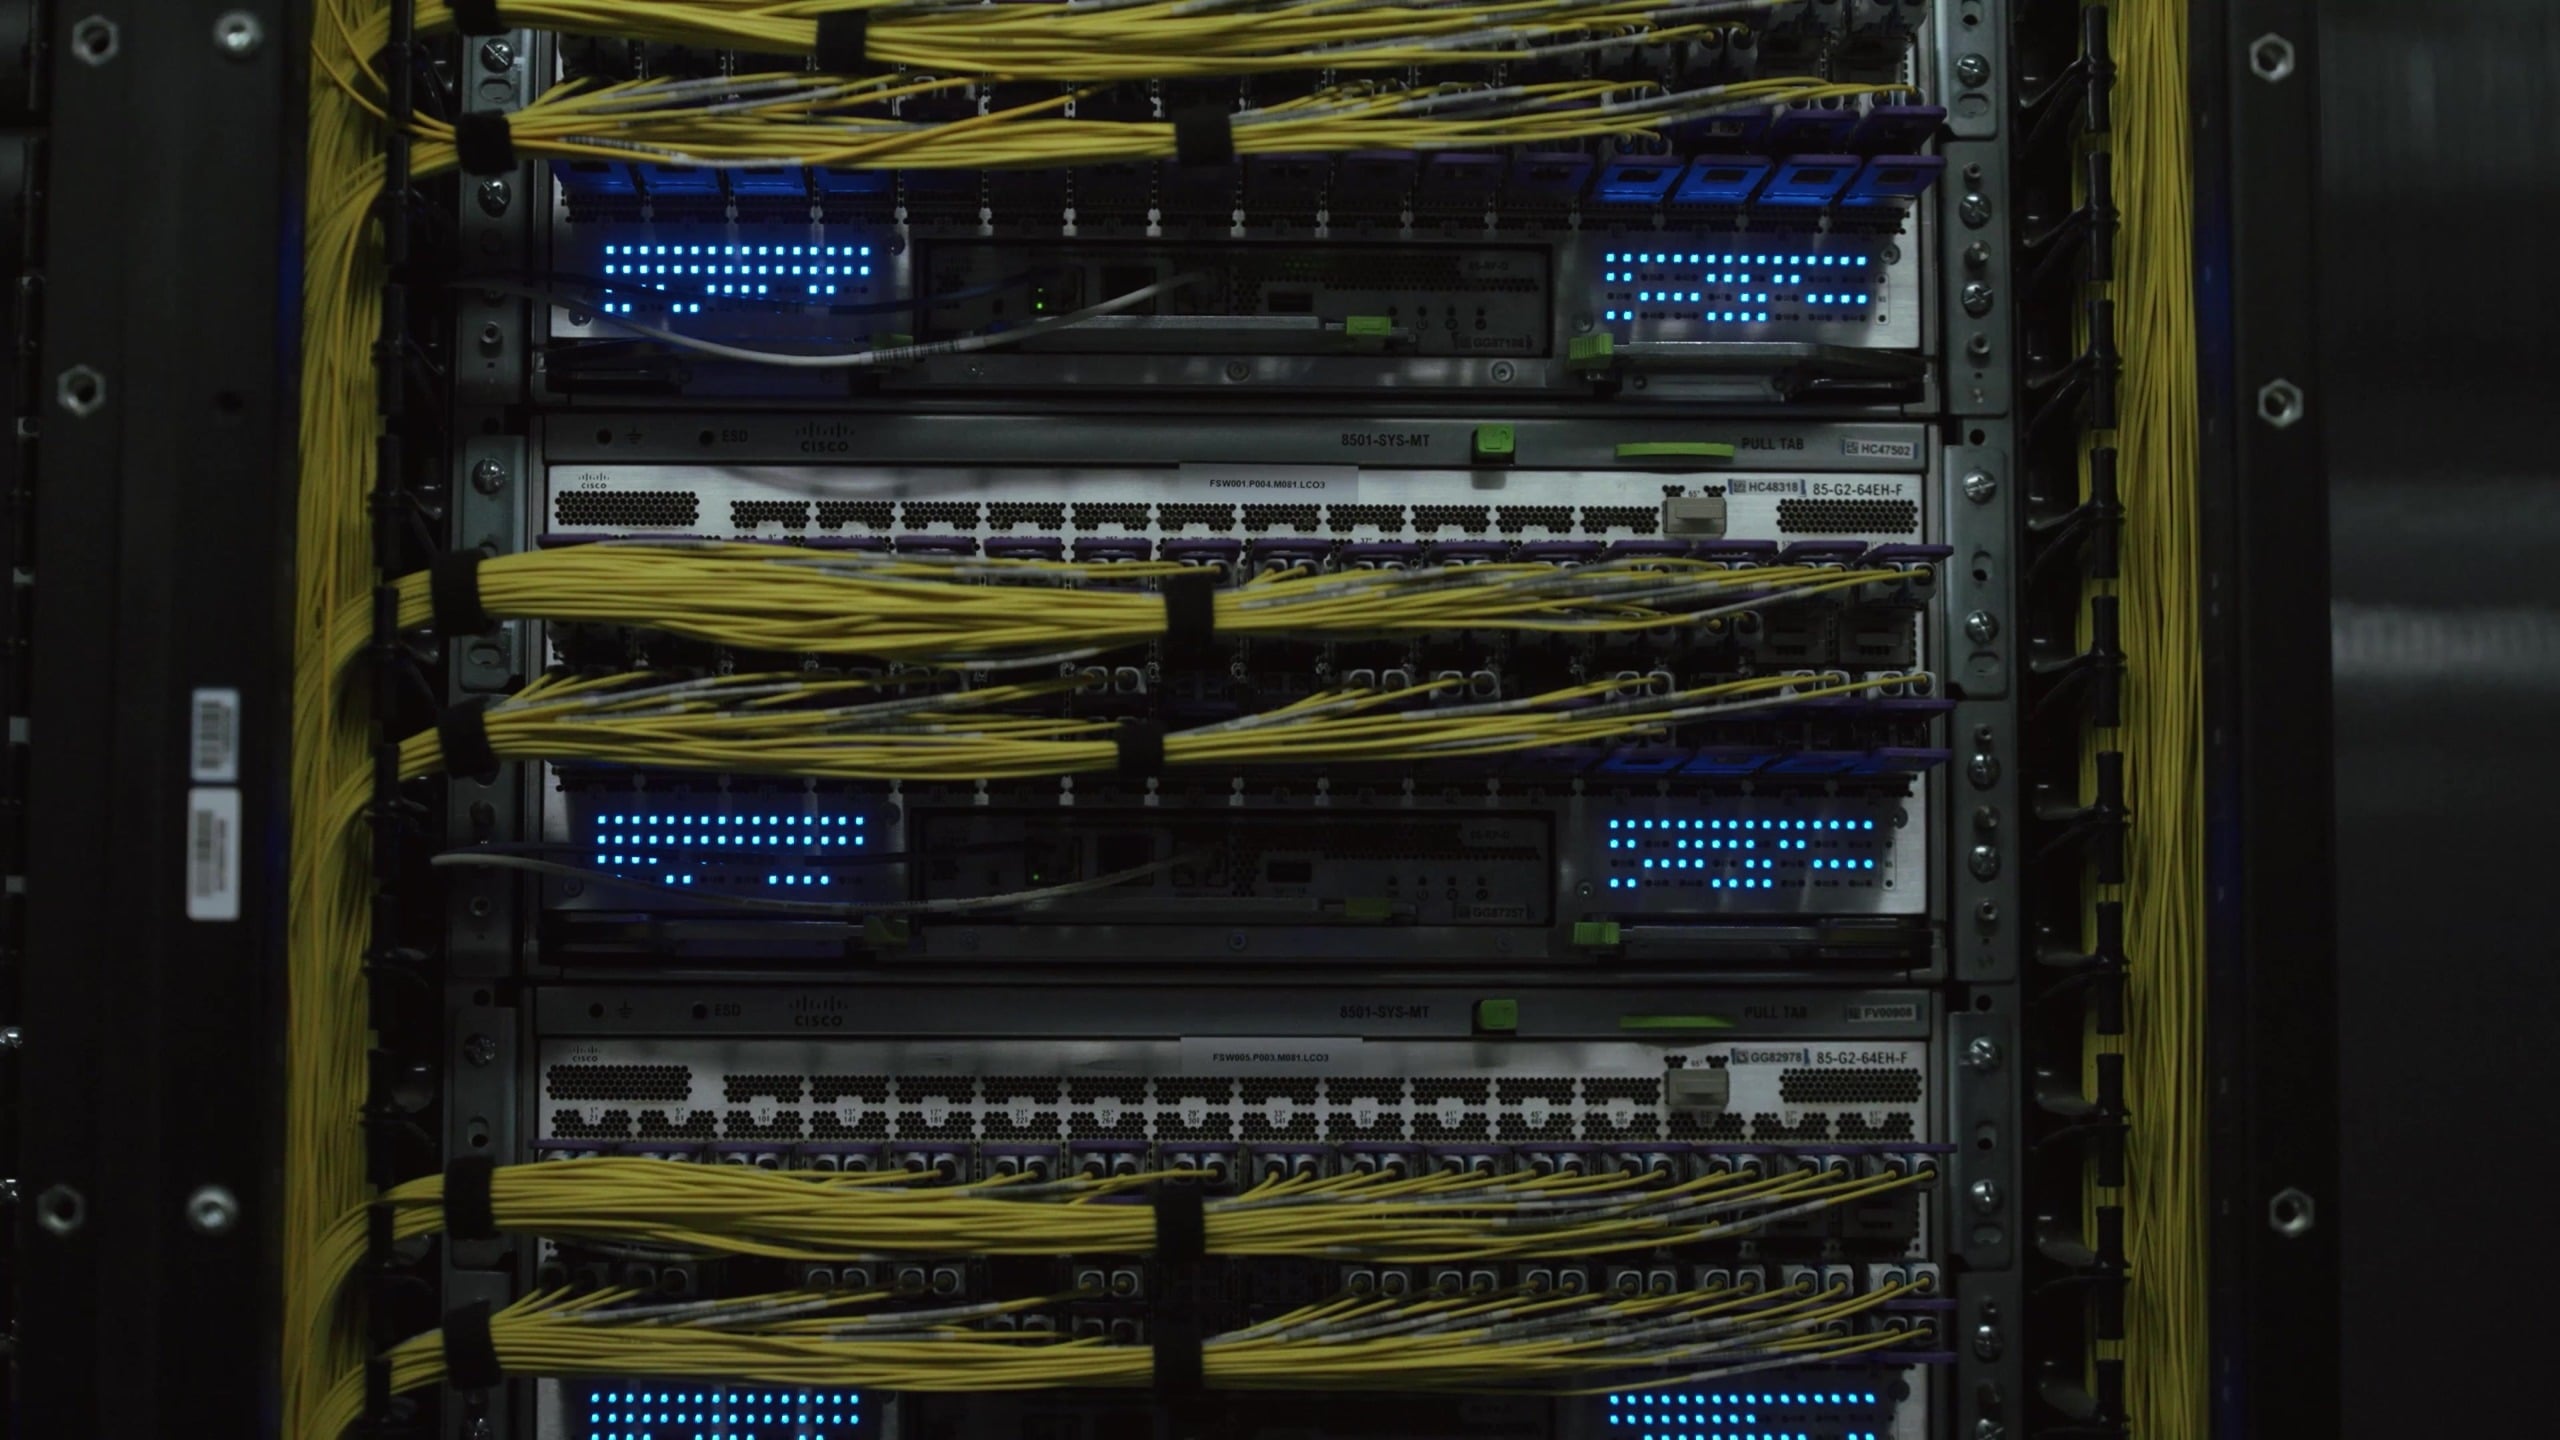
Każda struktura łączy do 20 736 procesorów GPU. Pierwszym projektem Meta była struktura Disaggregated Scheduled Fabric, która wykorzystywała wielościeżkowe routing podpakietów, reorganizację wewnątrz struktury, wirtualne kolejki wyjściowe i kontrolę przepływu opartą na kredytach, aby zapobiec kolizji kilku dużych, długowiecznych przepływów zbiorowości szkoleniowej. Wraz z uzyskaniem możliwości reorganizacji pakietów w punkcie końcowym, Meta przeszła na strukturę Non-Scheduled Fabric zbudowaną na przełącznikach 51.2T z płytkim buforem: Minipack3 z dynamicznym równoważeniem obciążenia oraz Minipack3N, który wykorzystuje układ NVIDIA Spectrum-4 ASIC z adaptacyjnym routingiem na kartach sieciowych ConnectX, przy czym oba korzystają ze stosu sieciowego FBOSS firmy Meta.
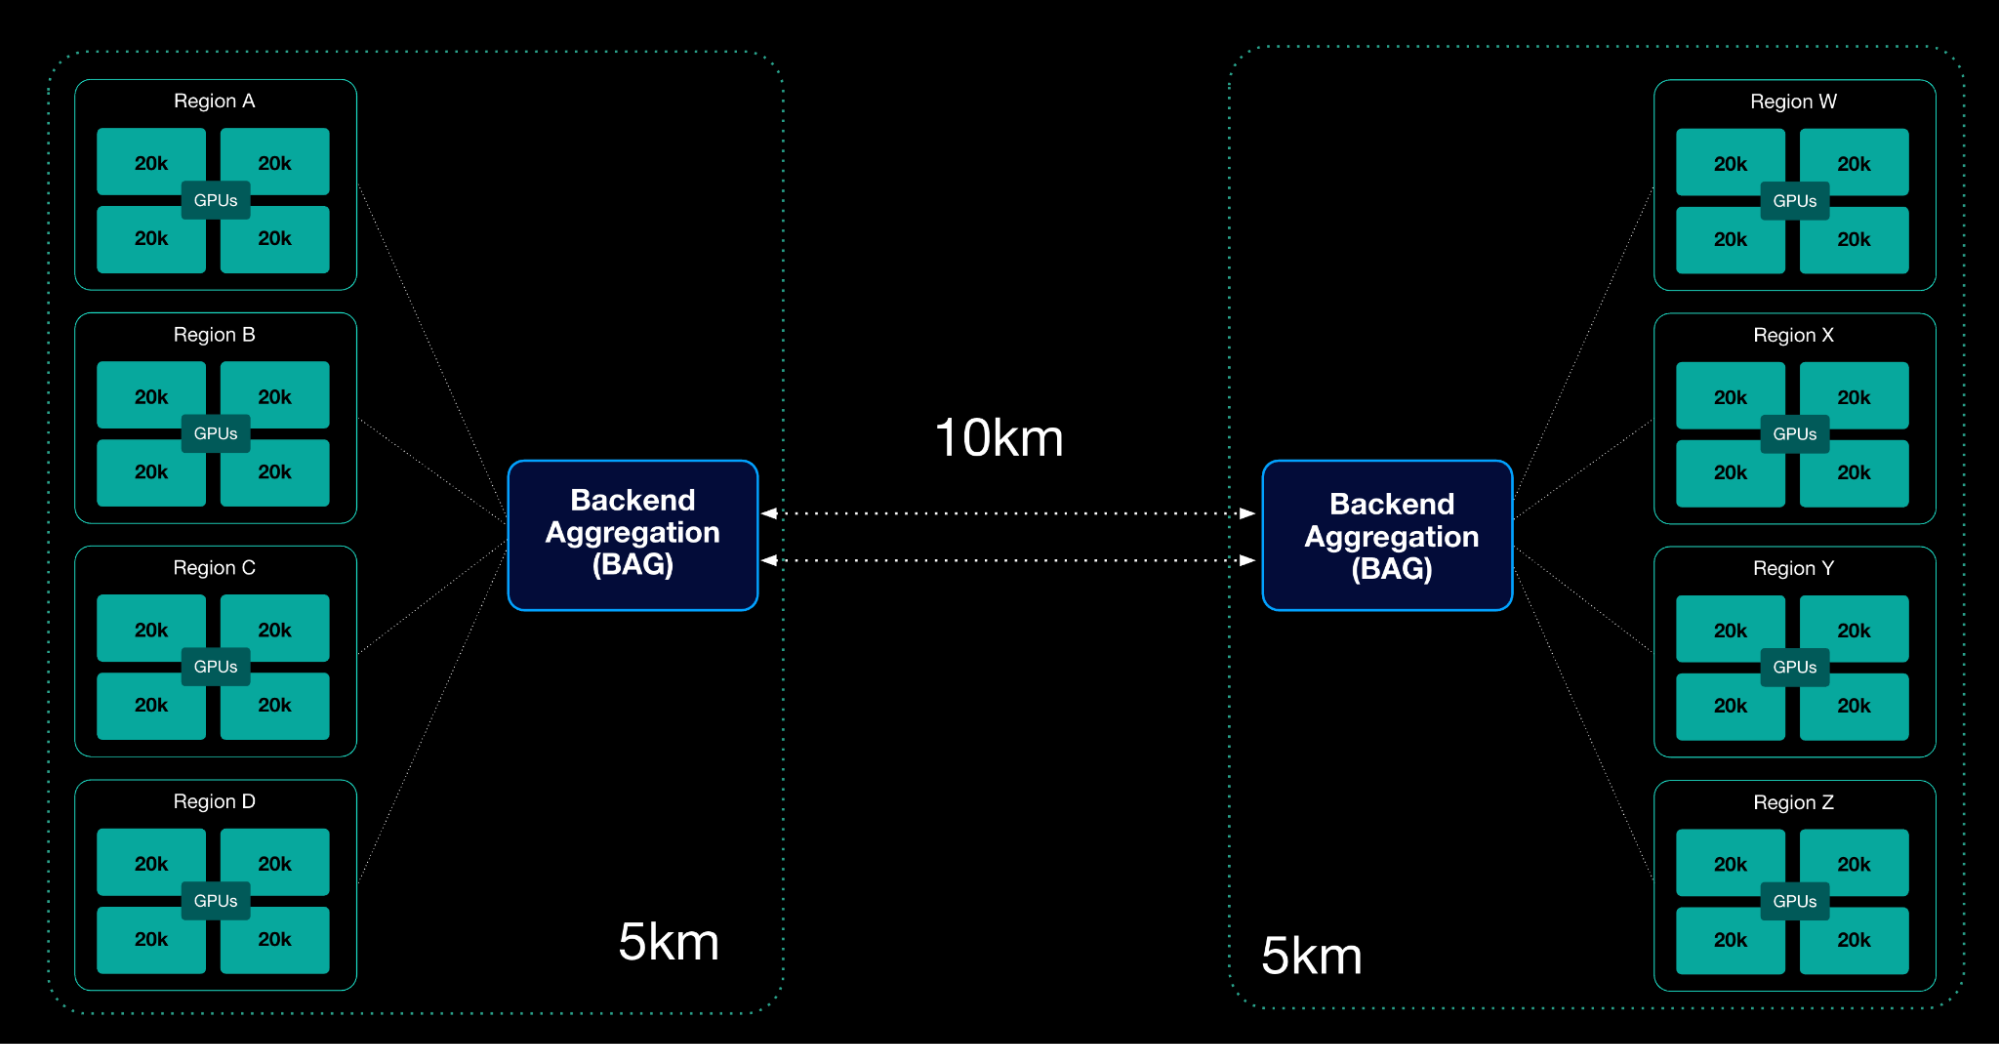
Nad budynkami znajduje się sieć agregacji zaplecza (Backend Aggregation), wielowarstwowa konstrukcja typu hub-and-spoke, oparta na obudowie Arista serii 7800 z głęboką buforowaną matrycą krzemową Broadcom Jericho3. Obejmuje ona zasięg od 2 km do ponad 100 km i zapewnia wiele petabitów na sekundę między parami regionów. Firma Meta twierdzi, że przeprowadzenie wstępnego treningu na tych dystansach wymagało dedykowanych działań optymalizacyjnych z Meta Superintelligence Labs ze względu na opóźnienia porównywalne z prędkością światła. Sieć obejmuje miliony mil światłowodów, dziesiątki tysięcy przełączników i miliony elementów optycznych, od wtykowych modułów FR4 LITE 2x400G wewnątrz budynków po koherentną optykę 800G-ZR dla łączy o długości ponad 10 km.
64 z 72 procesorów graficznych wykonuje pracę
Przejście z domeny NVLink z ośmioma GPU generacji H100 na NVL72 zwiększyło promień wybuchu awarii dziewięciokrotnie, a Meta planuje teraz pojemność wokół szafy z 72 GPU. Ponieważ paralelizm treningowy najlepiej odwzorowuje rozmiary grup potęg dwójki, każda domena NVL72 obsługuje segment z 64 GPU i przechowuje pozostałe osiem GPU jako zapasowe w szafie. W przypadku awarii GPU, zapasowy przejmuje jego funkcję, a zadanie jest wznawiane od ostatniego punktu kontrolnego bez oczekiwania na naprawę. W przypadku awarii całej szafy Meta zachowuje około 2 procent dodatkowych szaf w rezerwie.
W przypadku treningu z 32 768 procesorami GPU: 523 szafy NVL72, czyli 37 656 procesorów GPU, około 13 procent powyżej aktywnego obszaru, z czego 11 punktów przypada na geometrię 64 z 72 wycinków. Obciążenie integralności sygnału, które stoi za tą niezawodnością, jest znaczne; pojedyncza domena NVL72 przenosi 5,184 dostrojonych łączy różnicowych o przepustowości 200 Gb/s, z których każde przechodzi przez układy SerDes procesorów GPU, płytki PCB tacek obliczeniowych, kasety kablowe i interfejsy tacek przełączników.
Dwie ścieżki odzyskiwania obsługują występujące błędy. Gdy awarię można odizolować od jednej repliki równoległej, tolerancja błędów Meta uwzględniająca paralelizm przełącza tę replikę w tryb offline, podczas gdy reszta klastra powtarza krok i kontynuuje szkolenie, a segment uruchamia się ponownie na hostach zapasowych i resynchronizuje. Większe błędy odsyłają całe zadanie z powrotem do ostatniego punktu kontrolnego, dlatego punkty kontrolne Meta są często tworzone, asynchronicznie zapisując stan modelu, w tym gradienty i dane optymalizatora, w pamięci masowej wielowarstwowej z punktami kontrolnymi delta i etapowaniem w pamięci, aby ograniczyć wpływ na przepustowość.
99-procentowy spadek przerw
Pomimo postępu, jaki pokazują te liczby, Prometheus początkowo nie był stabilny. W połowie 2025 roku, w fazie początkowej, liczba przerw osiągnęła szczyt, sięgając prawie 1,000 zdarzeń na 8,000 GPU dziennie. Rok pracy międzyfunkcyjnej pozwolił na zmniejszenie tej liczby o 99 procent, a klaster obsługuje obecnie wiele zadań szkoleniowych, obejmujących dziesiątki tysięcy GPU, każde równolegle. Meta przypisuje sobie model współinżynierii z firmą NVIDIA, w którym zespoły NVIDIA pracują w siedzibie w New Albany, dzielą się danymi telemetrycznymi i prowadzą wspólne sesje triażowe, analizując każde zatrzymanie według jego pierwotnej przyczyny. Meta odpowiada za harmonogramowanie i poprawki infrastruktury, a NVIDIA za oprogramowanie układowe, diagnostykę sygnałów i obsługę pamięci.
Integralność sygnału NVLink była pierwszym wąskim gardłem w GB200. Przy ponad 600 000 połączeń NVLink w klastrze, łącza marginalne uruchamiały częste cykle odzyskiwania, dlatego Meta dodała ciągłą telemetrię, automatyczne flagowanie i testy diagnostyczne L11, aby znaleźć słabe łącza przed rozpoczęciem produkcji. Błędy pamięci w HBM i LPDDR stały się główną przyczyną, gdy GB300 pojawił się z większą pamięcią, a odpowiedzią na to są udoskonalone ustawienia oprogramowania układowego HBM, czyszczenie pamięci, ulepszony algorytm korekcji błędów LPDDR oraz predykcyjne wycofanie z eksploatacji urządzeń ulegających degradacji. Stan przełącznika jest monitorowany z dokładnością do milisekund, a zdarzenia łącza w warstwie agregacji są przekierowywane sprzętowo bez przerywania ruchu GPU.
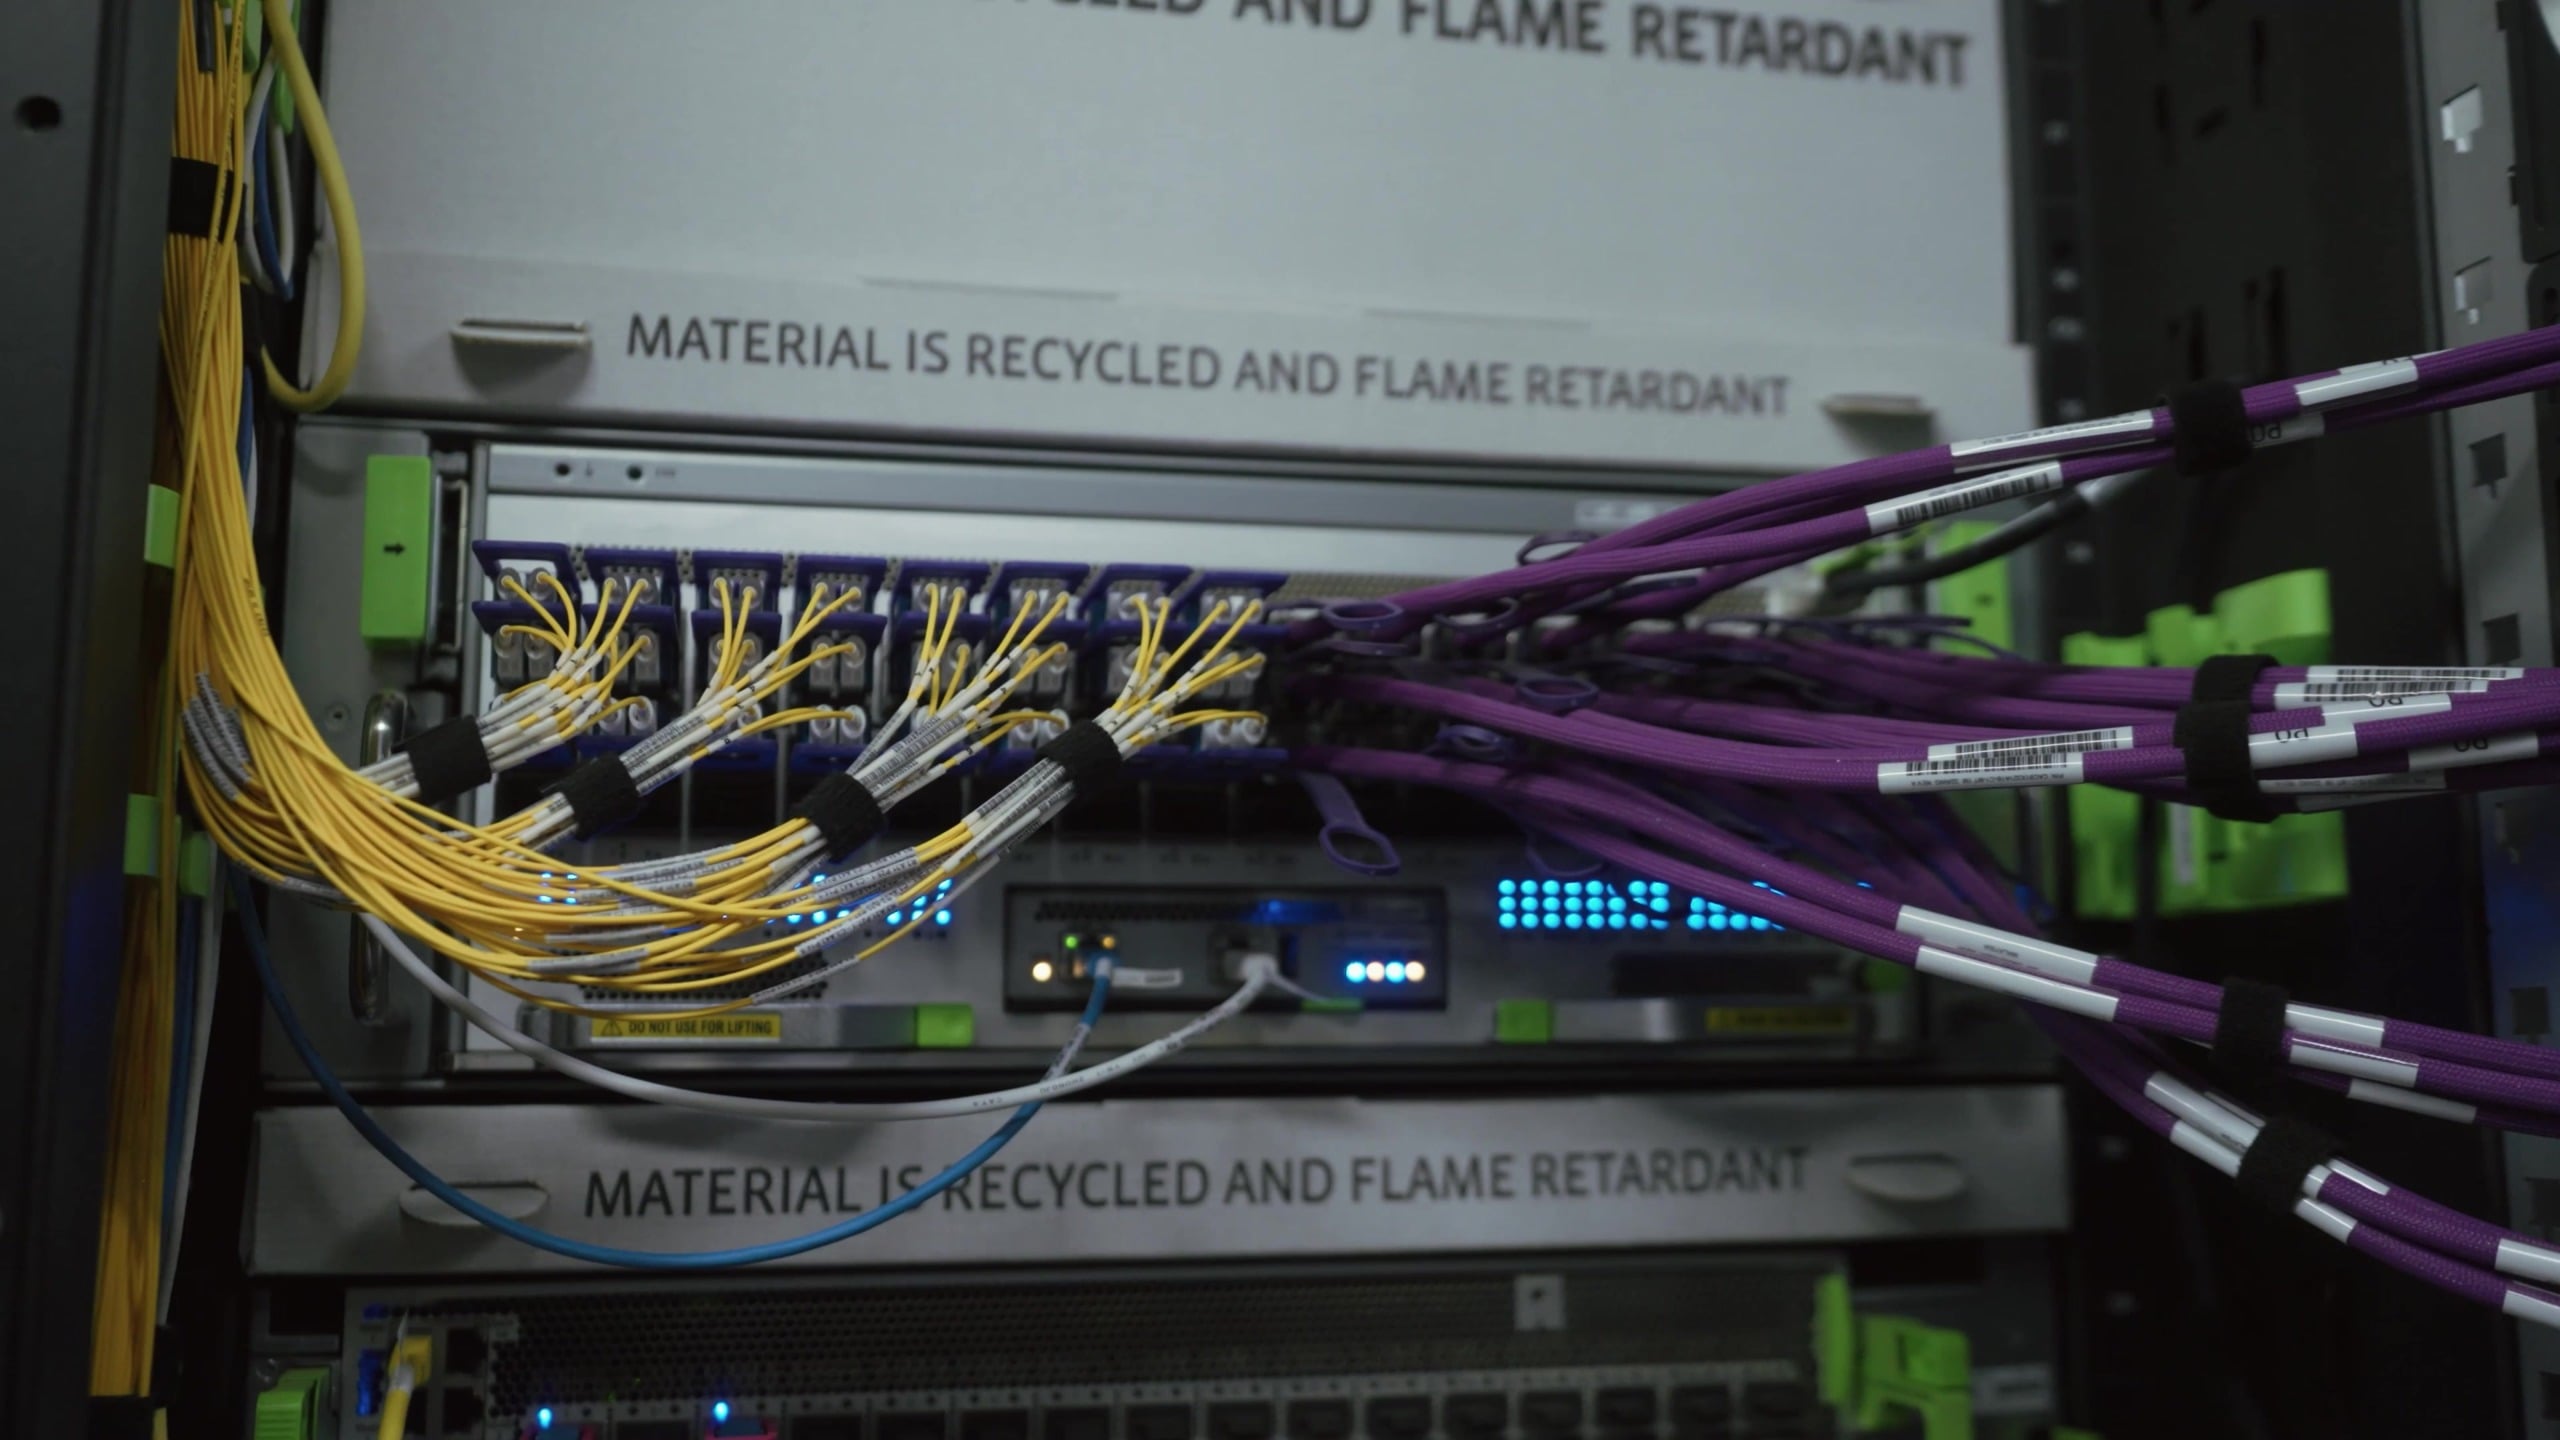
Obsługa setek tysięcy akceleratorów pierwszej generacji sprawiła, że dojrzewanie sprzętu stało się odrębną dyscypliną. Automatyzacja oprogramowania układowego Meta pozwala na wdrożenie poprawek sterowników i oprogramowania układowego do ponad 100 000 procesorów graficznych w ciągu kilku godzin, a czas aktualizacji pojedynczego modułu w systemie P90 skrócił się z ponad siedmiu godzin na początku wprowadzenia GB200 do dwóch godzin. Testy obciążeniowe dostarczania energii sprawdzają, jak moduły zasilaczy i regulatory napięcia zachowują się pod obciążeniem 1,400 W pojedynczego procesora graficznego, a każdy naprawiony system jest poddawany kwarantannie do czasu pomyślnego zatwierdzenia. Marcowy sprint Meta na rzecz stabilności zsynchronizował poprawki w całym stosie.
Przejścia mocy i mieszana flota chłodnicza
Synchroniczne szkolenie przenosi moc w synchronizacji, a dziesiątki tysięcy procesorów graficznych, które wspólnie wchodzą w fazę obliczeniową lub komunikacyjną, zmieniają obciążenie klastra o 30–40 procent, a uruchomienie lub wstrzymanie dużego zadania może przesunąć moc o dziesiątki megawatów w ciągu kilku sekund. Dynamo Dimmer, platforma zarządzania energią w całym klastrze firmy Meta, stopniowo ogranicza moc procesora graficznego, gdy klaster zbliża się do maksymalnego limitu mocy, zapewniając ciągłość pracy zadań. Moduły zasilania awaryjnego na poziomie szafy rack absorbują skoki napięcia, tace kondensatorów wygładzają szczyty, magazyny energii na skalę całego obiektu znajdują się za nimi, a Meta koordynuje profil obciążenia z dostawcami energii.
Chłodzenie różni się w zależności od budynku, ponieważ Prometheus został szybko zmontowany w centrach danych z otwartą przestrzenią, strukturach szybkiego wdrażania, dzierżawionej pojemności i specjalnie zbudowanym budynku AI. Starsze budynki wykorzystują modułowe chłodzenie cieczą wspomagane powietrzem; budynek zoptymalizowany pod kątem AI wykorzystuje chłodzenie cieczą w obiegu zamkniętym, co Meta opisuje jako najefektywniejszy sposób chłodzenia serwerów GPU i najbardziej energooszczędny. Meta udostępniła projekty, takie jak IcePack, swój chłodzony cieczą stojak sieciowy, za pośrednictwem OCP. Aby zobaczyć, jak wygląda wdrożenie znacznie mniejszego systemu GB300 NVL72 z chłodzeniem cieczą, zobacz platformę testową GAIFA firmy Giga Computing.
Następny jest Hyperion
Meta będzie nadal rozbudowywać Prometheusa, łącząc szafy GB300 NVL72 i Vera Rubin NVL72, przy czym Vera Rubin będzie dostępna za pośrednictwem platformy San Miguel w istniejącej strukturze sieciowej. Doświadczenia z New Albany są wykorzystywane przez Hyperion, superklastr, który Meta projektuje od podstaw w Richland Parish w Luizjanie, z chłodzeniem cieczą w obiegu zamkniętym, pełną łącznością z siecią za pośrednictwem Entergy oraz projektami sieci nowej generacji. Meta deklaruje, że pokrywa pełny koszt energii w obu lokalizacjach i dopasowuje jego zużycie do nowej, czystej i odnawialnej generacji.
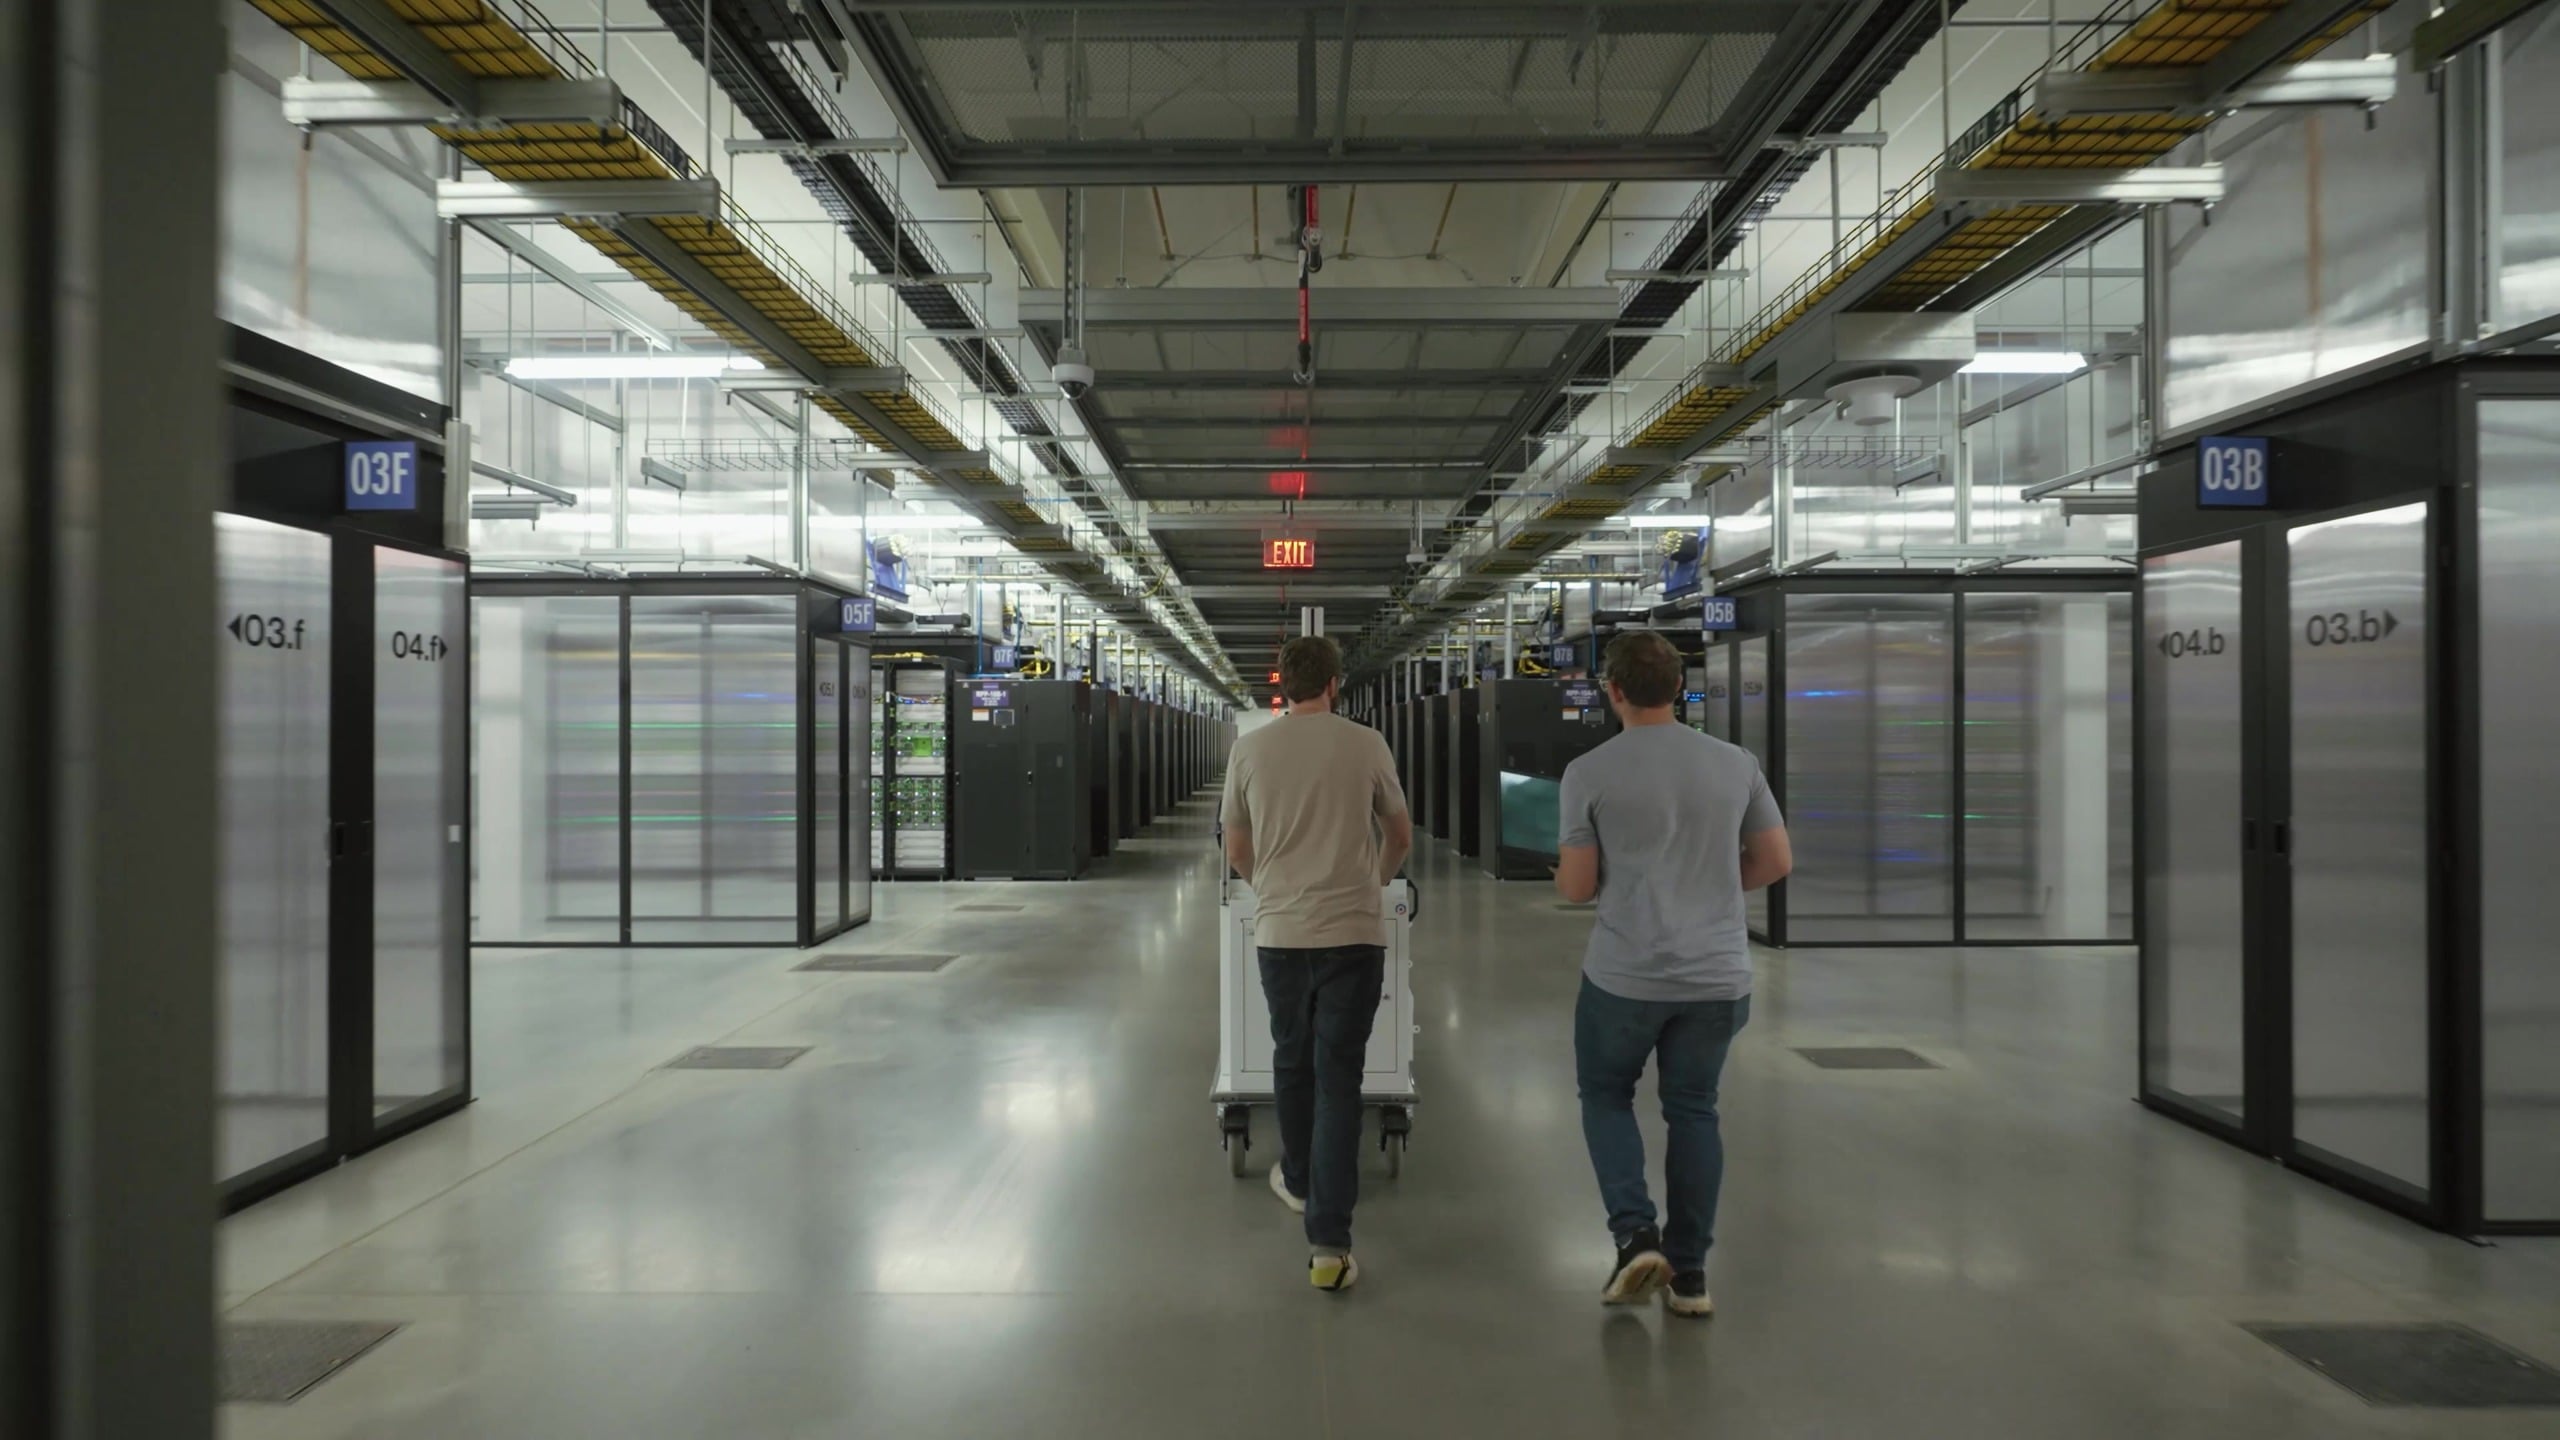
Większość opublikowanych przez Meta danych to szczegóły operacyjne, które firmy zajmujące się hiperskalarnością zazwyczaj zachowują dla siebie: konfiguracja zapasowego GPU, częstotliwość przerw, czas wdrażania oprogramowania sprzętowego i powody wyboru konfiguracji Ariel. Głównym założeniem jest to, że w tej skali sprzęt to dopiero punkt wyjścia, a praca, która przekształca setki tysięcy GPU w użyteczną pojemność szkoleniową, to praca w sieci, odporność na błędy i telemetria. Dla przedsiębiorstw planujących wdrożenie sztucznej inteligencji na dużą skalę, to dogłębne omówienie Meta stanowi dobry punkt wyjścia, aby przynajmniej zrozumieć, gdzie mogą pojawić się problemy, dzięki czemu organizacje będą mogły planować z wyprzedzeniem całe swoje centrum danych.



 Amazon