

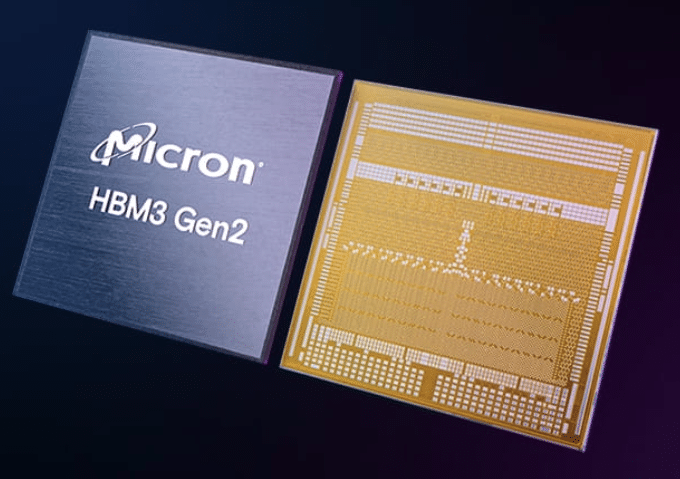
Firma Micron Technology, Inc. zaprezentowała nową generację pamięci o wysokiej przepustowości – HBM3 Gen2. To zaawansowane rozwiązanie pamięciowe, charakteryzujące się bezprecedensowymi parametrami, przewyższającymi poprzednie wersje, ma potencjał, by zrewolucjonizować sposób, w jaki przedsiębiorstwa wdrażają i wykorzystują sztuczną inteligencję.
Doładowanie generatywnej sztucznej inteligencji
Generatywna sztuczna inteligencja i modele LLM są w dużym stopniu uzależnione od ilości pamięci, jaką można zapewnić na potrzeby treningu i wnioskowania. Wydajność tych modeli sztucznej inteligencji jest często uzależniona od efektywności zasobów obliczeniowych i pamięci. HBM3 Gen2 firmy Micron oferuje większą pojemność pamięci, obiecując lepszą ogólną wydajność i zwrot z inwestycji przedsiębiorstwa w zadania związane ze sztuczną inteligencją i dużymi zbiorami danych.
Dzięki ulepszeniu warstw, wzrost wydajności umożliwi szybsze szkolenie i zaoferuje bardziej responsywne zapytania podczas wnioskowania LLM. Ten skok w wydajności pamięci pomoże przedsiębiorstwom zbliżyć się o krok do wdrożeń AI, które będą mogły reagować szybciej i dostarczać bardziej precyzyjne wyniki.
„HBM3 Gen2 zapewnia większą pojemność pamięci, co przekłada się na lepszą wydajność i mniejsze obciążenie procesora, co przekłada się na szybsze szkolenie i bardziej responsywne zapytania podczas wnioskowania LLM, np. ChatGPT™.” – Micron
Głębokie uczenie się na szybkim pasie
Wraz z ciągłym przenikaniem sztucznej inteligencji do wszystkich sektorów – od biznesu i IT po naukę i medycynę – rośnie zapotrzebowanie na większe, bardziej zaawansowane modele sztucznej inteligencji. HBM3 Gen2 firmy Micron ma sprostać temu zapotrzebowaniu, zapewniając wydajne rozwiązanie pamięci, które równoważy wydajność, koszty i zużycie energii. Dzięki naciskowi na efektywność energetyczną, która zwiększa wydajność na wat, najnowsze rozwiązanie firmy Micron, po wdrożeniu w procesorach graficznych, układach ASIC i procesorach, pomoże skrócić czas szkolenia i ciągłego dostrajania modeli LLM, umożliwiając zgodne z przepisami wdrożenia takich modeli w przedsiębiorstwach.
Wspieranie obliczeń o wysokiej wydajności
HBM3 Gen2 będzie istotnym atutem nie tylko dla sztucznej inteligencji, ale także dla bardziej tradycyjnych obliczeń o wysokiej wydajności. Naukowcy i badacze zajmujący się rozwiązywaniem złożonych problemów, takich jak modelowanie czy symulacje, wykorzystujących HPC, pracują z ciągle rosnącymi zbiorami danych. Nowe rozwiązanie pamięciowe firmy Micron, o większej pojemności, oferuje lepszą wydajność poprzez redukcję konieczności dystrybucji danych do wielu węzłów, przyspieszając tym samym innowacje w kluczowych obszarach poprzez redukcję złożoności lub zwiększenie gęstości szaf.
„Micron HBM3 Gen2 zapewnia większą pojemność pamięci i poprawia wydajność poprzez redukcję konieczności dystrybucji danych pomiędzy wieloma węzłami, co przyspiesza tempo innowacji”.
Wiodące w branży specyfikacje, maksymalizacja wydajności
Micron HBM3 Gen2 oferuje imponujące parametry, które przesuwają granice wydajności pamięci. Dzięki przepustowości pamięci przekraczającej 1.2 TB/s, o 50% większej pojemności pamięci na 8-calowym sześcianie o pojemności 24 GB i ponad 2.5-krotnemu wzrostowi wydajności na wat, HBM3 Gen2 został zaprojektowany z myślą o spełnieniu wymagających potrzeb w zakresie sztucznej inteligencji (AI) i obciążeń HPC.
Warto zauważyć, że większa przepustowość i pojemność pamięci HBM3 Gen2 pozwalają na trenowanie modeli AI z większą precyzją i dokładnością. Pozwala to również na skrócenie czasu trenowania o ponad 30% i zwiększenie liczby zapytań o ponad 50% dziennie. Takie udoskonalenia zrewolucjonizują cykl życia modeli LLM i zwiększą potencjał zastosowań AI w przedsiębiorstwach.
Z niecierpliwością czekamy na możliwość testowania w laboratorium układu HBM3 Gen2 firmy Micron, ale może to potrwać jeszcze trochę czasu. Stanowi on znaczący krok naprzód w dziedzinie rozwiązań pamięciowych i ma zapewnić bardzo potrzebne wsparcie dla implementacji sztucznej inteligencji (AI) i obliczeń o wysokiej wydajności. Minie jednak sporo czasu, zanim zobaczymy go w gotowych rozwiązaniach. Do tego czasu będziemy musieli z niecierpliwością czekać na to, co przyniesie przyszłość.


 Amazon