

Firma MinIO ogłosiła MemKV, magazyn pamięci kontekstowej zaprojektowany w celu rozwiązania problemu narastających wąskich gardeł w środowiskach wnioskowania AI na dużą skalę. MemKV, pozycjonowany jako drugi podstawowy komponent oferty firmy, obok AIStor , rozszerza infrastrukturę danych MinIO o warstwę pamięci, zapewniając trwały, współdzielony kontekst dla agentowych obciążeń AI działających w klastrach GPU.
W miarę jak systemy sztucznej inteligencji ewoluują od interakcji opartych na pojedynczych odpowiedziach do wieloetapowego wnioskowania i wykonywania zadań, utrzymanie kontekstu w cyklach wnioskowania staje się kluczowe. W obecnych architekturach kontekst jest często tracony z powodu ograniczonej pojemności warstw pamięci sąsiadujących z GPU, takich jak HBM i DRAM. Zmusza to GPU do ponownego obliczania wcześniej wygenerowanego kontekstu, co zwiększa opóźnienia, wykorzystanie mocy obliczeniowej i zużycie energii. MinIO charakteryzuje to jako obciążenie związane z ponownym obliczaniem, które rośnie w dużej skali, szczególnie w środowiskach hiperskalowych i chmurowych.
Rozwiązanie MemKV ma na celu złagodzenie tego problemu poprzez zapewnienie współdzielonej, trwałej warstwy pamięci, umożliwiającej odczyt danych z dokładnością do mikrosekundy w skali petabajtów. Utrzymując kontekst w operacjach wnioskowania, platforma redukuje redundantne obliczenia i poprawia ogólną wydajność systemu. W wewnętrznych testach porównawczych MinIO raportuje poprawę czasu do pierwszego tokenu na poziomie współbieżności produkcyjnej. W reprezentatywnym wdrożeniu ze 128 procesorami graficznymi i oknami kontekstowymi o pojemności 128 tys. tokenów, wykorzystanie procesorów graficznych wzrosło z około 50% do ponad 90%, co przełożyło się na znaczne roczne oszczędności kosztów obliczeniowych.
Kierownictwo MinIO zauważyło, że obciążenie związane z rekalkulacją było historycznie maskowane w mniejszych wdrożeniach, ale w większej skali staje się strukturalnym ograniczeniem. Wraz ze wzrostem klastrów GPU rosną koszty wielokrotnego generowania kontekstu, zarówno pod względem zużycia energii, jak i wymagań infrastrukturalnych. W związku z tym, do stabilnego działania sztucznej inteligencji niezbędne są specjalnie zaprojektowane systemy pamięci.
Rozwiązywanie problemu kompromisu między pamięcią a skalą
Tradycyjna infrastruktura AI wymusza kompromis między szybkością a skalowalnością. Wysokowydajne warstwy pamięci, takie jak HBM i DRAM, zapewniają mikrosekundowe opóźnienia, ale są ograniczone pojemnościowo i drogie. Z kolei systemy pamięci masowej oferują skalowalność, ale wprowadzają milisekundowe opóźnienia, co nie nadaje się do wnioskowania w czasie rzeczywistym i wnioskowania długokontekstowego.
Rozwiązanie MemKV zostało zaprojektowane, aby wypełnić tę lukę, wprowadzając współdzieloną warstwę pamięci, która łączy dostęp o niskim opóźnieniu z dużą pojemnością. Platforma, zbudowana do działania na platformie NVIDIA BlueField-4 STX i zintegrowana z NVIDIA Dynamo i NIXL, umożliwia całemu klastrowi GPU dostęp do wspólnej puli danych kontekstowych z prędkością dostosowaną do wymagań inferencji. Takie podejście eliminuje konieczność przenoszenia kontekstu między różnymi warstwami pamięci i pamięci masowej, zmniejszając opóźnienia i poprawiając przepustowość.
Architektura zoptymalizowana pod kątem obciążeń wnioskowania
Technologia MemKV została zaprojektowana specjalnie dla ścieżki danych wnioskowania i jest zgodna z opisem warstwy G3.5 w hierarchii pamięci GPU opracowanym przez MinIO. Zapewnia ona pojemność na poziomie petabajtów w infrastrukturze opartej na NVMe, zachowując jednocześnie parametry dostępu na poziomie mikrosekund, skutecznie oddzielając skalę pamięci od zasobów obliczeniowych GPU.
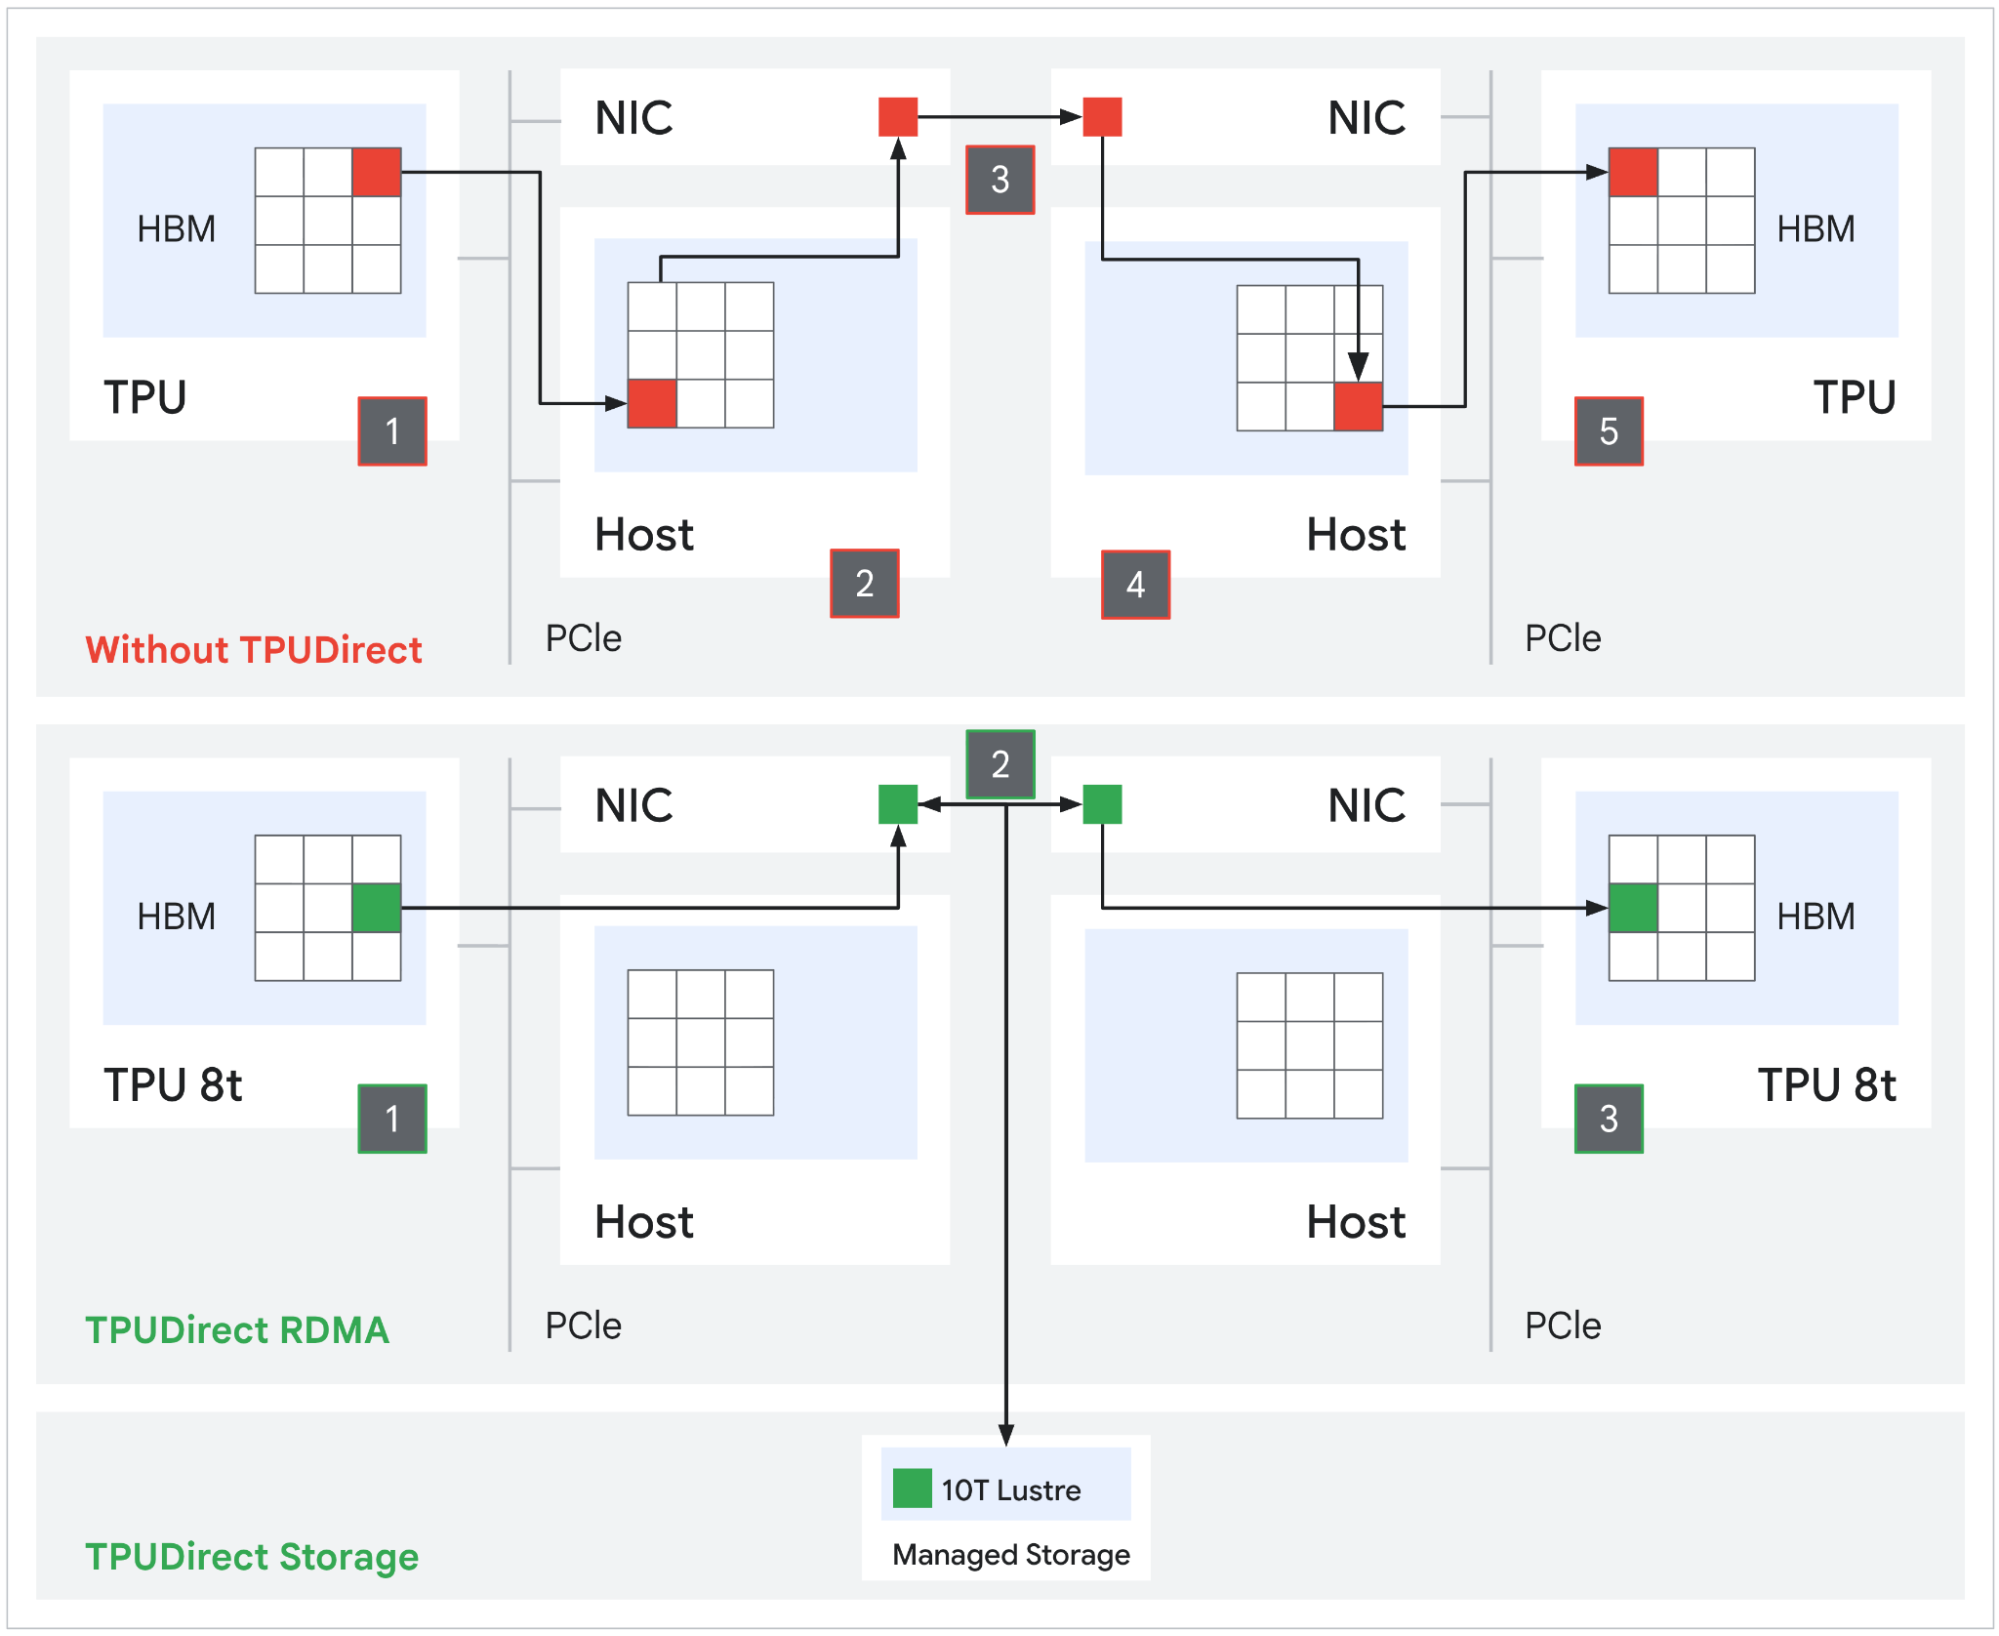
System unika tradycyjnych abstrakcji pamięci masowej, przesyłając dane bezpośrednio z NVMe do ścieżki danych AI za pośrednictwem kompleksowego transportu RDMA . Eliminuje to obciążenie związane z protokołami HTTP, translacją systemów plików i pośredniczącymi serwerami pamięci masowej, które są powszechne w architekturach obiektowych i plikowych.
Źródło: Google
Kluczowe elementy architektury obejmują natywne wykonywanie na platformie NVIDIA BlueField-4 STX jako binarny kod ARM64 osadzony w warstwie pamięci masowej, co zmniejsza zależność od zewnętrznych węzłów pamięci masowej x86. Transfer danych odbywa się za pośrednictwem protokołu RDMA z pamięci GPU do NVMe, z pominięciem konwencjonalnych stosów pamięci masowej. Technologia MemKV wykorzystuje również większe rozmiary bloków, od 2 MB do 16 MB, zoptymalizowane pod kątem przepustowości GPU, zamiast tradycyjnych bloków pamięci masowej o rozmiarze 4 KB. Wydajność sieciowa jest zgodna z nowoczesnymi, szybkimi strukturami, w tym NVIDIA Spectrum-X Ethernet i PCIe Gen6, umożliwiając przesyłanie danych w klastrze z prędkością zbliżoną do prędkości łącza.
Dostępność:
MinIO MemKV jest dostępny od ręki.


 Amazon