

Podczas konferencji GTC 2026 w San Jose, prezes NVIDIA, Jensen Huang, wygłosił przemówienie, w którym przedstawił platformę infrastruktury AI nowej generacji firmy oraz szereg zapowiedzi dotyczących partnerstw w zakresie układów scalonych, systemów, oprogramowania i ekosystemu. Z ponad 30 000 uczestników z ponad 190 krajów, konferencja GTC 2026 była miejscem największej odnowy platformy NVIDIA od czasu wprowadzenia na rynek platformy Blackwell, której punktem kulminacyjnym było pełne wdrożenie produkcyjne architektury Vera Rubin oraz integracja technologii Groq 3 LPU z ekosystemem centrów danych NVIDIA. Jak powiedział Huang, nadszedł punkt zwrotny w rozwoju sztucznej inteligencji opartej na agentach, a Vera Rubin zapoczątkowuje to, co NVIDIA określa mianem największej rozbudowy infrastruktury w historii.
Centralnym tematem wystąpienia było pojawienie się czwartego prawa skalowania sztucznej inteligencji: skalowania agentowego, w którym systemy sztucznej inteligencji komunikują się nie tylko z ludźmi, ale także z innymi agentami sztucznej inteligencji, napędzając wykładniczy popyt na wnioskowanie wielkokontekstowe o niskich opóźnieniach na niespotykaną dotąd skalę. NVIDIA pozycjonowała platformę Vera Rubin jako fundament infrastruktury, aby sprostać temu nowemu wyzwaniu. Łączy ona siedem współprojektowanych układów w pięciu nowych systemach rackowych, zbudowanych specjalnie dla fabryki sztucznej inteligencji. Platforma zyskała również poparcie laboratoriów Frontier AI: Dario Amodei, dyrektor generalny i współzałożyciel Anthropic, zauważył: „Przedsiębiorstwa i deweloperzy używają Claude do coraz bardziej złożonego rozumowania, obsługi agentowych przepływów pracy i podejmowania decyzji o znaczeniu krytycznym. Wymaga to infrastruktury zdolnej do dotrzymania kroku. Platforma Vera Rubin firmy NVIDIA zapewnia nam moc obliczeniową, sieci i projektowanie systemów, aby móc dostarczać rozwiązania, jednocześnie zwiększając bezpieczeństwo i niezawodność, na których polegają nasi klienci”. Sam Altman, dyrektor generalny OpenAI, stwierdził: „Infrastruktura NVIDIA to fundament, który pozwala nam nieustannie poszerzać granice sztucznej inteligencji. Dzięki NVIDIA Vera Rubin będziemy mogli uruchamiać wydajniejsze modele i agentów na masową skalę oraz dostarczać szybsze i bardziej niezawodne systemy setkom milionów ludzi”.
Platforma Very Rubin: Otwieranie granic sztucznej inteligencji agentowej
Bazując na architekturze Vera Rubin NVL72, zaprezentowanej po raz pierwszy na targach CES 2026, GTC 2026 rozszerzyło platformę o kompleksowy ekosystem fabryk AI w skali POD. NVIDIA przedstawia to jako przejście od oddzielnych układów scalonych i samodzielnych serwerów do w pełni zintegrowanych systemów rackowych, wdrożeń w skali pod i suwerennych fabryk AI. Platforma Vera Rubin łączy procesory NVIDIA Vera, procesory graficzne Rubin, przełączniki NVLink 6, karty sieciowe ConnectX-9 SuperNIC, jednostki DPU BlueField-4, przełączniki Ethernet Spectrum-6 oraz nowo zintegrowaną jednostkę LPU NVIDIA Groq 3. Wszystkie te elementy zostały zaprojektowane z myślą o działaniu jako jeden, zunifikowany superkomputer AI z głębokim współprojektowaniem w zakresie obliczeń, sieci i pamięci masowej, wspieranym przez ekosystem ponad 80 partnerów MGX z globalnym łańcuchem dostaw.

NVIDIA twierdzi, że platforma zapewnia do 10 razy większą przepustowość wnioskowania na wat i jedną dziesiątą niższy koszt na token w porównaniu z generacją Blackwell w pełnym spektrum obciążeń AI. Do trenowania dużych modeli Mixture-of-Experts, Vera Rubin potrzebuje tylko jednej czwartej tej liczby procesorów GPU, aby osiągnąć porównywalną wydajność. NVL72 płynnie skaluje się z NVIDIA Quantum-X800 InfiniBand i Spectrum-X Ethernet, aby utrzymać wysokie wykorzystanie w rozległych klastrach GPU, jednocześnie skracając czas szkolenia i obniżając całkowity koszt posiadania.
Porównanie generacji: Blackwell Ultra kontra Vera Rubin NVL72
| Specyfikacja | GB300 NVL72 (Blackwell Ultra) | VR NVL72 (Vera Rubin) |
|---|---|---|
| Architektura obliczeniowa | ||
| Liczba GPU | 72 procesory graficzne Blackwell Ultra | 72 procesory graficzne Rubin |
| Liczba procesorów | 36 procesorów Grace | 36 procesorów Vera |
| Rdzenie procesora | 72 rdzenie ARM na procesor | 88 rdzeni ARM firmy Olympus na procesor |
| Wydajność AI | ||
| Wydajność wnioskowania FP4 | 1.44 eksaflopsów | 3.6 eksaflopsów |
| NVFP4 na GPU (wnioskowanie) | 20 PFLOPS | 50 PFLOPS |
| NVFP4 na GPU (szkolenie) | 10 PFLOPS | 35 PFLOPS |
| Pamięć | ||
| Typ pamięci GPU | HBM3e | HBM4 |
| Przepustowość pamięci GPU | ~8 TB/s | ~22 TB/s |
| Połączyć się | ||
| Generacja NVLink | NVLink 5 | NVLink 6 |
| Przepustowość NVLink (na GPU) | 1.8 TB / s | 3.6 TB / s |
| Przepustowość łącza NVLink w skali szafy | 130 TB / s | 260 TB / s |
| Sieci | ||
| Skalowalna karta sieciowa | ConnectX-8 (800 Gb/s) | ConnectX-9 (1.6 TB/s) |
| Połączenie CPU-GPU | NVLink-C2C (900 GB/s) | NVLink-C2C (1.8 TB/s) |
Produkty oparte na platformie Vera Rubin będą dostępne u partnerów od drugiej połowy 2026 roku. Wśród nich znajdą się wiodący dostawcy usług chmurowych: Amazon Web Services, Google Cloud, Microsoft Azure i Oracle Cloud Infrastructure, a także partnerzy NVIDIA Cloud: CoreWeave, Crusoe, Lambda, Nebius, Nscale i Together AI. Oczekuje się, że globalni producenci systemów, tacy jak Dell Technologies, HPE, Lenovo i Supermicro, dostarczą serwery oparte na produktach Vera Rubin, a także ASUS, Foxconn, GIGABYTE, Inventec, Pegatron, QCT, Wistron i Wiwynn.
Od CPX do LPX: jak przejęcie Groq przez firmę NVIDIA zmieniło przyspieszenie dekodowania
W zeszłym roku, podczas konferencji AI Infra Summit, firma NVIDIA ogłosiła szafę CPX w kilku konfiguracjach zaprojektowanych do przyspieszania zapytań wnioskowania długokontekstowego. Kiedy omawialiśmy tę zapowiedź, pojawiło się kilka pytań dotyczących faktycznej funkcji CPX. Na pierwszy rzut oka, choć była to interesująca koncepcja architektoniczna, CPX nie oferował niczego istotnego poza samym układem GPU Rubin, poza ewentualnym dodatkowym przyspieszeniem operacji związanych z koncentracją uwagi.
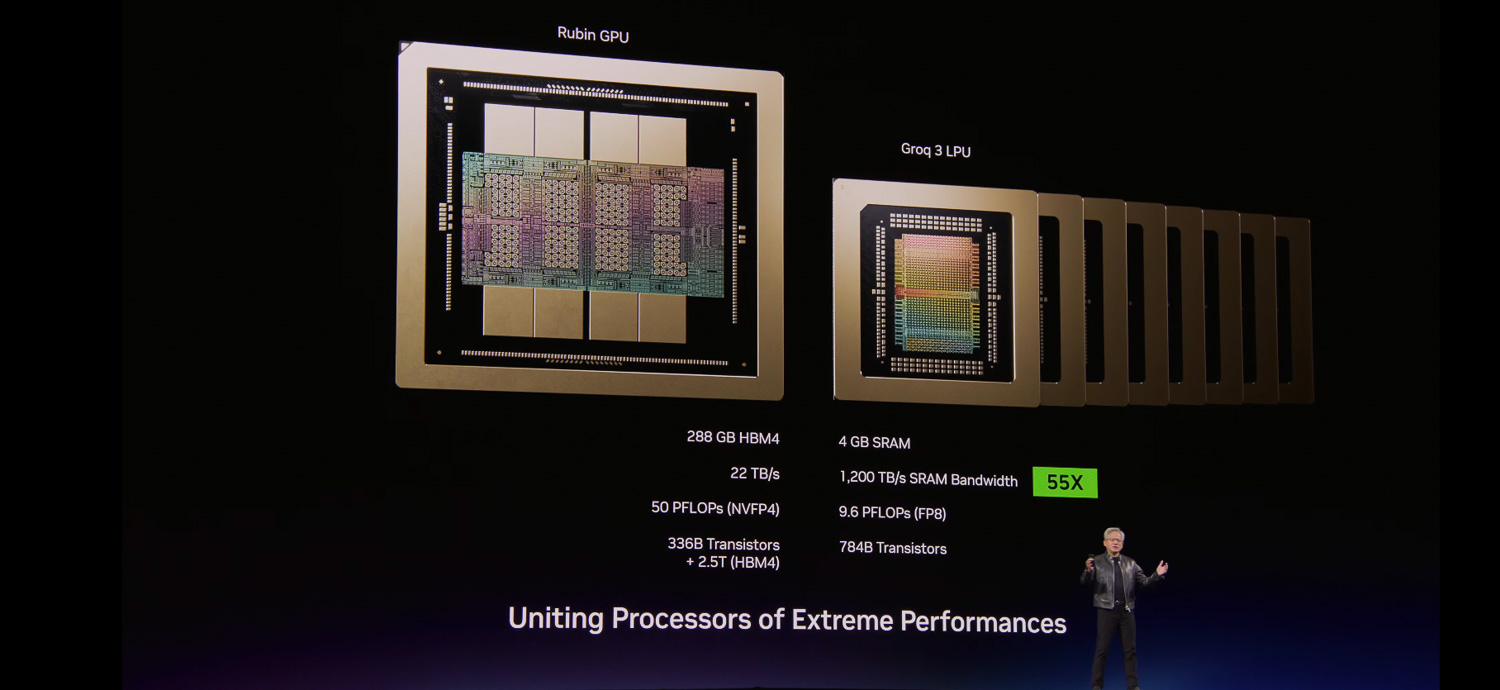
Następnie nastąpiło przejęcie Groq, które cieszyło się ogromną popularnością w branży i wywołało spekulacje na temat tego, jak NVIDIA zintegruje technologię LPU Groq z szerszą platformą Vera Rubin. NVIDIA wyjaśniła sytuację na targach GTC 2026, ogłaszając LPX. Z tego, co zaprezentowano, wynika, że koncepcja racka CPX ewoluowała w kierunku stojaka Groq 3 LPX, a pierwotne skupienie CPX na przetwarzaniu kontekstu ustąpiło miejsca fundamentalnie innej architekturze dekodowania i przyspieszania, zbudowanej na krzemie Groq.
Rubin GPU kontra Groq 3 LPU: uzupełniające się architektury
| Specyfikacja | GPU Rubin | Groq 3 LPU (LP30) |
|---|---|---|
| Typ pamięci | HBM4 | Ułożona pamięć SRAM |
| Pojemność pamięci (na chip) | 288 GB | 500 MB |
| Przepustowość pamięci | 22 TB / s | 150 TB / s |
| Moc: | Szkolenie o wysokiej przepustowości i wstępne wypełnianie | Dekodowanie tokenów o bardzo niskim opóźnieniu |
| Rozlokowanie | VR NVL72 (72 na stojak) | Stojak LPX (256 na stojak) |
| Łączna pamięć stojakowa | ~20.7 TB HBM4 | 128 GB pamięci SRAM |
| Skalowalna przepustowość (rack) | 260 TB/s NVLink 6 | 640 TB / s |
Pojedyncza szafa LPX mieści 256 jednostek LPU Groq 3. Każda jednostka LPU zawiera około 500 MB pamięci SRAM w stosie, co zapewnia około 128 GB łącznej pamięci SRAM na chipie i 640 TB/s skalowalnej przepustowości, zaprojektowanej specjalnie z myślą o przyspieszeniu dekodowania z ultraniskim opóźnieniem. Kontrast między tymi dwoma typami procesorów jest wyraźny: procesor graficzny Rubin zapewnia 288 GB pamięci HBM4 o przepustowości 22 TB/s, podczas gdy jednostka LPU wymienia pojemność na surową przepustowość, dostarczając 150 TB/s z puli pamięci SRAM na chip. Po wdrożeniu wspólnym z VR NVL72 za pośrednictwem niestandardowego połączenia opartego na Spectrum X, obie szafy mają wspólnie przetwarzać każdy token dekodowania, a dekodowanie uwagi istniejące w warstwach Rubin i Feed Forward jest przenoszone na jednostki LPU. Zoptymalizowana pod kątem modeli bilionów parametrów i kontekstu miliona tokenów, współprojektowana architektura LPX łączy się z Vera Rubin, aby zmaksymalizować wydajność w zakresie zasilania, pamięci i mocy obliczeniowej. Szafa LPX jest w pełni chłodzona cieczą, oparta na infrastrukturze MGX i będzie dostępna w drugiej połowie 2026 roku, równolegle z szerszą premierą Vera Rubin.

Co ważne, NVIDIA potwierdziła, że nie są wymagane żadne zmiany w CUDA. LPU działa jako akcelerator istniejącego stosu CUDA działającego na platformie Vera i NVL72, a obliczenia są transparentnie odciążane w oparciu o liczbę tokenów. Podczas sesji pytań i odpowiedzi GTC, NVIDIA opisała LPU jako „wzmacniacz modelu dekodowania” i wyjaśniła, że będzie „ściśle współpracować z laboratoriami sztucznej inteligencji i twórcami modeli pionierskiej sztucznej inteligencji, którzy wdrażają te modele o bilionach parametrów”, aby umożliwić obsługę kolejnej generacji modeli premium i ultra-premium. Wielu założycieli i inżynierów Groq dołączyło do NVIDIA, a współpraca między tymi dwoma zespołami jest podobno doskonała, ponieważ realizują plan działania Groq, aby wbudować go w infrastrukturę MGX. Wdrożenie LPX będzie początkowo koncentrować się na twórcach modeli i dostawcach usług, a nie na szerokiej dostępności OEM. Z niecierpliwością czekamy na rzeczywistą poprawę wydajności dzięki integracji NVIDIA i Groq.
Vera CPU Rack: specjalnie zaprojektowane obliczenia do uczenia się przez wzmacnianie i obciążeń agentowych
Dlaczego sztuczna inteligencja oparta na agentach wymaga nowej klasy procesorów
Aby zrozumieć, dlaczego NVIDIA zbudowała dedykowany rack procesorów, warto zrozumieć, jak działa uczenie ze wzmocnieniem (RL) w fazie posttreningowej nowoczesnego rozwoju sztucznej inteligencji. Posttrening to etap po wstępnym wytrenowaniu modelu na ogromnym zbiorze danych, gdzie model jest udoskonalany i specjalizowany pod kątem docelowych przypadków użycia.
W modelu uczenia się przez wzmacnianie pętla treningowa obejmuje trzy podstawowe komponenty: model polityki (model poddawany treningowi), środowisko, w którym model podejmuje działania i otrzymuje informacje zwrotne, oraz sygnał nagrody, który ocenia jakość tych działań. Model polityki generuje potencjalne wyniki, które są następnie wykonywane w środowisku, oceniane przez model nagrody, a powstałe gradienty służą do aktualizacji polityki.
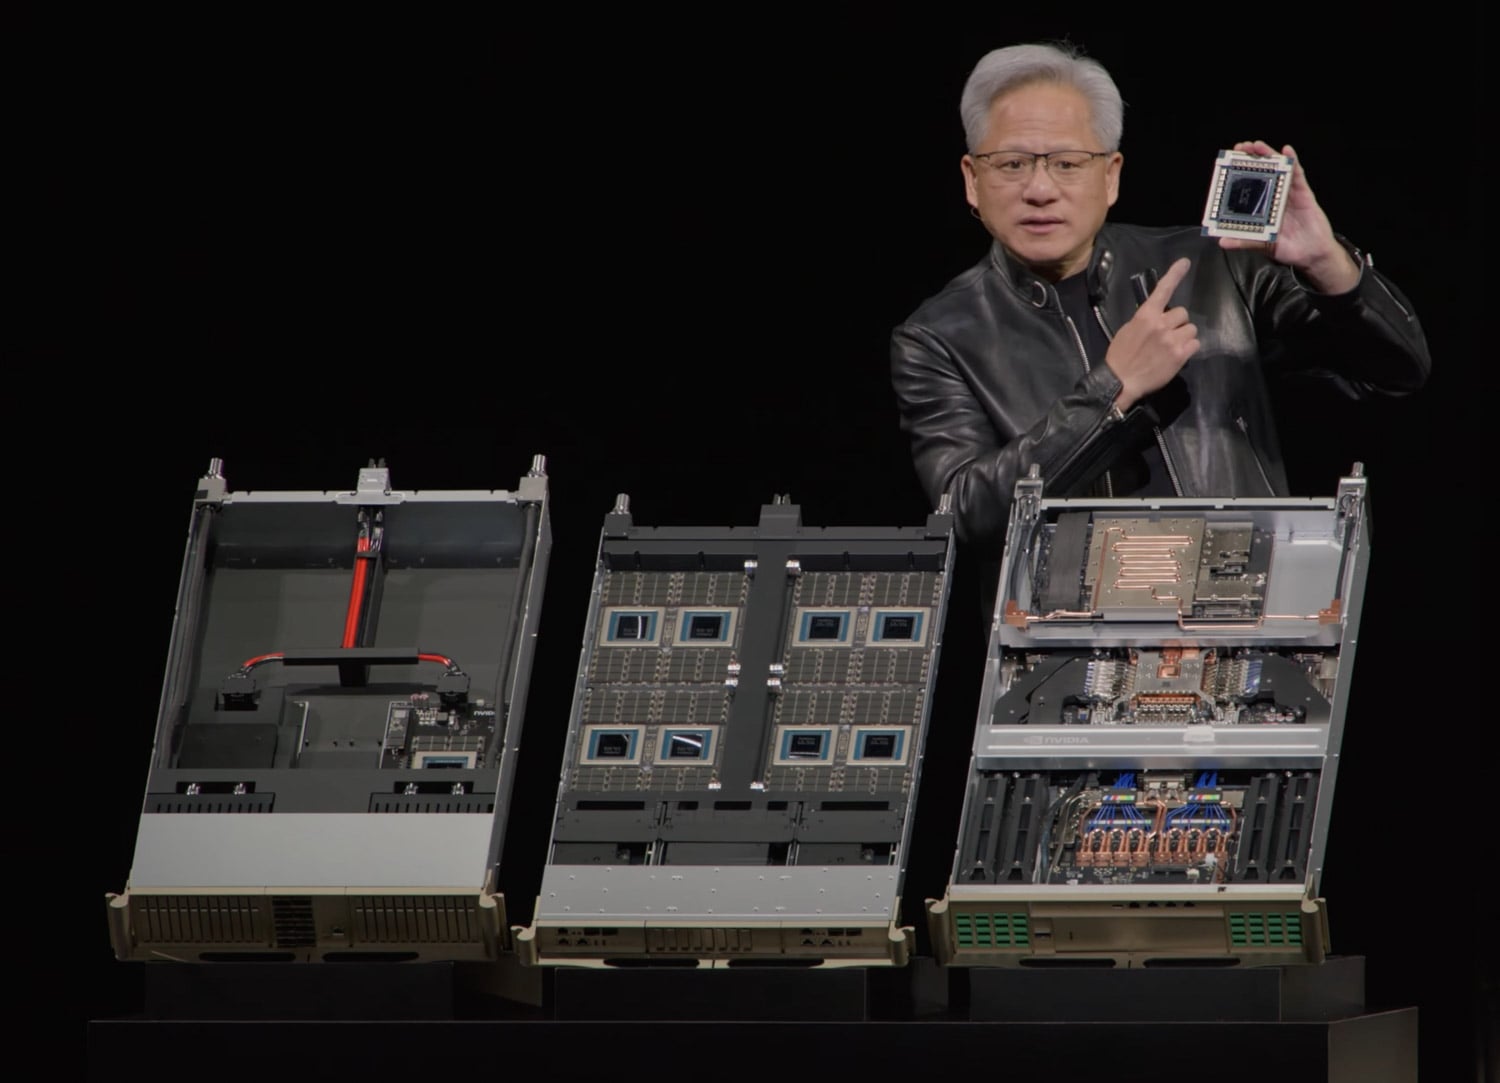
W przypadku obciążeń agentowych AI, to środowisko RL nie jest abstrakcyjną symulacją, lecz prawdziwą piaskownicą obliczeniową. Rozważmy na przykład pouczenie modelu kodowania agentowego za pomocą narzędzi takich jak Claude Code lub podobnych autonomicznych agentów kodujących. W tym systemie potrzebne są trzy odrębne pule obliczeniowe działające jednocześnie. Po pierwsze, istnieje pula treningowa akceleratorów GPU aktualizujących wagi modelu zasad. Po drugie, akceleratory inferencji uruchamiają bieżący punkt kontrolny modelu zasad, aby generować działania kandydujące (edycje kodu, wywołania narzędzi, operacje na plikach) na dużą skalę. Po trzecie, i co najważniejsze, istnieje duża pula konwencjonalnych obliczeń CPU, w której działają rzeczywiste środowiska RL. W tych środowiskach agenci wykonują wygenerowany kod, uruchamiają zestawy testów, wykonują wywołania narzędzi, wysyłają zapytania SQL, kompilują pliki binarne, wchodzą w interakcje z systemami plików i wykonują wszystkie operacje piaskownicy, które generują sygnały nagrody przekazywane z powrotem do pętli treningowej.
Skala tego konwencjonalnego zapotrzebowania na moc obliczeniową jest znacząca. Każde wykonanie z modelu reguł może wywołać dziesiątki sekwencyjnych wywołań narzędzi, z których każde musi zostać wykonane, ocenione i zwrócone przed przejściem do następnego kroku. Generując tysiące punktów danych równolegle w trakcie treningu, potrzebna jest ogromna flota szybkich procesorów, aby zapobiec zatrzymaniu klastra szkoleniowego GPU podczas wykonywania środowiska. Każde opóźnienie w puli piaskownicy procesorów bezpośrednio przekłada się na bezczynne cykle GPU i marnowanie mocy obliczeniowej podczas treningu. Ta sama dynamika dotyczy czasu wnioskowania wdrożonych systemów agentowych. Każde wywołanie narzędzia, kompilacja kodu i wykonanie piaskownicy wykonywane przez agenta to obciążenie procesora, które musi zostać wykonane wystarczająco szybko, aby zapewnić responsywność całego potoku agentowego. Jak ujęto w materiałach prasowych firmy NVIDIA, procesor nie tylko obsługuje model, ale go napędza.
Vera CPU Rack: odpowiedź firmy NVIDIA
Aby sprostać temu wymogowi, NVIDIA wprowadziła na rynek procesor Vera, który firma nazywa pierwszym na świecie procesorem specjalnie zaprojektowanym dla ery sztucznej inteligencji opartej na agentach i uczeniu maszynowym. Vera CPU Rack to dedykowany system o konstrukcji rack, zawierający 256 chłodzonych cieczą procesorów Vera, zdolnych do obsługi ponad 22 500 współbieżnych środowisk procesorowych, z których każde działa niezależnie z pełną wydajnością. Fabryki AI mogą szybko wdrażać i skalować się do dziesiątek tysięcy równoczesnych instancji i narzędzi agentowych w jednej szafie rack. Szafa rack oferuje 400 TB pamięci całkowitej, 300 TB/s łącznej przepustowości pamięci i 64 jednostki DPU BlueField-4, które są kompatybilne z ekosystemami Vera Rubin i DGX oraz zbudowane w oparciu o modułową architekturę referencyjną NVIDIA MGX.
Sam procesor Vera zbudowany jest na 88 rdzeniach Olympus, zaprojektowanych przez firmę NVIDIA i w pełni kompatybilnych z architekturą Armv9.2. Każdy rdzeń obsługuje dwa zadania jednocześnie, wykorzystując technologię NVIDIA Spatial Multithreading. Podsystem pamięci drugiej generacji o niskim poborze mocy zbudowany jest na pamięci LPDDR5X, zapewniając przepustowość do 1.2 TB/s, czyli dwukrotnie większą przy o połowę mniejszym zużyciu energii w porównaniu z procesorami ogólnego przeznaczenia.
Poza parametrami wydajnościowymi, Vera Rack rozwiązuje również praktyczny problem łańcucha dostaw: organizacje obsługujące fabryki AI w skali dziesiątek tysięcy procesorów GPU potrzebują równie dużych flot procesorów do obsługi środowiska, a pozyskiwanie tak dużej liczby wydajnych procesorów x86 od AMD lub Intela w wymaganej skali i czasie może wiązać się ze znacznymi wyzwaniami w zakresie zaopatrzenia i dostępności. Pionowo zintegrowany rack procesorów NVIDIA upraszcza tę zależność.
Wśród klientów współpracujących z firmą NVIDIA przy wdrażaniu procesorów Vera znajdują się Alibaba, ByteDance, Meta i Oracle Cloud Infrastructure, a także CoreWeave, Crusoe, Lambda, Nebius, Nscale, Cloudflare, Together AI i Vultr. Partnerami produkcyjnymi są między innymi Dell Technologies, HPE, Lenovo, Supermicro, ASUS, Cisco, Foxconn, GIGABYTE i QCT.
BlueField-4 STX i NVIDIA CMX: architektura referencyjna pamięci kontekstowej wnioskowania
Podczas targów CES 2026 firma NVIDIA ogłosiła platformę pamięci kontekstowej wnioskowania (ICMS) – nową klasę infrastruktury pamięci masowej natywnej dla sztucznej inteligencji, stworzonej specjalnie do zarządzania pamięcią podręczną KV w wnioskowaniu LLM na dużą skalę. Podczas targów GTC 2026 firma NVIDIA zaprezentowała architekturę referencyjną, która ją napędza: BlueField-4 STX – modułową konstrukcję, która płynnie rozszerza pamięć GPU w całym podzespole, umożliwiając dostęp do kontekstu agentowego i danych pamięci podręcznej KV. Pierwszą implementacją STX w skali rack jest nowa platforma pamięci kontekstowej NVIDIA CMX, która rozszerza pamięć GPU o wysokowydajną warstwę kontekstową, umożliwiając skalowalne wnioskowanie i systemy agentowe.
Potrzeba dedykowanej warstwy pamięci masowej staje się oczywista, gdy przyjrzymy się skalowalności wnioskowania opartego na transformatorach. Każdy wygenerowany token musi obsłużyć wszystkie poprzednie tokeny za pośrednictwem mechanizmu uwagi, a pamięć podręczna klucz-wartość (KV) przechowuje wstępnie obliczone macierze uwagi do ponownego wykorzystania, unikając ponownego obliczania. Problem polega na tym, że rozmiar pamięci podręcznej KV rośnie wraz z długością sekwencji i rozmiarem partii. W środowiskach wielodostępnych, obsługujących tysiące równoczesnych żądań w oknach kontekstowych liczących miliony tokenów, zasoby GPU HBM ulegają wyczerpaniu. Operatorzy muszą albo zmniejszyć rozmiary partii, skrócić okna kontekstowe, albo dodać więcej GPU, co pogarsza ekonomikę lub wydajność.
BlueField-4 STX rozwiązuje ten problem, zapewniając współdzieloną warstwę pamięci masowej o wysokiej przepustowości, zaprojektowaną specjalnie dla wzorców dostępu do pamięci podręcznej KV, która znajduje się pomiędzy GPU HBM a konwencjonalną pamięcią masową. Jest ona akcelerowana przez platformę Vera Rubin i wykorzystuje zoptymalizowany pod kątem pamięci masowej procesor BlueField-4, który łączy procesor Vera z ConnectX-9 SuperNIC, a także sieć Ethernet Spectrum-X, NVIDIA DOCA i oprogramowanie NVIDIA AI Enterprise. NVIDIA twierdzi, że platforma CMX zapewnia do 5 razy większą przepustowość tokenów na sekundę w porównaniu z tradycyjnymi pamięciami masowymi, 4 razy wyższą efektywność energetyczną w porównaniu z tradycyjnymi architekturami procesorów w przypadku pamięci o wysokiej wydajności oraz 2 razy szybsze pobieranie danych w przypadku danych AI dla przedsiębiorstw.
NVIDIA wprowadza również DOCA Memos, nową platformę DOCA, która wzbogaca pamięć masową BlueField-4 o dedykowane przetwarzanie pamięci podręcznej KV, zwiększając przepustowość wnioskowania i jednocześnie znacząco poprawiając efektywność energetyczną. Rezultatem jest kontekst obejmujący cały POD, który zapewnia szybszą interakcję wieloetapową z agentami AI, bardziej skalowalne usługi AI i lepsze wykorzystanie infrastruktury. Rozwiązanie to jest powiązane z projektem open source NVIDIA Dynamo, który zapewnia platformę programistyczną do rozdzielonych faz wstępnego wypełniania/dekodowania, inteligentnego routingu i odciążania warstwowej pamięci masowej.
STX to architektura referencyjna, której NVIDIA nie sprzedaje bezpośrednio, lecz udostępnia partnerom ekosystemu pamięci masowej. Dostawcy pamięci masowej współprojektujący infrastrukturę nowej generacji na platformie STX to m.in. Cloudian, DDN, Dell Technologies, Everpure, Hitachi Vantara, HPE, IBM, MinIO, NetApp, Nutanix, VAST Data i WEKA. Partnerzy produkcyjni tworzący systemy oparte na platformie STX to m.in. AIC, Supermicro i QCT. Wiodące laboratoria sztucznej inteligencji i dostawcy usług chmurowych planujący wdrożenie platformy STX do pamięci kontekstowej to m.in. CoreWeave, Crusoe, IREN, Lambda, Mistral AI, Nebius, Oracle Cloud Infrastructure i Vultr. Platformy oparte na platformie STX będą dostępne u partnerów w drugiej połowie 2026 roku.
Projekt referencyjny fabryki DSX AI Vera Rubin i plan Omniverse DSX
Oprócz pojedynczych szaf i podów, NVIDIA ogłosiła projekt referencyjny Vera Rubin DSX AI Factory oraz ogólną dostępność NVIDIA Omniverse DSX Blueprint, co razem zapewnia kompleksowe ramy do projektowania, budowania i obsługi współprojektowanej infrastruktury AI, która maksymalizuje liczbę tokenów na wat i przyspiesza czas do pierwszej produkcji. Dzięki ścisłej integracji obliczeń, sieci, pamięci masowej, zasilania i chłodzenia, architektura zwiększa efektywność energetyczną i gwarantuje, że fabryki AI mogą niezawodnie skalować się przy ciągłych, intensywnych obciążeniach, zachowując jednocześnie maksymalny czas sprawności.
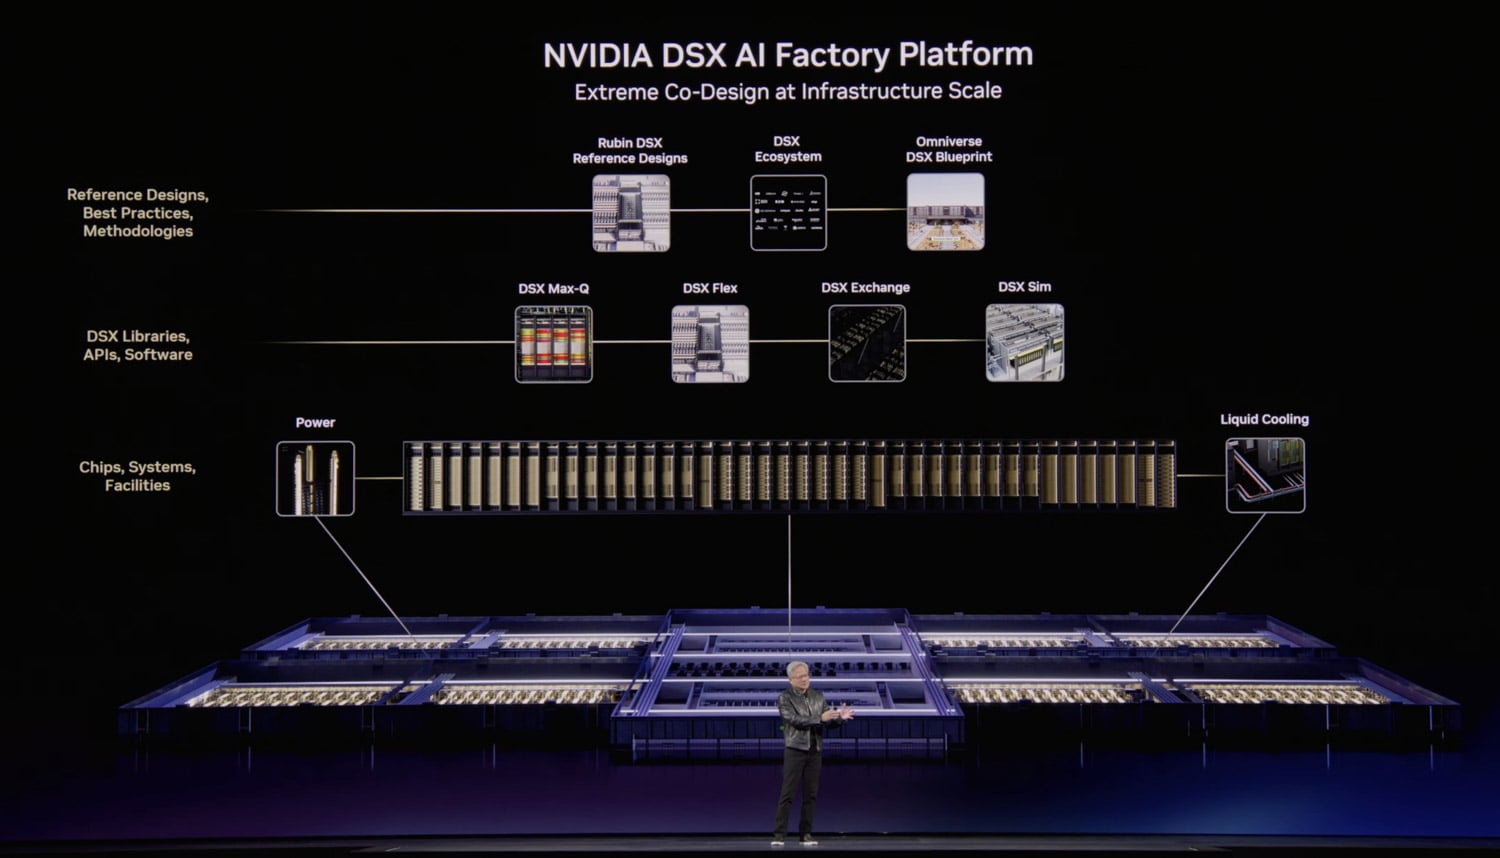
Stos oprogramowania Rubin DSX jest otwarty, modułowy i komponowalny, łącząc sprzęt klastra z systemami zasilania i chłodzenia. Zawiera kilka bibliotek komponentów: DSX Max-Q umożliwia dynamiczne dostarczanie zasilania w całej fabryce AI, co skutkuje wdrożeniem o 30% więcej infrastruktury AI w centrum danych o stałym poborze mocy. DSX Flex umożliwia fabrykom AI przekształcenie się w elastyczne zasoby sieciowe, uwalniając szacunki NVIDIA na poziomie 100 gigawatów energii sieciowej, co jest kluczową możliwością, biorąc pod uwagę, że energia jest obecnie największym wąskim gardłem w budowie infrastruktury AI, z ponad 300 miliardami dolarów zaległości sprzętowych i ponad 200 GW projektów oczekujących w kolejkach połączeń międzysystemowych w USA. DSX Exchange umożliwia skalowalną i bezpieczną integrację sygnałów obliczeniowych, sieciowych, energetycznych, zasilania i chłodzenia między IT, technologią operacyjną i agentami operacyjnymi. Modele DSX Sim weryfikują fabryki AI jako cyfrowe bliźniaki o wysokiej wierności przy użyciu platformy NVIDIA DSX Air.
Projekt Omniverse DSX Blueprint, teraz ogólnie dostępny na build.nvidia.com i w pełni kompatybilny z projektem referencyjnym Vera Rubin DSX, umożliwia deweloperom tworzenie fizycznie dokładnych cyfrowych bliźniaków swoich fabryk AI, symulowanie operacji w czasie rzeczywistym i optymalizację wydajności przed rozpoczęciem budowy lub wdrożenia. To ujednolica zasilanie, chłodzenie, sieć i operacje w jednym środowisku, przyspieszając czas generowania przychodów i zwiększając wydajność AI.
Wśród liderów branży, którzy przyczynili się do powstania architektury i projektu DSX, znajdują się Cadence, Dassault Systèmes, Eaton, Jacobs, Nscale, Phaidra, Procore Technologies, PTC, Schneider Electric, Siemens, Switch, Trane Technologies i Vertiv. Warto odnotować, że Nscale i Caterpillar wdrażają projekty referencyjne DSX Vera Rubin w Zachodniej Wirginii, w wielogigawatowym obiekcie, opisywanym jako jedna z największych fabryk AI na świecie. W sektorze energetycznym, Emerald AI, GE Vernova, Hitachi i Siemens Energy wykorzystują architekturę referencyjną DSX do odblokowania potencjału sieci i dostarczenia mocy potrzebnej do budowy nowych fabryk AI. Phaidra zintegrowała DSX Max-Q z samouczącym się agentem AI, który zapewnia około 10% więcej mocy obliczeniowej poprzez redukcję skoków temperatury przy jednoczesnym zachowaniu bezpieczeństwa.
NVIDIA Agent Toolkit i OpenCLAW: pakiet oprogramowania dla agentów autonomicznych
Konferencja TC 2026 zwróciła również uwagę na gwałtowny wzrost liczby agentowych obciążeń AI, a NVIDIA określiła autonomicznych agentów jako najszybciej rozwijające się obciążenie, jakie kiedykolwiek zaobserwowała. Centralnym elementem zapowiedzi oprogramowania był OpenCLAW, określany jako prawdopodobnie najważniejsza pojedyncza wersja oprogramowania w historii, oraz framework orkiestracji dla długotrwałych, samorozwijających się agentów zwanych CLAW – autonomicznych systemów, które mogą planować, działać i wykonywać całe misje, a nie pojedyncze zadania. NVIDIA określiła CLAW jako nową warstwę aplikacji dla AI, zauważając, że odeszliśmy od podpowiedzi typu „co, jak lub dlaczego” na podpowiedzi typu „kompiluj, twórz lub twórz”.
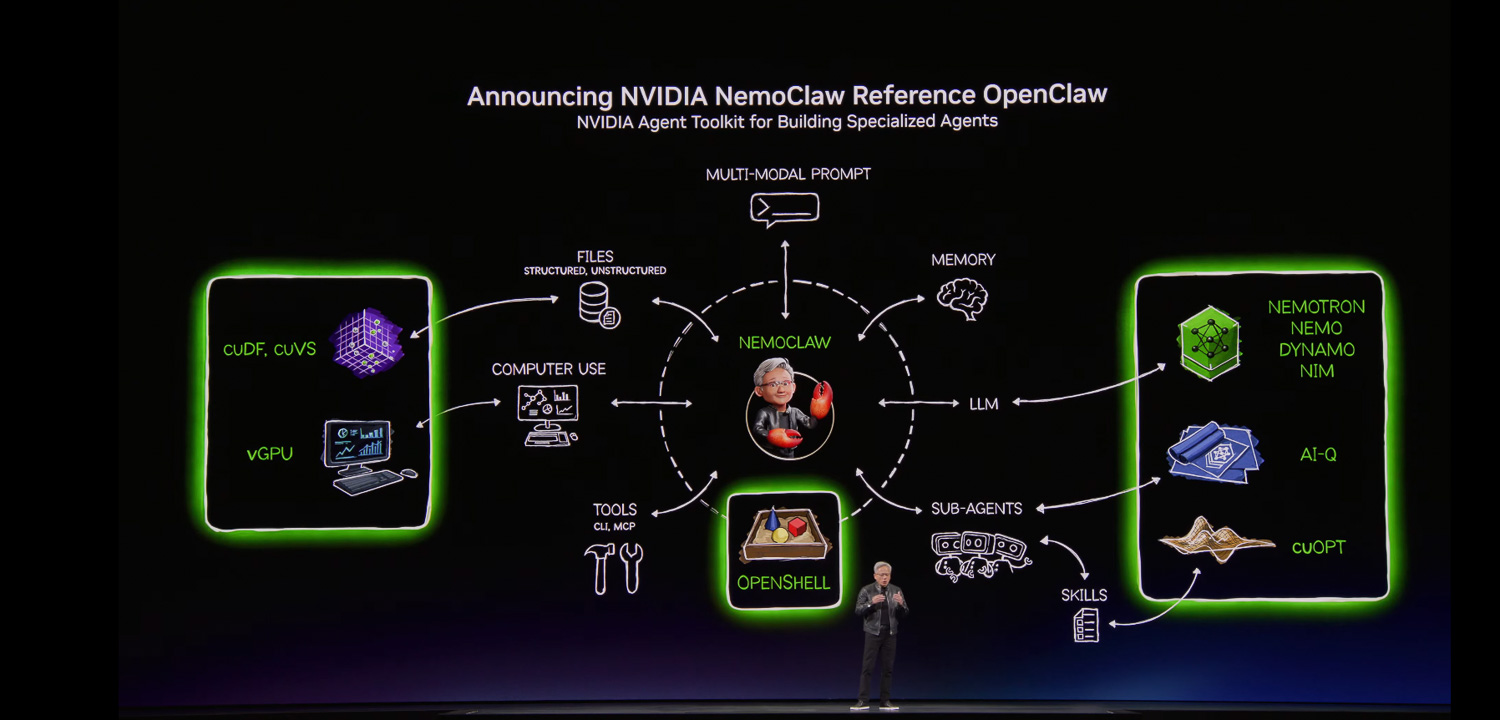
Firma NVIDIA ogłosiła NVIDIA Agent Toolkit, w pełni otwarty zbiór modeli, środowisk uruchomieniowych i projektów do tworzenia, oceny i optymalizacji długotrwałych autonomicznych agentów. Kluczowe komponenty obejmują otwarte modele Nemotron do wnioskowania, kodowania i mowy; Nemo do profilowania i dostosowywania agentów; NIM do wnioskowania w modelach; oraz Dynamo 1.0 do skalowania w poziomie. Nowe dodatki obejmują NVIDIA OpenShell, otwarte środowisko uruchomieniowe zapewniające bezpieczeństwo i ochronę, oparte na regułach sieci, prywatności i zabezpieczeniach dla wykonywania agentów, oraz IQ, otwarty projekt łączący inteligencję pionierskich i otwartych modeli dla agentów do głębokich badań, pierwszy system badawczy, który uzyskał najlepsze wyniki zarówno w testach Deep Research Bench 1, jak i Complex Deep Research Bench 2. Nowa umiejętność cuOPT zapewnia wiedzę specjalistyczną w zakresie problemów optymalizacyjnych opisanych w języku naturalnym.
NVIDIA ogłosiła również Nemo CLAW, swój wkład w społeczność OpenCLAW, opracowany we współpracy z Peterem Steinbergerem, twórcą OpenCLAW. Nemo CLAW instaluje OpenCLAW wraz z modelami Nemotron i środowiskiem wykonawczym OpenShell za pomocą jednego polecenia, zapewniając agentom podstawę do rozwijania i zdobywania nowych umiejętności, działając w ramach zdefiniowanych zabezpieczeń prywatności i bezpieczeństwa. Rozwiązanie może działać na dowolnej platformie, od infrastruktury chmurowej po lokalne komputery RTX, DGX Station i DGX Spark.
DGX Spark i DGX Station: lokalne platformy programistyczne CLAW
Uznając, że wielu deweloperów preferuje lokalne środowiska programistyczne z pełną kontrolą nad zasobami obliczeniowymi, NVIDIA wprowadziła dwie nowe platformy, stworzone specjalnie do tworzenia agentów CLAW. DGX Spark to wydajna i energooszczędna platforma do uruchamiania bezpiecznych, zawsze aktywnych, autonomicznych agentów. Systemy partnerów OEM oparte na DGX Spark i GB10 są już dostępne na całym świecie. Platforma DGX Station, pozycjonowana jako najlepsza lokalna platforma programistyczna CLAW, umożliwia deweloperom uruchamianie modeli z inteligencją na najwyższym poziomie w pełni lokalnie, bez konieczności połączenia z chmurą, co ma kluczowe znaczenie dla rozwoju oprogramowania, gdzie wszystko pozostaje lokalne, zapewniając pełną kontrolę i bezpieczeństwo. Systemy DGX Station można zamawiać u partnerów OEM od 16 marca 2026 r.
Moduły kosmiczne Very Rubin: infrastruktura sztucznej inteligencji poza Ziemią
Firma NVIDIA ogłosiła, że jej najnowsze platformy akcelerowanych obliczeń otwierają nową erę innowacji kosmicznych, wprowadzając obliczenia AI do orbitalnych centrów danych (ODC), inteligencji geoprzestrzennej i autonomicznych operacji kosmicznych. Moduł NVIDIA Vera Rubin Space Module oferuje do 25 razy więcej mocy obliczeniowej AI do wnioskowania kosmicznego niż procesor graficzny NVIDIA H100, umożliwiając działanie dużych modeli językowych i zaawansowanych modeli bazowych bezpośrednio na orbicie. Jego ściśle zintegrowana architektura CPU-GPU zapewnia wydajność i pamięć niezbędne do przetwarzania ogromnych strumieni danych z instrumentów kosmicznych w czasie rzeczywistym.
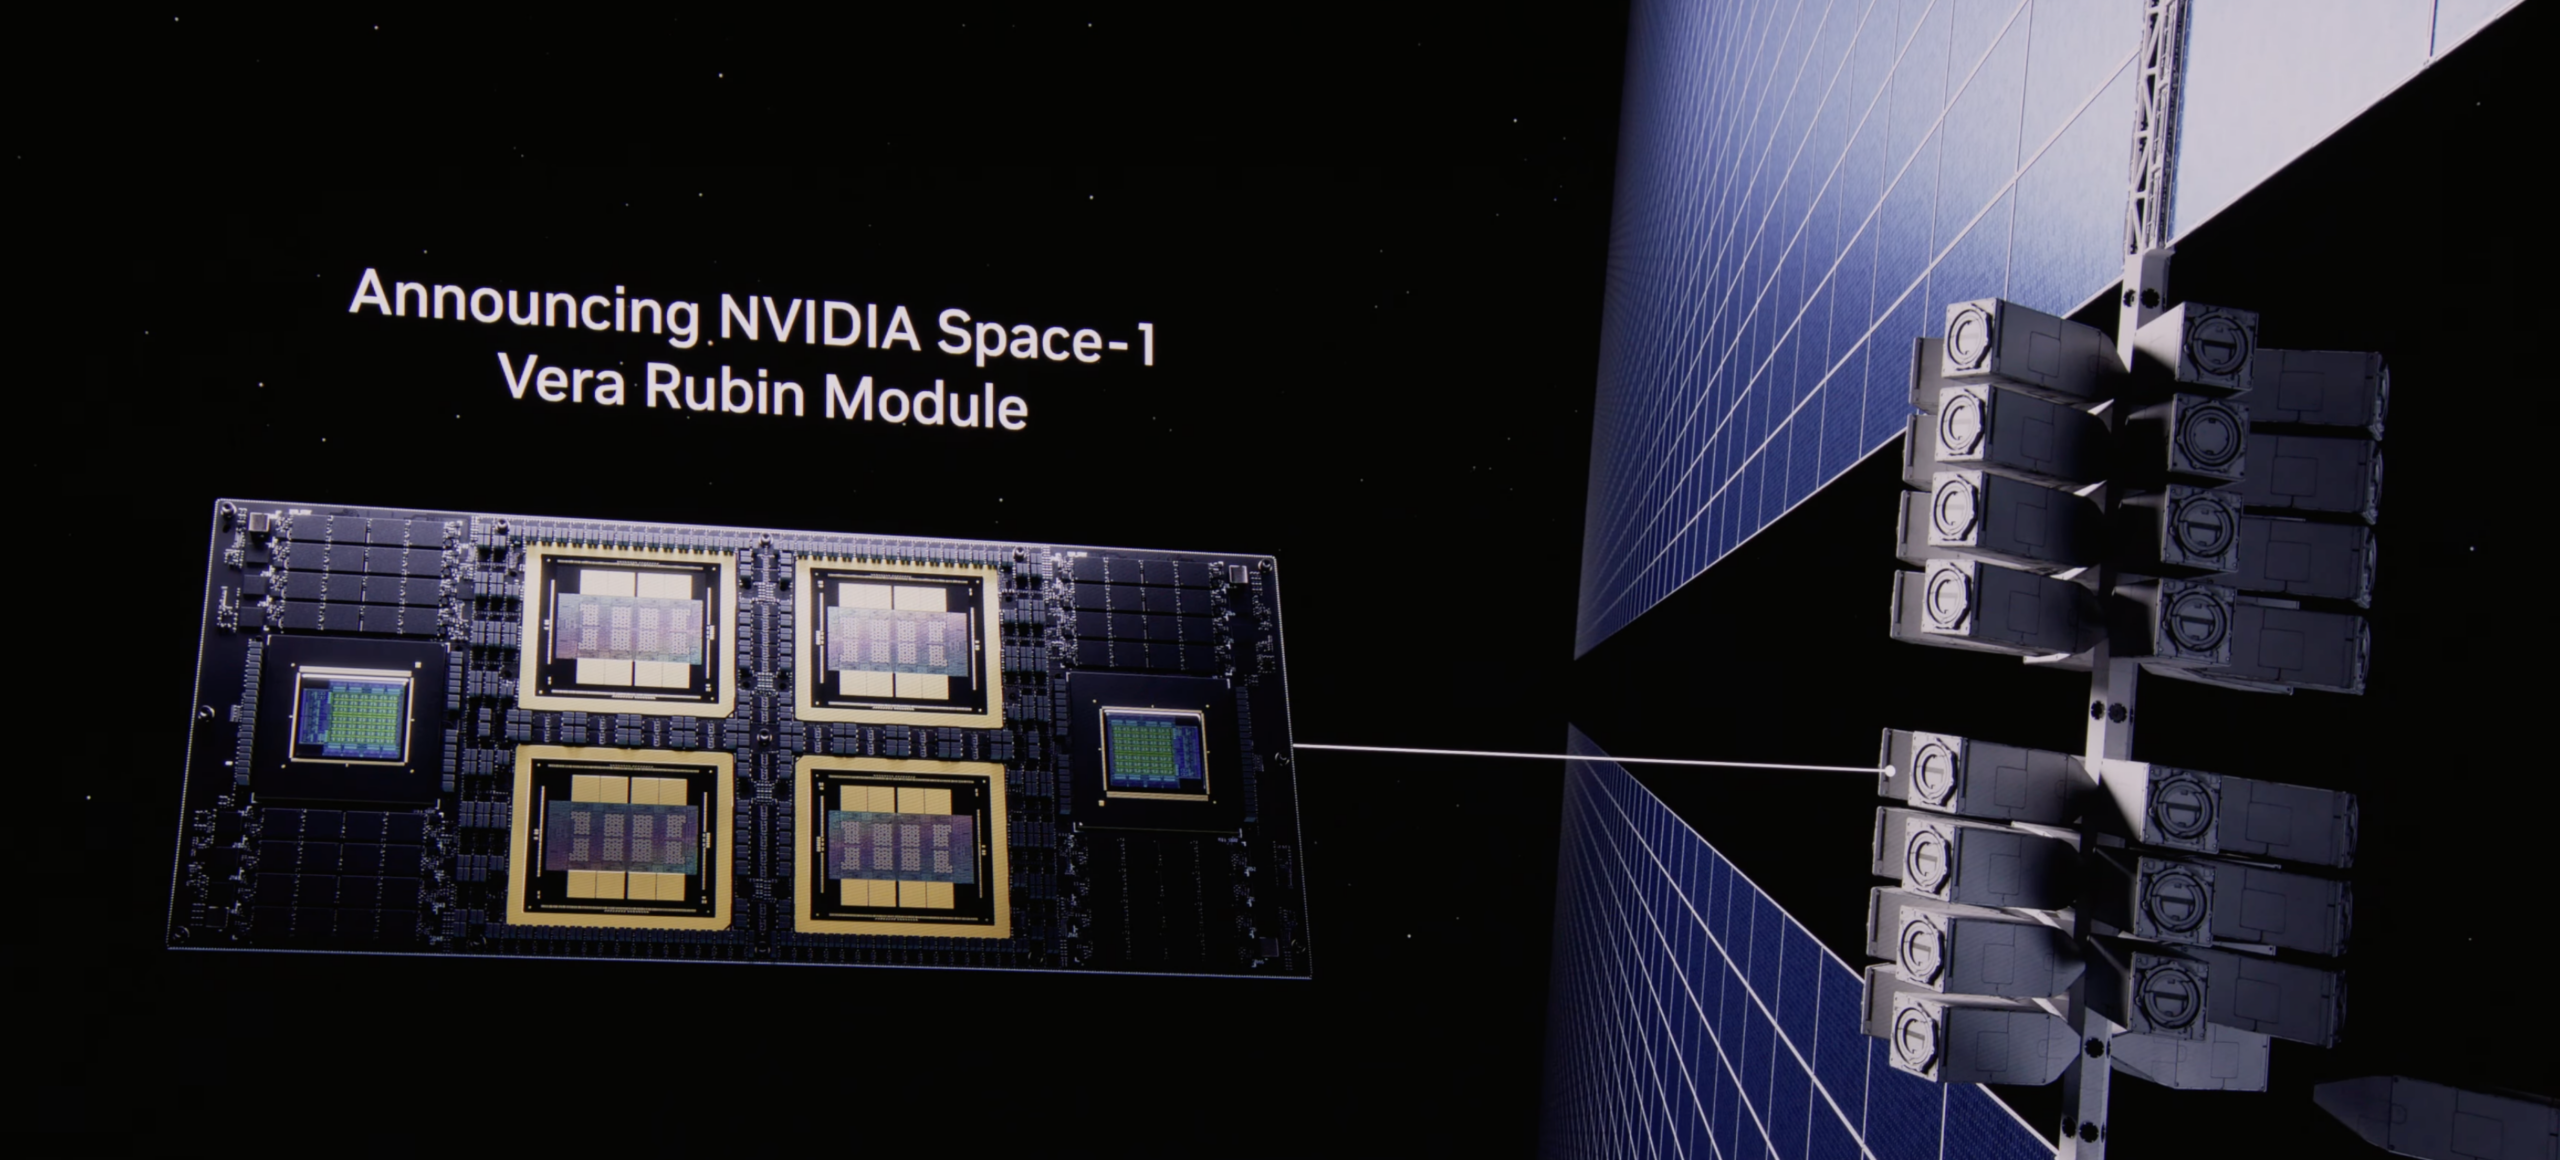
Oprócz modułu Vera Rubin Space Module, NVIDIA IGX Thor zapewnia wytrzymałość klasy przemysłowej dla krytycznych dla misji środowisk brzegowych na orbicie, a Jetson Orin oferuje wysokowydajną inferencję AI w ultrakompaktowym module zoptymalizowanym pod kątem statków kosmicznych z ograniczeniami SWaP. Na ziemi, procesor graficzny RTX PRO 6000 Blackwell Server Edition zapewnia do 100 razy wyższą wydajność w porównaniu ze starszymi systemami wsadowymi opartymi na procesorach CPU, w zakresie przetwarzania danych geoprzestrzennych. Partnerzy, tacy jak Aetherflux, Axiom Space, Kepler Communications, Planet Labs, Sophia Space i Starcloud, budują na tych platformach misje kosmiczne nowej generacji, obejmujące orbitalne centra danych, autonomiczne operacje kosmiczne i obserwację Ziemi w czasie rzeczywistym.
NVIDIA Dynamo 1.0: System operacyjny do wnioskowania dla fabryk AI
Uzupełnieniem zapowiedzi GTC 2026 było rozpoczęcie produkcji przez firmę NVIDIA oprogramowania open source Dynamo 1.0, które firma pozycjonuje jako pierwszy rozproszony system operacyjny do wnioskowania w fabrykach AI. Podobnie jak system operacyjny komputera koordynuje sprzęt i aplikacje, Dynamo 1.0 pełni funkcję rozproszonej warstwy orkiestracji dla fabryk AI, płynnie zarządzając zasobami GPU i pamięci w całym klastrze, co pozwala na obsługę złożonych, heterogenicznych obciążeń AI na dużą skalę.
Dynamo 1.0 rozdziela zadania wnioskowania między procesory graficzne (GPU) dzięki inteligentnemu routingowi i możliwości przenoszenia danych między procesorami graficznymi a tańszymi warstwami pamięci masowej, redukując marnotrawstwo mocy obliczeniowej i łagodząc ograniczenia pamięci. W przypadku zadań z wykorzystaniem sztucznej inteligencji i zadań o długim kontekście, Dynamo może kierować żądania do procesorów graficznych (GPU), które przechowują już najistotniejsze dane pamięci podręcznej KV z wcześniejszych etapów, a następnie odciążać tę pamięć, gdy nie jest potrzebna. Ta funkcja jest bezpośrednio powiązana z architekturą pamięci masowej BlueField-4 STX/ICMS. W ostatnich testach porównawczych w branży Dynamo zwiększyło wydajność wnioskowania procesorów graficznych NVIDIA Blackwell nawet 7-krotnie, obniżając koszt tokenów i zwiększając możliwości generowania przychodów dla milionów wdrożonych procesorów graficznych, a wszystko to dzięki darmowemu oprogramowaniu open source.
NVIDIA przyspiesza rozwój ekosystemu open source, integrując optymalizacje Dynamo i TensorRT-LLM z popularnymi frameworkami wnioskowania, takimi jak LangChain, llm-d, LMCache, SGLang i vLLM. Podstawowe bloki konstrukcyjne Dynamo, KVBM do zarządzania pamięcią, NIXL do szybkiego przesyłania danych między GPU a GPU oraz Grove do uproszczonego skalowania są również dostępne jako samodzielne moduły. NVIDIA wnosi również jądra CUDA TensorRT-LLM do projektu FlashInfer, umożliwiając natywną integrację z frameworkami open source.
Zakres wdrożenia jest godny uwagi. Platforma inferencyjna NVIDIA jest obecnie zintegrowana z dostawcami usług chmurowych, takimi jak AWS, Microsoft Azure, Google Cloud i Oracle Cloud Infrastructure, a także z partnerami NVIDIA w chmurze: Alibaba Cloud, CoreWeave, Crusoe, DigitalOcean, Nebius, Nscale i Together AI. Firmy Cursor, Hebbia i Perplexity, specjalizujące się w sztucznej inteligencji, wdrożyły platformę, podobnie jak dostawcy punktów końcowych inferencyjnych Baseten, Deep Infra i Fireworks. Globalne przedsiębiorstwa, takie jak Amazon, AstraZeneca, BlackRock, ByteDance, Coupang, Instacart, Meituan, PayPal, Pinterest, Shopee i SoftBank Corp., wdrożyły stos inferencyjny NVIDIA. Dynamo 1.0 jest już dostępne dla programistów na całym świecie.


 Amazon