

Firma NetApp, podczas konferencji INSIGHT 2026 w Las Vegas, ogłosiła NetApp Novus – zdezagregowaną architekturę pamięci masowej dla fabryk sztucznej inteligencji, która oddziela metadane od ścieżki danych. Zaprojektowano ją tak, aby przekraczała łączną przepustowość 100 TB/s, obsługiwała setki tysięcy procesorów graficznych i rozwijała się w kierunku systemu plików o skali zettabajtowej. Pierwsza konfiguracja łączy NetApp Novus Data Director, oprogramowanie do metadanych, działające na certyfikowanych serwerach Supermicro z systemami NetApp AFF A90 z ONTAP jako warstwą danych. NetApp twierdzi, że można ją zamawiać już dziś. Ogłoszenie nastąpiło tydzień po tym, jak NetApp zgodził się na przejęcie PEAK:AIO w celu realizacji skalowalnego projektu metadanych pNFS.
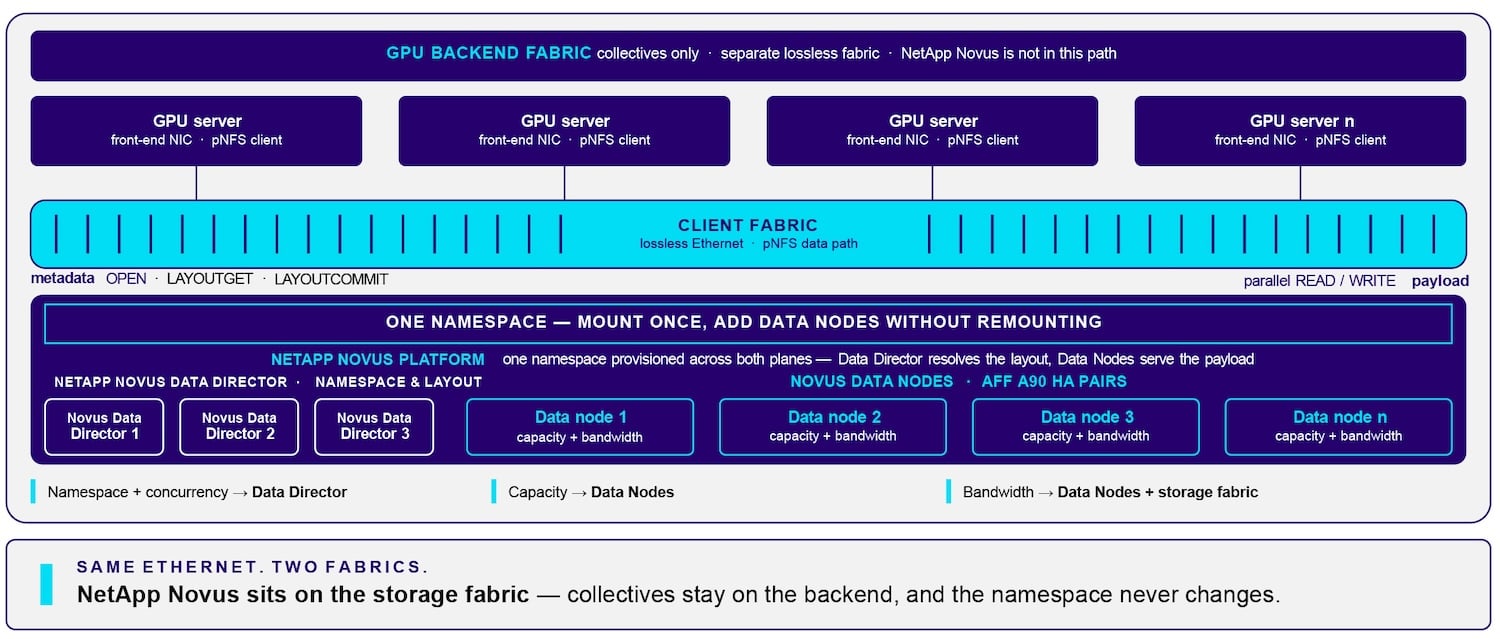
NetApp Novus oddziela metadane i skalowanie danych
Novus utrzymuje pojedynczą, zgodną ze standardami przestrzeń nazw NFS, jednocześnie przenosząc usługi metadanych do osobnej warstwy. Data Director działa na standardowej architekturze x86 i obsługuje przestrzeń nazw oraz układ (diagram architektury NetApp wymienia OPEN, LAYOUTGET i LAYOUTCOMMIT na ścieżce Data Director), podczas gdy pary AFF A90 HA pełnią funkcję węzłów danych Novus, które zapewniają pojemność i przepustowość. Klientami są standardowe klienty Linux pNFS na kartach sieciowych front-end serwerów GPU, korzystające z NFSv4.2 z pNFS Flex Files, nconnect i GPUDirect Storage, zgodnie ze stroną produktu NetApp, więc nie ma potrzeby instalowania zastrzeżonego klienta.
Ścieżka danych pNFS przebiega przez bezstratną strukturę klienta Ethernet, oddzieloną od struktury zaplecza GPU używanej do obsługi kolektywów, a diagram NetApp wyraźnie wskazuje, że Novus nie znajduje się na tej ścieżce zaplecza. Hosty montuje się raz, a węzły danych można dodawać bez ponownego montowania, co pozwala na niezależne skalowanie wydajności, pojemności i współbieżności metadanych. NetApp pozycjonuje to jako rozwiązanie dla wielodostępnych fabryk AI obsługiwanych przez dostawców neocloud i GPU-as-a-Service.
Podczas odprawy poprzedzającej konferencję INSIGHT Jeff Baxter, wiceprezes ds. marketingu technicznego w firmie NetApp, opisał Data Director jako urządzenie, które odpowiada na wyszukiwania i żądania układu poza pasmem i w pamięci, dzięki czemu każdy klient GPU może adresować każdy węzeł danych bezpośrednio, bez konieczności korzystania z proxy za pośrednictwem połączenia klastrowego, co jest zachowaniem równoległego systemu plików, którego poszukuje firma NetApp bez agenta w stylu Lustre na kliencie.
Dodał również, że pierwsze węzły danych to konkretna wersja AFF A90 dostrojona pod kątem sekwencyjnej przepustowości z dodatkową pamięcią NVRAM, z programowo definiowaną kompilacją ONTAP dla wybranej grupy serwerów x86, która ma zostać w przyszłości wprowadzona, oraz że Novus plasuje się powyżej rozproszonej platformy AFX w ofercie NetApp, w punkcie, w którym sieć rozproszonego klastra staje się granicą.
NetApp ujmuje problem w kategoriach wykorzystania: „W tradycyjnych architekturach wykorzystanie GPU może spaść poniżej 30 procent, gdy fabryki AI nie są w stanie dostarczyć wystarczającej ilości danych do swoich GPU” – czytamy w komunikacie. NetApp reklamuje również Novusa jako „najszybszą pamięć masową na świecie”, co opiera się na poniższych prognozach.
Dane dotyczące skalowania to prognozy oparte na mniejszym, audytowanym teście. NetApp twierdzi, że testy audytowane przez Omdia wykazały niemal liniowe skalowanie wydajności po dodaniu klastrów ONTAP do jednej globalnej przestrzeni nazw, a modelowanie Omdia przewiduje, że architektura może skalować się do 100 TB/s sekwencyjnej przepustowości odczytu przy dziesiątkach eksabajtów efektywnej pojemności. „Jesteśmy przekonani, że nasze prognozy pozwalają na skalowanie rozwiązania do potrzeb wdrożeń zettascale” – powiedział Tony Palmer, główny analityk w Omdia.
Według własnych obliczeń NetApp na stronie Novus, dla wydajności 100 TB/s potrzeba ponad 50 000 procesorów GPU o przepustowości około 2 GB/s każdy. Firma twierdzi, że projekt ten zachowuje usługi danych ONTAP, bezpieczeństwo, jakość usług i wielodostępność, jednocześnie obsługując miliardy plików w tysiącach węzłów pamięci masowej. NetApp twierdzi również, że początkowa konfiguracja sprzętowa „zapewnia ścieżkę do wdrożeń definiowanych programowo w dłuższej perspektywie”.
Baxter powiedział, że odnosząc się do harmonogramu, zamierza przekazać Novus klientom Lighthouse w ciągu miesiąca lub dwóch od wdrożenia INSIGHT i udostępnić go innym klientom fabrycznym korzystającym z AI w kolejnych miesiącach.
Oszacował populację docelową na około sto firm, które korzystają z dziesiątek tysięcy, a nawet setek tysięcy procesorów GPU. To skłoniło NetApp do poszukiwania pojedynczych przestrzeni nazw klasy eksabajtów, które mogą rosnąć do zettabajtów, skumulowanej przepustowości rzędu dziesiątek, a nawet setek TB/s, gęstości na jednostkę rack, obsługi wielu najemców oraz obsługi aprowizacji za pośrednictwem własnych płaszczyzn sterowania za pośrednictwem interfejsów API i zestawów SDK. „Prawdopodobnie najdroższym zasobem w każdym centrum danych na świecie jest nieużywany procesor GPU w fabryce sztucznej inteligencji” – powiedział.
„Fabryki sztucznej inteligencji borykają się z problemami, a ekonomia GPU załamuje się, gdy dane nie nadążają za rozwojem” – powiedział Syam Nair, dyrektor ds. produktów w firmie NetApp.
Rola Supermicro wykracza poza hosting Data Director na kwalifikowanych serwerach wraz z węzłami danych AFF A90: obie firmy łączą rozwiązania Supermicro w zakresie obliczeń, sieci, zasilania i chłodzenia cieczą w obudowach rack z oprogramowaniem NetApp do zarządzania danymi i cyberodporności, tworząc fabryczne systemy sztucznej inteligencji. Wspólnie z Supermicro wspierają również NetApp AIPod, sprawdzoną przez NetApp architekturę infrastruktury konwergentnej, opartą na wytycznych NVIDIA Reference Architecture, do obsługi obciążeń treningowych, wnioskowania i agentowych w skali od kilkudziesięciu do kilkuset procesorów graficznych, sprzedawaną za pośrednictwem partnerów handlowych NetApp.
Silnik danych AI rozszerza możliwości odkrywania metadanych
NetApp AI Data Engine, czyli AIDE, rozszerza teraz wyszukiwanie metadanych na systemy ONTAP, StorageGRID i pamięci masowe innych firm. NetApp twierdzi, że AIDE może wyszukiwać i analizować dane w repozytoriach NFS, SMB i S3, dzięki czemu zespoły IT mogą wyszukiwać gotowe na sztuczną inteligencję zestawy danych, możliwości optymalizacji pamięci masowej, kandydatów do migracji i zagrożenia bezpieczeństwa bez konieczności wcześniejszego kopiowania danych do oddzielnego potoku AI.
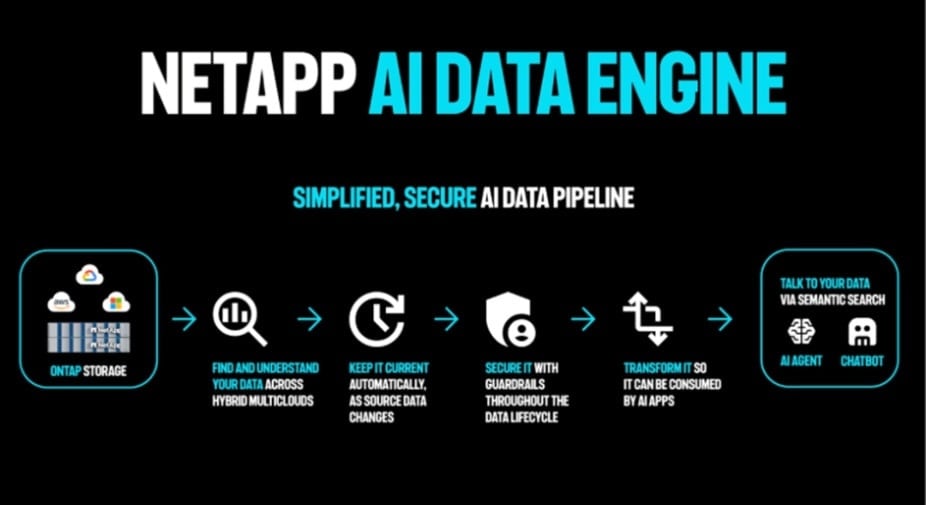
Firma testuje również funkcje analizy danych oparte na sztucznej inteligencji, pogłębioną inteligencję zarządzania, otwartą integrację analityki ze Starburst i Onehouse.AI oraz usługi agentowe, które przekształcają dane w kontekst AI na dużą skalę. Nadal są one w fazie testowej, a NetApp nie podał daty powszechnej dostępności.
NetApp rozszerzył integrację z Commvault, dzięki czemu sygnały autonomicznej ochrony przed ransomware z głównej pamięci masowej trafiają bezpośrednio do przepływów pracy Commvault w zakresie odzyskiwania danych. Według NetApp, wspólne rozwiązanie zapewnia wykrywanie zagrożeń w czasie niemal rzeczywistym, głębsze skanowanie w poszukiwaniu zagrożeń unikających, walidację w warunkach „cleanroom” z detekcją zagrożeń opartą na sztucznej inteligencji w odizolowanym środowisku oraz czyste odzyskiwanie danych z konsoli Commvault, co – jak twierdzą firmy – skraca czas odzyskiwania do minut, a nie dni lub tygodni, bez ponownego wprowadzania infekcji.
Podczas wstępnego spotkania Baxter powiedział, że integracja umożliwia firmie Commvault korzystanie z natywnych mechanizmów ONTAP tam, gdzie mają one zastosowanie: kopie migawek zamiast kopii zapasowych przesyłanych strumieniowo, SnapMirror do replikacji, SnapLock do niezmiennego sejfu po stronie pamięci masowej i SnapRestore do odzyskiwania, gdy główna migawka nadal istnieje.
Operacje hybrydowe w środowisku wielochmurowym i kontrola suwerenności
Rozwiązanie NetApp Console Autonomous Operations zastępuje ręczne pętle zatwierdzania automatyzacją opartą na wynikach, nadzorowaną przez człowieka, w przypadku dużych flot hybrydowych. NetApp twierdzi, że rozwiązanie działa w środowiskach odizolowanych od sieci. Firma opisuje projekt zorientowany na API i agencką orkiestrację, które stoją za analityką predykcyjną, optymalizacją pojemności, usuwaniem incydentów i operacjami opartymi na regułach.
Rozwiązanie NetApp Console Fleet Management oferuje drugi model dostarczania konsoli, instalowany w środowisku klienta, umożliwiający zarządzanie, obserwowalność i sztuczną inteligencję w całej infrastrukturze pamięci masowej. Firma Baxter poinformowała, że lokalna instalacja może działać w trybie całkowicie odłączonym w przypadku serwerów typu dark site i ma na celu umożliwienie klientom, którzy korzystali z ActiveIQ Unified Manager do lokalnego zarządzania flotą, dostępu do tej samej konsoli, z której korzysta usługa hostowana.

Nowy interfejs NetApp Console AI ChatOps wprowadza konwersacyjne operacje pamięci masowej do systemów ONTAP, obejmując provisioning oparty na intencjach, automatyczne naprawy, zabezpieczenia polityk, raportowanie i analitykę predykcyjną. Działa on poprzez otwartą bramę LLM, dzięki czemu klienci mogą podłączać własne modele, a każda akcja jest ograniczona do zdefiniowanych klas pamięci masowej, polityk i granic zarządzania. Baxter opisał interfejs czatu jako front-end serwera MCP wbudowanego w platformę, dzięki czemu te same provisioningi i operacje mogą być obsługiwane przez agentów klienta, z zachowaniem niezmienionych ścieżek REST API, Terraform i Ansible.
NetApp Keystone Sovereign rozszerza ofertę pamięci masowej jako usługi o regionalne mechanizmy kontroli dla kwalifikujących się klientów z Europejskiego Obszaru Gospodarczego. Usługa przechowuje odpowiednie dane klientów, logi, kopie zapasowe i dane telemetryczne, a także procesy wsparcia i eskalacji oraz przepływy pracy związane z dostępem i zarządzaniem, w ramach zdefiniowanych granic europejskich, a także dokumentuje dane telemetryczne, monitorowanie i przepływy danych.
Pilotaże rozpoczną się w Niemczech i Francji, a planuje się ich objęcie większą liczbą krajów. Baxter zapowiedział start w listopadzie i poinformował, że obsługą techniczną i eskalacją zajmą się w regionie posiadacze paszportów z danego regionu – jest to ten sam model, z którego korzysta NetApp w przypadku swojej oferty dla sektora publicznego w USA.
NetApp i Nutanix planują również zintegrowaną ofertę łączącą NetApp ONTAP z infrastrukturą chmurową Nutanix dla obciążeń wirtualnych. NetApp zapowiada, że ogólna dostępność będzie planowana na jesień tego roku.
Integracje pamięci masowej SAP i OCI nadal mają charakter przyszłościowy
Firmy NetApp i SAP ogłosiły zamiar zbadania głębszej integracji rozwiązań NetApp z chmurą natywną dla SAP Cloud Infrastructure, platformą SAP IaaS. Platforma NetApp oferuje już przechowywanie plików i bloków, ochronę danych oraz replikację; nowe prace obejmują wspólne programy wprowadzania na rynek w celu migracji i obsługi obciążeń SAP i innych niż SAP oraz walidację techniczną obiektowej pamięci masowej NetApp w SAP Cloud Infrastructure. Jest to planowane rozszerzenie partnerstwa bez określonego harmonogramu, a wydanie NetApp zawiera zwyczajowe ostrzeżenie, że nie należy opierać się na nieopublikowanych ofertach przy podejmowaniu decyzji zakupowych.
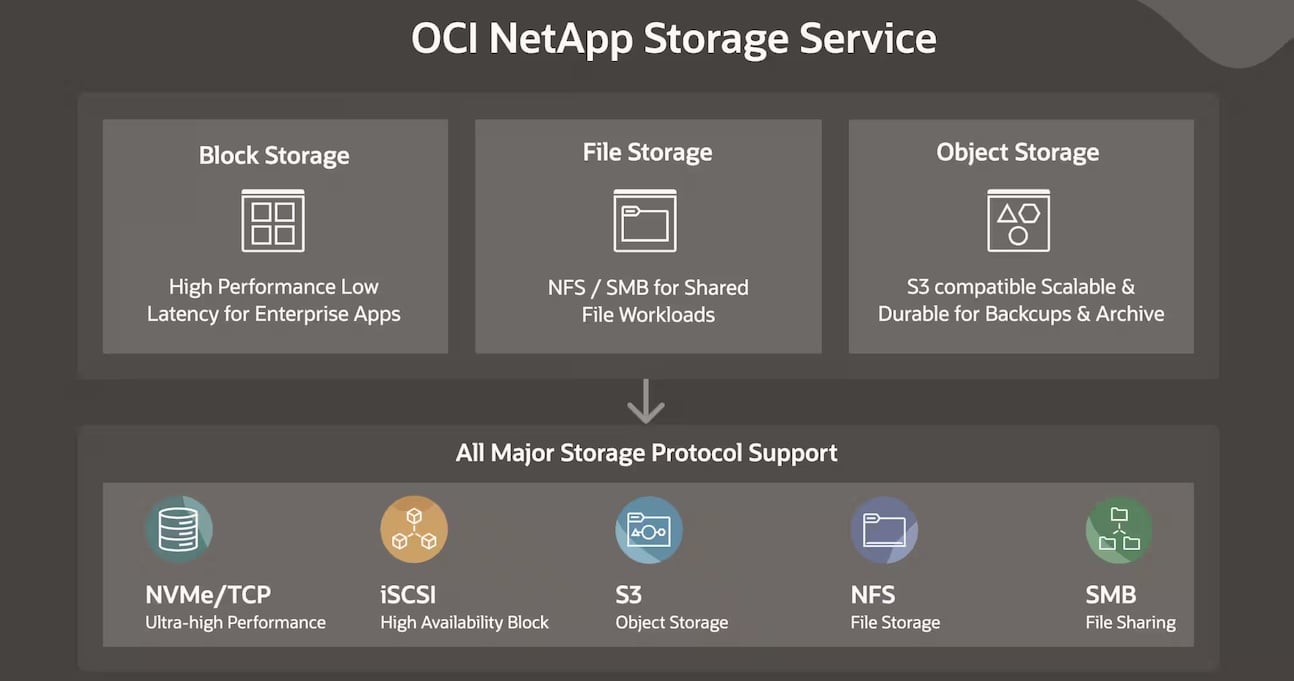
Firmy NetApp i Oracle ogłosiły wprowadzenie usługi OCI NetApp Storage Service – planowanej, w pełni zarządzanej, natywnej dla OCI usługi pamięci masowej, która wprowadza zarządzanie danymi ONTAP do infrastruktury Oracle Cloud Infrastructure. Klienci będą nią zarządzać za pośrednictwem konsoli OCI, zestawów SDK OCI oraz interfejsów API ONTAP. NetApp jako docelowe wskazał potoki danych AI, bazy danych, aplikacje korporacyjne, środowiska zwirtualizowane, EDA i HPC oraz obciążenia regulowane. Planowane jest wprowadzenie usługi na rynek w ciągu najbliższych 12 miesięcy.
„Usługa OCI NetApp Storage Service zapewnia klientom natywne środowisko OCI, umożliwiając im jednocześnie korzystanie ze znanych funkcji ONTAP w zakresie ochrony danych, migracji, zarządzania i dostępu wieloprotokołowego” — powiedział Pravjit Tiwana, starszy wiceprezes i dyrektor generalny ds. pamięci masowej w chmurze i usług w firmie NetApp.


 Amazon