

Firmy hiperskalerowe i operatorzy infrastruktury skoncentrowani na sztucznej inteligencji (AI) coraz częściej opracowują autorskie akceleratory AI i jednostki XPU, aby dotrzymać kroku dużym modelom językowym i złożonym obciążeniom wnioskowania. Aby sprostać wyzwaniom fizycznym, pamięciowym i sieciowym związanym z wdrażaniem opatentowanych układów scalonych na dużą skalę, NVIDIA szczegółowo opisała swoje połączenie NVLink Fusion i niestandardową architekturę pamięci NVHBM . Zunifikowane portfolio zostało zaprojektowane w celu połączenia niestandardowych układów scalonych z istniejącymi platformami NVIDIA do skalowania sieci i platformami MGX w obudowie rack.
Pierwszym chętnym jest Annapurna Labs firmy Amazon, której plany dotyczące NVHBM pojawiły się wraz z rozszerzeniem partnerstwa AWS o 2 miliony procesorów GPU ; niniejsze ogłoszenie dostarcza architekturę stojącą za tym partnerstwem i określa Trainium4 jako pierwszą generację Trainium z obsługą NVLink Fusion. NVIDIA opracowuje również standardową implementację NVHBM dostępną u wielu dostawców pamięci, co, jak twierdzi, zmniejsza nakład pracy inżynieryjnej związany z integracją i kwalifikacją pamięci u różnych dostawców. „NVHBM reprezentuje nowe podejście architektoniczne do zwiększania wydajności i efektywności pamięci o dużej przepustowości” – powiedział Nafea Bshara, wiceprezes Annapurna Labs w Amazon. „Z niecierpliwością oczekujemy na tę współpracę technologiczną, która przyniesie korzyści przyszłym projektom infrastruktury AWS”.
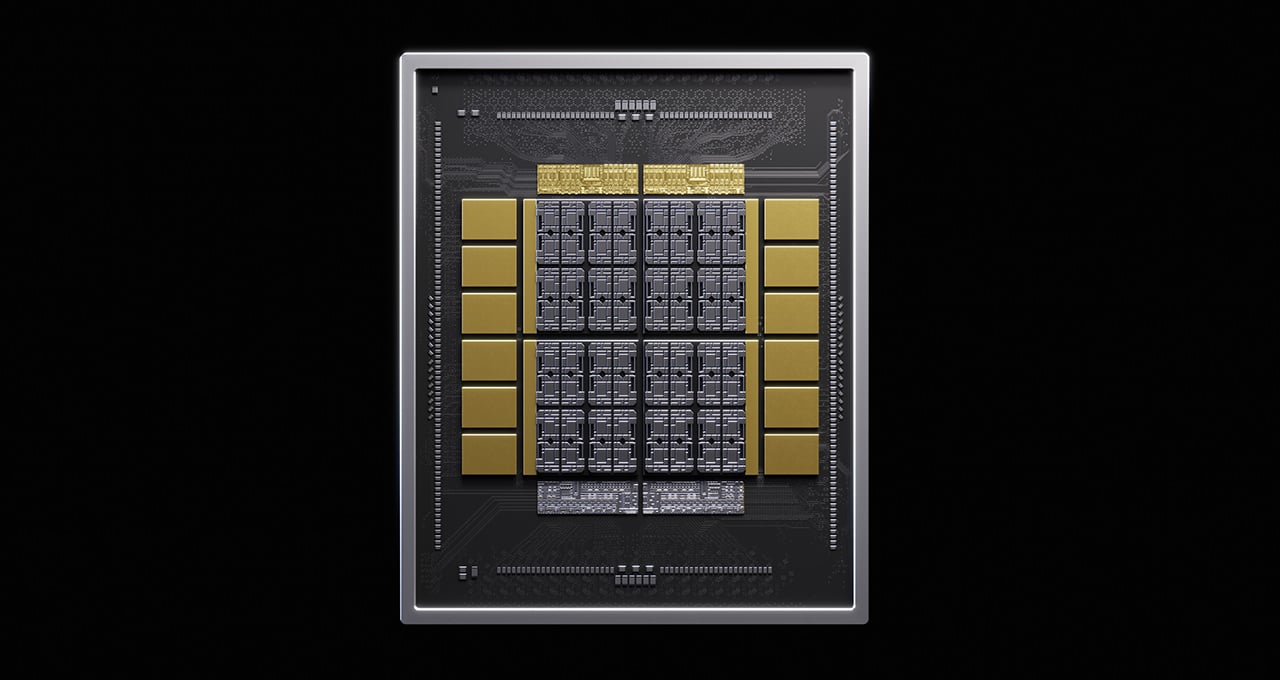
Wdrażanie niestandardowych jednostek XPU w centrach danych o wysokiej gęstości wymaga zrównoważenia logiki obliczeniowej, dystrybucji zasilania, obciążenia termicznego i pamięci o dużej przepustowości. Integracja i kwalifikacja najnowocześniejszych stosów pamięci często stwarza istotne wąskie gardła w zakresie pakowania i rozwoju. Dzięki NVLink Fusion i NVHBM projektanci mogą wykorzystać wstępnie walidowane układy bazowe i interfejs IP, zmniejszając złożoność integracji i przyspieszając czas wprowadzania produktów na rynek.
Optymalizacja przepustowości pamięci i opóźnień
Nowoczesne obciążenia AI, zwłaszcza wnioskowanie w dużych modelach i potoki agentowe, stawiają wysokie wymagania przepustowości pamięci w zakresie odczytu wag modeli, aktywacji i wpisów w pamięci podręcznej par klucz-wartość (KV). NVHBM to niestandardowy układ bazowy opracowany we współpracy z producentami pamięci, zapewniający nawet o 30% większą przepustowość pamięci na stos w porównaniu ze standardową specyfikacją JEDEC HBM4E.
| Cecha | Korzyść NVHBM |
| Przepustowość | Do 30% większa przepustowość pamięci w porównaniu ze standardową pamięcią HBM4e |
| Obszar | Bardziej wydajne połączenia interfejsów pozwalają na zwiększenie powierzchni układu obliczeniowego o 25%, co zapewnia dodatkowe możliwości XPU |
| Zasilanie | Do 15% niższe zużycie energii HBM w porównaniu ze standardowym HBM4e przekłada się na oszczędności w tysiącach jednostek XPU |
Tabela 1. Technologia NVHBM zapewnia programom akceleratorów AI trzy główne korzyści na poziomie platformy: większą przepustowość pamięci, większą powierzchnię obudowy i krzemu oraz niższe zużycie energii przez technologię HBM
To zwiększenie przepustowości minimalizuje niedobór mocy obliczeniowej silnika obliczeniowego podczas faz wykonywania zadań z ograniczoną pamięcią. Przyspieszając transfer danych między stosami HBM a wbudowaną logiką obliczeniową, akceleratory mogą utrzymać wyższe wykorzystanie i poprawić wskaźniki generowania tokenów na użytkownika podczas intensywnych obciążeń wnioskowania.
Realokacja obszaru i optymalizacja PHY
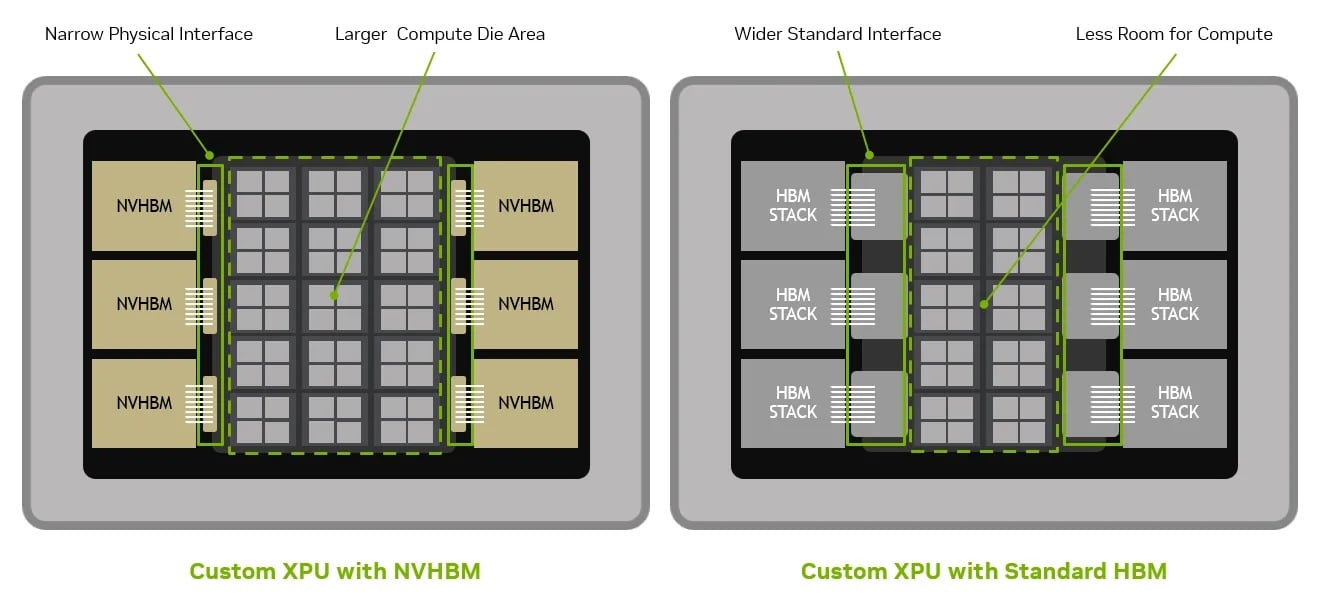
Dostępność krzemu w nowoczesnych pakietach akceleratorów jest ściśle ograniczona, co wymaga od projektantów zrównoważenia przestrzeni między jednostkami obliczeniowymi ALU, silnikami macierzowymi, wbudowaną pamięcią SRAM i interfejsami peryferyjnymi. Standardowe architektury HBM wymagają szerokich interfejsów fizycznych, które zajmują znaczną powierzchnię.
NVHBM rozwiązuje ten problem, przenosząc kontroler pamięci bezpośrednio do stosu 3D HBM i wykorzystując niestandardową warstwę fizyczną (PHY). Takie podejście pozwala nawet o 67% zmniejszyć obszar warstwy fizycznej (PHY) i obsługi urządzeń peryferyjnych w porównaniu ze standardowymi implementacjami HBM4E, jednocześnie upraszczając trasowanie ścieżek interposera, co pozwala odzyskać nawet o 80% więcej użytecznego krzemu w całym układzie. Węższy interfejs pamięci uwalnia przestrzeń w obudowie, umożliwiając projektantom rozbudowę centralnego układu obliczeniowego AI nawet o 30% w celu dodania większej liczby rdzeni macierzowych, jednostek wektorowych lub hierarchii pamięci podręcznej w ramach ustalonej fizycznej obudowy.
Efektywność energetyczna i rezerwa mocy w skali obiektu
Dystrybucja zasilania pozostaje jednym z największych ograniczeń w eksploatacji centrów danych o dużej skali, bezpośrednio wpływając na wymagania dotyczące projektowania termicznego i chłodzenia akceleratorów. NVHBM zmniejsza zużycie energii HBM o 15 procent w porównaniu ze standardowym HBM4E.
Na poziomie krzemu, obniżona moc pamięci obniża ciśnienie termiczne, zapewniając dodatkową rezerwę mocy do napędzania rdzeni obliczeniowych przy wyższych, stałych częstotliwościach. W skali obiektu, te oszczędności energii znacząco się mnożą. W teoretycznym centrum danych o mocy 1 gigawata, w którym zastosowano jednostki XPU o mocy 2,000 watów, obniżona moc pamięci może uwolnić wystarczającą pojemność cieplną i elektryczną, aby obsłużyć nawet 15 000 dodatkowych jednostek XPU.
Integracja w skali szafy za pośrednictwem NVLink Fusion
Podczas gdy NVHBM optymalizuje wydajność na poziomie pojedynczego pakietu, NVLink Fusion pełni funkcję mostu na poziomie systemu. Wykorzystując dedykowane chiplety NVLink Fusion, niestandardowe jednostki XPU mogą być podłączane bezpośrednio do infrastruktury skalowalnej NVLink szóstej generacji , łącząc wszystkie akceleratory w szafie w jedną spójną domenę pamięci i obliczeń.
Ta struktura skalowalności ma kluczowe znaczenie dla zaawansowanych schematów paralelizacji, takich jak paralelizm ekspercki (EP) i WideEP, w których rozproszone modele mieszanej pracy ekspertów wymagają synchronizacji aktywacji i stanów ukrytych o niskim opóźnieniu na wielu urządzeniach fizycznych. Procesory niestandardowe mogą również łączyć się z procesorami hosta za pośrednictwem protokołu NVLink-C2C.
Dzięki integracji półniestandardowego układu scalonego z szerszym ekosystemem sprzętu i oprogramowania NVIDIA, NVLink Fusion umożliwia operatorom wdrażanie heterogenicznych środowisk, które łączą niestandardowe jednostki XPU ze standardowymi procesorami graficznymi NVIDIA w ramach standardowej architektury rack MGX, upraszczając operacje i przydzielanie obciążeń.


 Amazon