

Firma NVIDIA ogłosiła premierę produkcyjną NVIDIA Groq 3 LPX , dedykowanego interaktywnego akceleratora wnioskowania, stworzonego jako uzupełnienie platformy Vera Rubin NVL72. Wraz z przejściem obciążeń AI przedsiębiorstw od wstępnego trenowania modelu surowego do wnioskowania w czasie rzeczywistym i autonomicznej koordynacji agentów, zmieniają się wymagania infrastrukturalne. Przepływy pracy agentów wymagają iteracyjnego, wieloetapowego wykonywania, gdzie opóźnienie podczas generowania tokenów może się kumulować w przypadku zautomatyzowanych ścieżek wnioskowania, zapytań do narzędzi zewnętrznych i komunikacji między agentami.
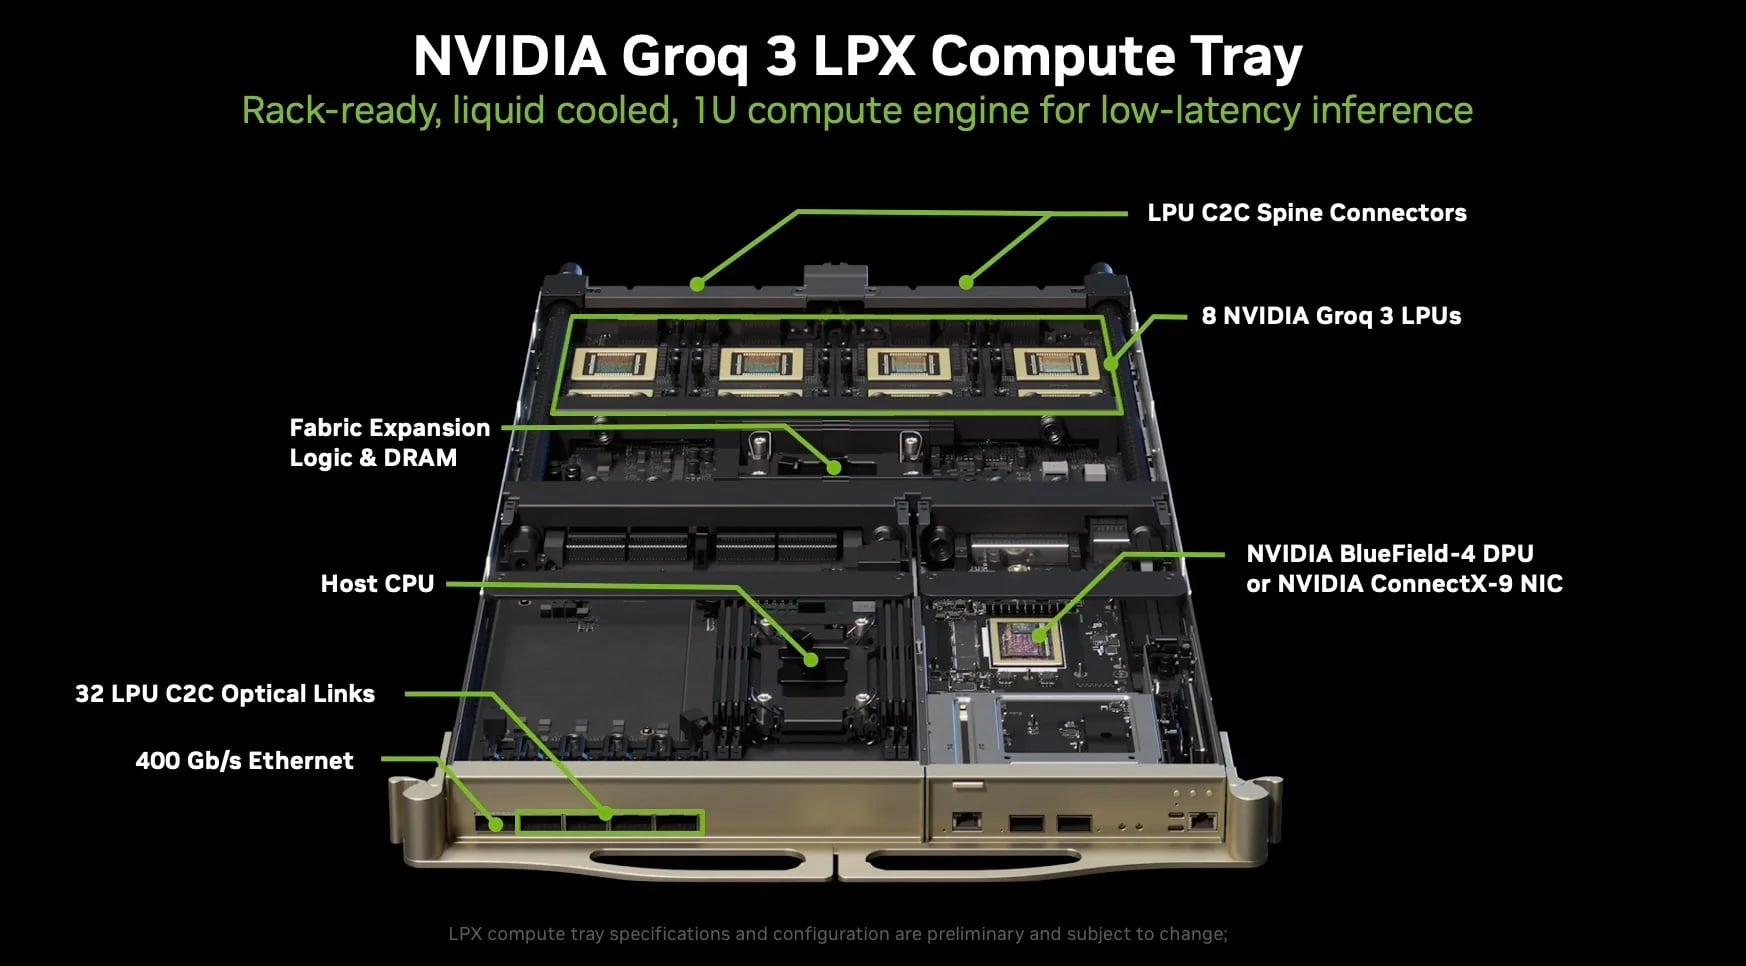
Architektura Groq 3 LPX doskonale sprawdza się w tej fazie dekodowania. Każda chłodzona cieczą tacka obliczeniowa 2U zawiera szesnaście jednostek LPU Groq 3 wraz z procesorem hosta, logiką rozbudowy struktury i pamięcią DRAM oraz kartą DPU BlueField-4 lub ConnectX-9 z 32 łączami optycznymi typu chip-to-chip LPU i Ethernetem 400 Gb/s z przodu. W heterogenicznym wdrożeniu, obok systemów Vera Rubin NVL72, procesory graficzne NVIDIA Rubin obsługują pobieranie kontekstu i obliczenia wstępnego wypełniania ogromnych zestawów danych wejściowych, podczas gdy jednostki Groq 3 LPX przetwarzają wrażliwe na opóźnienia generowanie tokenów wyjściowych.
Architektura i wydajność testów porównawczych
W standardowych ocenach wydajności sztucznej inteligencji (Artificial Analysis) z wykorzystaniem modelu Gemma 4 31B o otwartym kodzie źródłowym i aktywnym oknie kontekstowym o pojemności 100 000 tokenów, platforma Groq 3 LPX osiągnęła wydajność 3,400 tokenów na sekundę. NVIDIA zauważa, że ten poziom przepustowości jest czterokrotnie szybszy niż najbliższa alternatywna platforma przy identycznych parametrach długiego kontekstu, a Artificial Analysis rejestruje go jako najszybszy wynik zmierzony dla tego modelu. Warto uważnie przeczytać to porównanie: dane firmy NVIDIA pochodzą z prywatnego punktu końcowego przedpremierowego, zmierzonego 21 sierpnia, podczas gdy konkurencyjne wartości dotyczą działających, bezserwerowych punktów końcowych w środowisku produkcyjnym. Utrzymanie ekstremalnej prędkości generowania w oknach o pojemności 100 000 tokenów jest kluczowe dla architektur agentów korporacyjnych, które stale analizują rozległe repozytoria kodu, złożone schematy API i bogatą dokumentację techniczną.
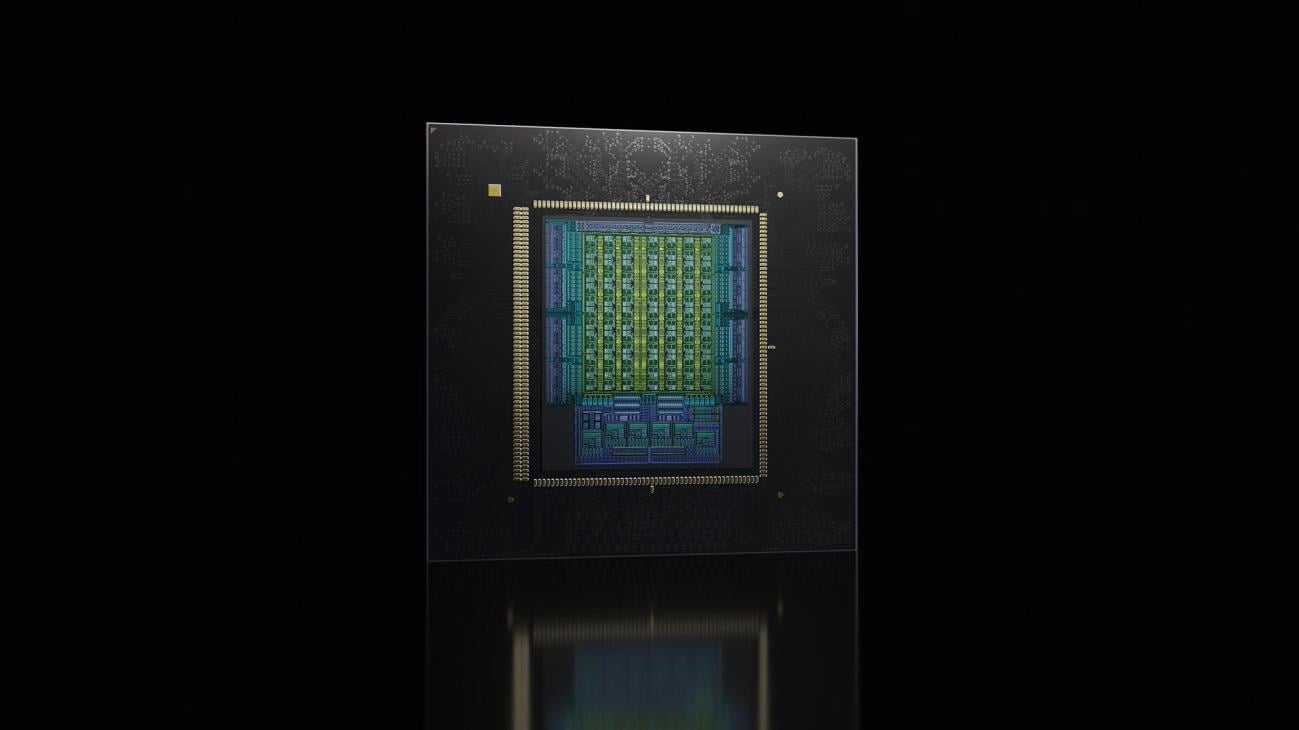

Z punktu widzenia fizycznej architektury systemu wdrożenie Groq 3 LPX w skali szafy obejmuje maksymalnie 256 akceleratorów LP30 połączonych za pomocą szybkich, bezpośrednich połączeń między układami scalonymi.
Wdrożenia w chmurze i ekosystem systemów
Trwa wczesna komercyjna adaptacja przez wyspecjalizowanych dostawców usług chmurowych. Nebius został mianowany pierwszym partnerem w chmurze AI, który wdrożył Groq 3 LPX, planując wprowadzenie tego sprzętu do produkcyjnej usługi wnioskowania Nebius Token Factory. Architektura ta została zaprojektowana tak, aby umożliwić programistom dostęp do akceleracji wnioskowania w czasie rzeczywistym za pośrednictwem istniejących interfejsów API bez konieczności migracji baz kodu do nowych abstrakcji frameworka. Dostawca wnioskowania, Groq, spodziewa się być jednym z pierwszych użytkowników tej platformy.


NVIDIA łączy premierę z zaktualizowaną matematyką platformy dla szafy rack, do której jest podłączana, zapewniając nawet 30-krotnie większą przepustowość tokenów na megawat dla Vera Rubin NVL72 w porównaniu z GB300 NVL72 przy obciążeniu kodowania agentowego 140 000 tokenów, a przewaga ta rośnie wraz ze wzrostem docelowych interaktywności dla użytkownika. Implementacja sprzętowa jest zgodna z infrastrukturą fabryczną pełnego stosu sztucznej inteligencji Rubin firmy NVIDIA, która obejmuje siedem oddzielnych układów scalonych w pięciu specjalnie zaprojektowanych konfiguracjach szaf rack.
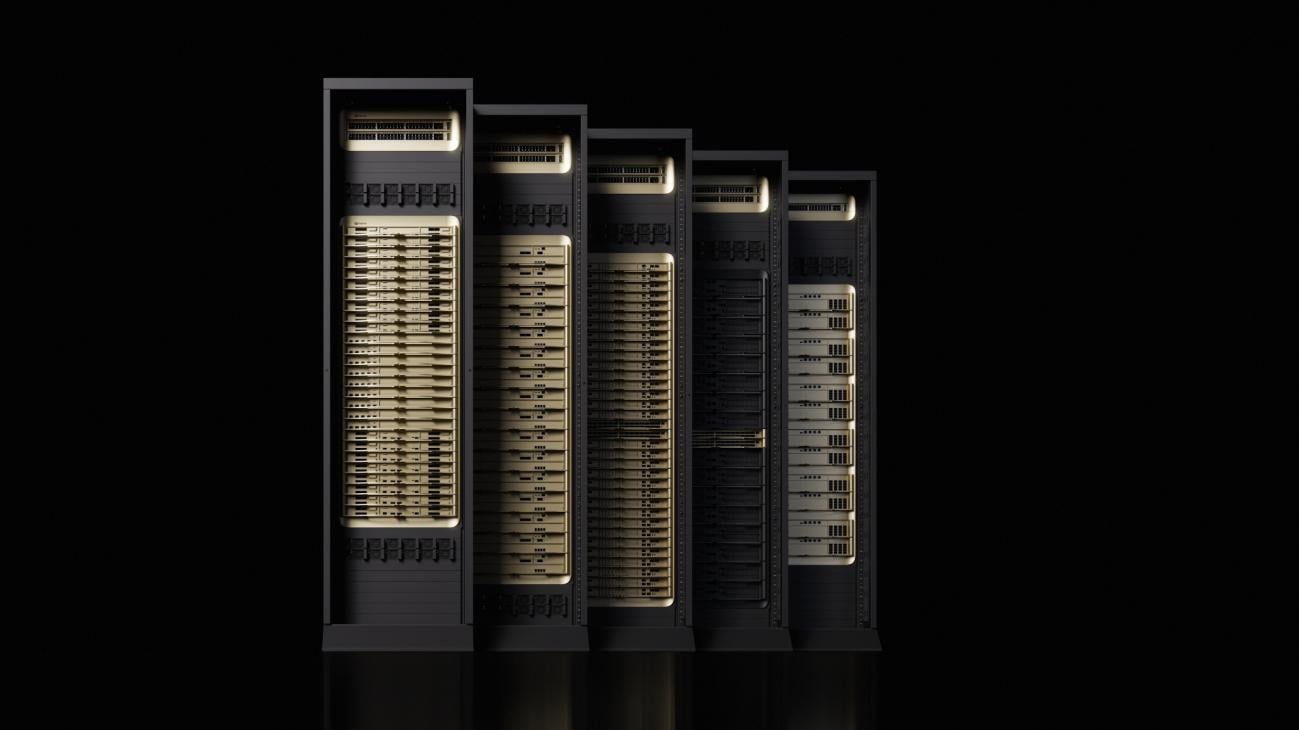
Elementy systemu działające wraz z klastrami obliczeniowymi Rubin i LPX obejmują szafy procesorów NVIDIA Vera, macierze pamięci masowej Vera BlueField-4 STX i struktury sieciowe NVIDIA Spectrum-6 SPX.
Co mówią NVIDIA i Nebius
„Wnioskowanie jest motorem napędowym rozwoju sztucznej inteligencji. NVIDIA Grace Blackwell i NVL72 zrewolucjonizowały wnioskowanie w modelach wielojęzykowych, zapewniając bezprecedensowy skok w wydajności i efektywności” – powiedział Jensen Huang, założyciel i dyrektor generalny firmy NVIDIA. „Vera Rubin rozszerza tę wizję, oferując zoptymalizowane pod kątem obciążenia konfiguracje fabryczne sztucznej inteligencji, zaprojektowane z myślą o erze sztucznej inteligencji opartej na agentach, przesuwając granicę wydajności dzięki LPX do ultraszybkiego generowania tokenów”.
Nebius określił wartość w kontekście faktycznego opóźnienia dla użytkowników. „Generowanie to faza wnioskowania, która określa, jak responsywny jest system sztucznej inteligencji, i właśnie do tego została stworzona platforma NVIDIA Groq 3 LPX” – powiedziała Danila Shtan, dyrektor ds. technologii w Nebius. „Jako pierwsza chmura AI, która wprowadza ją do produkcji za pośrednictwem Nebius Token Factory, dbamy o to, aby każdy krok w pętli agenta był natychmiastowy, za pośrednictwem tego samego interfejsu API, z którego korzystają już programiści, bez konieczności migracji do nowego stosu”.
Infrastruktura wielopłaszczyznowa i skalowalna Spectrum-X
Aby sprostać ogromnemu zapotrzebowaniu sieciowemu tych fabryk wnioskowania, NVIDIA zaprezentowała architekturę Spectrum-X Multiplane Ethernet. Tradycyjna rozbudowa klastra poza współczesne ograniczenia gęstości często wymaga dodania trzeciej warstwy przełączającej, co wiąże się z opóźnieniami, kosztami okablowania optycznego i nadmiernym zużyciem energii. Spectrum-X Multiplane omija ten problem, dzieląc interfejsy sieciowe hosta na wiele niezależnych warstw, z których każda obsługuje płaską, dwuwarstwową sieć skalowalną do 512 000 GPU.

Zarządzanie ruchem i łagodzenie awarii są obsługiwane w układzie scalonym przez układ NVIDIA ConnectX-9 SuperNIC, który obsługuje prędkości sieci do 1,600 Gb/s na GPU w połączeniu z układami ASIC Spectrum-6 Ethernet o przepustowości 102.4 Tb/s. Spectrum-XGS Ethernet rozszerza ten sam kod między obiektami, co według firmy NVIDIA przyspiesza kolektywne połączenia NCCL w wielu lokalizacjach o 1.9 raza. W topologii ośmiopłaszczyznowej sprzętowe przełączanie awaryjne natychmiast przekierowuje ruch wokół uszkodzonych ścieżek, utrzymując około 90 procent łącznej przepustowości sieci. NVIDIA twierdzi, że sprzętowe odzyskiwanie danych jest 11 razy szybsze niż programowe równoważenie obciążenia wielopłaszczyznowego, co, jak twierdzi, przekłada się na 1.6 razy większą wydajność fabryczną sztucznej inteligencji.

Równocześnie NVIDIA wprowadziła swój filar sieciowy Scale-In, łączący jednostki przetwarzania danych BlueField-4 ze stosem oprogramowania DOCA . Scale-In jest skierowany do infrastruktury północ-południe, odciążając procesory hosta z izolacji wielu najemców, szyfrowania in-silicon z prędkością łącza, telemetrii i ścieżek danych o wysokiej wydajności.
NVLink Fusion do integracji niestandardowych układów krzemowych
NVIDIA wprowadziła również rozwiązanie NVLink Fusion dla operatorów hiperskalowych wymagających architektur hybrydowych. Platforma ta umożliwia bezpośrednią integrację niestandardowych jednostek XPU i procesorów CPU innych firm z szóstej generacji skalowalnych struktur sieciowych NVLink i NVLink-C2C firmy NVIDIA. Wykorzystując modułowe projekty obudów NVIDIA MGX i oprogramowanie do zarządzania, operatorzy centrów danych mogą standaryzować projekty współdzielonych szaf zasilających, chłodzących i sieciowych, jednocześnie dostosowując konkretne proporcje procesorów graficznych, jednostek LPU i niestandardowych układów scalonych w miarę rozwoju obciążeń.
NVIDIA ogłosiła drugą generację procesorów Vera Rubin na konferencji Hot Chips: SpaceXAI wdraża procesory Vera do obsługi zadań agentowych w satelitach Grok i planuje umieścić zoptymalizowany procesor Vera Rubin NVL72 na orbicie satelity Starmind pierwszej generacji.


 Amazon