

Na konferencji AI Infra Summit zaprezentowano wyniki wnioskowania MLPerf opracowane przez firmy AMD i NVIDIA, a także plan rozwoju technologii Vera Rubin firmy NVIDIA na rok 2026, w szczególności technologii Rubin CPX.
Podczas konferencji AI Infra Summit 2025 firma NVIDIA zaprezentowała dynamikę na dwóch frontach: imponujące nowe wyniki wnioskowania MLPerf uzyskane z systemów Blackwell Ultra oraz, co ważniejsze, szczegółowy plan działania na generację Vera Rubin na rok 2026, obejmujący Rubin CPX, nową klasę procesorów GPU stworzonych specjalnie do wnioskowania w kontekście masowym.
Blackwell Ultra wyznacza nowe standardy wydajności
Systemy NVIDIA GB300 NVL72 o konstrukcji rackowej osiągnęły już imponującą wydajność w teście MLPerf Inference v5.1, co dowodzi dojrzałości architektonicznej platformy Blackwell Ultra, nawet gdy oprogramowanie wciąż rozwija swój potencjał. Tę moc wyraźnie widać w teście Llama 2 70B, gdzie platforma uzyskała imponujące 12 934 tokeny na sekundę na GPU w scenariuszach offline. Wydajność w teście serwowania online była niemal identyczna i wyniosła 12 701 tokenów na sekundę, co świadczy o wyjątkowej wydajności architektury w różnych obciążeniach.
Gotowość platformy do zastosowań w świecie rzeczywistym została dodatkowo potwierdzona w nowo wprowadzonej kategorii interaktywnej, która nakłada znacznie surowsze ograniczenia dotyczące opóźnień, w tym wymagania dotyczące czasu do pierwszego tokena poniżej 500 ms oraz progu 33 tokenów na sekundę na użytkownika. Nawet przy tak agresywnych wymaganiach dotyczących jakości usług (Quality of Service), Blackwell Ultra utrzymał wysoką przepustowość, dostarczając 7,856 tokenów na sekundę na GPU. W teście wnioskowania DeepSeek-R1 platforma ustanowiła kolejny ostateczny poziom bazowy na poziomie 5,842 tokenów na sekundę na GPU.
Ostatecznie wyniki te wskazują, że możliwości sprzętu przewyższają możliwości obecnego stosu oprogramowania. Znaczny margines wydajności pozostaje jeszcze do wykorzystania, ponieważ frameworki takie jak TensorRT-LLM i NVIDIA Dynamo ewoluują, aby w pełni wykorzystać zalety architektury Blackwell Ultra, takie jak ulepszone ścieżki obliczeniowe NVFP4 i ogromna pojemność pamięci HBM3e wynosząca 288 GB na kartę graficzną.
Przyspieszenie tempa innowacji: Platforma Very Rubin
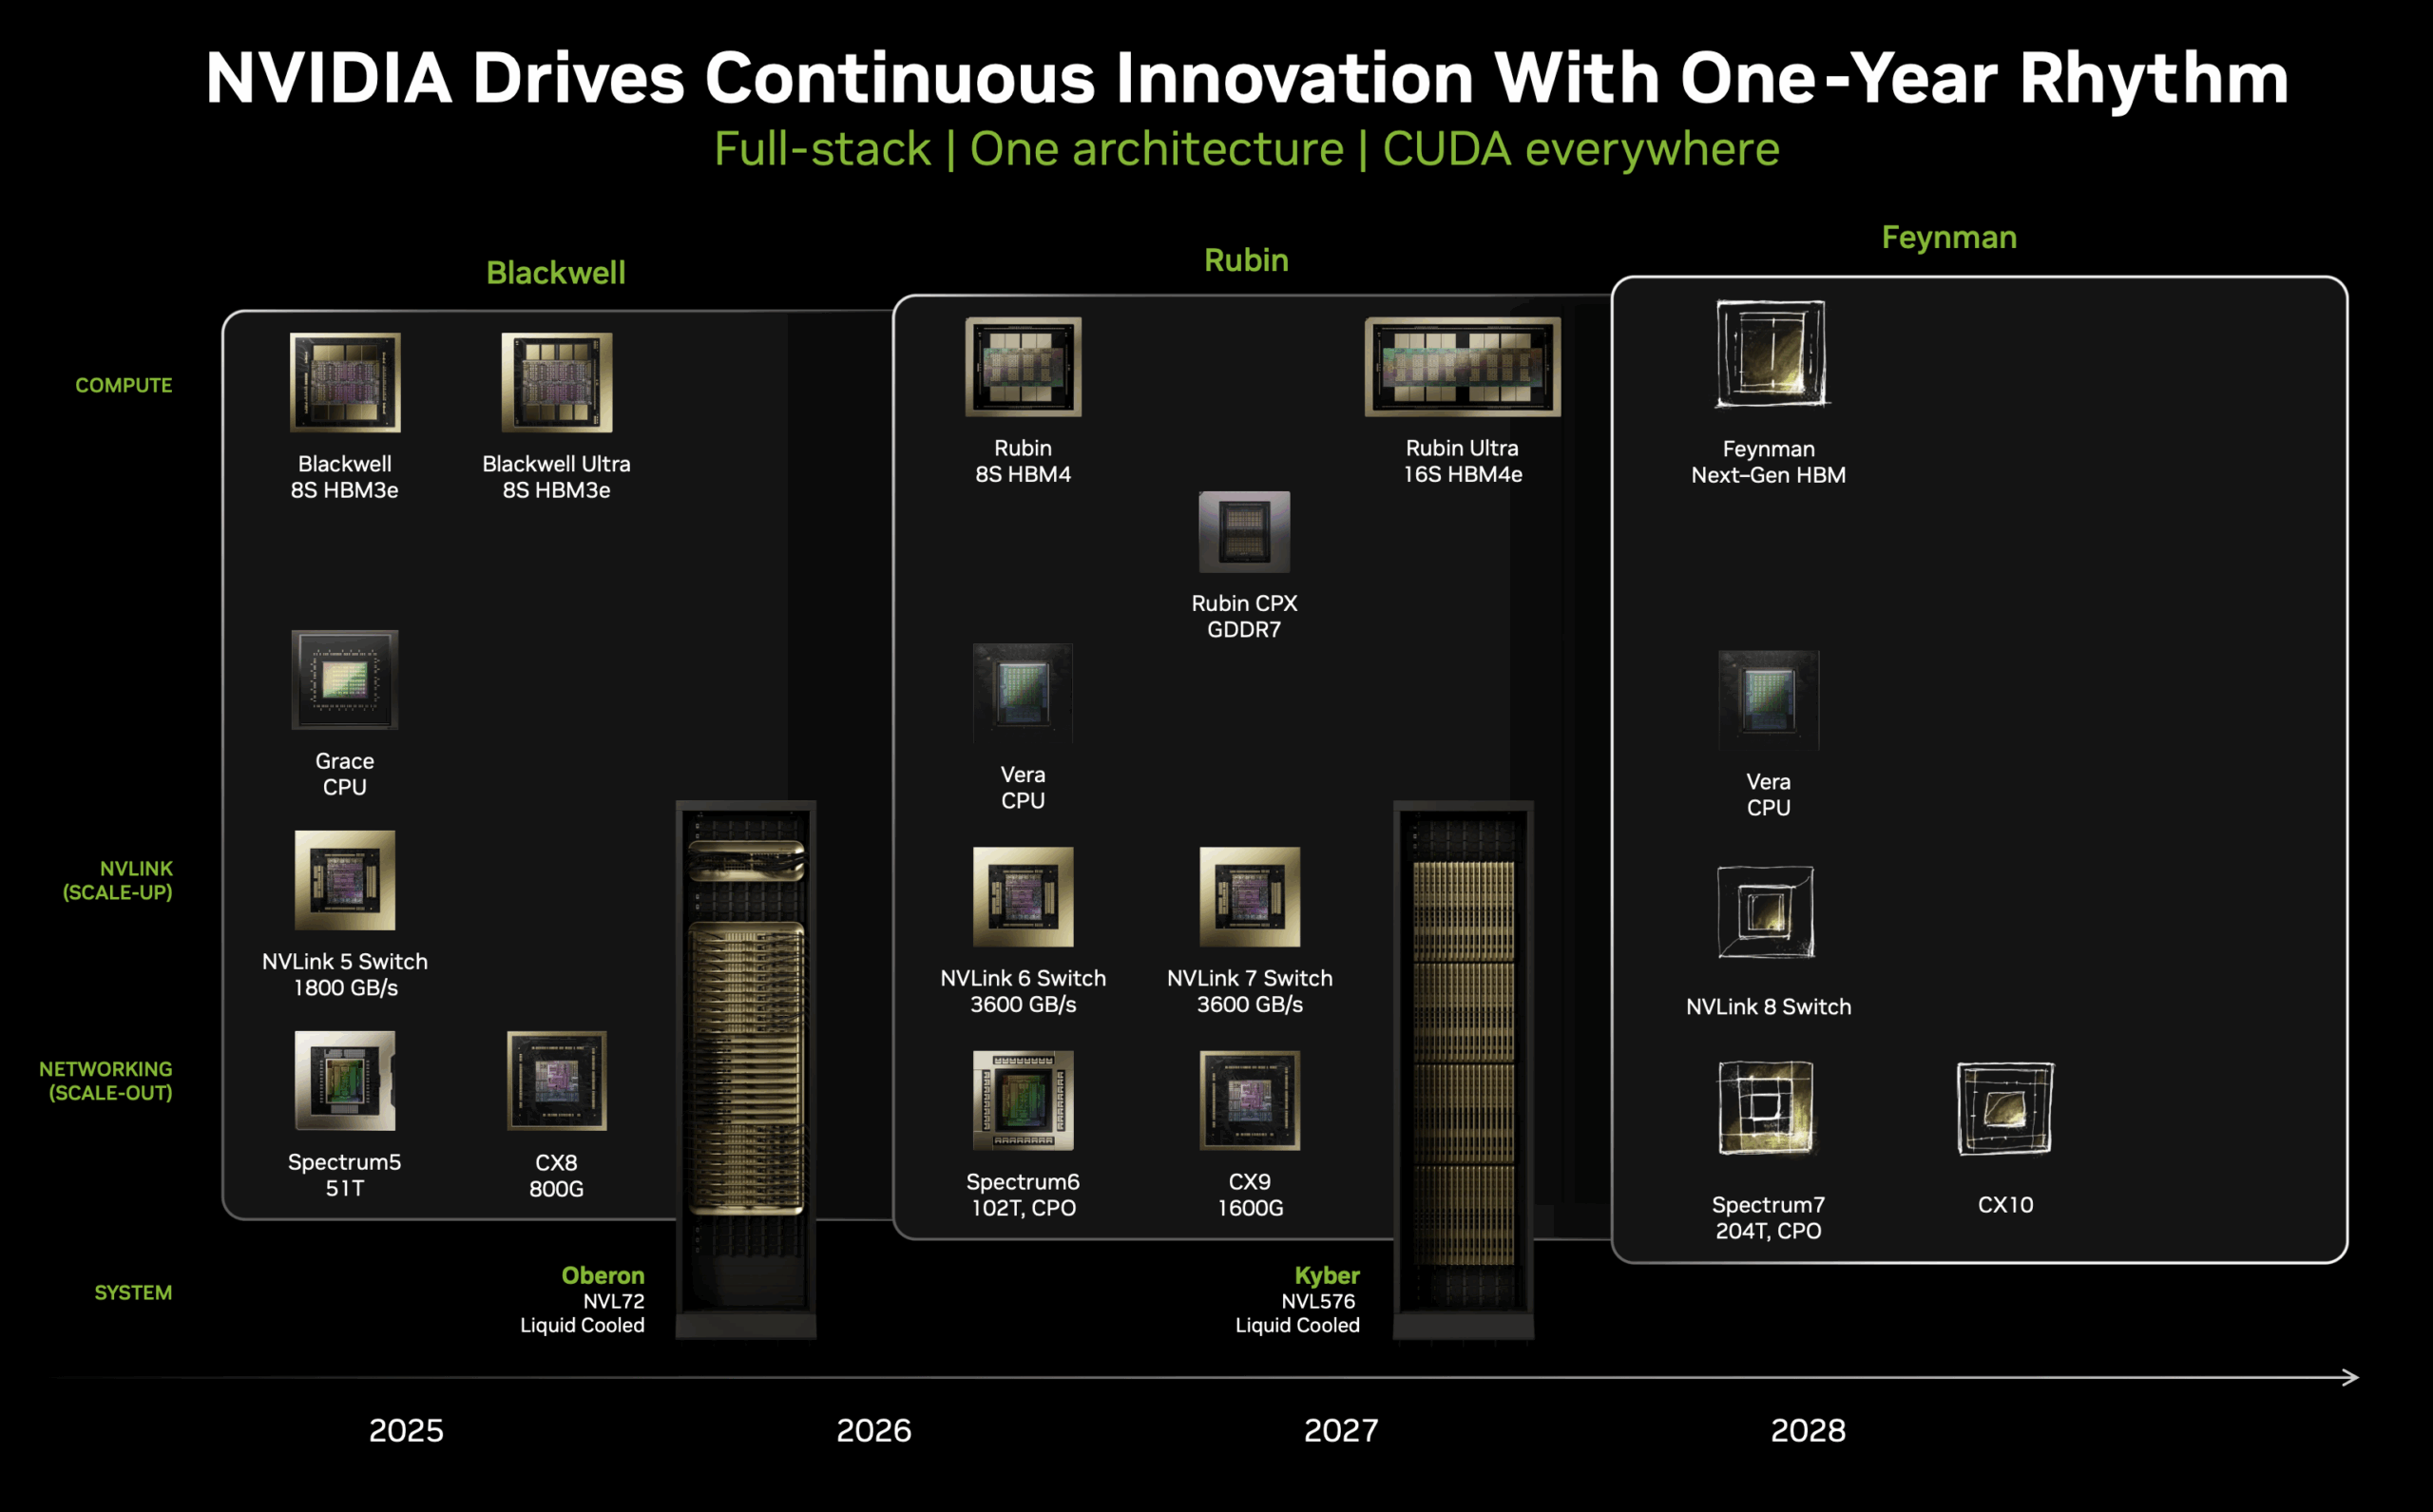
NVIDIA przyjęła coroczny cykl odświeżania architektury jako strategiczną odpowiedź na wykładniczy wzrost zapotrzebowania na obliczenia w dziedzinie sztucznej inteligencji. Zgodnie z tym ambitnym harmonogramem, NVIDIA ogłosiła, że generacja Vera Rubin jest już gotowa i planowana do wdrożenia w przedsiębiorstwach w drugiej połowie 2026 roku.
Architektura Vera Rubin wprowadza kompleksową odświeżenie platformy, skoncentrowane na integracji nowych procesorów Vera i układów GPU Rubin. Procesor Vera stanowi znaczącą ewolucję w stosunku do trzech ostatnich generacji systemów NVIDIA Grace. Procesory Vera posiadają 88 rdzeni ARM obsługujących 176 wątków. Procesory te podwajają również przepustowość łącza między układami (C2C) do 1,800 GB/s, umożliwiając szybsze połączenie między procesorem, układem GPU i ich współdzielonymi zasobami pamięci.

W warstwie połączeń, NVLink szóstej generacji zapewnia dwukierunkową przepustowość 3,600 GB/s, podwajając tym samym przepustowość obecnych przełączników NVLink piątej generacji. Ta ulepszona łączność staje się szczególnie istotna, ponieważ modele skalują się poza pojemność pamięci poszczególnych urządzeń, co wymaga zaawansowanych strategii równoległego wykonywania zadań, które minimalizują opóźnienia w komunikacji i maksymalizują przepustowość między węzłami.
Uzupełniając rozwój technologii NVLink, przełącznik Spectrum-6, wykorzystujący technologię optyki w obudowie (CPO), osiąga przepustowość przełączania 102 TB/s. Integracja komponentów optycznych bezpośrednio w obudowie przełącznika eliminuje tradycyjne wąskie gardła konwersji elektrycznej na optyczną, zmniejszając opóźnienia i jednocześnie znacząco poprawiając efektywność energetyczną – kluczowe kwestie w kontekście skalowania fabryk AI w kierunku gigawatów.

Systemy VR NVL144 będą nadal wykorzystywać sprawdzoną platformę stelażową Oberon, na której obecnie bazują systemy Grace Hopper, Grace Blackwell i Grace Blackwell Ultra.
Ewolucja nomenklatury architektonicznej: od opakowań do matryc
NVIDIA zmienia swoją konwencję nazewnictwa z opartej na liczbie układów scalonych na liczbę układów scalonych. Choć ta zmiana może budzić kontrowersje, jest to krok w przyszłość, który zapewni większą przejrzystość, zwłaszcza w kontekście spodziewanej premiery procesorów graficznych Rubin Ultra pod koniec 2026 roku, które mają zawierać cztery układy scalone wielkości siatki.

W generacji Rubin firma NVIDIA stosuje nomenklaturę opartą na liczbie kości, która bezpośrednio odzwierciedla dostępne zasoby obliczeniowe. Oznaczenie NVL144 wyraźnie odnosi się do 144 kości GPU, zachowując jednocześnie 72-pakietową konfigurację fizyczną i zapewniając dokładniejszy pomiar mocy obliczeniowej. Jest to podobne do obecnej generacji systemów GB200 i GB300 NVL72, które zawierają 72 pakiety GPU, z których każdy mieści dwie kości GPU, co daje łącznie 144 kości obliczeniowe.
Rozwiązanie problemu przetwarzania kontekstu
Zapowiedź Rubin CPX, którego dostępność planowana jest na koniec 2026 roku, to architektoniczna odpowiedź firmy NVIDIA na jedno z najpilniejszych wyzwań w wnioskowaniu LLM: fundamentalną niezgodność między wzorcami obliczeniowymi na różnych etapach generowania tokenów. Aby zrozumieć tę innowację, musimy przyjrzeć się specyficznym cechom obciążeń wnioskowania LLM oraz ograniczeniom obecnych, jednorodnych architektur GPU w zakresie obsługi tych zróżnicowanych wymagań obliczeniowych.
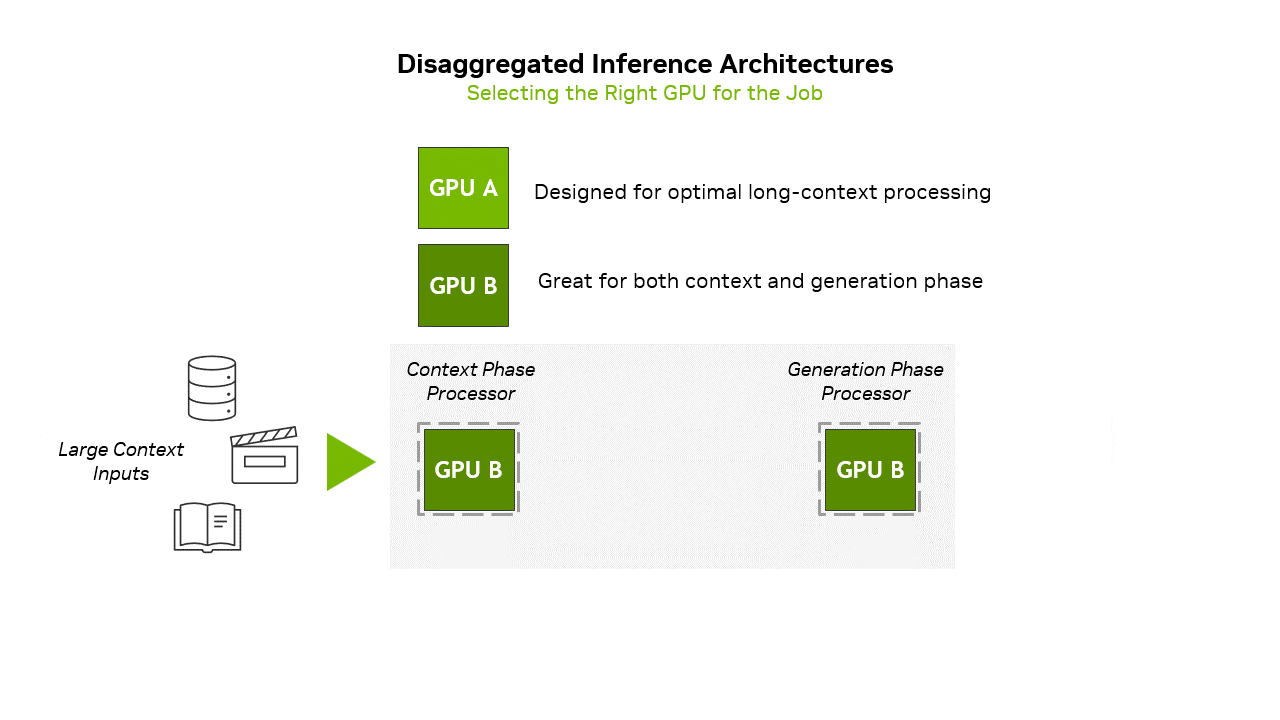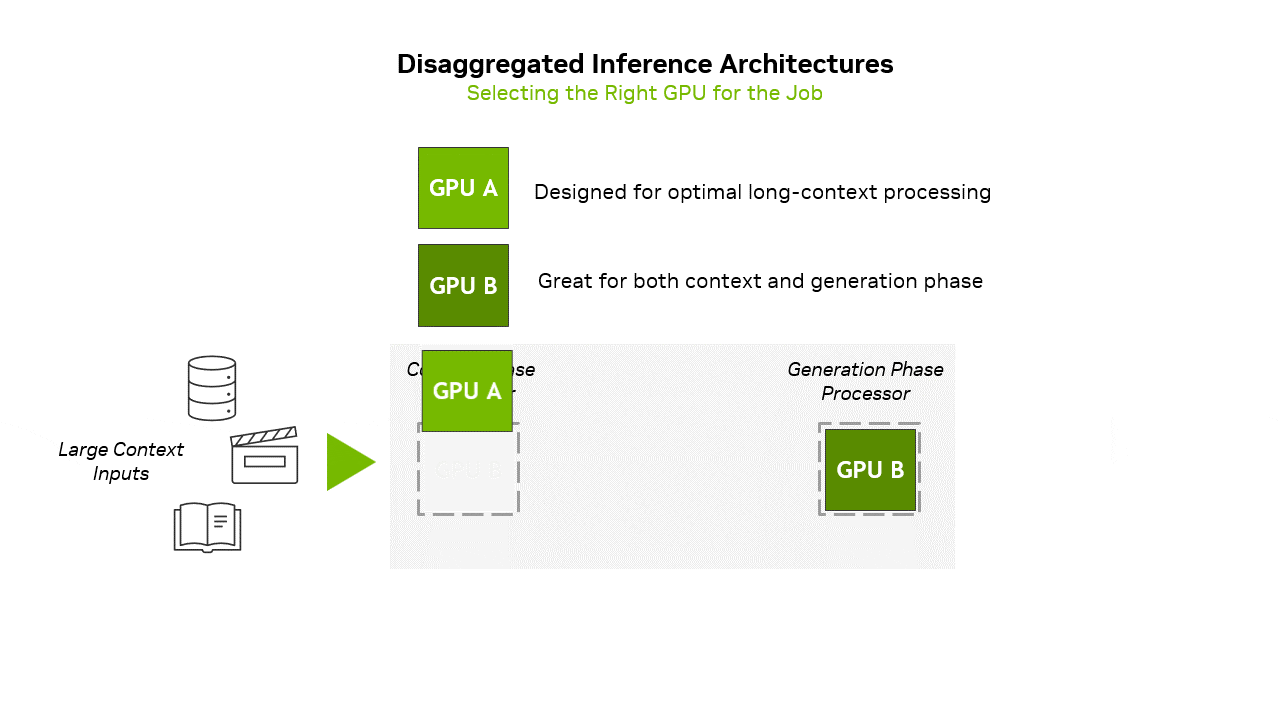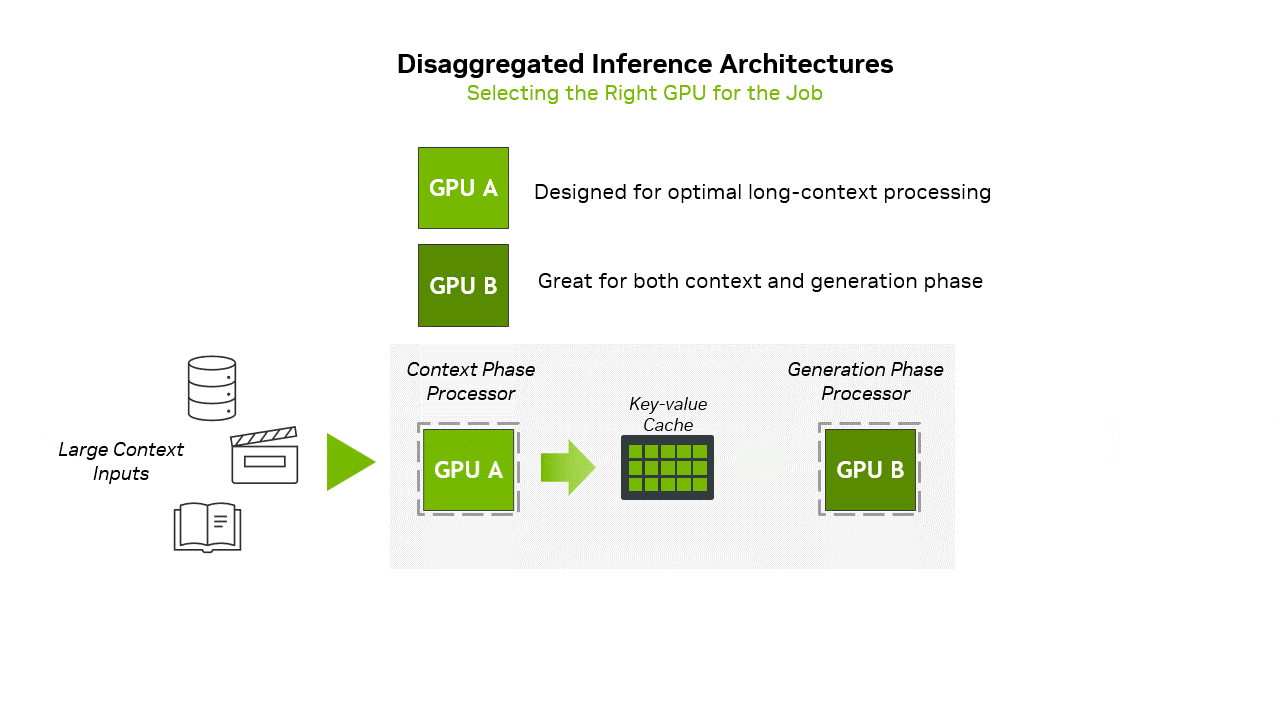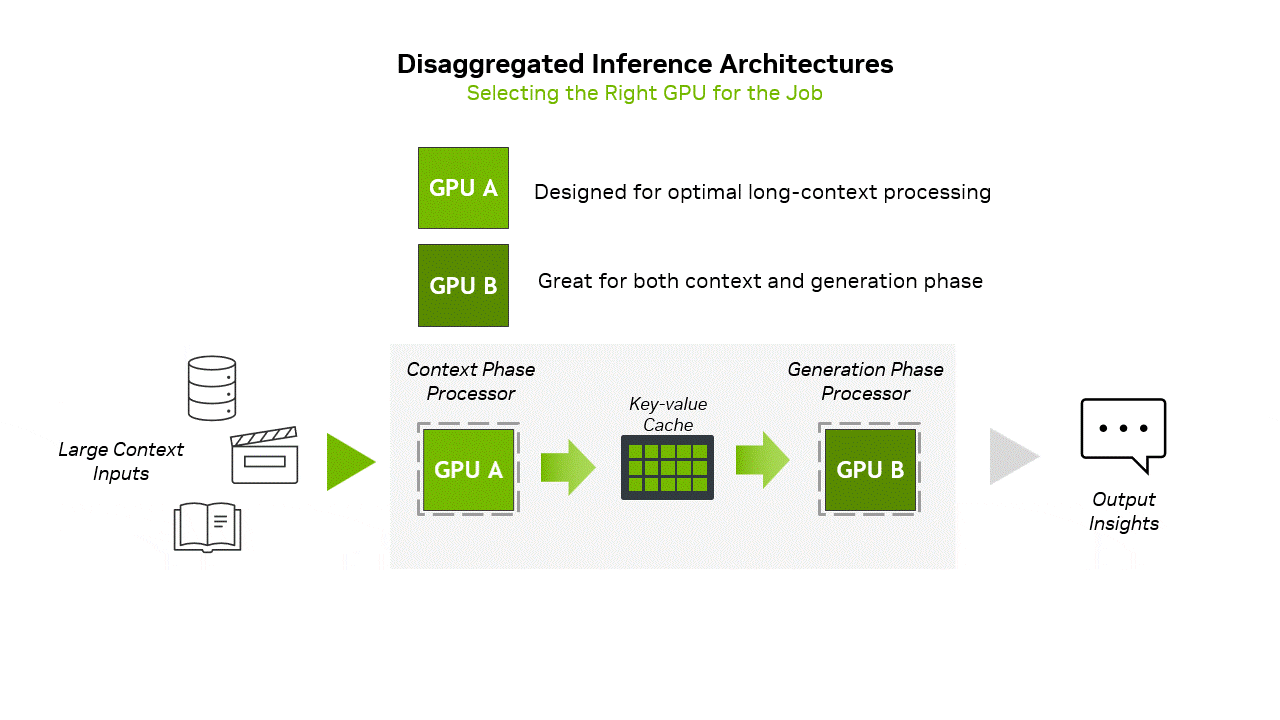
Wnioskowanie w dużym modelu językowym odbywa się poprzez dwie zasadniczo różne fazy obliczeniowe, które stawiają diametralnie różne wymagania w zakresie zasobów sprzętowych. Etap wstępnego wypełniania przetwarza początkowy monit wejściowy, obliczając macierze kluczy i wartości do późniejszego generowania. Ta faza jest obliczeniowo intensywniejsza i efektywnie wykorzystuje ogromną przepustowość zmiennoprzecinkową nowoczesnych procesorów graficznych.
Etap dekodowania stanowi zupełnie inne wyzwanie obliczeniowe. Podczas dekodowania model generuje tokeny wyjściowe w sposób autoregresyjny, produkując jeden token na raz, uwzględniając poprzedni kontekst. Każdy nowy token wymaga mechanizmu uwagi, aby przetworzyć całą historię sekwencji, obliczając jego relację do wszystkich poprzednich tokenów. Tworzy to unikalny wzorzec obliczeniowy, w którym głównym wąskim gardłem staje się przepustowość pamięci, a nie przepustowość obliczeniowa. Pamięć podręczna KV, która przechowuje reprezentacje pośrednie niezbędne do utrzymania kontekstu, staje się dominującym konsumentem pamięci.
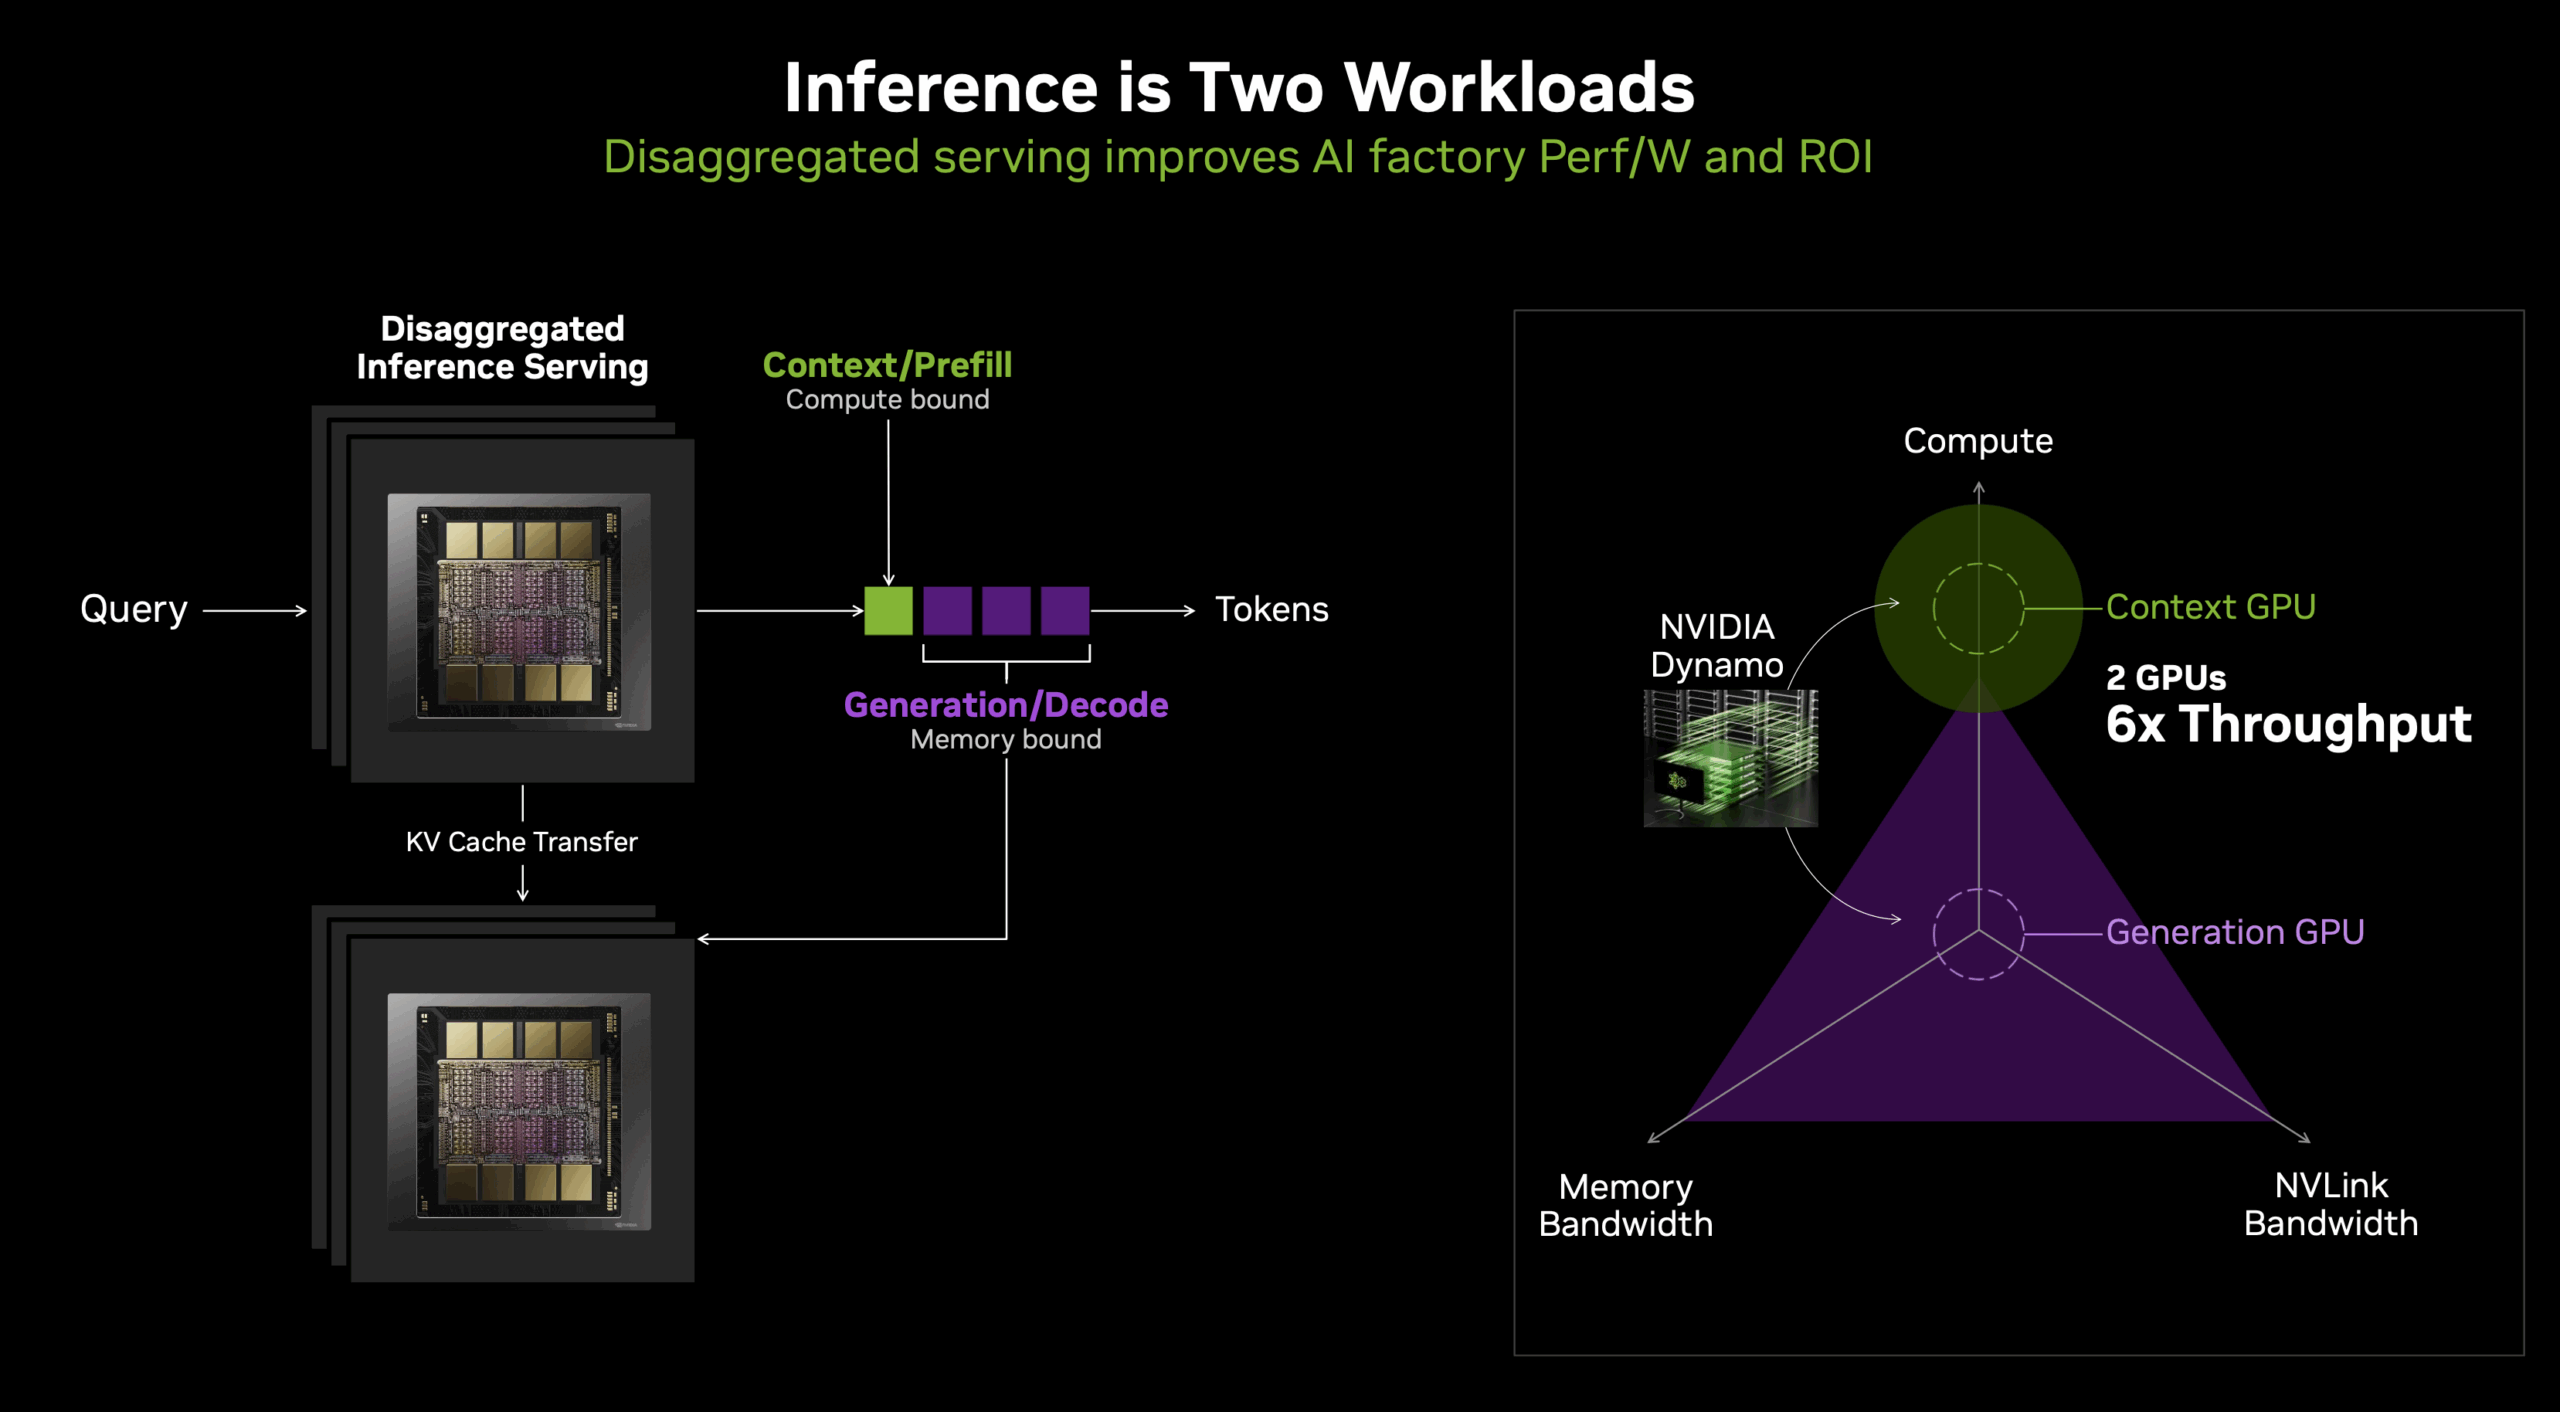
Skalowalność pamięci podręcznej KV stwarza szczególne wyzwania w środowiskach produkcyjnych. W przypadku modelu takiego jak Llama 3.1 405B przetwarzającego rozszerzone konteksty, pamięć podręczna KV może z łatwością zużywać dziesiątki gigabajtów na sekwencję. W scenariuszach wnioskowania wsadowego, które są niezbędne do osiągnięcia wysokiej przepustowości w środowisku produkcyjnym, łączny rozmiar pamięci podręcznej KV często przekracza rozmiar samych wag modelu. Ze względu na duże rozmiary wsadów możliwe w przypadku wdrożeń NVL72 na dużą skalę, pamięć podręczna KV może osiągnąć rozmiar wielu terabajtów. Chociaż dane te muszą być dostępne z rozsądnym opóźnieniem, nie wszystkie dostępy do pamięci podręcznej KV wymagają ekstremalnej przepustowości pamięci HBM. Wiele operacji uwagi wykazuje wzorce dostępu podatne na hierarchiczne architektury pamięci.
Rubin CPX: architektura stworzona specjalnie do przetwarzania kontekstu
Rubin CPX rozwiązuje te niedopasowania architektoniczne poprzez specjalnie zaprojektowaną inferencję LLM w długim kontekście. Architektura opiera się na 128 GB pamięci GDDR7, zapewniając dużą i ekonomiczną pulę pamięci dla operacji pamięci podręcznej KV. Charakterystyka przepustowości pamięci GDDR7, choć niższa niż HBM4, jest wystarczająca dla większości operacji wymagających uwagi, szczególnie w połączeniu z inteligentnymi strategiami buforowania.
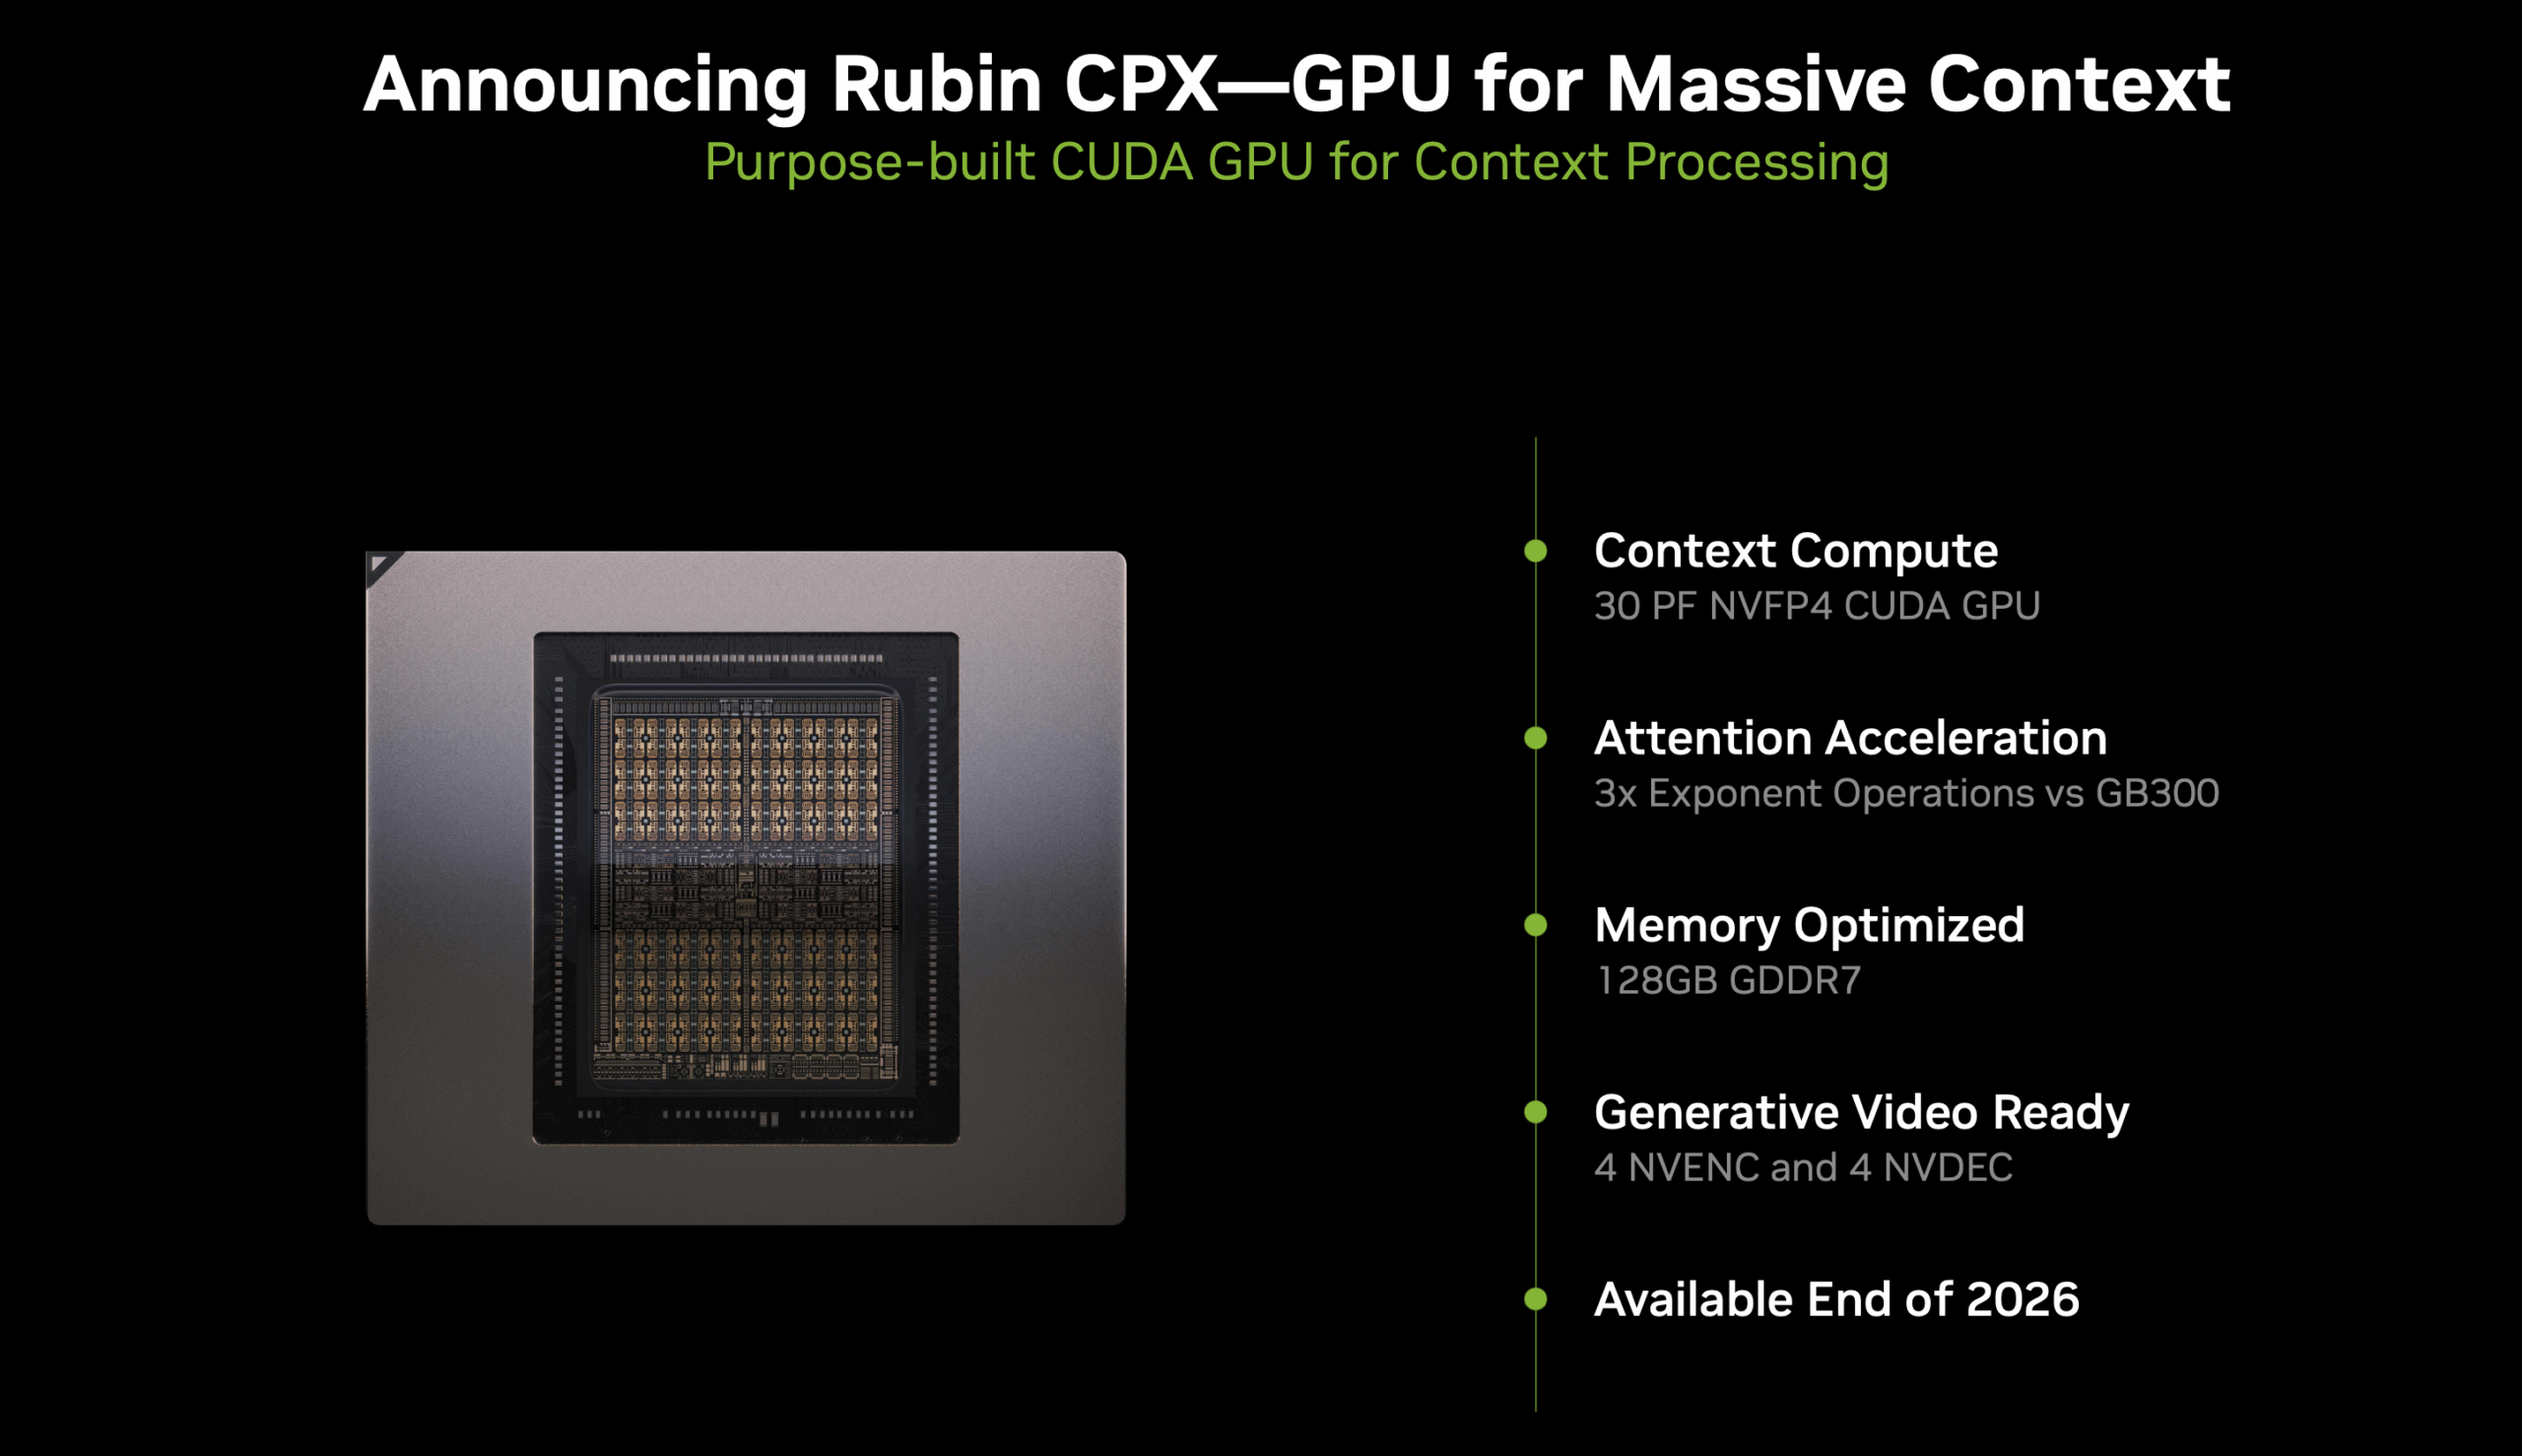
Integracja z szerszą platformą Vera Rubin w szafie VR NVL144 CPX odbywa się za pośrednictwem łączy PCIe poprzez karty sieciowe ConnectX-9 i układy przełączające, co ułatwia hybrydowe modele wykonywania, w których operacje wymagające dużej mocy obliczeniowej są wykonywane na tradycyjnych procesorach GPU. Zarządzanie kontekstem wymagające dużej ilości pamięci jest migrowane do procesorów CPX.
Elastyczne architektury wdrożeniowe i opcje konfiguracji
Modułowa architektura platformy Vera Rubin zapewnia elastyczność wdrażania, umożliwiając organizacjom optymalizację konfiguracji pod kątem specyficznych charakterystyk obciążeń. Standardowa konfiguracja rackowa VR NVL144 zawiera procesory graficzne Vera Rubin z ośmioma kartami sieciowymi ConnectX-9, zapewniając zrównoważoną architekturę odpowiednią do zróżnicowanych obciążeń AI. Ta konfiguracja oferuje 3.6 eksaflopsów mocy obliczeniowej NVFP4, co stanowi 3.3-krotny wzrost w porównaniu z obecnymi systemami GB300 NVL72, a także przepustowość HBM4 na poziomie 1.4 PB/s (2.5-krotnie większą niż w obecnej generacji) i 75 TB pojemności pamięci HBM4 (2-krotnie większą niż w obecnej generacji).
Dla organizacji optymalizujących wnioskowanie i długokontekstowe RL po szkoleniu dostępna jest ultragęsta platforma obliczeniowa VR NVL144 CPX. Każda platforma zawiera cztery pakiety GPU VR, z których każdy zawiera osiem układów GPU, zachowując tym samym gęstość obliczeniową standardowej konfiguracji, a jednocześnie dodając osiem procesorów GPU Rubin CPX. Osiem układów ConnectX-9 NIC/przełączników zapewnia płynny przepływ danych niezbędny do rozproszonego wnioskowania.
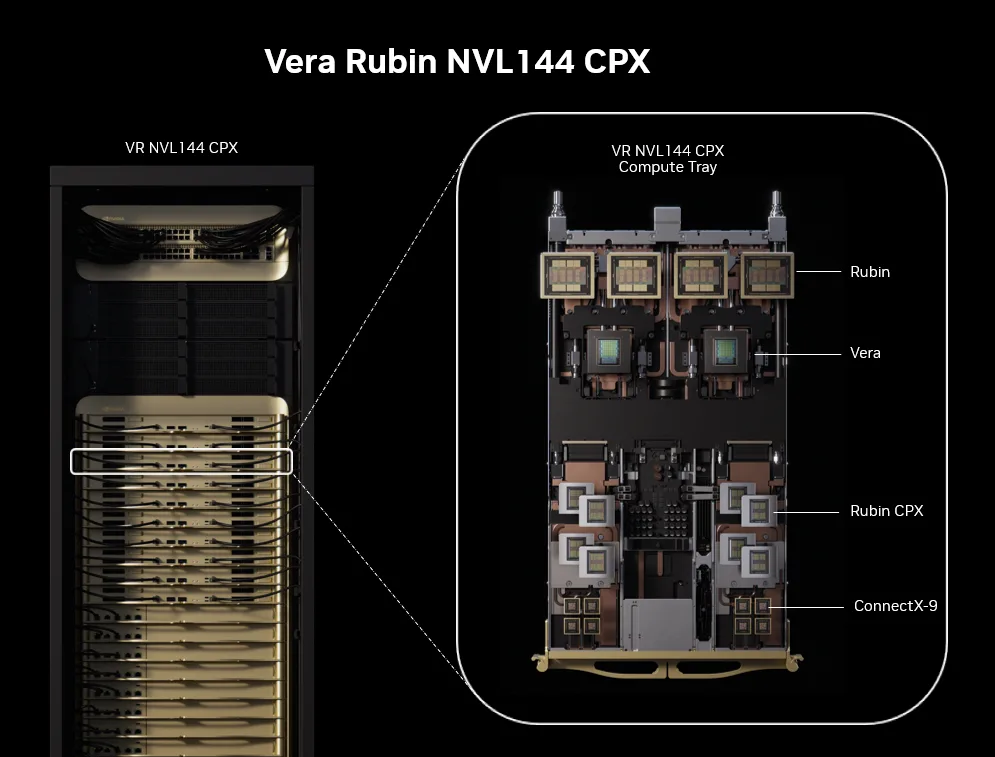
Modułowy charakter architektury umożliwia wyjątkowo elastyczne strategie wdrażania. Organizacje mogą początkowo wdrożyć standardowe szafy VR NVL144, a następnie uzupełniać je o dedykowane szafy Rubin CPX w miarę wzrostu wymagań dotyczących przetwarzania kontekstowego. Takie podejście umożliwia ewolucję infrastruktury w połączeniu z możliwościami modelu, unikając w ten sposób nadmiernego alokowania zasobów.
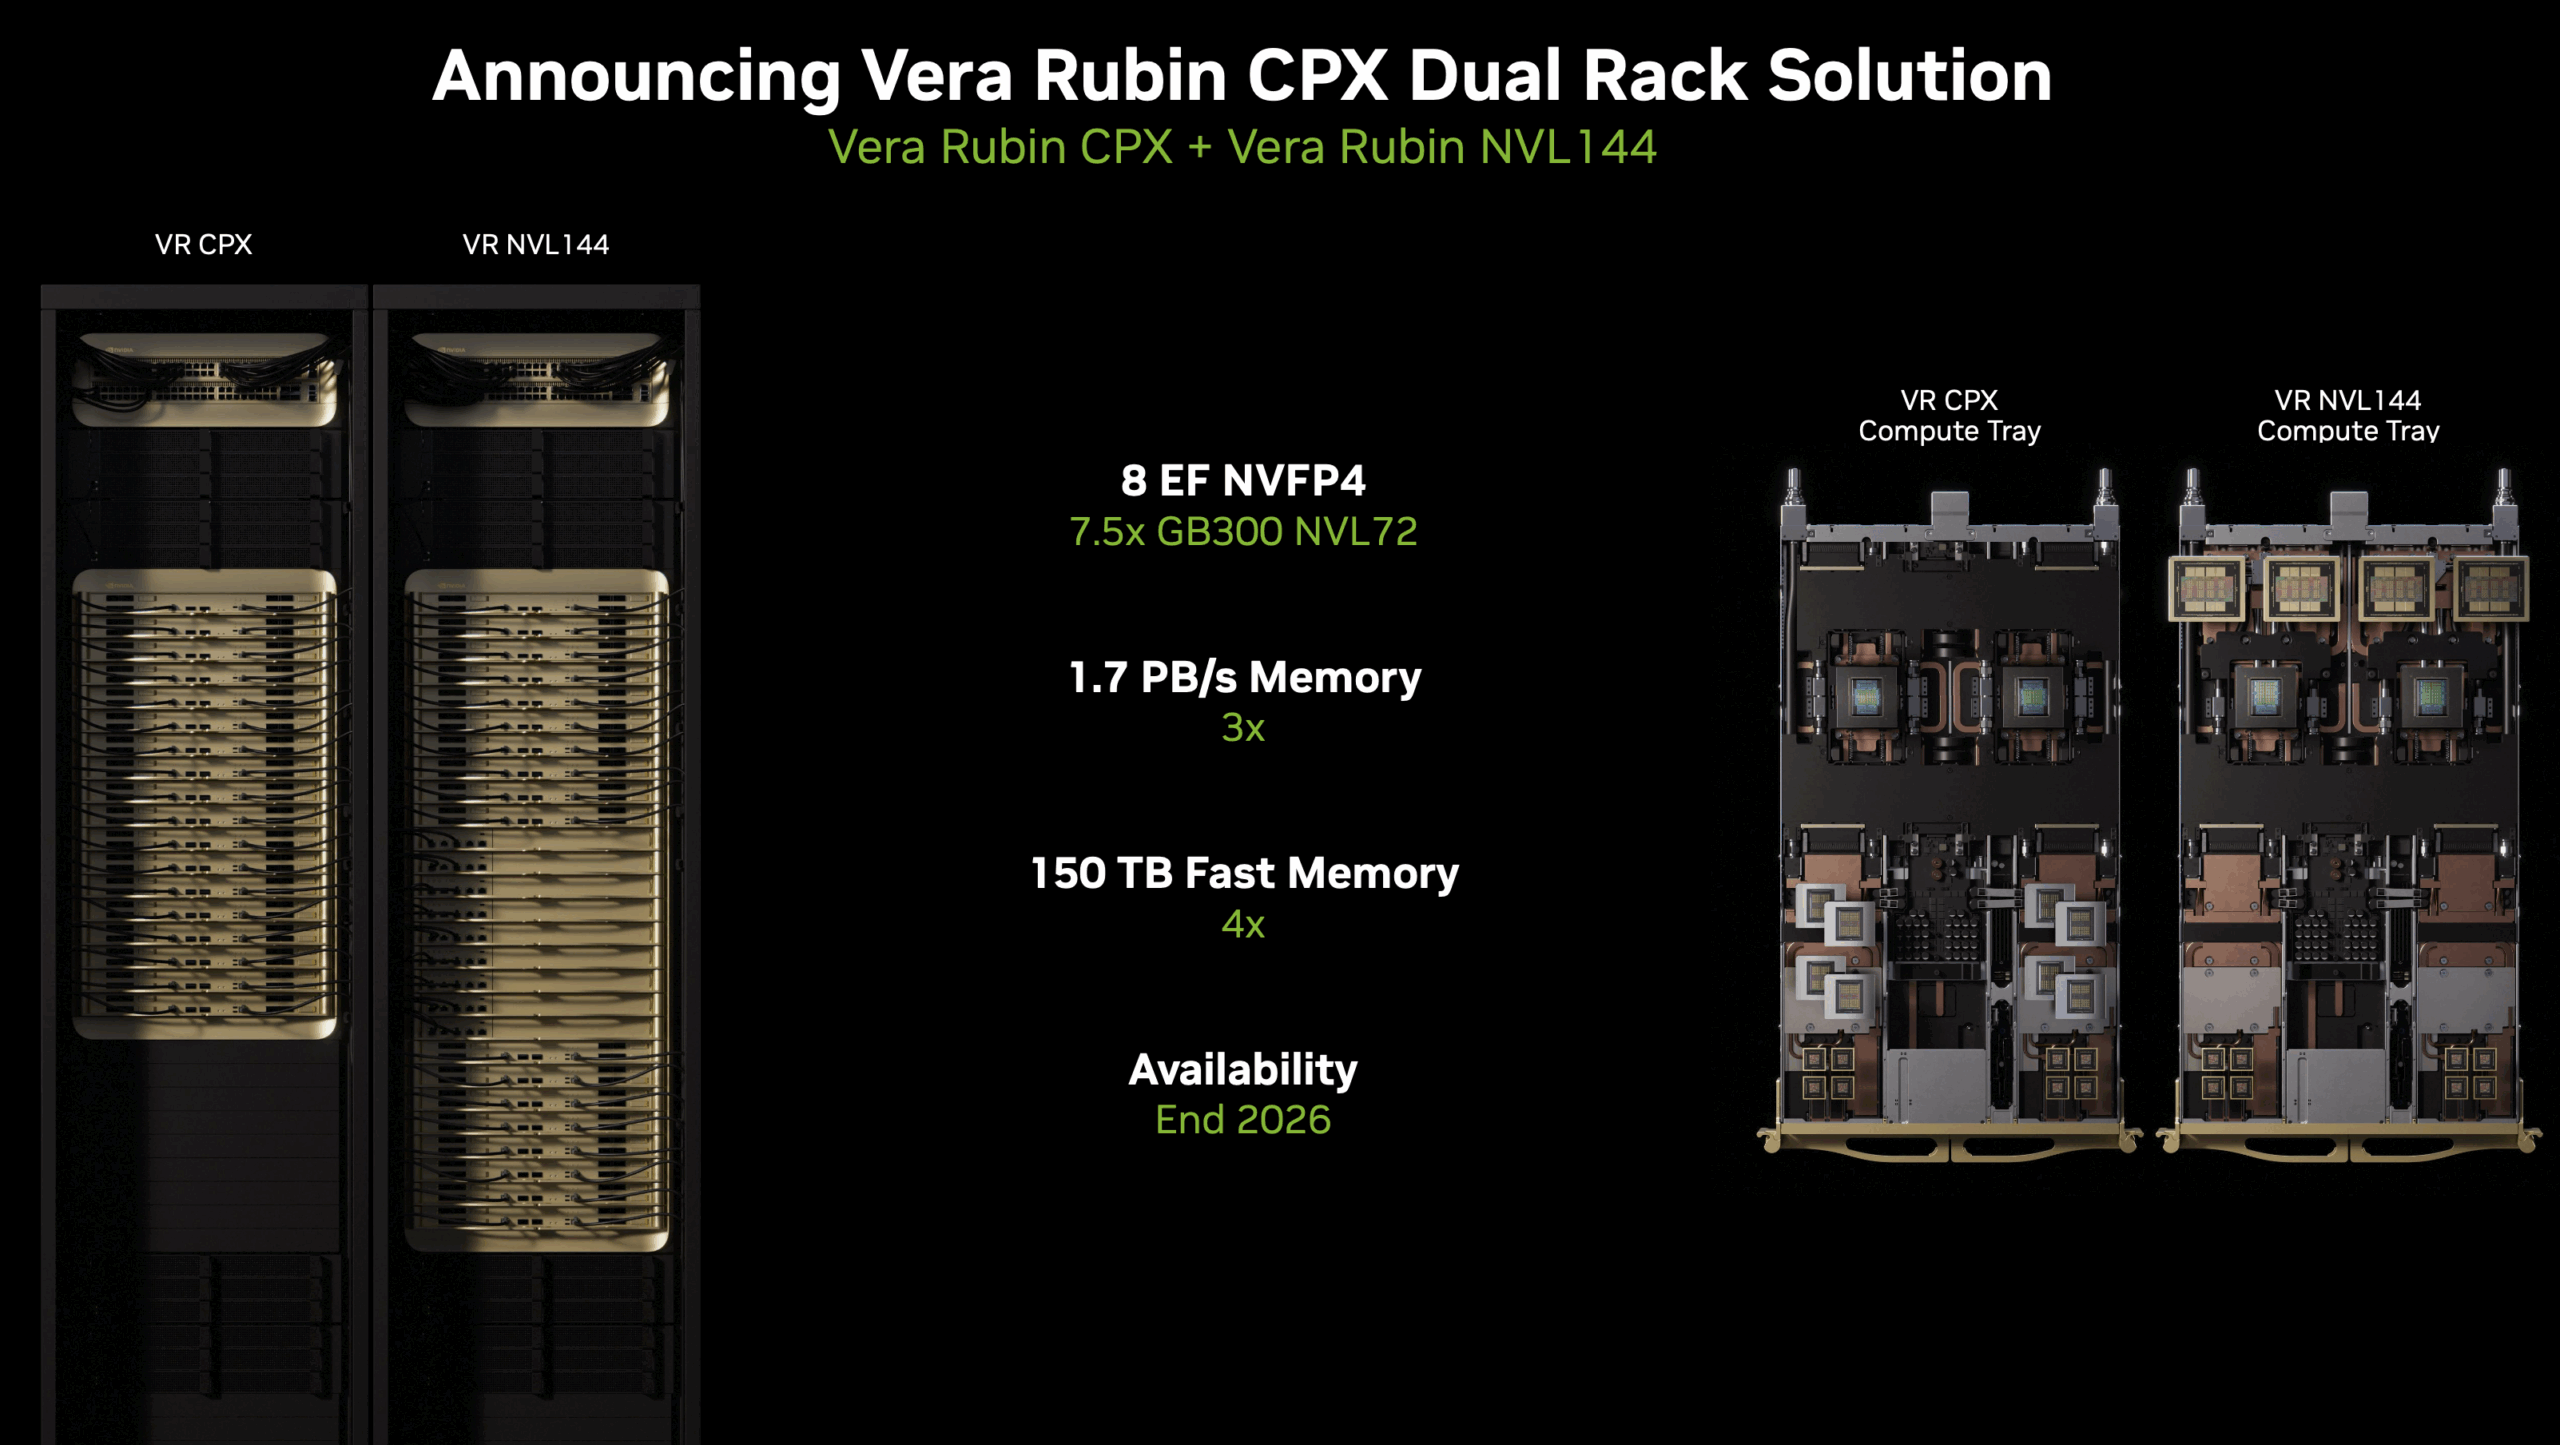
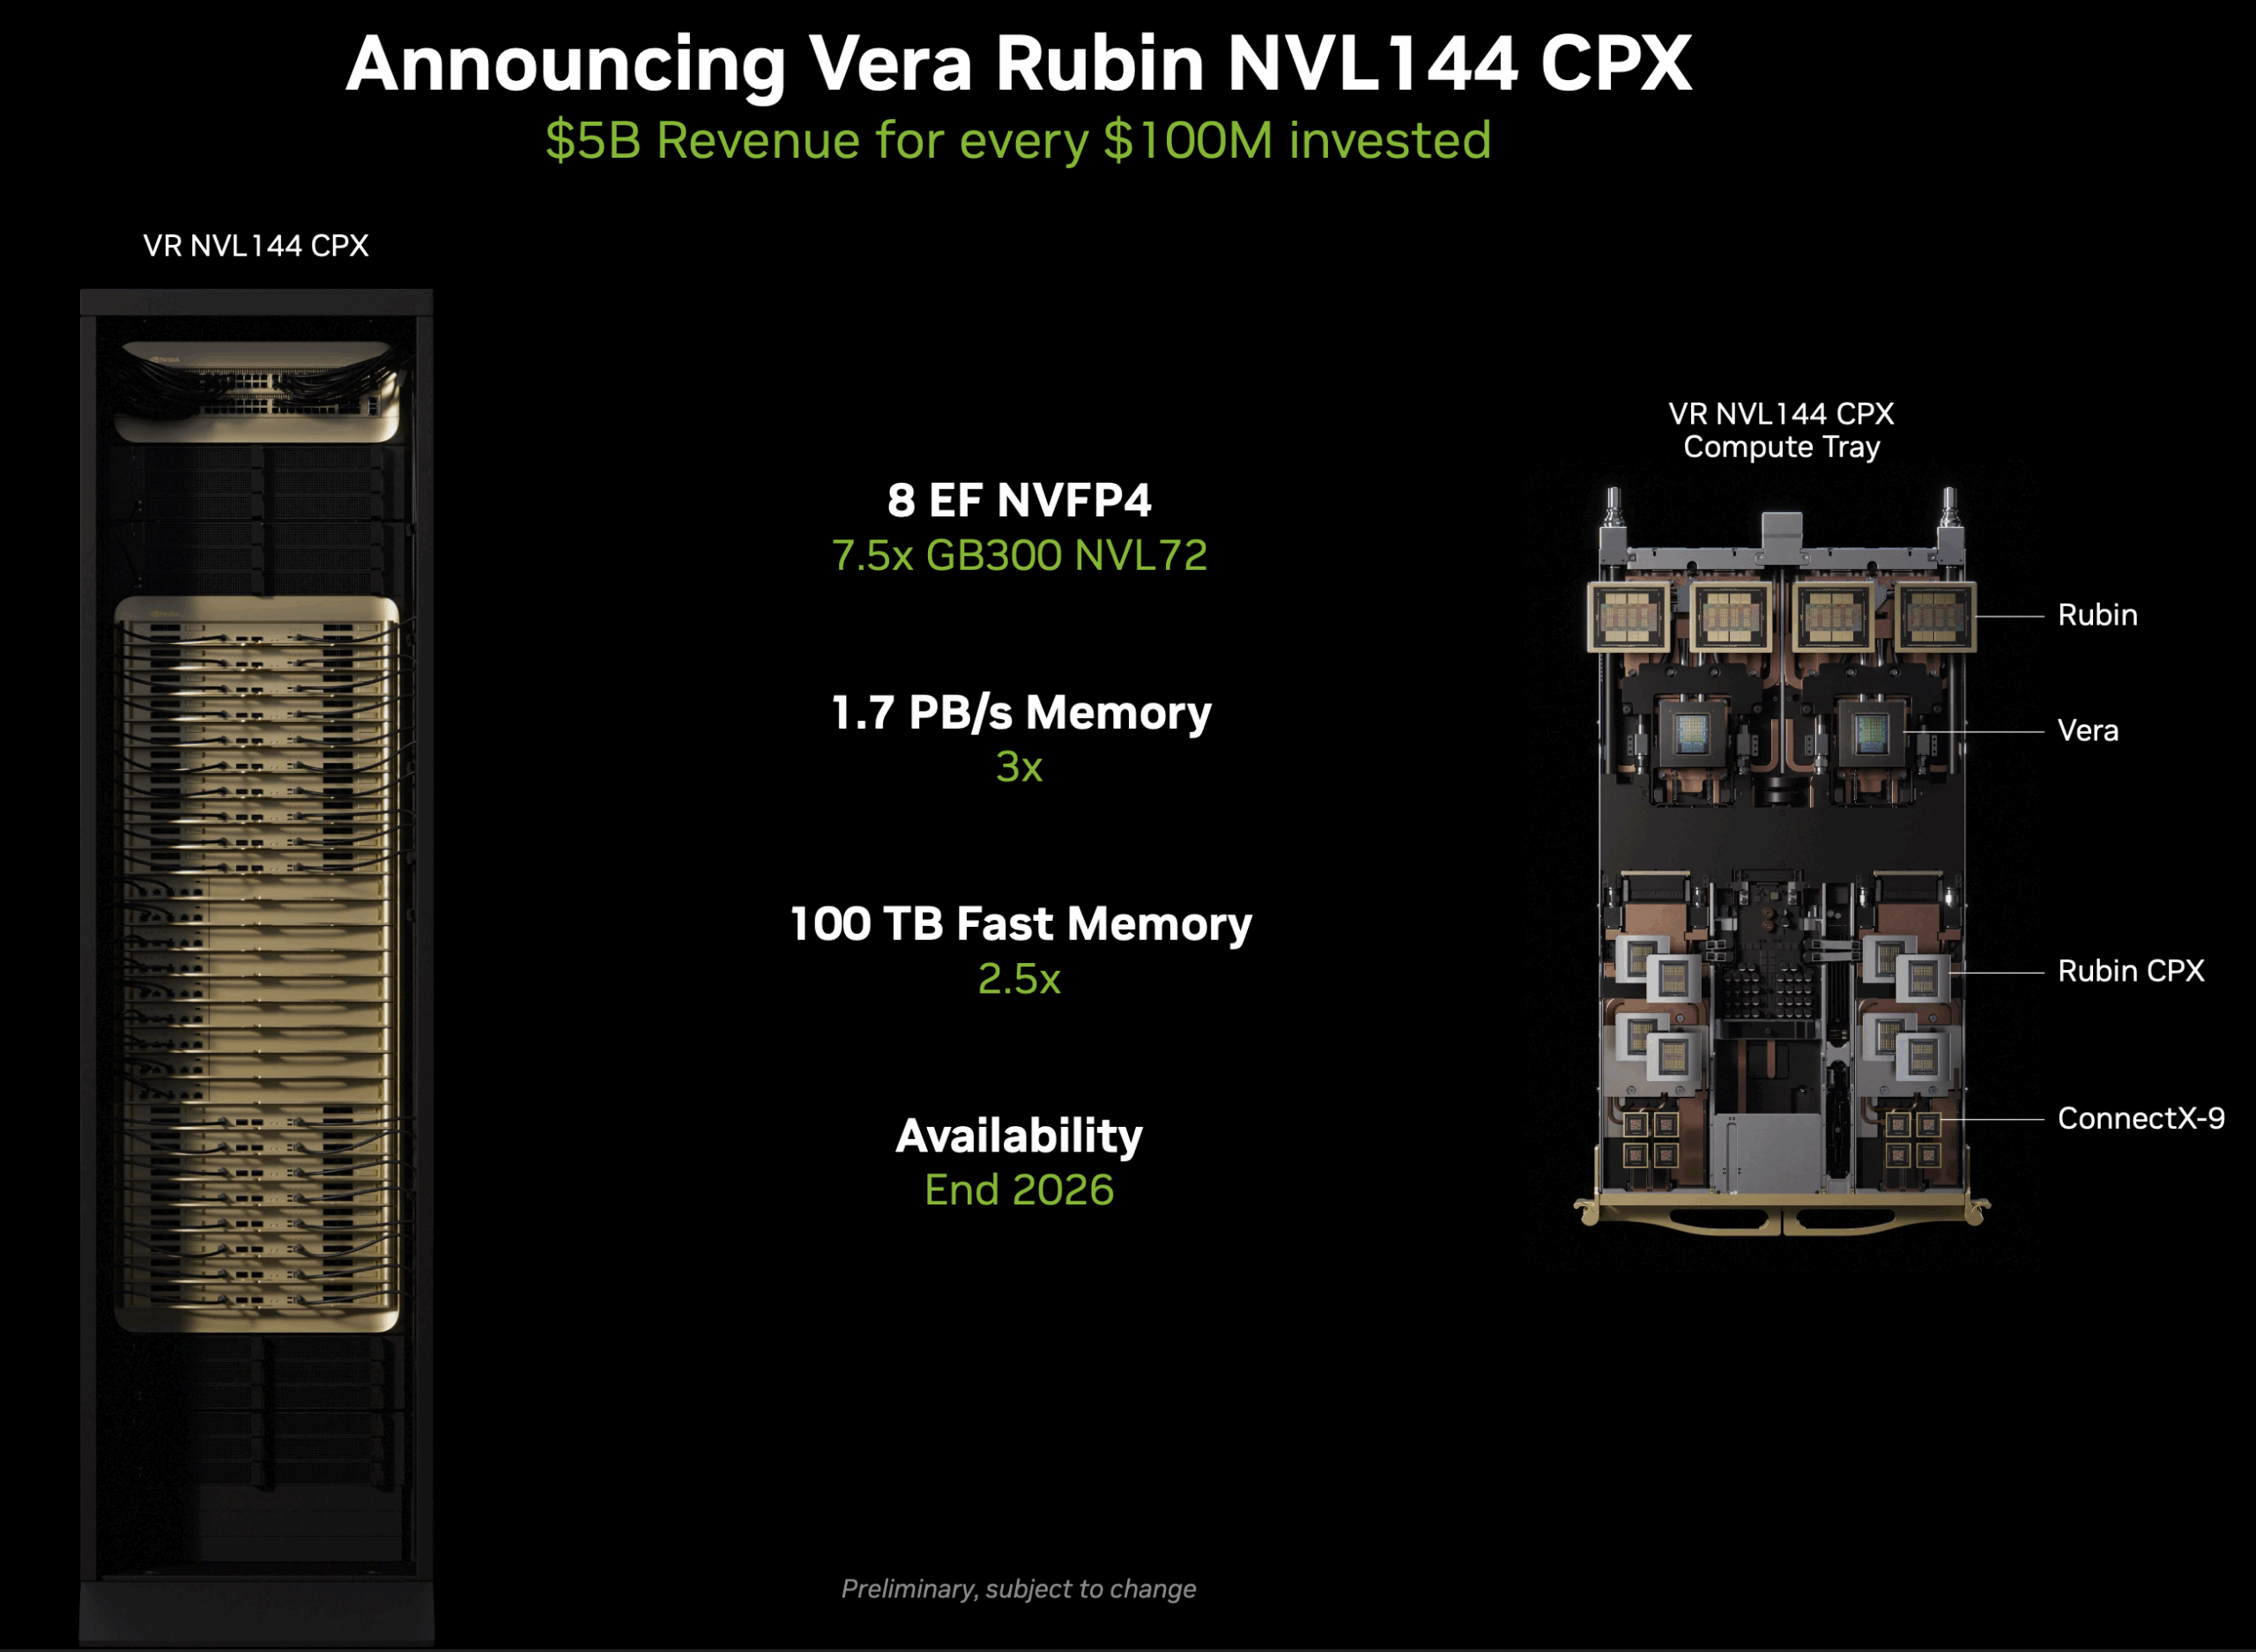
Kompletna konfiguracja VR NVL144 CPX wyznacza nowy poziom mocy obliczeniowej. System oferuje 8 eksaflopów mocy obliczeniowej NVFP4, co stanowi 7.5-krotny wzrost w porównaniu z systemami GB300 NVL72 obecnej generacji. Ta ogromna moc obliczeniowa w połączeniu z łączną przepustowością pamięci na poziomie 1.7 PB/s, wykorzystuje zarówno HBM4, jak i GDDR7, aby osiągnąć trzykrotnie większą przepustowość pamięci niż obecne systemy. Całkowita pojemność pamięci sięga 100 TB, zapewniając 2.5-krotnie większe zasoby pamięci niż platformy obecnej generacji.
NVIDIA planuje udostępnić tę technologię pod koniec 2026 roku. Umożliwi to nowe kategorie aplikacji AI i sprawi, że okna kontekstowe o wartości miliona tokenów staną się praktyczne w środowisku produkcyjnym, umożliwiając systemom AI przetwarzanie całych baz kodu lub obszernych dokumentów w jednym przebiegu. Te innowacje umożliwiają również organizacjom obsługę większych partii, obniżając koszty wnioskowania i tworząc korzystniejsze kalkulacje kosztów operacyjnych (OPEX).
Plan infrastruktury o mocy gigawatów
Oprócz innowacji w poszczególnych systemach, NVIDIA zaprezentowała również architektury referencyjne dla fabryk AI o mocy gigawatów. Opracowane we współpracy z partnerami infrastrukturalnymi, takimi jak Jacobs, Schneider Electric, Siemens Energy i Vertiv, projekty te obejmują cały stos infrastrukturalny, od wytwarzania energii po dostarczanie mocy obliczeniowych. Projekty referencyjne potwierdzają, że wdrożenia AI nowej generacji wymagają holistycznej optymalizacji, wykraczającej daleko poza same komponenty obliczeniowe.
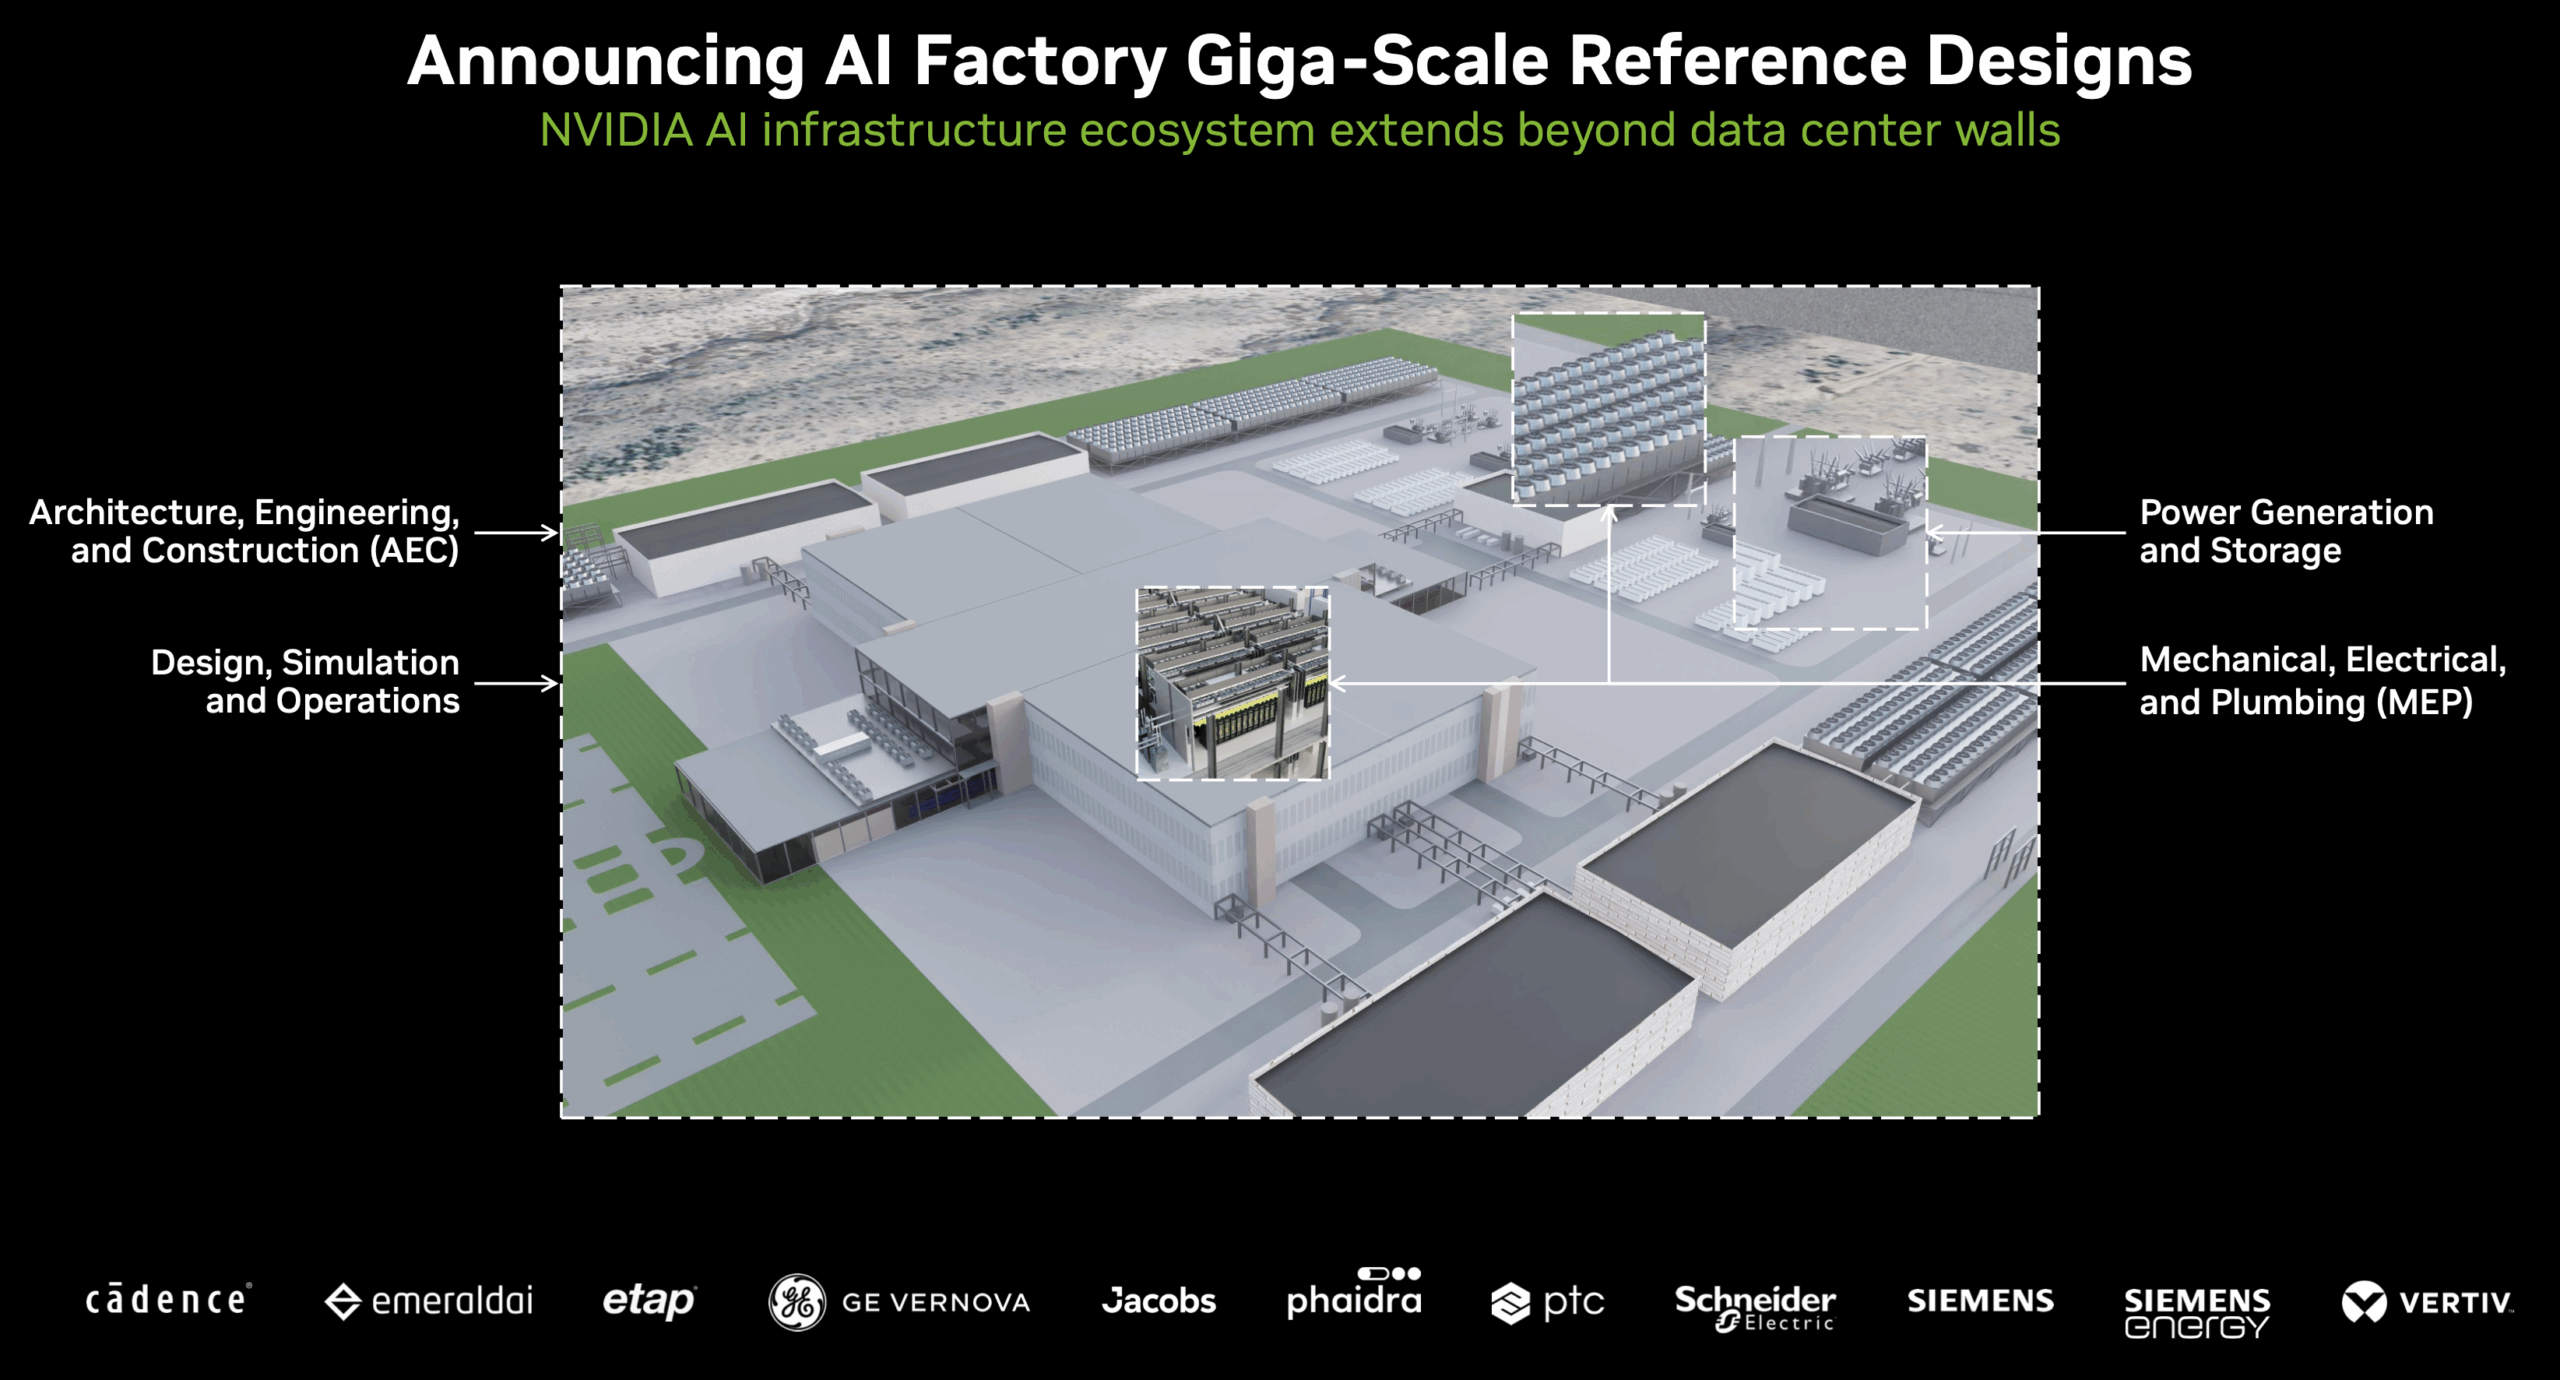
Te projekty architektoniczne wykorzystują cyfrowe bliźniaki NVIDIA Omniverse, aby ułatwić kompleksową symulację obiektów przed fizycznym wdrożeniem. Organizacje mogą modelować dystrybucję zasilania, systemy chłodzenia i obciążenia obliczeniowe w ujednoliconych symulacjach, identyfikując i usuwając wąskie gardła przed wdrożeniem infrastruktury fizycznej.
Wniosek
NVIDIA nadal jest liderem w dziedzinie infrastruktury AI dzięki przyszłościowemu, zorientowanemu na deweloperów podejściu, które bezpośrednio rozwiązuje problemy organizacji i laboratoriów AI. Przejście od akceleracji ogólnego przeznaczenia do architektur specyficznych dla obciążeń, czego przykładem jest ukierunkowane podejście Rubin CPX do przetwarzania kontekstowego, wskazuje, że przyszłe systemy AI będą w coraz większym stopniu obejmować heterogeniczne zasoby obliczeniowe zoptymalizowane pod kątem każdego etapu procesów AI. Ta ewolucja architektury wymaga, aby organizacje planujące wieloletnie inwestycje w infrastrukturę AI uwzględniały nie tylko samą przepustowość obliczeniową, ale także dostosowanie możliwości sprzętowych do ewoluujących architektur modeli.
Przyspieszony rytm innowacji, od Blackwell Ultra, przez Vera Rubin, po Rubin CPX w krótkim czasie, jest naprawdę imponujący. Tak szybkie tempo wymaga od organizacji projektowania systemów zdolnych do integracji nowych paradygmatów architektonicznych w miarę ich pojawiania się, unikając przy tym blokady, która charakteryzowała poprzednie generacje infrastruktury centrów danych. Aby sprostać temu wyzwaniu, projekty referencyjne AI Factory firmy NVIDIA oraz cyfrowe bliźniaki Omniverse dostarczają niezbędnych planów i narzędzi symulacyjnych, które zabezpieczają te kluczowe inwestycje na przyszłość. W miarę jak modele AI podążają ścieżką ku skalom bilionów parametrów i kontekstom milionów tokenów, innowacje architektoniczne zaprezentowane na szczycie AI Infrastructure Summit stanowią fundament dla tej przyszłości obliczeń. Ustanawiają one ramy i technologie, które zdefiniują możliwości sztucznej inteligencji w przedsiębiorstwach w ciągu dekady.
Powiązane artykuły: Aktualności Nvidia GTC25
Wszystkie slajdy i obrazy pochodzą ze strony Nvidia


 Amazon