

Konferencja GTC firmy NVIDIA podkreśliła liczne innowacje, które zrewolucjonizują rozwój sztucznej inteligencji w wielu sektorach, a także zaprezentowała przełomowe osiągnięcia w dziedzinie sprzętu, oprogramowania i partnerstw AI. Perełką GTC 2025 było bez wątpienia zaprezentowanie procesorów graficznych dla centrów danych i ich planów rozwoju. Najpotężniejszym akceleratorem AI firmy NVIDIA w produkcji jest B300, oparty na architekturze Blackwell Ultra. Oferuje on 1.5-krotny wzrost wydajności w porównaniu z i tak już wiodącą w branży wydajnością procesorów graficznych Blackwell.

W porównaniu z wydanymi procesorami graficznymi firmy NVIDIA, wzrost wydajności jest oszałamiający:
| Specyfikacja | H100 | H200 | B100 | B200 | B300 |
|---|---|---|---|---|---|
| Maksymalna pamięć | 80 GB HBM3 | 141 GB HBM3e | 192 GB HBM3e | 192 GB HBM3e | 288 GB HBM3e |
| Przepustowość pamięci | 3.35 TB / s | 4.8 TB/s | 8 TB/s | 8 TB/s | 8 TB/s |
| Rdzeń tensorowy FP4 | - | - | 14 PFLOPS | 18 PFLOPS | 30 PFLOPS |
| Rdzeń tensorowy FP6 | - | - | 7 PFLOPS | 9 PFLOPS | 15 PFLOPS* |
| Rdzeń tensorowy FP8 | 3958 TFLOPS (~4 PFLOPS) | 3958 TFLOPS (~4 PFLOPS) | 7 PFLOPS | 9 PFLOPS | 15 PFLOPS* |
| Rdzeń tensora INT 8 | 3958 TOPS | 3958 TOPS | 7 POPS | 9 POPS | 15 PFLOPS* |
| Rdzeń tensorowy FP16/BF16 | 1979 TFLOPS (~2 PFLOPS) | 1979 TFLOPS (~2 PFLOPS) | 3.5 PFLOPS | 4.5 PFLOPS | 7.5 PFLOPS* |
| Rdzeń tensora TF32 | X TFTPS | X TFTPS | 1.8 PFLOPS | 2.2 PFLOPS | 3.3 PFLOPS* |
| FP32 (gęsty) | X TFTPS | X TFTPS | X TFTPS | X TFTPS | Informacje nieznane |
| Rdzeń tensorowy FP64 (gęsty) | X TFTPS | X TFTPS | X TFTPS | X TFTPS | Informacje nieznane |
| FP64 (gęsty) | X TFTPS | X TFTPS | X TFTPS | X TFTPS | Informacje nieznane |
| Maksymalny pobór mocy | 700W | 700W | 700W | 1000W | Informacje nieznane |
Uwaga: wartości oznaczone gwiazdką „*” to szacunkowe obliczenia i nie są to oficjalne liczby firmy NVIDIA

Blackwell Ultra B300, podobnie jak jego odpowiedniki z serii Blackwell, wprowadza nowe, precyzyjne formaty: rdzenie FP4 Tensor Cores zapewniają imponującą wydajność 30 PFLOPS, a FP6/FP8 – 15 PFLOPS*, w porównaniu z obecnymi modelami H200. To około 7.5-krotna poprawa w porównaniu z obliczeniami FP8 i FP4 oraz prawie 4-krotna poprawa w porównaniu z wydajnością FP8.

Kolejnym krokiem na drodze rozwoju firmy NVIDIA jest procesor graficzny Vera Rubin, którego premiera planowana jest na przyszły rok. Oczekuje się, że Vera Rubin zapewni 3.3-krotnie wyższą wydajność niż Blackwell Ultra, osiągając 50 PFLOPS gęstych obliczeń FP4, w porównaniu z 15 PFLOPS w B300. Będzie on wspierany przez technologie ConnectX-9 i NVLink-6, podwajając przepustowość w porównaniu z poprzednimi generacjami. Procesory graficzne Vera Rubin będą również wyposażone w pamięć HBM4, zapewniając 1.6-krotny wzrost przepustowości pamięci. Przejście z procesorów Grace na procesory Vera znacząco usprawni również połączenie między procesorem a procesorem graficznym, osiągając prędkość do 1.8 TB/s.

NVIDIA nie szczędziła zbędnych informacji, zapowiadając swoje procesory graficzne Rubin Ultra, których premiera planowana jest na drugą połowę 2027 roku. Procesory graficzne Rubin Ultra mają podwoić wydajność Vera Rubin, zapewniając imponujące 100 PFLOPS-ów mocy obliczeniowej FP4 na procesor graficzny. Rubin Ultra będzie również wyposażony w 1 TB zaawansowanej pamięci HBM4e.
NVIDIA® DGX Spark®
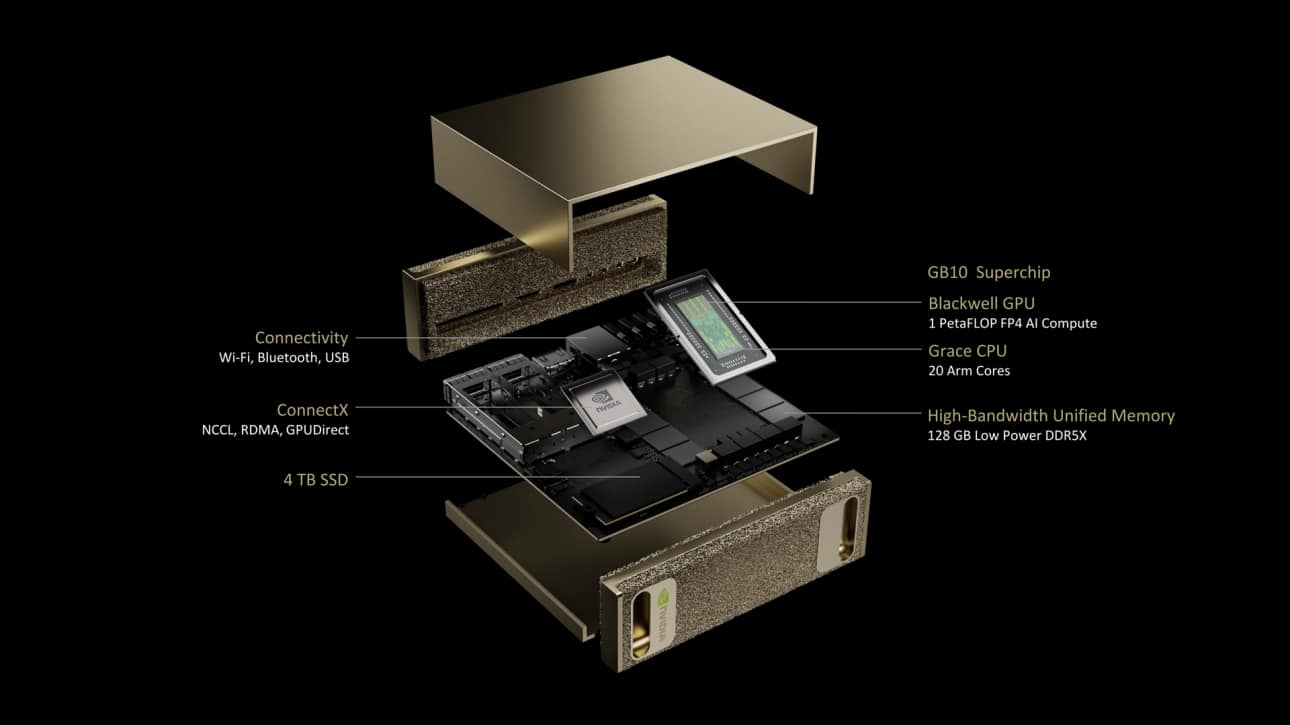
Firma NVIDIA zaprezentowała DGX Spark, system wprowadzony na rynek pod nazwą Project Digits , na targach CES na początku tego roku. Stworzony z myślą o twórcach sztucznej inteligencji, badaczach, analitykach danych i studentach, system DGX Spark wykorzystuje nowy układ GB10 Blackwell i jest wyposażony w 128 GB pamięci zunifikowanej.
NVIDIA twierdzi, że system oferuje imponującą wydajność AI TOPS na poziomie 1,000, co stawia Sparka na praktycznym poziomie porównywalnym z kartą RTX 5070. Platforma Spark integruje również kartę sieciową ConnectX 7 SmartNIC, która zapewnia Sparkowi dwa łącza 200 Gb/s, usprawniając przesyłanie danych. Partnerzy OEM, tacy jak ASUS, Dell, HPE i Lenovo, wkrótce zaoferują wersje markowe. Rezerwacje są już otwarte, a dostawy mają rozpocząć się w lipcu.
Stacja NVIDIA DGX
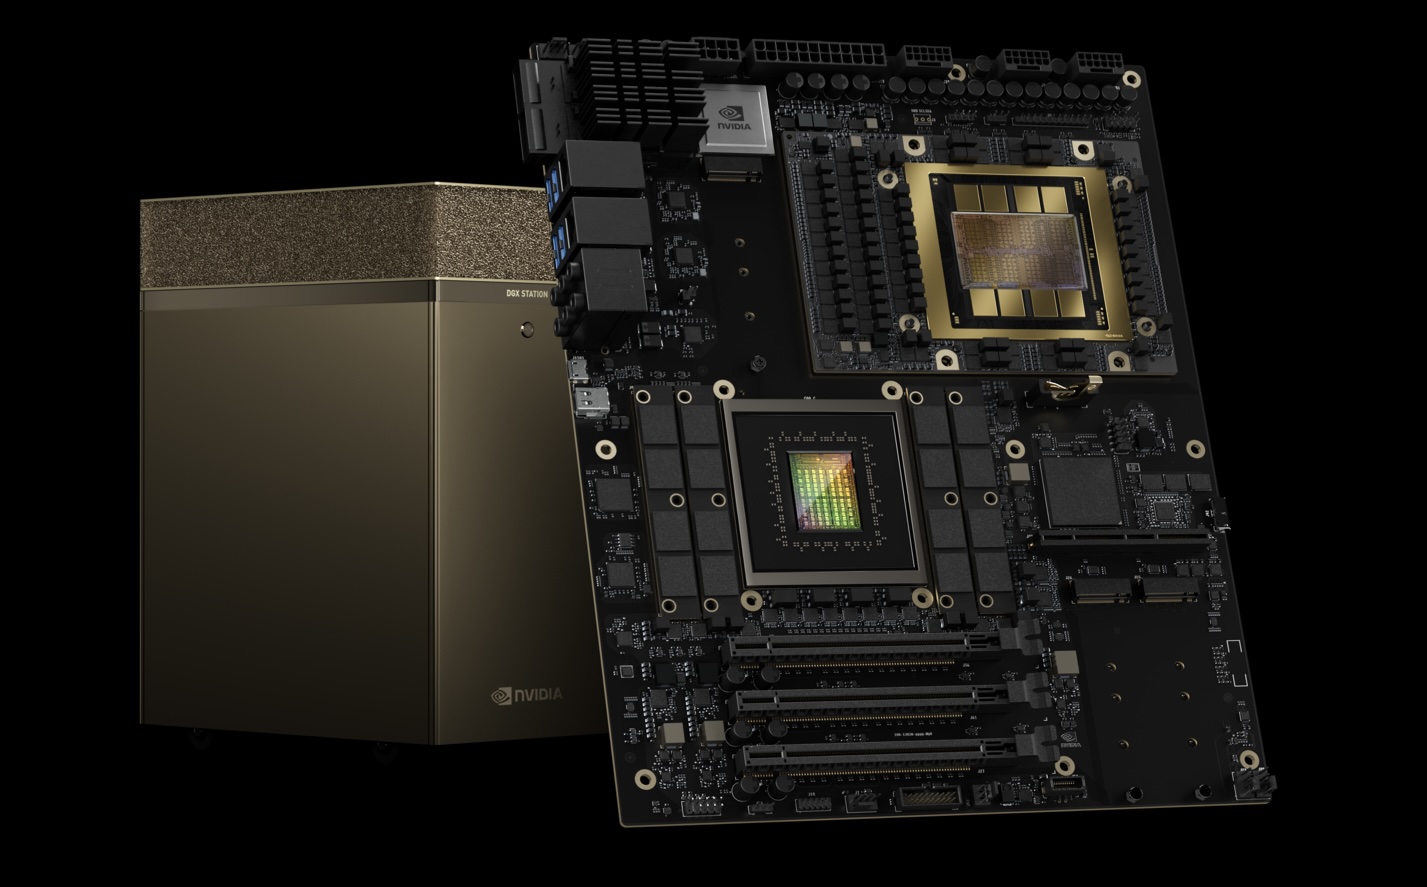
Firma NVIDIA zaprezentowała również zmodernizowaną stację DGX Station, która jest pozycjonowana jako najnowocześniejszy komputer stacjonarny ze sztuczną inteligencją do zastosowań korporacyjnych. Została zbudowana na bazie układu GB300 Grace Blackwell Ultra.
Stacja DGX oferuje 784 GB zunifikowanej pamięci systemowej, zapewniając jednocześnie 20 petaflopów wydajności FP4 AI. Integruje ona kartę sieciową NVIDIA ConnectX 8 SuperNIC bezpośrednio z systemem, umożliwiając łączność sieciową o przepustowości 800 Gb/s, gwarantując, że wysoka wydajność sieciowa spełni wymagania jego ogromnych możliwości obliczeniowych. Partnerzy OEM, tacy jak ASUS, Box, Dell, HPE, Lambda i Supermicro, planują budowę systemów DGX Station, których dostępność spodziewana jest jeszcze w tym roku.
NVIDIA RTX Pro Blackwell
Na tym nie poprzestał rozwój GPU . NVIDIA zaprezentowała serię RTX Pro Blackwell, kompleksową odświeżoną wersję swojej profesjonalnej linii GPU, zaprojektowaną z myślą o przyspieszeniu zadań związanych ze sztuczną inteligencją, grafiką i symulacjami na wszystkich platformach. Ta nowa generacja obejmuje stacjonarne stacje robocze, systemy mobilne i serwery, a flagowy model RTX Pro 6000 Blackwell oferuje wiodącą w branży pamięć GPU o pojemności 96 GB i zapewnia wydajność do 4,000 TOPS w zakresie AI. Te udoskonalenia umożliwiają śledzenie promieni w czasie rzeczywistym, szybkie wnioskowanie AI oraz zaawansowane przepływy pracy graficznej, wcześniej nieosiągalne dla komputerów stacjonarnych.
Innowacje technologiczne zastosowane w tych procesorach graficznych są znaczące, w tym procesor strumieniowy NVIDIA o 1.5-krotnie wyższej przepustowości, rdzenie RT czwartej generacji zapewniające dwukrotnie wyższą wydajność niż poprzednie generacje oraz rdzenie Tensor piątej generacji obsługujące nową precyzję FP4 dla zadań AI. Dodatkowe udoskonalenia obejmują obsługę PCIe Gen 5 dla podwojenia przepustowości, kompatybilność z DisplayPort 2.1 dla konfiguracji wyświetlaczy o ekstremalnej rozdzielczości oraz, w wersji Server Edition, technologię NVIDIA Confidential Computing do bezpiecznych zadań AI.
Specjaliści z branży odnotowali znaczną poprawę wydajności w rzeczywistych zastosowaniach. Firma Foster + Partners osiągnęła 5-krotnie szybszy ray tracing niż RTX A6000, a GE HealthCare odnotowało nawet dwukrotny wzrost czasu przetwarzania GPU w algorytmach rekonstrukcji medycznej. Producent samochodów Rivian wykorzystał nowe GPU, aby uzyskać niespotykaną dotąd jakość obrazu VR podczas testów projektowych, a SoftServe odnotował trzykrotny wzrost wydajności podczas pracy z dużymi modelami AI, takimi jak Llama 3.3-70B. Co być może najbardziej imponujące, Pixar zauważył, że 99% ich ujęć produkcyjnych mieści się teraz w 96 GB pamięci pojedynczego GPU.
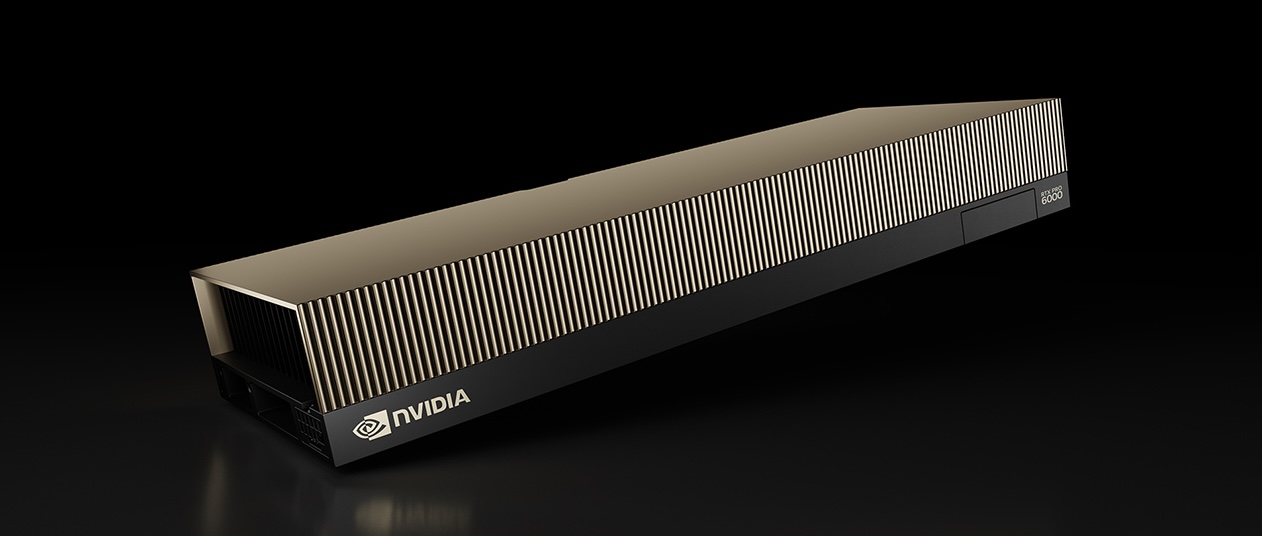
Karta RTX Pro 6000 Blackwell Server Edition przenosi te możliwości do środowisk centrów danych dzięki pasywnie chłodzonej konstrukcji, umożliwiającej pracę 24/7. Ten wariant zorientowany na serwery oferuje 5-krotnie wyższą przepustowość wnioskowania dużych modeli językowych, 7-krotnie szybsze sekwencjonowanie genomiczne, 3.3-krotne przyspieszenie generowania tekstu na wideo oraz 2-krotnie większą poprawę wnioskowania i renderowania w systemach rekomendacji w porównaniu ze sprzętem poprzedniej generacji. Po raz pierwszy te procesory graficzne obsługują zarówno technologię vGPU, jak i Multi-Instance GPU (MIG), co pozwala na partycjonowanie każdej karty na maksymalnie cztery w pełni izolowane instancje, maksymalizując wykorzystanie zasobów dla zróżnicowanych obciążeń. Wersje desktopowe tych procesorów graficznych mają trafić na rynek w kwietniu, a ich odpowiedniki serwerowe w maju, a laptopy OEM w czerwcu.
NVIDIA Photonics

NVIDIA Photonics, innowacja mająca na celu transformację sieci optycznych w centrach danych AI, uzupełniła zapowiedzi sprzętowe. Zastępując tradycyjne, podłączane transceivery modułami optycznymi w obudowach, umieszczonymi w tej samej obudowie co układ ASIC przełącznika, NVIDIA Photonics minimalizuje zużycie energii i usprawnia łączność danych.
Wykorzystując optymalizację silnika fotonicznego TSMC i uzupełniając ją o modulatorami mikropierścieniowymi, laserami o wysokiej wydajności i odłączanymi złączami światłowodowymi, nowa platforma Photonics została zaprojektowana tak, aby zapewnić nawet 3.5-krotnie wyższą wydajność, 10-krotnie wyższą odporność i osiągnąć 1.3-krotnie większą szybkość wdrażania niż w przypadku rozwiązań konwencjonalnych. Prezentując swoje szersze podejście ekosystemowe, NVIDIA szczegółowo opisała, jak kluczowe dla osiągnięcia tych korzyści w zakresie wydajności są partnerstwa z liderami w dziedzinie zaawansowanych rozwiązań w zakresie pakowania i produkcji komponentów optycznych.
 Dzięki tym nowym osiągnięciom NFirma VIDIA zaprezentowała trzy nowe przełączniki z serią 200G SerDes z rodzin Quantum-X i Spectrum-X. Seria Quantum-X Infiniband obejmuje model Quantum 3450-LD, który oferuje imponujące 144 porty 800G lub 576 portów 200G, zapewniając przepustowość 115 Tb/s. Oferta przełączników Ethernet Spectrum-X obejmuje zarówno bardziej kompaktowy model Spectrum SN6810, oferujący 128 portów 800G lub 512 portów 200G, jak i model Spectrum SN6800 o wysokiej gęstości, oferujący 512 portów 800G i 2048 portów 200G. Wszystkie te przełączniki wykorzystują technologię chłodzenia cieczą, aby zapewnić optymalną wydajność i efektywność.
Oczekuje się, że przełączniki NVIDIA Quantum-X Photonics InfiniBand będą dostępne w dalszej części roku, a przełączniki NVIDIA Spectrum-X Photonics Ethernet będą dostępne w 2026 roku u wiodących dostawców infrastruktury i systemów.
Łączenie sprzętu i oprogramowania dzięki Nvidia Dynamo
Zapowiedzi firmy NVIDIA dotyczyły zarówno oprogramowania, jak i sprzętu. Aby w pełni wykorzystać moc obliczeniową nowych procesorów graficznych Blackwell, NVIDIA wprowadziła Dynamo, oprogramowanie do wnioskowania AI, zaprojektowane specjalnie do obsługi modeli AI na dużą skalę.

NVIDIA Dynamo to platforma wnioskowania typu open source, zaprojektowana z myślą o optymalizacji wdrażania modeli AI na dużą skalę w całych centrach danych. Unikalna, rozproszona i zdezagregowana architektura Dynamo pozwala na skalowanie pojedynczego zapytania na wielu procesorach GPU, co znacząco przyspiesza obciążenia wnioskowania. Dzięki inteligentnemu rozdzieleniu zadań przetwarzania między obliczenia tokenów wejściowych i tokenów wyjściowych oraz wykorzystaniu zalet połączenia NVLink firmy NVIDIA, platforma osiąga nawet 30-krotny wzrost wydajności w przypadku modeli intensywnie wykorzystujących wnioskowanie, takich jak DeepSeek R1.
Co godne uwagi, Dynamo podwaja przepustowość istniejących systemów LLM, takich jak LLAMA, na procesorach graficznych Hopper bez dodatkowego sprzętu, skutecznie podwajając generowanie tokenów i potencjał dochodowy fabryk AI. Dzięki Dynamo, NVIDIA oferuje wszystkim optymalizacje na poziomie hiperskalowym i udostępnia je, pozwalając każdemu w pełni wykorzystać potencjał transformacyjny sztucznej inteligencji.
Dynamo jest już dostępne w serwisie GitHub i obsługuje popularne back-endy, w tym PyTorch, BLM, SGLang i TensorRT.
Nvidia AI-Q: następna generacja systemów agentowych AI
NVIDIA wprowadziła również AI-Q, wymawiane jako „IQ”, projekt umożliwiający bezproblemowe połączenie agentów AI z danymi i narzędziami przedsiębiorstwa na dużą skalę. Ta platforma open source umożliwia agentom wykonywanie zapytań i wnioskowanie na podstawie wielu typów danych, w tym tekstu, obrazów i wideo, a także korzystanie z narzędzi zewnętrznych, takich jak wyszukiwarka internetowa i inni agenci.
Sercem AI-Q jest nowy zestaw narzędzi NVIDIA AgentIQ, biblioteka oprogramowania open source, udostępniona dziś w serwisie GitHub. AgentIQ ułatwia łączenie, profilowanie i optymalizację systemów wieloagentowych, umożliwiając przedsiębiorstwom budowanie zaawansowanych cyfrowych sił roboczych. AgentIQ płynnie integruje się z istniejącymi platformami wieloagentowymi, takimi jak CrewAI, LangGraph, Llama Stack, Microsoft Azure AI Agent Service i Letta, umożliwiając deweloperom stopniowe wdrażanie lub wdrażanie go jako kompletnego rozwiązania.
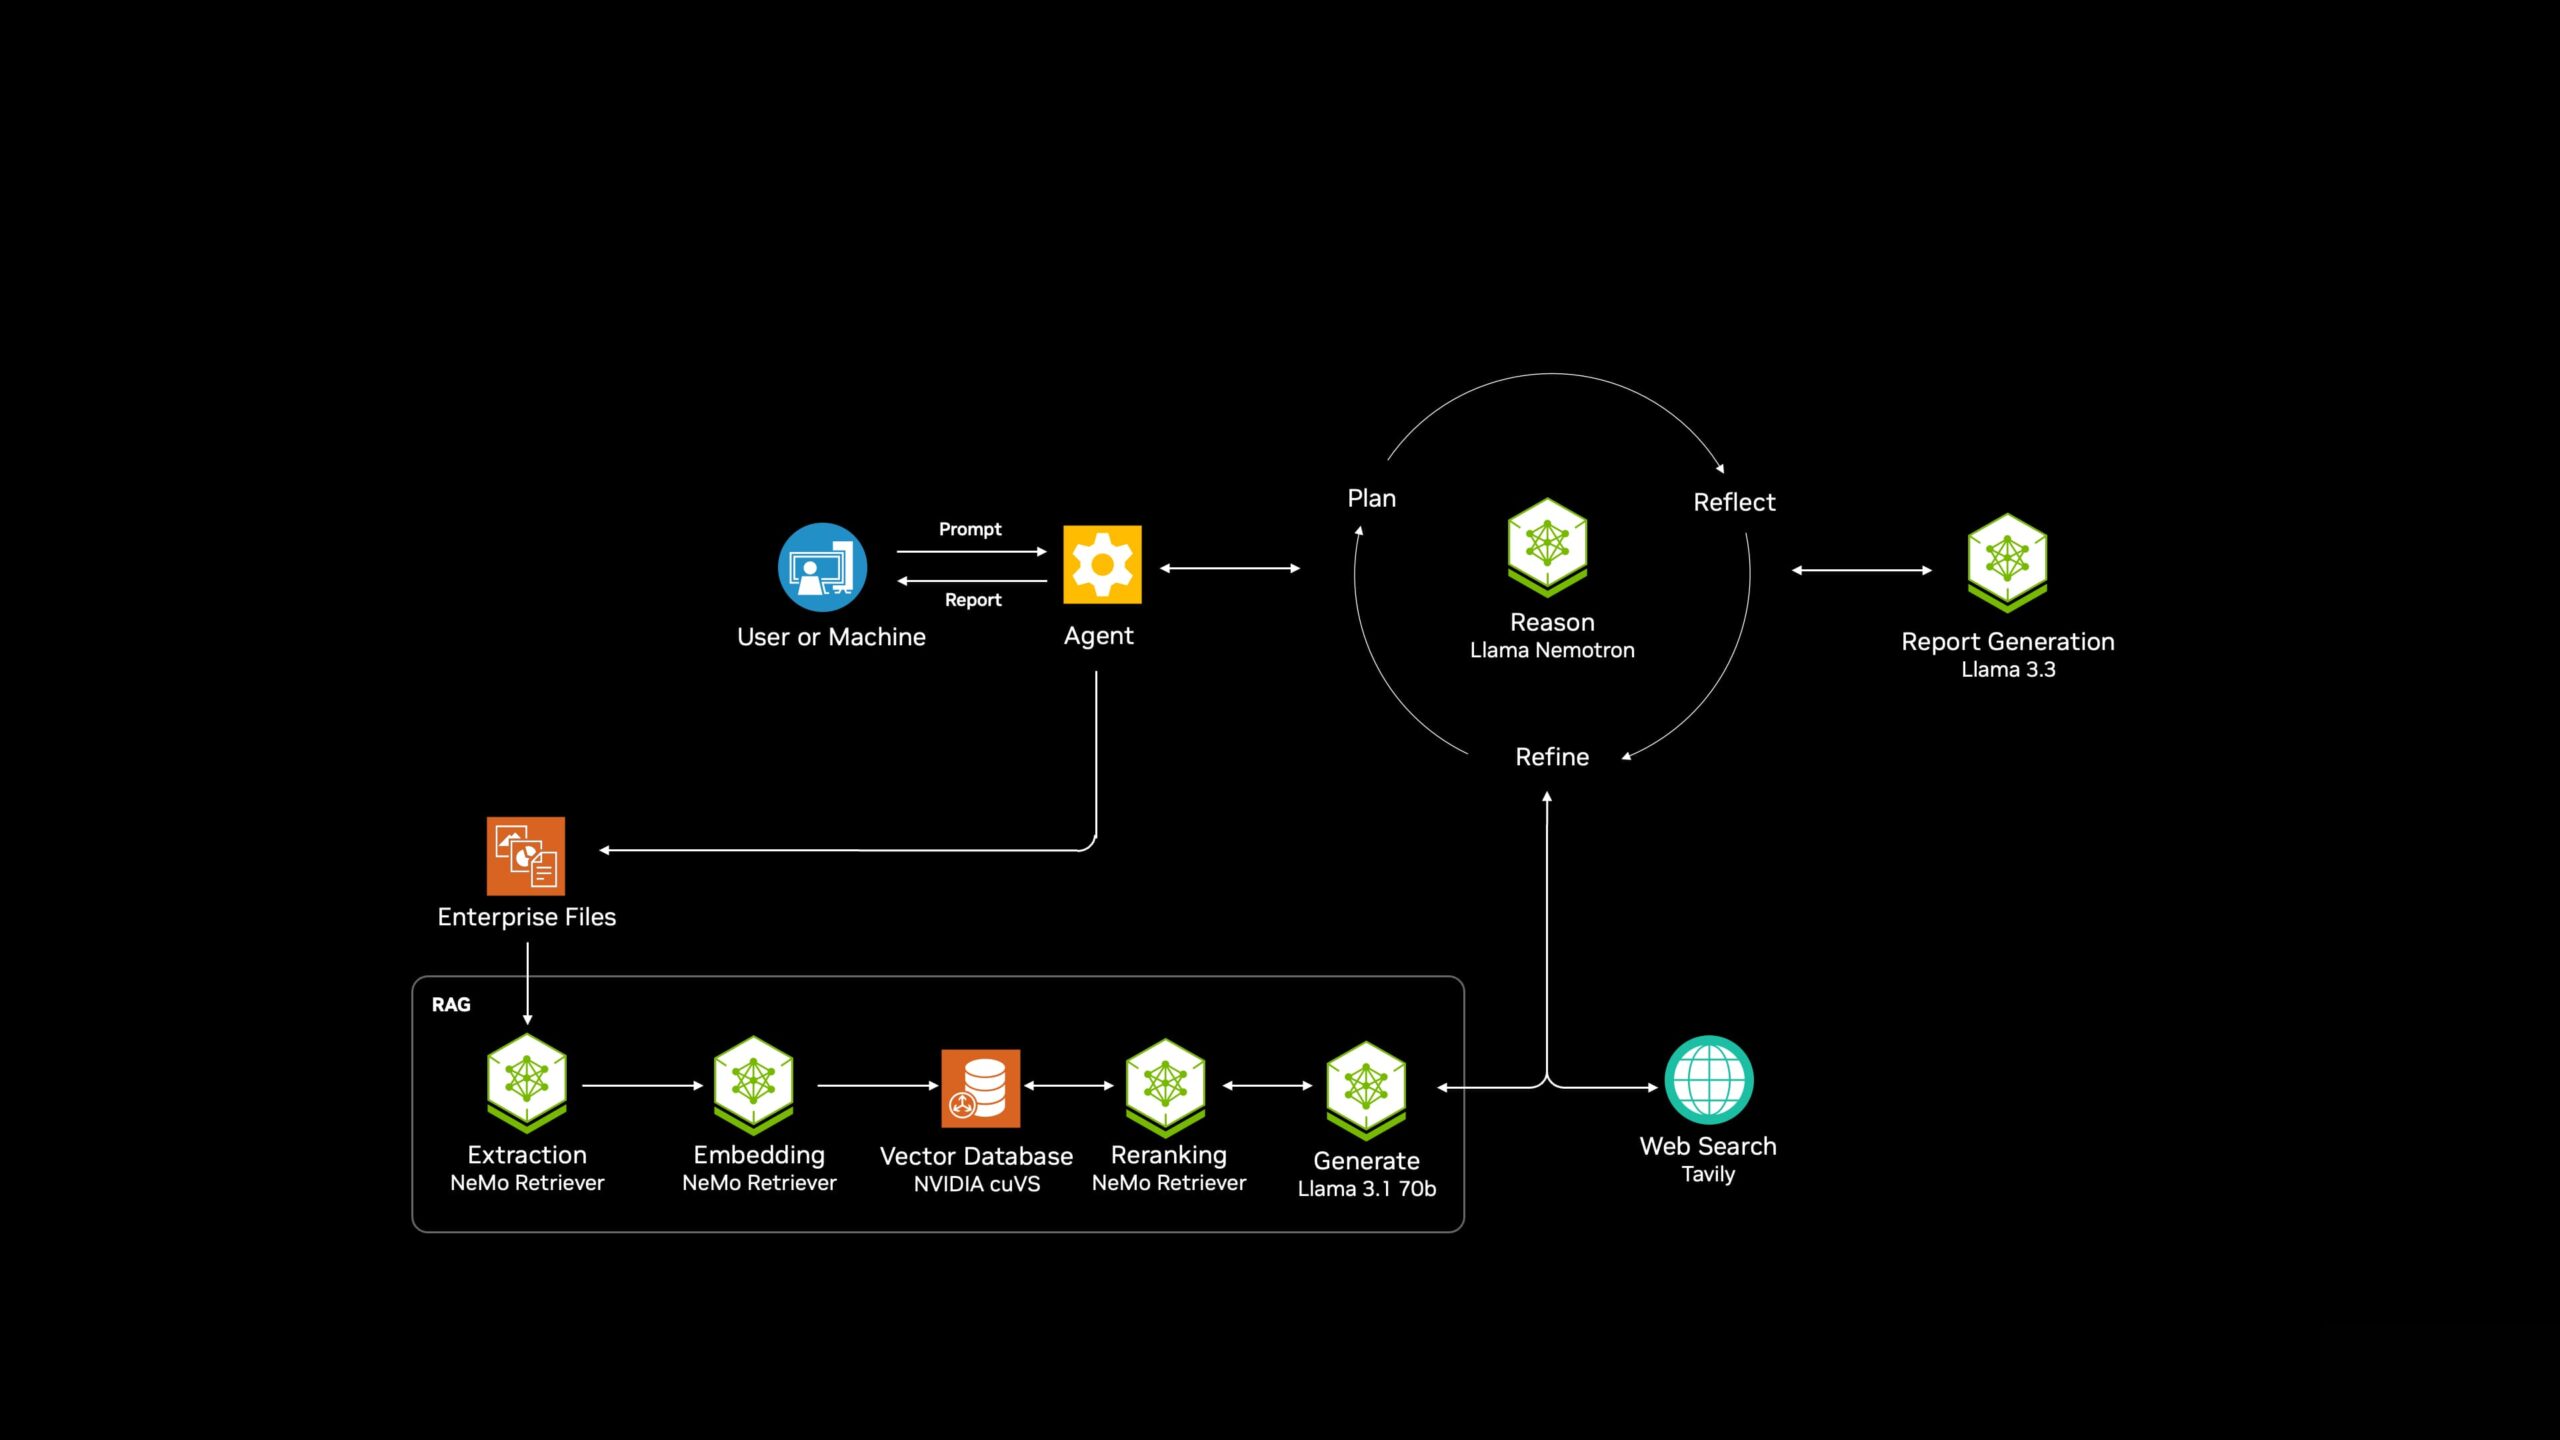
NVIDIA współpracuje również z wiodącymi dostawcami pamięci masowej, aby stworzyć referencyjną architekturę platformy danych AI, która integruje NVIDIA NeMo Retriever, AI-Q Blueprint, procesory graficzne Blackwell, sieć Spectrum X oraz jednostki przetwarzania danych Bluefield. Ma to zapewnić przetwarzanie danych w czasie niemal rzeczywistym i szybkie wyszukiwanie wiedzy, zapewniając agentom AI dostęp do kluczowych informacji biznesowych.
Aplikacja AI-Q będzie dostępna dla programistów już w kwietniu.
NVIDIA Mission Control: Orkiestracja fabryki AI
Bazując na swojej kompleksowej strategii oprogramowania, NVIDIA zaprezentowała Mission Control, jedyną w branży zunifikowaną platformę oprogramowania do obsługi operacji i koordynacji, zaprojektowaną do automatyzacji złożonego zarządzania centrami danych i obciążeniami AI. Podczas gdy Dynamo optymalizuje wnioskowanie, a AI-Q umożliwia działanie systemów agentowych, Mission Control zajmuje się krytyczną warstwą infrastruktury, która stanowi podstawę całego procesu AI.
Mission Control zmienia sposób, w jaki przedsiębiorstwa wdrażają i zarządzają infrastrukturą AI, automatyzując kompleksowe zarządzanie, w tym dostarczanie zasobów, monitorowanie i diagnostykę błędów. Platforma umożliwia płynne przejścia między obciążeniami szkoleniowymi a wnioskowaniem w systemach opartych na platformie Blackwell, umożliwiając organizacjom realokację zasobów klastra w miarę dynamicznej zmiany priorytetów. Dzięki technologii Run:ai, przejętej przez firmę NVIDIA, Mission Control zwiększa wykorzystanie infrastruktury nawet pięciokrotnie, zapewniając jednocześnie do 10 razy szybsze odzyskiwanie zadań niż tradycyjne metody wymagające ręcznej interwencji.
Oprogramowanie oferuje szereg korzyści operacyjnych, kluczowych dla nowoczesnych obciążeń AI, w tym uproszczoną konfigurację klastra, płynną koordynację obciążeń dla przepływów pracy SUNK (Slurm i Kubernetes), zoptymalizowane pod kątem zużycia energii profile zasilania z możliwością wyboru przez dewelopera oraz autonomiczne funkcje odzyskiwania zadań. Dodatkowe funkcje obejmują konfigurowalne panele wydajności, kontrole stanu na żądanie oraz integrację z systemem zarządzania budynkiem (BMS) w celu usprawnienia chłodzenia i zarządzania energią.
Główni producenci systemów, w tym Dell, HPE, Lenovo i Supermicro, ogłosili plany wprowadzenia na rynek systemów NVIDIA GB200 NVL72 i GB300 NVL72 wyposażonych w funkcję Mission Control. Dell wdroży to oprogramowanie w swojej fabryce AI we współpracy z firmą NVIDIA, a HPE będzie oferować je w systemach Grace Blackwell w formacie rack. Lenovo planuje aktualizację swoich rozwiązań Hybrid AI Advantage o funkcję Mission Control, a Supermicro zintegruje je ze swoimi systemami Supercluster.
Rozwiązanie NVIDIA Mission Control jest już dostępne dla systemów DGX GB200 i DGX B200, a wsparcie dla systemów DGX GB300, DGX B300 i GB300 NVL72 spodziewane jest jeszcze w tym roku. Dla organizacji planujących rozpoczęcie zarządzania infrastrukturą AI, NVIDIA ogłosiła również, że oprogramowanie Base Command Manager wkrótce będzie bezpłatne dla maksymalnie ośmiu akceleratorów na system, niezależnie od rozmiaru klastra.
Wniosek
Konferencja NVIDIA GTC 2025 zapoczątkowała rewolucyjny skok w technologii sztucznej inteligencji (AI), prezentując przełomowe osiągnięcia w zakresie sprzętu, oprogramowania i infrastruktury. Od wydajnych procesorów graficznych B300 opartych na architekturze Blackwell Ultra po rewolucyjne systemy DGX Spark i DGX Station, NVIDIA nieustannie redefiniuje możliwości w dziedzinie obliczeń AI. Wprowadzenie NVIDIA Photonics, oprogramowania inferencyjnego Dynamo, frameworków agentowych AI-Q oraz platformy do koordynacji Mission Control pomoże przedsiębiorstwom szybciej wprowadzać rozwiązania na rynek i efektywniej je skalować, a także niewątpliwie umocni pozycję firmy NVIDIA jako lidera w tej dziedzinie.
To jednak dopiero wierzchołek góry lodowej. Na GTC czeka na Was o wiele więcej innowacji i informacji. Bądźcie na bieżąco i śledźcie nasze pozostałe artykuły w tym tygodniu, w których będziemy informować o najnowszych zapowiedziach i dogłębnie analizować ekscytującą przyszłość firmy NVIDIA.


 Amazon