

MLPerf Inference v5.1 oferuje rygorystyczne testy porównawcze dla wnioskowania AI w zakresie LLM, wizji i zadań multimodalnych. Poniżej znajduje się analiza techniczna wyników Blackwell Ultra firmy NVIDIA oraz zgłoszeń dotyczących układów Instinct MI300X/MI325X/MI355X firmy AMD. Zawiera ona szczegółowe dane porównawcze, optymalizacje oprogramowania, strategie architektoniczne oraz implikacje dla hiperskalerów i przedsiębiorstw.
Struktura porównawcza MLPerf
Testy wnioskowania MLPerf służą jako tablica wyników dla akceleratorów AI, zapewniając znormalizowaną, porównywalną metodę pomiaru wydajności w zakresie klasyfikacji obrazów, modeli językowych i systemów rekomendacji. W przypadku przedsiębiorstw wdrażających procesory graficzne na dużą skalę, liczby te często determinują decyzje zakupowe.
Wnioskowanie MLPerf jest regulowane przez MLCommons i definiuje zasady podziału zamkniętego i otwartego. Scenariusze obejmują:
- Niekatywne: Skoncentrowany na przepustowości (obsługuje tyle zapytań, ile to możliwe).
- :Wnioskowanie wielostrumieniowe zgodne z wymaganiami dotyczącymi opóźnień.
- Interaktywny: Ścisłe wymagania TTFT (czas do pierwszego tokena) i TPS (tokeny na sekundę przy 99. percentylu).
Pakiet obciążeń v5.1 zawierał:
- DeepSeek-R1: Model mieszany 671B dla ekspertów (test wytrzymałościowy wnioskowania rozumowego).
- Lama-3.1-405B i 8B:Najnowsze modele LLM w wielu trybach wnioskowania.
- Szept:ASR zastępuje RNN-T.
- Stabilna dyfuzja XL (SD-XL):Sztuczna inteligencja generująca tekst na obraz.
- Mieszany, DLRMv2oraz starsze obciążenia, takie jak ResNet-50.
Wykresy przepustowości (tokeny/s lub próbki/s) zazwyczaj podkreślają utrzymującą się dominację NVIDII w liczbach bezwzględnych, zwłaszcza w przeliczeniu na GPU. Jednak postępy AMD w zakresie względnej wydajności i płynności skalowania pokazują, że firma nadrabia zaległości z rundy na rundę, szczególnie w scenariuszach serwerowych i wdrożeniach wielowęzłowych.
Wyniki NVIDIA Blackwell Ultra
Systemy Blackwell Ultra osiągnęły rekordową przepustowość dla wszystkich nowych obciążeń. Kluczowe czynniki:
- Precyzja NVFP4: niestandardowy 4-bitowy float, przyspieszający DeepSeek i Llama.
- FP8 KV-cache: oszczędność pamięci dla warstw uwagi.
- Rozproszone serwowanie: podział kontekstu i etapów generowania na 72 procesory GPU za pośrednictwem łącza NVLink o przepustowości 1,800 GB/s.
- Oprogramowanie: CUDA Graphs, TensorRT-LLM, ADP Balance.
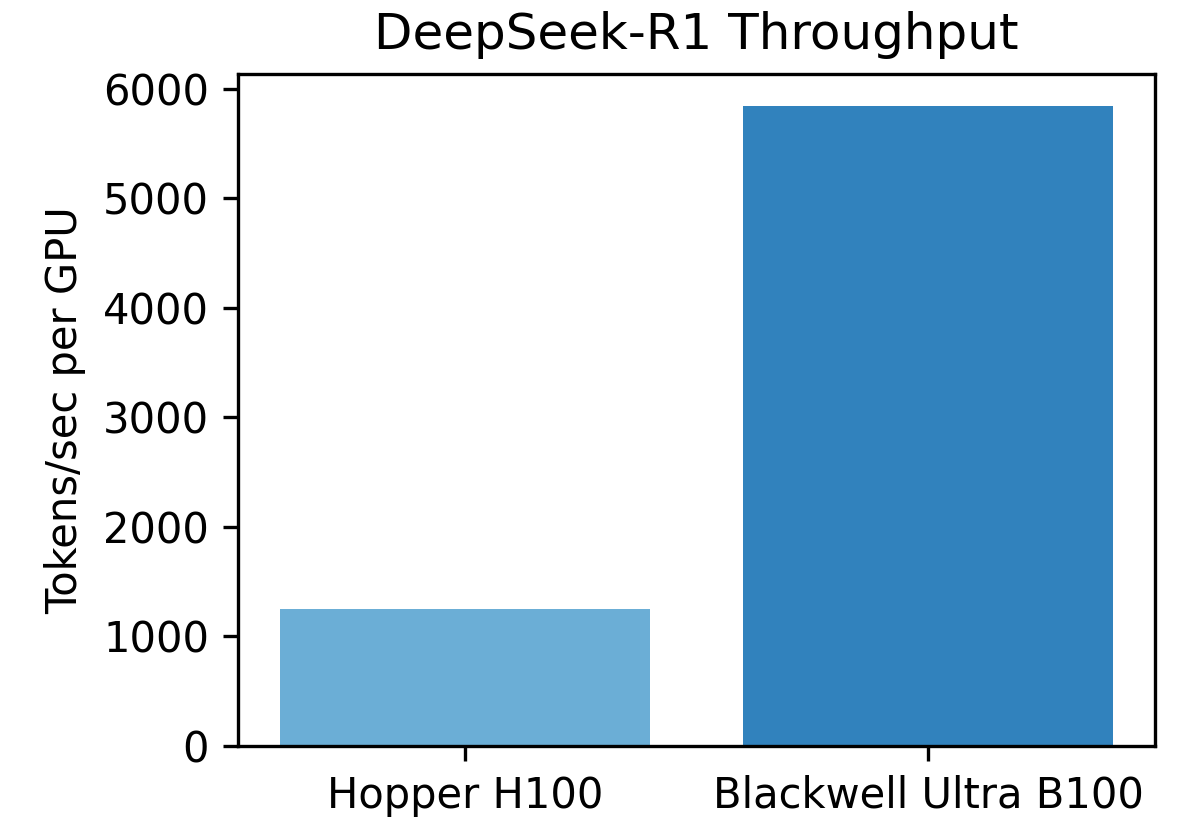
Poniższy wykres słupkowy, porównujący Hopper i Blackwell Ultra na procesor graficzny, pokazuje prawie 5-krotny wzrost przepustowości w DeepSeek-R1, co potwierdza, że drobnoziarniste formaty danych (NVFP4) i przepustowość w całej szafie rackowej skalują się liniowo w przypadku obciążeń wymagających dużej inferencji. Kolejny wykres, oparty na interaktywnych wynikach Llama-405B, które ustanowiły rekord, pokazuje, jak NVIDIA wykorzystuje infrastrukturę NVLink i rozproszone udostępnianie, aby utrzymać SLA dotyczące opóźnień, jednocześnie przekraczając dotychczasowe limity przepustowości. Wniosek: NVIDIA pozostaje liderem w branży pod względem czystej prędkości i obciążeń wrażliwych na opóźnienia.
Wyniki AMD Instinct MI300X/MI325X/MI355X
AMD postawiło na wydajność i elastyczność:
- FP4 na MI355X: zapewnia 2.7× większą przepustowość Llama-2-70B w porównaniu do MI325X FP8.
- Przycinanie strukturalne:W przypadku Llama-405B przycięcie o 21–33% zmniejszyło liczbę FLOP-ów bez wpływu na dokładność, zwiększając przepustowość o ~82–90%.
- Skalowanie: Płynne skalowanie liniowe sprawdzone do 8 węzłów; pierwszy heterogeniczny klaster (4 × MI300X + 2 × MI325X) osiągnął 94% wydajności skalowania.
- Powtarzalność ekosystemu ROCm:Propozycje partnerów zawsze mieszczą się w przedziale 1–3% wyników firmy AMD.
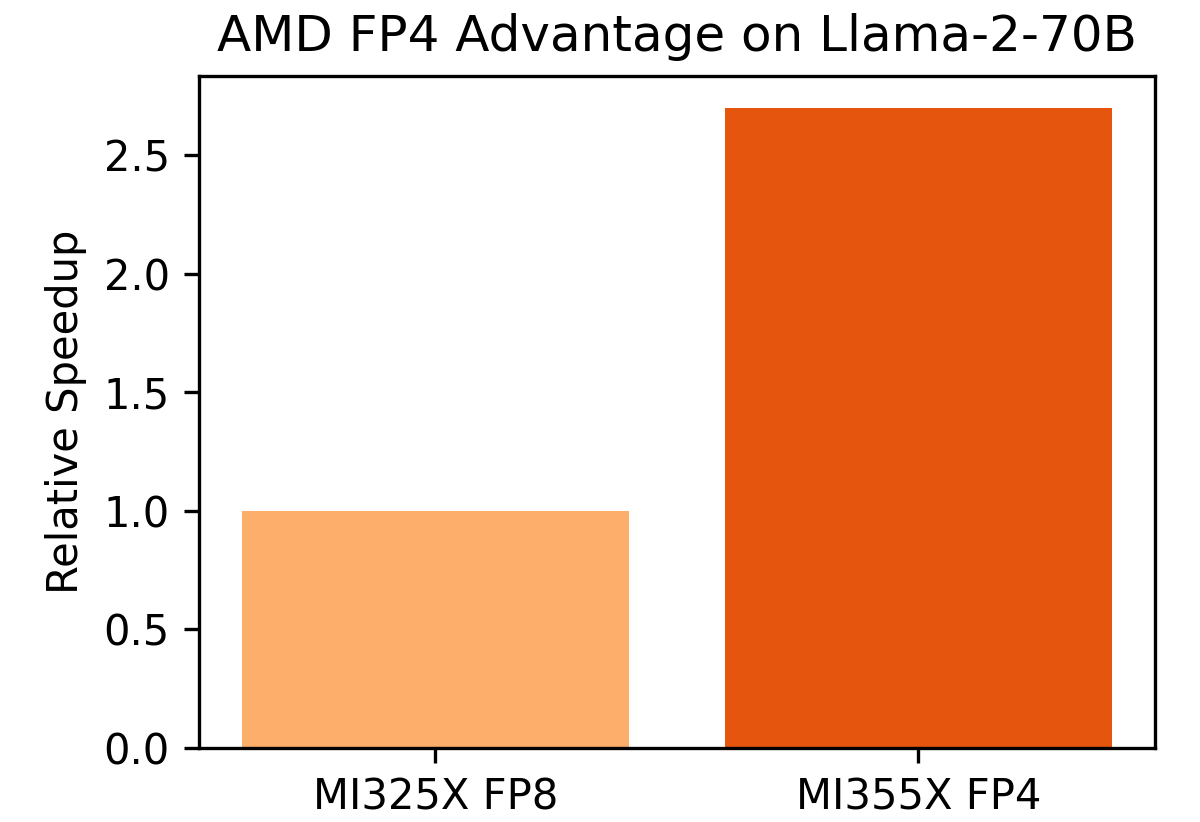
Powyższy wykres przedstawiający MI325X FP8 w porównaniu z MI355X FP4 ilustruje przełomowe korzyści FP4, takie jak większa liczba tokenów na sekundę przy minimalnej utracie dokładności, co dowodzi, że FP4 nie jest systemem eksperymentalnym, lecz gotowym do wdrożenia.
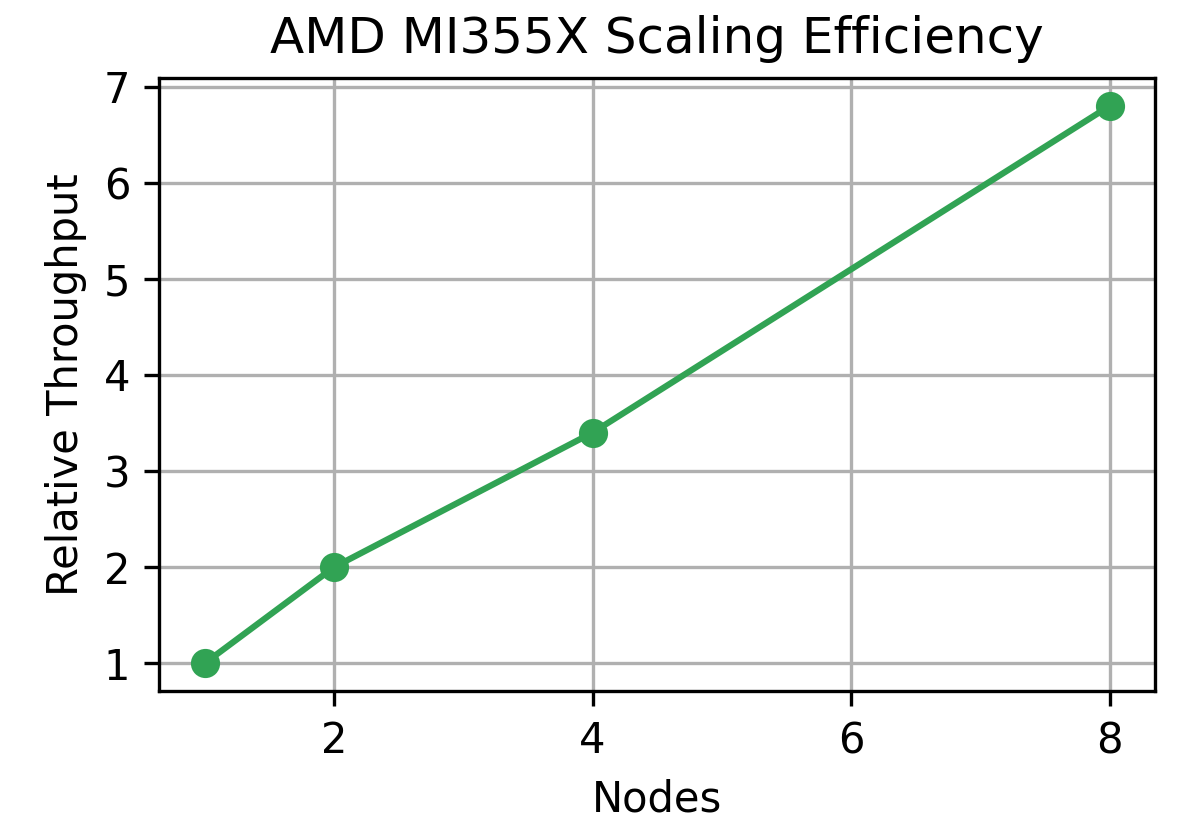
Ten wykres krzywej skalowania (1 → 8 węzłów) podkreśla skalowanie niemal liniowe, co jest cenione przez firmy zajmujące się hiperskalowaniem, ponieważ przekłada się na przewidywalne koszty rozbudowy. Tymczasem schemat strukturalnego przycinania pokazuje, że AMD koncentruje się nie tylko na brutalnej sile sprzętu, ale także na wydajności algorytmicznej, kluczowej dla rzeczywistych klastrów wnioskowania, ograniczonych mocą obliczeniową i przestrzenią.
Porównanie bezpośrednie AMD-NVIDIA
|
metryczny |
NVIDIA Blackwell Ultra |
AMD MI355X |
Komentarz |
Zwycięzca |
|
Tokeny/sek. na GPU |
5842 (DeepSeek-R1) |
~2200 (skalowane FP4) |
Wyższa wydajność surowa NVIDIA |
NVIDIA |
|
Pamięć na GPU |
192 GB HBM3e |
288 GB HBM3e |
AMD pasuje do modelu 520B z pojedynczym GPU |
AMD |
|
Wsparcie precyzyjne |
FP16, FP8, NVFP4 |
FP16, FP8, FP4 |
Oba 4-bitowe |
Tie |
|
Skalowanie tkaniny |
72 GPU NVLink |
Skalowanie liniowe węzłów do 8 |
Różne strategie skalowania |
Tie |
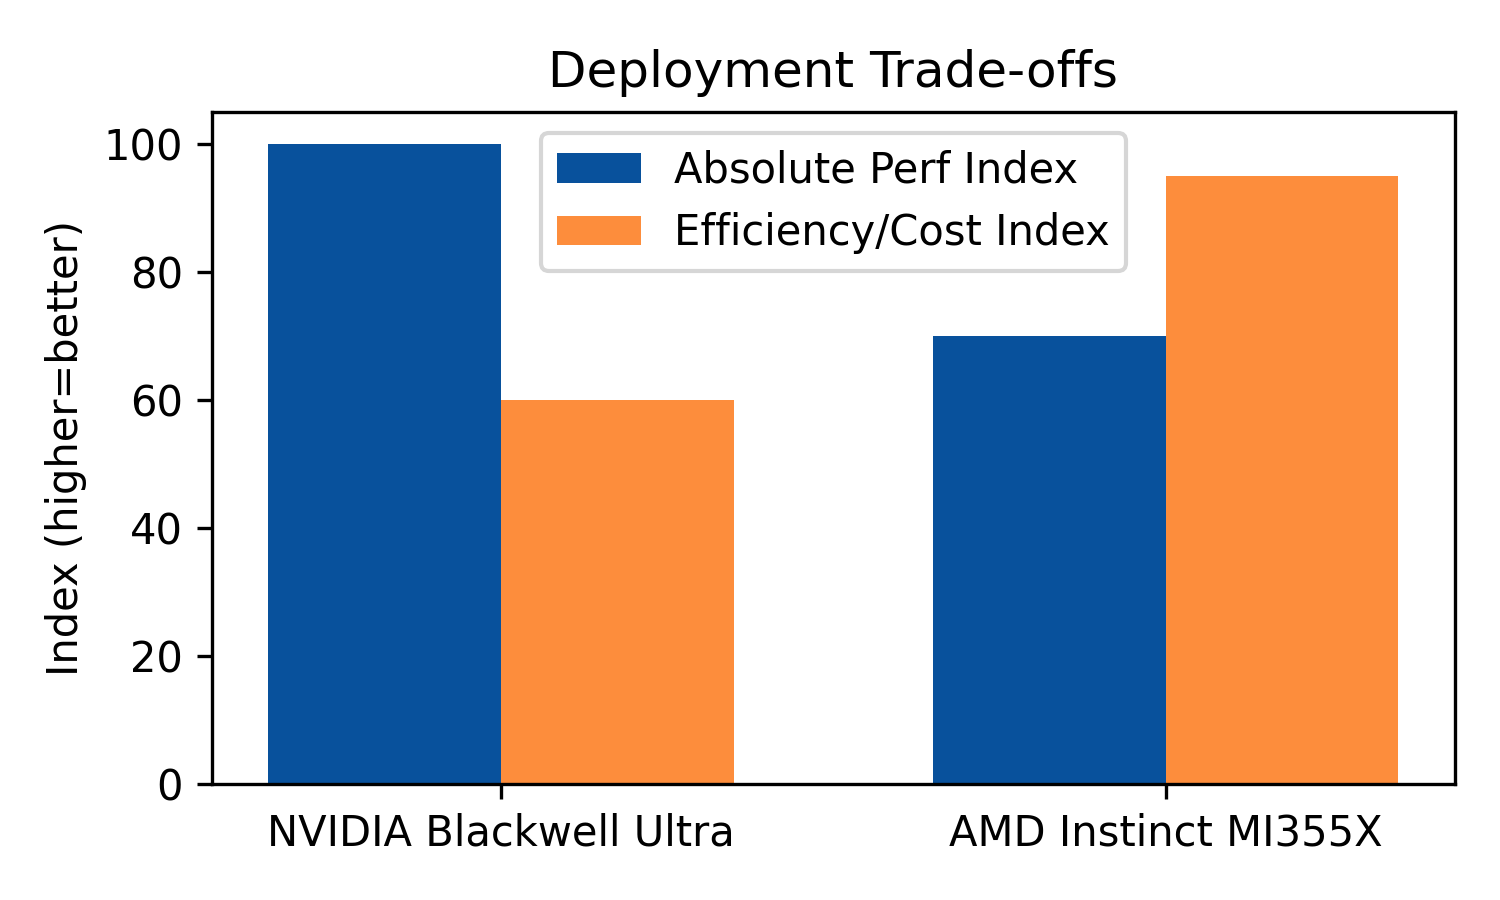
Wizualizacje obok siebie podkreślają kompromisy.
- NVIDIA ma przewagę pod względem przepustowości na procesor graficzny, co czyni ją idealną dla fabryk AI, w których gęstość flopów ma znaczenie.
- AMD, dzięki większej pamięci (288 GB) i redukcji FP4, sprawdza się tam, gdzie koszt na token i elastyczność wdrażania mają kluczowe znaczenie.
Implikacje branżowe
- HiperskalerzyNVIDIA pozostaje narzędziem pierwszego wyboru dla fabryk AI dążących do osiągnięcia szczytowej wydajności. Jednak coraz bardziej zaawansowane innowacje AMD w zakresie wydajności umożliwiają optymalizację kosztów skalowania, co sprzyja równoważeniu obciążeń między różnymi poziomami.
- Dostawcy chmury:Można spodziewać się heterogenicznych ofert, wydajnych modułów NVIDIA w porównaniu z ekonomicznymi modułami AMD Kubernetes.
- Przedsiębiorstwa:Strukturalne przycinanie, FP4 i obsługa heterogenicznych klastrów pozwalają AMD na wnioskowanie modeli 405B+ przy niższym całkowitym koszcie posiadania (TCO). Innowacje firmy NVIDIA (serwisowanie rozproszone i Dynamo) pozostają korzystne dla aplikacji wrażliwych na opóźnienia (np. chatbotów LLM w czasie rzeczywistym).
- Perspektywy na przyszłość:Można się spodziewać powszechnego przyjęcia wnioskowania 4-bitowego jako podstawy, szerszego wykorzystania heterogenicznych pul procesorów GPU oraz nowych projektów systemów, w tym Rubin CPX firmy NVIDIA dla długich sekwencji i rozszerzenia ROCm firmy AMD obejmującego więcej struktur.
NVIDIA nadal wyznacza tempo w zakresie przepustowości surowej, a układy GPU H200 przodują w wnioskowaniu w testach ResNet-50 i BERT w testach porównawczych z zamkniętymi działami. Mimo to, układ MI300 firmy AMD nie pozostaje daleko w tyle, osiągając konkurencyjne wyniki w scenariuszach serwerowych i offline, a jednocześnie wykazując znaczny wzrost efektywności energetycznej. Prawdziwym faktem jest nie tylko to, że NVIDIA utrzymuje się na szczycie, ale to, że AMD znacząco zniwelowało dystans w porównaniu z zaledwie jedną rundą MLPerf sprzed roku. Dla kupujących oznacza to, że czasy, w których można było skupić się wyłącznie na ekologicznych układach GPU, mogą się skończyć – ROCm dojrzewa, a układ MI300 jest realny w rzeczywistych wdrożeniach wnioskowania.


 Amazon