

To, co kiedyś było trudne, stało się łatwe. Odkąd IBM ogłosił integrację produktów pamięci masowej Red Hat z IBM Storage, nastąpił gwałtowny wzrost zainteresowania i wzrostu, ponieważ klienci wdrażają architektury chmurowe. Klienci ci dostrzegają korzyści płynące z chmury publicznej w zakresie kosztów, szybkości i elastyczności. W związku z tym IBM Storage Ceph, dawniej Red Hat Ceph, dąży do uproszczenia wdrażania i zarządzania platformą pamięci masowej definiowanej programowo (SDS). Elastyczność i skalowalność sprawiają również, że IBM Storage Ceph jest idealnym rozwiązaniem do obsługi generatywnych zastosowań sztucznej inteligencji (AI).
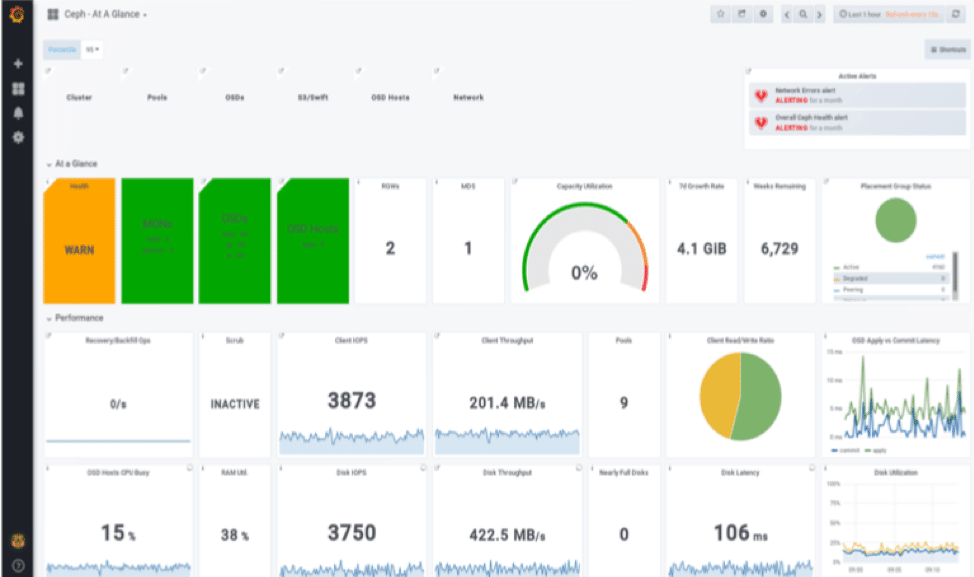
IBM Storage Ceph to otwarte, skalowalne i definiowane programowo, wieloprotokołowe rozwiązanie pamięci masowej, zaprojektowane z myślą o konsolidacji danych w dowolnym miejscu i czasie. Zoptymalizowane pod kątem dużych wdrożeń w pojedynczych i wielu lokalizacjach, rozwiązanie IBM Storage Ceph sprawnie skaluje się, obsługując setki petabajtów danych, a opublikowane testy wskazują na możliwość obsługi dziesiątek miliardów obiektów. Taka skalowalność oraz wrodzona odporność i bezpieczeństwo są kluczowe dla obsługi serwerów typu data lakehouse oraz środowisk open source AI/ML.
Platforma samonaprawiająca się i samozarządzająca
Elastyczność platformy IBM Storage Ceph przejawia się w prostocie zarządzania i zwiększonej elastyczności w dostosowywaniu się do rosnących potrzeb biznesowych, przy jednoczesnym skalowaniu mocy obliczeniowej i pojemności w miarę wprowadzania nowych obciążeń. Samonaprawiające się i samozarządzające elementy platformy zostały zaprojektowane z myślą o dostarczaniu ujednoliconych usług pamięci masowej plików, bloków i obiektów, działających na sprzęcie zgodnym ze standardami branżowymi. Ujednolicona pamięć masowa zapewnia klientom pomost między starszymi aplikacjami działającymi w niezależnej pamięci masowej plików lub bloków a wspólną platformą z pamięcią masową obiektów w jednym urządzeniu.
Obsługa rozwiązań Data Lakehouse i AI/ML, a także tradycyjnych obciążeń, takich jak MySQL i MongoDB na platformach Red Hat OpenShift i Red Hat OpenStack, to główny powód, dla którego pojemność surowa IBM Storage Ceph wynosząca 768 TiB została uwzględniona w watsonx.data — otwartej, zarządzanej i dostosowanej do potrzeb architekturze Data Lakehouse firmy IBM.
Rozwiązanie problemu ciągłego wzrostu ilości danych
Gwałtowny wzrost nieustrukturyzowanych danych i generatywnej sztucznej inteligencji, trend, który raczej nie ustanie w najbliższym czasie, wzajemnie na siebie oddziałuje i przynosi korzyści. Raport Gartnera „Top Trends in Enterprise Data Storage 2023” sugeruje, że „do 2028 roku duże przedsiębiorstwa potroją swoją pojemność nieustrukturyzowanych danych w swoich lokalizacjach lokalnych, na brzegu sieci i w chmurze publicznej w porównaniu z połową 2023 roku”.
Wzrost ilości nieustrukturyzowanych danych, takich jak tekst, obrazy i filmy, napędza generatywną sztuczną inteligencję, pomagając jej w zrozumieniu tych danych i znajdowaniu cennych spostrzeżeń. To tworzy pętlę: sztuczna inteligencja rozwija się wraz z rosnącą ilością danych, a jej realistyczne generowanie danych pogłębia nasze zrozumienie nieustrukturyzowanych zbiorów danych, co prowadzi do większej liczby innowacji.
Ten sam raport Gartnera przewiduje, że „do 2028 roku 70% danych plikowych i obiektowych będzie wdrażanych na skonsolidowanych, nieustrukturyzowanych platformach pamięci masowej, w porównaniu z 35% na początku 2023 roku”. W związku z tym organizacje będą potrzebować rozwiązania do zarządzania pamięcią masową, które przyspieszy przetwarzanie danych – od ich pobierania i czyszczenia po klasyfikację i zarządzanie metadanymi – oraz oferuje zarządzanie pojemnością i wdrażanie w skali chmury, a wszystkie te funkcje są dostępne w rozwiązaniu pamięci masowej definiowanej programowo. Skalowalność IBM Storage Ceph pozwala bezproblemowo sprostać rosnącym potrzebom w zakresie danych.
Aby przyspieszyć i skalować wpływ danych i sztucznej inteligencji (AI) w całej organizacji, IBM uważa, że firmy muszą wdrożyć hybrydową architekturę. To ostatecznie poprawi wyniki biznesowe. IBM Storage Ceph oferuje lokalną pamięć masową w modelu chmurowym, rozwiązując problemy takie jak brak funkcji korporacyjnych w chmurach publicznych, suwerenność danych i koszty. Łatwa w integracji architektura rozwiązania współpracuje z różnymi platformami, chmurami, hiperwizorami, bazami danych open source, takimi jak Apache Iceberg i Parquet, a także pełnymi stosami, takimi jak watsonx.ai i watsonx.data. Można łatwo dodawać nowe węzły lub urządzenia bez przerywania działania usługi. To doskonały wybór do budowy „data lakehouse” z wykorzystaniem watsonx.data i innych obciążeń AI.
IBM Storage Ceph 7.0 przygotowuje się do obsługi technologii NVMe/TCP
W 2023 roku IBM intensywnie pracował, wprowadzając niezbędne aktualizacje do platformy Ceph, w tym IBM Storage Ceph 7.0. Ta platforma Ceph nowej generacji przygotowuje się do obsługi technologii NVMe/TCP, która ma zapewnić szybszy transfer danych między urządzeniami pamięci masowej, serwerami i platformami chmurowymi, przy jednoczesnym zachowaniu niskich opóźnień i wysokiej przepustowości tradycyjnej technologii NVMe.
IBM Storage Ceph idealnie nadaje się do aplikacji wymagających szybkiej pamięci masowej, takich jak bazy danych, systemy analityczne i systemy dostarczania treści. Architektura ta ułatwia integrację z obecnymi środowiskami sieciowymi, ułatwiając klientom przejście na model definiowany programowo, co przekłada się na szybsze, bardziej elastyczne i ekonomiczne działanie.
Technologia NVMe/TCP pozwala firmie Ceph udoskonalić tradycyjną pamięć blokową o skalowalne rozwiązania. Dzięki NVMe/TCP Ceph może współpracować z platformami takimi jak VMware, umożliwiając firmom naśladowanie konfiguracji chmurowych w swoich centrach danych. To rozwiązanie może zmniejszyć zależność od kosztownych, nieelastycznych sieci SAN i dużych macierzy pamięci masowej.
Inne funkcje Ceph 7.0 obejmują:
- Certyfikacja zgodności z SEC i FINRA dla WORM z blokadą obiektów, umożliwiająca korzystanie z WORM zgodność z przepisami dotyczącymi przechowywania obiektów
- Obsługa NFS dla dostępu do systemu plików CephFS dla klientów Ceph, którzy nie są natywnymi klientami
Aby uzyskać więcej szczegółów na temat funkcji, odwiedź społeczność IBM Storage.
Koniec z ograniczeniami sprzętowymi
IBM Storage Ceph przechowuje dane jako obiekty w logicznych pulach pamięci masowej, umożliwiając pojedynczemu klastrowi korzystanie z wielu pul, z których każda jest dostosowana do różnych wymagań wydajnościowych lub pojemnościowych. Klienci korzystają z łatwiejszego i szybszego dostępu do danych dzięki klasyfikacji treści i kontekstu, pojemności pamięci masowej ograniczonej jedynie rozmiarem infrastruktury oraz redukcji kosztów na dużą skalę dzięki usunięciu ograniczeń sprzętowych w porównaniu z tradycyjnymi i starszymi architekturami macierzy pamięci masowej.
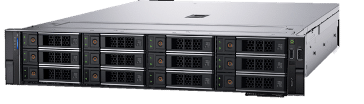
Wdrożenie Ceph stało się łatwiejsze dzięki węzłom IBM Storage Ready Node . Oznacza to, że platformę można wdrożyć jako kompletne rozwiązanie programowo-sprzętowe. Węzły Ready Node są dostępne w różnych konfiguracjach pojemności, zoptymalizowanych pod kątem obciążeń IBM Storage Ceph.
Przygoda w prawdziwym świecie
Ceph.io przedstawia kilka technik rozwiązywania problemów podczas migracji z dysków twardych do NVMe. Do Clyso zgłosiła się dość modna i nowoczesna firma, która chciała przenieść swój klaster Ceph oparty na dyskach twardych do 10-petabajtowej konfiguracji NVMe. Zapoznaj się ze szczegółami Ceph.io.


 Amazon