

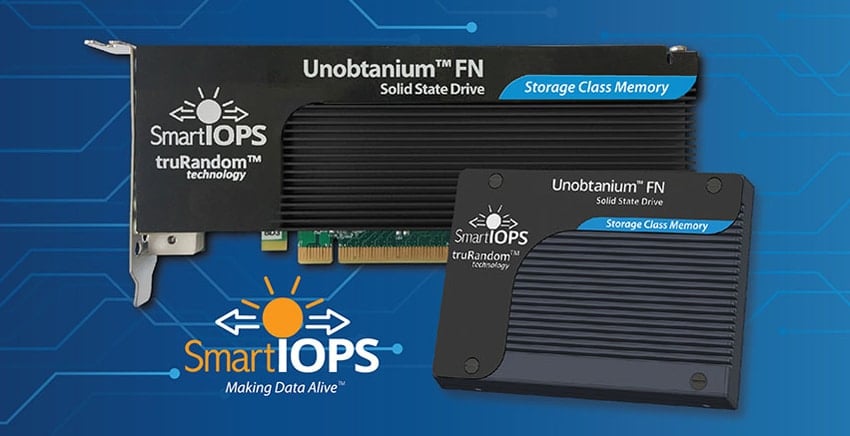
Firmy Smart IOPS i H3 Platform ogłosiły platformę pamięci masowej do obliczeń AI, która ma osiągnąć nawet miliard losowych operacji odczytu na sekundę (IOPS). Proponowany system łączy w sobie tranzystory Unobtanium T50 firmy Smart IOPS z chłodzonym powietrzem urządzeniem H3 Platform, zaprojektowanym w oparciu o technologie akceleracji obliczeniowej i sieciowej firmy NVIDIA.
Platforma jest przeznaczona do intensywnych pod względem danych obciążeń wnioskowania i analityki AI, które wymagają od procesorów GPU dostępu do dużych zbiorów danych za pośrednictwem wysoce równoległych, precyzyjnych operacji wejścia/wyjścia. Została zaprojektowana z myślą o obsłudze inicjatywy NVIDIA Storage-Next oraz modelu programowania SCADA (Scaled Accelerated Data Access ). Technologie te umożliwiają inicjowany przez procesor GPU dostęp do pamięci masowej NVMe, gdy zestawy robocze aplikacji przekraczają możliwości lokalnej pamięci GPU.
Zmniejszając odległość między mocą obliczeniową GPU a pamięcią masową, architektura ma na celu zmniejszenie obciążenia ścieżki sterowania procesora i pomóc w utrzymaniu akceleratorów w stanie zasilenia danymi. To podejście jest ukierunkowane na obciążenia takie jak grafowe sieci neuronowe, wyszukiwanie wektorowe, systemy rekomendacji, generowanie rozszerzone o wyszukiwanie, osadzanie magazynów i inne aplikacje analityki rozproszonej, które generują duże wolumeny małych, losowych żądań.
„Infrastruktura sztucznej inteligencji wkracza w fazę, w której pamięć masowa musi zachowywać się mniej jak pasywne repozytorium, a bardziej jak aktywne rozszerzenie infrastruktury obliczeniowej” – powiedział Ashutosh Das, dyrektor generalny Smart IOPS.
Inteligentne IOPS Unobtanium T50
Unobtanium T50 to urządzenie PCIe Gen6 x4, NVMe 2.0 w formacie E3.S. Parametr Smart IOPS określa do 50 milionów losowych operacji odczytu i 10 milionów losowych operacji zapisu przy rozmiarze bloku 512 bajtów. Wydajność sekwencyjna wynosi do 28 GB/s dla odczytu i 24 GB/s dla zapisu. Przepustowość sekwencyjna w tym zakresie dorównuje przepustowości dysków SSD PCIe Gen6 klasy enterprise, które już wchodzą do masowej produkcji ; wartość 512 bajtów dla losowego odczytu to specyfikacja, która się wyróżnia.
Cztery urządzenia T50 mogą zapewnić deklarowaną łączną wydajność do 200 milionów losowych operacji odczytu na sekundę (IOPS) na poziomie urządzenia. Funkcja Smart IOPS pozycjonuje tę zdolność jako dostosowaną do wymagań wejścia/wyjścia procesorów graficznych PCIe Gen6 x16 nowej generacji, w tym NVIDIA Rubin. Rzeczywista wydajność będzie zależeć od charakterystyki obciążenia, oprogramowania, topologii PCIe, konfiguracji systemu i innych czynników na poziomie systemu.
| Inteligentne IOPS ACS Unobtanium T50 | |
| Specyfikacja wstępna | |
|---|---|
| Wydajność | |
| Losowy odczyt | Do 50 miliona IOPS |
| Losowy zapis | Do 10 miliona IOPS |
| Rozmiar bloku | 512 bajtów |
| Sekwencyjny odczyt | Do 28 GB/s |
| Pisanie sekwencyjne | Do 24 GB/s |
| sprzęt komputerowy | |
| Pojemność | 9 TB, 18 TB i 36 TB |
| Media | Pamięć NAND TLC działająca w trybie pseudo-SLC; obsługa specjalistycznych pamięci NAND SLC o niskim opóźnieniu |
| Budowa | E3.S 2T |
| Interfejs | PCIe Gen6 x4; NVMe 2.0 |
| Dostępność: | |
| Planowana dostępność | Próbki ewaluacyjne: I kw. 2027 r.; produkcja: II kw. 2027 r. |
| Urządzenie H3 Platform High IOPS | |
| Specyfikacja wstępna | |
|---|---|
| Obliczenia i sieci | |
| GPU | 4 × procesory graficzne NVIDIA RTX PRO 6000 Blackwell Server Edition |
| Sieci | 4 × NVIDIA ConnectX-8 |
| Dyski | |
| zatoki SSD | 20 gniazd E3.S 2T na dyski SSD o dużej wydajności IOPS |
| Moc na gniazdo | Do 60 W na gniazdo E3.S |
| Konfiguracja | |
| Chłodzenie | Chłodzony powietrzem |
| Dostępność: | |
| Planowana dostępność | Systemy ewaluacji: I kw. 2027 r.; produkcja: II kw. 2027 r. |
| Specyfikacje wstępne; mogą ulec zmianie bez powiadomienia. | |
W modelu T50 zastosowano architekturę kontrolera Smart IOPS TruRandom z powszechnie dostępną pamięcią NAND TLC działającą w trybie pseudo-SLC. Firma twierdzi, że takie podejście pozwala urządzeniom korzystać z pamięci NAND wielu kwalifikowanych dostawców, zachowując jednocześnie dostęp do skali produkcji i przepustowości łańcucha dostaw w całej branży pamięci flash. Kontroler może również obsługiwać wyspecjalizowaną pamięć NAND o niskim opóźnieniu, jeśli uzasadnia to obciążenie lub ekonomika wdrożenia.
Urządzenie platformy H3
Platforma H3 opracowuje urządzenie chłodzone powietrzem z czterema kartami graficznymi NVIDIA RTX PRO 6000 Blackwell Server Edition, czterema kartami sieciowymi NVIDIA ConnectX-8 i 20 gniazdami pamięci masowej E3.S 2T. Każde gniazdo obsługuje moc do 60 watów, zapewniając moc i pojemność cieplną wymagane przez wydajne urządzenia pamięci masowej.
System, wyposażony w 20 slotów, w których znajdują się urządzenia T50, został zaprojektowany z myślą o osiągnięciu do miliarda losowych operacji odczytu IOPS. Konfiguracja ma na celu zrównoważenie mocy obliczeniowej GPU, łączności sieciowej i łączności z pamięcią masową na jednej platformie, co umożliwia ocenę i wdrażanie obciążeń pamięci masowej małych bloków inicjowanych przez GPU.
„Następna fala systemów AI musi zostać zaprojektowana jako zintegrowana ścieżka danych” – powiedział Brian Pan, założyciel i dyrektor generalny H3 Platform – „a nie jako odłączone od siebie komponenty obliczeniowe, sieciowe i pamięci masowej”. Projekt zakłada umieszczenie pamięci masowej E3.S o wysokiej wydajności IOPS obok procesorów graficznych i szybkich kart sieciowych, zachowując jednocześnie chłodzony powietrzem współczynnik kształtu.
Wysoka wartość IOPS jest istotna w przypadku tych obciążeń, ponieważ sama przepustowość nie opisuje, jak skutecznie system pamięci masowej obsługuje nieregularne, współbieżne dostępy. Żądania małych bloków generowane przez wiele wątków GPU mogą narazić na obciążenie kolejkowania i synchronizacji w architekturach pamięci masowej koordynowanych przez procesor. Urządzenie o wyższej wartości IOPS i niższym opóźnieniu może obsługiwać więcej współbieżnych żądań i potencjalnie skrócić czas oczekiwania GPU na dane.
Smart IOPS i platforma H3 spodziewają się dostępności próbek ewaluacyjnych i systemów w pierwszym kwartale 2027 roku. Dostępność produkcyjna planowana jest na drugi kwartał 2027 roku. Specyfikacje, konfiguracje i harmonogramy pozostają wstępne i mogą ulec zmianie. Kwalifikacja klienta, gotowość ekosystemu oprogramowania oraz ewentualna walidacja lub zatwierdzenie przez firmę NVIDIA to odrębne procesy, których nie można wywnioskować z ogłoszenia.


 Amazon