

Historycznie, każdy odczyt danych przez GPU przechodził przez procesor hosta, który zarządza systemem plików, wysyła polecenia i zwraca dane. To obciążenie jest pomijalne w przypadku dużych transferów sekwencyjnych, ale staje się czynnikiem ograniczającym przy obsłudze milionów operacji 512-bajtowych na sekundę. Podczas konferencji FMS 2026 w Santa Clara, NVIDIA ogłosiła nowe oprogramowanie i inicjatywę branżową mającą na celu wyeliminowanie tego wąskiego gardła.
Centralnym wydarzeniem jest cuFile, API umożliwiające procesorom graficznym bezpośredni odczyt i zapis danych z pamięci masowej. NVIDIA udostępnia cuFile i jego pełen pakiet oprogramowania wspierającego, a kod jest hostowany w nowej organizacji XIO-SIG w serwisie GitHub. Wśród założycieli i opiekunów znajdują się Google, Intel, Meta i NVIDIA. Ponadto NVIDIA oficjalnie uruchomiła Storage-Next, inicjatywę omawianą publicznie co najmniej od konferencji GTC 2025. Storage-Next obejmuje obecnie ponad 40 dostawców pamięci masowej i pamięci flash, takich jak DDN, KIOXIA i Micron, a także producentów kontrolerów, specjalistów ds. chłodzenia i organizacje normalizacyjne. Uczestnicy ci wspólnie definiują, jak powinny zachowywać się urządzenia pamięci masowej, gdy klientem jest procesor graficzny (GPU), a nie procesor (CPU).
Problem: wejście/wyjście pośredniczone przez hosta
Systemy GPU tradycyjnie działały w modelu wejścia/wyjścia zorientowanym na hosta. Procesor (CPU) planuje zadania GPU, przetwarza dane i inicjuje wszystkie transfery między GPU a siecią lub pamięcią masową. Każda operacja przebiega zgodnie z sekwencją: jądro GPU kończy działanie, sterowanie wraca do procesora, procesor konfiguruje transfer, a kolejne jądro zostaje uruchomione. Koszt pojedynczej operacji, głównie koszt uruchomienia jądra i narzut synchronizacji procesora z procesorem graficznym, jest mierzony w mikrosekundach. Chociaż jest on pomijalny w przypadku transferów masowych, narzut ten staje się znaczący w przypadku operacji szczegółowych.
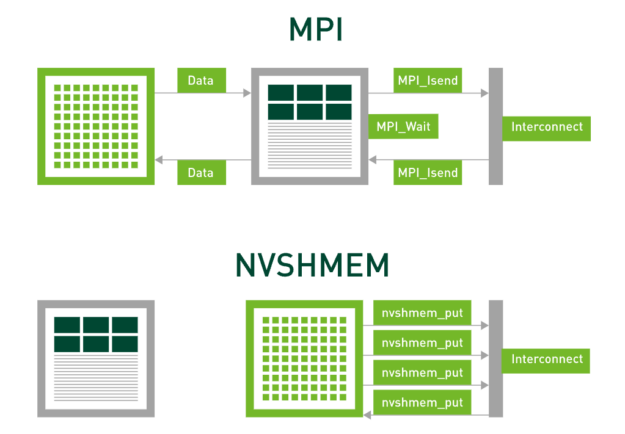
W przypadku komunikacji między procesorami graficznymi (GPU), NVIDIA wyeliminowała zaangażowanie hosta poprzez protokół NVSHMEM, co pozwala kodowi urządzenia na bezpośrednie inicjowanie transferów i nakładanie ich na obliczenia. Wpływ jest znaczący: gdy GROMACS przeniósł swoją komunikację halo-exchange z MPI na protokół NVSHMEM, komunikacja została usunięta ze ścieżki krytycznej i w pełni nałożyła się na obliczenia.
Pamięć masowa zachowała model pośredniczony przez hosta. Odczyt z dysku NVMe nadal zwraca kontrolę procesorowi, uruchamia system plików i czeka na zakończenie. Uczenie toleruje to, ponieważ odczyty są duże i rzadkie. Wnioskowanie nie. Obsługa wpisów w pamięci podręcznej KV, osadzania i wyników wyszukiwania wektorowego generuje miliony małych, losowych odczytów na sekundę, a procesor znajduje się na ścieżce każdego z nich.
I/O inicjowane przez GPU i SCADA
SCADA (skalowany, przyspieszony dostęp do danych) stosuje model NVSHMEM do pamięci masowej, umożliwiając procesorowi graficznemu inicjowanie i zarządzanie własnymi operacjami wejścia/wyjścia pamięci masowej.
Podstawą badań jest BaM, czyli Big Accelerator Memory, opublikowany na konferencji ASPLOS 2023 przez NVIDIA, IBM, Uniwersytet Illinois i Uniwersytet w Buffalo. BaM zademonstrował procesor graficzny zarządzający dyskami NVMe bezpośrednio, koalesując i buforując małe żądania generowane w wątkach, aby utrzymać nasycenie dysków na poziomie kolejek bez ingerencji hosta. Na identycznym sprzęcie, BaM uruchamiał obciążenia analizy danych 5.3 razy szybciej niż dostęp inicjowany przez procesor, a także wykonywał obciążenia graficzne z pamięci flash przy nawet 21.7 razy niższym koszcie sprzętowym niż przechowywanie tych samych danych w pamięci hosta.
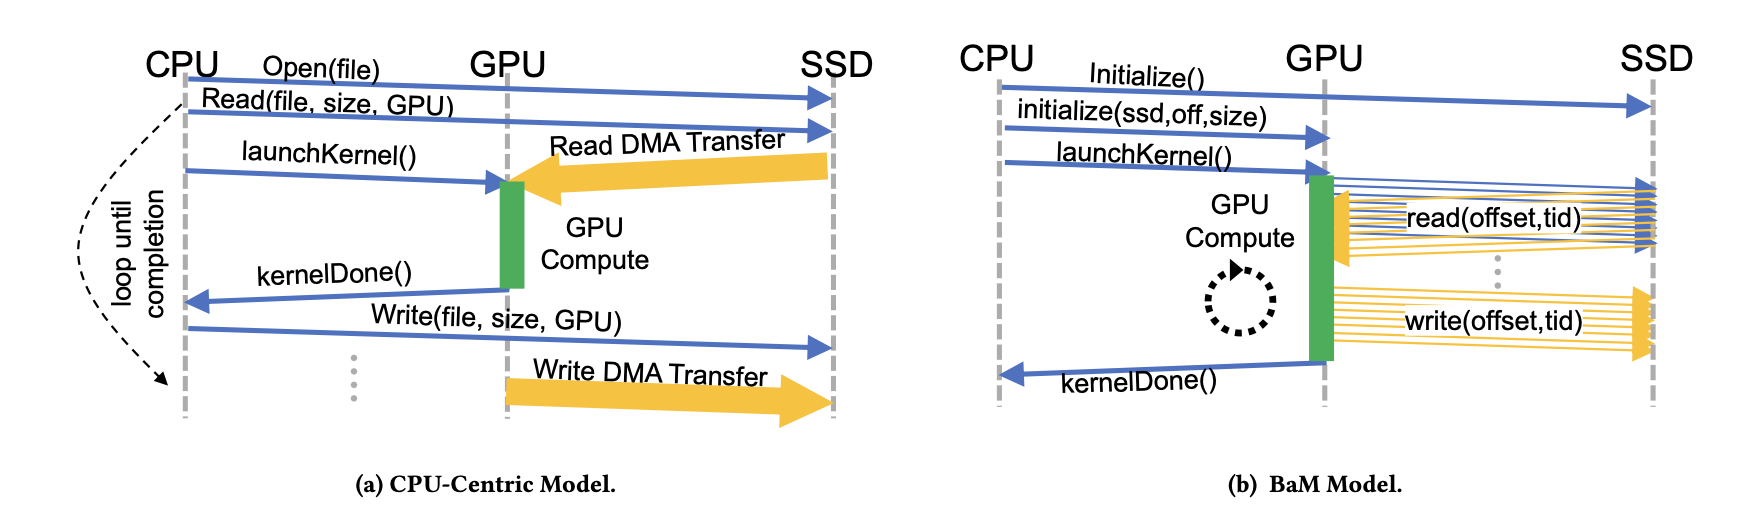
SCADA to forma uproduktywniona. Środowisko wykonawcze na GPU znajduje się pomiędzy wątkami jądra a pamięcią masową. Łączy rozproszone, małe żądania w odczyty obsługiwane z pamięci podręcznej na GPU lub wysyłane na dyski, które mogą być lokalnym NVMe lub zdalnym serwerem pamięci masowej.
Bezpośredni dostęp do urządzeń musi być ograniczony, ponieważ bezpośredni dostęp do współdzielonego dysku mógłby umożliwić jednej aplikacji odczytanie lub uszkodzenie danych innej. Projekt NVIDIA rozdziela poziomy uprawnień. Elementy aplikacji krytyczne dla wydajności działają bez uprawnień, poza zaufaną bazą obliczeniową. Uprzywilejowany komponent konfiguruje chroniony dostęp między każdą aplikacją a wyłącznie jej zatwierdzoną pamięcią masową podczas konfiguracji, wykorzystując standardowe mechanizmy bezpieczeństwa systemu Linux. NVIDIA podaje ten podział i interoperacyjność opartą na systemie Linux jako powód, dla którego stos został udostępniony jako oprogramowanie open source, a nie jako zamknięty komponent CUDA.
Czym SCADA różni się od pamięci masowej GPUDirect
Każda operacja przechowywania danych ma ścieżkę danych (przesunięte bajty) i ścieżkę kontrolną (konstruowanie, wysyłanie i obsługa ukończenia żądania). Technologia GPUDirect Storage (GDS), wprowadzona w 2019 roku i dostępna od 2021 roku, usunęła procesor ze ścieżki danych: poprzez plik cuFile dane są przesyłane za pomocą DMA między dyskiem a pamięcią GPU bez bufora odbić w pamięci RAM hosta. Materiały startowe firmy NVIDIA określają limit ścieżki procesora w DGX-2 na 50 GB/s, przy czym GDS może łączyć ścieżki, aby uzyskać górny limit zbliżający się do 200 GB/s, a DDN, VAST, WEKA, Pure Storage i inni czołowi dostawcy pamięci masowej AI posiadają certyfikaty potwierdzające jego zgodność. Ścieżka kontrolna pozostała w procesorze: oprogramowanie hosta nadal decyduje, co pobrać i wysyła każde żądanie, a procesor GPU jest celem DMA, a nie inicjatorem.
Przy dużych rozmiarach transferu ten podział jest w porządku. Odczyt 1 MB amortyzuje koszt ścieżki sterowania do zera. Przy 512 bajtach proporcje się odwracają. Dominuje stały koszt na żądanie, a procesor (CPU) nasyca się znacznie wcześniej niż dyski. SCADA przenosi ścieżkę sterowania na kartę graficzną (GPU), która absorbuje opóźnienie na operację w taki sam sposób, jak absorbuje opóźnienie pamięci, utrzymując setki tysięcy operacji w ruchu.
Oba systemy współistnieją: cuFile do transferów masowych, SCADA do dużych ilości małych, losowych odczytów.
Storage-Next i problem 512 bajtów
SCADA obsługuje stronę GPU. Storage-Next obsługuje stronę dysków, która jest obecnie zoptymalizowana pod kątem innego obciążenia.
Dyski SSD klasy korporacyjnej od dekady są dostrajane do losowych odczytów 4 KB, dopasowując się do wzorców dostępu do baz danych i wirtualizacji. Większość kontrolerów wykonuje mniej więcej tyle samo pracy, aby obsłużyć odczyt 512 bajtów, co odczyt 4 KB, więc żądania poniżej 4 KB generują koszt 4 KB. Wzorce dostępu do wnioskowania są krótsze: osadzenia zajmują kilkaset bajtów, a bloki pamięci podręcznej KV mają znacznie mniej niż kilobajt. Obsługa ich z dysków dostrojonych do 4 KB wymusza 8-krotne wzmocnienie odczytu, marnując przepustowość i pamięć podręczną kontrolera. Przy dziesiątkach terabajtów małych obiektów, to wzmocnienie decyduje o tym, czy pamięć flash nadaje się jako warstwa pamięci.
Storage-Next to inicjatywa mająca na celu modernizację napędów, kontrolerów i systemów wokół mniejszej jednostki. Projekt został publicznie zaprezentowany na konferencji GTC 2025, gdzie już się rozpoczął, z deklarowanym celem maksymalizacji 512-bajtowego IOPS na GPU przy ograniczeniach mocy i opóźnień końcowych. Podczas konferencji FMS firma NVIDIA dołączyła numer członkowski, ponad 40 dostawców pamięci masowej i pamięci flash oraz wskazała SCADA jako platformę do rozbudowy.
Referencyjnym wynikiem jest demonstracja SC25 firmy Micron, która wykazała 230 milionów losowych operacji odczytu na sekundę (IOPS) o rozmiarze 512 bajtów z jednego serwera w modelu programowania SCADA: 44 dyski SSD Micron 9650 PCIe Gen6 w trzech przełącznikach Broadcom PEX90000 Gen6, sterowane przez trzy przełączniki H100 w obudowie H3 Platform Falcon 6048. Wartość ta stanowi około 95% łącznej wartości 5.5 miliona operacji odczytu na sekundę (IOPS) dla 44 dysków.
Skład tej liczby ma znaczenie. 230 milionów odczytów 512 bajtów odpowiada w przybliżeniu 118 GB/s ładunku, który cztery lub pięć z tych dysków mogłoby dostarczyć sekwencyjnie. Osiągnięciem jest liczba operacji. Utrzymanie jej przez oprogramowanie hosta wymagałoby kilkudziesięciu rdzeni procesora na samo przetwarzanie zgłoszeń i ich zakończenie, a mimo to pojedynczy procesor w wersji demonstracyjnej był praktycznie bezczynny. Rozłożone na ponad sto tysięcy wątków GPU, obciążenie wynosi kilka tysięcy operacji na wątek na sekundę.
Możliwości dysków SSD są obecnie czynnikiem decydującym. Micron 9650, pierwszy dysk SSD PCIe Gen6, charakteryzuje się sekwencyjną przepustowością 28 GB/s i rekordowymi 5.5 milionami losowych operacji odczytu (IOPS). Micron informuje o liniowym skalowaniu od 1 do 44 dysków w wersji demonstracyjnej. Seria GP firmy Kioxia, dysk SSD XL-Flash przeznaczony do dostępu do danych 512-bajtowych , jest rozwijana w ramach programu Storage-Next. Plan działania firmy NVIDIA w ramach programu Storage-Next zakłada dyski SSD PCIe Gen7 o wydajności 100 milionów IOPS każdy, do czego dążą obecnie producenci kontrolerów, w tym Marvell. Osiągnięcie tych wartości wymaga przeprojektowania kontrolera, dostosowania korekcji błędów do małych obciążeń oraz standardów definiujących natywne dla GPU zachowanie dysków.
Mapowanie na potrzeby szkolenia i wnioskowania
Obie ścieżki odpowiadają dwóm wzorcom dostępu. Trening jest ograniczony przepustowością. Strumieniuje duże sekwencyjne fragmenty i okresowo zapisuje punkty kontrolne o rozmiarze wielu terabajtów, podczas gdy GPU są bezczynne. Obciążenie procesora jest znikome przy takich rozmiarach transferu, więc GDS i nowo udostępniony stos cuFile pozostają właściwym interfejsem, mierzonym w GB/s na GPU i czasie trwania punktu kontrolnego.
Wnioskowanie jest ograniczone liczbą operacji wejścia/wyjścia na sekundę (IOPS). Pamięć podręczna KV, stan uwagi dla każdego tokena już przetworzonego w konwersacji, rośnie wraz z długością kontekstu. Wdrożenia agentowe obsługują tysiące równoczesnych konwersacji. Szybko przekracza ona pamięć GPU, a ponowne obliczenie usuniętych wpisów zajmuje więcej czasu GPU niż ich odczyt. Standardowa konstrukcja to wielopoziomowa pamięć podręczna, która rozlewa się z pamięci GPU do pamięci systemowej i pamięci flash, uzupełniana poprzez duże wolumeny małych, losowych odczytów. Wyszukiwanie wektorowe i wyszukiwanie osadzające generują ten sam wzorzec. Jest to docelowy kształt dostępu SCADA i powód, dla którego NVIDIA podaje 512-bajtowe IOPS zamiast przepustowości. Udostępnianie pamięci podręcznej KV z pamięci flash, a nie z pamięci RAM, zwiększa kontekst i liczbę równoczesnych użytkowników obsługiwanych przez każdy GPU, co określa koszt obsługi na użytkownika.
Sprzęt: Vera BlueField-4 STX i CMX
Warstwę platformy stanowi NVIDIA Vera BlueField-4 STX , architektura pamięci masowej o konstrukcji rack, zaprezentowana na targach GTC 2026 i rozszerzona w tym tygodniu. STX łączy platformę Vera Rubin z procesorami pamięci masowej BlueField-4, z których każdy łączy rdzenie Vera Arm ze zintegrowaną siecią o przepustowości 800 Gb/s i mocą obliczeniową około 6 razy większą niż BlueField-3.
Na targach FMS firma NVIDIA opublikowała test porównawczy dla tych rdzeni. Dwuetapowy potok kompresji i szyfrowania, reprezentatywny dla systemów pamięci masowej z usługami danych inline, które dotyczą całego ruchu, działał z przepustowością nawet 3.21 razy większą niż procesor x86 w systemie Vera. Domniemane twierdzenie jest takie, że szyfrowanie, kompresja i weryfikacja, które obecnie wykorzystują rdzenie x86 w kontrolerach pamięci masowej, mogą zostać przeniesione na układ Vera przy niższym poborze mocy. DOCA, platforma programowa firmy NVIDIA dla BlueField, wymusza politykę bezpieczeństwa na ścieżce danych. Pamięć masowa CMX Context Memory Storage , oparta na platformie STX, łączy pamięć flash z BlueField-4 jako współdzieloną warstwę pamięci podręcznej KV do wnioskowania o długim kontekście. Systemy partnerskie firm DDN, Dell, HPE, IBM, VAST Data, WEKA i innych mają się pojawić w drugiej połowie 2026 roku.
Myśli końcowe
Struktura strategiczna jest jasna: NVIDIA publikuje interfejs, którego GPU będą używać do komunikacji z pamięcią masową, udostępniając implementację na zasadzie open source i organizując współpracę ponad 40 dostawców w celu standaryzacji działania sprzętu. Otwarcie pliku cuFile odchodzi od praktyki firmy NVIDIA polegającej na utrzymywaniu tej warstwy w CUDA. Jednak interfejs pamięci masowej inicjowany przez GPU opłaca się tylko wtedy, gdy dostawcy dysków, kontrolerów i macierzy go opracują. Dołączenie Intela jako podmiotu utrzymującego jest znaczącym sygnałem. Wiodący dostawca układów scalonych x86 w obecnych systemach pamięci masowej wspiera oprogramowanie zaprojektowane w celu usunięcia tych układów ze ścieżki wejścia/wyjścia.
Demonstracja Microna dowodzi wykonalności. Trzy procesory graficzne napędzały 44 dyski Gen6 do około 95% ich łącznego limitu nominalnego przy rozmiarze bloku, który branża traktowała jako dodatek. Pozostaje kwestia wykonania: kod trafia na GitHub, SCADA dojrzewa od frameworka do obsługiwanego komponentu CUDA oraz producenci masowo dostarczają dyski SSD zoptymalizowane pod kątem małych odczytów. Powyższe dane pochodzą od firmy NVIDIA i jej partnerów, a nie są niezależnymi pomiarami. Przetestujemy je, gdy systemy STX dotrą do laboratorium w drugiej połowie roku.


 Amazon