

Firma Supermicro ogłosiła dziś, we współpracy z IBM i NVIDIA, rozwiązanie pamięci podręcznej KV, które przenosi stan klucz-wartość, będący podstawą wnioskowania o długim kontekście, z GPU na współdzieloną warstwę all-flash. Pakiet łączy serwery pamięci masowej Supermicro Petascale z procesorami AMD EPYC 9005, IBM Storage Scale, NVIDIA Dynamo i NVIDIA Spectrum-X Ethernet, a firmy wspierają go sprawdzoną architekturą referencyjną, opublikowaną przez IBM w Redbook. Wartość ta to 56-krotne skrócenie czasu do pierwszego tokena dla 130 000 tokenów w porównaniu z GPU, które przelicza kontekst od podstaw.
Dlaczego pamięć podręczna KV potrzebuje warstwy pamięci masowej
Wnioskowanie przebiega w dwóch fazach: wstępne wypełnianie przekształca monit w tokeny i przepuszcza je przez model w celu wygenerowania pośrednich stanów klucz-wartość, a dekodowanie generuje odpowiedź po jednym tokenie na raz dla tych stanów. Przechowywanie stanu KV w trwałej pamięci podręcznej pozwala systemowi na jego ponowne wykorzystanie w następnej turze, kolejnym kroku agenta lub kolejnym żądaniu w tym samym kontekście, bez konieczności ponownego obliczania.
Przepływy pracy oparte na agentach, asystenci kodowania, RAG o długim kontekście i aplikacje wieloobrotowe generują wystarczająco dużo tego stanu, aby szybko przepełnić pamięć procesora graficznego i procesora. Dlatego właśnie Supermicro, IBM i NVIDIA opracowują warstwę pamięci masowej w sieci.
W tym projekcie NVIDIA Dynamo zarządza hierarchią pamięci podręcznej i przenosi bloki przez NIXL; IBM Storage Scale Erasure Code Edition zapewnia współdzieloną warstwę plików; a serwery Petascale dostarczają pamięć flash i łącza PCIe Gen5. Supermicro twierdzi, że trzy firmy przetestowały stos na poziomie klastra przy wysokiej współbieżności i zakłóconym ruchu sieciowym sąsiadów. Firma przedstawia rezultat jako gotowe rozwiązanie z integracją z fabryczną szafą rack i wdrożeniem na miejscu, co skraca czas wdrożenia z tygodni do dni.
Testowana konfiguracja
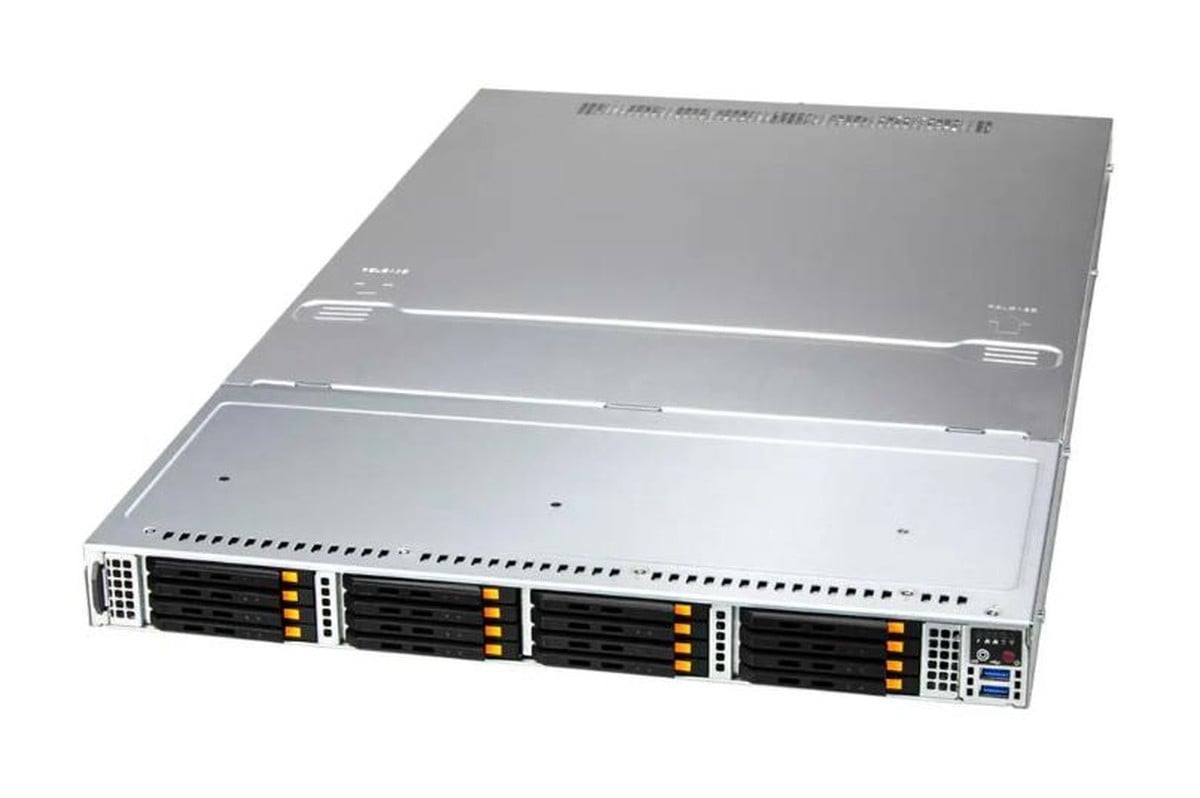
Architektura referencyjna wykorzystuje osiem węzłów Supermicro ASG-1115S-NE316R Petascale, każdy w systemie 1U z pojedynczym procesorem AMD EPYC 9535 i dyskami 16 Micron E3.S NVMe o pojemności 7.68 TB, co daje 122.88 TB surowej pamięci flash w każdym węźle i około 983 TB w ośmiu węzłach. Każdy węzeł zawiera dwuportową kartę NVIDIA BlueField-3 B3220 o pojemności 200 Gb/s po stronie klienta i 400 Gb/s ConnectX-7 dla zaplecza pamięci masowej, z trzema przełącznikami Spectrum-X SN5600 w układzie „spine and leaf” i łączami uplink o przepustowości 800 Gb/s.
Węzły pamięci masowej obsługują RHEL 9.6 i IBM Storage Scale ECE 6.0.0.1 w układzie kodu kasowania 8+2P. Na podstawie wcześniejszych testów IBM oszacowało, że przepustowość odczytu tej ośmiowęzłowej warstwy wynosi 315 GB/s.
| Składnik | Architektura referencyjna pamięci podręcznej KV (według testów) |
|---|---|
| Poziom przechowywania | |
| Węzły pamięci masowej | 8x Supermicro ASG-1115S-NE316R (1U, pojedyncze gniazdo) |
| Procesor na węzeł | AMD EPYC 9535, 128 linii PCIe Gen5 (64 do NVMe, 64 do sieci) |
| Flash na węzeł | 16x Micron 7.68 TB E3.S NVMe (122.88 TB w stanie surowym) |
| Sieć na węzeł | NVIDIA BlueField-3 B3220, dwuportowa karta 200 Gb (po stronie klienta) NVIDIA ConnectX-7 400Gb (zaplecze pamięci masowej) |
| Przełączanie | 3x NVIDIA Spectrum-X SN5600, spine and leaf, łącza uplink 800 Gb/s |
| Oprogramowanie do przechowywania danych | IBM Storage Scale Erasure Code Edition 6.0.0.1, 8+2P RHEL 9.6 |
| Klient wnioskowania | |
| Konfiguracja | Supermicro SYS-212GB-FNR (NVIDIA MGX), Ubuntu 24.04 |
| Procesor graficzny użyty do testów porównawczych | 1x NVIDIA RTX PRO 6000 Blackwell, 19.6 GiB wolnej pamięci podręcznej KV po uwzględnieniu wag i wykresów CUDA |
| Sieć kliencka | 2x NVIDIA BlueField-3 B3140H 400 Gb/s, do 80 GB/s przepustowości dla klienta |
| Model i oprogramowanie | openai/gpt-oss-120b (MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0 z NIXL Klient benchmarku NVIDIA AIPerf |
| Warstwowanie pamięci podręcznej | Poziomy hosta i lokalne ustawione na zero; wszystkie 1.4 miliona buforowanych tokenów obsługiwane są z poziomu Storage Scale |
Klientem testowym jest pojedynczy system Supermicro SYS-212GB-FNR MGX, a wyniki pochodzą z jednej karty graficznej NVIDIA RTX PRO 6000 Blackwell w tym systemie, uruchamiającej model openai/gpt-oss-120b w MXFP4 pod vLLM 0.14.1 i Dynamo 0.9.0.
Po uwzględnieniu wag i wykresów CUDA, 19.6 GB pamięci GPU pozostało na pamięć podręczną KV, co wystarcza na około 1.14 miliona tokenów na samym GPU. Na potrzeby testów pamięć hosta i warstwy lokalne zostały ustawione na zero, tak aby każdy buforowany blok pochodził z Storage Scale. Dzięki temu wyniki mierzą ścieżkę pamięci masowej samodzielnie, bez pomocy hierarchii mieszanej.
56x w czasie do pierwszego tokena, 22x w przepustowości
Bez pamięci podręcznej czas do pierwszego tokena dla modelu 120B wzrósł z 0.572 sekundy przy 10 000 tokenów wejściowych do 32.14 sekundy przy 130 000, gdy GPU przeliczał pełny kontekst. Z pamięcią podręczną KV w Storage Scale, czas TTFT utrzymywał się między 0.193 a 0.57 sekundy w tym samym zakresie, co stanowi wartość 56x przy 130 000 tokenów i rozpiętość 0.377 sekundy, którą Supermicro podaje w swoim ogłoszeniu. IBM, Supermicro i NVIDIA przeprowadziły te testy, a my nie przeprowadzaliśmy ani nie weryfikowaliśmy wyników.
Test przepustowości obejmował wysłanie 200 żądań w 28 równoczesnych połączeniach, pochodzących ze 100 unikalnych komunikatów, co łącznie dało 24 miliony tokenów i 825 GB danych w pamięci podręcznej KV, przy czym pamięć podręczna początkowo była pusta. Bazowy wynik przeliczenia wyniósł 0.19 żądania na sekundę w 1,048 sekund; warstwa Storage Scale osiągnęła 4.26 żądania na sekundę w 46.94 sekundy, co stanowi 22-krotny wzrost, uwzględniający koszt zimnego startu związanego z zapełnieniem pamięci podręcznej.
Trzeci przebieg dodał czterech klientów przesyłających niepowiązany ruch sieciowy z prędkością 200 GB/s przez tę samą sieć, a konfiguracja z pamięcią podręczną utrzymywała 3.6 żądań na sekundę i 55.56 sekundy dla 200 żądań, czyli o około dziewięć sekund wolniej niż czysty przebieg, ale wciąż 18-krotnie dłużej niż w przypadku linii bazowej. IBM przypisuje ten niewielki spadek wydajności sieci Spectrum-X, która izoluje ruch z pamięci podręcznej od obciążenia w tle.
„Agentna sztuczna inteligencja i aplikacje długokontekstowe wymagają efektywnego ponownego wykorzystywania kontekstu na wielu etapach, a NVIDIA Dynamo pomaga w koordynacji rozproszonego wnioskowania, dzięki czemu przedsiębiorstwa mogą uzyskać większą użyteczną przepustowość z każdego procesora graficznego” – powiedziała Shruti Koparkar, dyrektor ds. produktów NVIDIA AI Inference. „Dzięki połączeniu NVIDIA Dynamo i Spectrum-X Ethernet z serwerami pamięci masowej Supermicro Petascale i IBM Storage Scale, to rozwiązanie pamięci podręcznej KV tworzy wysokowydajną, współdzieloną warstwę pamięci masowej, która może zredukować redundantne obliczenia, skrócić czas do pierwszego tokenu i pomóc klientom skalować odporne usługi wnioskowania AI”.
Rozmiarowanie i to, czego nie ma w liczbach
Przewodnik IBM dotyczący rozmiarów określa konfigurację czterowęzłową z 4+2P z 67% pojemności użytkowej dla modeli od 7B do 34B i do 64 GPU, testowaną konfigurację ośmiowęzłową z 8+2P i 80% pojemności użytkowej dla modeli od 70B do 120B i 100 do 256 GPU wymagających przepustowości odczytu od 100 do 300 GB/s, oraz 16 lub więcej węzłów z 16+3P i 84% pojemności użytkowej dla większych modeli i 300 lub więcej GPU o przepustowości 300 GB/s i większej. Sam Storage Scale ECE skaluje się od trzech serwerów pamięci masowej do 256.
Głównym zastrzeżeniem jest konfiguracja testowa z pojedynczym GPU. Architektura referencyjna jest skalowana dla setek GPU, ale wszystkie wyniki w artykule pochodzą z porównania jednej karty RTX PRO 6000 z ośmiowęzłową pamięcią flash o pojemności 983 TB, którą IBM szacuje na 315 GB/s. Oznacza to, że po stronie pamięci masowej nie było nawet mowy o przeciążeniu, a testy nie pokazują, jak TTFT sprawdza się, gdy cały klaster GPU pobiera jednocześnie pamięć podręczną.
Firma Supermicro nie opublikowała cen ani daty dostępności pakietu, a ogłoszenie nie podaje danych dotyczących wykorzystania GPU. To podejście jest zbliżone do zintegrowanej z Dynamo akceleracji pamięci podręcznej KV DDN w systemie AI400X3M , z tą różnicą, że stos ten działa na standardowych serwerach Supermicro i sieci Ethernet w systemie plików IBM.
„W miarę jak obciążenia AI rozszerzają się z uczenia na wnioskowanie, przedsiębiorstwa i neocloudy wdrażające obciążenia wnioskowania o wysokiej przepustowości, charakterystyczne dla agentowej AI oraz wielokontekstowej, generatywnej AI z wieloma turami, muszą usuwać wąskie gardła, aby poprawić wydajność GPU” – powiedział Charles Liang, prezes i dyrektor generalny Supermicro. „Nasze rozwiązanie, z IBM i NVIDIA, wyraźnie pokazuje te korzyści wydajnościowe”.



 Amazon