

Niektóre serwery rozszerzają to, co już istnieje, podczas gdy inne zmieniają oczekiwania. Dell PowerEdge R7725xd należy do tej drugiej kategorii. W naszych ostatnich testach, skonfigurowanych z 24 dyskami SSD Micron 9550 PRO PCIe Gen5 NVMe i czterema kartami sieciowymi 2x 200 GbE, ten serwer 2U osiągnął wyższą przepustowość niż jakikolwiek inny system, który wcześniej mierzono. Wewnętrznie platforma utrzymywała ponad 300 GB/s w całej puli NVMe. W sieci osiągnęła 160 GB/s przy użyciu standardowego protokołu RDMA, bez dodatkowej złożoności.
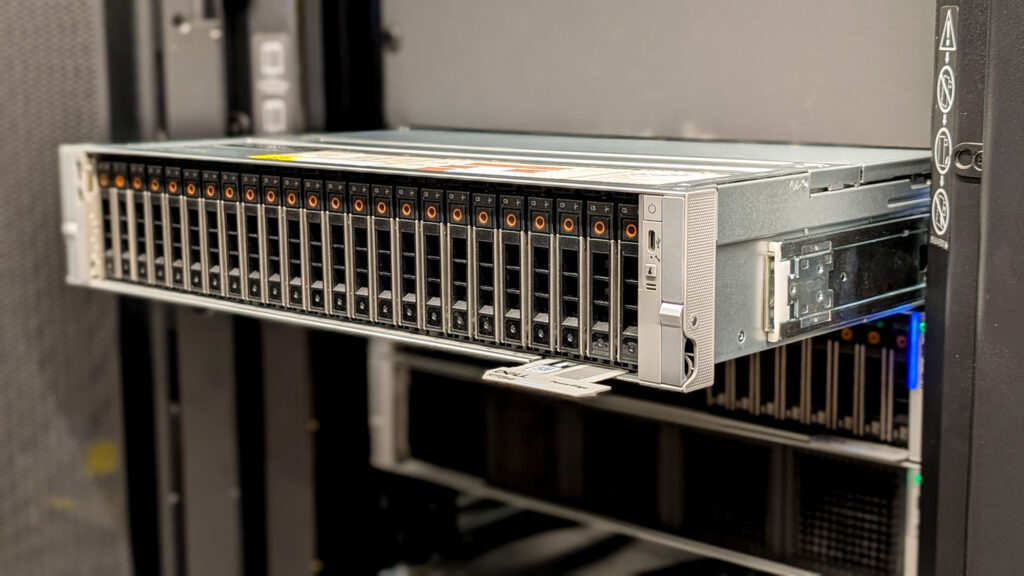
To nie tylko szybszy serwer pamięci masowej. To system, który zmienia sposób, w jaki projektuje się obliczenia intensywnie wykorzystujące dane. Nowoczesne procesy uczenia i wnioskowania AI są często ograniczone nie mocą obliczeniową GPU, ale szybkością, z jaką dane mogą być przygotowywane, przesyłane strumieniowo, tasowane i ustawiane w punktach kontrolnych. Duże węzły GPU będą bezczynne, jeśli pamięć masowa nie będzie w stanie nadążyć. Zespoły rozwiązują te ograniczenia, wykorzystując pamięci podręczne, nadwymiarowanie i złożone warstwowanie, aby zapewnić akceleratorom wystarczająco szybki odbiór danych, aby uzasadnić ich koszty.
Dell PowerEdge R7725xd rozwiązuje problem wąskiego gardła u źródła. Serwer został zbudowany w oparciu o 24-zatokową płytę główną U.2, a każdy dysk otrzymuje dedykowane łącze PCIe Gen5 x4 bezpośrednio do procesora AMD EPYC. Brak jest rozgałęzień przepustowości i nie zastosowano ekspandera midplane w celu ograniczenia współbieżności. Wydajność skaluje się płynnie, ponieważ sprzęt został zaprojektowany tak, aby agregować przepustowość bez konfliktów. W tradycyjnej konfiguracji 2-gniazdowej procesory są połączone 4 łączami XGMI, co umożliwia komunikację między gniazdami. W modelu R7725xd jedno z tych łączy zostało przeznaczone na dodatkowe 16 linii PCIe Gen5 na procesor, co daje serwerowi łącznie 160 linii PCIe Gen5 (96 dla przednich dysków SSD i 64 dla czterech tylnych gniazd PCIe). W połączeniu z dyskami SSD 9550 PRO firmy Micron, które są przeznaczone do stałych obciążeń zapisu i wysokiej wytrzymałości, system staje się silnikiem danych o wysokiej przepustowości, zdolnym do obsługi obciążeń wymagających dużej liczby punktów kontrolnych i ciągłego przesyłania strumieniowego.
Na tej architekturze umieściliśmy platformę PEAK:AIO , aby wykorzystać równoległe ścieżki przesyłania i utrzymać wydajność wraz ze wzrostem współbieżności. Rezultatem była nie tylko szczytowa wydajność, ale także jej stała wydajność pod obciążeniem. Platforma może działać jako lokalny węzeł wykonawczy do przetwarzania wstępnego, trenowania lub transformacji, albo obsługiwać pamięć masową o dużej przepustowości w wielu systemach GPU przez sieć. Jeśli masz ochotę na eksperymenty, możesz wykonywać obie te czynności jednocześnie.
Na wynos
- Bezprecedensowa przepustowość w pojedynczym węźle: R7725xd osiągnął przepustowość wewnętrzną ponad 300 GB/s i 160 GB/s w standardzie NVMe-oF RDMA, co dorównuje wielowęzłowym klastrom pamięci masowej w obudowie 2U.
- Prawdziwa architektura Gen5, brak przełączników, brak rozgałęzień: Wszystkie 24 dyski SSD Micron 9550 PRO otrzymują dedykowane linie x4 PCIe Gen5 bezpośrednio z zespołu procesora, co pozwala na skalowanie przepustowości łącza bez konfliktów.
- Wyposażony w procesor AMD EPYC serii 9005: Dwa procesory AMD EPYC 9575F zapewniają liczbę ścieżek, przepustowość pamięci i topologię NUMA niezbędną do utrzymania wysokiej współbieżności operacji wejścia/wyjścia.
- Zaprojektowane dla obciążeń wymagających sztucznej inteligencji, analityki i punktów kontrolnych: System eliminuje wąskie gardła wejścia/wyjścia, które blokują nowoczesne potoki GPU, umożliwiając ciągłe przesyłanie danych o dużej przepustowości.
- PEAK:AIO odblokowuje pełną paralelność: Oprogramowanie PEAK:AIO utrzymuje nasycenie struktur kolejek pod obciążeniem, zapewniając wydajność klasy korporacyjnej przy atrakcyjnym stosunku ceny do wydajności (USD/GB).
Zbudowany specjalnie dla przepustowości NVMe
W najnowszej generacji serwerów firma Dell odeszła od stosowania przełączników PCIe w konfiguracjach serwerów o dużej gęstości pamięci masowej. Modele takie jak PowerEdge R770 lub R7725 oferują zatoki PCIe Gen5 x4, obsługujące do 16 konfiguracji dysków SSD, a w konfiguracjach z większą płytą główną pamięci masowej można je przełączyć na zatoki x2. Serwery poprzedniej generacji, takie jak PowerEdge R760, zawierały przełącznik PCIe w 24-zatokowych konfiguracjach NVMe. Aby uprościć budowę i wyeliminować złożoność wprowadzoną przez przełącznik PCIe, nowe serwery przyjęły strategię redukcji liczby linii PCIe w konfiguracjach o dużej gęstości pamięci masowej. Tak było aż do wprowadzenia modelu R7725xd.
Różnica między standardowym R7725 a R7725xd sprowadza się do sposobu, w jaki platformy alokują zasoby PCIe w warstwie root. Podstawowy R7725 rozdziela linie PCIe między pamięć masową, rozbudowę GPU i uniwersalne wejścia/wyjścia. Wariant „xd” realokuje ten budżet, tak aby podsystem NVMe stał się głównym odbiorcą przepustowości PCIe. 24 zatoki U.2 są podłączone bezpośrednio do rdzeni PCIe Gen5 procesora, a każdy dysk SSD otrzymuje własny punkt końcowy x4, a nie współdzielone łącze uplink dostępne za pośrednictwem przełącznika PCIe lub drzewa re-timerów. Dzięki temu każdy dysk ma niezależne struktury kolejek i niezależne ścieżki DMA z powrotem do kontrolera pamięci.
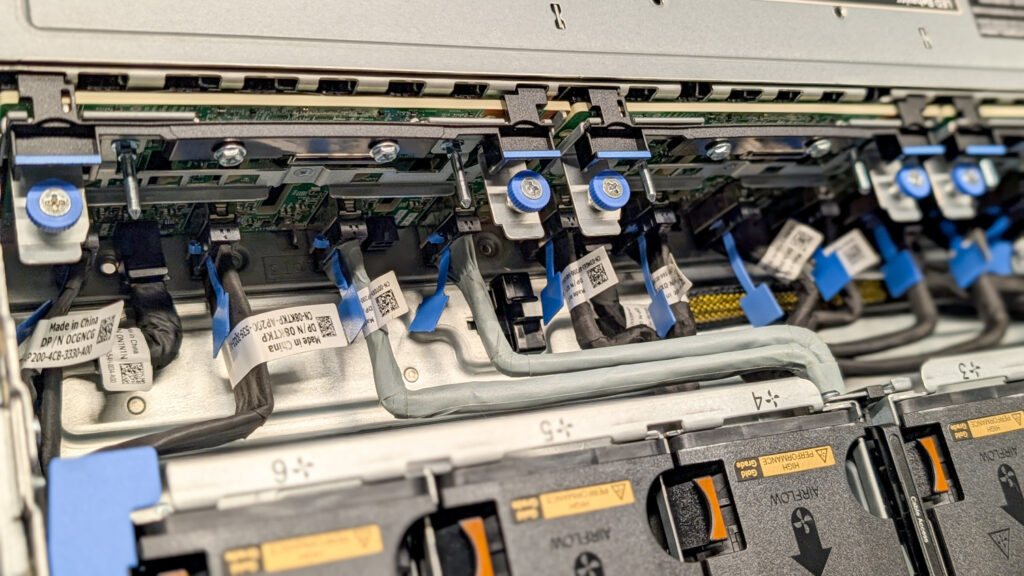
Topologia płyty głównej i karty riser odzwierciedla to zaangażowanie. Dell grupuje złącza NVMe i gniazda PCIe w obu gniazdach AMD EPYC, dzięki czemu każdy procesor ma bezpośrednią własność nad częścią zestawu dysków. W praktyce tworzy to dwie symetryczne domeny NVMe, z których każda charakteryzuje się lokalnymi parametrami opóźnień i pełną współbieżnością odczytu/zapisu. Gdy zainstalowaliśmy cztery dwuportowe karty sieciowe Broadcom 200 GbE jako karty dodatkowe, rozmieszczenie gniazd pozwoliło każdej karcie sieciowej trafić do domeny PCIe zsynchronizowanej z odpowiadającą jej grupą NVMe. W przypadku technologii NVMe-over-RDMA oznaczało to, że ruch sieciowy pozostawał lokalny dla gniazda obsługującego operacje wejścia/wyjścia powiązanego dysku, unikając przeskoku między gniazdami Infinity Fabric, który zazwyczaj zwiększa opóźnienie i zużywa przepustowość pod obciążeniem.
Właściwości termiczne również zapewniają stałą przepustowość. Technologia U.2 pozostaje korzystna w gęstych konfiguracjach Gen5, ponieważ zapewnia zdefiniowany kanał przepływu powietrza i przewidywalną powierzchnię radiatora dla każdego urządzenia. Moduły wentylatorów o wysokim ciśnieniu statycznym i kanały wentylacyjne w obudowie serwera R7725xd zapewniają stały przepływ powietrza we wszystkich 24 zatokach, umożliwiając ciągłą pracę obciążeń zapisu na pełnym dysku bez ograniczania przepustowości. Konstrukcja mechaniczna uzupełnia konstrukcję elektryczną: każdy dysk może utrzymać pełną wydajność, ponieważ platforma jest zaprojektowana do chłodzenia 24 równoczesnych urządzeń Gen5 przy obciążeniu.
To połączenie wyrównania typu root-complex, spójnego, nierównomiernego układu ścieżek dostępu do pamięci (NUMA), rozmieszczenia kart sieciowych z uwzględnieniem gniazd oraz stabilnej termicznie obudowy U.2 umożliwia systemowi osiągnięcie szybkości transmisji danych (I/O) na dużą skalę. Architektura ta eliminuje wąskie gardła i optymalizuje wydajność.
Dell PowerEdge R7725xd iDRAC 10 – przegląd
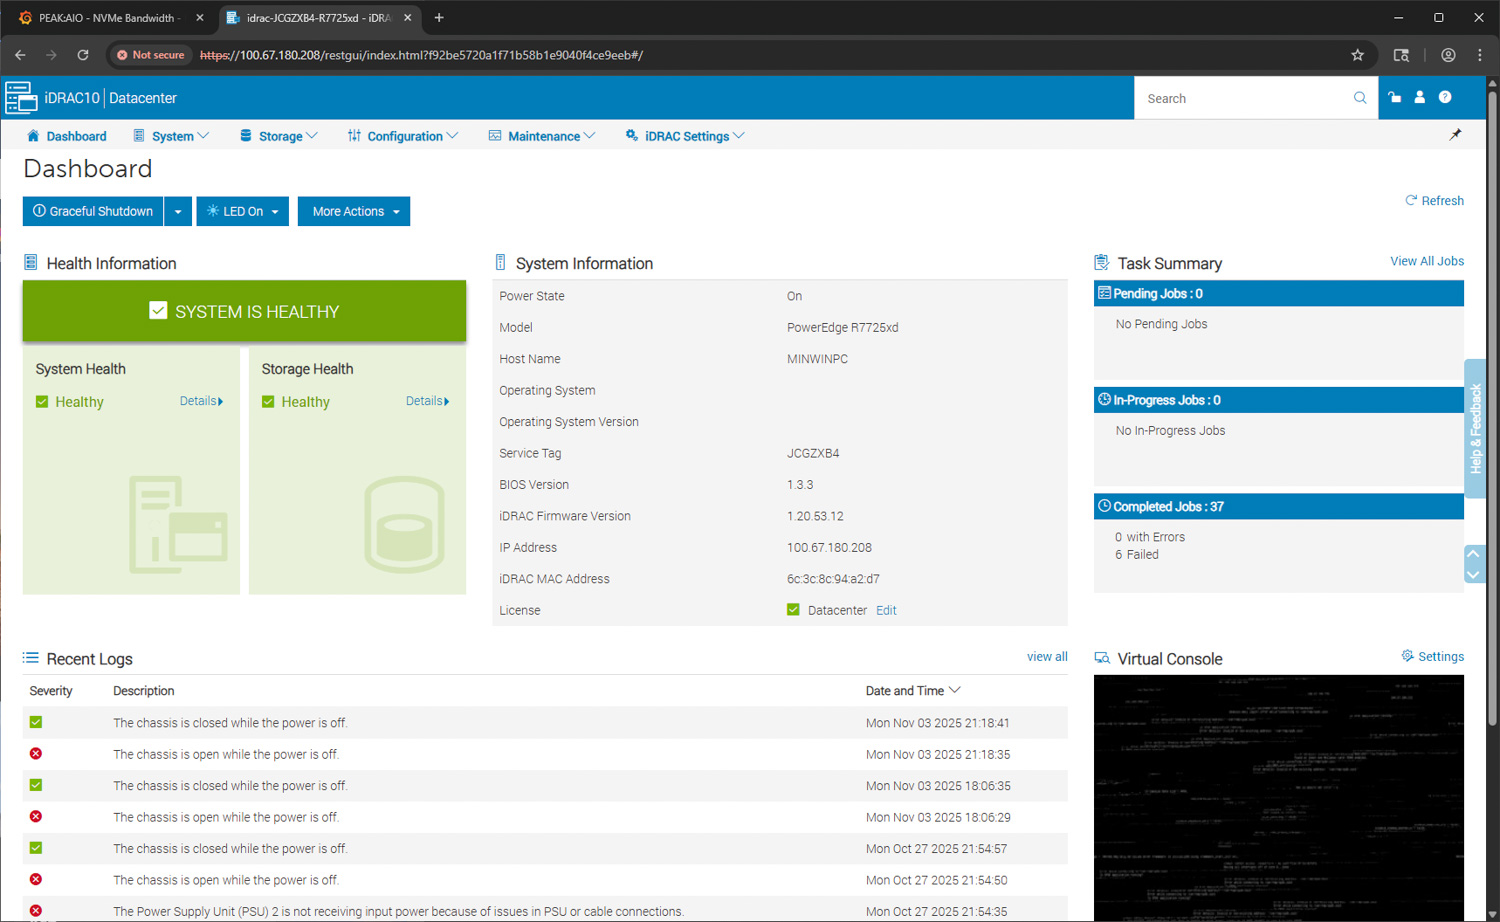
Ta generacja serwera R7725xd, podobnie jak wiele innych platform 17. generacji, które testowaliśmy, wykorzystuje nową platformę iDRAC 10 firmy Dell, która pełni funkcję centralnego punktu zdalnego zarządzania, monitorowania stanu i kontroli poza pasmem. Widok pulpitu nawigacyjnego zapewnia natychmiastowe podsumowanie ogólnego stanu systemu, stanu pamięci masowej i ostatniej aktywności. W przypadku naszego egzemplarza testowego raport o stanie systemu i pamięci masowej ma kolor zielony, co potwierdza, że serwer działa prawidłowo. Kluczowe szczegóły systemu, takie jak model, nazwa hosta, wersja BIOS-u, poziom oprogramowania układowego kontrolera iDRAC, adres IP i informacje o licencjach, są wyświetlane po prawej stronie interfejsu.
Pulpit nawigacyjny zawiera również panel podsumowania zadań, który pokazuje ukończone, oczekujące i trwające operacje. Poniżej znajduje się lista ostatnich logów rejestrujących zdarzenia naruszenia obudowy i komunikaty dotyczące zasilania, zapewniając szybki wgląd w zmiany stanu sprzętu bez konieczności przechodzenia do głębszych menu. Panel konsoli wirtualnej jest dostępny w prawym dolnym rogu, umożliwiając pełne zdalne sterowanie przełącznikiem KVM.
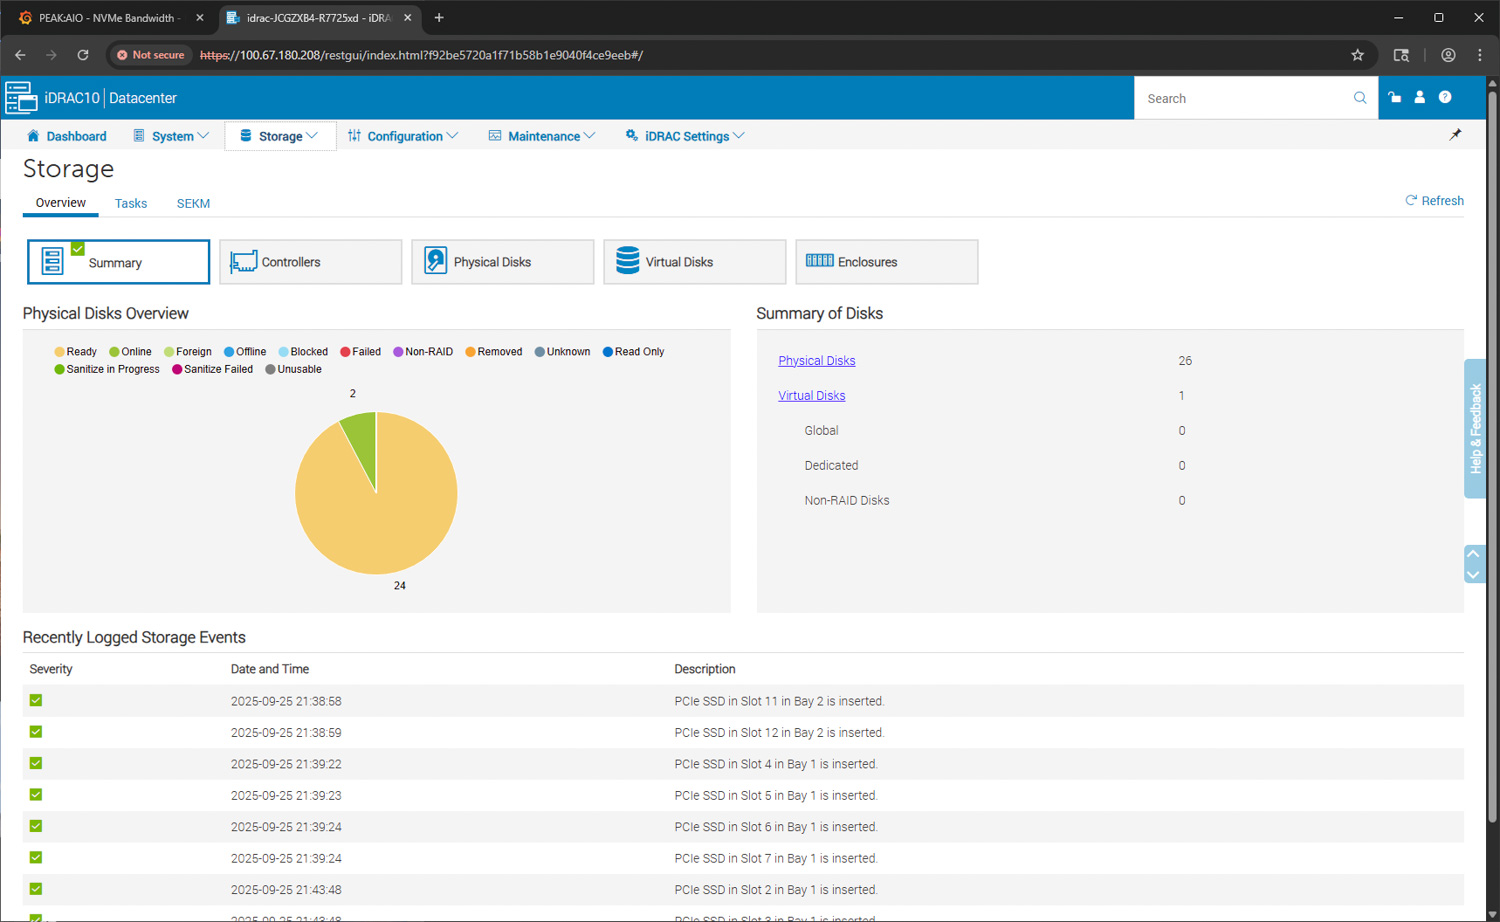
Sekcja pamięci masowej kontrolera iDRAC 10 przedstawia pełny przegląd wszystkich dysków fizycznych zainstalowanych w serwerze R7725xd. Panel podsumowania wyświetla ogólną liczbę wszystkich podłączonych dysków, wraz z wizualnym wykresem kołowym ilustrującym ich stany. W tej konfiguracji 24 dyski SSD NVMe są aktywne i zgłaszają gotowość, a w systemie znajdują się dwa dodatkowe urządzenia rozruchowe, niezależne od głównego banku dysków NVMe.
Po prawej stronie, panel Podsumowanie dysków dzieli je na dyski fizyczne i wszelkie powiązane dyski wirtualne. Ponieważ R7725xd korzysta z bezpośredniej architektury NVMe bez tradycyjnych kontrolerów RAID, wszystkie dyski są raportowane jako nie-RAID i indywidualnie adresowalne, co jest zgodne z projektem systemu dla dużych pul NVMe i platform SDS.
Poniżej podsumowania statusu, w obszarze „Ostatnio zarejestrowane zdarzenia pamięci masowej” znajduje się lista logów wkładania dla każdego dysku SSD PCIe, uporządkowanych według zatok i gniazd. Ten rekord potwierdza prawidłowe wykrywanie dysków we wszystkich zatokach i pomaga zidentyfikować wszelkie problemy z osadzeniem, okablowaniem lub działaniem funkcji hot-swap. W przypadku dużych wdrożeń, te logi są przydatne do śledzenia alokacji dysków lub weryfikacji, czy pojemność została zapełniona zgodnie z oczekiwaniami.
Ostatni zrzut ekranu przedstawia szczegółowy widok urządzeń NVMe w kontrolerze iDRAC10. Każdy dysk NVMe zainstalowany w systemie jest wymieniony wraz ze swoim statusem, pojemnością i lokalizacją wnęki. Wybranie pojedynczego dysku otwiera pełny opis jego cech.
W tym przykładzie panel informacji o dysku wyświetla pełny ciąg znaków modelu, protokół urządzenia, współczynnik kształtu oraz wynegocjowane ustawienia PCIe. Urządzenia NVMe działają z prędkością łącza 32 GT/s przy wynegocjowanym połączeniu x4, co potwierdza, że dyski działają z pełną przepustowością na płycie głównej PCIe Gen5 systemu. Sekcja informacji zawiera również procent wytrzymałości, stan dostępnego zapasu oraz typ protokołu, co pomaga administratorom monitorować stan dysków i przewidywany cykl ich eksploatacji.
Szczegółowe raportowanie stanu napędu jest cenne w konfiguracjach NVMe o dużej gęstości, w których szerokość łącza, wynegocjowana prędkość i stan nośnika mają bezpośredni wpływ na zachowanie obciążenia i wydajność pamięci masowej.
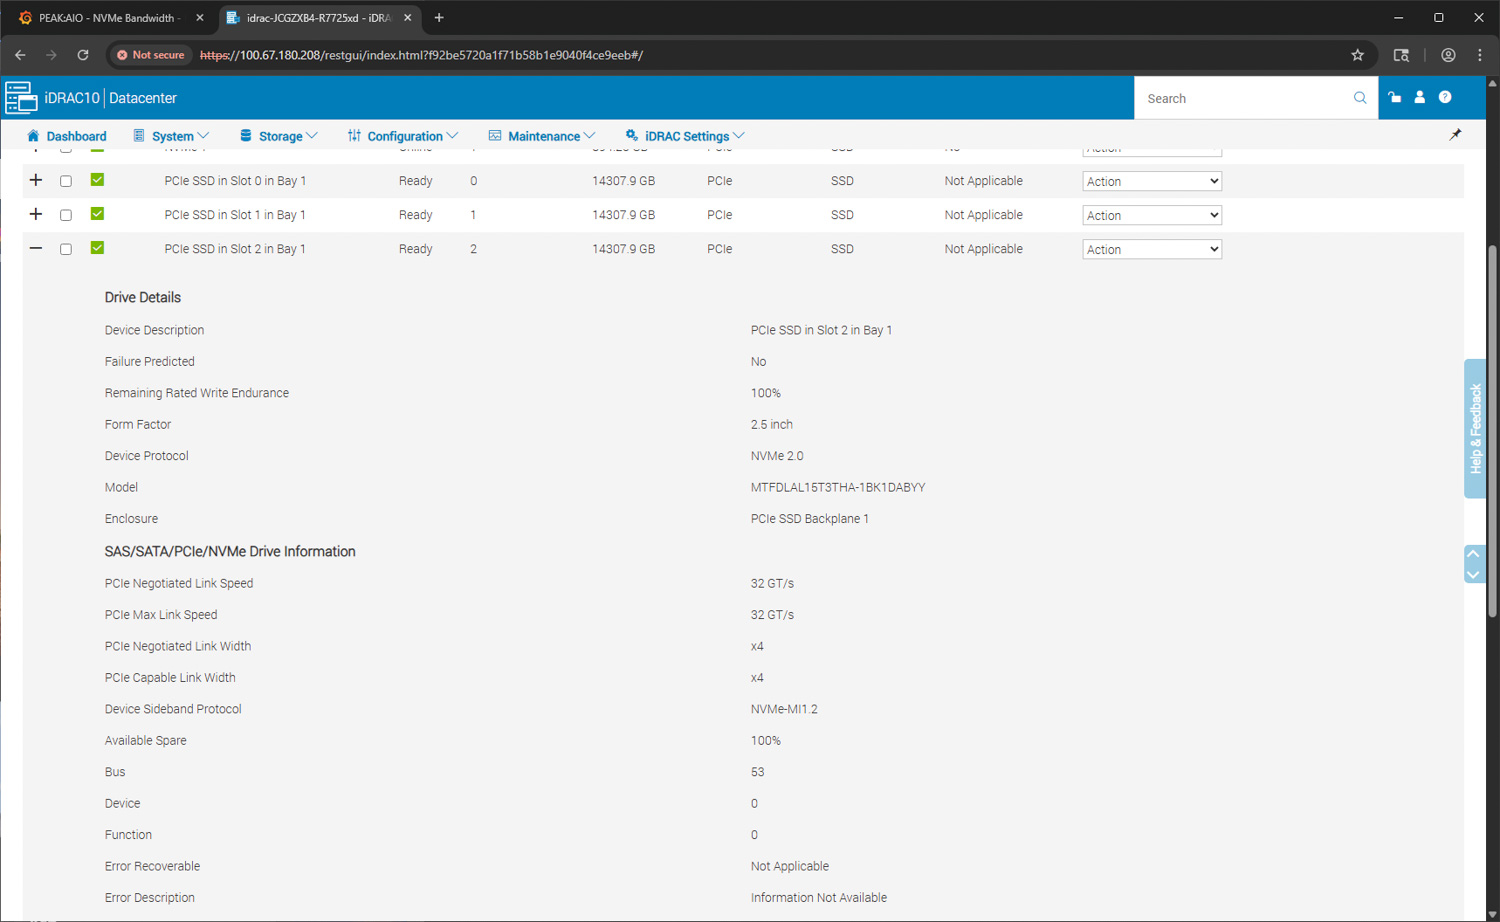
Ogólnie rzecz biorąc, interfejs iDRAC 10 zapewnia przejrzysty, zorientowany na sprzęt podgląd architektury pamięci masowej NVMe serwera R7725xd, umożliwiając łatwą i szybką weryfikację stanu łącza, statusu dysków i integralności systemu.
Wydajność Dell PowerEdge R7725xd
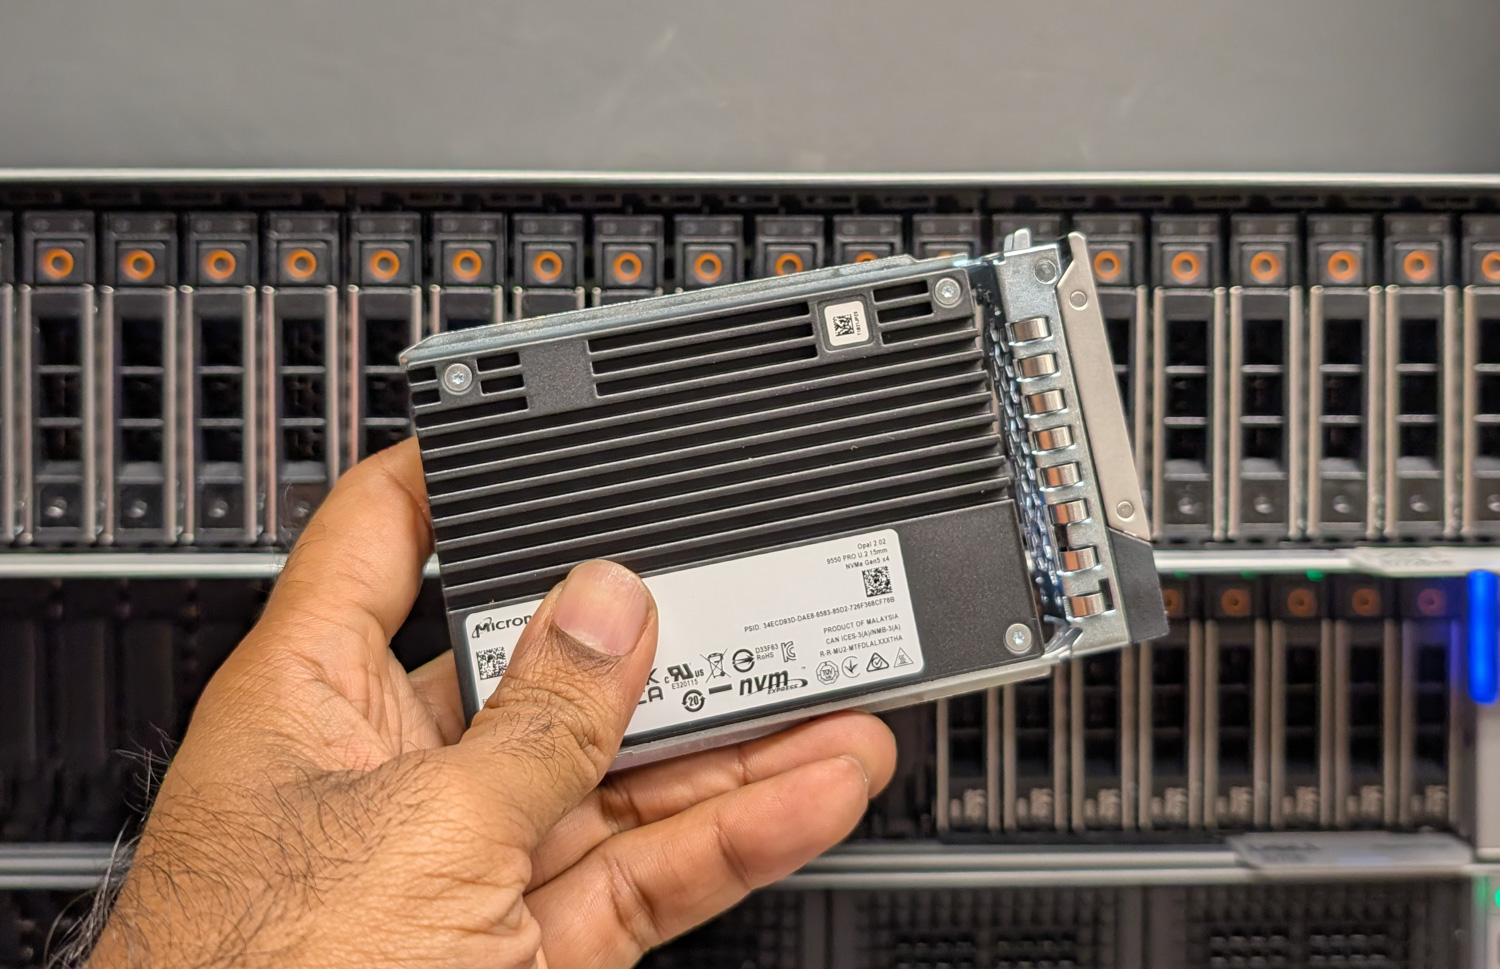
Przed testami nasz system został skonfigurowany ze zbalansowanym, a jednocześnie wysokowydajnym obciążeniem. System wyposażony jest w dwa procesory AMD EPYC 9575F, każdy z 64 rdzeniami o wysokiej częstotliwości, połączone z 24 modułami pamięci DDR5 DIMM o pojemności 32 GB, pracującymi z szybkością 6400 MT/s. Obudowa została w pełni wyposażona w 24 dyski SSD Micron 9550 PRO U.2 NVMe o pojemności 15.36 TB, każdy połączony dedykowanym łączem PCIe Gen5 x4. Zapewnia to łączną pojemność 368.64 TB, a dyski Micron 9550 PRO zapewniają sekwencyjną prędkość odczytu do 14 000 MB/s i sekwencyjną prędkość zapisu do 10 000 MB/s. Za sieć odpowiadają cztery karty sieciowe Broadcom BCM57608, które zapewniają łącznie osiem portów 200 Gb/s, a także karta sieciowa BCM57412 OCP oferująca dwa dodatkowe porty 10-gigabitowe.
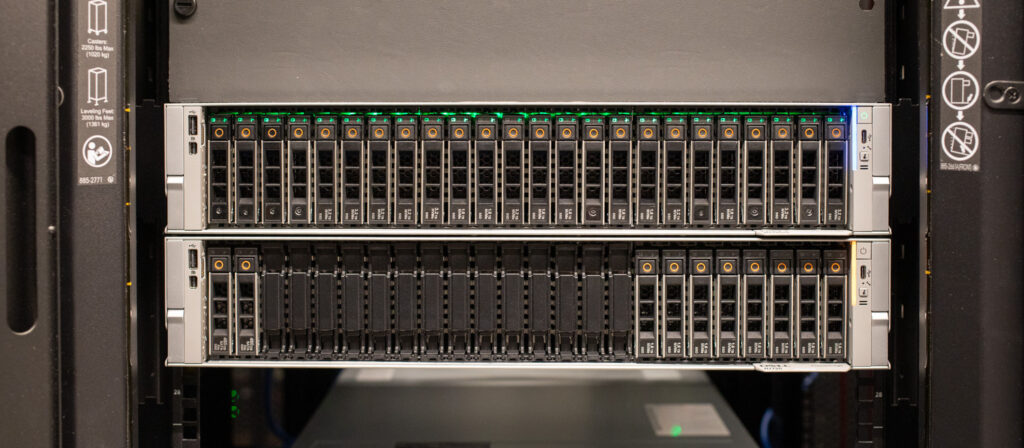
Specyfikacje systemu testowego
- PROCESOR: 2x 64-rdzeniowy procesor AMD EPYC 9575F o wysokiej częstotliwości
- Pamięć: 24x 32 GB DDR5 @ 6400 MT/s
- Przechowywanie: 24 dyski Micron 9550 PRO U.2 o pojemności 15.36 TB każdy (połączone po 4 linie PCIe Gen5 każdy); obsługuje obecnie dyski o pojemności do 128 TB, a na horyzoncie pojawią się jeszcze większe pojemności
- Networking: 4 karty sieciowe Broadcom BCM57608 2x200G, 1 karta sieciowa BCM57412 2x10Gb OCP
- Przełącznik: Przełącznik Dell PowerSwitch Z9664
Wskaźnik wydajności FIO
Aby zmierzyć wydajność pamięci masowej serwera PowerEdge R7725xd, wykorzystaliśmy standardowe w branży wskaźniki oraz narzędzie FIO. W tej sekcji skupiamy się na następujących testach porównawczych FIO:
- Losowe 4K – 1M
- Sekwencyjny 4K – 1M
FIO – Lokalny – Przepustowość
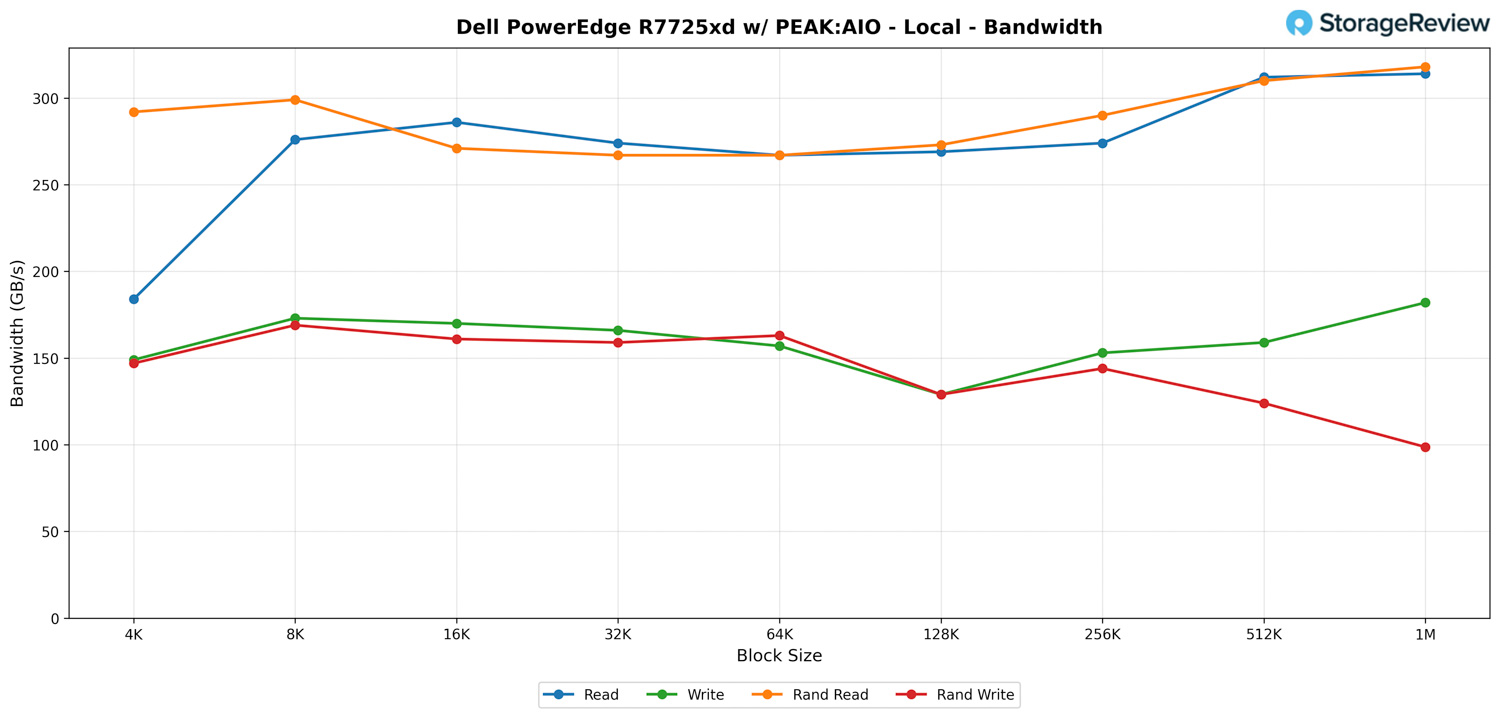
Podczas testów lokalnego dostępu do 24 dysków PCIe Gen5 NVMe w serwerze Dell PowerEdge R7725xd, system wykazuje dokładnie to, czego można oczekiwać od platformy, w której każdy dysk jest podłączony do procesora za pomocą pełnego łącza x4 PCIe Gen5. Bez udziału warstwy sieciowej, jest to czysta, wewnętrzna przepustowość układu pamięci masowej Dell Gen5 i przepustowość PCIe platformy AMD EPYC działająca bez ograniczeń.
Odczyty sekwencyjne rozpoczynają się od 184 GB/s dla bloków 4 KB i szybko skalują się wraz ze wzrostem rozmiaru bloku. Od 512 KB do 1 MB serwer utrzymuje stałą przepustowość na poziomie 312–314 GB/s, co wyraźnie wskazuje na to, jak dobrze system potrafi agregować wszystkie 24 × 4 linie Gen5 w celu uzyskania stałej przepustowości odczytu bez żadnych wąskich gardeł na poziomie kontrolera.
Zapis sekwencyjny przebiega według innej krzywej, ale utrzymuje się w oczekiwanym zakresie. Począwszy od 149 GB/s, wyniki rosną do połowy setek i osiągają 182 GB/s przy 1 milionie. Jest to zgodne z zachowaniem zapisu dysków SSD Micron 9550 PRO i narzutem właściwym dla zapisu równoległego NVMe na tak wielu niezależnych urządzeniach.
Kolejnym atutem jest wydajność odczytu losowego. System osiąga prędkości prawie 300 GB/s przy najmniejszych rozmiarach bloków, nieznacznie spadają w średnim zakresie, a następnie wracają do górnych 200 i dolnych 300 GB/s przy większych rozmiarach bloków. Przy 1M, odczyty losowe osiągają maksymalnie 318 GB/s, co dowodzi, że platforma jest w stanie równomiernie rozłożyć operacje mieszane na wszystkie 24 dyski.
Losowe zapisy występują z niższą szybkością, co jest typowe dla rozproszonych metadanych i zadań alokacji zapisu w szerokim zestawie NVMe. Wyniki utrzymują się w zakresie 140–160 GB/s przez większość testu i spadają do nieco poniżej 100 GB/s przy 1 M.
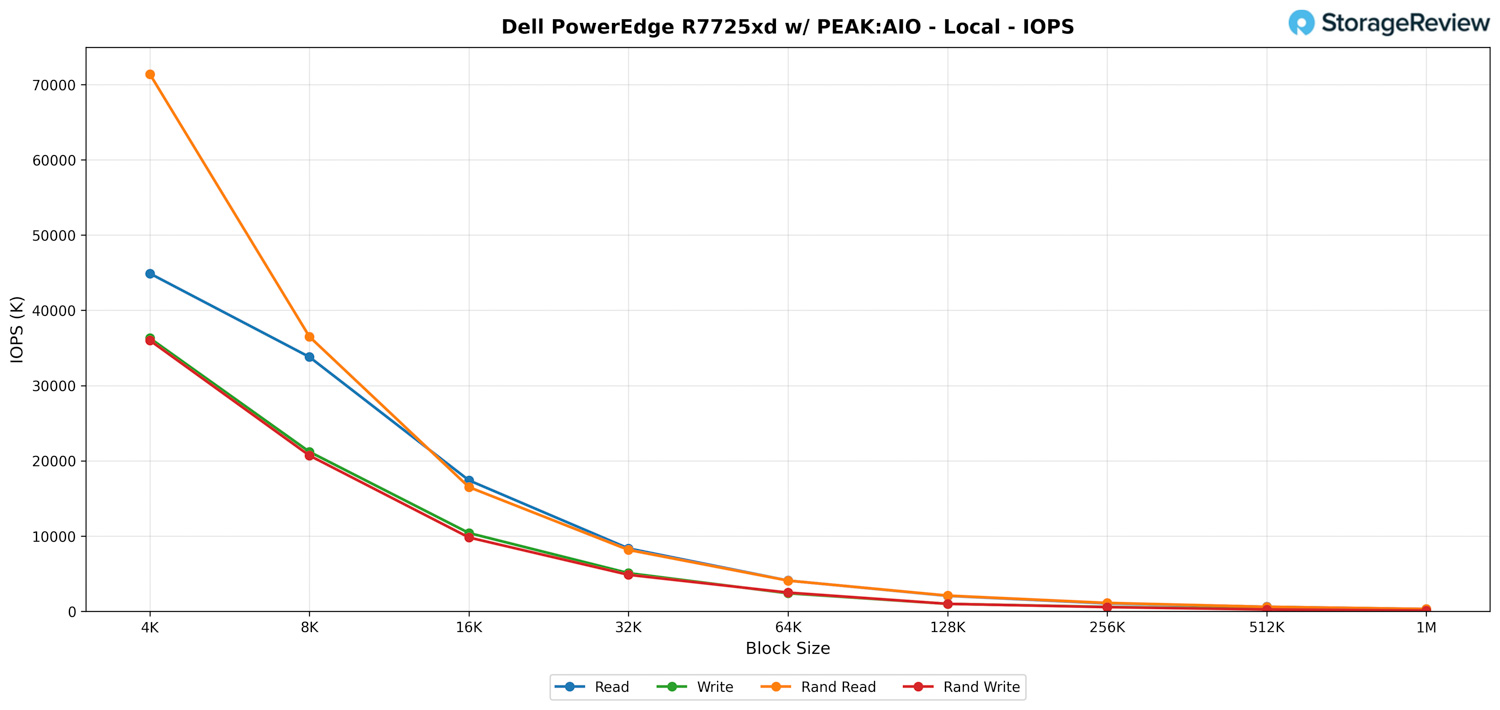
FIO – Lokalny – IOPS
Analizując IOPS, R7725xd wykazuje solidną wydajność małych bloków, przy czym liczba żądań sięga dziesiątek milionów, zanim większe rozmiary bloków nie przeniosą obciążenia w stronę profilu napędzanego przepustowością.
Przy 4K odczyty sięgają 44.9 mln IOPS, a zapisy 36.3 mln. Odczyty losowe osiągają jeszcze wyższe poziomy, 71.4 mln IOPS, co dowodzi zdolności systemu do efektywnego rozprowadzania obciążeń z dużą kolejką na wszystkie dyski. Wartości te naturalnie maleją wraz ze wzrostem rozmiarów bloków, ale progresja pozostaje spójna w zakresie 8K, 16K i 32K.
Dla bloków 16 tys. i 32 tys. odczyty stabilizują się na poziomie 17.4 mln i 8.35 mln IOPS, a odczyty losowe są zbliżone na poziomie 16.5 mln i 8.15 mln. Zapisy przebiegają zgodnie z oczekiwanym schematem, notując niższe wartości, ale pozostając stabilne zarówno w przypadku dostępu sekwencyjnego, jak i losowego.
W miarę jak przekraczamy 64 KB i więcej, test przechodzi od czystego IOPS do scenariusza bardziej ograniczonego przepustowością. IOPS spada do kilku milionów, a ostatecznie do setek tysięcy. Przy rozmiarze bloku 1 MB, odczyt IOPS zatrzymuje się na około 300 KB, zapis na około 174 KB, a losowe operacje kończą się w tym samym obszarze.
Ogólnie rzecz biorąc, wyniki lokalnych operacji wejścia/wyjścia na sekundę (IOPS) wyraźnie pokazują zdolność systemu do obsługi obciążeń o bardzo dużej głębokości kolejki w małych blokach, z przewidywalną skalowalnością w miarę wzrostu transferów i gdy przepustowość staje się dominującym czynnikiem.
PEAK:AIO: Dlaczego Dell PowerEdge R7725xd sprawdza się w tym obciążeniu
Platforma PEAK:AIO została zaprojektowana z myślą o środowiskach wymagających niezwykle szybkiego dostępu do dużych zbiorów danych z niskim opóźnieniem, zazwyczaj do szkolenia sztucznej inteligencji, wnioskowania, modelowania finansowego i analiz w czasie rzeczywistym. Platforma rozwija się dzięki gęstej pamięci masowej NVMe, zrównoważonej przepustowości PCIe i przewidywalnym opóźnieniom w dużej skali. Aby spełnić te wymagania, sprzęt musi zapewniać stałą przepustowość, zachowując jednocześnie spójną i powtarzalną wydajność przy jednoczesnym dużym obciążeniu.
W tym miejscu Dell PowerEdge R7725xd naturalnie wpisuje się w architekturę PEAK:AIO. Architektura systemu została zaprojektowana z myślą o maksymalizacji zasobów PCIe Gen5, udostępniając pełną przepustowość 24 przednich zatok U.2 NVMe bezpośrednio procesorom, bez konieczności korzystania z tradycyjnych kontrolerów RAID. Taki układ zapewnia PEAK:AIO parametry paralelizmu i opóźnień, jakich oczekuje się od nowoczesnych potoków danych opartych na technologii NVMe. Konfiguracja systemu podzieliła dyski SSD NVMe na dwie grupy RAID0.
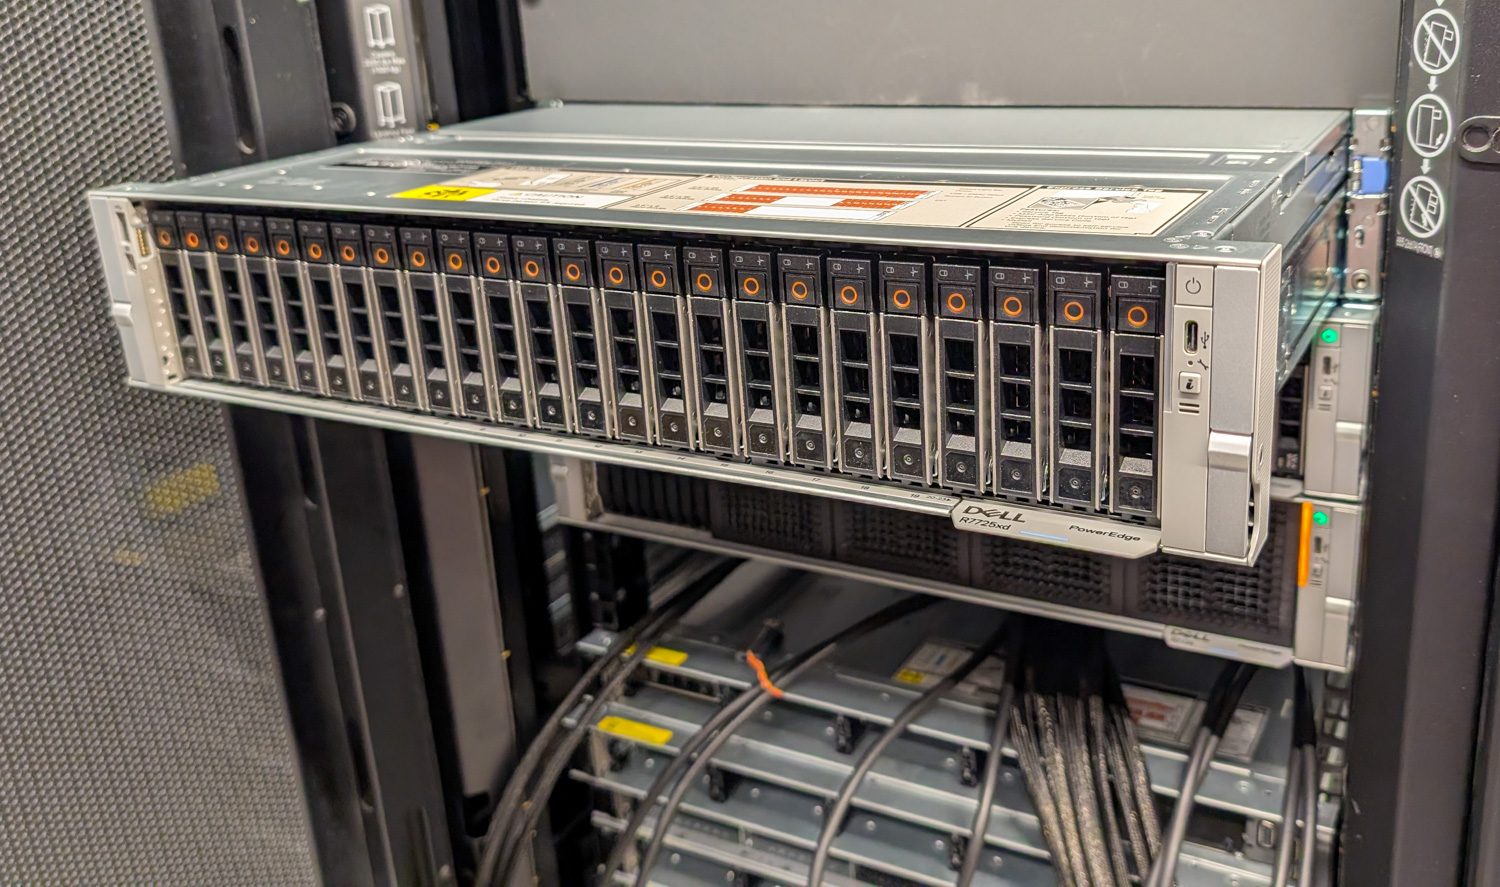
W testowanym scenariuszu użyliśmy dwóch systemów klienckich podłączonych do serwera R7725xd, z których każdy wyposażony był w karty sieciowe Broadcom BCM57608 2x 200G. Utworzyło to łącznie cztery łącza uplink 200G dla każdego klienta, co pozwoliło serwerowi R7725xd na stworzenie realistycznej konfiguracji o wysokiej wydajności, odzwierciedlającej rozwiązania stosowane w środowiskach produkcyjnych PEAK:AIO. Taka przepustowość sieci zapewniła nam margines bezpieczeństwa, pozwalający na pełne obciążenie podsystemu NVMe, topologii PCIe i połączeń między procesorami bez tworzenia wąskich gardeł na poziomie kart sieciowych.
Rezultatem jest platforma, która skutecznie współpracuje z obciążeniami PEAK:AIO. R7725xd oferuje dużą pojemność NVMe, przepustowość PCIe Gen5, dwa procesory AMD EPYC 9005 dla zapewnienia równoległości oraz funkcje sieciowe umożliwiające obsługę wielu klientów z prędkością setek gigabitów na klienta. Wszystkie te cechy są kluczowe dla osiągnięcia oczekiwań wydajnościowych PEAK:AIO.
PEAK:AIO – NVMe-oF RDMA – Przepustowość
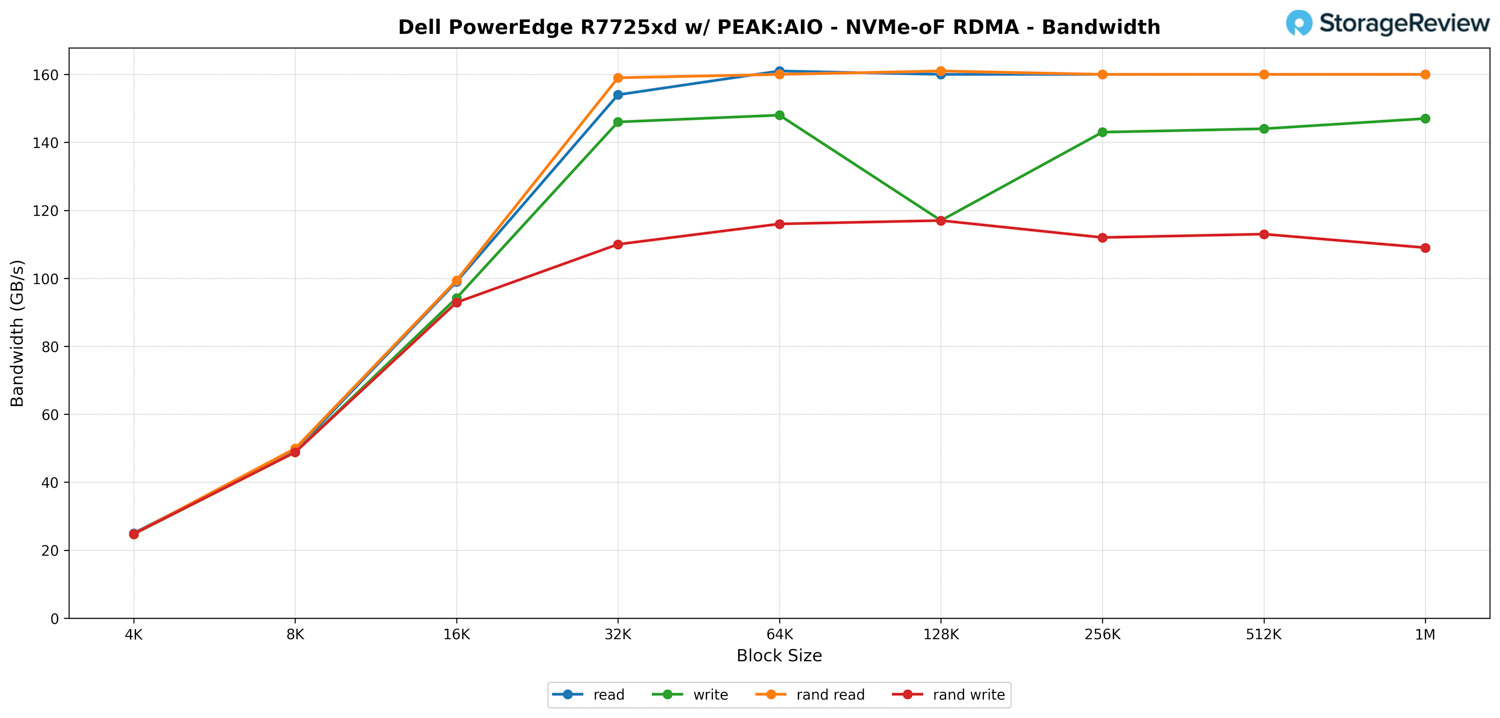
Analizując wyniki przepustowości NVMe-oF RDMA na serwerze PowerEdge R7725xd z PEAK:AIO, ogólny trend jest dokładnie taki, jakiego oczekujemy od systemu o tak dużej przepustowości PCIe i sieci. Wraz ze wzrostem rozmiaru bloku, przepustowość gwałtownie rośnie, aż do momentu, gdy ustabilizuje się w pobliżu praktycznego limitu platformy.
Przy małych rozmiarach bloków wydajność zaczyna się w okolicach 20 GB/s, zarówno dla odczytów, jak i zapisów, co jest normalne, ponieważ transfery 4K i 8K znacznie bardziej obciążają ścieżkę IOPS niż ścieżka przepustowości. Po przejściu do bloków 16K i 32K, potok się otwiera. Odczyty skaczą do około 154 GB/s przy 32K i kontynuują wzrost do 160 GB/s, czyli dokładnie tam, gdzie spodziewalibyśmy się osiągnąć w konfiguracji z dwoma klientami na czterech łączach 200 Gb/s.
Wydajność odczytu losowego niemal idealnie odzwierciedla wydajność sekwencyjną. PEAK:AIO doskonale radzi sobie z zapełnianiem kolejek poleceń, więc przepustowość odczytu losowego zasadniczo odpowiada przepustowości odczytu sekwencyjnego w całym zakresie, ustalając się na poziomie około 159–161 GB/s od 32 KB do 1 MB. Oznacza to, że stos pamięci masowej nie stanowi wąskiego gardła w przypadku mieszanych wzorców dostępu, a topologia PCIe serwera R7725xd równomiernie rozkłada obciążenie na 24 dyski NVMe Gen5.
Wydajność zapisu przebiega podobnie, choć jej szczyty są nieco niższe niż w przypadku odczytu. Zapis sekwencyjny utrzymuje się w zakresie 140–148 GB/s w blokach o średniej wielkości, spadając do około 117 GB/s przy 128 KB, ale odzyskując wartość wraz ze wzrostem rozmiaru bloku. Zapis losowy zachowuje się inaczej i osiąga poziom zbliżony do 110–117 GB/s, co jest normalne w przypadku obciążeń z kolejką mieszaną, które generują dodatkowy narzut.
Kluczowym wnioskiem z tej sekcji jest to, że R7725xd bez problemu utrzymuje ekstremalnie wysoką przepustowość w standardzie NVMe-oF, nawet przy wielu klientach, które wykorzystują system do granic możliwości. Gdy rozmiar bloków osiągnie 32 tys. lub więcej, serwer konsekwentnie wyczerpuje dostępną przepustowość sieci i pamięci masowej. Właśnie taki poziom wydajności został zaprojektowany, aby uzyskać PEAK:AIO, co sprawia, że te wyniki stanowią solidne potwierdzenie możliwości skalowania platformy w warunkach rzeczywistych.
PEAK AIO – NVMe-oF RDMA IOPS
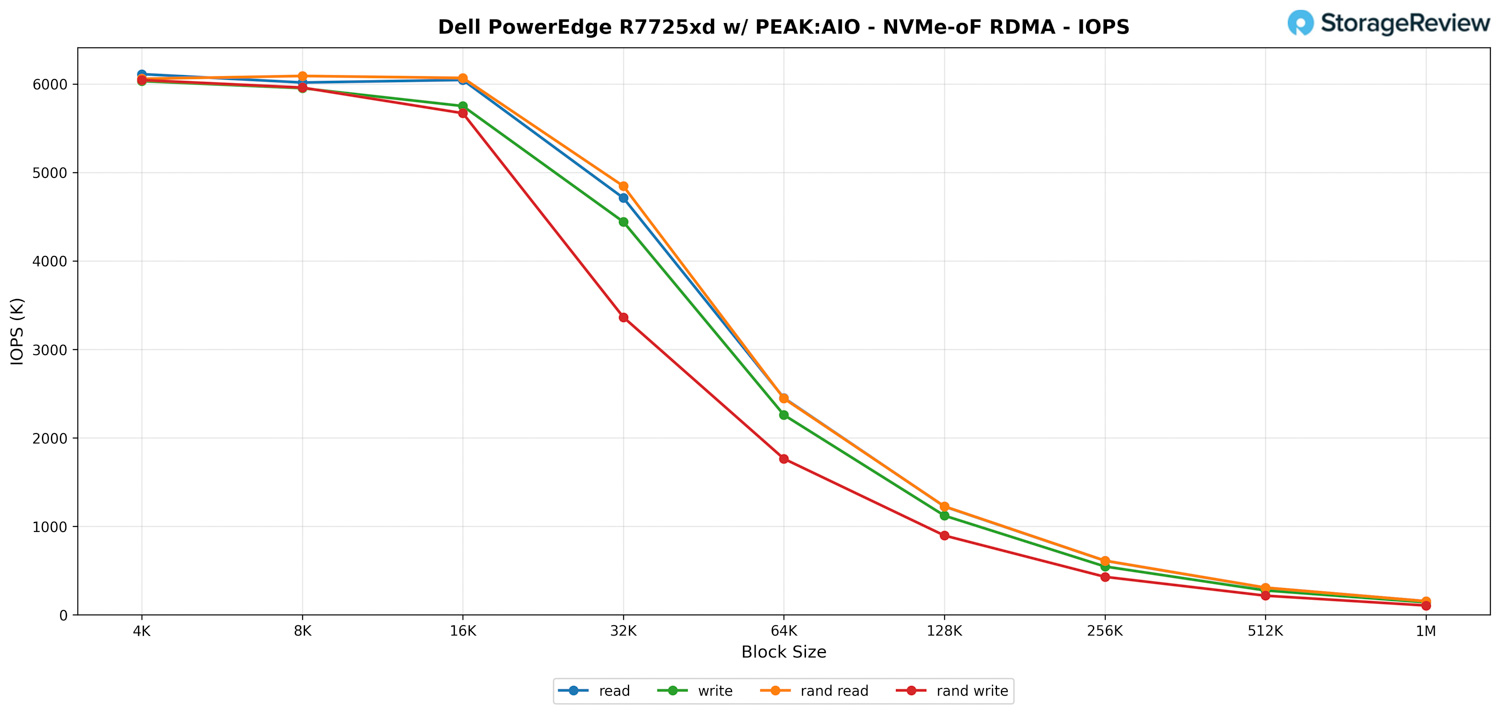
Pod względem IOPS, PowerEdge R7725xd wykazuje wysoką wydajność w małych blokach, chociaż początkowo obserwowaliśmy wyniki niższe od oczekiwanych; problem ten ma zostać rozwiązany dzięki ulepszonemu wsparciu sterowników sieciowych w przyszłości. Nawet przy takim podejściu, ogólny trend skalowania wygląda dokładnie tak, jak zwykle zachowuje się NVMe-oF RDMA przy wzroście rozmiaru bloku.
Przy najmniejszym rozmiarze bloku system może dostarczyć ponad 6 milionów operacji wejścia/wyjścia na sekundę (IOPS) zarówno w obciążeniach sekwencyjnych, jak i losowych. Odczyt, zapis, odczyt losowy i zapis losowy mieszczą się w mniej więcej tym samym zakresie przy 4K i 8K, co wskazuje, że klienci front-end, infrastruktura PCIe i same dyski NVMe bez problemu nadążają za tempem żądań.
Wraz ze wzrostem rozmiarów bloków, zaczyna się przewidywany spadek IOPS. Przy 32 000 odczyty osiągają około 4.7 miliona IOPS, podczas gdy zapisy pozostają nieznacznie w tyle, osiągając około 4.4 miliona. Największy spadek odnotowują tutaj zapisy losowe, spadając do około 3.3 miliona IOPS, co jest zgodne z dodatkowym obciążeniem kolejki i procesora wprowadzanym przez wzorce dostępu mieszanego.
Przechodząc do dużych bloków, IOPS nadal maleje w przewidywalny, liniowy sposób. Gdy osiągniemy transfery 256 000 i 512 000, przepustowość staje się dominującym wskaźnikiem, a IOPS naturalnie spada do kilkuset tysięcy. Przy rozmiarze bloku 1 MB wszystkie obciążenia zbiegają się do 140 000–153 000 IOPS, co jest zgodne z wartościami przepustowości, które przedstawiliśmy w poprzedniej sekcji.
Wydajność pamięci masowej GPUDirect
Jednym z testów, jakie przeprowadziliśmy na komputerze R7725xd, był test Magnum IO GPUDirect Storage (GDS). GDS to funkcja opracowana przez firmę NVIDIA, która pozwala procesorom graficznym ominąć procesor główny podczas uzyskiwania dostępu do danych przechowywanych na dyskach NVMe lub innych szybkich urządzeniach pamięci masowej. Zamiast kierować dane przez procesor i pamięć systemową, GDS umożliwia bezpośrednią komunikację między procesorem graficznym a urządzeniem pamięci masowej, znacznie redukując opóźnienia i poprawiając przepustowość danych.
Jak działa pamięć masowa GPUDirect
Tradycyjnie, gdy procesor graficzny (GPU) przetwarza dane przechowywane na dysku NVMe, dane muszą najpierw przejść przez procesor i pamięć systemową, zanim dotrą do procesora graficznego. Ten proces wprowadza wąskie gardła, ponieważ procesor staje się pośrednikiem, zwiększając opóźnienia i zużywając cenne zasoby systemowe. Technologia GPUDirect Storage eliminuje ten problem, umożliwiając procesorowi graficznemu bezpośredni dostęp do danych z urządzenia pamięci masowej za pośrednictwem magistrali PCIe. Ta bezpośrednia ścieżka zmniejsza obciążenie związane z przesyłaniem danych, umożliwiając szybsze i bardziej wydajne przesyłanie danych.
Obciążenia AI, zwłaszcza te wykorzystujące uczenie głębokie, charakteryzują się wysoką intensywnością przetwarzania danych. Trenowanie dużych sieci neuronowych wymaga przetwarzania terabajtów danych, a każde opóźnienie w transferze danych może prowadzić do niewykorzystania procesorów GPU i wydłużenia czasu trenowania. Rozwiązanie GPUDirect Storage rozwiązuje ten problem, zapewniając jak najszybsze dostarczanie danych do procesora GPU, minimalizując czas przestoju i maksymalizując wydajność obliczeniową.
Ponadto GDS jest szczególnie przydatny w przypadku obciążeń wymagających strumieniowego przesyłania dużych zbiorów danych, takich jak przetwarzanie wideo, przetwarzanie języka naturalnego czy wnioskowanie w czasie rzeczywistym. Zmniejszając zależność od procesora, GDS przyspiesza przesyłanie danych i uwalnia zasoby procesora do innych zadań, co dodatkowo zwiększa ogólną wydajność systemu.
Oprócz surowej przepustowości, GPUDirect z NVMe-oF (TCP/RDMA) zapewnia również ultraniskie opóźnienia wejścia/wyjścia. Dzięki temu GPU nigdy nie będą miały niedoboru danych, co czyni system idealnym do wnioskowania AI w czasie rzeczywistym, tworzenia potoków analitycznych i odtwarzania wideo.
Odczyt sekwencyjny GDSIO
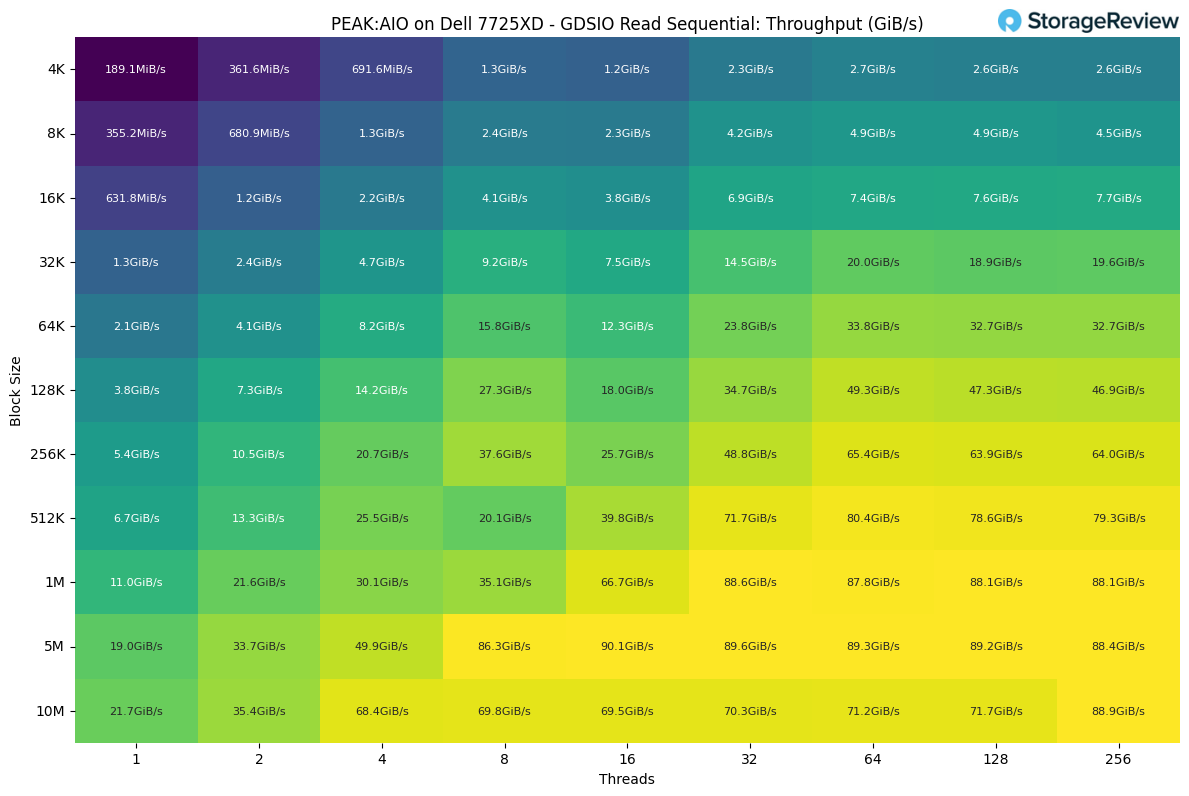
Podczas analizy PEAK:AIO z jednym klientem korzystającym z GDSIO, przepustowość odczytu wykazuje wyraźny wzorzec skalowania wraz ze wzrostem rozmiaru bloku i liczby wątków. Ten pojedynczy klient był połączony dwoma łączami 400G, co ograniczało jego całkowity potencjał do 90 GB/s.
Przy najmniejszych rozmiarach bloków i niskiej liczbie wątków wydajność jest skromna, a odczyty 4K zaczynają się od około 189 MiB/s w pojedynczym wątku. Gdy tylko zwiększymy paralelizm wątków, system reaguje natychmiast, osiągając 691 MiB/s w czterech wątkach i przekraczając zakres wielu GiB/s przy większych blokach.
Średnie rozmiary bloków wykazują największą wrażliwość na liczbę wątków. Przy 32 KB przepustowość rośnie z 1.3 GiB/s przy pojedynczym wątku do prawie 20 GiB/s przy 64 wątkach, z niewielkim spadkiem powyżej tej wartości. Podobny schemat pojawia się przy 64 KB i 128 KB, gdzie system przechodzi od niskich, jednocyfrowych GiB/s przy niskim paralelizmie do ponad 30 GiB/s wraz ze skalowaniem obciążenia.
Po osiągnięciu większych rozmiarów bloków, przepustowość zaczyna się stabilizować, ponieważ system zbliża się do maksymalnego poziomu wydajności dla pojedynczego klienta. Przy 1 MiB wydajność wzrasta z 11 GiB/s w jednym wątku do około 88 GiB/s przy dużej liczbie wątków. Transfery 5 MiB i 10 MiB wykazują ten sam poziom, osiągając maksymalnie około 89–90 GiB/s, niezależnie od tego, czy test jest wykonywany z 64, 128 czy 256 wątkami.
Zapis sekwencyjny GDSIO
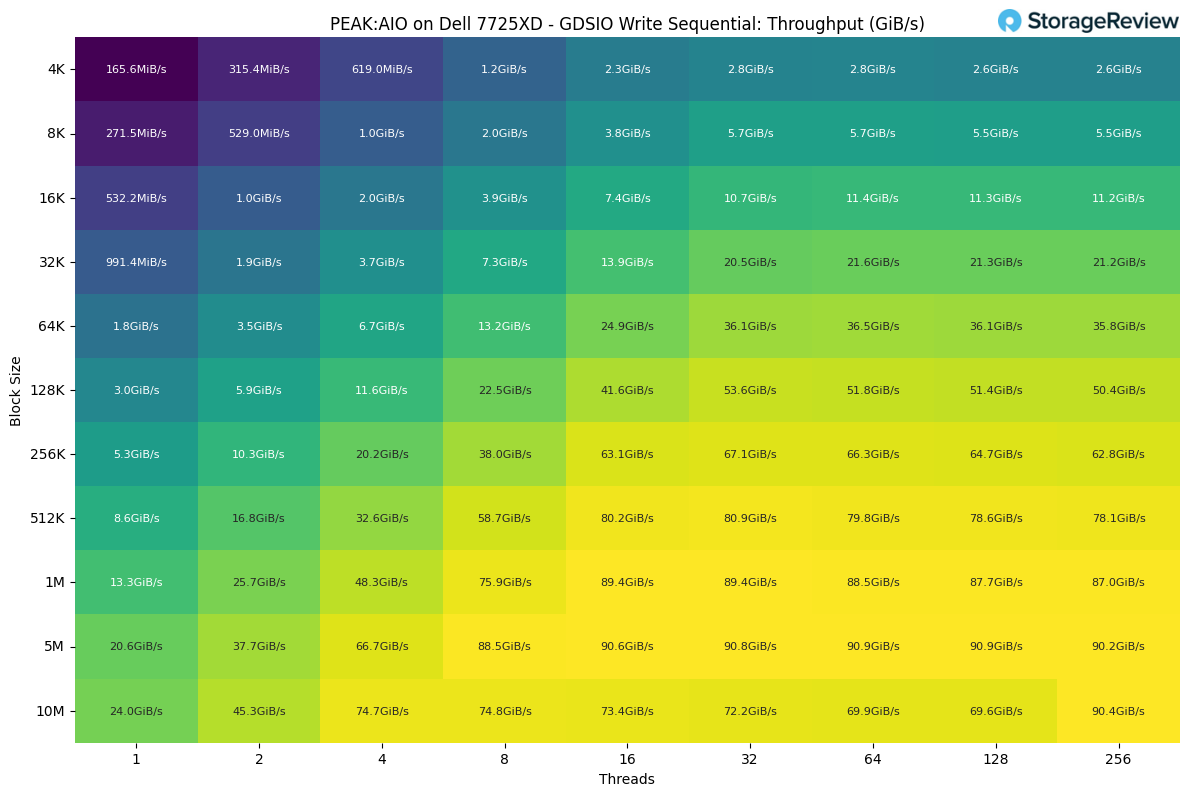
Po stronie zapisu, skalowanie przebiega podobnie jak w przypadku odczytu, ale z nieco niższą wydajnością dla większości rozmiarów bloków, co jest oczekiwane w przypadku obciążeń zapisu sekwencyjnego. Przy najmniejszych rozmiarach bloków przepustowość zaczyna się od 165 MiB/s dla pojedynczego wątku przy 4K i stale rośnie wraz ze wzrostem paralelizmu. Przy czterech wątkach wzrasta do nieco ponad 619 MiB/s, a następnie przekracza 1 GiB/s przy ośmiu wątkach.
Średnie rozmiary bloków wykazują większe zyski wraz ze wzrostem liczby wątków. Przy 32 000 przepustowość zaczyna się od nieco poniżej 1 GiB/s i skaluje się do ponad 21 GiB/s przy wyższych poziomach wątków. Zakresy 64 000 i 128 000 kontynuują ten trend, przechodząc od niskich jednocyfrowych wartości GiB/s do średnich 30 GiB/s i 50 GiB/s, w miarę jak obciążenie staje się bardziej równoległe.
Większe transfery występują, gdy system osiąga swój naturalny limit przepustowości zapisu. Przy 1 MiB wydajność wzrasta z 13.3 GiB/s przy pojedynczym wątku do nieco poniżej 90 GiB/s przy dużej liczbie wątków. Testy 5 MiB i 10 MiB przebiegają podobnie, z wynikami sięgającymi około 90 GiB/s, niezależnie od tego, czy system działa z 64, 128 czy 256 wątkami.
Nowa definicja wydajności w erze Gen5
Dell PowerEdge R7725xd to coś więcej niż serwer pamięci masowej; to przełom w sposobie dostarczania przepustowości w szafie rack. Eliminując przełączniki PCIe i zapewniając każdemu dyskowi NVMe bezpośrednią ścieżkę do procesora, Dell stworzył system, w którym przepustowość skaluje się płynnie, parametry termiczne pozostają przewidywalne, a współbieżność staje się atutem, a nie wyzwaniem.
W połączeniu z dyskami SSD Micron 9550 PRO i oprogramowaniem równoległego wejścia/wyjścia PEAK:AIO, R7725xd przekształca się z gęstej obudowy NVMe w prawdziwy silnik danych. Może on nasycić lokalną infrastrukturę PCIe, przesyłać dane do procesorów graficznych przez RDMA z prędkością liniową lub jednocześnie pełnić funkcję obliczeniową i pamięci masowej – wszystko w obudowie 2U.
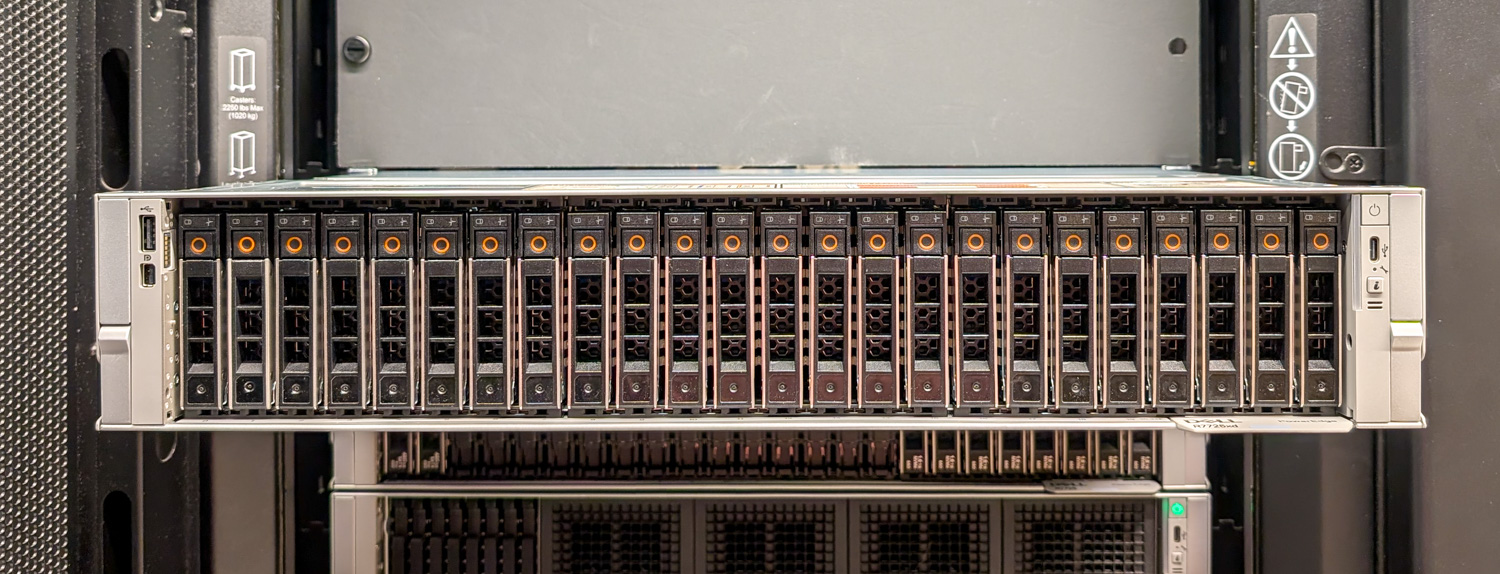
Dell PowerEdge R7225xd
W praktyce ta konfiguracja zapewnia ponad 300 GB/s przepustowości lokalnej i 160 GB/s w sieci, dorównując wydajnością wielowęzłowym klastrom pamięci masowej, przy ułamku złożoności i kosztów. To demonstracja tego, co się dzieje, gdy każda warstwa stosu, od krzemu po oprogramowanie, jest zorientowana na wydajność i stałą przepustowość.
R7725xd wyznacza nowy standard wydajności pamięci masowej jednowęzłowej w erze Gen5. Dla organizacji budujących potoki AI nowej generacji, szybkie analizy lub środowiska szkoleniowe z dużą liczbą punktów kontrolnych, jest to przedsmak możliwości, jakie daje całkowite wyeliminowanie wąskich gardeł z systemu.
Niniejszy raport jest sponsorowany przez firmę Dell Technologies. Wszystkie poglądy i opinie wyrażone w niniejszym raporcie opierają się na naszej obiektywnej ocenie omawianego produktu/produktów.


 Amazon