

Dell Pro Max 16 Plus ma dwie historie, które idą w przeciwnych kierunkach. Pierwsza to mobilna stacja robocza najwyższej klasy: 24-rdzeniowy procesor Intel Core Ultra 9 285HX, do 256 GB pamięci CAMM2, trzy gniazda M.2, karta graficzna NVIDIA RTX PRO Blackwell do serii 5000 z 24 GB pamięci GDDR7, konstrukcja zgodna z normą MIL-STD-810H oraz obudowa, w którą Dell ewidentnie włożył mnóstwo pracy inżynieryjnej.
Drugim z omawianych modeli jest omawiany SKU, w którym zamiast karty graficznej zastosowano kartę Qualcomm AIC100 PC Inference Card, czyli dwusystemowy moduł SoC zbudowany na bazie układu Cloud AI 100 z 2019 roku, oraz stos oprogramowania, który sprawia, że większość współczesnych zadań wnioskowania staje się bolesną eksploracją. To przestroga przed tym, co się dzieje, gdy flagowa obudowa zostanie sparowana z niewłaściwym akceleratorem, i dlaczego klienci muszą zrozumieć stos oprogramowania, na którym opiera się rozwiązanie AI, zanim podpiszą zamówienie. Zanim przejdziemy do wyjaśnienia, spójrzmy na laptopa jako całość.
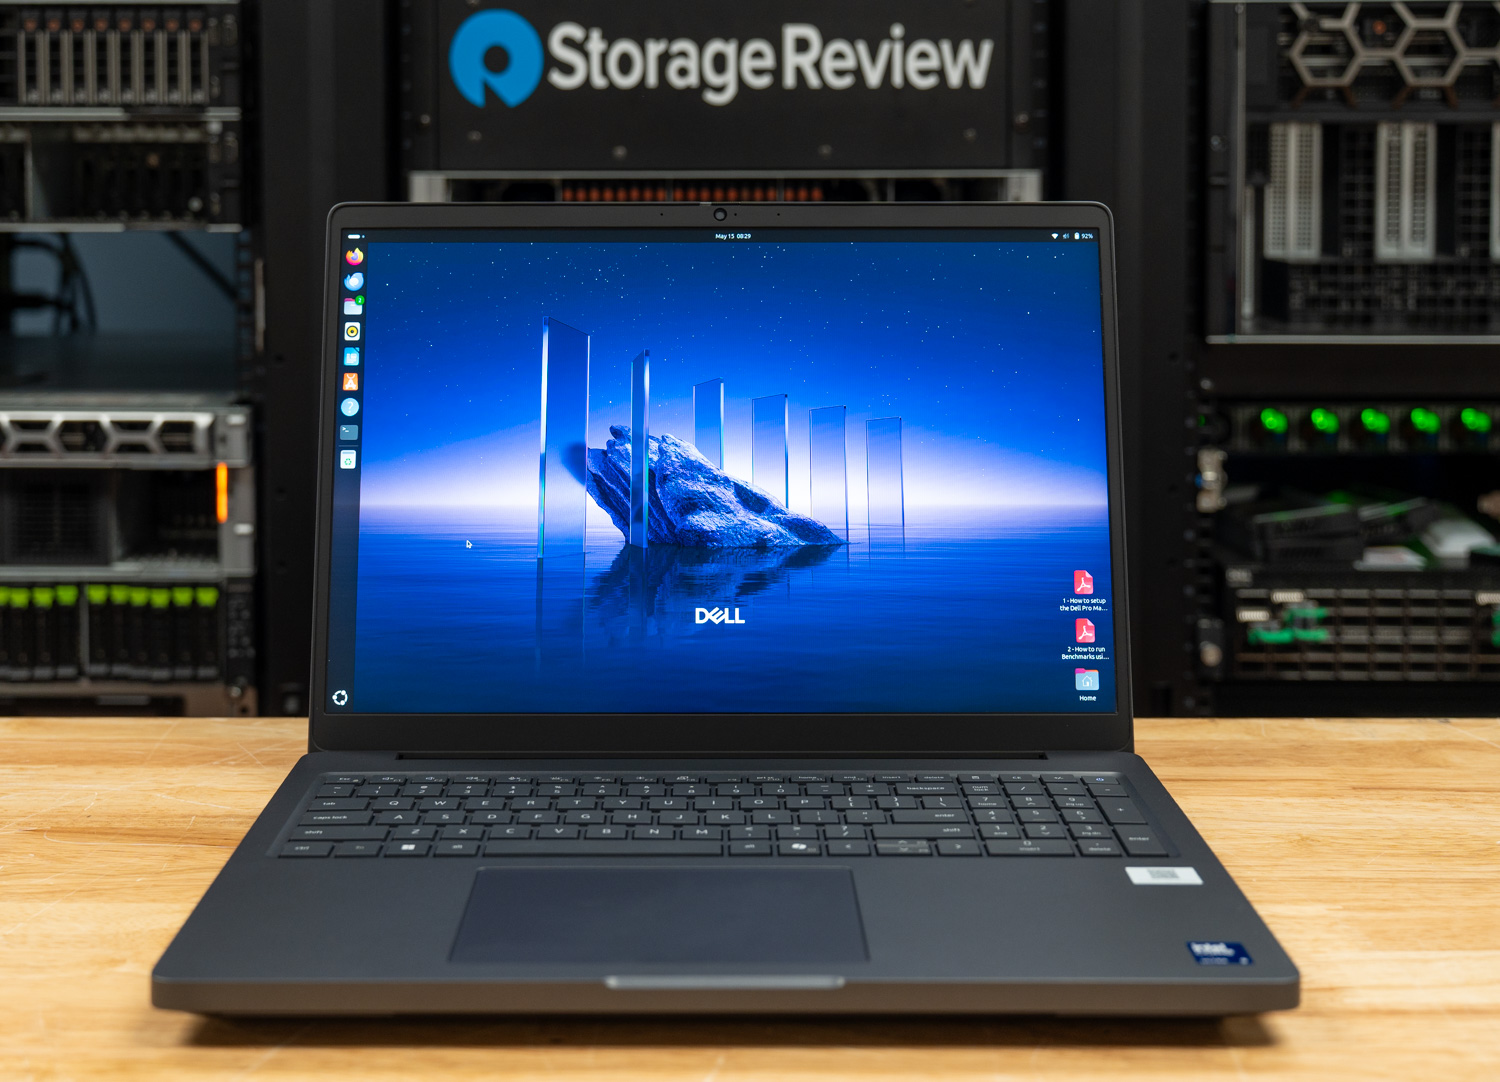
Pro Max 16 Plus plasuje się na szczycie oferty stacji roboczych Dell Pro Max, oferując większą moc obliczeniową niż podstawowy model Pro Max 16 i smuklejszy Pro Max 16 Premium. Jego sercem jest skalowalny procesor Intel Core Ultra 9 285HX – 55-watowy, 24-rdzeniowy procesor z taktowaniem Turbo Boost 5.5 GHz. Wszystkie konfiguracje procesora obsługują technologię Intel vPro Enterprise, co wzmacnia pozycję laptopa na rynku. Ceny zaczynają się od 2,779 dolarów.
Opcje graficzne obejmują zintegrowaną kartę graficzną Intel, układ NVIDIA RTX PRO 1000 oparty na architekturze Blackwell, aż do testowanego wcześniej modelu RTX PRO 5000 , który oferuje imponujące 24 GB pamięci GDDR7. Konfiguracje pamięci masowej i operacyjnej są równie imponujące: do 12 TB w trzech gniazdach M.2 Gen5 oraz do 128 GB pamięci DDR5-6400 obsługiwanej przez moduł CAMM2 firmy Dell.
Wybór wyświetlaczy obejmuje podstawowy panel IPS o rozdzielczości 1920 x 1200 pikseli oraz wyrazisty, dotykowy ekran OLED o rozdzielczości 3840 x 2400 pikseli. Pomiędzy nimi znajduje się opcja ze średniej półki o rozdzielczości 1920 x 1200 pikseli, oferująca jasność 500 nitów, zmienną częstotliwość odświeżania 120 Hz i pełne pokrycie przestrzeni barw DCI-P3. Dzięki ponad 100 certyfikatom niezależnych dostawców oprogramowania (ISV), profesjonaliści kreatywni mogą oczekiwać płynnego działania swoich aplikacji.
Funkcje bezpieczeństwa są gotowe do użycia w przedsiębiorstwach, w tym czytnik linii papilarnych, obsługa kart inteligentnych, NFC, kamera na podczerwień 8 MP do rozpoznawania twarzy oraz oprogramowanie Dell Control Vault 3. Standardowa trzyletnia gwarancja dopełnia pakiet, podkreślając rolę laptopa jako poważnego narzędzia do poważnej pracy.
Specyfikacja Dell Pro Max 16 Plus
| Specyfikacja | Dell Pro Max 16 Plus |
|---|---|
| Platforma | |
| Procesor | Intel Core Ultra 5 245HX Intel Core Ultra 7 265HX Intel Core Ultra 9 285HX |
| System operacyjny | Windows 11 Pro Ubuntu Linux 24.04 LTS |
| Pamięć | 16 GB–128 GB CSoDIMM lub CAMM2, 1 gniazdo |
| Przyspieszenie grafiki i sztucznej inteligencji | |
| Karta graficzna | Zintegrowana grafika Intel NVIDIA RTX PRO 1000 8 GB NVIDIA RTX PRO 2000 8 GB NVIDIA RTX PRO 3000 12 GB NVIDIA RTX PRO 4000 16 GB NVIDIA RTX PRO 5000 24 GB Qualcomm AI Cloud 100 64 GB (2 x 32 GB) |
| Przechowywanie i wyświetlanie | |
| Dyski | Do 3 dysków SSD M.2, każdy o pojemności 4 TB Dostępne RAID 0/1/5 |
| Wyświetlacz | 16-calowy 16:10 1920×1200, 300 nitów, 45% NTSC, 60 Hz, bezdotykowy 1920×1200, 500 nitów, 100% DCI-P3, 120 Hz VRR, bezdotykowy 3840×2400, 500 nitów, OLED, dotykowy |
| Łączność i moc | |
| Aparat fotograficzny | 8MP w podczerwieni |
| Sieć bezprzewodowa | Intel Wi-Fi 7 BE200 z Bluetooth 5.4 lub bez Dostępny mobilny szerokopasmowy |
| bateria | 6-ogniwowy 96 Wh |
| Zasilacz | 165W lub 280W |
| Bezpieczeństwo i bezpieczeństwo fizyczne | |
| Funkcje zabezpieczeń | Kamera internetowa IR czytnik linii papilarnych Czytnik kart inteligentnych NFC Skarbiec kontrolny 3 |
| Wymiary i waga | 1.22 na 10.18 na 14.17 cala Waga początkowa: 5.63 funta |
| Gwarancja | Standardowa naprawa na miejscu w ciągu trzech lat w następnym dniu roboczym |
Budowa i projektowanie
Podobnie jak poprzedni testowany model, Pro Max 16 Plus jest niezwykle wytrzymały i posiada certyfikat MIL-STD-810H potwierdzający wytrzymałość w wymagających warunkach. Dell w swojej ofercie materiałów kładzie duży nacisk na zrównoważony rozwój, wykorzystując plastik pochodzący z recyklingu, magnez i kobalt z recyklingu oraz tworzywa sztuczne pochodzenia biologicznego. W dłoni obudowa wydaje się wyjątkowo sztywna, bez wyczuwalnych odkształceń. Krótko mówiąc, jest zbudowana jak czołg.
To solidne urządzenie. Mając zaledwie 3,8 cm grubości (wliczając nóżki) i ważąc od 2,5 kg (5.63 funta), nie nadaje się do częstego podróżowania, choć jego wymiary 26,4 x 36,7 cm (10.18 x 14.17 cala) są dość kompaktowe jak na 16-calowy ekran o proporcjach 16:10. Kamera internetowa znajduje się na górze pokrywy, wraz z przesuwaną osłoną prywatności; nasz egzemplarz testowy jest dostarczany z wersją IR do rozpoznawania twarzy.
Pod względem estetycznym, język wzornictwa Dell jest wręcz niedoceniany. Szaro-czarna obudowa i subtelne logo podkreślają, że produkt ten stawia funkcjonalność ponad formę. Linia Pro Max Premium oferuje więcej wizualnego blasku kosztem wydajności i możliwości rozbudowy.
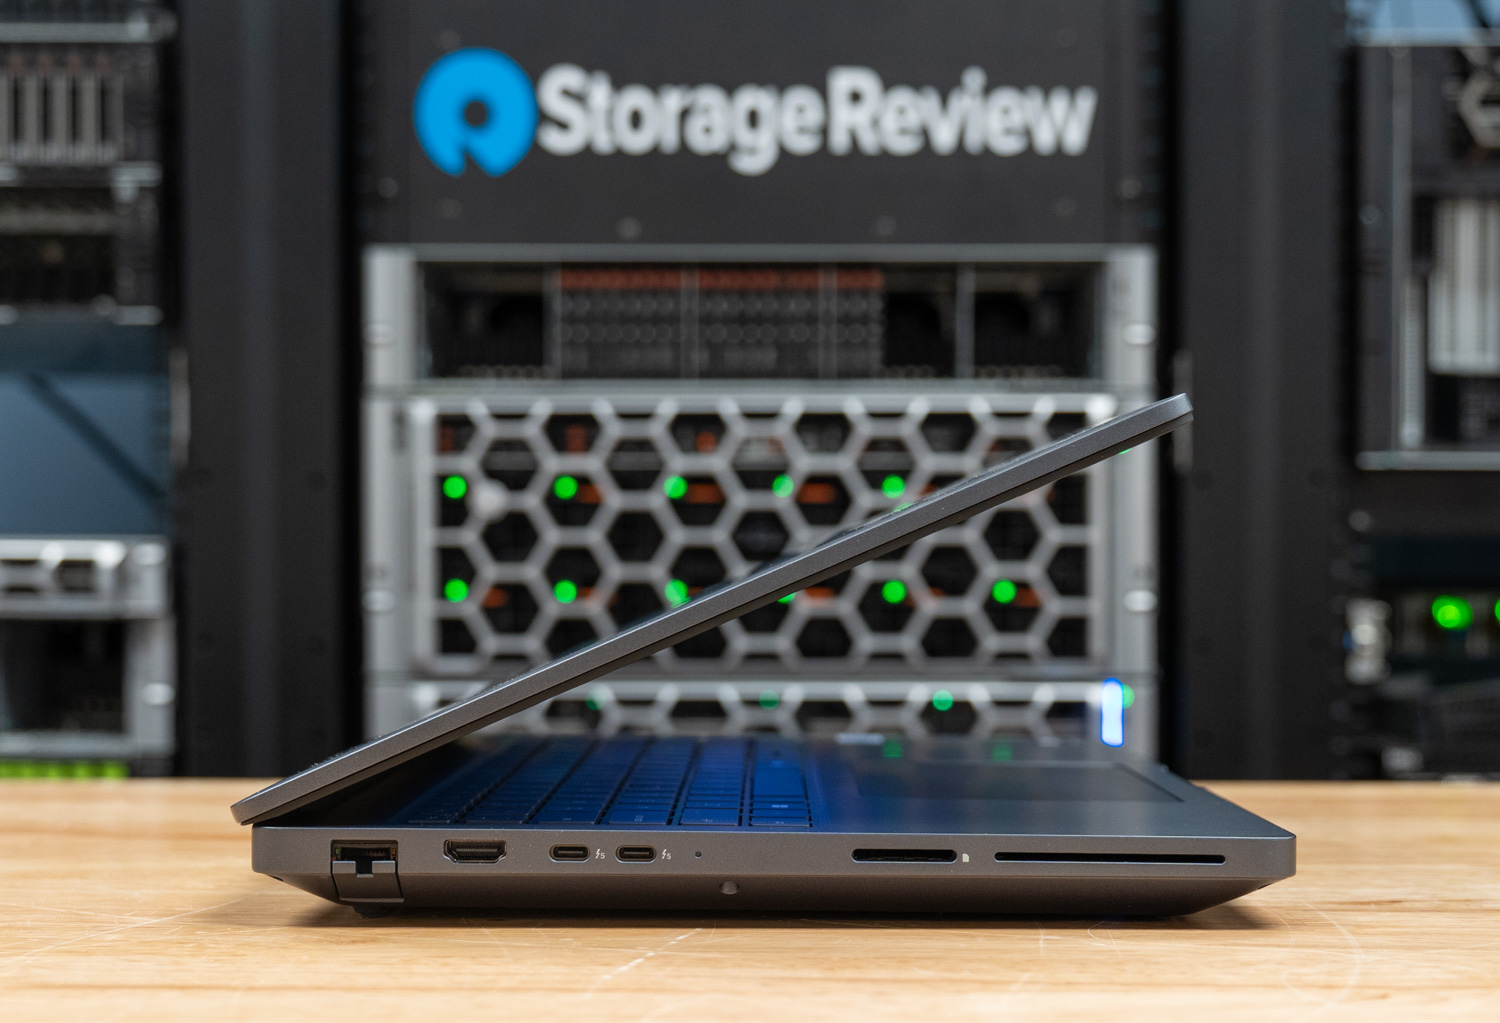
Kompleksowy wybór portów zaczyna się na lewej krawędzi:
- 2.5 Gb/s RJ45 Ethernet
- Wyjście HDMI 2.1
- Dwa porty Thunderbolt 5 (USB-C)
- Czytnik kart SD
- Opcjonalny slot na kartę SmartCard
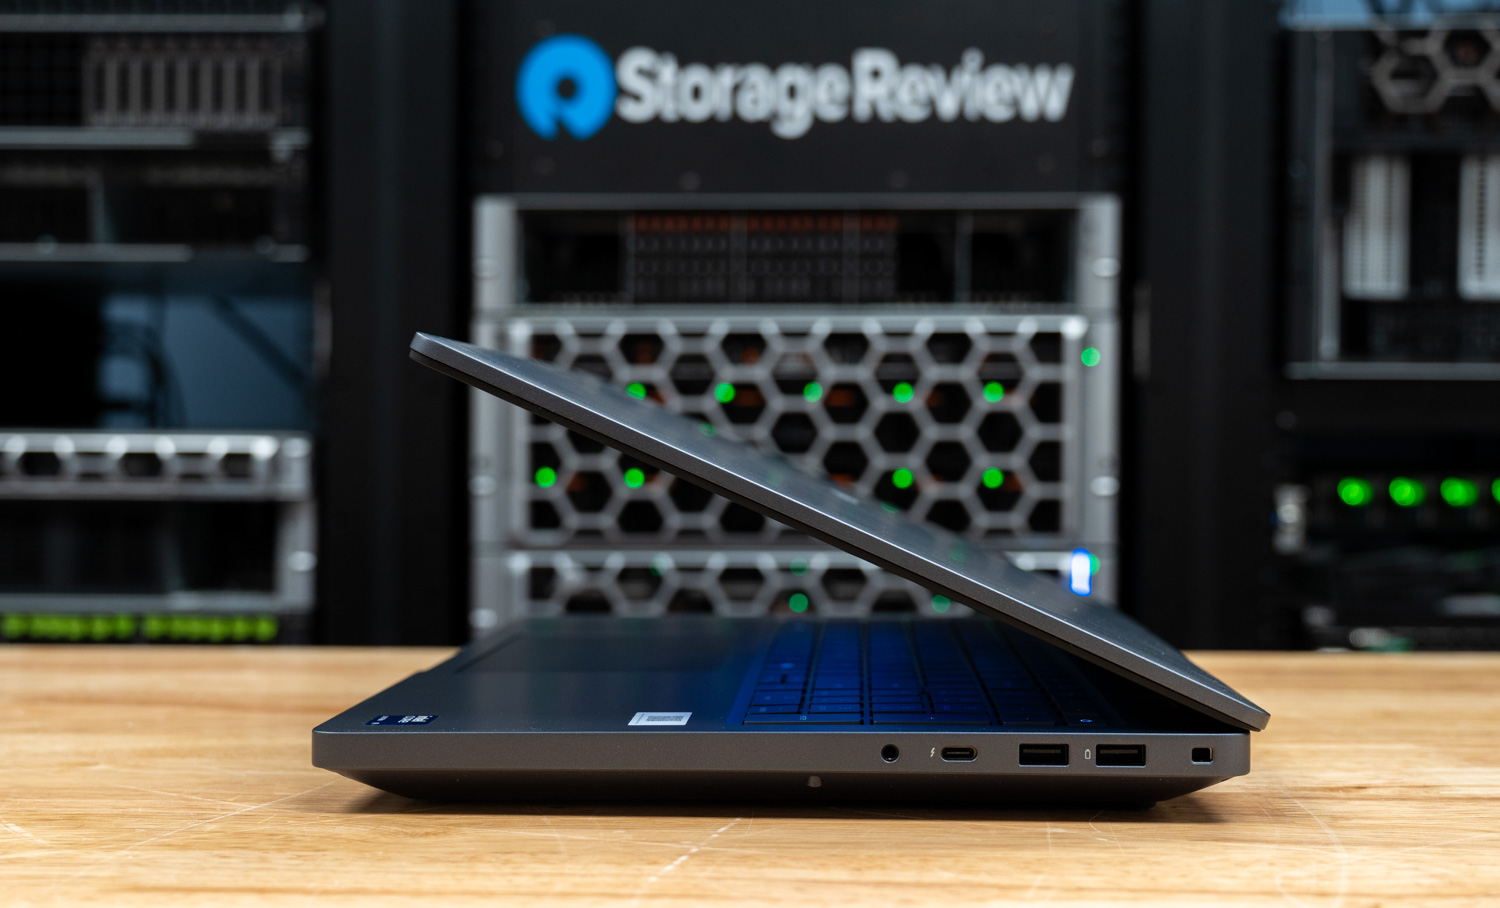
Po prawej:
- audio jack 3.5mm
- Thunderbolt 4 (USB-C)
- Dwa porty USB 3.2 Gen1 typu A
- Gniazdo blokady
Na tylnej krawędzi nie ma żadnych portów. Łączność bezprzewodową obsługuje moduł Intel BE200, obsługujący Wi-Fi 7 i Bluetooth 5.4. W niestandardowych konfiguracjach można pominąć Bluetooth, a mobilny internet szerokopasmowy 5G jest również dostępny.
Ekran i urządzenia wejściowe
Nasz egzemplarz testowy wyposażony jest w 16-calowy wyświetlacz Dell o rozdzielczości 1920×1200 z panelem VRR 120 Hz, który doskonale prezentuje się w codziennym użytkowaniu. Kolory są żywe, a dzięki 100% pokryciu DCI-P3, po kalibracji monitor doskonale nadaje się do zadań wymagających dużej czułości na kolor. Jasność 500 nitów sprawia, że wyświetlacz pozostaje komfortowy w jaśniejszych biurach i pracowniach.
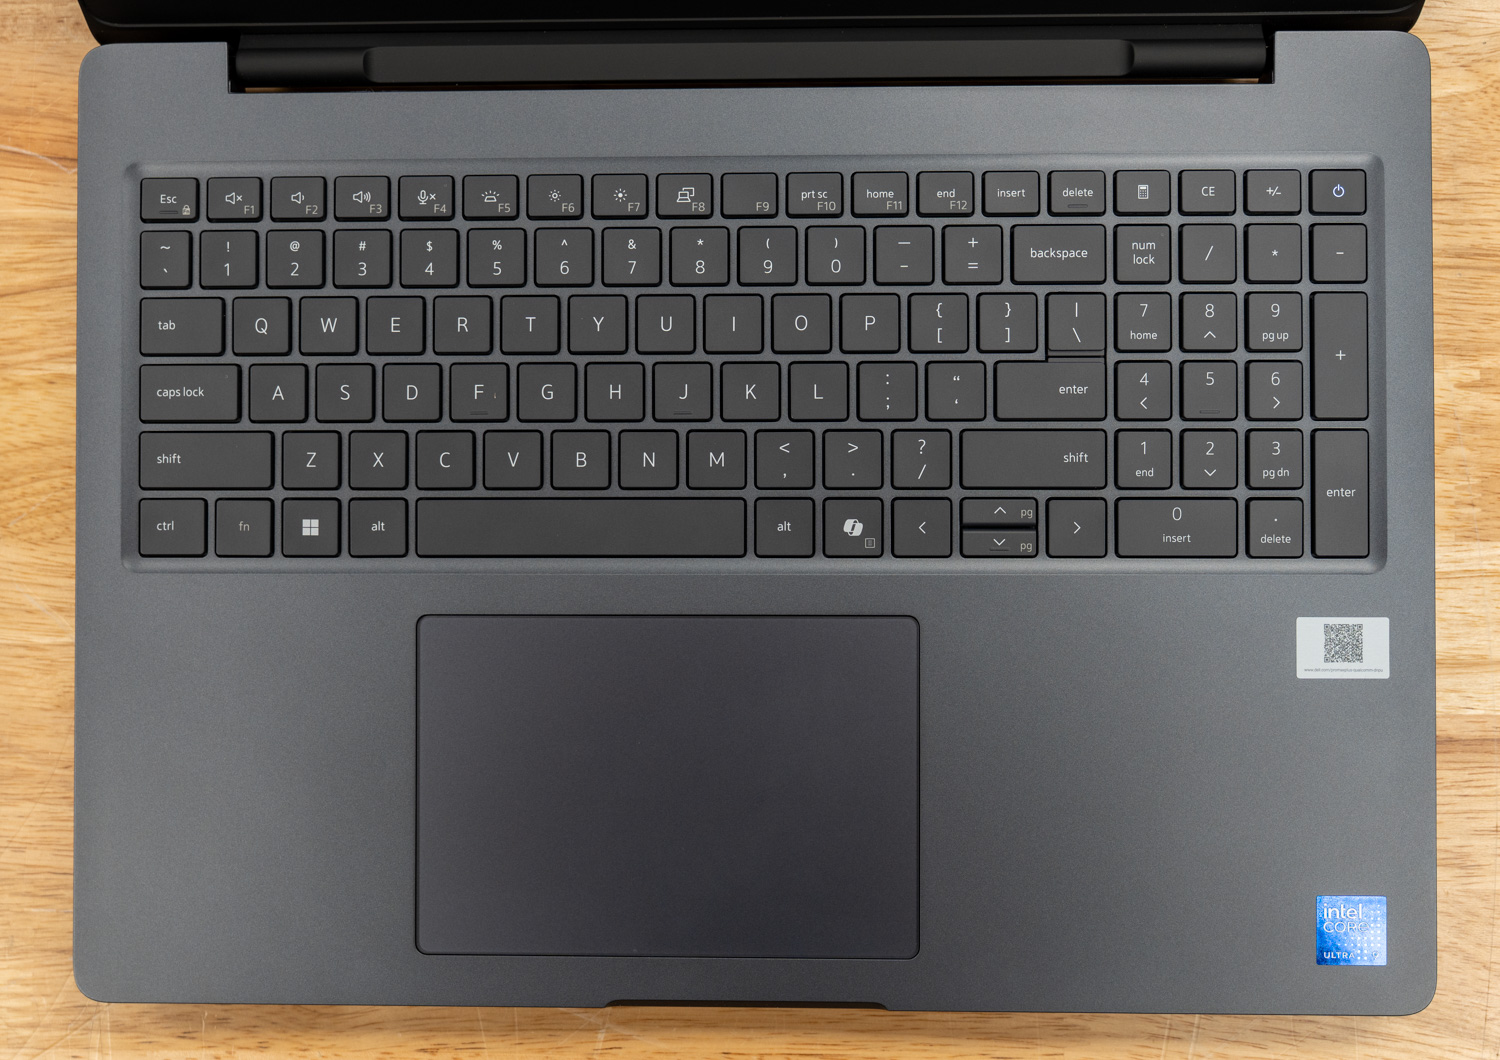
Klawiatura Della doskonale nadaje się do długich sesji pisania, a pełnowymiarowe klawisze zapewniają lekkość, responsywność i wyraźne, wyczuwalne sprzężenie zwrotne. Białe podświetlenie zapewnia dobrą widoczność w słabo oświetlonych pomieszczeniach. Układ jest w dużej mierze konwencjonalny, ale nierównomierne rozmieszczenie klawiszy strzałek może powodować sporadyczne błędy w naciskaniu, a umiejscowienie klawiszy Home i End stanowi szczególną wadę; dzielą one miejsce z klawiszami F11 i F12, więc włączenie funkcji Fn-Lock (Fn + Esc) w celu nadania priorytetu rzędowi funkcji wymusza naciśnięcie klawiszy Fn + F11 lub F12, aby uzyskać do nich dostęp. Mile widziane byłyby dedykowane klawisze Page Up i Page Down; zamiast tego pełnią one drugorzędne funkcje strzałek w górę i w dół, które i tak są najbardziej niewygodnymi klawiszami w tym zestawie. Przycisk zasilania, znajdujący się w prawym górnym rogu, pełni również funkcję czytnika linii papilarnych.
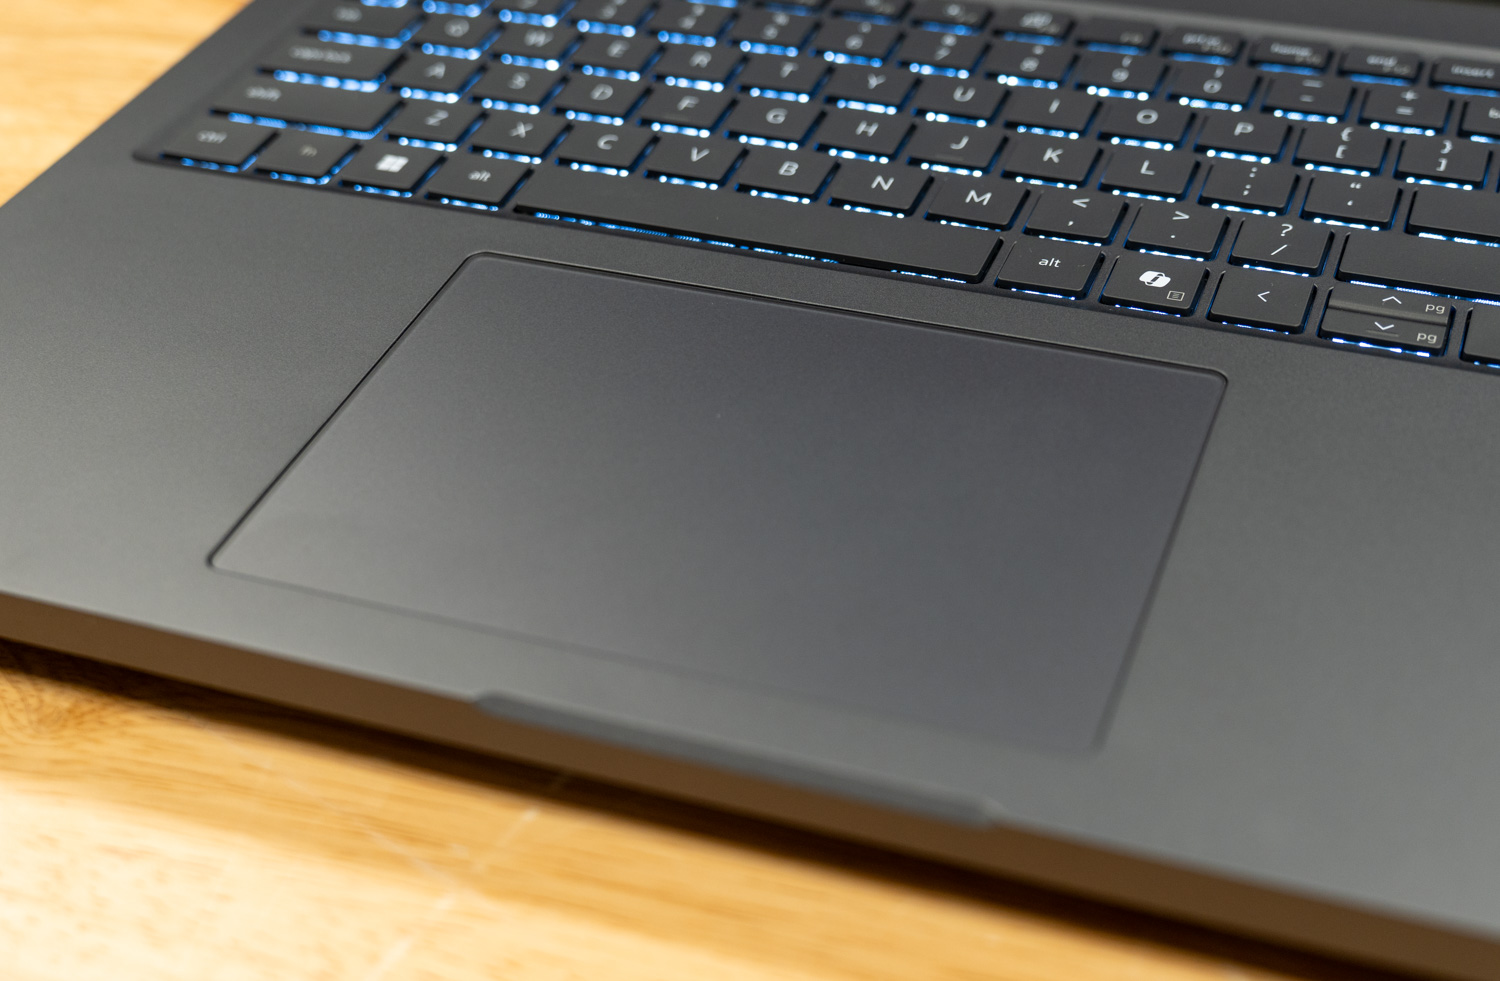
Przestronny touchpad idealnie pasuje do 16-calowego formatu. Jego gładka, antyodblaskowa powierzchnia precyzyjnie śledzi ruchy, a wykrywanie nadgarstka działało bez zarzutu podczas testów.
Możliwość rozbudowy
Pro Max 16 Plus został zaprojektowany z myślą o rozbudowie, oferując znaczny potencjał rozbudowy. Posiada trzy gniazda M.2 Gen5 do przechowywania danych, gniazdo CAMM2 do rozbudowy pamięci oraz kilka modułowych komponentów, w tym wymienne porty USB-C.
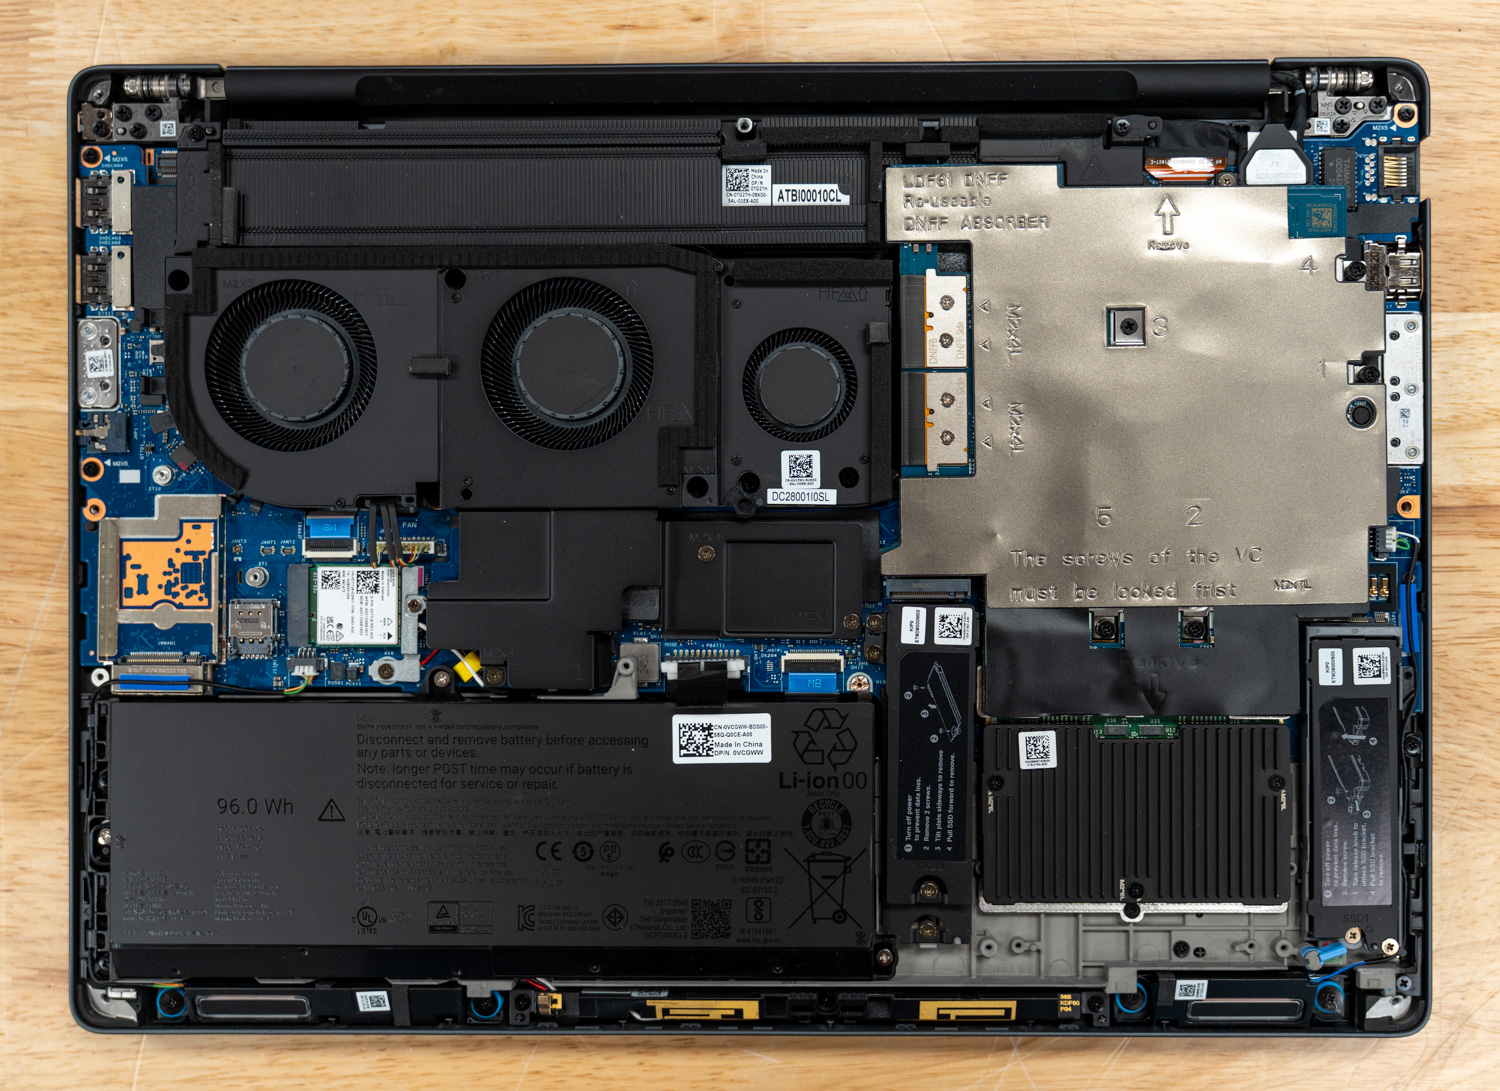
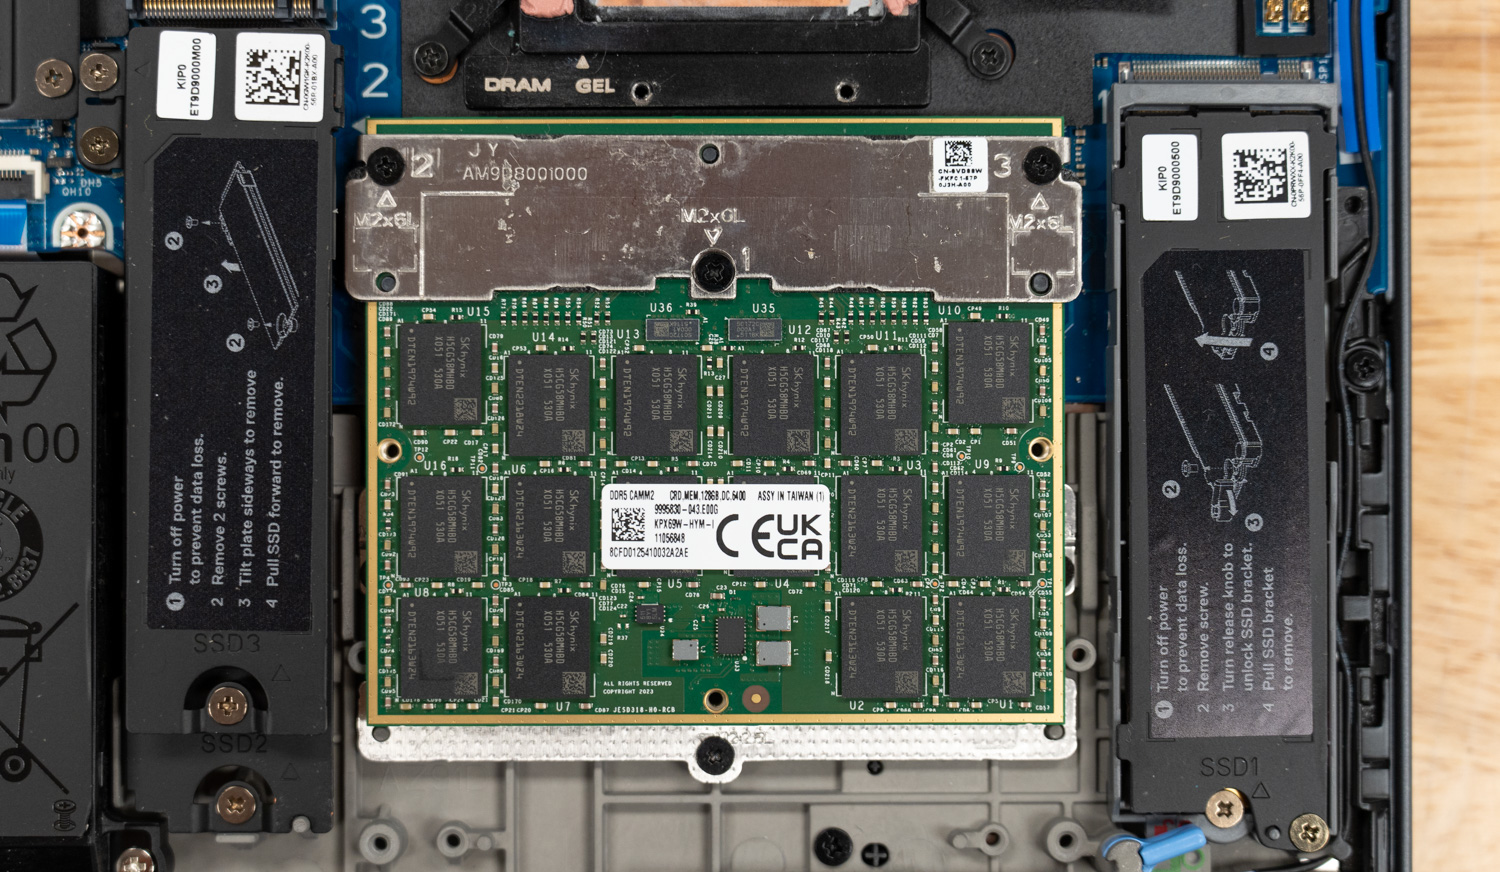
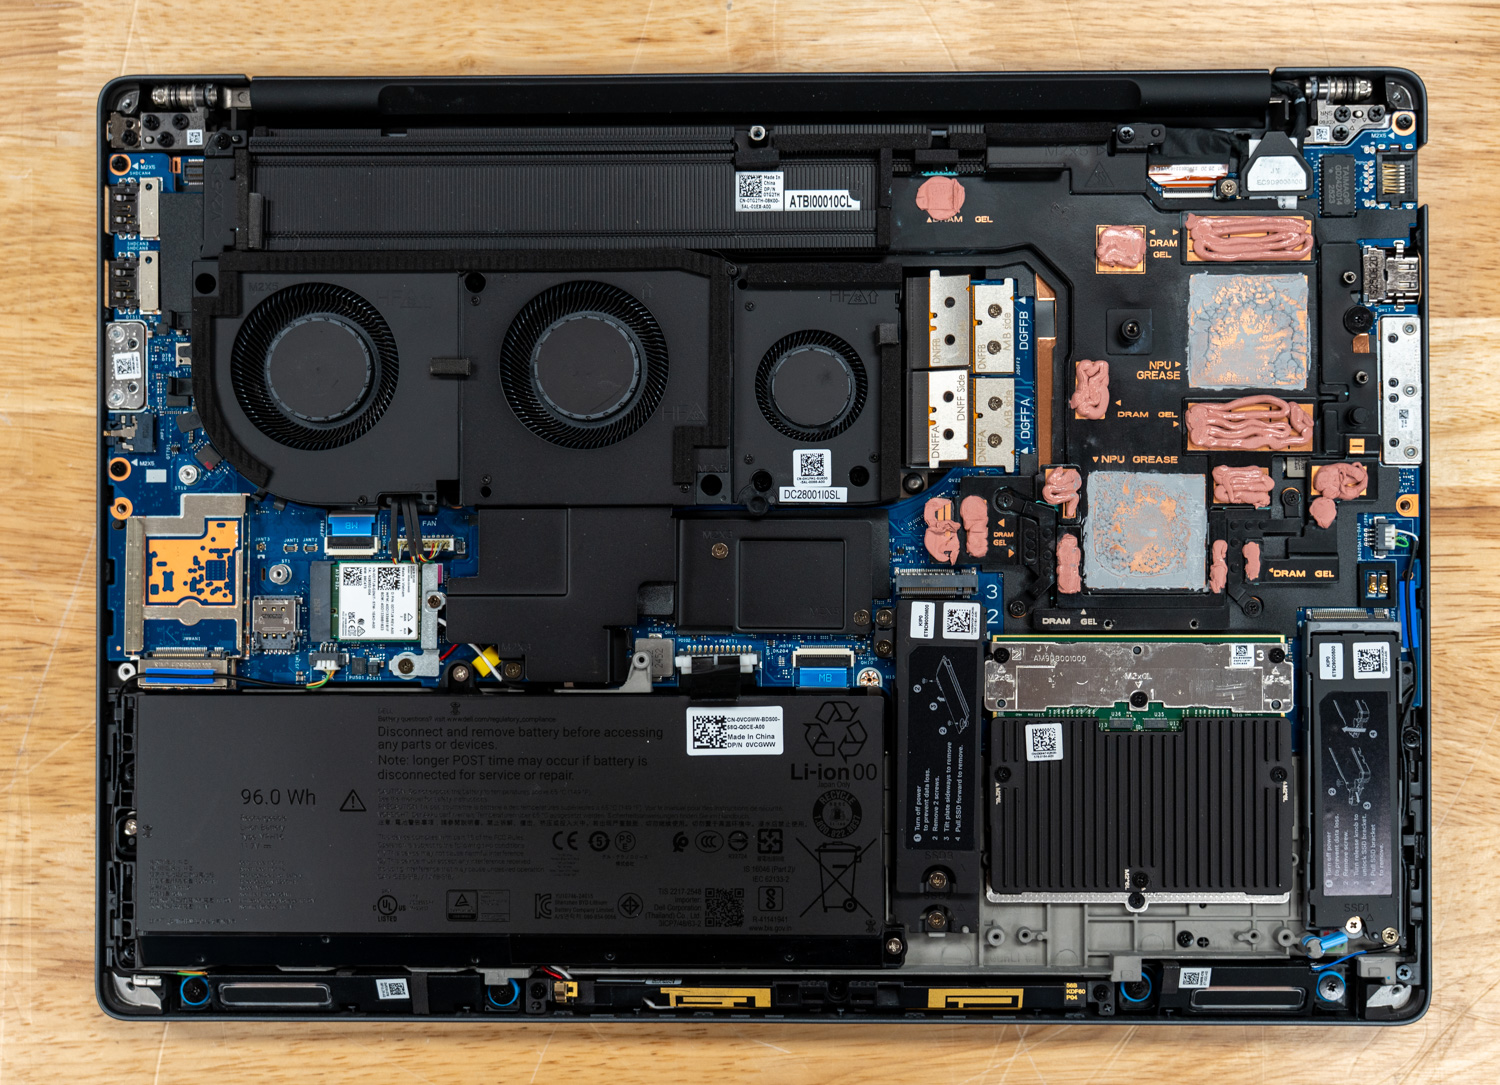
Dostęp do podzespołów jest prosty: wystarczy odkręcić śruby obwodowe i podnieść dolny panel od tyłu do przodu. Wewnątrz wita nas solidny system chłodzenia z trzema wentylatorami i pojemna bateria 96 Wh. Moduł pamięci CAMM2 znajduje się w prawym dolnym rogu, pod dedykowanym radiatorem, po bokach gniazd M.2. Trudno to dostrzec na zdjęciu, ale gniazdo M.2 po lewej stronie to w rzeczywistości gniazdo piętrowe, mieszczące dwa dyski w tej samej obudowie. Karta sieci bezprzewodowej M.2, również wymienialna przez użytkownika, znajduje się tuż nad baterią.
Gwiazda pokazu: Qualcomm AIC100
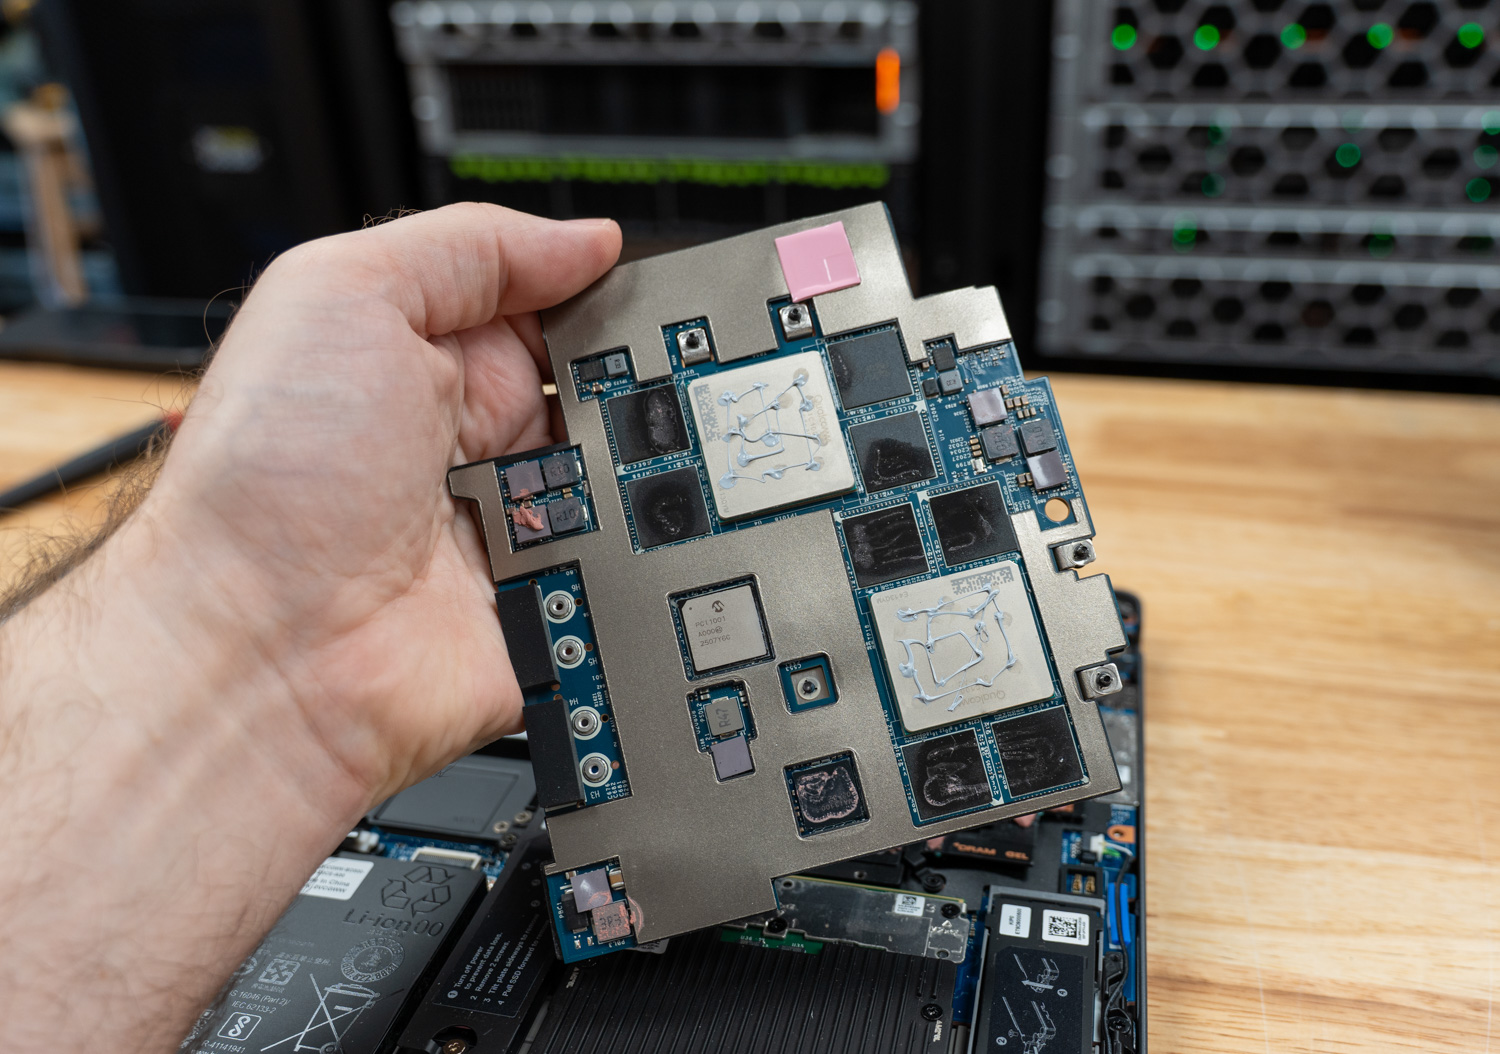
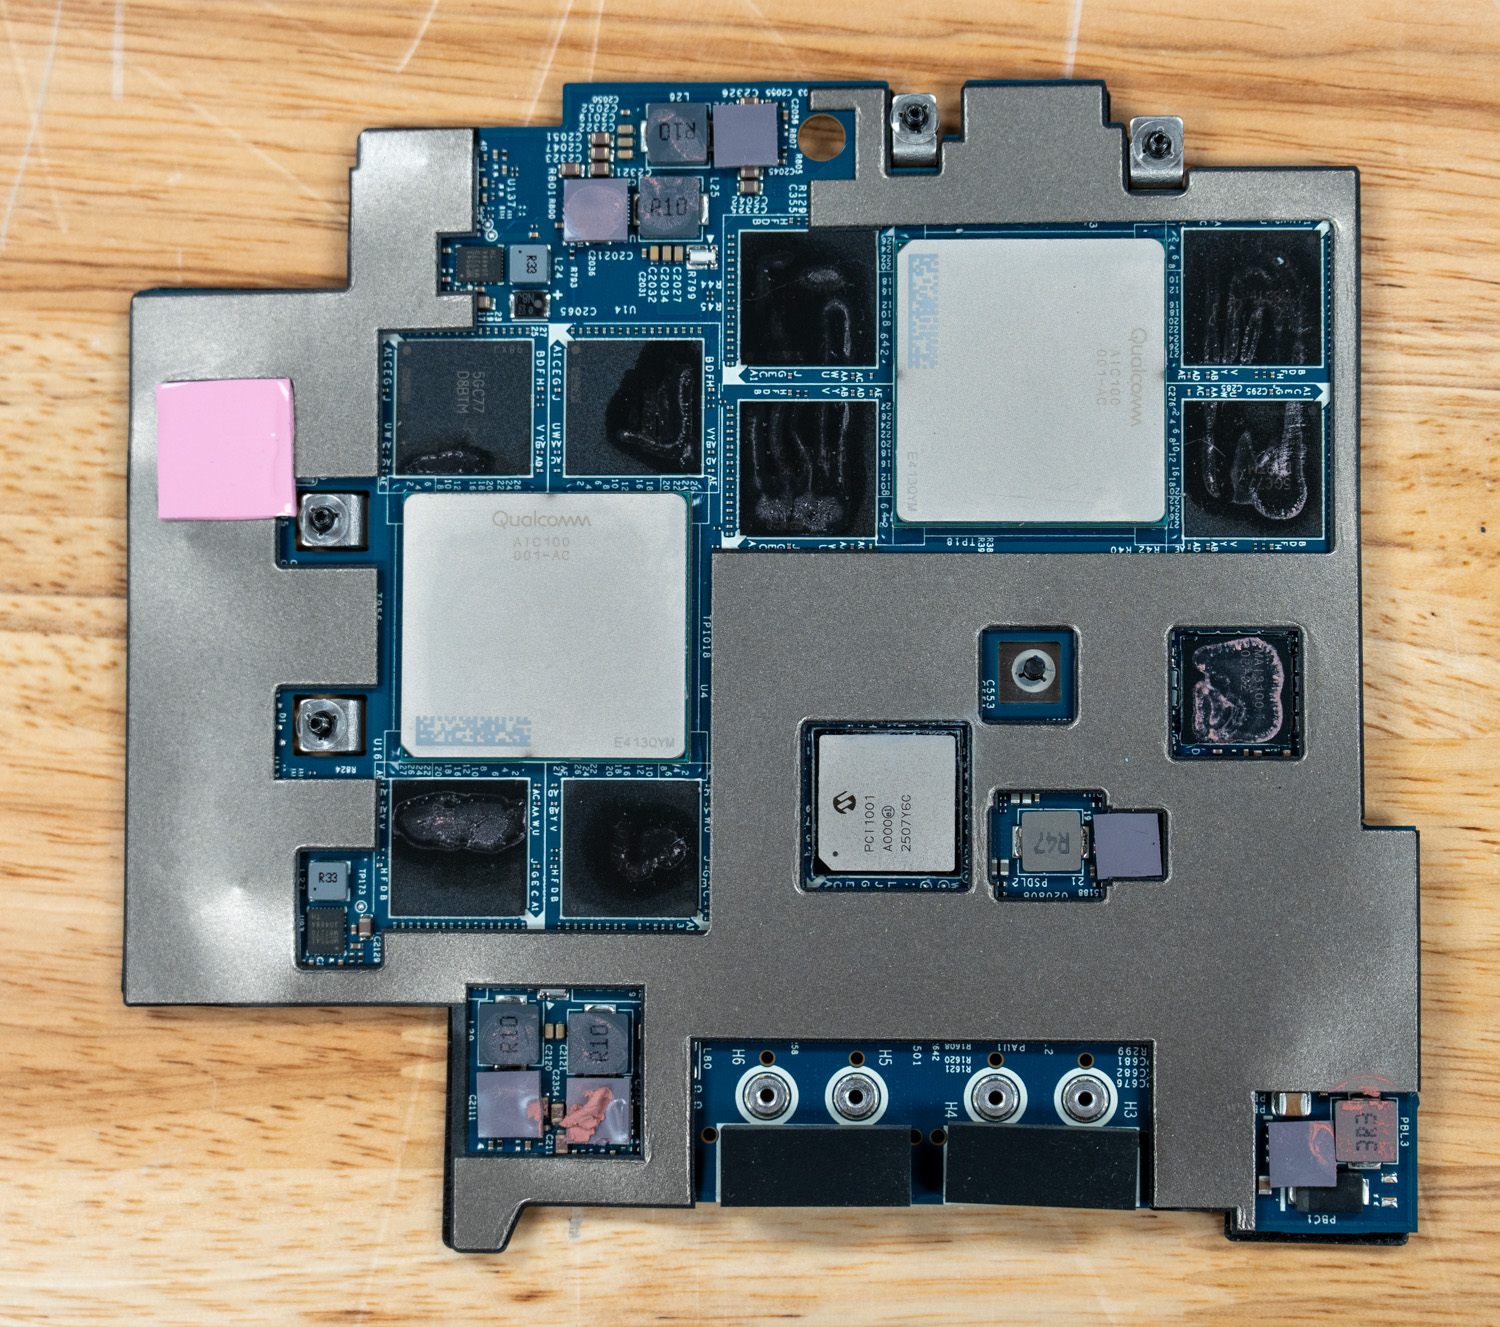
Testowany model Dell SKU jest dostarczany z jednostką NPU Qualcomm AI 100, pojedynczym modułem, który mieści obok siebie dwa układy SoC Qualcomm Cloud AI 100. Każdy SoC zapewnia 16 rdzeni AI, co daje łącznie 32 rdzenie w module, a każdy z nich posiada własne 32 GB pamięci LPDDR4x, prezentowane hostowi jako dwa oddzielne układy NPU.
Dell i Qualcomm reklamują przepustowość INT8 rzędu 450 TOPS i możliwość obsługi modeli o parametrach rzędu 100 miliardów. Dell publicznie zaprezentował Llama 4 Scout (109B parametrów, MoE) działający lokalnie na laptopie. Oba układy SoC komunikują się z hostem za pośrednictwem sterownika akceleratora Linux QAIC, a oprogramowanie układowe (bloby) jest przesyłane do linux-firmware.
Jak dotąd, wszystko w porządku. Liczby, same w sobie, są duże. Problemem jest krzem, który kryje się pod tymi liczbami.
Firma Qualcomm ogłosiła wprowadzenie na rynek układu Cloud AI 100 w kwietniu 2019 r., przeprowadziła jego testy pod koniec 2020 r., a jego sprzedaż komercyjną rozpoczęła się w pierwszej połowie 2021 r. Układ został zbudowany w oparciu o proces technologiczny 7 nm i wykorzystuje cztery 64-bitowe kontrolery LPDDR4X o taktowaniu 2100 MHz (LPDDR4X-4200), zapewniając przepustowość pamięci na poziomie 136 GB/s na układ SoC, zgodnie z dokumentacją architektury Cloud AI firmy Qualcomm.
Pierwotnie został zaprojektowany z myślą o formacie PCIe. Umieszczenie dwóch takich układów w niestandardowym module i umieszczenie go w laptopie z 2025 roku nie zmienia kompromisów. To krzem z ery 2019 roku z technologią pamięci z 2019 roku, odświeżony i przemianowany, ale architektonicznie należący do tej samej rodziny. Zanim trafił do Della Pro Max 16 Plus, reszta branży przeszła już przez HBM2e, HBM3, HBM3e i LPDDR5X, a teraz zmierza w kierunku GDDR7 i HBM4 w poważnych akceleratorach AI.
Ale głębszy problem ma większe znaczenie niż przepustowość pamięci. W branży istnieje wiele znakomitych projektów układów scalonych i zespołów inżynieryjnych, które rozumieją problem wnioskowania AI na bardzo głębokim poziomie, a sama architektura Cloud AI 100 może być w tym zakresie kompetentna. Problem polega na tym, że inżynierowie oprogramowania, którzy faktycznie tworzą produkt, zainwestowali już znaczne środki w inny ekosystem: CUDA. O ile nie ma silnej zachęty do zmiany, programiści trzymają się zestawu narzędzi, który już oferuje doskonałe wsparcie, dokumentację i pomoc społeczności. NVIDIA wcześnie zdobyła bazę programistów i zbudowała wokół niej ogromną społeczność. AMD przez lata pozostawało w tyle na tym froncie, ale ostatnie wersje ROCm są naprawdę doskonałe, a luka się zmniejsza. Rozwiązania takie jak Modular Mojo i MAX pozwalają nawet na kierowanie kodu na NVIDIA lub AMD, a czasami nawet pokonują natywne środowiska uruchomieniowe. Każdy inny akcelerator ma jednak problemy z publiczną adopcją z powodu braku wsparcia programowego.
Kluczową frazą jest publiczna adopcja. Duże organizacje, takie jak Google, mogą inwestować miliardy w XLA i JAX, aby procesory TPU działały . Dobrze finansowane prywatne startupy i laboratoria AI mogą pisać niestandardowe jądra dla własnego, wąskiego zestawu modeli i nie przejmować się tym, że nikt inny nie może replikować stosu, którego nie budują dla nieskończonej liczby publicznych przypadków użycia; budują dla problemów, z którymi się borykają. Dla publicznego konsumenta, a nawet większości przedsiębiorstw, akcelerator bez prężnie działającego publicznego ekosystemu programistów jest funkcjonalnie bezużyteczny. Stracisz tygodnie, próbując umieścić na nim swój model, a w momencie, gdy Hugging Face wypuści nową architekturę, będziesz wpatrywać się w zadanie rekompilacji (lub błąd nieobsługiwanego modelu), podczas gdy wszyscy w CUDA i ROCm mają wsparcie od dnia zerowego.
Powiem więc wprost: układ AIC100 w tym laptopie jest martwy. Nikt nie powinien go kupować. Żadna organizacja nie powinna go kupować, chyba że dysponuje zasobami inżynieryjnymi i wyraźnym zamiarem stworzenia od podstaw wnioskowania dla swojego konkretnego obciążenia, a także zaakceptowała, że sama będzie utrzymywać ten stos.
Rzeczywistość oprogramowania i narzędzi
Aby zrozumieć, dlaczego ta rekomendacja jest tak surowa, należy przyjrzeć się temu, jakie wnioski dotyczące wysyłki są faktycznie zawarte na tej karcie.
Elementy widoczne dla użytkownika są podzielone na dwa zestawy SDK i jedną bibliotekę wrapperów. Zestaw Qualcomm Cloud AI Platform SDK zawiera sterownik jądra (sterownik accel/qaic w Linuksie), oprogramowanie układowe urządzenia, środowisko uruchomieniowe na karcie oraz interfejsy API niskiego poziomu. Zestaw Apps SDK znajduje się na wierzchu i zapewnia kompilator qaic-exec, interfejs wiersza poleceń wnioskowania qaic-runner, integrację środowiska uruchomieniowego ONNX za pośrednictwem dostawcy wykonania QAIC, powiązania Pythona oraz fork vLLM. Biblioteka Qualcomm efficient-transformers, zwana również QEfficient, to wrapper Hugging Face Transformers, który reimplementuje popularne architektury LLM ze statycznymi kształtami, układami pamięci podręcznej KV i transformacjami grafów wymaganymi przez układ AIC100. Qualcomm AI Hub to oddzielny katalog modeli i produkt typu „kompilacja jako usługa” skierowany bardziej do urządzeń klasy Snapdragon niż do układu AIC100, choć ma wspólną markę.
Ścieżka kompilacji jest sztywna. Bierzesz model PyTorch, eksportujesz go za pomocą torch.export lub ONNX i przekazujesz do qaic-exec z flagami takimi jak -convert-to-fp16, -mxfp6-matmul, rozmiarem partii, długością kontekstu i docelową liczbą SoC. Kompilator wykonuje harmonogramowanie z wyprzedzeniem i rozmieszczanie pamięci, a następnie emituje QPC, Qualcomm Program Container, zapieczętowany plik binarny, który przypina układ pamięci, kształt pamięci podręcznej KV, rozmiar partii, długość sekwencji prefill i długość kontekstu. Nie ma JIT. Zgodnie z dokumentacją LLM firmy Qualcomm, kompilator ahead-of-time AI 100 wstępnie przydziela zasoby urządzenia na podstawie długości monitu, długości generacji, pamięci podręcznej KV i rozmiaru partii, a Cloud AI 100 obsługuje tylko statyczne kształty wejściowe. Każda zmiana tych parametrów w czasie kompilacji wyzwala kolejną pełną kompilację, która może trwać wiele minut w przypadku małych modeli i godzin w przypadku dużych.
Lista obsługiwanych architektur jest bardzo krótka. Biblioteka QEfficient i hostowany w Zentree, wstępnie skompilowany katalog QPC, do którego Dell kieruje klientów, w dużej mierze obejmują starsze modele, a tylko kilka z nich jest wartych użycia w 2026 roku.
Nowsze punkty kontrolne natywne dla FP8 wymagają rekwantyzacji. Jeśli model jest dostarczany natywnie w MXFP4, tak jak popularne modele GPT-OSS, mamy do czynienia z potokiem konwersji i rekompilacji, a nie z redukcją wag. Nie ma rzeczy niemożliwych do obejścia, jeśli jest się gotowym na pracę, ale jest to stałe obciążenie.
Następnie pojawia się problem współbieżności, który jest tym, co sprawia, że laptop się rozpada, nawet dla programistów skupionych na wydajności od razu po wyjęciu z pudełka. Dostarczone przez firmę Dell obrazy kontenerów, które firma instruuje użytkowników, aby je pobierali i uruchamiali za pomocą vLLM, oparte są na komputerach QPC, które Zentree wstępnie skompilował z określonymi kształtami, a dostarczane kontenery działają tylko z współbieżnością równą 1. Niezależnie od kształtu sekwencji wejściowej lub wyjściowej, otrzymujesz jedną stałą przepustowość dla danego modelu. Wiele równoległych żądań nie jest wykonywanych jednocześnie; są one kolejkowane i przetwarzane sekwencyjnie przez vLLM. Nie można dynamicznie przetwarzać wsadowo. Nie można używać ciągłego przetwarzania wsadowego, takiego jak vLLM lub SGLang, które oferuje za darmo na procesorach graficznych Team Red lub Green. Aby uzyskać współbieżność powyżej 1, należy ponownie skompilować komputer QPC z większym rozmiarem wsadu.
Przykłady Della zachęcają deweloperów do skorzystania z tego laptopa, a najpopularniejszym obecnie zastosowaniem sztucznej inteligencji jest kodowanie wibracji za pomocą narzędzi takich jak Claude Code, OpenCode i podobnych. Pojedyncze żądanie do tych narzędzi może zostać rozproszone na wiele równoległych wywołań LLM; domyślnie te NPU kolejkują te żądania i przetwarzają je sekwencyjnie, a nie równolegle, więc coś, co na NVIDIA Spark mogłoby zająć sekundy, w tej konfiguracji zajmie minuty.
Wydajność
System dostarczony przez firmę Dell do testów ma następującą konfigurację:
- Procesor Intel Core Ultra 9 285HX
- Karta inferencyjna Qualcomm AIC100 PC
- 128 GB 6400 MTs CAMM2 DDR5
- 4TB SSD
Zanim podam jakiekolwiek liczby, uwaga dotycząca metodologii. Jak opisano powyżej, AIC100 uruchamia skompilowane z wyprzedzeniem serwery QPC z zamrożonym rozmiarem wsadu, długością sekwencji i układem pamięci podręcznej KV. Dell dostarcza ten laptop z zestawem wstępnie skompilowanych serwerów QPC hostowanych w Zentree oraz obrazem kontenera vLLM, który pobiera je przy pierwszym uruchomieniu. Ten zestaw wstępnie skompilowanych serwerów QPC, obsługiwany przez kontener referencyjny Dell z poziomem współbieżności 1, to to, co użytkownik końcowy faktycznie otrzymuje po rozpakowaniu komputera i postąpieniu zgodnie z dokumentacją Dell. Jest to konfiguracja, którą testowaliśmy.
Mamy narzędzia, które pozwalają nam zrobić inaczej. Moglibyśmy pobrać qaic-exec, utworzyć punkt kontrolny, uruchomić go przez torch.export, przeprowadzić rekwantyzację, przekompilować QPC z większym rozmiarem partii i przesłać go z powrotem przez vLLM. Moglibyśmy napisać własne kernele dla sterownika akceleratora QAIC, gdybyśmy chcieli. Zrezygnowaliśmy z tego, ponieważ zdecydowana większość nabywców na rynku docelowym tego laptopa – programiści, inżynierowie zainteresowani sztuczną inteligencją i zespoły pilotażowe w przedsiębiorstwach – nie podejmie się tego zadania. Pobiorą kontener, uruchomią go i ocenią produkt na podstawie tego, co wyjdzie. Właśnie to zmierzyliśmy.
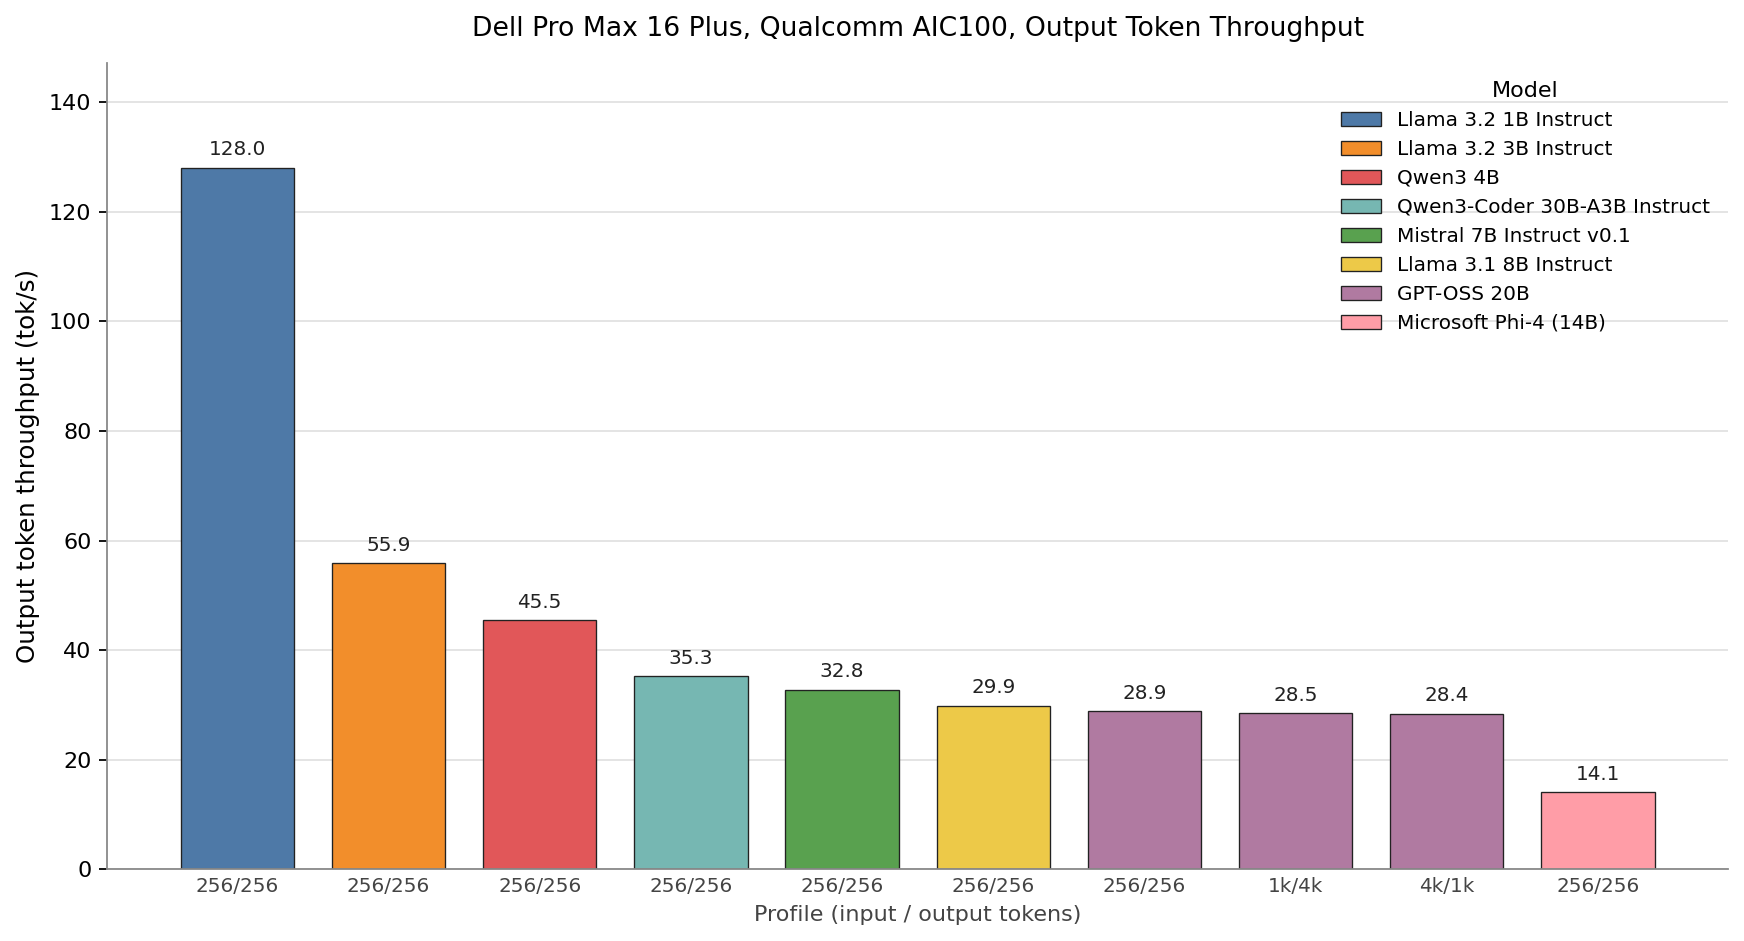
Każdy słupek reprezentuje komputer QPC skompilowany przez Qualcomm, działający z wagami MXFP6 i pamięcią podręczną MXINT8 KV, czyli precyzją, z jaką artefakty Della są powszechnie stosowane. Llama 3.2 1B to jedyny model na wykresie, który przekracza 100 TPS, osiągając 128 TPS. Na kolejnym miejscu plasują się Llama 3.2 3B z 56 TPS, Qwen3 4B z 45 TPS, Qwen3-Coder 30B-A3B z 35 TPS, Mistral 7B z 33 TPS i Llama 3.1 8B z 30 TPS. GPT-OSS 20B osiąga odpowiednio 28.9, 28.5 i 28.4 TPS dla profili 256/256, 1k/4k i 4k/1k, co potwierdza obietnice zawarte w dokumentacji Qualcomma dotyczące kompilatora AOT: po utworzeniu QPC dla danego kształtu, szybkość dekodowania jest stała, a długość prompta nie wpływa na koszt tokena. Phi-4 zamyka wykres na poziomie 14 TPS.
Chociaż większe modele niż te powyżej zmieszczą się na tej karcie, nie przeprowadzaliśmy ich testów porównawczych. Na przykład, w przypadku modelu Llama 4 Scout, prezentowanego publicznie przez firmę Dell, wymaga to dalszego obniżenia precyzji do INT4, a w praktyce mniejszy, mniej skwantyzowany model będzie miał lepszą wydajność niż większy, silnie skwantyzowany model w wielu obciążeniach.
Dostarczony kontener vLLM uruchamia również każdy QPC z parametrem batch_size=1 i w praktyce potwierdziliśmy, że wysłanie dwóch jednoczesnych żądań nie podwaja przepustowości. Drugie żądanie po prostu czeka w kolejce oprogramowania, aż pierwsze się zakończy. Dostarczony stos nie oferuje ciągłego przetwarzania wsadowego, przetwarzania wsadowego w trakcie przetwarzania ani dekodowania spekulatywnego. W przypadku agentów kodujących, takich jak Claude Code czy OpenCode, które rozsyłają wiele równoległych wywołań LLM z jednej tury użytkownika, to ograniczenie pojedynczego strumienia zamienia to, co powinno być kilkusekundowym czasem reakcji, w wielominutowe oczekiwanie. Zwiększenie wymiaru wsadu wymaga ponownej kompilacji QPC na hoście, co ponownie stawia nas w pułapce, przez którą już odmówiliśmy.
Porównajmy to z NVIDIA Spark. Z długością sekwencji wejścia i wyjścia 256/256, Spark może obsłużyć model 120B szybciej niż układ Qualcomm AIC 100 firmy Dell – model 20B. I to nie są nawet najlepsze wyniki, jakie Spark może zaoferować, ponieważ wyniki te zostały zebrane przy użyciu jądra Marlin w wersjach oprogramowania startowego.
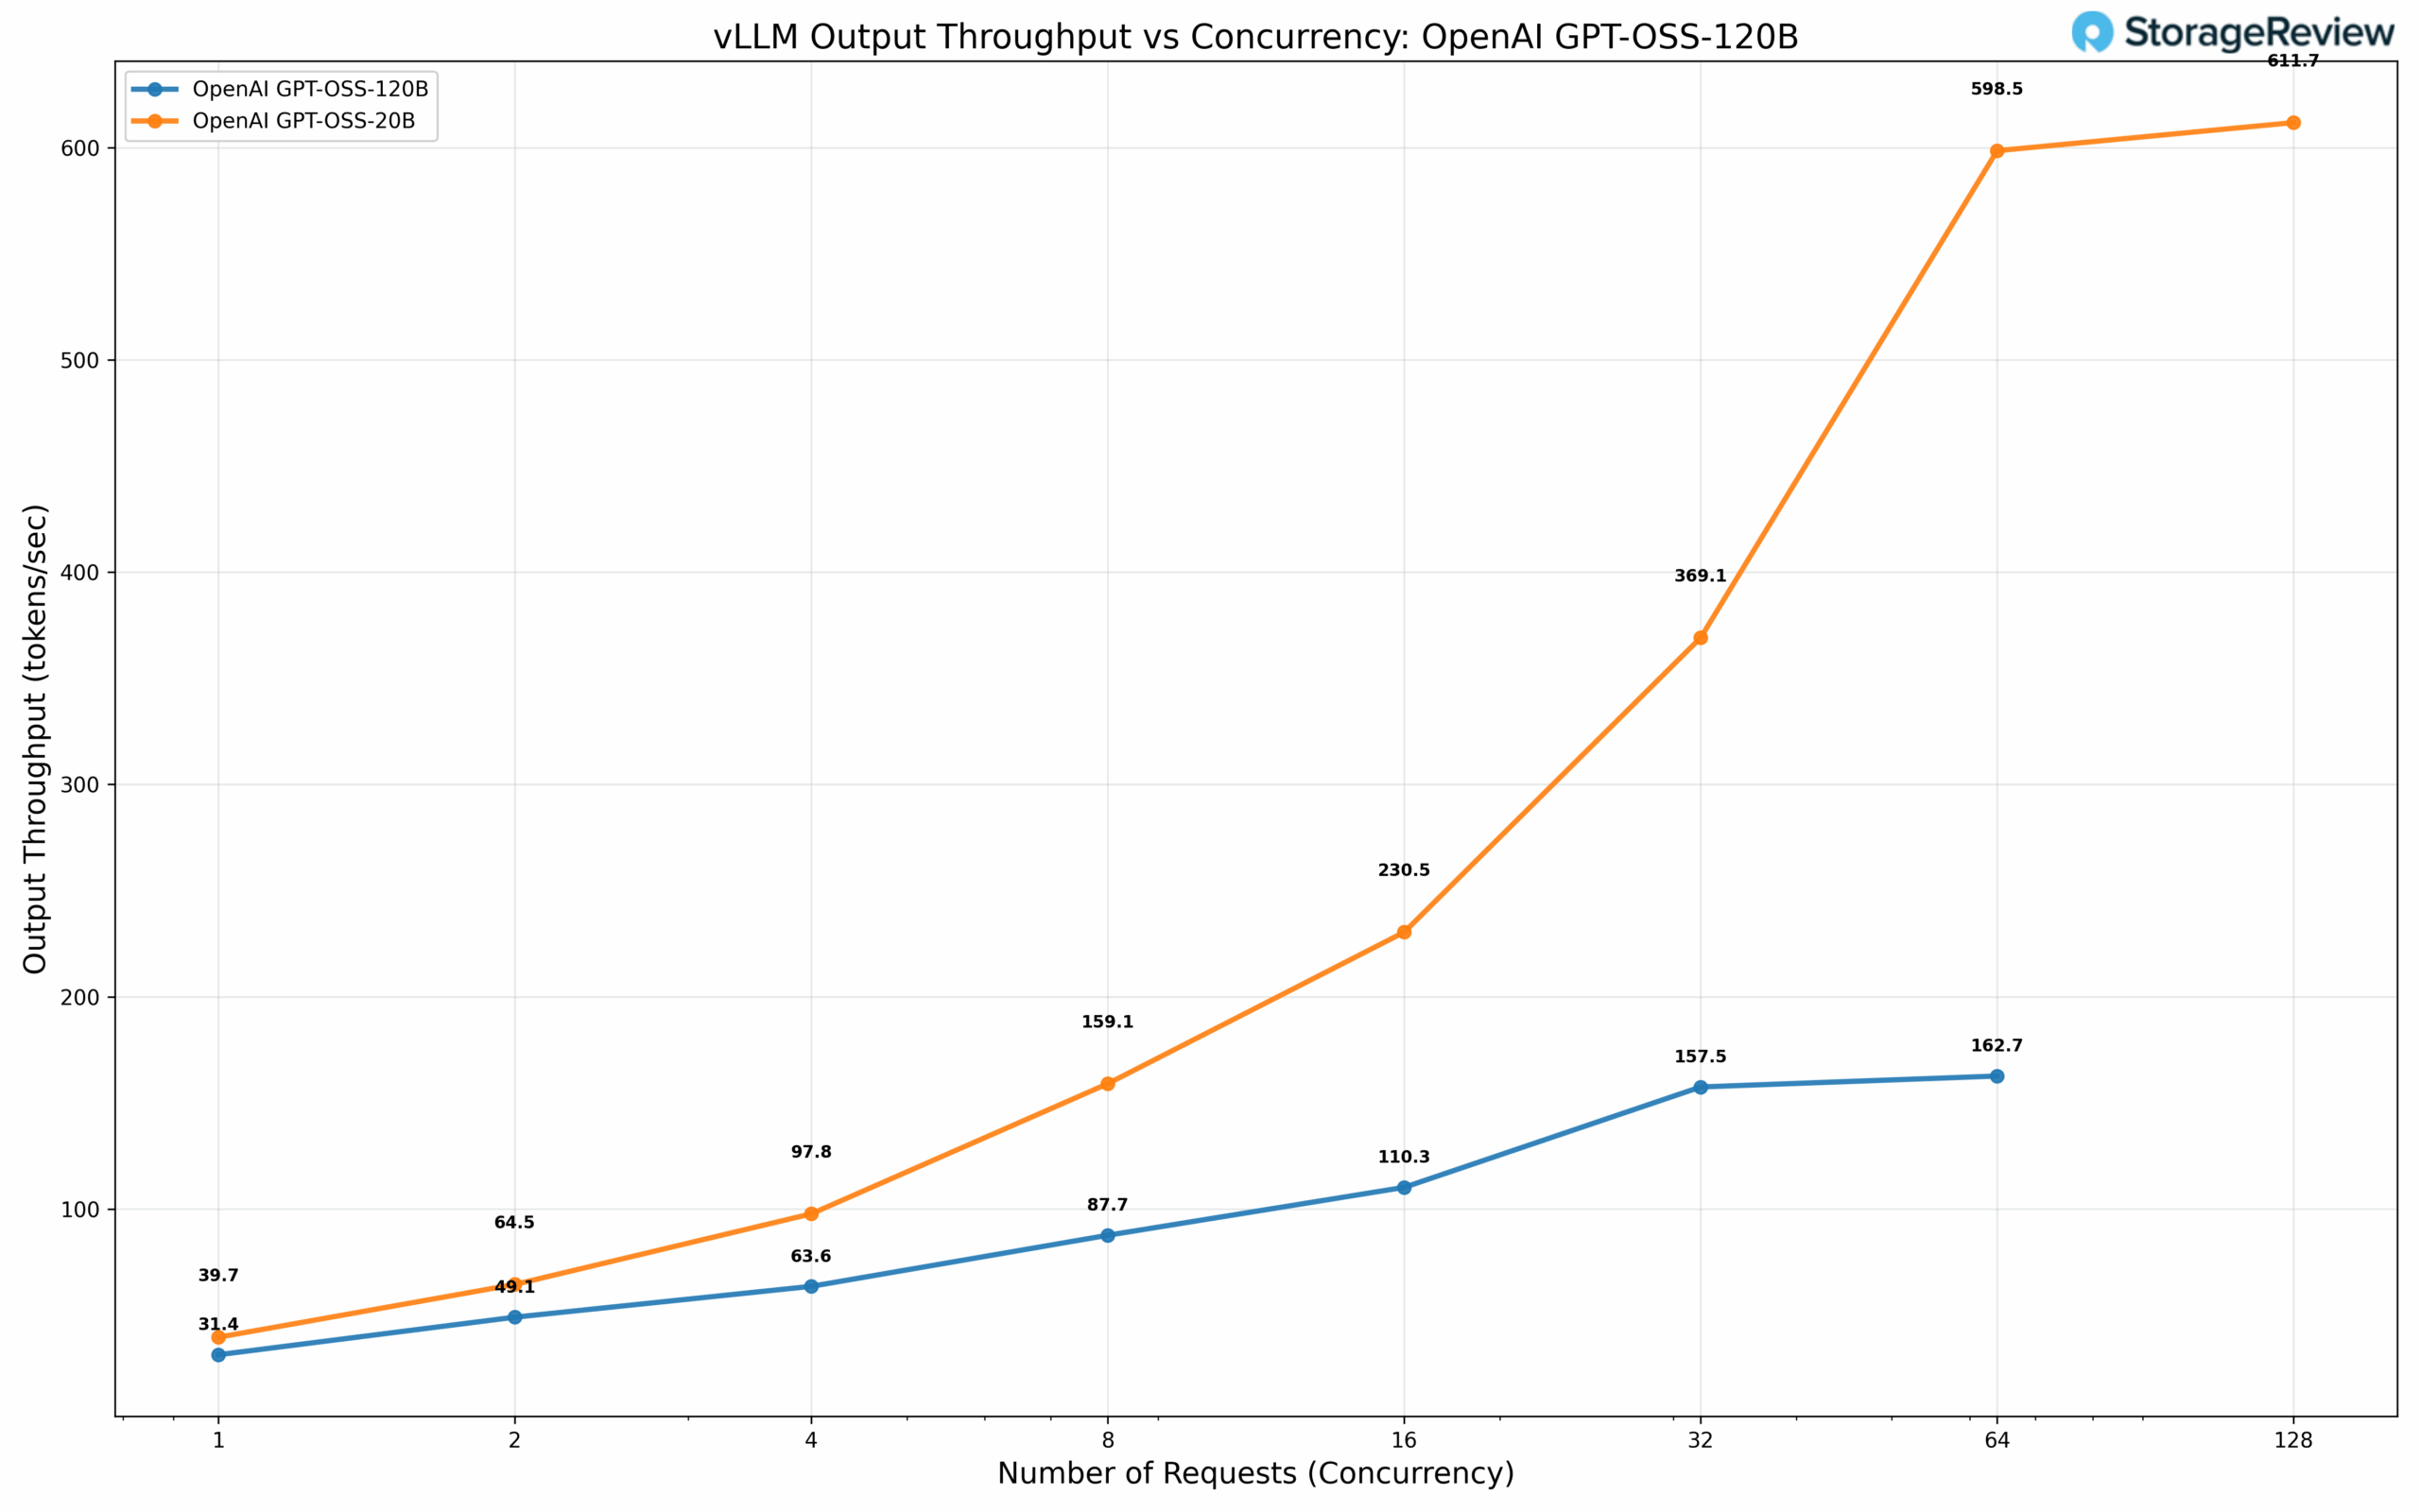
Wniosek jest prosty. Dla pojedynczego użytkownika, pojedynczej rozmowy i modelu na tyle małego, że 136 GB/s LPDDR4X na SoC nie stanowi ograniczenia (Llama 3.2 1B i, co bardziej prawdopodobne, Llama 3.2 3B), układ AIC100 w tym laptopie jest użyteczny. W przypadku większych konfiguracji, w konfiguracji, którą klient faktycznie otrzyma, połączenie dekodowania pojedynczego strumienia i potoku kompilacji o statycznym kształcie, który karze każdy kształt, którego Qualcomm nie przygotował wcześniej, pozostawia ten akcelerator w tyle za zintegrowanym NPU i zintegrowanym GPU na tym samym procesorze Intel Core Ultra HX, z którym jest połączony, nie mówiąc już o oddzielnych jednostkach NVIDIA, z którymi można zamówić tę samą obudowę.
Jeśli porównamy na chwilę surowe specyfikacje, NVIDIA Spark oferuje 273 GB/s , a maksymalną osiągalną liczbę operacji zmiennoprzecinkowych (MAMF) w FP8 (E4M3) przetestowaliśmy na 200 TFLOPS na jednym chipie. QAIC reklamuje się jako oferujący 272 GB/s na dwóch chipach i 435 TFLOPS INT8. Teoretycznie powinny one działać podobnie, ale układ Qualcomma pozostaje w tyle ze względu na oprogramowanie.
Dla kogo jest ten produkt i czy warto go kupić?
Dla każdego, kto dziś próbuje poważnie zająć się sztuczną inteligencją, odpowiedź brzmi: nie. Nie kupuj tej konfiguracji.
W amerykańskim sklepie Della, modele Pro Max 16 Plus z serii AIC100 kosztują 14 871,56 USD za najdroższą konfigurację (Core Ultra 9 285HX, 128 GB pamięci RAM, dysk SSD 4 TB), 9,661.56 USD za konfigurację średnią (Core Ultra 7 265HX, 64 GB pamięci RAM, 1 TB) i 8,831.56 USD za podstawową wersję AIC100. Wszystkie modele są dostępne wyłącznie z systemem Ubuntu Linux, a wkrótce pojawi się obsługa systemu Windows. Po testach, cena urządzenia mieści się w przedziale 14 000–15 000 USD.
Dla porównania, NVIDIA DGX Spark obecnie sprzedaje się za 4,699 USD. Za te pieniądze otrzymujesz GB10 Grace Blackwell Superchip , 128 GB zunifikowanej pamięci LPDDR5X, 4 TB NVMe, GPU Blackwell i około 1 petaflopa obliczeń AI FP4, wszystko wspierane przez pełny stos oprogramowania CUDA, TensorRT-LLM, NIM i cały ekosystem NVIDIA. Pojedynczy DGX Spark przewyższy AIC100 w tym laptopie w przypadku niemal każdego realistycznego obciążenia AI i zrobi to z oprogramowaniem, które każdy inżynier AI zatrudniony w tym roku już umie obsługiwać. Za cenę naszego egzemplarza testowego możesz kupić trzy DGX Spark, wyposażyć każdy z nich w monitor, urządzenia peryferyjne i biurko, a nadal zostanie ci pieniądze. Jeśli mała sztuczna inteligencja nie jest tym, czego szukasz, stacja robocza Dell Pro Max Tower T2 z procesorem Intel 285K, 128 GB pamięci RAM DDR5 i kartą graficzną NVIDIA RTX Pro 6000 kosztuje około 15 000 dolarów, w zależności od rozmiaru dysku SSD.
Trudno oprzeć się wrażeniu, że Dell umieścił coś w rodzaju elektrośmieci w znakomitej obudowie. Pro Max 16 Plus z kartą RTX PRO 5000 to fantastyczna mobilna stacja robocza. Ta sama maszyna, z procesorem AIC100, to bałaganiarski eksperyment naukowy objęty gwarancją Dell.
Wniosek
Jeśli za kilka lat będziesz majsterkowiczem i będziesz to czytał, a natknąłeś się na jeden z tych laptopów na wyprzedaży za dwieście lub trzysta dolarów, to jak najbardziej, kup go. System jest naprawialny i można go rozbudować, klawiatura jest dobra, a wykorzystanie modułów AIC100 do zrobienia czegoś ciekawego w ramach weekendowego projektu to dokładnie taka zabawa bez ryzyka, na jaką zasługuje ten sprzęt.
Jeśli dziś próbujesz poważnie zająć się sztuczną inteligencją, skonfiguruj swojego Pro Max 16 Plus z dosłownie dowolnym innym akceleratorem. Mobilna karta graficzna NVIDIA RTX PRO, nawet podstawowa RTX PRO 1000, sprawdzi się lepiej niż moduły AIC100. Zintegrowany układ NPU procesora Intel Core Ultra HX sprawdzi się lepiej w wielu praktycznych scenariuszach, ponieważ przynajmniej współpracuje z systemem Windows ML, OpenVINO i istniejącym stosem sztucznej inteligencji dla komputerów PC.
Jedna sugestia warta przedstawienia firmie Dell: Pro Max 16 Plus to doskonała obudowa, a linia Pro Max to jedna z najmocniejszych platform mobilnych stacji roboczych na rynku. Jednostka SKU AIC100 w obecnej postaci w żadnym wypadku nie spełnia tego standardu. Eksperymentalna lub deweloperska linia produktów, wyraźnie oznaczona jako taka, dałaby firmie Dell możliwość dostarczania nowatorskich akceleratorów klientom, którzy chcą się nimi pobawić, bez konieczności umieszczania szerszej marki Pro Max na niegotowym stosie. Marka Pro Max jest warta ochrony i istnieje prosty sposób, aby to zrobić, jednocześnie znajdując miejsce dla sprzętu eksperymentalnego.


 Amazon