

Krajobraz procesorów graficznych (GPU) doświadczył ogromnych zmian w ciągu ostatnich dwóch dekad, a ostatnio, wraz z rozwojem sztucznej inteligencji (AI), znacząco wpłynął na rozwój technologii umożliwiających tandemową pracę wielu procesorów graficznych. NVIDIA, lider w dziedzinie procesorów graficznych, przewodziła tej rewolucji dzięki dwóm kluczowym technologiom: Scalable Link Interface (SLI) i NVIDIA NVLink . Niniejszy artykuł przedstawia historię przejścia od SLI do NVLink, podkreślając, jak NVIDIA nieustannie dostosowuje się do stale zmieniających się wymagań obliczeniowych.
Świt SLI
NVIDIA wprowadziła technologię SLI na początku XXI wieku. Technologia ta została pierwotnie opracowana przez firmę 3dfx dla linii kart Voodoo2 i stanowiła odpowiedź firmy NVIDIA na rosnące zapotrzebowanie na wyższą jakość grafiki w grach wideo i aplikacjach konsumenckich. W swojej istocie SLI wykorzystuje technikę znaną jako Alternate Frame Rendering (AFR), która dzieli obciążenie renderowania na wiele układów GPU. Każda karta renderowała co drugą klatkę lub nawet jej część, efektywnie podwajając moc obliczeniową. Choć SLI było wówczas rewolucyjne, miało jednak pewne ograniczenia, takie jak wyższe opóźnienia i brak elastyczności w udostępnianiu danych między układami GPU.
SLI kontra CrossFire: Rywalizacja w rozwiązaniach wieloprocesorowych
Chociaż technologia SLI firmy NVIDIA wyznaczała trendy w konfiguracjach z wieloma GPU, nie obyło się bez konkurencji. Bezpośrednim rywalem był CrossFire firmy AMD , oferując podobne możliwości w konfiguracjach z wieloma GPU. Podobnie jak SLI, CrossFire miał na celu zwiększenie wydajności graficznej poprzez techniki takie jak Alternate Frame Rendering (AFR) i Split Frame Rendering (SFR).

Źródło obrazu: Dallas Moore
CrossFire miał jednak swój własny zestaw zalet i wad. Był generalnie bardziej elastyczny w kwestii kombinacji używanych układów GPU, co pozwalało na współpracę z różnymi kartami AMD. Z drugiej strony, CrossFire był często krytykowany za swój pakiet oprogramowania, który niektórzy użytkownicy uznawali za mniej niezawodny i bardziej skomplikowany w konfiguracji niż SLI firmy NVIDIA. Pomimo tych różnic, obie technologie miały ten sam cel: ulepszenie wrażeń graficznych w grach i aplikacjach konsumenckich. Ich ograniczenia w obsłudze bardziej zaawansowanych zadań wymagających dużej ilości danych ostatecznie utorowały drogę rozwiązaniom nowej generacji, takim jak NVLink.
Wraz z nadejściem drugiej dekady XXI wieku krajobraz komputerowy zaczął się radykalnie zmieniać. Rozwój sztucznej inteligencji (AI), obliczeń o wysokiej wydajności (HPC) i analityki dużych zbiorów danych wymusił konieczność zastosowania bardziej zaawansowanych rozwiązań multi-GPU. Stało się oczywiste, że SLI, początkowo zaprojektowane z myślą o grach i zastosowaniach konsumenckich, było niewystarczające do obsługi tych wymagających obliczeniowo zadań. NVIDIA potrzebowała nowego paradygmatu.
Era kart z dwoma procesorami graficznymi: unikalne podejście do obliczeń z wieloma procesorami graficznymi
Podczas gdy technologie takie jak SLI i CrossFire koncentrowały się na łączeniu wielu oddzielnych układów GPU, istniało inne, mniej powszechne podejście do konfiguracji multi-GPU: karty dual-GPU. Te wyspecjalizowane karty graficzne mieściły dwa rdzenie GPU na jednej płytce PCB (Printed Circuit Board), działając w praktyce jak konfiguracja SLI lub CrossFire na jednej karcie. Karty takie jak NVIDIA GeForce GTX 690 i AMD Radeon HD 6990 były popularnymi przykładami tego podejścia.
Karty z dwoma procesorami graficznymi oferują szereg zalet. Oszczędzają miejsce, umieszczając dwa procesory graficzne w jednym slocie, co czyni je atrakcyjnymi dla komputerów o małym formacie. Uprościły również konfigurację, eliminując potrzebę podłączania oddzielnych kart do zewnętrznych złączy. Karty te miały jednak swoje wady. Odprowadzanie ciepła stanowiło poważny problem, często wymagający zaawansowanych rozwiązań chłodzenia. Wysokie zużycie energii wymagało wydajnych zasilaczy do stabilizacji systemu.
Co ciekawe, karty z dwoma GPU stanowiły swego rodzaju rozwiązanie łączące w sobie zalety obu światów, łącząc surową moc konfiguracji z wieloma GPU z prostotą pojedynczej karty. Często jednak postrzegano je jako produkt niszowy ze względu na wysoki koszt i związane z nim wyzwania techniczne. Wraz z rozwojem technologii z wieloma GPU, takich jak NVLink, w celu zapewnienia większej przepustowości i mniejszych opóźnień, zapotrzebowanie na karty z dwoma GPU zmalało. Mimo to, karty te pozostają fascynującym rozdziałem w historii rozwoju GPU.
Linia procesorów graficznych Tesla firmy NVIDIA była kamieniem węgielnym w obliczeniach na poziomie korporacyjnym, szczególnie w centrach danych i klastrach obliczeniowych o wysokiej wydajności. Chociaż większość procesorów graficznych Tesla to karty z pojedynczym procesorem graficznym, zaprojektowane z myślą o maksymalnej wydajności i efektywności, zdarzały się wyjątki, takie jak Tesla K80, która oferuje dwa procesory graficzne na jednej karcie. Te wieloprocesorowe karty Tesla zostały zoptymalizowane pod kątem obliczeń wysoce równoległych i były podstawą badań naukowych, uczenia maszynowego i analizy dużych zbiorów danych. Zostały zaprojektowane tak, aby spełniać specyficzne wymagania tych aplikacji, oferując wysoką przepustowość obliczeniową, duże pojemności pamięci i zaawansowane funkcje, takie jak pamięć z kodem korekcji błędów (ECC). Choć mniej popularne niż ich odpowiedniki z pojedynczym procesorem graficznym, te dwuprocesorowe karty Tesla stanowiły potężne, choć niszowe, rozwiązanie w obliczeniach korporacyjnych.
Pojawienie się NVLink
Poznaj NVLink, wprowadzony wraz z architekturą Volta firmy NVIDIA w 2017 roku. Technologia ta nie była jedynie ulepszeniem, ale gruntownym przeobrażeniem sposobu łączenia procesorów graficznych. NVLink oferował znacznie wyższą przepustowość (do 900 GB/s w najnowszych wersjach), niższe opóźnienia oraz topologię siatki, która umożliwiała bardziej złożone i liczne połączenia między procesorami graficznymi. Co więcej, NVLink wprowadził koncepcję pamięci ujednoliconej, umożliwiając łączenie pamięci między połączonymi procesorami graficznymi, co jest kluczową funkcją w przypadku zadań wymagających dużych zbiorów danych.
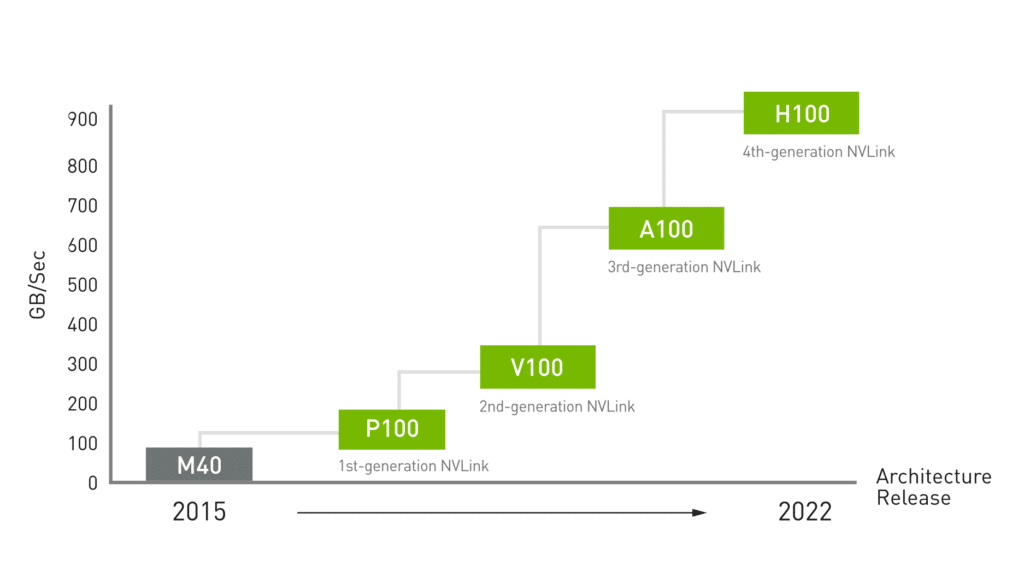
Ewolucja wydajności NVLink
SLI kontra NVLink
Na pierwszy rzut oka NVLink może wydawać się „SLI na sterydach”, ale byłoby to zbytnie uproszczenie. Chociaż obie technologie mają na celu połączenie wielu procesorów graficznych, NVLink został zaprojektowany z myślą o innej grupie odbiorców. Został stworzony do badań naukowych, analizy danych, a przede wszystkim do zastosowań w sztucznej inteligencji i uczeniu maszynowym. Większa przepustowość, niższe opóźnienia i ujednolicona pamięć sprawiają, że NVLink jest znacznie bardziej elastycznym i wydajnym rozwiązaniem dla współczesnych wyzwań obliczeniowych.
Techniczny kręgosłup NVLink
NVLink stanowi logiczną ewolucję technologii połączeń między wieloma procesorami graficznymi (Multi-GPU), nie tylko pod względem szybkości, ale także architektury. Struktura NVLink składa się z szybkich linii danych, które umożliwiają dwukierunkową transmisję danych. W przeciwieństwie do tradycyjnych systemów opartych na magistrali, NVLink wykorzystuje połączenie punkt-punkt, skutecznie redukując wąskie gardła i poprawiając przepustowość danych. Najnowsze wersje oferują przepustowość do 900 GB/s, co stanowi znaczną poprawę w porównaniu z możliwościami SLI.
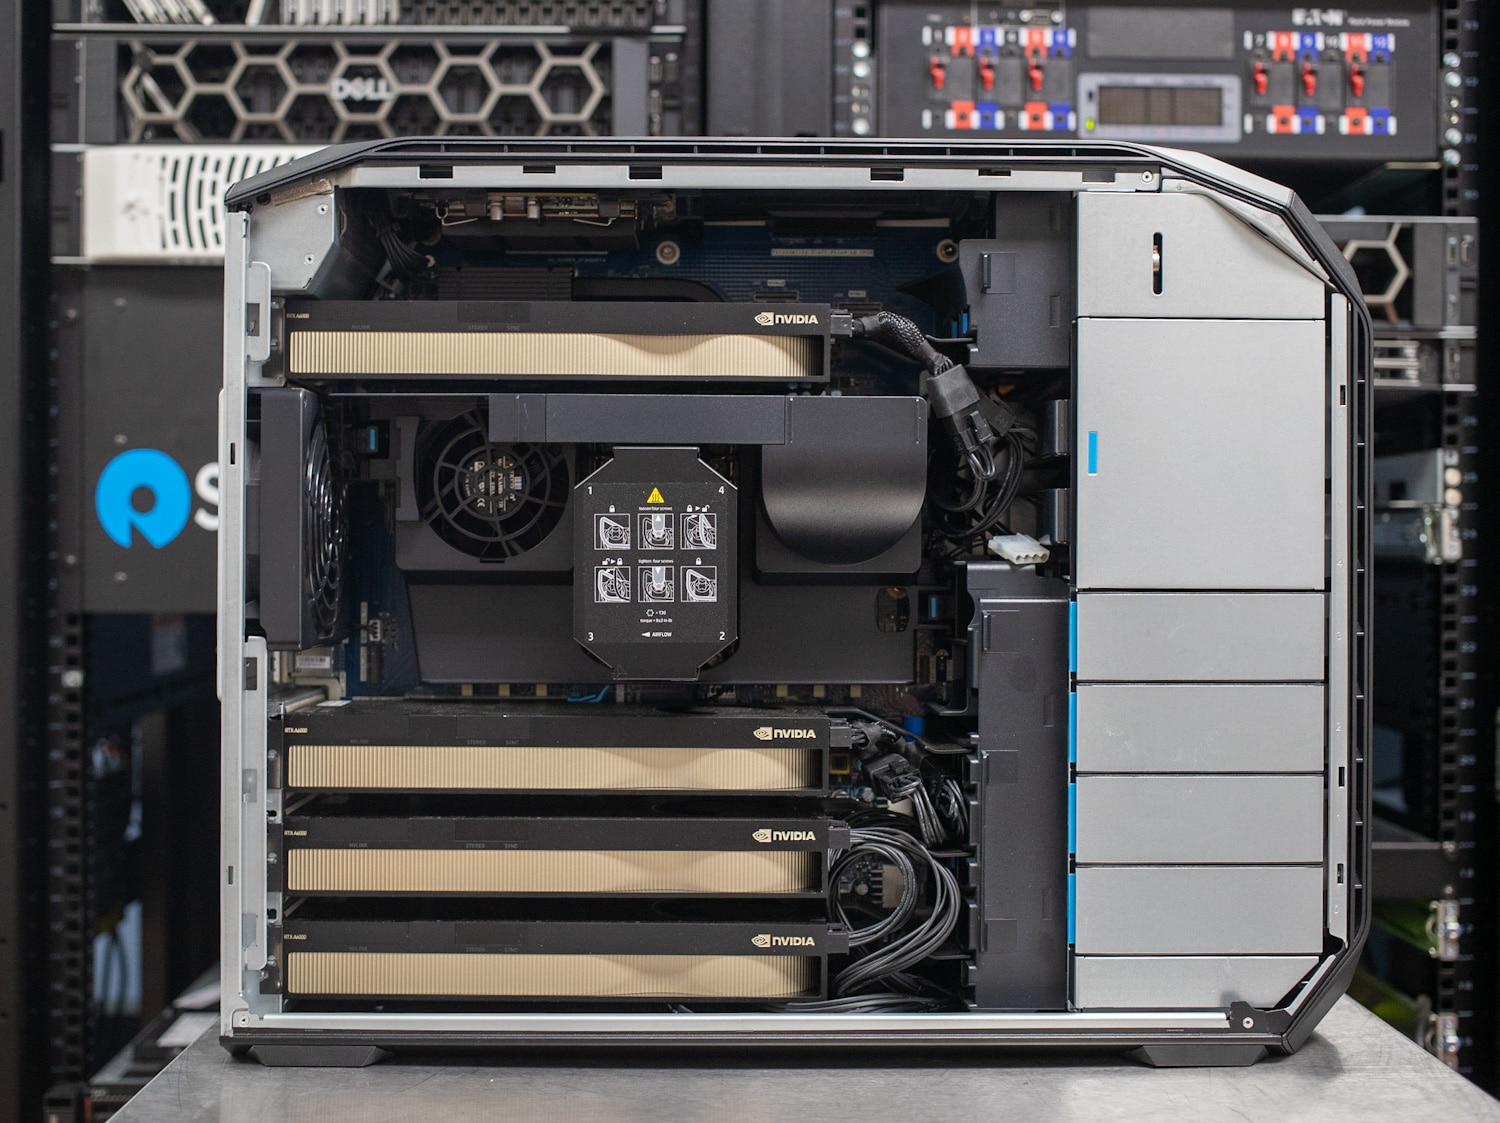
HP Z8 Fury G5 z 4 kartami graficznymi A6000
Jedną z kluczowych cech wyróżniających NVLink jest możliwość obsługi topologii siatki (mesh). W przeciwieństwie do topologii szeregowej (daisy-chain) lub hub-and-spoke stosowanych w starszych technologiach, konfiguracja siatki (mesh) pozwala na bardziej wszechstronne i liczne połączenia między procesorami graficznymi (GPU). Jest to szczególnie przydatne w centrach danych i aplikacjach o wysokiej wydajności, gdzie złożone trasy danych są normą.
Kolejną cechą NVLink jest ujednolicona pamięć. Pozwala ona procesorom GPU na współdzielenie wspólnej puli pamięci, co przekłada się na efektywniejsze współdzielenie danych i ogranicza konieczność kopiowania danych między procesorami GPU. To ogromne ułatwienie dla aplikacji takich jak uczenie maszynowe i analiza dużych zbiorów danych, gdzie duże zbiory danych często przekraczają pojemność pamięci pojedynczego procesora GPU.
NVLink redukuje również opóźnienia, co jest kluczowym czynnikiem w każdej konfiguracji obliczeniowej o wysokiej wydajności. Niższe opóźnienia zapewniają szybszy transfer danych i synchronizację między procesorami graficznymi, co przekłada się na wydajniejsze obliczenia równoległe. Jest to możliwe dzięki możliwościom bezpośredniego dostępu do pamięci (DMA) NVLink, które umożliwiają procesorom graficznym odczyt i zapis danych bezpośrednio do pamięci drugiej osoby, bez angażowania procesora głównego.
Wpływ na sztuczną inteligencję i uczenie maszynowe
Biorąc pod uwagę rosnące znaczenie sztucznej inteligencji (AI) we współczesnej informatyce, zalety NVLinka nie tylko rosną, ale wręcz transformują. W procesie trenowania modeli AI i tworzenia danych, NVLink umożliwia szybszy transfer danych między procesorami GPU, umożliwiając wydajniejsze przetwarzanie równoległe. Jest to szczególnie korzystne podczas pracy z dużymi zbiorami danych treningowych, co jest ściśle powiązane z rozwijającą się dziedziną tworzenia danych treningowych modeli AI.
Wraz z rosnącym zapotrzebowaniem na zaawansowane obliczenia, takie jak symulacje kwantowe, analityka w czasie rzeczywistym i algorytmy sztucznej inteligencji nowej generacji, możemy spodziewać się dalszych udoskonaleń w zakresie możliwości NVLinka. Niezależnie od tego, czy chodzi o zwiększenie przepustowości, czy nowe funkcje, które umożliwią jeszcze lepszą współpracę między procesorami graficznymi, NVLink lub jego następca niewątpliwie pozostaną kluczowe dla zaspokojenia potrzeb obliczeniowych przyszłości.
Przejście z SLI na NVLink stanowi ważny kamień milowy dla technologii multi-GPU. Odzwierciedla ono zaangażowanie firmy NVIDIA w innowacje i dogłębne zrozumienie zmieniającego się krajobrazu obliczeniowego. Od gier po sztuczną inteligencję, od aplikacji konsumenckich po centra danych – korzenie NVLink w grach i SLI pokazują, jak konieczność rodzi innowację, napędzając rozwój technologii w niekończącym się cyklu udoskonaleń.


 Amazon