

Dyski SSD NVMe przejmują centra danych, szybko umacniając swoją pozycję jako technologia docelowa dla aplikacji o znaczeniu krytycznym. Interfejs NVMe umożliwia swobodne działanie pamięci flash, pokonując wąskie gardła starszych interfejsów SATA i SAS. Usunięcie ograniczeń związanych z pamięcią flash wprowadza jednak nowe wyzwania architektoniczne, których nie da się łatwo rozwiązać za pomocą tradycyjnych układów serwerów kart HBA/RAID. Firma Intel rozwiązała ten problem, oferując uproszczone rozwiązanie do zarządzania dyskami SSD NVMe w serwerach. Wirtualny RAID na procesorze (ang. Virtual RAID on CPU), w skrócie Intel VROC, zasadniczo umożliwia dyskom SSD bezpośredni dostęp do procesorów, całkowicie eliminując potrzebę stosowania kontrolera HBA. To znacznie upraszcza zarówno ścieżkę danych, jak i komponenty niezbędne do pełnego wykorzystania możliwości dysków SSD NVMe w serwerach. Oprócz RAID klasy korporacyjnej, Intel VROC zapewnia oczekiwaną łatwość serwisowania, jakiej wymagają przedsiębiorstwa, w tym zarządzanie RAID przed uruchomieniem systemu, obsługę hot plug i zarządzanie diodami LED.
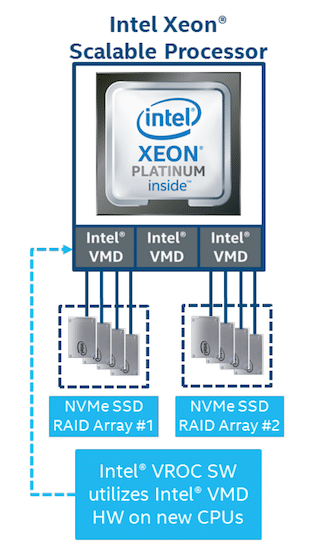
Aby lepiej zrozumieć technologię Intel VROC, ważne jest zrozumienie innej technologii o nazwie Intel Volume Management Device (Intel VMD). Kompatybilny z najnowszymi procesorami Intel Xeon Scalable, Intel VMD to zintegrowany kontroler wewnątrz głównego systemu PCIe procesora. W rezultacie Intel VMD umożliwia obsługę większej lub mniejszej liczby wirtualnych kontrolerów HBA dla podłączonych dysków SSD NVMe. Jest to istotne, ponieważ Intel VMD oferuje kluczowe funkcje serwisowania dysków, które są uproszczone bez utraty niezawodności. Dzięki Intel VMD dyski SSD NVMe można wymieniać „na gorąco” bez przerywania pracy systemu ani restartu. Intel VMD przekierowuje zdarzenia związane z wkładaniem i wyjmowaniem dysków na magistrali PCIe do sterowników obsługujących macierz RAID, które obsługują te zdarzenia i inicjują automatyczną odbudowę. W przypadku awarii kluczowe jest również określenie, który dysk należy wyjąć, co może być trudne w centrach danych z dziesiątkami lub setkami dysków i niespójnymi praktykami etykietowania wnęk dysków różnych producentów. Intel VMD obsługuje zarządzanie diodami LED NVMe, co jest zgodne ze specyfikacją wskaźników świetlnych dysków, z której od lat korzystają dyski SATA i SAS, ułatwiając identyfikację i serwisowanie dysku SSD w razie potrzeby. Technologia Intel VMD jest również szeroko wspierana w branży. Przykładowo firma VMware obsługuje natywnie sterownik Intel VMD NVMe w wersji VMware ESXi 6.7, co obejmuje obsługę zarządzania dyskami SSD NVMe w sieciach vSAN.
Technologia Intel VROC bazuje na technologii Intel VMD, wprowadzając RAID dysków SSD NVMe. Obecnie pojedynczy procesor Xeon Scalable obsługuje do 12 bezpośrednio podłączonych dysków NVMe i do 6 macierzy RAID. System dwuprocesorowy obsługuje odpowiednio 24 i 12 dysków. Procesor może jednak wykorzystać przełączniki do obsługi do 48 dysków SSD w systemie. Technologia Intel VROC obsługuje woluminy danych i woluminy rozruchowe, co historycznie było trudne do osiągnięcia w przypadku dysków NVMe. Ustawienia RAID można konfigurować za pomocą BIOS-u lub interfejsu CLI, a Intel obsługuje zarządzanie lokalne lub zdalne za pośrednictwem agenta RESTful.
Intel VROC jest sprzedawany jako klucz fizyczny; dostępne są trzy wersje SKU. Wersja Standard obsługuje RAID 0/1/10 z obsługą dysków SSD innych firm. Licencja Premium dodaje obsługę RAID5. Dostępna jest również licencja Intel SSD Only, która, jak sama nazwa wskazuje, obsługuje tylko dyski Intel, ale oferuje pełen zakres opcji RAID.
Oprócz licencji, dysków SSD NVMe i procesorów Xeon Scalable, potrzebny jest kompatybilny serwer. Chociaż technologia Intel VROC jest powszechnie obsługiwana, niektórzy producenci serwerów preferują własne technologie oparte na kartach do zarządzania dyskami zamiast tej nowocześniejszej alternatywy. W tej recenzji nawiązaliśmy współpracę z firmą EchoStreams, która obsługuje technologię Intel VROC we wszystkich swoich liniach serwerów pamięci masowej.
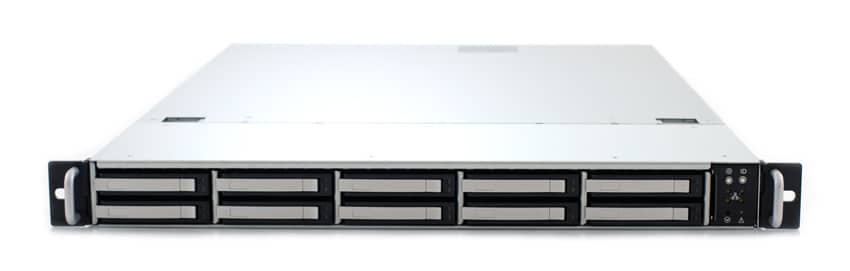
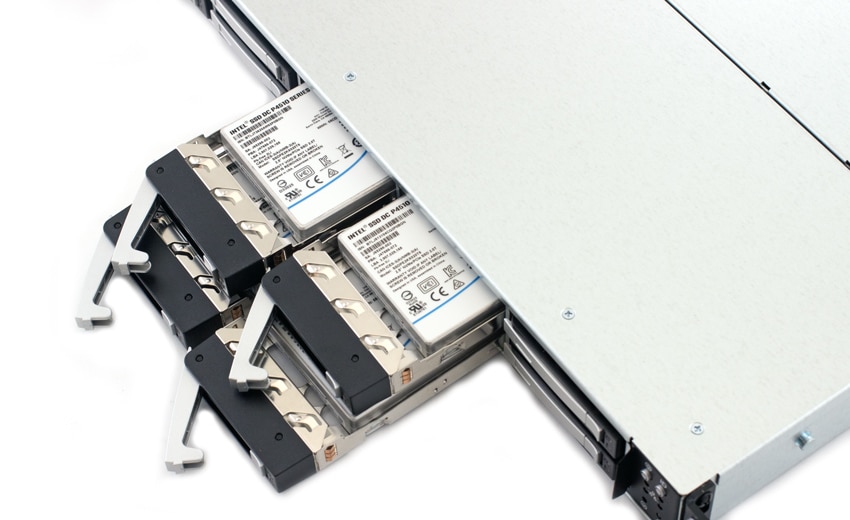
Jak na tak małą obudowę, serwer EchoStreams FlacheSAN1N10U-D5 jest niezwykle elastyczny. W naszej konfiguracji serwer jest wyposażony w dwa procesory Intel 8180M, 64 GB pamięci RAM i osiem dysków SSD Intel DC P4510 NVMe o pojemności 2 TB . Serwer oferuje trzy gniazda PCIe 3.0 x16, co pozwala użytkownikom na pełne wykorzystanie potencjału wewnętrznej pojemności pamięci masowej, z maksymalnie 160 TB pamięci flash NVMe (10 dysków SSD o pojemności 16 TB) i trzema kartami sieciowymi Ethernet 100 Gb/s.
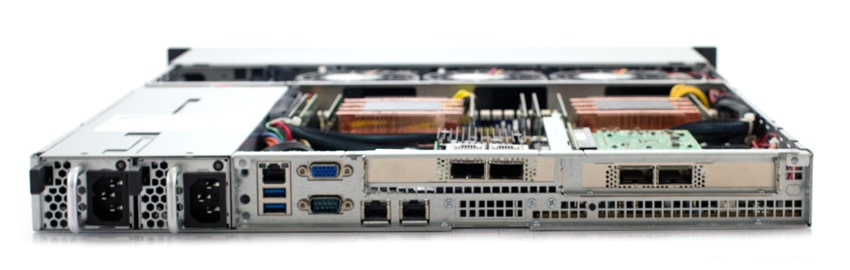
Konstrukcja obudowy pozwala również na symetryczny układ obu procesorów, dysków SSD NVMe i kart sieciowych. Jako rozwiązanie typu whitebox, obudowa może być również dostosowana do potrzeb użytkownika końcowego, obsługując inne rozmiary dysków SSD, takie jak 15 mm i 7 mm U.2, a także wewnętrzne dyski SSD M.2 i technologię Intel Optane. Serwer można skonfigurować z podwójnym zasilaczem AC o mocy 850 W lub skonfigurować do obsługi zasilaczy o wysokiej sprawności 48 V DC. Biorąc pod uwagę zaawansowane procesory Intel w naszej konfiguracji, większe zasilacze okazały się bardzo przydatne.
Analizując potencjał FlacheSAN1N10U-D5 w zakresie wartości dodanej, EchoStreams wskazuje na sieci dostarczania treści (CDN) jako główny przykład zastosowania. Obecnie klienci wykorzystują te węzły jako urządzenia buforujące w centrach danych lub lokalizacjach brzegowych, aby dostarczać popularne treści użytkownikom końcowym. Kilka uniwersytetów wykorzystuje platformę również do obliczeń o wysokiej wydajności (HPC) i badań, gdzie moc obliczeniowa i przepustowość pamięci masowej stanowią kluczową przewagę w rozwiązywaniu złożonych problemów. Poza tymi scenariuszami serwer doskonale sprawdza się również w postprodukcji mediów i rozrywki, a także dobrze współpracuje z rozwiązaniami pamięci masowej definiowanej programowo, które mogą korzystać z pamięci masowej NVMe i szybkich sieci.
Specyfikacje EchoStreams FlacheSAN1N10U-UN
| Budowa | 1U |
| CPU | Obsługuje dwugniazdowy procesor Intel Xeon Scalable LGA3647 |
| chipset | Intel C622 |
| RAM | DDR4 do 1.5 TB RDIMM/RDIMM/LRDIMM 2666/2400 MHz |
| Gniazda DIMM | Do 16 |
| wnęki na napędy |
|
| Interfejs I / O |
|
| Gniazda rozszerzeń |
|
| Płyta montażowa | 5 x 2-zatokowych płyt głównych NVMe |
| obsługiwane systemy operacyjne |
|
| Zasilanie |
|
| Fizyczny |
|
| Środowiskowy |
|
Użyteczność i wdrażanie
Płyta główna nie posiada rozbudowanego graficznego interfejsu użytkownika do konfiguracji Intel VROC, ale jest ona z pewnością przyjazna dla użytkownika. Dla administratorów IT, którzy mogą być zaznajomieni z używaniem poleceń mdadm z konsoli, Intel VROC automatyzuje większość zadań back-endowych, upraszczając konfigurację. Choć nie jest przeładowany bajerami, nie sprawi trudności większości specjalistów IT. Z poziomu ekranu BIOS-u użytkownicy mogą skonfigurować woluminy RAID, jednocześnie obserwując dostępne dyski fizyczne.
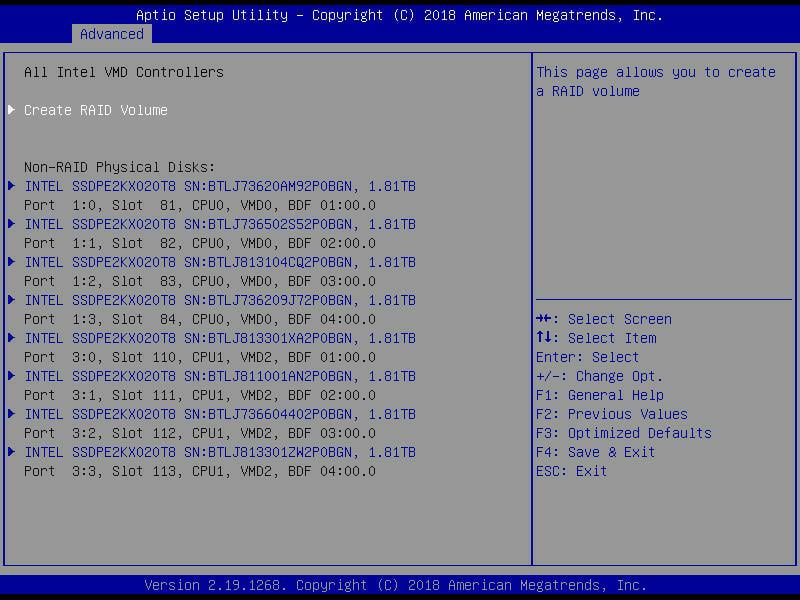
Następnie można nadać nazwę woluminowi (w tym przypadku wolumen 0), wybrać poziom RAID i włączyć RAID rozciągnięty na oba kontrolery Intel VMD.
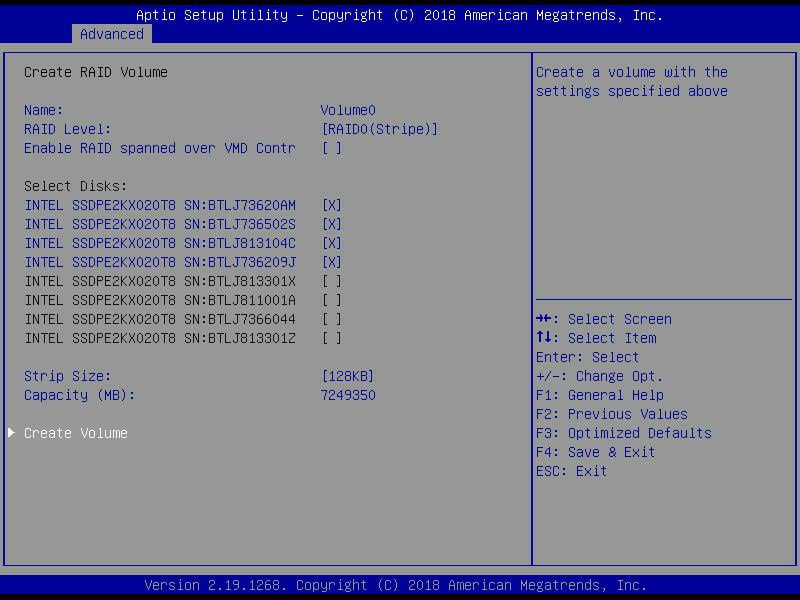
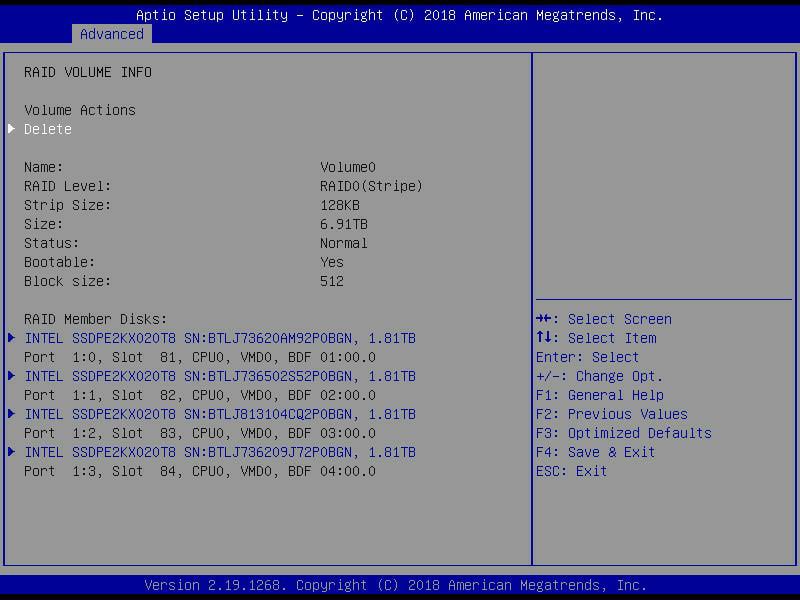
Po skonfigurowaniu macierzy RAID można sprawdzić działania dotyczące woluminów, np. usunąć wolumin RAID lub uczynić go bootowalnym.
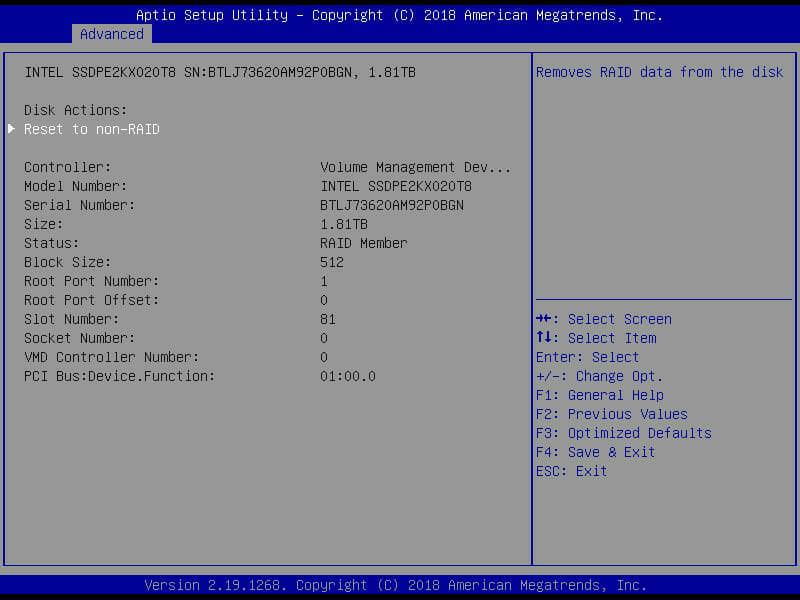
Na koniec użytkownicy mogą wykonać czynności związane z dyskami, takie jak resetowanie do trybu bez RAID lub usuwanie danych RAID z dysków.
Po uruchomieniu systemu w środowisku CentOS 7.4 konfiguracja woluminów RAID była gotowa i czekała na nas. W przypadku woluminów RAID5/10 można śledzić postęp inicjalizacji w tle za pomocą programu mdstat lub ręcznie zmienić całą grupę RAID, jeśli zajdzie taka potrzeba. Konfiguracja na poziomie BIOS-u eliminuje znaczną część prac przygotowawczych związanych z uruchomieniem RAID, ale nie usuwa jej ani nie zastępuje dla użytkowników, którzy chcą uzyskać dodatkowy poziom personalizacji.
Wydajność
Analiza obciążenia VDBench
W przypadku testów porównawczych macierzy pamięci masowej, testy aplikacji są najlepsze, a testy syntetyczne plasują się na drugim miejscu. Chociaż nie odzwierciedlają one idealnie rzeczywistych obciążeń, testy syntetyczne pomagają w ustaleniu punktu odniesienia dla urządzeń pamięci masowej, zapewniając powtarzalność, która ułatwia bezpośrednie porównanie konkurencyjnych rozwiązań. Obciążenia te oferują szereg różnych profili testowych, od testów „czterech kątów”, przez testy rozmiaru transferu baz danych, po przechwytywanie śladów z różnych środowisk VDI. Wszystkie te testy wykorzystują generator obciążeń vdBench z silnikiem skryptowym do automatyzacji i przechwytywania wyników w dużym klastrze obliczeniowym. Pozwala to na powtarzanie tych samych obciążeń dla szerokiej gamy urządzeń pamięci masowej, w tym macierzy flash i pojedynczych urządzeń pamięci masowej.
Profile:
- Losowy odczyt 4K: 100% odczytu, 128 wątków, 0-120% ioratu
- 4K losowy zapis: 100% zapisu, 64 wątki, 0-120% ioracji
- 64K Sekwencyjny odczyt: 100% odczytu, 16 wątków, 0-120% ioracji
- 64K Sekwencyjny zapis: 100% zapisu, 8 wątków, 0-120% ioratu
- Syntetyczna baza danych: SQL i Oracle
- Ślady pełnego klonu VDI i klonów powiązanych
W tej serii testów VDBench przeprowadzimy standardowe testy, jednak zamiast jednego urządzenia (np. dysku SSD, serwera lub macierzy) uruchomimy wiele konfiguracji zbalansowanych na obu procesorach:
- 8 dysków w JBOD
- Dwie grupy po cztery dyski SSD w RAID0
- Dwie grupy po cztery dyski SSD w RAID5
- Dwie grupy po cztery dyski SSD w RAID10
Poniższe dane stanowią sumę 8 dysków SSD użytych w każdej konfiguracji. Dane te mają jedynie na celu podkreślenie możliwości tej platformy w różnych konfiguracjach obsługiwanych przez technologię Intel VROC. Należy zauważyć, że RAID5 charakteryzuje się niższą wydajnością zapisu w trakcie tej recenzji ze względu na złożoność obliczeń parzystości i aktualizacji, co jest oczekiwane na podstawie porównań poziomów RAID.
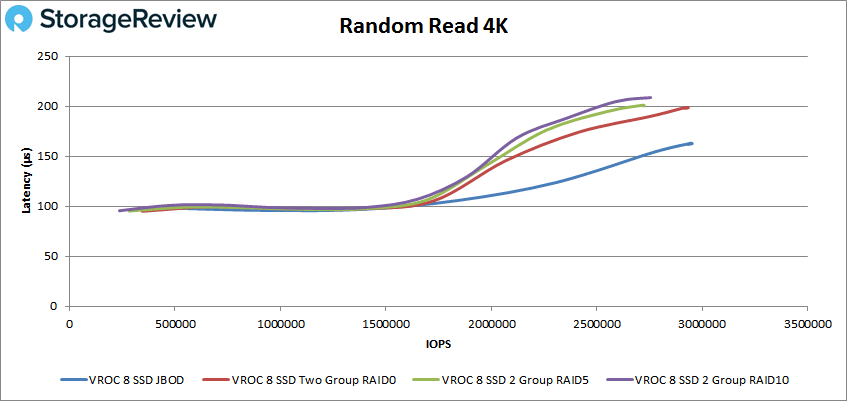
W przypadku szczytowej wydajności losowej 4K wszystkie grupy RAID utrzymały opóźnienie poniżej 1 ms (w rzeczywistości wszystkie grupy miały opóźnienie poniżej 210 μs). Wszystkie grupy uzyskały od 2.5 do 3 milionów IOPS, a najwyższą wydajność uzyskała grupa JBOD z wynikiem 2 944 335 IOPS i opóźnieniem 163 μs.
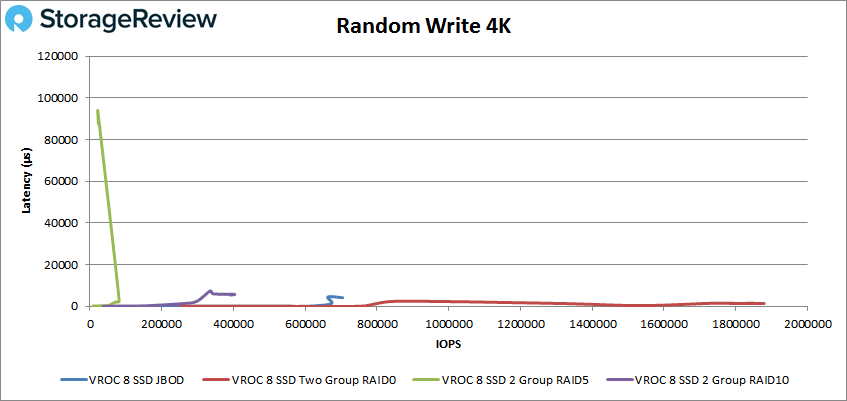
Losowy zapis 4K nie wykazywał takiej samej spójności w przypadku różnych grup RAID. Grupa RAID5 miała najniższą wydajność, osiągając szczyt 21 921 IOPS i opóźnienie 936.7 ms. Pozostałe grupy RAID radziły sobie lepiej, a grupa RAID0 osiągnęła szczyt 1 879 180 IOPS i opóźnienie 1.35 ms.
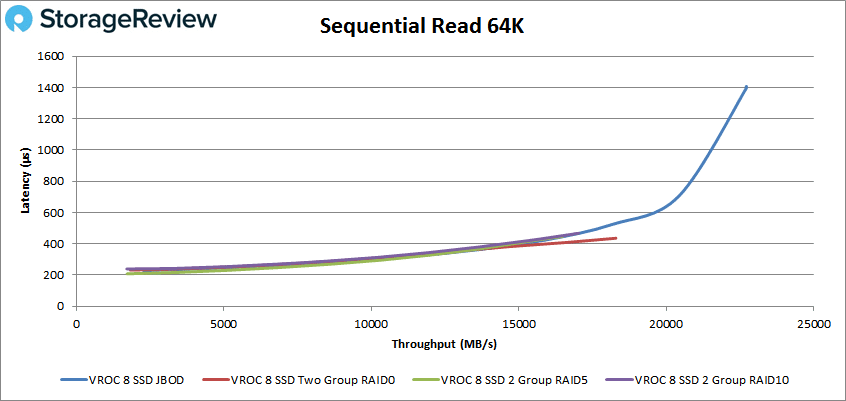
Po przełączeniu na obciążenia sekwencyjne odczyt 64 KB wykazał, że wszystkie grupy RAID zaczynają z dużym opóźnieniem poniżej milisekundy, a jedynie grupa JBOD przekracza 1 ms przy 330 tys. operacji wejścia/wyjścia na sekundę (IOPS) lub 22 GB/s, osiągając szczyt na poziomie 363 203 operacji wejścia/wyjścia na sekundę (IOPS) lub 22.7 GB/s przy opóźnieniu wynoszącym zaledwie 1.4 ms.
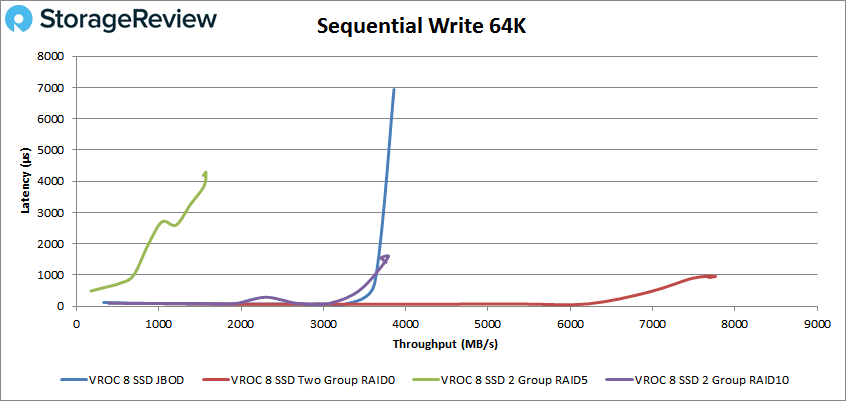
Ponownie podczas zapisu grupy RAID rozpadają się, oferując bardzo zróżnicowaną wydajność. Grupa RAID5 ponownie osiągnęła poziom około 25 tys. IOPS z opóźnieniem 4.3 ms, a RAID0 osiągnął 124 104 IOPS z opóźnieniem 958 μs.
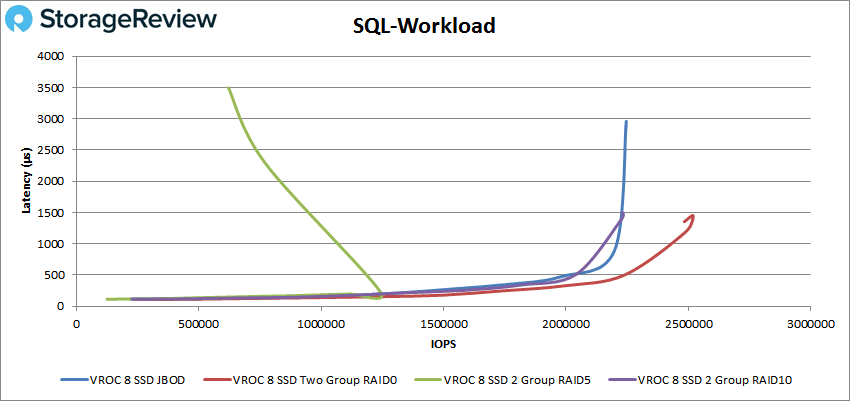
Następnie mamy obciążenia SQL. Wszystkie grupy RAID osiągały opóźnienia poniżej milisekundy aż do około 1.4 miliona IOPS. W tym przypadku grupa RAID5 odnotowała gwałtowny wzrost opóźnień, a następnie spadek wydajności. Pozostałe trzy grupy utrzymywały się poniżej 1 ms, aż wszystkie przekroczyły 2 miliony IOPS. Najwyższe wyniki ponownie osiągnęła grupa RAID0, osiągając szczytową wydajność 2 519 727 IOPS przy opóźnieniu 1.45 ms.
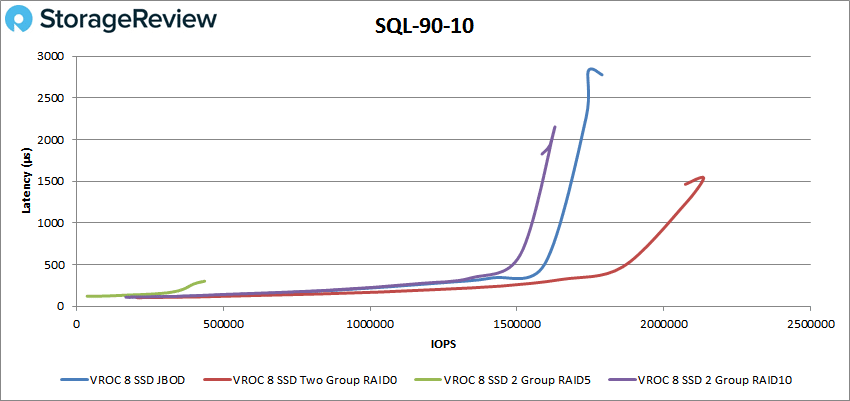
W przypadku SQL 90-10 zaobserwowaliśmy lepszy profil opóźnień dla grupy RAID5, ze szczytem 302 μs, ale jej szczytowa wydajność wyniosła zaledwie 436 439 IOPS. Pozostałe grupy osiągnęły ponad 1.5 miliona IOPS, zanim przekroczyły 1 ms, a grupy JBOD i RAID10 osiągnęły szczyt wkrótce potem. Grupa RAID0 osiągnęła szczyt na poziomie 2 135 362 IOPS z opóźnieniem 1.54 ms.
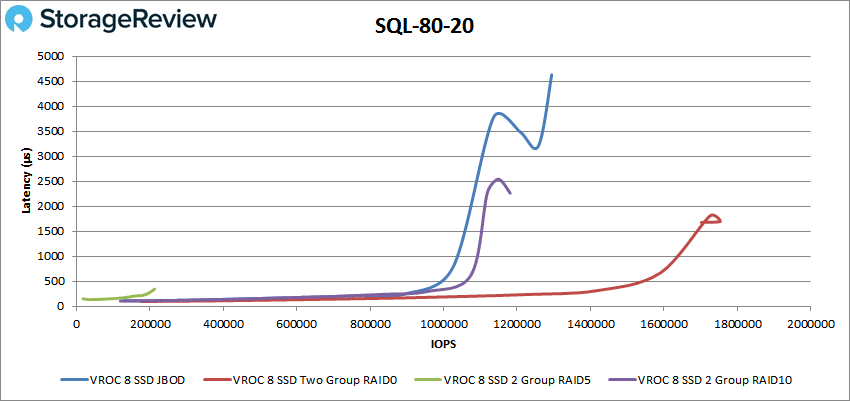
Ponownie w SQL 80-20, grupa RAID5 osiągnęła opóźnienie poniżej milisekundy przy niższej wydajności w porównaniu z pozostałymi, 345 μs przy 212 980 IOPS. Pozostałe grupy osiągnęły 1 milion IOPS poniżej 1 ms, a JBOD i RAID10 ponownie osiągnęły szczyt wkrótce potem, a RAID0 osiągnął szczyt na poziomie 1 753 622 IOPS przy opóźnieniu 1.7 ms.
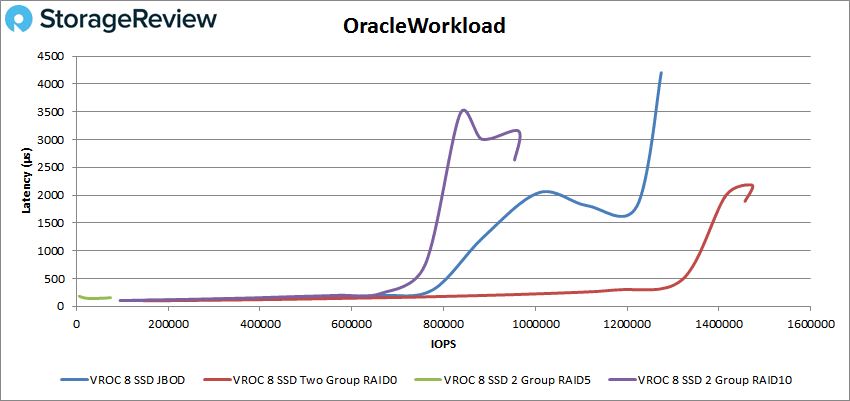
Nasze testy porównawcze Oracle, co nie jest zaskakujące, dały nam podobne wyniki. Grupa RAID5 osiągnęła szczyt na poziomie 61 695 IOPS z opóźnieniem 153 μs. Pozostałe dyski osiągnęły łącznie około 780 tys. IOPS w czasie krótszym niż 1 ms, zanim RAID10 przekroczył ten limit i osiągnął szczyt (954 567 IOPS z opóźnieniem 2.63 ms), następnie JBOD (osiągając szczyt na poziomie 1 274 172 IOPS z opóźnieniem 4.2 ms), a na końcu grupa RAID0 ze szczytem 1 472 338 IOPS z opóźnieniem 2.18 ms.
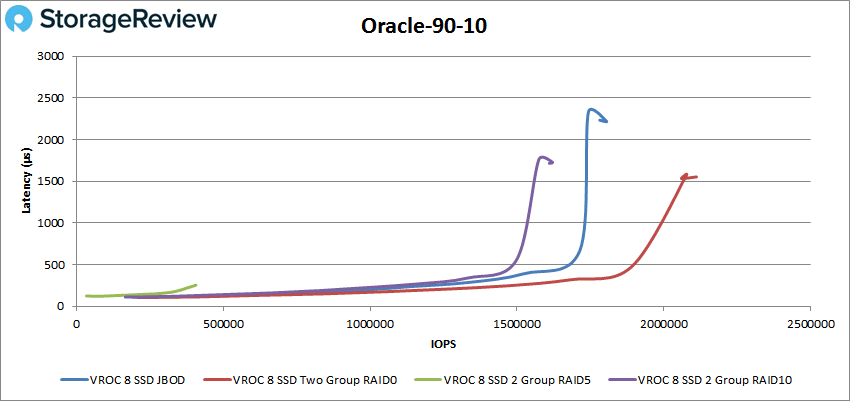
Oracle 90-10 odnotował szczytowy wynik dla grupy RAID5 – 406 693 IOPS i opóźnienie 255 μs. Pozostałe grupy miały opóźnienia poniżej milisekundy, aż do przekroczenia 1.5 miliona IOPS i osiągnęły szczyt w ten sam sposób, co obserwujemy: RAID10, JBOD i RAID0 z najwyższymi wynikami – 2 110 799 IOPS i opóźnieniem 1.55 ms.
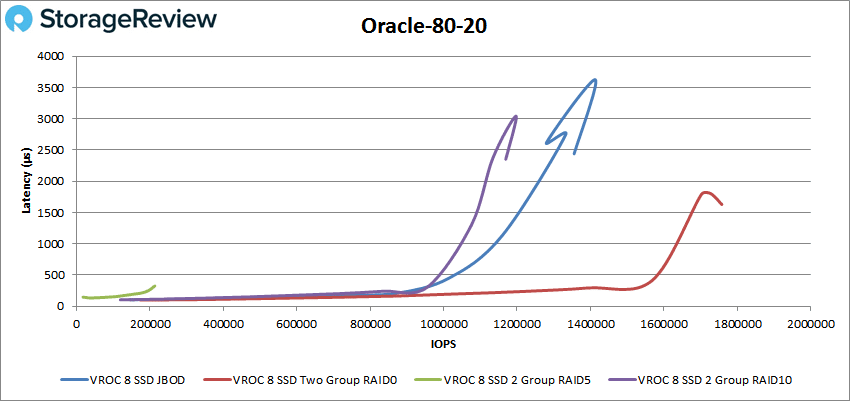
W przypadku Oracle 80-20 grupa RAID5 osiągnęła szczyt na poziomie 213 479 IOPS i opóźnieniu 327 μs. Pozostałe grupy osiągnęły ponad milion IOPS, zanim osiągnęły szczyt, a RAID0 osiągnął 1.65 miliona IOPS przy czasie poniżej 1 ms i 1 757 722 IOPS z opóźnieniem 1.63 ms.
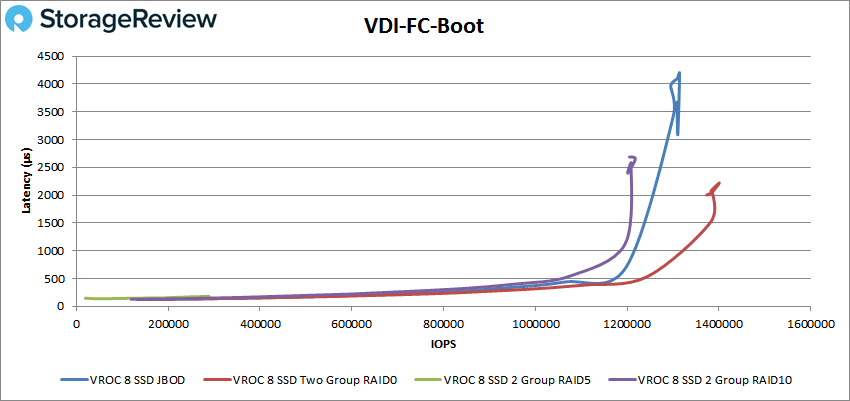
Następnie przeszliśmy do testu klonowania VDI, pełnego i połączonego. Tutaj nadal widzimy ten sam znany schemat rozmieszczenia dla różnych grup RAID: RAID5, RAID10, JBOD i RAID0. W przypadku rozruchu pełnego klonu VDI, grupa RAID5 osiągnęła szczyt na poziomie 288 613 IOPS z opóźnieniem 182 μs. Pozostałe grupy osiągnęły prawie 1.2 miliona IOPS z opóźnieniem poniżej milisekundy, zanim najpierw grupa RAID10 osiągnęła 1 217 620 IOPS z opóźnieniem 2.65 ms, następnie grupa JBOD z 1 314 075 IOPS z opóźnieniem 4.19 ms, a następnie grupa RAID0 z 1 400 765 IOPS z opóźnieniem 2.22 ms.
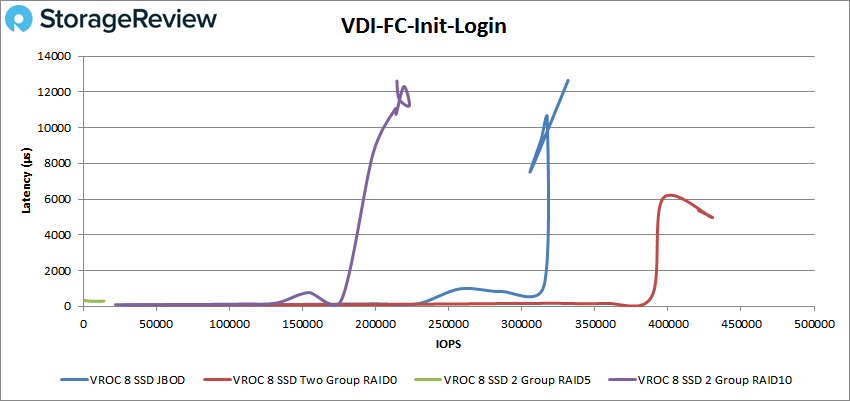
Po początkowym zalogowaniu do VDI FC, grupa RAID5 osiągnęła bardzo krótki czas, osiągając 13 296 IOPS i opóźnienie 286 μs. Pozostałe dyski osiągnęły 175 tys. IOPS, zanim przekroczono granicę 1 ms. Grupa RAID0 osiągnęła 390 tys. IOPS z opóźnieniem poniżej milisekundy i osiągnęła szczyt na poziomie 429 692 IOPS z opóźnieniem 4.98 ms.
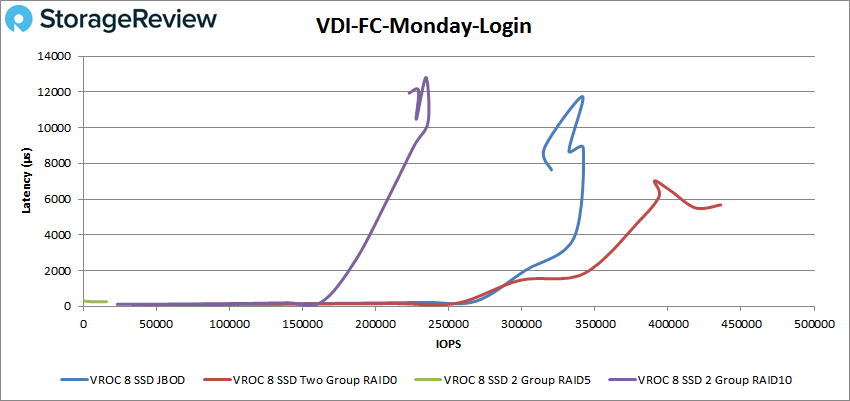
Po zalogowaniu VDI FC Monday grupa RAID5 osiągnęła szczyt 15 tys. operacji wejścia/wyjścia na sekundę (IOPS) z czasem 262 μs. Pozostałe grupy RAID przekroczyły 150 tys., zanim przekroczyły 1 ms. Grupa RAID10 i JBOD odnotowały dość wysokie opóźnienie, odpowiednio 12.8 ms i 11.7 ms. Mimo to wydajność była imponująca: 234 431 operacji wejścia/wyjścia na sekundę (IOPS) i 341 483 operacji wejścia/wyjścia na sekundę (IOPS). Grupa RAID0 uzyskała najlepszą ogólną wydajność z wynikiem 435 641 operacji wejścia/wyjścia na sekundę (IOPS) i opóźnieniem 5.67 ms.
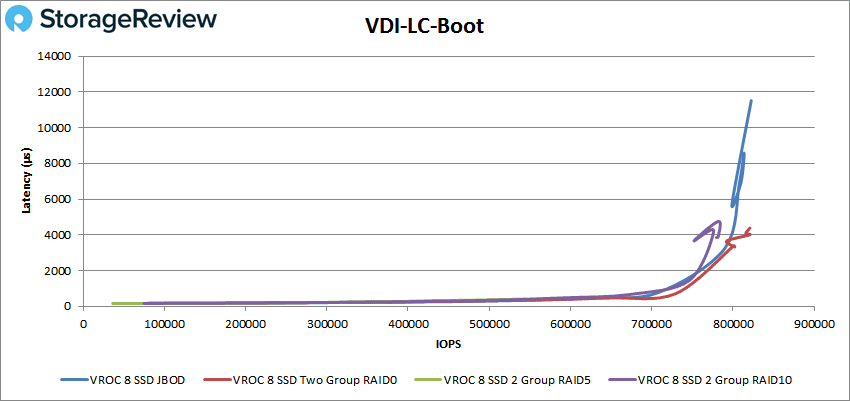
Przechodząc do naszych testów VDI Linked Clone, zauważyliśmy znacznie lepszą wydajność wszystkich grup w naszym rozruchu, przy czym grupa RAID5 osiągnęła szczyt na poziomie 543 680 IOPS i opóźnieniu 407 μs, RAID10 osiągnął szczyt na poziomie 782 224 z opóźnieniem 4.76 ms, JBOD osiągnął szczyt na poziomie 822 555 IOPS z opóźnieniem 11.52 ms, a RAID0 osiągnął szczyt na poziomie 820 998 IOPS z opóźnieniem 4.39 ms.
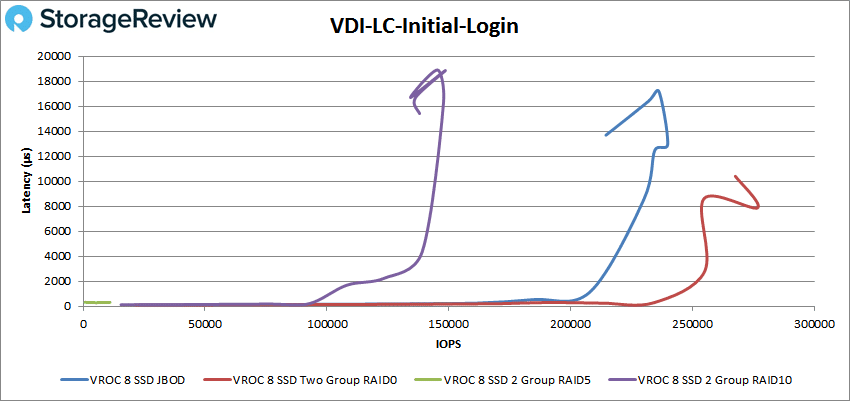
Przy początkowym logowaniu do VDI LC obserwujemy szczytową wydajność od 10 998 IOPS z opóźnieniem 312 μs w przypadku RAID5 do 276 814 IOPS z opóźnieniem 7.88 ms w przypadku RAID0.
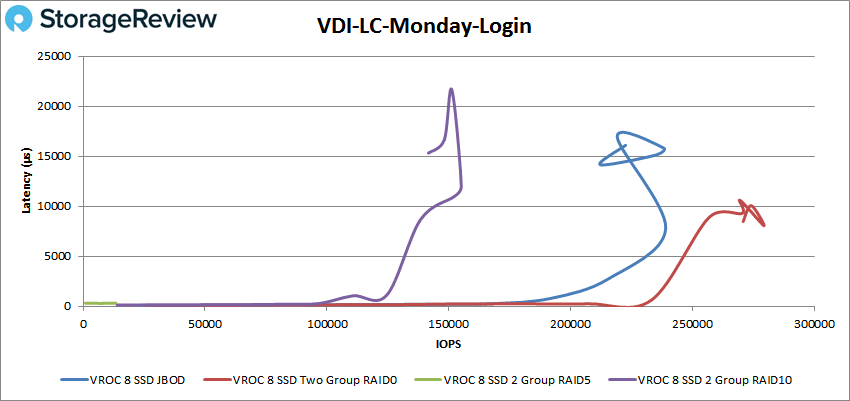
Wreszcie, wraz z poniedziałkowym logowaniem do VDI LC, nadal widzimy, że RAID5 zajmuje pierwsze miejsce (11 591 IOPS przy 315 μs), a za nim RAID10 (około 155 tys. IOPS przy 1.2 ms w szczycie), potem JBOD (około 238 tys. IOPS przy 15.8 ms w szczycie) i na końcu RAID0 (279 332 IOPS przy 8.06 ms).
Wniosek
Analizując wydajność Intel VROC na platformie EchoStreams 1U, przyjrzeliśmy się czterem różnym grupom testowym, z których każda korzystała z zagregowanych danych z 8 dysków SSD Intel P4510 NVMe. Łatwo jest ogłosić RAID0 „zwycięzcą” w tej grupie, ale jest to zrozumiałe ze względu na sposób działania RAID. Analizując wyniki wydajności od dołu do góry, jak zauważono na początku, RAID5 ma duży spadek redundancji danych przy obliczeniach parzystości, co wyraźnie odzwierciedlają dane. RAID10 wykorzystuje dublowanie, więc spadek redundancji jest znacznie niższy, a tym samym wyniki znacznie przewyższają RAID5. Za tą grupą znajduje się JBOD z zagregowaną wydajnością pass-thru. RAID0 prowadzi w liczbach, ponieważ koncentruje się wyłącznie na wydajności i wykorzystuje zalety dysków pracujących wspólnie poprzez striping danych, ale poświęca odporność danych. Wszystkie dane, z perspektywy funkcjonalności RAID, potwierdzają fakt, że Intel VROC jest dobrze zaimplementowany i zapewnia spójne i oczekiwane wyniki na dobrze zaprojektowanej platformie.
Zamiast szczegółowo omawiać każdy wynik (przy czterech grupach wygeneruje to łącznie 64 wyniki), przyjrzymy się kilku najważniejszym punktom. W naszym teście 4K zaobserwowaliśmy, że grupa JBOD osiągnęła prawie 3 miliony IOPS przy opóźnieniu odczytu poniżej milisekundy, a RAID0 osiągnął 1.9 miliona IOPS przy opóźnieniu zaledwie 1.35 ms. W przypadku sekwencyjnego 64K zaobserwowaliśmy wartości sięgające 22.7 GB/s odczytu i 7.8 GB/s zapisu. Nasze testy SQL wykazały 2.5 miliona IOPS, 2.1 miliona IOPS dla 90-10 i 1.75 miliona IOPS dla 80-20, wszystkie z opóźnieniem poniżej 1.7 ms. Oracle odnotował 1.47 miliona IOPS, 2.1 miliona IOPS dla 90-10 i 1.76 miliona IOPS dla 80-20, wszystkie z opóźnieniem 2.18 ms lub mniejszym. Nasz test VDI wykazał rozruch FC na poziomie 1.4 miliona IOPS, początkowe logowanie FC na poziomie 430 tys. IOPS i poniedziałkowe logowanie VDI FC na poziomie 436 tys. IOPS oraz rozruch LC na poziomie 821 tys. IOPS, początkowe logowanie LC na poziomie 277 tys. IOPS i poniedziałkowe logowanie LC na poziomie 279 tys. IOPS.
Ostatecznie, Intel VROC oferuje dostawcom systemów, takim jak EchoStreams, uproszczony sposób dostarczania RAID z dyskami SSD NVMe. W rezultacie EchoStreams może zapewnić doskonałą przepustowość i opóźnienia przy mniejszej złożoności i niższych kosztach. Co więcej, dzięki dodatkowym funkcjom Intel VMD, klienci EchoStreams zyskują lepszą łatwość serwisowania systemu dzięki takim funkcjom jak wymiana dysków SSD NVMe na gorąco, obsługa dysków NVMe o niskim zużyciu energii oraz rozruchowy RAID z konfiguracją przed uruchomieniem. Jak wspomniano, przypadki użycia są zróżnicowane, ale oczywistym jest ogromny potencjał dla sieci CDN i innych, które mogą skorzystać z RAID klasy korporacyjnej w najszybszych, powszechnie dostępnych interfejsach pamięci masowej i sieciowych.



 Amazon