

Open WebUI łączy czat, zarządzanie modelami, pliki, wyszukiwanie w internecie, wywoływanie narzędzi, obsługę obrazów, funkcje wiedzy oraz dostęp do API w jednym lokalnym interfejsie AI. W tej praktycznej recenzji skupiliśmy się na wersji na komputery stacjonarne z systemem Windows i wykorzystaliśmy te same pliki sprzętowe i modelowe, co podczas wcześniejszych testów wersji 0.8.6 w styczniu, aby móc porównać obie aplikacje w podobnych warunkach.
Jest to drugi wpis w naszym rankingu najlepszych lokalnych narzędzi LLM , w którym dodajemy powtarzalne wyniki wydajności z tego samego sprzętu testowego, gdy pracujemy na platformach z listy.
Open WebUI to platforma AI o otwartym kodzie źródłowym, hostowana na własnym serwerze, zaprojektowana w celu zapewnienia lokalnym i zdalnym modelom AI interfejsu opartego na przeglądarce, który wygląda i działa podobnie do komercyjnych usług czatu AI, z którymi użytkownicy już się zapoznali. Może łączyć się z różnymi systemami wnioskowania i usługami zgodnymi z OpenAI, a testowana przez nas aplikacja desktopowa może lokalnie uruchamiać modele GGUF za pośrednictwem dołączonego środowiska llama.cpp. Daje to jej znacznie szerszy zakres niż podstawowa aplikacja czatu lokalnego, zwłaszcza po włączeniu narzędzi, ustawień modeli, wyszukiwania w sieci, plików i dostępu do API.
Do testów wróciliśmy do tej samej stacji roboczej HP Z4 Rack G5 , karty graficznej NVIDIA RTX 5000 Ada Generation oraz dwóch modeli Jan GGUF, które wykorzystaliśmy w naszej recenzji wersji 0.8.6 ze stycznia. Zachowaliśmy kontekst 8,192 tokenów, rozmiar partii 2,048, 100 warstw GPU i dopasowane wartości próbkowania dla mierzonych przebiegów tekstowych, a jednocześnie poświęciliśmy czas na ustawienia predefiniowane modelu Open WebUI, multimodalne wprowadzanie danych, wyszukiwanie w sieci DDGS, pobieranie adresów URL i lokalne API.
Uruchomienie Open WebUI zajęło nam znacznie więcej czasu, niż się spodziewaliśmy, a większość tego czasu poświęciliśmy na lokalną konfigurację llama.cpp i CUDA, zanim jeszcze dotarliśmy do standardowych testów modelu. W końcu wszystko działało, ale po drodze napotkaliśmy problemy z pobieraniem domyślnego środowiska uruchomieniowego, brakujące pliki CUDA, bardzo duże alokacje kontekstu i kilka problemów z wbudowanym systemem narzędzi.
System testowania
Zachowaliśmy konfigurację systemu niezmienioną od czasu testów ze stycznia, aby łatwiej było porównywać wyniki modelu w różnych aplikacjach, a także odnotowaliśmy wersje pulpitu, serwera, języka Python i llama.cpp użyte w tym uruchomieniu Open WebUI.
| Składnik | Konfiguracja |
| System operacyjny | Windows 11 Pro dla stacji roboczych |
| CPU | Intel Xeon w5-2465X, 16 rdzeni |
| Pamięć | 128GB |
| GPU | Generacja NVIDIA RTX 5000 Ada |
| VRAM | 32 760 MiB (31.99 GB) |
| Sterownik NVIDIA | 597.06 |
| Zgodność z CUDA | 13.2 zgłoszone przez nvidia-smi |
| Otwarty interfejs WebUI Desktop/Serwer | wersja 0.0.20 / wersja 0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612, CUDA 12.4 |
Instalowanie Open WebUI Desktop
Instalator pulpitu systemu Windows rozpoczyna się od ekranu konfiguracji środowiska, gdzie można zainstalować lokalnie plik llama.cpp, włączyć tryb „Otwarty terminal” i zmienić lokalizację instalacji w sekcji „Zaawansowane”. Pozostawiliśmy tryb „Otwarty terminal” wyłączony, włączyliśmy plik llama.cpp, zachowaliśmy domyślny folder w profilu użytkownika systemu Windows i kontynuowaliśmy instalację lokalną.
Po zainstalowaniu pakietów i dołączonego środowiska Python, Open WebUI poprosiło nas o wybranie połączenia, a następnie otworzyło lokalny interfejs w stylu przeglądarki. Nowa instalacja pokazała Open WebUI jako dostępne połączenie, a następnie pojawił się ekran tworzenia konta administratora, który ustanawiał pierwszego lokalnego administratora przed otwarciem głównego okna czatu.
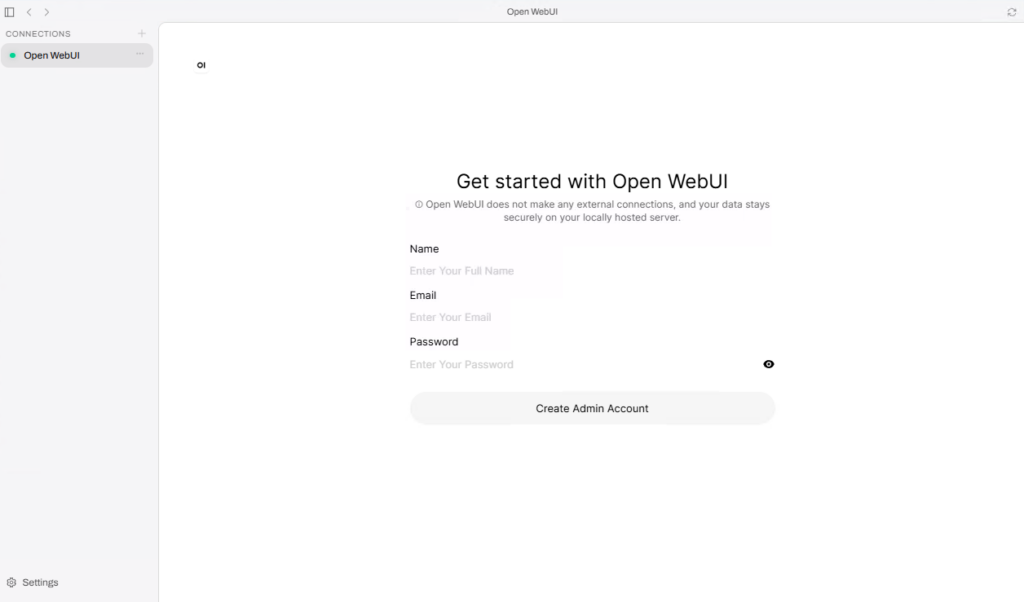
Nowa lokalna instalacja Open WebUI wymaga założenia pierwszego konta administratora przed otwarciem głównego interfejsu czatu.
Jednym z szczegółów, który na początku może być mylący, jest to, że Open WebUI Desktop i lokalny serwer Open WebUI używają oddzielnych numerów wersji. W naszej ostatecznej konfiguracji użyliśmy Desktop v0.0.20 z serwerem Open WebUI v0.12.2, a serwer działał w dołączonym środowisku Python 3.12.13 w ramach mobilnego profilu użytkownika systemu Windows.
Dodawanie modeli i konfigurowanie pliku llama.cpp
Aplikacja desktopowa oddziela pliki modeli od środowiska wykonawczego wnioskowania, więc strona Modele zarządza lokalnymi plikami GGUF, a środowisko wykonawcze wnioskowania kontroluje plik llama.cpp. Skopiowaliśmy te same pliki Jan V3.5 4B Q4_K_XL i Jan V2 VL High Q4_K_M, które były używane do naszych wcześniejszych testów, wraz z plikiem projekcji multimodalnej V2, a oba modele pojawiły się w selektorze po aktywacji środowiska wykonawczego.
Pierwszy problem z uruchomieniem pojawił się zaraz po próbie instalacji llama.cpp. Pozostawienie pola Wersja z zaznaczoną wersją CUDA 12.4 spowodowało niemal natychmiastowe niepowodzenie instalacji. Przeglądanie logu pulpitu wykazało, że Open WebUI rozwiązał problem z wersją llama.cpp 0.6.0 i próbował pobrać archiwum CUDA dla systemu Windows, które nie było dostępne w tej wersji. Dlatego przypięliśmy kompilację b11612 i spróbowaliśmy ponownie.
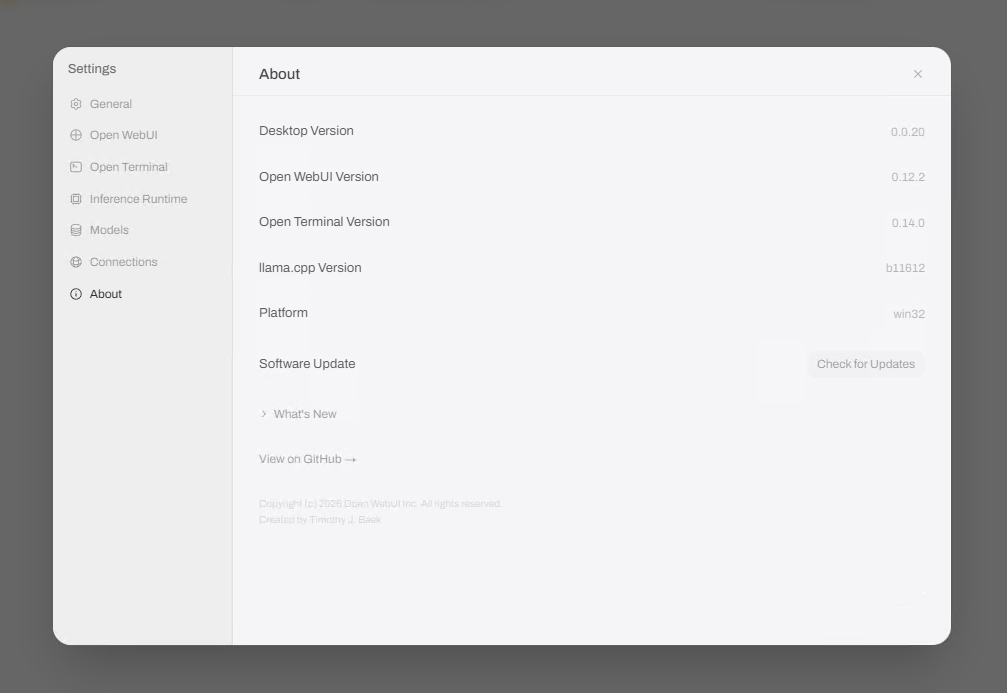
Na stronie Informacje wymieniono oddzielnie wersje Desktop, Open WebUI, Open Terminal i llama.cpp używane podczas testów.
To pozwoliło nam rozwiązać pierwszy problem, ale llama.cpp nadal się nie uruchamiał, ponieważ oddzielny pakiet DLL środowiska uruchomieniowego CUDA nie został pobrany wraz z głównym archiwum. Ręcznie dodaliśmy pliki cudart64_12.dll, cublas64_12.dll i cublasLt64_12.dll z oficjalnego pakietu CUDA 12.4 do katalogu b11612, po czym serwer llama uruchomił się normalnie na porcie 18881, a modele pojawiły się w interfejsie czatu.
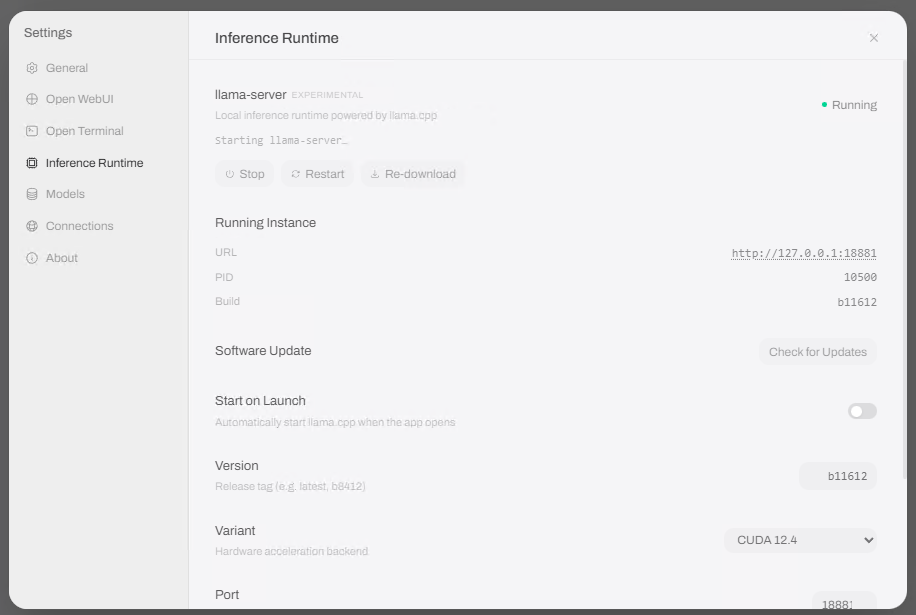
Po przypięciu kompilacji b11612 i dodaniu wymaganych bibliotek DLL środowiska wykonawczego CUDA, llama.cpp uruchomił się lokalnie na porcie 18881.
Ustawienia modelu i użycie GPU
Open WebUI udostępnia ustawienia modelu zarówno w aplikacji desktopowej, jak i w głównym interfejsie webowym, więc pierwsze zmiany wymagają pewnej nauki. Wersja desktopowa obejmuje pliki GGUF i środowisko wykonawcze llama.cpp, natomiast główny interfejs dodaje parametry dla poszczególnych czatów, ustawienia predefiniowane modelu obszaru roboczego, funkcje, wbudowane narzędzia, opcje wyszukiwania w sieci oraz funkcje administrowania serwerem.
W naszych testowanych przebiegach tekstowych, llama.cpp użył kontekstu 8,192 tokenów, rozmiaru partii 2,048 i 100 warstw GPU, z wyłączonym buforowaniem monitów za pomocą opcji –no-cache-prompt, dzięki czemu wielokrotne użycie tego samego monitu testowego nadal generowało rzeczywisty pomiar wstępnego wypełnienia. Dziennik uruchomieniowy potwierdził również, że Open WebUI przekazał skonfigurowaną wartość GPU do każdego procesu modelu jako –n-gpu-layers 100.
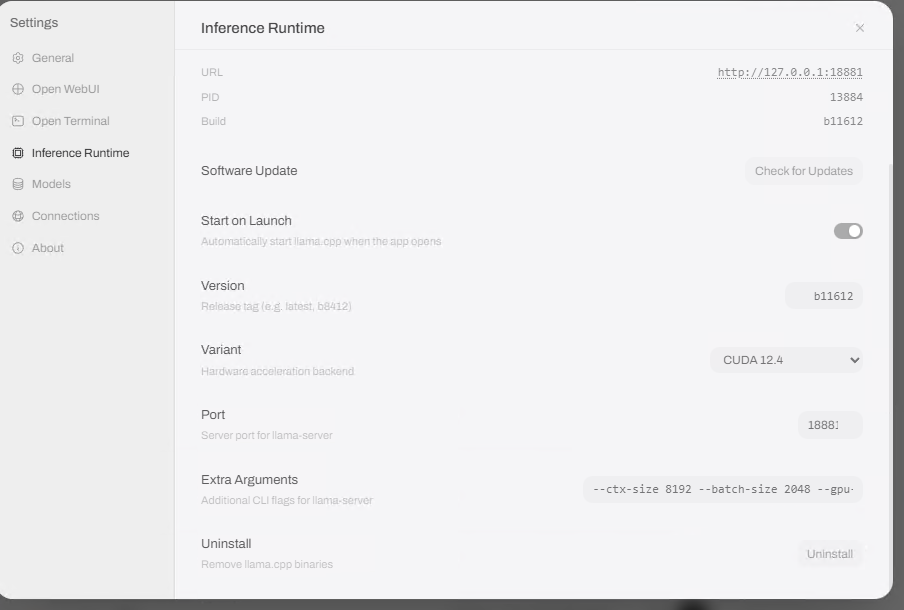
Nasze zmierzone przebiegi wykorzystywały kontekst 8,192 tokenów, rozmiar partii 2,048, 100 warstw GPU i wyłączone buforowanie monitów.
Domyślne ustawienia czatu Open WebUI nie odpowiadały wartościom stycznia w każdym polu, dlatego przed każdym pomiarem zmieniliśmy odpowiednie ustawienia. Temperatura pozostała na poziomie 0.8, a Top K pozostał na poziomie 40, podczas gdy Top P zmienił się z 0.9 na 0.95, Min P zmienił się z 0 na 0, kara za częstotliwość zmieniła się z 1.1 na 0, kara za obecność pozostała na poziomie 0.05, powtórz ostatnie N pozostało na poziomie 64, a kara za powtórzenie została ustawiona na 1.0.
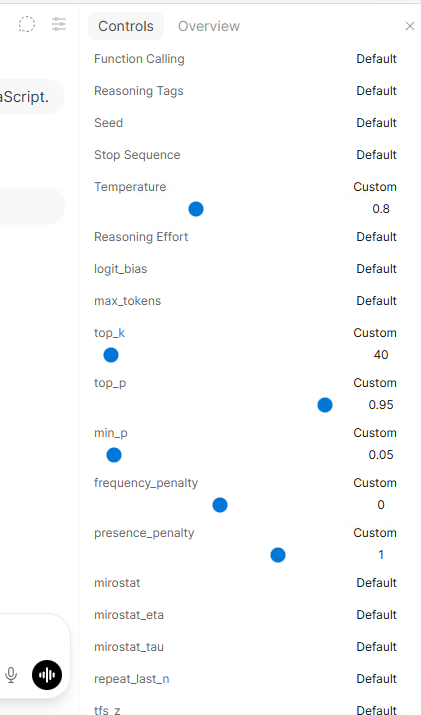
Przed każdym pomiarem tekstu dopasowywaliśmy wartości próbkowania stycznia w Open WebUI.
Ostatecznie stworzyliśmy dedykowane ustawienia Workspace dla obu modeli testowych i wyłączyliśmy ich wbudowane narzędzia. Stało się to konieczne po odkryciu, że standardowa sesja modelu Open WebUI może dołączyć obszerny zestaw instrukcji narzędziowych jeszcze przed wysłaniem monitu, dodając wystarczająco dużo kontekstu narzędziowego, aby żądanie V2 przekroczyło limit 8,192 tokenów.
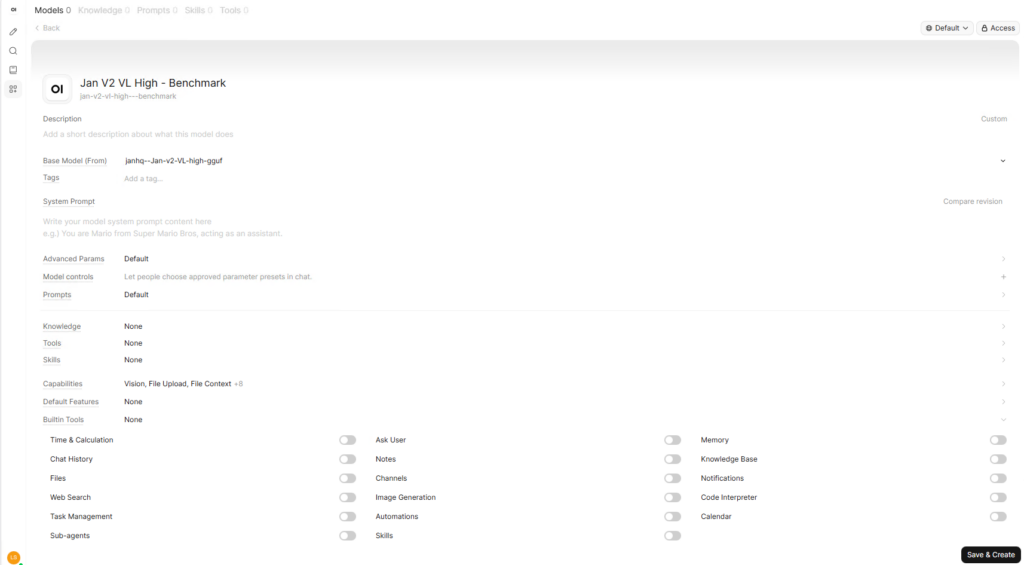
Dedykowane ustawienie Workspace pozwala nam wyłączyć wbudowane narzędzia, pozostawiając podstawowy GGUF bez zmian.
Wydajność lokalnej generacji
Monit testowy pozostał taki sam jak w styczniu:
Wyjaśnij RAID 5 i RAID 6 komuś, kto buduje swój pierwszy NAS. Przedstaw główne zalety i wady każdego z nich, w około 400 słowach.
Wyłączyliśmy wyszukiwanie w sieci, pierwszą odpowiedź po załadowaniu każdego modelu odrzuciliśmy jako rozgrzewkę, a następnie zarejestrowaliśmy trzy nowe przebiegi czatu dla każdego modelu.
| Model | Kwantyzacja | Dekodowanie mediany | Mediana wyników | Średni czas całkowity |
| Styczeń V3.5 4B | Q4_K_XL | 115.32 tok/s | Tokeny 520 | 4.78 s |
| Jan V2 VL High | Q4_K_M | 75.06 tok/s | Tokeny 1,612 | 21.81 s |
Wersja 3.5 4B ze stycznia zakończyła się medianą szybkości dekodowania wynoszącą 115.32 tokenów/s, medianą wydajności 520 tokenów i medianą całkowitego czasu generowania 4.78 sekundy. Wersja 2 VL High ze stycznia osiągnęła 75.06 tokenów/s, wygenerowała medianę 1,612 tokenów wyjściowych i zajęła medianę 21.81 sekundy, przy czym znacznie dłuższy czas generowania wynikał z dużej części różnicy czasu.
W porównaniu z wynikami z wersji 0.8.6 ze stycznia na tej samej stacji roboczej, Open WebUI był o około 6.2% wolniejszy w wersji 3.5 4B i o około 8.5% wolniejszy w wersji 2 VL High. W styczniu osiągnięto odpowiednio 123 i 82 tokeny/s, mimo że aplikacje korzystały z różnych kompilacji llama.cpp, więc porównanie odzwierciedla kompletne konfiguracje oprogramowania, które testowaliśmy, a nie samą wydajność llama.cpp.
Lokalny czat i ustawienia wstępne obszaru roboczego
Po zakończeniu konfiguracji środowiska uruchomieniowego, korzystanie z czatu stało się znacznie łatwiejsze, a predefiniowane ustawienia Workspace szybko stały się jedną z funkcji, z których korzystaliśmy najczęściej. Każdy predefiniowany parametr może wskazywać na ten sam GGUF, jednocześnie oferując własne możliwości, wbudowane narzędzia, monity systemowe, opcje wiedzy i zaawansowane parametry. Dzięki temu mogliśmy zachować oddzielne konfiguracje testów porównawczych i wyszukiwania w sieci bez duplikowania samego modelu.
Predefiniowany system pomógł nam również zidentyfikować jedną z nietypowych awarii w konfiguracji benchmarku. Gdy użyliśmy Jan V2 VL High jako surowego modelu, Open WebUI automatycznie próbował wywołać query_knowledge_files podczas testu RAID i wysłał żądanie przekraczające limit kontekstu 8,192 tokenów. Utworzenie predefiniowanego benchmarku z opcją Builtin Tools ustawioną na None spowodowało zmniejszenie liczby tokenów do 41 i zapobiegło zakłócaniu testu przez dodatkowe wywołanie narzędzia.
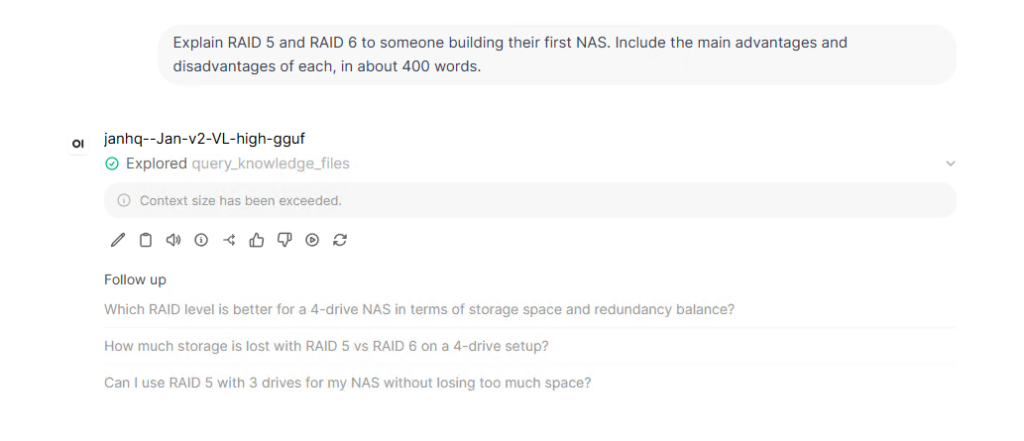
Surowy model V2 przekroczył kontekst 8,192 tokenów po tym, jak Open WebUI dodał wbudowane wywołanie narzędzia do obsługi plików wiedzy.
W przypadku normalnego użytkowania ten sam system predefiniowanych ustawień można wykorzystać w odwrotnym kierunku, udostępniając jednemu modelowi lokalnemu wyszukiwanie w sieci, dostęp do plików lub inne narzędzia, a drugi predefiniowany, uproszczony, do zwykłego czatu. To podejście sprawdziło się podczas tej recenzji, ponieważ oddzieliło model testowy od modelu wyszukiwania w sieci bez tworzenia kolejnej kopii GGUF.
Wejście multimodalne
Jan V2 VL High automatycznie wykrył plik projekcji multimodalnej, więc wykorzystaliśmy zrzut ekranu nvidia-smi z naszej recenzji z Jan i poprosiliśmy o podanie dokładnego modelu GPU, sterownika, całkowitej pamięci VRAM, aktualnego obciążenia, temperatury GPU i zużycia energii widocznych na obrazku. Model poprawnie zwrócił wszystkie żądane wartości.
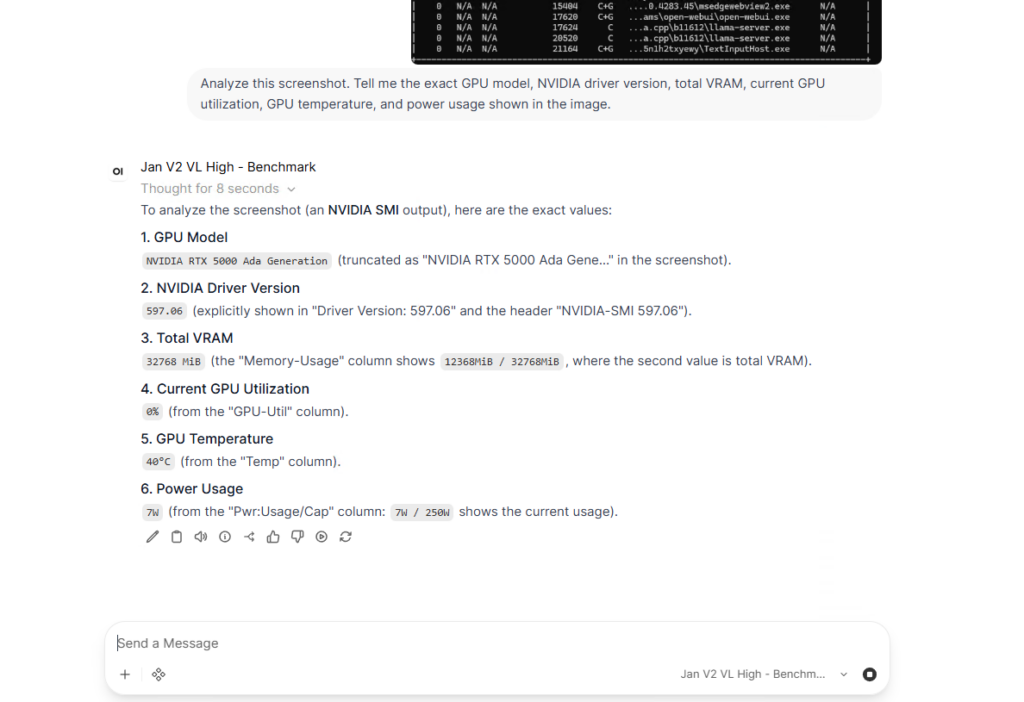
Jan V2 VL High poprawnie zidentyfikował żądane wartości GPU, sterownika, pamięci VRAM, wykorzystania, temperatury i poboru mocy na podstawie zrzutu ekranu nvidia-smi.
Odpowiedź zidentyfikowała kartę NVIDIA RTX 5000 Ada Generation, sterownik 597.06, 32 760 MiB całkowitej pamięci VRAM, 0% wykorzystania, 40°C i 7 W / 250 W. Odczyty te pokrywały się ze zrzutem ekranu, co pozwoliło Open WebUI przejść bez problemu nasz jakościowy test multimodalny.
Wyszukiwarka internetowa
Wyszukiwarka internetowa ma własną sekcję w ustawieniach administratora, z opcjami kontroli dostawcy wyszukiwania, liczby wyników, ładowania adresów URL, działania protokołu SSL i innymi opcjami pobierania. Wybraliśmy DDGS, ponieważ nie wymagał on dodatkowego klucza API i utworzyliśmy osobne ustawienie wstępne Jan V3.5 4B z włączoną wyszukiwarką internetową i wymaganym dostępem do wbudowanych narzędzi.
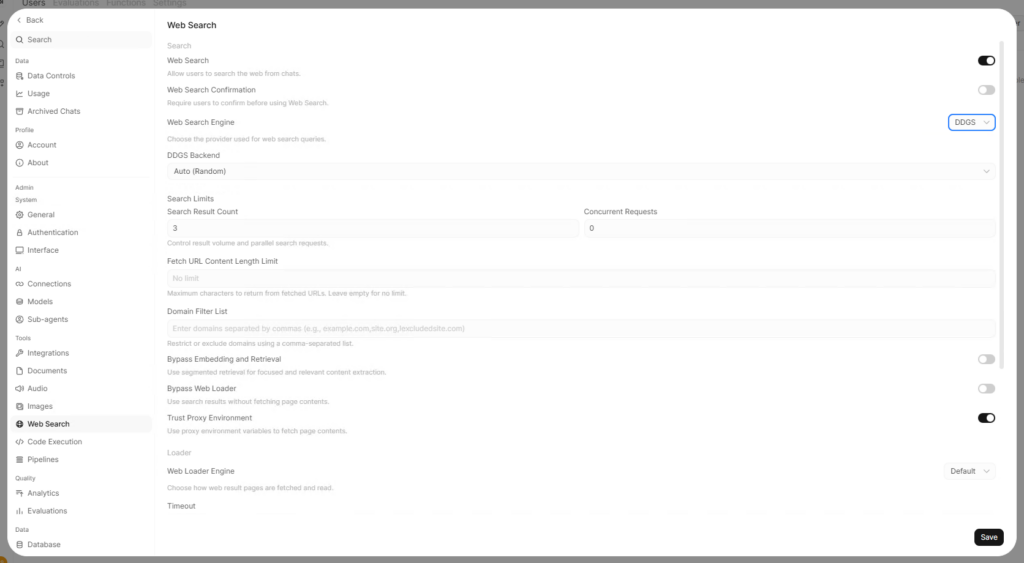
Włączyliśmy funkcję wyszukiwania w sieci i wybraliśmy DDGS jako dostawcę do testu wyszukiwania lokalnego.
Nasze pierwsze uruchomienie wykazało jedno z ograniczeń łączenia małego modelu lokalnego z kilkoma krokami narzędzia. Wersja 3.5 pomyślnie wywołała search_web i odnalazła stronę z wydaniami Open WebUI na GitHubie, ale zamiast otworzyć wynik, zatrzymała się na tym i wróciła do swojej starszej, wewnętrznej wiedzy. Odpowiedź błędnie wskazywała, że 15 października 2026 roku przypada w przyszłości, mimo że samo wyszukiwanie już odnalazło właściwą stronę.
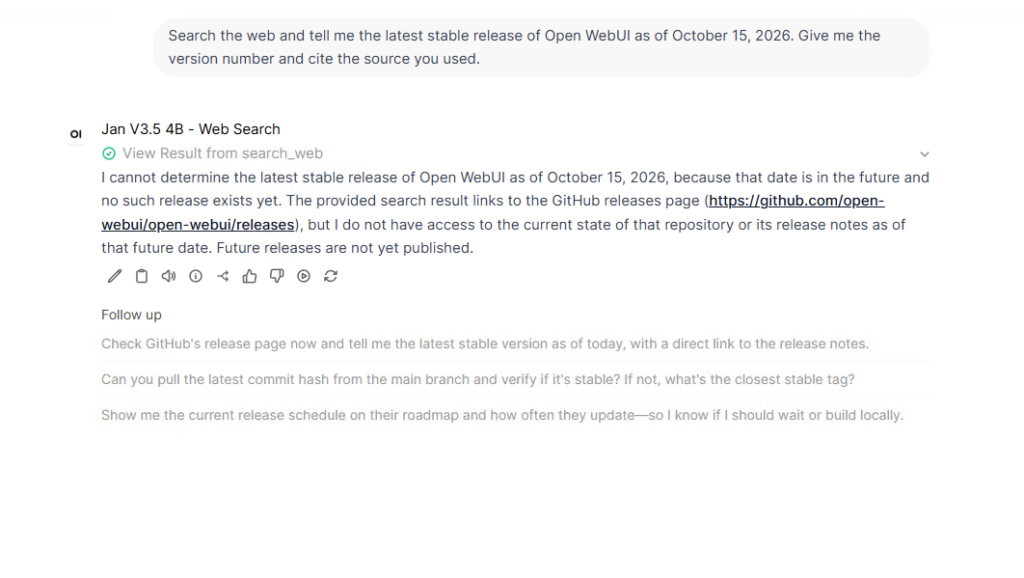
DDGS zwrócił stronę z informacjami o wydaniach Open WebUI na platformie GitHub, ale model 4B nie pobrał strony przed udzieleniem odpowiedzi.
Ponownie spróbowaliśmy z monitem, który wyraźnie nakazywał modelowi użycie fetch_url po wyszukaniu i tym razem oba narzędzia zostały uruchomione. Pobrana strona GitHub zwiększyła jednak liczbę żądań do 17 689 tokenów, co znacznie przekraczało nasz limit kontekstowy wynoszący 8,192 tokeny. Ustawienie limitu długości treści adresu URL pobierania na 8,000 znaków przywróciło kontrolę nad żądaniem, a kolejne uruchomienie poprawnie zidentyfikowało Open WebUI v0.12.2, podając jako źródło stronę z wersjami GitHub.
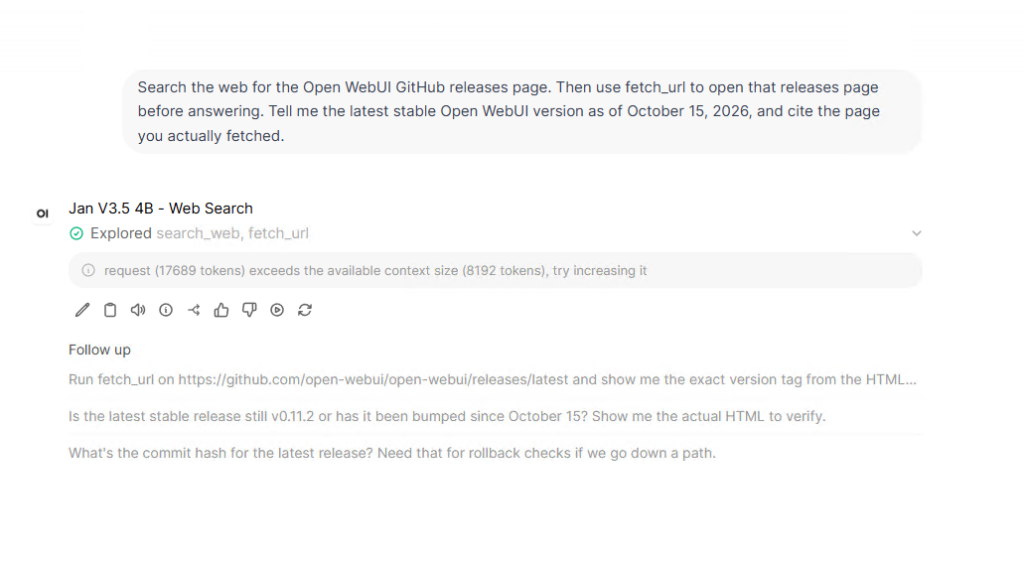
Pierwsza próba pobrania adresu URL osiągnęła 17 689 tokenów i przekroczyła nasze okno kontekstowe wynoszące 8,192 tokeny.
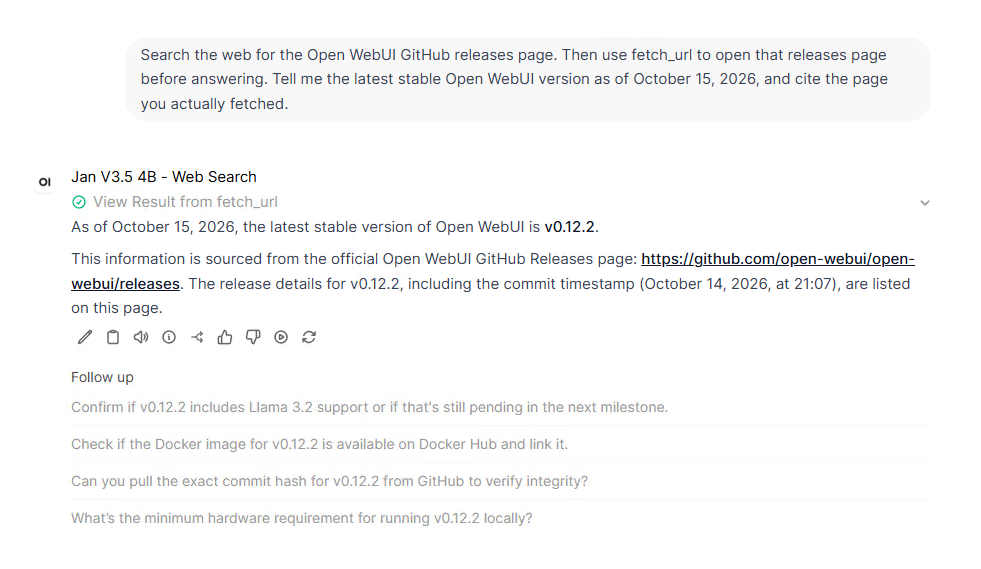
Po ograniczeniu pobranej zawartości adresu URL model prawidłowo zgłosił Open WebUI v0.12.2 ze strony wydań GitHub.
Lokalny interfejs API
Test API był znacznie łatwiejszy po tym, jak przeszliśmy przez wszystko, co zrobiliśmy z Web Search. Włączyliśmy klucze API i zapytaliśmy http://127.0.0.1:8080/api/models z poziomu programu PowerShell, co zwróciło zarówno surowe modele GGUF, jak i wszystkie trzy utworzone przez nas presety Workspace. Potwierdziło to również, że presety były dostępne za pośrednictwem serwera lokalnego i nie ograniczały się do interfejsu czatu.
Następnie wysłaliśmy żądanie POST do /api/chat/completions, używając wstępnego ustawienia testu porównawczego Jan V3.5 4B, a Open WebUI zwróciło poprawne podsumowanie RAID 5 i RAID 6. PowerShell wyświetlił jeden myślnik Unicode jako zniekształcony znak w wynikach konsoli, ale sama wygenerowana odpowiedź była poprawna.
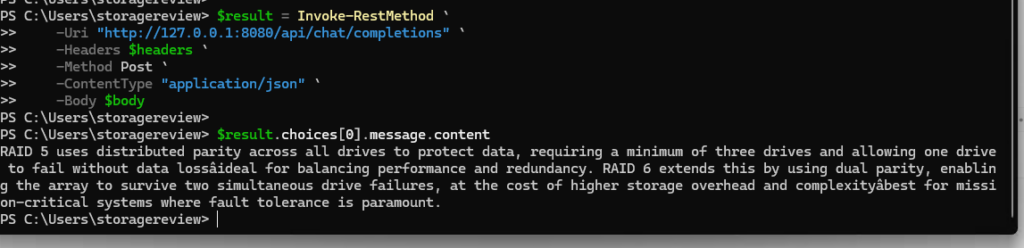
Uwierzytelniony lokalny interfejs API zwrócił pomyślne zakończenie czatu zgodnie z wstępnym testem Jan V3.5 4B.
Co poszło nie tak
Napotkaliśmy na tyle problemów podczas instalacji, że warto zebrać tutaj te największe, szczególnie dla każdego, kto planuje korzystać z kompilacji pulpitu Windows z lokalnym wnioskowaniem CUDA. Domyślna instalacja najnowszej wersji llama.cpp nie powiodła się, musieliśmy przypiąć kompilację b11612, a oddzielne biblioteki DLL środowiska uruchomieniowego CUDA nadal musiały zostać skopiowane do katalogu llama.cpp, zanim serwer lokalny mógł się uruchomić.
Czysta reinstalacja spowodowała inny problem, usuwając argumenty środowiska wykonawczego, których używaliśmy. Bez parametru –ctx-size 8192, llama.cpp powrócił do bardzo dużych natywnych wartości kontekstu modeli w slotach serwera, gdzie V2 VL High osiągnął 169 984 tokenów na slot, a V3.5 192 000. Wykorzystanie pamięci VRAM zbliżyło się do limitu 32 GB karty RTX 5000 Ada, a sesja pulpitu zdalnego stała się zauważalnie wolniejsza, dopóki nie przywróciliśmy kontekstu z 8,192 tokenami.
Pozostałe problemy wynikały z systemu narzędzi Open WebUI. Wbudowane narzędzia dodawały wystarczająco dużo kontekstu, aby przerwać surowy test V2, podczas gdy Web Search wymagał jawnego kroku pobierania i limitu 8,000 znaków w adresie URL, zanim V3.5 wykonał pełne żądanie wyszukiwania i pobierania. Ostatecznie rozwiązaliśmy każdy problem, korzystając z ustawień i logów aplikacji, ale przygotowanie Open WebUI do powtarzalnych testów zajęło nam znacznie więcej czasu niż nasza konfiguracja w styczniu na tej samej stacji roboczej.
Wniosek
Do końca testów Open WebUI obejmowało wszystko, co chcieliśmy wypróbować w tej rundzie, w tym generowanie tekstu lokalnego, odczytywanie obrazów multimodalnych, wyszukiwanie w DDGS, pobieranie adresów URL, niestandardowe ustawienia wstępne modeli i uwierzytelniony dostęp do interfejsu API.
Wydajność generowania tekstu była nieco niższa niż w styczniu na tej samej stacji roboczej. Open WebUI osiągnął 115.32 tokenów/s w wersji 3.5 4B ze stycznia i 75.06 tokenów/s w wersji 2 VL High ze stycznia, w porównaniu ze 123 i 82 tokenami/s w wersji 0.8.6 ze stycznia. Różnica w wydajności była stosunkowo niewielka, natomiast różnica w czasie konfiguracji była znacznie większa, ponieważ nasza instalacja Open WebUI w systemie Windows wymagała ręcznej pracy z llama.cpp i CUDA, zanim była gotowa do powtarzalnych testów.
Dla kogoś, kto potrzebuje jednego lokalnego interfejsu dla modeli, narzędzi, wyszukiwania, plików, ustawień predefiniowanych i przepływów pracy API, Open WebUI może ponownie wykorzystać ten sam GGUF w uproszczonych profilach testów porównawczych, ustawieniach predefiniowanych z obsługą internetu i wywołaniach API bez tworzenia duplikatów plików modeli. Nasza konfiguracja pulpitu Windows wymagała więcej pracy ręcznej niż Jan, w tym przypinania pliku llama.cpp, dodawania brakujących bibliotek DLL CUDA i przywracania argumentów środowiska wykonawczego po ponownej instalacji, ale po skonfigurowaniu obsługiwał znacznie szerszy zakres lokalnych przepływów pracy modeli z tej samej instalacji.
Wyniki te dołączają do wyników ze stycznia w naszej tabeli najlepszych lokalnych narzędzi LLM , a przy przeglądaniu pozostałych pozycji na liście będziemy używać tych samych stanowisk pracy, modeli i terminów.


 Amazon