

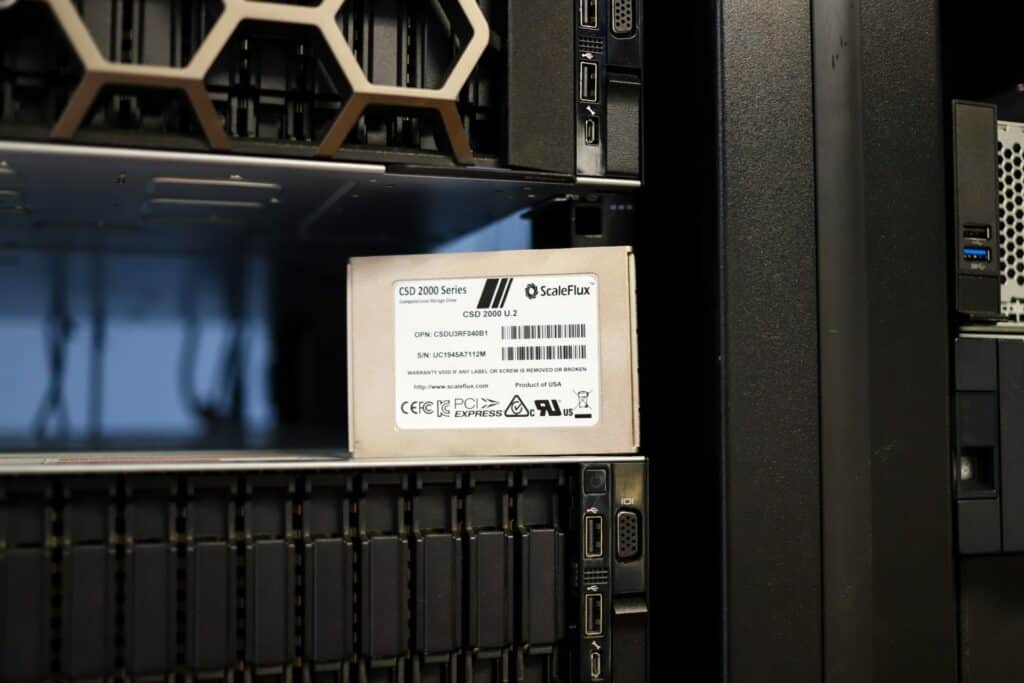
ScaleFlux to firma specjalizująca się wyłącznie w pamięci obliczeniowej, a dokładniej w pamięci obliczeniowej na dużą skalę. Firma realizuje to przede wszystkim za pomocą dysków ScaleFlux Computational Storage Drives (CSD). Jak można się domyślić po nazwie, CSD to dysk SSD NVMe zintegrowany z silnikami obliczeniowymi, który może poprawić wydajność dysku i systemu. Jednak pamięć obliczeniowa oznacza wiele różnych rzeczy, w zależności od tego, z kim się rozmawia. W tej recenzji poznajemy perspektywę ScaleFlux, prezentując ScaleFlux CSD 2000.
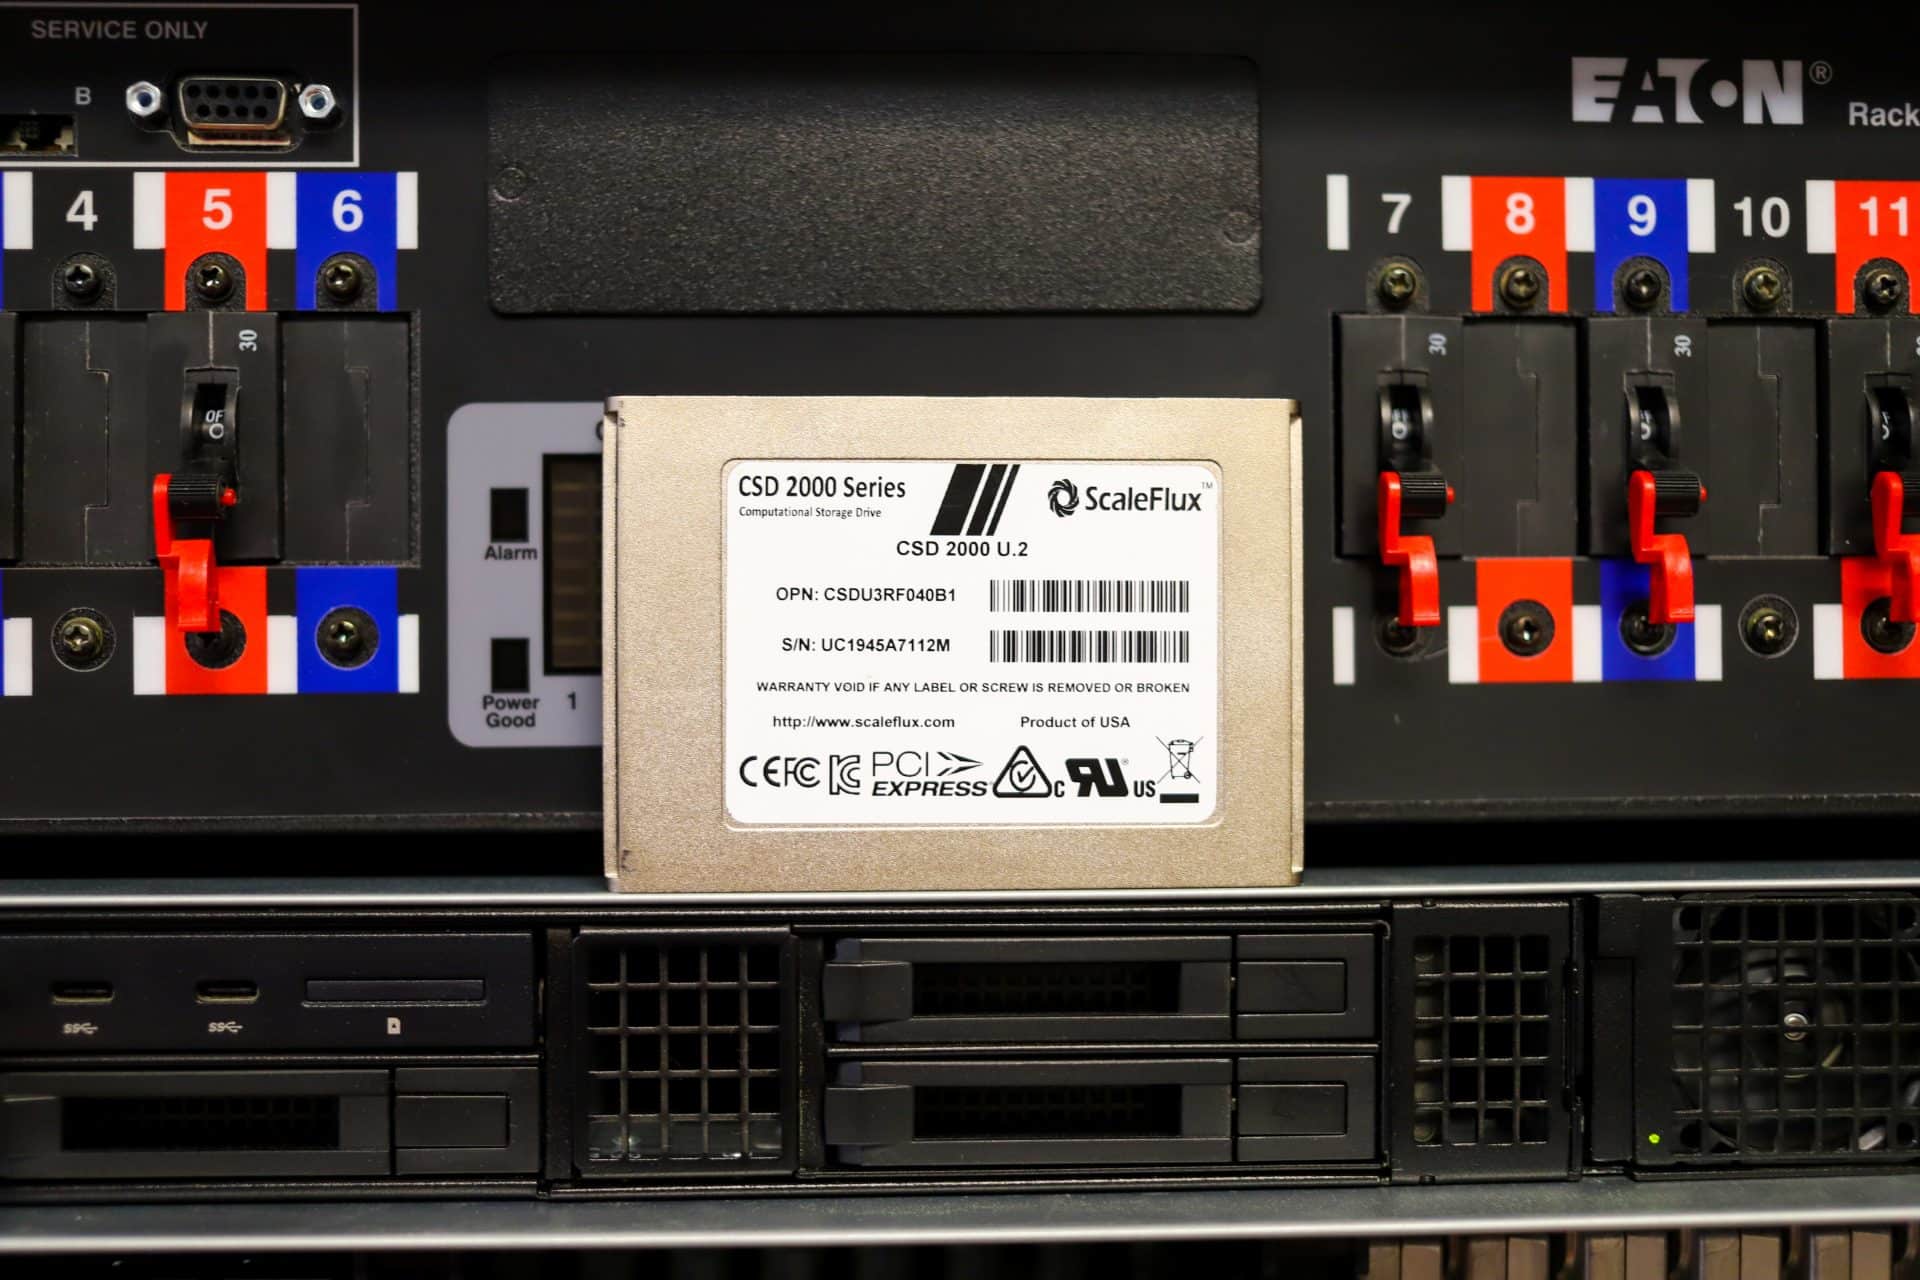
Czym jest pamięć obliczeniowa?
W StorageReview od kilku lat piszemy o pamięci obliczeniowej. W skrócie, pamięć obliczeniowa polega na wykorzystaniu zasobów obliczeniowych (które nie są częścią architektury obliczeniowej i/lub pamięci systemu) i umieszczeniu ich w samej pamięci masowej.
Czasami te zasoby obliczeniowe są również umieszczane między hostem a pamięcią masową. Może to zmniejszyć ruch danych, odciążyć zasoby obliczeniowe systemu i potencjalnie zwiększyć wydajność lub przynajmniej zapewnić jej spójność. W segmencie pamięci obliczeniowych działa jednak wielu dostawców, dlatego ważne jest, aby zrozumieć, że termin „pamięć obliczeniowa” może oznaczać bardzo różne rzeczy, w zależności od produktu.
ScaleFlux CSD 2000 i pamięć obliczeniowa
ScaleFlux CSD wyróżnia się wprowadzeniem silników kompresji/dekompresji ścieżek danych. Według firmy, może to efektywnie czterokrotnie zwiększyć pojemność i podwoić wydajność. Oczywiście, zakłada to kompresowalność danych, co jest fundamentalne dla prawidłowego działania tej platformy. W odpowiednich warunkach, efektywna pojemność staje się mocnym argumentem sprzedażowym.
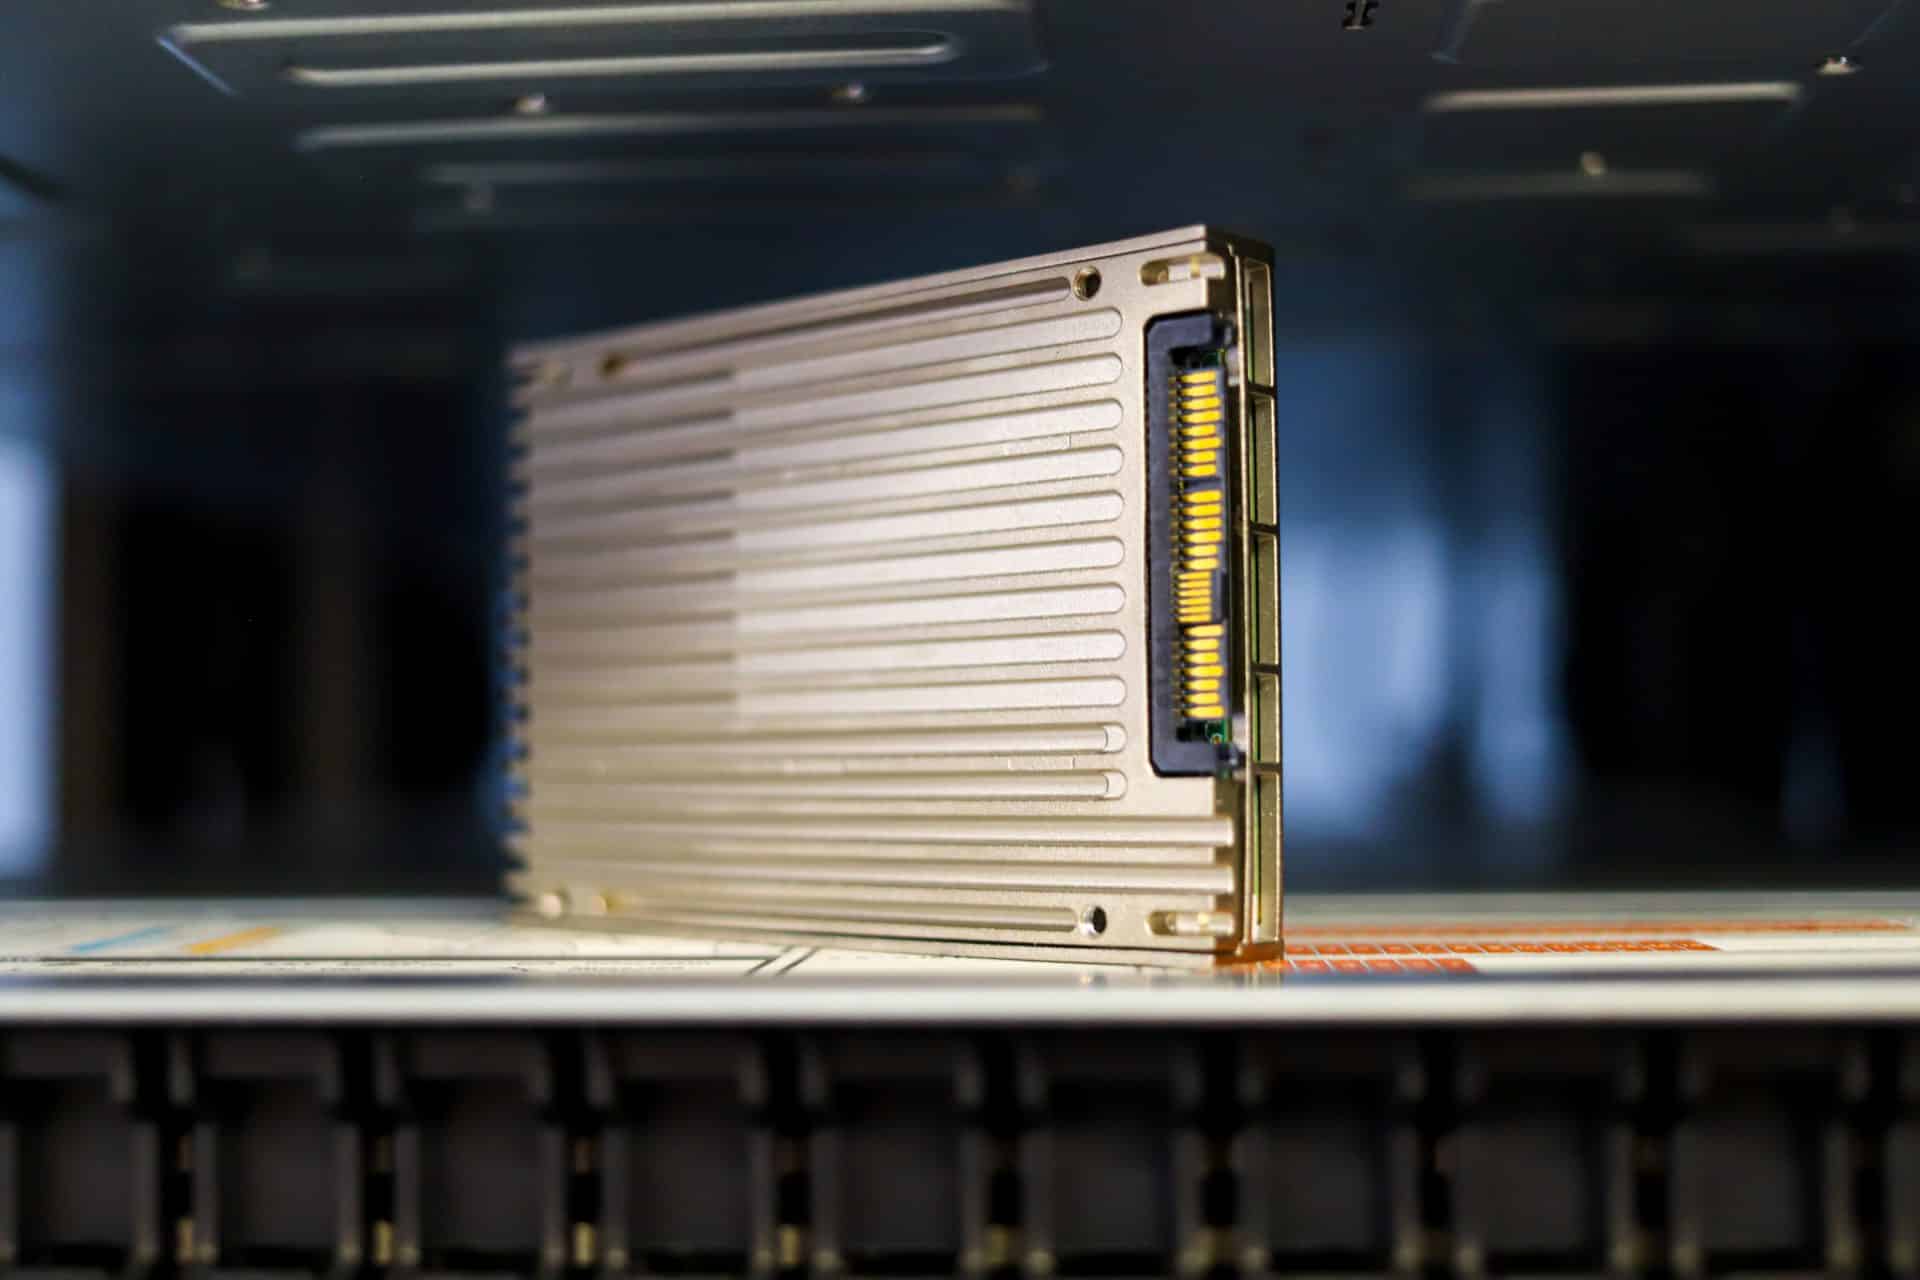
Należy również poruszyć kwestię kosztów i gęstości. ScaleFlux szacuje, że dzięki kompresji danych i zwiększeniu efektywnej pojemności organizacje mogą zaoszczędzić nawet 50% na kosztach pamięci flash. Dzięki kompresji mogą również zaoferować „więcej” pamięci flash w tym samym slocie.
Koszt i wydajność niewiele znaczą bez wydajności, którą, jak twierdzi ScaleFlux, można podwoić w porównaniu z tradycyjnymi dyskami SSD. Dysk jest dostępny zarówno w wersji Data Center, jak i Data Scale, ale przyjrzyjmy się tutaj najwyższym wynikom. Najwyższa wartość przy kompresji danych 1:1 to 750 tys. IOPS przy odczycie 4K i 490 tys. IOPS przy zapisie 4K, co daje kompresję danych 2:1. Jeśli chodzi o prędkości sekwencyjne, dysk osiąga 3 GB/s przy obu kompresjach i do 2.3 GB/s przy zapisie przy kompresji 1:1.
Kilka innych różnic w stosunku do CSD to możliwość dostrajania FTL/FM, co pozwala użytkownikom optymalizować wydajność i cenę za GB. Wysoka wydajność może prowadzić do problemów z zasilaniem i temperaturą, jednak można je ograniczyć, aby uniknąć przegrzania. Ochrona danych wydaje się być coraz bardziej popularna, dlatego CSD zapewnia kompleksową ochronę danych i korekcję błędów (ECC) we wszystkich pamięciach wewnętrznych na ścieżce danych, a także ochronę przed utratą zasilania.
W kontekście tej akcji CSD z ScaleFlux, istnieje kilka wad. Jedną z nich jest to, że testowany przez nas dysk jest trzeciej generacji, w czasie, gdy tradycyjne dyski SSD przeszły migrację do PCIe czwartej generacji. Ten problem można rozwiązać. Kolejnym problemem jest to, że obecnie obsługa sterowników jest ograniczona do Linuksa. Windows i VMware nie są już dostępne. Zlokalizowana wirtualizacja byłaby interesującym przypadkiem użycia i mogłaby przynieść korzyści w zakresie redukcji danych. Miejmy nadzieję, że wkrótce pojawi się szersze wsparcie.
Kluczowe specyfikacje ScaleFlux CSD 2000
| Formy czynników | PCIe AIC i 2.5” U.2 |
| Interfejs | Urządzenie pamięci masowej blokowej PCIe Gen3 x4 o niskim opóźnieniu |
| Nośniki NAND | 3D TLC i 3D QLC |
| Ochrona przed utratą zasilania | Tak |
| Ochrona danych |
|
| Zasilanie |
|
| temperatura robocza | 50°C przy 200LFM (AIC) 35°C przy 200LFM (U.2) |
| Ochrona temperatury | Włączone dławienie termiczne |
| MTTF | 2 milion godzin |
| Możliwości obliczeniowe |
|
| Kompatybilność oprogramowania | Tylko system operacyjny Linux z jądrem 2.6 lub nowszym
|
Kompresja za pomocą ScaleFlux
Na samym początku chcieliśmy zrozumieć, jak implementowana jest kompresja. Aby rozpocząć pracę w systemie Linux, należy załadować niestandardowy sterownik, który umożliwia podgląd i interakcję z dyskiem. Jest to gałąź wspólnego zestawu narzędzi nvme-cli. Pozwala to na podgląd dysku w jego obecnej postaci, formatowanie go, a także interakcję i/lub modyfikację użytecznej pojemności na podstawie bieżącego zestawu danych. Poniżej znajduje się krótki przykład wyników przed i po naszych testach obciążeniowych. Pierwsze polecenie „sfx-nvme list” pokazuje zainstalowany dysk.
root@storagereview:~# lista sfx-nvme
Format użycia przestrzeni nazw modelu węzła SN Wersja oprogramowania układowego BUS:slot:func
/dev/sfdv0n1 UC1945A7112M CSDU3RF040B1 1 3.20 TB / 3.20 TB 512 B + 0 B 4870 0000:d8:00.0
Po pierwszej rundzie testów porównawczych z danymi całkowicie niekompresowalnymi (nasz normalny roboczy zbiór danych) widzimy, że dysk wykazuje współczynnik kompresji wynoszący 1.00.
root@storagereview:~# cat /sys/block/sfdv*/sfx_smart_features/sfx_capacity_stat
wolna_przestrzeń rozmiar_fizyczny rozmiar_logiczny współczynnik_kompensacji przyznany_kapitał flaga_przestrzeni
2736 6251231232 6251231312 1.00 6251233968 0
Następnie zmieniliśmy poziom kompresji vdbench na 4x, pozwalając dyskowi na wykonanie części swoich magicznych zadań w tle. Po zakończeniu tej operacji i ponownym odpytaniu dysku SSD, zauważyliśmy zwiększony rozmiar i współczynnik kompresji 4.10. Dobra wiadomość jest taka, że po tym podstawowym odtworzeniu dyski spełniają swoje obietnice, jeśli chodzi o funkcjonalność kompresji.
root@storagereview:~# cat /sys/block/sfdv*/sfx_smart_features/sfx_capacity_stat
wolna_przestrzeń rozmiar_fizyczny rozmiar_logiczny współczynnik_kompensacji przyznany_kapitał flaga_przestrzeni
4728607824 1522626144 6251231312 4.10 6251233968 0
Wydajność ScaleFlux CSD 2000
Analiza obciążenia VDBench
Jeśli chodzi o benchmarking urządzeń pamięci masowej, testy aplikacji są najlepsze, a testy syntetyczne plasują się na drugim miejscu. Chociaż testy syntetyczne nie odzwierciedlają idealnie rzeczywistych obciążeń, pomagają one w ustaleniu punktu odniesienia dla urządzeń pamięci masowej dzięki współczynnikowi powtarzalności, który ułatwia porównywanie konkurencyjnych rozwiązań.
Te obciążenia oferują szereg zróżnicowanych profili testowych, od testów „czterech narożników”, przez testy rozmiaru transferu wspólnej bazy danych, po przechwytywanie śladów z różnych środowisk VDI. Wszystkie te testy wykorzystują wspólny generator obciążeń vdBench z silnikiem skryptowym do automatyzacji i przechwytywania wyników w dużym klastrze obliczeniowym. Pozwala to nam powtarzać te same obciążenia w szerokiej gamie urządzeń pamięci masowej, w tym w macierzach flash i indywidualnych urządzeniach pamięci masowej.
Nasz proces testowania tych benchmarków polega na wypełnieniu całej powierzchni dysku danymi, a następnie podzieleniu go na sekcje odpowiadające 25% pojemności dysku, aby zasymulować reakcję dysku na obciążenia aplikacji. Różni się to od testów pełnej entropii, które wykorzystują 100% pojemności dysku i wprowadzają go w stan ustalony. W rezultacie te wartości będą odzwierciedlać wyższe, stałe prędkości zapisu.
Profile:
- Losowy odczyt 4K: 100% odczytu, 128 wątków, 0-120% ioratu
- 4K losowy zapis: 100% zapisu, 64 wątki, 0-120% ioracji
- 64K Sekwencyjny odczyt: 100% odczytu, 16 wątków, 0-120% ioracji
- 64K Sekwencyjny zapis: 100% zapisu, 8 wątków, 0-120% ioratu
- Syntetyczna baza danych: SQL i Oracle
- Ślady pełnego klonu VDI i klonów powiązanych
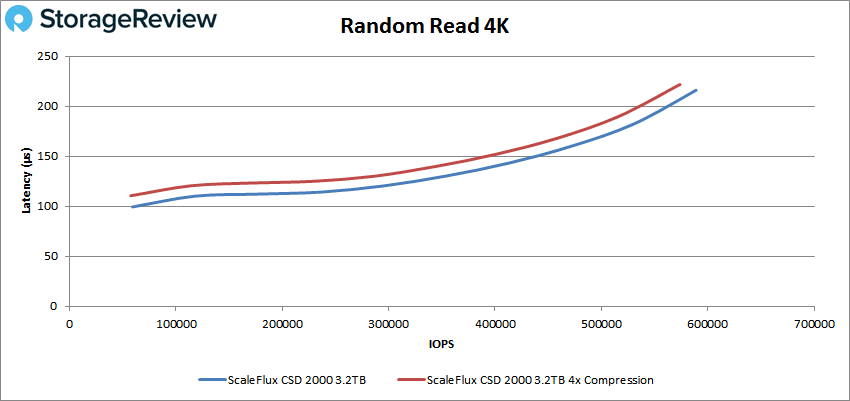
Dla porównania przyjrzymy się dyskowi SSD ScaleFlux z VDBench przesyłającemu dane niekompresowalne i czterokrotnie kompresowalne. W losowym 4K, niekompresowalny CSD rozpoczął się poniżej 100 µs i osiągnął szczyt 588 893 IOPS z opóźnieniem 216 µs. Po kompresji dysk był tylko nieznacznie wolniejszy, osiągając szczyt 573 460 IOPS z opóźnieniem 222 µs.
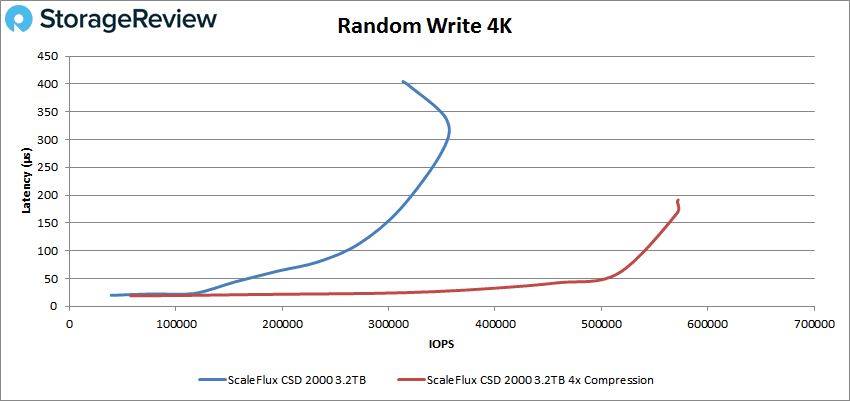
Podczas losowego zapisu 4K, niekompresowalny dysk osiągnął szczyt wydajności około 355 tys. IOPS przy około 325 µs, po czym nastąpił niewielki spadek. Przy kompresji, dysk utrzymywał się poniżej 100 µs przez większość czasu, osiągając szczyt około 572 tys. IOPS przy opóźnieniu 168 µs.
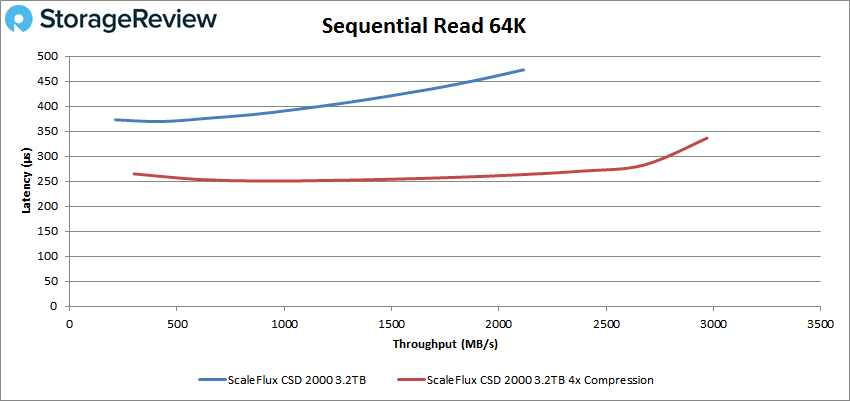
Po przełączeniu na obciążenia sekwencyjne 64 KB, dysk niekompresowalny osiągnął szczytową wartość 33 785 IOPS, czyli 2.11 GB/s, przy opóźnieniu 473 µs. Po kompresji dysk osiągnął 47 489 IOPS, czyli 2.97 GB/s, przy niższym opóźnieniu 336 µs.
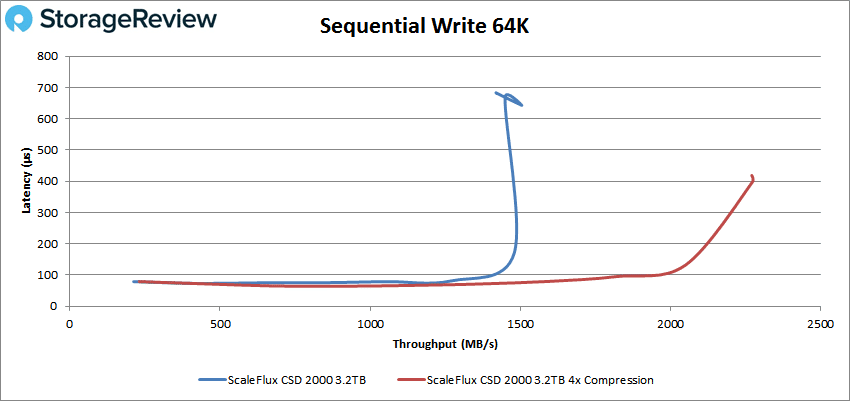
W przypadku zapisu 64 KB obie konfiguracje działały poniżej 100 µs przez znaczną część testu. Konfiguracja niekompresowalna osiągnęła szczyt 24 074 IOPS, czyli 1.5 GB/s, przy opóźnieniu 643 µs. Przy kompresji 4x zaobserwowaliśmy szczyt 36 364 IOPS, czyli 2.27 GB/s, przy opóźnieniu 397 µs.
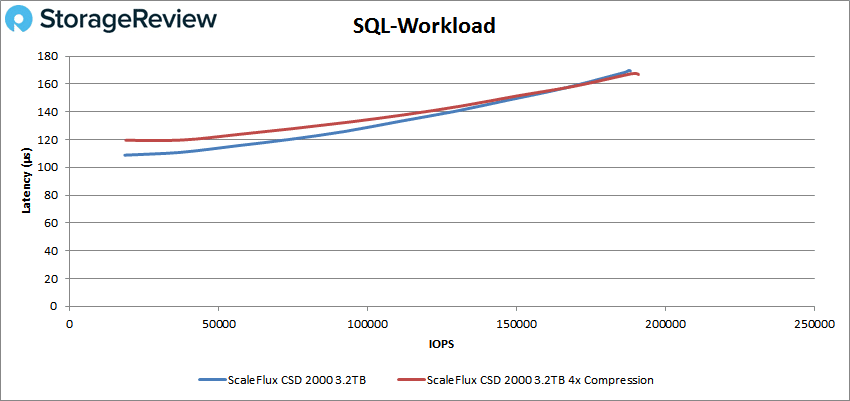
Kolejnym zestawem testów są obciążenia SQL: SQL, SQL 90-10 i SQL 80-20. Zaczynając od SQL, obie konfiguracje danych były bardzo podobne. Dane niekompresowalne osiągnęły szczytową wydajność 188 269 IOPS i opóźnienie 167 µs, podczas gdy dane skompresowane przesyłane na dysk osiągnęły szczytową wydajność 190 370 IOPS i opóźnienie również 167 µs.
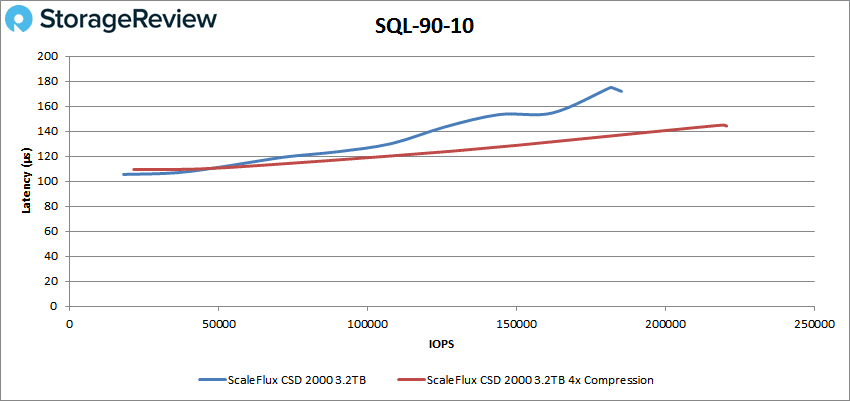
W SQL 90-10 niekompresowalny ScaleFlux CSD 2000 osiągnął szczyt 185 310 IOPS z opóźnieniem 172 µs. Po zastosowaniu czterokrotnej kompresji na dysku, osiągnął szczyt 220 615 IOPS z opóźnieniem 144 µs.
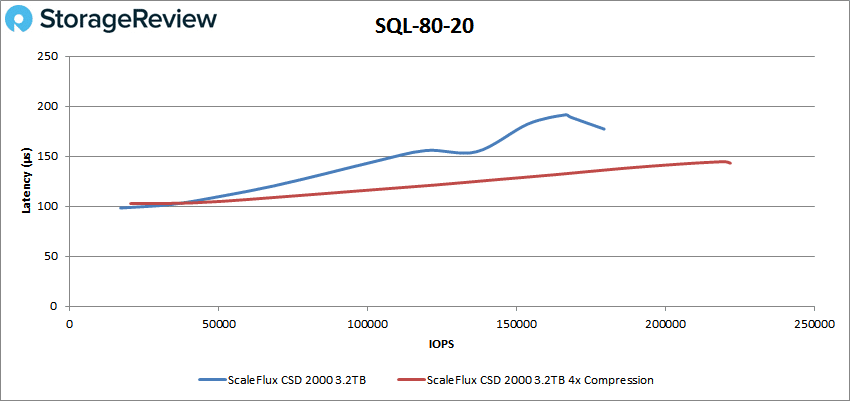
W SQL 80-20 szczytowy wynik operacji na dysku niekompresowalnym wyniósł 179 482 IOPS, a opóźnienie 177 µs. Analizując kompresję przesyłaną do CSD, zaobserwowaliśmy szczyt 221 851 IOPS przy opóźnieniu 143 µs.
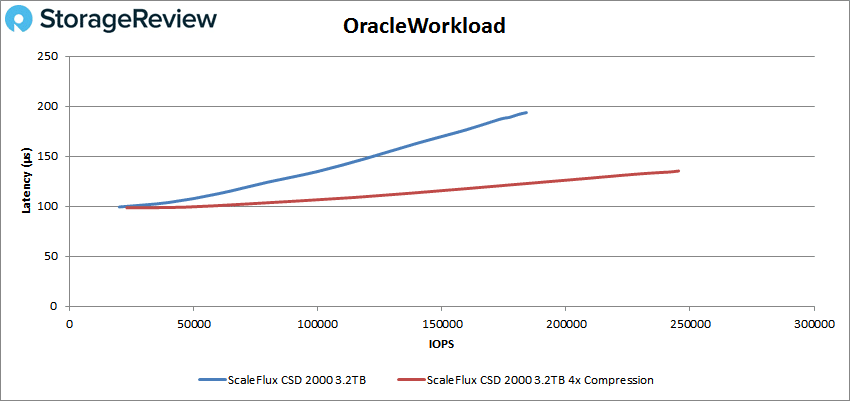
Następnie mamy nasze obciążenia Oracle: Oracle, Oracle 90-10 i Oracle 80-20. Począwszy od Oracle, niekompresowalny osiągnął szczyt na poziomie 184 048 IOPS i opóźnienie 194 µs. Patrząc na dysk z kompresją, zaobserwowaliśmy szczyt na poziomie 245 385 IOPS i opóźnienie 135 µs.
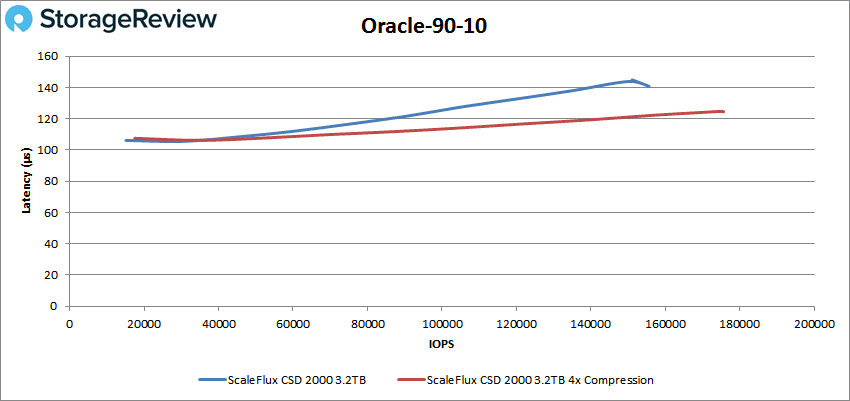
Oracle 90-10 początkowo oba systemy charakteryzowały się niemal identyczną wydajnością i opóźnieniem. Wersja niekompresowalna osiągnęła szczyt 155 641 IOPS przy opóźnieniu 141 µs. Wersja kompresowana osiągnęła szczyt 175 681 IOPS przy opóźnieniu 125 µs.
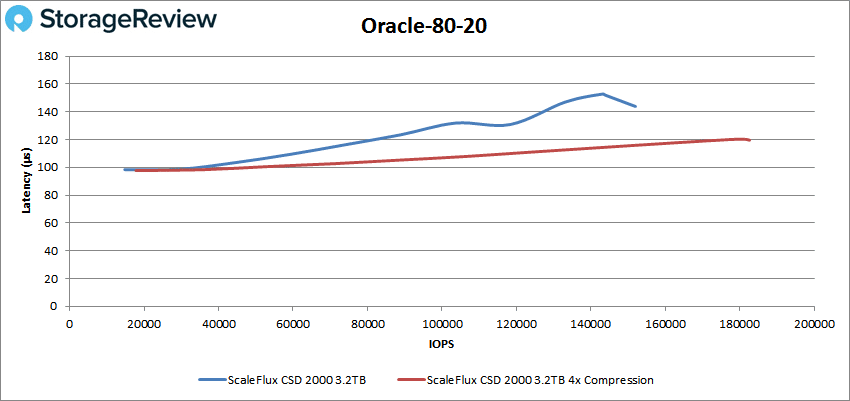
Konfiguracje dysków Oracle 80-20 Booth miały początkowo wydajność poniżej 100 µs. W przypadku danych niekompresowalnych szczytowa wydajność wyniosła 151 983 IOPS przy opóźnieniu 144 µs. W przypadku danych skompresowanych szczytowa wydajność wyniosła 182 640 IOPS przy opóźnieniu 120 µs.
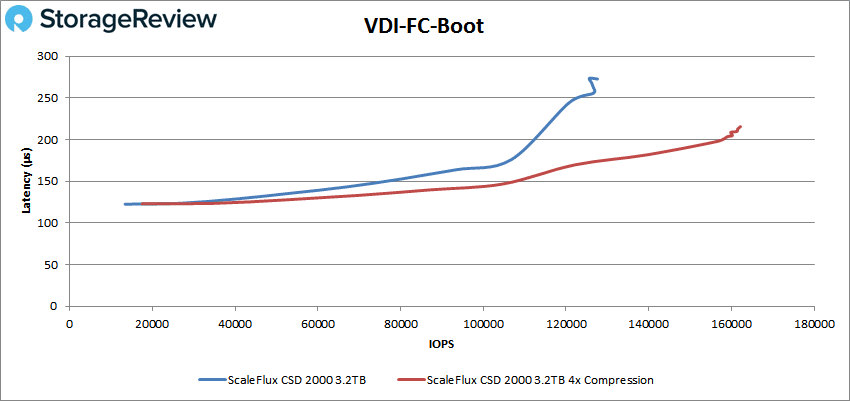
Następnie przeszliśmy do testu klonowania VDI, pełnego i połączonego. W przypadku rozruchu VDI Full Clone (FC), dysk ScaleFlux CSD 2000 bez niekompresowalnych danych osiągnął szczytową wydajność 127 616 IOPS przy opóźnieniu 263 µs. Wysłanie 4-krotnej kompresji zwiększyło wydajność do 161 543 IOPS przy opóźnieniu 216 µs.
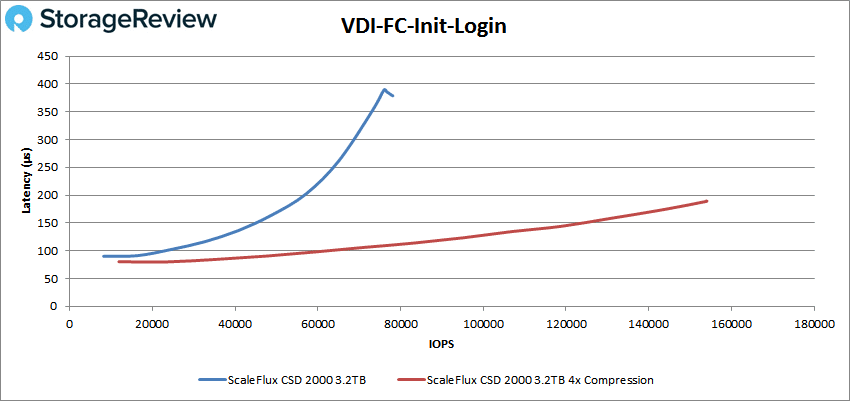
Początkowe logowanie VDI FC dało nam szczytowe wyniki 78 125 IOPS przy 379 µs dla danych niekompresowalnych i 154 077 IOPS przy 189 µs dla danych skompresowanych.
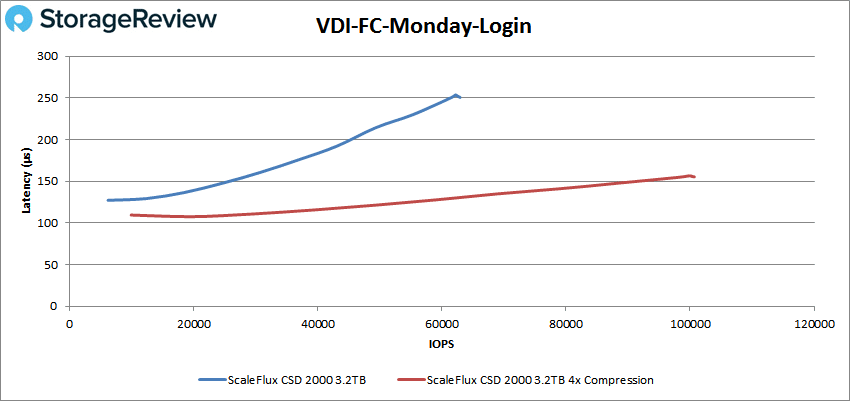
W przypadku VDI FC Monday, niekompresowalny dysk osiągnął szczyt na poziomie 62 922 IOPS z opóźnieniem 251 µs. Przy czterokrotnej kompresji, szczyt był znacznie wyższy i wyniósł 100 680 IOPS z opóźnieniem zaledwie 156 µs.
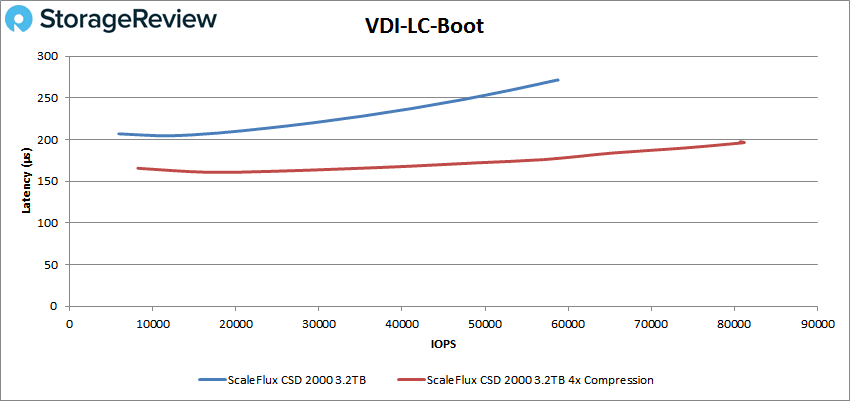
W przypadku rozruchu VDI Linked Clone (LC) niekompresowalne dane na dysku osiągnęły szczytową wartość 58 705 IOPS przy opóźnieniu 271 µs. Po przesłaniu 4-krotnej kompresji na dysk, szczytowa wartość wyniosła 81 137 IOPS, a opóźnienie 196 µs.
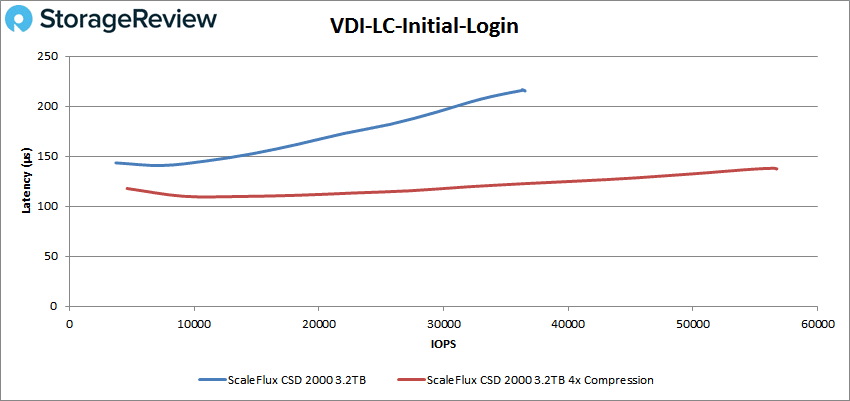
Podczas początkowego logowania do VDI LC dysk z niekompresowalnymi danymi osiągnął maksymalną wydajność 36 537 IOPS przy opóźnieniu 215 µs. Gdy dane poczwórnie skompresowane dotarły do dysku, ich wydajność osiągnęła 56 739 IOPS przy opóźnieniu 137 µs.
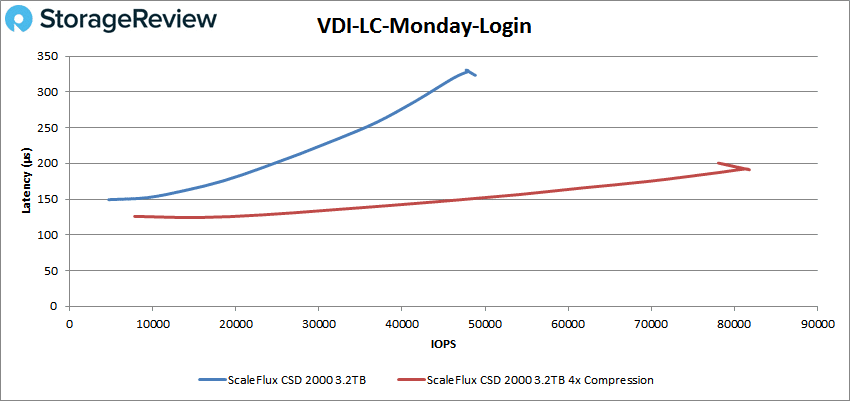
Wreszcie, po zalogowaniu się do VDI LC Monday, dysk niekompresowalny osiągnął szczytową wydajność 48 814 IOPS przy opóźnieniu 323 µs. Po kompresji dysk SSD osiągnął szczytową wydajność 81 799 IOPS przy opóźnieniu 192 µs.
Wniosek
ScaleFlux koncentruje się wyłącznie na pamięci obliczeniowej. Odbywa się to głównie za pośrednictwem dysków SSD, znanych jako ScaleFlux Computational Storage Drives (CSD). Są to dyski SSD PCIe Gen3 z silnikami obliczeniowymi, które poprawiają wydajność i efektywność przetwarzania danych. Firma oferuje kilka różnych dysków, ale w tej recenzji przyjrzeliśmy się modelowi ScaleFlux CSD 2000.
Główną różnicą między dyskiem ScaleFlux a innymi pamięciami obliczeniowymi jest mechanizm kompresji/dekompresji ścieżki danych. ScaleFlux deklaruje czterokrotnie większą pojemność i podwojenie wydajności dzięki swojej technologii obliczeniowej. To nie tylko przekłada się na wydajność, ale może również obniżyć koszt na TB pamięci SSD, biorąc pod uwagę efektywność pamięci masowej w przypadku danych o wysokiej kompresji.
Głównym problemem jest zatem to, czy silnik kompresji działa? Odpowiedź była prosta: tak, ponieważ manipulowaliśmy kompresją od samego początku testów. Zaczęliśmy od danych całkowicie niekompresowalnych i, zgodnie z oczekiwaniami, uzyskaliśmy współczynnik kompresji na dysku 1:1. Przejście na współczynnik kompresji 4X dało nam współczynnik kompresji na dysku 4.1:1. Krytyczny pierwszy krok został zaliczony, zanim zajęliśmy się wydajnością.
Najpierw przyjrzyjmy się dyskowi bez przesyłania do niego danych niekompresowalnych. Najważniejsze wyniki to 589 tys. IOPS przy odczycie 4K, 355 tys. IOPS przy zapisie 4K, 2.11 GB/s przy odczycie 64K i 1.5 GB/s przy zapisie 64K. W przypadku SQL zaobserwowaliśmy szczyty na poziomie 188 tys. IOPS, 185 tys. IOPS w SQL 90-10 i 179 tys. IOPS w SQL 80-20. W przypadku naszych obciążeń Oracle zaobserwowaliśmy szczyty na poziomie 184 tys. IOPS, 156 tys. IOPS w Oracle 90-10 i 152 tys. IOPS w Oracle 80-20. W naszych testach klonowania VDI, dysk CSD 2000 bez kompresji uzyskał 128 tys. IOPS podczas rozruchu, 78 tys. IOPS podczas pierwszego logowania i 63 tys. IOPS podczas poniedziałkowego logowania w trybie pełnego klonu. W przypadku klonu połączonego, dysk uzyskał 59 tys. IOPS podczas rozruchu, 37 tys. IOPS podczas pierwszego logowania i 49 tys. IOPS podczas poniedziałkowego logowania.
Po przesłaniu danych skompresowanych czterokrotnie, byliśmy mile zaskoczeni wzrostem wydajności w każdym teście, z wyjątkiem odczytu 4K, gdzie różnica nie była aż tak duża. Najważniejsze wyniki to 573 tys. operacji wejścia/wyjścia na sekundę (IOPS) przy odczycie 4K, 572 tys. operacji wejścia/wyjścia na sekundę (IOPS) przy zapisie 4K, 2.97 GB/s przy odczycie 64K i 2.27 GB/s przy zapisie 64K. W przypadku SQL zaobserwowaliśmy szczyty na poziomie 190 tys. operacji wejścia/wyjścia na sekundę (IOPS), 221 tys. operacji wejścia/wyjścia na sekundę (IOPS) w SQL 90-10 i 222 tys. operacji wejścia/wyjścia na sekundę (IOPS) w SQL 80-20. W przypadku Oracle zaobserwowaliśmy szczyty na poziomie 245 tys. operacji wejścia/wyjścia na sekundę (IOPS), 176 tys. operacji wejścia/wyjścia na sekundę (IOPS) w Oracle 90-10 i 183 tys. operacji wejścia/wyjścia na sekundę (IOPS) w Oracle 80-20. W naszych testach klonowania VDI, ScaleFlux z kompresją dał nam 162 tys. IOPS podczas rozruchu, 154 tys. IOPS podczas pierwszego logowania i 101 tys. IOPS podczas poniedziałkowego logowania w trybie pełnego klonu. W przypadku klonu połączonego, dysk dał nam 81 tys. IOPS podczas rozruchu, 57 tys. IOPS podczas pierwszego logowania i 82 tys. IOPS podczas poniedziałkowego logowania.
ScaleFlux CSD 2000 to naprawdę interesujący produkt, który wskazuje na potencjalny przełom w tradycyjnym segmencie dysków SSD, w miarę jak pamięć obliczeniowa zyskuje na popularności. Dyski CSD istnieją już od wielu lat, więc koncepcja nie jest nowa. Prawdopodobnie brakuje im jednak wydajności. ScaleFlux jest pierwszym z CSD, który wprowadził coś do naszego laboratorium. Sama pewność siebie nie wystarczy, dysk musi działać.
W tym przypadku wydajność to nie tylko liczby widoczne na naszych wykresach, choć tam dysk wypadł całkiem nieźle. Dowodem na to jest jego zdolność do efektywnej pracy z danymi kompresowalnymi. Działa dokładnie tak, jak oczekiwaliśmy w naszych testach, oferując nawet niewielki wzrost wydajności we wszystkich profilach testowych z wyjątkiem jednego. Aby ten dysk SSD miał sens, wystarczy dopasować go do konkretnego przypadku użycia. Dane kompresowalne z pewnością skorzystają na technologii ScaleFlux. O ile obecnie nie potrzebujesz obsługi wirtualizacji VMware ani Windows, zdecydowanie warto rozważyć test CSD 2000 w ramach PoC, aby przekonać się, jak wiele korzyści może przynieść Twoje obciążenie.


 Amazon