

Zapotrzebowanie na szybkie, wysokiej jakości treści wideo nigdy nie było większe. W dzisiejszym krajobrazie medialnym od małych zespołów informacyjnych, niezależnych twórców treści i ekip produkcyjnych wydarzeń oczekuje się, że będą rejestrować, edytować i publikować profesjonalne materiały filmowe w czasie rzeczywistym, często bez wsparcia zespołu postprodukcyjnego lub scentralizowanej infrastruktury.
Właśnie dlatego lokalne wyszukiwanie oparte na sztucznej inteligencji (AI), realizowane za pośrednictwem brzegowych systemów produkcyjnych, staje się koniecznością, ponieważ ilość materiału filmowego gwałtownie rośnie, a zapotrzebowanie na jego ponowne wykorzystanie rośnie. Umożliwiając zespołom bezpośrednią pracę z materiałem filmowym w momencie jego przechwytywania, brzegowe przepływy pracy eliminują wąskie gardła i pozwalają twórcom poświęcać mniej czasu na wyszukiwanie i zarządzanie materiałem, a więcej na produkcję jak najlepszych treści.
Axle AI , platforma do zarządzania zasobami multimedialnymi i automatyzacji oparta na sztucznej inteligencji, została zaprojektowana specjalnie z myślą o tym zdecentralizowanym, dynamicznym procesie pracy. W połączeniu z wiodącym w branży sprzętem, takim jak serwer HPE ProLiant DL145 Gen11, procesor graficzny NVIDIA L4 i dyski SSD Solidigm PCIe Gen5, powstaje wydajne, przenośne środowisko produkcyjne. Zapewnia ono profesjonalne funkcje multimedialne wspomagane przez sztuczną inteligencję nawet najbardziej oszczędnym zespołom.
Przegląd architektury systemu
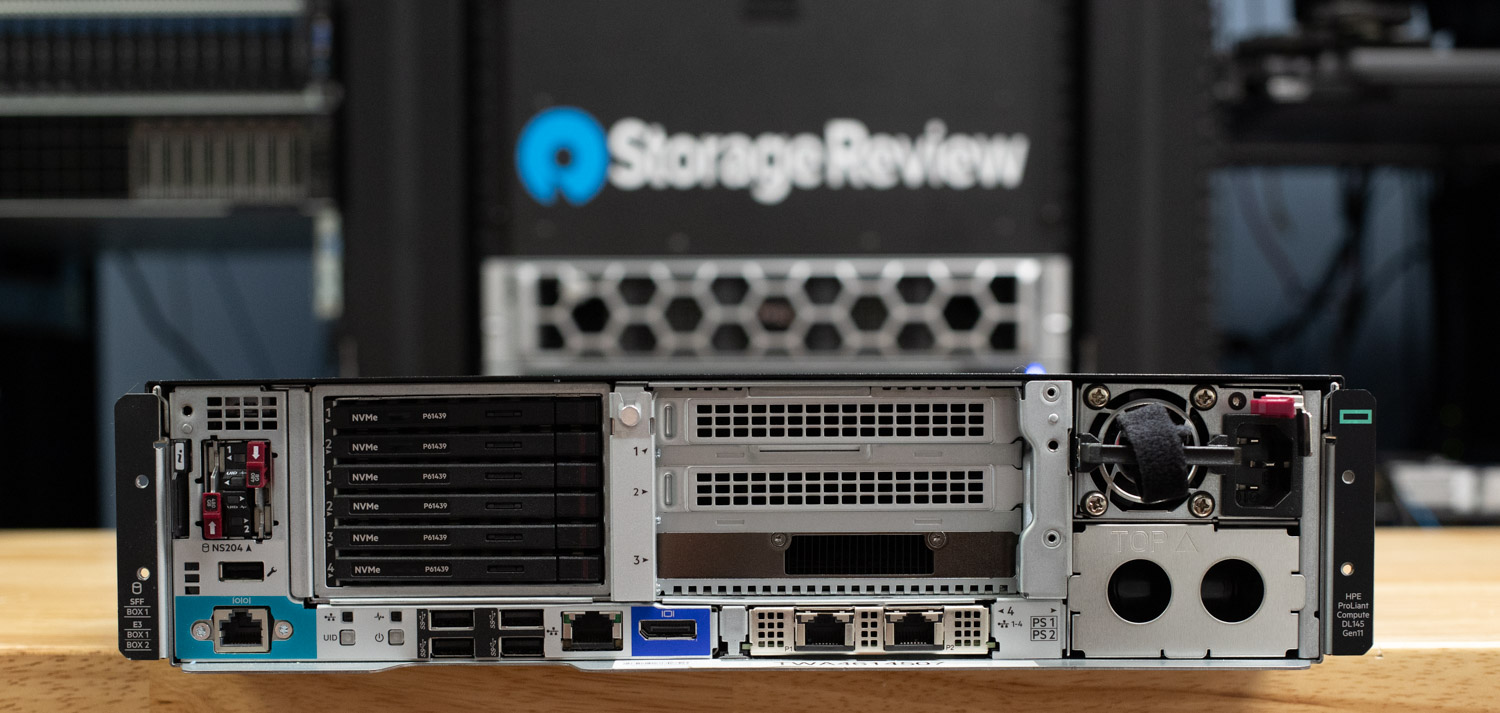
Serwer brzegowy HPE ProLiant DL145 Gen11 to solidny kandydat do wdrożeń Axle AI w środowiskach terenowych i eventowych, gdzie przestrzeń, zasilanie i chłodzenie są ograniczone. Dzięki konstrukcji 2U o małej głębokości, wynoszącej zaledwie 16 cali (40 cm), serwer ten został zaprojektowany z myślą o mobilności i montażu w ciasnych przestrzeniach, takich jak mobilne szafy rack i skrzynie transportowe. W przeciwieństwie do tradycyjnego sprzętu klasy enterprise, obsługuje rozszerzony zakres temperatur pracy od -5°C do 55°C, dzięki czemu nadaje się do środowisk o mniejszej kontroli. Pomimo kompaktowych rozmiarów, oferuje funkcje klasy enterprise, takie jak redundantne zasilanie i opcje dysków rozruchowych, co czyni go idealnym rozwiązaniem dla zespołów potrzebujących solidnej infrastruktury obsługującej rozwiązania brzegowe bez konieczności stosowania sprzętu pełnowymiarowego.
Jeśli chodzi o procesor, DL145 obsługuje procesory AMD EPYC serii 8004 (Siena) z obsługą od ośmiu do 64 rdzeni. Nasz system testowy wyposażony jest w procesor EPYC 8434P, oferujący 48 rdzeni i 96 wątków. Dzięki TDP na poziomie 200 W, zapewnia on doskonałą równowagę między wydajnością a mocą obliczeniową, co czyni go idealnym do intensywnych obciążeń. Procesor obsługuje 96 linii PCIe 5.0 i oferuje sześć kanałów pamięci DDR5, umożliwiając prędkość do 4800 MT/s przy doskonałej przepustowości pamięci. Chociaż minimalne wymagania dla Axle AI obejmują co najmniej 16 rdzeni procesora i 32 GB pamięci RAM, nasza konfiguracja z łatwością je przekracza, oferując 48 rdzeni i 256 GB pamięci DDR5.
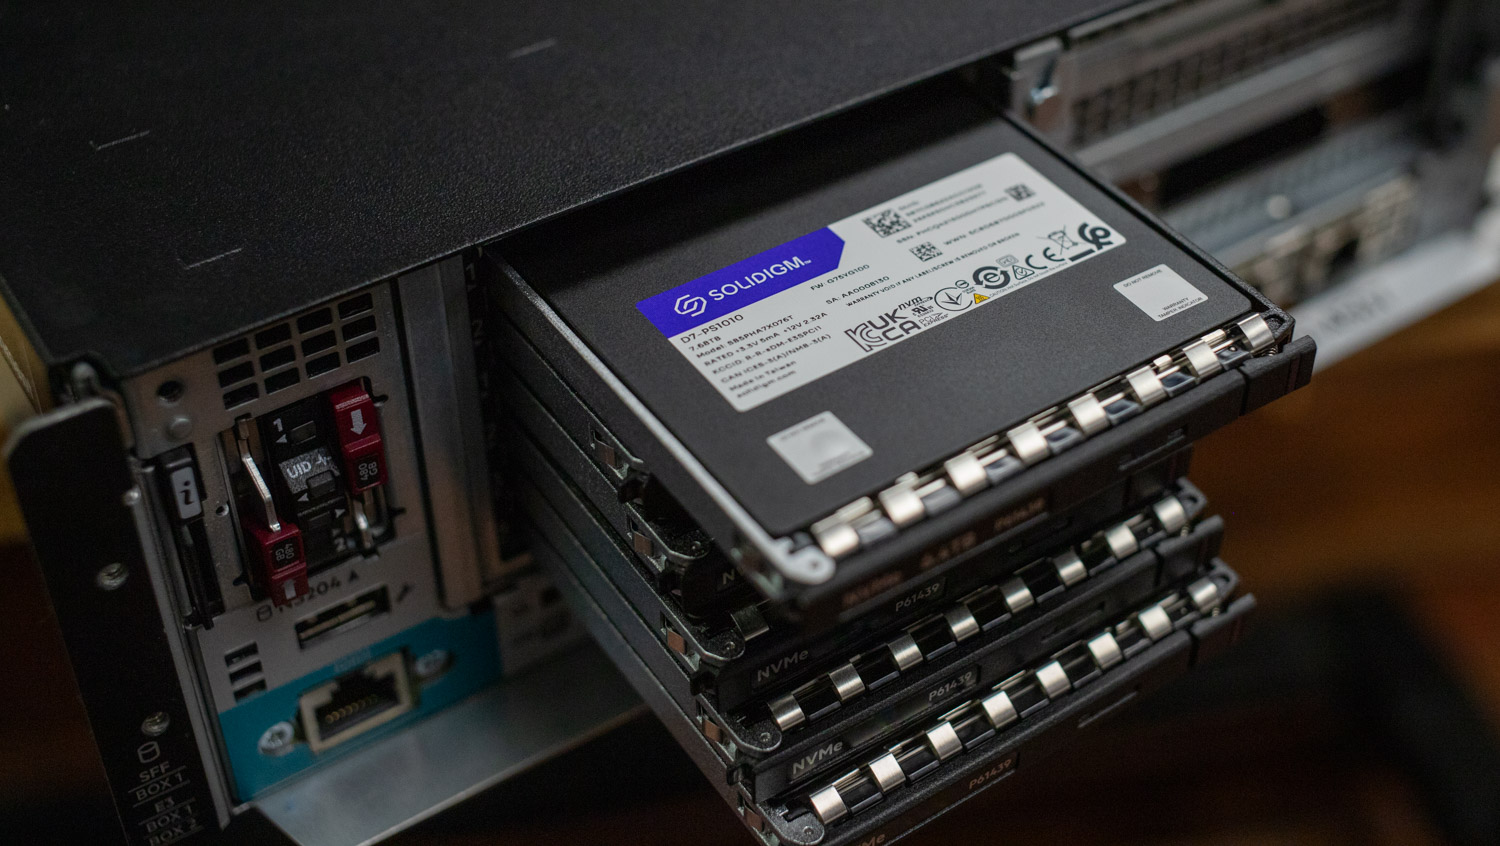
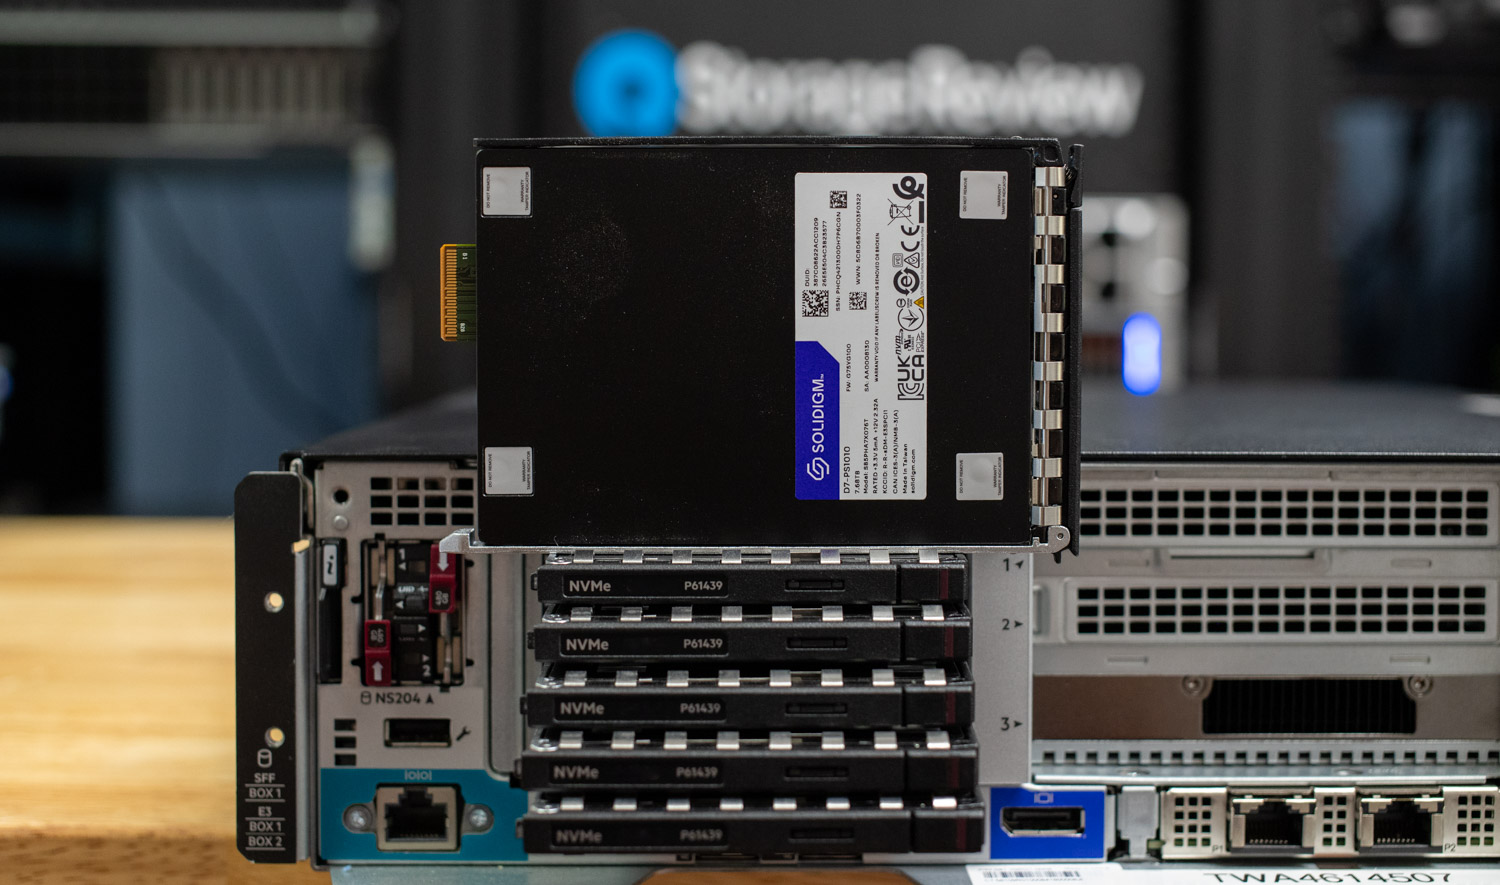
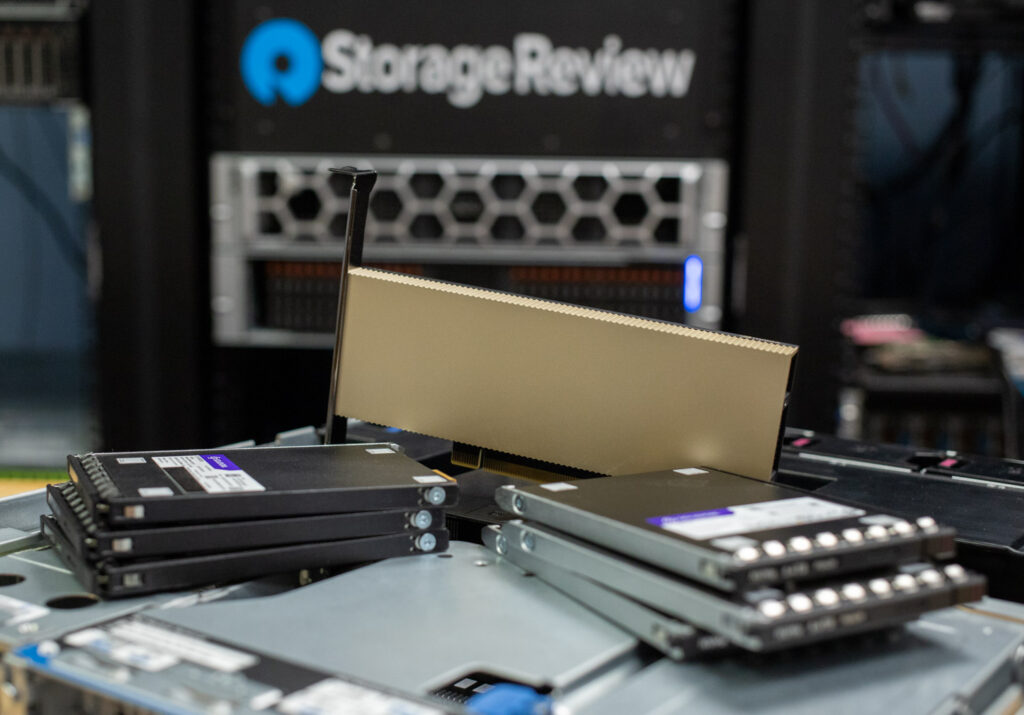
Wydajność pamięci masowej ma kluczowe znaczenie w każdym procesie przetwarzania multimediów, a DL145 obsługuje do sześciu dysków EDSFF E3.S NVMe, aby sprostać tym wymaganiom. W naszej konfiguracji wykorzystaliśmy sześć dysków SSD Solidigm D7-PS1010 E3.S, każdy o pojemności 7.68 TB. Te dyski PCIe 5.0 x4 zapewniają prędkość odczytu do 14 500 MB/s i zapisu do 10 000 MB/s, co łącznie daje prawie 46 TB szybkiej pamięci masowej. Zaprojektowane z myślą o sztucznej inteligencji i procesach przetwarzania multimediów, te dyski SSD oferują imponującą energooszczędność i mogą zapewnić nawet o 50% wyższą przepustowość w określonych fazach procesu przetwarzania w porównaniu z konwencjonalnymi dyskami NVMe. W przypadku zespołów wymagających dodatkowej pojemności, konfiguracja ta może zostać skalowana do 15.36 TB na dysk, zapewniając łącznie 92 TB szybkiej, gęstej pamięci masowej w kompaktowej obudowie.
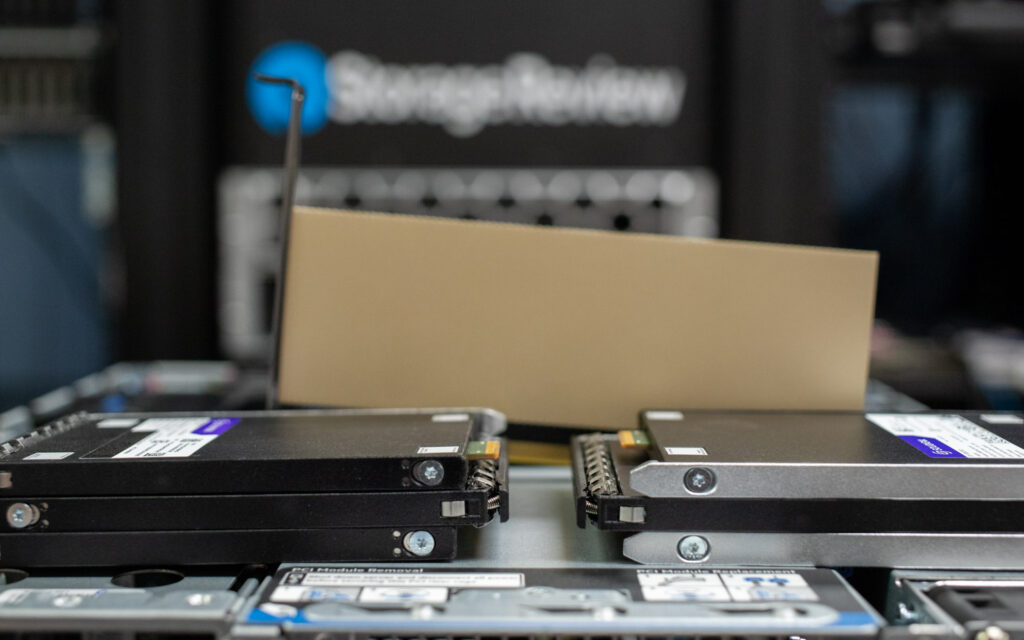
DL145 obsługuje do trzech jednoslotowych procesorów graficznych, a w naszej konfiguracji zastosowaliśmy pojedynczy akcelerator NVIDIA L4 – energooszczędny akcelerator oparty na architekturze Ada Lovelace. Zaprojektowany do przetwarzania wideo, wnioskowania AI, obliczeń wizualnych i wirtualizacji, L4 zapewnia solidną wydajność przy zużyciu zaledwie 72 watów. Posiada 24 GB pamięci VRAM GDDR6 i łączy się przez interfejs PCIe 4.0 x16, zarówno w celu zasilania, jak i przesyłania danych. Axle AI zaleca minimum 16 GB pamięci VRAM, a L4 z łatwością ją przewyższa, oferując dodatkowe 8 GB, zapewniając rezerwę mocy dla zadań multimedialnych o wysokiej rozdzielczości i operacji sterowanych przez AI.
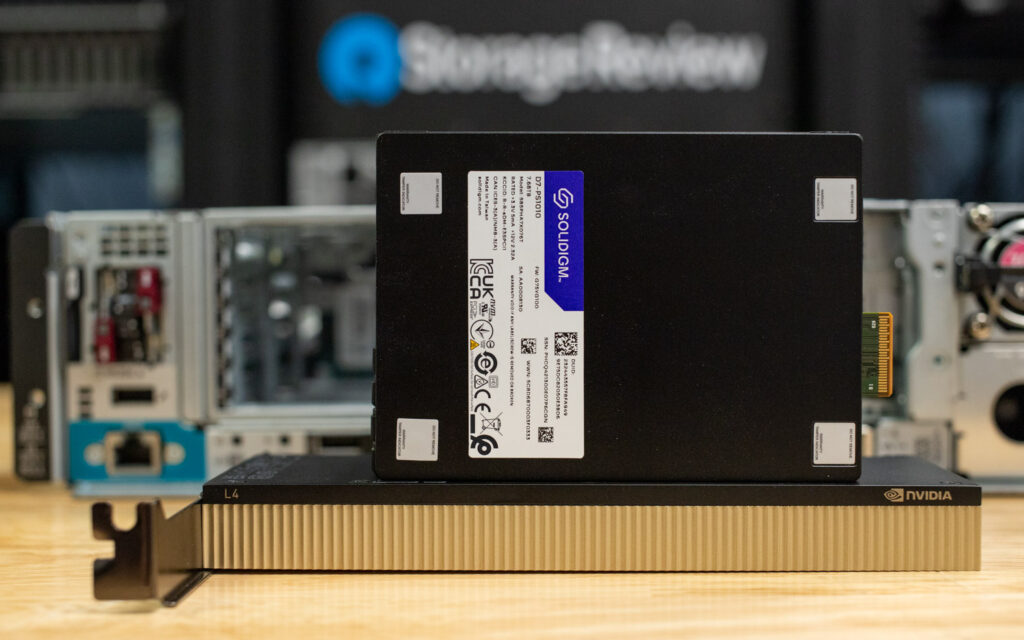
Karta graficzna Nvidia L4 z jednym gniazdem
W warstwie aplikacji wdrożyliśmy Axle AI MAM i Axle AI Tags przy użyciu środowiska wirtualnego Proxmox (8.3.5). System jest skonfigurowany z dwiema dedykowanymi maszynami wirtualnymi: jedną z systemem Axle AI MAM, a drugą z systemem Axle AI Tags. Taka struktura zapewnia wyraźne oddzielenie zarządzania multimediami od przetwarzania metadanych opartego na sztucznej inteligencji, jednocześnie umożliwiając płynną komunikację między komponentami.
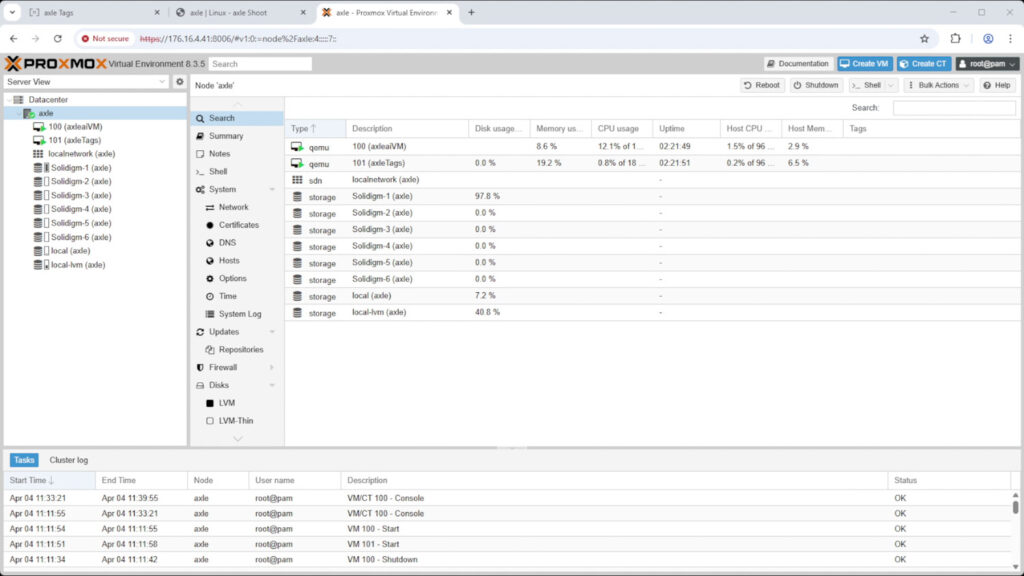
Podsumowanie środowiska i sprzętu Proxmox
Współpracując z MAM, Axle AI Tags oferuje lokalne możliwości AI, w tym wyszukiwanie semantyczne za pomocą wektorów, rozpoznawanie obiektów i logo oraz trenowalne wykrywanie twarzy. Jest wdrażany w kontenerze Docker i wykorzystuje procesor graficzny NVIDIA L4 poprzez złącze PCIe pass-through do wydajnego wnioskowania w czasie rzeczywistym. Interfejs do trenowania i administrowania oparty na przeglądarce umożliwia elastyczne dostrajanie, a modułowa konstrukcja obsługuje konfiguracje sprzętowe Intel/NVIDIA lub AMD/NVIDIA. Mimo pełnej integracji z MAM w naszej konfiguracji, Axle AI Tags oferuje również kompatybilność z interfejsem REST API, co pozwala na współpracę z innymi platformami.
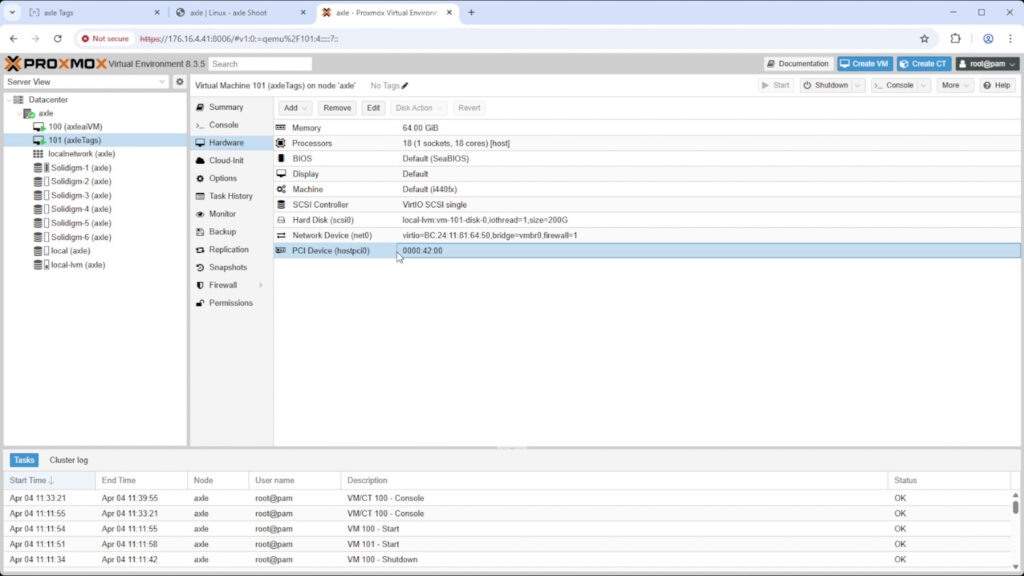
Konfiguracja sprzętowa maszyny wirtualnej Axle AI Tags
Dyski Solidigm PS1010 są montowane w maszynie wirtualnej Axle AI MAM, zapewniając szybki dostęp do nagrań z niskim opóźnieniem. Dzięki wirtualizacji całego stosu i przypisaniu dedykowanych zasobów obliczeniowych do każdego komponentu, ta konfiguracja zapewnia dłuższy czas sprawności, lepsze zarządzanie zasobami i obsługę wielu użytkowników, znacznie wykraczającą poza możliwości pojedynczej stacji roboczej. To sprawia, że idealnie nadaje się do środowisk produkcyjnych o dużej wydajności i współpracy.
Razem te komponenty tworzą ściśle zintegrowane rozwiązanie sprzętowe, które umożliwia szybkie, lokalne, oparte na sztucznej inteligencji przepływy pracy z mediami. To wydajna, gotowa do pracy w terenie platforma dla zespołów zdalnych, które wymagają niezawodnej wydajności w warunkach ograniczonej przestrzeni i mocy, a jednocześnie tam, gdzie przetwarzanie AI pozostaje niezbędne.
Wydajność HPE ProLiant DL145 Gen11
Przed przejściem do testów porównawczych, poniższa tabela przedstawia konfigurację systemu HPE ProLiant DL145 Gen11. Podczas testów z Axle AI przeprowadzonych na zwirtualizowanej instalacji z systemem Proxmox, system został przeniesiony na Ubuntu Server 22.04.5, aby zmierzyć wydajność pamięci masowej w naszych testach GDSIO i FIO.
| HPE ProLiant DL145 Gen 11 | Przegląd Sprzętu |
|---|---|
| CPU | Pojedynczy AMD EPYC 8434P |
| RAM | 256 GB ECC DDR5 |
| Dyski | 6 dysków SSD Solidigm D7-PS1010 E3s o pojemności 7.68 TB |
| Przechowywanie butów | Port NS204 2x zapełniony (480 GB Samsung PM9A3 M.2) |
| GPU | Pojedyncza karta NVIDIA L4 |
| System operacyjny | Ubuntu Server 22.04.5 |
Maksymalna wydajność syntetyczna
Test FIO to elastyczne i wydajne narzędzie testowe służące do pomiaru wydajności urządzeń pamięci masowej, w tym dysków SSD i HDD. Ocenia ono takie parametry, jak przepustowość, IOPS (liczba operacji wejścia/wyjścia na sekundę) oraz opóźnienie przy różnych obciążeniach, takich jak sekwencyjne i losowe operacje odczytu/zapisu. Test ten ma na celu rejestrowanie szczytowej wydajności i obciążanie systemu pamięci masowej przy wielu obciążeniach, co czyni go szczególnie przydatnym do porównywania różnych urządzeń lub konfiguracji. W tym przypadku przeprowadzono test pełnej powierzchni, wykorzystując całą pojemność dysków, aby zapewnić kompleksowy obraz ich stałych parametrów wydajnościowych.
W teście sekwencyjnego odczytu z wykorzystaniem bloków 128 KB, system osiągnął przepustowość 56.4 GB/s i utrzymał 430 000 IOPS przy średnim opóźnieniu 1.78 milisekundy. Wydajność zapisu sekwencyjnego przy tym samym rozmiarze bloku osiągnęła 45.4 GB/s, generując 346 000 IOPS i średnie opóźnienie 2.22 milisekundy. W przypadku losowych operacji odczytu z wykorzystaniem bloków 4 KB, system osiągnął 46.6 GB/s przy 11.4 miliona IOPS i niskim średnim opóźnieniu 0.269 milisekundy, co podkreśla potencjał macierzy pamięci masowej NVMe w zakresie wysokiej przepustowości przy intensywnym dostępie. Losowe operacje zapisu z wykorzystaniem bloków 4 KB osiągnęły przepustowość 29.1 GB/s, osiągając 7.1 miliona IOPS przy średnim opóźnieniu 0.432 milisekundy, co potwierdza solidną, stałą wydajność zapisu nawet w przypadku fragmentacji dostępu.
| Podsumowanie testu porównawczego FIO HPE DL145 Gen 11 | Przepustowość – GB/s | IOPS | Średnie opóźnienie |
|---|---|---|---|
| Odczyt sekwencyjny (128 KB) | 56.4 Gb / s | 430k | 1.78 ms |
| Zapis sekwencyjny (128 KB) | 45.4 Gb / s | 346k | 2.22 ms |
| Losowe czytanie (4KB) | 46.6 Gb / s | 11.4M | 0.269 ms |
| Losowy zapis (4K) | 29.1 Gb / s | 7.1M | 0.432 ms |
Bezpośrednie przechowywanie GPU
Jednym z testów, jakie przeprowadziliśmy na tym stanowisku testowym, był test Magnum IO GPU Direct Storage (GDS). GDS to funkcja opracowana przez firmę NVIDIA, która pozwala procesorom graficznym ominąć procesor główny (CPU) podczas uzyskiwania dostępu do danych przechowywanych na dyskach NVMe lub innych szybkich urządzeniach pamięci masowej. Zamiast kierować dane przez procesor i pamięć systemową, GDS umożliwia bezpośrednią komunikację między procesorem graficznym a urządzeniem pamięci masowej, znacznie redukując opóźnienia i poprawiając przepustowość danych.
Jak działa bezpośrednie przechowywanie danych GPU
Tradycyjnie, gdy procesor graficzny (GPU) przetwarza dane przechowywane na dysku NVMe, dane muszą najpierw przejść przez procesor (CPU) i pamięć systemową, zanim dotrą do procesora graficznego (GPU). Proces ten wprowadza wąskie gardła, ponieważ procesor (CPU) staje się pośrednikiem, zwiększając opóźnienia i zużywając cenne zasoby systemowe. Technologia GPU Direct Storage eliminuje ten problem, umożliwiając procesorowi graficznemu bezpośredni dostęp do danych z urządzenia pamięci masowej za pośrednictwem magistrali PCIe. Ta bezpośrednia ścieżka zmniejsza obciążenie związane z przesyłaniem danych, umożliwiając szybsze i bardziej wydajne przesyłanie danych.
Obciążenia sztucznej inteligencji, zwłaszcza te wykorzystujące uczenie głębokie, charakteryzują się wysoką intensywnością przetwarzania danych. Trenowanie dużych sieci neuronowych wymaga przetwarzania terabajtów danych, a każde opóźnienie w transferze danych może prowadzić do niewykorzystania procesorów graficznych (GPU) i wydłużenia czasu trenowania. Technologia GPU Direct Storage rozwiązuje ten problem, zapewniając jak najszybsze dostarczanie danych do procesora graficznego (GPU), minimalizując czas przestoju i maksymalizując wydajność obliczeniową.
Ponadto GDS jest szczególnie przydatny w przypadku obciążeń wymagających strumieniowego przesyłania dużych zbiorów danych, takich jak przetwarzanie wideo, przetwarzanie języka naturalnego czy wnioskowanie w czasie rzeczywistym. Zmniejszając zależność od procesora, GDS przyspiesza przesyłanie danych i uwalnia zasoby procesora do innych zadań, co dodatkowo zwiększa ogólną wydajność systemu.
Odczyt sekwencyjny GDSIO
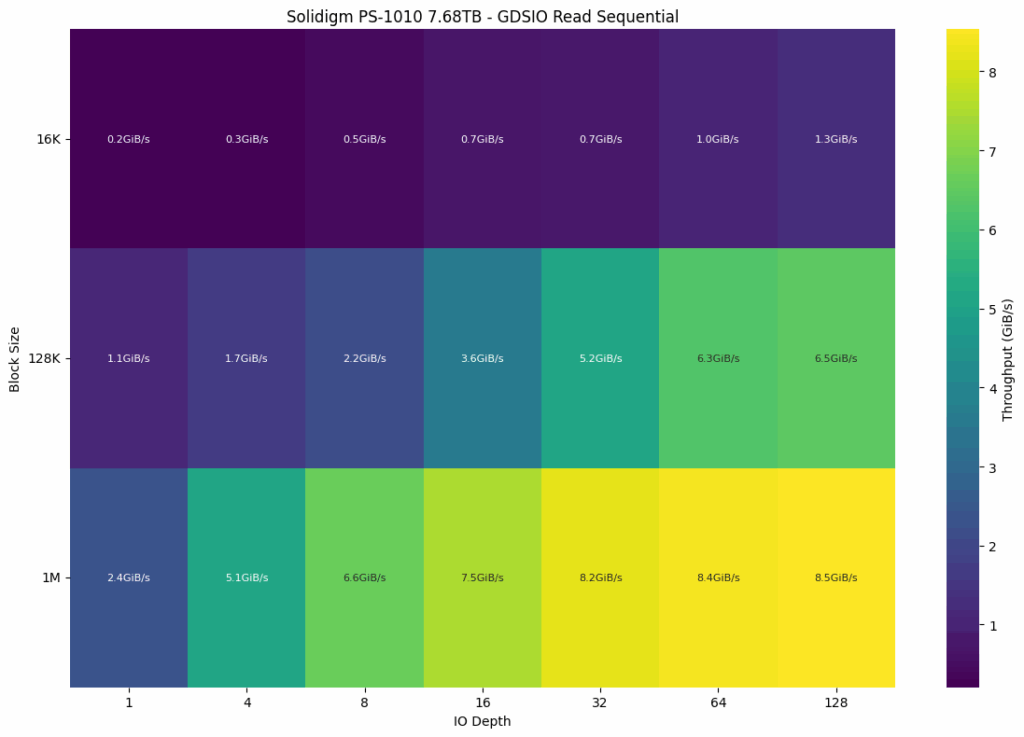
W teście sekwencyjnego odczytu GDSIO dysku Solidigm PS1010 o pojemności 7.68 TB wydajność znacząco rosła wraz z rozmiarem bloku i głębokością operacji wejścia/wyjścia. Przy najmniejszym bloku o rozmiarze 16 KB przepustowość zaczynała się od zaledwie 0.2 GiB/s przy głębokości kolejki 1 i stopniowo rosła do 1.3 GiB/s przy głębokości 128, co wskazywało na ograniczoną skalowalność przy takiej granularności. Po przekroczeniu 128 KB bloków wydajność poprawiła się jeszcze bardziej, zaczynając od 1.1 GiB/s i osiągając 6.5 GiB/s przy największej głębokości. Najlepsze wyniki uzyskano dla bloku o rozmiarze 1 MB, gdzie przepustowość początkowo osiągnęła 2.4 GiB/s i osiągnęła szczyt 8.5 GiB/s przy głębokości kolejki 128, co wskazuje, że optymalny profil wydajności dysku uzyskuje się przy dużych sekwencyjnych odczytach i głębszych kolejkach.
Zapis sekwencyjny GDSIO
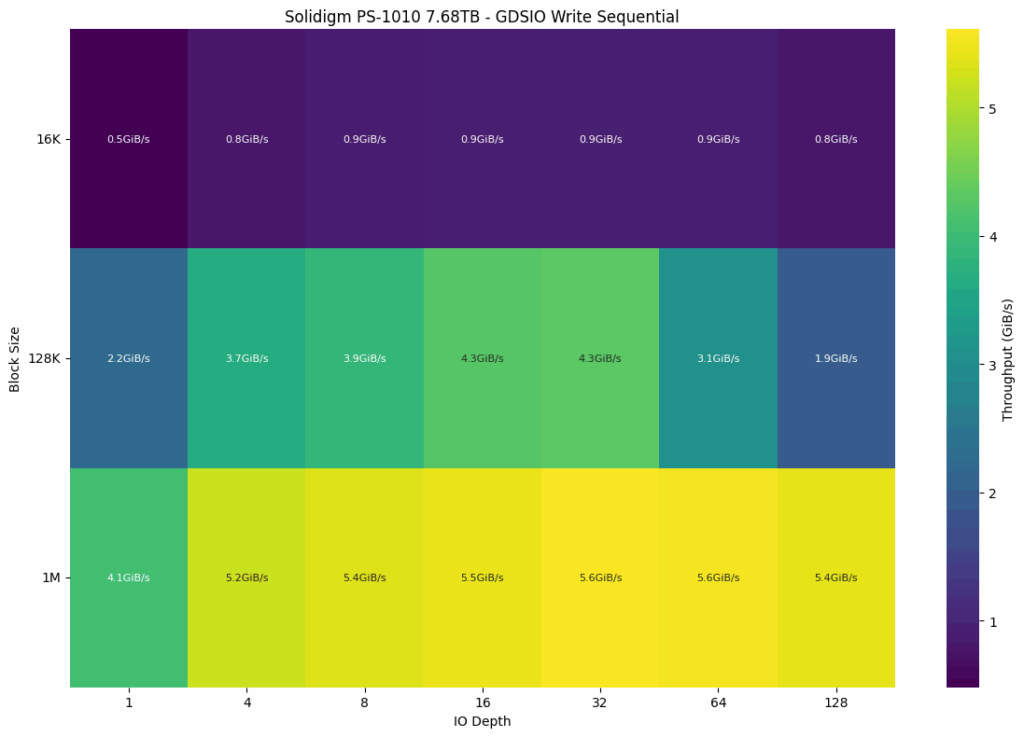
Wydajność zapisu sekwencyjnego na Solidigm PS1010 charakteryzuje się solidną skalowalnością przy większych rozmiarach bloków, ale wykazuje pewien spadek przy wyższych głębokościach kolejek w obciążeniach średniej wielkości. Przy najmniejszym rozmiarze bloku 16 KB, prędkość zapisu zaczynała się od 0.5 GiB/s i osiągała umiarkowanie wysoki poziom 0.9 GiB/s od głębokości kolejek 8 do 64, po czym nieznacznie spadała do 0.8 GiB/s na głębokości 128. Przy blokach 128 KB, wydajność zaczynała się od 2.2 GiB/s, wzrastała do 4.3 GiB/s na głębokości 32, a następnie spadała do zaledwie 1.9 GiB/s przy najgłębszej kolejce, co wskazuje na potencjalne nasycenie lub ograniczenie przepustowości zapisu. Najlepszą stałą wydajność osiągnięto przy blokach o rozmiarze 1M, gdzie przepustowość skalowała się płynnie od 4.1 GiB/s na głębokości 1 do 5.6 GiB/s na głębokościach 32 i 64, pozostając stabilna do głębokości 128.
Podsumowanie GDSIO
Ta tabela przedstawia przejrzyste zestawienie metryk wydajności GDSIO dotyczących opóźnień i operacji wejścia/wyjścia na sekundę (IOPS) zebranych na dysku SSD Solidigm D7-PS1010, mierzonych dla bloków o rozmiarach 16 KB, 128 KB i 1 MB oraz głębokości IO 128. Przy głębokości kolejki 128, opóźnienie i operacje wejścia/wyjścia na sekundę (IOPS) skalują się przewidywalnie wraz z rozmiarem bloku. Odczyt bloku 16 KB trwał średnio 1.549 ms przy 82.3 tys. operacji wejścia/wyjścia na sekundę (IOPS), a opóźnienie zapisu wyniosło 2.429 ms przy 52.6 tys. operacji wejścia/wyjścia na sekundę (IOPS). Przy 128 KB bloków opóźnienie odczytu wzrosło do 2.414 ms (52.9 tys. operacji wejścia/wyjścia na sekundę), a opóźnienie zapisu do 8.050 ms (15.9 tys. operacji wejścia/wyjścia na sekundę). Przy 1M opóźnienie odczytu osiągnęło 14.643 ms przy 8.7 tys. operacji wejścia/wyjścia na sekundę (IOPS), a opóźnienie zapisu wzrosło do 23.030 ms przy 5.6 tys. operacji wejścia/wyjścia na sekundę (IOPS).
| Wykres GDSIO (średnie rozmiary bloków: 16 KB, 128 KB, 1 MB) | HPE DL145 Gen 11 (6 dysków SSD Solidigm D7-PS1010 E3s o pojemności 7.68 TB) |
|---|---|
| (Rozmiar bloku 16 KB, głębokość IO 128) Średni odczyt | 1.3 GiB/s (1.549 ms) IOPS: 82.3 K |
| (Rozmiar bloku 16 KB, głębokość IO 128) Średni zapis | 0.8 Gb/s (2.429 ms) IOPS: 52.6 KB |
| (Rozmiar bloku 128 KB, głębokość IO 128) Średni odczyt | 6.5 GiB/s (2.414 ms) IOPS: 52.9 K |
| (Rozmiar bloku 128 KB, głębokość IO 128) Średni zapis | 1.9 GiB/s (8.050 ms) IOPS: 15.9 K |
| (Rozmiar bloku 1 MB, głębokość 128 IO) Średni odczyt | 8.5 GiB/s (14.643 ms) IOPS: 8.7 K |
| (Rozmiar bloku 1 MB, głębokość IO 128) Średni zapis | 5.4 GiB/s (23.030 ms) IOPS: 5.6 K |
Produkcja medialna na krawędzi
Czym jest Axle AI?
Axle AI to lokalna platforma do zarządzania zasobami multimedialnymi (MAM) oparta na sztucznej inteligencji, która upraszcza przepływy pracy z materiałami wideo w małych i średnich zespołach medialnych. Automatyzuje kluczowe zadania, takie jak pobieranie, tagowanie i wyszukiwanie multimediów, bez kosztów i złożoności tradycyjnych systemów MAM. Zaprojektowana z myślą o szybkości i łatwości użytkowania, platforma Axle AI umożliwia zespołom efektywniejsze zarządzanie treściami i ich dostarczanie, niezależnie od tego, czy pracują w biurze, czy zdalnie.
Platforma obsługuje cały proces produkcyjny. Automatycznie pobiera materiał filmowy, tworzy proxy, stosuje metadane oparte na sztucznej inteligencji, korzystając z funkcji takich jak rozpoznawanie obiektów, wykrywanie twarzy i wyszukiwanie semantyczne, a także integruje się ze standardowymi narzędziami do edycji, takimi jak Adobe Premiere Pro i DaVinci Resolve. Dzięki temu zespoły mogą szybko lokalizować, edytować i publikować treści bez wąskich gardeł i opóźnień.
Rzeczywiste przypadki użycia
Z Axle AI korzysta wiele zróżnicowanych zespołów medialnych, w tym nadawcy, twórcy filmów dokumentalnych, działy wideo dla firm, agencje marketingowe i producenci wydarzeń na żywo. Zespoły te często pracują w wielu lokalizacjach i wymagają niezawodnego dostępu do swoich bibliotek multimediów bez konieczności stosowania rozbudowanej infrastruktury.
Dzięki Axle AI użytkownicy mogą współpracować zdalnie za pośrednictwem interfejsu opartego na przeglądarce, który zapewnia natychmiastowy dostęp do materiałów proxy. Montażyści mogą natychmiast rozpocząć montaż materiału w preferowanych przez siebie systemach montażu nieliniowego (NLE), a producenci i osoby zainteresowane przeglądają, tagują i zatwierdzają klipy w czasie rzeczywistym (bez konieczności przesyłania dużych plików ani specjalistycznych umiejętności technicznych).
Niezależnie od tego, czy Twój zespół liczy pięć, czy pięćdziesiąt osób, Axle AI umożliwia szybsze i bardziej wydajne przepływy pracy. Prosty interfejs, szybkie wdrożenie i kompatybilność z istniejącymi systemami pamięci masowej sprawiają, że jest to inteligentne rozwiązanie do rozproszonej produkcji multimediów o dużej objętości.
Rosnące zapotrzebowanie na natychmiastowe media społecznościowe drastycznie zwiększyło tempo produkcji mediów. Panuje zasada „jeśli nie jesteś pierwszy, jesteś ostatni”, zwłaszcza w przypadku wydarzeń na żywo i tworzenia treści do nich. Firmy medialne potrzebowały wydajnego sposobu na organizację i szybkie przeglądanie dużych ilości materiału filmowego. Narzędzia takie jak Axle AI, dzięki możliwości skalowania do małych operacji, umożliwiają praktyczne zastosowanie tego procesu w terenie. W połączeniu z odpowiednim procesem, takim jak kamery, które mogą jednocześnie rejestrować pliki proxy i surowe nagrania, możliwości zwiększenia wydajności rosną.
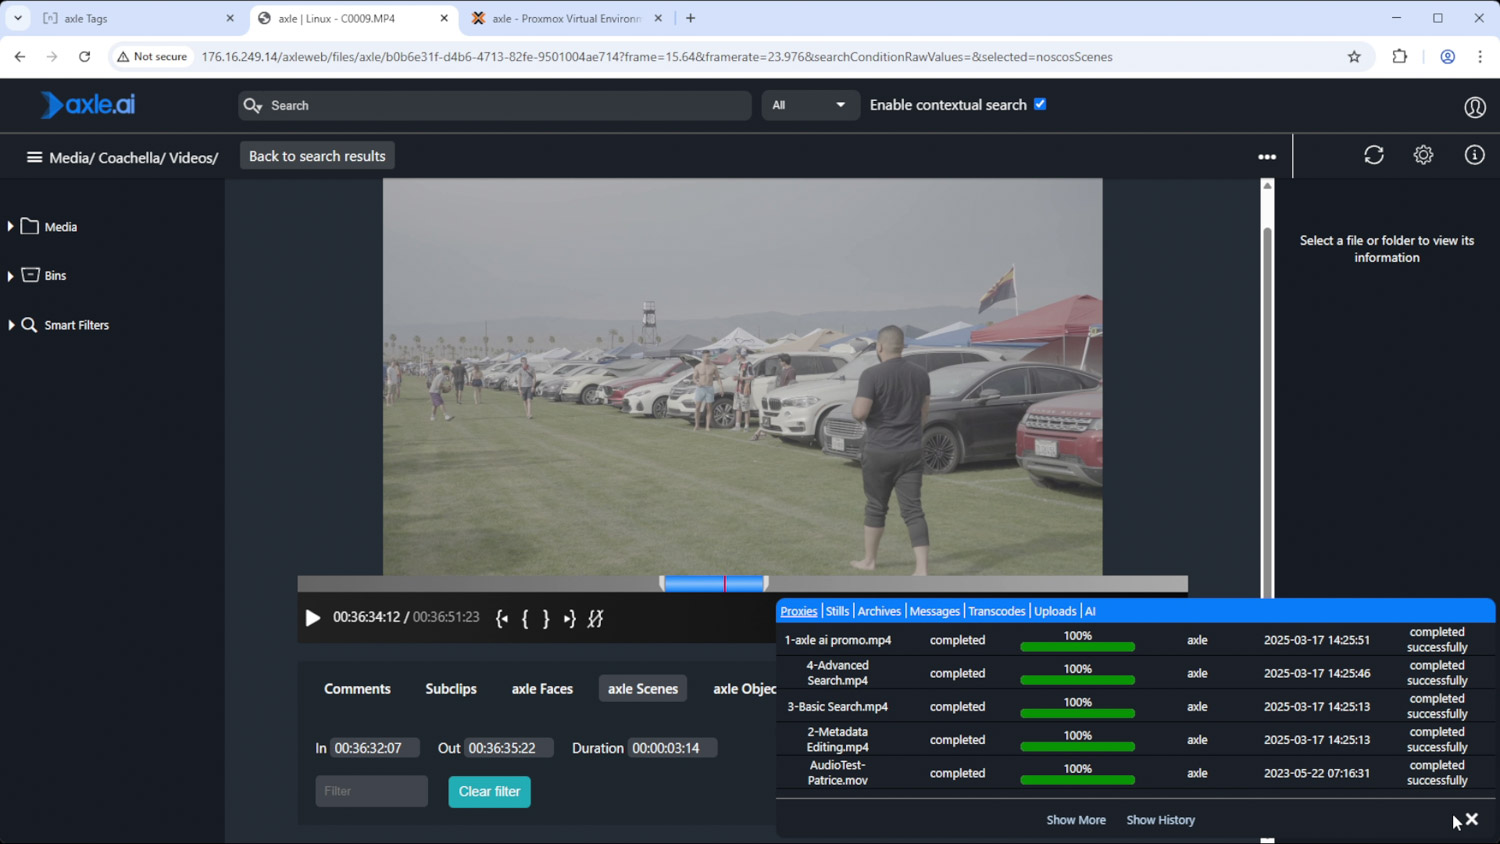
Zapisywanie zarówno plików proxy o wysokiej, jak i niskiej rozdzielczości podczas przechwytywania oraz natychmiastowe przetwarzanie mniejszych plików proxy w tagach Axle AI pozwala na niemal natychmiastowe przeszukiwanie całego materiału. Montażyści mogą natychmiast rozpocząć pracę dzięki integracji Axle AI z większością popularnych programów do edycji nieliniowej, takich jak Adobe Premiere Pro, DaVinci Resolve i Avid Media Composer. Odciąża to również zespół produkcyjny, pozwalając mu skupić się na innych zadaniach i uniknąć wypalenia zawodowego.
Tradycyjnie, rejestrowanie było jednym z najbardziej pracochłonnych i najczęściej pomijanych aspektów procesu przechwytywania multimediów. Axle AI automatycznie rejestruje materiały multimedialne za pomocą opisów scen generowanych przez sztuczną inteligencję, zamiast tradycyjnych pól metadanych, pozwalając montażyście zapoznać się z zawartością klipu przed jego przeglądaniem. Oferuje również narzędzia wyszukiwania semantycznego, umożliwiając montażystom i producentom szybkie znajdowanie odpowiednich materiałów na podstawie pojęć i tematów, zamiast polegania na konkretnych tagach.
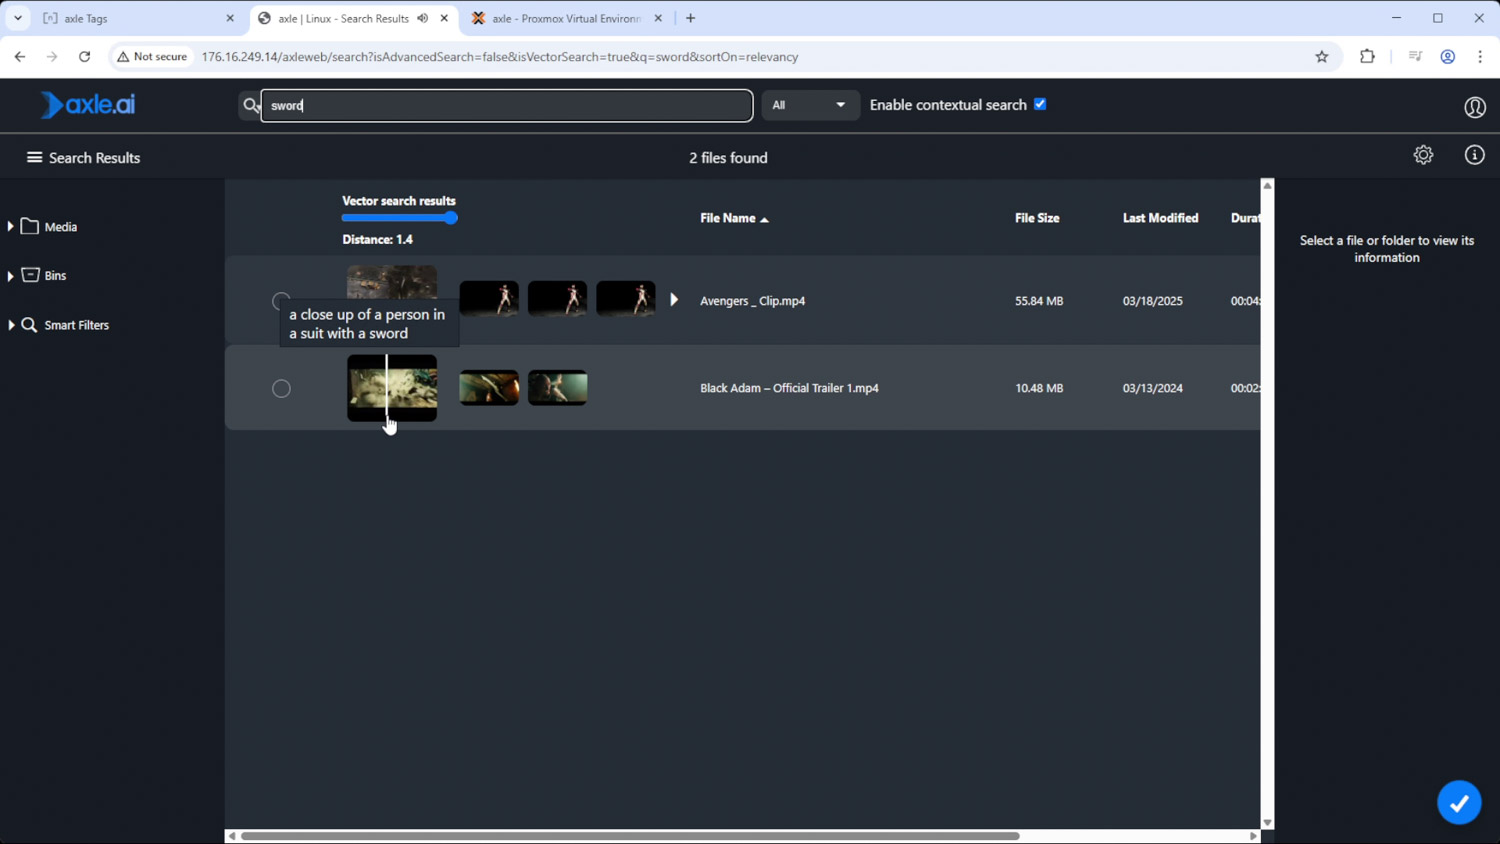
Skalowalność jest również kluczowa, ponieważ nie wszystkie zadania wymagają szybkiej, lokalnej produkcji materiałów medialnych. Axle AI można skonfigurować w bardziej wydajnym, stacjonarnym systemie z dostępem do zapasów materiałów filmowych firmy medialnej za pośrednictwem udziału sieciowego. Umożliwia to redaktorom i producentom szybsze wyszukiwanie odpowiednich materiałów, a nawet odnajdywanie tych, których wcześniej nie brali pod uwagę, a które „zaginęły” w archiwach. Twórcy treści i nadawcy mogą znacząco skorzystać z tego rodzaju indeksu zaległości, generując większą wartość z materiałów, które w przeciwnym razie zalegałyby bezczynnie na serwerze. Choć z pewnością nie jest to rozwiązanie niezawodne, może ono dać firmom medialnym przewagę w niektórych z najbardziej czasochłonnych aspektów procesu tworzenia materiałów medialnych.
HPE ProLiant DL145 Gen11 stanowi podstawę sprzętową dla tego wdrożenia AI na brzegu sieci, oferując imponującą równowagę między gęstością obliczeniową, przepustowością pamięci masowej i akceleracją GPU w kompaktowej obudowie. Napędzany 48-rdzeniowym procesorem AMD EPYC 8434P z energooszczędnej serii 8004, system ten jest zoptymalizowany pod kątem obciążeń wielowątkowych, zachowując jednocześnie niskie zużycie energii. Konfiguracja obejmuje 256 GB pamięci RAM i pojedynczy procesor graficzny NVIDIA L4, wysoce wydajny akcelerator doskonale nadający się do wnioskowania AI na brzegu sieci. Pamięć masowa jest wyposażona w sześć dysków SSD Solidigm D7-PS1010 E3.S, każdy o pojemności 7.68 TB, zapewniając wystarczającą, wydajną pamięć flash dla zasobów multimedialnych i obciążeń intensywnie korzystających z metadanych. Dzięki obsłudze do trzech procesorów GPU o pojedynczej szerokości i łącznie sześciu dysków E3.S, DL145 Gen11 jest doskonale przygotowany do skalowania w wymagających zastosowaniach wideo i AI. Ta konfiguracja podkreśla znaczenie starannego montażu nowoczesnych komponentów sprzętowych, w tym procesora, procesora graficznego i dysków SSD, aby zapewnić wyjątkową wydajność dla przepływów pracy AI skoncentrowanych na brzegu sieci, takich jak te obsługiwane przez Axle AI.
Wniosek
Rozwiązanie Axle AI zmienia sposób produkcji treści wideo, szczególnie w przypadku zespołów pracujących w czasie rzeczywistym przy ograniczonych zasobach. Łącząc inteligentne zarządzanie zasobami multimedialnymi z zaawansowanymi narzędziami do wnioskowania, Axle AI zapewnia poziom automatyzacji i responsywności, którego tradycyjne systemy MAM nie są w stanie osiągnąć. W połączeniu z serwerem brzegowym HPE ProLiant DL145 Gen11, kartą graficzną NVIDIA L4 i dyskami SSD Solidigm Gen5, zbudowane przez nas rozwiązanie zapewnia kompaktowe, wydajne środowisko zoptymalizowane pod kątem nowoczesnych procesów pracy z mediami. Niezależnie od tego, czy jest używane w terenie, czy jako element hybrydowego procesu edycji, ta konfiguracja zapewnia skalowalny i wydajny sposób pobierania, tagowania, wyszukiwania i dostarczania treści wideo szybciej niż kiedykolwiek wcześniej, bez utraty jakości i kontroli. Dla zespołów, którym zależy na utrzymaniu przewagi w dynamicznym środowisku treści, połączenie infrastruktury brzegowej i wspomaganych przez sztuczną inteligencję procesów pracy oferuje znaczącą przewagę konkurencyjną.



 Amazon