

Wraz z rosnącą popularnością programowania wspomaganego sztuczną inteligencją, warto zapewnić dzieciom wydajniejszą platformę obliczeniową i graficzną. Owszem, istnieją korzyści, takie jak granie w najnowsze gry, ale pojawia się również możliwość wdrażania zaawansowanych narzędzi sztucznej inteligencji i lokalnych programów nauczania (LLM) lokalnie w systemie. Stanowi to wyraźny kontrast z platformami podstawowymi, od których wiele osób zazwyczaj zaczyna, a które ograniczają się jedynie do przeglądania stron internetowych lub oprogramowania biurowego. W tym artykule analizujemy, jak komputer do gier – wyposażony w wysokiej klasy procesor graficzny i szybką pamięć masową – może służyć zarówno jako elitarny zestaw do gier, jak i wydajna platforma do nauki kodowania z wykorzystaniem sztucznej inteligencji.
Pomysł systemu do gier przekształconego w stację roboczą z AI nie jest nowy; część tego tematu poruszyliśmy w zeszłym roku w artykule, w którym omówiliśmy różnice między modelami Dell Alienware R16 i Dell Precision 5860. Podczas gdy tamten artykuł koncentrował się na różnicach w wydajności między procesorami graficznymi i sterownikami klasy konsumenckiej i stacji roboczej w szerokim zakresie obciążeń, ten artykuł skupi się na tym, dlaczego system do gier może przynieść korzyści osobie uczącej się AI. Narzędzia wykorzystujące AI również nie zwalniają tempa, a wiele zapowiedzi dotyczy nowych procesorów graficznych NVIDIA z serii 50.
Jeśli Twoje dziecko uczęszcza do szkoły podstawowej i średniej (K-12), dostarczony system będzie zazwyczaj podstawowym Chromebookiem. Platformy te mają zalety pod względem ceny, łatwości serwisowania i dostępu do technologii, ale nie sprawdzają się w zaawansowanych zastosowaniach. Oto domowy komputer do gier, który może zapewnić niezliczone godziny zabawy, a jednocześnie jest wyposażony w jeden z najbardziej ekonomicznych podzespołów do prac nad rozwojem sztucznej inteligencji.
Wszystko zaczęło się od pytania mojego 11-letniego syna, czy mógłby użyć sztucznej inteligencji do stworzenia gry wideo. Z pomocą przedstawiłem mu Abacus.AI i pokazałem, jak stworzyć komunikat tekstowy do pisania kodu w Pythonie, zainstalować Pythona w systemie Windows i uruchomić projektowane przez siebie gry. Zajęło mi to zaledwie 15 minut. Nie miał żadnego doświadczenia w programowaniu i chyba po raz pierwszy instalowałem środowisko Pythona w systemie Windows. To było niezwykłe doświadczenie, móc to zobaczyć na własne oczy.
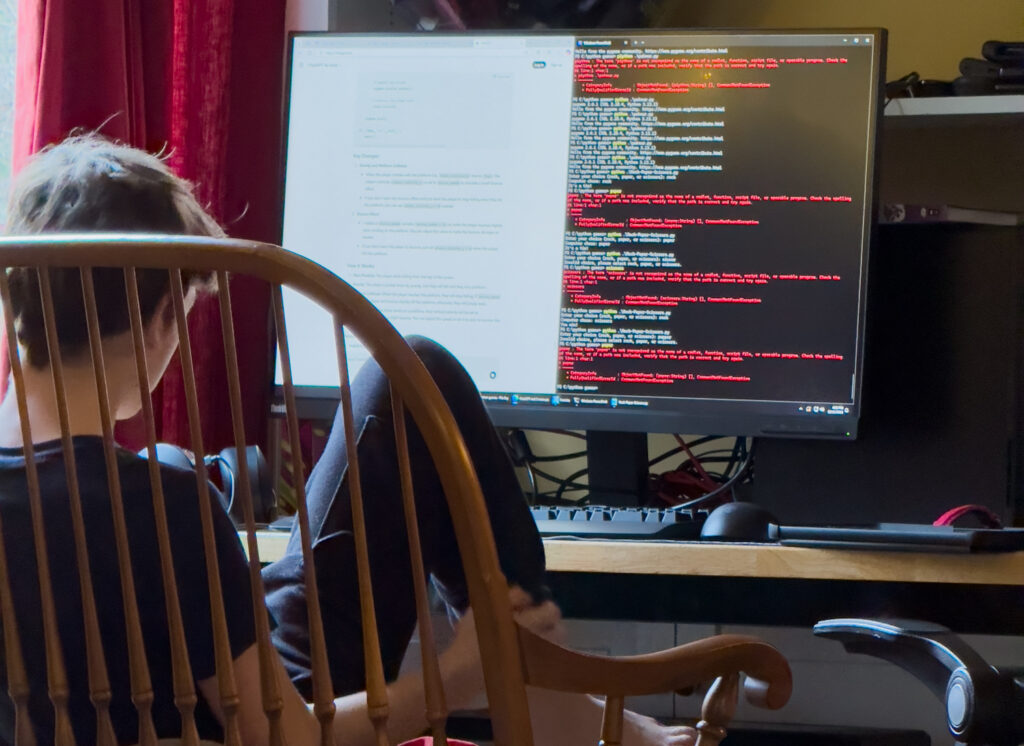
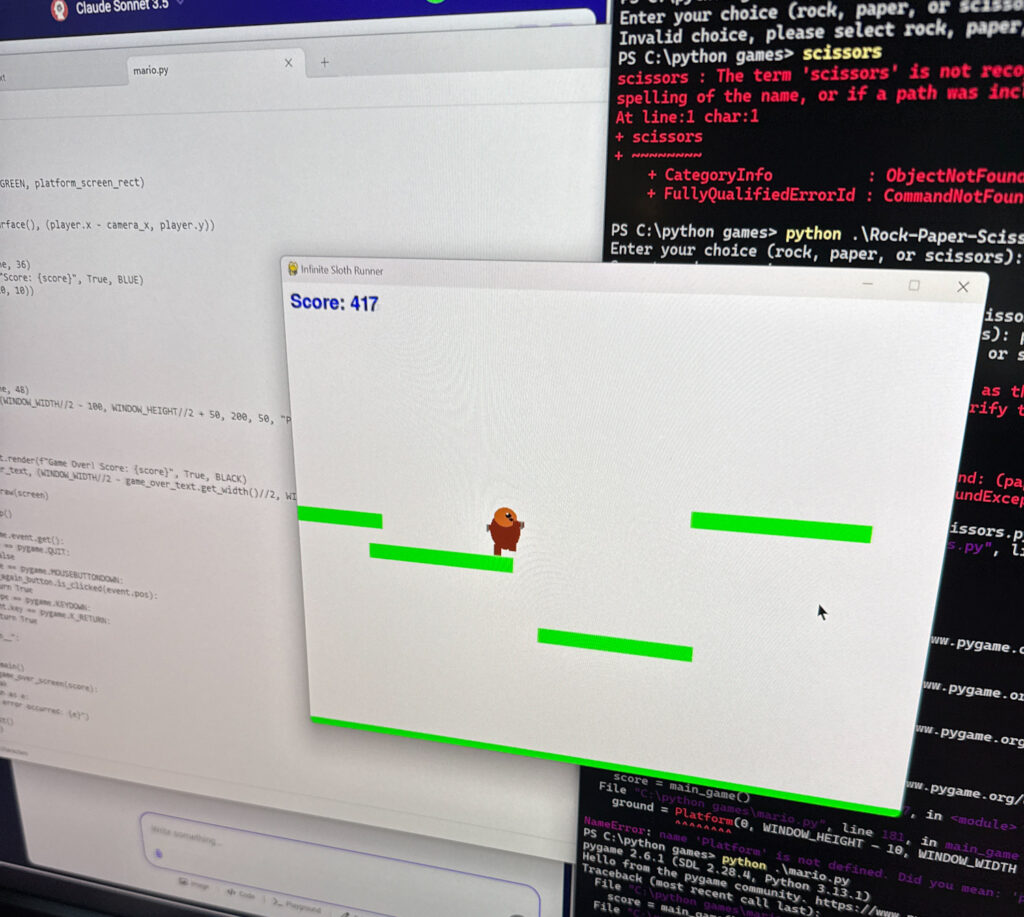
Miał mnóstwo pomysłów na gry do wypróbowania. Na początku były gry z tekstowymi podpowiedziami, takie jak „Kamień, papier, nożyce”, ale z czasem ewoluowały w grę platformową z graficznym interfejsem użytkownika. Pierwsza wersja składała się z małego czerwonego klocka, który mógł odbijać się na początku gry i wymagał wsparcia fizyki. Szybko przekształcił się w leniwca skaczącego po platformach.
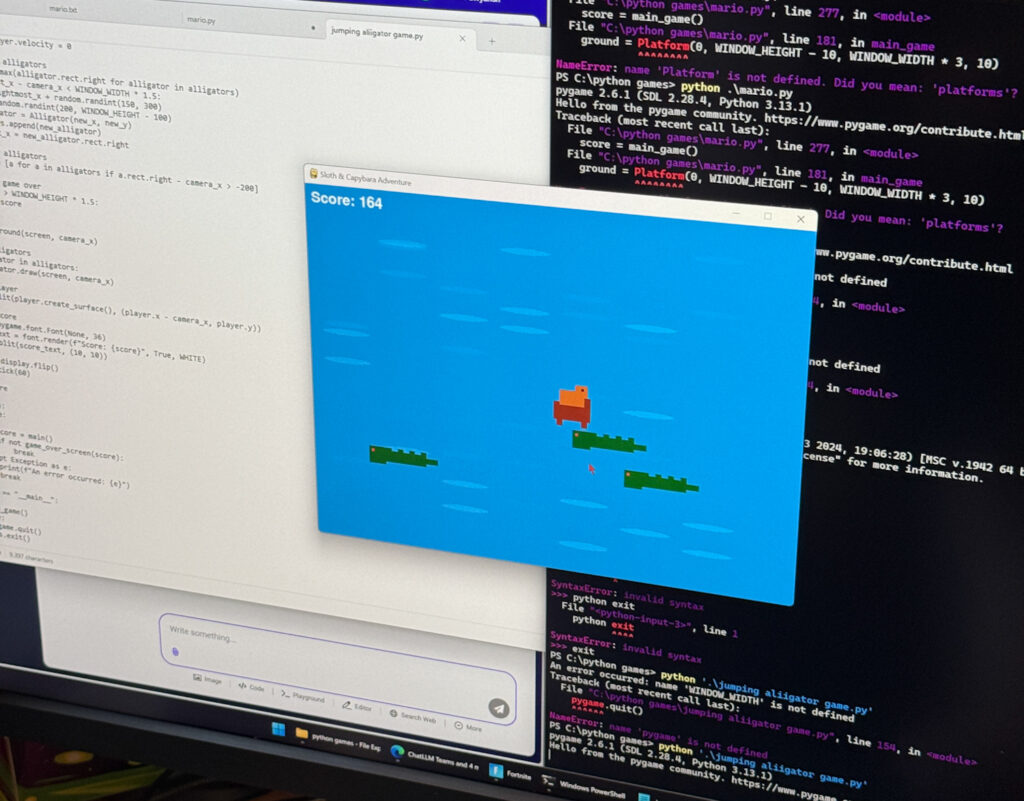
Ostateczna wersja tej gry przekształciła się w grę przygodową o leniwcu i kapibary, w której postacie skaczą nad wodą pełną aligatorów. Było to surrealistyczne doświadczenie, ale pokazuje, że dzieci potrafią zdziałać cuda, mając przed sobą odpowiednie narzędzia.
W tym artykule omówimy kilka obszarów sztucznej inteligencji, które mogą być z łatwością eksplorowane w domu, zarówno przez młodszych, jak i starszych odbiorców. Rozwiązania oparte na chmurze, takie jak Abacus AI, OpenAI i inne, są łatwe w obsłudze i nie wymagają specjalistycznego sprzętu. Te narzędzia AI oferują szeroki zakres modeli tekstowych, graficznych, wideo i niezliczone inne.
Rozwiązania AI oparte na chmurze
Rozwiązania AI oparte na chmurze zrewolucjonizowały sposób, w jaki wchodzimy w interakcje ze sztuczną inteligencją i uczymy się od niej. Platformy te zapewniają dostęp do najnowocześniejszych modeli bez konieczności inwestowania w drogi sprzęt – popularne rozwiązania, takie jak ChatGPT i Claude firmy Anthropic. Jednak jedną z platform, która wyróżnia się wszechstronnością i wartością, jest Abacus.ai.
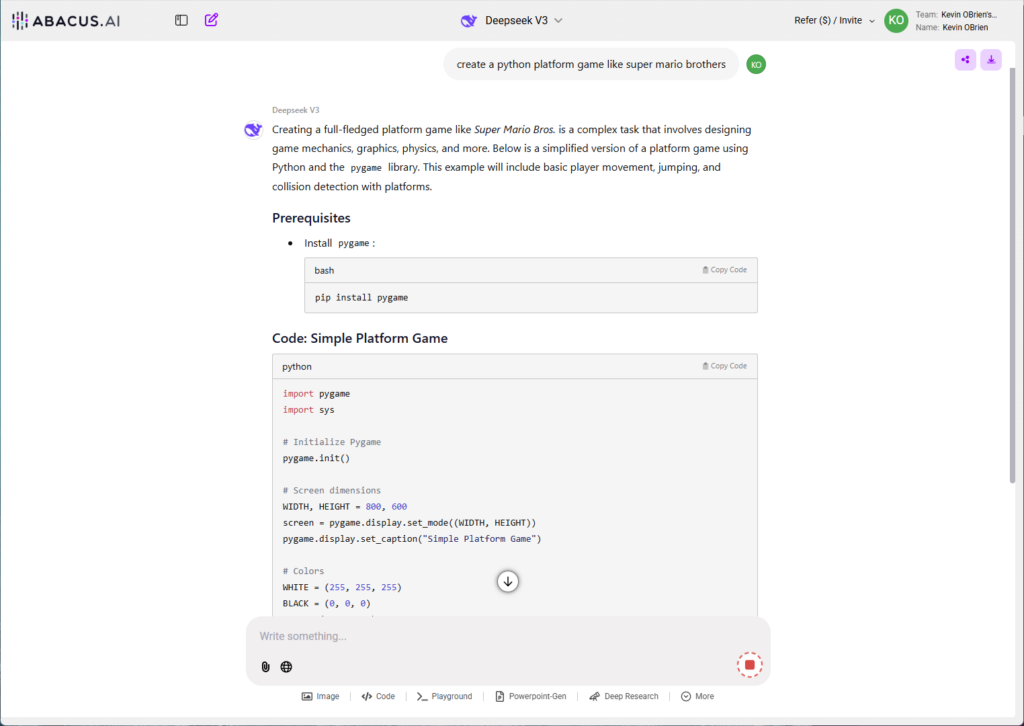
Na przykład CodeLLM pozwala użytkownikom programować bezpośrednio w internetowym środowisku IDE, jednocześnie komunikując się z chatbotem, który zapewnia pomoc w czasie rzeczywistym. Ta funkcja jest idealna dla początkujących programistów uczących się kodowania lub doświadczonych programistów, którzy chcą szybko tworzyć prototypy. Funkcja Code Playground idzie o krok dalej, umożliwiając użytkownikom wykonywanie kodu bezpośrednio w przeglądarce, eliminując potrzebę konfiguracji lokalnej. Jest to szczególnie przydatne przy tworzeniu animacji interaktywnych.
Abacus oferuje również funkcje takie jak Deep Research, która integruje sztuczną inteligencję z procesami badawczymi, oraz AI Engineer, który może automatycznie tworzyć boty do określonych zadań. Funkcje te ułatwiają rozpoczęcie pracy z AI, niezależnie od tego, czy zgłębiasz tajniki kodowania, generujesz obrazy, czy tworzysz interaktywne aplikacje. Nawet zwykły laptop lub Chromebook może stać się potężnym narzędziem edukacyjnym dla rodziców lub nauczycieli w połączeniu z rozwiązaniem chmurowym, takim jak Abacus.AI.
Lokalna sztuczna inteligencja
Nasuwa się naturalne pytanie: skoro rozwiązania oparte na chmurze są tak tanie, dostępne i łatwe w użyciu, po co w ogóle zawracać sobie głowę lokalną sztuczną inteligencją? Odpowiedź tkwi w unikalnych zaletach, jakie oferuje lokalna sztuczna inteligencja, co może uczynić ją atrakcyjnym wyborem dla niektórych użytkowników, zwłaszcza tych z zaawansowanymi komputerami do gier lub tych, którzy chcą mieć większą kontrolę nad swoimi procesami pracy z wykorzystaniem sztucznej inteligencji.
Odpowiedź leży w prywatności, kontroli i dostępności. Lokalne uruchamianie modeli AI gwarantuje, że Twoje dane pozostaną na Twoim komputerze, oferując niezrównaną prywatność i idealnie nadaje się do projektów wymagających ochrony prywatności lub do użytku osobistego. Zapewnia również dostęp offline, dzięki czemu jest niezawodny w obszarach o słabej łączności lub podczas awarii serwerów. W przypadku intensywnych użytkowników, lokalna sztuczna inteligencja może być bardziej opłacalna w dłuższej perspektywie, ponieważ po skonfigurowaniu sprzętu nie ma cyklicznych opłat za użytkowanie. Lokalna sztuczna inteligencja oferuje również swobodę i elastyczność. Możesz dostosowywać i dostrajać modele, eksperymentować z opcjami open source, a nawet trenować swoje modele. Ponadto, praktyczne podejście pomoże Ci rozwinąć cenne umiejętności techniczne.
Wymagania sprzętowe
Uruchomienie lokalnej sztucznej inteligencji (AI) wiąże się z pewnymi wyzwaniami sprzętowymi, dlatego temat dostosowania systemu do gier do tego celu wydaje się sensowny. Chociaż niektóre lokalne pakiety AI mogą wykorzystywać procesor (CPU), o czym mowa poniżej, prawie wszystkie preferują karty graficzne (GPU), a konkretnie NVIDIA. Obecnie najpopularniejsze są karty graficzne NVIDIA, a pamięć VRAM jest czynnikiem bramkującym. Biorąc za przykład karty NVIDIA GeForce z serii 40, analizujemy, ile pamięci VRAM ma każda z nich:
- NVIDIA GeForce RTX 4050 (8 GB pamięci VRAM)
- NVIDIA GeForce RTX 4060 (12 GB pamięci VRAM)
- NVIDIA GeForce RTX 4070 (16 GB pamięci VRAM)
- NVIDIA GeForce RTX 4080 (20 GB pamięci VRAM)
- NVIDIA GeForce RTX 4090 (24 GB pamięci VRAM)
Ogólnie rzecz biorąc, wraz ze wzrostem rozmiaru lub precyzji modelu, wzrasta zapotrzebowanie na pamięć VRAM. Poniżej znajduje się zestawienie modeli DeepSeek R1 o rozmiarze od 1.5 do 70 B i poziomach precyzji FP4 do FP8. Szybko zauważysz, że większość konsumenckich procesorów graficznych będzie ograniczona do mniejszych modeli. Rozmiar pamięci VRAM również będzie się wahał w zależności od przeznaczenia modelu, dlatego potrzebujesz pewnego zapasu.
| Rozmiar modelu DeepSeek R1 | Pamięć VRAM wnioskowania (FP8) | Pamięć VRAM wnioskowania (FP4) |
|---|---|---|
| 1.5B | ~ 1.5 GB | ~ 0.75 GB |
| 7B | ~ 7 GB | ~ 3.5 GB |
| 8B | ~ 8 GB | ~ 4 GB |
| 14B | ~ 14 GB | ~ 7 GB |
| 32B | ~ 32 GB | ~ 16 GB |
| 70B | ~ 70 GB | ~ 35 GB |
Uruchamianie DeepSeek R1 lub Llama 3.1 lokalnie za pomocą Ollama
Ollama to jedna z najprostszych metod wdrażania lokalnego LLM. Ollama jest przyjazna dla użytkownika, dzięki czemu jest dostępna nawet dla osób o niewielkiej wiedzy technicznej. Jej interfejs upraszcza proces pobierania, zarządzania i interakcji z dużymi modelami językowymi (LLM). W systemie Windows instalacja Ollama jest prosta. Wejdź na stronę internetową Ollama , kliknij „Pobierz” (wybierz swój system operacyjny), a następnie uruchom plik instalacyjny.
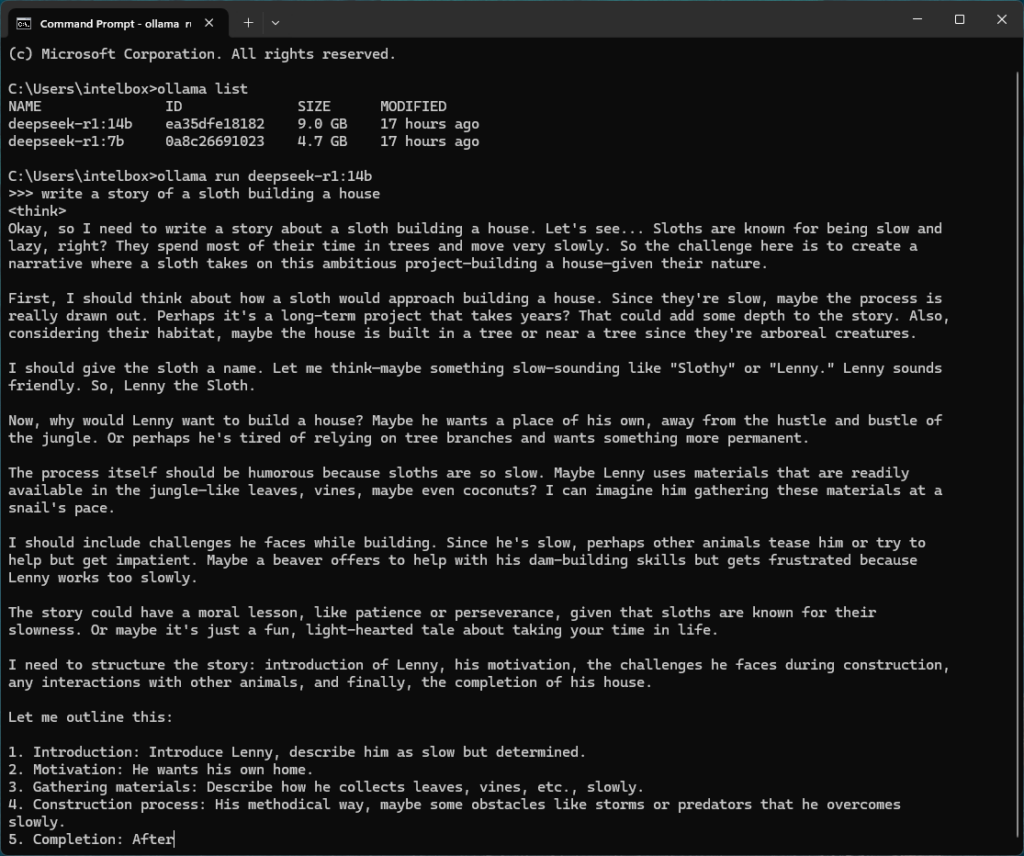
Po zainstalowaniu interfejs wiersza poleceń (CLI) Ollama umożliwia użytkownikom łatwe pobieranie i uruchamianie modeli za pomocą prostych poleceń, takich jak ollama pull i ollama biegną Dostęp do niego można uzyskać, klikając przycisk Start systemu Windows, wpisując „cmd” i uruchamiając wiersz poleceń. Poniżej znajduje się przykład pokazujący modele już pobrane do systemu, uruchamiający DeepSeek R1 14B i piszący historię o leniwcu budującym dom.
Oprócz interfejsu CLI firma Ollama oferuje również Ollama Hub, internetowy interfejs użytkownika zapewniający środowisko podobne do rozwiązań opartych na sztucznej inteligencji w chmurze, dzięki czemu jest ono dostępne nawet dla użytkowników preferujących interfejs graficzny.
Szerokie wsparcie społeczności i szybki cykl rozwoju Ollama czynią ją szczególnie atrakcyjną. Dodatkową zaletą jest to, że instalacja zajmuje kilka sekund, a zapoznanie się z pobieraniem i uruchamianiem modeli jest równie szybkie. Największym opóźnieniem dla większości użytkowników będzie prędkość internetu, ponieważ wiele z tych modeli ma rozmiar wielu gigabajtów.
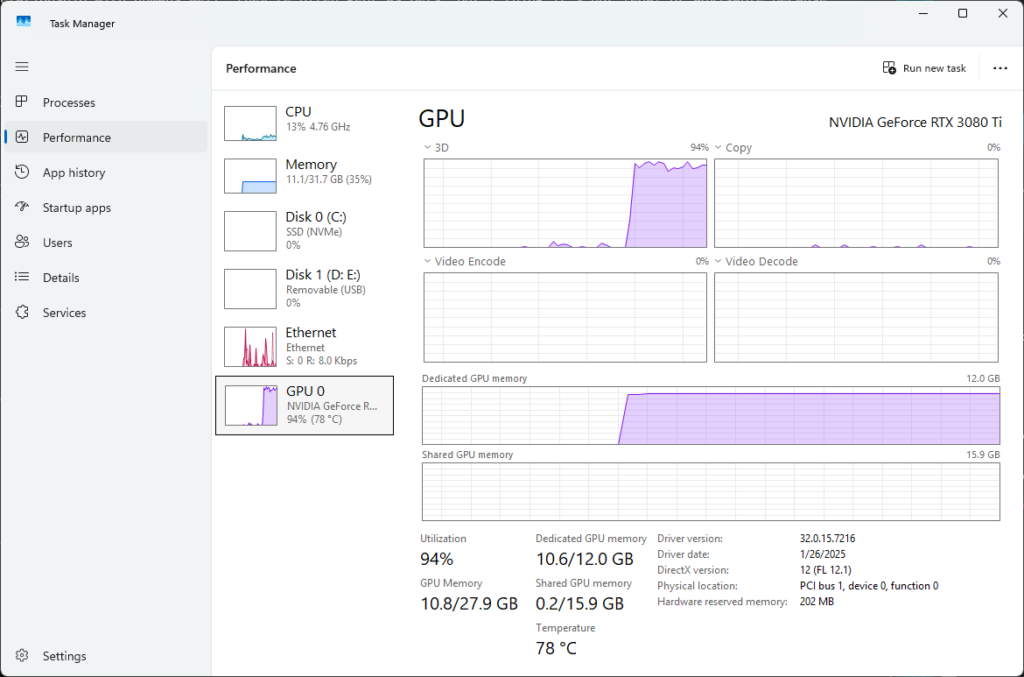
Należy pamiętać, że jeśli planujesz uruchomić lokalny LLM, każdy model będzie miał inne wymagania systemowe, a do wydajnego działania systemu zdecydowanie preferowany jest procesor graficzny (GPU). Ollama korzysta z modelu DeepSeek R1 14B na powyższym zrzucie ekranu zasobów systemowych, który zużywa nieco mniej niż 11 GB pamięci VRAM. Gdy model jest załadowany, procesor graficzny pozostaje bezczynny, ale jego wykorzystanie gwałtownie wzrośnie, gdy tylko zaczniesz z nim współpracować.
Uruchamianie LLM na sprzęcie niższej klasy: modele kwantyzowane
Modele kwantyzowane oferują praktyczne rozwiązanie dla użytkowników pracujących z procesorami graficznymi o niższej pamięci VRAM. Są to w zasadzie skompresowane wersje LLM, które zmniejszają zapotrzebowanie na pamięć, umożliwiając ich działanie na mniej wydajnych procesorach graficznych. Chociaż kwantyzacja wiąże się z pewnymi kosztami wydajności i dokładności, sprawia, że uruchamianie zaawansowanych modeli jest bardziej dostępne dla szerszego zakresu sprzętu.
Możliwe jest również uruchamianie LLM na procesorach, choć wiąże się to z dalszym spadkiem wydajności. Przetwarzanie oparte na procesorze jest znacznie wolniejsze niż przetwarzanie oparte na procesorze graficznym (GPU), ale nadal może być opłacalną opcją dla mniejszych modeli lub użytkowników bez dostępu do dedykowanego procesora graficznego (GPU).
LLAMA.CPP
Jedną z najpopularniejszych możliwości uruchamiania LLM na procesorach jest llama.cpp , natywna aplikacja C++ zaprojektowana do wydajnego wnioskowania dużych modeli językowych. Pomimo swojej nazwy, llama.cpp nie ogranicza się do modeli LLaMA. Jej lekka konstrukcja i optymalizacja pod kątem wykorzystania procesora sprawiają, że jest to doskonały wybór dla użytkowników, którzy chcą eksperymentować z lokalną sztuczną inteligencją na niewielkim sprzęcie. Dzięki obsłudze modeli kwantyzowanych, llama.cpp dodatkowo zmniejsza zapotrzebowanie na zasoby, umożliwiając wydajne uruchamianie zaawansowanych LLM nawet na sprzęcie klasy konsumenckiej.
Generowanie stabilnego obrazu dyfuzyjnego za pomocą ComfyUI
W przypadku generowania lokalnego obrazu, ComfyUI to prosty sposób na rozpoczęcie pracy. Postępowaliśmy zgodnie z instrukcją Stable Diffusion Art , aby uruchomić instancję. Kroki obejmują pobranie instancji ComfyUI w przenośnym archiwum 7z, rozpakowanie folderu i pobranie istniejącego punktu kontrolnego modelu.
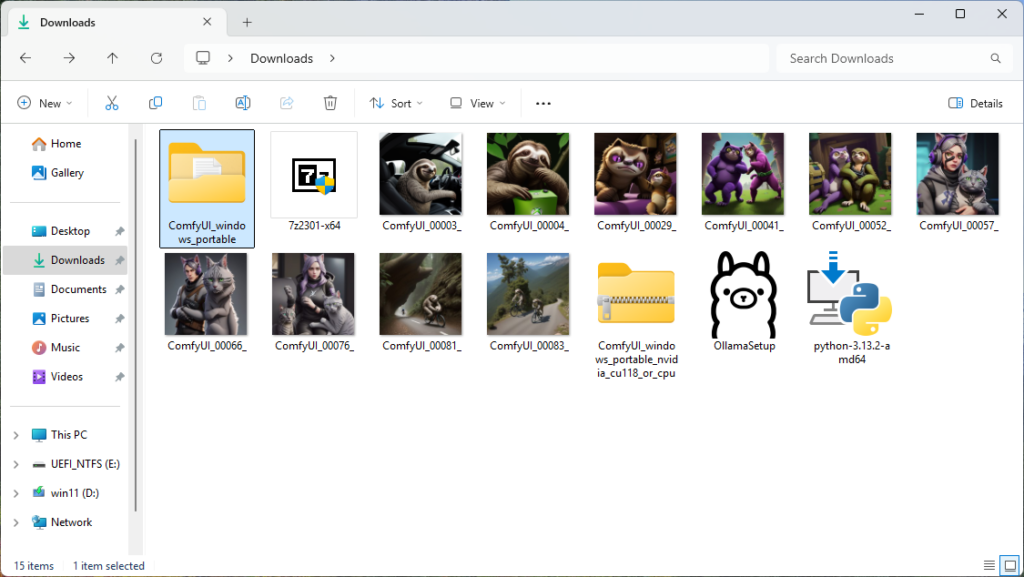
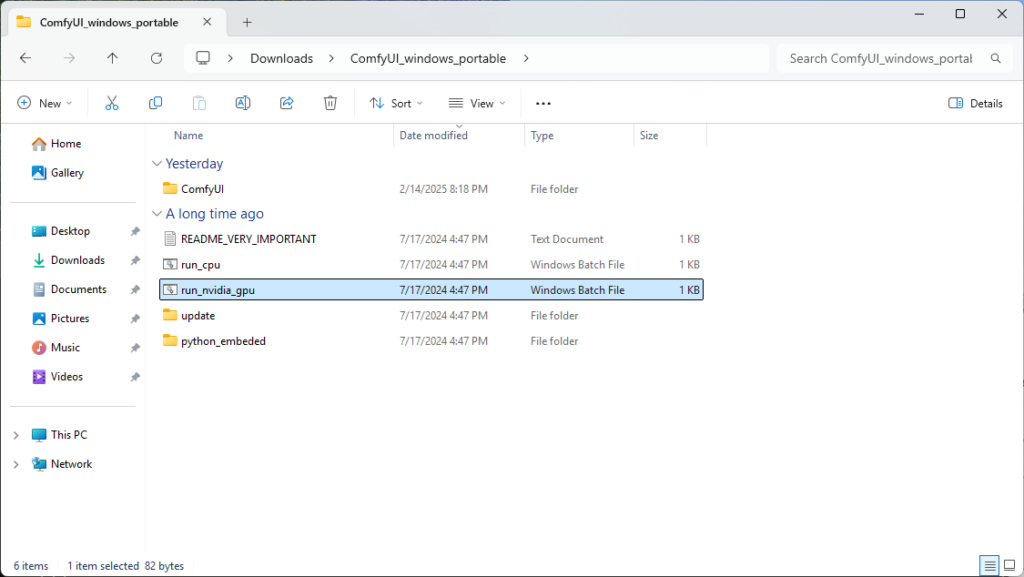
Uruchamianie ComfyUI różni się nieco od uruchamiania Ollama LLM. Otwórz folder z instancją ComfyUI i zapisanym punktem kontrolnym, a następnie kliknij dwukrotnie plik run_cpu, jeśli masz system ze zintegrowaną lub słabą kartą graficzną, albo run_nvidia_gpu, jeśli masz mocną, dedykowaną kartę graficzną NVIDIA.
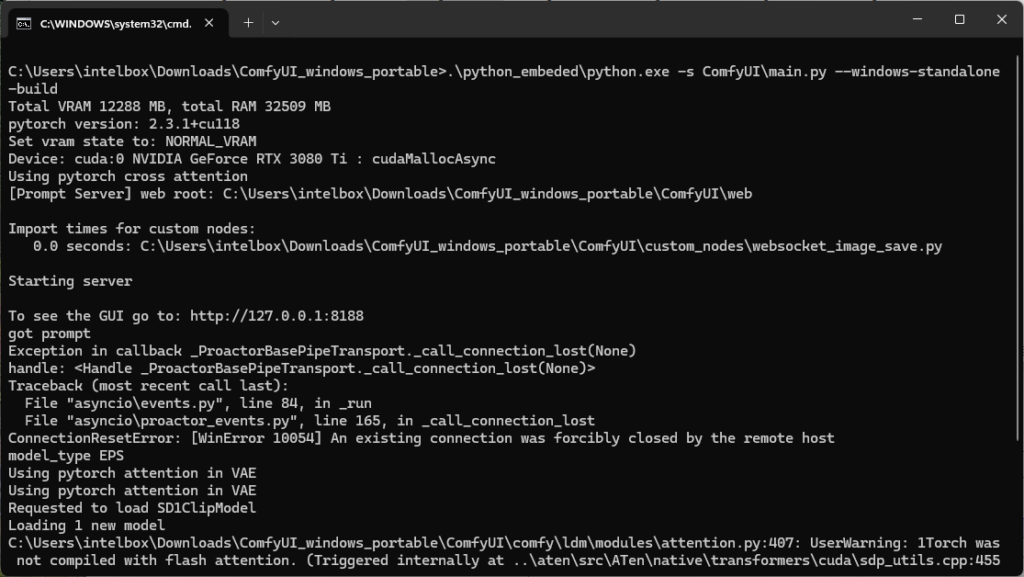
Spowoduje to załadowanie w tle wiersza poleceń. Wygląda on na dość skomplikowany, ale szybko ładuje link do domyślnej przeglądarki internetowej, aby wyświetlić interfejs graficzny.
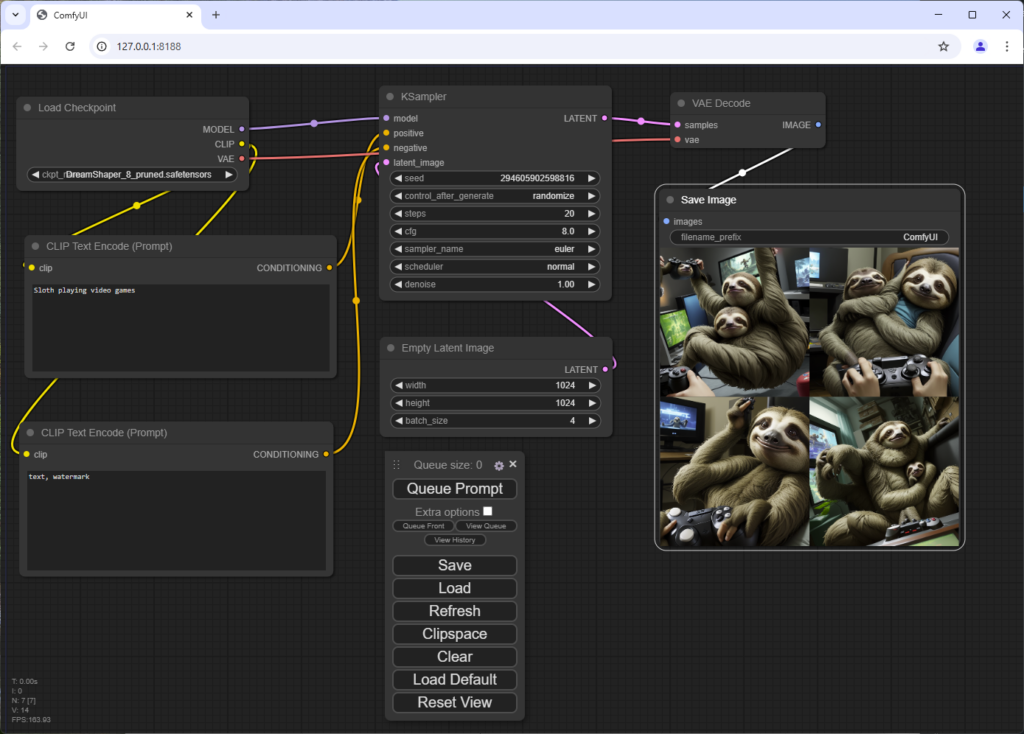
Wyświetlony interfejs graficzny pokazuje przepływ pracy modelu generowania obrazu, choć można od razu rozpocząć pracę, zastępując tekst w wierszu poleceń kodowania tekstu CLIP. W tym przykładzie wygenerowaliśmy cztery obrazy leniwca grającego w grę wideo. W polu „Pusty obraz ukryty” szerokość i wysokość obrazów zmieniono z 512 na 1024, aby je powiększyć. Wartość „batch_size” zmieniono na 4, aby jednocześnie tworzyć wielokrotności.
Ostatnie przemyślenia: Wspieranie kolejnego pokolenia za pomocą sztucznej inteligencji
Szybki rozwój sztucznej inteligencji i jej rosnąca dostępność oznaczają, że dzisiejsze komputery do gier mogą służyć o wiele bardziej niż tylko rozrywce. Zapewniając dzieciom wczesny dostęp do sztucznej inteligencji poprzez rozwiązania chmurowe lub lokalne instancje z wydajnymi systemami, dajemy im narzędzia do odkrywania uczenia maszynowego. Mogą eksperymentować z kreatywnością opartą na sztucznej inteligencji i rozwijać cenne umiejętności programistyczne, które będą coraz bardziej przydatne.
Od kodowania prostych gier, przez prowadzenie kursów LLM, po tworzenie grafiki opartej na sztucznej inteligencji – dobrze wyposażony komputer domowy może stać się solidnym środowiskiem edukacyjnym. Niezależnie od tego, czy korzystamy z usług AI w chmurze, czy też wdrażamy je lokalnie za pomocą narzędzi takich jak Ollama, ComfyUI i niezliczonych innych, możliwości dla młodych uczniów, aby zaangażować się w sztuczną inteligencję, są liczniejsze niż kiedykolwiek.
Ostatecznie decyzja o inwestycji w bardziej wydajny system nie dotyczy wyłącznie modernizacji sprzętu; chodzi o rozbudzanie ciekawości, kreatywności i rozwijanie umiejętności technicznych. W miarę jak sztuczna inteligencja będzie kształtować przyszłość, umożliwienie dzieciom eksperymentowania z tymi technologiami może być jedną z najbardziej znaczących inwestycji w ich edukację i rozwój.


 Amazon