

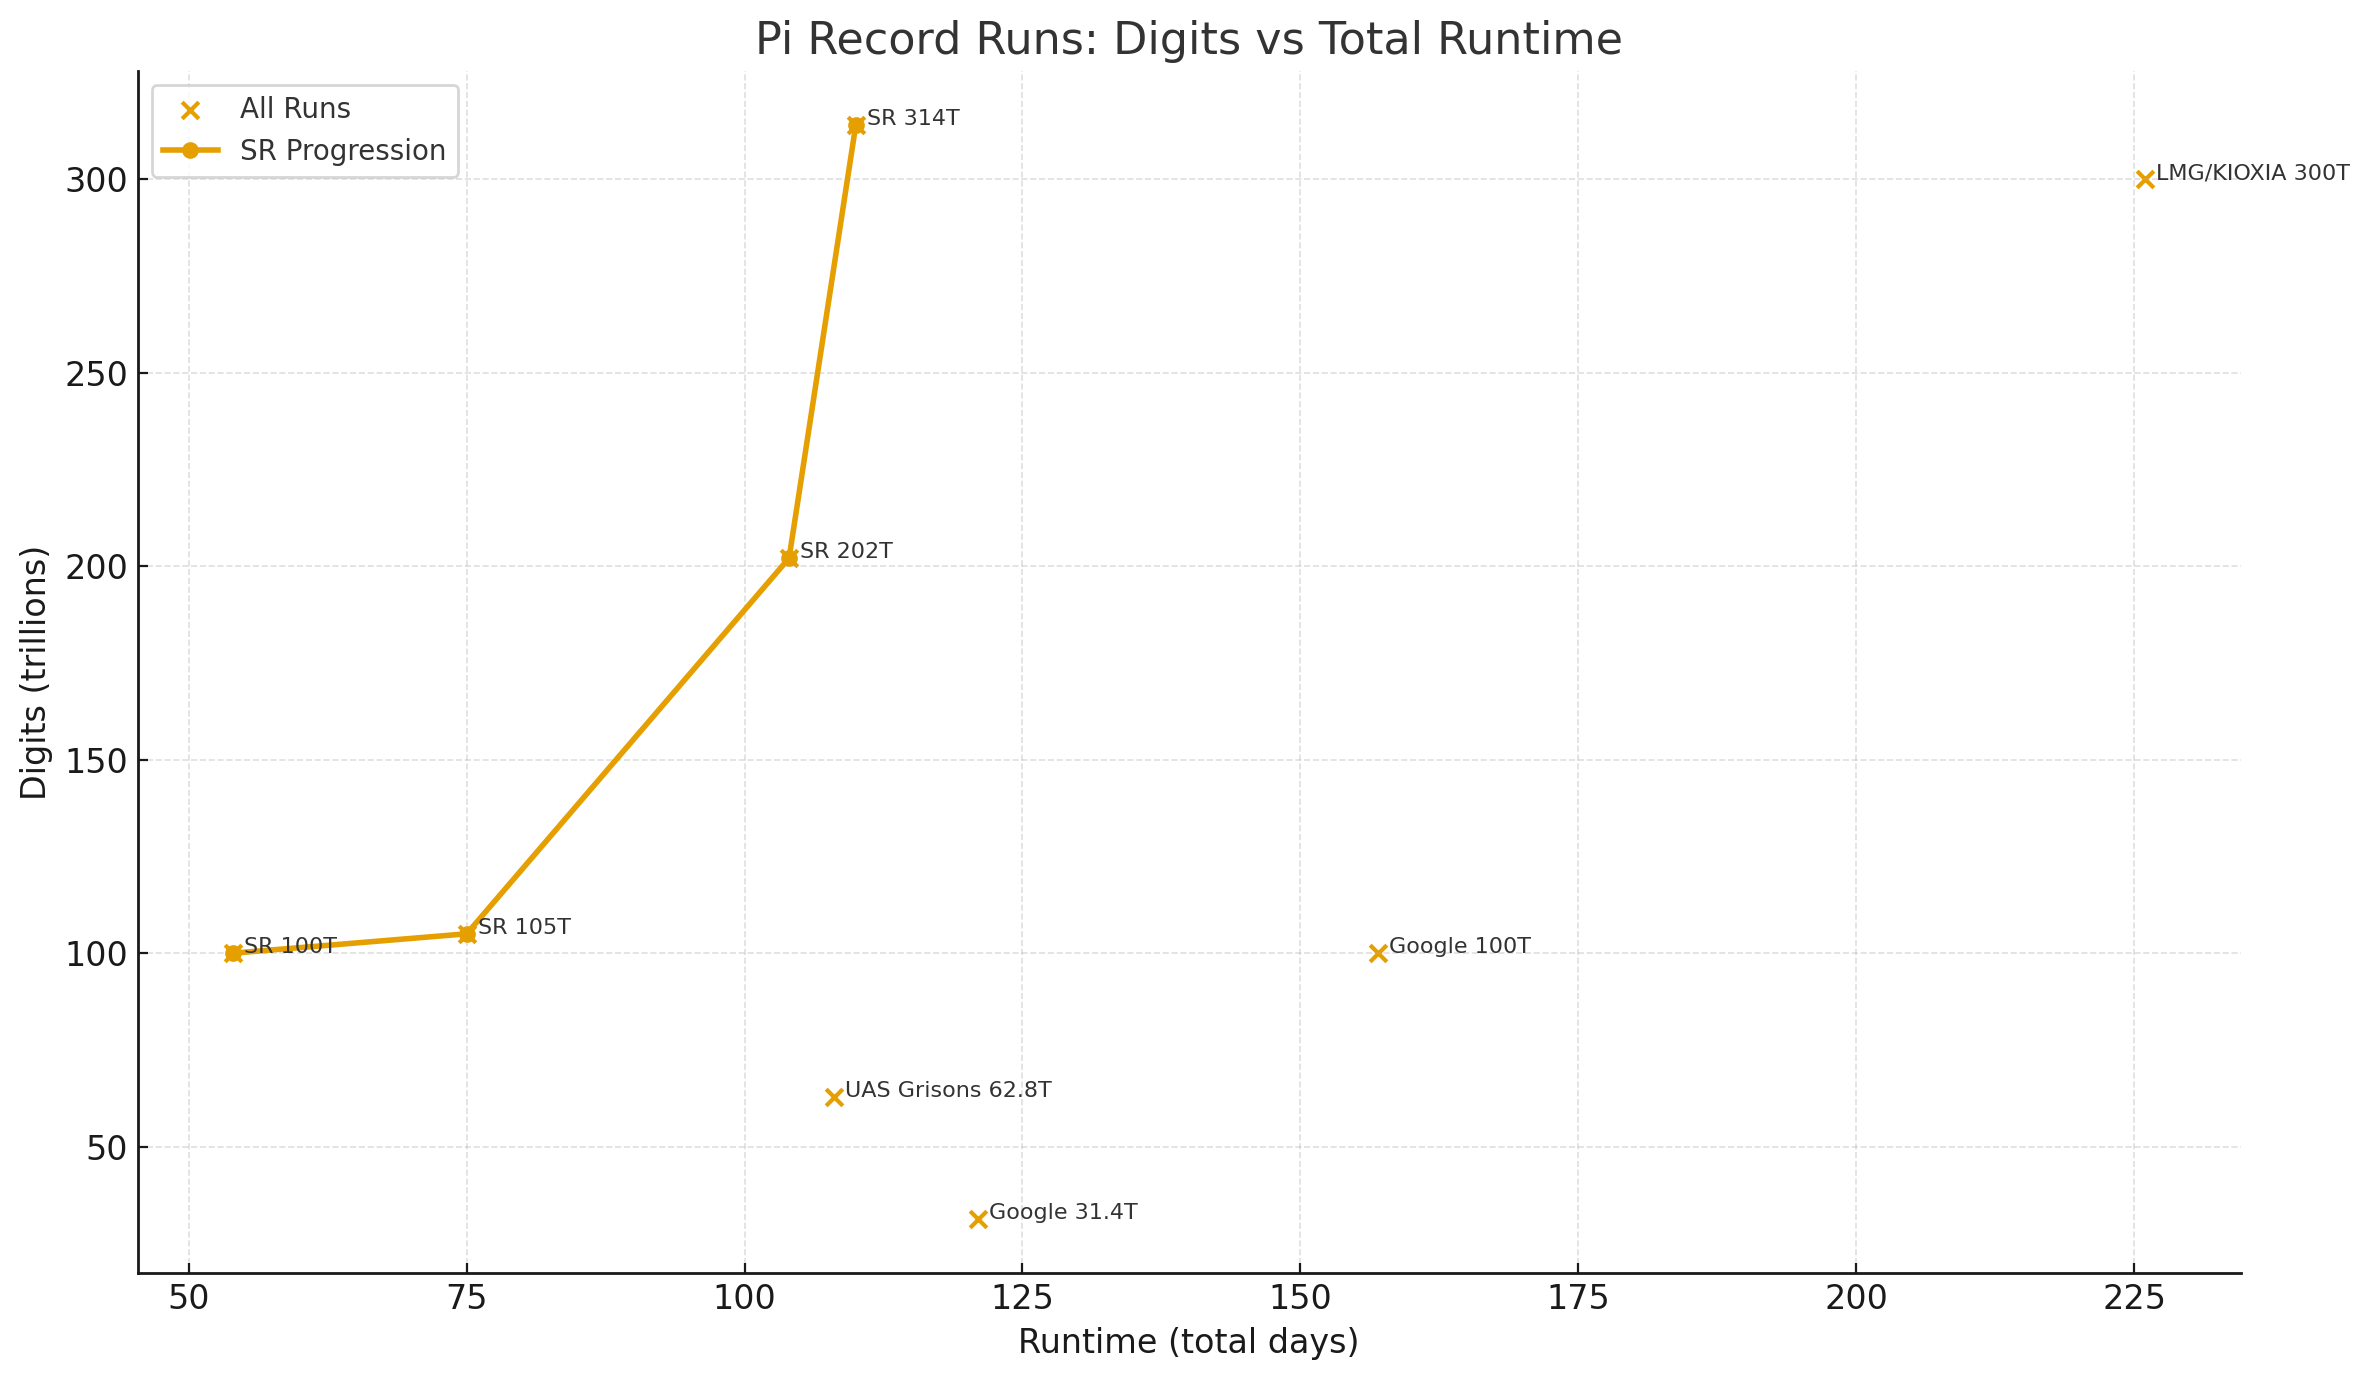
StorageReview odzyskało koronę popularności w dziedzinie obliczeń, rozwiązując nowy rekord liczby pi do 314 bilionów cyfr. Współczesny wyścig π przeszedł od eksperymentów w chmurze do w pełni elastycznej infrastruktury. W 2022 roku Google Cloud zwiększyło π do 100 bilionów cyfr, uruchamiając y-cruncher na ogromnej flocie instancji chmurowych i przetwarzając w tym procesie dziesiątki petabajtów operacji wejścia/wyjścia. Ten wynik stał się głównym wskaźnikiem „jak daleko jest to możliwe” przy użyciu tradycyjnej infrastruktury.
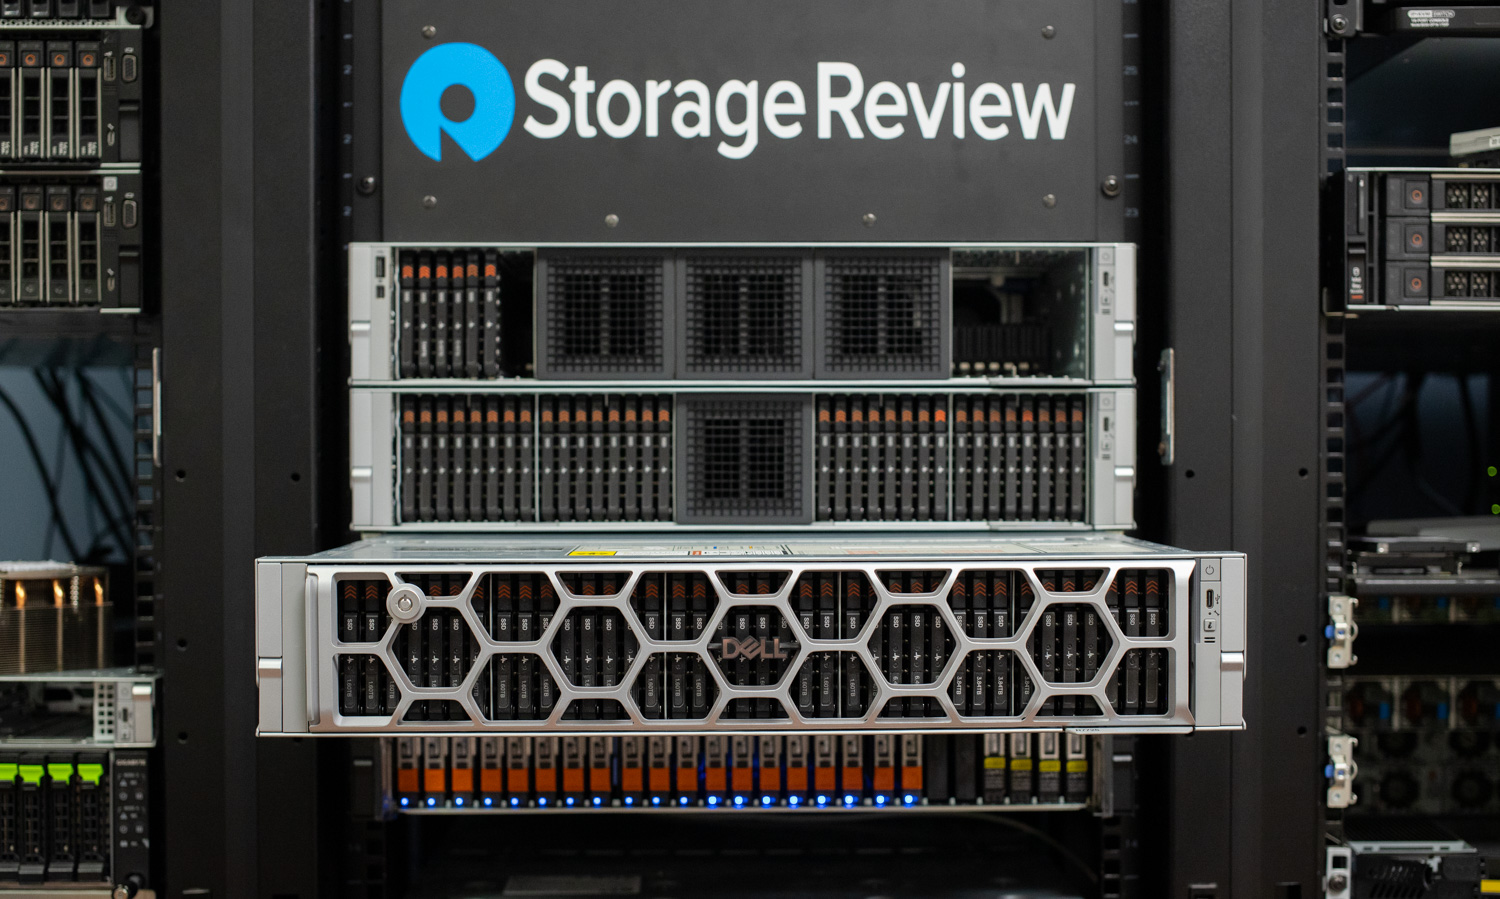
Następnie działania przeniosły się do laboratorium. Na początku 2024 roku zaktualizowaliśmy nasz rekord do 105 bilionów cyfr w systemie obsługiwanym przez prawie petabajt dysków SSD Solidigm QLC. To osiągnięcie ustanowiło nowy standard skalowalności i pokazało, jak wydajna może być pojedyncza maszyna lokalna. Kilka miesięcy później dokonaliśmy tego ponownie, tym razem osiągając 202 biliony cyfr. To potwierdziło, że pamięć flash o wysokiej gęstości i staranne dostrojenie mogą przewyższyć infrastrukturę hiperskalową w przypadku tego konkretnego, wymagającego obciążenia.
Oczywiście, rekordy przyciągają rywali. Linus Media Group i KIOXIA zdobyły koronę dzięki wynikowi 300 bilionów cyfr, napędzanemu przez duży klaster współdzielonej pamięci masowej Weka z 2 PB pamięci flash. To przedsięwzięcie pokazało, co potrafi tradycyjna infrastruktura o dużym zapotrzebowaniu na pamięć masową, pomimo szafy sprzętowej, wysokich rachunków za prąd i skomplikowanych systemów chłodzenia. Nie mogliśmy bezczynnie przyglądać się temu rekordowi!

StorageReview zwiększyło liczbę π do 314 bilionów cyfr, wykorzystując pojedynczy serwer Dell PowerEdge R7725 o rozmiarze 2U , wyposażony w dwa 192-rdzeniowe procesory AMD EPYC i czterdzieści dysków SSD Micron 6550 Ion o pojemności 61.44 TB. Ponieważ budowa i strojenie systemu miały miejsce w lipcu, rozpoczęliśmy test 31 lipca 2025 roku. Szczęśliwym trafem test pi zakończył się drugiego dnia konferencji SC25, co wpisuje się w nowy rekord HPC.
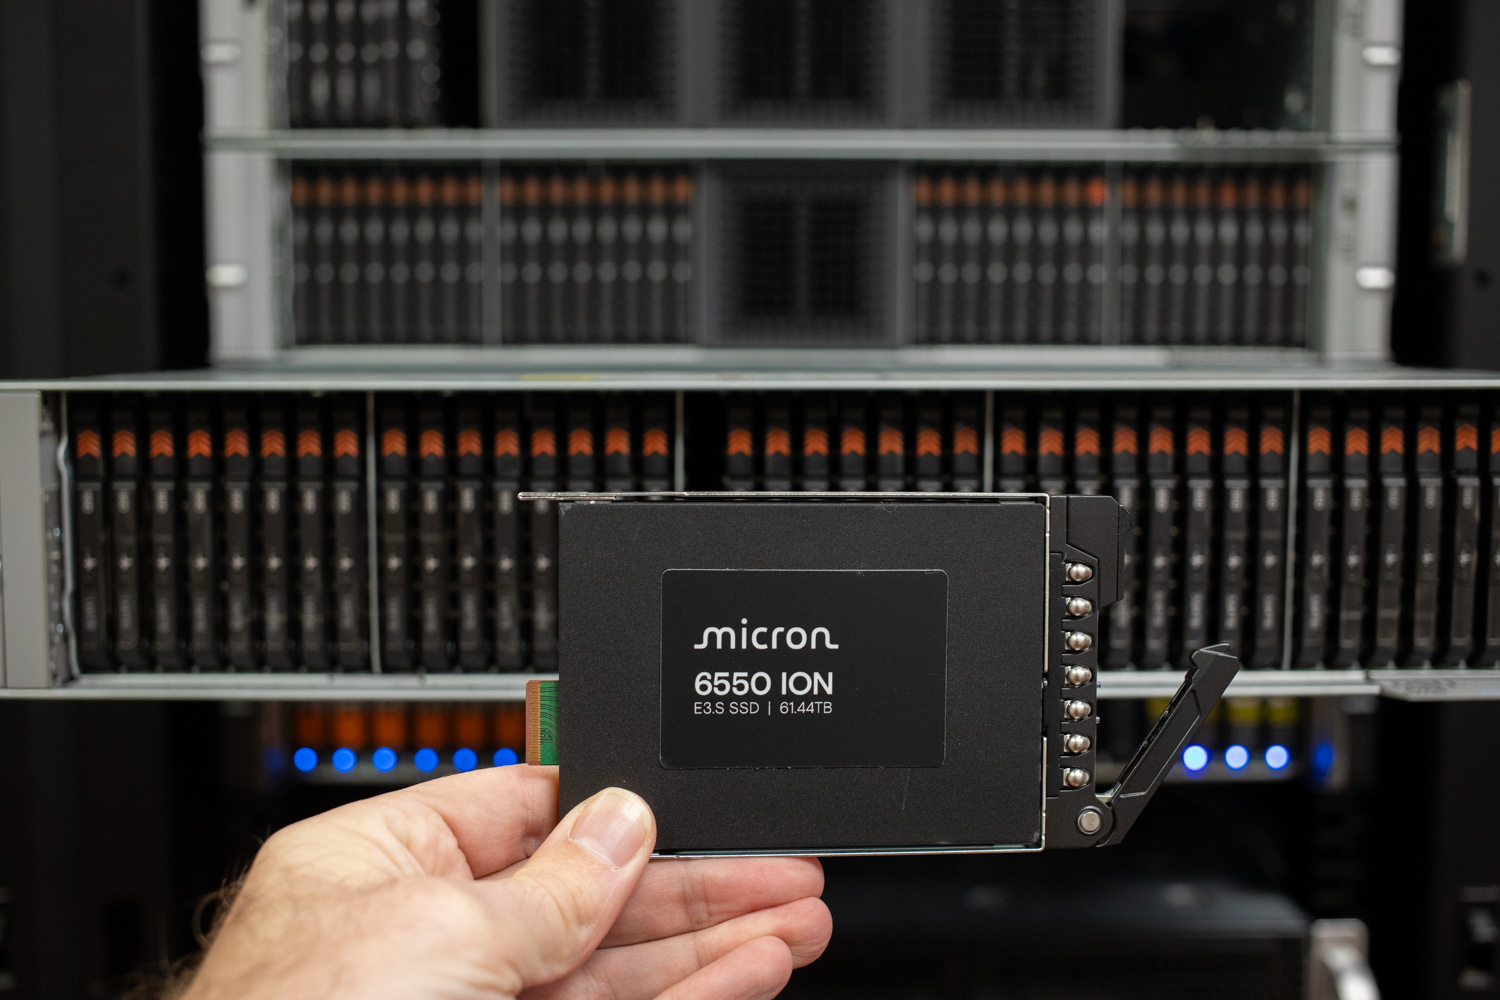
Skalowanie y-crunchera do 314 bilionów cyfr
Po przekroczeniu setek bilionów cyfr, y-cruncher zachowuje się mniej jak tradycyjny benchmark, a bardziej jak test obciążeniowy infrastruktury dalekiego zasięgu. Sama aplikacja jest prosta, ale sposób, w jaki wchodzi w interakcję ze sprzętem w tej skali, staje się czynnikiem decydującym. Wszystko sprowadza się do tego, jak dobrze system jest w stanie obsłużyć tysiące operacji wieloprecyzyjnych bez spowalniania procesorów lub przeciążania warstwy pamięci masowej. To właśnie warstwa pamięci masowej faktycznie ustanowiła ten rekord. Wdrożyliśmy 40 dysków SSD Micron 6550 Ion Gen5 NVMe, z których 34 zostały przydzielone do y-crunchera. Ta pula dysków SSD dostarczyła około 2.1 petabajta, dając y-cruncherowi wystarczająco dużo miejsca na wykonanie 314-bitowego przebiegu. Pozostałe 6 dysków SSD posłużyło do zbudowania programowego woluminu RAID10, którego użyliśmy do zapisania 314-bitowych cyfr liczby pi.
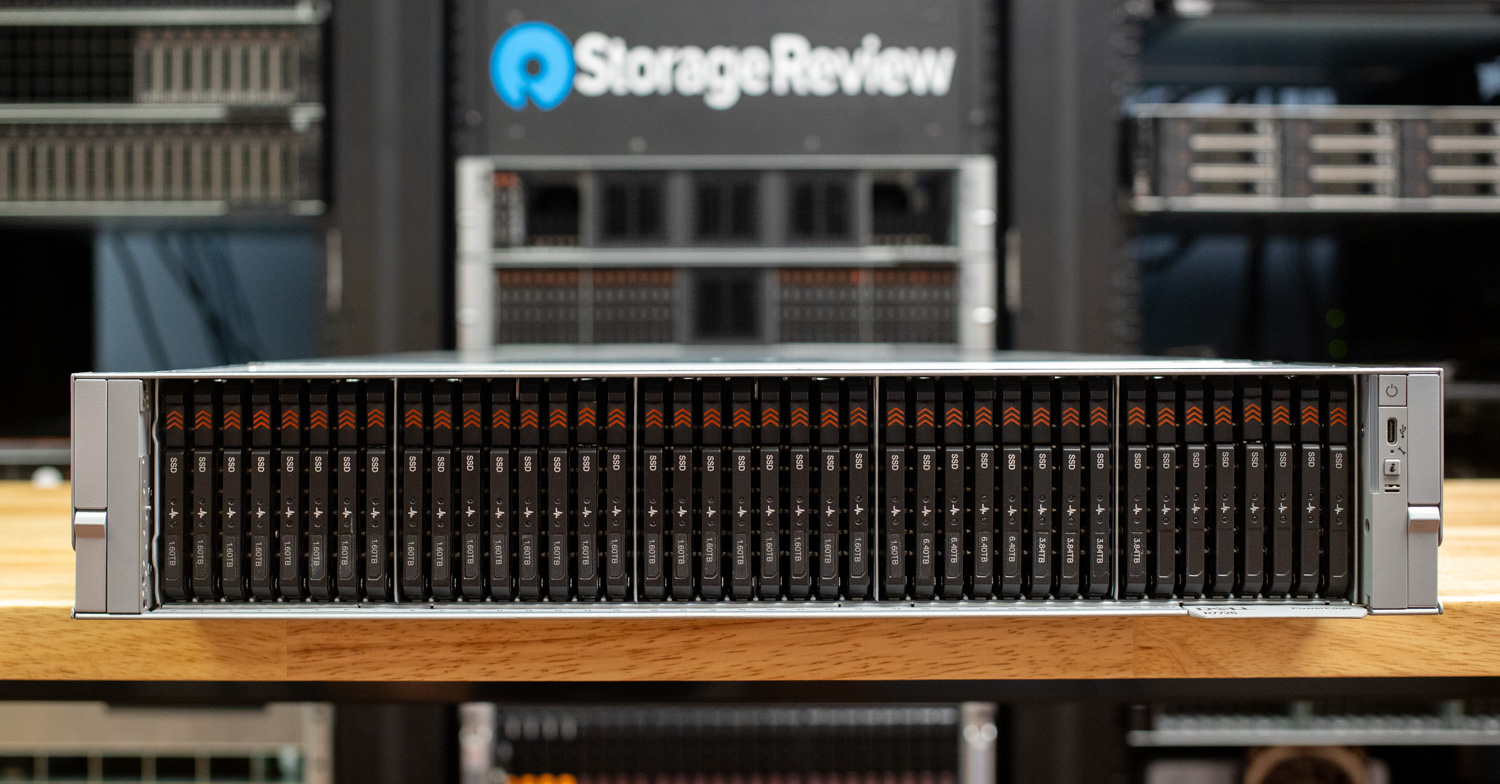
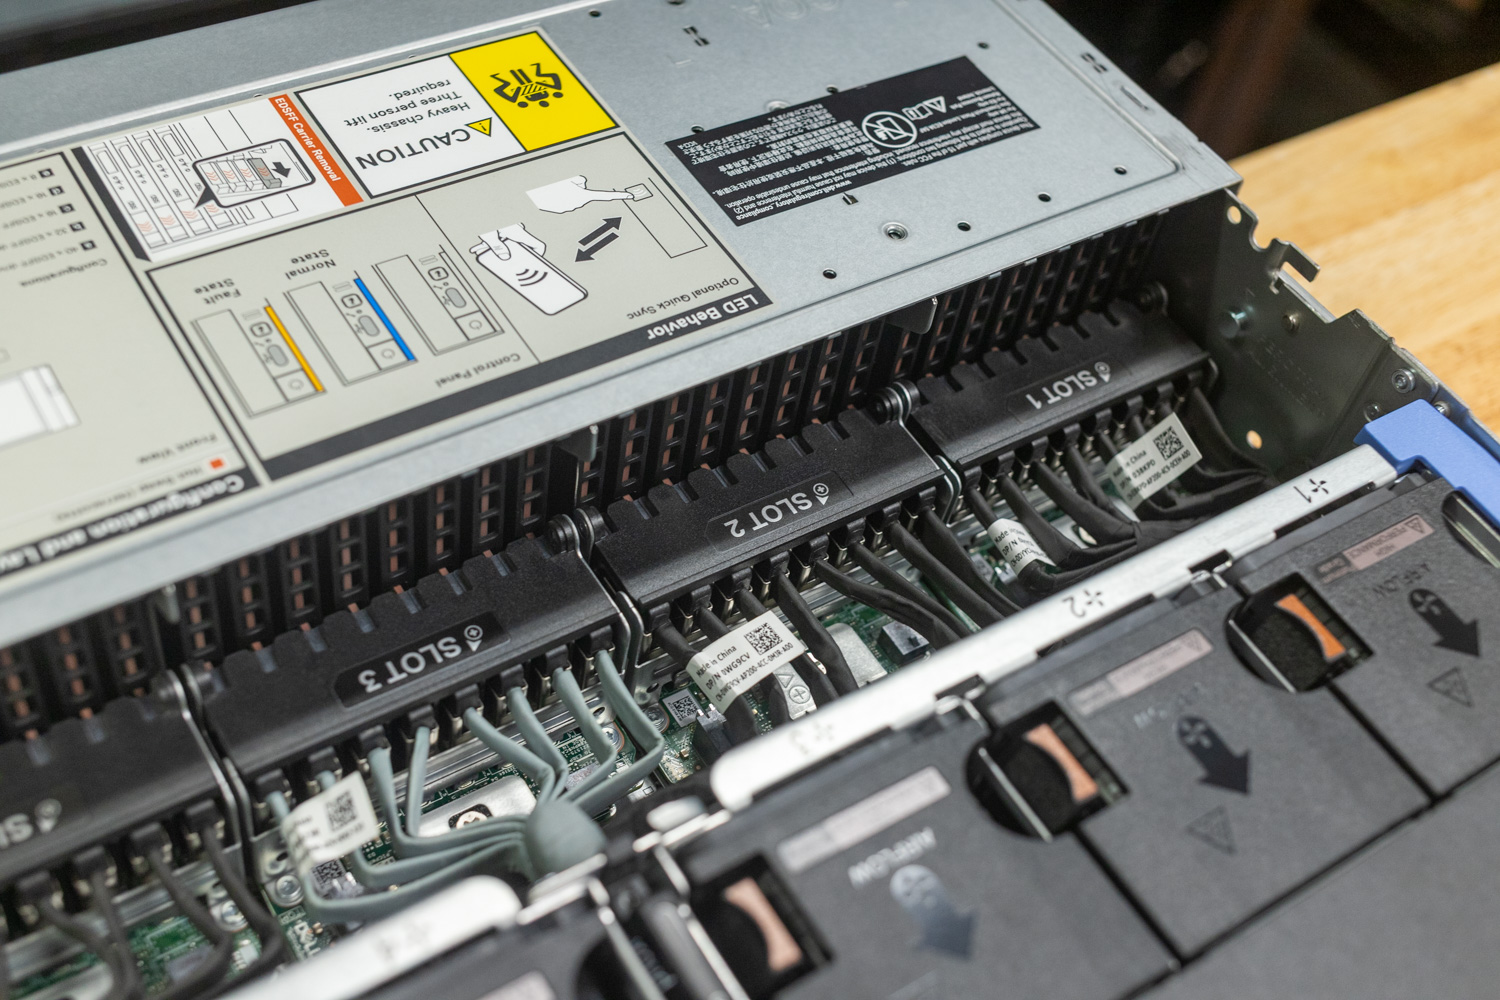
Zmiany konstrukcyjne między serwerami Dell PowerEdge 16. i 17. generacji również przyczyniły się do poprawy wydajności naszego najnowszego rekordu 314T. W poprzednim rekordzie 202T wykorzystaliśmy 24-zatokowy serwer Dell PowerEdge R760, który wykorzystywał przełącznik PCIe na płycie montażowej dysków, rezygnując z gęstości dysków na rzecz wydajności. W serwerach Dell PowerEdge 17. generacji, takich jak R770 z procesorem Intel lub R7725 z procesorem AMD, płyty montażowe powróciły do trybu wyłącznie bezpośredniego połączenia, z 2 lub 4 liniami PCIe na zatokę. W serwerze PowerEdge R7725 z 40-zatokową płytą montażową Gen5 E3.S, każdy dysk SSD ma 2 linie PCIe. Chociaż może to wydawać się spadkiem wydajności, platforma nadal jest w stanie osiągnąć do 280 GB/s odczytu i zapisu przy jednoczesnym obciążeniu wszystkich 40 zatok.
Korzystając z wewnętrznego benchmarku pamięci masowej y-cruncher, zmierzyliśmy wydajność pamięci masowej każdej platformy w konfiguracji użytej w każdym przebiegu. Dla każdego obciążenia zaobserwowaliśmy wzrost wydajności pamięci masowej w zakresie od 72% do 383%, przy zrównoważonych metrykach odczytu i zapisu.
| metryczny | System 202T (stary rekord) | System 314T (nowy rekord) | Różnica procentowa (314T vs. 202T) |
|---|---|---|---|
| Zapis sekwencyjny | 47.0 GiB/s | 107 GiB/s | + 127.7% |
| Sekwencyjny odczyt | 56.7 GiB/s | 127 GiB/s | + 124.0% |
| Próg zapisu krokowego | 62.2 GiB/s | 107 GiB/s | + 72.0% |
| Próg odczytu krokowego | 20.9 GiB/s | 101 GiB/s | + 383.3% |
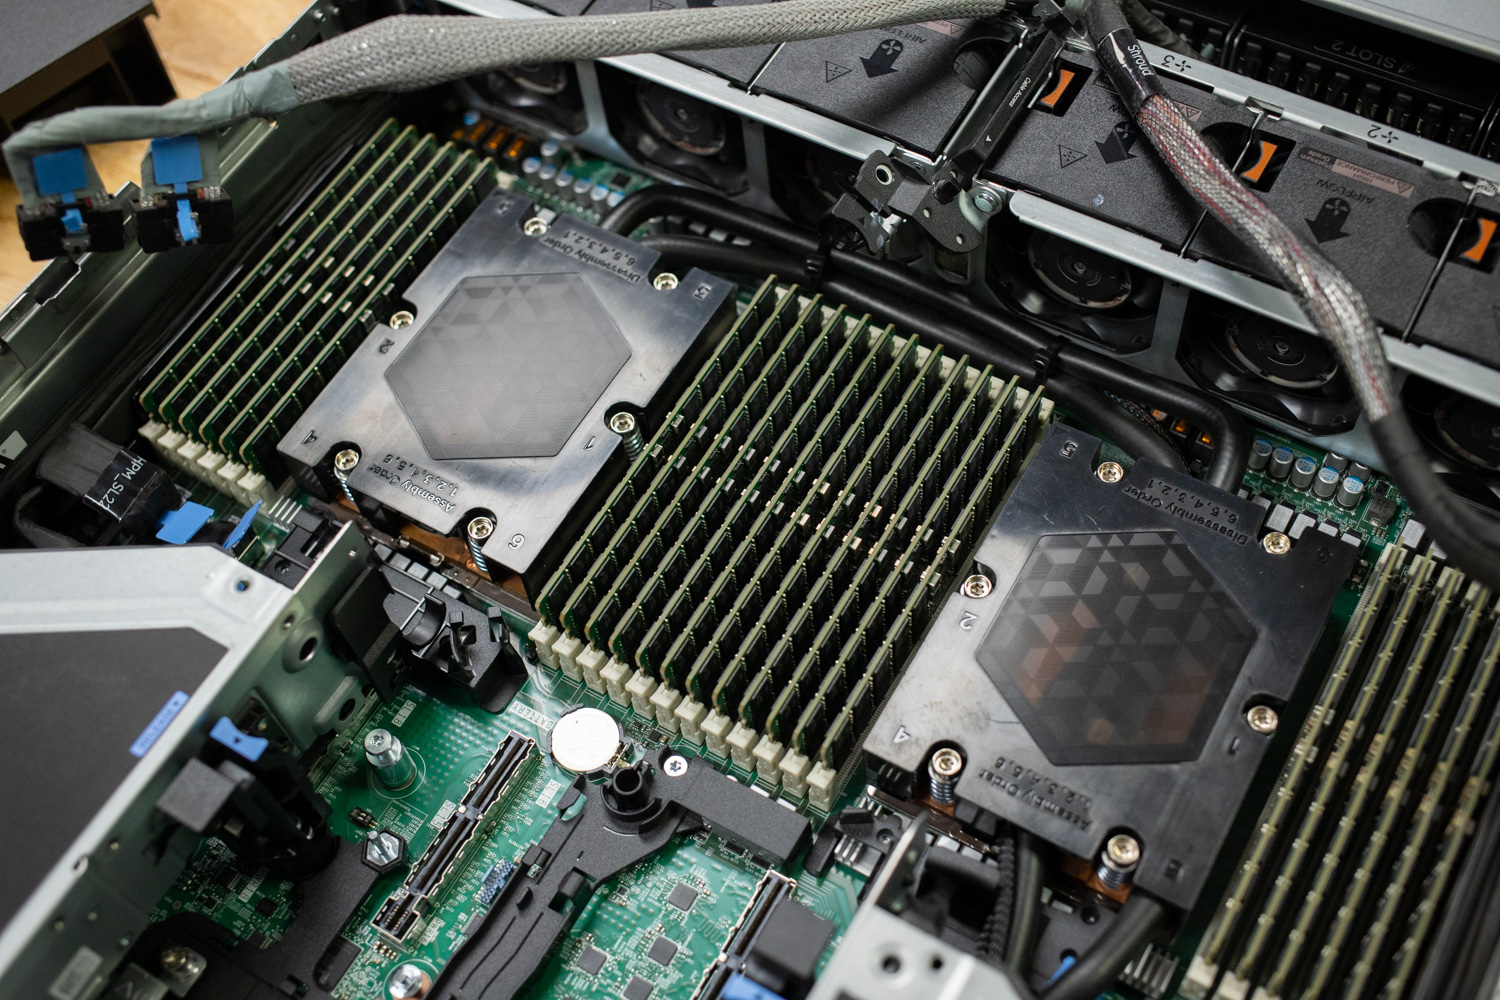
Dell PowerEdge R7725 to nie tylko obudowa do przechowywania danych; oferuje również znaczny potencjał obliczeniowy jako dwuprocesorowa platforma AMD Turin. Wykorzystaliśmy 192-rdzeniowe procesory AMD EPYC 9965, co daje łącznie 384 rdzenie. Wymieniliśmy również standardowe radiatory chłodzone powietrzem na chłodzone cieczą płyty chłodzące CoolIT SP5, które były chłodzone przez jednostkę CoolIT AHx10 Liquid-to-Air CDU. Dzięki temu połączeniu procesory pracowały z wyższą, stałą częstotliwością taktowania, wentylatory obudowy działały z prędkością około 30% PWM, a nasze średnie zużycie energii w systemie oscylowało wokół 1,600 W.
Od strony programowej platforma działała pod kontrolą Ubuntu 24.04.2 LTS Server zamiast Windows Server, jak w poprzednich testach. Zmaksymalizowało to stabilność systemu i zapewniło znaczący wzrost wydajności obciążenia. Przed rozpoczęciem testu przeprowadziliśmy liczne iteracje testowe, w tym zarezerwowaliśmy 4 z 384 rdzeni dla operacji systemowych w tle. Rezultatem było nie tylko pobicie istniejącego rekordu Raspberry Pi, ale także jego pobicie w wielu innych parametrach. Nic nie dorównuje naszemu testowi pod względem wydajności, zużycia energii i, co najbardziej imponujące, niezawodności. Jesteśmy również jedynym testem rekordu świata Raspberry Pi na dużą skalę, który nie zanotował ani sekundy przestoju. Od początku do końca test nie wymagał wznowienia.
Rekordowa efektywność energetyczna
Podejście StorageReview do każdego z naszych przebiegów rekordów pi polegało na zmniejszeniu złożoności i przeprowadzeniu testu porównawczego przy użyciu jak najmniejszej ilości energii. Poprzedni rekord 300T, który wykorzystywał rozproszony klaster pamięci masowej i szybką sieć, wiązał się z większym zapotrzebowaniem na energię i chłodzenie. Wybraliśmy inną ścieżkę, koncentrując się na gęstości pamięci masowej, aby użyć jednego serwera 2U zarówno do przechowywania danych wymiany, jak i wyjściowego. Odegrało to znaczącą rolę w zmniejszeniu naszego całkowitego zapotrzebowania na energię i chłodzenie. Nasz serwer Dell PowerEdge R7725 zużył zaledwie 4,304.662 kWh podczas przebiegu 314T, co daje zaledwie 13.70 kWh na bilion cyfr. To sprawia, że jest to jedno z najbardziej energooszczędnych obliczeń pi na dużą skalę. Porównując oba podejścia, różnica staje się natychmiast widoczna, co zostało przedstawione w poniższej tabeli.
| Uruchom | Całkowita kWh | Koszt 0.12 USD/kWh | Koszt 0.20 USD/kWh |
|---|---|---|---|
| 300T Weka Cluster Run | 33,600 XNUMX kWh (szacowane) | $4,032 | $6,720 |
| 314T Uruchomienie pojedynczego serwera | 4,304.662 kWh | $517 | $861 |
Należy zauważyć, że podczas obliczeń, nasz system 314T wykorzystywał dyski SSD w konfiguracji JBOD bez odporności danych. Zużycie energii i ogólna wydajność systemu były czynnikami, które doprowadziły do tej decyzji, ale zapoczątkowały również dyskusję na temat projektowania rozwiązania pamięci masowej pod kątem obciążenia. Każde obciążenie jest inne, a niektóre, które można ponownie uruchomić z minimalnym wpływem na produkcję, mogą nie wymagać takiego samego poziomu odporności na błędy. W naszym przypadku skupiliśmy się na ochronie danych wyjściowych za pomocą tradycyjnego oprogramowania RAID.
Całkowity czas trwania: 110 dni
Pomimo obliczenia większej liczby cyfr niż w jakimkolwiek poprzednim przebiegu, czas obliczeniowy był znacznie krótszy niż poprzedni rekord, który wymagał około 225 dni (175 dni obliczeniowych, nie licząc przestojów). Nieprzerwane 110-dniowe okno jest wynikiem stabilnego systemu operacyjnego, zminimalizowanego obciążenia w tle, zbalansowanej topologii NUMA oraz macierzy obliczeniowej zaprojektowanej pod kątem wzorca generowanego przez y-cruncher w tej skali.
Najważniejsze informacje techniczne
- Obliczono całkowitą liczbę cyfr: 314,000,000,000,000
- Sprzęt używany:Dell PowerEdge R7725 z 2 procesorami AMD EPYC 9965, 1.5 TB pamięci DRAM DDR5, 40x Micron 61.44 TB 6550 Ion
- Oprogramowanie i algorytmy: y-cruncher v0.8.6.9545, Chudnovsky
- Zużycie dysków SSD zgodnie z SMART:7.3 PB zapisane na dysk lub 249.11 PB na 34 dyskach SSD używanych do wymiany
- Największy logiczny punkt kontrolny: 850 538 385 064 992 (774 TiB)
- Logiczne szczytowe wykorzystanie dysku: 126 658 805 195 776 600 (1.43 PiB)
- Odczytane bajty dysku logicznego: 126 658 805 195 776 600 (132 PiB)
- Zapisane bajty dysku logicznego: 126 658 805 195 776 600 (112 PiB)
- Data rozpoczęcia: czw. 31 lip 17:16:41 2025
- Data zakończenia: Wt 18 lis 05:57:08 2025
- liczba pi: 8793223.144 sekundy, 101.773 dni
- Całkowity czas obliczeń: 9274878.580 sekund
- Czas ściany od początku do końca: 9463226.454 sekund
Myśli końcowe
Przez dekady ekstremalne obliczenia pi były sposobem na zaprezentowanie tego, co w danym momencie uznawano za „wielkie żelazo”. Wczesne rekordy opierały się na wydajnych komputerach stacjonarnych i zewnętrznie podłączonych pamięciach masowych, a następnie przeniosły się na lokalny sprzęt korporacyjny. Niedawno wyścig przeniósł się do chmury, gdzie zadania takie jak 100-bilionowe obliczenia Google'a udowodniły, że można siłą uzyskać rekord z wystarczającą liczbą instancji i wejściem/wyjściem. Następnie zobaczyliśmy duże klastry współdzielonej pamięci masowej, które zamieniły prostotę na czystą paralelność i ogromne rachunki za energię i chłodzenie.
Nasze podejście poszło w przeciwnym kierunku. Podczas wielu przebiegów rekordów traktowaliśmy y-cruncher jako poważne obciążenie HPC, a nie jednorazowy wyczyn. Rozwiązania 105T i 202T pomogły nam zidentyfikować rzeczywiste wąskie gardła, dostosować rozmiar i dostroić pamięć masową, zapewnić zasilanie procesorów bez obciążania warstwy wejścia/wyjścia oraz wzmocnić system, aby wielomiesięczna praca faktycznie dobiegła końca. Przebieg 314T jest wynikiem tego doświadczenia. To nie tylko większa liczba rekordów. To bardziej dojrzała konstrukcja.
Dane potwierdzają tę tezę. Przekroczyliśmy 300 bilionów cyfr na jednym serwerze Dell PowerEdge R7725 o wysokości 2U z dyskami SSD 40 Micron 6550 Ion i dwoma 192-rdzeniowymi procesorami AMD EPYC, utrzymywaliśmy system w trybie online przez 110 dni z rzędu i nigdy nie musieliśmy wznawiać pracy po awarii. Przepustowość pamięci masowej wzrosła ponad dwukrotnie w porównaniu z naszą platformą 202T, a mimo to serwer zużywał średnio około 1,600 W i łącznie 4,305 kWh. Daje to 13.70 kWh na bilion cyfr, co stanowi ułamek szacowanego zużycia energii przez poprzedni klaster 300T: mniej węzłów, mniejsza złożoność, mniej energii, więcej wykonanej pracy.
Właśnie dlatego ten rekord jest ważny nie tylko ze względu na dumę: skoro jeden komercyjny serwer 2U jest w stanie obsłużyć tak dużą liczbę serwerów Y-Crunker, przy takim poziomie niezawodności i wydajności, te same wzorce projektowe przekładają się bezpośrednio na naukę produkcji. Długotrwałe modele klimatyczne, symulacje fizyczne, potoki genomiczne i zadania związane ze szkoleniem sztucznej inteligencji (AI) opierają się na tych samych fundamentach: zrównoważonym wejściu/wyjściu, przewidywalnych parametrach termicznych, stabilnym oprogramowaniu sprzętowym i architekturze, która może pracować w pozycji pionowej przez wiele miesięcy. Ta platforma udowodniła, że potrafi to robić w warunkach, które nie pozostawiają miejsca na błąd.
Tak, StorageReview odzyskało koronę pi z 314 bilionami cyfr. Co ważniejsze, wyznaczyliśmy poprzeczkę dla tego, co oznacza „dobry” w obliczeniach numerycznych na dużą skalę na prawdziwym sprzęcie. Jeśli ktoś chce pobić rekord, chcielibyśmy, aby pobił go w całości: więcej cyfr, mniej energii, krótszy czas reakcji i ta sama niezawodność bez przestojów. Do tego czasu to jest punkt odniesienia dla wydajności.


 Amazon