

Firma Supermicro od dawna oferuje serwery GPU w większej liczbie kształtów i rozmiarów, niż jesteśmy w stanie omówić w tej recenzji. Dzisiaj przyjrzymy się ich stosunkowo nowemu serwerowi GPU 4U z chłodzeniem powietrznym, który obsługuje dwa procesory AMD EPYC serii 9004, PCIe Gen5 oraz osiem kart rozszerzeń GPU o podwójnej lub dwanaście o pojedynczej szerokości. Chociaż Supermicro oferuje również warianty tych serwerów z procesorami Intel, rodzina AS-4125GS-TNRT z procesorami AMD to jedyne serwery w tej klasie obsługujące procesory graficzne NVIDIA H100 i AMD Instinct Mi210.
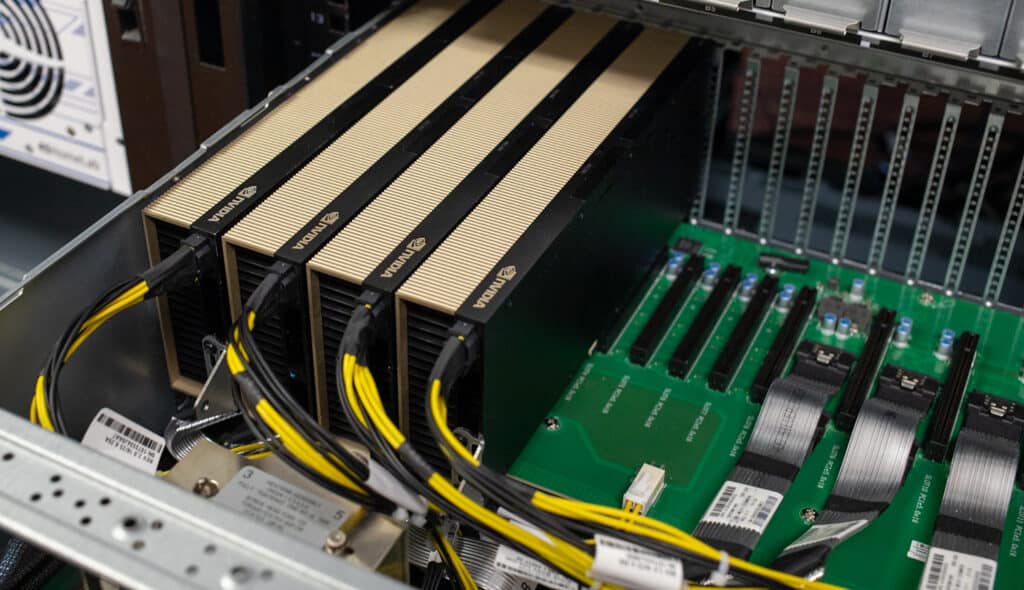
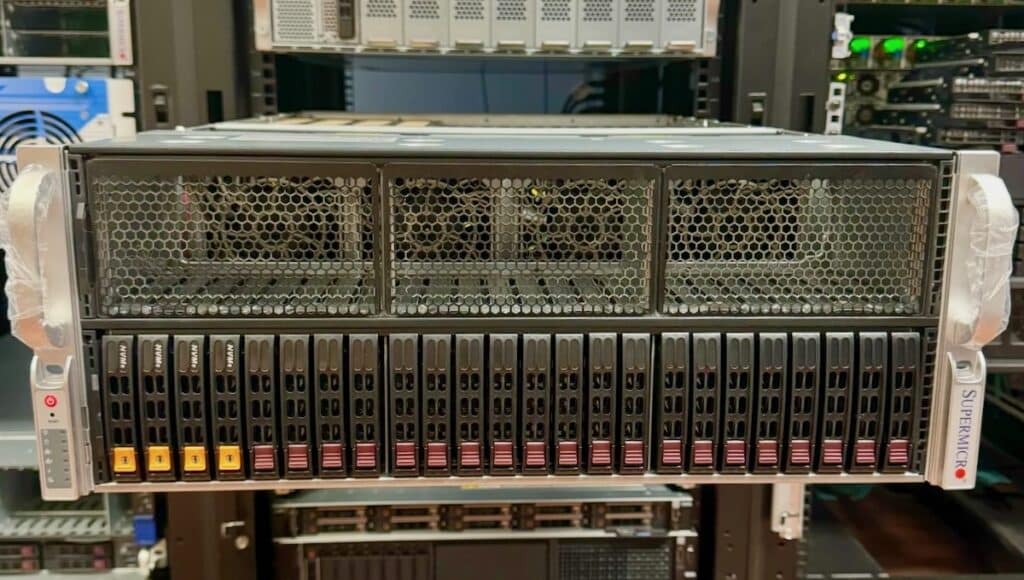
Serwer GPU Supermicro AS-4125GS-TNRT oferuje kilka innych istotnych elementów sprzętowych, takich jak wbudowana karta sieciowa 10 GbE, zarządzanie out-of-band, 9 gniazd FHFL PCIe Gen5, 24 zatoki 2.5″, z czego cztery to NVMe, a pozostałe to SATA/SAS. Znajdziemy tu również 4 redundantne zasilacze tytanowe o mocy 2000 W. Na płycie głównej znajduje się jedno gniazdo M.2 NVMe do rozruchu.
Zanim zagłębimy się w szczegóły, warto wspomnieć, że Supermicro oferuje dwa inne warianty konfiguracji serwerowej AS-4125GS-TNRT. Chociaż korzystają z tej samej płyty głównej, AS-4125GS-TNRT1 to konfiguracja jednoprocesorowa z przełącznikiem PCIe, który obsługuje do 10 procesorów graficznych o podwójnej szerokości i 8 zatok na dyski SSD NVMe. AS-4125GS-TNRT2 to konfiguracja dwuprocesorowa, która jest mniej więcej taka sama, również z przełącznikiem PCIe.
Niezależnie od konfiguracji, serwer Supermicro AS-4125GS-TNRT jest niezwykle elastyczny dzięki swojej konstrukcji i możliwości wyboru modeli za pomocą przełącznika PCIe. Ten typ serwera GPU jest popularny, ponieważ pozwala organizacjom zacząć od małej infrastruktury i ją rozbudowywać, łączyć i dopasowywać GPU do różnych potrzeb lub robić cokolwiek innego. Systemy GPU z gniazdami umożliwiają lepszą agregację GPU w przypadku dużych obciążeń AI, ale systemy kart rozszerzeń są bezkonkurencyjne pod względem elastyczności obciążenia.
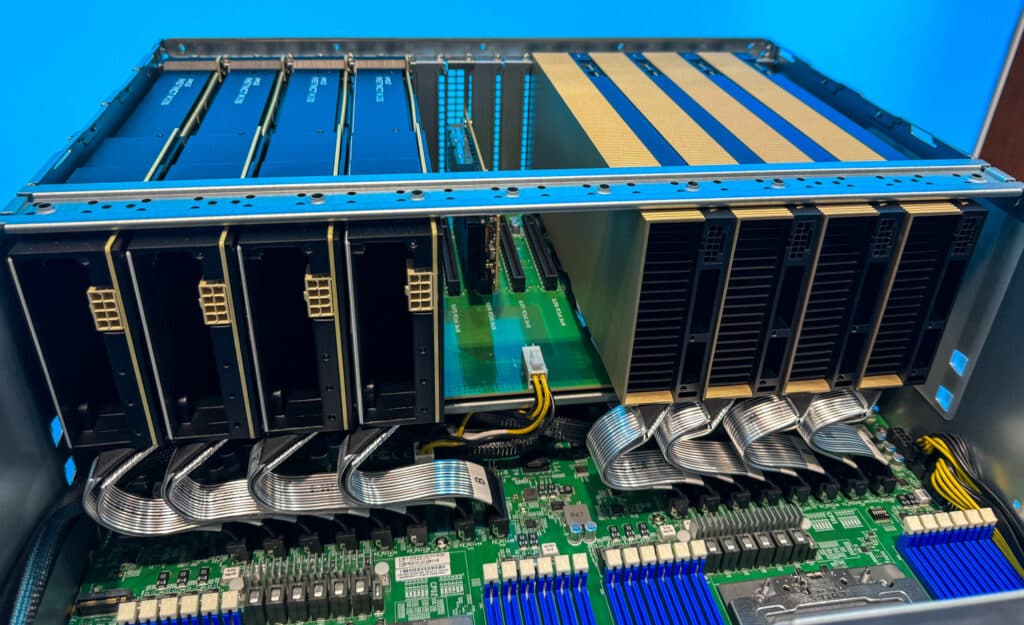
Supermicro AS-4125GS-TNRT z procesorami graficznymi AMD i NVIDIA od SC23
Co więcej, choć dla niektórych może to brzmieć jak bluźnierstwo, serwery GPU Supermicro z kartami rozszerzeń można nawet używać z kartami AMD i NVIDIA w jednym urządzeniu! O zgrozo, ale wielu klientów odkryło, że niektóre obciążenia preferują Instinct, a inne, jak GPU NVIDIA. Na koniec, choć mniej popularne niż serwery GPU wypełnione po brzegi, warto wspomnieć, że te sloty to po prostu sloty PCIe; nie jest nierozsądne wyobrazić sobie scenariusze, w których klienci mogą preferować układy FPGA, DPU lub inny rodzaj akceleratora w tym systemie. Ponownie, elastyczność jest podstawową, miażdżącą zaletą tej konstrukcji.
Na potrzeby naszej recenzji, komputer Supermicro AS-4125GS-TNRT został dostarczony w wersji podstawowej, z możliwością dodania procesora, pamięci DRAM, pamięci masowej i oczywiście procesorów graficznych. Współpracowaliśmy z Supermicro, aby wypożyczyć cztery procesory graficzne NVIDIA H100 na potrzeby tej recenzji.
Specyfikacje Supermicro AS-4125GS-TNRT
| SPECYFIKACJA | |
| CPU | Procesory Dual Socket SP5 do 128C / 256T każdy |
| Pamięć | Do 24 modułów pamięci DDR5 RDIMM/LRDIMM o pojemności 256 GB i częstotliwości 4800 MHz ECC (Łącznie 6TB pamięci) |
| GPU |
|
| Gniazda rozszerzeń | 9 gniazd PCIE 5.0 x16 FHFL |
| Zasilacze | 4x 2000W redundantnych zasilaczy |
| Sieci | 2x 10GbE |
| Dyski |
|
| Płyta | Super H13DSG-O-CPU |
| Zarząd |
|
| Ochrona |
|
| Rozmiar Podwozie | 4U |
Recenzja konfiguracji Supermicro AS-4125GS-TNRT
Skonfigurowaliśmy nasz system od Supermicro jako barebone, choć firma ta sprzedaje go głównie w wersji skonfigurowanej. Kiedy dotarł do laboratorium, pierwszą rzeczą, jaką zrobiliśmy, było zainstalowanie w nim dwóch procesorów AMD EPYC 9374F 32c 64t. Zostały one wybrane ze względu na wysoką częstotliwość taktowania i przyzwoitą wydajność wielordzeniową.
W przypadku akceleratorów mieliśmy do wyboru całkiem sporą gamę, od starych koprocesorów Intel Phi, przez najnowsze karty H100 PCIe, po zaawansowane procesory graficzne RTX 6000 ADA Workstation. Naszym celem było znalezienie równowagi między mocą obliczeniową a wydajnością i wszechstronnością. Ostatecznie zdecydowaliśmy się zacząć od czterech procesorów graficznych NVIDIA RTX A6000, a następnie przejść do czterech kart NVIDIA H100 PCIe do naszych wstępnych testów. Ta kombinacja pokazuje elastyczność platformy Supermicro i kart akceleracyjnych NVIDIA.
Karta RTX A6000, zaprojektowana przede wszystkim z myślą o wydajności w obciążeniach intensywnie wykorzystujących grafikę, dzięki architekturze Ampere doskonale sprawdza się również w aplikacjach AI i HPC. Oferuje 48 GB pamięci GDDR6, co czyni ją idealną do obsługi dużych zbiorów danych i złożonych symulacji. Jej 10 752 rdzenie CUDA i 336 rdzeni Tensor umożliwiają przyspieszenie obliczeń, co jest kluczowe dla naszych testów AI i głębokiego uczenia.
Z drugiej strony, karty NVIDIA H100 PCIe to najnowsze karty w ofercie architektury Hopper, zaprojektowane głównie z myślą o obciążeniach AI. Każda karta oferuje imponujące 80 miliardów tranzystorów, 80 GB pamięci HBM3 oraz przełomowy silnik Transformer Engine, dostosowany do modeli AI, takich jak GPT-4. Rdzenie Tensor czwartej generacji i instrukcje DPX zastosowane w karcie H100 znacząco usprawniają wnioskowanie i trenowanie AI.
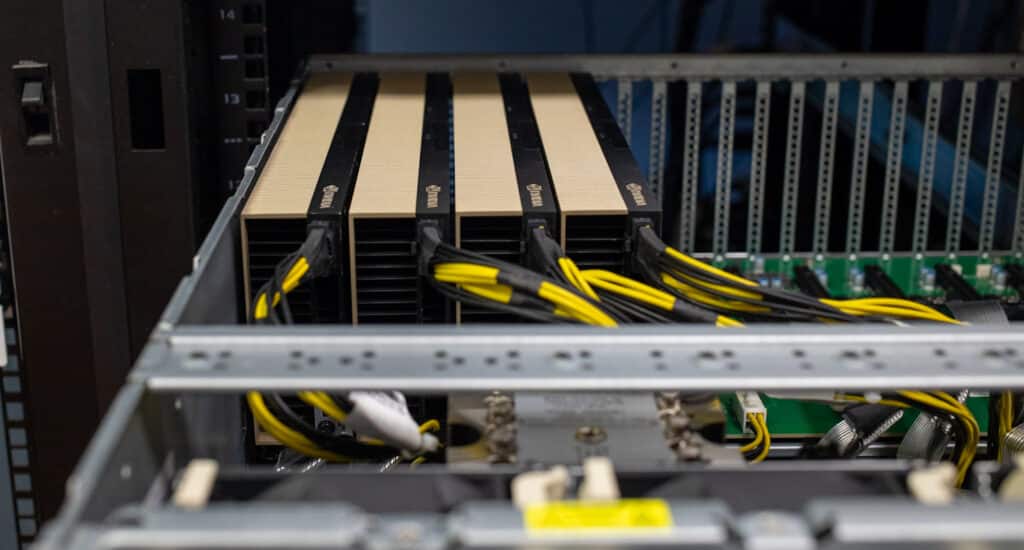
Integrując te procesory graficzne z naszym systemem barebone Supermicro, skupiliśmy się na zapewnieniu optymalnego zarządzania temperaturą i dystrybucji energii, biorąc pod uwagę znaczny pobór mocy i generowanie ciepła przez te wysokiej klasy komponenty. Obudowa Supermicro, choć oficjalnie nie obsługuje takiej konfiguracji, okazała się wystarczająco wszechstronna, aby pomieścić naszą konfigurację. Aby utrzymać temperaturę A6000 pod kontrolą, musieliśmy rozmieścić je w odległości równej szerokości karty ze względu na konstrukcję wentylatora klatkowego, ale karty H100 można umieścić w obudowie dzięki pasywnym, przelotowym żebrom chłodzącym.
Nasz pakiet benchmarkingowy obejmował zarówno przypadki użycia HPC, jak i specyficzne dla sztucznej inteligencji (AI). Obejmowały one zarówno tradycyjne obciążenia benchmarkingowe, jak i zadania związane z trenowaniem i wnioskowaniem AI z wykorzystaniem modeli splotowych sieci neuronowych. Naszym celem było wykorzystanie tych akceleratorów do granic możliwości, oceniając ich wydajność, skalowalność oraz łatwość integracji z naszym serwerem Supermicro A+.
Testowanie procesora graficznego Supermicro AS-4125GS-TNRT
Pracując w laboratorium nad podstawowym modelem CNN i omawiając flagowe procesory graficzne firmy NVIDIA, zaczęliśmy od szkolenia na poziomie stacji roboczej, wykorzystując parę starszych, ale bardzo wydajnych procesorów graficznych RTX8000.
Podczas naszej analizy wydajności sztucznej inteligencji (AI) zaobserwowaliśmy znaczący, ale oczekiwany postęp w zakresie możliwości, przechodząc od NVIDIA RTX 8000 do czterech układów GPU RTX A6000, a ostatecznie do czterech kart NVIDIA H100 PCIe. Ten postęp pokazał surową moc tych akceleratorów i ewolucję akceleratorów NVIDIA w ciągu ostatnich kilku lat, w miarę jak coraz większy nacisk kładzie się na obciążenia związane ze sztuczną inteligencją.
Począwszy od RTX 8000, odnotowaliśmy przyzwoity poziom wydajności. W tej konfiguracji, trenowanie naszego modelu AI na zbiorze danych obrazowych o rozmiarze 6.36 GB zajmowało około 45 minut na epokę. Jednak ograniczenia RTX 8000 były widoczne pod względem rozmiaru partii i złożoności zadań, które mógł obsłużyć. Byliśmy ograniczeni do mniejszych rozmiarów partii i ograniczonej złożoności modeli sieci neuronowych, które mogliśmy skutecznie trenować.
Przejście na cztery procesory graficzne RTX A6000 oznaczało znaczący skok wydajności. Większa przepustowość pamięci i większa pamięć GDDR6 procesora A6000 pozwoliły nam czterokrotnie zwiększyć rozmiar wsadu, zachowując ten sam czas trwania epoki i złożoność modelu. To ulepszenie usprawniło proces uczenia i umożliwiło nam eksperymentowanie z bardziej zaawansowanymi modelami bez wydłużania czasu uczenia.
Jednak najbardziej imponujący postęp nastąpił wraz z wprowadzeniem czterech kart NVIDIA H100 PCIe. Wykorzystując ulepszone możliwości sztucznej inteligencji (AI) architektury Hopper, karty te pozwoliły nam ponownie podwoić rozmiar wsadu. Co bardziej imponujące, mogliśmy znacząco zwiększyć złożoność naszych modeli AI bez zauważalnej zmiany czasu trwania epoki. Ta możliwość świadczy o zaawansowanych funkcjach specyficznych dla AI karty H100, takich jak silnik Transformer Engine i rdzenie Tensor czwartej generacji, zoptymalizowane pod kątem wydajnego przetwarzania złożonych operacji AI.
Podczas testów zestaw danych obrazu o pojemności 6.36 GB i parametry modelu posłużyły jako spójny punkt odniesienia, umożliwiając nam bezpośrednie porównanie wydajności w różnych konfiguracjach GPU. Przejście z RTX 8000 do A6000, a następnie do H100, uwydatniło poprawę mocy obliczeniowej i zdolność GPU do obsługi większych, bardziej złożonych zadań AI bez utraty szybkości i wydajności. Dzięki temu te GPU są szczególnie odpowiednie do najnowocześniejszych badań nad AI i aplikacji głębokiego uczenia na dużą skalę.
Serwer Supermicro użyty w naszych testach oferuje bezpośrednie połączenie PCIe z procesorami, eliminując potrzebę stosowania przełącznika PCIe. To bezpośrednie połączenie zapewnia każdemu procesorowi graficznemu dedykowaną ścieżkę do procesora, co umożliwia szybki i wydajny transfer danych. Architektura ta ma kluczowe znaczenie w przypadku niektórych obciążeń w obszarze sztucznej inteligencji (AI) i HPC, minimalizując opóźnienia i maksymalizując wykorzystanie przepustowości, co jest szczególnie przydatne w przypadku zadań o wysokiej przepustowości, takich jak trenowanie modeli AI lub złożone środowiska VDI, gdzie cała praca jest wykonywana lokalnie na serwerze.
Wniosek
Skalowalność i elastyczność serwera Supermicro GPU A+ Server AS-4125GS-TNRT to jego kluczowe cechy. Jest on szczególnie korzystny dla klientów, którzy muszą dostosowywać się do zmieniających się wymagań dotyczących obciążeń, zarówno w obszarze AI, VDI, jak i innych zadań wymagających wysokiej wydajności. Zaczynając od skromnej konfiguracji, użytkownicy mogą skutecznie obsługiwać zadania AI lub VDI na poziomie podstawowym, oferując ekonomiczne rozwiązanie dla mniejszych obciążeń lub dla osób dopiero rozpoczynających przygodę z AI i infrastrukturą wirtualnych pulpitów. Ta początkowa konfiguracja zapewnia solidne i skalowalne podstawy, umożliwiając użytkownikom korzystanie z podstawowych, ale niezbędnych aplikacji AI i VDI.
Co więcej, chociaż wiemy, że wiele przedsiębiorstw chce korzystać z procesorów graficznych H100 z gniazdami, czas oczekiwania na te platformy jest wygórowany. Wiele źródeł podało, że oczekiwanie trwa prawie rok. Logistyka łańcucha dostaw podkreśla zalety tego serwera – jest w stanie obsłużyć wszystko. Procesory graficzne L40S są dostępne „od ręki”, więc klienci mogą szybciej niż później uruchomić swoje zadania związane ze sztuczną inteligencją, korzystając z tego zestawu. W razie zmiany potrzeb klienci mogą łatwo wymieniać karty. Dzięki temu serwer Supermicro GPU A+ Server AS-4125GS-TNRT nie tylko zaspokaja bieżące potrzeby, ale jest również odporny na wyzwania przyszłości, dostosowując się do zmieniającego się krajobrazu technologicznego.



 Amazon