

Program JumpStart firmy Supermicro ugruntował swoją pozycję jako jedno z bardziej użytecznych narzędzi w zestawie narzędzi do ewaluacji przed zakupem infrastruktury AI. Zamiast skryptowanej wersji demonstracyjnej w środowisku współdzielonym, JumpStart oferuje kwalifikowanym użytkownikom bezpłatny, ograniczony czasowo dostęp do rzeczywistych serwerów produkcyjnych za pośrednictwem SSH, IPMI i VNC, umożliwiając im uruchamianie obciążeń na rzeczywistym sprzęcie. W listopadzie ubiegłego roku szczegółowo omówiliśmy program, wykorzystując system X14 z kartą graficzną NVIDIA HGX B200 , i uzyskaliśmy jasny obraz tego, co tydzień intensywnego dostępu może, a czego nie może dać. Tym razem Supermicro zapewniło dostęp do systemu H14 8U z zupełnie inną historią akceleratora.
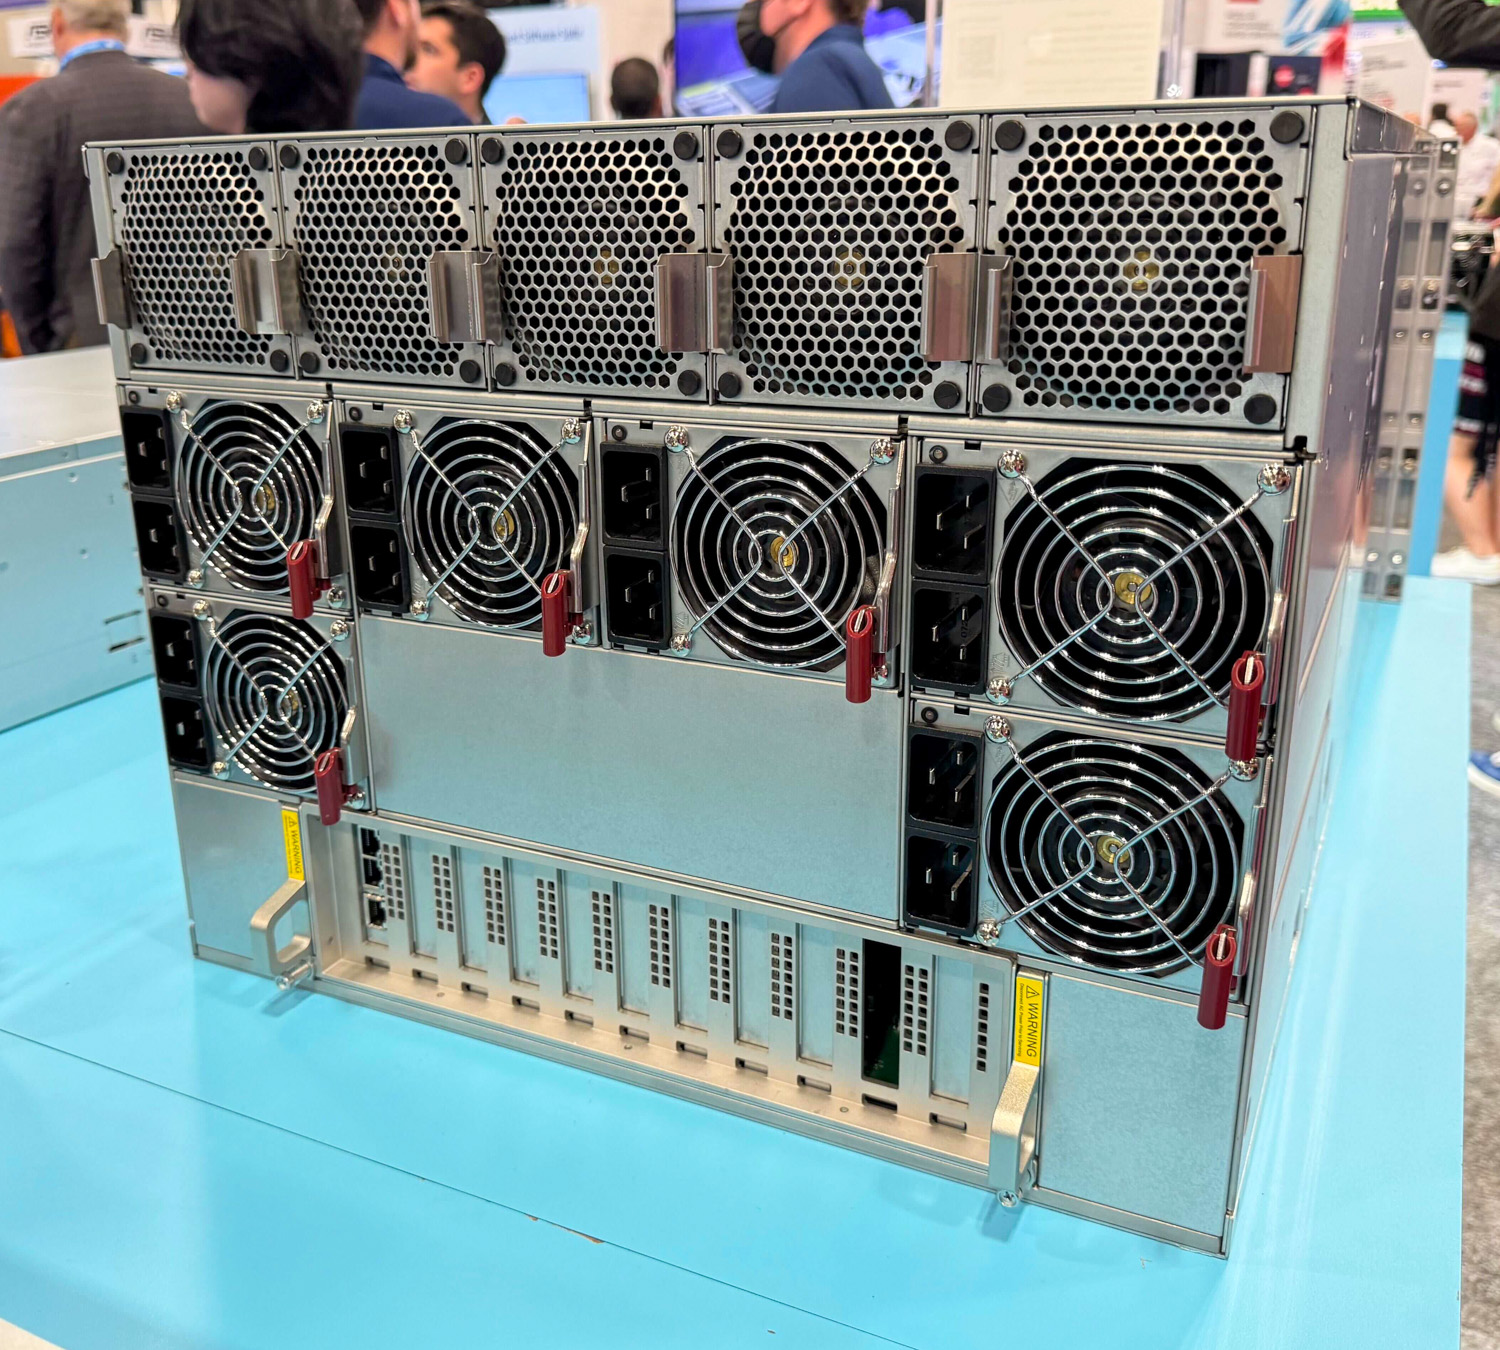
Przetestowaliśmy system AS-8126GS-TNMR , platformę chłodzoną powietrzem o wysokości 8U, zbudowaną na bazie dwóch procesorów AMD EPYC 9575F i ośmiu procesorów graficznych AMD Instinct MI350X. MI350X to flagowy akcelerator centrów danych AMD, zbudowany w oparciu o architekturę CDNA czwartej generacji w 3-nanometrowym węźle TSMC i oferujący 288 GB pamięci HBM3e na procesor graficzny. Dzięki ośmiu procesorom graficznym połączonym za pomocą technologii AMD Infinity Fabric, serwer oferuje łącznie 2.3 TB pamięci GPU w jednym węźle, przy łącznej przepustowości 1,024 GB/s. Cały system wykorzystuje sześć zasilaczy Titanium o mocy 5,250 W w konfiguracji redundantnej 3+3, a firma Supermicro zapewniła dedykowaną przepustowość sieciową 400 Gb/s na procesor graficzny, co umożliwia skalowanie wdrożeń.
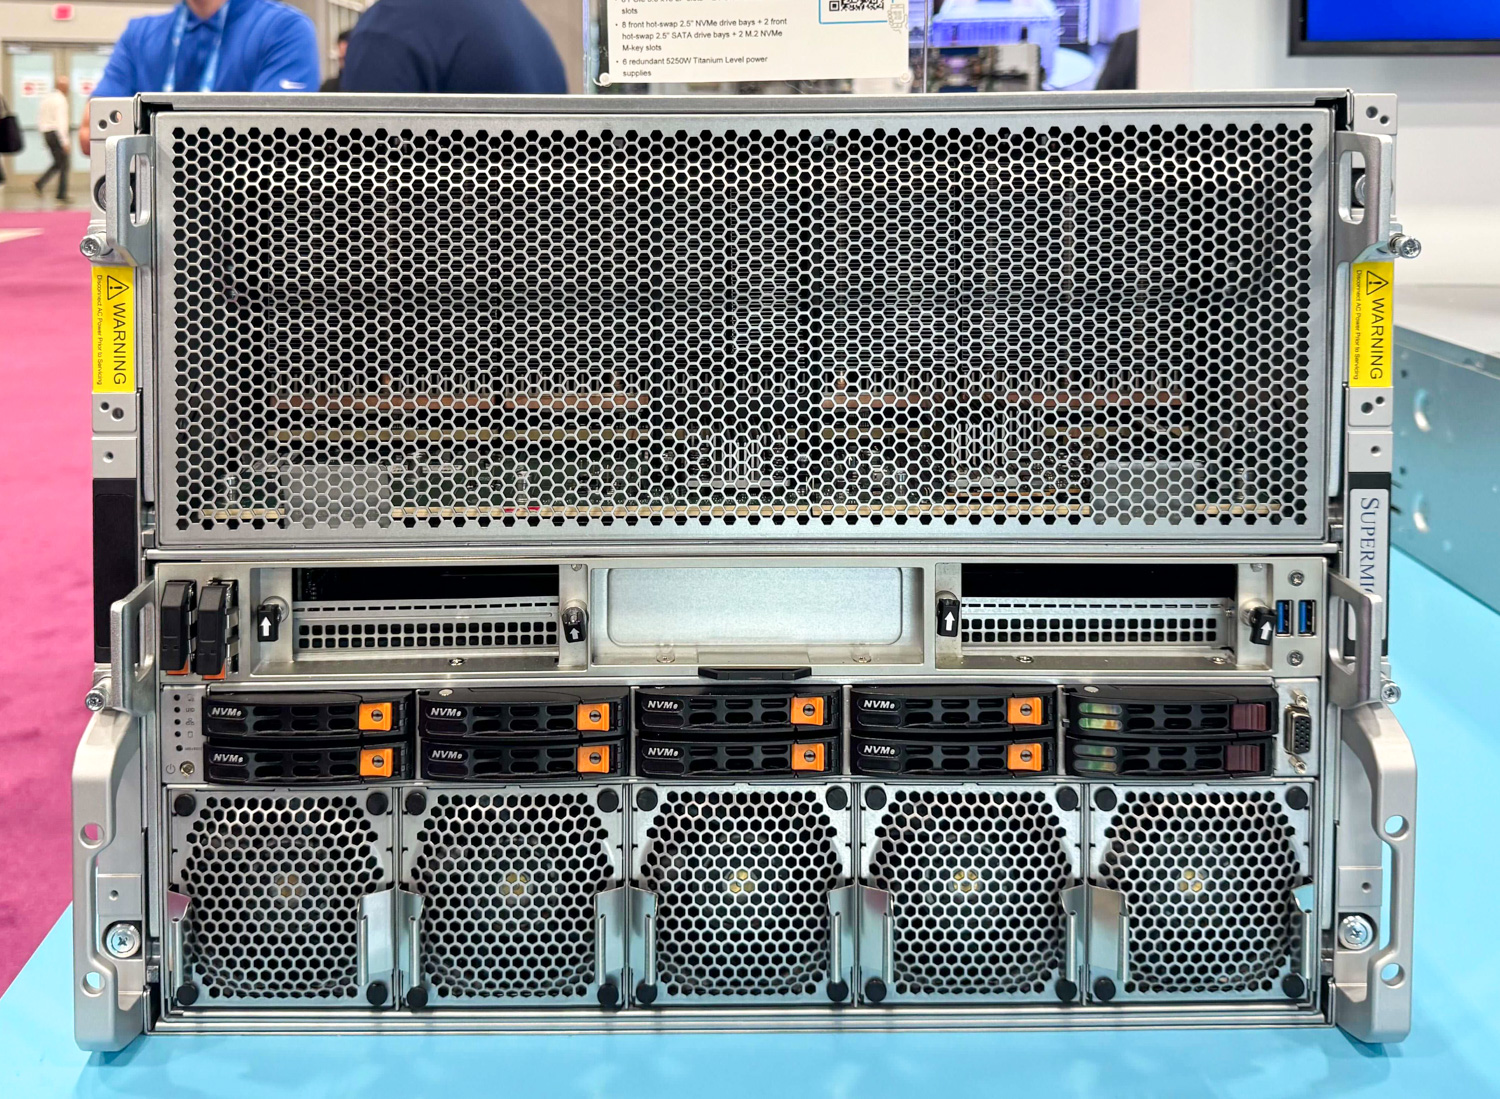
Pozycja AMD na rynku procesorów graficznych dla centrów danych znacząco zmieniła się w ciągu ostatnich dwóch lat, a generacja MI350X stanowi dla firmy NVIDIA poważniejsze wyzwanie konkurencyjne niż jakikolwiek poprzedni produkt Instinct. ROCm 7, wydany we wrześniu 2025 roku i obecnie w wersji 7.2, przyniósł natywne wsparcie dla MI350X, a także znacząco ulepszoną wydajność wnioskowania, aktualizacje interfejsu API HIP, które niwelują lukę w kompatybilności z CUDA, oraz rozszerzone wsparcie dla frameworków, w tym PyTorch, JAX, TensorFlow, ONNX Runtime, vLLM i SGLang.
Projekt vLLM dodał dedykowany potok CI AMD ROCm pod koniec grudnia 2025 roku, dzięki czemu sprzęt AMD stał się platformą najwyższej klasy w tym stosie wnioskowania, a nie portem downstream. Trudno również zignorować fakt, że ekosystem został wdrożony: w lutym 2026 roku AMD i Meta ogłosiły wieloletnią umowę na wdrożenie 6-gigawatowych procesorów graficznych (GPU) o wielu generacjach, bazując na istniejących wdrożeniach produkcyjnych Meta sprzętu z serii MI300 i MI350. Ten poziom zaangażowania jednego z największych operatorów infrastruktury AI na świecie nie jest jedynie marketingowym przypisem.
Dla organizacji, które obecnie analizują infrastrukturę akceleratorów AI, czas realizacji zamówień na sprzęt NVIDIA pozostaje kwestią sporną. Pytanie brzmi, czy AMD stanowi wiarygodną alternatywę, a nie rozwiązanie awaryjne. Na podstawie tygodniowych testów z ROCm 7.2.0 i obecnym vLLM, odpowiedź znacząco różni się od tej sprzed 18 miesięcy.
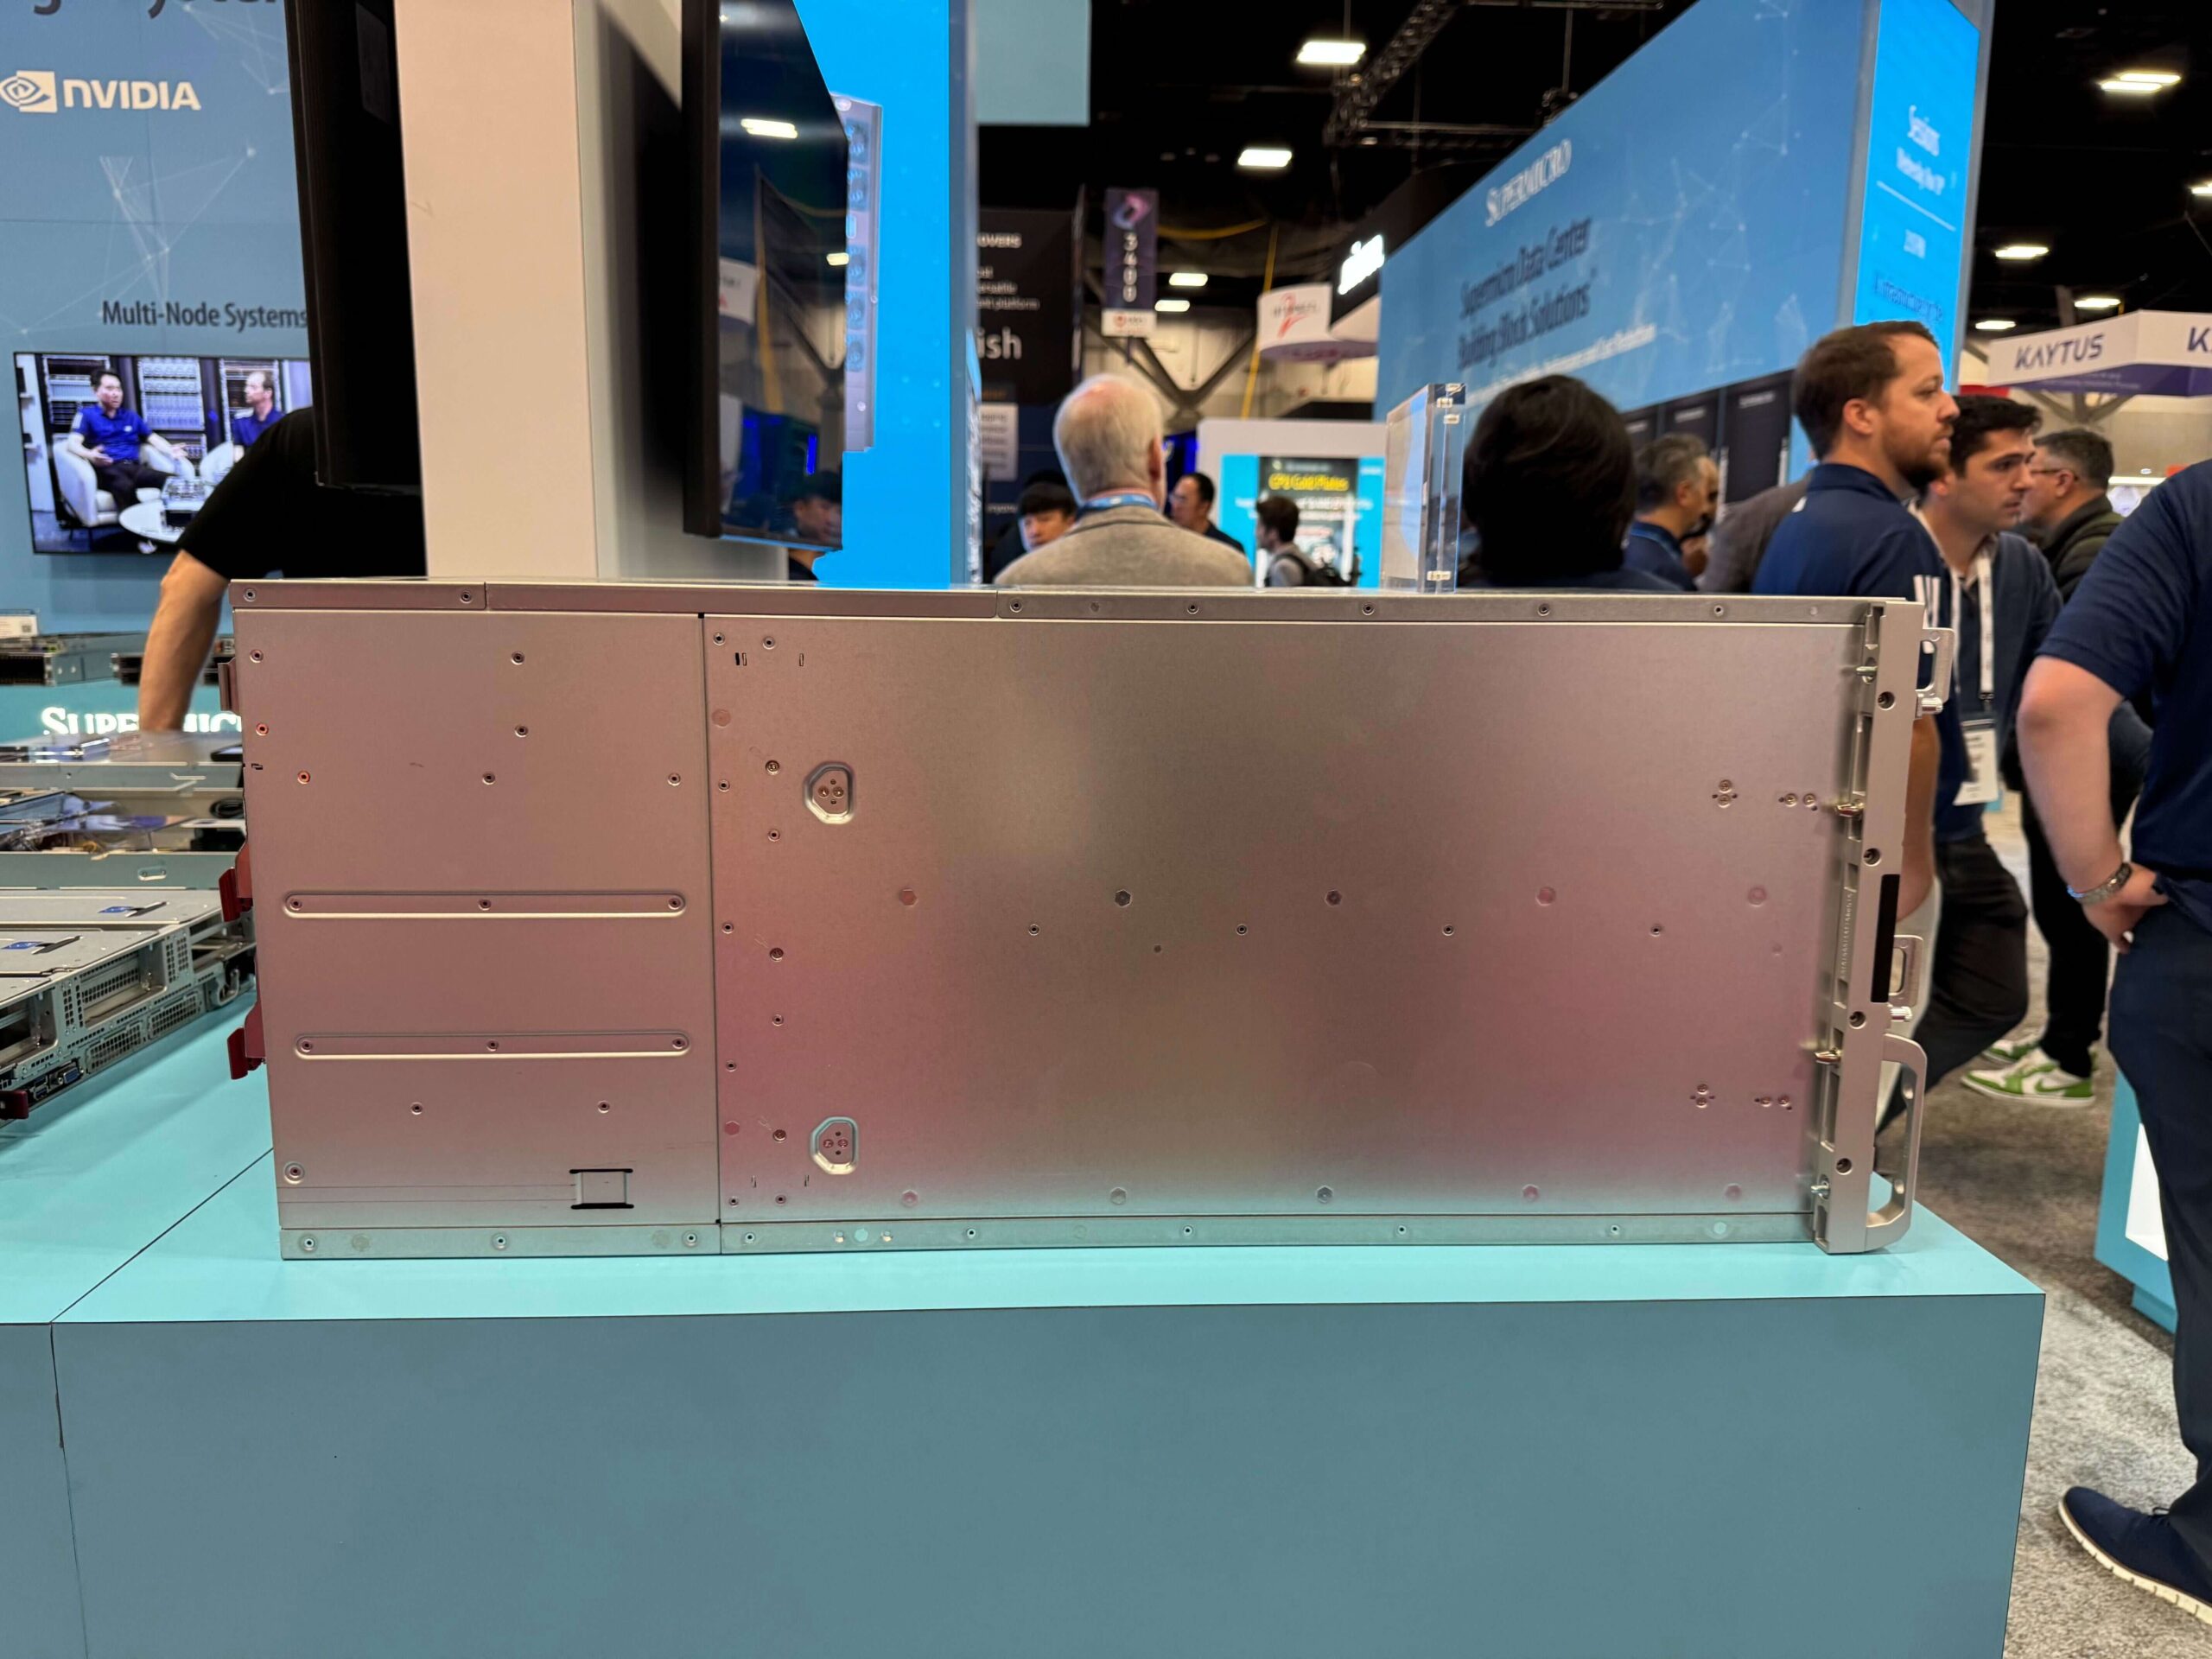
Nasze testy objęły wybrane popularne modele; 2.3 TB pamięci HBM3e w jednym węźle umożliwiło wnioskowanie na pojedynczym serwerze w modelach o dużych parametrach, w tym Kimi K2.5 firmy Moonshot i MiniMax M2.5.
AMD Instinct MI350X: architektura i udoskonalenia generacyjne
MI350X to jak dotąd najbardziej ambitny architektonicznie skok generacyjny AMD w linii produktów Instinct. Zrozumienie decyzji inżynieryjnych, które za nim stoją, zapewnia istotny kontekst dla interpretacji późniejszych wyników wydajności.
Architektura CDNA 4 i przejście węzła procesowego
Fundamentalna zmiana z serii MI300 na serię MI350 opiera się na węźle procesowym N3P firmy TSMC dla układów XCD (Accelerator Compute Chiplets), co oznacza odejście od procesu produkcyjnego 5 nm stosowanego w poprzedniej generacji. Łączna liczba tranzystorów sięga około 185 miliardów, co stanowi wzrost o około 21% w porównaniu z generacją MI300, bez jednoczesnego wzrostu zużycia energii.
W procesorze MI350X zachowano sprawdzoną strategię AMD opartą na wielochipletowej budowie układów. W jego rdzeniu, układ GPU zawiera osiem chipletów obliczeniowych akceleratora (XCD) jako główne silniki obliczeniowe. Każdy XCD zawiera cztery silniki shaderów, każdy z ośmioma aktywnymi jednostkami obliczeniowymi CDNA 4, co daje 32 jednostki obliczeniowe na XCD i łącznie 256 jednostek obliczeniowych dla całego akceleratora.
Warstwa I/O została również skonsolidowana z czterech płytek do dwóch w obudowie CDNA 4. Ta reorganizacja pozwoliła AMD podwoić szerokość magistrali Infinity Fabric, poprawiając przepustowość dwusekcyjną, a jednocześnie obniżając częstotliwość magistrali i napięcie robocze, co pozwoliło zmniejszyć zużycie energii.
Przeprojektowane jednostki obliczeniowe i rozszerzona obsługa precyzji
Dzięki możliwościom matematycznym macierzy jednostek obliczeniowych CDNA 4 nastąpił znaczny wzrost: jednostki CU MI350 zapewniają dwukrotnie większą przepustowość na jednostkę CU w przypadku operacji 16-bitowych (BF16, FP16) i 8-bitowych (FP8, INT8) w porównaniu do odpowiedników MI300.
Oprócz zwiększenia przepustowości CDNA 4 wprowadza sprzętową obsługę typów danych o niższej precyzji, których nie było w serii MI300, zwłaszcza FP6 i FP4, a także istniejącą obsługę FP8 przeniesioną z poprzedniej generacji.
Oprócz tych standardowych formatów, MI350X oferuje natywne wsparcie sprzętowe dla wariantów mikroskalowania OCP: MXFP4, MXFP6 i MXFP8. Formaty mikroskalowania zostały zaprojektowane tak, aby zapewnić korzyści w zakresie przepustowości obliczeń o niższej precyzji, przy jednoczesnym zachowaniu jakości wyjściowej bliższej bazom o wyższej precyzji, niż zazwyczaj pozwala na to standardowa kwantyzacja. Nie jest to rozwiązanie specyficzne dla AMD. Format NVFP4 firmy NVIDIA działa w oparciu o te same zasady mikroskalowania i został szeroko przyjęty w wielu modelach granicznych, a rodzina GPT-OSS firmy OpenAI jest jednym z najpopularniejszych przykładów opartych na tych formatach. Natywne wsparcie MXFP4 w MI350X pozwala na obsługę tych i podobnych rodzin modeli kwantyzowanych bez uciekania się do emulacji programowej lub zwiększania precyzji.
MI350X zapewnia 9.2 PFLOP-ów w MXFP4 i MXFP6, w porównaniu z 4.6 PFLOP-ów w OCP-FP8, z FP16 na poziomie 2.3 PFLOP-ów i szczytowym taktowaniem silnika 2,200 MHz. W przypadku wdrożeń zoptymalizowanych pod kątem wnioskowania, gdzie kwantyzacja mikroskalowalna jest realna, rezerwa mocy obliczeniowej efektywnie podwaja się w porównaniu z obciążeniami FP8. Do jednostki obliczeniowej CDNA 4 dodano również nową wektorową jednostkę ALU, obsługującą operacje 2-bitowe i zdolną do gromadzenia wyników BF16 w FP32, zapewniając dodatkową elastyczność w przypadku obciążeń wektorowych o niskiej precyzji poza główną ścieżką obliczeniową macierzy.
Podsystem pamięci: HBM3e, pamięć podręczna Infinity i wydajność przepustowości
Seria MI350 charakteryzuje się znacząco zmodernizowanym podsystemem pamięci z ośmioma stosami pamięci HBM3e, zapewniającymi łączną pojemność 288 GB na GPU. Każdy stos o pojemności 36 GB, złożony z 12 urządzeń o pojemności 24 Gb/s, działa z pełną szybkością pinów HBM3e, wynoszącą 8 Gb/s na pin. Architektura zachowuje pamięć podręczną Infinity Cache firmy AMD, pamięć podręczną po stronie pamięci, umieszczoną pomiędzy pamięcią HBM a pamięcią podręczną Infinity Fabric/L2. Obejmuje ona 128 kanałów, każdy z 2 MB pamięci podręcznej, co daje łącznie 256 MB na GPU. AMD poszerzyło wbudowane magistrale sieciowe w modułach IOD i obsługuje je przy obniżonym napięciu, co umożliwia około 1.3-krotnie większą przepustowość pamięci na wat w porównaniu z serią MI300.
Zwiększenie pojemności pamięci z 192 GB w MI300X do 288 GB umacnia przewagę AMD w zakresie pojemności pamięci na kartę graficzną, co ma bezpośrednie implikacje dla wnioskowania w dużych modelach. Każdy procesor graficzny MI350X może niezależnie obsługiwać modele z ponad 500 miliardami parametrów. W serwerze z ośmioma procesorami graficznymi, łączna pojemność pamięci HBM3e wynosząca 2.3 TB eliminuje wymagania dotyczące dystrybucji wielowęzłowej, które komplikują wdrożenia z bilionami parametrów, co pokazują wyniki Kimi K2.5 i MiniMax M2.5 w niniejszym przeglądzie.
Elastyczna architektura partycjonowania i wdrażania
Seria MI350 obsługuje elastyczne partycjonowanie GPU na gniazdo, z pamięcią podzieloną na dwa oddzielne klastry. Ta elastyczność dotyczy również dysków XCD, gdzie poczwórny klaster XCD można podzielić na dwa lub pojedyncze bloki, co umożliwia układowi obsługę konfiguracji takich jak 8 instancji modeli 70B w CPX+NPS2. W przypadku organizacji obsługujących heterogeniczne obciążenia wnioskowania w ramach współdzielonej infrastruktury, ta możliwość partycjonowania zmniejsza zapotrzebowanie na dedykowany sprzęt dla każdej warstwy modelu i poprawia ekonomikę wykorzystania w środowiskach wdrożeń mieszanych.
Seria MI350 zachowuje również bezpośrednią kompatybilność z infrastrukturą UBB (Universal Base Board) wykorzystywaną w systemach serii MI300. Istniejące obudowy serwerów, układy zasilania i infrastruktura chłodzenia są przenoszone bez modyfikacji, co zmniejsza opory związane z modernizacją w organizacjach z aktywnymi wdrożeniami MI300.
MI355X: chłodzony cieczą brat
Seria MI350 jest dostępna w dwóch wariantach, zbudowanych na identycznym krzemie bazowym i zoptymalizowanych pod kątem różnych zakresów temperatur pracy. Testowany tutaj MI350X to wariant chłodzony powietrzem, natomiast MI355X to jego odpowiednik chłodzony cieczą, przeznaczony do wdrożeń o wyższej gęstości, gdzie dostępna jest infrastruktura bezpośredniego chłodzenia cieczą.
Chociaż oba warianty bazują na tym samym podstawowym sprzęcie, wyższa moc robocza MI355X umożliwia utrzymanie wyższych częstotliwości taktowania, co przekłada się na około 20% przewagę wydajności w rzeczywistych, kompleksowych obciążeniach w porównaniu z MI350X. MI355X charakteryzuje się maksymalną mocą obliczeniową 1,400 W w porównaniu z 1,000 W w MI350X, a taktowanie sięga 2.4 GHz w porównaniu z 2.2 GHz w wariancie chłodzonym powietrzem.
W ujęciu generacyjnym platforma MI355X zapewnia nawet czterokrotnie wyższą teoretyczną wydajność szczytową w porównaniu z MI300X, a w warunkach rzeczywistych wzrost wnioskowania wynosi około 4.2-krotnie w przypadku obciążeń agentowych i chatbotów oraz około 3-krotnie w scenariuszach generowania treści. Dla organizacji oceniających wdrożenia MI350X, 20% różnica w wydajności między tymi dwoma wariantami stanowi wyraźny pułap. Obiekty z infrastrukturą DLC powinny ocenić MI355X, aby ustalić, czy inwestycja w chłodzenie termiczne zapewnia wystarczający wzrost przepustowości dla ich konkretnego profilu obciążenia, zanim zdecydują się na konfiguracje chłodzone powietrzem na dużą skalę.
Dostęp do AMD Instinct MI350X za pośrednictwem programu Supermicro JumpStart
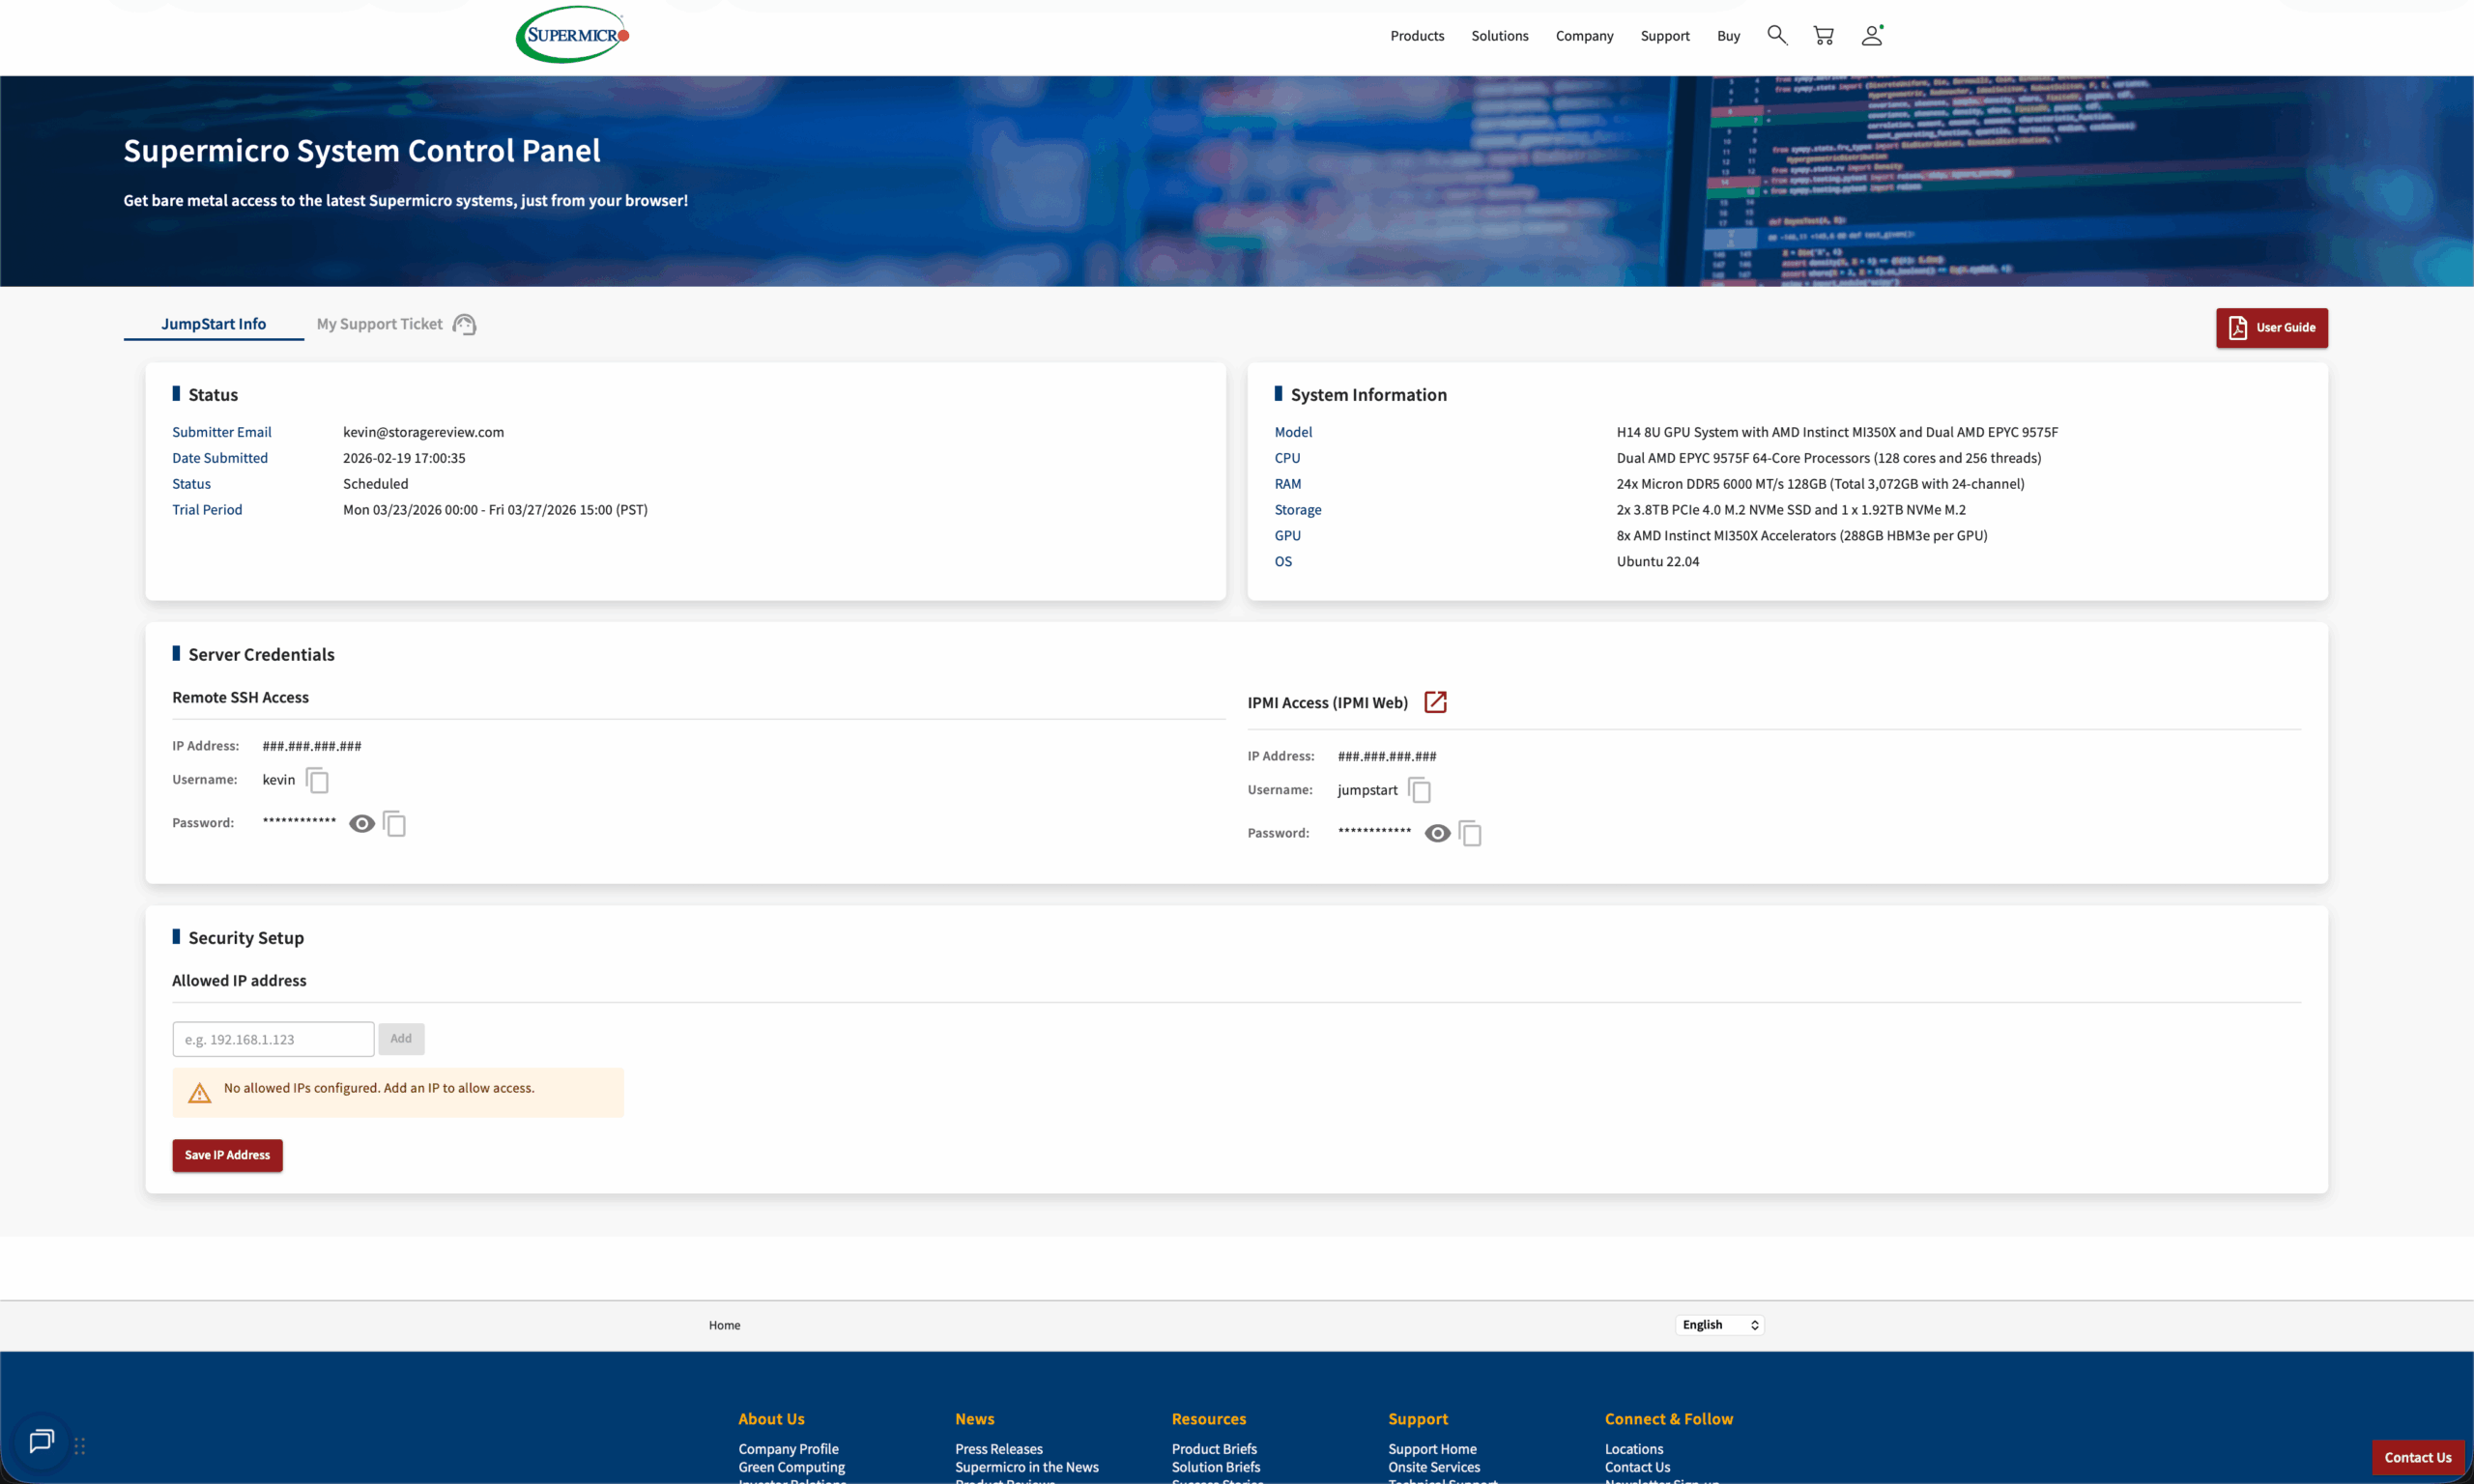
Aby rozpocząć korzystanie z JumpStart, należy zarejestrować się na portalu Supermicro, gdzie wykwalifikowani użytkownicy mogą przeglądać dostępne systemy i rezerwować terminy rezerwacji. Po zatwierdzeniu, portal udostępnia dane uwierzytelniające SSH, dostęp do IPMI oraz internetową konsolę zdalną na czas trwania rezerwacji. System jest dostarczany z preinstalowanym Ubuntu i gotowy do użycia. Nie ma żadnych opóźnień w konfiguracji ani konieczności kontaktu z działem wsparcia technicznego, aby rozpocząć korzystanie z platformy. Nasza rezerwacja trwała od 23 do 27 marca 2026 roku, co daje nam cały tydzień na platformie, zgodnie z naszym wcześniejszym zaangażowaniem w JumpStart w HGX B200.
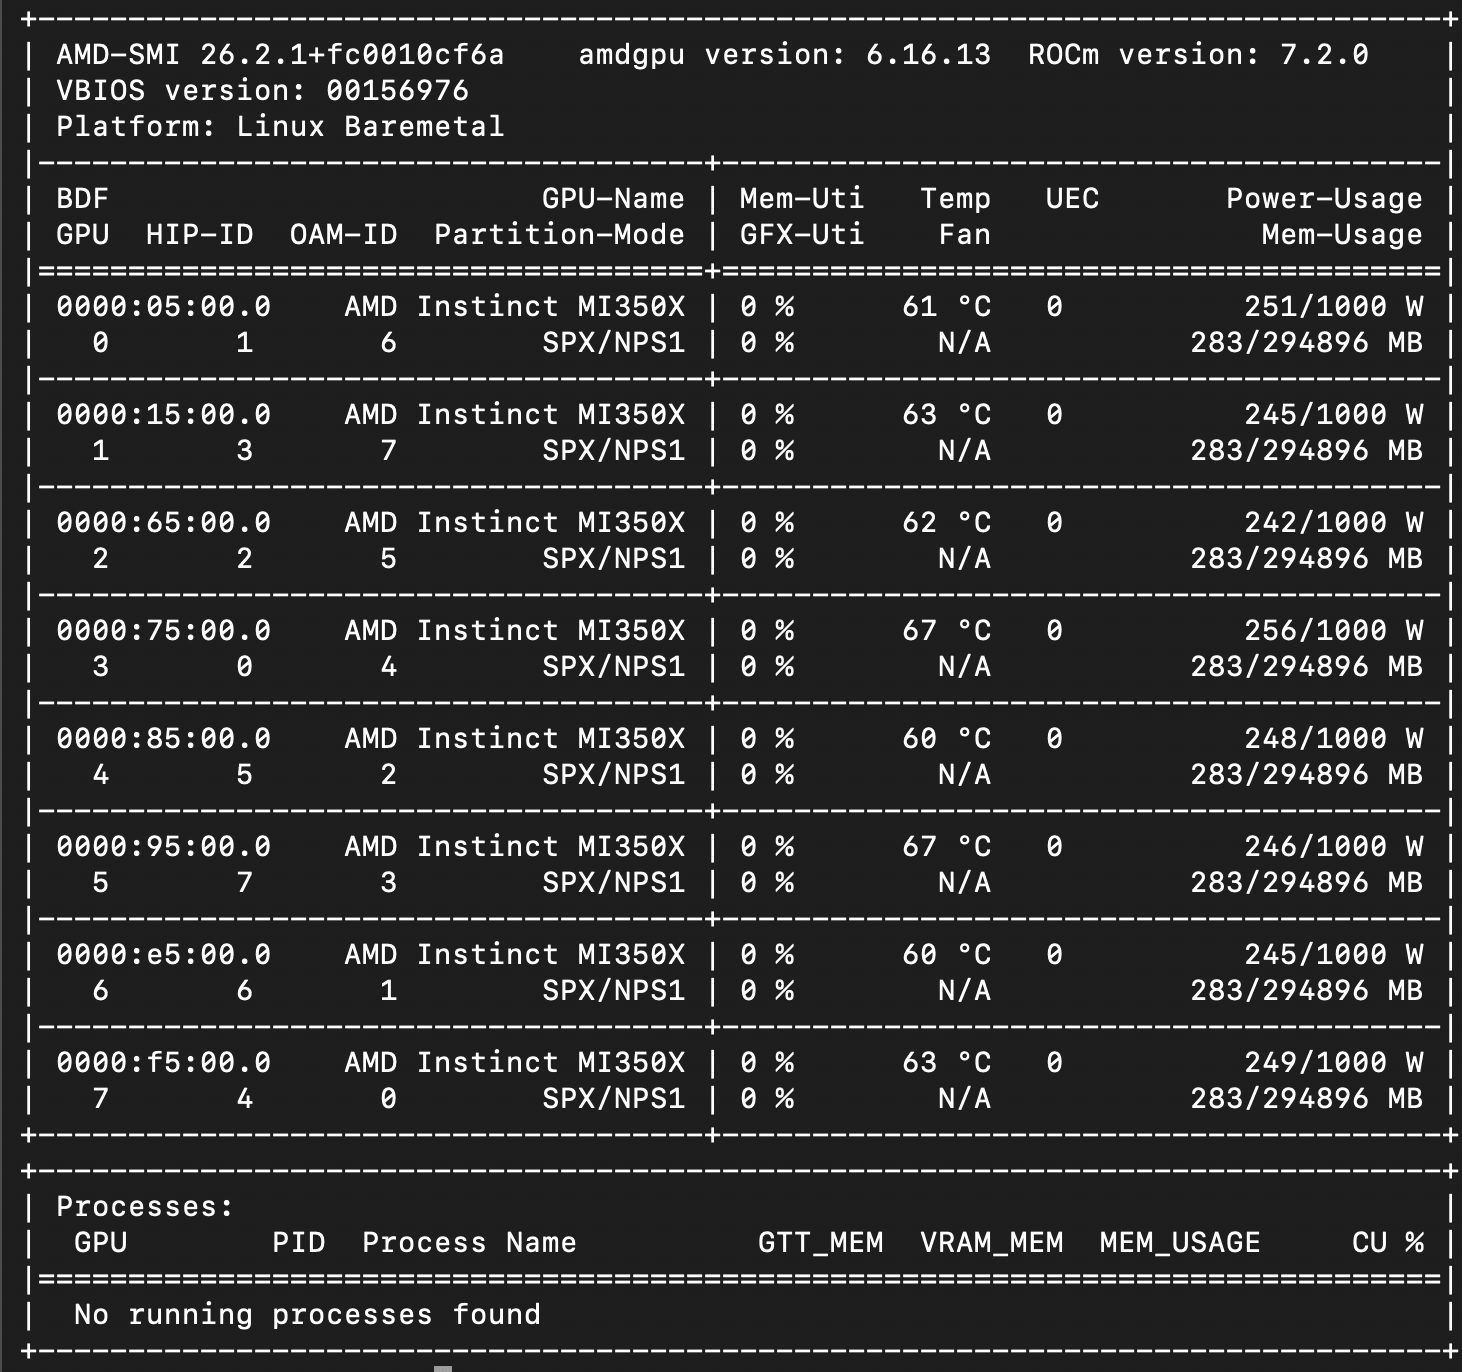
Poniższy zrzut ekranu przedstawia dane wyjściowe terminala z jumpstart dla systemu H14, przy czym narzędzie AMD-SMI wyświetla osiem procesorów graficznych AMD Instinct MI350X i wersje ich uruchomionego oprogramowania.
Wyniki testów wydajności AMD Instinct MI350X
Konfiguracja systemu
- Podwozie: Supermicro H14
- PROCESOR: Podwójny AMD EPYC 9575F
- Pamięć: 3TB DDR5
- GPU: osiem AMD Instinct MI350X
- Przechowywanie: 2 dyski SSD PCIe 4.0 M.2 NVMe o pojemności 3.8 TB i 1 dysk NVMe M.2 o pojemności 1.92 TB
Podsumowanie rezultatów
| Model | Precyzja | Równy (256/256) | Wstępne wypełnienie – mocne (8 tys./1 tys.) | Dekodowanie ciężkie (1k/8k) |
|---|---|---|---|---|
| GPT-OSS 20B | NVFP4 | 62,247 | 123,714 | 32,468 |
| GPT-OSS 120B | NVFP4 | 33,538 | 84,018 | 20,602 |
| Lama 3.1 8B Instruktaż | BF16 | 51,467 | 77,658 * | 19,326 |
| Mistral Small 3.1 24V | FP8 | 40,742 | 56,093 | 14,557 |
| Mistral Small 3.1 24V | BF16 | 30,530 | 53,740 | 13,559 |
| Koder Qwen3 30B A3B | BF16 | 34,980 | 51,550 | 11,782 |
| Koder Qwen3 30B A3B | FP8 | 25,928 | 47,179 | 11,014 |
| MiniMax M2.5 | FP8 w skali blokowej | 14,391 | 23,689 | 6,068 |
| Kimi K2.5 | INT4 QAT + BF16 | 6,527 | 11,256 | 2,513 |
| Wszystkie wartości podano w tok/s, szczytowa przepustowość przy BS=256. *Llama 3.1 8B z intensywnym wstępnym wypełnianiem osiągnęła szczyt przy BS=128 (77 658 tok/s); BS=256 wynosiło 76 893 tok/s. | ||||
Claude Code Serving – MiniMax M2.5
Poza tradycyjnymi, surowymi testami wnioskowania LLM, chcieliśmy ocenić, jak dobrze ten sprzęt sprawdza się w procesie kodowania agentowego, a konkretnie w obsłudze wielu równoczesnych sesji Claude Code z modelem hostowanym lokalnie. Ten przypadek użycia ma bezpośrednie przełożenie na produktywność zespołu programistów: ilu inżynierów może jednocześnie korzystać z asystenta kodowania AI obsługiwanego z jednego węzła, zanim jakość pracy ulegnie pogorszeniu?
Aby to przetestować, zbudowaliśmy zestaw testowy, który generuje zbiór danych o umiarkowanie trudnych problemach kodowania (takich jak implementacja pamięci podręcznej LRU, budowanie aplikacji z listą zadań CLI, pisanie konwertera Markdown i konstruowanie interfejsu API REST) i uruchamia każdą sesję Claude Code w osobnym kontenerze Dockera na lokalnym serwerze vLLM. Pomiędzy sesjami a punktem końcowym wnioskowania znajduje się transparentny serwer proxy, który rejestruje metryki dla każdego żądania dla każdej instancji kodu Claude. Użyty model to MiniMax M2.5, obsługiwany przez vLLM na ośmiu procesorach graficznych MI350X. Chociaż nie jest to najlepszy model kodowania w publicznych rankingach, M2.5 to wydajny model, z którego korzysta wielu użytkowników, w tym wielu naszych zaprzyjaźnionych programistów.
Jako punkt odniesienia użyliśmy średniej przepustowości wyjściowej Claude Opus 4.6 firmy Anthropic, uzyskanej za pośrednictwem OpenRouter.ai, jednej z najpopularniejszych usług routingu dla dostępu do API produkcyjnego. Ta wartość bazowa wynosi około 37 tokenów na sekundę na żądanie API.
Zmierzyliśmy dwa kluczowe wskaźniki: średnią liczbę tokenów wyjściowych na sekundę dla sesji Claude Code (to, co zauważa każdy programista) oraz łączną liczbę tokenów wyjściowych na sekundę dla wszystkich sesji (całkowitą pracę generowaną przez serwer).
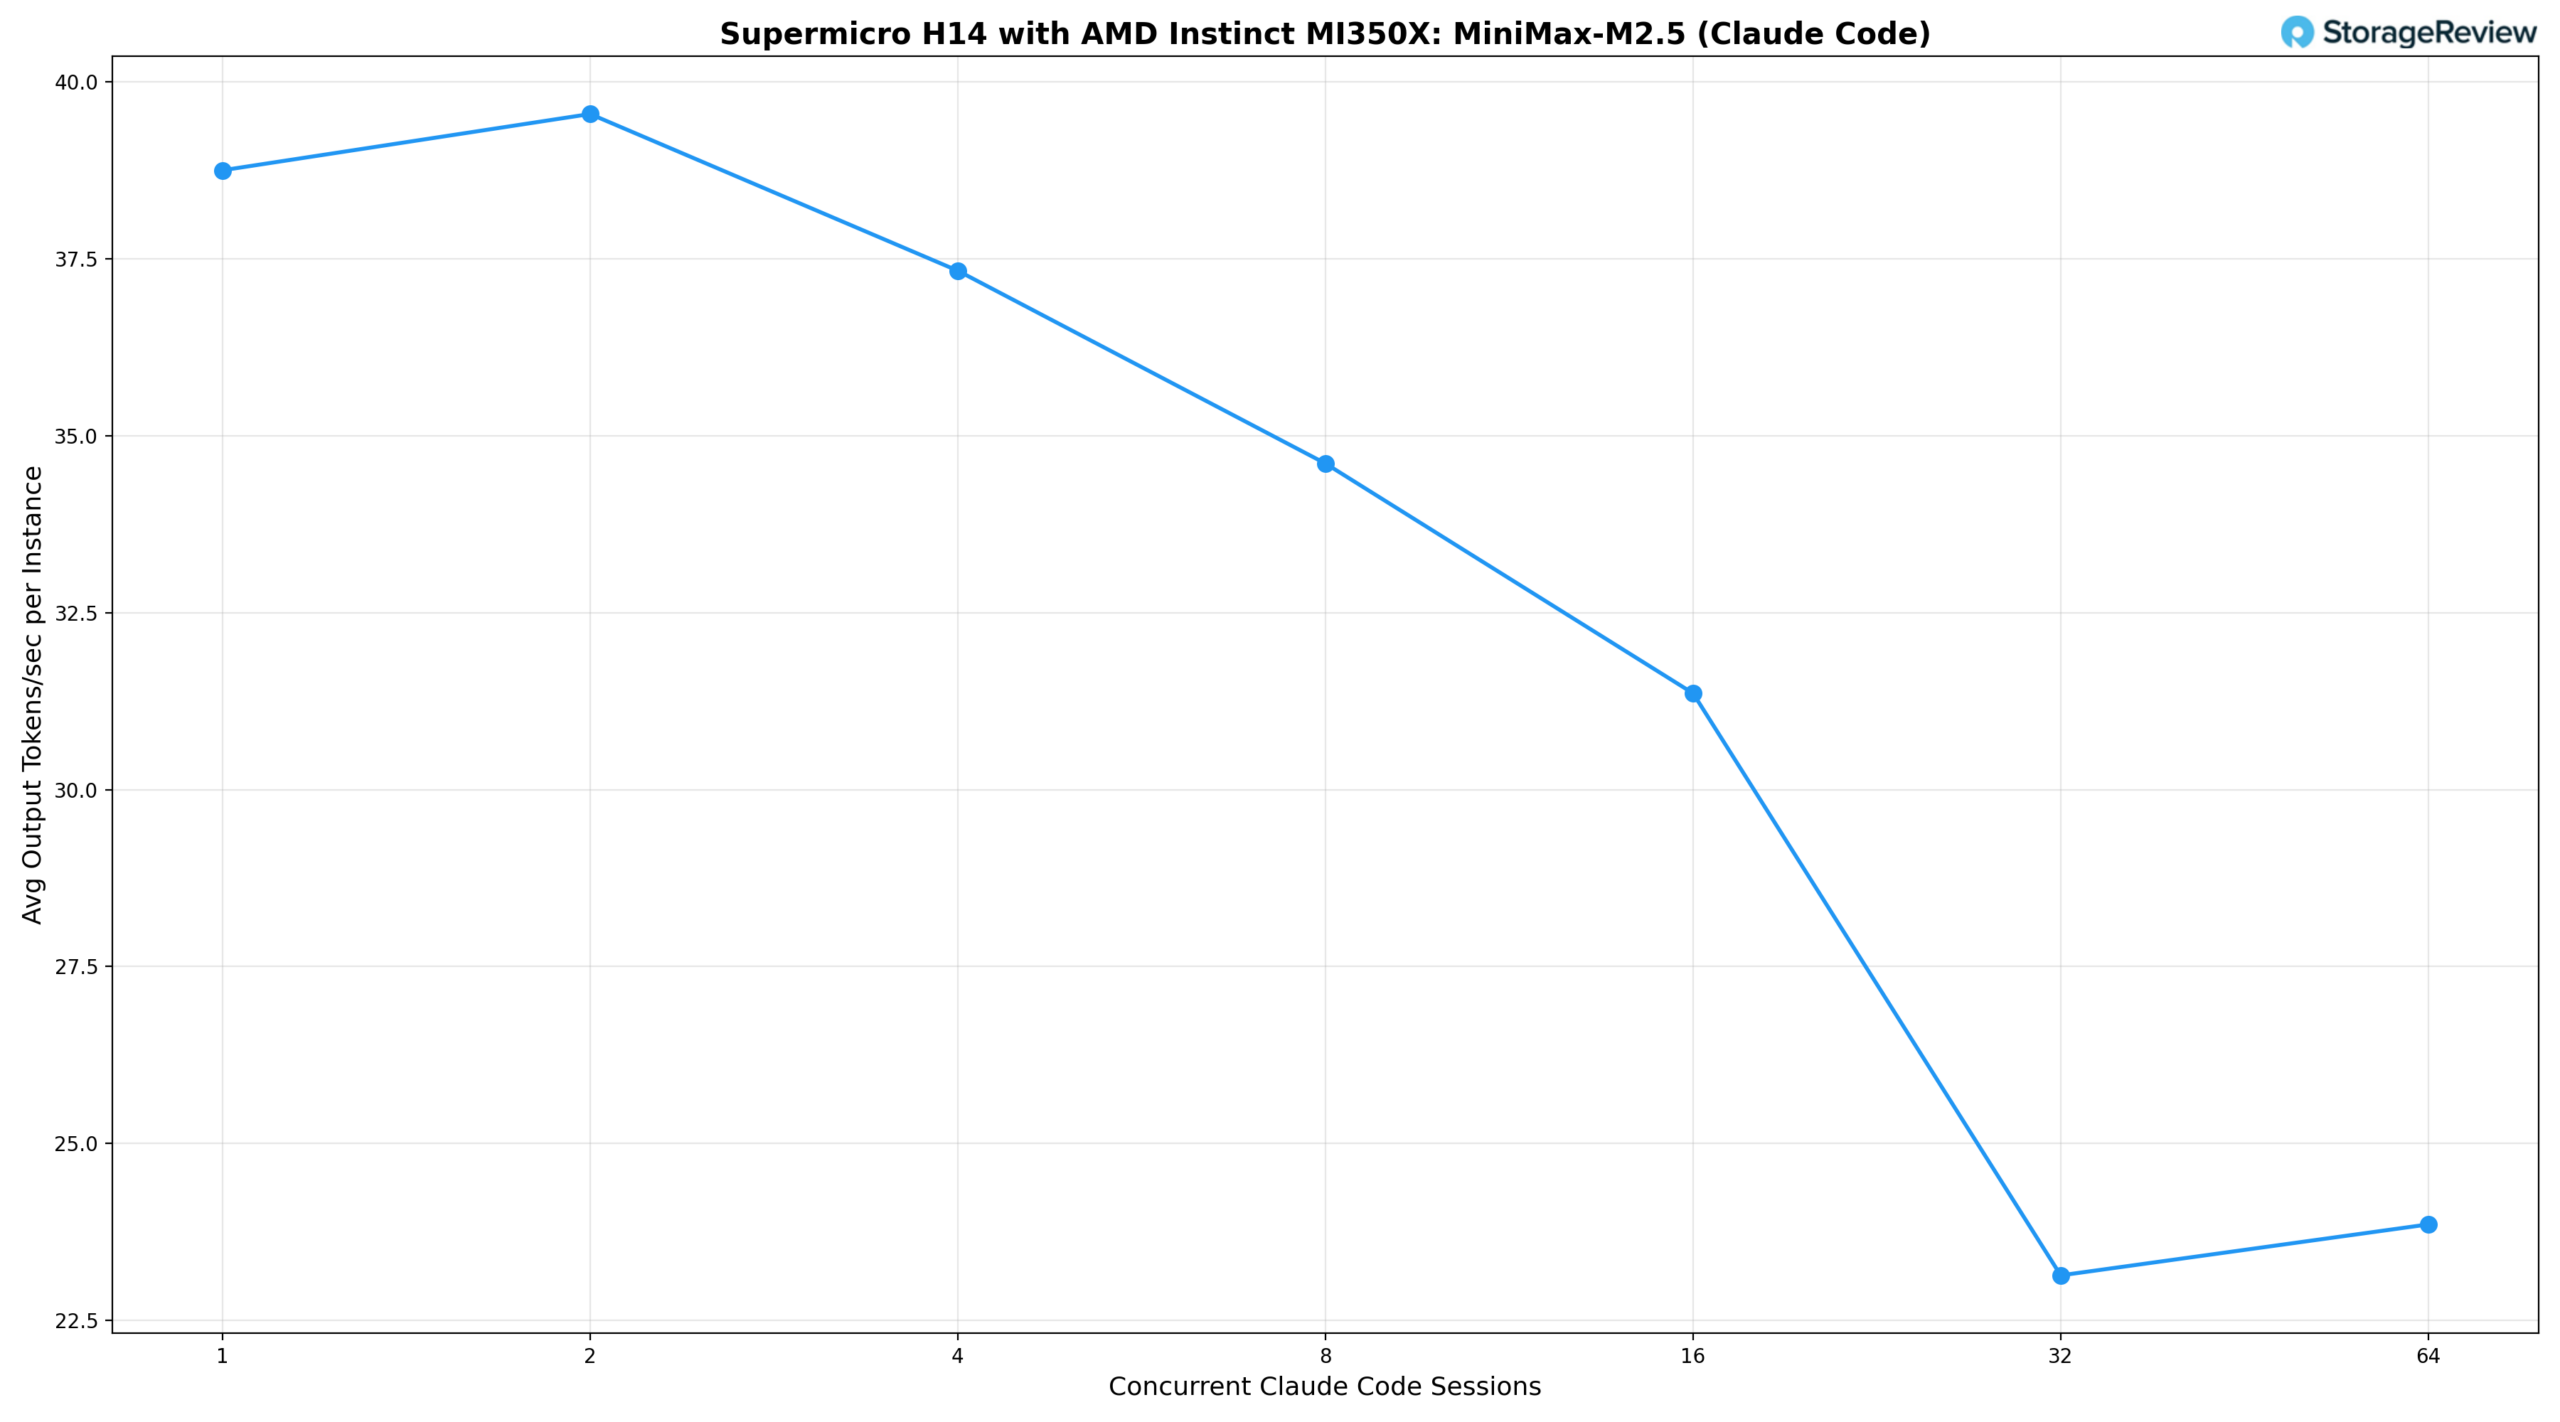
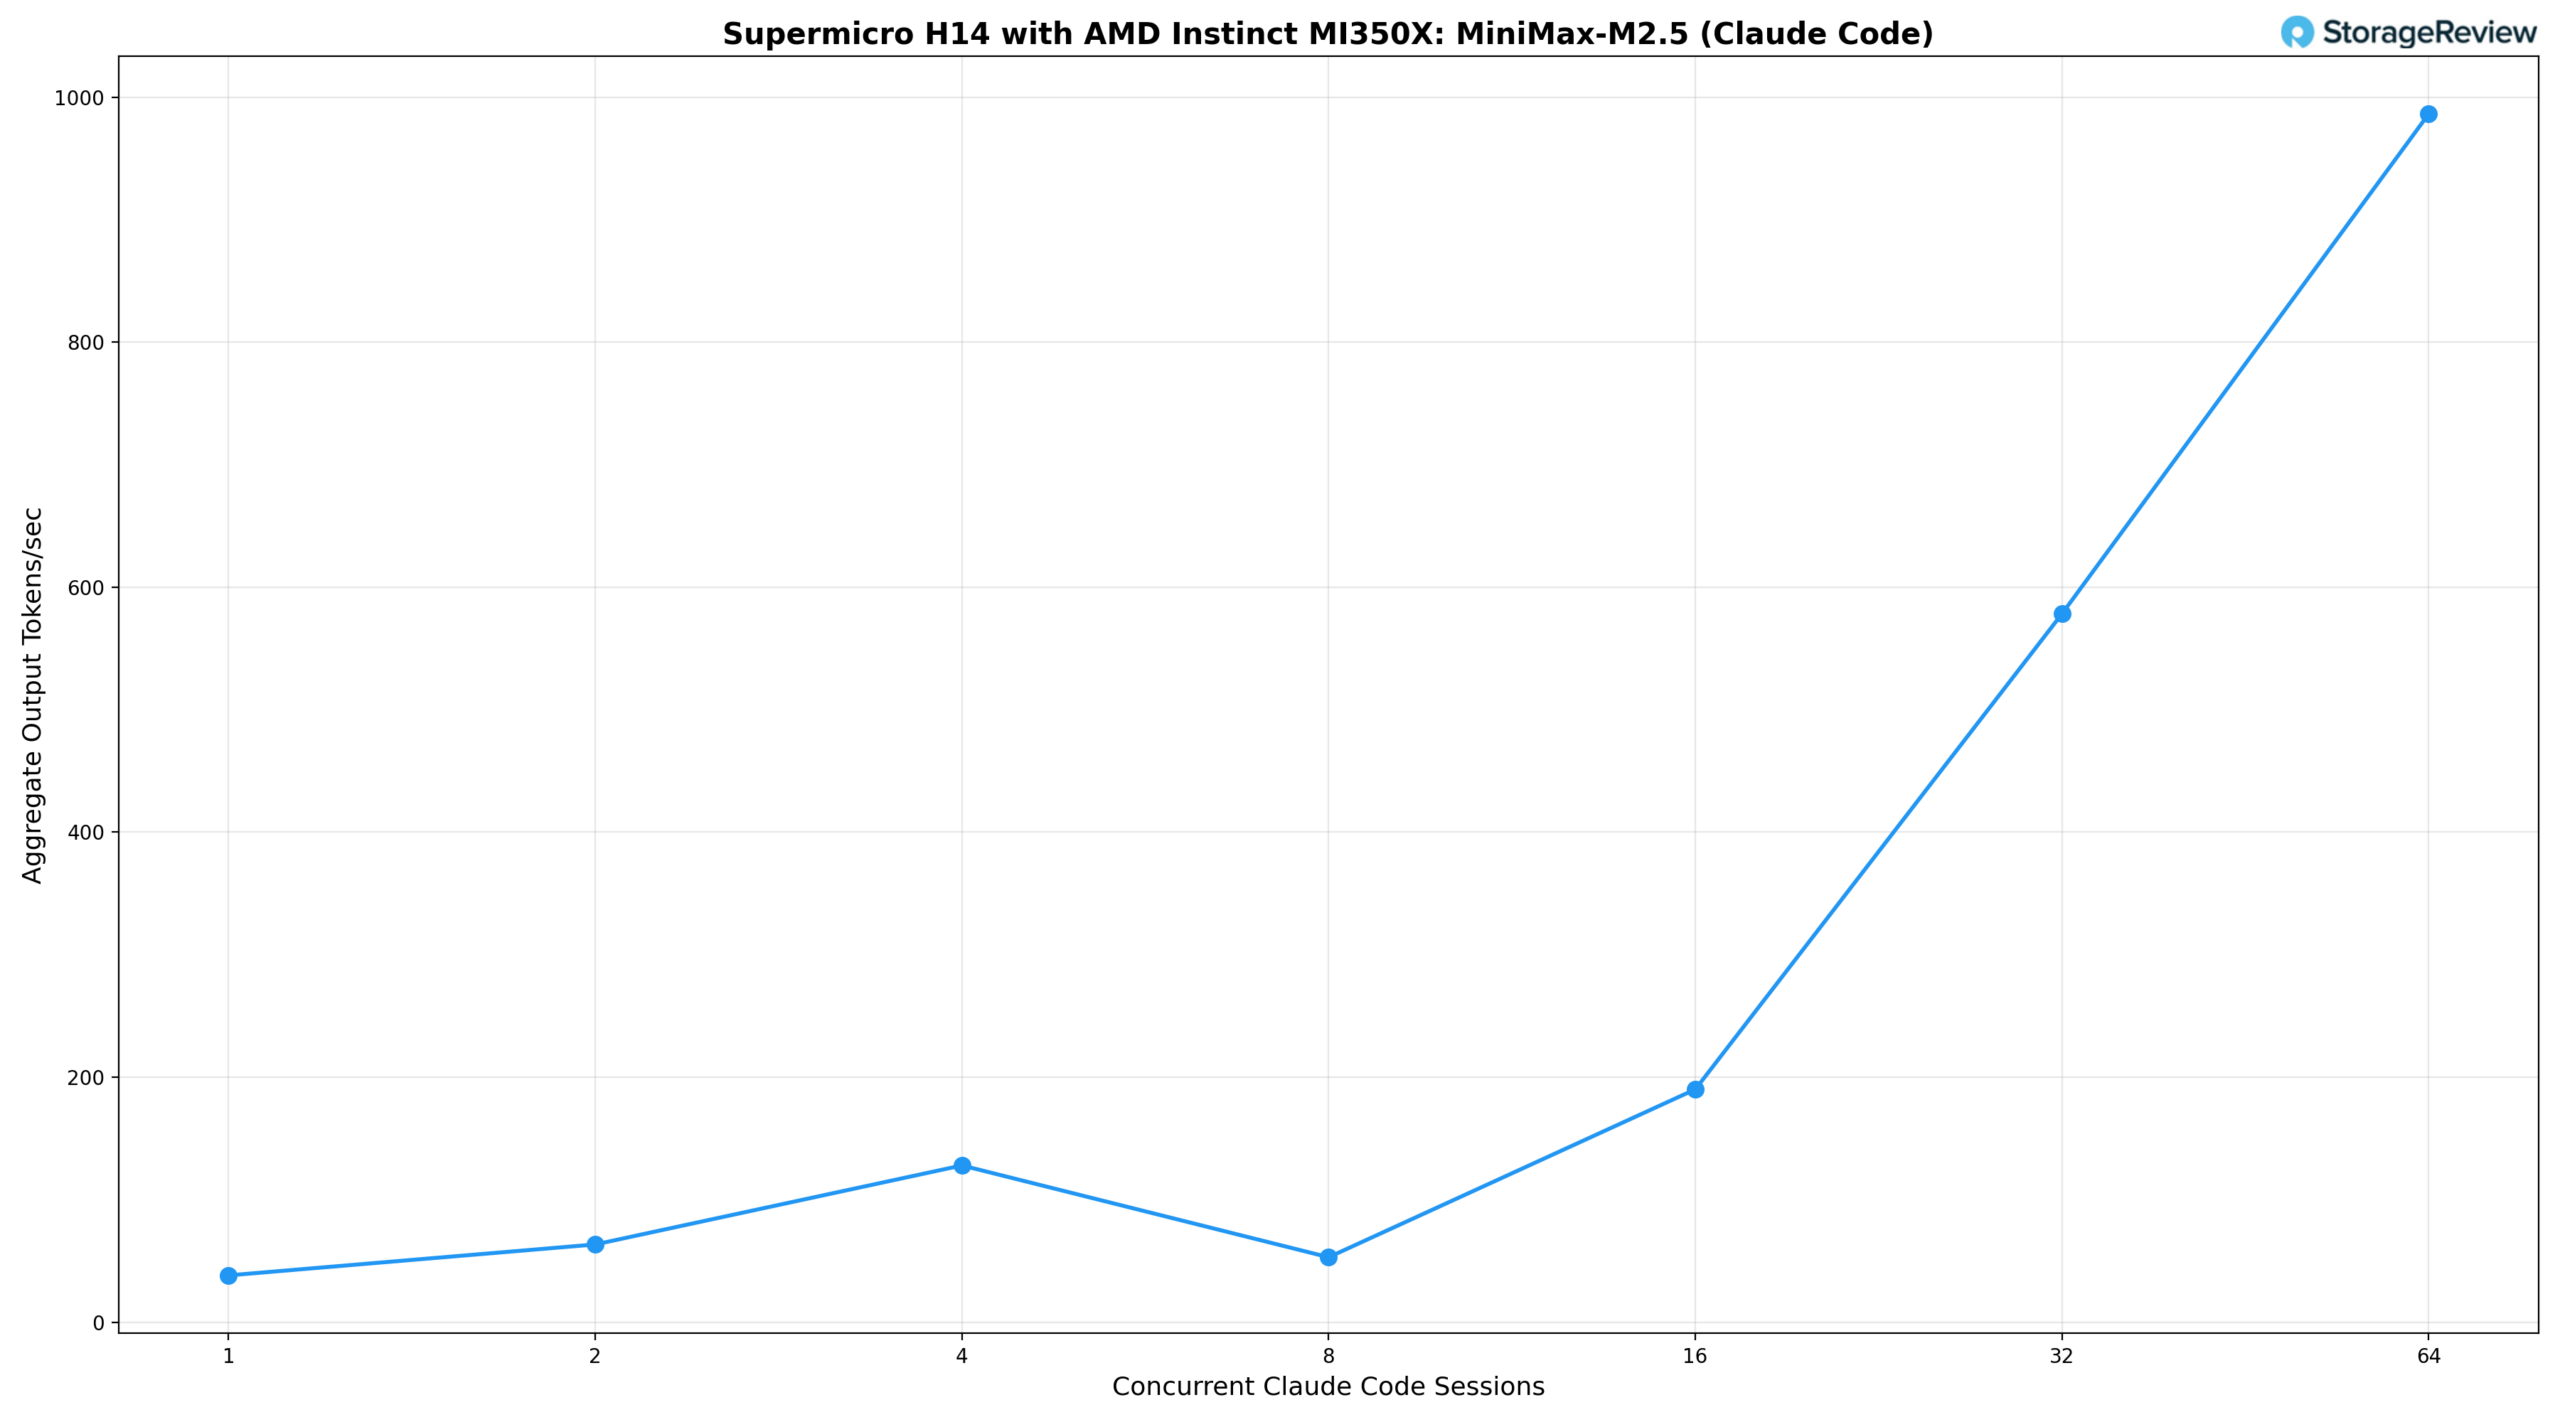
Patrząc na wyniki, pojedyncza sesja równoczesna zapewnia 38.8 tok/s na użytkownika i łączną przepustowość 38 tok/s, nieznacznie powyżej wartości bazowej chmury OpenRouter. Przy dwóch sesjach system osiąga 39.5 tok/s na użytkownika, ponieważ przetwarzanie wsadowe vLLM zaczyna amortyzować narzut, a łączna przepustowość wzrasta do 63 tok/s. Cztery sesje równoczesne odbywają się z przepustowością 37.3 tok/s na użytkownika, co odpowiada wartości bazowej chmury, jednocześnie obsługując czterech programistów, a łączna przepustowość osiąga 128 tok/s. Od ośmiu sesji w górę przepustowość na instancję zaczyna spadać: 34.6 tok/s na użytkownika przy ośmiu sesjach, 31.4 tok/s przy szesnastu z łączną przepustowością 190 tok/s i stabilizuje się na poziomie 23 tok/s na użytkownika przy 32 i 64 sesjach, podczas gdy łączna przepustowość wzrasta odpowiednio do 578 tok/s i 986 tok/s. To klasyczny kompromis między przepustowością przetwarzania wsadowego a interaktywnością: system może osiągnąć znacznie wyższą całkowitą przepustowość, przetwarzając wsadowo więcej żądań, ale każdy użytkownik doświadcza dłuższego czasu reakcji. Nawet przy 64 jednoczesnych użytkownikach, każdy programista nadal widzi użyteczne, interaktywne środowisko, choć zauważalnie wolniejsze niż w przypadku bazowej wersji chmury.
Dla organizacji, które porównują koszt kilkudziesięciu jednoczesnych komercyjnych subskrypcji API z infrastrukturą hostowaną we własnym zakresie, kompromis jest oczywisty: pojedynczy węzeł MI350X może obsłużyć zespół programistów składający się z 16–32 inżynierów, utrzymując szybkość reakcji na użytkownika w granicach 60–85% wartości bazowej chmury, jednocześnie dostarczając łączną wydajność na poziomie 600–1,000 tok/s, z dodatkowymi korzyściami w postaci lokalizacji danych, braku opłat API za token i pełnej kontroli nad wyborem modelu.
vLLM Online Serving – wydajność wnioskowania LLM
vLLM to jeden z najpopularniejszych wysokoprzepustowych silników wnioskowania i obsługi dla systemów LLM. Test porównawczy obsługi online vLLM ocenia rzeczywistą wydajność obsługi tego silnika wnioskowania przy współbieżnych żądaniach. Symuluje obciążenia produkcyjne poprzez wysyłanie żądań do działającego serwera vLLM, z konfigurowalnymi parametrami, takimi jak częstotliwość żądań, długość wejścia/wyjścia i liczba współbieżnych klientów. Test mierzy kluczowe wskaźniki, takie jak przepustowość (liczba tokenów na sekundę), czas do pierwszego tokena i czas na token wyjściowy (TPOT), pomagając użytkownikom zrozumieć, jak vLLM działa w różnych warunkach obciążenia.
Przetestowaliśmy wydajność wnioskowania w ramach kompleksowego zestawu modeli obejmujących różne architektury, skale parametrów i strategie kwantyzacji, aby ocenić przepustowość przy różnych profilach współbieżności.
GPT-OSS 120B i 20B
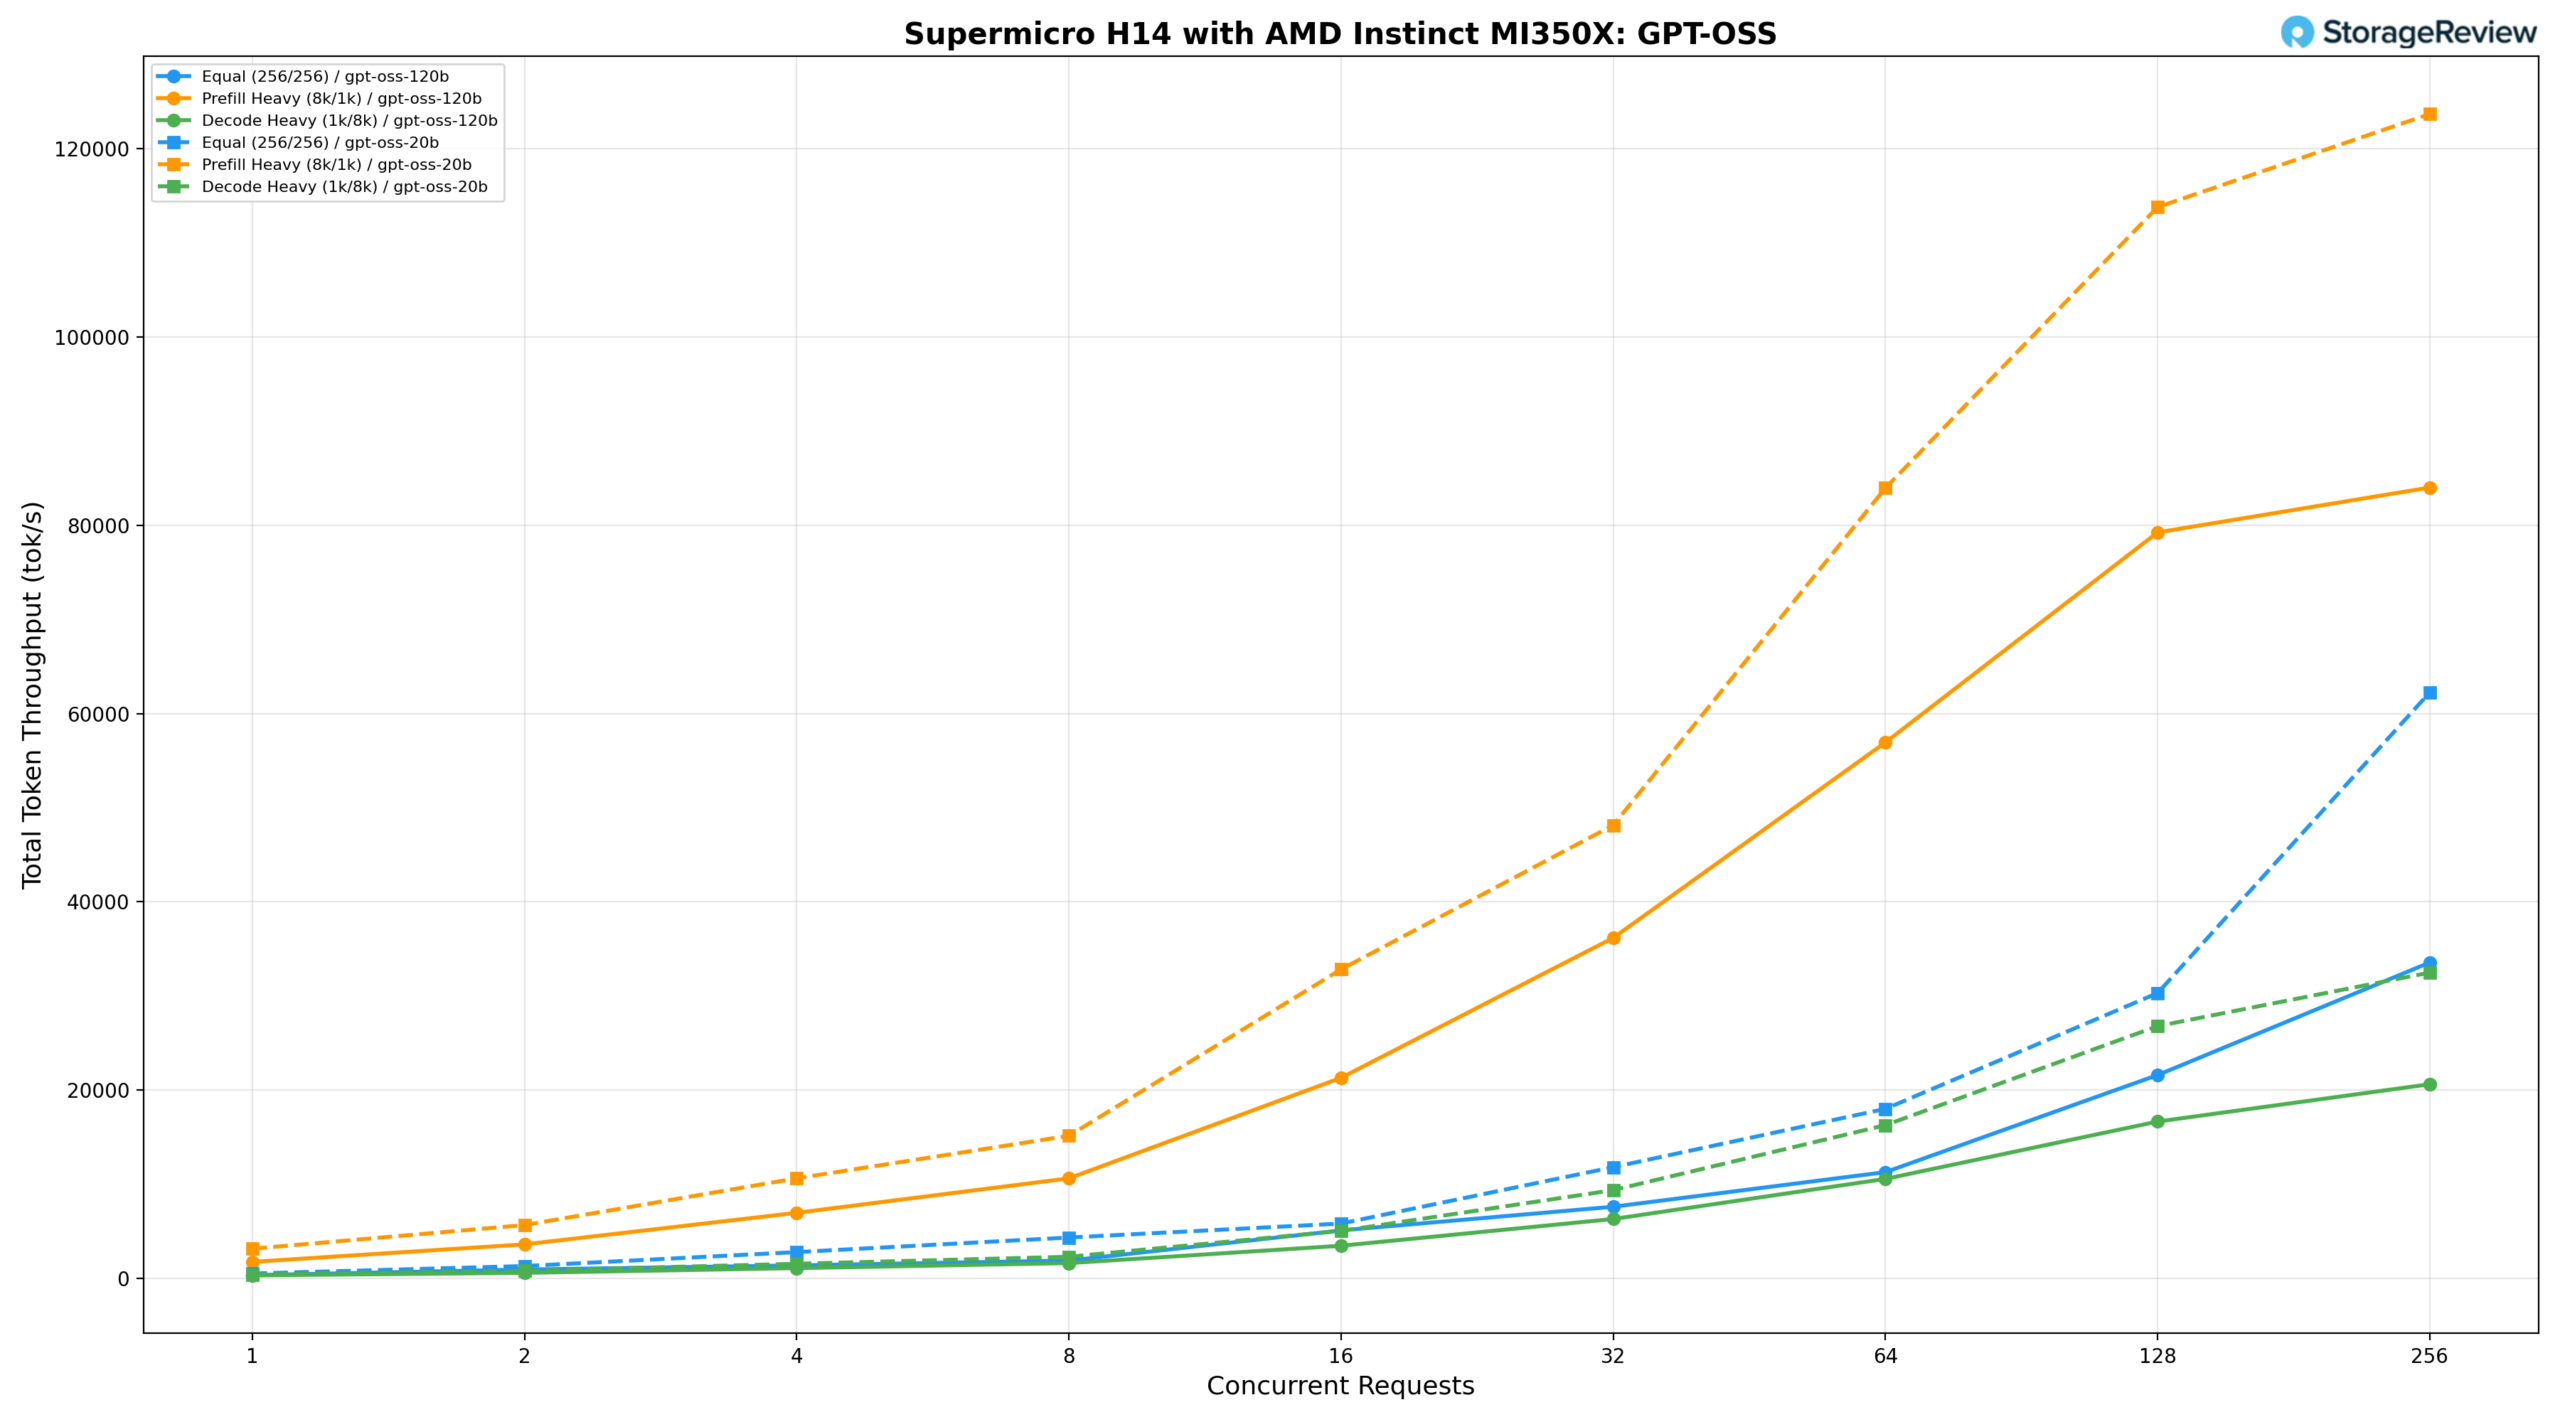
Rodzinę modeli GPT-OSS testowano w konfiguracjach 120B i 20B na komputerze Supermicro H14.
GPT-OSS 120B
Model 120B przy równym obciążeniu (256/256) zapewnia 313.42 tok/s przy BS=1, osiąga 11 261,72 tok/s przy BS=64 i osiąga szczyt na poziomie 33 538,23 tok/s przy BS=256. Model z dużym obciążeniem wstępnym (8k/1k) rozpoczyna się od 1,724.84 tok/s, wzrasta do 36 156,80 tok/s przy BS=32 i 79 247,76 tok/s przy BS=128, osiągając szczyt na poziomie 84 018,79 tok/s przy BS=256. Prędkość dekodowania (1k/8k) wzrasta z 288.90 tok/s przy BS=1 do 20 602,52 tok/s przy BS=256, przy czym opóźnienie pozostaje dobrze kontrolowane przy niższych poziomach współbieżności.
GPT-OSS 20B
Model 20B zapewnia 485.17 tok/s przy BS=1 i takim samym obciążeniu, osiągając 17 986,36 tok/s przy BS=64 i osiągając szczyt na poziomie 62 247,52 tok/s przy BS=256. Model z dużym obciążeniem wstępnym rozpoczyna się od 3,120.72 tok/s, wzrasta do 48 132,52 tok/s przy BS=32 i 83 968,71 tok/s przy BS=64, osiągając szczyt na poziomie 123 714,50 tok/s przy BS=256 — jest to najwyższa bezwzględna przepustowość wstępna odnotowana dla obu rozmiarów modelu. Prędkość dekodowania wzrasta z 378.20 tok/s przy BS=1 do 32 468,67 tok/s przy BS=256, zapewniając w przybliżeniu 1.6-krotność przepustowości dekodowania 120B przy szczytowej współbieżności, przy jednoczesnym zachowaniu lepszych parametrów opóźnienia.
Instrukcja Qwen3 Coder 30B A3B i instrukcja FP8
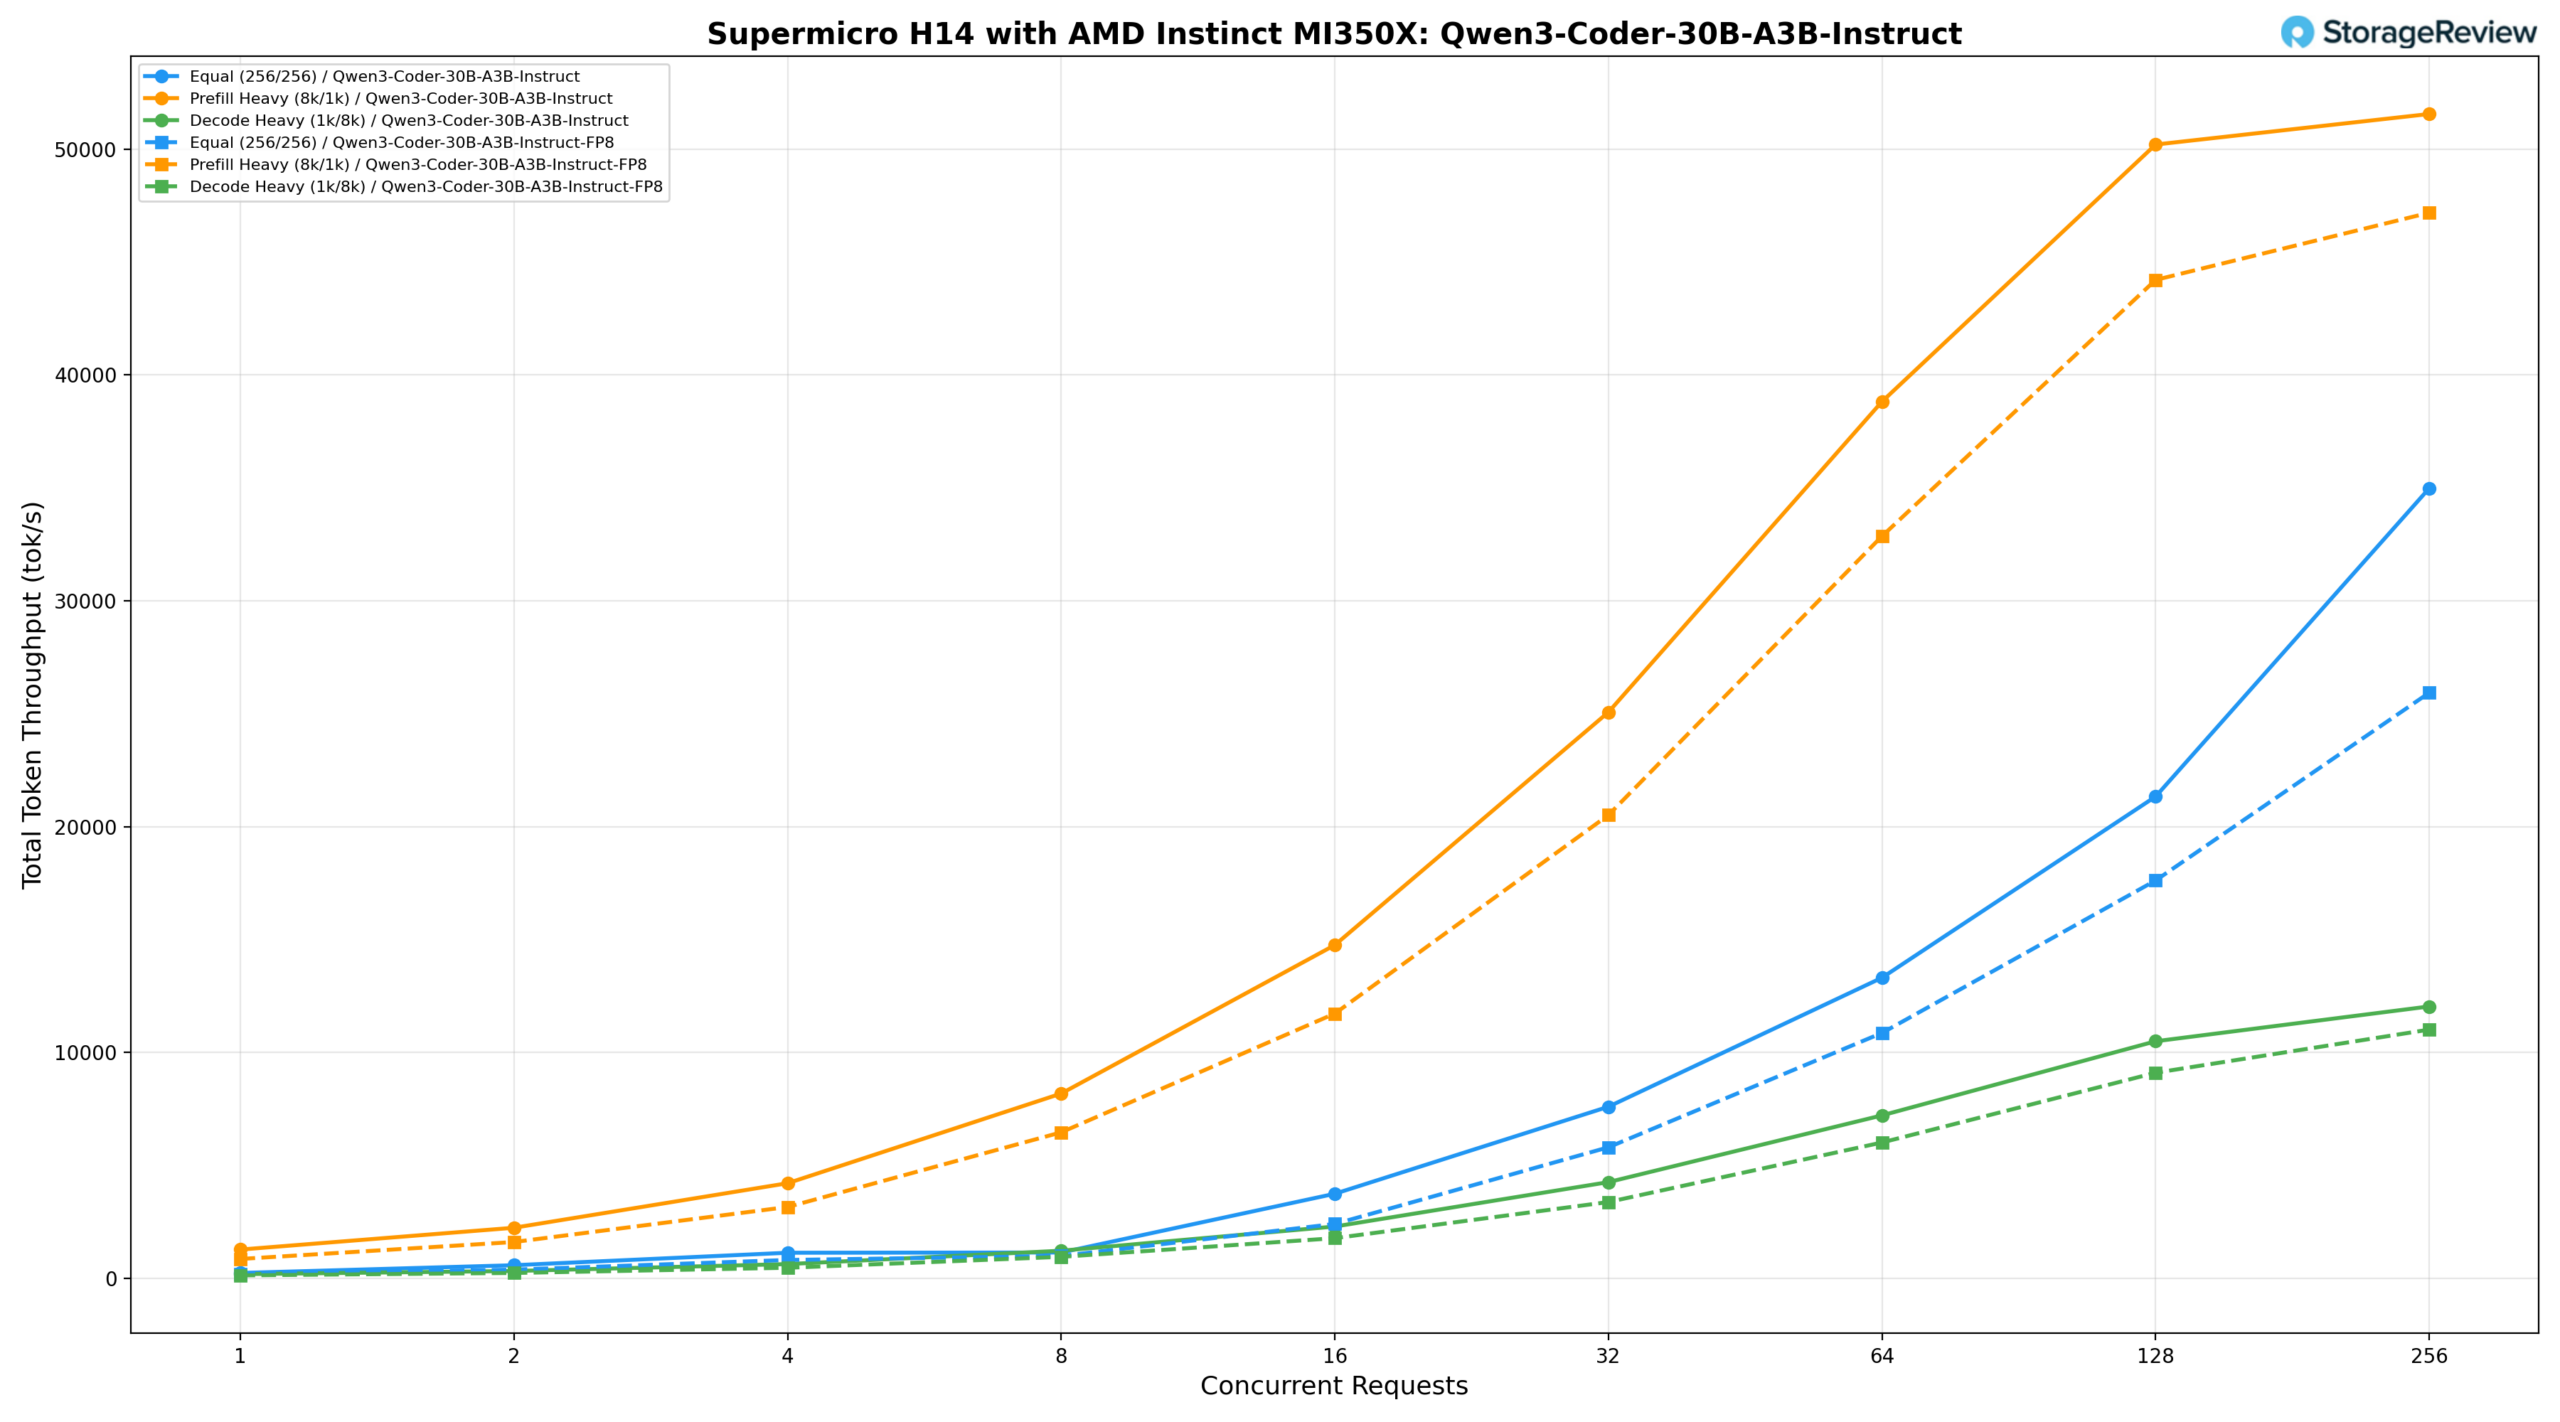
Qwen3-Coder-30B-A3B-Instruct na komputerze Supermicro H14 został przetestowany zarówno przy standardowej precyzji (BF16), jak i FP8.
Qwen3-Coder-30B-A3B-Instruct (BF16)
W BF16, równe obciążenie (256/256) zapewnia 240.53 tok/s przy BS=1, osiągając 13 312,70 tok/s przy BS=64 i 21 333,79 tok/s przy BS=128, ze szczytową przepustowością 34 980,97 tok/s przy BS=256. Obciążenie wstępne (8k/1k) zaczyna się od 1,276.76 tok/s, wzrasta do 25 069,32 tok/s przy BS=32 i 50 198,94 tok/s przy BS=128, osiągając szczyt na poziomie 51 550,66 tok/s przy BS=256. Dekodowanie wymagające dużej ilości danych (1k/8k) stale rośnie z około 188 tok/s przy BS=1 do 11 782 tok/s przy BS=256, zachowując najwęższy profil opóźnienia spośród trzech scenariuszy.
Qwen3-Coder-30B-A3B-Instruct (FP8)
Wariant FP8 osiąga 188.92 tok/s przy BS=1 i takim samym obciążeniu, osiągając 10 866,27 tok/s przy BS=64 i 17 617,60 tok/s przy BS=128, osiągając szczyt na poziomie 25 928,77 tok/s przy BS=256 – nieznacznie poniżej wyników BF16 w całym zakresie. Wariant z dużym obciążeniem wstępnym rozpoczyna się od 860.07 tok/s, wzrasta do 20 513,77 tok/s przy BS=32 i 44 205,46 tok/s przy BS=128, osiągając szczyt na poziomie 47 179,15 tok/s przy BS=256. Szybkość dekodowania wzrasta z 133.79 tok/s przy BS=1 do 11 014,95 tok/s przy BS=256, skalując się spójnie i pozostając blisko BF16.
Mistral Small 3.1 24B Instrukcja 2503
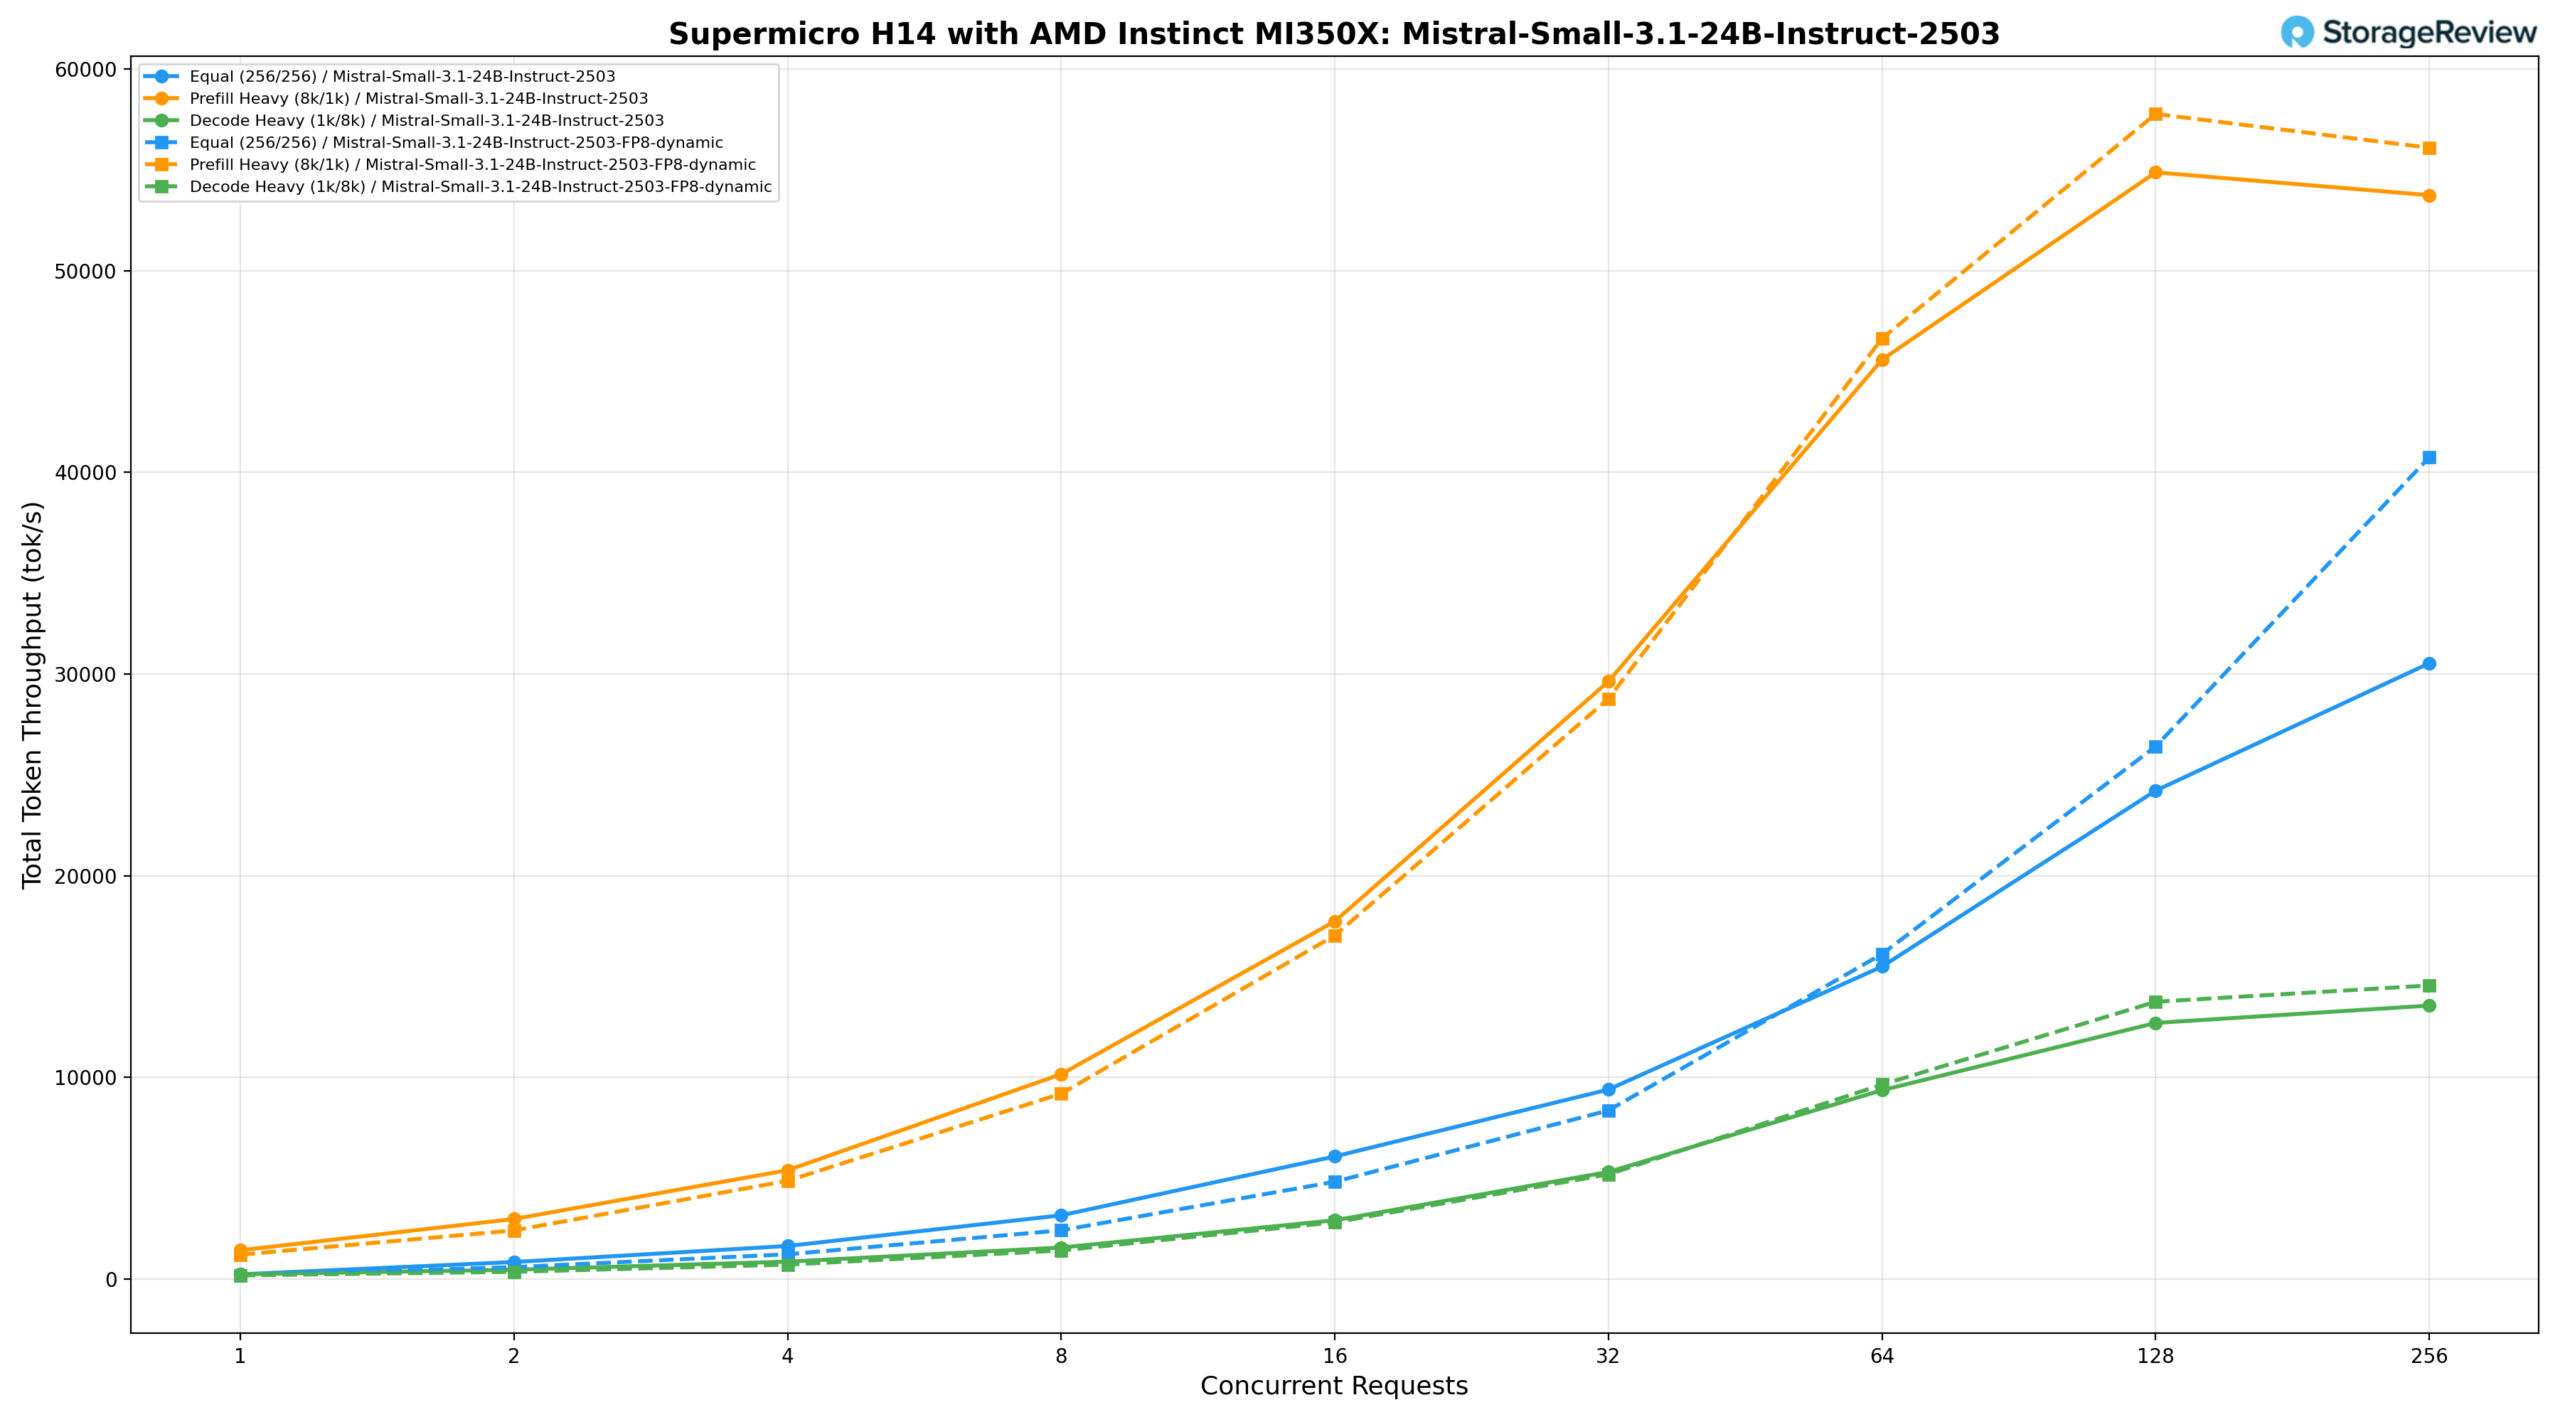
Mistral-Small-3.1-24B-Instruct-2503 na H14 przetestowano zarówno ze standardową, jak i dynamiczną precyzją FP8, wykazując spójne skalowanie we wszystkich trzech profilach obciążenia.
Mistral-Small-3.1-24B-Instruct-2503 (BF16)
Przy precyzji BF16, równe obciążenie (256/256) zapewnia 236.15 tok/s przy BS=1, osiągając 15 494,56 tok/s przy BS=64, 24 216,52 tok/s przy BS=128 i osiągając szczyt na poziomie 30 530,54 tok/s przy BS=256. Obciążenie z dużym obciążeniem wstępnym (8 tys./1 tys.) zaczyna się od 1,429.41 tok/s, wzrasta do 29 631,68 tok/s przy BS=32 i 54 871,74 tok/s przy BS=128, osiągając szczyt na poziomie 53 740,04 tok/s przy BS=256. Prędkość dekodowania (1k/8k) wzrasta z 242.66 tok/s przy BS=1 do 13 559,19 tok/s przy BS=256, przy stałym zwiększeniu szybkości w całym zakresie.
Mistral-Small-3.1-24B-Instruct-2503 (FP8-dynamic)
Wariant dynamiczny FP8 zapewnia 184.25 tok/s przy BS=1 i równym obciążeniu, osiągając 16 113,95 tok/s przy BS=64 i 26 409,01 tok/s przy BS=128, osiągając szczyt na poziomie 40 742,04 tok/s przy BS=256. Wariant z dużym obciążeniem wstępnym rozpoczyna się od 1,210.06 tok/s, wzrasta do 28 773,52 tok/s przy BS=32 i 57 765,02 tok/s przy BS=128, osiągając szczyt na poziomie 56 093,09 tok/s przy BS=256, wyprzedzając standardowy wynik precyzji od BS=64 w górę. Prędkość dekodowania wzrasta z 183.94 tok/s przy BS=1 do 14 557,94 tok/s przy BS=256, utrzymując się blisko środka zakresu, zanim nieznacznie wzrośnie przy BS=128 i BS=256.
Lama 3.1 8B Instruktaż
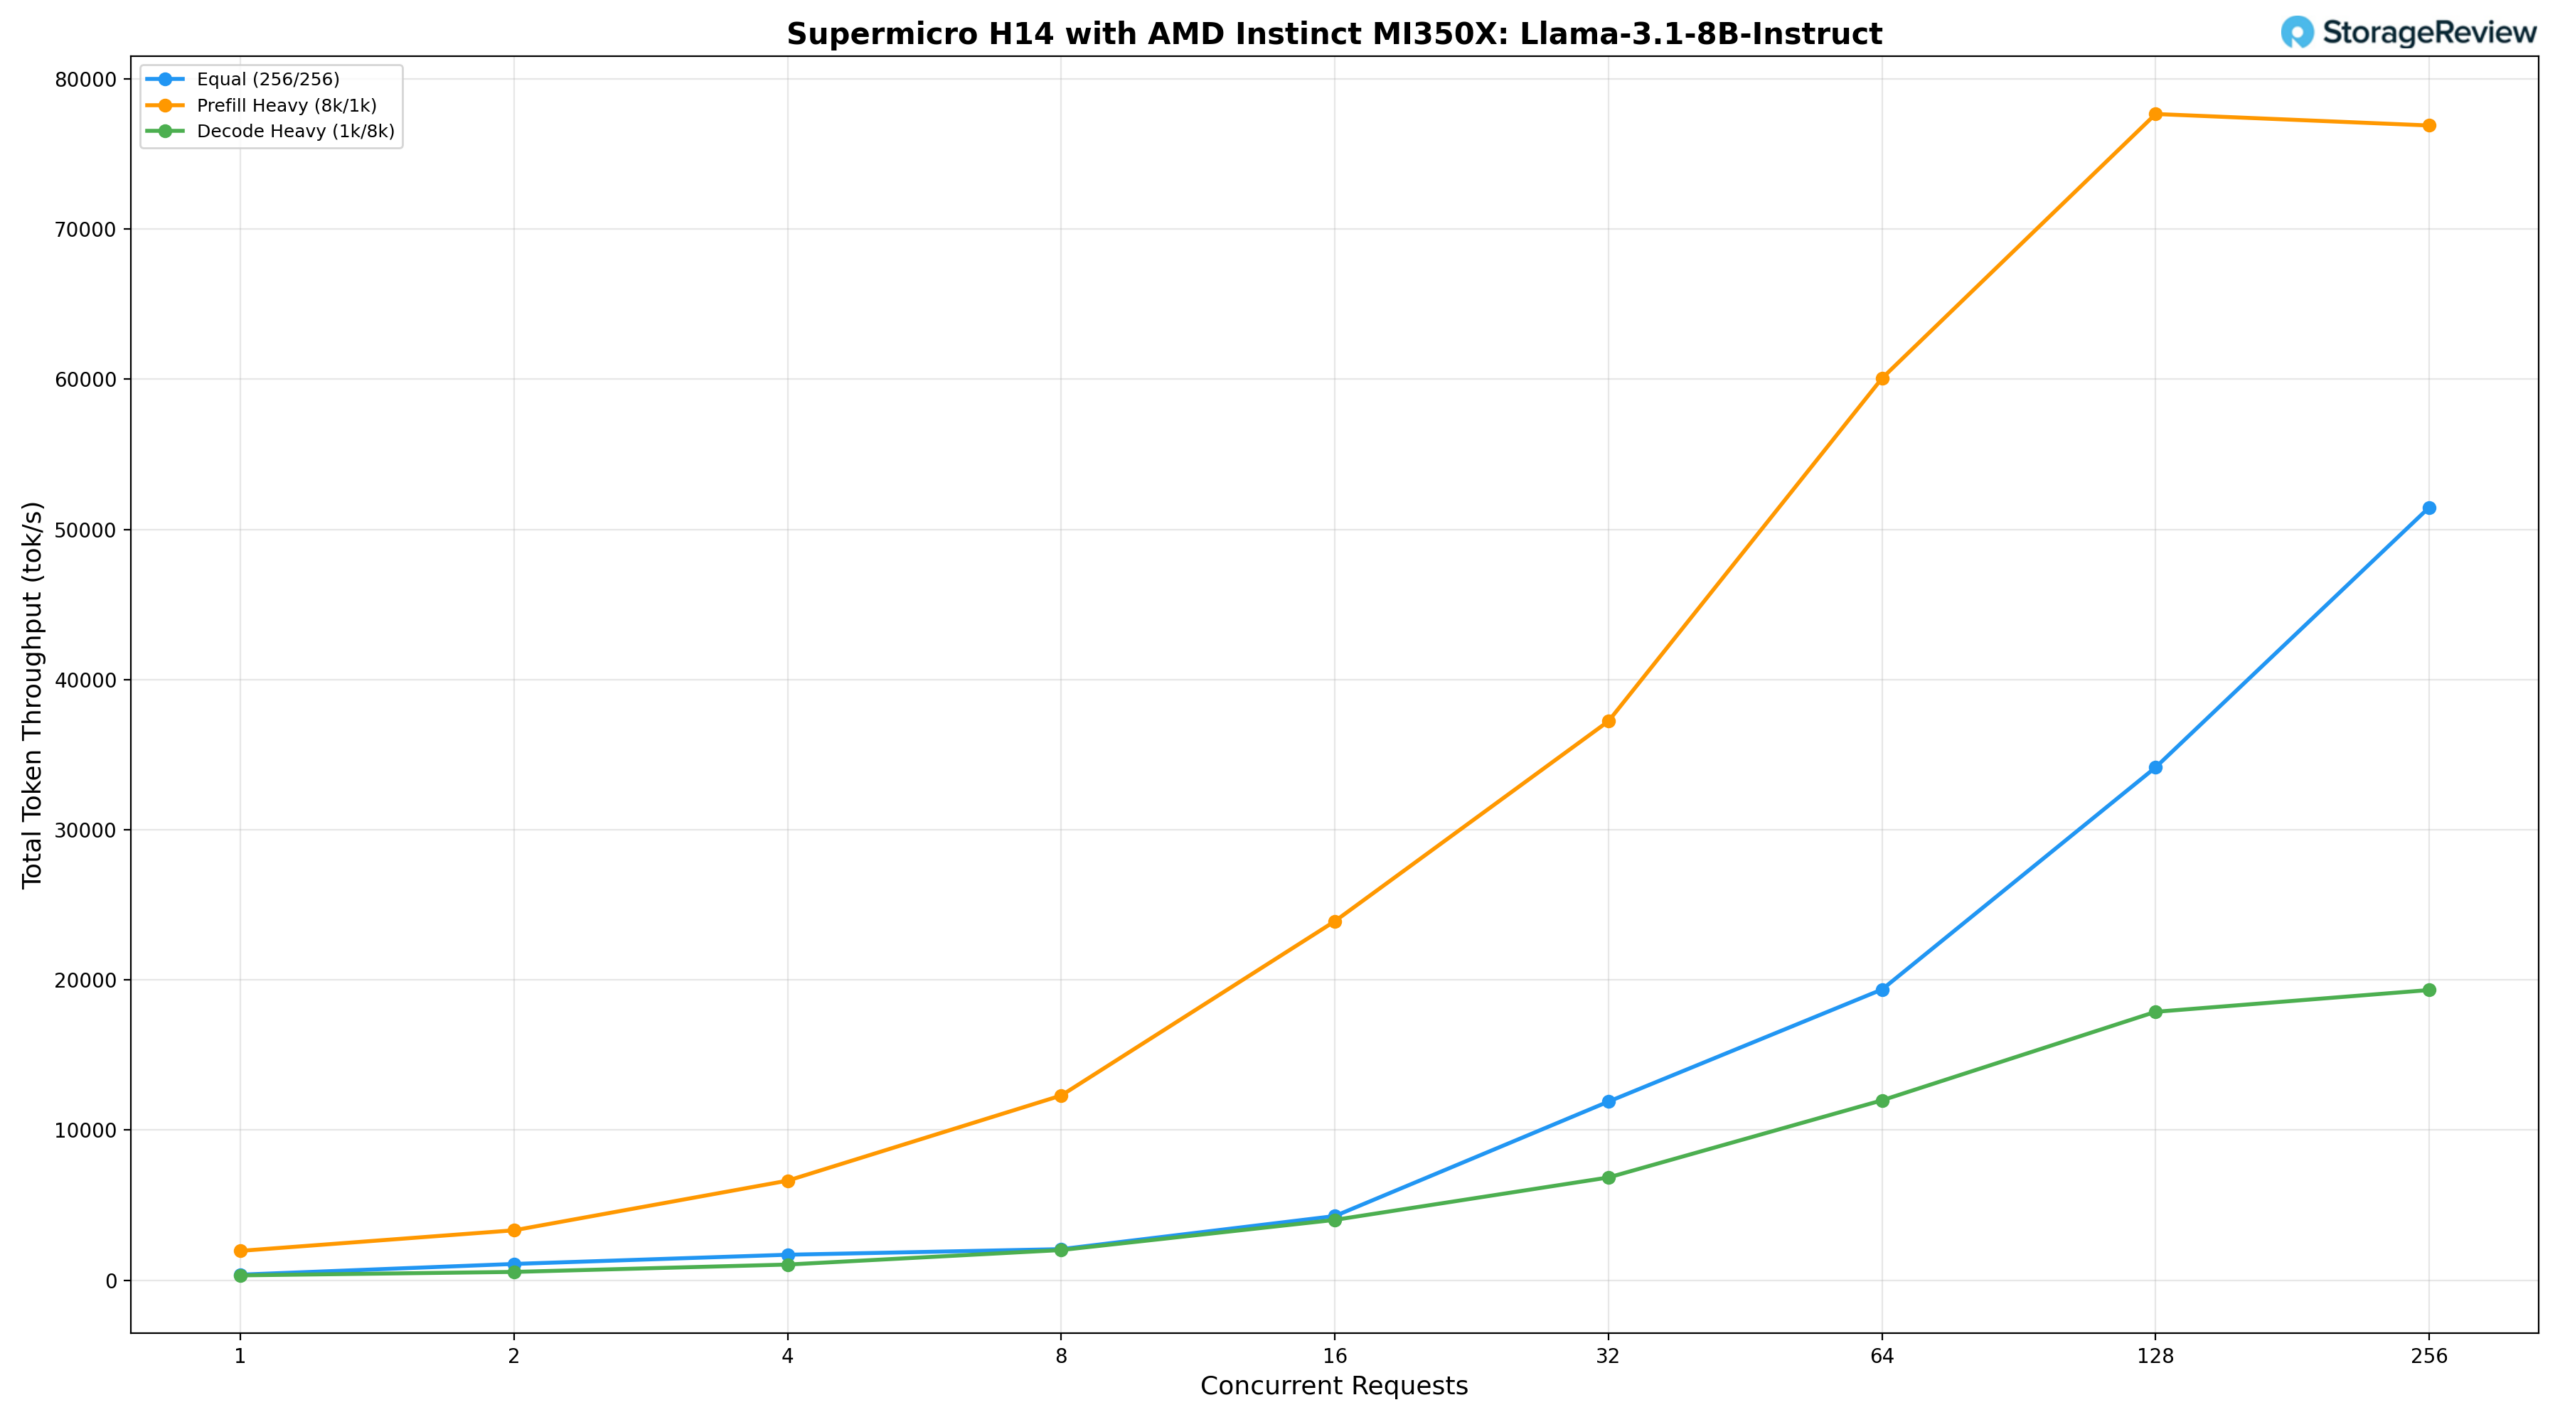
W przypadku Llama-3.1-8B-Instruct zaobserwowaliśmy, że równe obciążenie (256/256) zapewnia 373.26 tok/s przy BS=1, osiągając 19 363,33 tok/s przy BS=64, 34 155,70 tok/s przy BS=128 i osiągając szczyt na poziomie 51 467,30 tok/s przy BS=256. Model z dużym obciążeniem wstępnym (8k/1k) zaczyna się od 1,959.04 tok/s, wzrasta do 37 227,63 tok/s przy BS=32 i 60 062,40 tok/s przy BS=64, osiągając szczyt na poziomie 77 658,50 tok/s przy BS=128, a następnie nieznacznie spadając do 76 893,77 tok/s przy BS=256. Model z dużym obciążeniem dekodowania (1k/8k) zaczyna się od 326.48 tok/s, osiągając 17 877,52 tok/s przy BS=128 i 19 326,35 tok/s przy BS=256, utrzymując niższe opóźnienie na token w dalszym zakresie współbieżności niż którykolwiek z większych testowanych modeli.
MiniMax M2.5
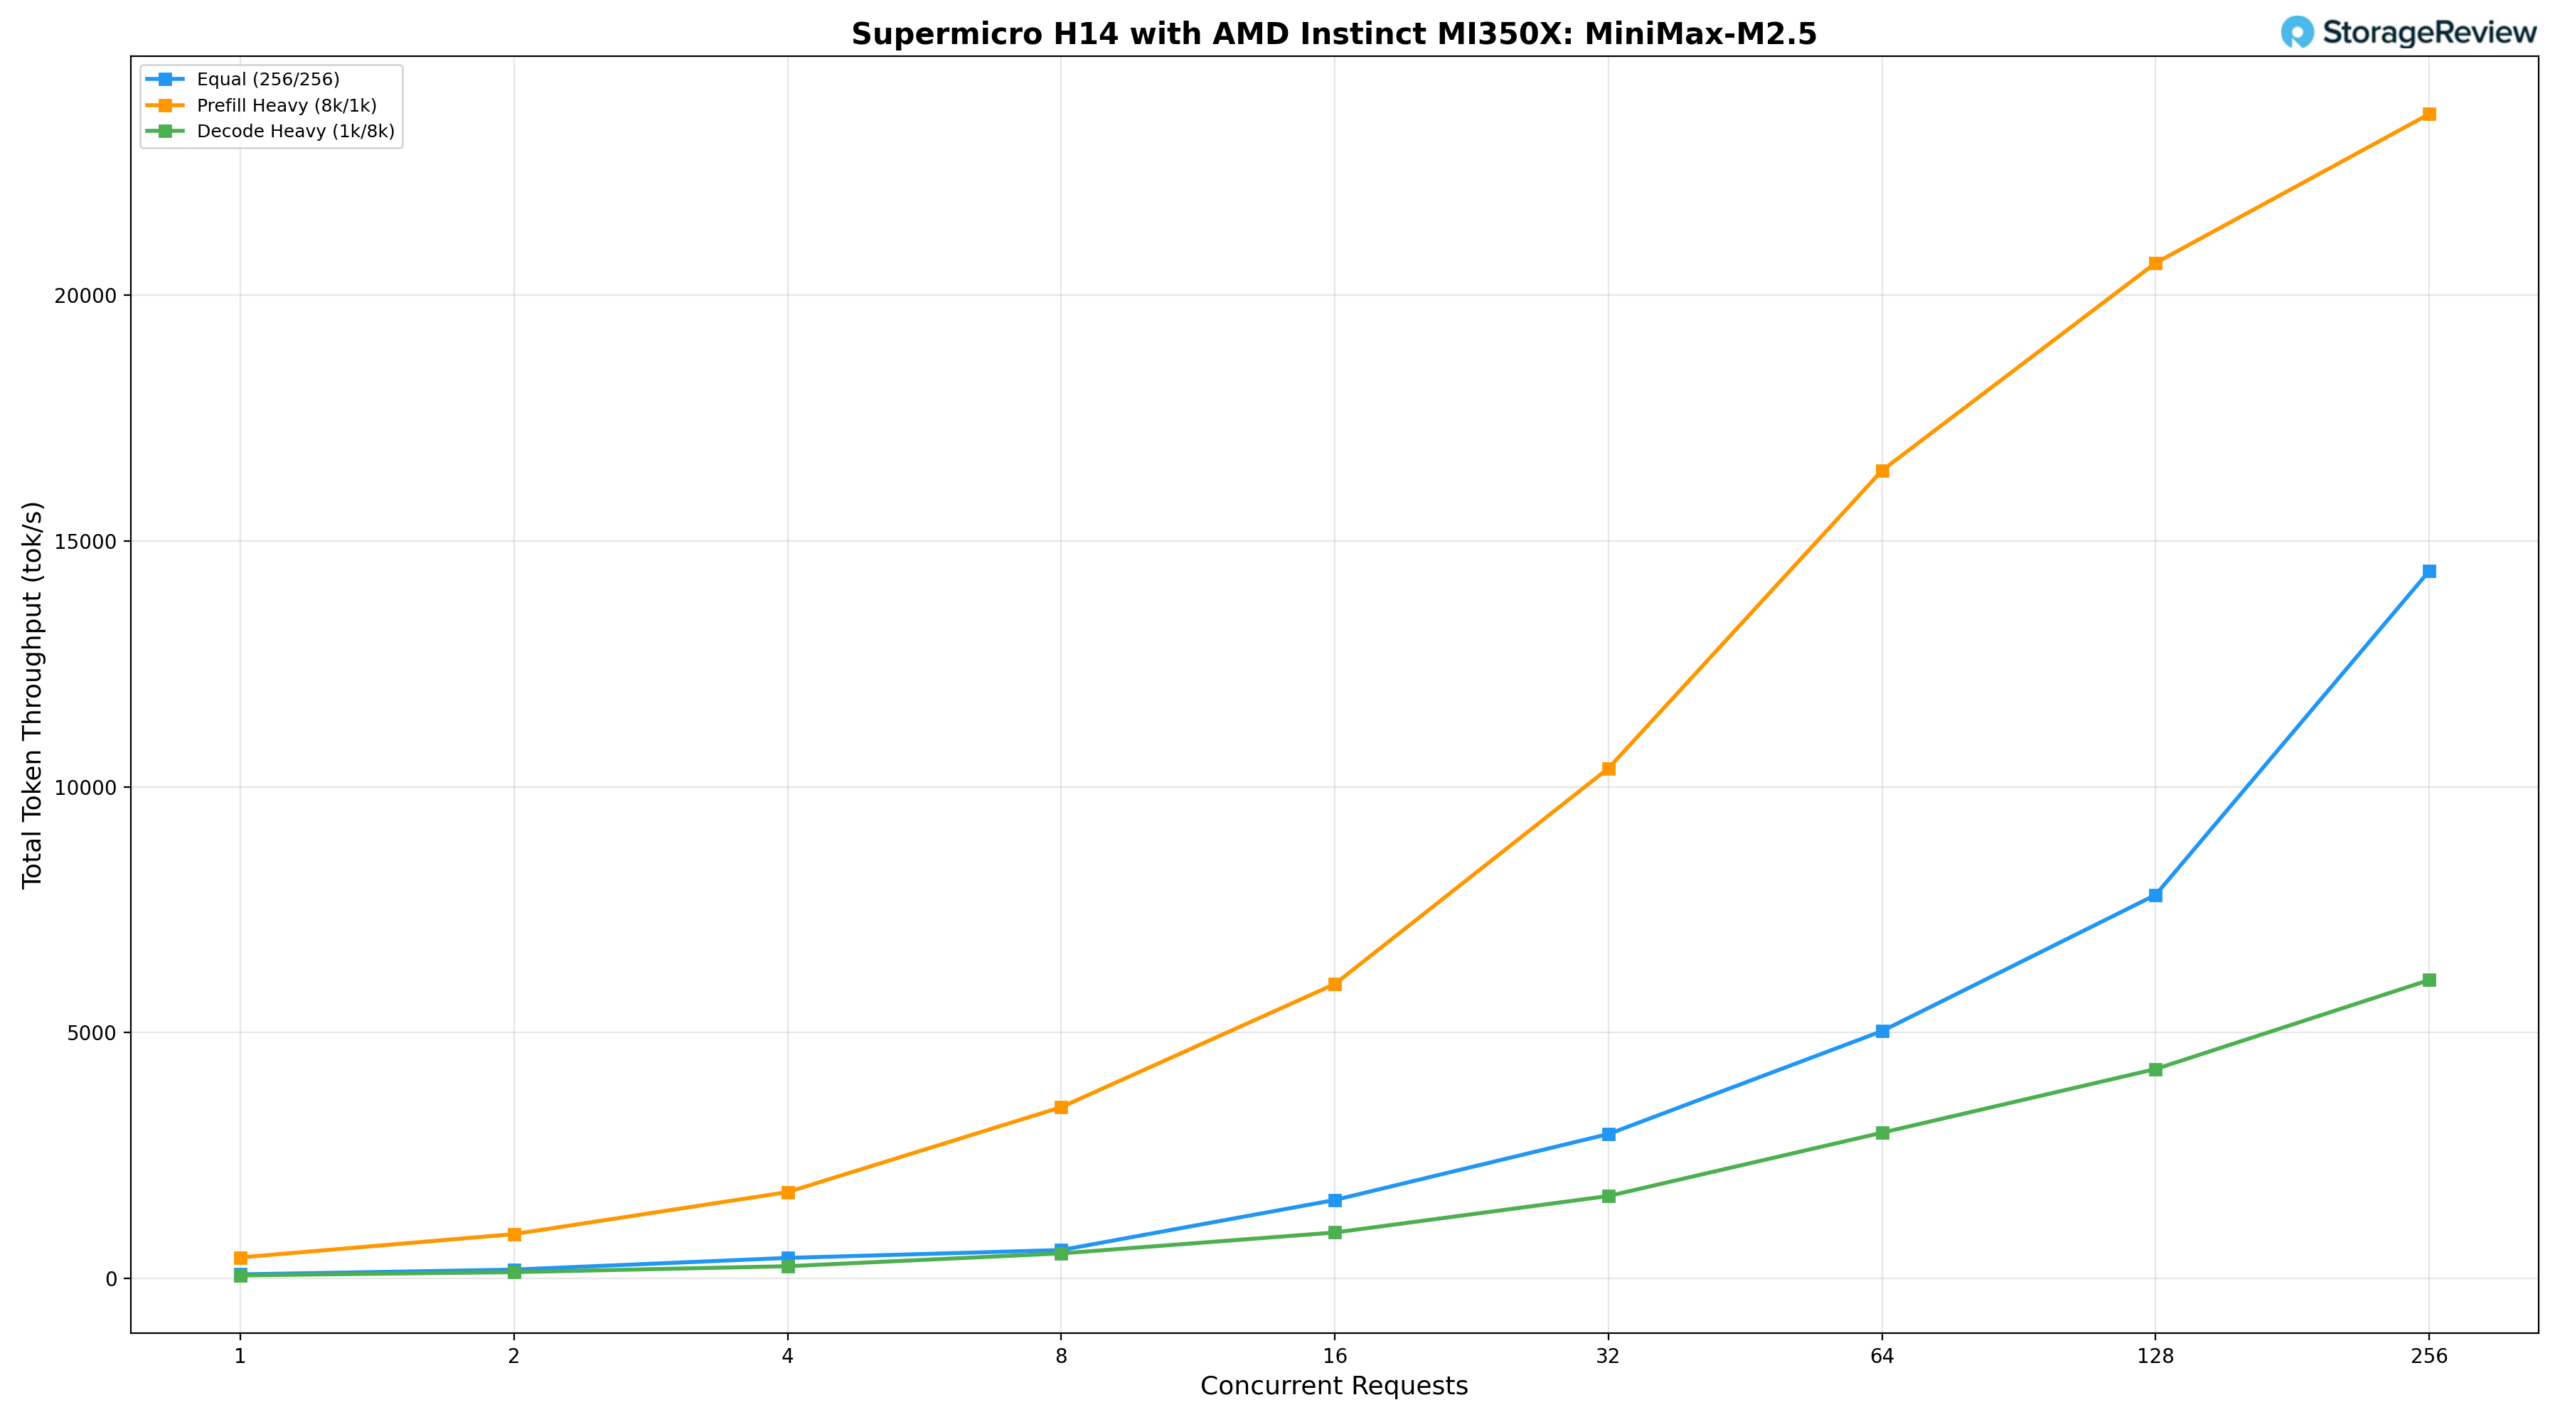
Model MiniMax-M2.5 na H14 uzupełnia gamę modeli, plasując się pomiędzy Kimi K2.5 a modelami średniej wielkości pod względem profilu przepustowości, z cechami odzwierciedlającymi jego architekturę mieszaną z architekturą ekspertów. Równe obciążenie (256/256) zapewnia 79.31 tok/s przy BS=1, osiągając 5,029.76 tok/s przy BS=64, 7,801.10 tok/s przy BS=128 i 14,391.98 tok/s przy BS=256. Scenariusz z intensywnym wypełnianiem (8k/1k) charakteryzuje się najsilniejszym skalowaniem spośród trzech scenariuszy, zaczynając od 424.41 tok/s i rosnąc do 10 376,75 tok/s przy BS=32 i 20 658,57 tok/s przy BS=128, osiągając szczyt na poziomie 23 689,18 tok/s przy BS=256. Scenariusz z intensywnym dekodowaniem (1k/8k) skaluje się stabilnie do 4,257.68 tok/s przy BS=128 i 6,068.70 tok/s przy BS=256, oferując najbardziej spójny wzrost opóźnień w całym zakresie współbieżności.
Kimi K2.5
Model Kimi K2.5 z 1 bilionem parametrów na komputerze H14 jest największym i najinteligentniejszym modelem przetestowanym w tym przeglądzie, a jego przepustowość odzwierciedla tę wagę.
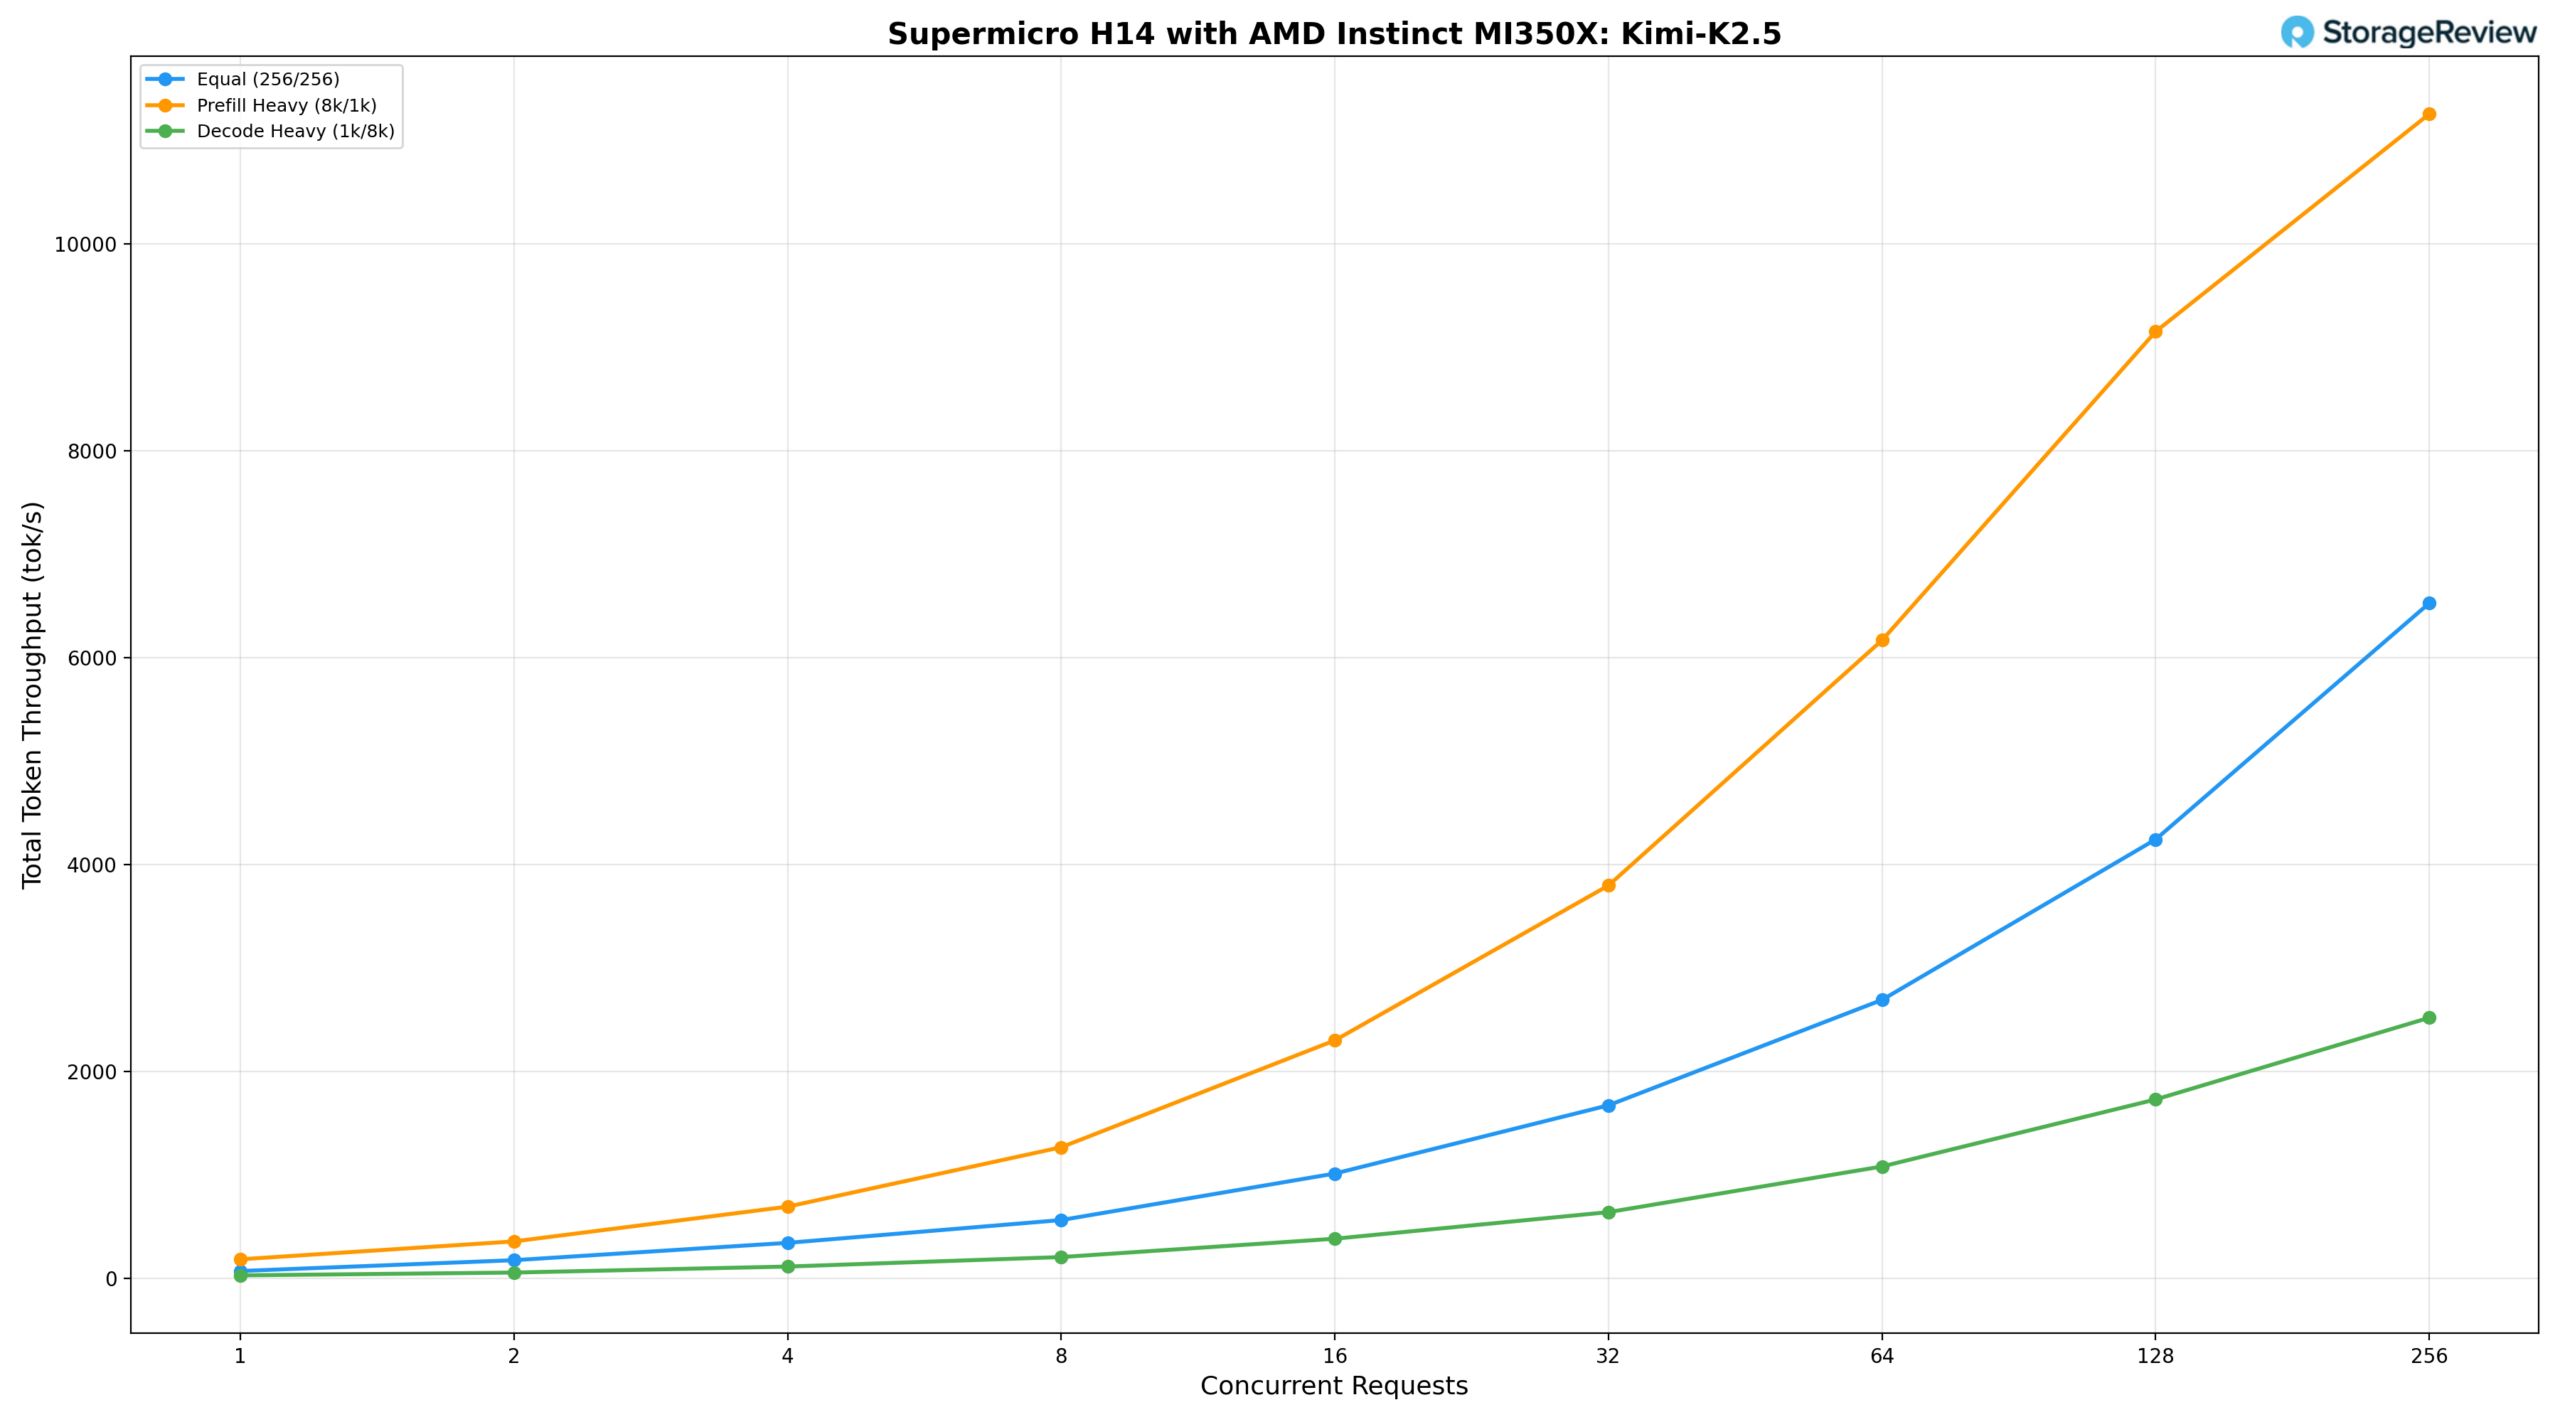
Równe obciążenie (256/256) zapewnia 72.06 tok/s przy BS=1, osiągając 2,693.07 tok/s przy BS=64, 4,244.27 tok/s przy BS=128 i osiągając szczyt na poziomie 6,527.62 tok/s przy BS=256. Obciążenie prefill (8 tys./1 tys.) skaluje się bardziej agresywnie, zaczynając od 185.29 tok/s i osiągając 3,798.85 tok/s przy BS=32 i 9,153.12 tok/s przy BS=128, ze szczytową przepustowością 11 256,69 tok/s przy BS=256. Wzrost skoku z BS=128 do BS=256 niesie ze sobą znaczny koszt opóźnienia, co wskazuje, że system zbliża się do limitu pamięci i mocy obliczeniowej przy pełnej głębokości wsadu dla tego rozmiaru modelu. Dekodowanie z dużą ilością danych (1 tys./8 tys.) rośnie z 29.88 tok/s przy BS=1 do 2,513.85 tok/s przy BS=256, zapewniając najwęższą krzywą skalowania spośród trzech scenariuszy, jednocześnie wykazując stały wzrost przepustowości w całym zakresie.
Wniosek
Procesor AMD Instinct MI350X zapewnia bardzo konkurencyjną wydajność wnioskowania w testowanych profilach obciążeń, a Supermicro AS-8126GS-TNMR to dobrze zaprojektowana platforma, która pozwala na jej pełne wykorzystanie. Dzięki 288 GB pamięci HBM3e na akcelerator i ośmiu procesorom graficznym połączonym przez Infinity Fabric, łączna pamięć GPU o pojemności 2.3 TB dostępna w jednym węźle wystarcza do obsługi modeli o bilionach parametrów, takich jak Kimi K2.5 i MiniMax M2.5, bez konieczności stosowania obejść dystrybucji wielowęzłowej lub partycjonowania modeli. Ta możliwość znacząco upraszcza architekturę wdrożeniową dla wnioskowania na dużą skalę.
Mniejsze modele również przyniosły dobre wyniki. Llama 3.1 8B przekroczyła 77 000 tok/s przy obciążeniach wymagających prefill, a architektury średniej klasy, takie jak Mistral Small 3.1 24B i Qwen3 Coder 30B, utrzymały wysoką przepustowość z dobrze kontrolowanymi opóźnieniami w całym zakresie współbieżności. Ogólnie rzecz biorąc, wyniki wskazują na platformę sprzętową, która skaluje się przewidywalnie pod obciążeniem, a nie spada gwałtownie przy większych głębokościach przetwarzania wsadowego.
ROCm 7.2 wprowadza znaczące ulepszenia w stosie oprogramowania wnioskowania AMD, szczególnie w połączeniu z vLLM 0.18. To połączenie zapewnia zauważalnie bardziej stabilne i wydajne działanie niż poprzednie generacje ROCm, z szerszym wsparciem frameworka i mniejszą liczbą niedociągnięć, które charakteryzowały wcześniejsze wdrożenia Instinct. Warto również zwrócić uwagę na dynamikę ekosystemu wokół sprzętu AMD: upstream vLLM utrzymuje teraz dedykowany potok CI AMD ROCm, a zaangażowanie Meta we wdrożenia wielogeneracyjne w skali 6 gigawatów potwierdza, że walidacja produkcyjna wykracza daleko poza kontrolowane środowiska testowe.
Ocena obsługi kodu Claude'a dodaje praktyczną perspektywę do surowych danych o przepustowości. Pojedynczy węzeł MI350X utrzymywał prędkość reakcji zbliżoną do chmury dla maksymalnie 16 jednoczesnych sesji kodowania i pozostawał interaktywny z maksymalnie 64 użytkownikami jednocześnie, generując jednocześnie prawie 1,000 tok/s łącznych danych wyjściowych. Dla organizacji, które porównują koszty komercyjnych subskrypcji API z infrastrukturą hostowaną we własnym zakresie, ekonomia staje się oczywista przy takiej gęstości, z dodatkowymi zaletami w postaci lokalizacji danych, eliminacji kosztów per token i nieograniczonego wyboru modelu.
Program JumpStart firmy Supermicro stale umacnia swoją pozycję w procesie oceny infrastruktury. Dostęp do sprzętu produkcyjnego bez konieczności przygotowania, bez dodatkowych kosztów, pozwolił nam na uruchamianie rzeczywistych obciążeń w rzeczywistych warunkach przez cały okres testów. Dla zespołów przeprowadzających ocenę zakupu akceleratorów, ten poziom praktycznego dostępu pozostaje o wiele bardziej pouczający niż porównania specyfikacji technicznych czy starannie dobrane prezentacje dostawców.



 Amazon