

Program JumpStart firmy Supermicro prezentuje zupełnie inne podejście do oceny sprzętu. Zamiast krótkiej, opartej na scenariuszu demonstracji we współdzielonym środowisku laboratoryjnym, JumpStart oferuje wykwalifikowanym klientom bezpłatny, ograniczony czasowo, dostęp do katalogu rzeczywistych serwerów produkcyjnych. Od nowych platform X14 z procesorami Intel Xeon 6 po systemy H14 z procesorami AMD EPYC 5. generacji i rozbudowanymi konfiguracjami GPU HGX, klienci rezerwują systemy, logują się zdalnie i uruchamiają własne obciążenia, tak jakby sprzęt znajdował się we własnej szafie.
Wartość biznesowa staje się oczywista, gdy podejmuje się szybkie i świadome decyzje dotyczące platformy. Przygotowanie realistycznego proof of concept dla sztucznej inteligencji (AI) lub obliczeń o wysokiej wydajności (HPC) zazwyczaj oznacza oczekiwanie na sprzęt ewaluacyjny, koordynację z wieloma dostawcami i liczenie na to, że konfiguracja testowa jest wystarczająco zbliżona do planowanego wdrożenia. JumpStart eliminuje te trudności. Zespoły mogą weryfikować wydajność, sprawdzać kompatybilność oprogramowania, analizować zużycie energii i parametry termiczne oraz porównywać architektury bez marnowania czasu na wewnętrzne laboratoria lub wysyłania palety serwerów przez cały kraj. Dla większości organizacji tydzień skupienia się na prawidłowej konfiguracji wystarczy, aby potwierdzić, że platforma spełnia ich potrzeby lub wykluczyć ją, zanim stanie się zobowiązaniem.
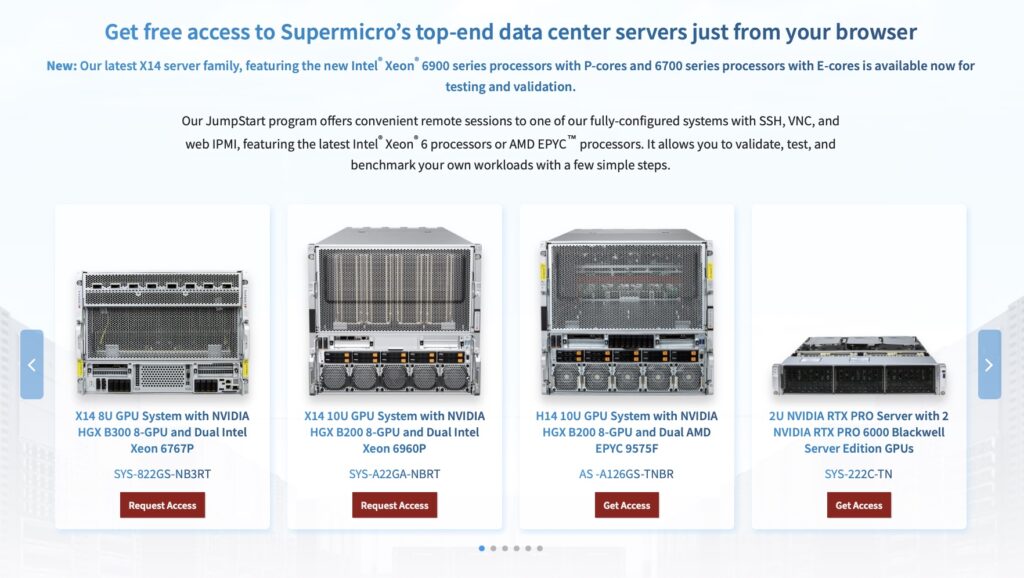
Strona startowa Supermicro JumpStart
Tym, co czyni JumpStart szczególnie atrakcyjnym, jest nie tylko liczba systemów online, ale także głębia technologii, którą Supermicro jest gotowe ujawnić. Popularne wybory obejmują serwery GPU X14 z procesorami Intel Xeon 6 i akceleratorami NVIDIA, platformy H14 zoptymalizowane pod kątem gęstych obliczeń CPU z procesorami AMD EPYC 5. generacji oraz systemy skoncentrowane na pamięci masowej, łączące nowoczesne procesory z wszystkimi back-endami NVMe. W segmencie high-end, Supermicro oferuje już dostęp do systemów HGX klasy B200 i B300 do szkolenia i wnioskowania AI, a JumpStart umożliwia wczesne, oparte na porozumieniu o poufności, spojrzenie na platformy nowej generacji, które nie są jeszcze powszechnie dostępne. Nie widzieliśmy żadnego innego producenta OEM tak agresywnie podchodzącego do przekształcania infrastruktury przed GA w ustrukturyzowane, powtarzalne środowisko zdalnego laboratorium.
Większość środowisk demonstracyjnych dostawców ogranicza się do laboratoriów rozwiązań z przewodnikiem lub wąskich środowisk testowych produktów. Są one przydatne do nauki narzędzi do zarządzania i procesów orkiestracji, ale rzadko zapewniają dostęp root do serwera najwyższej klasy lub swobodę instalacji i uruchomienia własnego stosu. JumpStart działa bardziej jak szafa rack w zdalnym centrum danych. Rezerwując konkretny system, otrzymujesz pełną kontrolę poprzez SSH, VNC i IPMI na czas trwania rezerwacji, a Supermicro czyści i odbudowuje środowisko przed kolejnym klientem. W praktyce przypomina to mniej demonstrację marketingową, a bardziej krótkie, ukierunkowane spotkanie w dobrze zarządzanym zdalnym laboratorium.
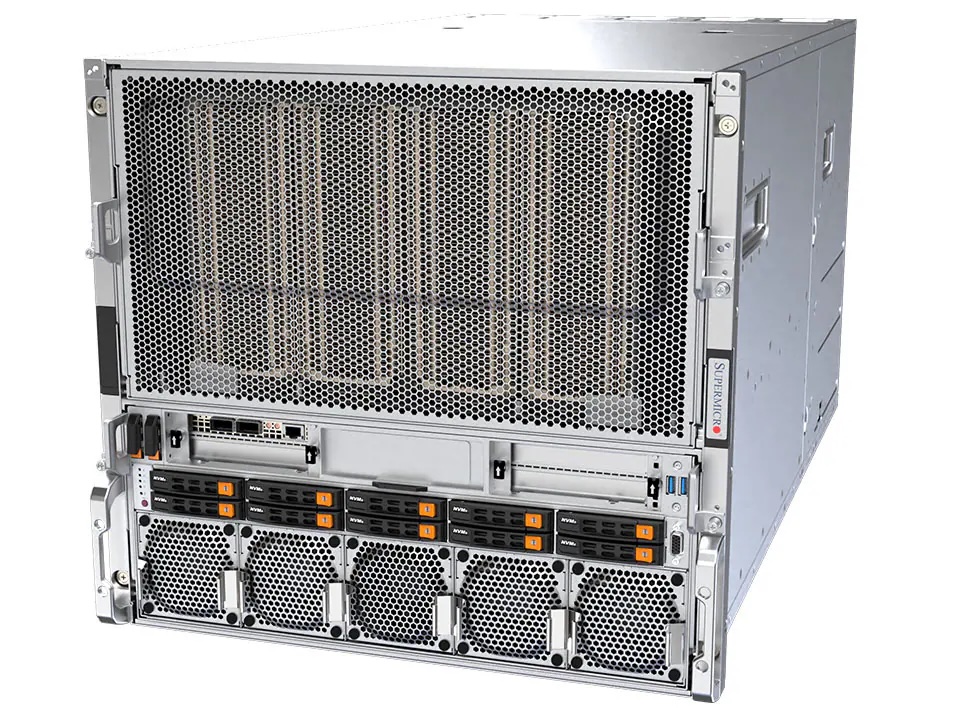
System Supermicro JumpStart X14 B200
Na potrzeby tej analizy firma Supermicro udostępniła StorageReview dostęp do JumpStart dokładnie tak, jak korzystałby z niego klient. Zaplanowaliśmy czas na systemie z GPU X14 10U , wyposażonym w płytę główną NVIDIA HGX B200 8-GPU i dwa procesory Intel Xeon Platinum 6960P 6. generacji. Serwer został skonfigurowany z 3 TB pamięci DDR5-6400 ECC, dyskami SSD M.2 i U.2 NVMe do przechowywania danych lokalnych oraz ośmioma procesorami GPU B200, każdy ze 180 GB pamięci HBM3e. W ciągu tygodnia wykorzystaliśmy tę platformę do wyrywkowej kontroli obciążeń AI i zachowania systemu, koncentrując się na pytaniach, na które prawdziwi nabywcy chcą uzyskać odpowiedź przed podjęciem decyzji o zakupie infrastruktury nowej generacji.
Nasz tydzień w programie Supermicro JumpStart
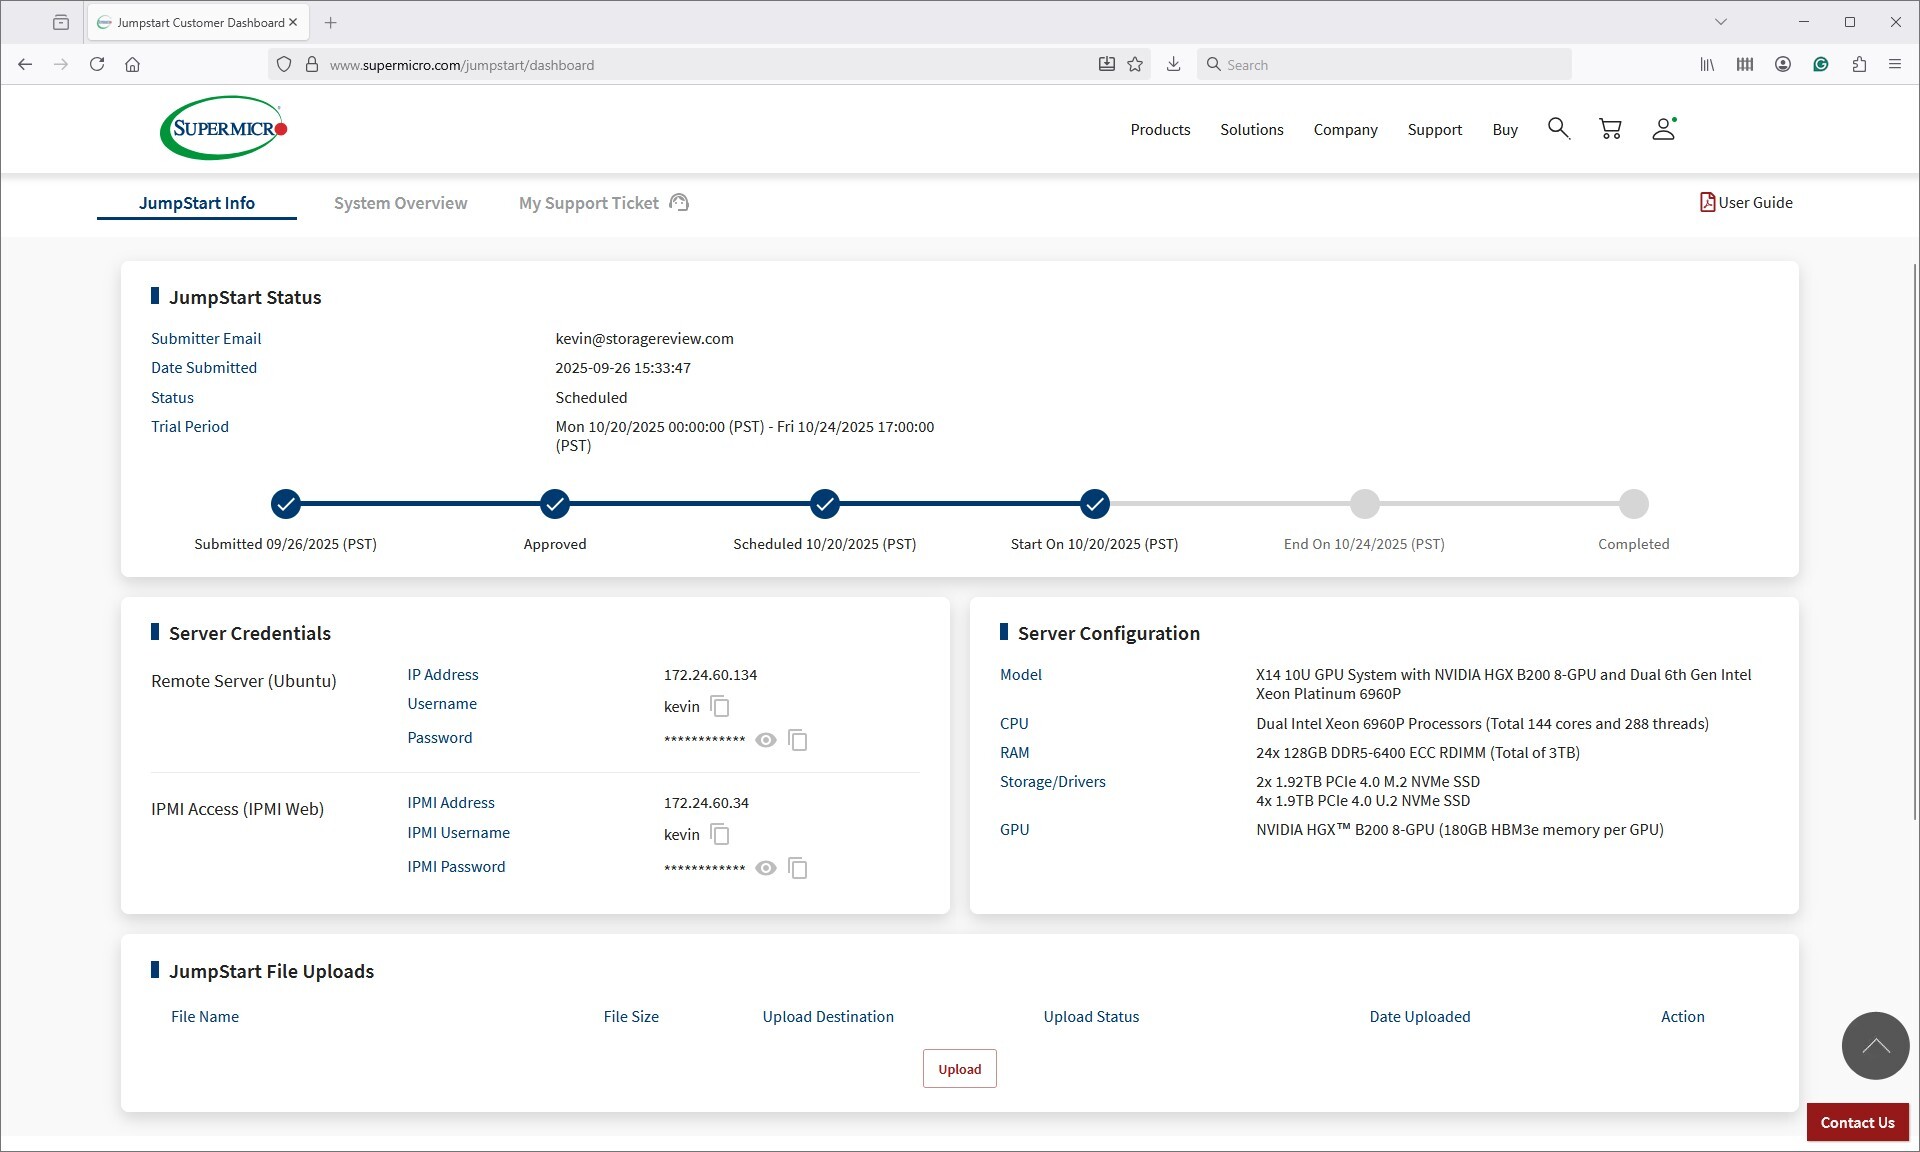
Po otwarciu okna rezerwacji portal JumpStart stał się centralnym punktem naszych testów. Początkowy panel, pokazany poniżej, przedstawiał harmonogram rezerwacji i zawierał wszystko, co potrzebne do rozpoczęcia pracy, w tym dane uwierzytelniające SSH dla zdalnego środowiska Ubuntu oraz pełny dostęp do IPMI. Natychmiastowa dostępność obu interfejsów oznaczała, że mogliśmy rozpocząć walidację systemu w ciągu kilku minut, bez konieczności czekania na provisioning lub interwencję wsparcia.
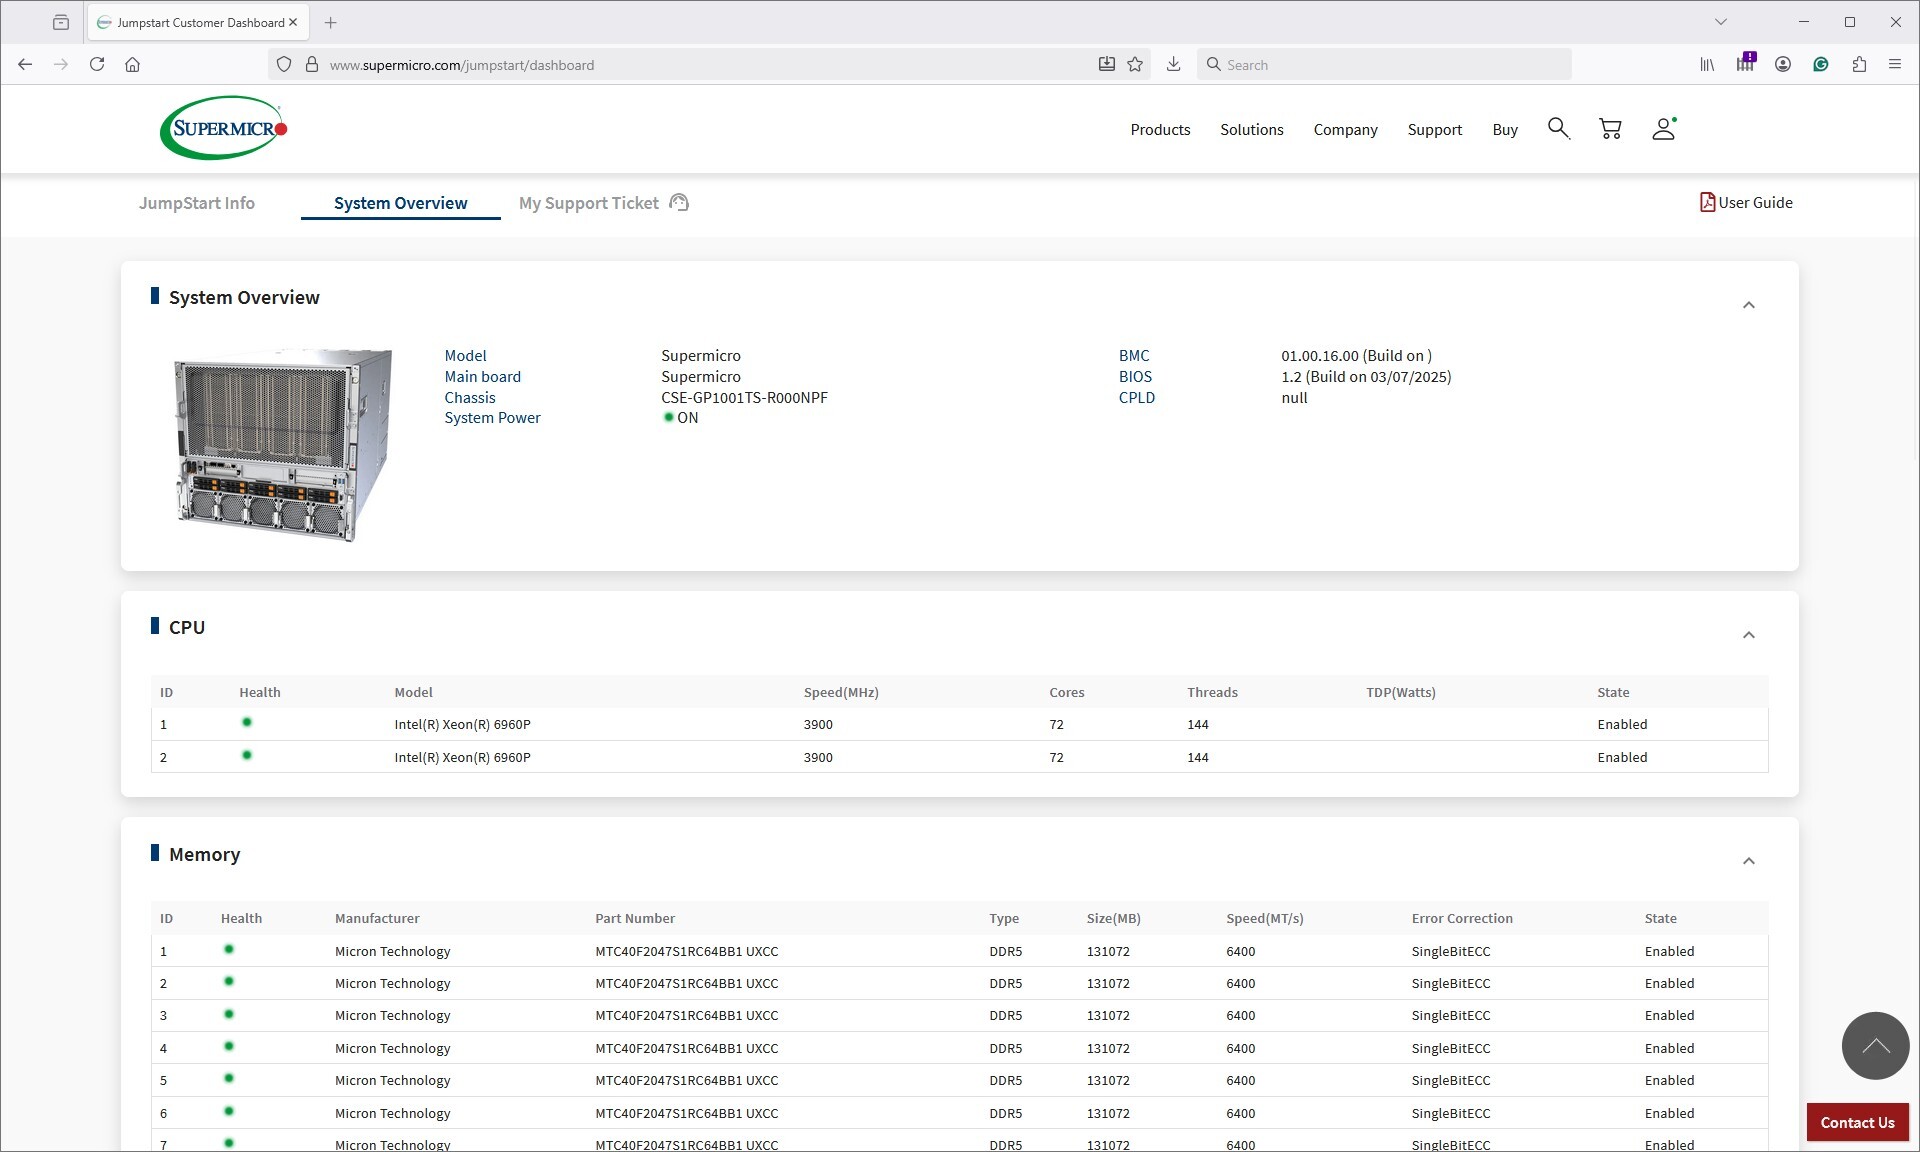
Pierwszym krokiem w naszym procesie pracy było potwierdzenie gotowości sprzętu. Korzystając ze strony „Przegląd systemu” w portalu (patrz zrzut ekranu poniżej), sprawdziliśmy, czy obudowa jest włączona, czy oba procesory zostały wykryte, czy pamięć jest w pełni zapełniona, a kontroler BMC zgłasza stan systemu w dobrym stanie. Ta szybka kontrola stała się standardową praktyką w naszych ewaluacjach laboratoryjnych, a zdalny wgląd w dane za pośrednictwem portalu usprawnił ten proces.
Po walidacji systemu przeszliśmy do pracy praktycznej. Przesyłanie plików dla zasobów testowych odbywało się bezpośrednio przez interfejs JumpStart, co wyeliminowało typowe trudności związane z przechowywaniem zestawów danych na platformie zdalnej. Stamtąd łączyliśmy się przez SSH w celu wdrożenia obciążenia i korzystaliśmy ze zdalnej konsoli za pośrednictwem IPMI, gdy potrzebowaliśmy dostępu niskiego poziomu lub aby obserwować zachowanie systemu podczas rozruchu.
Przepływ pracy przez cały tydzień był bardzo zbliżony do obsługi sprzętu w naszym własnym laboratorium. Mogliśmy szybko uruchamiać, zatrzymywać i iterować obciążenia, restartować platformę w razie potrzeby oraz monitorować działanie sprzętu bez angażowania wsparcia Supermicro. Połączenie dostępu na poziomie systemu operacyjnego i pełnej kontroli poza pasmem sprawiło, że środowisko było przewidywalne i wydajne w krótkich cyklach testowych.
Po zakończeniu rezerwacji system został automatycznie odzyskany i zresetowany, co pozwoliło na czyste zamknięcie zlecenia. Ta przewidywalna struktura pozwoliła nam skupić się na testach, a nie na logistyce, i zapewniła pełne wykorzystanie ograniczonego okna dostępu.
Wydajność pamięci masowej GPUDirect
Jednym z testów, jakie przeprowadziliśmy na platformie Supermicro X14, był test Magnum IO GPUDirect Storage (GDS). GDS to funkcja opracowana przez firmę NVIDIA, która pozwala procesorom graficznym ominąć procesor główny (CPU) podczas uzyskiwania dostępu do danych przechowywanych na dyskach NVMe lub innych szybkich urządzeniach pamięci masowej. Zamiast kierować dane przez procesor i pamięć systemową, GDS umożliwia bezpośrednią komunikację między procesorem graficznym a urządzeniem pamięci masowej, znacznie redukując opóźnienia i poprawiając przepustowość danych.
Jak działa pamięć masowa GPUDirect
Tradycyjnie, gdy procesor graficzny (GPU) przetwarza dane przechowywane na dysku NVMe, dane muszą najpierw przejść przez procesor i pamięć systemową, zanim dotrą do procesora graficznego. Ten proces wprowadza wąskie gardła, ponieważ procesor staje się pośrednikiem, zwiększając opóźnienia i zużywając cenne zasoby systemowe. Technologia GPUDirect Storage eliminuje ten problem, umożliwiając procesorowi graficznemu bezpośredni dostęp do danych z urządzenia pamięci masowej za pośrednictwem magistrali PCIe. Ta bezpośrednia ścieżka zmniejsza obciążenie związane z przesyłaniem danych, umożliwiając szybsze i bardziej wydajne przesyłanie danych.
Obciążenia AI, zwłaszcza te wykorzystujące uczenie głębokie, charakteryzują się wysoką intensywnością przetwarzania danych. Trenowanie dużych sieci neuronowych wymaga przetwarzania terabajtów danych, a każde opóźnienie w transferze danych może prowadzić do niewykorzystania procesorów GPU i wydłużenia czasu trenowania. Rozwiązanie GPUDirect Storage rozwiązuje ten problem, zapewniając jak najszybsze dostarczanie danych do procesora GPU, minimalizując czas przestoju i maksymalizując wydajność obliczeniową.
Ponadto GDS jest szczególnie przydatny w przypadku obciążeń wymagających strumieniowego przesyłania dużych zbiorów danych, takich jak przetwarzanie wideo, przetwarzanie języka naturalnego czy wnioskowanie w czasie rzeczywistym. Zmniejszając zależność od procesora, GDS przyspiesza przesyłanie danych i uwalnia zasoby procesora do innych zadań, co dodatkowo zwiększa ogólną wydajność systemu.
Oprócz surowej przepustowości, GPUDirect z NVMe-oF (TCP/RDMA) zapewnia również ultraniskie opóźnienia wejścia/wyjścia. Dzięki temu GPU nigdy nie będą miały niedoboru danych, co czyni system idealnym do wnioskowania AI w czasie rzeczywistym, tworzenia potoków analitycznych i odtwarzania wideo.
Przepustowość sekwencyjna odczytu GDSIO
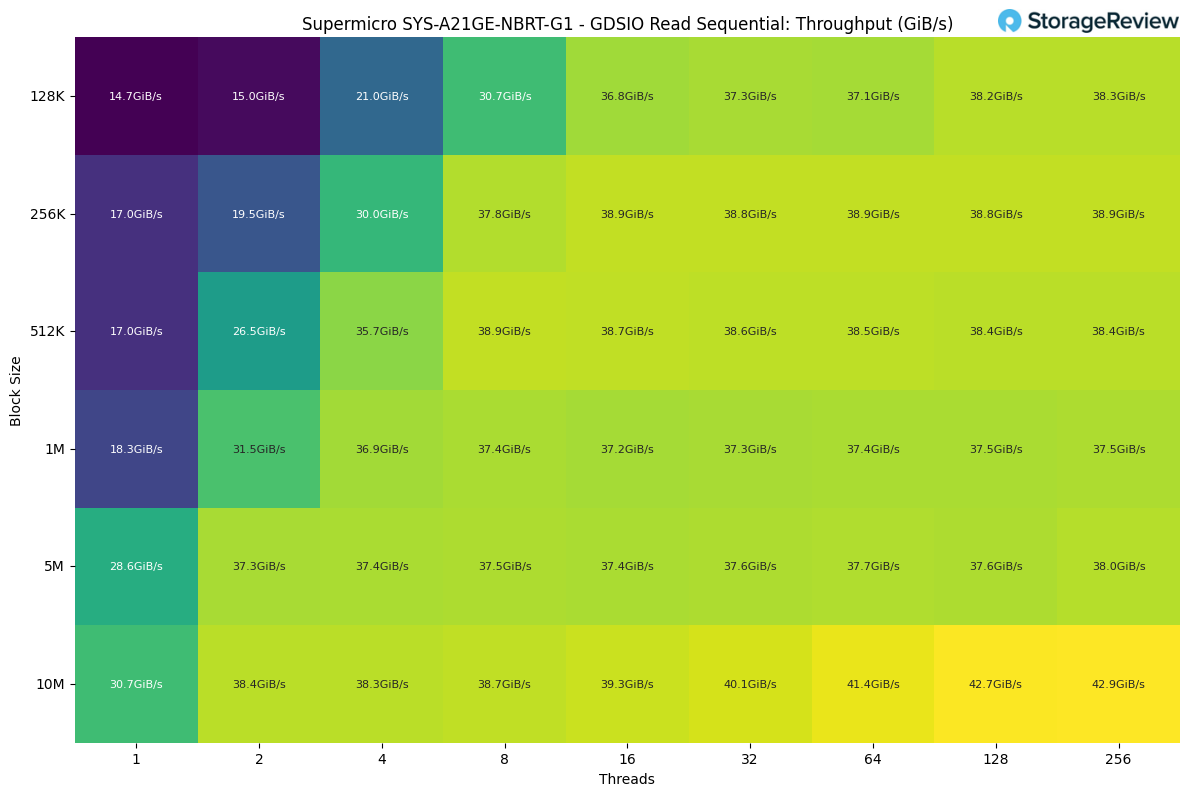
Podczas testów sekwencyjnego odczytu GDSIO na platformie B200, obciążenie początkowo było umiarkowane – pojedynczy wątek osiągnął około 14–15 GiB/s, w zależności od rozmiaru bloku. Gdy tylko zwiększyliśmy liczbę wątków i rozmiar bloku, wydajność szybko wzrosła. Przejście na 2 i 4 wątki zwiększyło przepustowość do zakresu 20–36 GiB/s, co pokazuje, jak dobrze system skaluje się po wprowadzeniu paralelizmu.
Prawdziwe przyspieszenie nastąpiło po osiągnięciu ośmiu lub więcej wątków, kiedy to większość obciążeń ustabilizowała się w zakresie 30 GiB/s. Największe korzyści odniosły większe bloki, a rozmiary 5 MB i 10 MB konsekwentnie zapewniały wysokie wyniki przy każdej liczbie wątków.
Przepustowość ostatecznie osiągnęła maksimum na poziomie około 43 GiB/s przy rozmiarze bloku 10 MB i 256 wątkach, co stanowi najwyższą stałą szybkość odczytu sekwencyjnego, jaką zaobserwowaliśmy w tym teście.
Opóźnienie sekwencyjnego odczytu GDSIO
Po stronie opóźnień, obciążenie początkowo reagowało bardzo dynamicznie, a odczyty z pojedynczego wątku mieściły się w zakresie 0.06–0.1 ms dla mniejszych bloków. Wraz ze wzrostem liczby wątków, opóźnienie stopniowo rosło, utrzymując się poniżej 1 ms do momentu wystąpienia 8 wątków w przypadku większości obciążeń.
Po przekroczeniu 16 wątków, większe rozmiary bloków zaczęły zbliżać się do poziomu kilku milisekund, ponieważ ścieżka pamięci masowej stawała się coraz bardziej nasycona. Największe opóźnienie wystąpiło pod koniec testu, gdzie blok o rozmiarze 10 MB i 256 wątków osiągnął szczyt nieco ponad 1.2 sekundy (około 1200 ms), odzwierciedlając najgorszy scenariusz obciążenia, mający na celu przeciążenie systemu.

Przepustowość sekwencyjna zapisu GDSIO
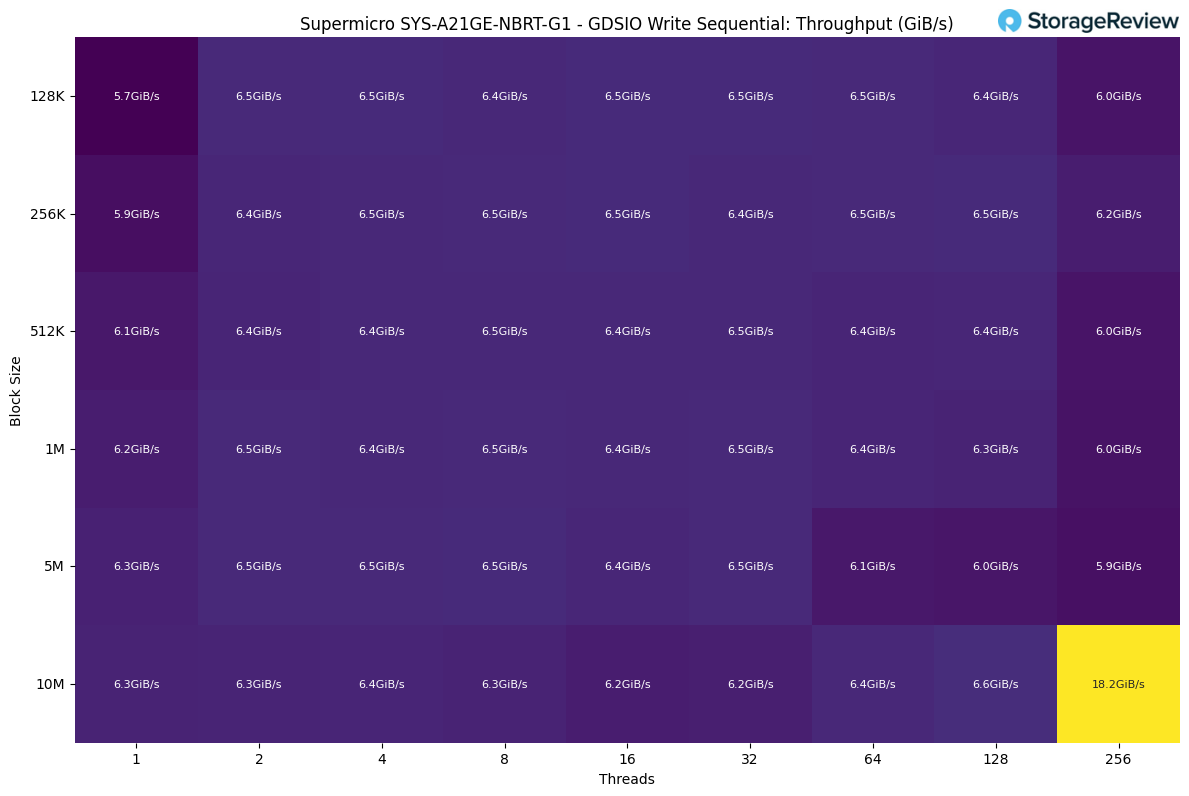
W przypadku zapisu sekwencyjnego wydajność była znacznie bardziej płaska w porównaniu z odczytem. Obciążenie szybko się unormowało, a większość kombinacji rozmiaru wątku i bloku wyniosła około 6.3–6.5 GiB/s. Wskazuje to, że ścieżka zapisu szybko osiąga stały limit, prawdopodobnie związany z nośnikami danych i buforowaniem, a nie ograniczeniami GPU lub PCIe.
Skalowanie liczby wątków nie miało znaczącego wpływu, ponieważ przepustowość pozostała zasadniczo niezmieniona z 2 do 128 wątków. Jedyny wyróżniający się wynik pojawił się na końcu, gdzie rozmiar bloku 10 MB przy 256 wątkach gwałtownie wzrósł do 18.2 GiB/s, co oznaczało chwilową przewagę, gdy system mógł w pełni wykorzystać głębokie kolejki i agregację zapisu.
Opóźnienie zapisu sekwencyjnego GDSIO
Opóźnienie zapisu początkowo było stosunkowo niskie, przy obciążeniach jednowątkowych na poziomie około 0.15–0.5 ms przy mniejszych rozmiarach bloków. Wraz ze wzrostem liczby wątków, opóźnienie skalowało się znacznie bardziej agresywnie niż po stronie odczytu, osiągając zakres 1–4 ms w przypadku czterech wątków i 4–9 ms w przypadku ośmiu wątków.
Po osiągnięciu 32 wątków z większymi rozmiarami bloków, opóźnienie gwałtownie wzrosło, a bloki 5 mln i 10 mln osiągnęły zakres 170–350 ms. Najbardziej ekstremalnym przypadkiem był blok o rozmiarze 10 mln przy 256 wątkach, którego szczyt nastąpił po niecałych 3 sekundach (około 2900 ms), co wyraźnie pokazuje, jak szybko ścieżka zapisu ulega nasyceniu pod dużym obciążeniem równoległym.

Przepustowość losowego odczytu GDSIO
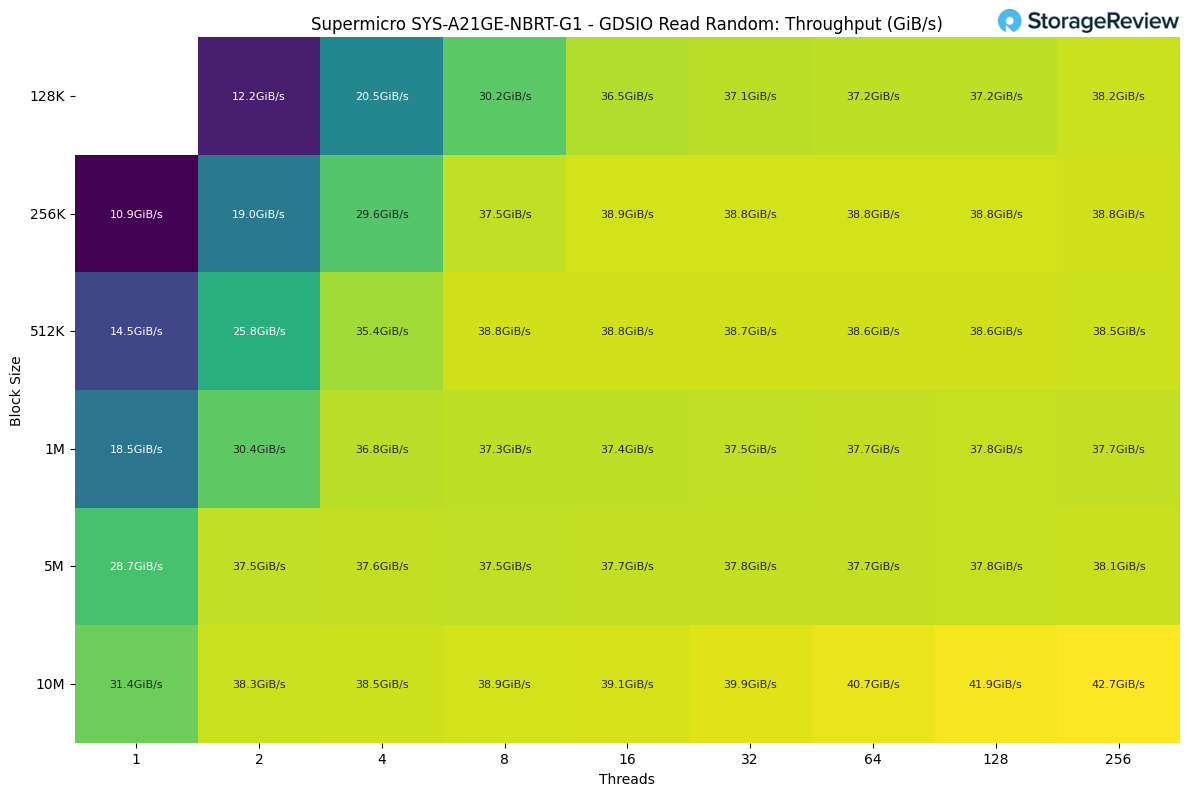
W przypadku odczytów losowych obciążenie szybko rosło. Wydajność pojedynczego wątku wahała się od około 11 do 31 GiB/s, w zależności od rozmiaru bloku, przy czym większe bloki od razu korzystały z większej przepustowości. Po przejściu na dwa i cztery wątki przepustowość wzrosła do zakresu 20–36 GiB/s, wykazując silną skalowalność już na wczesnym etapie.
Od 8 wątków wzwyż system ustabilizował się na stabilnym poziomie w zakresie 30 GiB/s, bardzo podobnym do tego, co zaobserwowaliśmy w teście sekwencyjnego odczytu. Najwyższy wynik uzyskano przy rozmiarze bloku 10 MB i 256 wątkach, osiągając szczyt na poziomie około 42.7 GiB/s.
Opóźnienie odczytu losowego GDSIO
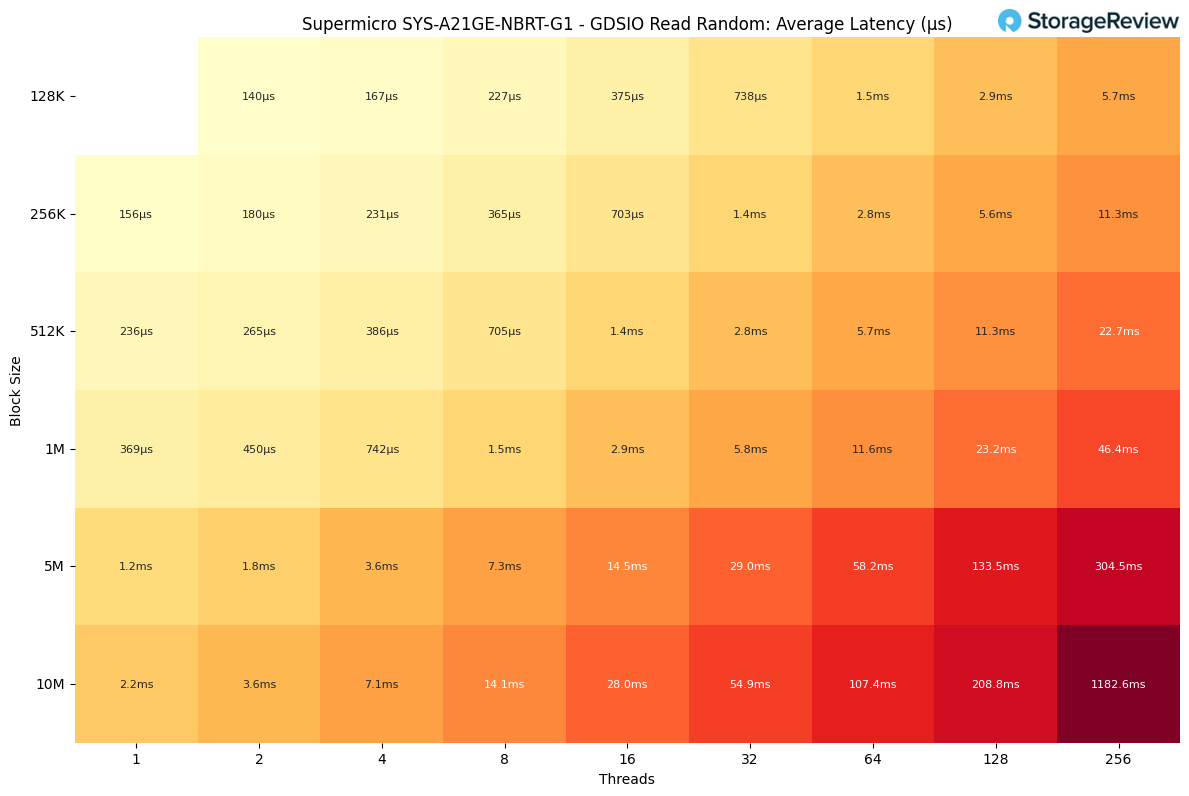
Opóźnienie odczytu losowego początkowo było bardzo niskie, przy obciążeniach jednowątkowych na poziomie około 0.15–0.4 ms przy mniejszych rozmiarach bloków. Wraz ze wzrostem liczby wątków, opóźnienie stopniowo rosło, utrzymując się poniżej 1 ms w punkcie 4 wątków i osiągając około 1–3 ms w przypadku ośmiu wątków.
Po przejściu na 32 wątki i większe bloki, opóźnienie wzrosło jeszcze bardziej, a transfery 5 i 10 milionów osiągały zakres 30–55 ms. Najbardziej ekstremalny przypadek wystąpił przy 256 wątkach i rozmiarze bloku 10 milionów, gdzie opóźnienie osiągnęło szczyt nieco ponad 1.1 sekundy (około 1180 ms).
Przepustowość losowego zapisu GDSIO
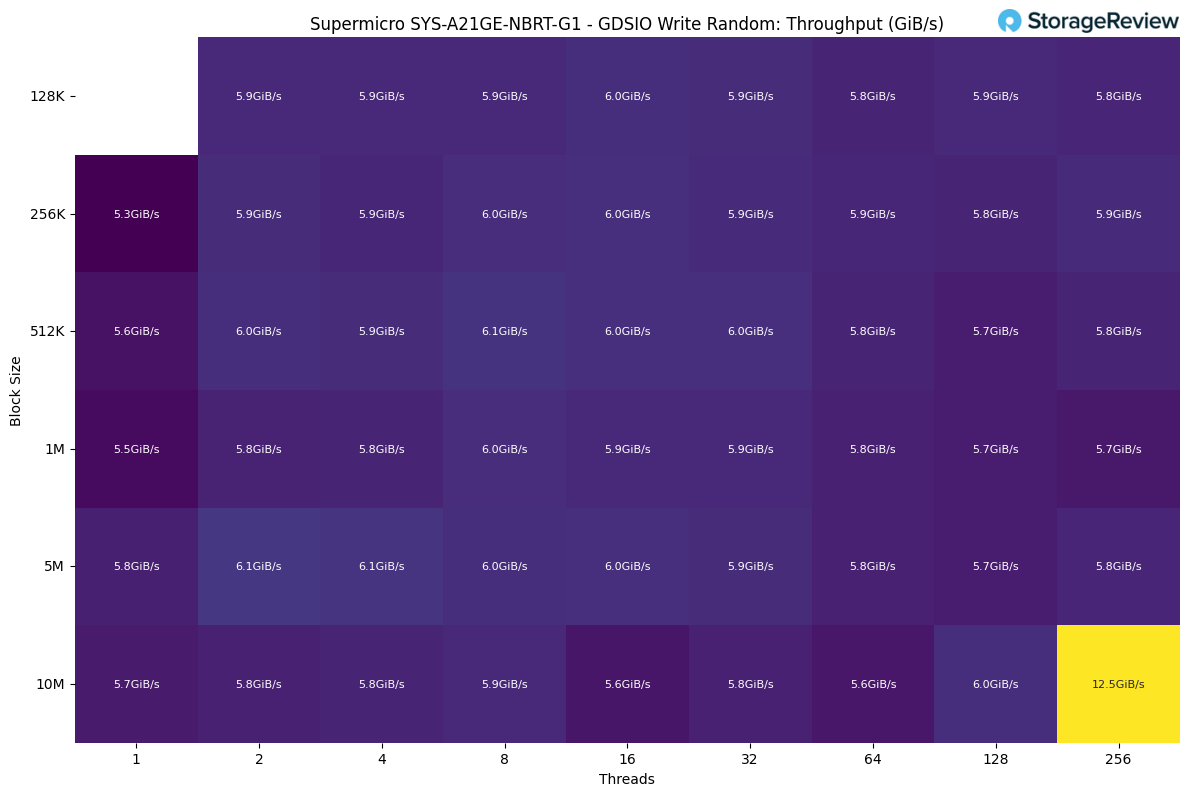
Wydajność zapisu losowego była bardzo spójna w całym zakresie, przy czym większość rozmiarów bloków i liczby wątków mieściła się w przedziale 5.8–6.1 GiB/s. Obciążenie osiągnęło ten poziom niemal natychmiast i wykazywało minimalne skalowanie wraz z wprowadzaniem kolejnych wątków, co wskazuje, że ścieżka zapisu szybko osiągnęła swój limit.
Jedynym godnym uwagi wyjątkiem był koniec testu, kiedy rozmiar bloku 10 MB przy 256 wątkach na krótko wzrósł do 12.5 GiB/s, prawdopodobnie dzięki głębokiemu kolejkowaniu i agregacji zapisu przy dużym obciążeniu równoległym.
Opóźnienie losowego zapisu GDSIO
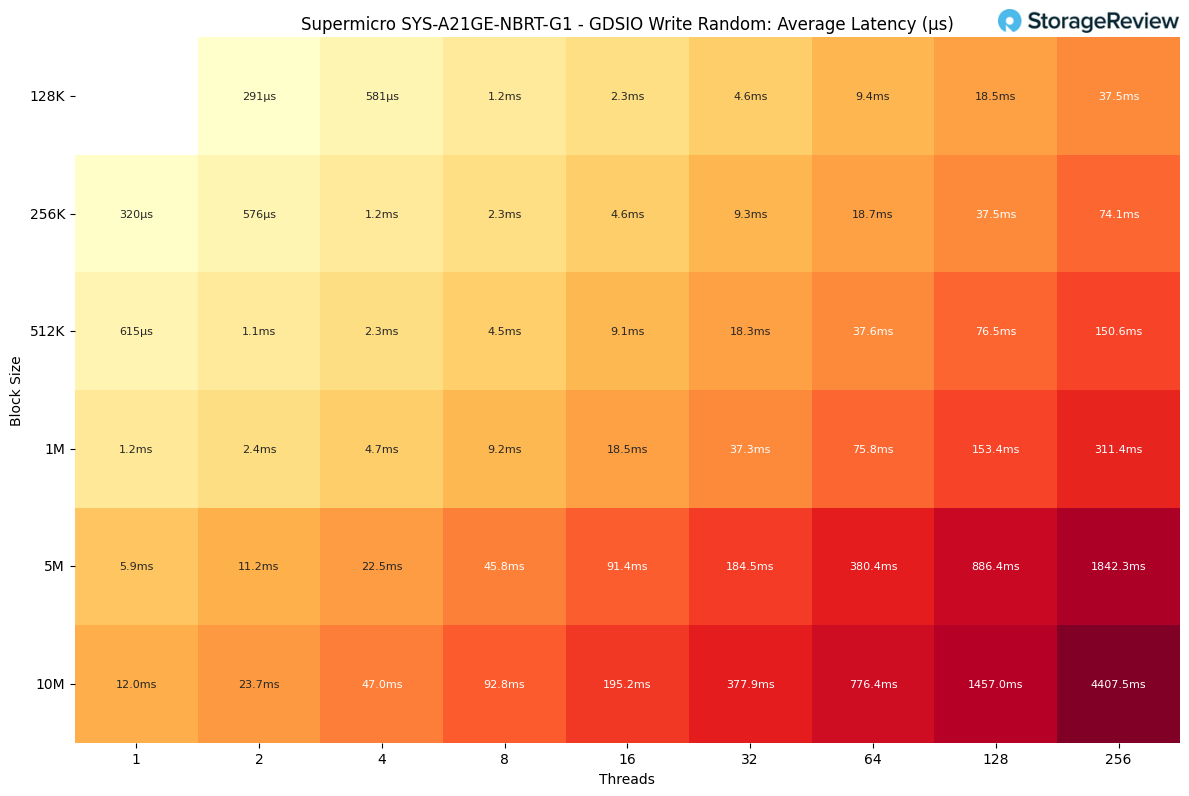
Początkowo opóźnienie zapisu losowego było stosunkowo niskie, a wydajność pojedynczego wątku wahała się od około 0.6 do 1.2 ms dla mniejszych bloków i od 5 do 12 ms dla największych transferów. Wraz ze wzrostem współbieżności, opóźnienie szybko rosło, osiągając 4–9 ms dla ośmiu wątków i 18–38 ms dla 32 wątków.
Po przekroczeniu tego punktu ścieżka zapisu ulegała przeciążeniu. Większe rozmiary bloków osiągały zakres 150–380 ms przy 64 wątkach, a ciągłe skalowanie powodowało gwałtowny wzrost opóźnień. Najgorszym przypadkiem był blok o rozmiarze 10 MB przy 256 wątkach, którego maksymalny czas wynosił około 4.4 sekundy.
vLLM Online Serving – wydajność wnioskowania LLM
vLLM to najpopularniejszy silnik wnioskowania i obsługi o wysokiej przepustowości dla systemów LLM. Test porównawczy obsługi online vLLM to narzędzie do oceny wydajności, które mierzy rzeczywiste możliwości obsługi tego silnika wnioskowania przy współbieżnych żądaniach. Symuluje obciążenia produkcyjne, wysyłając żądania do działającego serwera vLLM z konfigurowalnymi parametrami, takimi jak częstotliwość żądań, długość wejścia/wyjścia i liczba współbieżnych klientów. Test mierzy kluczowe wskaźniki, takie jak przepustowość (liczba tokenów na sekundę), czas do pierwszego tokena i czas na token wyjściowy (TPOT), pomagając użytkownikom zrozumieć, jak vLLM działa w różnych warunkach obciążenia.
Przetestowaliśmy wydajność wnioskowania w ramach kompleksowego zestawu modeli obejmujących różne architektury, skale parametrów i strategie kwantyzacji, aby ocenić przepustowość przy różnych profilach współbieżności.
Wydajność gęstego modelu
Modele gęste bazują na konwencjonalnej architekturze LLM, w której wszystkie parametry i aktywacje są uwzględniane podczas wnioskowania, co skutkuje bardziej intensywnym obliczeniowo przetwarzaniem niż w przypadku modeli rzadkich. Aby kompleksowo ocenić charakterystykę wydajności w różnych skalach modeli i strategiach kwantyzacji, przeprowadziliśmy testy porównawcze wielu konfiguracji modeli gęstych z rodziny Llama 3.1 8B.
Nasz zestaw testów obejmował ewaluacje Meta Llama 3.1 8B w trzech formatach precyzji: konfiguracji standardowej oraz skwantyzowanych wersjach FP8 i FP4 wykorzystujących format NVFP4 firmy NVIDIA. Należy zauważyć, że vLLM obecnie wykorzystuje jądro Marlin dla skwantyzowanych modeli NVFP4, a pełne korzyści wydajnościowe tego formatu kwantyzacji nie zostały jeszcze w pełni wykorzystane w tych testach. Przyszłe optymalizacje vLLM ukierunkowane na natywne operacje rdzenia tensora NVFP4 mogą przynieść dodatkową poprawę wydajności. Ta strategia wyboru modelu umożliwia bezpośrednie porównanie wydajności, jednocześnie izolując wpływ kwantyzacji progresywnej na przepustowość wnioskowania.
Wydajność Llama 3.1 8B
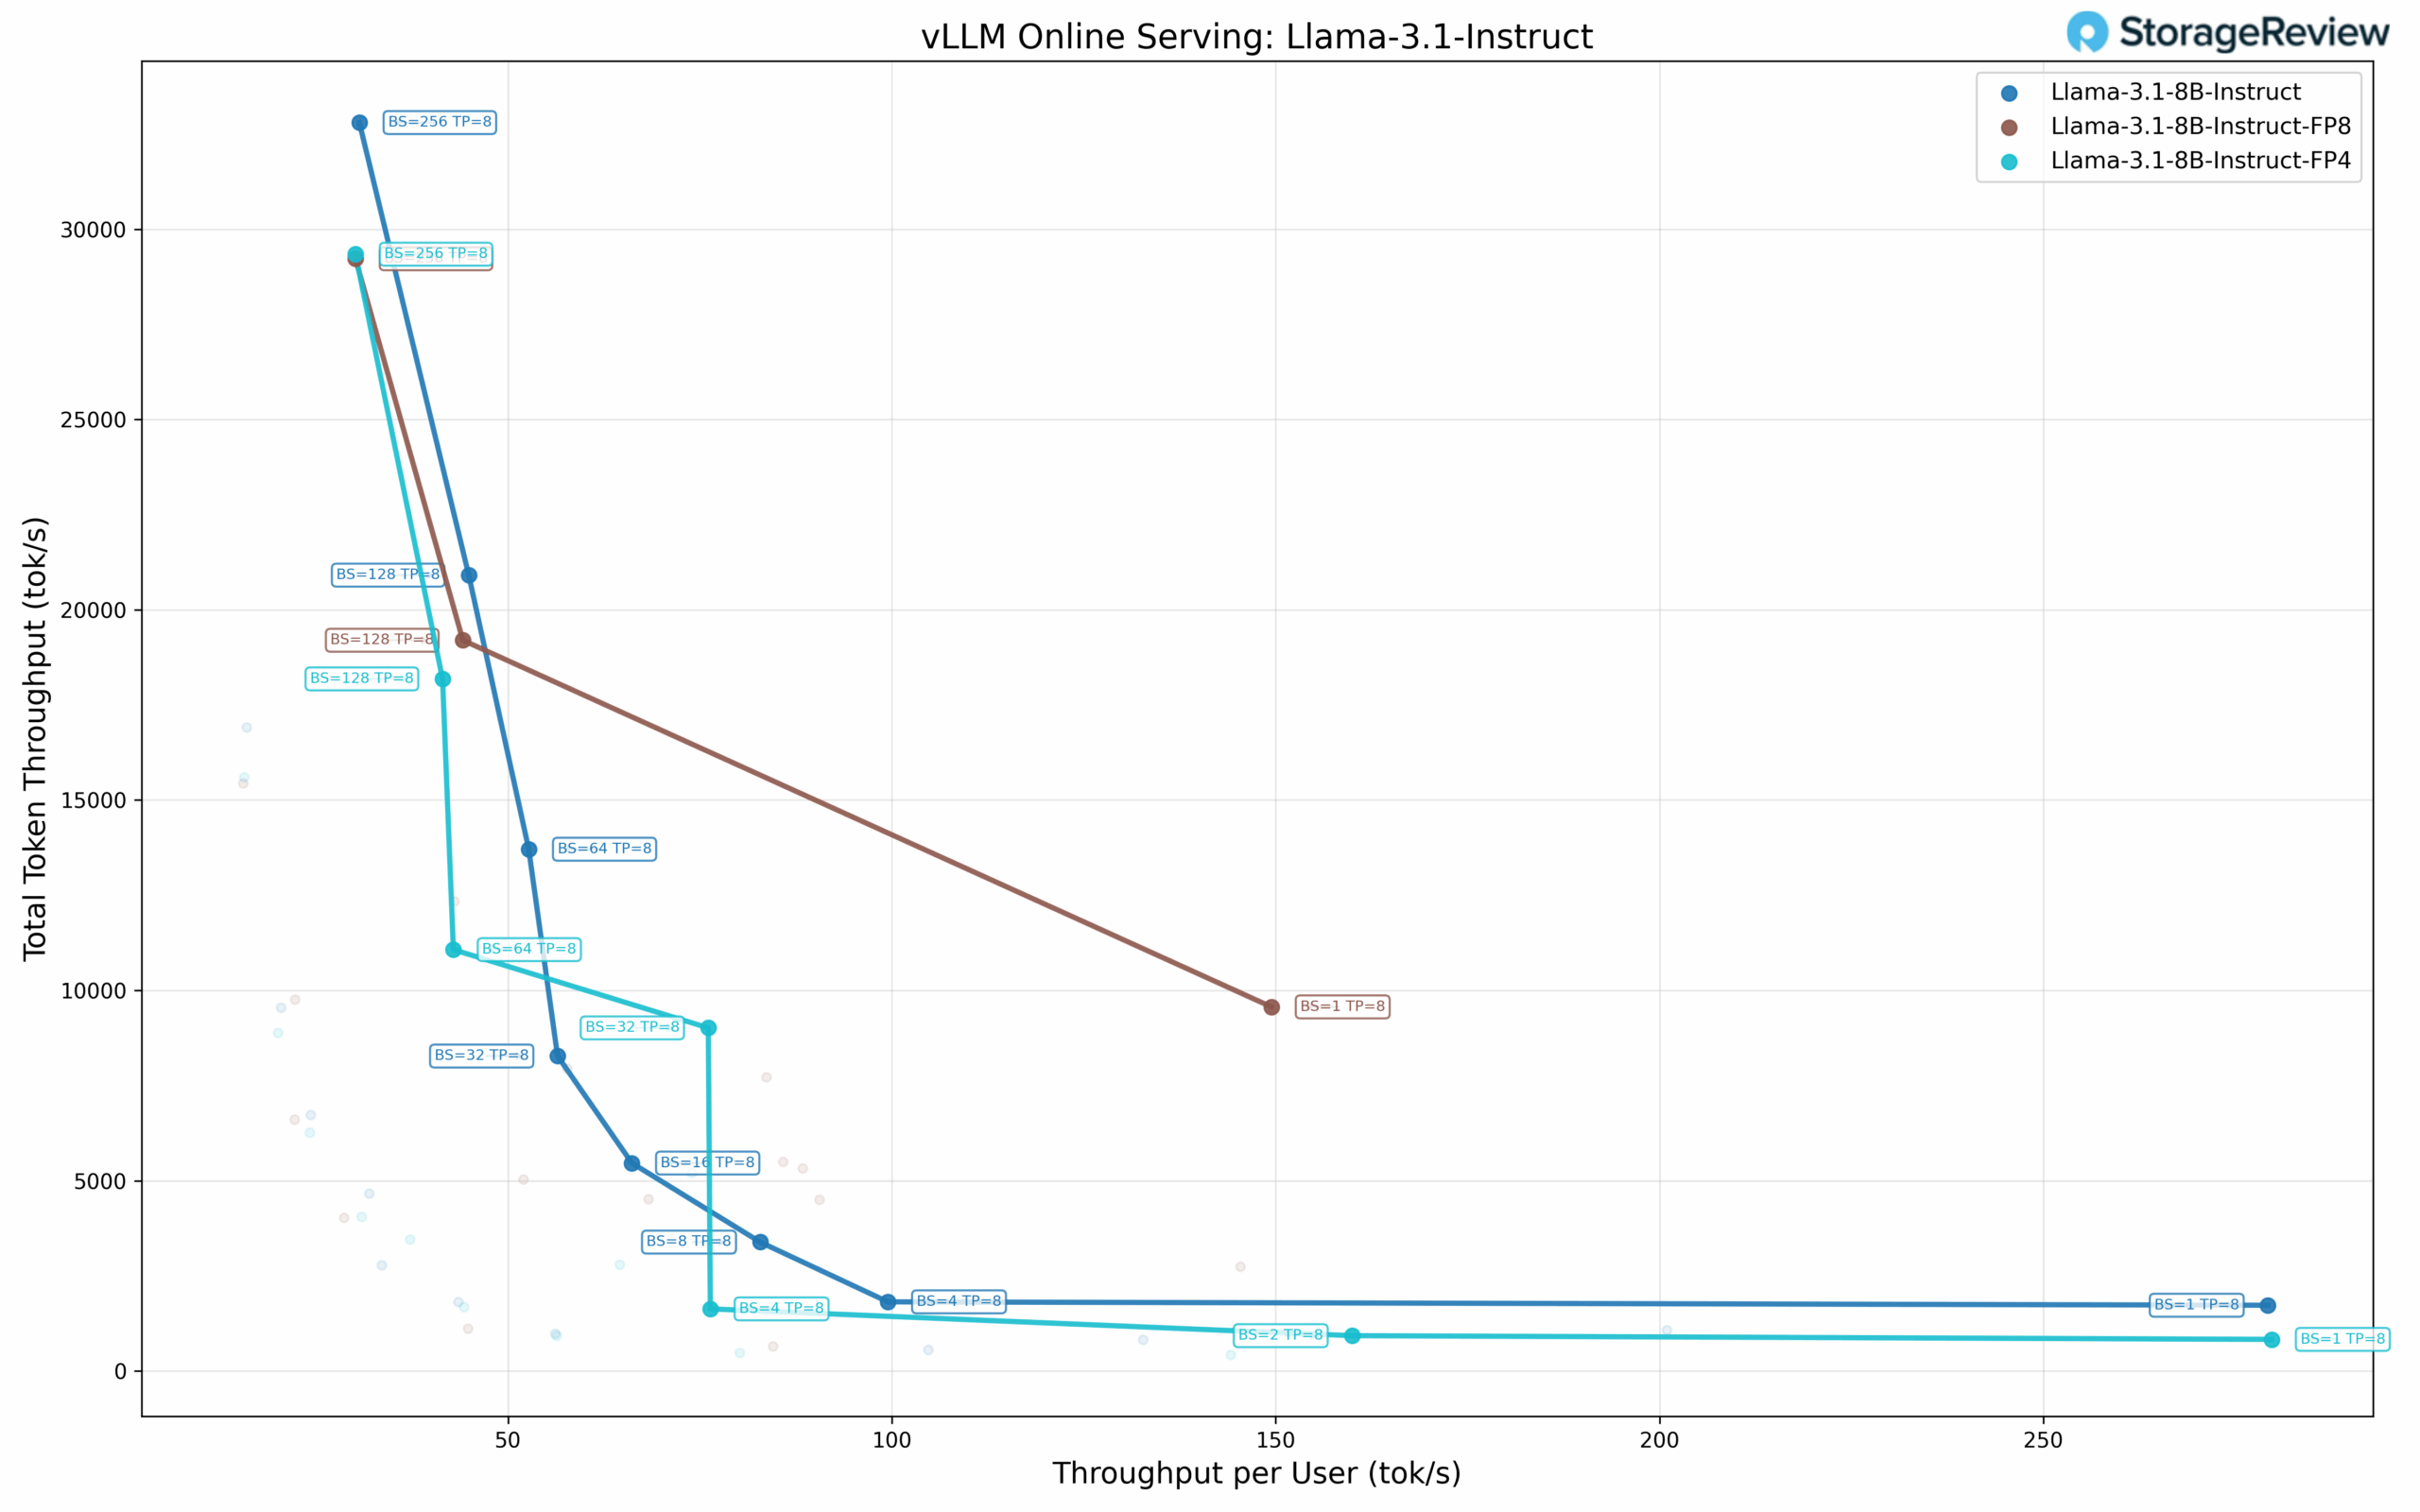
Model Llama 3.1 8B o standardowej precyzji charakteryzuje się następującymi charakterystykami skalowania na różnych poziomach współbieżności. Przy współbieżności pojedynczego użytkownika (BS=1) model zapewnia 279.27 tok/s na użytkownika, przy całkowitej przepustowości 1,727.62 tok/s i TPOT 3.37 ms. Wraz ze wzrostem rozmiaru wsadu, przepustowość na użytkownika maleje, a całkowita przepustowość rośnie. Przy BS=8 model osiąga 82.85 tok/s na użytkownika, przy całkowitej przepustowości 3,386.48 tok/s i TPOT 3.28 ms. Wydajność nadal rośnie do BS=32 (56.46 tok/s na użytkownika, 8,274.66 tok/s łącznie) i BS=64 (52.70 tok/s na użytkownika, 13,707.66 tok/s łącznie).
Model osiąga maksymalną całkowitą przepustowość przy BS=256, zapewniając 32 797,67 tok/s, przy 30.64 tok/s na użytkownika i TPOT wynoszącym 16.13 ms. Oznacza to 19-krotny wzrost całkowitej przepustowości w porównaniu z wydajnością pojedynczego użytkownika. Wartości TPOT utrzymują się w zakresie 3-4 ms do BS=64, wzrastając do 16.13 ms przy BS=256.
Wydajność Llama 3.1 8B FP8
Skwantyzowany wariant FP8 charakteryzuje się innymi cechami. Przy BS=1 osiąga 149.46 tok/s na użytkownika, przy całkowitej przepustowości 9,565.20 tok/s i TPOT 3.44 ms. Analiza granicy Pareto ujawnia trzy optymalne punkty (BS=1, BS=128, BS=256).
Przy BS=128 model zapewnia 44.12 tok/s na użytkownika przy łącznej wartości 19 198,40 tok/s i 11.04 ms
TPOT. Maksymalna całkowita przepustowość występuje przy BS=256 z całkowitą przepustowością 29 219,67 tok/s, 30.13 tok/s na użytkownika i TPOT 13.26 ms. Wariant FP8 osiąga niższą maksymalną całkowitą przepustowość w porównaniu ze standardową precyzją (29.2 tys. w porównaniu z 32.8 tys. tok/s).
Wydajność Llama 3.1 8B FP4
Konfiguracja skwantowana FP4 przedstawia następujące wyniki. Przy współbieżności pojedynczego użytkownika (BS=1) osiąga 279.73 tok/s na użytkownika, całkowitą przepustowość 830.46 tok/s i TPOT 3.43 ms.
Model FP4 pokazuje siedem punktów granicznych Pareto. Przy BS=2 zapewnia on 159.95 tok/s na użytkownika, łącznie 928.60 tok/s i 3.43 ms TPOT. Wydajność nadal rośnie do BS=4 (76.36 tok/s na użytkownika, łącznie 1,631.69 tok/s) i BS=32 (76.09 tok/s na użytkownika, łącznie 9,014.29 tok/s). Model osiąga maksymalną całkowitą przepustowość przy BS=256 z 29 340,89 tok/s łącznie, 30.13 tok/s na użytkownika i 16.18 ms TPOT.
Wydajność modelu rzadkiego
Modele rzadkie, a w szczególności architektury Mixture of Experts (MoE), to nowe podejście do efektywnego skalowania modeli językowych. Architektury te utrzymują wysoką całkowitą liczbę parametrów, aktywując jednocześnie tylko podzbiór parametrów na token, co potencjalnie oferuje lepszą wydajność w przeliczeniu na aktywny parametr.
Oceniliśmy dwie architektury MoE: DeepSeek-R1, model skoncentrowany na rozumowaniu, oraz Qwen3 Coder 30B-A3B, architekturę rzadką, specjalizującą się w generowaniu kodu. DeepSeek-R1 to najpopularniejszy model skoncentrowany na rozumowaniu, charakteryzujący się odmiennymi parametrami wydajnościowymi w porównaniu z tradycyjnymi modelami językowymi. Model Qwen3 Coder utrzymuje pełną wielkość 30 mld parametrów, aktywując jednocześnie tylko 3 mld parametrów na wygenerowany token. Przeprowadziliśmy testy porównawcze Qwen3 Coder zarówno w wersji standardowej, jak i skwantyzowanej z FP8, aby zrozumieć charakterystykę wydajności w różnych strategiach kwantyzacji.
Wydajność DeepSeek-R1
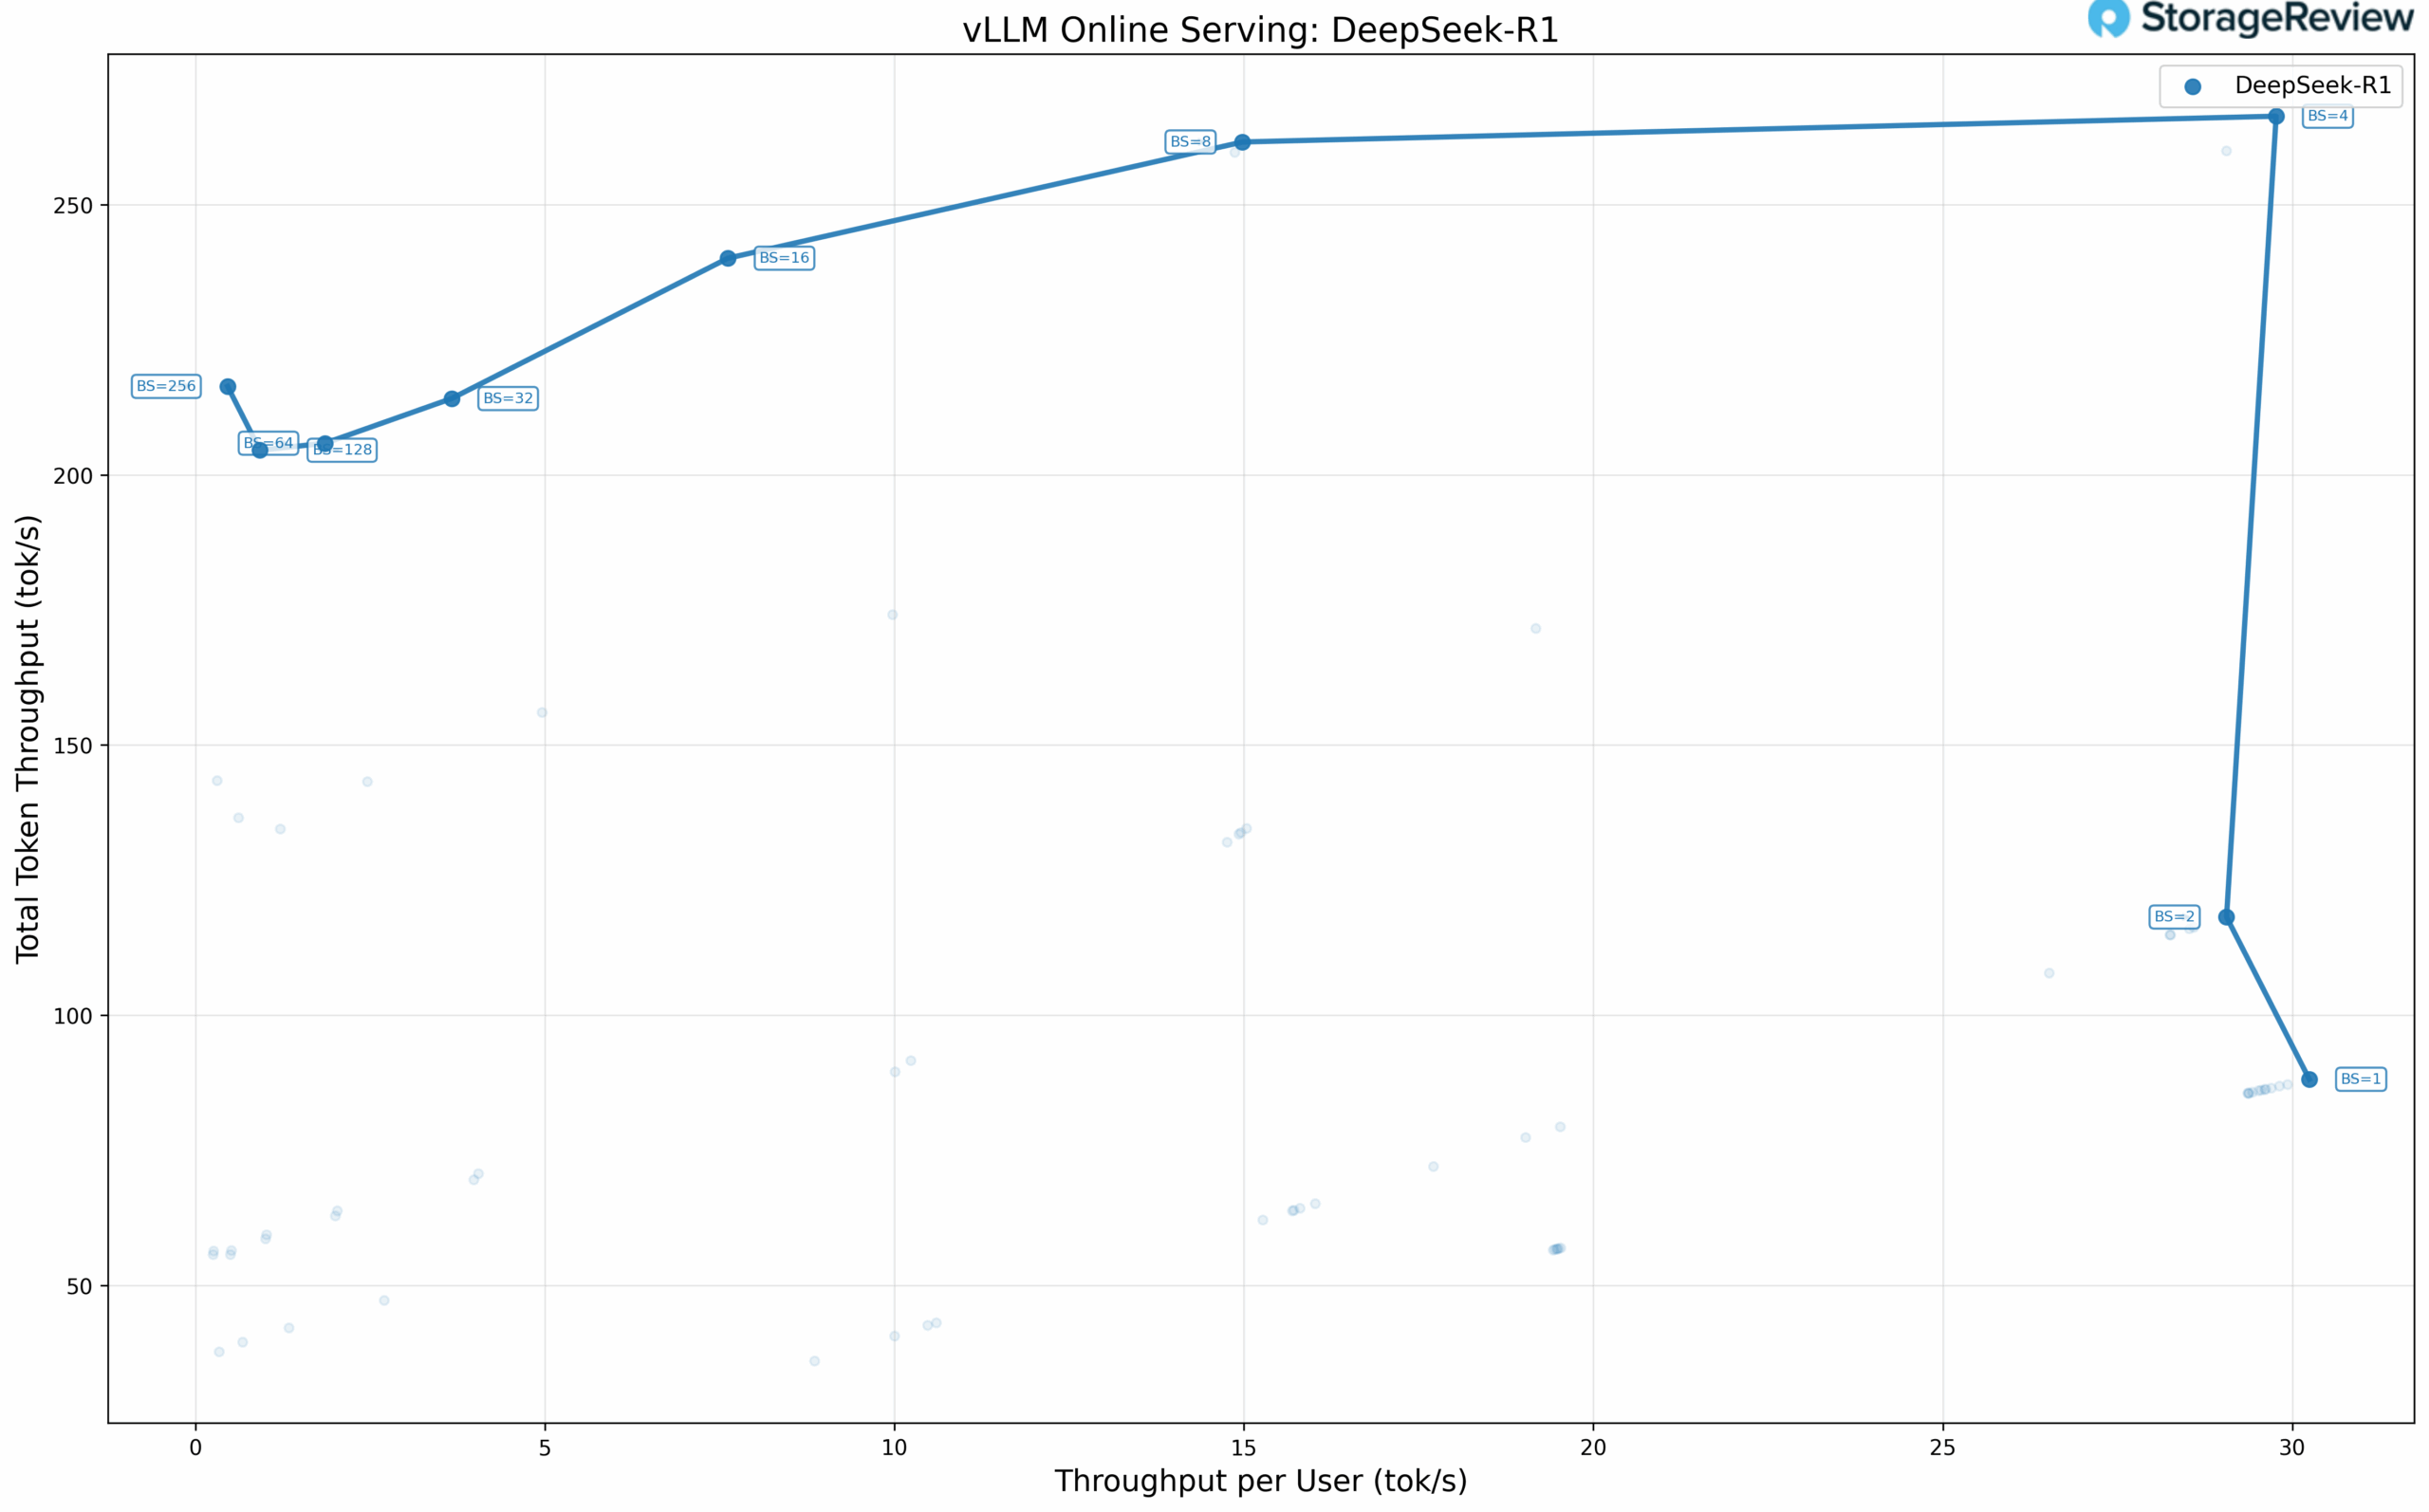
Model DeepSeek-R1 charakteryzuje się interesującym skalowaniem w różnych rozmiarach partii. Przy współbieżności pojedynczego użytkownika (BS=1) model osiąga 30.24 tok/s na użytkownika, całkowitą przepustowość 88.13 tok/s i TPOT 29.85 ms. Po skalowaniu do BS=4, wydajność osiąga 29.77 tok/s na użytkownika, zapewniając jednocześnie całkowitą przepustowość 266.40 tok/s i TPOT 32.04 ms, co stanowi maksymalną całkowitą przepustowość osiągniętą we wszystkich konfiguracjach.
Wydajność DeepSeek-R1 osiąga plateau powyżej BS=4. Przy BS=8 przepustowość na użytkownika gwałtownie spada do 14.98 tok/s, a spadek ten utrzymuje się przy większych rozmiarach wsadów, osiągając zaledwie 0.46 tok/s na użytkownika przy BS=256. Całkowita przepustowość pozostaje względnie stabilna w zakresie od 200 do 260 tok/s w zakresie od BS=4 do BS=256, ponieważ model nie jest w stanie skalować się z dodatkowymi równoczesnymi żądaniami na jednym węźle, co prowadzi do zwiększonego opóźnienia bez znaczącego wzrostu przepustowości. Warto zauważyć, że B200 DGX jest jednym z niewielu rozwiązań jednoserwerowych, które mogą obsługiwać ten ogromny model.
Wydajność kodera Qwen3 30B-A3B
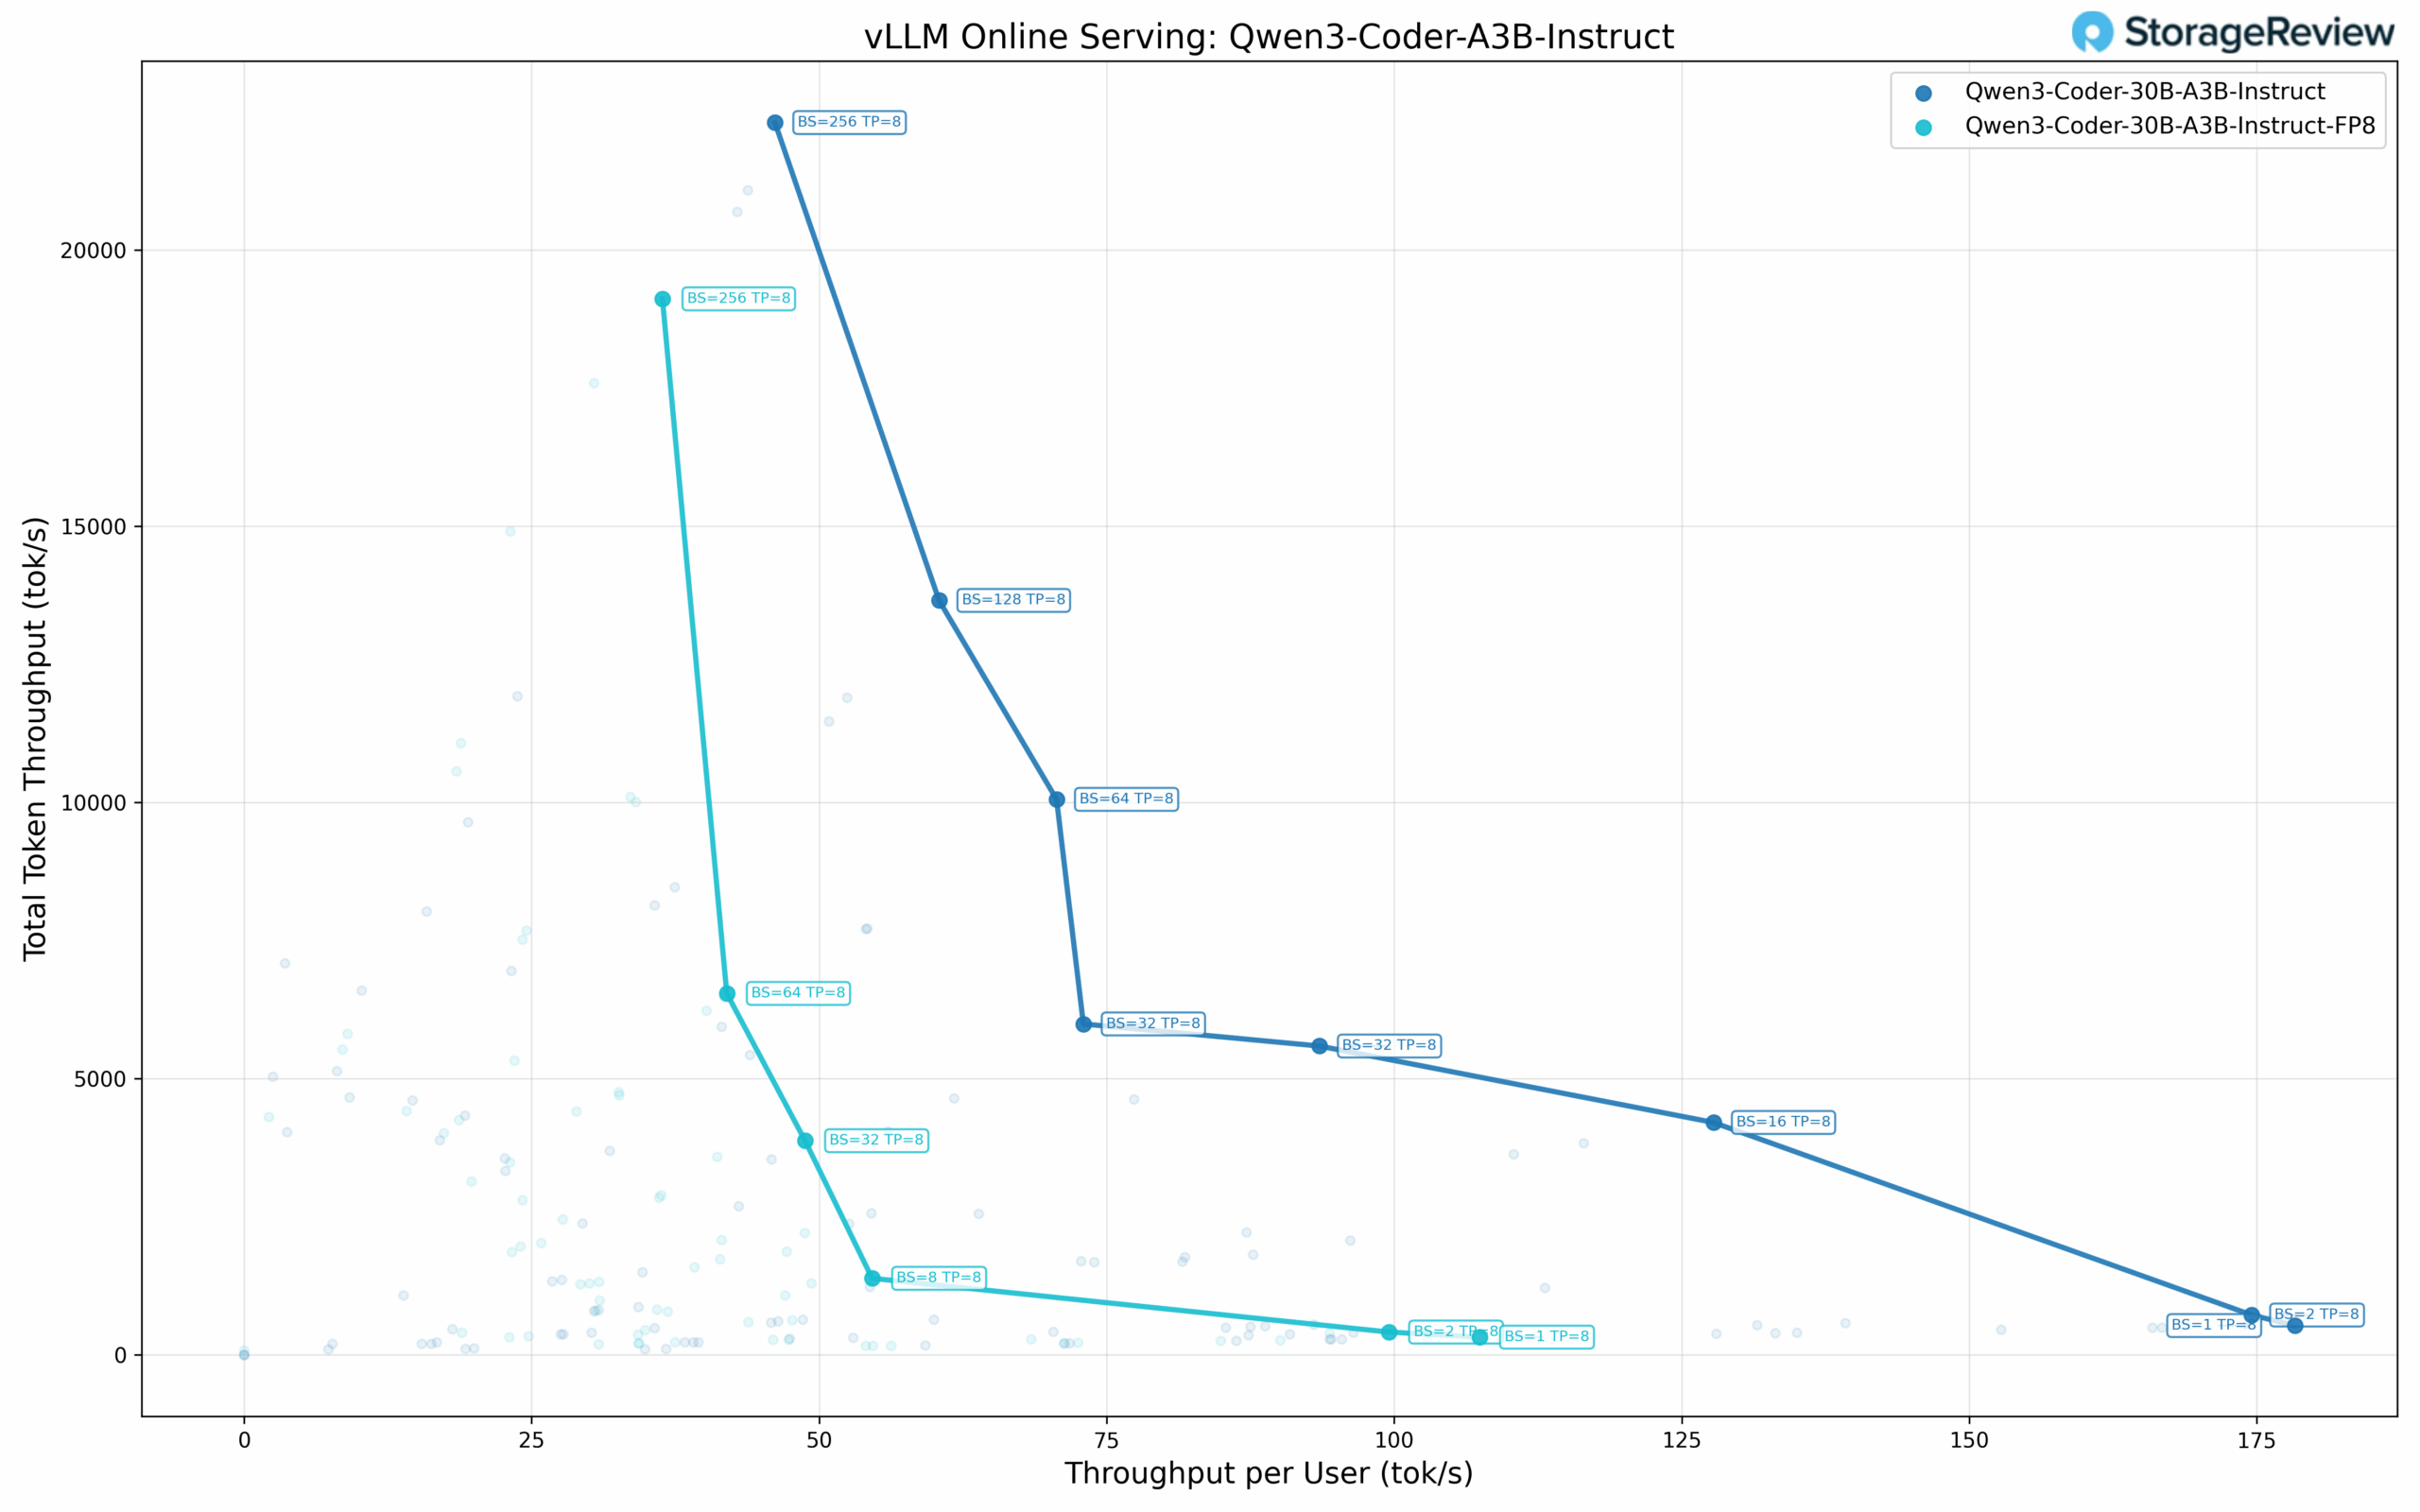
Standardowa precyzja kodera Qwen3 pokazuje następujące skalowanie na różnych poziomach współbieżności. Przy współbieżności pojedynczego użytkownika (BS=1) model osiąga 178.30 tok/s na użytkownika, całkowitą przepustowość 527.25 tok/s i TPOT 5.46 ms. Przy BS=2 wydajność osiąga 174.56 tok/s na użytkownika, przy całkowitej przepustowości 718.70 tok/s i TPOT 5.60 ms. Wraz ze wzrostem rozmiaru wsadu, przepustowość na użytkownika spada, podczas gdy całkowita przepustowość nadal się skaluje: BS=16 zapewnia 127.76 tok/s na użytkownika, całkowitą przepustowość 4,204.40 tok/s i TPOT 6.93 ms.
Model osiąga maksymalną całkowitą przepustowość przy BS=256, osiągając łączną wartość 22 305,88 tok/s, przy 46.16 tok/s na użytkownika i 17.64 ms TPOT. Granica Pareto obejmuje osiem odrębnych punktów, z duplikatem wpisu przy BS=32 (72.97 tok/s i 93.50 tok/s na użytkownika, prawdopodobnie reprezentujących różne konfiguracje). Wartości TPOT utrzymują się w zakresie 5–9 ms do BS=64.
Wydajność Qwen3 Coder 30B-A3B FP8
Skwantyzowany wariant FP8 charakteryzuje się następującymi parametrami wydajności. Przy współbieżności pojedynczego użytkownika (BS=1) zapewnia 107.46 tok/s na użytkownika, całkowitą przepustowość 317.75 tok/s i czas TPOT 9.16 ms. Przy BS=2 model osiąga 99.55 tok/s na użytkownika, łącznie 409.87 tok/s i czas TPOT 9.86 ms.
Skalowanie do większych rozmiarów partii: BS=8 zapewnia 54.60 tok/s na użytkownika, przy łącznej wartości 1,383.13 tok/s i 10.24 ms TPOT, podczas gdy BS=32 osiąga 48.78 tok/s na użytkownika, przy łącznej wartości 3,874.21 tok/s i 10.67 ms TPOT. Maksymalna całkowita przepustowość występuje przy BS=256, przy łącznej wartości 19 114,86 tok/s, 36.38 tok/s na użytkownika i 20.00 ms TPOT. Stanowi to około 86% standardowej maksymalnej przepustowości precyzyjnej.
Wydajność typów danych w mikroskali
Mikroskalanie to zaawansowane podejście do kwantyzacji, które stosuje drobnoziarniste współczynniki skalowania do małych bloków wag, zamiast jednorodnej kwantyzacji w dużych grupach parametrów. Format NVFP4 firmy NVIDIA implementuje tę technikę poprzez blokową reprezentację zmiennoprzecinkową, w której każdy mikroblok o wartościach od 8 do 32 ma wspólny wykładnik jako współczynnik skalowania. To granularne podejście zachowuje precyzję numeryczną, jednocześnie osiągając 4-bitową reprezentację, utrzymując zakres dynamiczny krytyczny dla architektur transformatorowych. Format integruje się z architekturą Tensor Core firmy NVIDIA, umożliwiając wydajne obliczenia o mieszanej precyzji z dekompresją „w locie” podczas operacji na macierzach.
Oceniliśmy modele GPT OSS OpenAI w dwóch skalach parametrów, wykorzystując kwantyzację NVFP4: wariant 20B i większy wariant 120B. Te testy porównawcze pokazują, jak kwantyzacja mikroskalowalna sprawdza się w różnych rozmiarach modeli.
Wydajność GPT-OSS-20B
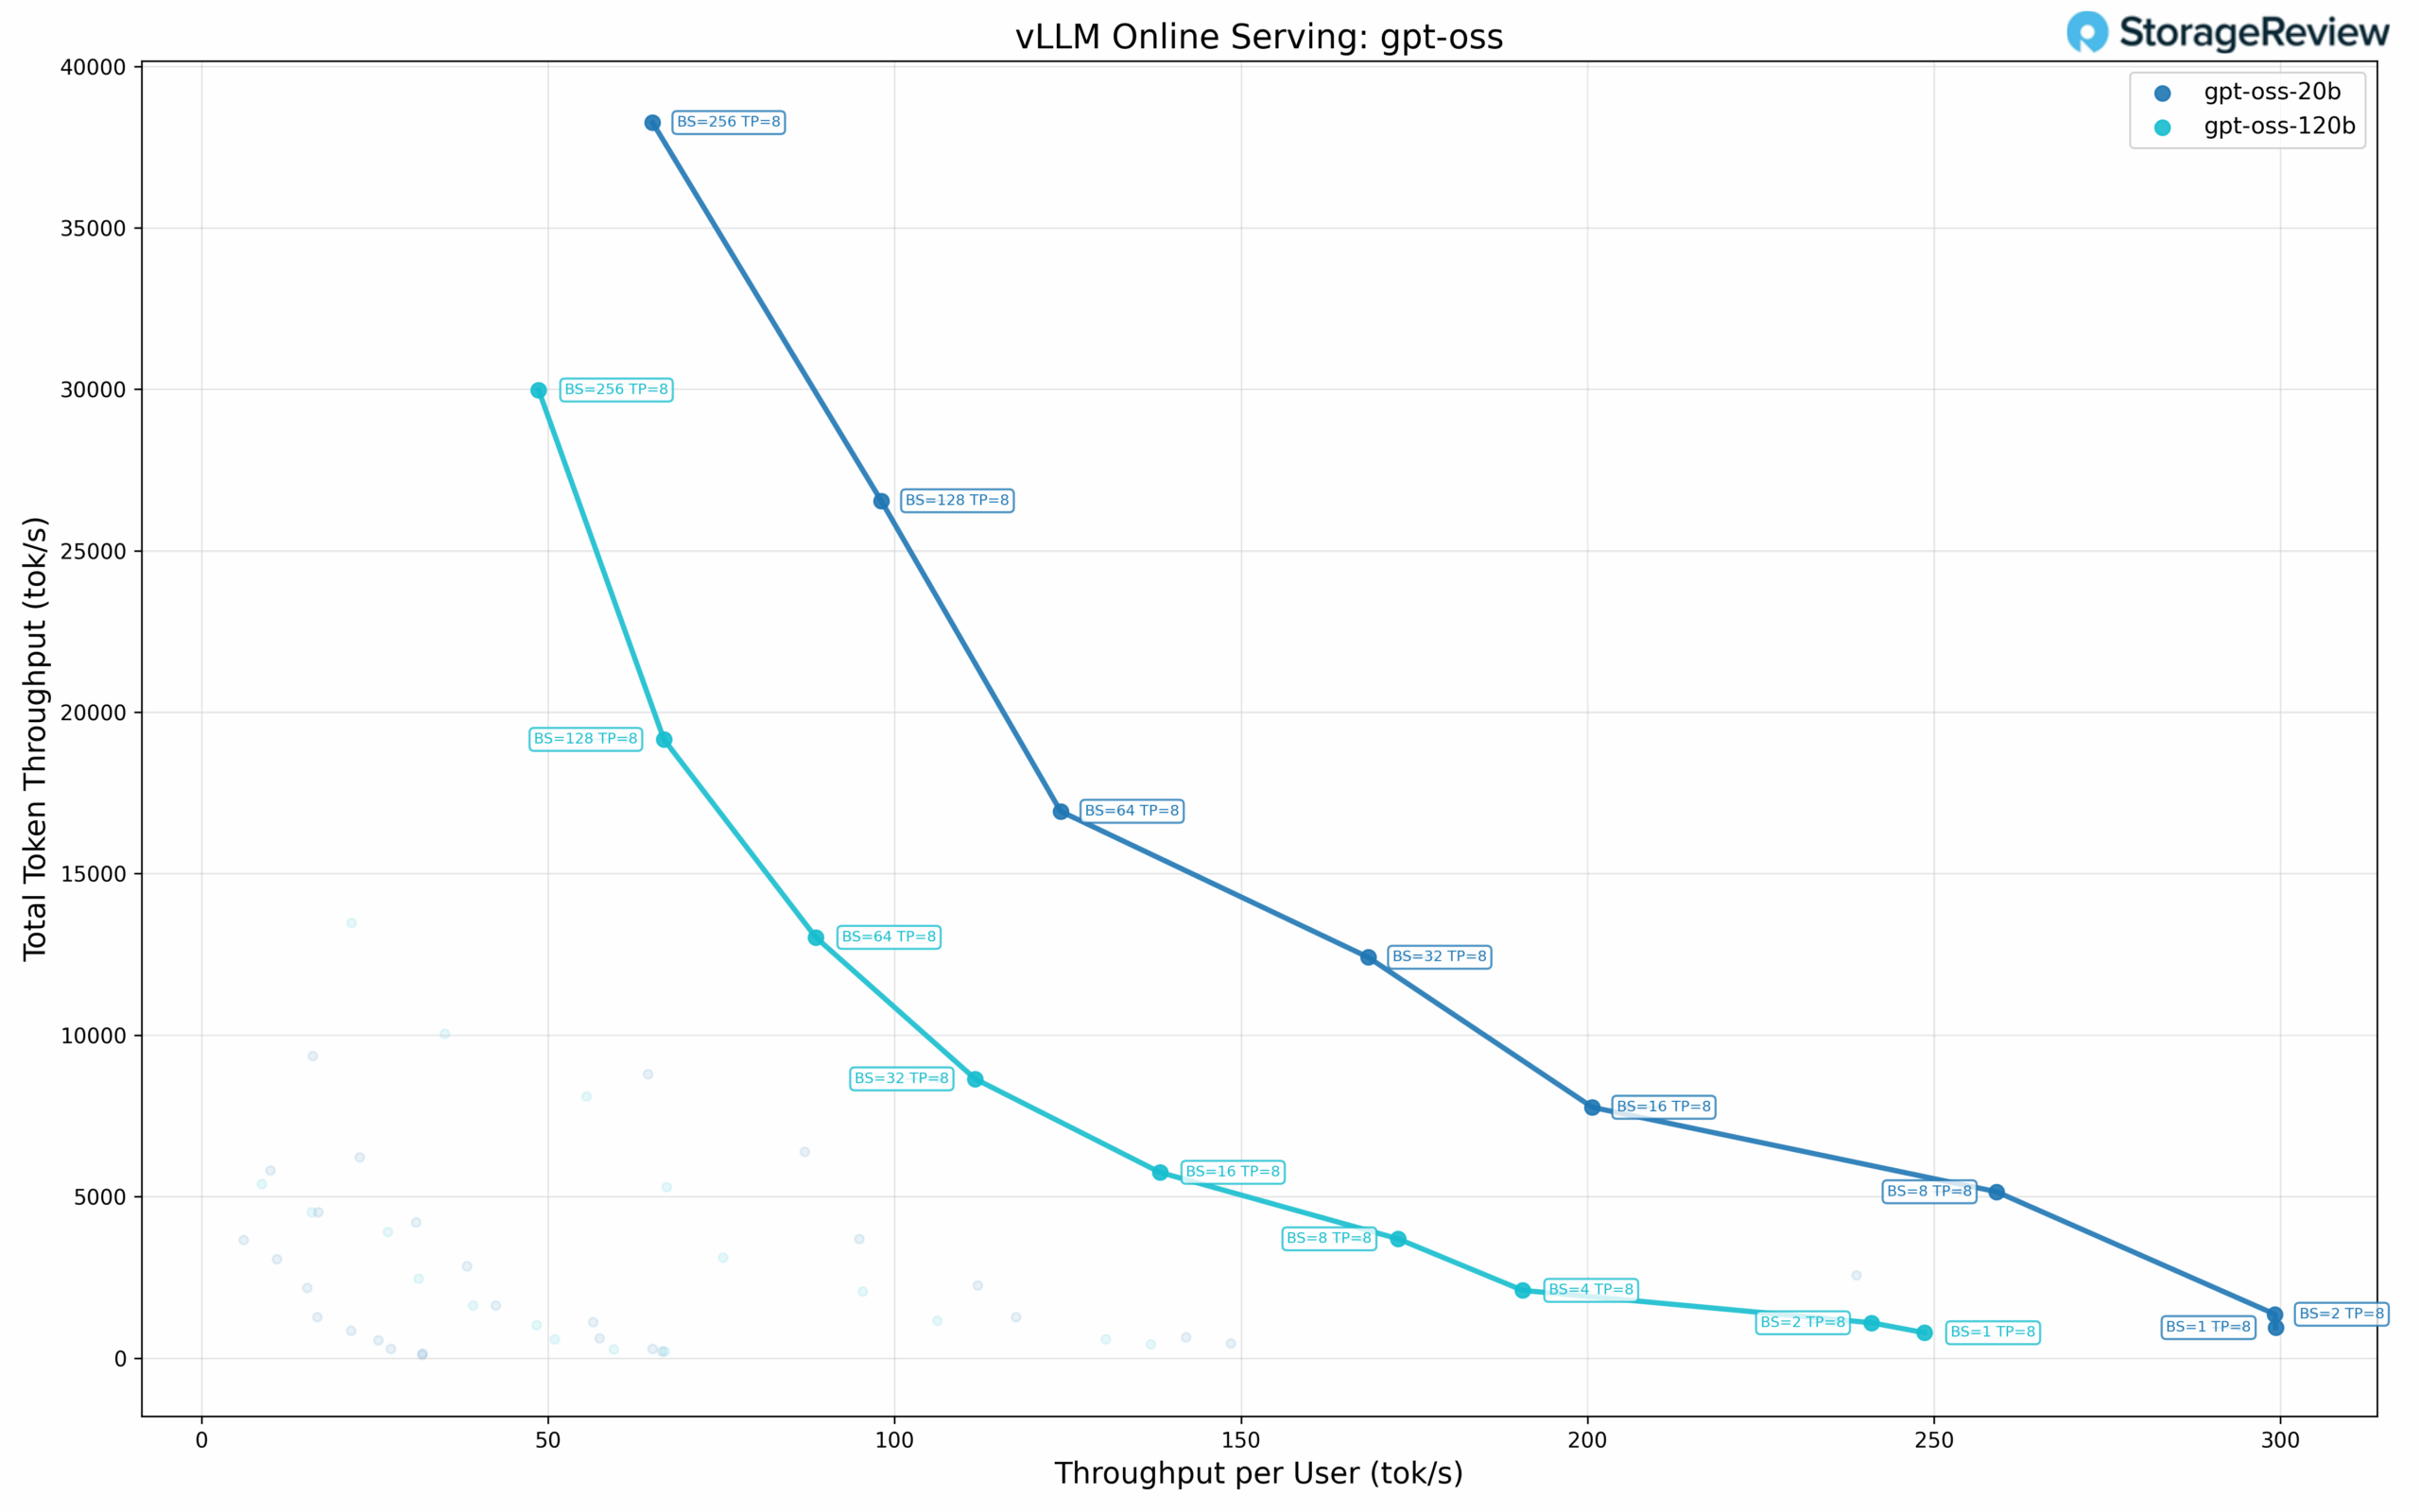
Model parametrów 20B osiąga następującą wydajność dla różnych rozmiarów partii. Przy współbieżności pojedynczego użytkownika (BS=1) zapewnia 299.28 tok/s na użytkownika, całkowitą przepustowość 943.43 tok/s i czas TPOT 3.23 ms. Przy BS=2 model utrzymuje 299.19 tok/s na użytkownika, łącznie 1,356.87 tok/s i czas TPOT 3.19 ms.
Skalowanie do większych rozmiarów partii: BS=8 osiąga 259.02 tok/s na użytkownika, co daje łącznie 5,149.59 tok/s i 3.42 ms czasu przetwarzania (TPOT), podczas gdy BS=16 zapewnia 200.69 tok/s na użytkownika, co daje łącznie 7,765.73 tok/s i 3.77 ms czasu przetwarzania (TPOT). Model nadal skaluje się do BS=32 (168.34 tok/s na użytkownika, łącznie 12 411,72 tok/s) i BS=64 (123.96 tok/s na użytkownika, łącznie 16 931,47 tok/s).
Całkowita przepustowość występuje przy BS=256, osiągając łączną wartość 38 258,50 tok/s, przy 65.08 tok/s na użytkownika i TPOT 9.39 ms. Stanowi to 40.5-krotny wzrost całkowitej przepustowości w porównaniu z wydajnością pojedynczego użytkownika. Wartości TPOT utrzymują się w zakresie 3-5 ms do BS=32. Granica Pareto obejmuje osiem odrębnych punktów.
Wydajność GPT-OSS-120B
Większy model o parametrach 120B utrzymuje następującą wydajność pomimo zwiększonej liczby parametrów. Przy współbieżności pojedynczego użytkownika (BS=1) osiąga 248.62 tok/s na użytkownika, całkowitą przepustowość 783.73 tok/s i czas TPOT 3.89 ms. Przy BS=2 model zapewnia 240.99 tok/s na użytkownika, całkowitą przepustowość 1,092.91 tok/s i czas TPOT 3.99 ms.
Wydajność nadal rośnie wraz ze wzrostem wielkości partii: BS=4 osiąga 190.63 tok/s na użytkownika, co daje łącznie 2,096.73 tok/s i TPOT 4.22 ms, podczas gdy BS=8 zapewnia 172.66 tok/s na użytkownika, co daje łącznie 3,692.10 tok/s i TPOT 4.54 ms. Skalowanie poprzez BS=16 (138.28 tok/s na użytkownika, łącznie 5,751.41 tok/s), BS=32 (111.63 tok/s na użytkownika, łącznie 8,646.05 tok/s) i BS=64 (88.64 tok/s na użytkownika, łącznie 13 027,97 tok/s) pokazuje stały wzrost przepustowości.
Model osiąga maksymalną całkowitą przepustowość przy BS=256, dostarczając 29 976,99 tok/s, przy 48.64 tok/s na użytkownika i TPOT wynoszącym 12.53 ms. Oznacza to 38.2-krotny wzrost całkowitej przepustowości w porównaniu z wydajnością pojedynczego użytkownika. Maksymalna całkowita przepustowość stanowi około 78% szczytowej przepustowości modelu 20B. Granica Pareto obejmuje dziewięć odrębnych punktów, najwięcej spośród wszystkich testowanych modeli.
Nieoczekiwana wydajność modelu kwantowego
Wyniki uzyskane dla modeli kwantyzowanych były nieoczekiwane i wymagają dalszych badań. W kilku przypadkach skwantyzowane wersje modeli NVFP4 i FP8 nie osiągnęły oczekiwanej poprawy wydajności w porównaniu z ich odpowiednikami o natywnej precyzji. Na przykład, model Llama 3.1 8B FP4 osiągnął jedynie 830.46 tok/s całkowitej przepustowości przy BS=1, w porównaniu z 1,727.62 tok/s dla wariantu o standardowej precyzji, pomimo podobnej przepustowości na użytkownika. Przy większych rozmiarach wsadów, podczas gdy modele kwantyzowane zbliżały się do przepustowości o standardowej precyzji (29.2 tys.–29.3 tys. tok/s w porównaniu z 32.8 tys. tok/s przy BS=256), ogólne wyniki sugerują, że obecna implementacja vLLM może nie być w pełni zoptymalizowana pod kątem Blackwell.
Zamierzamy przeprowadzić dodatkowe testy vLLM i porównać je z TensorRT-LLM, aby sprawdzić, jakiej wydajności mogą oczekiwać już dziś użytkownicy końcowi.
Supermicro JumpStart zmienia zasady gry w PoC AI
Program JumpStart firmy Supermicro zapewnia to, co obiecuje: prawdziwy, nieograniczony dostęp do sprzętu klasy produkcyjnej bez logistyki, opóźnień w dostawach i kosztów laboratoryjnych, które wiążą się z tradycyjnym testem PoC. Nasz tydzień JumpStart na platformie X14 HGX B200 rozpoczął się szybko, przebiegł bezproblemowo i pozwolił nam ocenić wydajność w taki sam sposób, jak w przypadku sprzętu w naszych własnych szafach.
W przypadku organizacji podejmujących szybkie decyzje dotyczące infrastruktury AI, taki dostęp do platformy może skrócić tygodnie planowania do dni. Jeśli celem jest sprawdzenie przepustowości GPU, zachowania pamięci masowej, wydajności modelu lub po prostu potwierdzenie zgodności stosu, JumpStart pozwala uzyskać odpowiedzi z minimalnym oporem. To podejście do oceny sprzętu oparte na zaufaniu i chcielibyśmy, aby więcej dostawców je wdrożyło.



 Amazon