

Vi har tittat på ett par GB300 DGX-stationer nu, och nyligen hade vi två av dem fysiskt i vårt labb samtidigt: ASUS ExpertCenter Pro ET900N G3 och HP ZGX Fury AI-station . Med båda tornen bredvid varandra ville vi ansluta dem och se vad en andra GB300 skulle kunna bidra med till prestandan hos en enda maskin för mer koordinerade AI-arbetsbelastningar vid skrivbordet.
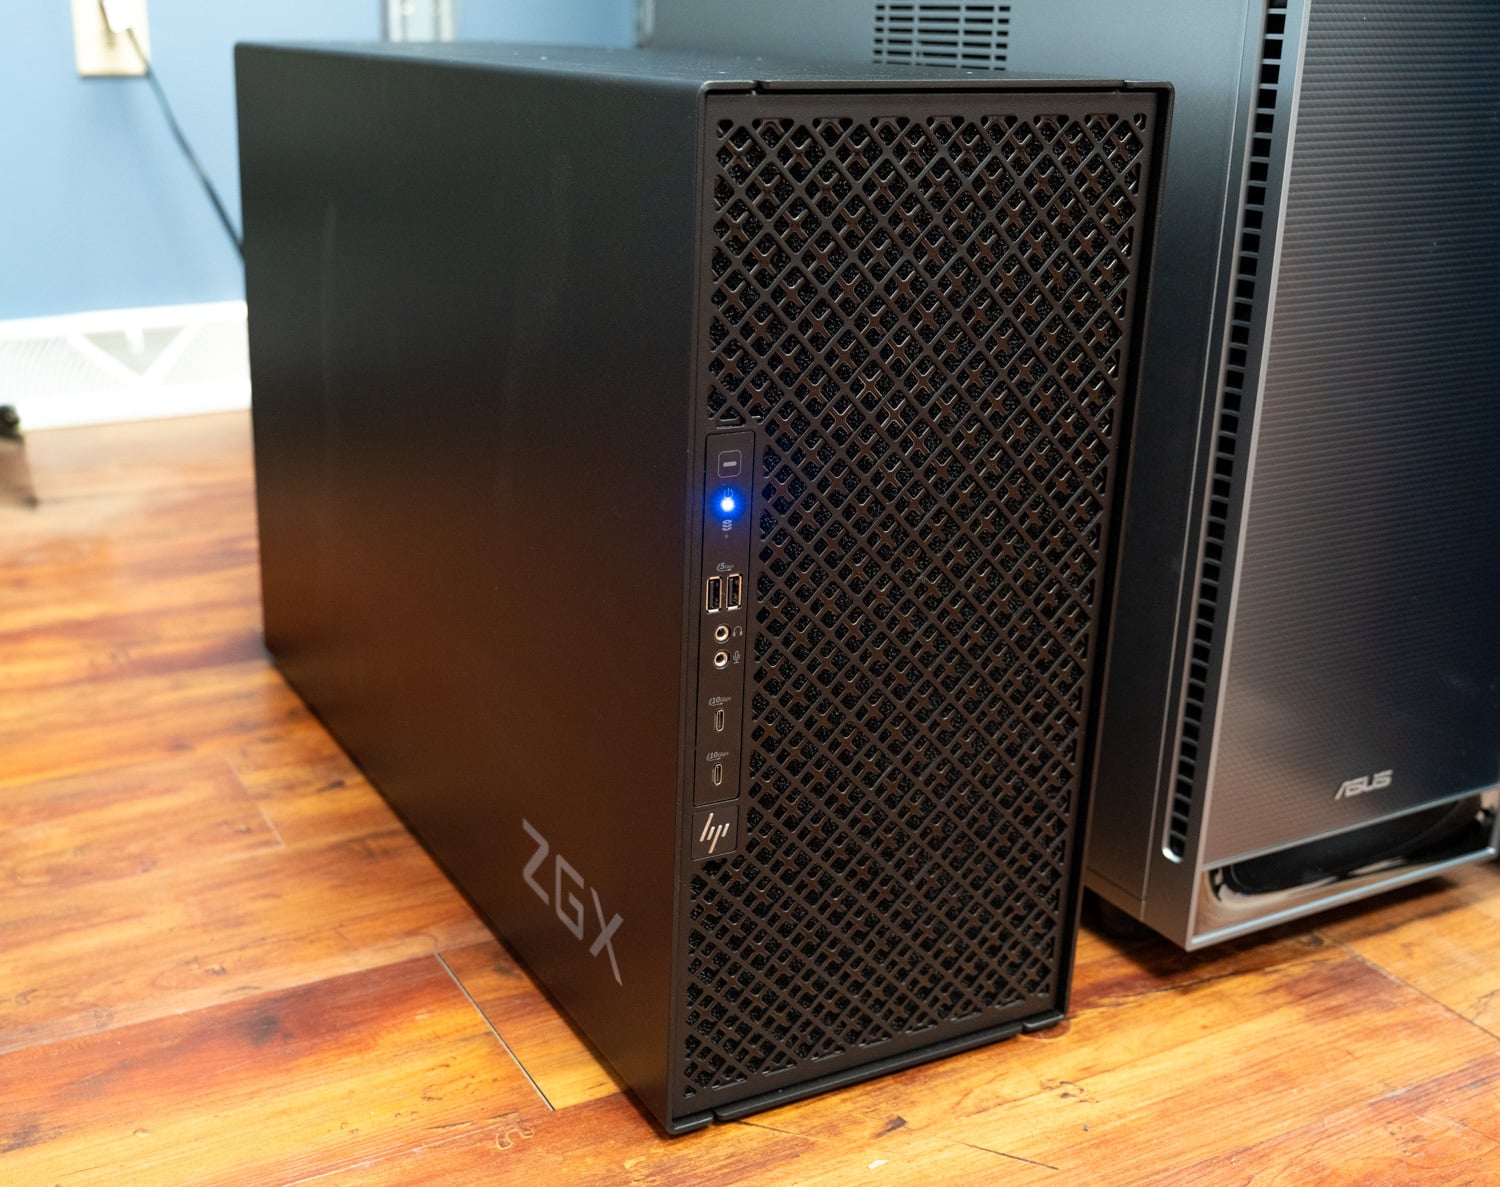
Att utöka en stationär dator med en dator i taget är ingen ny idé; NVIDIA presenterade detta uttryckligen med GB10-plattformen. En av de saker som gjorde DGX Spark så speciell var möjligheten att börja med ett system och ansluta fler allt eftersom arbetsbelastningen växte. GB300 börjar med betydligt högre prestanda, men att köra större modeller eller betjäna fler användare kan belasta även en av de snabbaste stationära datorerna vi har testat. Det var det vi ville säga i vår ursprungliga MSI-recension : om dina arbetsbelastningar motiverar en av dessa stationära datorer är det lätt att se hur de så småningom skulle kunna motivera flera.
För många köpare avgör kostnaden när expansionen blir praktisk. Att förstå hur väl två stationer fungerar tillsammans ger nu någon som börjar med en av dem en tydligare uppfattning om vad de kan vinna på att expandera senare.
Key Takeaways
- Två kablar, 98 % av linjehastigheten: Två 400G DAC:er mellan ConnectX-8-portarna på ASUS ET900N G3 och HP ZGX Fury gav NCCL 98 GB/s vid broadcast, reduce och send/reception jämfört med de 100 GB/s som paret klarar av, GPUDirect RDMA nådde 392 Gb/s på varje skena, och en 8-byte RDMA-skrivning var i genomsnitt 1.46 µs. NVIDIAs playbook hanterade installationen.
- GLM-5.2 vinner 11x vid matchad samtidighet: 433 GB NVFP4-kontrollpunkten lagrar cirka 215 GB expertvikter i Grace-minnet på en Station, som hanterade 139 utdatatokens per sekund vid 32 strömmar; fördelat på två B300:or i tensorparallell nådde den 1 525 vid 32 strömmar och 3 141 vid 256.
- GLM-5.3 går från 188 till 5 018 tokens per sekund: Den största ökningen i setet, 27x, kom från den andra modellen som har 252 GB HBM3e-lagring, där paret fortfarande klättrar med 256 strömmar på samma arbetsbelastning och håller nära 600 utdatatokens per sekund på 8 192-token-prompter, ungefär fem gånger så mycket som med ett enda torn.
- MiniMax-M3 långa uppmaningar stannar vid åtta strömmar på en station: Det enskilda tornet föll till 103 utdatatokens per sekund vid åtta strömmar när KV-cachen tog slut; paret levererade 736 vid samma tidpunkt, 7.1x, och fortsatte till 1 801 vid 256 strömmar.
- Modeller som passar får en andra kopia och en förifyllnings-/avkodningsdelning: Med en station på förfyllning och den andra på avkodning tredubblade GLM-5.3 Flash genomströmningen vid korta signaler vid 32 strömmar (828 till 2 721) och fördubblade genomströmningen vid långa signaler (1 219 till 2 448), och DeepSeek V4.1 Flash hade den högsta genomströmningen av alla testade modeller, 5 248 tokens per sekund vid 256 strömmar.
Nätverkande på DGX-stationen
Innan vi går in på klustret, låt oss sammanfatta nätverksfunktionerna som vi tog upp i vår MSI-recension. ConnectX-8 SuperNIC gör mer än att tillhandahålla nätverksanslutningen. Dess integrerade PCIe-switch hanterar också en del av Stationens interna I/O, som ansluter till Grace samt de 2x PCIe Gen 6 x4-lagringsplatserna.
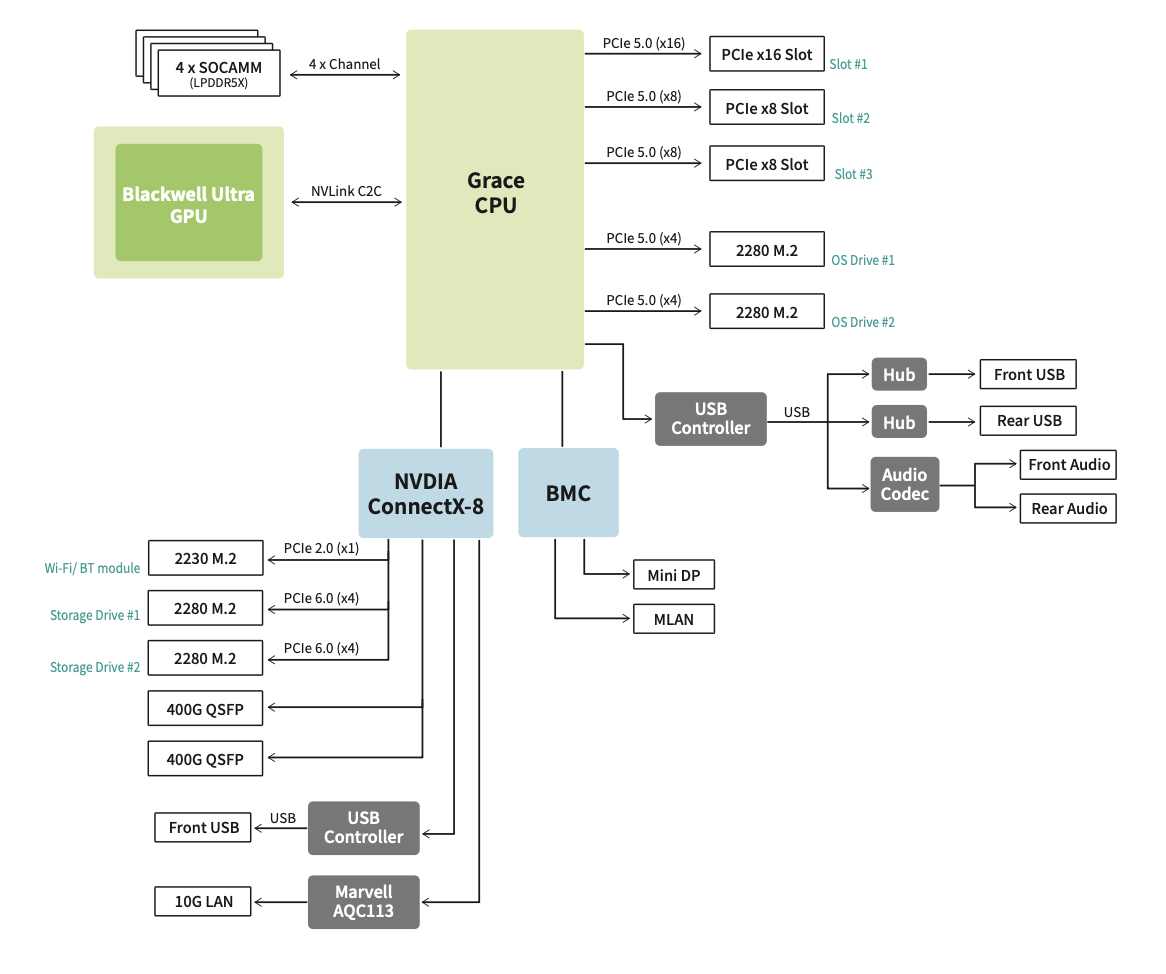
För själva nätverket exponerar systemet två QSFP112-portar med en hastighet på 400 Gb/s vardera, vilket ger 800 Gb/s aggregerad bandbredd för att ansluta stationer till varandra eller till ett större nätverk.
Jämfört med DGX Sparks implementering, som vi tog upp i vår ursprungliga DGX Spark-recension , var Sparks 400 Gb/s-klass ConnectX-7 mer kapabel än vad GB10:s PCIe-anslutning kunde utnyttja fullt ut. Styrenheten placerades bakom två separata PCIe 5.0 x4-länkar, vilket begränsade den användbara aggregerade nätverksgenomströmningen till cirka 200 Gb/s. Dess två fysiska portar framträdde också som fyra logiska Ethernet-gränssnitt i Linux. För att få full bandbredd krävdes mappning av dessa gränssnitt tillbaka till den anslutna buren, konfiguration av båda logiska gränssnitten bakom den och säkerställande av att RDMA-trafik kunde använda båda PCIe-vägarna.
Stationen ger oss ett enklare arrangemang, med två 400 Gb/s-portar som var och en kan fungera som en oberoende nätverksskena.
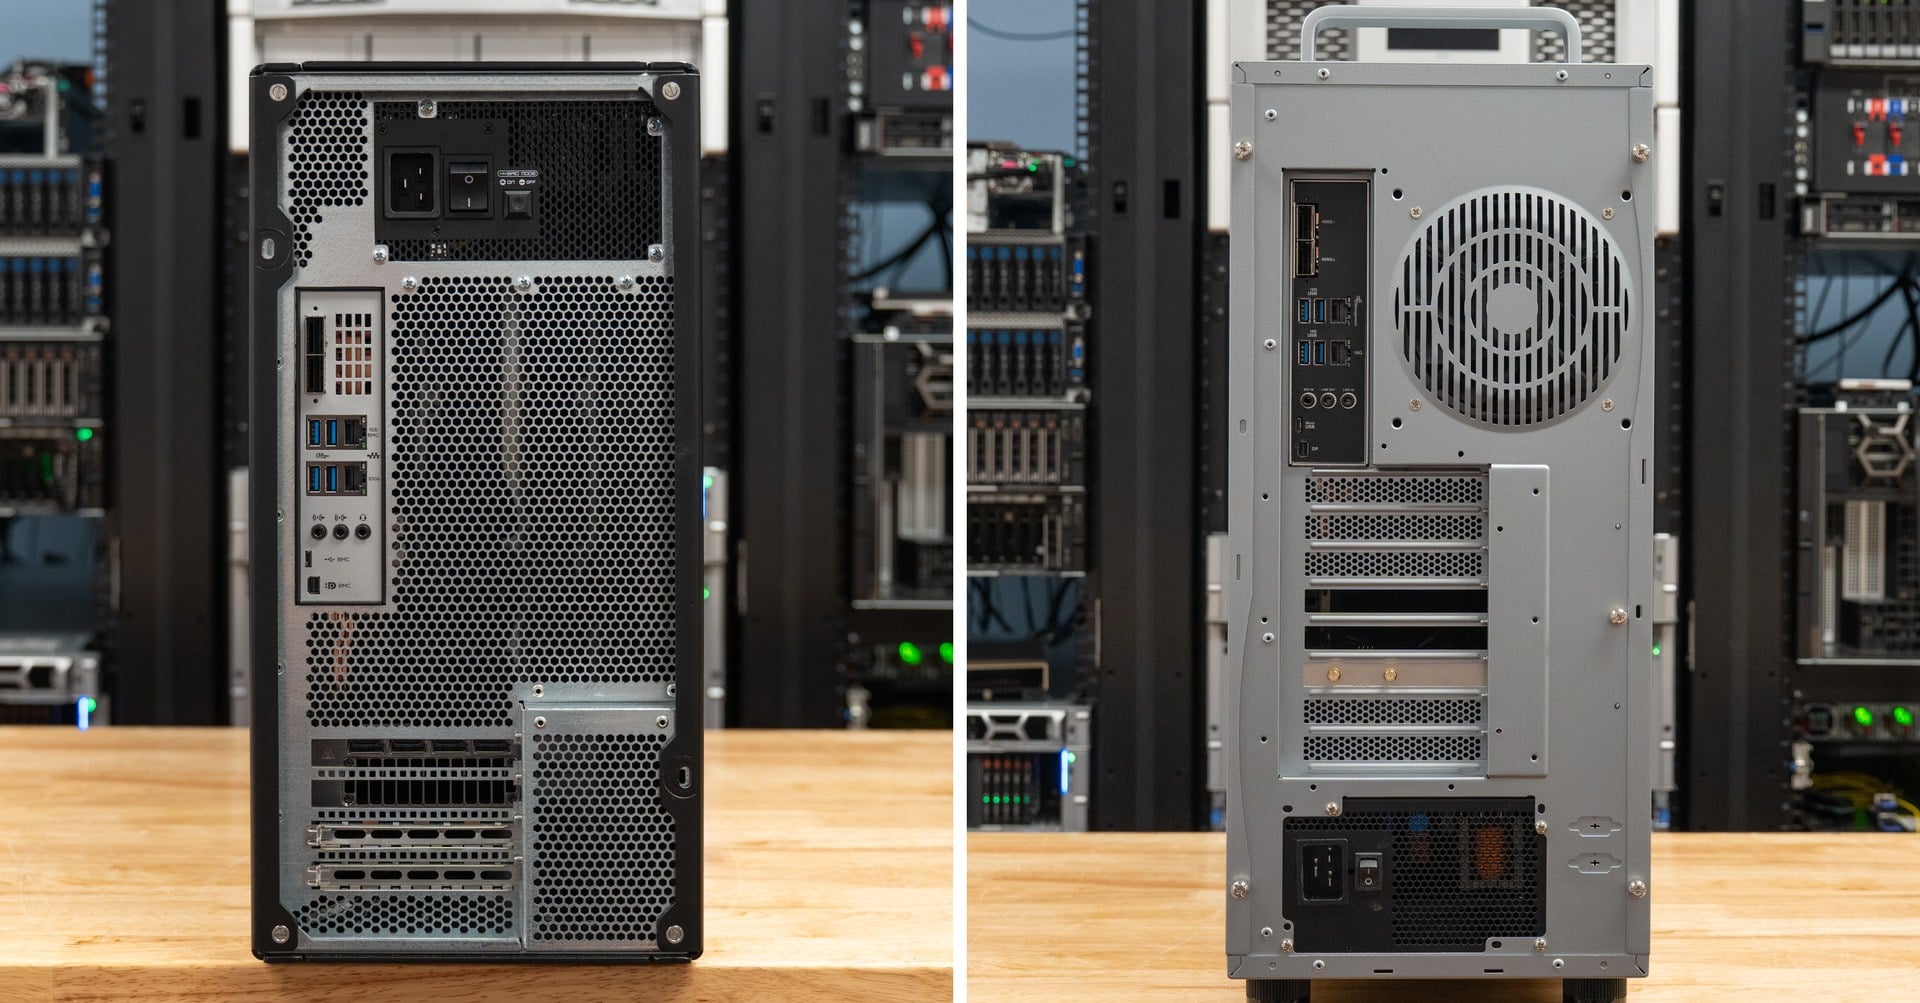
Att fyra gånger så mycket som Sparks användbara bandbredd kan nås genom ett par QSFP-burar ökar också kylbelastningen, och under våra tester hanterade alla enheter det. ConnectX-8 i sig är vätskekyld, och vissa leverantörer utökar den kylningen till QSFP-burarna, som MSI, medan andra system använder kylflänsar och dedikerade fläktar över burarna, vilket vi såg i vår ASUS-recension. Den kylningen är särskilt användbar för optiska moduler, som genererar mer värme än passiva DAC:er. Båda metoderna har fungerat bra i våra tester, och vi har inte stött på problem med kylningen av nätverket.
Ansluta två stationer
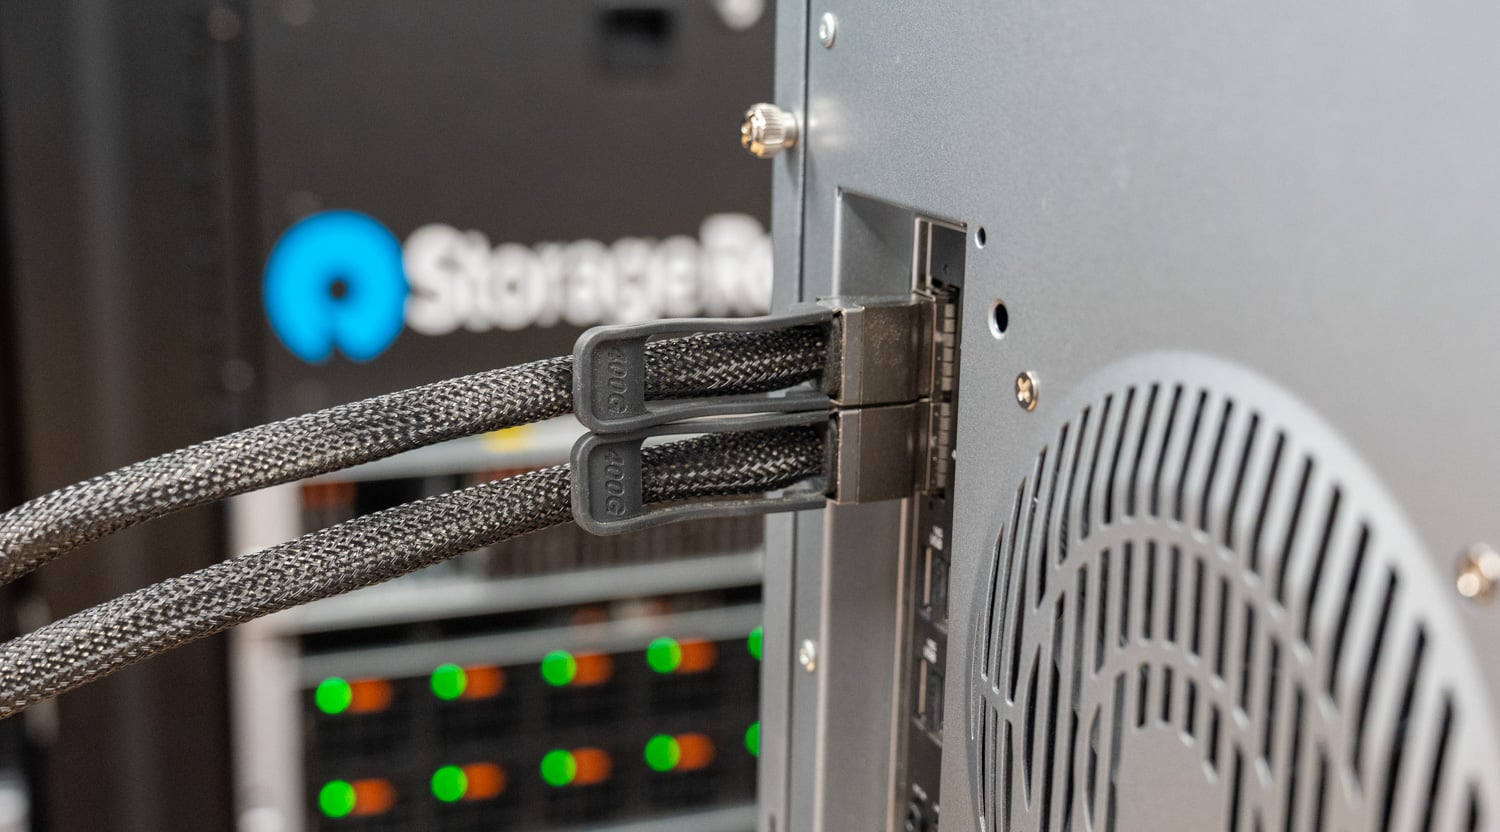
Att klustra två DGX-stationer var enkelt: vi kopplade ASUS och HP direkt med två 400G direktanslutna kopparkablar (DAC) mellan deras matchande QSFP112-portar, vilket gav oss två oberoende 400 Gb/s-anslutningar.
På mjukvarusidan tillhandahåller NVIDIA en steg-för-steg- guide för att klustra systemen, och instruktionerna var tillräckligt tydliga för att vi helt enkelt gav länken till Claude Code och lät dem hantera installationen. De konfigurerade nätverket mellan de två stationerna, körde NCCL-bandbreddstester och gav oss en rapport med resultaten.
Guiden är en numrerad playbook som körs från en tredje maskin och når båda stationerna via SSH. Portarna är kablade som matchande skenor, QSFP0 till QSFP0 och QSFP1 till QSFP1, och varje skena blir sin egen punkt-till-punkt RoCEv2-länk: skripten öppnar de två ConnectX-8-gränssnitten vid en 9 000-byte MTU, ger varje skena en egen privat /24 och tillämpar RoCE- och GPUDirect-körtidsinställningarna.
En validering bekräftar sedan att båda länkarna tränats vid 400G, att jumbo-pings korsar varje skena, och att de två RDMA-enheterna, mlx5_0 och mlx5_1, rapporterar aktiva, och en ib_write_bw-körning på varje skena bevisar att tyget flyttar RDMA-trafik och inte bara pings. Därefter pekas NCCL mot båda skenorna med NCCL_IB_HCA=mlx5_0,mlx5_1, och jobbet startas som vilken annan tvånodskörning som helst. Resultaten nedan kom från den sekvensen.
Den första tabellen är från nccl-tests, kollektiven, en distribuerad inferens eller träningsjobbproblem, som körs över de två B300:orna med båda skenorna i bruk. Med en GPU per station kommer varje kollektiv att bero på att de två GPU:erna utbyter data över paret av 400G-länkar, så bussbandbredds-kolumnen läser direkt mot de 100 GB/s (800 Gb/s) som de två kablarna tillhandahåller. Toppen är det bästa resultatet över meddelandestorlekar; 16 GiB-kolumnen är det största testade meddelandet, där bandbredden har stabiliserats.
| Drift | Toppstorlek | Toppbussbandbredd | Bussbandbredd vid 16 GiB |
|---|---|---|---|
| All-reduce | 1 GiB | 92.242 GB / s | 91.346 GB / s |
| All-samla | 16 GiB | 87.893 GB / s | 87.893 GB / s |
| Minska spridningen | 2 GiB | 93.930 GB / s | 92.905 GB / s |
| Broadcast | 16 GiB | 97.975 GB / s | 97.975 GB / s |
| Minska | 16 GiB | 97.978 GB / s | 97.978 GB / s |
| Allt-mot-allt | 8 GiB | 80.522 GB / s | 80.512 GB / s |
| Skicka/ta emot, enkelriktad | 16 GiB | 97.953 GB / s | 97.953 GB / s |
| Skicka/ta emot, dubbelriktad | 16 GiB | 83.748 GB/s per riktning | 167.496 GB/s totalt |
Sändning, sänkning och enkelriktad sändning/mottagning nådde alla 98 GB/s, 98 % av vad de två kablarna klarar av. Mönstren med data som rör sig i båda riktningarna samtidigt landade lägre, 92 GB/s för alla-sänkningar och 80 GB/s för alla-till-alla. Resultatet för dubbelriktad sändning/mottagning är referenspunkten för dessa: med båda grafikkorten som sänder samtidigt, landade varje riktning på 84 GB/s, 167 GB/s totalt över länken.
Den andra tabellen sjunker under NCCL till den råa RDMA-sökvägen, med ib_write_bw en skena i taget. GPUDirect-raderna skriver 1 MiB-överföringar från en B300:s HBM till den andra, medan nätverkskortet läser och skriver GPU-minne direkt; båda skenorna når 392 Gb/s, 98 % av linjehastigheten. Värdminnesraderna är guidens grundläggande röktest, ett enda köpar som hämtar källa från Grace-minne, vilket NVIDIAs playbook hanterar till 220 till 230 Gb/s på en 400G-skena; vi såg 228 Gb/s. Latensraden är en 8-byte-skrivning: 1.46 µs i genomsnitt.
| Testa | Bandbredd | Länkanvändning |
|---|---|---|
| GPUDirect RDMA, GPU-minne, ib_write_bw, 1 MiB-överföringar | ||
| Skena 0 | 392.15 Gb / s | 98.04% |
| Skena 1 | 392.15 Gb / s | 98.04% |
| Värdminnes-RDMA, båda skenorna | ||
| RDMA-skrivning, enkelriktad | 228.15 Gb / s | |
| RDMA-läsning, enkelriktad | 228.23 Gb / s | |
| RDMA-sändning, enkelriktad | 228.16 Gb / s | |
| RDMA-skrivning, dubbelriktad | 447.10 Gb/s aggregerat | |
| RDMA-skrivfördröjning, 8 byte | 1.46 µs i genomsnitt; 1.63 och 1.66 µs i den 99:e percentilen med järnväg | |
Hur vi testade klustret
Tiden med paret var begränsad, så vi fokuserade på inferens, den mest populära AI-arbetsbelastningen idag. Vi planerar att utöka detta arbete till större kluster. I den här artikeln koncentrerade vi oss på större modeller och jämförde en enda station med två stationer med hjälp av tensorparallellism (TP) och prefill/decode (PD) disaggregering.
Tensorparallellism delar upp vikttensorerna och beräkningarna inom modellen över flera GPU:er. I vår tvåstationskonfiguration, eller TP2, innehåller varje B300 en del av modellen, och båda arbetar på varje begäran. Det ger oss mer högbandbreddsminne (HBM) att placera vikterna i, tillsammans med mer beräkningskraft för att köra dem. Det kräver också att GPU:erna utbyter mellanliggande resultat och synkroniserar via NCCL under hela inferensen, så kommunikationsoverhead blir en del av kostnaden för att köra modellen.
Disaggregerad inferens tilldelar förfyllnings- och avkodningsstegen i en begäran till separata arbetare. Förfyllning bearbetar inmatningsprompten och bygger nyckel/värde-cachen (KV), det uppmärksamhetstillstånd som modellen återanvänder under genereringen. Avkodning använder sedan det tillståndet för att generera utdatatokens en i taget. De två stegen har olika bearbetningskrav: förfyllning är beräkningskrävande, medan avkodning är minnesbandbreddsintensiv. I större uppsättningar tillåter disaggregerad inferens som denna operatören att oberoende skala dessa arbetare efter behov, vilket vår KV-cache-avlastningsartikel visade.
I en konfiguration med en enda nod, när båda faserna delar en arbetare, kan vLLM sammanfoga förfyllningsarbete för inkommande prompter med avkodningsarbetet för förfrågningar som redan pågår. Den promptbearbetningen kan öka tiden mellan utgående tokens. I vår PD-konfiguration hanterar en station förfyllning och överför förfrågningens KV-cache till den andra stationen, som hanterar avkodning. Varje arbetare har tillgång till sin egen kopia av modellen, inklusive all data som placerats i Grace-minnet. Avkodningsarbetaren behöver inte längre schemalägga ny promptbearbetning tillsammans med tokengenerering, vilket påskyndar inferensgenomströmningen.
För våra tester styrde modellens minneskrav vilken metod vi använde. För de största kontrollpunkterna, där en enskild station var tvungen att avlasta en betydande mängd modellvikter till Grace-minnet, gav TP oss bäst prestanda. Att sprida vikterna över två GPU:er gjorde att mer av modellen kunde stanna kvar i HBM och minskade avlastningsstraffet. För modeller som passar rimligt bra på en station, antingen helt i HBM eller med begränsad avlastning till Grace, använde vi PD-disaggregation. Det inkluderade DeepSeek V4.1 Flash, med dess Engram-uppslagstabeller placerade i Grace DRAM.
För att bibehålla jämförbarheten med vår äldre täckning behöll vi vår äldre metod med fasta inmatningssekvenslängder (ISL) och utmatningssekvenslängder (OSL). Den lika stora arbetsbelastningen använder 512 inmatningstokens och 512 utmatningstokens, medan den förfyllningstunga arbetsbelastningen använder 8 192 inmatningstokens och 1 024 utmatningstokens. Vi varierar antalet samtidiga förfrågningar samtidigt som vi håller dessa sekvenslängder fasta.
Baslinjen för en enda station i varje diagram är ASUS ET900N G3 från vår recension, svept till 32 strömmar; körningarna för två stationer går till 256. Varje punkt är en enda passning, så en dipp på en samtidighetsnivå rapporteras som insamlad.
Inferenskonfiguration
| Modell | Klusterläge | Mjukvara | Spekulativ avkodning | Nådminne |
|---|---|---|---|---|
| DeepSeek V4.1 Flash (FP8) | Förifyllnings-/avkodningsuppdelning, fullständig kopia per station | vllm/vllm-openai:deepseekv41-flash-0909 | Modellens egen draftare, fixade 5 tokens | Två FP8 Engram-tabeller (188.84 GiB) fästa i Grace-minne plus 131.97 GB avlastade expertvikter, på varje station. |
| GLM-5.3 NVFP4 | Tensorparallell (TP2) | NVIDIA vLLM 26.08 NGC-behållare (vLLM 0.27.1) | MTP, fast 5-token-utkast | Ingen på klustret; 215 GB expertvikter avlastade på en enda station |
| GLM-5.3 Flash NVFP4 | Förfyllnings-/avkodningsuppdelning, ASUS förfyllning, HP-avkodning | vLLM 0.28.1 RC1 | MTP, fast 5-token-utkast | Ingen |
| GLM-5.2 NVFP4 | Tensorparallell (TP2) | NVIDIA vLLM 26.08 NGC-behållare (vLLM 0.27.1) | MTP, fast 3-token-utkast | Ingen på klustret; cirka 215 GB expertvikter avlastas på en enda station |
| MiniMax-M3 NVFP4 | Tensorparallell (TP2) | NVIDIA vLLM 26.08 NGC-behållare (vLLM 0.27.1) | EAGLE3, fixat 3-token-utkast | Ingen i klustret; en del experter avlastade på en enda station |
Inferensprestanda
DeepSeek V4.1 Flash
DeepSeek V4.1 Flash kördes disaggregerat, där en Station hanterade förfyllning och den andra avkodning, där varje Station innehöll en fullständig kopia av modellen: de två FP8 Engram-tabellerna, totalt 188.84 GiB, fästa i Grace-minne och ytterligare 131.97 GB expertvikter avlastade till Grace. Det gör den till den enda konfigurationen i setet med Grace-minne i spel på båda maskinerna. Det är också den enda modellen här utan en single-Station-linje, eftersom ASUS-recensionen körde den tidigare V4 Flash-kontrollpunkten och de två inte är direkt jämförbara.
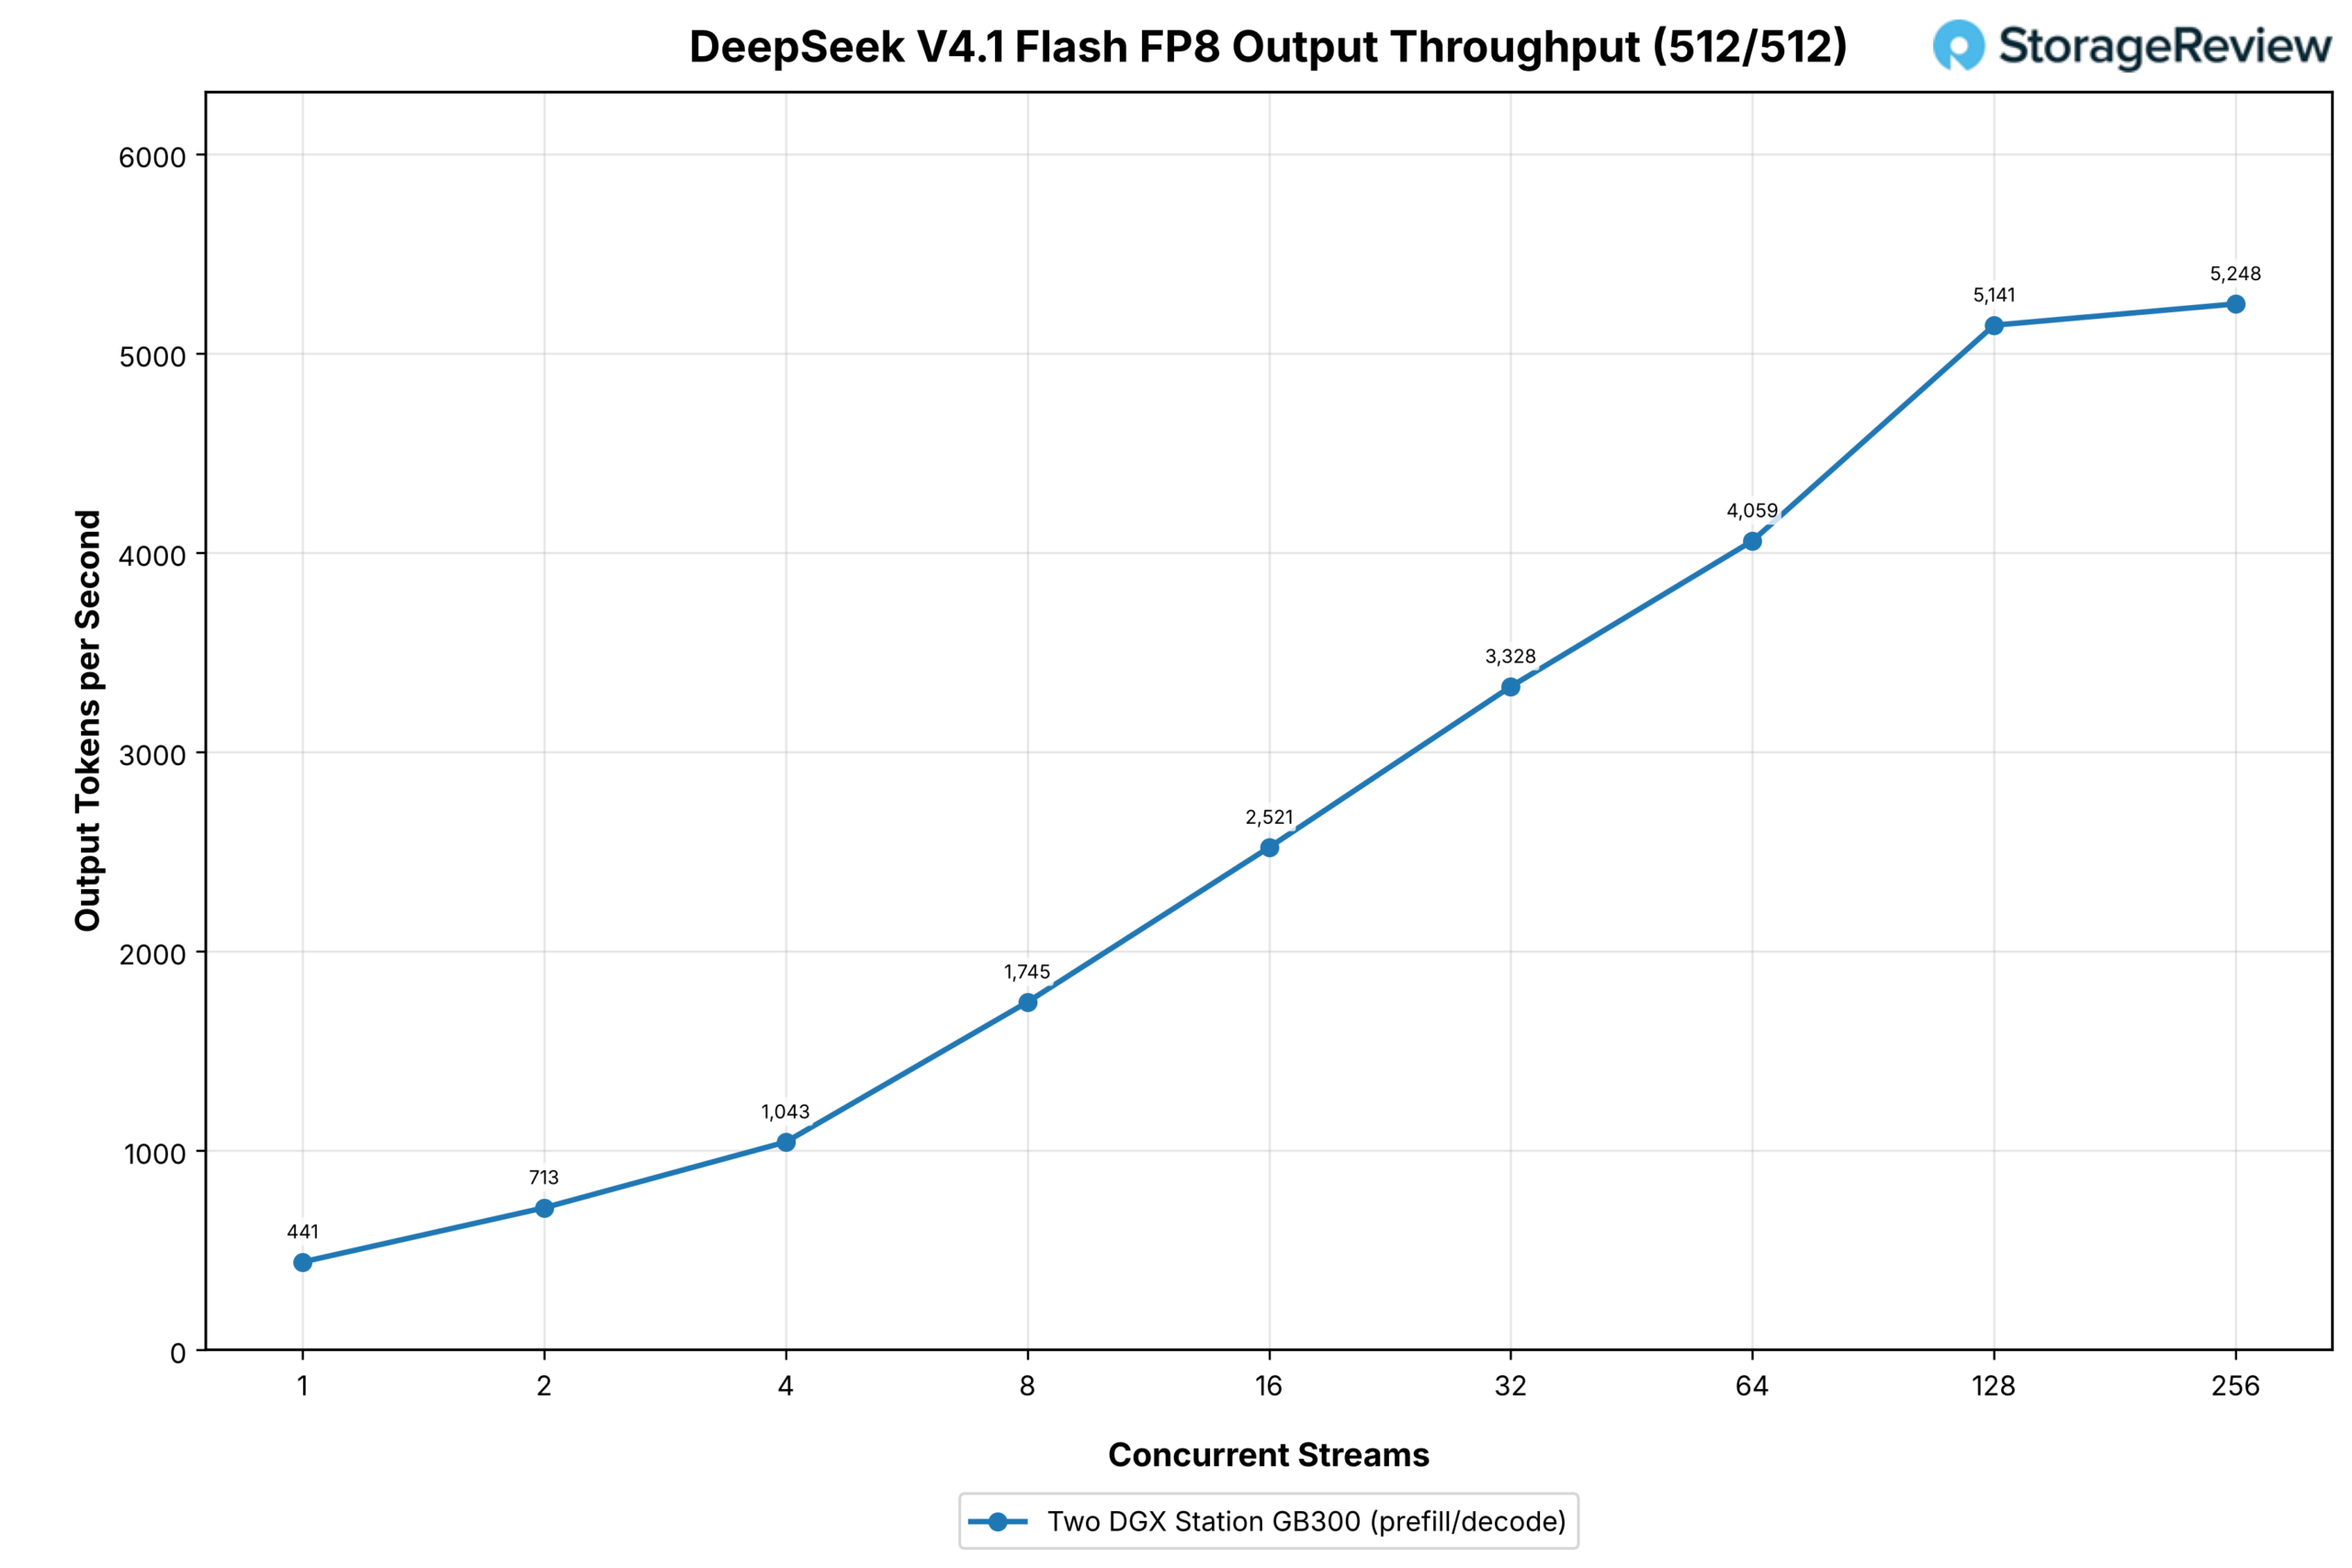
På klustret med två stationer gick den inbyggda FP8-modellen från 441 utdatatokens per sekund vid en ström till 3 328 vid 32, 5 141 vid 128 och 5 248 vid 256, den högsta utdatakapaciteten av alla modeller i den här uppsättningen, med kurvan som endast plattades ut högst upp i svepområdet. Som referens levererade den enskilda ASUS Stationen V4 Flash med 1 766 utdatatokens per sekund vid 32 strömmar i vår recension.
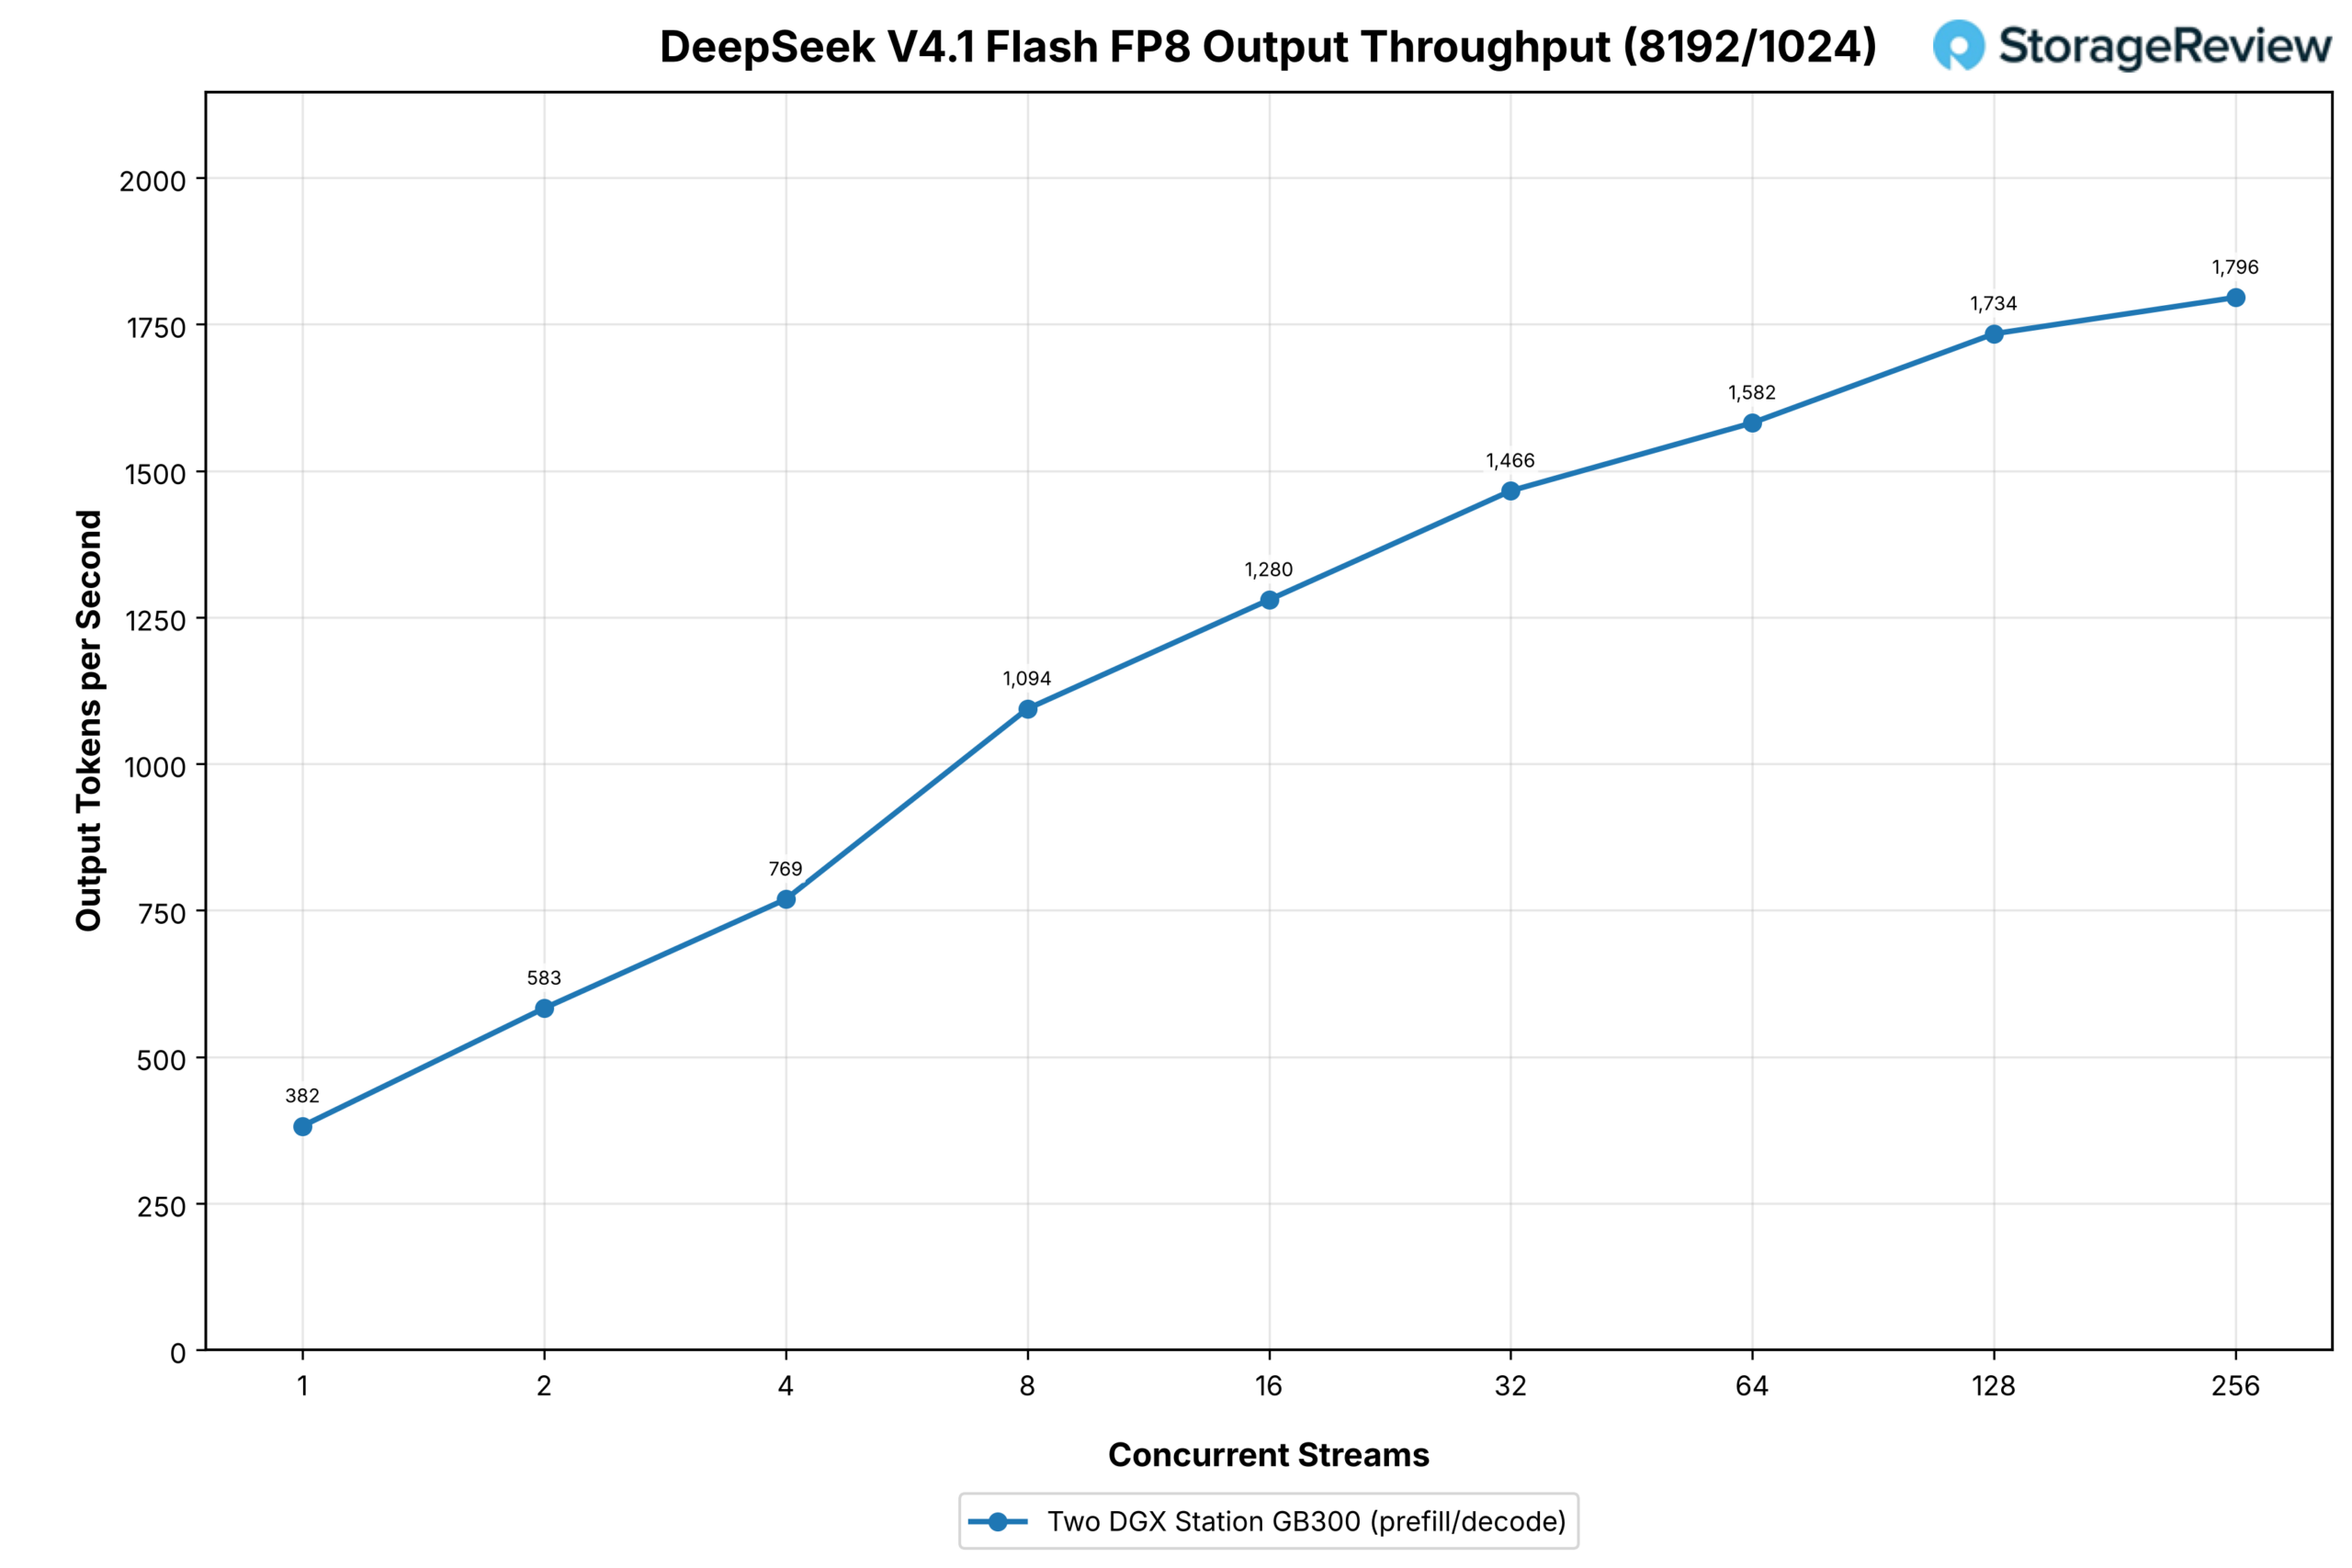
På den förfyllningstunga profilen gick klustret från 382 utdatatokens per sekund vid en ström till 1 466 vid 32 och 1 796 vid 256, och eftersom varje begäran bär 8 192 indatatokens nådde den totala dataflödet 16 163 tokens per sekund högst upp i svepet. Med Engram-tabellerna och 131.97 GB expertvikter i Grace-minnet på varje Station förblir kurvorna släta över hela svepet oavsett.
GLM-5.3
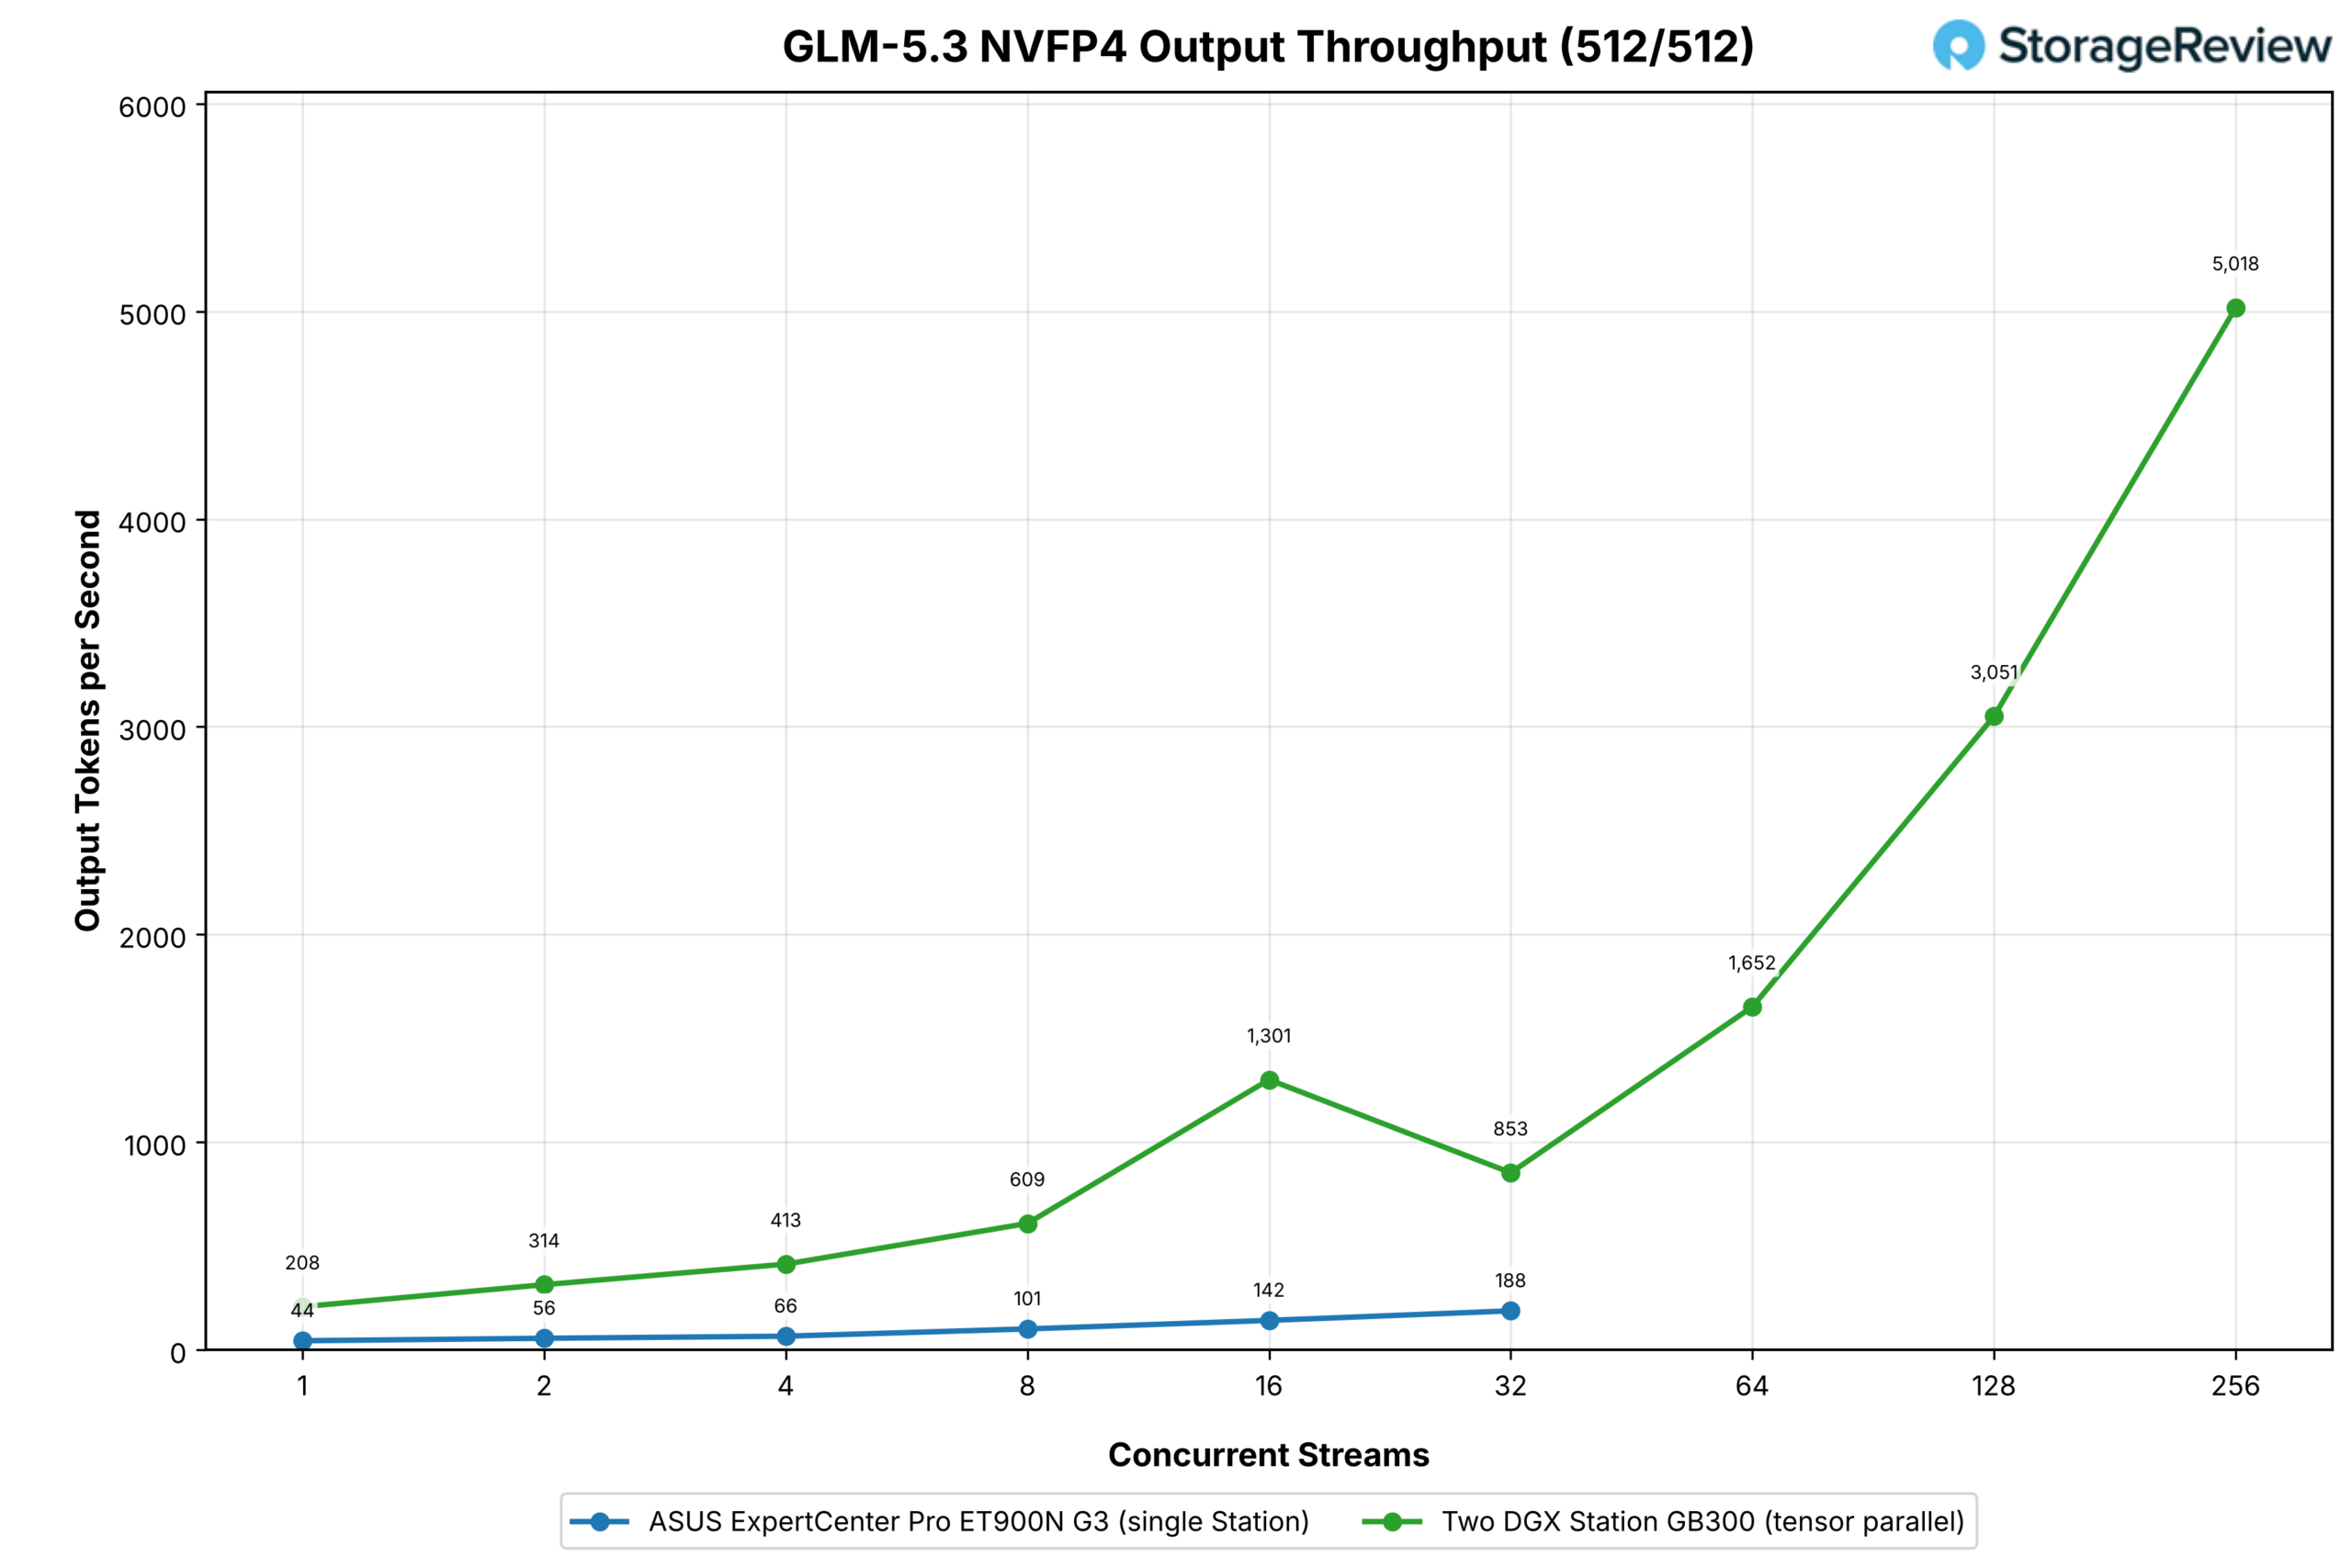
GLM-5.3 kördes i TP2 utan Grace-avlastning. På en enskild station avlastas 215 GB expertvikter till Grace-minnet, och klusterresultatet följer GLM-5.2 genom större delen av svepningen innan det blir ojämnt. En station körde från 44 utdatatokens per sekund vid en ström till 188 vid 32 på samma arbetsbelastning.
Klustret med två stationer gick från 208 vid en ström till 1 301 vid 16, mellan 4.7x och 9.2x det enskilda tornet, föll till 853 vid 32, och återupptog sedan klättringen till 1 652 vid 64, 3 051 vid 128 och 5 018 vid 256. Punkten med 32 strömmar finns i insamlad data; batchbeslut och kärnval ändras båda när samtidigheten ökar, och en tensorparallell distribution lägger till ett kollektiv på varje lager som måste slutföras innan nästa steg, så kurvan är inte en rak linje, men taket vid 256 strömmar är 27x vad en station nådde vid 32.
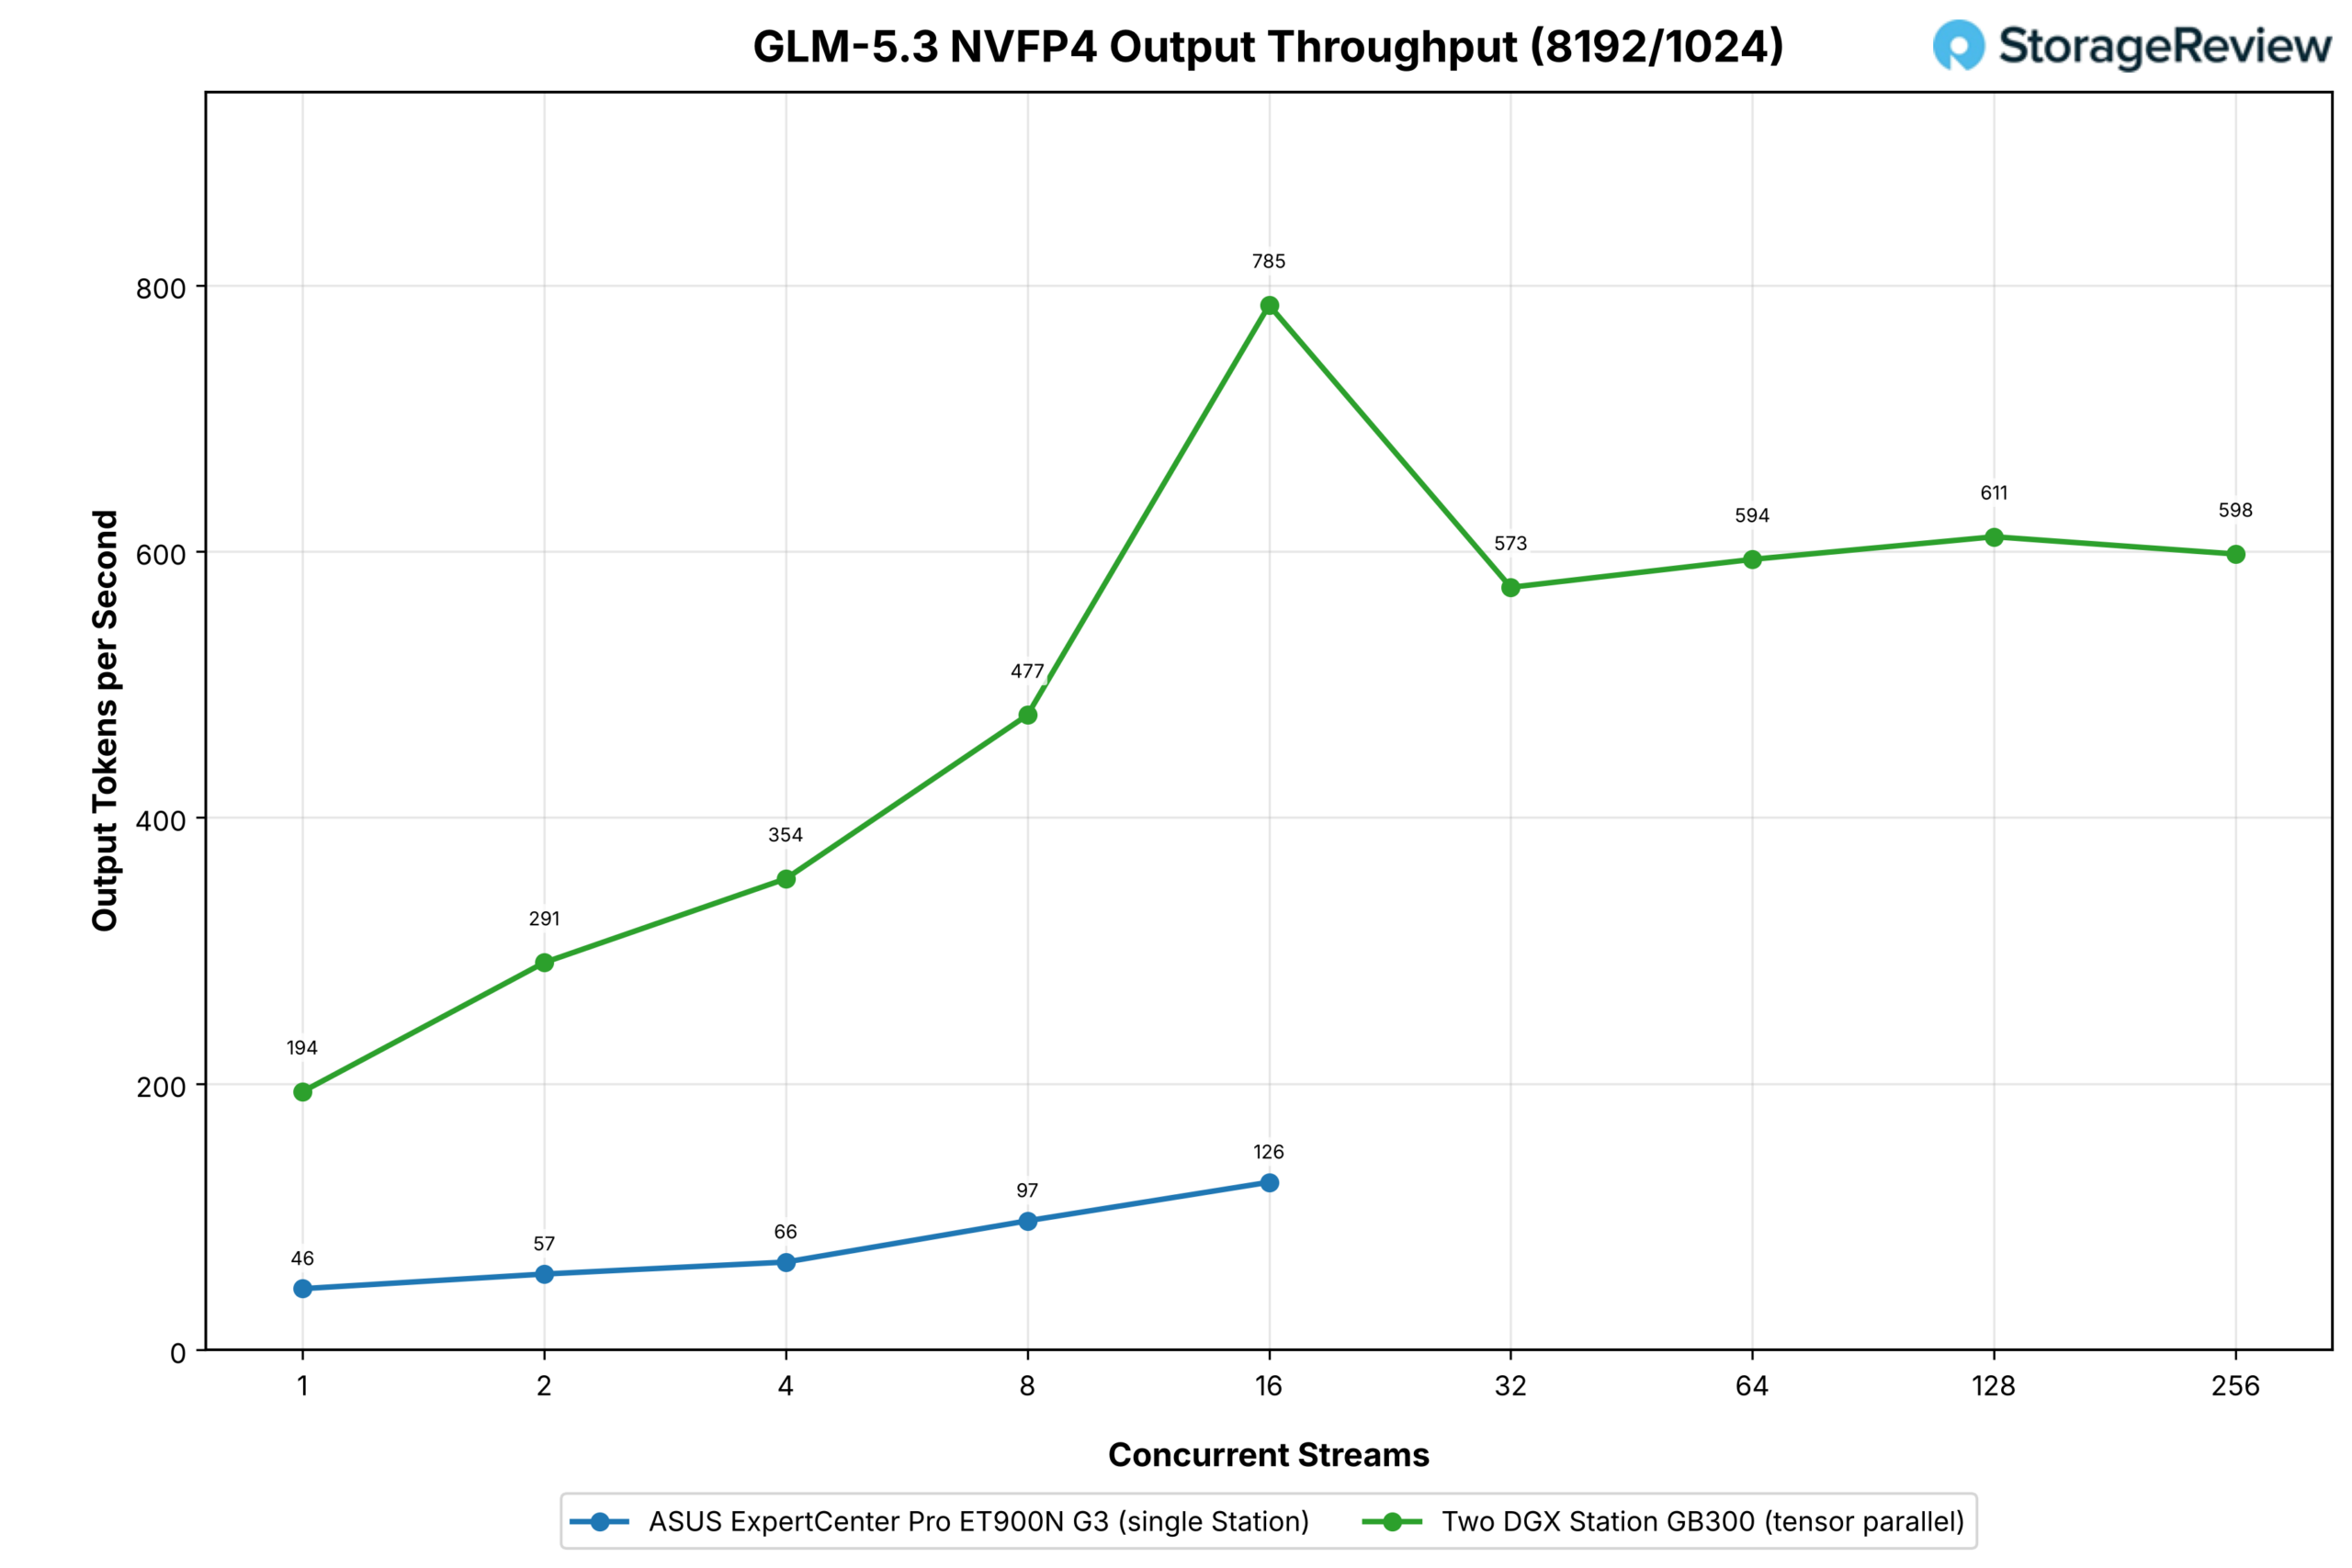
På den prefill-tunga profilen stannade den enskilda Stationen vid 16 strömmar, avsiktligt: en offloaded-modell planar ut tidigt, och det finns lite att lära sig av att driva samtidighet ytterligare. Den gick från 46 utdatatokens per sekund vid en ström till 126 vid 16. Klustret gick från 194 till 785 över samma intervall, 6.2x högst upp, och stabiliserades sedan mellan 573 och 611 från 32 strömmar till 256, ett långtidstak nära 600 utdatatokens per sekund som fortfarande är ungefär fem gånger den enskilda Stationens bästa.
GLM-5.3 Blixt
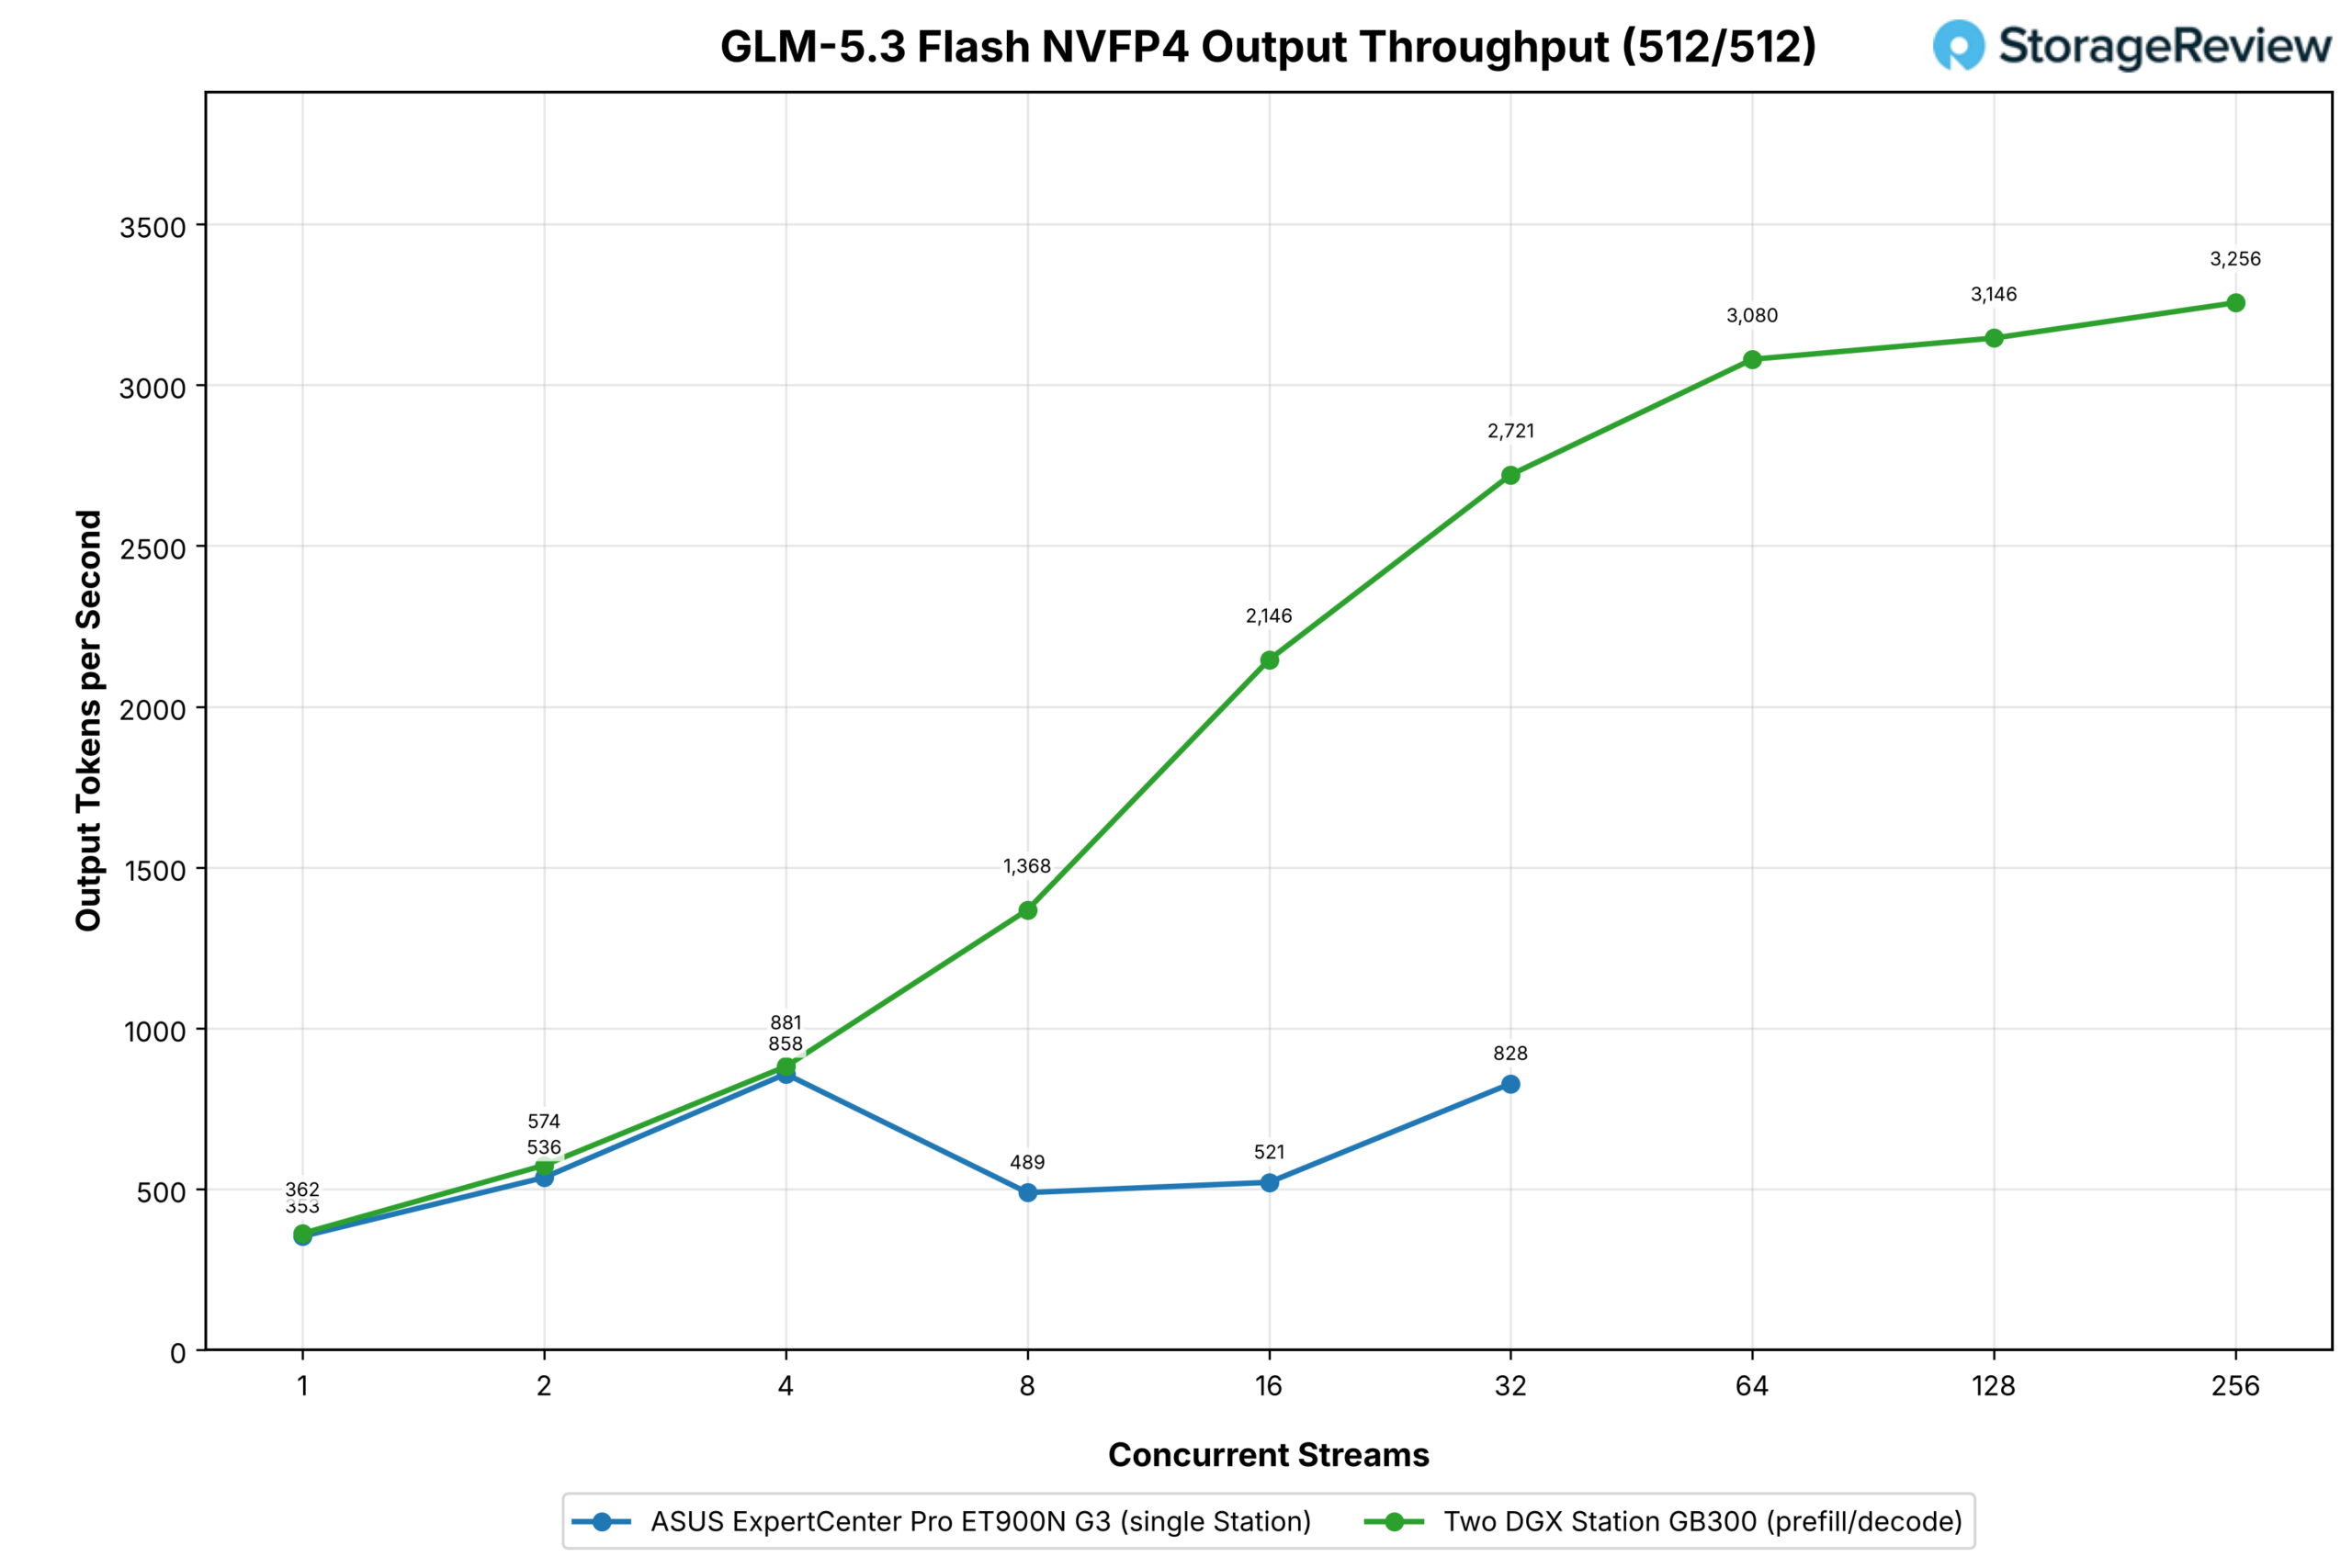
GLM-5.3 Flash är tillräckligt liten för att varje Station ska kunna lagra en fullständig kopia, så den kördes disaggregerad, med ASUS hanteringsförfyllning och HP hanteringsavkodning. Flash har ett litet antal aktiva parametrar, så på en enda Station körs den redan snabbt: 353 utdatatokens per sekund vid en ström och 828 vid 32 på samma arbetsbelastning, med en ojämn mitten (858 vid fyra strömmar, 489 vid åtta) som vi rapporterar som insamlade.
På det disaggregerade paret varierade den lika stora arbetsbelastningen från 362 utdatatokens per sekund vid en ström till 2 721 vid 32, 3.3 gånger det enskilda tornet, och vidare till 3 256 vid 256 strömmar.
Vid en och två strömmar matchar paret en enda Station nästan exakt, vilket är vad man kan förvänta sig när avkodningsstationen gör samma arbete ensam; vinsten kommer när det finns tillräckligt med förfrågningar under färd för att förfyllningsstationen ska förbli upptagen och för att avkodningsstationen ska dra nytta av att aldrig pausa för förfyllning.
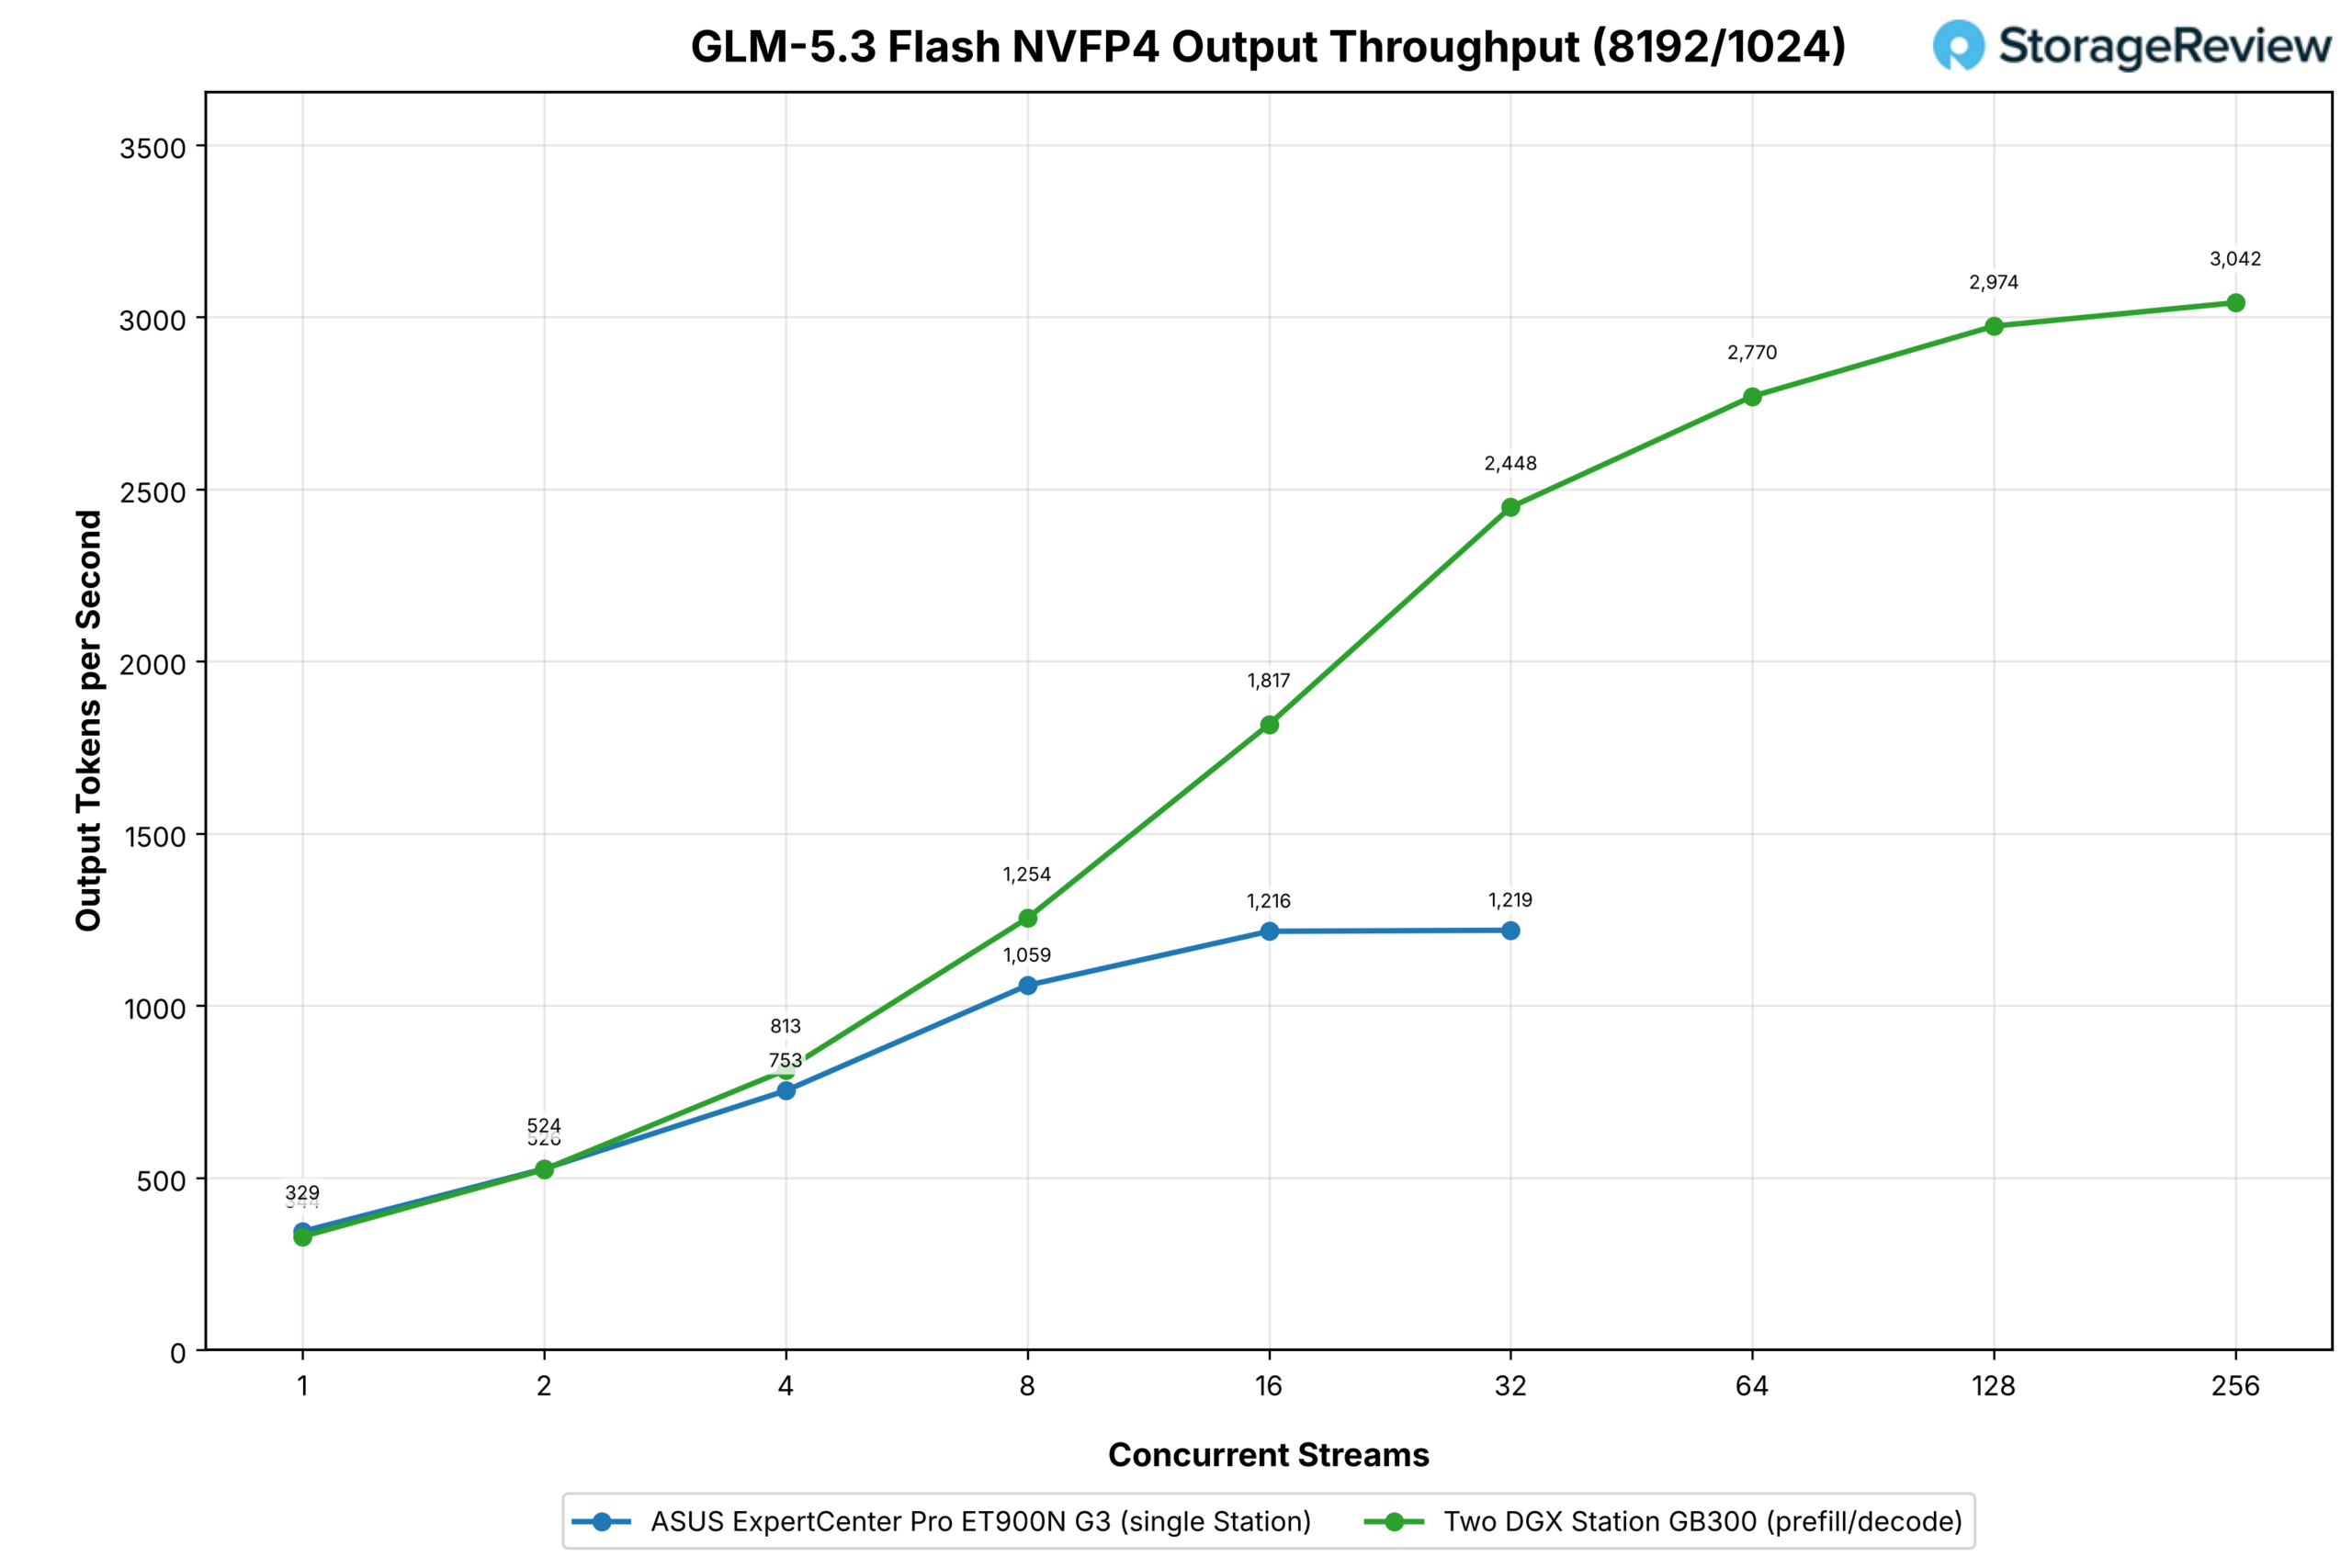
På den förfyllningstunga profilen klättrade den enskilda Stationen från 344 utdatatokens per sekund vid en ström till 1 216 vid 16 och höll 1 219 vid 32, oförändrat från 16 strömmar och framåt. Förfyllnings-/avkodningsparet fortsatte att klättra, från 329 vid en ström till 2 448 vid 32, dubbelt så mycket som den enskilda Stationen där den hade planat ut, och vidare till 3 042 vid 256. Långa prompter är fallet som denna uppdelning är byggd för, eftersom förfyllningsstationen absorberar prompterna med 8 192 tokens medan avkodningsstationens KV-cache och beräkningsförmåga förblir på generering.
GLM-5.2
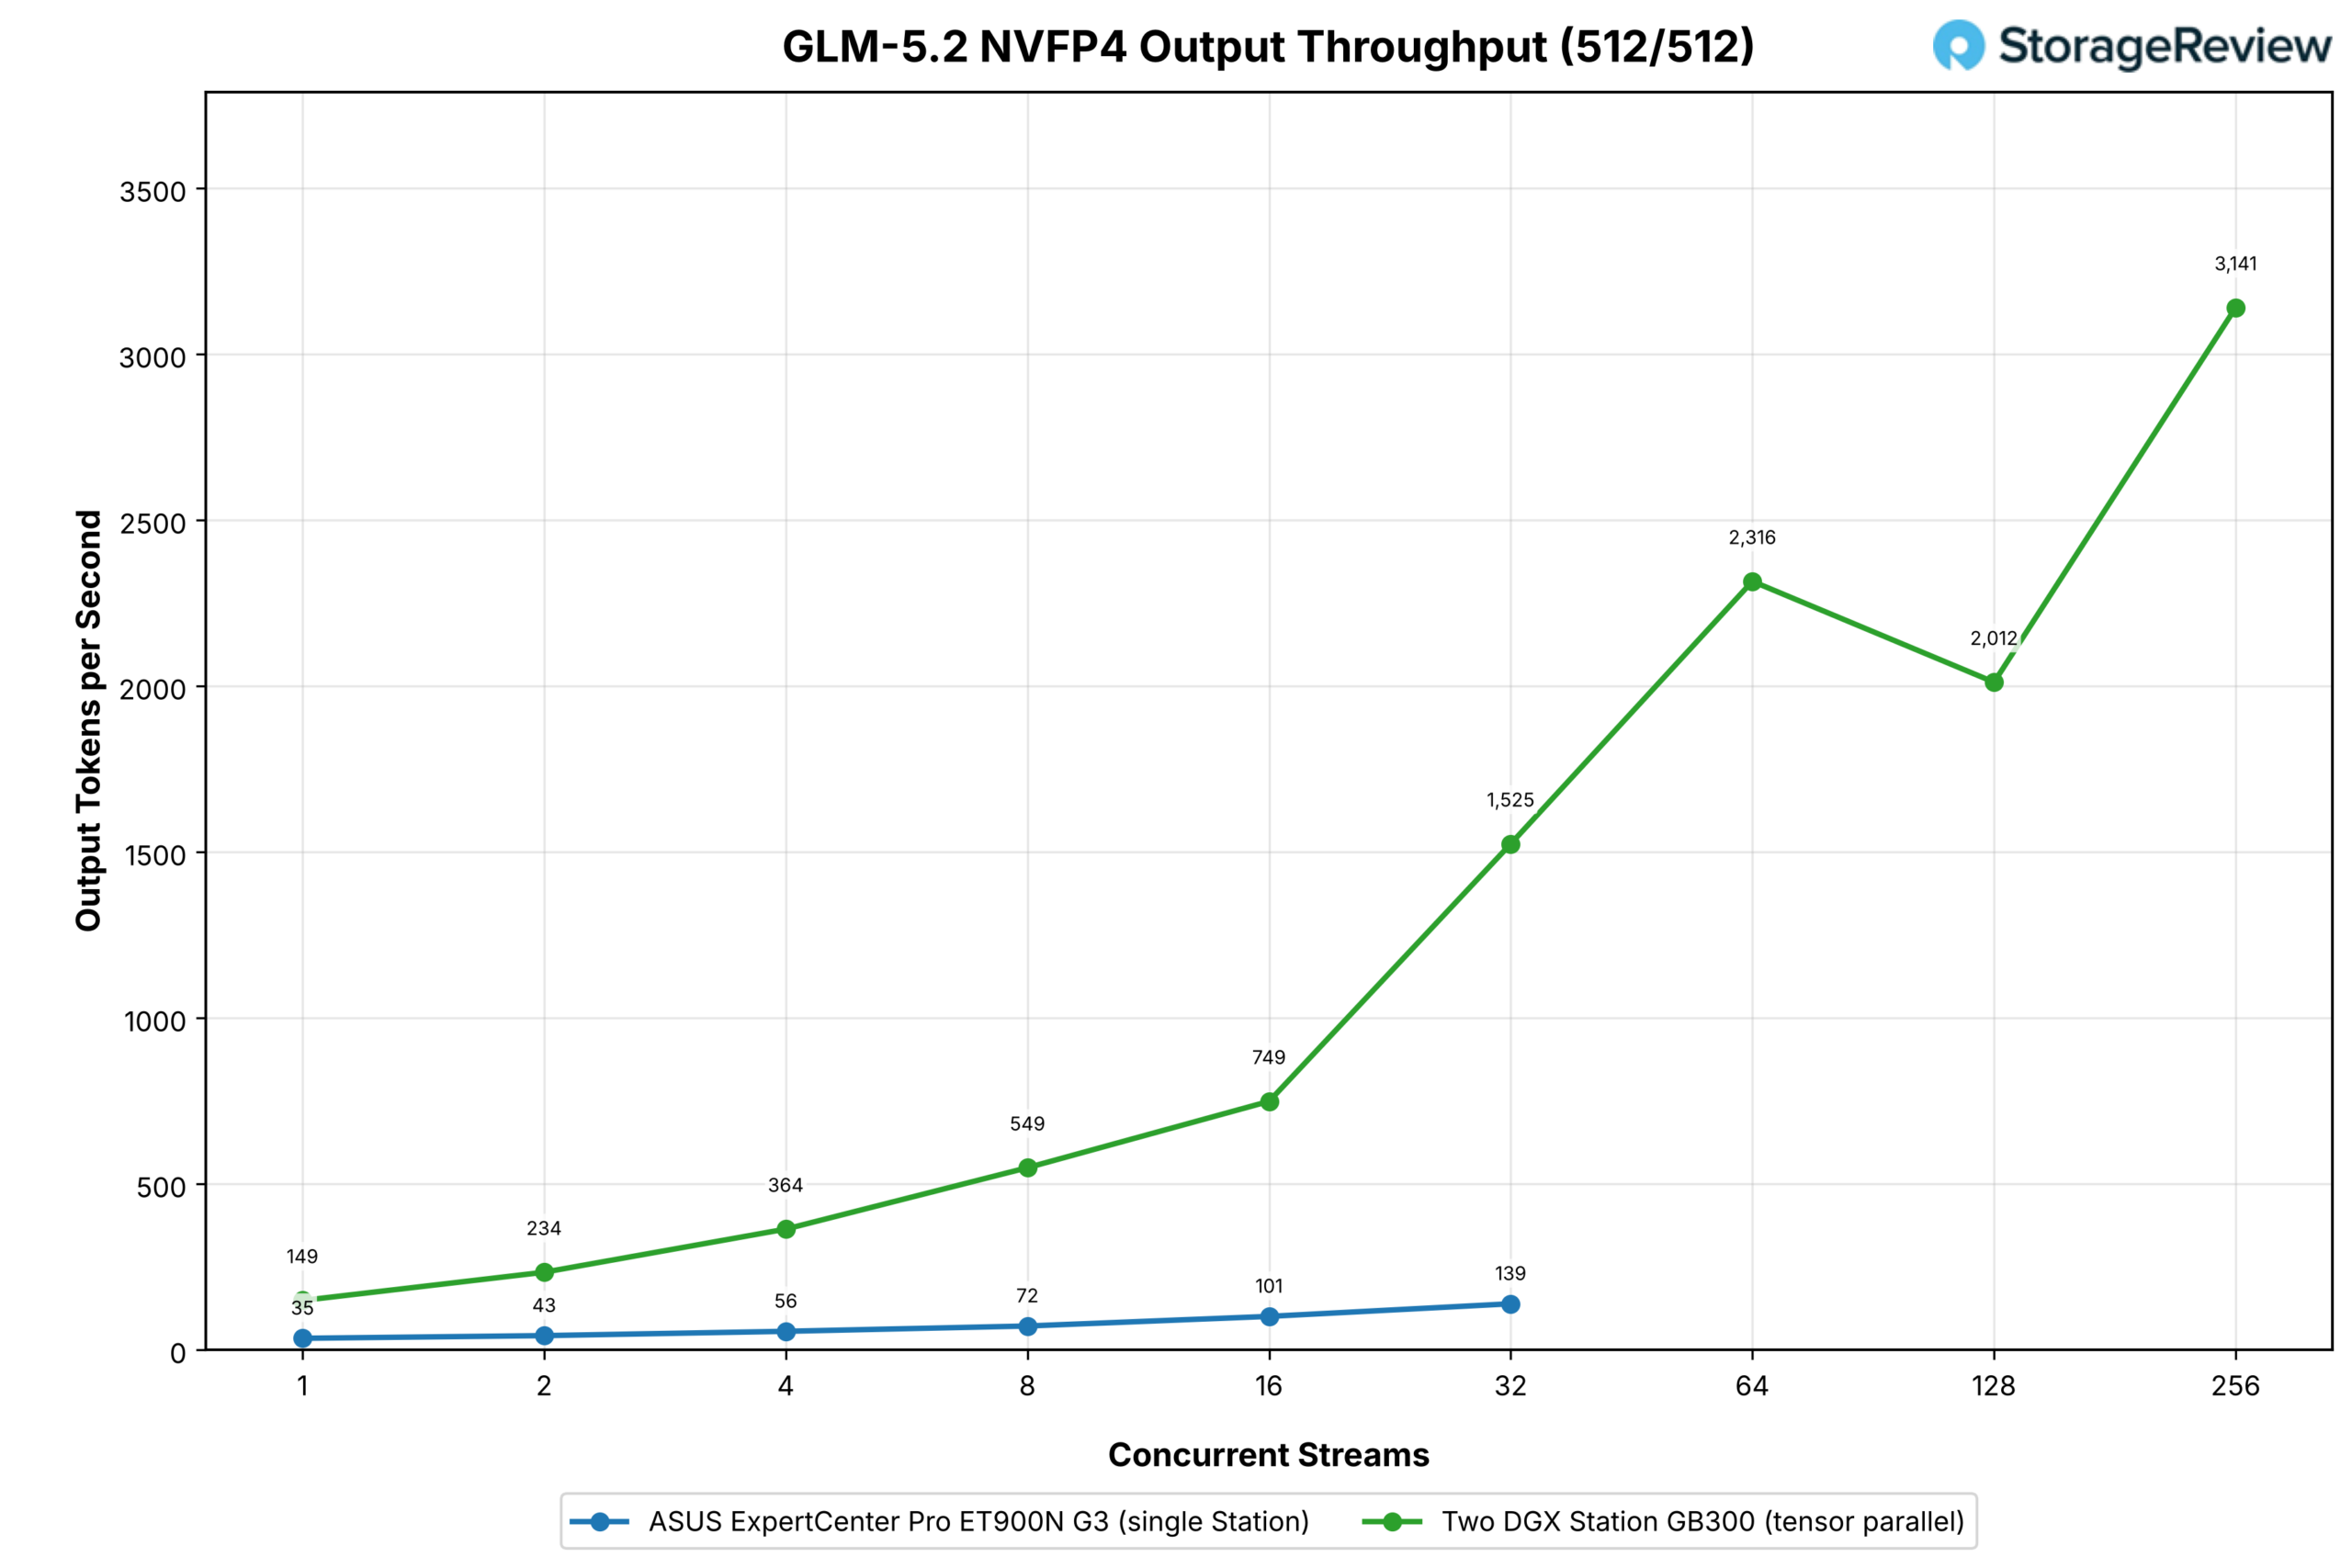
GLM-5.2 kördes i TP2 utan Grace-avlastning på klustret, och det är den modellen som ger de starkaste argumenten för en andra Station. NVFP4-kontrollpunkten är cirka 433 GB, så på en GB300 finns ungefär 215 GB expertvikter i Grace-minnet, och varje avkodningssteg som berör dem korsar NVLink-C2C till LPDDR5X med 396 GB/s. Uppdelat på två Stationer, innehåller varje B300 ungefär hälften av modellen i HBM3e.
Vid samma arbetsbelastning levererade den enskilda ET900N G3 35 utdatatokens per sekund på en ström och 139 vid 32. Klustret med två stationer började på 149 tokens per sekund på en ström, 4.3 gånger det enskilda tornet, nådde 1 525 vid 32 strömmar, 11 gånger, och fortsatte att klättra förbi den enskilda stationens svep till 2 316 vid 64 och 3 141 vid 256, med en nedgång till 2 012 vid 128. En modell som en station betjänar i samtalshastighet för en handfull användare blir en modell som två stationer kan betjäna en avdelning.
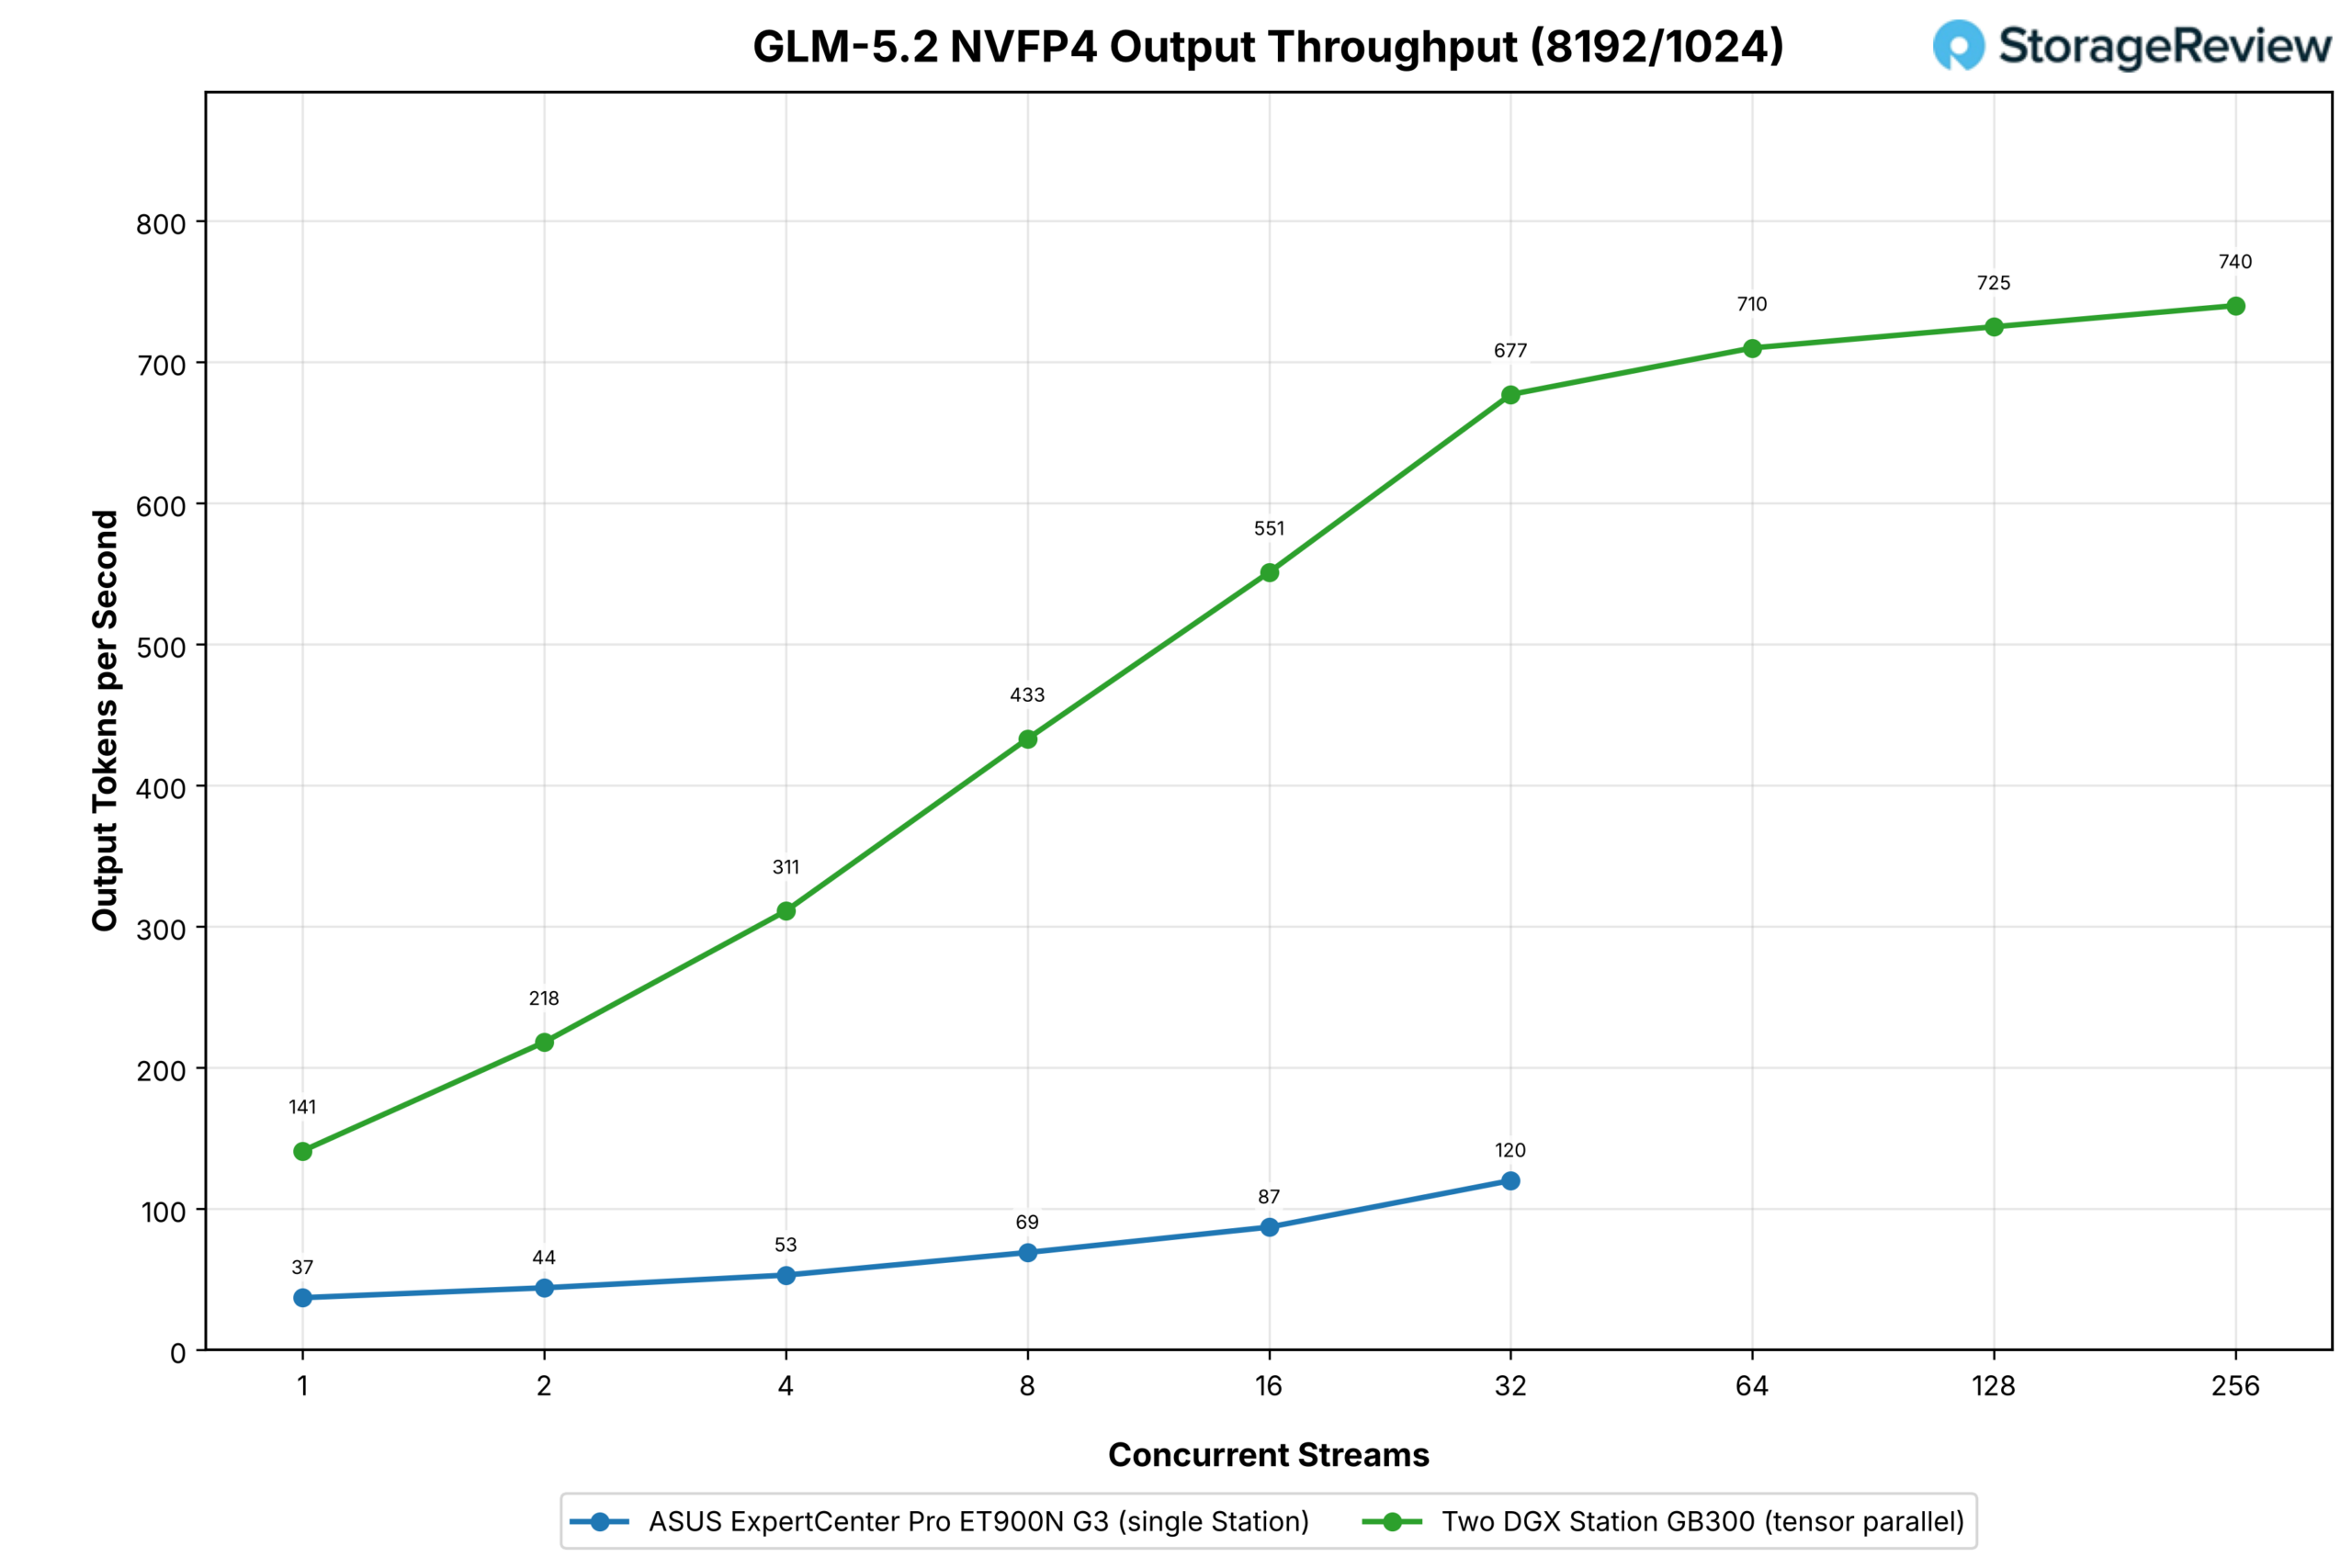
Profilen med hög förfyllning berättar samma historia vid en lägre höjd, där en station rör sig från 37 utdatatokens per sekund vid en ström till 120 vid 32, och klustret rör sig från 141 till 677 över samma intervall, 3.8x längst ner i svepningen och 5.6x högst upp, för att sedan plana ut vid 710, 725 och 740 genom 256 strömmar.
Långa prompter lägger mer av arbetet i förfyllning, där båda konfigurationerna är beräkningsbundna, så avlastningsstraffet som den andra Stationen tar bort är en mindre andel av totalen än den är på korta prompter. Vinsten går långt över 2x på båda profilerna eftersom den andra Stationen tar en 433 GB-modell från LPDDR5X och lägger allt i HBM, och det spelar större roll här än den andra B300:ans beräkningsförmåga.
MiniMax-M3
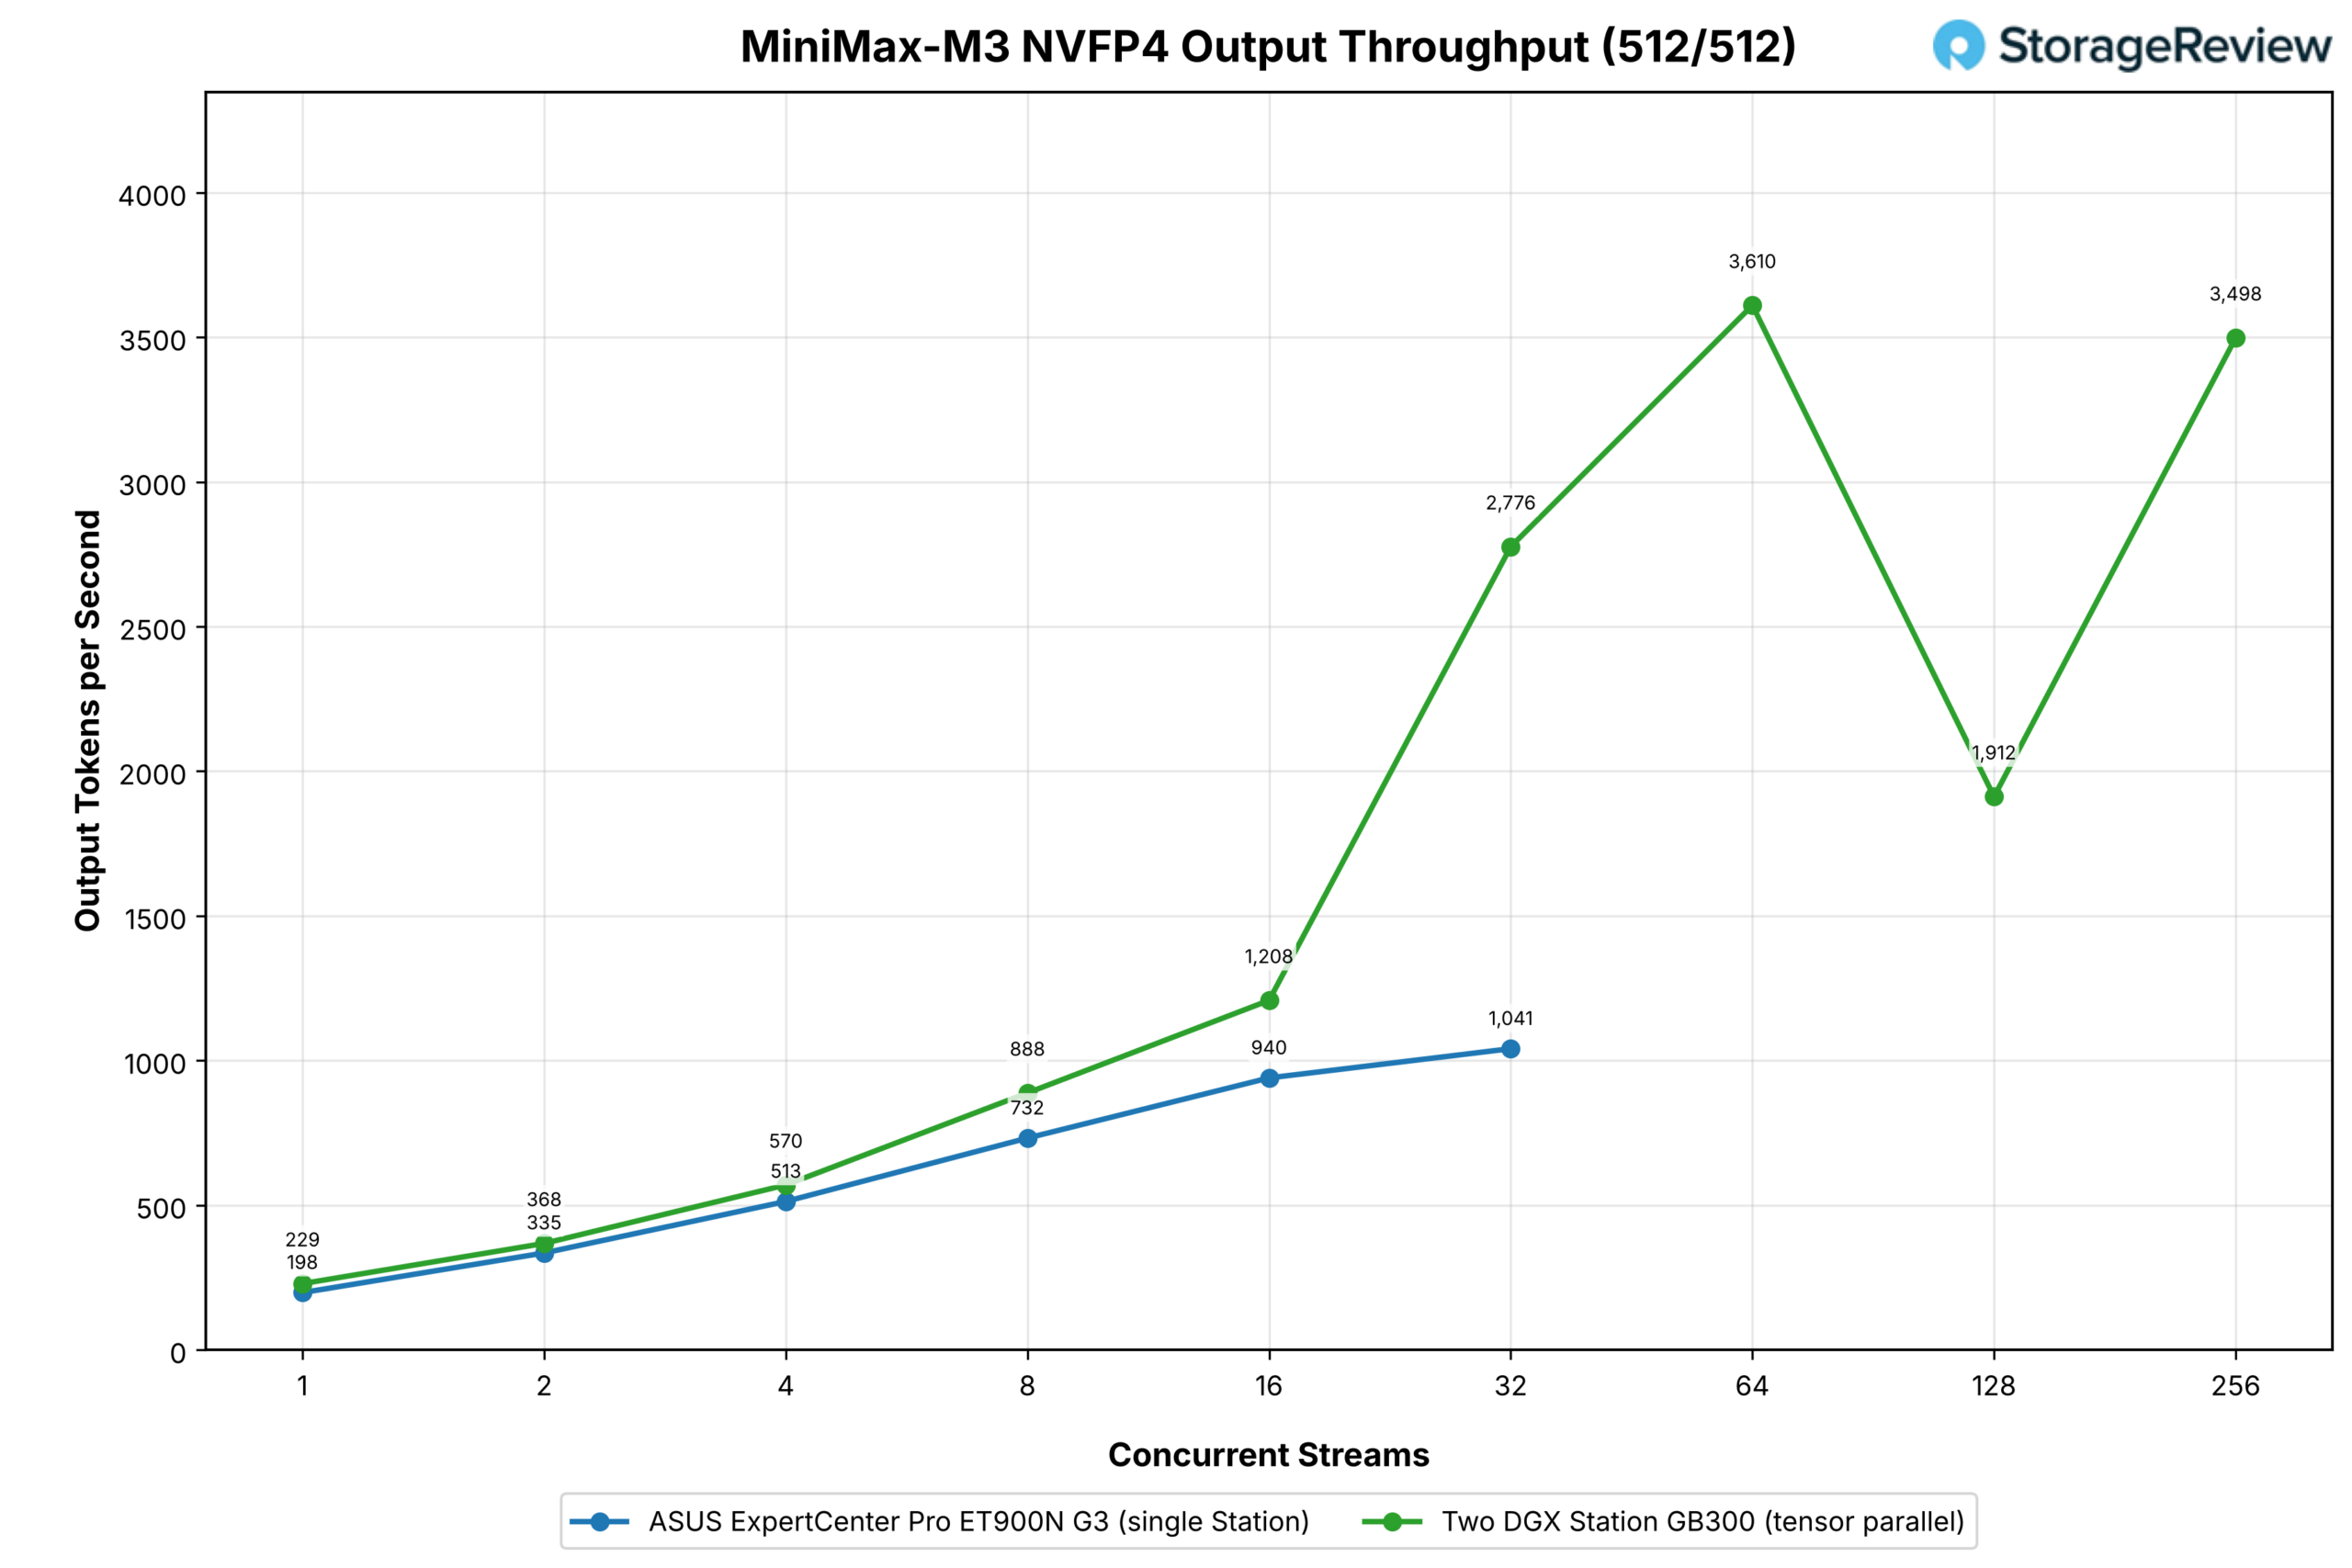
MiniMax-M3 kördes i TP2 utan Grace-avlastning. På en station ligger den precis på HBM-gränsen, med en andel av sina experter i Grace-minne, och i ASUS-recensionen nådde den 1 041 utdatatokens per sekund vid 32 strömmar på samma arbetsbelastning som EAGLE3.
Klustret följer den enskilda Stationen noggrant genom 16 strömmar (1 208 mot 940) och drar sedan ifrån: 2 776 vid 32, 2.7x det enskilda tornet, 3 610 vid 64, en nedgång till 1 912 vid 128 och 3 498 vid 256. Två Stationer lägger till mindre här än de gör på GLM-5.2 eftersom en Station redan har det mesta av denna modell i HBM, så den andra GPU:ns bidrag är närmare vanlig beräkningsskalning, med KV-cacheutrymme ovanpå.
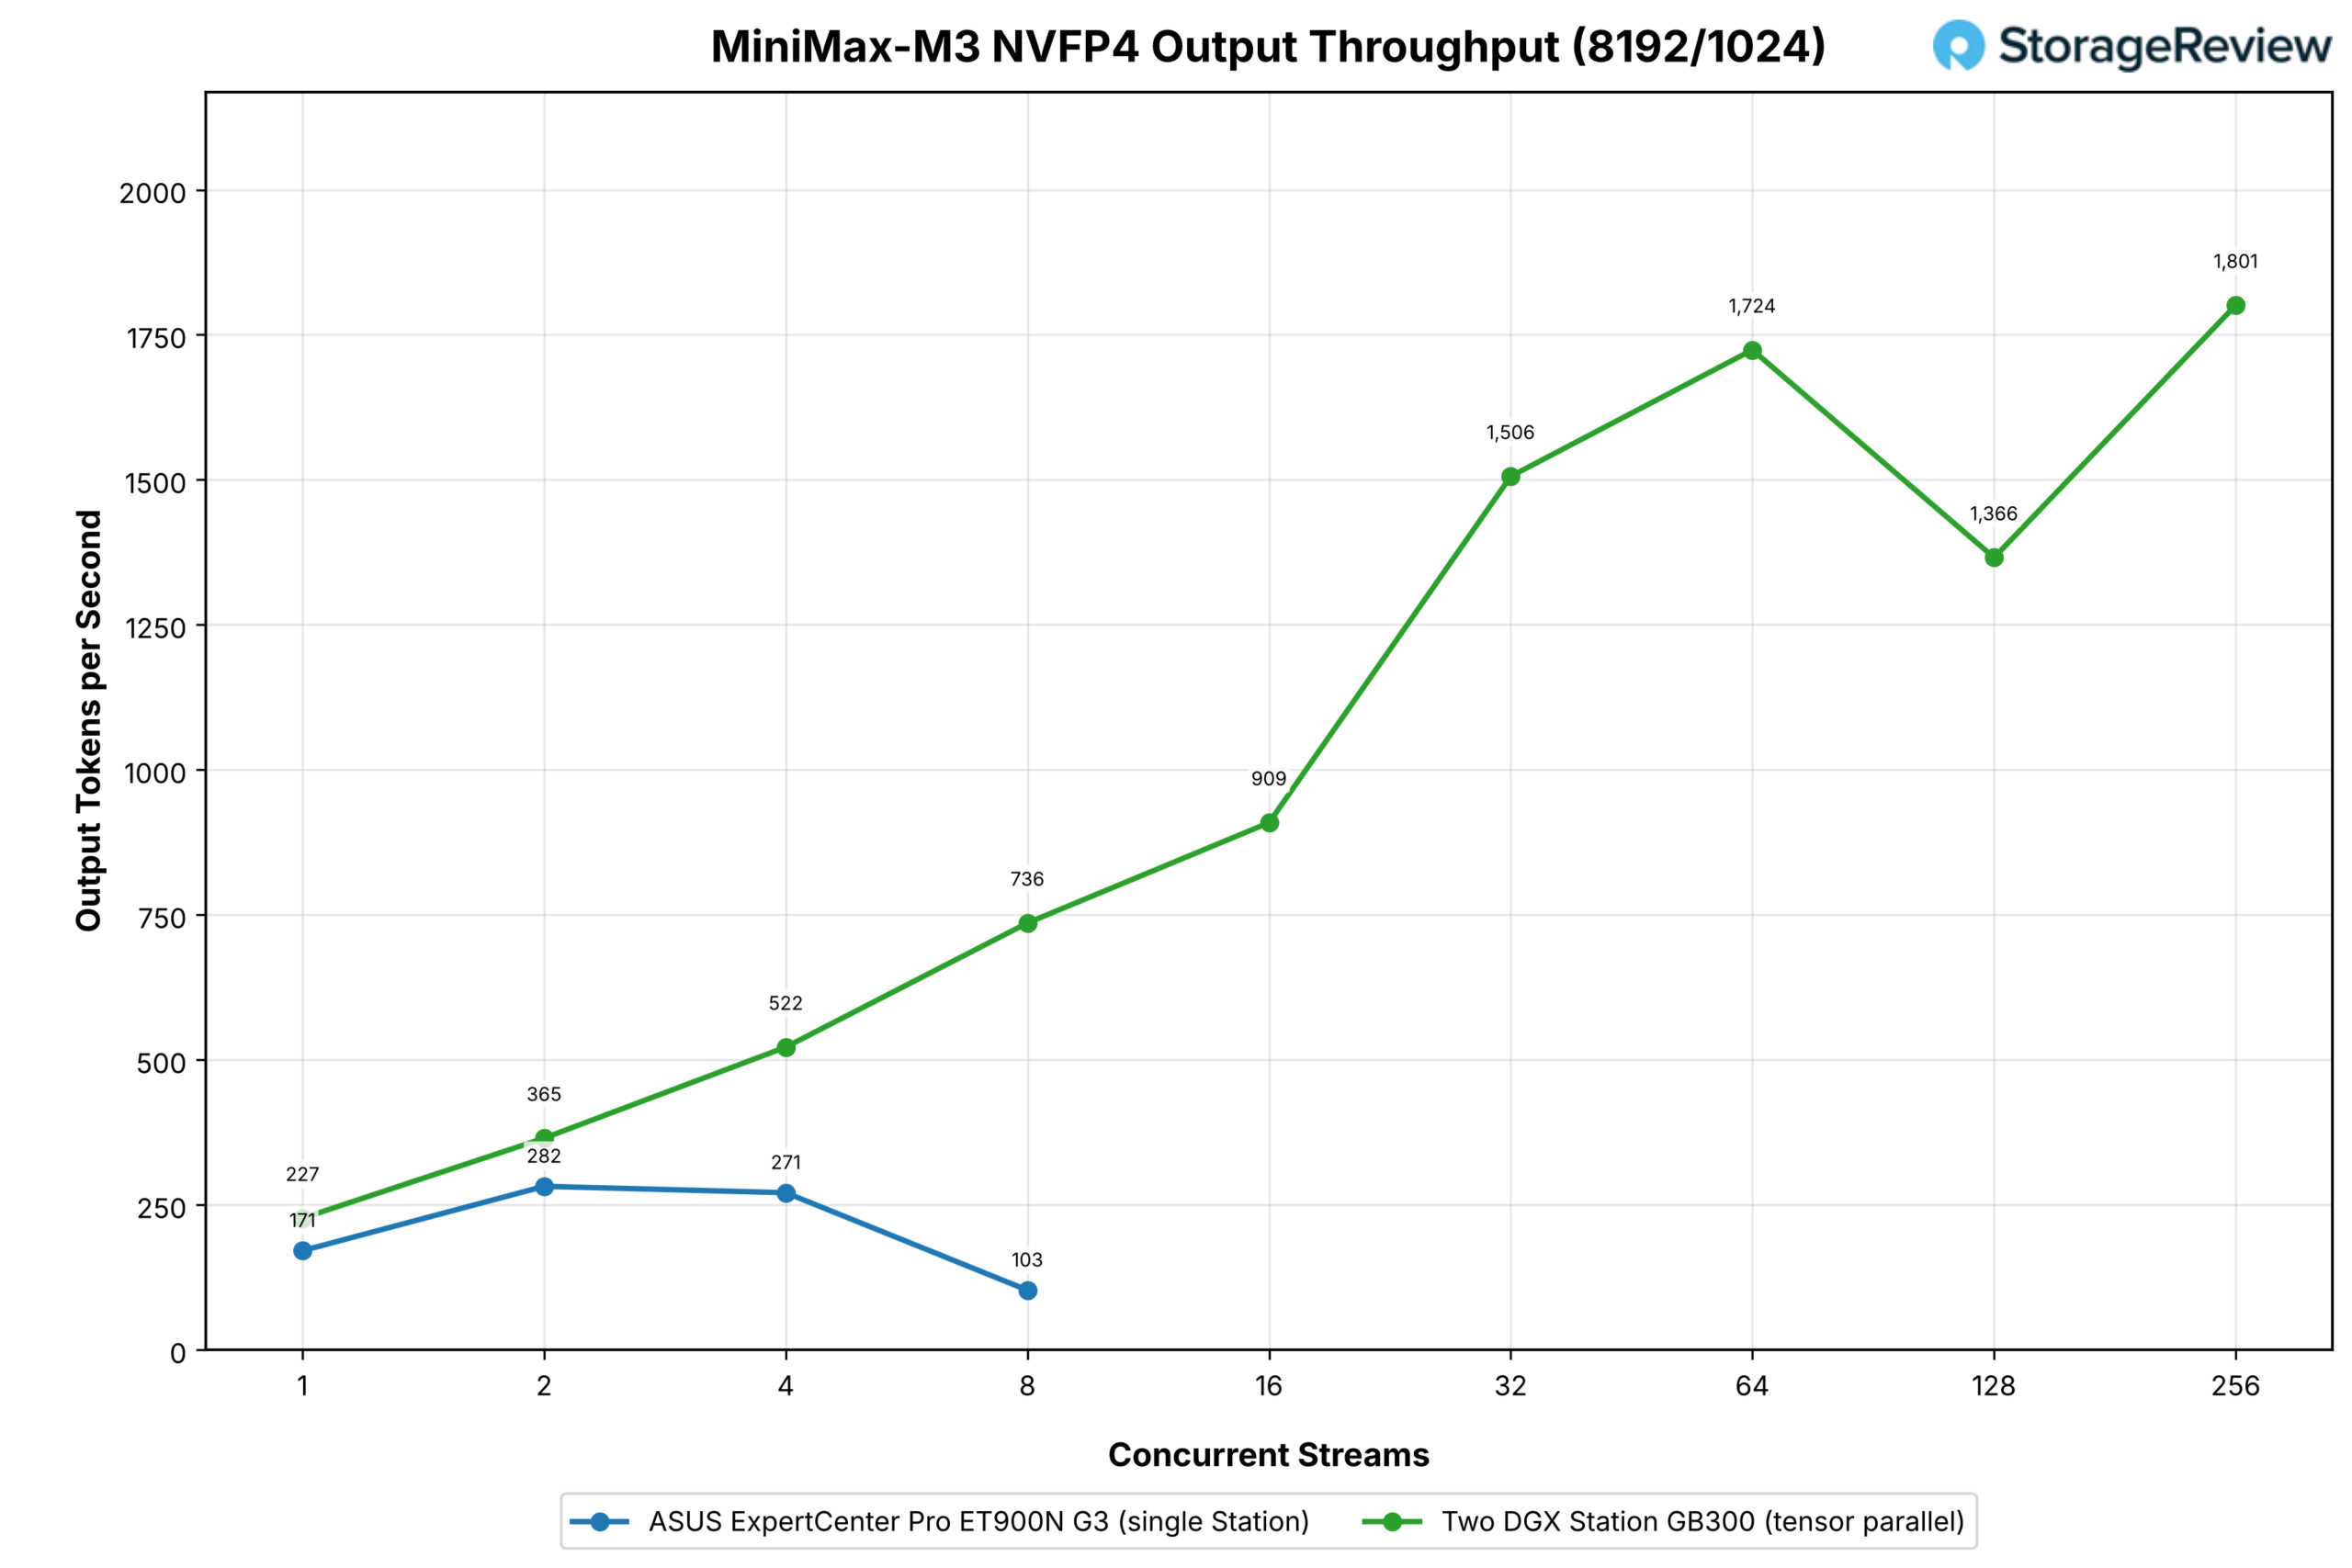
Det är i profilen med hög förfyllning som MiniMax-M3 fick slut på plats på en station: 8 192-token-prompter förbrukar snabbt den återstående KV-cachen, så det enskilda tornet nådde sin topp på 282 utdatatokens per sekund vid två strömmar, höll 271 vid fyra och sjönk till 103 vid åtta, där svepningen slutade eftersom det inte fanns något kvar att mäta.
Med modellen uppdelad på två stationer visar samma punkter 365, 522 och 736, en ökning på 30 % vid två strömmar där båda konfigurationerna har cache över och 7.1x vid åtta, där en har tagit slut. Klustret fortsatte sedan till 909 vid 16, 1 506 vid 32, 1 724 vid 64, 1 366 vid 128 och 1 801 vid 256, ett intervall som den enskilda stationen inte alls kan nå på den här profilen.
Slutsats
Två GB300 DGX-stationer kopplade samman via sina egna ConnectX-8-portar gör vad NVIDIAs dokumentation säger att de ska; installationen var smärtfri, och detta är den första dataöverföringsdata vi har sett för den dubbla systemkonfigurationen.
Den andra Stationen förtjänar sin plats på modellerna som överflödar 252 GB HBM3e: GLM-5.2 går från 139 utdatatokens per sekund vid 32 strömmar på en Station till 1 525 på två, och vidare till 3 141 vid 256 strömmar, eftersom uppdelningen tar en 433 GB-modell från LPDDR5X; GLM-5.3 når 5 018 vid 256 strömmar från ett tak på 188 för en enskild Station; MiniMax-M3 går på långa prompter från ett tower som saktar ner vid åtta strömmar till ett par som fortfarande klättrar vid 256.
På de två modellerna som får plats i en Station, GLM-5.3 Flash och DeepSeek V4.1 Flash, är det bättre sättet att använda den andra rutan att ge varje Station en hel kopia, dela upp förfyllning från avkodning och låta avkodningsarbetaren generera utan att pausa; på GLM-5.3 Flash fördubblades genomströmningen vid långa strömmar vid 32 strömmar och tredubblades genomströmningen vid korta strömmar, och DeepSeek V4.1 Flash hade den högsta genomströmningen i uppsättningen med 5 248 tokens per sekund.
Vår syn på produkten har inte förändrats sedan recensionen av MSI XpertStation WS300 : det här är en intressant maskin för en specifik marknad, och om du behöver en så kanske du behöver en till.
Det bästa sättet att köra dem är som en fungibel infrastruktur: en pool som ett team schemalägger arbete på och omstrukturerar allt eftersom projekten förändras, och NVIDIA äger delarna för att få det att hända. De köpte Run:ai för schemaläggning, Brev för utvecklarmiljöer och Lepton för en datormarknadsplats, och vilken som helst av de tre i kombination med ett rack med stationer skulle göra produkten mer attraktiv om du har tillgång.
Tvåboxkonfigurationen skalade bra; den bästa förstärkningen vi mätte var GLM-5.3, från 188 utdatatokens per sekund på en enda Station till 5 018 över paret (en 27x förstärkning), och vid matchande samtidighet gav GLM-5.2 11x vid 32 strömmar, båda på modeller som en enda Station bara kan hantera genom att spilla vikter i Grace-minnet. Det är ett GB300-resultat över 2x 400G, och det gör oss nyfikna på hur en Vera Rubin Station kommer att se ut när NVIDIA rullar ut en, med nästa generation av HBM och NVLink-C2C.
Var detta passar in har inte förändrats: två stationer på ett skrivbord, utan ett rack eller ett datacenter bakom sig, betjänar nu de modeller som brukade motivera en GPU-server och de faciliteter som följer med den, så ett team som inte kan få en plats i datacentret, eller inte vill vänta på en, har en väg till inferens i frontlinjen som ligger bredvid dem. NVIDIA har satt ribban för den kategorin, priset åsido. GB300-klassen rankas på vår topplista över bästa stationära datorer för lokal AI , där dessa klusterdata nu stöder valet.



 Amazon