

Cloudian 正式发布了 Cloudian HyperScale AI 数据平台,这是一个开箱即用的解决方案,能够满足客户部署企业级 AI 的需求。该解决方案基于 NVIDIA AI 数据平台参考设计,可将存储在文档、PDF、图像和电子表格中的数十年机构知识转化为可通过熟悉的聊天机器人式界面即时访问的洞察。其目标是帮助企业在数天而非数月内搭建生产级、合规的 AI 环境,同时保持对数据的完全控制。
解决企业人工智能部署难题
大多数企业级人工智能项目都会遇到一个常见的问题。为了快速推进,它们通常依赖共享或公共云环境,但这些环境可能与内部安全、数据主权或监管要求不符。为了保持控制权,它们转而采用定制化的本地部署方案,但这往往涉及多个供应商,需要数月的集成,而且难以确定最终能否实现可衡量的业务价值。

与此同时,企业知识的大部分对人工智能系统而言仍然几乎不可见。Cloudian 引用了一个广为流传的数据:大约 80% 的机构知识存在于非结构化内容中,例如文档、报告、电子邮件、图像和操作日志。这些内容往往跨越数十年,包含关键的流程知识、客户背景信息和监管历史。由于缺乏有效的方法来摄取和查询这些数据,人工智能部署难以取得有意义的成果。
超大规模人工智能数据平台旨在消除这种权衡取舍。它将计算、存储、网络和软件整合到一个集成的基础设施中,可在数天内投入运行,并且专为企业文档人工智能用例而设计。该系统无需进行大量的数据迁移或复杂的集成工作,即可部署在企业内部或受控环境中,使企业能够将数据保留在原地,同时又能将其用于人工智能工作负载。
该平台集成了成熟的 NVIDIA 企业级文档 AI 蓝图,提供用于文档处理、检索增强生成 (RAG) 及相关任务的参考工作流程和预验证组件。与定制项目相比,这降低了风险,并将部署固定在可重复使用的架构中。
NVIDIA企业AI产品副总裁Justin Boitano清晰地阐述了这一需求。他强调,将企业数据转化为AI洞察需要的不仅仅是可扩展的存储,还需要一个紧密集成、高性能且能够适应企业需求的架构堆栈。他指出,基于NVIDIA AI架构、网络和软件构建的Cloudian超大规模AI数据平台,能够帮助企业安全地获取关键知识,简化部署,并随着数据量的增长扩展AI容量。
立竿见影的商业影响,经济效益可预测
该平台旨在提供企业级人工智能功能,同时避免早期人工智能部署中常见的性能和成本权衡。在存储层,Cloudian 将其原生 S3 对象存储与 S3 操作的 RDMA 加速相结合。这种组合旨在消除延迟敏感型人工智能和向量数据库场景中对象存储通常带来的性能损失。
Cloudian 报告称,这种采用 RDMA 加速的 S3 服务,其向量数据库性能比依赖传统文件存储的 CPU 解决方案快 8 倍。对于客户而言,这意味着嵌入、相似性搜索和检索操作可以支持数千个并发用户的实时响应,而无需迁移到定制的非标准存储堆栈。
对于技术销售团队和架构师而言,经济效益同样至关重要。Cloudian 将 HyperScale AI 数据平台作为本地集成设备提供,使 AI 基础设施支出与可预测的资本支出 (CapEx) 而非可变且往往难以预测的云运营支出 (OpEx) 保持一致。该解决方案旨在消除常见的 AI 云支出,例如按令牌计算的推理费用和高昂的云存储成本,这些成本可能比密集型本地部署高出几个数量级。
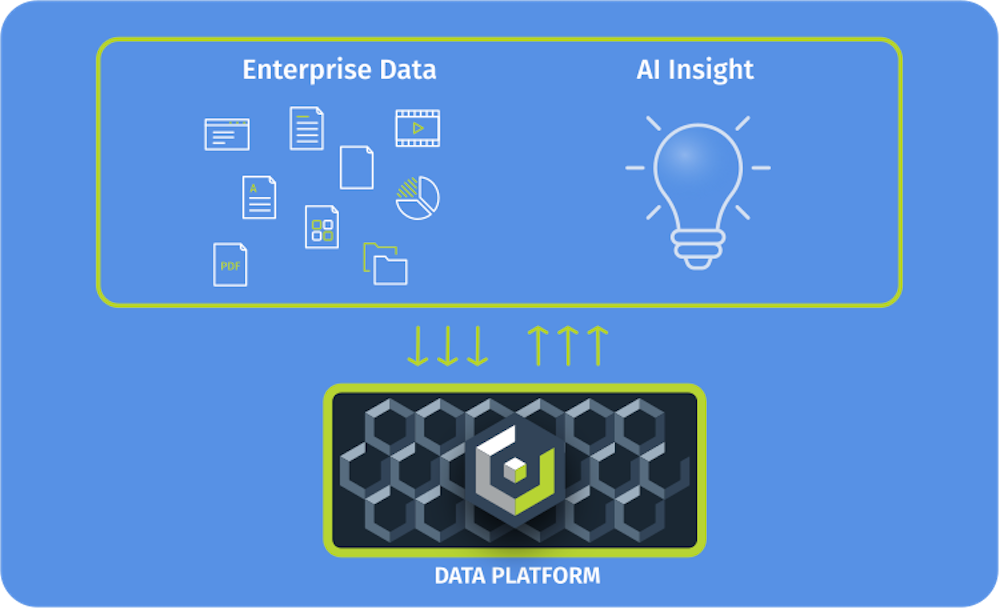
由于该平台原生支持 S3 并基于 Cloudian HyperStore 构建,因此能够处理和分析跨本地环境、混合架构和分布式位置的数据。这种灵活性使企业能够在数据原地保留数据,并将其导入 AI 工作流程,而无需强制进行大规模迁移到单一云平台或专有平台。对于许多受监管的企业而言,这种能力对于维护数据主权和满足内部治理要求至关重要。
企业文档人工智能
HyperScale AI 数据平台的初期重点是企业文档 AI。其内置的文档 AI 应用蓝图旨在通过对话式的自然语言查询,展现企业数十年的机构知识积累。用户体验有意模仿消费者聊天界面,但基于企业自身的文档和政策。
例如,在医疗保健领域,该平台可用于查询患者记录、临床方案和内部指南,同时确保符合 HIPAA 和其他隐私法规的要求。由于数据始终在组织的受控环境中运行,合规和审计团队可以随时了解信息的存储位置和访问方式。
在金融服务领域,机构无需将敏感信息发送给外部人工智能提供商,即可搜索监管文件、内部政策、风险评估和合同库。这种既能将监管内容和客户数据控制在受监管范围内,又能受益于现代检索增强生成技术的能力,是吸引注重风险的买家的核心卖点。
从技术角度来看,该蓝图抽象化了构建文档摄取管道、索引、向量化和检索工作流程等诸多复杂性。客户无需从零开始设计这套技术栈,而是可以依赖平台中包含的参考设计,专注于调优、访问控制和治理。
从文档到视频和分析
Cloudian 将超大规模 AI 数据平台定位为一个基础架构,它将在未来支持多种 AI 应用蓝图,而不仅仅是以文档为中心的用例。该路线图包括支持视频分析,尤其是在制造车间、仓库、物流中心和建筑工地等环境中,实时或近实时视频智能可以提升安全性、质量和运营效率。
即将推出的蓝图将重点利用同一集成基础设施,分析视频流以进行活动和异常检测,并实现运行监控。未来的应用还将涵盖更广泛的数据分析和更多企业级人工智能功能,所有这些都将通过相同的软硬件堆栈交付。这种单一平台方法简化了采购和生命周期管理,因为客户无需为每个新的人工智能工作负载部署单独的解决方案。
平台架构和硬件基础
HyperScale AI 数据平台的入门级配置基于 NVIDIA RTX PRO 服务器参考设计。该系统专为 AI 工作负载而设计,最多可配置八块 NVIDIA RTX PRO 6000 Blackwell 服务器版 GPU,从而显著加速大型非结构化数据集的训练、微调和推理。
计算能力由两颗英特尔® 至强® 6900 系列 CPU 提供,确保为编排、数据预处理和控制平面服务提供充足的通用处理能力。该平台还集成了 NVIDIA BlueField-3 DPU,可将网络、安全和存储任务从主机 CPU 卸载;以及 NVIDIA Spectrum-X 以太网超级网卡,提供高带宽、低延迟的连接,这对于 AI 和数据密集型工作负载至关重要。
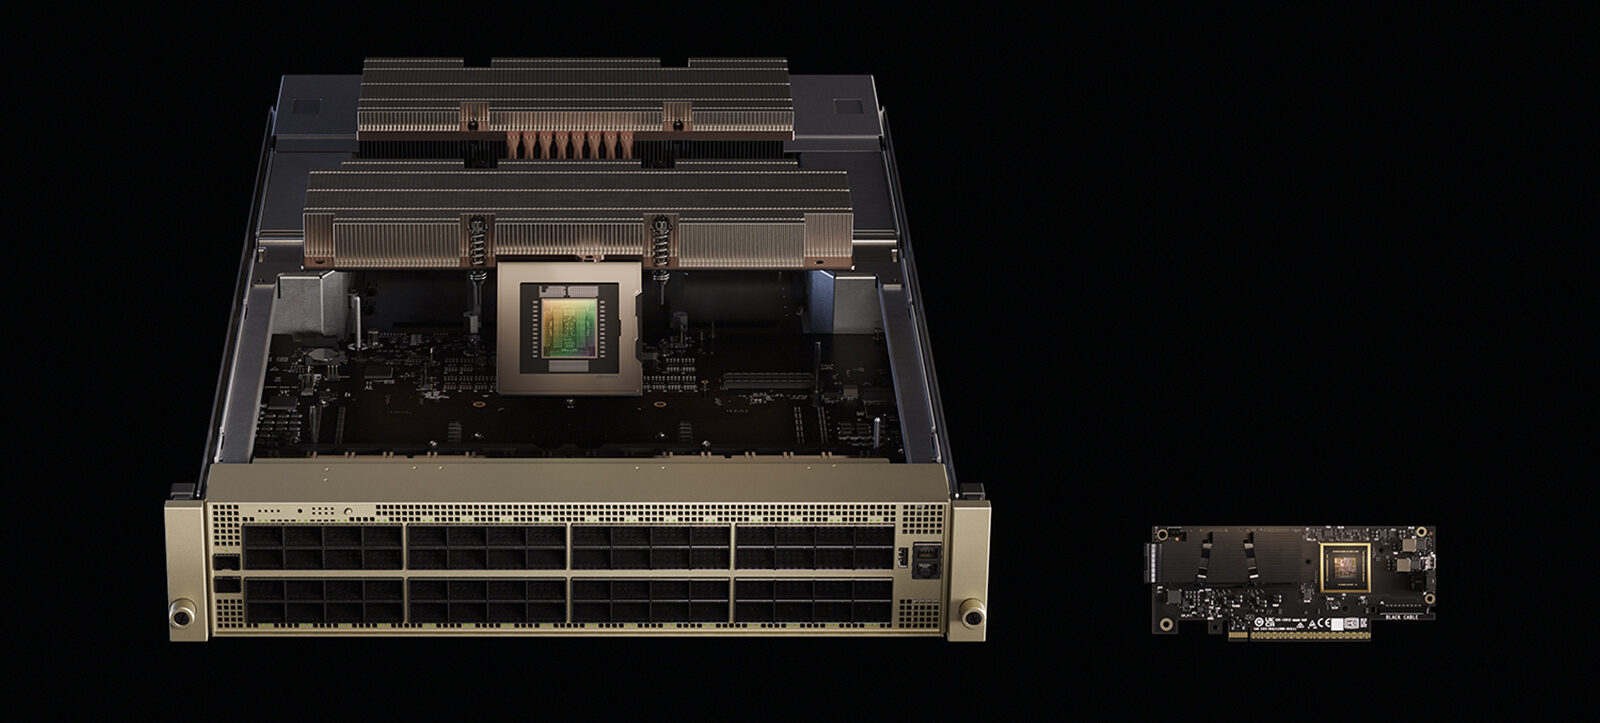
在存储方面,该平台采用基于 NVMe 介质的 Cloudian HyperStore,提供高吞吐量、低延迟的 S3 兼容对象存储。集成的 RDMA 可实现 S3 连接,从而降低协议开销,使 AI 和向量工作负载能够以接近本地块存储或文件系统的延迟访问对象数据,同时保留对象存储的可扩展性优势。
该架构旨在随着数据需求的增长,实现从TB级到EB级的无中断扩展。这种扩展能力对于希望从小规模AI项目起步,但又希望在不重新设计基础设施的情况下实现全球部署的客户至关重要。
Cloudian 首席执行官 Michael Tso 强调,企业需要的是能够融入现有安全和合规框架的 AI 平台,而不是强迫这些框架进行调整。他指出,HyperScale AI 通过熟悉的聊天机器人界面,提供对机构知识的安全访问,同时确保数据始终处于企业控制之下,并将部署时间从数月缩短至数天。
可用性
Cloudian 超大规模 AI 数据平台现已通过 Cloudian 的认证渠道合作伙伴生态系统在全球范围内推出。
每个系统都包含 Cloudian HyperCare 支持,提供远程管理服务和 24/7 全天候技术支持。


 Amazon