

在 ISC 2026 上,DDN 宣布大幅扩展其 AI 和 HPC 数据平台产品组合,推出新的硬件、软件和平台功能,旨在提高 GPU 利用率、加速 AI 推理并简化大规模 AI 基础设施部署。
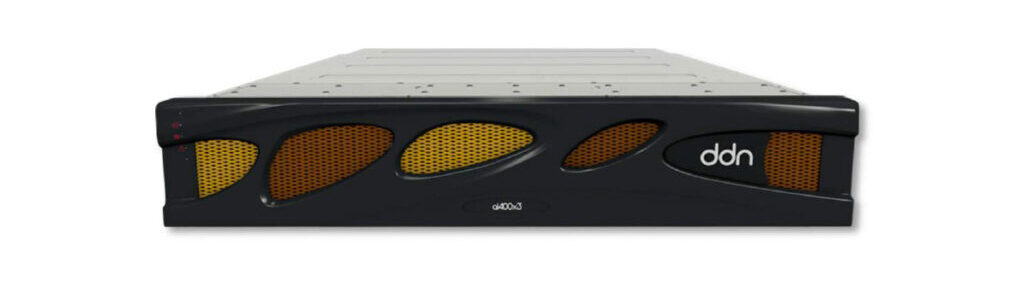
此次发布的产品包括 AI400X3M 存储设备、DDN 分布式 KV Cache 加速技术与NVIDIA Dynamo集成的正式发布,以及公司 AI 数据平台新增的安全性、可观测性和基础设施管理功能。
DDN表示,此次更新旨在解决人工智能数据管道中的各个瓶颈,包括数据准备、模型训练、推理、检索增强生成(RAG)、推理模型和智能体人工智能工作负载。该公司致力于通过提高GPU利用率来提升基础设施效率,同时降低功耗和基础设施成本。
DDN 首席执行官兼联合创始人 Alex Bouzari 表示,现代人工智能基础设施需要的不仅仅是计算资源。他强调,高效的数据管理、安全性和运营可视性已成为生产级人工智能部署的关键组成部分,而公司最新发布的版本旨在提高 GPU 效率、降低推理成本并加快首次令牌生成速度。
AI400X3M 旨在提升人工智能和高性能计算的性能密度
此次发布会的重头戏是 AI400X3M,这是基于 DDN 的 EXAScaler 并行文件系统构建的最新设备。
AI400X3M 技术规格
| 性能 | |
| 顺序读取性能 | 高达 190 GB/秒 |
| 顺序写入性能 | 高达 110 GB/秒 |
| 随机读取IOPS | 8M |
| 系统功能 | |
| 平台 | 适用于人工智能的交钥匙式 EXAScaler 共享并行文件系统设备,配备主动/主动存储控制器 |
| 每个设备的主机端口 | 4 个 XDR/400GbE OSFP 或 8 个 NDR200/200GbE QSFP112 端口 |
| 驱动器支持 | 24 个 2.5 英寸双端口热插拔 PCIe G5 NVMe 固态硬盘 |
| 容量选项 | 120/250/500TB 和 1PB/2PB 可用 |
| 标准固件功能 | LUN 映射和掩码、智能写入条带化、读取 QoS、数据完整性检查/纠正、接口选项(CLI、GUI、Python API)、包括 RELP 支持在内的出站 syslog、状态更改消息(通过电子邮件和 SNMP 陷阱) |
| 安全与合规 | |
| 安全 | IEC/EN/UL/CSA 62368-1,GB4943 |
| EMC | EN 55032 A级、EN 55035、EN 61000-3-2、EN 61000-3-3、FCC Part 15 A级、VCCI A级、ICES-003 A级、GB/T9254 A级、BSMI A级 |
| 环境 | RoHS、REACH、WEEE、ERP Lot9X |
| 物理属性 | |
| 外形 | 2U机架安装 |
| 尺寸 | 高度:3.43“(87mm) 宽度:17.56“(446mm) 深度:不含表圈 33.7 英寸(856 毫米);总深度 35.2 英寸(895 毫米) 可调节机架导轨:26.75″ 至 34.0″ (680–860mm) |
| 重量 | 空重 98 磅(44 公斤);最大重量 108 磅(49 公斤) |
| 电源和冷却 | |
| 输入电压 | 200–240伏 50/60赫兹 |
| 电源 | 2 个热插拔冗余 IEC60320-C20 插座 |
| 操作环境 | |
| 温度范围 | 5°C至30°C(41°F至86°F) |
| 相对湿度 | 8%–80%非凝结 |
| 低气压 | 海拔 950 米(3,117 英尺)@ 30°C — 海拔 3,048 米(10,000 英尺)@ 23°C |
该平台可提供高达 190GB/s 的吞吐量,读取性能比上一代产品提升高达 35%。DDN 还支持在单个机架内扩展至 30PB 的配置,并新增了混合磁盘支持,将闪存和 HDD 存储相结合,以平衡性能、容量和成本。
该设备专为人工智能模型训练、推理、检查点保存、高性能计算模拟以及其他高度并行的工作负载而设计,在这些工作负载中,存储吞吐量会直接影响GPU的利用率。预计将于2026年第三季度末正式上市。
分布式 KV 缓存现已正式发布
继在 NVIDIA GTC 2026 大会上进行技术预览后,DDN 正式发布了其分布式 KV 缓存加速架构,该架构集成了 NVIDIA Dynamo 技术。这项功能可应用于 Infinia 对象存储平台和 EXAScaler 文件系统。
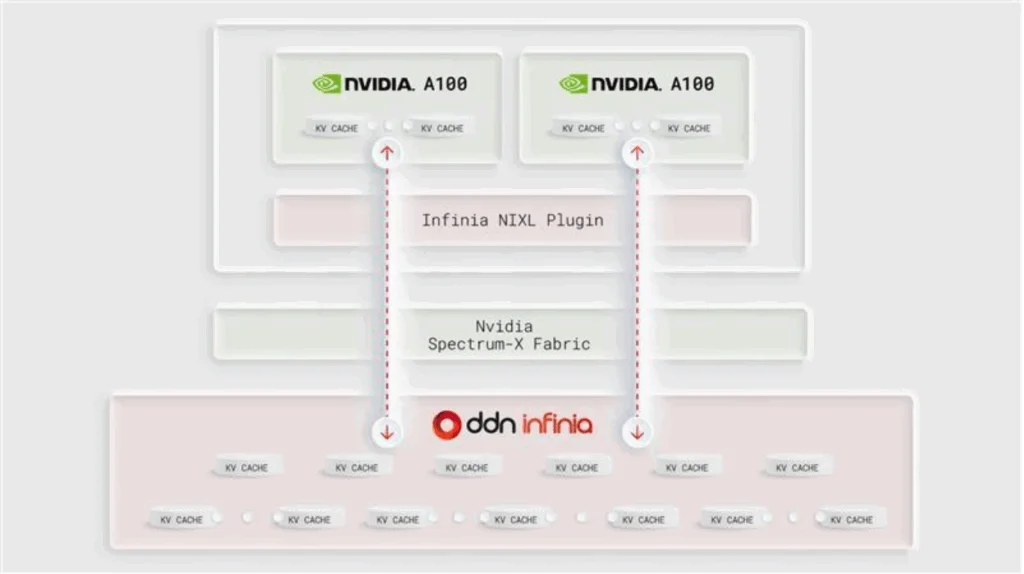
分布式架构不依赖本地 GPU 内存来存储模型上下文,而是从 DDN 的数据平台存储和检索 KV 缓存数据,从而减少推理过程中的内存瓶颈。
DDN表示,该平台支持NVIDIA Dynamo、vLLM和其他现代推理框架,并支持跨多个推理节点共享分布式键值缓存。该公司声称,对于大规模推理工作负载,键值缓存加载速度最多可提升55倍,同时还能提高GPU利用率、加快令牌生成速度,并降低大型语言模型部署的基础设施成本。
该技术旨在使长期上下文推理、检索增强生成、推理模型和反复访问大型模型上下文的智能 AI 工作流程受益。
统一人工智能数据管道
DDN 还概述了其更广泛的战略,即将 Infinia 对象存储用于推理,EXAScaler 用于模型训练和检查点,并整合到单一的 AI 数据基础设施中。
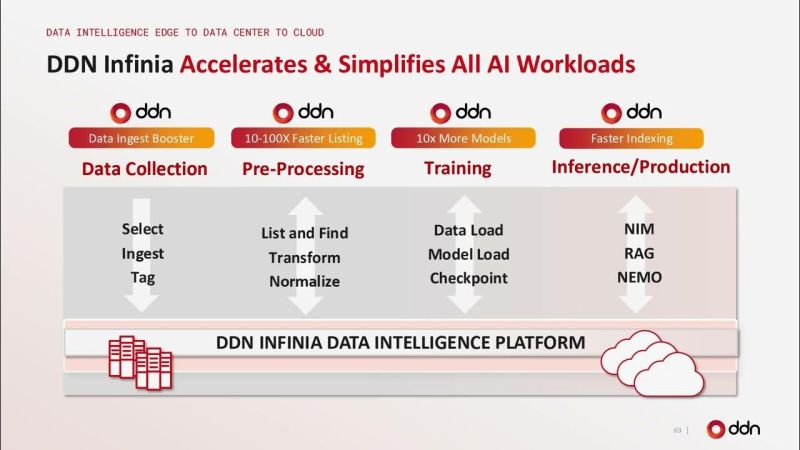
该公司表示,Infinia 提供低延迟元数据操作、高并发性和针对推理密集型工作负载优化的对象性能,而 EXAScaler 则继续服务于高性能训练环境。这两个平台旨在共同消除数据孤岛,并在整个 AI 生命周期中保持较高的 GPU 利用率。
新增安全和基础设施功能
平台的其他增强功能侧重于企业部署要求,包括裸机多租户、基于 KMIP 的加密和密钥管理、用于运营可见性的 VictoriaLogs 集成以及扩展的多租户 API。

在存储方面,DDN 推出了智能文件绑定和 NAND 加速热池技术,允许将频繁访问的数据保留在闪存中,同时自动将访问频率较低的数据分层存储到成本更低的硬盘驱动器中。该公司表示,这些功能旨在提高存储效率,同时降低闪存容量需求。
持续拓展云端人工智能
DDN 还重点介绍了其云 AI 基础设施产品的持续普及,包括与 Google Cloud 合作推出的 Managed Lustre 开发项目,以及使用由 EXAScaler 提供支持的 Google Cloud Managed Lustre 的 Salesforce 部署。
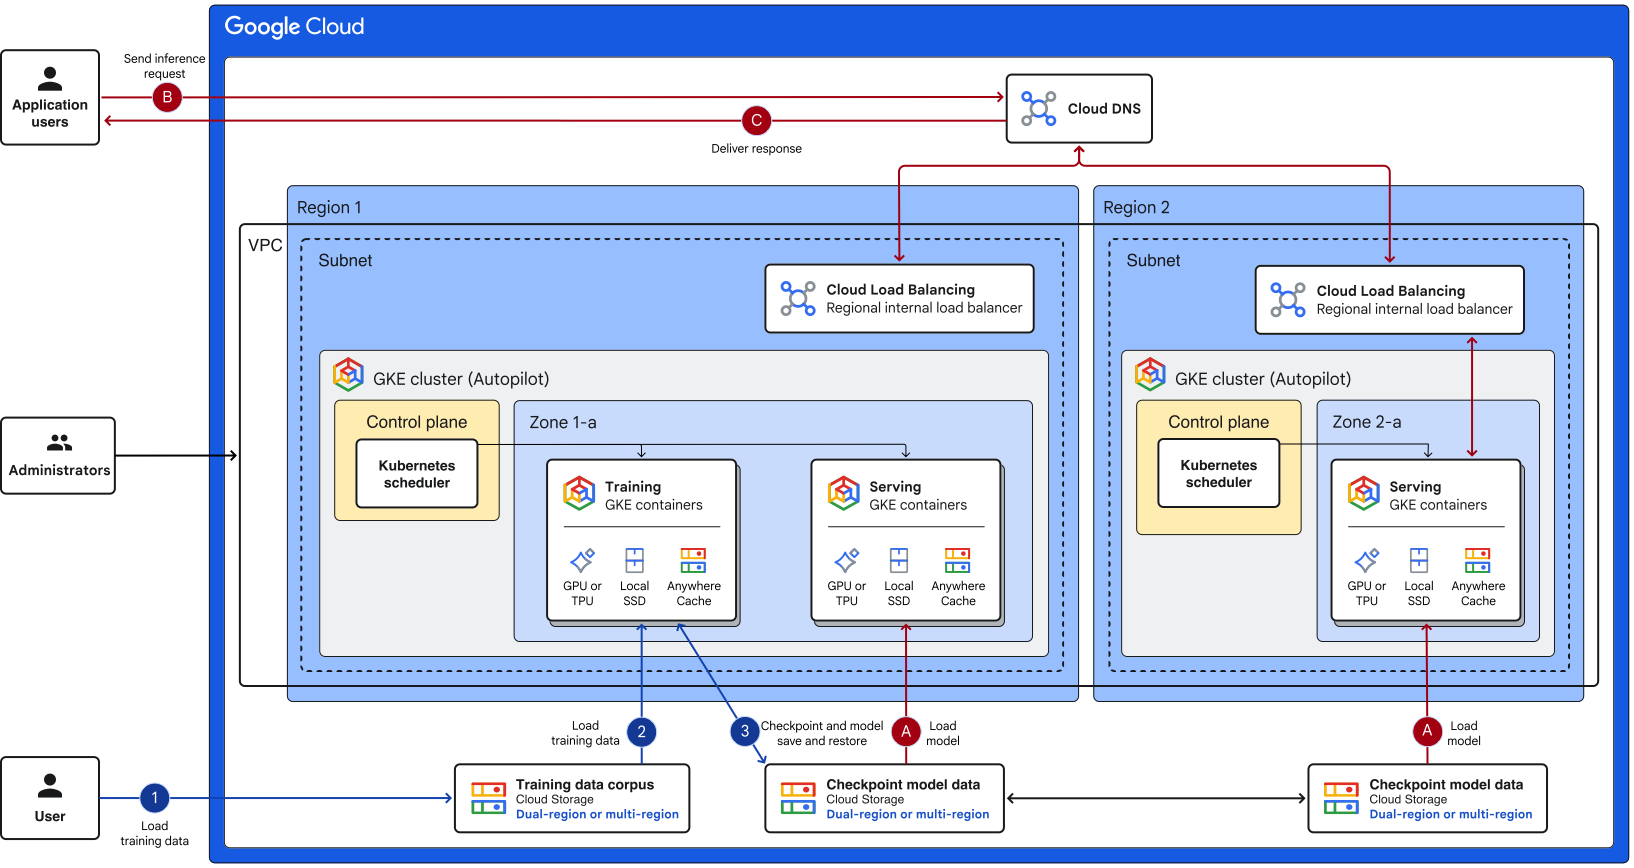
据 DDN 称,Salesforce 的实施使模型训练速度提高了 1.5 倍,I/O 延迟降低了 75%,训练成本降低了 42%,这表明减少大规模 AI 环境中的存储瓶颈具有重要意义。
通过最新的公告,DDN 继续扩展其产品组合,从并行存储扩展到 AI 数据编排、推理加速和基础设施管理,使其平台能够支持企业、云、研究和自主 AI 部署,并在大规模 GPU 规模下运行。


 Amazon