

戴尔科技集团与 CoreWeave 紧密合作,宣布业界首款 NVIDIA GB300 NVL72 系统正式出货。此前,戴尔已率先成为首家出货 NVIDIA GB200 的供应商,此次里程碑式的合作进一步巩固了其在 AI 基础架构领域的领先地位。领先的 AI 云服务提供商 (CSP) CoreWeave 成为首家部署 NVIDIA GB300 NVL72 的超大规模数据中心运营商。这是一款液冷式机架级 AI 系统,专为最严苛的企业级工作负载而设计。
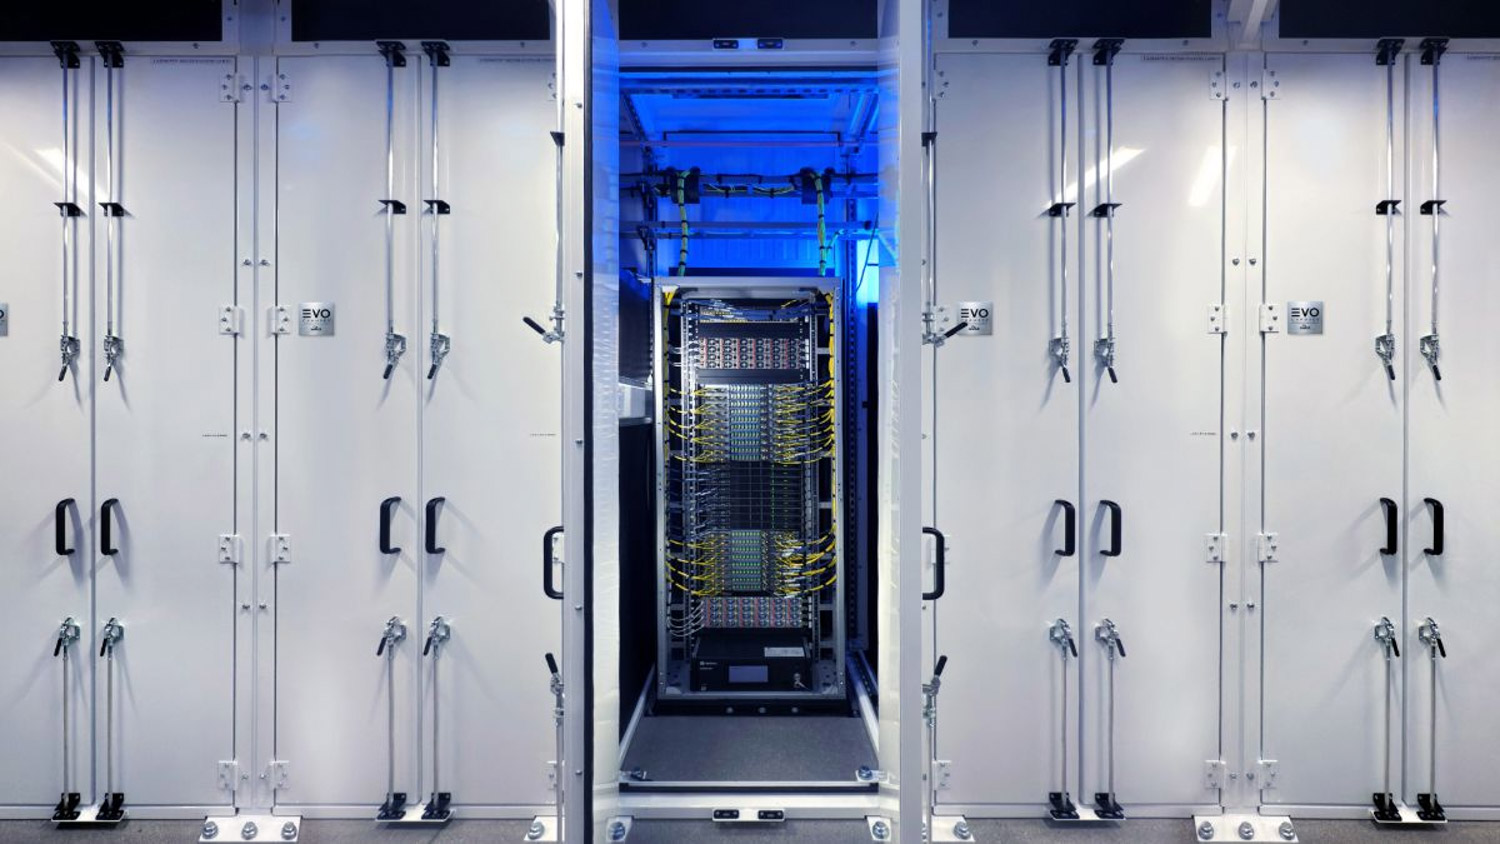
这一成就得益于戴尔、CoreWeave 和 NVIDIA 之间的紧密合作,并建立在戴尔 AI 工厂与 NVIDIA合作项目的成功基础之上。戴尔 AI 工厂提供全面、安全的 AI 解决方案,以满足现代企业不断变化的需求,帮助企业更有信心地加速 AI 计划的实施。
利用 CoreWeave 释放企业潜力
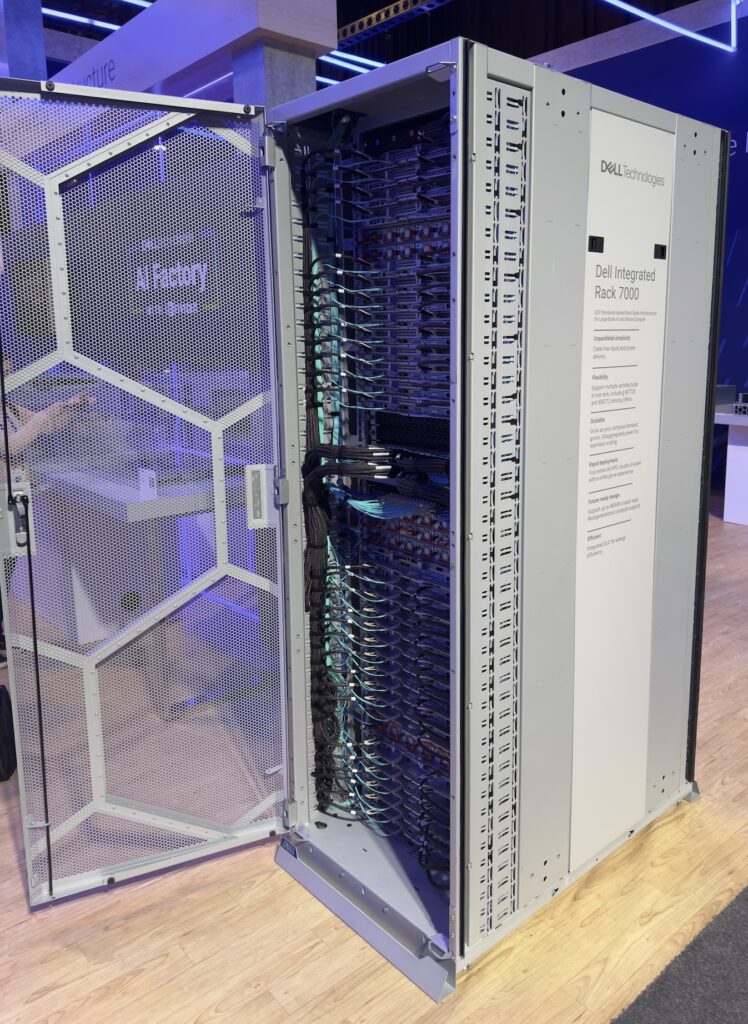
CoreWeave部署搭载NVIDIA GB300 NVL72的戴尔集成机架,标志着云端AI服务的可扩展性和性能实现了显著提升。该解决方案采用液冷式戴尔集成机架可扩展系统,并搭载PowerEdge XE9712服务器。每个机架配备72个NVIDIA Blackwell Ultra GPU和36个基于Arm架构的NVIDIA Grace CPU,为下一代AI工作负载提供了强大的基础。
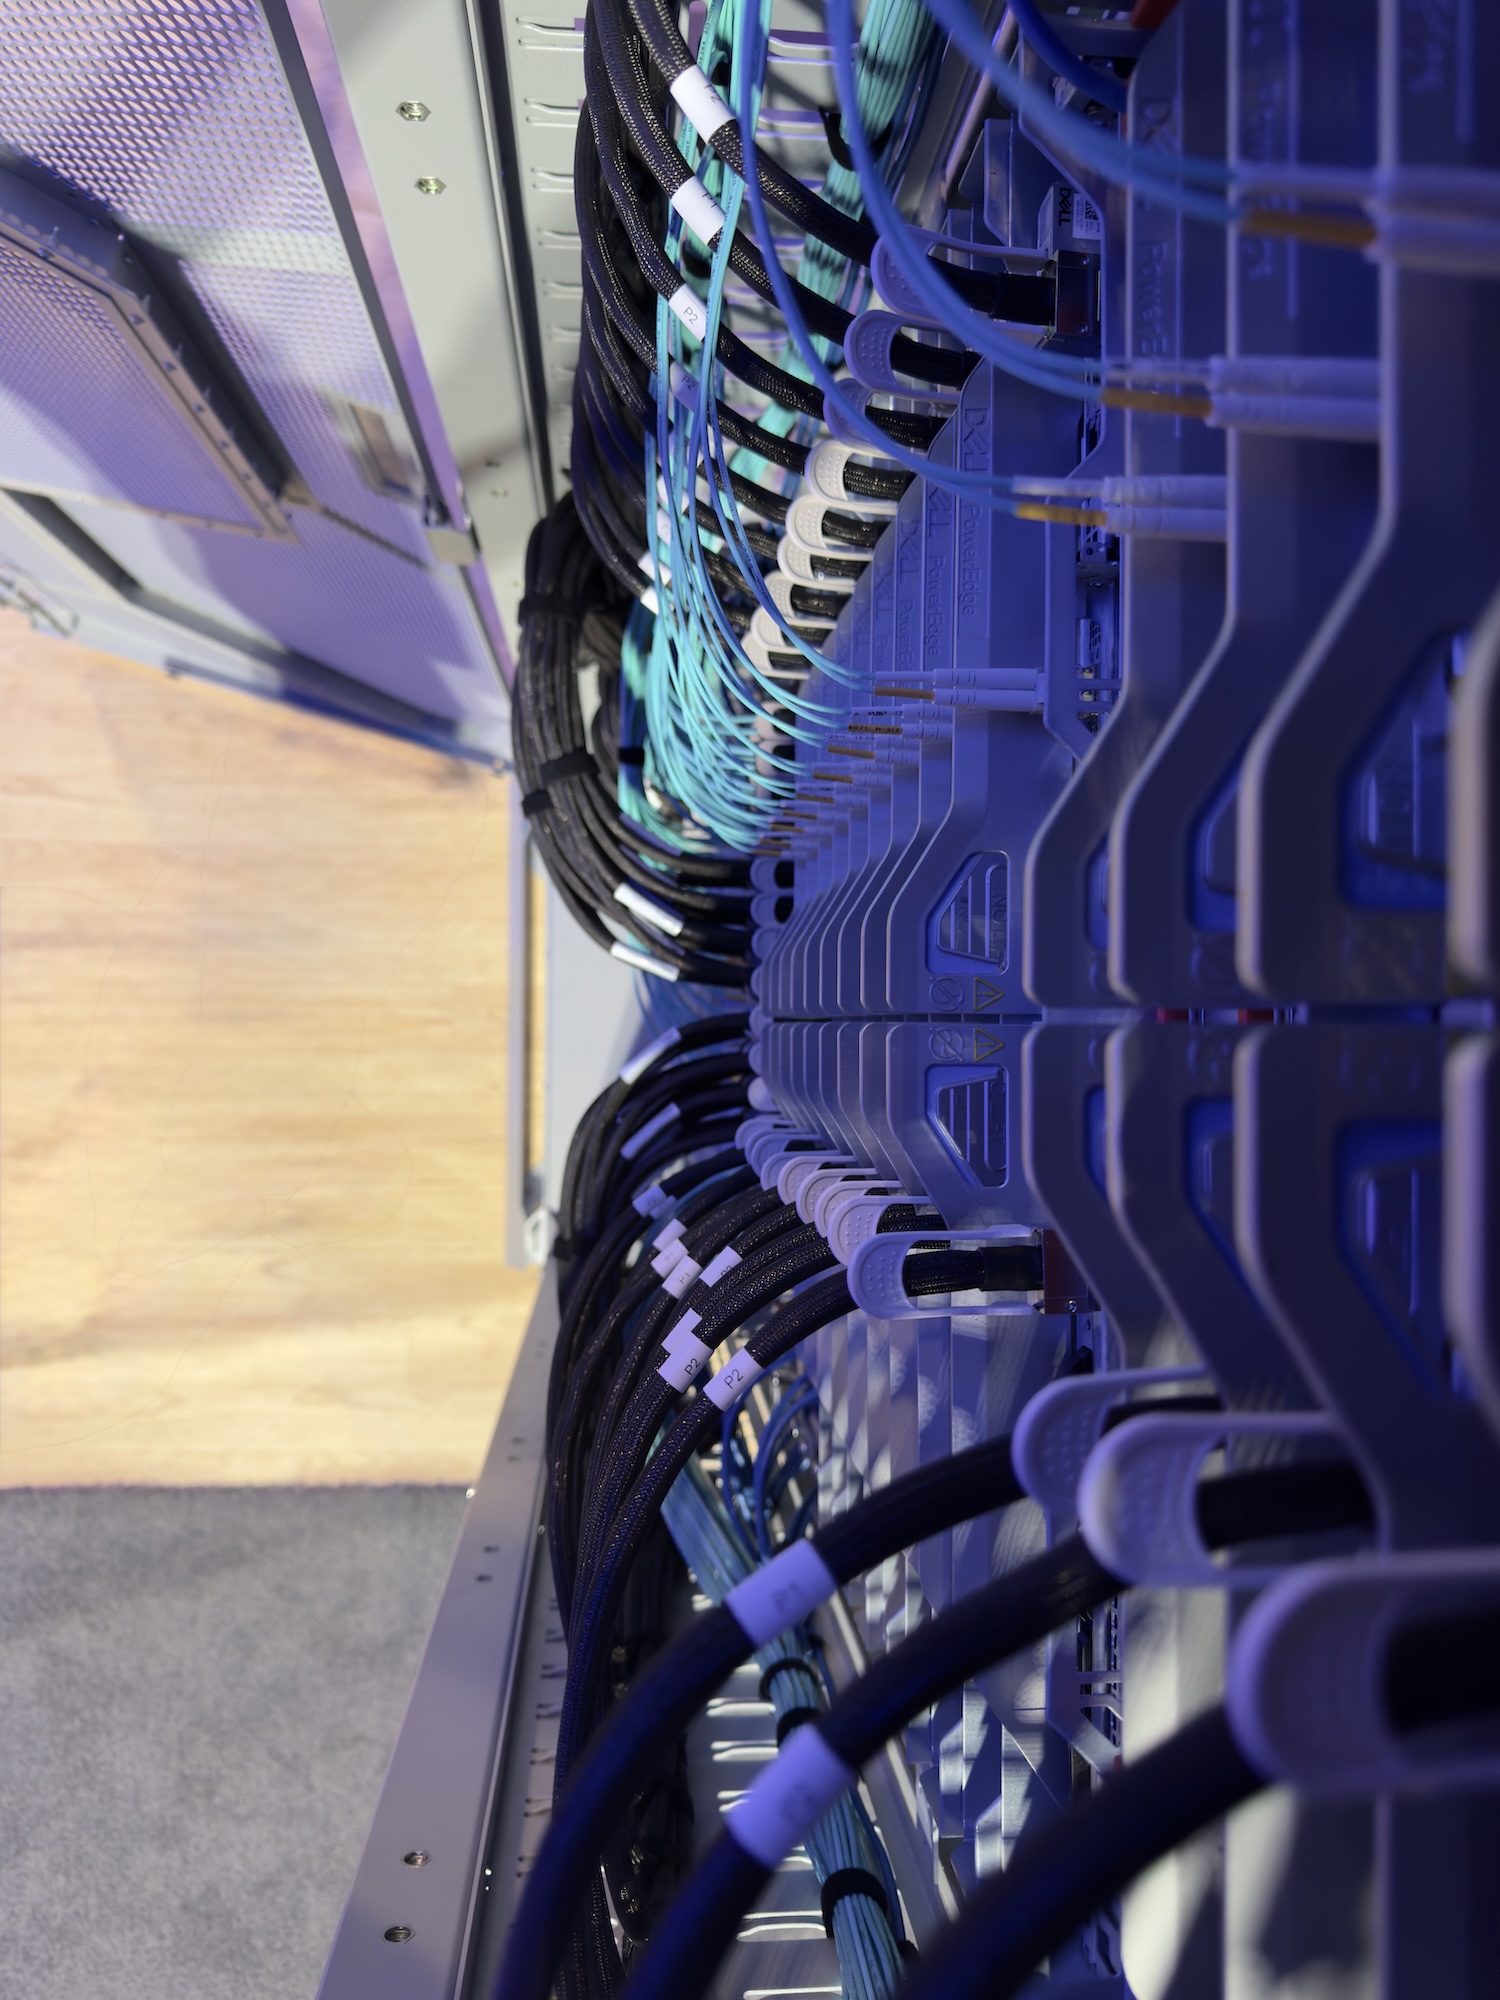
该系统的核心是 NVIDIA Blackwell Ultra GPU,其 AI 计算 FLOPS 比上一代产品高出 1.5 倍,从而能够更快、更高效地处理复杂模型。该系统还扩展了 HBM3e 内存,每机架可提供高达 21TB 的高带宽 GPU 内存,是上一代 GB1.5 NVL200 的 72 倍。内存的大幅提升支持更大的批次大小和更复杂的模型,这对于最大限度地提高 AI 推理和推断任务的吞吐量至关重要。
第五代 NVIDIA NVLink 技术提供高达 130TB/s 的聚合带宽,确保系统中每个 GPU 之间实现无缝高速通信。这种互联互通水平对于 AI 模型(尤其是大规模运行的模型)实现峰值性能至关重要。
新一代 InfiniBand 技术进一步增强了网络连接性能,NVIDIA Quantum-X800 InfiniBand 交换机和NVIDIA ConnectX-8 SuperNIC为每个 GPU 提供 800 Gbps 的专用连接。这种架构确保了卓越的远程直接内存访问 (RDMA) 性能,从而最大限度地提高了大规模 AI 工作负载的效率。
安全性和多租户问题通过运行在 NVIDIA BlueField-3 DPU 上的 NVIDIA DOCA 软件框架得到解决。这一组合通过提供高达 200Gb/s 的线速租户网络和高性能 GPU 数据访问来加速 AI 工作负载,并支持安全的多租户云环境。
专为前沿人工智能而设计
戴尔集成机架解决方案旨在快速部署并无缝集成到生产环境中。据戴尔称,与上一代 NVIDIA Hopper 相比,该系统可将用户响应时间提高十倍,并将每瓦吞吐量提高五倍。
CoreWeave 强调,该系统专为前沿规模的人工智能 (AI) 而设计,使用户能够训练、优化和部署具有数万亿参数的模型。它专门设计用于处理测试时间扩展推理的高计算需求,这是在生产中部署高级 AI 模型的关键要求。
此次部署显著增强了 CoreWeave 的 AI 云平台,简化了大型语言模型的训练、推理和实时推理。该系统架构支持通过 NVIDIA NVLink 交换托盘进行快速的 GPU 间通信,提供超过百亿亿次浮点运算的密集 AI 性能,并在单个机架中提供高达 40TB 的高速内存。
致力于性能和可扩展性
CoreWeave 计划全年推出搭载 NVIDIA GB300 加速的戴尔服务器,彰显其对效率、可扩展性和行业领先性能的承诺。该计划得到了戴尔 AI 专业服务的全力支持,该服务在数据中心设计和集成方面拥有深厚的专业知识,确保客户获得最佳性能并顺利过渡到下一代 AI 基础架构。


 Amazon