

戴尔科技集团宣布对其人工智能数据平台进行重大更新,这是戴尔人工智能工厂 (Dell AI Factory) 计划的一部分。这些改进旨在帮助企业将分散、孤立的数据转化为快速、可重复的人工智能成果。随着人工智能的普及,企业数据量不断增长,企业需要集安全性、灵活性和可扩展性能于一体的架构。戴尔的方案以构建统一、开放和模块化的基础为中心,该基础能够连接孤立的数据孤岛,同时支持训练、微调、检索增强生成 (RAG) 和推理等高级工作负载。
释放孤立数据对 AI 工作负载的价值
戴尔人工智能数据平台的架构将数据存储与处理分离,消除了性能和管理瓶颈。这种分离使得不同的团队(例如数据科学家、DevOps 工程师和 IT 管理员)能够在多个人工智能工作流程中使用相同的数据平台,而无需每次都重新构建基础架构。该平台还与 NVIDIA 人工智能数据平台参考设计直接集成,为企业提供跨戴尔和 NVIDIA 技术的优化互操作性和加速性能。
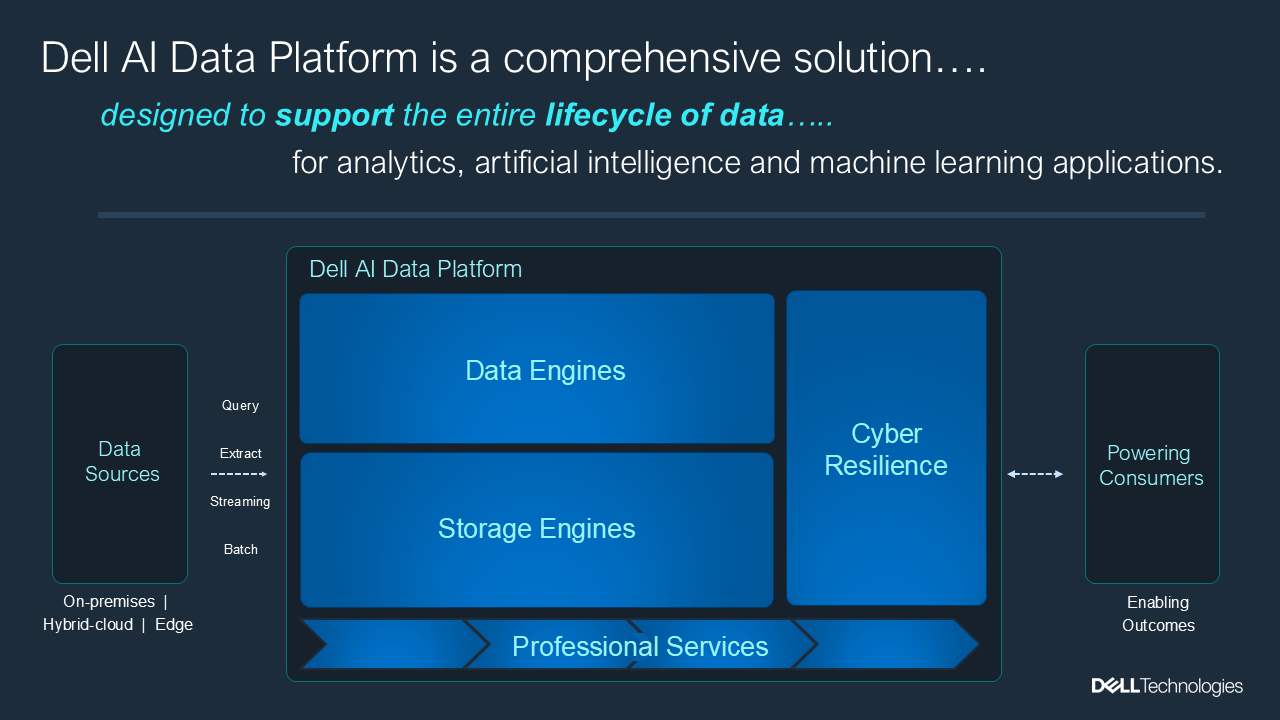
戴尔平台围绕四大关键支柱构建:用于数据放置和移动的存储引擎、用于实时洞察的数据引擎、内置网络弹性以及智能数据管理服务。这些组件共同为寻求大规模实施人工智能的企业创建了一个灵活、可扩展且安全的基础。
适用于现代 AI 管道的高性能存储引擎
戴尔人工智能数据平台的核心构建于 PowerScale 和 ObjectScale 存储系列之上。这两款产品均已得到增强,可提供更快的数据吞吐量、更高的安全性以及对多协议访问的支持,这些功能对于训练、微调、推理和 RAG 管道至关重要,因为在这些管道中,延迟和数据局部性会直接影响模型的准确性和迭代速度。
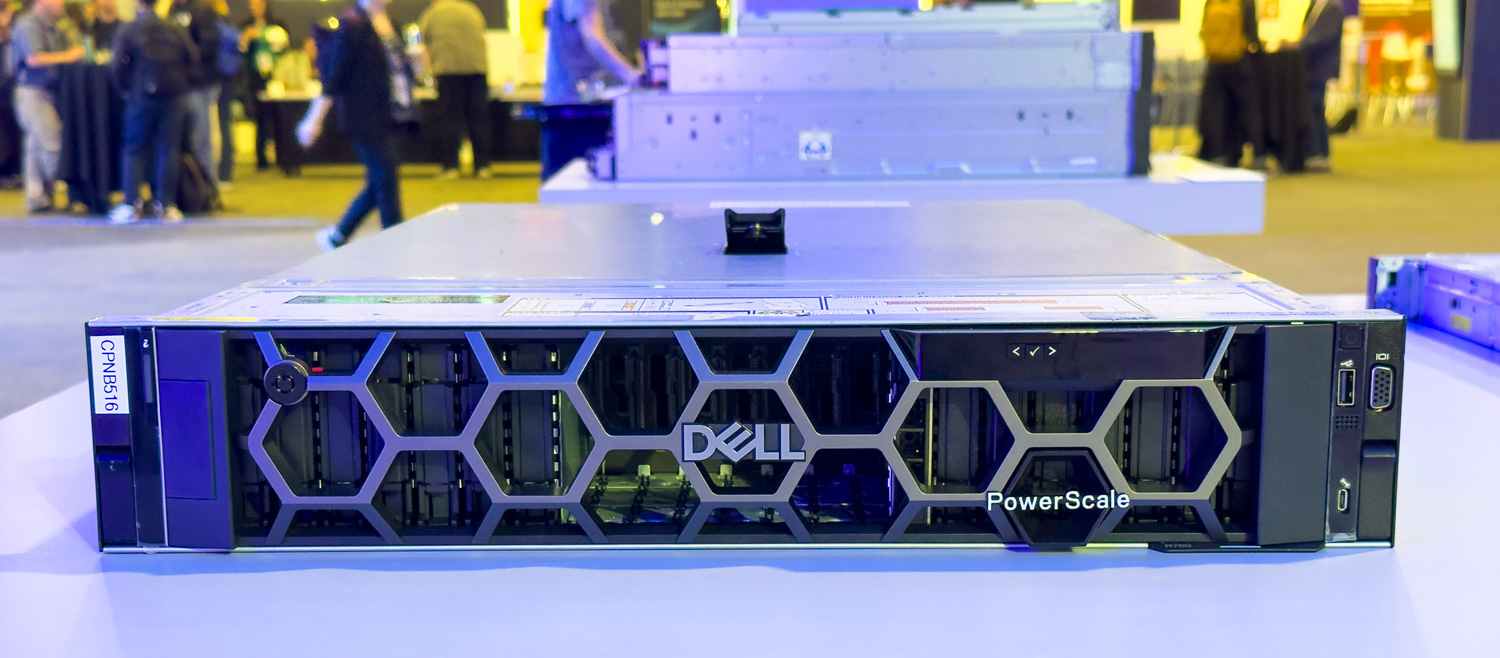
戴尔 PowerScale 兼具 NAS 的易用性和现代 AI 架构所需的大规模并行处理能力。最新更新与包括 GB200 和GB300 NVL72在内的全新 NVIDIA 平台紧密集成,并与现有应用堆栈无缝兼容。这种协同确保运行 GPU 密集型工作负载的企业能够线性扩展,同时保持性能稳定。获得 NVIDIA 云合作伙伴认证的 PowerScale F710 便是最好的例证,它在单个系统中支持超过 16,000 个 GPU,同时占用的机架空间却减少了五倍,从而显著提高了数据中心的密度和资源效率。
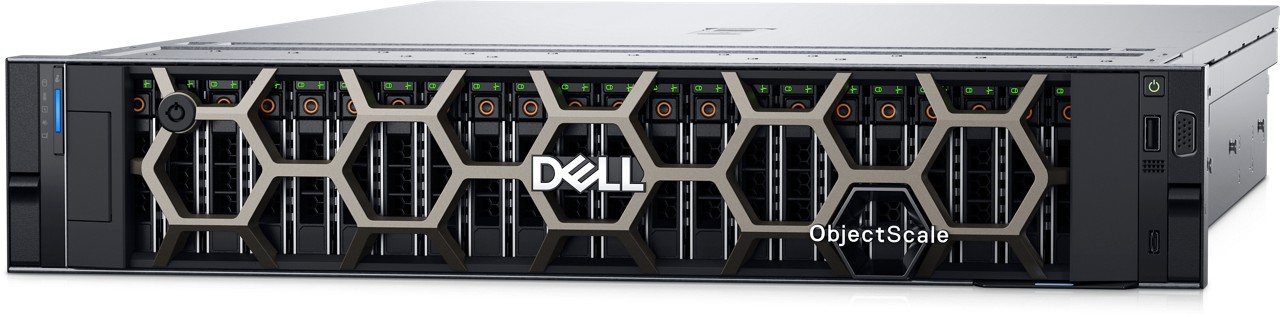
作为 PowerScale 的补充,Dell ObjectScale 提供与 S3 兼容的高性能对象存储,专为大规模 AI 数据工作负载而构建。客户可以将其部署为专用设备,也可以部署为 Dell PowerEdge 服务器上的软件定义堆栈。性能基准测试表明,ObjectScale 现在的运行速度比上一代全闪存配置快八倍,这直接提升了数据密集型 AI 训练和分析工作流程的性能。
戴尔还将在即将发布的技术预览版中推出基于 RDMA 的 S3,其性能显著提升:与传统 S3 协议相比,吞吐量提升高达 230%,延迟降低 80%,CPU 使用率降低 98%。这些改进有助于减少数据移动开销,释放系统资源用于 GPU 处理和推理。此外,增强的 AWS S3 集成、存储桶级压缩和小对象性能调优功能,可将 10KB 对象操作的吞吐量提升高达 19%,延迟降低 18%,这对于人工智能和边缘应用中常见的高流失率小文件环境至关重要。
用于实时 AI 激活的智能数据引擎
戴尔人工智能数据平台的数据引擎旨在使原始数据立即用于人工智能、分析和决策。这些引擎由戴尔与 NVIDIA、Elastic 和 Starburst 等合作伙伴共同开发,将数据搜索、分析和语义理解集成到统一的操作层。
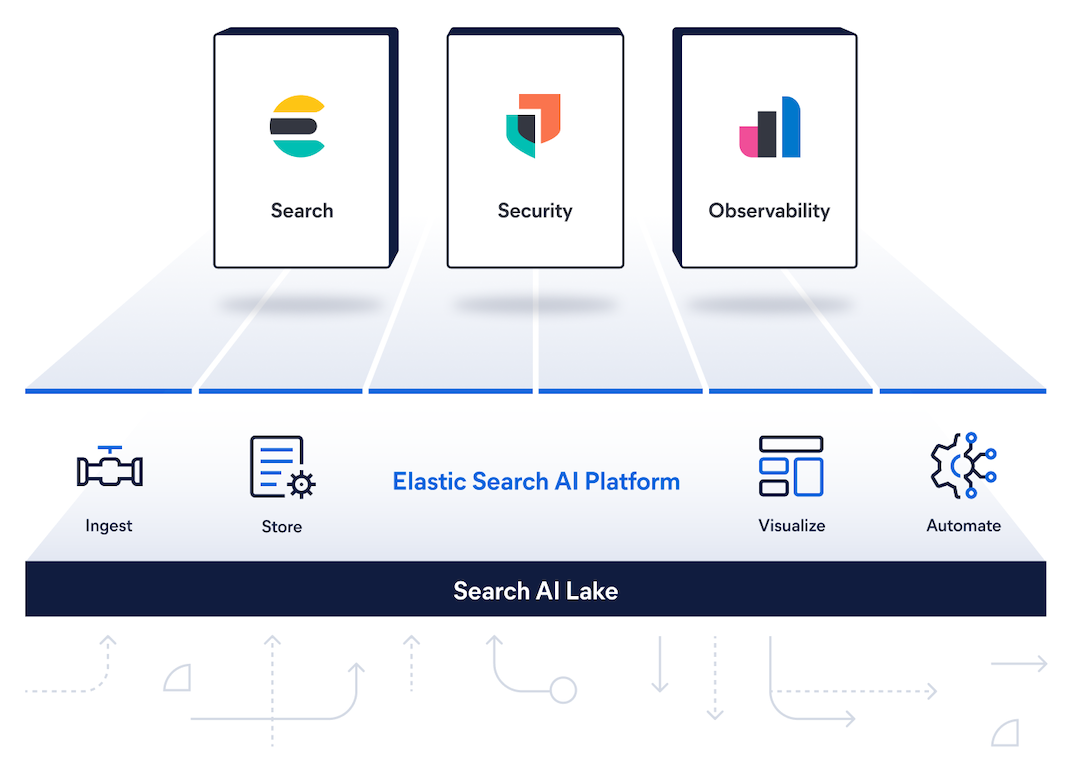
全新数据搜索引擎由 Elastic 提供支持,可在企业数据源之间提供自然语言搜索。用户可以对话式查询数据集,非常适合 RAG、语义搜索和生成式 AI 用例。该引擎与 MetadataIQ 集成,增强了文件级感知能力,通过元数据标记和发现功能在 PowerScale 和 ObjectScale 上索引数十亿个文件。此功能使开发人员能够使用 LangChain 等工具构建更具创新性的 RAG 应用程序,这些工具可以高效地更新和检索新数据或已更改的数据,从而最大限度地降低索引成本并维护准确的矢量数据库。
基于 Starburst 构建的数据分析引擎进一步扩展了这一功能,支持跨电子表格、数据库、云仓库和湖仓进行联合查询,无需数据迁移。全新的代理层利用大型语言模型 (LLM) 实现核心数据管理任务的自动化,包括文档生成、洞察生成和 SQL 增强。通过将 AI 直接嵌入数据库工作流,企业可以更快地从原始数据摄取转化为可执行的输出。
一个重要的新增功能是用于数据分析引擎的 MCP 服务器,它引入了多智能体协调功能,并为 AI 应用程序开发提供原生支持。团队可以同时运行生成式 AI 和数据分析工作流,同时保持模型治理和沿袭跟踪——这对于受监管或大规模企业环境至关重要。此外,统一的向量存储访问功能允许在 Iceberg、戴尔数据搜索引擎、PostgreSQL + PGVector 和其他存储库之间无缝运行 RAG 和 AI 搜索功能。
戴尔和 NVIDIA 的 GPU 加速矢量搜索
戴尔将 AI 数据平台与NVIDIA cuVS集成,为企业级矢量搜索带来 GPU 加速。这项技术进步使企业能够以卓越的性能和可扩展性执行混合关键词和矢量搜索。借助 GPU 加速,查询运行速度更快,相似度评分更高,并且可以在符合企业治理标准的安全本地环境中实时处理大型矢量存储。
这款 GPU 加速的混合搜索连接了戴尔的存储和数据引擎,缩小了存储基础架构与 AI 推理之间的差距。借助 cuVS 和戴尔的托管基础架构,IT 团队可以获得一个针对速度和安全性进行优化的交钥匙高性能搜索解决方案,能够支持最新的企业级 LLM 和多模式工作负载。
更大的图景:企业 AI 的统一平台
扩展的戴尔AI数据平台彰显了戴尔科技集团向AI原生基础架构环境的持续转型。通过与NVIDIA、Elastic和Starburst等合作伙伴的开放式协作,戴尔整合了其服务器、存储和数据引擎,将自己定位为现代AI和分析的全栈解决方案提供商,而非存储供应商。


 Amazon