

IBM 推出了 IBM Spyre Accelerator,这是一款低延迟推理引擎,专为生成式和代理式 AI 而设计,这些 AI 要求响应速度、安全性和正常运行时间至关重要。Spyre 专为寻求将 AI 与现有记录系统集成的企业而设计,允许敏感数据保留在平台上,而不会影响性能。
IBM z17 和 LinuxONE 5 将于 10 月 28 日全面上市,Power11 也将于 12 月初上市。该加速器是一款 5nm、32 核 SoC,封装在一张 75 瓦 PCIe 卡上。IBM 支持每个 IBM Z 或 LinuxONE 系统最多包含 48 张卡的集群,每个 IBM Power 系统最多包含 16 张卡,从而能够横向扩展,用于与事务性工作负载(例如欺诈检测、零售自动化和风险评分)相邻的多模型推理。Spyre 代表了 IBM 人工智能硬件中心研究成果的产品化,针对数据本地化、安全性和能效是基本要求的本地部署进行了优化。
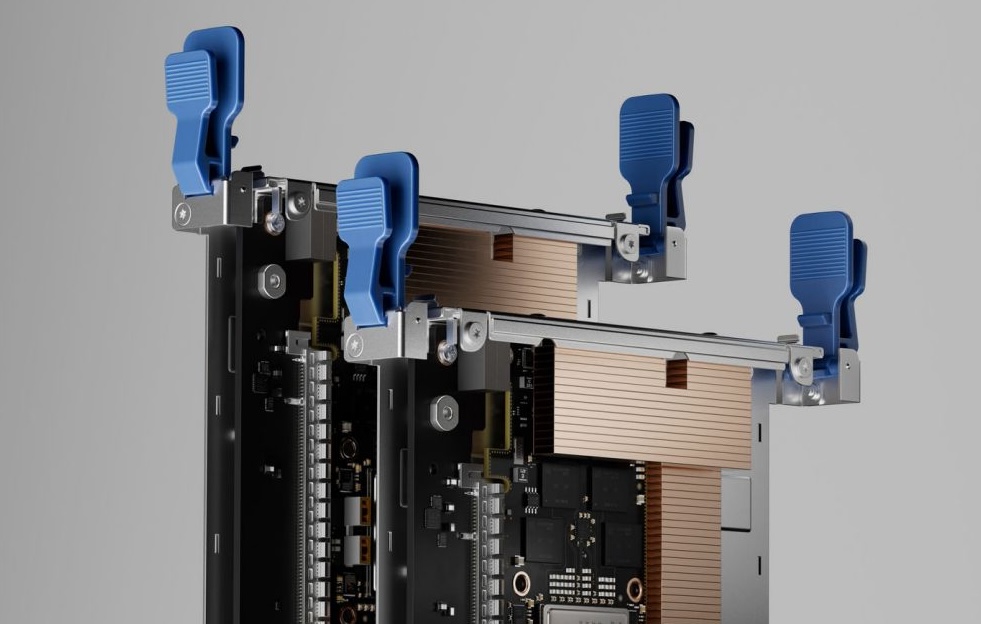
从逻辑管道到代理人工智能
企业工作流程正在从确定性逻辑链转向能够实时感知情境、制定计划并采取行动的代理型人工智能 (AI)。即使核心系统保持高交易量,这些代理系统也需要低延迟推理和可预测的服务质量。IBM 的方法是将专用推理硬件直接部署在关键数据所在的平台上。将数据保存在 IBM Z、LinuxONE 和 Power 上,可以避免不必要的数据流出和外部处理,从而降低风险和合规性开销。在靠近数据的地方运行生成式推理和代理式推理还可以最大限度地减少回程和网络引起的波动,而这些波动通常是尾部延迟出现的原因。总体目标是在不影响吞吐量、更改窗口或服务级别的前提下,将 AI 驱动的决策添加到现有的 OLTP、批处理和消息传递流中。
Spyre 架构
Spyre 是一款商用片上系统 (SoC),基于 IBM 研究院的原型开发而成。它采用 5nm 工艺,拥有 25.6 亿个晶体管和 32 个加速器核心,并针对并发、低延迟推理而非模型训练进行了优化。该设备以 75 瓦 PCIe 附加卡的形式交付,为基础设施团队提供熟悉的部署和服务模式。
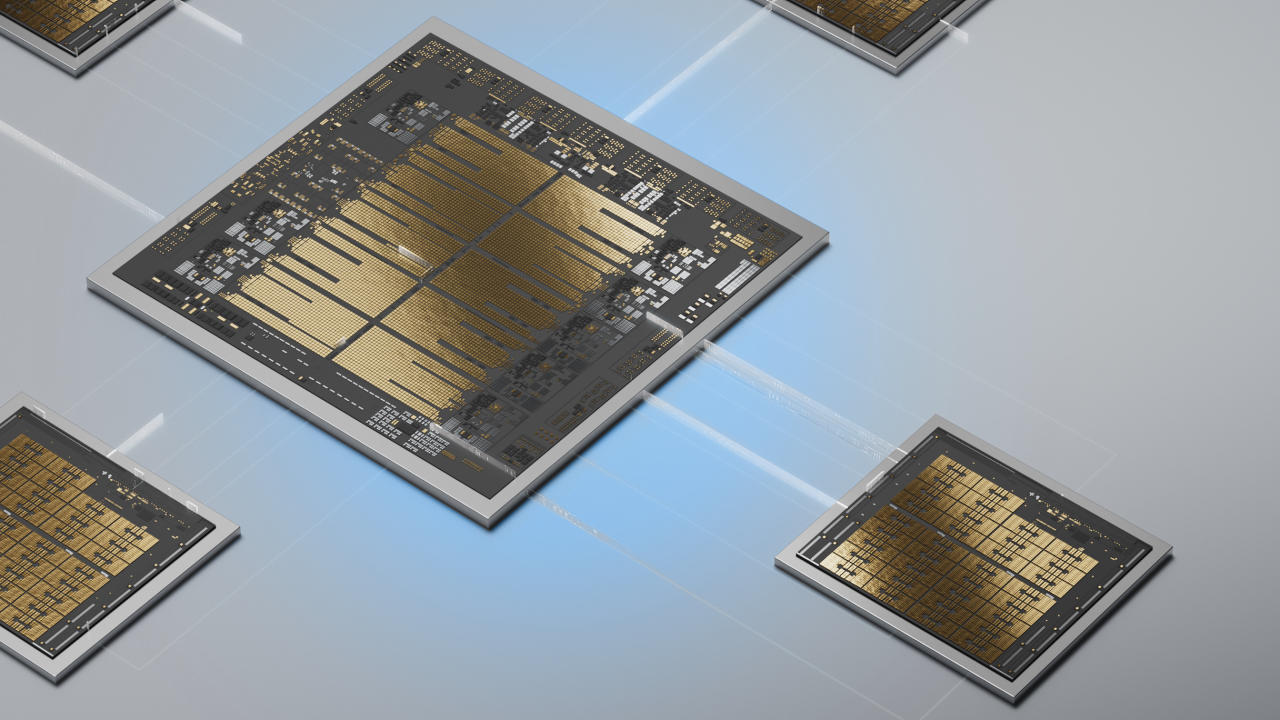
IBM 设计了横向扩展配置,允许在 IBM Z 或 LinuxONE 5 系统中最多使用 48 张卡,在 IBM Power11 系统中最多使用 16 张卡,从而在单一平台内实现多模型服务和租户隔离。在软件方面,Spyre 与 IBM 的企业堆栈集成,以实现模型服务、安全性和可观察性,而 Power 则添加了一键式目录以快速跟踪服务部署。这种组合旨在加快价值实现速度,同时将 AI 服务保持在现有的运营和合规性范围内。
平台整合
IBM Z 和 LinuxONE:与 Telum II 共置
在 z17 和 LinuxONE 5 上,Spyre 与 Telum II 处理器组合协同运行,使推理与交易数据和事件流共存。这种安排保留了现有的安全域和审计跟踪,这在受监管的环境中至关重要。通过在本地运行推理,组织可以最大限度地减少对外部加速器的访问,并防止额外的延迟影响交易 SLA。该系统最多可扩展至 48 张卡,同时支持多种模型和工作负载。它提供逻辑隔离,以满足不同业务部门或监管要求。这对于支付流程、欺诈预防、索赔处理和供应链事件尤其重要,因为在这些情况下,每一毫秒都至关重要,扩大合规范围并非明智之举。
IBM Power11:目录驱动的 AI 服务和 MMA 协同作用
在 Power11 服务器上,Spyre 与 AI 服务目录集成,旨在在现有的 Power 集群中快速采用。管理员只需单击即可部署服务,这与 Power 客户传统的中间件、分析和业务线应用程序的运行方式一致。Spyre 与 Power 的片上 MMA 加速器相结合,可提高数据转换和预处理吞吐量,而这些对于生成式 AI 流水线和复杂流程集成至关重要。
IBM 举了一个吞吐量的例子,在提示大小为 128 的情况下,系统可以在大约一小时内处理超过 800 万个文档,用于知识库集成。对于开发 RAG 系统或进行大规模企业搜索的企业来说,重点在于加速数据准备和提取,而不仅仅是推理步骤。整体适配性针对的是混合场景,例如制造、零售、医疗保健和 ERP 密集型部署,在这些场景中,可预测的吞吐量和可维护性是关键。
从 IBM AI 硬件中心到现场部署
Spyre 展示了 IBM 如何将研究成果转化为实际产品。该技术最初由 IBM 研究院开发,最初是一个原型,随后通过在约克敦高地园区的迭代集群部署以及与奥尔巴尼大学新兴人工智能系统中心的合作而日臻成熟。IBM 基础架构随后将 IBM Z、LinuxONE 和 Power 的设计产品化,使芯片能够满足企业对安全性、可靠性、生命周期管理和可维护性等需求。IBM 高管将 Spyre 描述为面向多模型 AI 的基础架构,强调其能够在已托管核心数据和交易的平台上安全且灵活地扩展生成型和代理型工作负载。
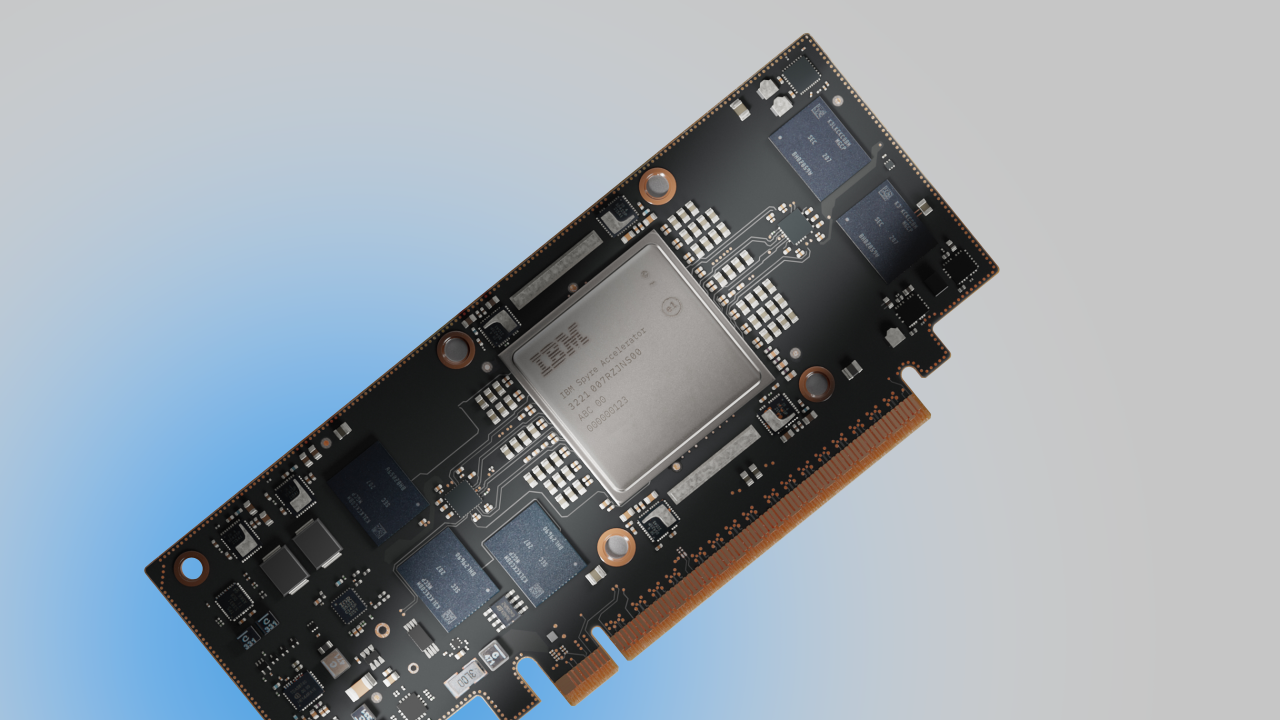
Spyre 的价值与 IBM 的运营态势密不可分。通过在数据创建和管理的地方运行推理,组织可以限制数据流出并降低合规性复杂性。IBM Z 和 LinuxONE 提供的加密、隔离、日志记录和审计功能已成为许多客户监管框架不可或缺的一部分。Power 提供了一个强大的安全和管理堆栈,适用于混合分析和事务处理环境。集群支持、逻辑分区和第一方可观察性工具符合大型机和 Power 的运营规范,使 AI 服务能够像任何其他一级工作负载一样进行部署、监控和服务。对于金融、医疗保健和公共部门的许多买家来说,这些运营保证优先于原始 TOPS 或综合基准。
性能和可伸缩性考虑因素
虽然 IBM 尚未公布每个模型的全面性能细节,但其架构指标显而易见。Spyre 的目标是针对代理循环和事件驱动管道优化的低延迟推理路径,其中并发性和尾部延迟控制比单独的峰值吞吐量更为重要。通过 PCIe 卡集群进行横向扩展,使团队能够调整部署规模,以实现多模型服务、租户隔离和未来增长,而无需重新设计平台。
在 Power 上,MMA-Spyre 组合可加速数据准备和转换,这通常占据了 RAG 和企业搜索端到端时间的大部分。企业应构建概念验证以反映生产环境:模型大小和令牌窗口、请求并发性、与事务负载的交互以及争用情况下尾部延迟的遥测。
IBM 基础设施首席运营官兼 IBM 系统总经理 Barry Baker 强调了公司专注于开发新兴 AI 工作负载的基础设施。他强调了 Spyre Accelerator 在增强系统以支持多模型 AI(包括生成式 AI 和代理式 AI)方面发挥的作用。他补充说,这项创新旨在使客户能够安全、灵活且高效地扩展关键任务 AI 工作负载,同时最大限度地发挥企业数据的价值。
IBM 半导体总经理 Mukesh Khare 指出,早在近期人工智能热潮兴起之前,IBM 就于 2019 年推出了人工智能硬件中心,以满足日益增长的人工智能计算需求。他对该中心首款芯片的商业化表示祝贺,该芯片旨在提升 IBM 大型机和服务器客户的性能。
使用案例
金融服务团队可以利用 Spyre 进行实时欺诈检测,该功能直接针对平台数据集运行,无需扩大审计范围即可进行模型刷新和策略更新。在零售和物流领域,代理助理可以通过将推理保持在本地操作系统中,以一致的响应时间协调库存和履行决策。医疗保健和政府机构可以在严格的隐私和驻留限制下部署生成性摘要和决策支持,避免数据移动,否则可能会引发额外的合规工作。在工业和 ERP 密集型环境中,Spyre 可以为运行在 Power 上的 SAP、Oracle 和工厂遥测系统提供流程自动化和异常检测支持,确保确定性行为和可维护性。
IBM 基础架构领导层将 Spyre 视为 AI 转型的基础设施,旨在支持企业级多模型生成和代理工作负载,并提供强大的安全性和弹性保障。IBM 半导体领导层将 Spyre 描述为 AI 硬件中心的首个商业化里程碑,并期待 IBM 大型机和服务器客户持续推进硬件创新。
底线
Spyre 是 IBM 为低延迟推理提供的本地解决方案,适用于安全性、可靠性和数据本地性均不容妥协的环境。其硬件规模、平台原生集成和运营模式与 IBM Z、LinuxONE 和 Power 等寻求在与核心事务相同的爆炸半径内实现代理型 AI 的平台相一致。对于买家来说,下一步是证据:概念验证,以验证其在实际工作负载下的延迟、并发性和治理优势。如果实际应用表现符合要求,Spyre 提供了一条实用途径,可将生成式和代理型 AI 直接嵌入到关键任务系统中。
可用性
Spyre 将于 10 月 28 日起在 IBM z17 和 LinuxONE 5 上正式发布。IBM Power11 系统将于 12 月初接收 Spyre。此次分阶段发布将为大型机和 LinuxONE 用户提供最早的平台推理途径,Power 平台用户也将紧随其后。


 Amazon