

MinIO 发布了 MemKV,这是一款上下文内存存储产品,旨在解决大规模 AI 推理环境中日益严重的瓶颈问题。MemKV 与AIStor一起,是 MinIO 产品组合中的第二个核心组件,它将 MinIO 的数据基础设施扩展到内存层,目标是为跨 GPU 集群运行的智能体 AI 工作负载提供持久共享的上下文信息。
随着人工智能系统从单次响应交互演进到多步骤推理和任务执行,在推理周期中保持上下文信息至关重要。在当前架构中,由于GPU相邻内存层(例如HBM和DRAM)容量有限,上下文信息经常丢失。这迫使GPU重新计算先前生成的上下文信息,从而增加延迟、计算利用率和能耗。MinIO将此描述为一种重复计算开销,这种开销会随着规模的扩大而加剧,尤其是在超大规模和云环境中。
MemKV旨在通过提供一个共享的持久内存层来缓解这个问题,该内存层能够在PB级规模下实现微秒级的检索速度。通过在推理操作之间维护上下文,该平台减少了冗余计算,并提高了整体系统效率。在内部基准测试中,MinIO报告称,在生产并发级别下,首次获取令牌的时间有所缩短。在一个具有128个GPU和128K个令牌上下文窗口的典型部署中,GPU利用率从约50%提高到超过90%,从而显著节省了年度计算成本。
MinIO 的领导层指出,在规模较小的部署中,重新计算的开销通常被掩盖,但在规模化部署中则会成为结构性效率低下的问题。随着 GPU 集群规模的扩大,重复生成上下文的成本(包括功耗和基础设施需求)都会增加,因此,为实现可持续的 AI 运行,专用内存系统必不可少。
解决内存规模权衡问题
传统的AI基础设施需要在速度和规模之间做出权衡。高性能内存层(例如HBM和DRAM)可提供微秒级延迟,但容量有限且成本高昂。相反,存储系统虽然规模庞大,但会引入毫秒级延迟,这不适用于实时推理和长上下文推理。
MemKV旨在通过引入共享内存层来弥合这一差距,该内存层结合了低延迟访问和大规模容量。该平台专为NVIDIA BlueField-4 STX而构建,并集成了NVIDIA Dynamo和NIXL,使整个GPU集群能够以符合推理需求的速度访问公共上下文数据池。这种方法无需在不同的内存和存储层之间传输上下文,从而降低延迟并提高吞吐量。
针对推理工作负载优化的架构
MemKV专为推理数据路径而设计,符合MinIO对GPU内存层次结构中G3.5层的描述。它在基于NVMe的基础架构上提供PB级容量,同时保持微秒级访问特性,有效地将内存规模与GPU计算资源解耦。
该系统通过端到端RDMA 传输,将数据直接从 NVMe 移动到 AI 数据路径,从而避免了传统的存储抽象。这消除了 HTTP 协议、文件系统转换和中间存储服务器带来的开销,而这些在基于对象和基于文件的架构中很常见。
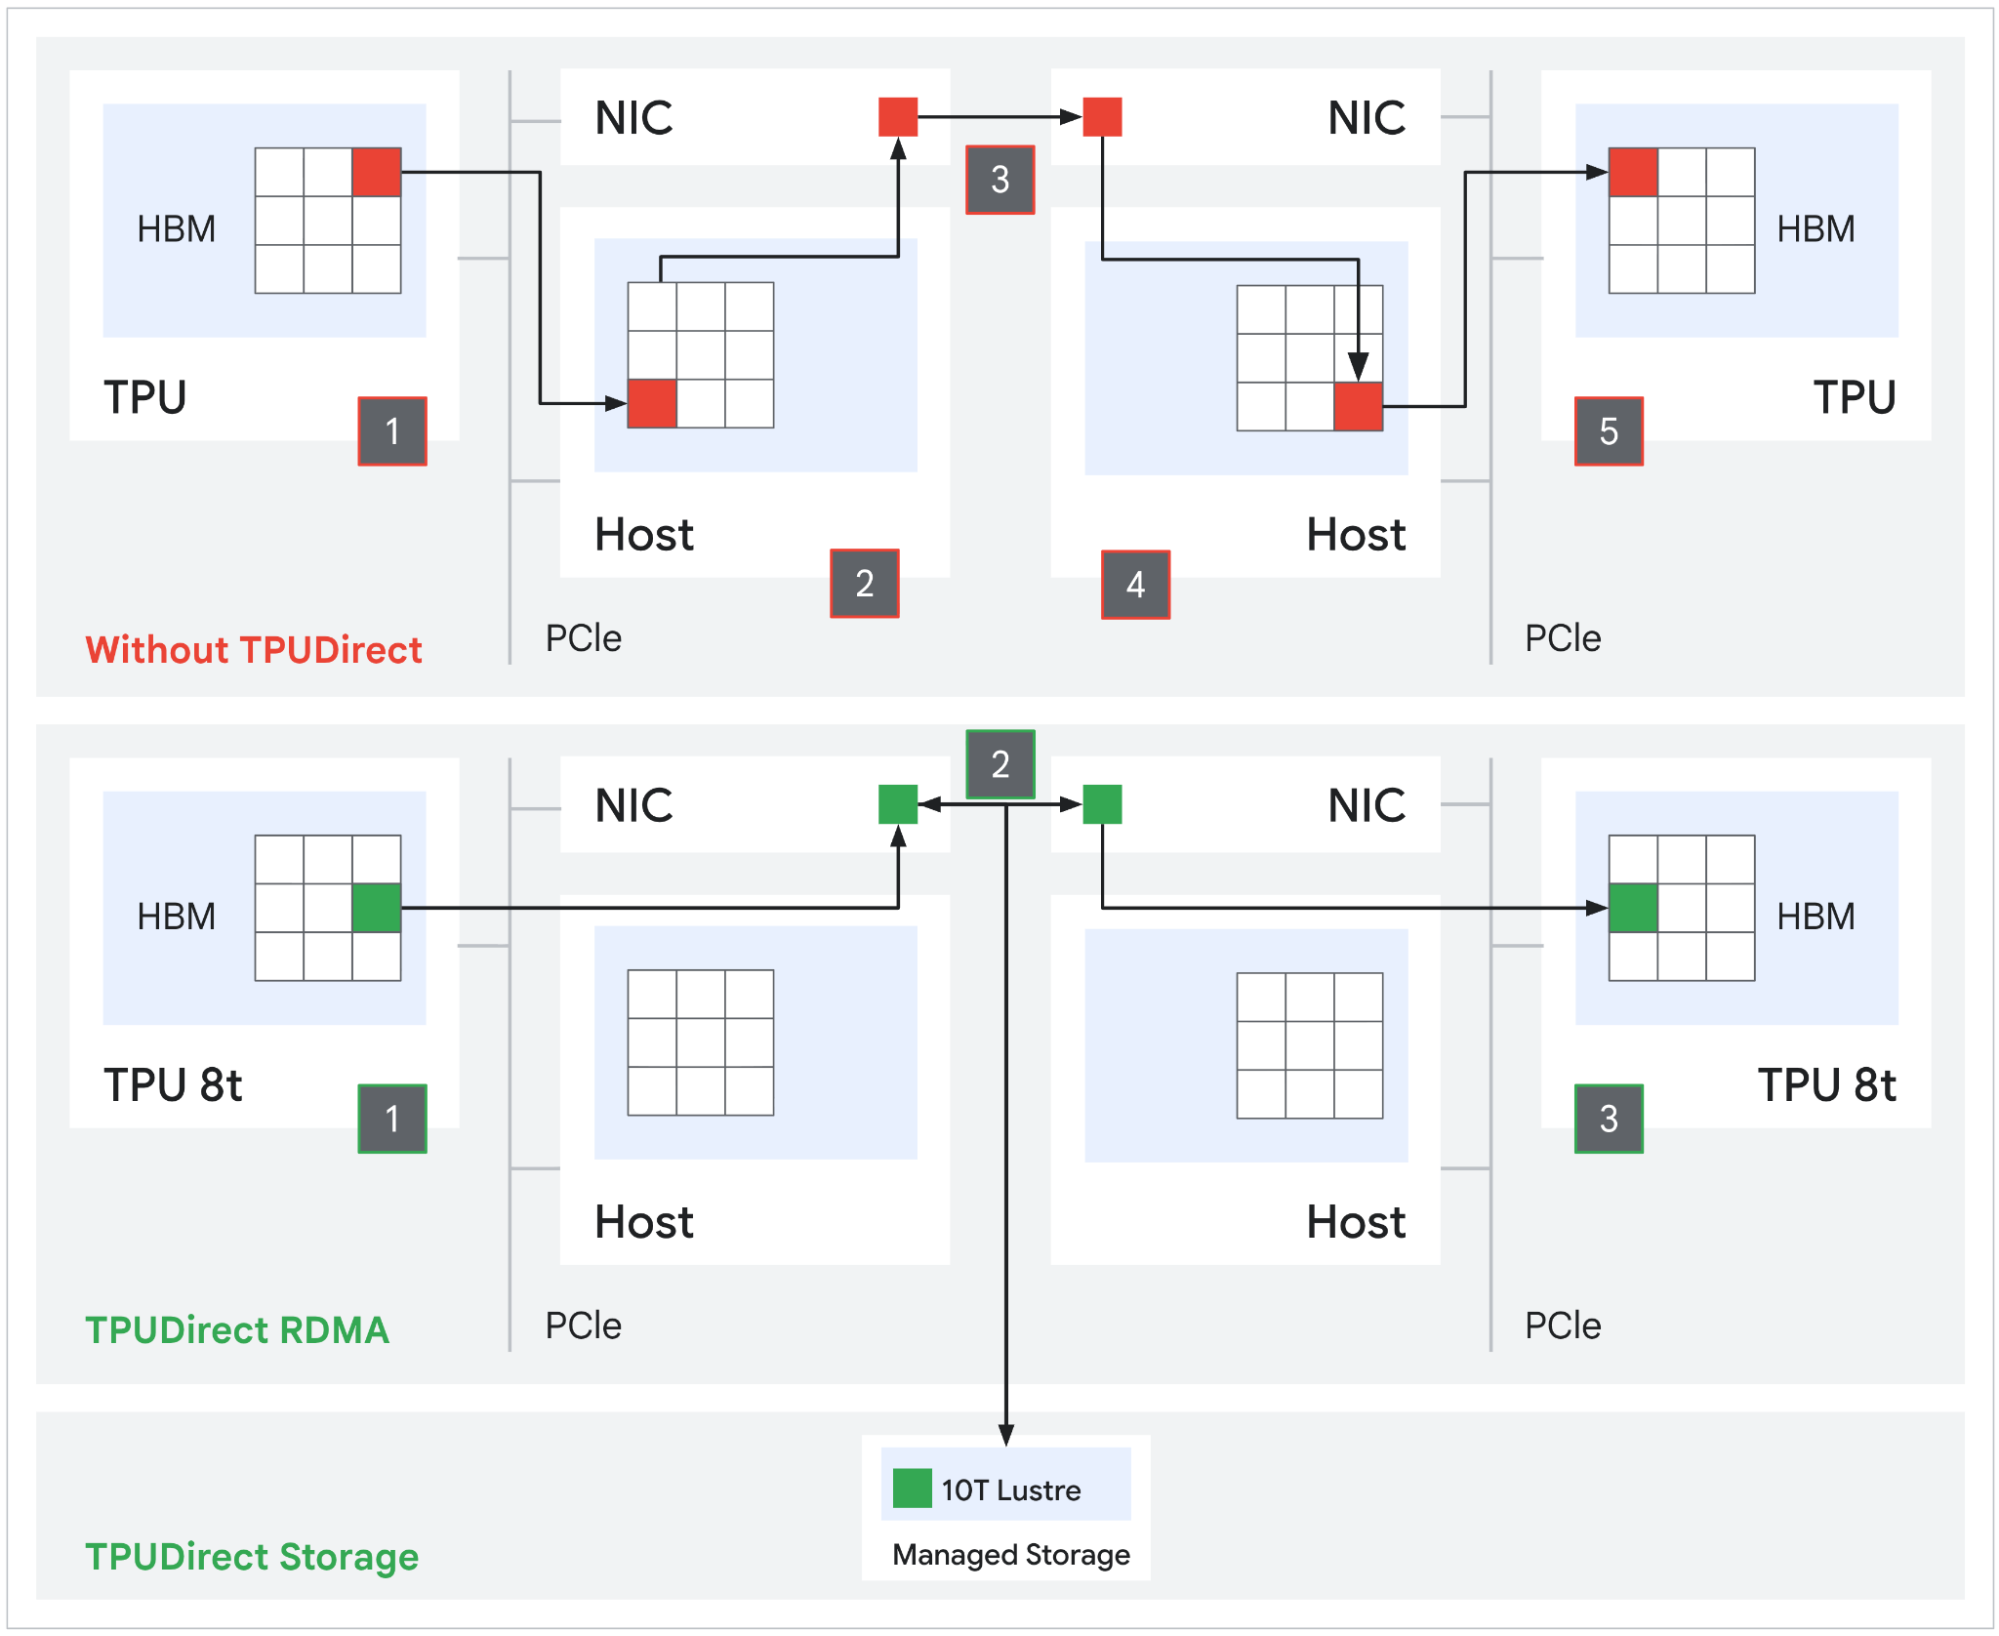
来源:谷歌
关键架构元素包括在NVIDIA BlueField-4 STX上以 ARM64 二进制文件的形式原生执行,并将其嵌入存储层,从而减少对外部 x86 存储节点的依赖。数据传输通过 RDMA 从 GPU 内存传输到 NVMe,绕过了传统的存储堆栈。MemKV 还采用了更大的块大小,范围从 2 MB 到 16 MB,针对 GPU 吞吐量模式进行了优化,而非传统的 4 KB 存储块。网络性能与现代高速架构相匹配,包括 NVIDIA Spectrum-X 以太网和 PCIe Gen6,从而实现了集群内接近线速的数据传输。
可用性
MinIO MemKV 现已上市。


 Amazon