

MLCommons今天发布了MLPerf Storage v3.0的测试结果,这一轮测试不仅改变了基准测试的内容,也改变了领先者的格局。这是唯一经过审计的AI存储基准测试首次涵盖了完整的流程:训练吞吐量、检查点机制,以及两个新的推理工作负载——向量数据库测试和键值缓存测试。共有19家机构提交了143个测试结果,其中11家是首次提交,包括微软Azure、NVIDIA、Everpure以及一批大多数读者可能不太熟悉的AI存储初创公司。同样值得注意的是,在v2.0版本中占据领先地位的DDN、华为、Hammerspace和Lightbits等公司,此次并未提交测试结果。
首先说明一点,v3.0 版本将其模拟加速器从 H100 升级到 B200,提高了单个加速器的带宽要求,因此 v3.0 的数据不能与 v2.0 的结果直接比较。这些数据由 MLCommons 审核的厂商提交;StorageReview 并未进行或独立验证此测试。
检查点是重头戏
MLCommons 将检查点机制列为一级工作负载,因为它已成为公认的性能瓶颈:大规模训练作业会定期写入大量状态,而刷新检查点的每一秒都意味着加速器空闲一秒。本轮测试中最大的数据也属于这一范畴。Everpure(前身为 Pure Storage)首次亮相 MLPerf Storage 大会,提交了 FlashBlade//EXA 的测试结果,其性能几乎与数据节点数量呈线性增长:10 个数据节点时检查点写入速度为 327.6 GiB/s,15 个为 484.1 GiB/s,20 个为 655.6 GiB/s,30 个数据节点时写入速度为 877.5 GiB/s,读取速度为 833.0 GiB/s。过去一年,Everpure 一直宣称 //EXA 具有很高的吞吐量;而此次测试结果首次经审计证实了这些说法。
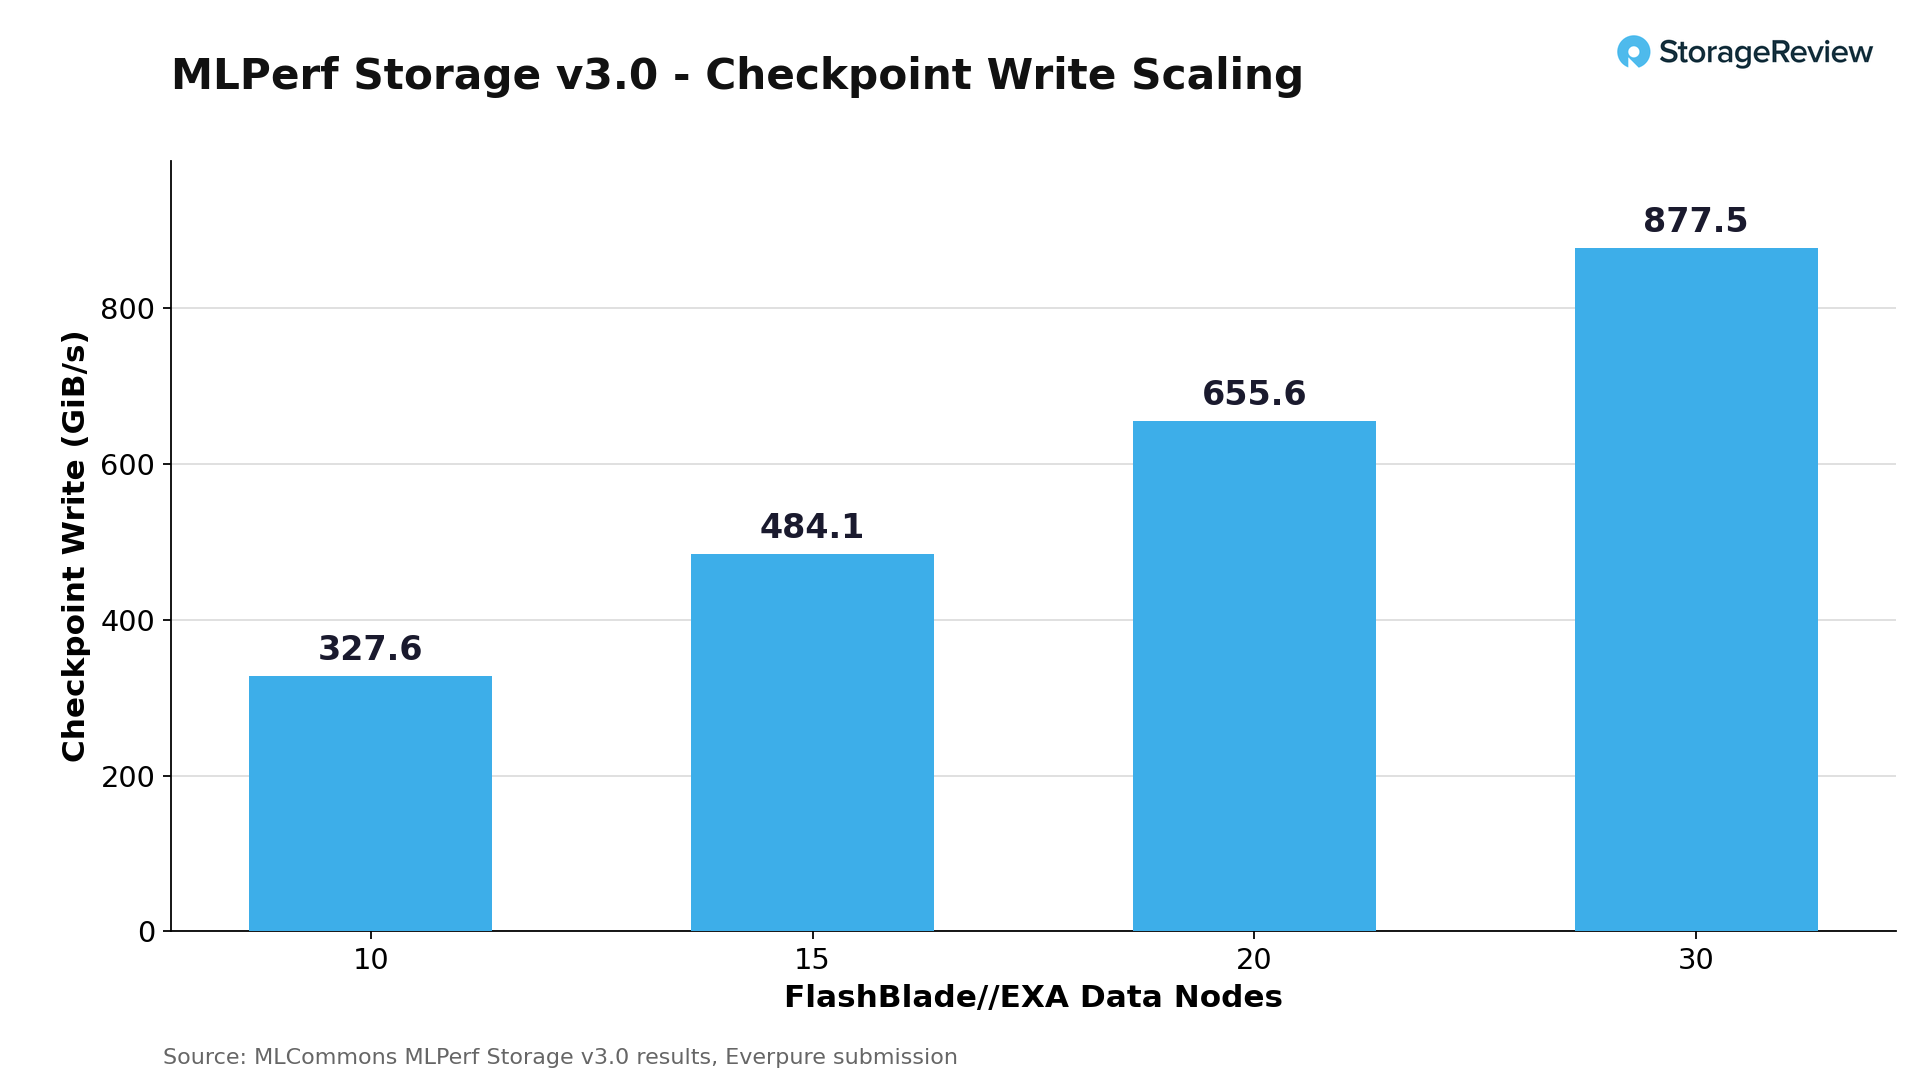
第二高的检查点写入速度或许更能说明问题。Azure Managed Lustre 是首个参与基准测试的超大规模云存储服务,其在 4,096 TiB 的部署规模下,拥有 128 个客户端,检查点写入速度达到了 642.2 GiB/s。在两轮测试之前,人们很难想象托管云文件服务能够与专用 AI 存储阵列相提并论。
| 检查点(热门提交) | 系统 | 写入黑白数据(GiB/s) |
|---|---|---|
| 爱惠浦 | FlashBlade//EXA,30 个数据节点 | 877.5 |
| Azure | 托管 Lustre,4,096TiB,128 个客户 | 642.2 |
| 炎荣科技 | F9000X,8 个客户 | 313.7 |
| 苏州紫山隆林 | 多种配置 | 313.7 |
| 图灵数据 | F9200,8 个客户 | 307.1 |
| UBIX | UbiPower18000,3 个存储节点 | 293.8 |
培训:你可能不知道的名字
3D U-Net 训练排行榜被新秀们占据。燕荣科技的 F9000X 持续提供 543.9 GiB/s 的读取带宽,为 99 个模拟 B200 加速器供电,成为本轮训练吞吐量最高的公司。新加坡人工智能基础设施公司 TuringData 首次提交测试结果,以 541.5 GiB/s 的读取带宽位列第二,落后 4 GiB/s。该集群仅由三个存储节点组成,为 96 个模拟 B200 加速器供电。同样的三节点 F9200 集群还提交了 Checkpoint-70B 测试结果,读取带宽为 539.9 GiB/s,写入带宽为 307.1 GiB/s。UBIX 的 UbiPower18000 集群由三个存储节点组成,配备 16 块 15.36TB NVMe 硬盘和四路 NDR400 网络,最终达到 454.1 GiB/s 的吞吐量。 HPE 是唯一一家提交训练结果的成熟企业阵列供应商,其 K3000 的训练速度为 345.8 GiB/s。
| 3D U-Net 训练(最佳提交) | 读取黑白数据(GiB/s) | 模拟B200加速器 |
|---|---|---|
| 炎荣科技 F9000X | 543.9 | 99 |
| 图灵数据 F9200 | 541.5 | 96 |
| UBIX UbiPower18000 | 454.1 | 80 |
| 苏州紫山隆林 | 433.4 | 80 |
| FarmGPU | 406.7 | 75 |
| Azure 托管 Lustre | 379.1 | 70 |
推理加入基准测试
这两个新增工作负载反映了存储需求的实际增长方向。KV缓存测试衡量存储系统在长上下文LLM服务中对注意力状态进行分页的速度,我们在之前针对戴尔和Solidigm的KV缓存卸载工作中对此模式进行了深入研究。Everpure再次刷新了本轮测试的最高纪录,在51台主机组成的FlashBlade//EXA配置上实现了1,623.4 GiB/s的KV缓存读取速度,而UBIX(443.7 GiB/s)和FarmGPU(443.6 GiB/s)则在标准规模的测试中名列前茅。在向量数据库方面,TTA的Seahorse系统以每秒57,620次查询的成绩位居查询吞吐量榜首。
另一项结构性变化是协议。v3.0 版本新增了对 S3 对象存储的支持,大约六分之一的提交版本使用了该存储。NVIDIA 占据了其中的大部分份额,提交了 20 个 AIStore 测试用例,涵盖了 OCI、AWS 和 GCP 上的裸机配置,最高检查点写入速度达到了 133.3 GiB/s。虽然绝对数值低于并行文件系统,但对象存储能够运行训练和检查点工作负载,这标志着 POSIX 文件系统在之前的领域占据了主导地位。
MLCommons 在本轮评测中也开始将电源和机架空间效率作为首要指标进行跟踪。
Everpure FlashBlade//EXA
Everpure FlashBlade//EXA 系统在 405B 和 1.25T 参数模型检查点类别以及键值 (KV) 缓存检索基准测试中均处于领先地位,突显了该平台在数据密集型人工智能训练和推理工作负载期间保持高吞吐量的能力。
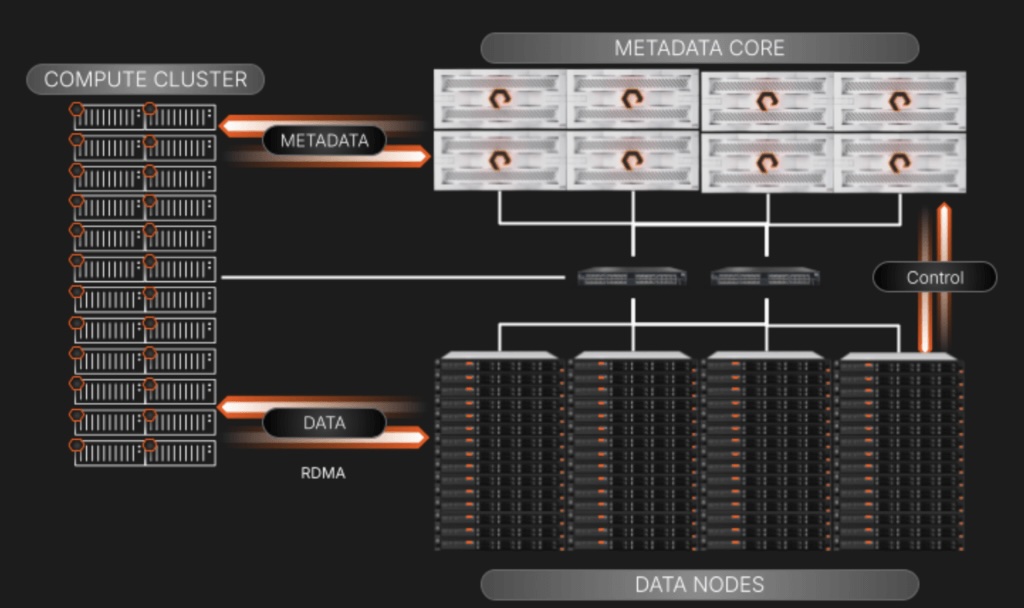
Everpure提交的配置方案将30个FlashBlade//EXA刀片服务器(120个DirectFlash模块用于处理元数据)与30个Linux/NVMe数据节点配对,在单个文件系统中提供了约866TB的可用容量。该方案将元数据通过pNFS/TCP传输,而数据则通过NFSv3的RDMA传输。在1.25T参数的检查点模拟中,使用1,024个客户端加速器,该30节点配置在17.74秒的时间内实现了877.52 GiB/s的写入带宽,并在28.99秒内实现了588.28 GiB/s的读取带宽。在 KV 缓存推断测试中,仅使用存储的 Llama 3.1 8B 运行报告每秒 85,736 个令牌,结合存储和系统内存的 8B 运行报告每秒 67,642 个令牌,仅使用存储的 70B 运行报告每秒 33,403 个令牌。
缺席意味着什么
基准测试轮次可以证明两件事:提交者的能力以及缺席者选择不展示的能力。赢得最大规模新云和人工智能工厂部署的厂商 VAST Data、WEKA 和 DDN 都缺席了 v3.0 轮次,v2.0 轮次的提交者华为、Hammerspace 和 Lightbits 也同样缺席。厂商缺席测试轮次的原因有很多,例如工程周期、发布时间以及基准测试的策略;缺席测试轮次并不代表系统速度慢。但这确实意味着,经过审计的记录和部署记录指向了不同的厂商名单,买家必须权衡两者。我们的“最佳存储阵列”页面精确地记录了这种差异,标明了哪些是经过审计的记录,哪些是部署记录,并且已经更新了完整的 v3.0 测试结果。



 Amazon