

NVIDIA 和联发科宣布大幅扩展双方的战略合作,涵盖企业级 AI 基础设施、边缘计算、客户端 PC 和汽车平台。为支持这项合作,NVIDIA 已投资 3.5 亿美元购买联发科发行的可转换债券。此次技术合作的核心在于,联发科将 NVIDIA NVLink Fusion 平台集成到 NVIDIA 的机架式 AI 环境中,为超大规模数据中心、云服务提供商和前沿模型开发者提供一个预验证的框架,用于设计可直接部署到 NVIDIA 机架式 AI 环境中的定制加速器 (XPU)。
两家公司的领导层将此次扩展联盟的重点放在跨计算领域的融合上。NVIDIA创始人兼首席执行官黄仁勋指出,从大型数据中心到个人系统和软件定义汽车,都需要加速计算,并特别提到了联发科在系统芯片设计、连接性和每瓦性能方面的专长。联发科副董事长兼首席执行官蔡崇信表示,将联发科的定制芯片设计能力与NVIDIA的加速计算堆栈和软件生态系统相结合,将加速客户在云AI基础设施、本地AI计算和汽车领域的创新。
基于NVLink Fusion平台的定制芯片设计
为机架级部署开发半定制化 AI 加速器,在高速 SerDes、互连拓扑结构、高带宽内存 (HBM) 集成、多芯片先进封装以及系统级热力学和机械性能认证等方面,都面临着巨大的工程挑战。联发科并没有要求客户从零开始设计这些底层互连和封装层,而是采用NVLink Fusion作为模块化设计蓝图。
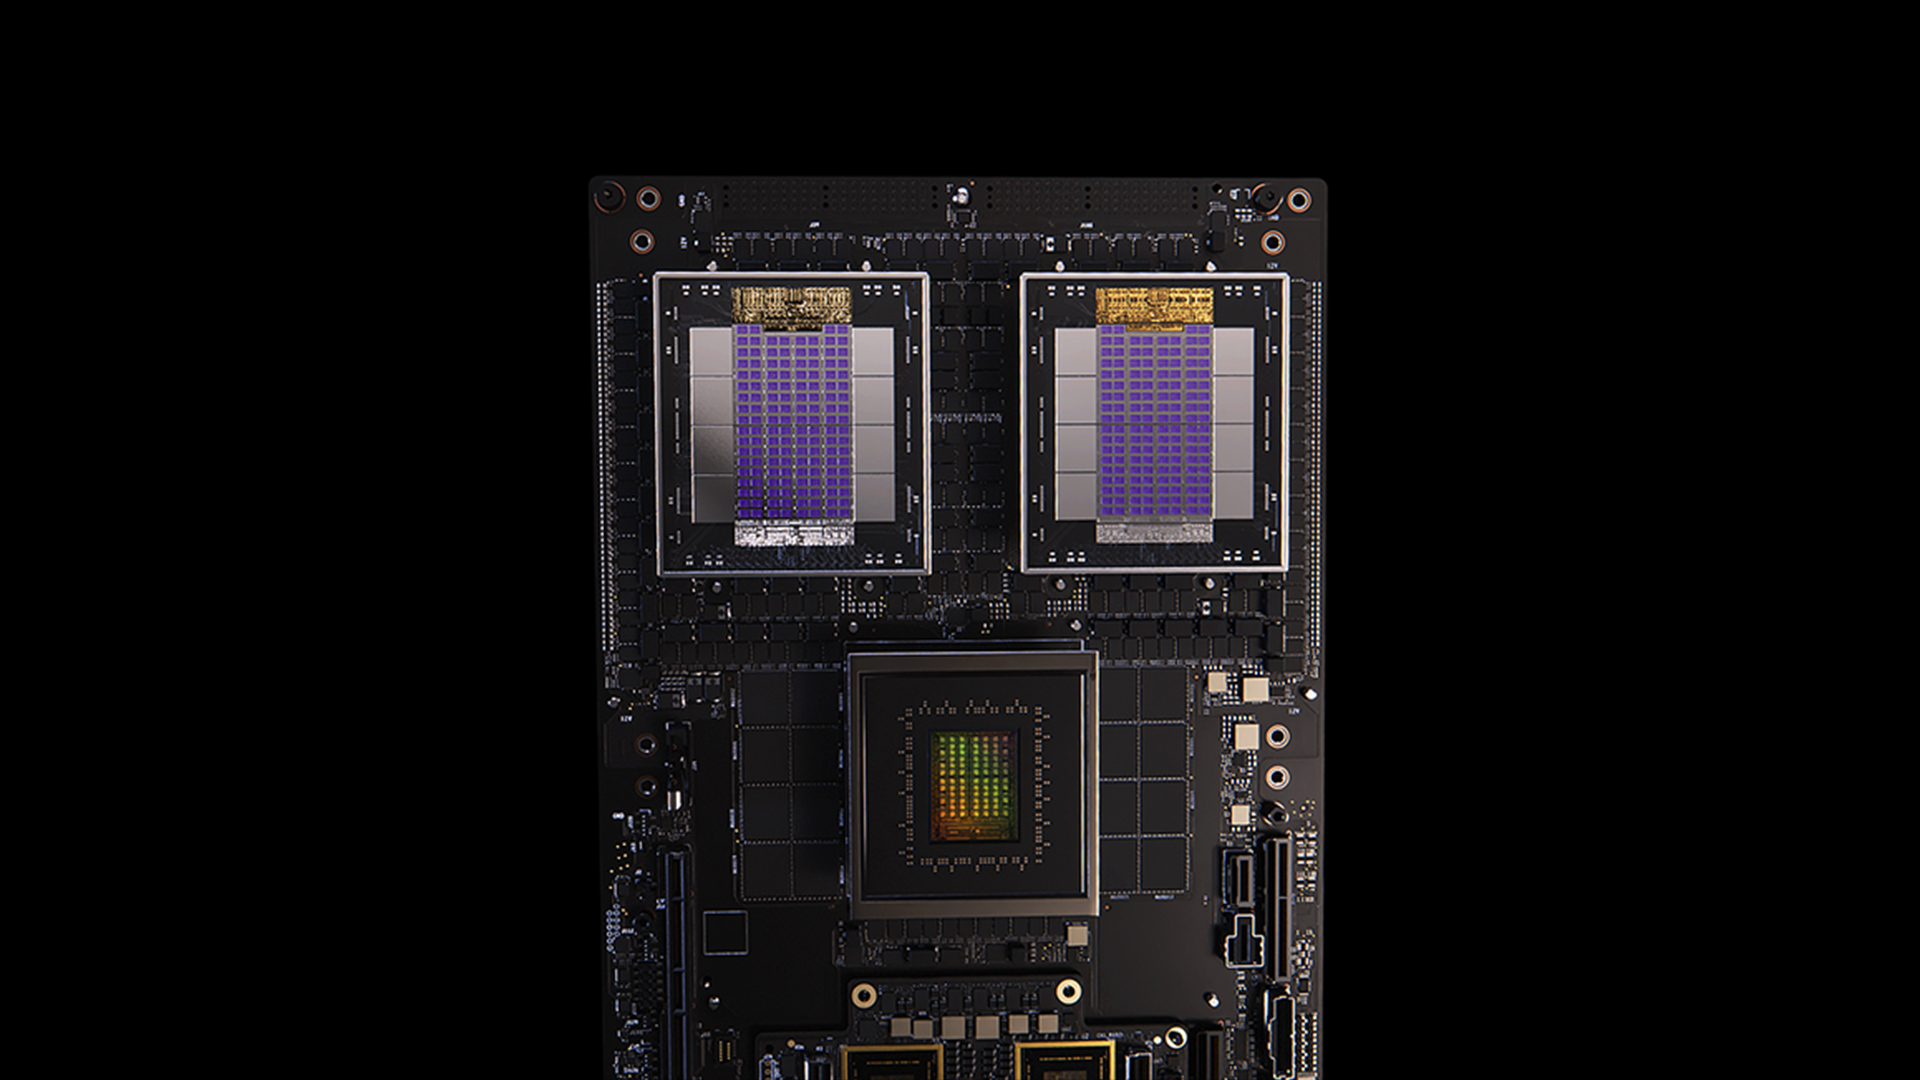
NVLink Fusion 架构提供了一个标准化的、预认证的多芯片基础架构,其中包含多种主要子系统技术。NVIDIA NVLink Fusion 芯片组利用 NVIDIA 光子或电互连技术,在定制 XPU 和更广泛的 NVLink 扩展架构之间建立直接连接。为了支持一致、低延迟的芯片间通信,NVIDIA NVLink-C2C可在客户 XPU、NVIDIA Rosa CPU 和其他兼容的处理单元之间提供高带宽、高能效的芯片间连接。在内存方面,NVIDIA NVHBM集成了定制的内存接口,以扩展可用带宽并提高能效,同时为活跃的计算引擎预留更多芯片面积。
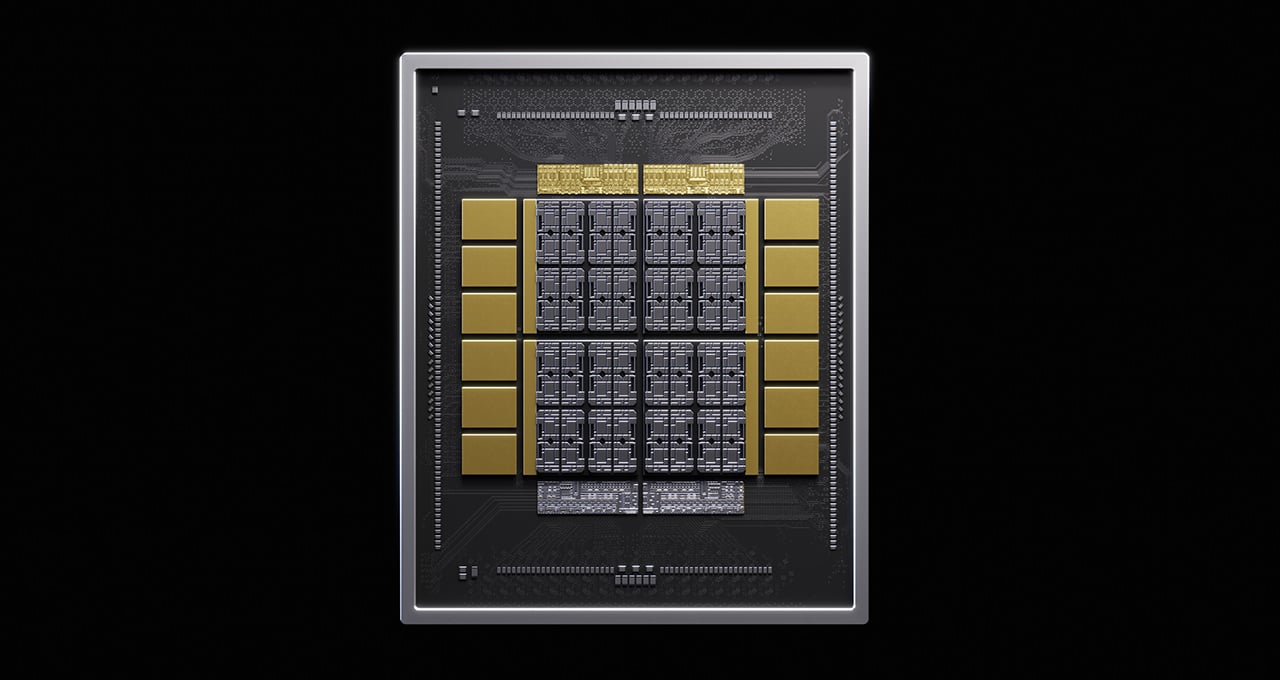
通过此框架,企业客户可将专有的处理架构提供给联发科,从而根据其目标工作负载定制特定的性能配置、内存密度和功耗目标。联发科则负责管理制造多芯片封装所需的复杂封装、物理实现和供应链物流。这些定制的 XPU 可以与 NVIDIA MGX 模块化机架级架构和横向扩展网络架构对接,从而显著降低开发风险,并缩短专用 AI 工厂的产品上市时间。
扩展客户端计算和汽车平台
除了数据中心基础设施之外,此次合作还着眼于生成式和智能体人工智能工作负载的本地客户端计算。两家公司此前曾合作开发 GB10 Grace Blackwell 超级芯片,该芯片通过 NVLink-C2C 将 NVIDIA Blackwell GPU 与基于 ARM 的 Grace CPU 连接起来,为面向开发者和边缘环境的NVIDIA DGX Spark平台提供动力。如今,这项合作正通过 NVIDIA RTX Spark 扩展到客户端系统。两家公司表示,RTX Spark 将与基于 GB10 的 DGX Spark(同样通过 NVLink-C2C 将 Blackwell GPU 和 Grace CPU 连接起来)一起,为面向人工智能时代的下一代消费级 PC 提供动力。
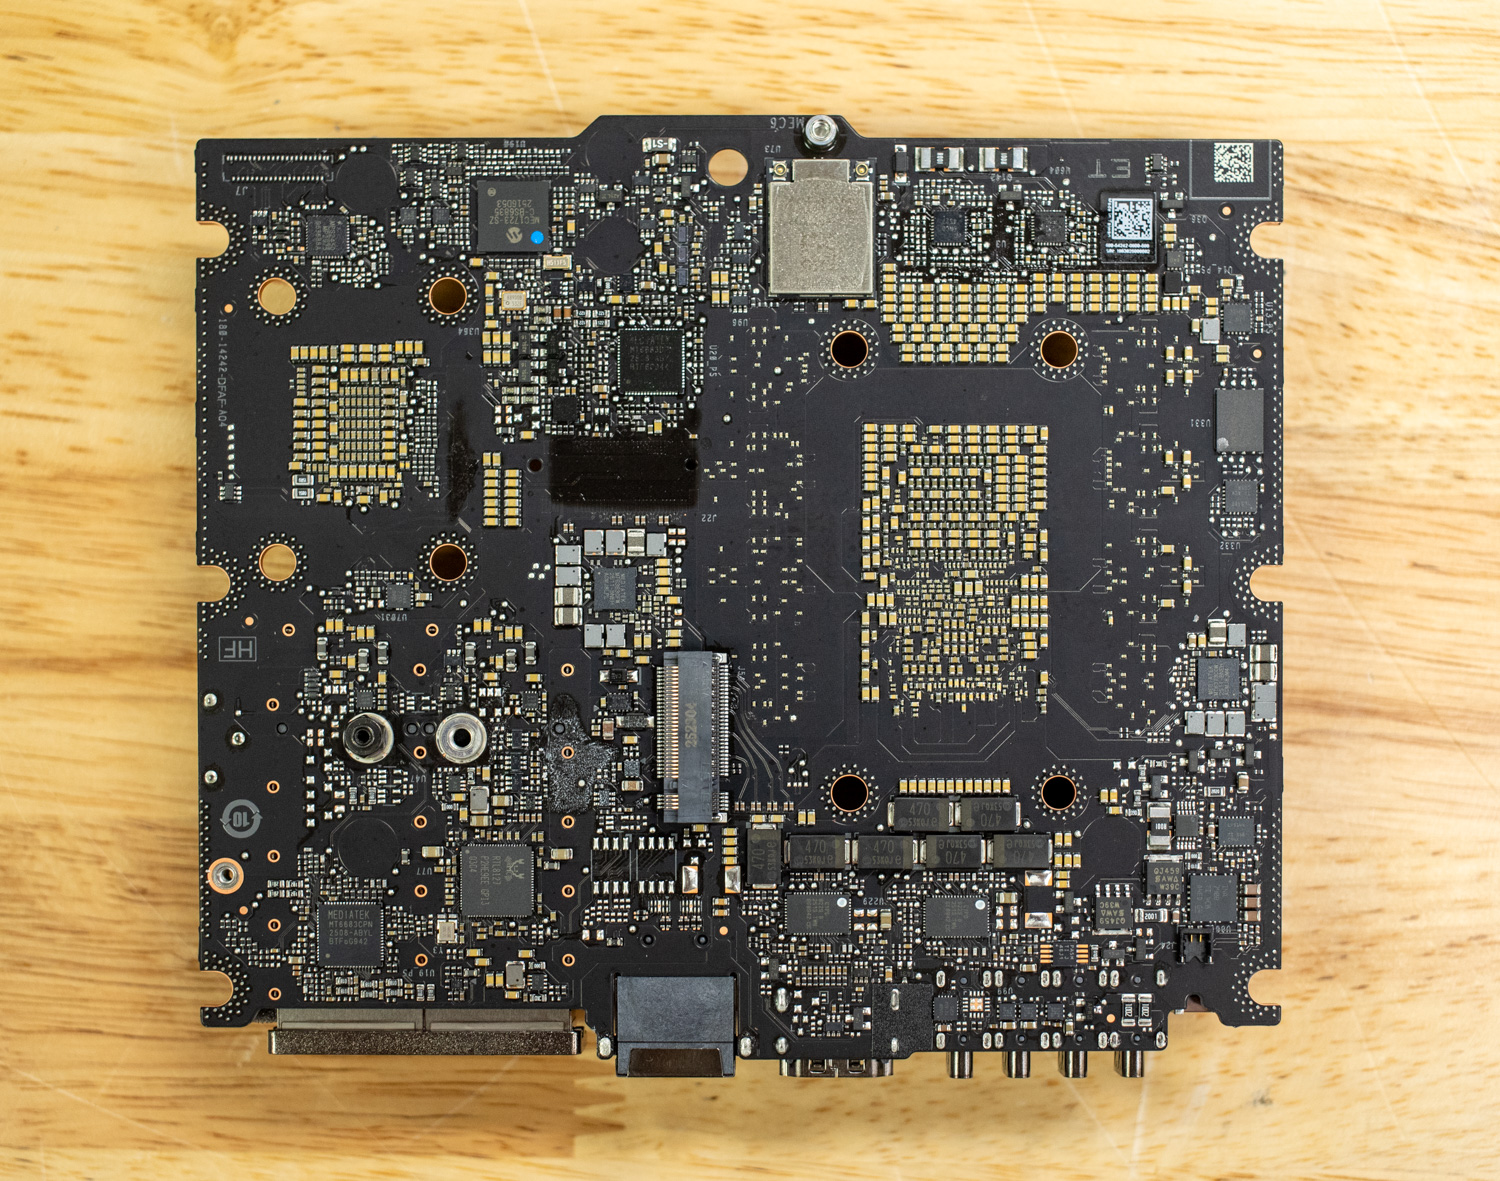
在汽车领域,此次合作涵盖了多代人工智能驱动的软件定义汽车产品。联发科的天玑自动平台集成了NVIDIA的AI和RTX图形技术,用于打造智能汽车座舱,并可与NVIDIA DRIVE AGX协同工作。两家公司正以此为基础,构建可扩展的架构,以支持日益智能化的AI定义汽车。


 Amazon