

NVIDIA 推出了 Helix Parallelism,这是一种为其 Blackwell GPU 架构开发的新方法,旨在提升处理超大数据集的实时 AI 性能。该技术满足了 LLM 日益增长的对数百万个 token 上下文的处理需求。NVIDIA 证明,与传统方法相比,这种方法可将处理速度提高高达 32 倍,从而支持更复杂、响应速度更快的 AI 应用程序。
百万代币挑战:为什么人工智能需要新方法
人工智能的前沿已经从简单的查询发展到复杂的长期推理。高级应用程序极其需要广泛的上下文才能有效运行。例如,AI 助手可以记住数月的对话,法律工具可以一次性分析数 GB 的案例,或者编程伙伴可以理解整个存储库。这些任务需要处理数百万个 token。
然而,扩展到这个水平会暴露出两个根本的瓶颈。
- 键值缓存瓶颈:在自回归 token 生成过程中,模型会计算对先前生成 token 的注意力,以避免二次方缩放因子。为了实现这一点,先前生成的 token 会被缓存,这个过程称为键值缓存。当上下文包含数百万个 token 时,这个缓存会变得非常庞大,耗尽 GPU 的内存带宽,并显著降低响应时间。
- FFN 权重瓶颈:模型每生成一个新 token,都必须从内存中加载大量的前馈网络 (FFN) 权重。在交互式、低延迟的应用中,这种持续的加载过程是延迟的主要来源。
目前,我们依赖于类似张量并行 (Tensor Parallelism) 的方法,该方法将模型的张量(从而将所需的内存和计算工作)拆分到多个 GPU 上。虽然这种方法对某些任务有效,但随着新的注意力机制的出现,其优势逐渐减弱。在 GQA(分组查询注意力)或 MLA(多潜在注意力)等注意力机制中,为了减少内存占用,多个查询头共享一组较小的键值头。然而,当张量并行的规模超过键值头的数量时,由于每一步跨 GPU 通信都会引入显著的延迟,因此需要复制键值头。这种复制会抵消张量并行的一些优势。
螺旋平行度
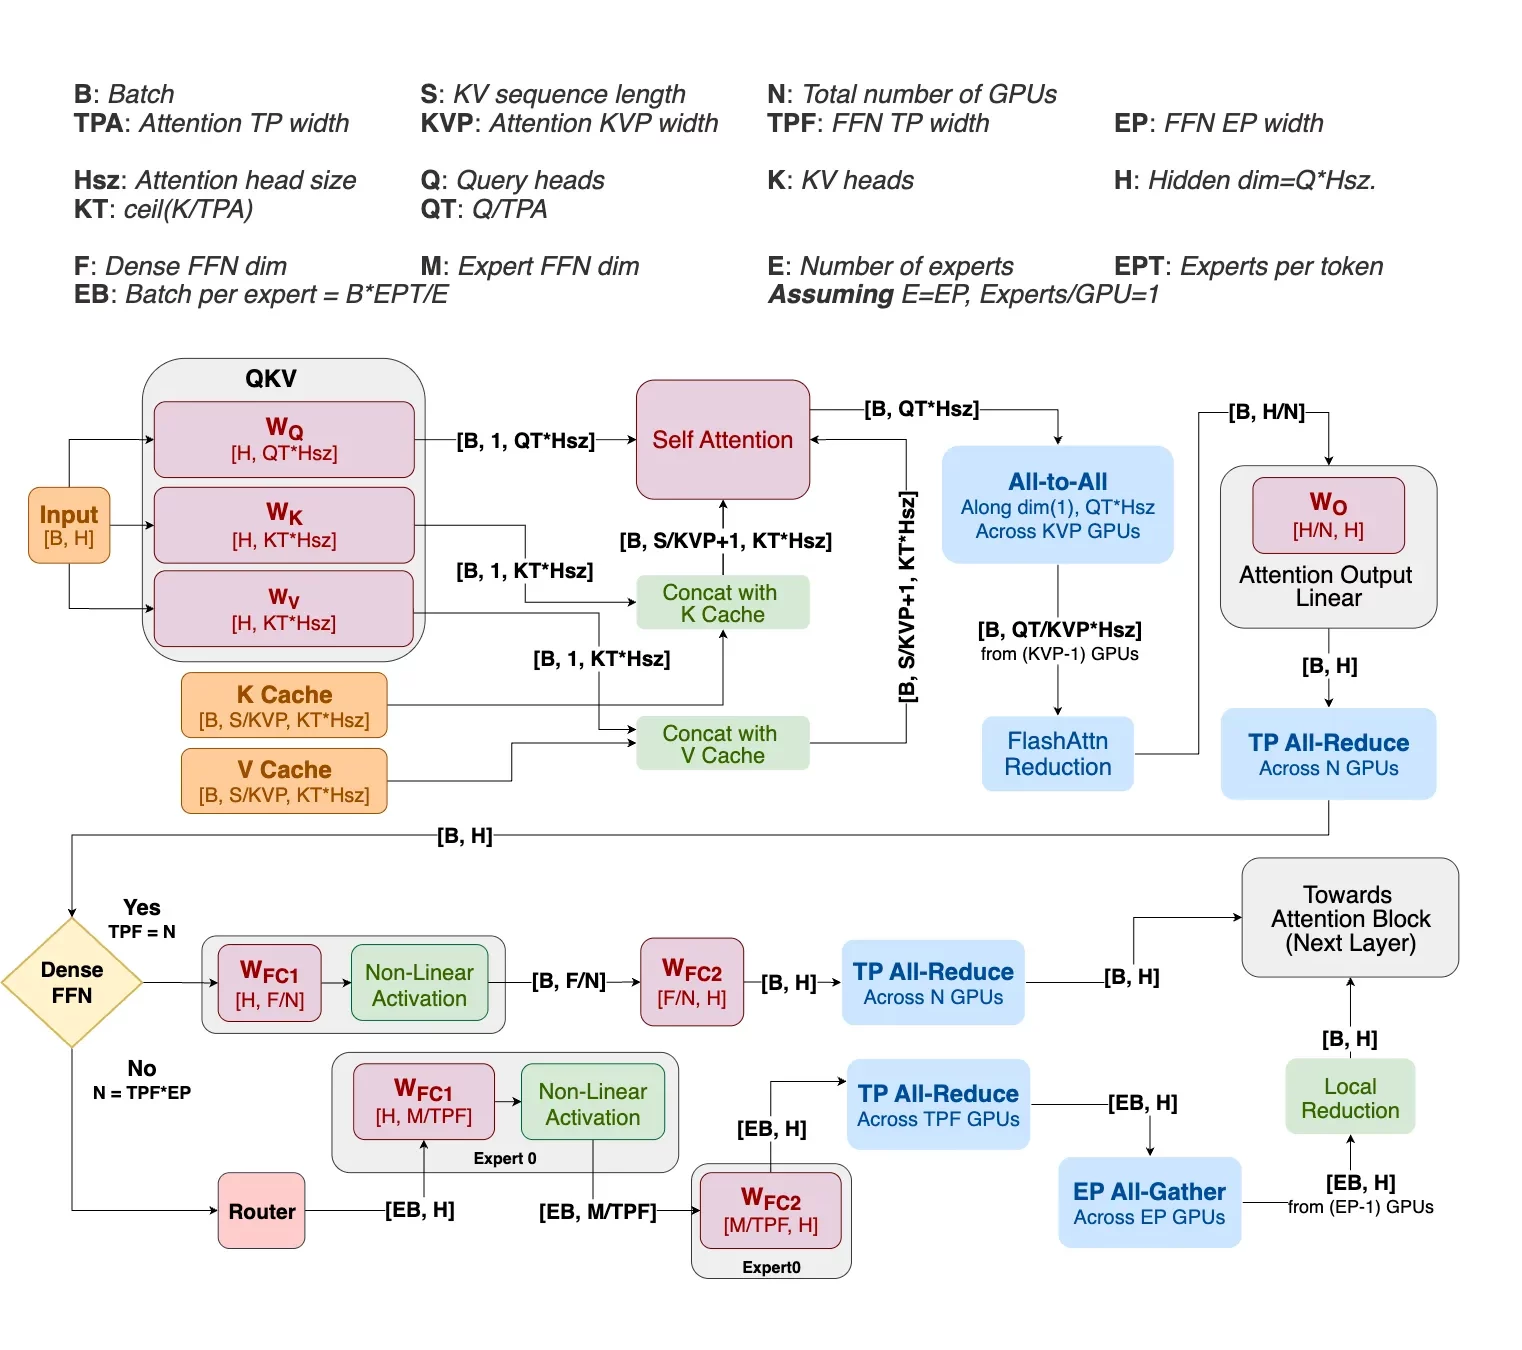
为了解决这一难题,NVIDIA 的 Helix Parallelism 引入了一种混合策略,将两个瓶颈视为独立的问题,并在无缝的时间流水线中加以解决。Helix 并非在整个过程中使用单一的并行方法,而是动态地重新配置同一个 GPU 池,以便在每个计算阶段使用最佳策略。
该过程可分为模型每一层的两个主要阶段。
第一阶段:注意力阶段(处理KV缓存)
Helix 通过结合两种并行机制,直接解决了键值缓存瓶颈问题。首先,它采用键值并行机制,将键值缓存本身沿序列维度分片到多个 GPU 上。这意味着每个 GPU 仅保存整个上下文的一部分,从而减轻了内存负担。
同时,它使用张量并行 (Tensor Parallelism) 来分割注意力头,确保分割数量不超过键值头的数量。这种组合避免了传统张量并行带来的缓存重复问题。最终形成了一个二维 GPU 网格,能够在海量上下文中高效计算注意力,且不会让任何一个 GPU 不堪重负。这些 GPU 之间的通信由一个高效的全对全交换器处理,其成本与上下文长度无关,因此具有高度的可扩展性。
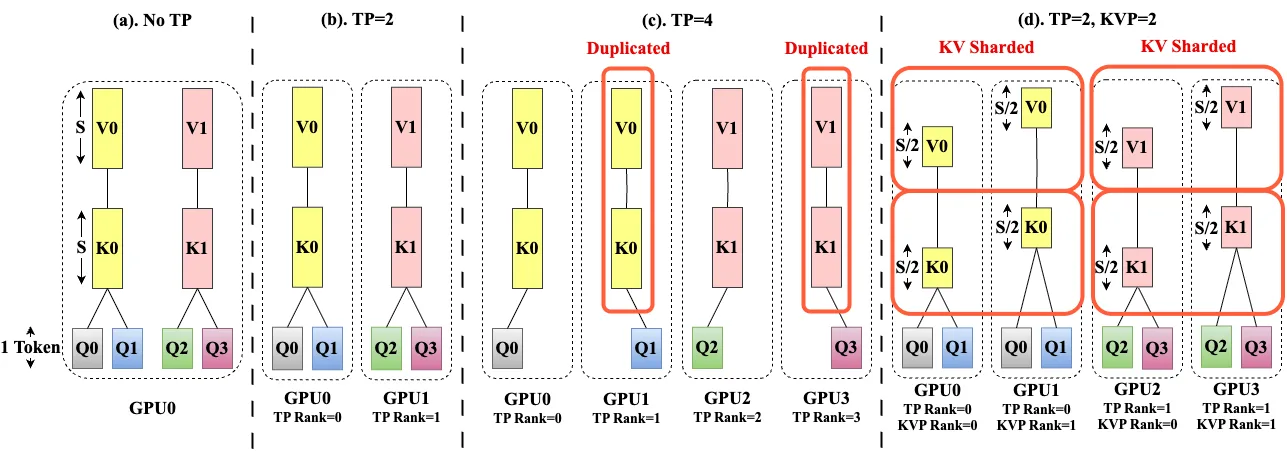
第二阶段:FFN 阶段(解决 FFN 权重)
注意力阶段结束时的全对全通信还会将输出数据在各个 GPU 之间进行划分。这意味着数据已经完美排列,可以立即开始 FFN 计算。
同一 GPU 池被重新配置为一个大型张量并行组。由于数据已预先分区,每个 GPU 都可以使用其海量 FFN 权重的分片执行本地矩阵乘法。此初始计算并行进行,无需跨 GPU 通信,从而最大限度地提高速度。只有在此本地计算步骤之后,GPU 才会参与高效的全归约通信,将其部分结果合并为最终输出。
最后一个难题是 Helix 如何管理不断增长的键值缓存。当模型生成新的令牌时,必须将它们追加到缓存中。一种简单的方法可能会将所有新令牌写入单个 GPU,从而造成内存热点。Helix 通过巧妙的循环更新系统来避免这种情况。例如,第一个新令牌块可能写入 GPU 0,下一个块写入 GPU 1,依此类推。这种交错方法可确保内存使用量在键值并行组中的所有 GPU 上均匀增长,从而无论上下文大小如何都能保持均衡的性能和一致的吞吐量。
Blackwell 的全新性能前沿
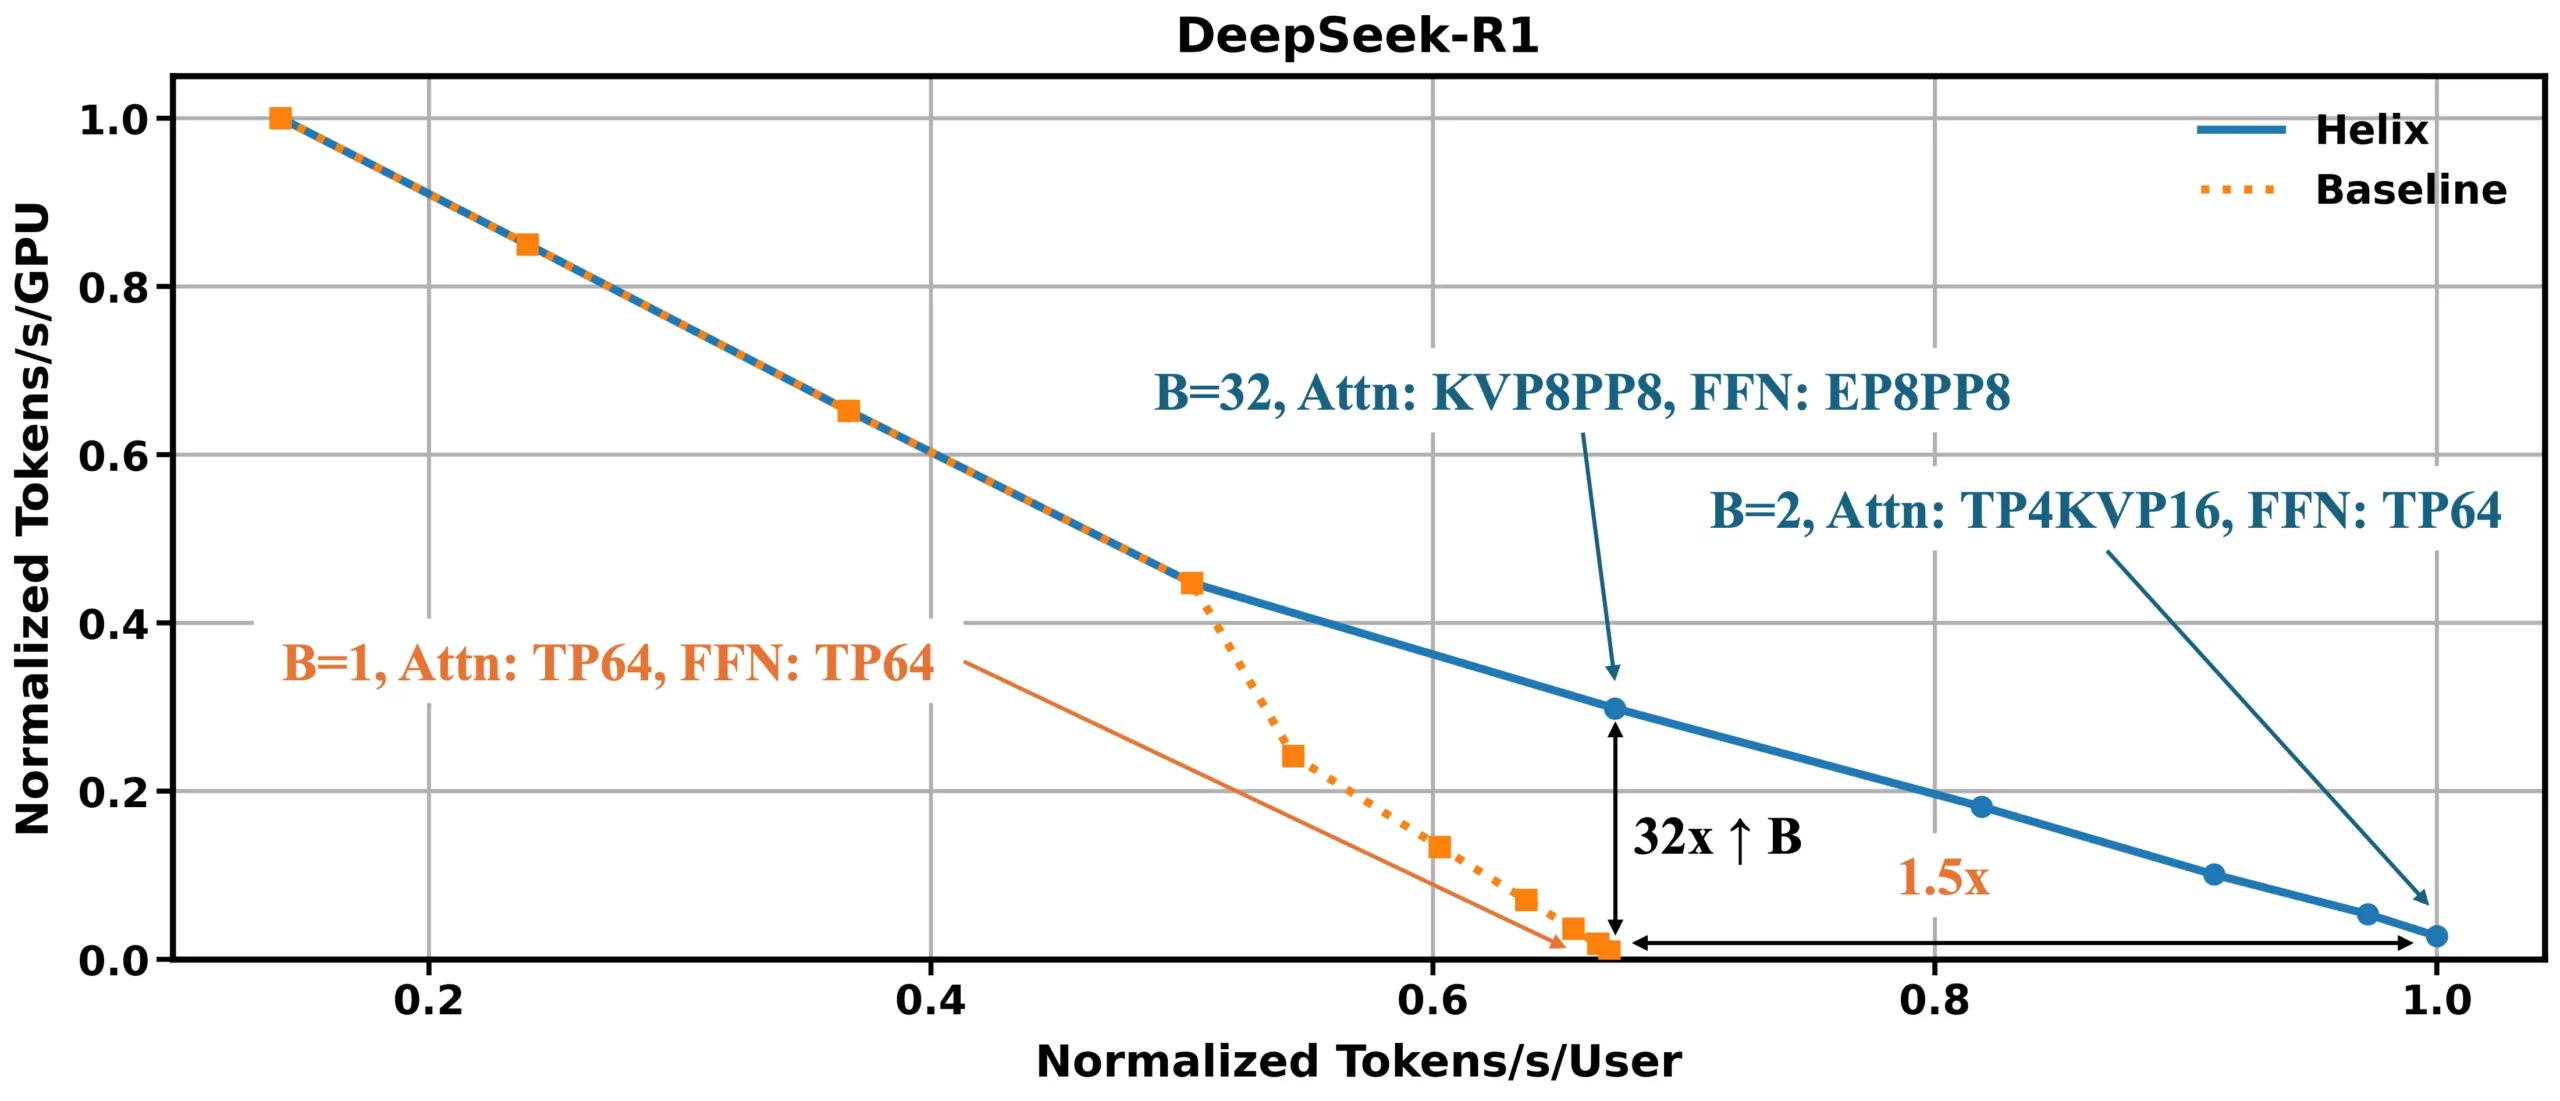
Helix 为长上下文 LLM 解码树立了新的性能标杆。结果基于在 Blackwell NVL72 上使用 DeepSeek R1 671B 参数模型 (FP4) 进行的详尽仿真,该模型假设上下文包含一百万个令牌,系统地调整分区策略和批处理大小,以找到最佳的吞吐量-延迟权衡。对于需要大规模可扩展性的应用程序(例如同时服务于众多用户),Helix 可以在给定延迟预算的情况下将并发用户数量提高高达 32 倍。对于单用户响应至关重要的低并发设置,该技术可以通过降低可实现的最小令牌到令牌延迟,将用户交互性提高高达 1.5 倍。这些提升是通过在所有可用设备上分片键值缓存和前向寻址网络 (FFN) 权重来实现的,这显著降低了 DRAM 压力并提高了计算效率。
如需深入了解方法论和模拟结果,请点击此链接查看完整报告。


 Amazon