

高通技术公司在2026年投资者日上发布了一系列重磅消息,阐述了其雄心勃勃的数据中心战略,其中包括三项重大公告:收购人工智能软件公司Modular Inc.、推出Dragonfly C1000 CPU和扩展的推理加速器产品组合,以及深化与Hugging Face和Meta的合作关系。这些举措共同表明,高通意图在人工智能基础设施的全栈领域展开竞争,涵盖芯片、软件和生态系统。
高通公司将收购 Modular 公司
高通公司已达成最终协议,将收购人工智能软件公司 Modular Inc.。Modular Inc. 的平台旨在实现跨异构硬件架构的高效人工智能执行。该交易预计将于 2026 年下半年完成,但需获得监管部门批准并满足其他惯例成交条件。
Modular 由一群曾参与基础人工智能基础设施项目的工程师创立,构建了一个开放的、原生于人工智能的软件栈,该软件栈可在 CPU、GPU、NPU 和定制 ASIC 架构上运行,无需开发人员为每个目标平台重写代码。该平台的可移植性是其关键优势,使企业能够一次构建,即可部署到任何环境中,同时降低总体拥有成本。
此次收购旨在解决人工智能部署中日益严峻的制约因素。正如高通所言,效率而非原始性能正成为限制因素:每瓦性能决定了推理成本,而软件效率正成为实现经济高效扩展的关键杠杆。Modular 的技术栈正是针对这一关键因素而设计的,它将芯片性能转化为跨异构、解耦计算的高效推理。
对于高通的数据中心战略而言,此次交易增强了其在各种平台上(从边缘设备到需要在各种硬件环境下保持性能一致的超大规模数据中心)提供优化推理、编排和部署的能力。高通称 Modular 的开发者社区开放、对行业友好且厂商中立,这将进一步扩大其在人工智能开发者生态系统中的影响力。
Dragonfly C1000 CPU 和数据中心平台
高通公司推出了 Dragonfly C1000,这是一款专为数据中心打造的 CPU,采用其定制的 Oryon 内核,目标应用包括智能体 AI 编排、通用服务器工作负载和 AI 头节点应用。该处理器采用多芯片架构,拥有超过 250 个内核,运行频率超过 5 GHz,根据已公布的规格,其每瓦性能比目前同类服务器 CPU 产品高出两倍以上。
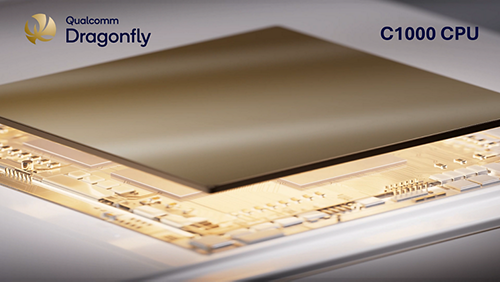
C1000 支持 PCIe Gen 7 连接,传输速率超过 2 TB/s,并支持 CXL 内存分离,可实现高速存储和网络集成。其内存子系统采用领先的低功耗内存技术,旨在实现高带宽、高容量和高能效。该平台支持风冷和液冷,并符合 OCP ORv3 机架和服务器标准。可靠性特性包括 ECC、故障隔离和错误恢复,可确保大规模弹性运行。预计将于 2028 年上市。
C1000 提供三种配置:一种是针对高吞吐量编排和低延迟交互式 AI 优化的代理 CPU;一种是针对第一方工作负载的每总拥有成本性能和针对第三方使用的 vCPU 弹性的通用 CPU;还有一种是 AI 头节点 CPU,旨在通过高速互连上的低开销主机处理来最大限度地利用 XPU。
高通高带宽计算(HBC)
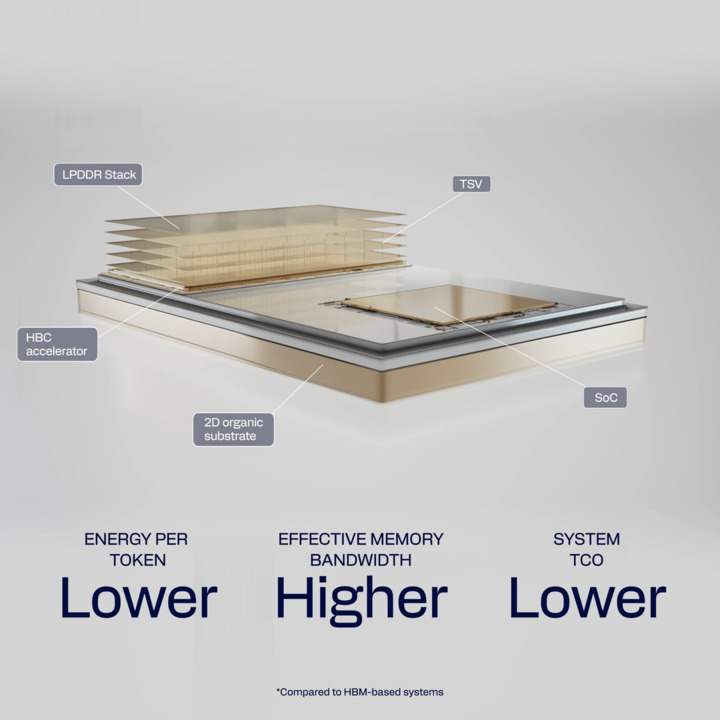
高通推理加速器路线图的核心是其高带宽计算(HBC)架构,这是一种近内存计算设计,它将计算能力与加速的内存带宽结合在一个3D堆叠的硅解决方案中。HBC被定位为HBM的直接替代方案,高通声称,基于与已公布的竞争对手规格的标准化卡级和机架级比较,HBC的每瓦带宽是HBM的6倍,每瓦容量是SRAM的200倍。
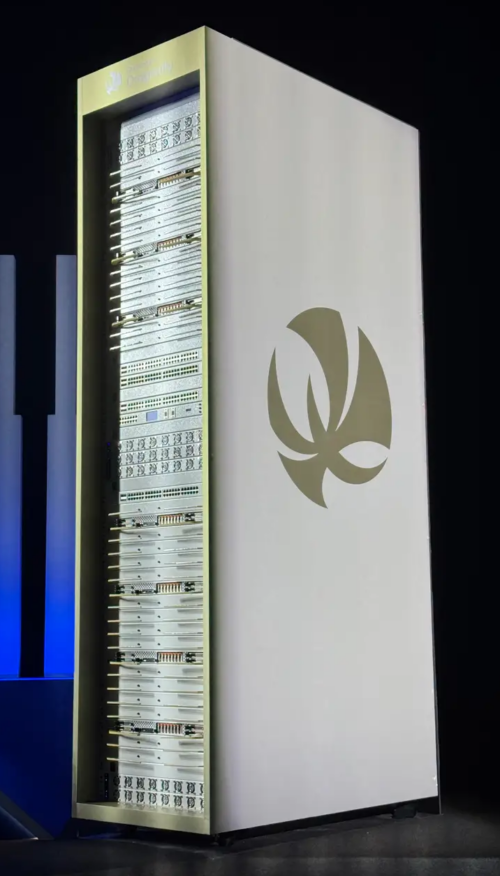
集成于 Dragonfly AI250 中的第一代 HBC 芯片,每张卡可提供 133 TB/s 的有效内存带宽,比采用 LPDDR5X 的 AI200 提升了 18 倍。集成于新发布的 AI300 中的第二代 HBC 芯片,其带宽比 AI200 提升了 54 倍。搭载第一代 HBC 芯片的 AI250 预计将于 2027 年年中开始商业化样品供应。
蜻蜓AI300
AI300 是高通第三代机架式 AI 推理平台,前两代产品 AI200 和 AI250 已于 2025 年 10 月发布。AI300 集成了第二代 HBC 技术,可显著提升计算速度,并拥有更高的有效内存带宽和容量,旨在满足大型语言模型和多模态模型推理以及智能体 AI 工作负载的需求。高通预计,与现有的基于 GPU 的架构相比,AI300 的每瓦内存带宽将提升 4 到 8 倍。AI300 支持通过 UALink 和 ESUN 进行纵向扩展,并通过铜缆和光纤互连进行横向扩展。预计将于 2028 年推出商用样品。
连接方式
高通的数据中心连接产品组合涵盖芯片间互连、铜缆互连、光纤互连和园区互连,支持光纤、AOC 和 AEC 应用的 800G 和 1.6T 带宽,传输距离可达 20 公里。该产品组合利用高通的 SerDes、PAM4、轻量级相干 DSP 和信号完整性技术,解决日益影响分布式、解耦式 AI 基础设施性能的数据传输瓶颈问题。
定制硅
高通还概述了一项针对超大规模数据中心和云服务提供商的定制芯片方案,该方案采用专为智能体人工智能和特定工作负载量身定制的设计。该方案涵盖芯片、系统和软件的端到端协同设计,采用先进的封装和模块化架构,旨在通过大规模生产支持缩短产品上市时间并降低执行风险。
合作关系:拥抱脸和元
拥抱脸
高通宣布扩大与 Hugging Face 的战略合作关系,该合作围绕三大支柱展开,涵盖高通的骁龙、龙翼和蜻蜓产品系列。此次合作旨在将高通的设备到数据中心平台与 Hugging Face 拥有 16 万开发者的庞大社区及其超过 3 万个开放模型的库连接起来。
第一支柱将 Hugging Face 的存储和推理服务映射到基于高通 Dragonfly 的数据中心基础设施,从而创建了一条从模型实验到应用程序和代理的生产部署的直接路径。第二支柱侧重于模型部署自动化:计划通过基于代理的工作流程将 Hugging Face 生态系统中的 AI 模型集成到高通平台上,该工作流程可处理设置、优化和部署,无需手动集成。这旨在简化从单一工作流程到智能手机、PC、可穿戴设备、工业系统、汽车平台和数据中心基础设施的部署。
第三支柱旨在实现跨混合环境的智能体人工智能编排。高通和Hugging Face计划支持一个分布式人工智能框架,在该框架中,智能体可以在设备端和云系统上运行,并根据性能、成本、隐私和延迟要求动态路由模型和工作流。作为合作的一部分,Hugging Face将为使用高通芯片设备或云系统的客户提供Hugging Face PRO的访问权限。开发者还可以通过Hugging Face生态系统访问Modular的人工智能软件组件和工具,从而将Modular的收购与此次合作直接联系起来。
元
高通和Meta宣布达成一项战略性的多代合作,高通将为Meta提供数据中心CPU。Dragonfly C1000计划用于Meta的下一代服务器,这标志着高通在数据中心CPU领域的雄心壮志取得了重大突破,并验证了该平台在性能和效率方面能够胜任大规模横向扩展部署的需求。
除了 Meta 之外,超过 35 家技术和人工智能供应链生态系统合作伙伴也对高通的数据中心愿景表示支持,其中包括 Arista、联想、美光科技、三星 SDS、SK 海力士美国公司、Supermicro、VAST Data 以及其他涵盖 ODM、内存供应商、网络供应商和人工智能基础设施提供商的公司。
高通公司承诺以年度节奏推出多代数据中心路线图,Dragonfly AI300 将加入 AI200 和 AI250 的行列,组成推理加速器产品线,该产品线将与 C1000 CPU 平台和 Modular 的软件堆栈一起不断发展。


 Amazon