

Supermicro宣布扩大机架式散热器的产能,并升级其直冷式液冷技术,以支持即将推出的NVIDIA Vera Rubin NVL72和NVIDIA HGX Rubin NVL8平台。该公司希望通过结合其位于美国的自主设计和制造能力、数据中心构建模块解决方案(DCBBS)方法以及端到端的液冷技术栈,缩短高密度AI基础设施的部署周期。
Supermicro首席执行官梁志强强调,公司与NVIDIA的合作以及其模块化设计方法旨在加速先进AI平台的交付。他还着重指出,Supermicro不断扩大的生产规模和液冷技术是实现Vera Rubin和Rubin系统在超大规模和企业级环境中高效、可靠、大规模部署的关键因素。
机架级旗舰产品:NVIDIA Vera Rubin NVL72 超级集群
在高端产品方面,Supermicro 将支持 NVIDIA Vera Rubin NVL72 超级集群。这款机架级系统集成了 72 个 NVIDIA Rubin GPU 和 36 个 NVIDIA Vera CPU,以及 NVIDIA ConnectX-9 超级网卡和 NVIDIA BlueField-4 DPU。该平台采用 NVIDIA NVLink 6 实现机架内一致性。它旨在通过 NVIDIA Quantum-X800 InfiniBand 和 NVIDIA Spectrum-X 以太网进行横向扩展,符合当前业界向大规模训练、推理和智能体人工智能 (AI) 的机架即系统 (RaaS) 设计趋势。
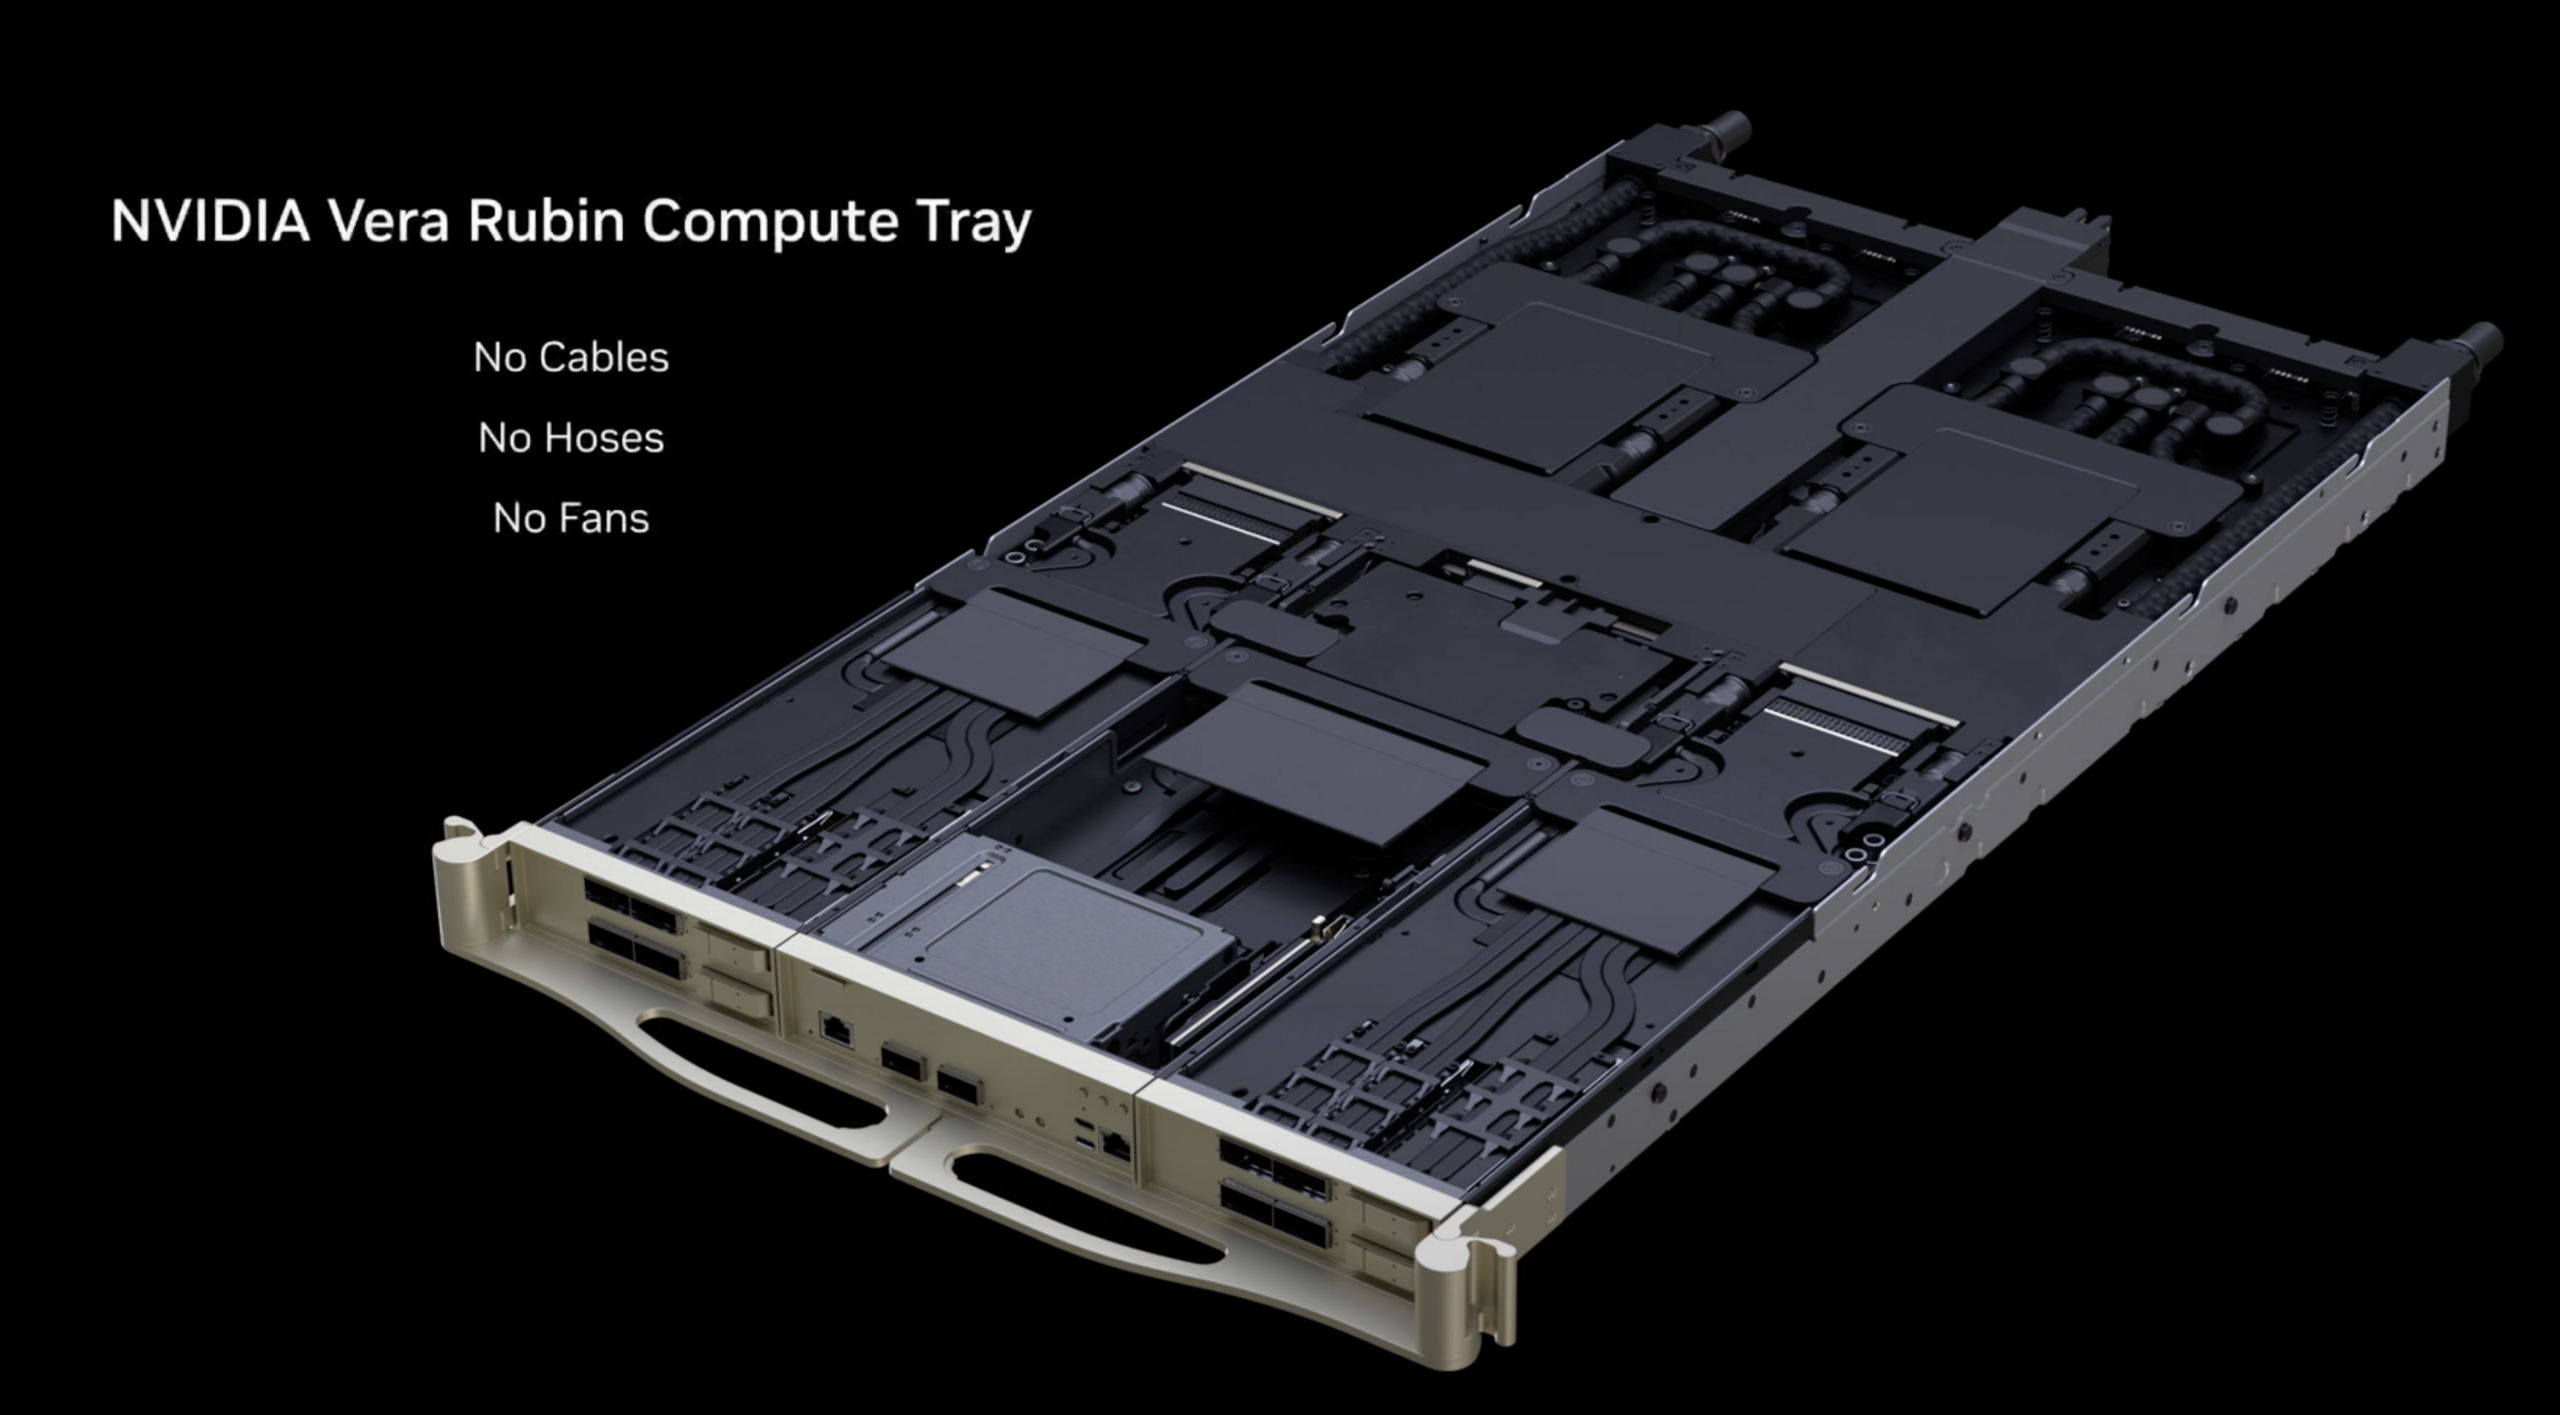
NVIDIA 官方标称 NVL72 配置的 NVFP4 性能为 3.6 exaflops,并配备 1.4 PB/s 的 HBM4 带宽和 75 TB 的高速内存。Supermicro 的实现方案基于第三代 NVIDIA MGX 机架式架构,重点关注可维护性、可靠性和可用性,以支持持续的集群运行。
散热是设计的核心。Supermicro 采用增强型数据中心级液冷散热系统,配备行内冷却液分配单元 (CDU)。其目标是实现可扩展的温水冷却,从而在保持高密度和可预测的性能的同时,降低能耗和用水量,尤其是在高负载 AI 任务下。
紧凑型高密度计算:2U 液冷 NVIDIA HGX Rubin NVL8
对于寻求更模块化构建模块的企业和服务提供商,Supermicro 还重点介绍了 2U 液冷 NVIDIA HGX Rubin NVL8 系统。这款 8 GPU 平台面向 AI 和 HPC 工作负载,NVIDIA 宣称其 NVFP4 性能可达 400 petaflops。该平台配备 176TB/s 的 HBM4 带宽和 28.8TB/s 的 NVLink 带宽,并通过 SuperNIC 提供 1600Gb/s 的 NVIDIA ConnectX-9 网络带宽。
Supermicro 提供了一种机架式设计,旨在保持部署的灵活性,其配置选项包括旗舰级 x86 CPU,例如新一代 Intel Xeon 和 AMD EPYC 处理器。该公司还重点介绍了一种用于机架集成的 2U 高密度母线设计,并结合 Supermicro 的直接液冷 (DLC) 技术,可在不牺牲可维护性的前提下支持更高的持续功率。
Vera Rubin平台功能
Supermicro 的平台支持与 Vera Rubin 时代的几项关键功能相一致,这些功能直接影响集群设计和运营规划,包括:
- NVIDIA NVLink 6 是一种高速互连架构,可实现更高的带宽和更低的延迟,从而提升 GPU 间和 CPU 间通信效率。这对于训练和推理超大规模的混合专家模型尤为重要,因为在这些模型中,通信模式会显著影响性能。
- NVIDIA Vera CPU 采用 NVIDIA 自主设计的 Arm 核心,据称性能比上一代提升两倍。该 CPU 支持空间多线程技术,拥有 88 个核心和 176 个线程,同时具备 1.2 TB/s 的 LPDDR5X 内存带宽和更大的内存容量。Vera 还通过 1.8 TB/s 的 NVLink-C2C 带宽提升了 CPU 与 GPU 之间的耦合度,据称是上一代的两倍。
- NVIDIA 第三代 Transformer Engine 旨在实现长上下文和窄精度加速,这在现代推理向持久会话、多智能体流水线和更高并发性转变的过程中变得至关重要。该平台还集成了第三代机密计算,这是一种机架级机密计算,具有统一的 GPU 级可信执行环境,可保护和隔离模型、数据和提示。对于将 AI 部署到受监管工作流程中的运营商而言,机密计算和 GPU 执行边界隔离正日益成为重要的平台选择标准。
- 第二代 RAS 发动机通过先进的健康监测和实时检查功能,显著提升了可靠性,从而减少了停机时间。在高密度液冷环境中,故障检测和可维护性至关重要,因为维护窗口成本高昂,且运行对不稳定性的容忍度很低。
网络:Spectrum-X 以太网光子学和机架级吞吐量
Supermicro 还将其 Rubin 平台支持与 NVIDIA 的 Spectrum-X 以太网光子技术相结合,该技术基于 Spectrum-6 以太网 ASIC 构建。NVIDIA 规定,该技术采用台积电 3nm 工艺,可实现 102.4 Tb/s 的交换速度,并配备 200G SerDes 共封装光器件和完全共享的缓冲器。
NVIDIA 表示,其目标是提升效率和运行稳定性,相比传统可插拔光模块,可实现 5 倍的电源效率提升、10 倍的可靠性提升以及 5 倍的应用正常运行时间提升。NVIDIA 列出了多款交换机型号,包括液冷式 SN6800(409.6 Tb/s 可插拔光模块,配备 512 个 800G 端口)、SN6810(102.4 Tb/s 可插拔光模块,配备 128 个 800G 端口,提供风冷和液冷两种配置)。对于数据中心运营商而言,这些设计预示着更高密度的 800G 以太网架构将拥有更优异的电源和散热性能,随着前端网络功耗在机架预算中占据越来越重要的地位,这一点显得尤为重要。
面向人工智能工厂的存储集成
在存储方面,Supermicro重点介绍了基于其百亿亿次级全闪存存储服务器和JBOF系统构建的配套解决方案。这些平台支持NVIDIA BlueField-4 DPU和一系列数据管理解决方案,使存储和网络与计算层使用的同一机架级加速架构保持一致。
尽管 Supermicro 在此次公告中没有提供存储平台的性能数据,但对集成的强调表明,该公司正继续朝着经过验证的全栈设计方向发展,其中计算、网络和存储一起经过认证,可用于 AI 工厂部署。
生产规模和上线时间
此次公告的运营重点在于提升生产效率和部署速度。Supermicro 扩建的工厂和液冷系统旨在简化全液冷 Vera Rubin 和 Rubin 平台的生产和交付流程。同时,模块化的 DCBBS 架构支持快速配置、验证和扩展。对于企业级技术采购人员而言,差异化优势不在于单一的机箱规格,而在于可预测的交付、可重复的机架搭建以及从设备到稳定生产服务的更短时间。
Supermicro 认为,随着液冷成为顶级 AI 密度的默认选择,能够实现机架级制造和验证工业化的供应商将最有能力支持大规模部署,而无需延长集成周期。


 Amazon