

NVIDIA 在斯坦福大学 Hot Chips 大会上清晰地传达了这样一个信息:数据中心本身就是一台计算机,其性能极限更多地取决于互连结构,而非原始 FLOPS。在五场会议中,NVIDIA 将展示 Spectrum-XGS 以太网、第五代 NVLink 和 NVLink Fusion、CPO 驱动的光子交换机以及全新 DGX Spark 桌面超级计算机如何协同工作。此次集成旨在将数以万计的 GPU 打造成一个单一的、可产生收益的 AI 工厂。
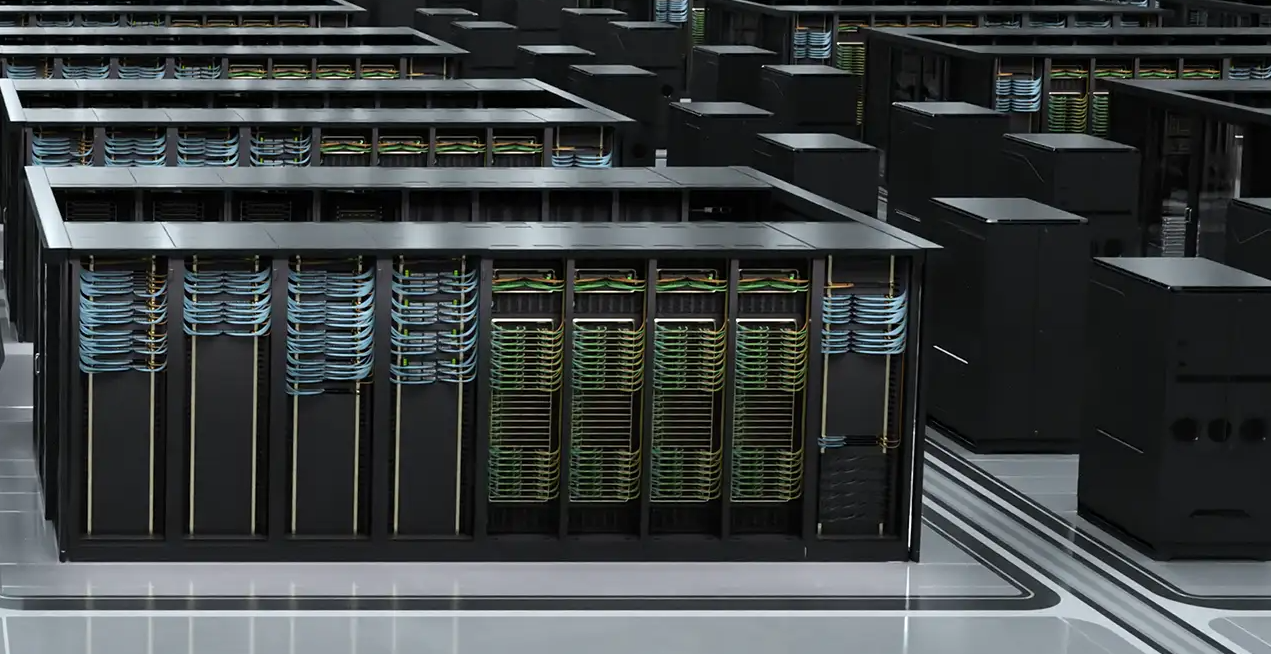
人工智能工厂的三层结构
现代 LLM 是隐式分布式应用程序。它们在 GPU 之间传输数万亿个参数,以微秒级的节奏同步梯度更新,并且必须在极短的时间内将第一个令牌返回给用户。这些工作负载驱动着层级化的互连:
- 在机架内进行扩展,以便 GPU 能够像单个大型处理器上的核心一样运行。
- 跨机架横向扩展,使集群作为统一系统运行。
- 跨整个数据中心进行扩展,以实现地理冗余、容量共享和法规遵从。
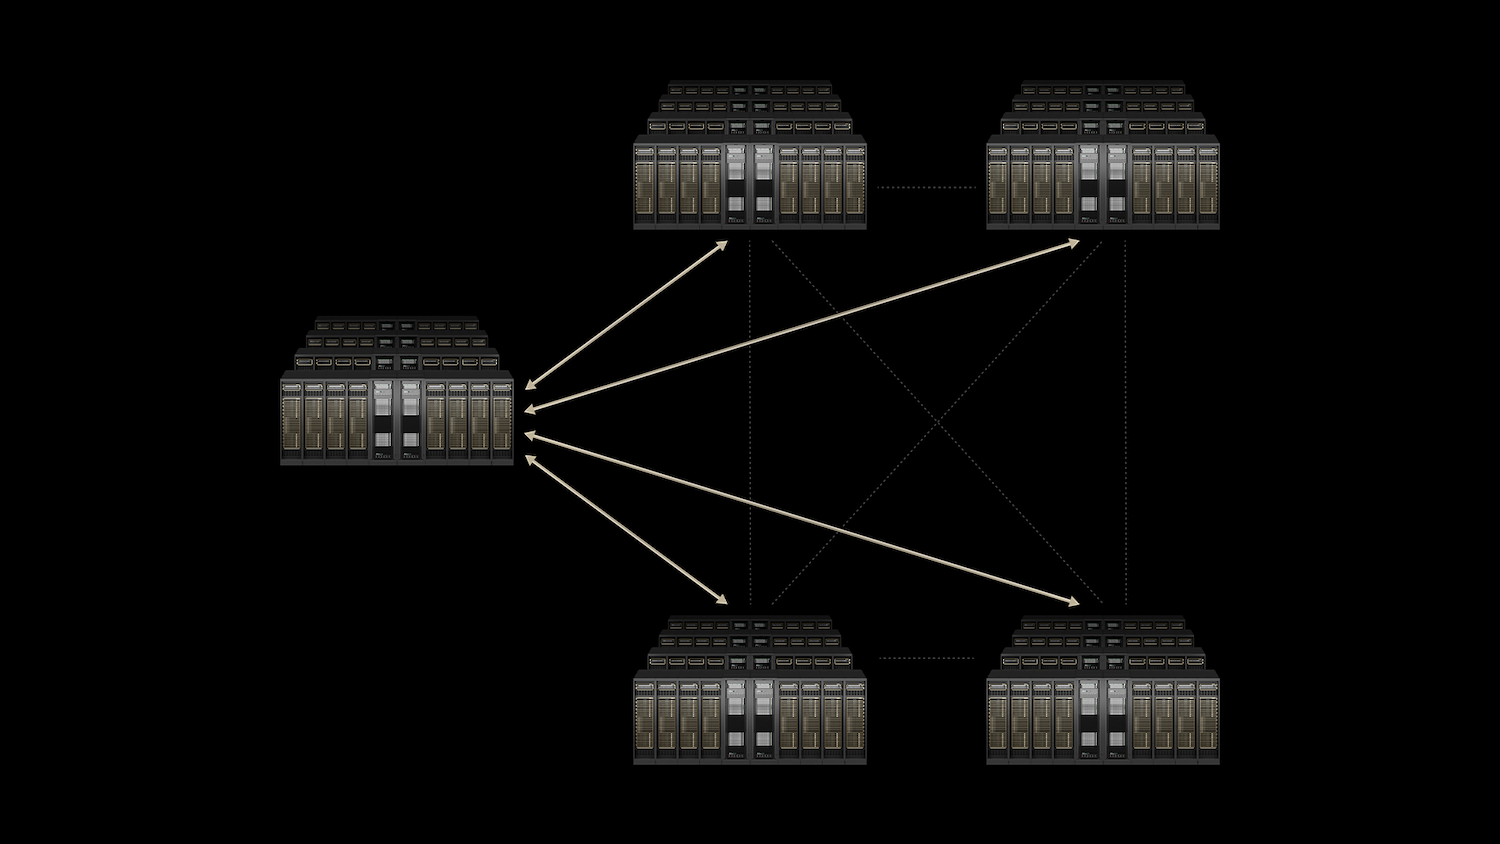
NVIDIA 的答案是垂直集成的堆栈。NVLink 和 NVLink Switch 拥有纵向扩展域;Quantum InfiniBand 和 Spectrum-X 拥有横向扩展域;全新的 Spectrum-XGS 以太网可在数据中心之间扩展无损、AI 调优的网络。共封装光模块 (CPO) 降低了百万 GPU 集群可能遇到的功率和密度限制。
Spectrum-XGS 以太网
传统以太网技术主要设计用于处理尽力而为的流量,这意味着它非常适合简单的单服务器通信。然而,随着我们进入一个越来越依赖人工智能的世界,我们发现自己面临着新的挑战。
随着人工智能集群和多租户推理系统的兴起,对网络性能的要求也发生了显著变化。这些现代应用对可靠性和速度的要求是传统以太网无法提供的。
具体来说,它们要求零抖动,这意味着延迟没有变化,这对于实时处理至关重要。此外,确定性延迟可确保响应的可预测性和一致性,这对于依赖即时反馈的应用程序至关重要。最后,近线速吞吐量对于处理在微突发负载期间处理的大量数据至关重要,因为在微突发负载下,数据流量可能会意外激增。
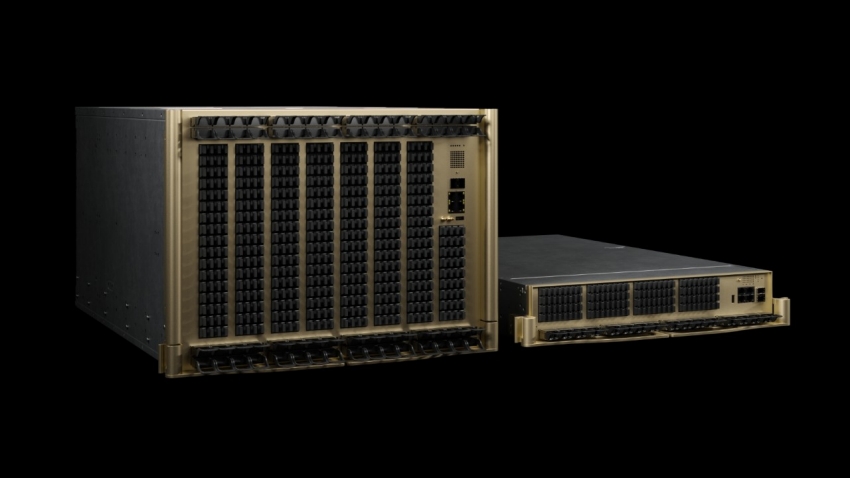
Spectrum-X是一款可在数据中心内无缝运行的解决方案,而 Spectrum-XGS 则将这项创新提升到了新的高度,将其功能扩展到多个数据中心。它集成了先进的基于 ASIC 的 Spectrum-6 或 -4 交换机以及超高速 800 Gb/s 超级网卡(具体而言是 BlueField-3 或 ConnectX-8 系列)。这些技术协同工作,能够高效地管理拥塞并重新排序数据包,从而确保数据流的顺畅。
该系统的独特之处在于其智能遥测技术,能够从每个端口收集数据,并将其输入交换机内的拥塞控制逻辑,从而实现实时流量整形。在生产集群中,这带来了卓越的性能,在惊人的 95k GPU 规模下,吞吐量仍能维持在理论容量的 32% 以上。相比之下,传统的 800 G 以太网则表现不佳,在出现集体冲突时,吞吐量仅能达到 60% 左右。
此外,Spectrum-XGS 保证符合标准,使 SONiC 和 Cumulus Linux 成为其生态系统不可或缺的组成部分。这意味着云和企业运营商可以保留其现有的自动化堆栈,同时受益于 InfiniBand 通常具备的卓越确定性。这些增强功能可提高 GPU 利用率并降低延迟,从而转化为更高的每瓦令牌数和更严格的服务水平目标。此外,它还使运营商能够在同一集群中引入新租户,而不会出现性能下降,从而改变行业的格局。
NVLink 和 NVLink Fusion:机架作为一个巨大的 GPU
第五代 NVLink 在 NVL1.8 机架内提供高达 130TB/s 的点对点带宽和 72TB/s 的聚合带宽。这种增强的连接性使每个 GPU 只需一次跳跃即可与其他 GPU 直接通信,从而有效地将整个机架转变为一个一致的内存域。得益于经过十年精心调校的 NVIDIA 集体通信库 (NCCL),应用程序开发人员可以轻松实现近线速率,而无需为不同的拓扑编写自定义通信代码。
此外,近期发布的 NVLink Fusion 为超大规模计算架构带来了激动人心的可能性。这项创新使定制 CPU 或 XPU 能够通过 UCIe(用于加速器)或 NVLink-C2C(用于 CPU)无缝集成 NVLink SERDES 或芯片组,从而允许这些组件直接部署到 NVLink 架构上。Fusion 的一大优势在于其模块化 MGX 机架规格,并配备完善的供应链。这意味着目前供应 NVL72 机架的供应商也可以提供 Fusion 机架,从而显著缩短了希望实施该技术的公司的产品上市时间。
在推理经济学方面,NVLink 的影响在传统的每瓦吞吐量与延迟帕累托边界上显而易见。通过从 PCIe 网格过渡到 NVLink 交换机节点,吞吐量和延迟均得到提升,并且可以通过升级到 NVLink 机架实现进一步的提升。这意味着每千瓦时可以处理更多的用户查询,同时降低每个令牌生成的摊销资本支出,从而使 NVLink 成为提升运营效率的强大工具。
第五代 NVLink 可在 NVL1.8 机架内提供 130 TB/s 的点对点带宽和 72 TB/s 的聚合带宽。借助 NVLink 交换机,每个 GPU 均可在单跳中互相访问,从而使整个机架成为一个一致的内存域。集体操作通过 NCCL 运行,NCCL 是一个现已问世十年的库,针对所有可能的拓扑进行了调整,并自动实现拓扑感知。因此,应用程序开发人员无需自定义通信代码即可实现近线速。
共封装光学器件 (CPO):突破 800 Gb/s 及以上速率的功率壁垒
传统的可插拔模块交换机已经成为网络标准一段时间了。然而,这些系统固有的低效率问题正日益凸显。数据离开ASIC后,会沿着冗长的PCB走线传输,并经过多个连接器,最终到达DSP密集型的光模块。这一过程会导致严重的损耗,在电场中的损耗通常高达22dB,并且仅为恢复信号,每个端口的功耗就高达30W。随着我们向更高的数据速率迈进,例如目前的200G PAM4以及不久的将来雄心勃勃的1.6T,这种架构的局限性日益凸显,导致功耗预算激增,面板密度也受到限制。
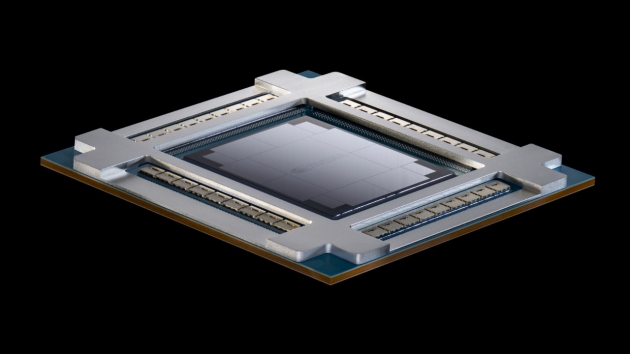
NVIDIA 的创新解决方案:用于 InfiniBand 的 Quantum-X 光子学和用于以太网的 Spectrum-X 光子学。通过将光学引擎直接集成到交换机封装中,它们大幅缩短了电气路径长度。这不仅将损耗降至约 4 dB,还将端口功耗降至约 9 W,这是一个令人印象深刻的改进。
下周,我们将迎来两款尖端液冷机箱的发布:128 端口型号,拥有高达 102.4 Tb/s 的吞吐量;以及 512 端口型号,将吞吐量进一步提升至 409.6 Tb/s。后者集成了光纤切换功能,确保每个端口都能无缝连接到正确的光纤束,无需繁琐的手动连接。初步现场数据令人鼓舞,与传统的可插拔式机箱相比,其能效显著提高了 3.5 倍,平均故障间隔时间提高了约 10 倍。此外,每个集群的启动窗口速度提高了 1.3 倍,从而简化了部署。
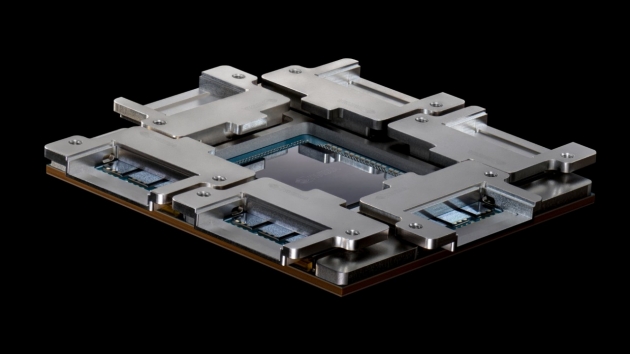
虽然这些先进的解决方案要到2026年才能面世,但设计工作已在进行中。这对于正在规划千兆瓦级设施的运营商,或正在考虑建设百万GPU国家实验室的政府而言至关重要。NVIDIA的CPO(相干光子学)技术清晰地定义了一条控制功率范围并避免令人头疼的光学器件维护难题的途径,为高性能网络更高效、更强大的未来铺平了道路。
DGX Spark 和系统:从桌面原型到机架规模生产
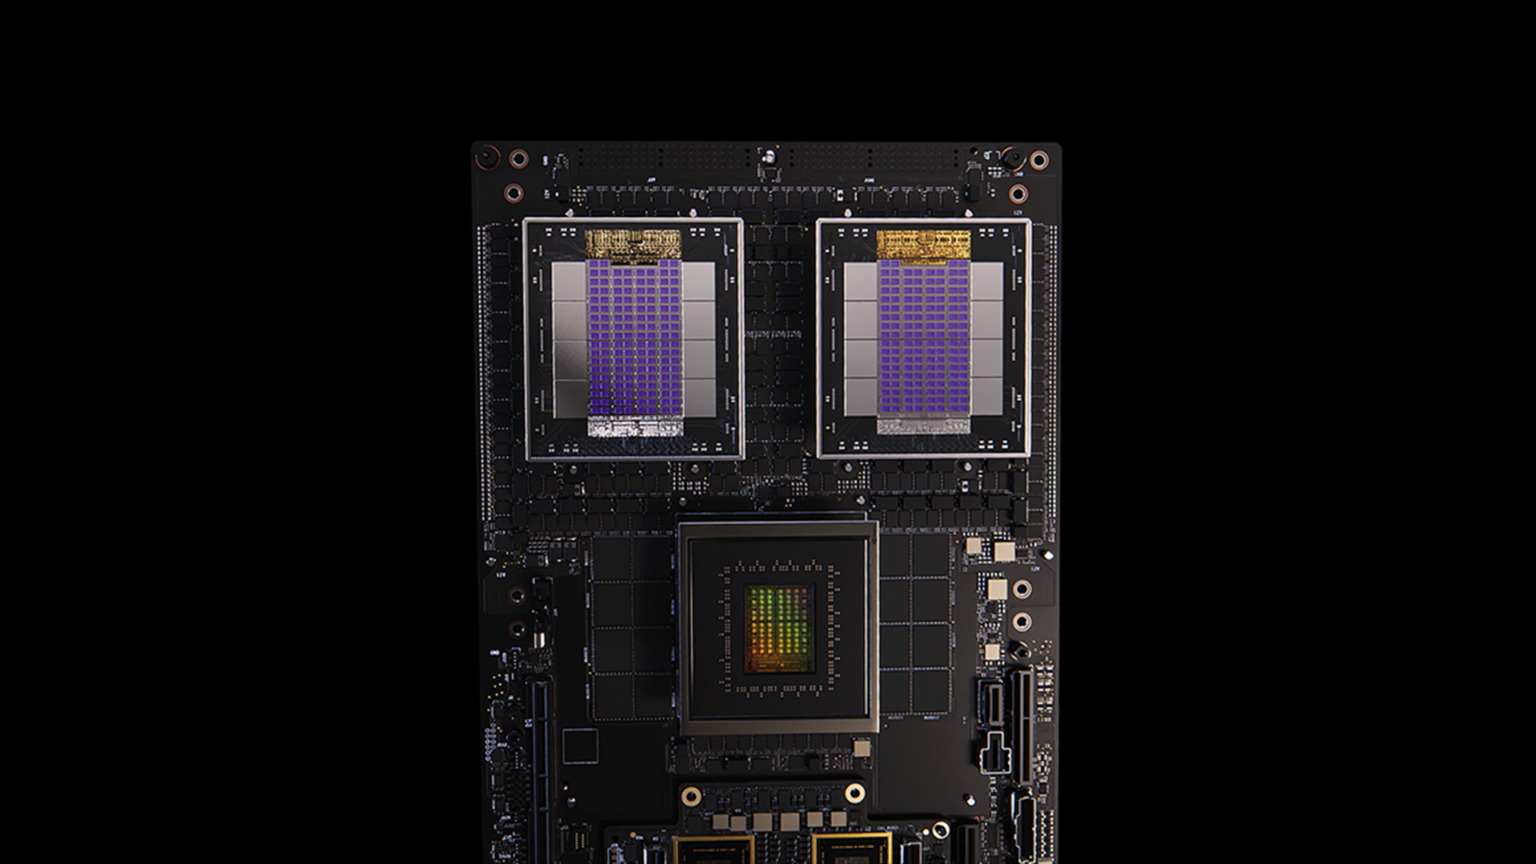
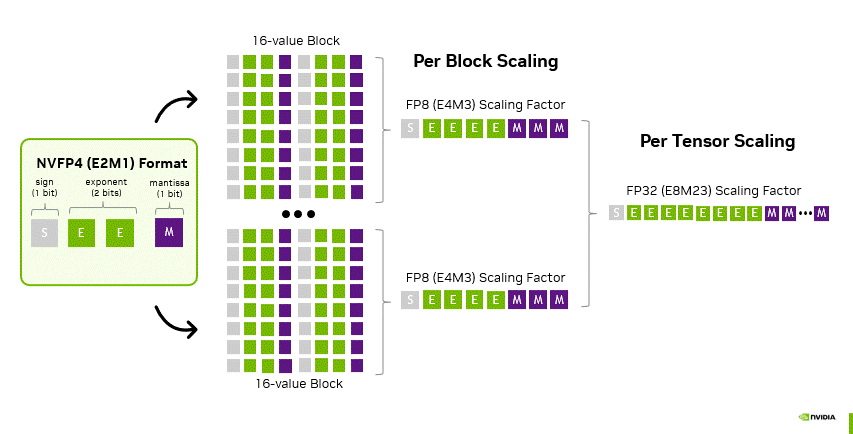
并非所有工作负载都从超大规模开始。DGX Spark由全新的 GB10 超级芯片驱动,将 Blackwell Tensor Core、NVFP4(4 位浮点)推理以及所有 CUDA-X 库压缩到一个桌面机箱中。开发人员可以在本地进行训练、微调和 RAG 组合,然后在工作负载成熟后,将相同的容器迁移到 GB200 或 GB300 NVL72 机架上。
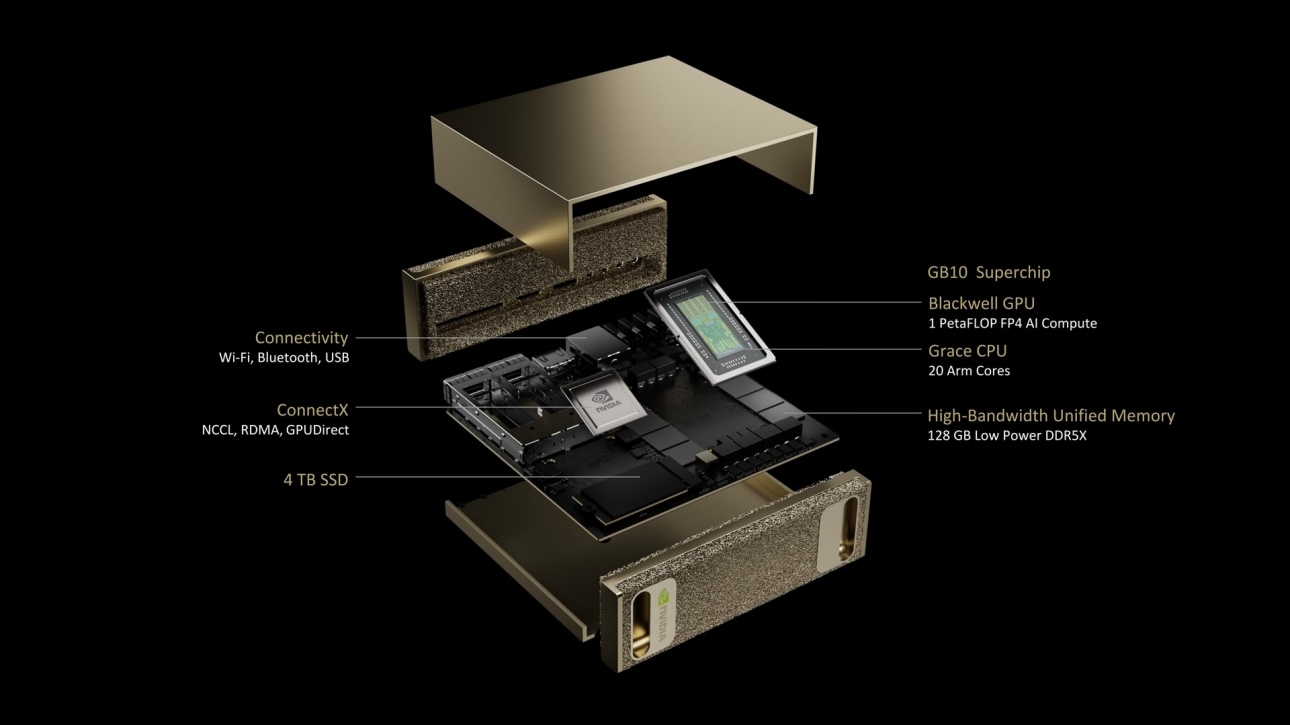
这种连续统一体让企业能够试运行代理AI、机器人感知或多模态生成任务,而无需占用集群插槽。对于该领域而言,Spark就像一匹特洛伊木马:在客户实验室里放置一台,让他们的研究人员亲眼见证4位推理加速,然后扩展就会随之而来。
软件乘数:TensorRT-LLM、Dynamo 和 NIM 微服务
硬件互连设定了上限;软件决定了实际工作负载的接近程度。NVIDIA 将演示 TensorRT-LLM,该模型在 NVFP120 中运行 4 亿参数的 GPT-OSS 模型,在长上下文中,其交互性是原版 TorchServe 的四倍。在 GB200 机架上,1 B 的 DeepSeek-R671 借助 Dynamo 的分解式流水线调度程序,每 GPU 的吞吐量提高了 2.5 倍,且每个查询的成本没有增加。所有这些都以 NIM 微服务的形式呈现——容器化的端点,可以部署到 Kubernetes 集群或本地裸机堆栈中。
开源是整个堆栈的基础。RAPIDS 在 GPU 上端到端加速 ETL;CUTLASS 模板支持自定义高性能内核;NeMo 和 BioNeMo 扩展了 PyTorch,用于前沿 LLM 和蛋白质折叠训练,同时保持 100% 开源软件 (OSS)。对于担心被锁定的买家来说,NVIDIA 的信息是“在重要之处开放,在关键之处优化”。
竞争和商业影响
NVIDIA 凭借其垂直整合的策略,在科技领域占据了独特的地位,尤其与商业芯片交换机供应商和分散的加速器初创公司形成鲜明对比。这一策略使 NVIDIA 不仅能够提供单个组件,还能提供包含参考架构的综合解决方案。该架构由成熟的供应链、清晰的两年路线图以及名为 NIM 的高级 API 接口提供支持,从而简化了开发人员的布线复杂性。
对于超大规模企业而言,NVIDIA 的产品极具吸引力,因为它们注重确定性的服务级别协议 (SLA) 和最低运营风险。通过部署 NVLink 机架,这些企业可以获得卓越的推理能力,这对于需要快速数据处理的应用至关重要。此外,Spectrum-X 技术有助于容量扩展,使超大规模企业能够无缝扩展其基础设施。Spectrum-XGS 的推出允许区域联合,从而提高跨地理分布数据中心的资源分配效率。这种集成支持标准以太网控制平面的运行,确保现有基础设施的兼容性和易管理性。
对于企业而言,NVIDIA 技术的吸引力在于其能够最大化每机架收益。例如,Spectrum-X 系统显著提升了 GPU 周期效率,据称最高可达 35%。这意味着企业无需增加资本支出,即可实现更高的产出,无论是以代币、图像还是自动化操作的形式。因此,企业可以从现有投资中获得更多价值,从而满足当今竞争激烈的市场对效率和成本效益的需求。
底线
围绕“热门芯片”的叙述标志着计算技术领域,尤其是在人工智能 (AI) 领域,发生了显著转变。它强调,网络如今已被视为计算领域的基础加速器,其重要性堪比张量核心等技术进步。
NVLink 等技术至关重要,因为它们将服务器机架转变为一个紧密集成的逻辑芯片,从而提升性能和效率。Spectrum-X 在促进广泛网络的亚毫秒级聚合方面发挥着至关重要的作用,而 Spectrum-XGS 则在全球范围内扩展了这种高性能结构。此外,CPO 旨在确保功率和密度要求面向未来,满足 AI 应用不断变化的需求。另一方面,DGX Spark 在促进这些技术的采用方面发挥着重要作用,鼓励企业采用创新解决方案。
总的来说,这些进步有可能改变推理和训练过程的经济动态。这一点尤其重要,因为企业目前正处于十字路口,权衡是构建新的基础设施、租用现有解决方案,还是推迟对大规模人工智能能力的投资。NVIDIA 的立场非常明确:企业应该投资构建自己的基础设施,但重点是精心设计的网络框架——从铜线到光子交换机——以支持即将到来的由人工智能驱动的工厂主导的时代。


 Amazon